物流向けOCR:
BOL、POD、輸送書類の自動化
中規模のフォワーダーは、毎日60〜100件の船荷証券、80件以上の配送証明書、そして数十件の運賃請求書と梱包明細書を処理しています。1件あたり10〜15分の手入力と、取扱量よりも速く増大するエラー修正のループにより、ほとんどの物流チームは貨物を動かすのではなく、入力に時間を費やしています。物流向けOCRは、この書類の流れを、運送会社ごとのテンプレート管理や手作業による再入力なしで、TMS、ERP、またはスプレッドシートに供給できる構造化データに変換するための体系的なアプローチです。
重要ポイント
- 1日60〜100件の船荷証券、1件あたり10〜15分 — 物流デスクは、1件の貨物が動き出す前に、データ入力に1日10〜15時間を費やしています。
- 請求書で導入したOCRは物流書類では機能しません。物流では自然言語ではなく、SCAC、UN/LOCODE、ISO 6346などのコード体系が使われており、生のテキスト
MAEUを抽出するツールは、それを運送会社名にマッピングするステップを自動化していないからです。 - セマンティック抽出は、特定の運送会社のレイアウト上の位置ではなく、フィールドの意味に基づいて読み取ります — 1つの設定で全てのBOLフォーマットを処理でき、新しい運送会社を追加してもテンプレート保守の工数はゼロです。
物流向けOCRの実際の意味 — 一般的な文書OCRとの違い
物流向けOCRとは、サプライチェーンを流れる文書(船荷証券(B/L)、配送証明書(POD)、梱包明細書、税関申告書、運賃請求書)からデータを自動抽出・構造化することを指します。目的は単にこれらの文書を検索可能なテキストにデジタル化することではなく、フィールドレベルの構造化データ(コンテナ番号、SCACコード、HSコード、運賃条件、港コード、数量、料金)を生成し、TMS、ERP、WMS、またはスプレッドシートに直接取り込めるようにすることです。
この違いが重要なのは、汎用OCRツールはすべての文書を「ページ上のテキスト」として扱うためです。文字は認識しますが、COSU8102804がコンテナ番号(ISO 6346の規則に基づくチェックディジット4付き)であることや、NL RTMがUN/LOCODEで表されたロッテルダム港であることは認識しません。物流文書には業界固有のコードやフィールド間の関係が含まれており、汎用OCRエンジンはトレーニング中にそれらを学習していません。請求書抽出に最適化されたツールは、SCACコードやコンテナプレフィックスを見逃します。なぜなら、そのトレーニングデータ(AP請求書)にはそもそもそれらが含まれていないからです。これは、AP請求書でトレーニングされたツールが物流固有のフィールドで60%を下回ったという、当社の物流抽出ツール比較で明らかになりました。
実際には、物流向けOCRにはセマンティック理解(ページ上の位置ではなく意味によってフィールドを識別する能力)とドメイン固有のコード知識(物流システムが期待する標準に照らして出力を検証・正規化する能力)の両方が必要です。セマンティック抽出が従来の文字認識とどう異なるかについては、AI OCRとは何か、その仕組みに関するガイドをご覧ください。
物流にOCRが必要な理由:定量化された根拠
物流の文書処理の規模は、オペレーション以外のチームにはほとんど見えません。フォワーダーのデスクが1日50〜80件の荷物を扱う場合、各荷物の書類は別々のPDFまたは画像として届きます。多くの場合、それぞれ異なるフォーマットを持つ異なる船会社やフォワーダーからです。手動データ入力は1文書あたり推定10〜15分かかるため、1日60件のB/Lを処理するフォワーダーは、配送証明書(POD)の確認、運賃請求書の照合、税関申告書の準備を考慮する前から、タイピングだけで毎日10〜15時間を費やしています。
この時間コストに加えて、エラー率も問題です。物流ワークフローにおける手動データ入力の調査では、定型フィールドで2%〜5%のエラー率が一貫して見られ、手書きの入力ではさらに高くなります。15〜20個の抽出可能なフィールドがあるB/Lでは、3%のエラー率はおよそ2文書に1件のエラーを意味します。物流では、HSコードの1桁の入力ミスが税関の保留を引き起こす可能性があります。コンテナ番号の打ち間違いは、荷物を数日間追跡不能に陥らせる可能性があります。重量の桁の入れ替えは、解決に数週間かかる運賃チャージバックを発生させる可能性があります。
大量の文書を処理する物流チームにとって、OCR自動化のビジネスケースは理論上のものではありません。B/Lと運賃請求書のデータ入力を自動化することで、処理時間を半分以上削減し、同時にエラー率も削減できることが示されています。これにより、データ入力スタッフは反復的なタイピングではなく、例外処理と顧客サービスに集中できるようになります。
OCRが必要な5種類の物流文書
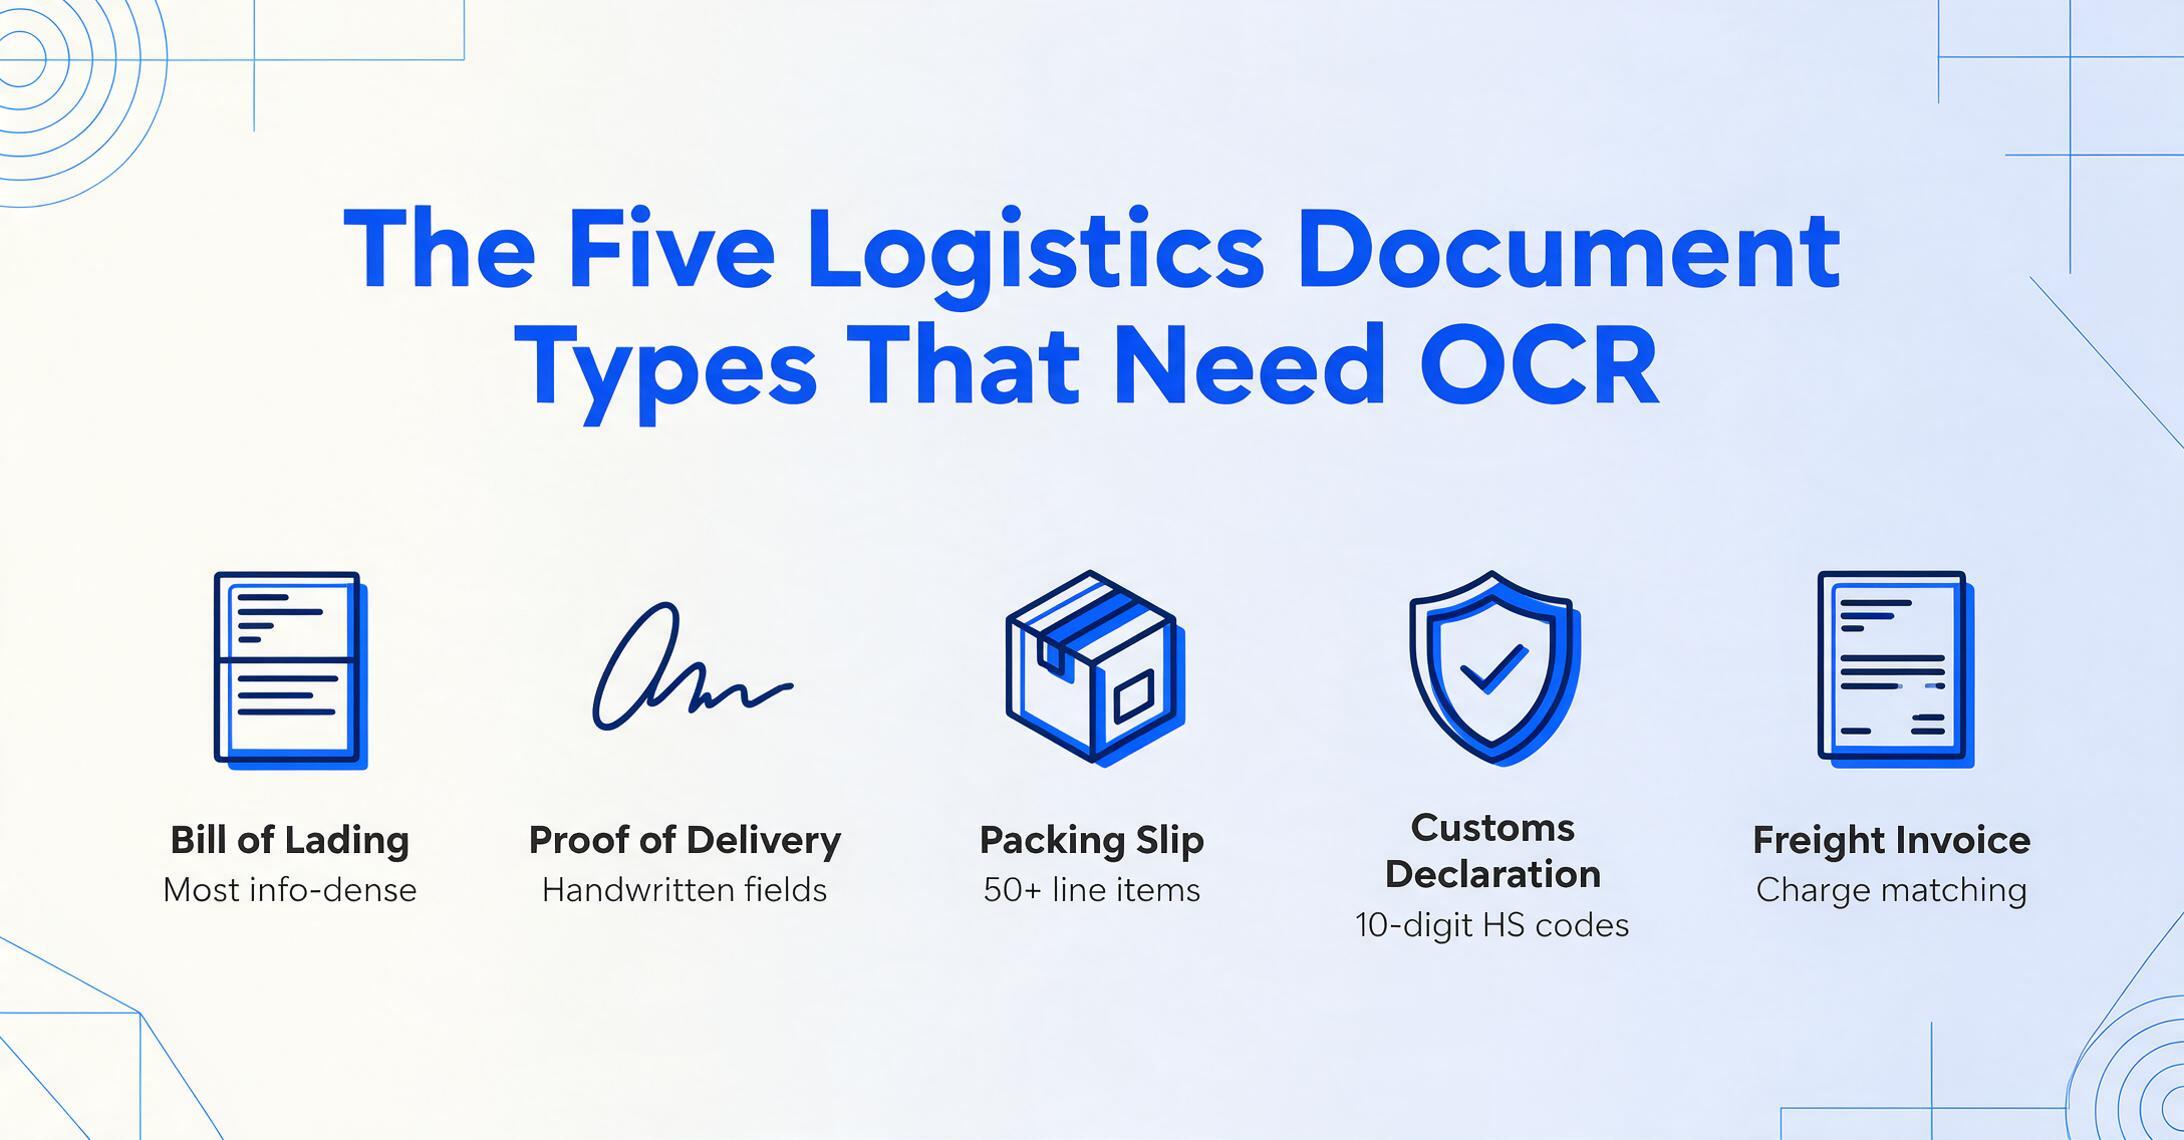
物流オペレーションは1種類の文書だけを処理するわけではありません。少なくとも5種類の文書が混在した流れを処理します。それぞれに独自のフィールドセット、法的機能、抽出課題があります。以下に、OCRがそれぞれにどのように適用されるかを示します。
1. 船荷証券(B/L)
船荷証券は物流において最も情報量の多い書類です。受取証、運送契約書、そして権原証券としての役割を果たします。原本を保有する者が貨物を請求できます。1枚の海上B/Lには、荷送人の名称とEORI番号、荷受人、通知先、船名と航海番号、船積港と荷揚港(それぞれUN/LOCODEで表記)、コンテナ番号(チェックディジット付きのISO 6346形式)、シール番号、貨物明細、総重量と正味重量、梱包数、運賃条件(前払いまたは着払い)、インコタームズ規則(FOB、CIF、FCAなど)、そして多くの場合HSコード付きの複数の明細項目が記載されます。フィールドの位置は船会社によって異なります。マースクはコンテナ番号を右上の象限に配置し、MSCは船名の下、ページ中央に配置します。ハウスB/LにはマスターB/L番号が記載されることがありますが、記名式船荷証券には記載されません。この書類タイプの詳細な解説については、船荷証券データ抽出に関する専用ガイドをご覧ください。B/Lのフィールドを数秒でスプレッドシートに抽出するには、船会社ごとの設定不要の船荷証券からExcelへの変換ツールをご利用ください。
2. 配送証明書(POD)
PODは輸送サイクルの最終書類であり、貨物が到着したこと、その状態、そして誰が受け取ったかを確認します。抽出の課題は、POD上で最も重要なフィールドが最も機械読み取りが難しいことです。配送サインは手書きであり、多くの場合、人間の読者でも解読に苦労するような走り書きです。配送のタイムスタンプはドライバーが手書きすることもあります。破損の記載(「段ボール1個つぶれ — 受取拒否」)、数量の部分的な注記(「50個中47個を受領」)、遅延到着のスタンプは、通常、欄外に手書きされます。2026年の最高の手書き文字OCRツールは、きれいなブロック体で85〜95%の精度を実現しますが、筆記体のサインや欄外のメモは、ほとんどの物流ワークフローにおいて人間による確認レイヤーとして残ります。セマンティック抽出によるAIはこれを部分的に軽減します。文書構造を理解するモデルは、確認者がすべてのフィールドを精査する代わりに、ページ上の正しい場所へ誘導することができます。
3. 梱包明細書
梱包明細書はすべての出荷に同梱され、各カートンやパレットの中身(品目説明、SKUコード、数量、ロット番号、場合によってはHSコードや原産国表示)を記載しています。梱包明細書の抽出価値は受入効率にあります。受入数量を発注書と自動照合し、仕入先請求書が届く前に不足出荷を検知し、手作業による品目レベルの入力なしでWMSにデータを供給できます。梱包明細書はB/Lよりもレイアウトがシンプルな傾向がありますが、明細行の密度は高く、1枚の明細書に50以上のSKUが記載されることもあり、在庫照合のためには各行を正確に取り込む必要があります。テンプレートベースOCRは、3PLや仕入先ごとに明細書の形式が異なるため、ここでは対応が困難です。フィールドを座標位置ではなく意味で読み取るセマンティック抽出は、このばらつきをネイティブに処理します。
4. 税関申告書
税関申告書(EUのSAD、米国のCBP 3461、英国のCDS申告)は、抽出精度が法的コンプライアンスに直接結びつく書類です。税関申告書の各フィールドは規制データ要素に対応しています。HSコードは関税率を決定し、原産国は貿易協定の適用可否を決定し、申告価格はVATと関税の課税標準を決定します。HSコードの1桁の誤りが関税の過払いにつながる可能性があり、規制対象貨物の場合は貨物の差し押さえや罰則につながることもあります。税関申告書にはこのリストの他の書類のデータも組み込まれます。B/Lは輸送詳細を、商業送り状は価格を、梱包明細書は明細行数量を提供するため、文書間の整合性が重要な検証要件となります。したがって、税関書類向けOCRは、汎用抽出よりも高い信頼度しきい値で動作する必要があります。
5. 運賃請求書
運賃請求書は物流における金銭照合書類です。基本運賃、燃料サーチャージ(通常総額の10〜25%)、付帯料金(リフトゲート、屋内配送、住宅地サーチャージ)、延滞料/滞船料、交渉による割引など、輸送にかかる費用を明細化します。これらの請求書の手作業による監査負担は大きく、1件の過請求が50〜200ドルになることもあり、規模が大きくなると、体系的な過大請求で年間数万ドルのコストになる可能性があります。運賃請求書の自動抽出により、APチームは請求額を契約レートと照合し、サーチャージの不一致をフラグし、例外をレビューに回すことができ、請求明細を手作業でスプレッドシートに入力する必要がなくなります。運賃請求書の抽出における特有の課題は、運送会社ごとに同じサービスを異なる方法で記述する、さまざまな料金コードと略語(多くの場合、運送会社固有)の存在です。
物流文書がOCRにとって特に難しい理由
物流文書は単なる「フィールドが異なる請求書」ではありません。従来のOCRや、多くの汎用AI抽出ツールでさえ処理できるように設計されていない、一連の構造的な課題を提示します。
ドメイン知識を必要とする独自のコード体系
物流は自然言語ではなくコードで運用されています。B/Lは「運送会社はMaersk Line」とは記載せず、MAEU(運送会社のSCACコード)と記載します。港は「Rotterdam, Netherlands」とは書かれず、UNECEによって割り当てられた5文字のUN/LOCODEであるNL RTMとして表示されます。コンテナ番号はISO 6346に従い、4文字の所有者コード(例:MSCU)、6桁の連番、および数学的に検証可能なチェックディジットで構成されます。HSコードは、世界税関機構によって管理されている6〜10桁の商品分類です。これらのコード構造を認識しないOCRシステムは、有用になる前に手動での再エンコードが必要な生のテキストを出力します。これらを認識するシステムは、出力を検証できます(例えば、抽出されたコンテナ番号がISO 6346のチェックディジット計算を通過することを確認するなど)。これにより、下流の検証負担を大幅に軽減できます。
手書きPOD署名と余白の注記
最も運用価値の高い書類である配送証明書(POD)は、機械可読性が最も低い書類でもあります。ドライバーは走り書きで署名し、受取人は余白に配送例外を書き留め、タイムスタンプも手書きで記入されます。運送会社にとって、これらの手書き欄は配送と状態の法的記録です。OCRシステムにとっては、固定フィールド境界のない二次元空間上の可変手書き文字という、最も困難な抽出シナリオを意味します。従来のOCRは、乱雑なPOD注記では50%未満の精度に低下します。ビジョン言語モデルを用いた最新のAI抽出はこれより優れており、きれいな手書き文字では75〜90%、筆記体では60〜75%を維持しますが、これらは完全自動処理を意味する数字ではありません。手書きフィールドに対する人間による検証は、ほとんどの物流ワークフローで依然として必要なチェックポイントです。
多言語・多文字セットのドキュメント
国際物流は国際的なドキュメントを意味します。上海からハンブルクへの輸送では、中国語(货物描述)、ドイツ語(Gefahrgutklasse)、英語が同じページに含まれる書類が生成されることがあります。タイの税関申告書はタイ文字を使用します。日本の港は漢字で表示されます。ラテンアメリカのB/Lはスペイン語と英語が混在することがよくあります。従来のOCRエンジンは言語固有であり、英語またはドイツ語用に設定すると、設定された言語セット外では認識精度が低下します。多言語ドキュメントコーパスでトレーニングされたAIビジョンモデルは、文字セットではなく視覚パターンを処理するため、これをより適切に処理しますが、精度はスクリプトによって大きく異なります。グローバル運用を目的とした物流OCRソリューションは、英語のみの精度ではなく、実際に遭遇する言語ミックス全体でのパフォーマンスで評価される必要があります。
標準化のない可変キャリアフォーマット
船荷証券(B/L)の標準化されたテンプレートは存在しません。マースク、MSC、CMA CGM、COSCO、ハパックロイド、ONE、エバーグリーン — 世界最大の7つの海運会社 — はそれぞれ異なるレイアウトを使用しています。フィールドの配置は、キャリア間、マスターB/LとハウスB/Lの間、そして同じキャリアの電子版と紙版の間でも異なります。FedEx Expressの航空運送状(AWB)はDHL Expressの書類とはまったく異なります。航空貨物抽出に特化したツールについては、航空運送状(AWB)からExcelへの変換ツールをご覧ください。トラック運送会社のPODは、多ページのカラー形式から、手書きの注記が追加された感熱紙の単一シートまで多岐にわたります。テンプレートベースOCRでは、バリアントごとに個別の設定が必要であり、新しいキャリアとの関係が増えるたびにメンテナンス負担が増大します。セマンティックAI抽出は、座標ではなく意味によってフィールドを特定するため、単一の設定ですべてのバリアントを処理します。これが、物流における従来のOCRと最新のAI抽出の核心的な違いです。
インコタームズと貿易条件の多様性
国際商業会議所が発行するインコタームズ2020は、EXW(工場渡し)からDDP(関税込持込渡し)までの11の貿易条件を定義しており、各貨物のリスク移転、コスト配分、保険義務を定めています。単一のB/Lに「CIF上海」と記載されていても、同じ貨物の他の書類では契約条件として「CIF」が異なる形で参照されることがあります。インコタームズの抽出自体はほとんどのOCRツールにとって簡単ですが、その解釈—FOBが海上輸送のみに適用される一方でFCAがあらゆる輸送手段に適用されることを理解すること—には、汎用抽出では提供されないドメイン知識が必要です。
物流における従来型OCRと最新AI抽出の比較
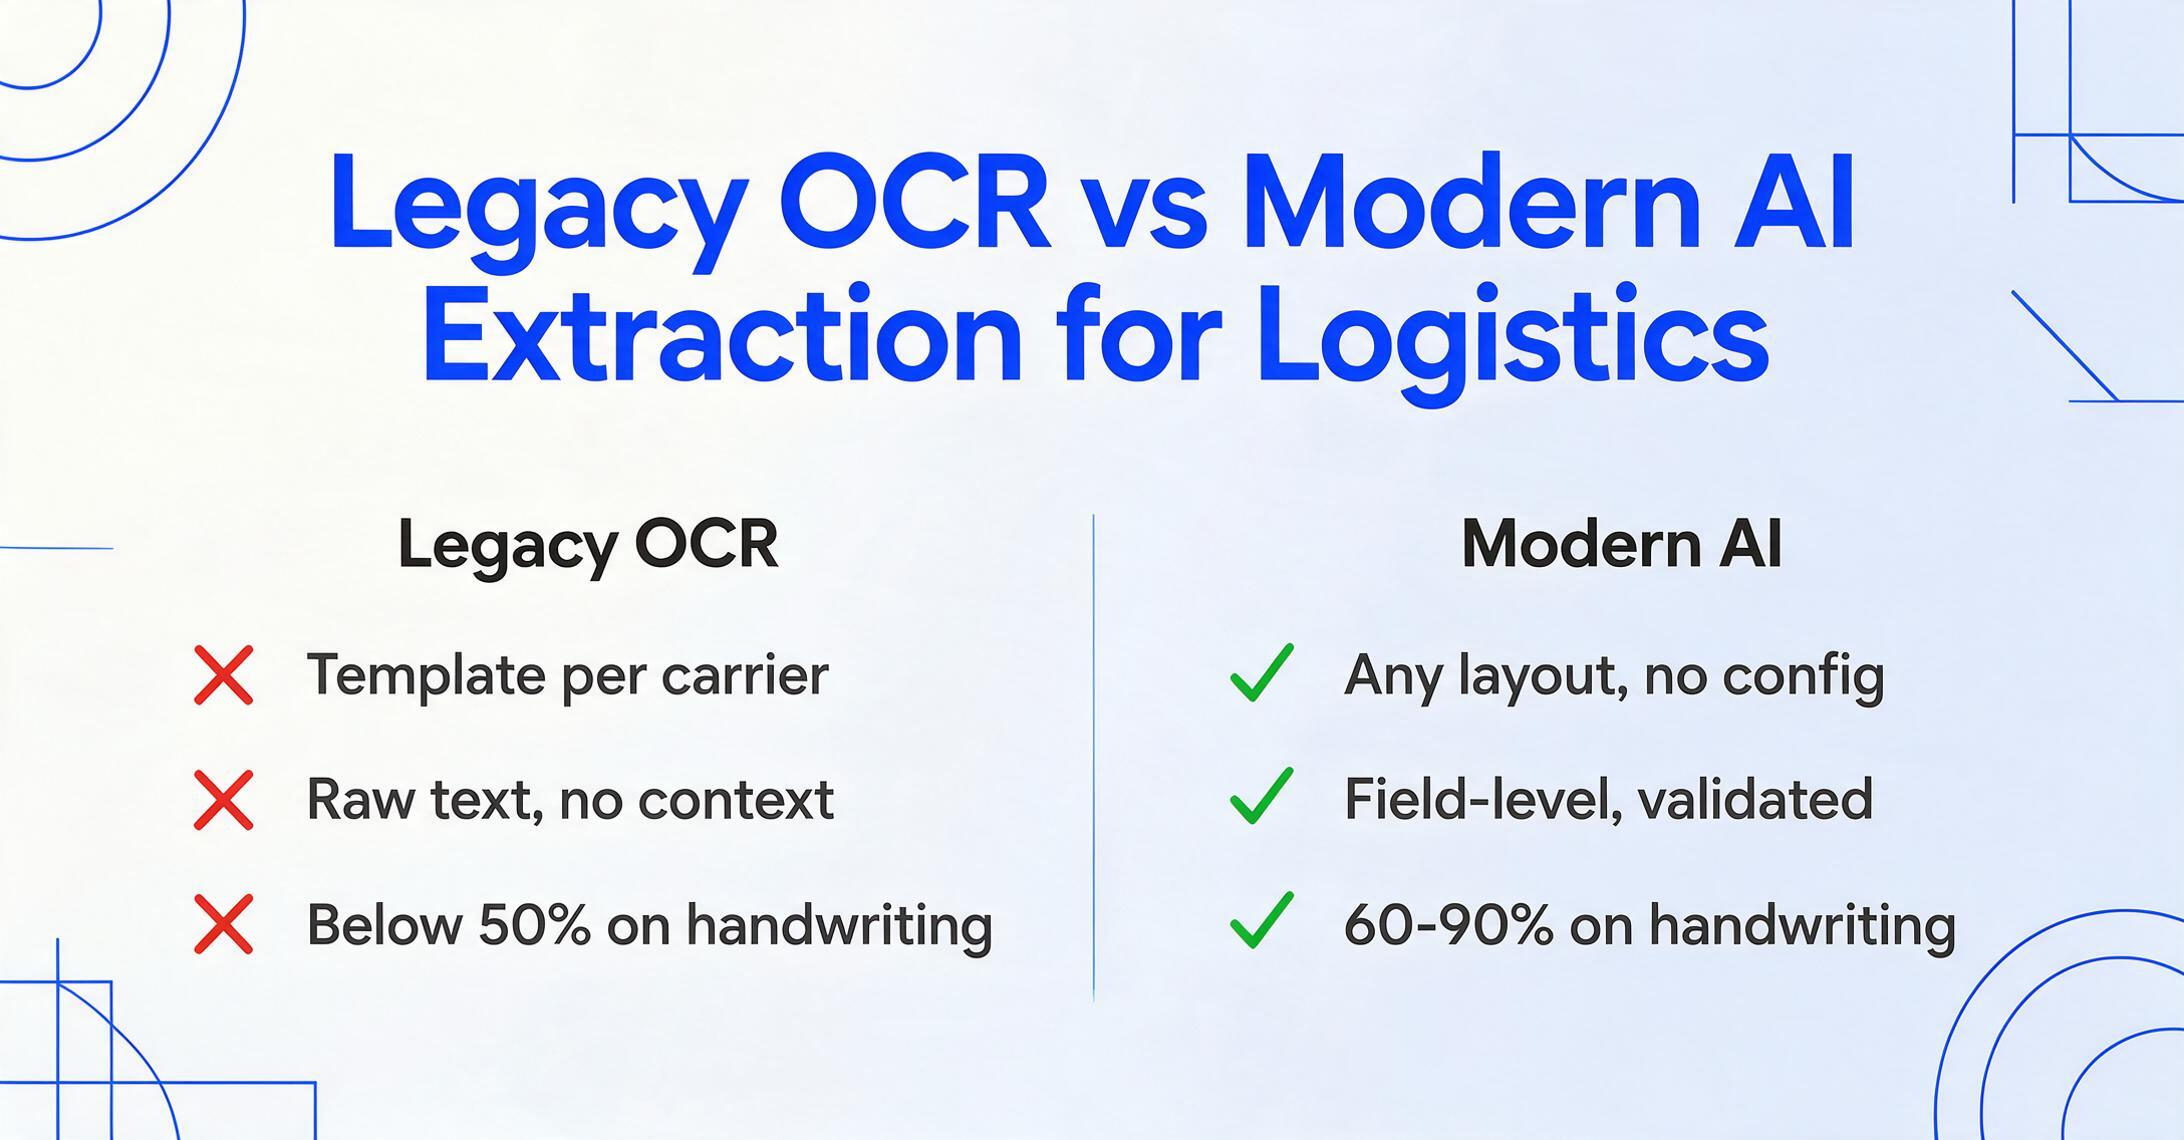
従来型OCRと最新AI抽出の違いは、段階的なアップグレードではありません。それは文書の読み取りに対する根本的に異なるアプローチです。物流にとって重要な各側面について、両者を比較したのが以下の表です。
| 側面 | 従来型OCR | AIビジョン言語モデル抽出 |
|---|---|---|
| 読み取り方法 | 文字単位、行単位で処理 | 全体的に処理—ページを画像として捉え、レイアウトを理解 |
| キャリアのフォーマット対応 | フォーマットごとのテンプレートまたは領域設定が必要 | あらゆるレイアウトを読み取り、キャリアごとの設定は不要 |
| コード認識 | 文脈なしで生テキスト(例:「MAEU」)を出力 | フィールドタイプを識別し、フォーマットを検証可能(例:SCACコード=2〜4文字) |
| 手書き文字の許容度 | 乱雑なPOD注記では50%未満 | 判読性に応じて60〜90%。人間による検証は依然として必要 |
| 多言語対応 | 言語固有。設定された言語以外では性能が低下 | デフォルトで多言語対応。混在スクリプトの文書も処理可能 |
| フィールド単位の出力 | テキストブロックを生成。フィールドは手動で特定する必要がある | 抽出値をユーザー定義またはAI識別のフィールドにマッピング |
| セットアップ時間 | キャリアごとのテンプレート設定に数時間〜数日 | 数分。文書をアップロードして必要な項目を定義するだけ |
上記の表は明確に示しています。複数のキャリア、複数の文書タイプ、印刷と手書きの混在コンテンツを扱う物流業務では、従来型OCRはフォーマットごとのメンテナンスが必要となり、自動化のROIを損なうのです。文書をセマンティックに処理するAIビジョン言語モデルは、設定時ではなく読み取り時点で多様性に対応します。これら2つの技術的アプローチの詳細な比較については、AI OCRと従来型OCRの比較に関する記事をご覧ください。
物流書類抽出における主要フィールド
以下は、各物流書類タイプがデータフローに提供するフィールドレベルの内訳です。抽出する具体的なフィールドはワークフローによって異なります(運用チームは出荷追跡データ、APチームは請求明細を必要とします)が、全フィールドマップを理解することでツール評価の指針となります。
| 書類タイプ | 主要抽出フィールド | 特有の課題 |
|---|---|---|
| 船荷証券 | BOL番号、荷送人、荷受人、通知先、船名、航海番号、積港、揚港、コンテナ番号(ISO 6346)、シール番号、貨物記述、HSコード、総重量/正味重量、梱包数、運送条件、インコタームズ | キャリアごとにフィールド位置が変動;ハウスBOLとマスターBOLの差異;SCACコード抽出;複数行の貨物記述;コンテナのチェックデジット検証 |
| 配送証明書 | 配達日時、受取人名、署名画像、配達ステータス、破損記録、部分数量、POD参照番号、運送会社名 | 手書き署名と余白のメモ;文書品質のばらつき(感熱紙の劣化);非標準的なタイムスタンプ形式 |
| 梱包明細書 | 梱包明細番号、PO番号、荷送人/荷受人、品目記述、SKUコード、SKU別数量、単位、バッチ/ロット番号、総カートン数、総重量、HSコード(輸出時) | 明細行の高密度(50行以上);サプライヤーごとの列順序の不統一;印刷と手書きの数量修正の混在 |
| 税関申告書 | 申告番号、申告者EORI、輸出者/輸入者詳細、HSコード(EU/USは10桁)、原産国、申告価格、通貨、総重量/正味重量、輸送手段、コンテナ番号、インボイス参照 | 規制に基づく検証が必要(HSコード構造、国コードISO 3166);複数ページの申告書;書類間の整合性チェック必須;エラーコストが高い |
| 運送請求書 | 請求書番号、運送会社名、SCACコード、PRO番号、BOL参照、基本運賃、燃料サーチャージ、付帯費用、合計金額、支払条件、NMFCクラス(LTL) | 同一サービスに対する運送会社固有の料金コード;燃料サーチャージ計算式のばらつき;契約ごとに異なる滞船料計算;誤金額によるチャージバックリスク |
抽出ツールの実用的なテスト:MaerskのBOLとMSCのBOLを同じ設定で処理し、両方のコンテナ番号をフィールドレベルで正確に抽出できるか?できない場合、そのツールは運送会社ごとのメンテナンスが必要であり、運送会社を追加しても抽出単価は低下しない。
コンプライアンスと規制に関する考慮事項
物流ドキュメント抽出は単なる効率化の手段ではなく、複数の時点で規制上の義務と交差します。ツール評価の際にこれらのコンプライアンスへの影響を理解することは重要です。すべての抽出ワークフローが同じレベルの検証厳格性を必要とするわけではないからです。
UCP 600と信用状(L/C)。 UCP 600第20条は、信用状に基づいて提示される船荷証券を規定しています。B/Lデータと信用条件の間に不一致がある場合(貨物明細、船積港または荷揚港、「船積み済み」の記載日、荷受人名など)、銀行による拒否が発生し、支払いが数週間遅延する可能性があります。L/Cを支払い手段として利用する輸出業者にとって、OCRツールは単なる一括テキスト抽出ではなく、事前定義されたルールに対するフィールドレベルの検証をサポートする必要があります。L/C条件に対してB/Lデータを検証できるAIツールは、書類が銀行に提示される前に潜在的な不一致を特定できます。
米国税関・国境警備局(CBP)。 米国に入国する貨物について、CBPのACE(自動商業環境)は特定のデータ要素を要求します:輸入者記録番号、10桁のHTSUSレベルでのHSコード、原産国(ISO 3166 alpha-2)、米ドルでの申告価格、船荷証券番号です。各フィールドには定義された形式と許容値範囲があります。これらのフィールドを形式準拠を検証せずに抽出するOCRソリューションは、検証負担を税関ブローカーに転嫁します。
ISO規格。 物流業界のコード体系は、定義された検証ルールを持つ国際規格によって管理されています。コンテナ番号はISO 6346のチェックディジットアルゴリズムに対して検証できます。UN/LOCODEはUNECEのマスターデータファイルに対して確認できます。SCACコードはNMFTAレジストリに対して確認できます。抽出時点でこれらの検証を実行する抽出ツール(TMSに入る前に無効なチェックディジットを持つコンテナ番号をフラグ付けする)は、下流での重大なエラー修正ループを排除します。
輸出管理。 規制対象貨物(ITAR、EAR)の輸送について、貨物明細とHSコード分類によって輸出ライセンスが必要かどうかが決まります。これらのフィールドを抽出するOCRシステムは自動コンプライアンスチェックをトリガーでき、必要な許可なしに規制対象貨物を輸送するリスクを低減します。
ドキュメント抽出が物流業務の財務面にどのように適合するかについてのより広い視点については、会計チーム向けAIデータ入力に関するガイドをご覧ください。自動データ検証の原則は、運賃請求書処理と税関評価に同様に適用されます。
物流OCRツールの選び方
物流業務は、運送会社の組み合わせ、文書量、下流システムの構成によってそれぞれ異なります。以下のフレームワークは、物流ワークフローに実際に影響する観点でツールを評価するためのものです。一般的な機能チェックリストではありません。
ImageToTable.aiのようなツールは、カスタム列抽出を使用します。フィールドを名前で定義するだけで、AIがページ上のどこにあっても意味的にそのフィールドを特定します。複数の運送会社の書式を1つの設定で処理できるため、物流業務に特に適しています。「コンテナ番号」「SCACコード」「船積港」「運賃条件」などの列を定義すれば、同じ設定でMaerskのB/L、MSCのB/L、トラック運送会社のPODを調整なしで処理できます。多種多様な貨物文書を大量に処理するチームにとって、このフォーマット非依存性は、自動化ROIを最も大きく押し上げる要素です。B/L、運賃請求書、税関申告書、梱包明細書など、単一の文書タイプのOCRだけでなく、文書全体を評価するのであれば、物流文書抽出のバイヤーズガイドで、文書横断的な評価基準を詳しく解説しています。
Google スプレッドシートのアドオンは、専用のTMSではなくスプレッドシートで輸送データを管理している小規模な物流チームやフォワーダーにも適しています。船荷証券のデータを直接Google スプレッドシートに抽出することで(コンテナ番号、PO番号、運賃など)、システム移行を必要とせずに手動でのスプレッドシート入力を置き換えます。現在スプレッドシートで輸送データを照合している場合、このアプローチはチームがすでに使用しているツール内で自動化のメリットをもたらします。
よくある質問
OCRは配送証明書の手書きサインを読み取れますか?
部分的に可能です。最新のAI搭載OCR(ビジョン言語モデル)は、きれいな活字体の手書き文字を75〜90%の精度で読み取れますが、筆記体のサインや走り書きは難しく、精度は60〜75%に低下します。手書きサインや破損の記載が法的記録となるPODでは、ほとんどの物流ワークフローがこれらのフィールドのOCR抽出を「使用前レビュー」ステップとして扱い、完全自動化は行いません。PODにおけるOCRの実用的な価値は、人間によるレビューを完全に排除することではなく、手書きフィールドの特定と確認にかかる時間を数分から数秒に短縮することです。
OCRは複数言語の国際輸送書類に対応していますか?
はい。AIベースのOCRツールは、従来のOCRエンジンよりも多言語書類の処理に優れています。多言語の文書コーパスでトレーニングされたビジョン言語モデルは、単一のモデル内で全ての文字体系を処理するため、言語ごとの設定は不要です。ただし、精度は文字体系によって異なります。ラテン文字圏の言語(英語、フランス語、スペイン語、ドイツ語)が最も高い精度を示します。中国語、日本語、韓国語の文字は、文字密度とストロークの複雑さにより認識が難しいものの、現行世代のAIモデルの能力の範囲内です。英語のみのベンチマークに頼らず、実際の書類構成でツールをテストすることをお勧めします。
OCR抽出におけるコンテナ番号の検証はどのように行われますか?
コンテナ番号はISO 6346形式に従います。所有者コード4文字、シリアル番号6桁、チェックディジット1桁で構成されます。高度なOCRツールは、抽出したコンテナ番号をISOのチェックディジットアルゴリズムと照合して検証できます。システムは数学的に、9文字のプレフィックスが10番目のチェックディジット文字を生成することを確認します。この検証により、物流で最も一般的な手動データ入力エラーの1つである、コンテナ番号の桁の入れ替え(通常、特定に数日かかる)を検出できます。抽出された番号が検証に失敗した場合、ツールはエラーを下流に渡すのではなく、レビュー用にフラグを立てます。
テンプレートベースのBOL抽出とセマンティック抽出の違いは何ですか?
テンプレートベースの抽出では、運送会社ごとにBOLフォーマットの座標とフィールドラベルを定義する必要があります。運送会社がレイアウトを変更したり、新しい運送会社を追加したりすると、テンプレートが機能しなくなるか、最初から設定し直さなければなりません。一方、セマンティック抽出は、フィールドの位置ではなく意味を理解して文書を読み取ります。必要なフィールド(BOL番号、コンテナ番号、積港など)を定義するだけで、AIがページ上のどこにあってもそれらを見つけ出します。つまり、1つの設定がすべての運送会社フォーマットで機能し、運送会社がレイアウトを変更してもメンテナンスは不要です。複数の運送会社を扱う物流業務において、セマンティック抽出は、拡張性のある自動化と新たなメンテナンス負担を生む自動化との実質的な違いをもたらします。
物流書類におけるAI抽出の精度は、手動データ入力と比較してどの程度ですか?
主要運送会社の鮮明な機械印字BOLの場合、最新のAI抽出は標準フィールド(荷主、荷受人、船舶、港)で90~99%のフィールドレベル精度を達成します。SCACやUN/LOCODEのような物流固有コードでは、印字内容の精度は通常85%以上です。手書き内容は、読みやすさに応じて60~90%に低下します。これらの数値は、手動データ入力(ルーチンフィールドで通常95~98%の精度)と比較しても遜色ありませんが、速度は格段に速く、AIでは1件あたり5~10秒に対し、手動では10~15分かかります。重要な指標はスループットです。AI抽出は、手動オペレーターが1件処理する間に60~100件を処理できるため、手書きフィールドに人間による確認ステップが残る場合でも、大量の物流業務に適しています。
抽出した出荷書類データをTMSやERPに直接エクスポートできますか?
ほとんどのAI抽出ツールは、基本機能としてCSVまたはExcelエクスポートを提供しています。また、TMSやERPシステムへの自動データ転送のためのAPIアクセスを提供するものも多くあります。一部のツールは、CargoWise、SAP、Oracle、QuickBooks、Xeroなどのプラットフォームとの直接統合や、Zapier、Make、Power Automateを介したデータ連携を提供しています。出力形式と統合方法は重要な選択基準です。抽出ツールのデータを運用システムに入力する前に手動で再フォーマットする必要がある場合、自動化のメリットは大幅に減少します。スプレッドシートベースのワークフローでは、Googleスプレッドシートアドオンを備えたツールを使用すると、中間ファイルのエクスポートなしで、抽出データをシートに直接挿入できます。
物流書類に記載されることが想定されるインコタームズは何ですか?
11のインコタームズ2020ルールは2つのカテゴリーに分類されます。あらゆる輸送手段向け:EXW(工場渡し)、FCA(運送人渡し)、CPT(輸送費込み)、CIP(輸送費・保険料込み)、DAP(場所渡し)、DPU(荷下ろし場所渡し)、DDP(関税込み渡し)。海上および内陸水路輸送のみ:FAS(船側渡し)、FOB(本船渡し)、CFR(運賃込み)、CIF(運賃・保険料込み)。コンテナ化された貨物の場合、FOBやCIFよりもFCAやCIPの方が一般的に適切ですが、FOBは今でも一般的に、そしてしばしば誤って使用されています。有能な抽出ツールは、これら11の用語とその略称をすべて認識できる必要があります。
配送書類抽出を業務に活かす
物流業務では、書類の受入を標準化する余裕はありません。BOLは20の異なる運送会社から、20の異なるレイアウトで届きます。PODはドライバーから手書きの署名や余白のメモとともに戻ってきます。梱包明細書、運送請求書、税関申告書は、それぞれ独自のフィールドの複雑さと検証要件を追加します。問題は、すべての手作業を排除できるかどうかではありません。特に手書きの署名など、一部のフィールドでは、人間による確認が依然として適切なチェックポイントです。問題は、業務上の価値を追加しないまま、現在チームのリソースを消費している、書類1枚あたり10~15分の手動データ入力を排除できるかどうかです。
テンプレートベースの文字認識ではなく、セマンティックAI抽出を搭載した最新の物流向けOCRは、これを可能にします。物流の専門家と同じように配送書類を理解し、各フィールドの意味を特定し、業界標準に照らして検証し、ダウンストリームシステムが期待する形式で出力します。1つの設定で、あらゆる運送会社のフォーマット、あらゆる言語、あらゆる書類タイプに対応します。
実際のBOL、POD、または梱包明細書をアップロードして、あなたの書類の流れが構造化データとしてどのように見えるかを、数分ではなく数秒で確認してください。
ご自身の書類で試す →サインアップは不要です。ファイルは安全に処理されます。