OCR pour la logistique :
Automatisation des connaissements, preuves de livraison et documents d'expédition
Un transitaire de taille moyenne traite 60 à 100 connaissements, plus de 80 preuves de livraison et des dizaines de factures de fret et de bons de livraison chaque jour. Avec une saisie manuelle qui consomme 10 à 15 minutes par document et des boucles de correction d'erreurs qui croissent plus vite que le volume, la plupart des équipes logistiques passent leur temps à taper — pas à faire circuler le fret. L'OCR pour la logistique est l'approche systématique qui transforme ce flux de documents en données structurées alimentant un TMS, un ERP ou un tableur, sans maintenance de modèles par transporteur ni ressaisie manuelle.
Points clés à retenir
- Soixante à cent connaissements par jour, dix à quinze minutes chacun — un poste logistique consacre dix à quinze heures à la saisie de données avant qu'une seule expédition ne parte.
- L'OCR que vous déployez sur les factures échouera sur les documents logistiques, car la logistique utilise des systèmes de codes — SCAC, UN/LOCODE, ISO 6346 — et non le langage naturel ; un outil qui extrait le texte brut
MAEUn'a pas automatisé l'étape qui consiste à le faire correspondre à un nom de transporteur. - L'extraction sémantique lit les champs selon leur signification, et non selon leur emplacement sur la mise en page d'un transporteur spécifique — une seule configuration traite tous les formats de connaissement, et l'ajout d'un nouveau transporteur ne coûte aucune heure de maintenance de modèle.
Ce que « l'OCR pour la logistique » signifie réellement — et en quoi il diffère de l'OCR documentaire généraliste
L'OCR pour la logistique désigne l'extraction et la structuration automatisées des données issues des types de documents qui circulent dans les chaînes d'approvisionnement : connaissements, preuves de livraison, bons de livraison, déclarations en douane et factures de fret. L'objectif n'est pas seulement de numériser ces documents en texte consultable — il s'agit de produire des données structurées au niveau des champs (numéros de conteneur, codes SCAC, codes SH, conditions de fret, codes de port, quantités, frais) qui peuvent alimenter directement un TMS, un ERP, un WMS ou un tableur.
Cette distinction est importante car un outil OCR générique traite chaque document comme du « texte sur une page ». Il reconnaît les caractères, mais il ne sait pas que COSU8102804 est un numéro de conteneur (avec la clé de contrôle 4 régie par les règles ISO 6346) ni que NL RTM désigne le Port de Rotterdam exprimé en UN/LOCODE. Les documents logistiques contiennent des codes et des relations entre champs propres au secteur que les moteurs OCR génériques n'ont jamais appris lors de leur entraînement. Un outil optimisé pour l'extraction de factures manquera les codes SCAC et les préfixes de conteneurs, car ses données d'entraînement — des factures fournisseurs — ne les contenaient pas en premier lieu, comme l'a constaté notre comparatif d'outils d'extraction logistique lorsque des outils entraînés sur des factures sont passés sous la barre des 60 % sur des champs spécifiques à la logistique.
En pratique, cela signifie que l'OCR pour la logistique exige à la fois une compréhension sémantique (la capacité d'identifier un champ par ce qu'il signifie, et non par sa position sur la page) et une connaissance des codes spécifiques au domaine (la capacité de valider et de normaliser les résultats par rapport aux normes attendues par les systèmes logistiques). Pour approfondir la différence entre l'extraction sémantique et la reconnaissance de caractères traditionnelle, consultez notre guide sur ce qu'est l'OCR IA et comment il fonctionne.
Pourquoi la logistique a besoin de l'OCR : le cas chiffré
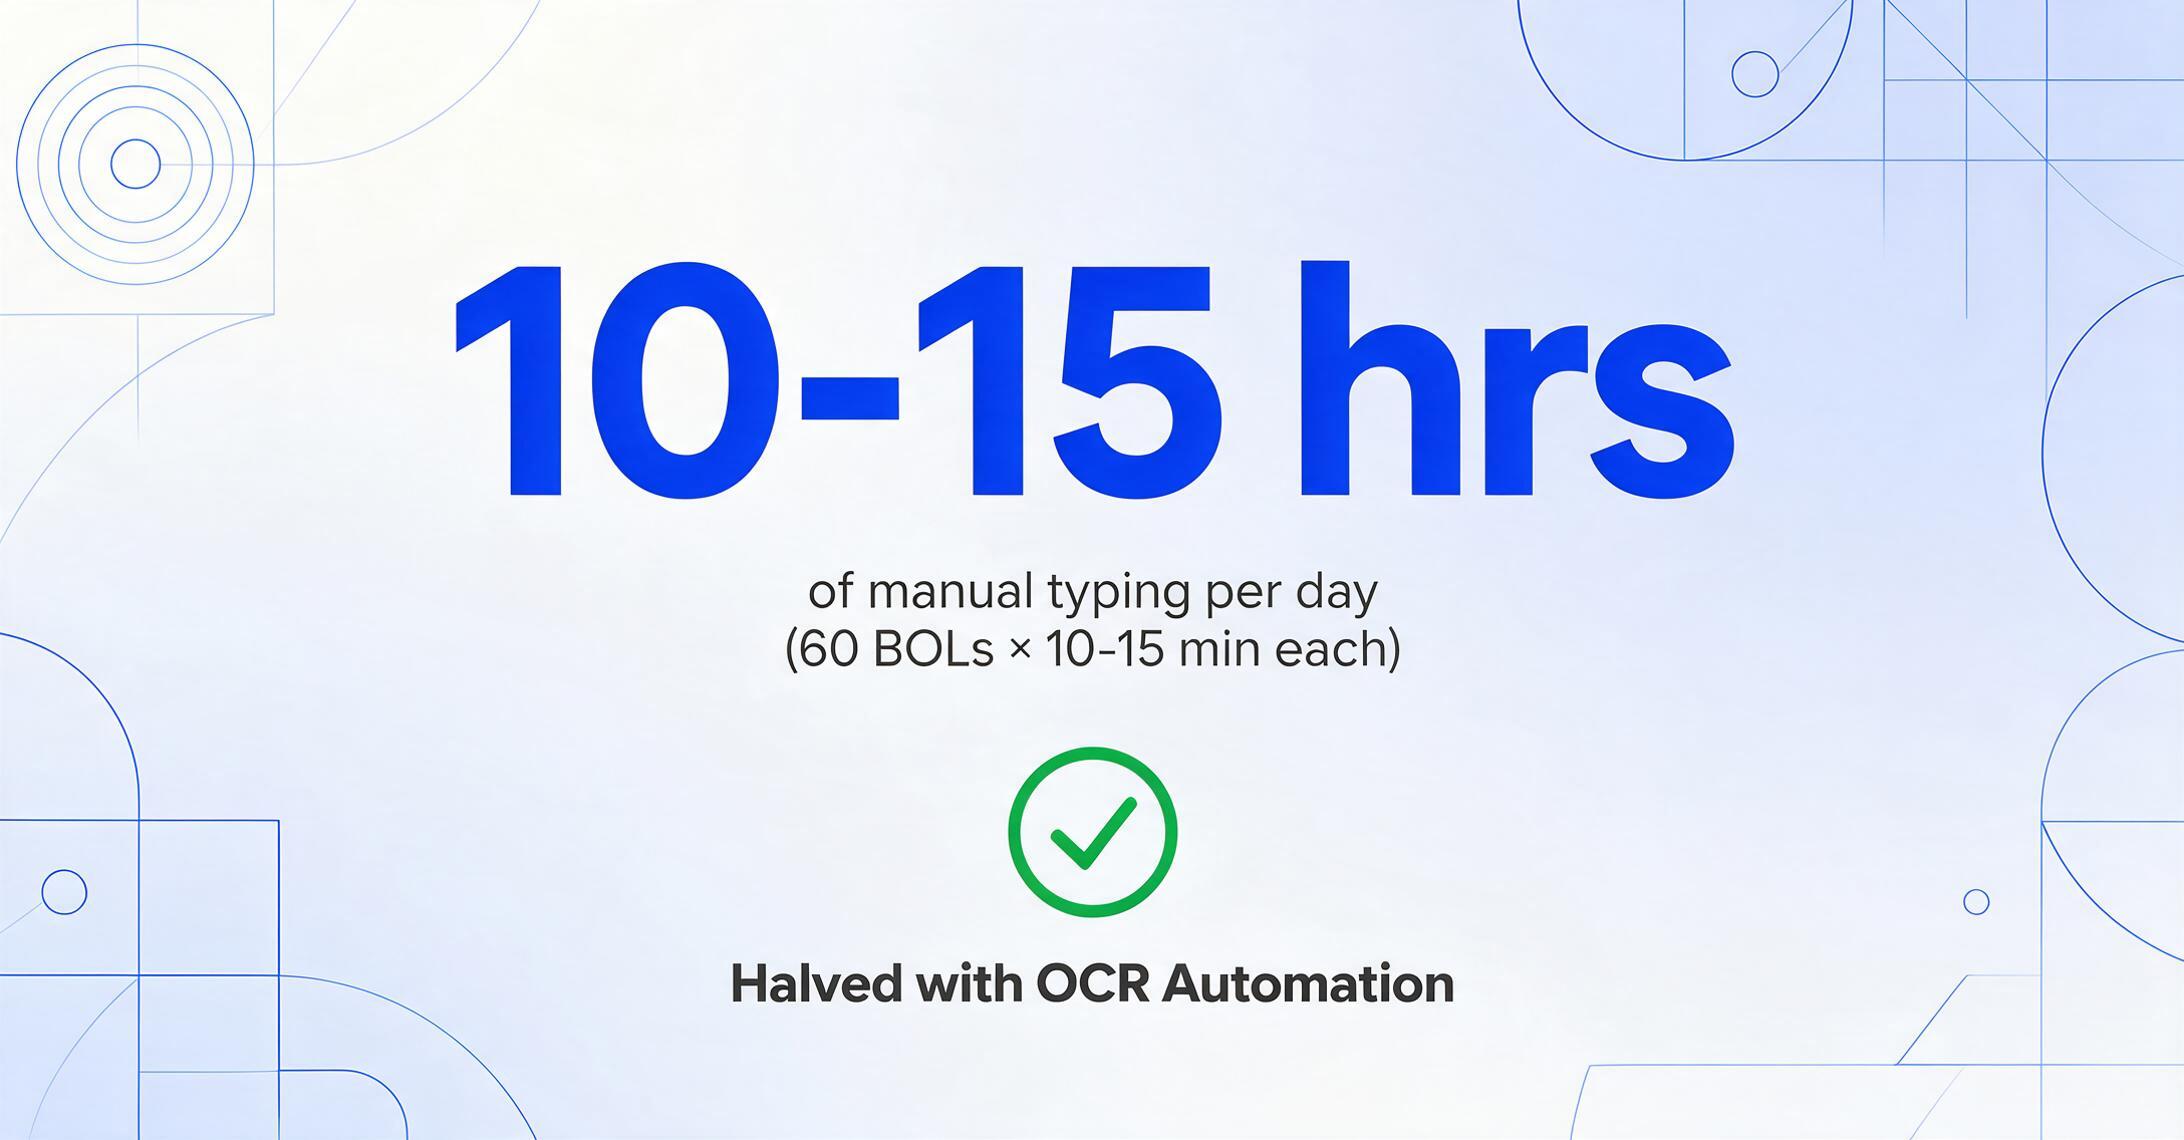
L'ampleur du traitement des documents logistiques est rarement visible pour les équipes hors opérations. Un bureau de transitaire traitant 50 à 80 expéditions par jour reçoit la documentation de chaque expédition sous forme de PDF ou d'image séparé — souvent d'un transporteur ou d'un transitaire différent avec un format unique. Avec une saisie manuelle des données qui consomme environ 10 à 15 minutes par document, un transitaire traitant 60 connaissements (B/L) par jour passe 10 à 15 heures par jour à taper avant même de prendre en compte la vérification des preuves de livraison (POD), le rapprochement des factures de fret et la préparation des déclarations en douane.
Ce coût en temps est aggravé par les taux d'erreur. Les études sur la saisie manuelle des données dans les flux de travail logistiques constatent systématiquement des taux d'erreur entre 2 % et 5 % sur les champs courants — et plus élevés sur les écritures manuscrites. Sur un connaissement (B/L) avec 15 à 20 champs extractibles, un taux d'erreur de 3 % signifie environ une erreur tous les deux documents. En logistique, un seul chiffre erroné dans un code SH peut déclencher une retenue en douane. Un numéro de conteneur mal saisi peut envoyer une expédition dans les limbes du suivi pendant des jours. Un chiffre de poids transposé peut générer un avoir de fret qui met des semaines à se résoudre.
Pour les équipes logistiques traitant de gros volumes, l'argument commercial en faveur de l'automatisation par OCR n'est pas théorique. L'automatisation de la saisie des données des connaissements (B/L) et des factures de fret a démontré qu'elle réduit le temps de traitement de plus de moitié tout en réduisant simultanément les taux d'erreur — libérant ainsi le personnel de saisie pour se concentrer sur la gestion des exceptions et le service client plutôt que sur la frappe répétitive.
Les cinq types de documents logistiques qui nécessitent l'OCR
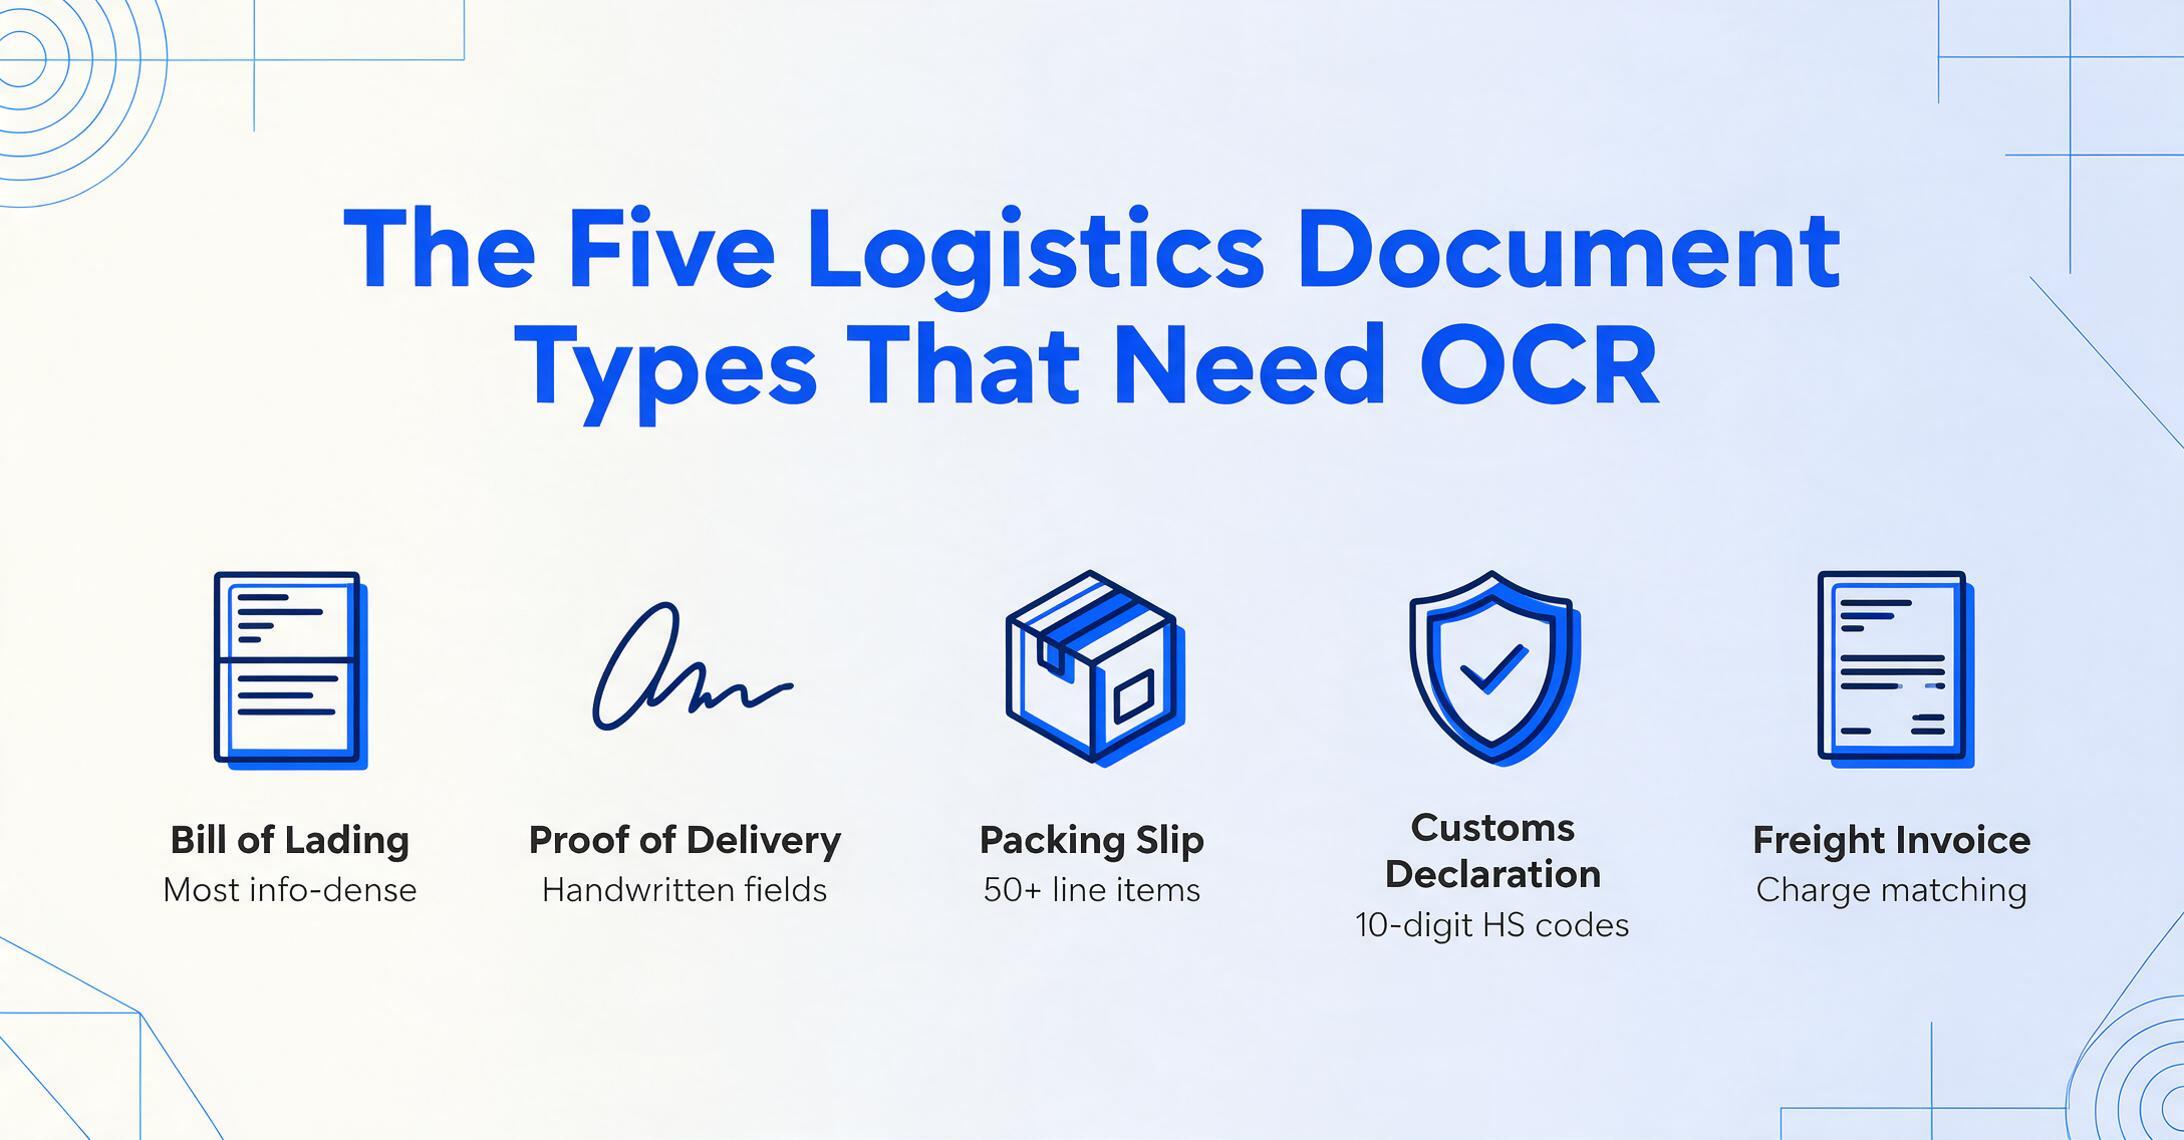
Les opérations logistiques ne traitent pas un seul type de document. Elles traitent un flux mixte d'au moins cinq types, chacun avec son propre ensemble de champs, sa fonction juridique et son défi d'extraction. Voici comment l'OCR s'applique à chacun.
1. Connaissement (B/L)
Le connaissement est le document le plus dense en informations de la logistique. Il sert de reçu, de contrat de transport et de titre de propriété — quiconque détient l'original peut réclamer la marchandise. Un seul connaissement maritime peut contenir le nom de l'expéditeur et son numéro EORI, le destinataire, le notifier, le nom du navire et le numéro de voyage, le port de chargement et le port de déchargement (chacun exprimé en UN/LOCODE), les numéros de conteneur (format ISO 6346 avec clés de contrôle), les numéros de scellé, les désignations de marchandise, les poids brut et net, les nombres de colis, les conditions de fret (payé ou dû), la règle Incoterm (FOB, CIF, FCA, etc.), et souvent plusieurs lignes avec des codes SH. La position des champs varie selon le transporteur — Maersk place le numéro de conteneur dans le quadrant supérieur droit ; MSC le met en milieu de page sous le nom du navire. Un connaissement de groupage peut référencer un numéro de connaissement maître qu'un connaissement nominatif ne porte pas. Pour une analyse complète de ce type de document, consultez notre guide dédié sur l'extraction de données de connaissement. Pour extraire les champs du B/L dans une feuille de calcul en quelques secondes — sans configuration par transporteur — utilisez l'outil de connaissement vers Excel.
2. Preuve de livraison (POD)
La POD est le document final du cycle d'expédition : elle confirme que la marchandise est arrivée, dans quel état, et qui l'a acceptée. Le défi de l'extraction est que les champs les plus importants d'une POD sont les moins lisibles par machine. Les signatures de livraison sont manuscrites — souvent un gribouillage rapide qu'un lecteur humain aurait même du mal à déchiffrer. Les horodatages de livraison peuvent être inscrits à la main par le conducteur. Les mentions de dommages (« 1 carton écrasé — refusé »), les annotations de quantité partielle (« Reçu 47 sur 50 ») et les tampons de retard sont généralement manuscrits dans les marges. Les meilleurs outils OCR pour écriture manuscrite en 2026 gèrent l'écriture en capitales propre avec une précision de 85 à 95 %, mais les signatures cursives et les notes marginales restent une couche de vérification humaine pour la plupart des flux de travail logistiques. L'extraction sémantique par IA atténue partiellement ce problème : un modèle qui comprend la structure du document peut au moins orienter le vérificateur vers le bon emplacement sur la page plutôt que de l'obliger à examiner chaque champ.
3. Bon de livraison
Les bons de livraison accompagnent chaque envoi et indiquent le contenu de chaque carton ou palette : désignations des articles, codes SKU, quantités, numéros de lot, et parfois codes SH et marquages d'origine. La valeur de l'extraction des bons de livraison réside dans l'efficacité de la réception : rapprocher automatiquement les quantités reçues avec le bon de commande, signaler les livraisons partielles avant l'arrivée de la facture fournisseur, et alimenter le WMS sans saisie manuelle au niveau des lignes. Les bons de livraison ont tendance à avoir une mise en page plus simple que les connaissements (B/L), mais une densité de lignes plus élevée — un seul bon peut lister plus de 50 SKU, et chaque ligne doit être capturée avec précision pour le rapprochement des stocks. L'OCR par gabarit échoue ici car chaque prestataire logistique et fournisseur formate le bon différemment. L'extraction sémantique, qui lit les champs par leur signification plutôt que par leur position, gère cette variabilité nativement.
4. Déclaration en douane
Les déclarations en douane — le document administratif unique (DAU) dans l'UE, le formulaire CBP 3461 aux États-Unis, la déclaration CDS au Royaume-Uni — sont le point où la précision de l'extraction rejoint directement la conformité légale. Chaque champ d'une déclaration en douane correspond à un élément de données réglementaire : le code SH détermine le taux de droits, le pays d'origine détermine l'éligibilité aux accords commerciaux, la valeur déclarée détermine l'assiette fiscale pour la TVA et les droits de douane. Un seul chiffre erroné dans un code SH peut entraîner un trop-payé de droits ou, dans le cas de marchandises contrôlées, une saisie de l'envoi et des pénalités. Les déclarations en douane intègrent également des données provenant d'autres documents de cette liste — le connaissement (B/L) fournit les détails de transport, la facture commerciale fournit la valeur, le bon de livraison fournit les quantités par ligne — ce qui fait de la cohérence inter-documents une exigence de validation clé. L'OCR pour les documents douaniers doit donc fonctionner avec des seuils de confiance plus élevés que l'extraction à usage général.
5. Facture de fret
La facture de fret est le document de réconciliation financière de la logistique. Elle détaille les frais d'une expédition : taux de fret de base, surcharge carburant (souvent 10 à 25 % du total), frais accessoires (hayon élévateur, livraison à l'intérieur, surcharge résidentielle), surestaries ou détention, et toute remise négociée. La charge de vérification manuelle de ces factures est considérable — une seule surfacturation peut représenter 50 à 200 $, et à grande échelle, la surfacturation systématique peut coûter des dizaines de milliers de dollars par an. L'extraction automatisée des factures de fret permet aux équipes des comptes fournisseurs de comparer les montants facturés aux tarifs contractuels, de signaler les écarts de surcharge et d'orienter les exceptions vers un examen sans saisir manuellement les lignes de frais dans un tableur. Le défi d'extraction propre aux factures de fret réside dans la variété des codes de frais et des abréviations (souvent spécifiques au transporteur) qui décrivent le même service différemment selon les transporteurs.
Ce qui rend les documents logistiques particulièrement difficiles pour l'OCR
Les documents logistiques ne sont pas simplement des « factures avec des champs différents ». Ils présentent un ensemble de défis structurels que l'OCR traditionnel — et même de nombreux outils d'extraction IA à usage général — n'a pas été conçu pour traiter.
Systèmes de codes propriétaires nécessitant une connaissance du domaine
La logistique fonctionne avec des codes, pas avec le langage naturel. Un connaissement (B/L) ne dit pas « le transporteur est Maersk Line » ; il indique MAEU — le code SCAC du transporteur. Les ports ne sont pas écrits comme « Rotterdam, Pays-Bas » ; ils apparaissent sous la forme NL RTM, le code UN/LOCODE à cinq caractères attribué par la CEE-ONU. Les numéros de conteneur suivent la norme ISO 6346 : quatre lettres de code propriétaire (par ex., MSCU), six chiffres de série et une clé de contrôle qui peut être validée mathématiquement. Les codes SH sont des classifications de marchandises à 6 à 10 chiffres établies par l'Organisation mondiale des douanes. Un système OCR qui ne reconnaît pas ces structures de codes produira un texte brut nécessitant un re-encodage manuel avant d'être utile. Un système qui les reconnaît peut valider les sorties — par exemple, en confirmant qu'un numéro de conteneur extrait passe le calcul de la clé de contrôle ISO 6346 — réduisant ainsi considérablement la charge de vérification en aval.
Signatures manuscrites sur les POD et annotations en marge
Les documents à plus forte valeur opérationnelle — les preuves de livraison — sont aussi ceux qui contiennent le moins de contenu lisible par machine. Les conducteurs signent d’un geste manuscrit. Les destinataires notent les exceptions de livraison dans les marges. Les horodatages sont inscrits à la main. Pour le transporteur, ces champs manuscrits constituent la preuve légale de livraison et de l’état de la marchandise. Pour le système OCR, ils représentent le scénario d’extraction le plus difficile : une écriture manuscrite variable sur un espace bidimensionnel, sans limites de champs fixes. L’OCR traditionnel tombe sous les 50 % de précision sur les annotations manuscrites désordonnées des POD. L’extraction IA moderne avec des modèles de vision-langage fait mieux, maintenant 75 à 90 % sur une écriture soignée en capitales et 60 à 75 % sur la cursive, mais ces chiffres ne correspondent pas à un traitement direct — la vérification humaine des champs manuscrits reste un point de contrôle nécessaire pour la plupart des flux logistiques.
Documents multilingues et multi-systèmes d’écriture
La logistique internationale implique des documents internationaux. Un envoi de Shanghai à Hambourg génère une documentation pouvant contenir des caractères chinois (货物描述), de l’allemand (Gefahrgutklasse) et de l’anglais — parfois sur la même page. Les déclarations douanières en Thaïlande utilisent l’alphabet thaï. Les ports japonais apparaissent en kanji. Les connaissements d’Amérique latine mélangent souvent l’espagnol et l’anglais. Les moteurs OCR traditionnels sont spécifiques à une langue : on les configure pour l’anglais ou l’allemand, et la précision de reconnaissance se dégrade en dehors de l’ensemble de langues configuré. Les modèles de vision IA entraînés sur des corpus documentaires multilingues gèrent cela plus facilement, car ils traitent des motifs visuels, et non des jeux de caractères, mais la précision varie encore considérablement selon l’écriture. Une solution OCR logistique destinée à des opérations mondiales doit être évaluée non pas sur sa précision en anglais uniquement, mais sur ses performances à travers le mélange de langues que l’opération rencontre réellement.
Formats transporteurs variables, sans normalisation
Il n’existe pas de modèle standardisé pour un connaissement. Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE et Evergreen — les sept plus grandes compagnies maritimes — utilisent chacune une mise en page différente. L’emplacement des champs varie entre les transporteurs, entre le connaissement maître et le connaissement de groupage, et parfois entre les versions électronique et papier du même transporteur. Les lettres de transport aérien de FedEx Express ne ressemblent en rien aux documents DHL Express — pour l’extraction de fret aérien spécifiquement, voir notre outil lettre de transport aérien (LTA) vers Excel. Les POD des transporteurs routiers vont de formulaires couleur multipages à des feuilles uniques imprimées thermiquement avec des ajouts manuscrits. L’OCR par gabarit exige une configuration distincte pour chaque variante — une charge de maintenance qui augmente à chaque nouvelle relation transporteur. L’extraction sémantique par IA, qui localise les champs par le sens plutôt que par les coordonnées, traite toutes les variantes via une configuration unique. C’est la différence fondamentale entre l’OCR traditionnel et l’extraction IA moderne pour la logistique.
Incoterms et variabilité des conditions commerciales
Les Incoterms 2020, publiés par la Chambre de commerce internationale, définissent 11 conditions commerciales — de EXW (Ex Works) à DDP (Delivered Duty Paid) — qui déterminent le transfert des risques, la répartition des coûts et les obligations d'assurance pour chaque expédition. Un connaissement unique peut indiquer l'Incoterm comme « CIF Shanghai », mais d'autres documents pour la même expédition peuvent faire référence à « CIF » différemment dans les conditions contractuelles. Extraire l'Incoterm est simple pour la plupart des outils OCR ; l'interpréter — comprendre que FOB s'applique uniquement au fret maritime tandis que FCA s'applique à tout mode — nécessite une logique métier que l'extraction générique ne fournit pas.
OCR traditionnel vs extraction IA moderne pour la logistique
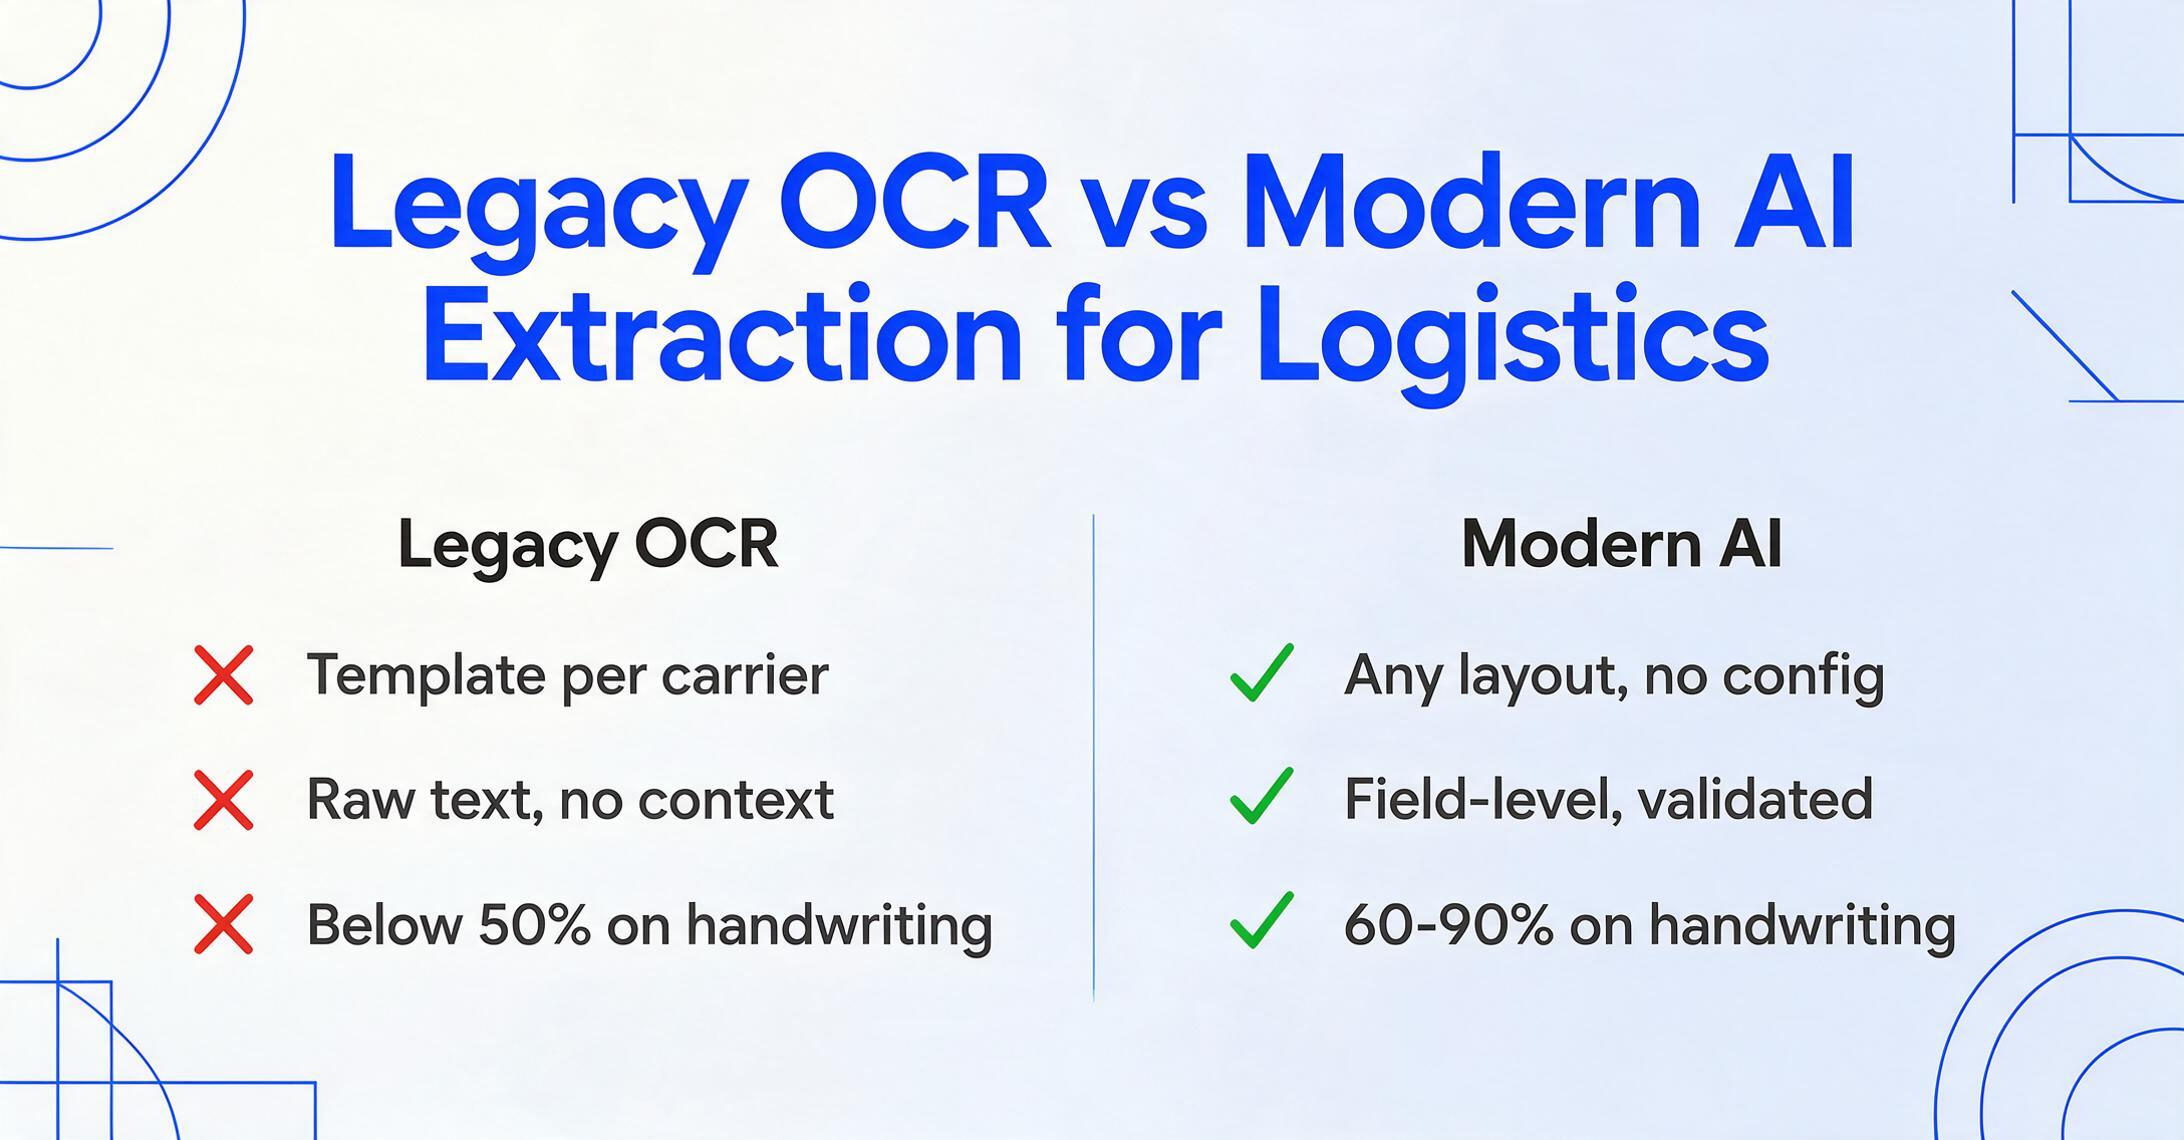
La différence entre l'OCR traditionnel et l'extraction IA moderne n'est pas une amélioration incrémentale — c'est une approche différente de la lecture des documents. Voici comment les deux se comparent sur les dimensions qui comptent pour la logistique.
| Dimension | OCR traditionnel | Extraction par modèle de vision-langage IA |
|---|---|---|
| Méthode de lecture | Caractère par caractère, ligne par ligne | Holistique — traite la page comme une image et comprend la mise en page |
| Gestion des formats de transporteur | Nécessite un modèle ou une configuration de zone par format | Lit toute mise en page ; aucune configuration par transporteur requise |
| Reconnaissance des codes | Produit du texte brut (ex. « MAEU ») sans contexte | Identifie le type de champ ; peut valider le format (ex. SCAC = 2 à 4 lettres) |
| Tolérance à l'écriture manuscrite | Moins de 50 % sur les annotations POD illisibles | 60 à 90 % selon la lisibilité ; nécessite toujours une vérification humaine |
| Multilingue | Spécifique à la langue ; se dégrade en dehors de l'ensemble configuré | Multilingue par défaut ; gère les documents à écritures mixtes |
| Sortie au niveau du champ | Produit un bloc de texte ; les champs doivent être identifiés manuellement | Mappe les valeurs extraites vers des champs définis par l'utilisateur ou identifiés par l'IA |
| Temps de configuration | Des heures ou des jours pour configurer les modèles par transporteur | Quelques minutes ; téléversez un document et définissez ce dont vous avez besoin |
Le tableau ci-dessus est sans équivoque : pour les opérations logistiques qui gèrent plusieurs transporteurs, plusieurs types de documents et un mélange de contenu imprimé et manuscrit, l'OCR traditionnel exige une maintenance par format qui érode le retour sur investissement de l'automatisation. Les modèles de vision-langage IA qui traitent les documents de manière sémantique gèrent la variabilité au moment de la lecture plutôt qu'au moment de la configuration. Pour une comparaison plus approfondie de ces deux approches technologiques, consultez notre article sur l'OCR IA par rapport à l'OCR traditionnel.
Champs clés dans l'extraction de documents logistiques
Voici une analyse détaillée de ce que chaque type de document logistique apporte au flux de données. Les champs que vous extrayez dépendent de votre flux de travail — une équipe opérationnelle a besoin des données de suivi des expéditions, tandis qu'une équipe AP a besoin des détails de facturation — mais comprendre la cartographie complète des champs guide l'évaluation des outils.
| Type de document | Champs clés extractibles | Défis uniques |
|---|---|---|
| Connaissement | Numéro BOL, expéditeur, destinataire, partie notifiée, nom du navire, numéro de voyage, port de chargement, port de déchargement, numéros de conteneur (ISO 6346), numéros de scellé, description de la cargaison, codes SH, poids brut/net, colis, conditions de fret, INCOTERM | Position des champs variable selon le transporteur ; variation BOL house vs master ; extraction du code SCAC ; descriptions de cargaison multi-lignes ; validation du chiffre de contrôle pour les conteneurs |
| Preuve de livraison | Date/heure de livraison, nom du destinataire, image de la signature, statut de livraison, annotations de dommages, quantité partielle, numéro de référence POD, nom du transporteur | Signatures manuscrites et notes en marge ; qualité de document variable (papier thermique qui s'efface) ; formats d'horodatage non standard |
| Bordereau de colisage | Numéro de bordereau, numéro de commande, expéditeur/destinataire, descriptions d'articles, codes SKU, quantités par SKU, unité de mesure, numéros de lot, nombre total de cartons, poids brut, codes SH (à l'export) | Haute densité de lignes (50+ lignes) ; ordre des colonnes incohérent selon les fournisseurs ; corrections de quantité imprimées vs manuscrites |
| Déclaration en douane | Numéro de déclaration, déclarant EORI, détails exportateur/importateur, code SH (10 chiffres pour UE/US), pays d'origine, valeur déclarée, devise, poids brut/net, mode de transport, numéros de conteneur, références de facture | Validation réglementaire requise (structure du code SH, code pays ISO 3166) ; déclarations multi-pages ; vérifications de cohérence inter-documents nécessaires ; coût élevé des erreurs |
| Facture de fret | Numéro de facture, nom du transporteur, code SCAC, numéro PRO, référence BOL, frais de fret de base, surcharge carburant, frais accessoires, montant total, conditions de paiement, classe NMFC (LTL) | Codes de frais spécifiques au transporteur pour le même service ; formules de surcharge carburant variables ; calculs de surestarie différents selon le contrat ; risque de contre-passation sur des montants incorrects |
Le test pratique pour tout outil d'extraction : peut-il traiter un BOL de Maersk et un BOL de MSC avec la même configuration et extraire les deux numéros de conteneur avec une précision au niveau du champ ? Si non, l'outil nécessite une maintenance par transporteur, et le coût unitaire d'extraction ne diminuera pas à mesure que vous ajoutez des transporteurs.
Conformité et considérations réglementaires
L'extraction de documents logistiques n'est pas qu'une question d'efficacité — elle recoupe des obligations réglementaires à plusieurs niveaux. Comprendre ces implications de conformité est important lors de l'évaluation d'un outil, car tous les flux d'extraction n'exigent pas le même niveau de rigueur de validation.
UCP 600 et lettres de crédit. L'article 20 des Règles et usances uniformes relatives aux crédits documentaires (UCP 600) régit les connaissements présentés dans le cadre de lettres de crédit. Un écart entre les données du connaissement et les conditions du crédit — la désignation de la marchandise, le port de chargement ou de déchargement, la date de la mention « embarqué à bord », ou le nom du destinataire — peut entraîner un rejet par la banque, retardant le paiement de plusieurs semaines. Pour les exportateurs utilisant la lettre de crédit (L/C) comme mécanisme de paiement, l'outil OCR doit prendre en charge la validation au niveau des champs par rapport à des règles prédéfinies, et pas seulement l'extraction de texte en masse. Les outils d'IA capables de valider les données du connaissement par rapport aux conditions de la L/C peuvent identifier les écarts potentiels avant que les documents ne soient présentés à la banque.
Service des douanes et de la protection des frontières des États-Unis (CBP). Pour les envois à destination des États-Unis, l'environnement commercial automatisé (ACE) du CBP exige des éléments de données spécifiques : le numéro de l'importateur de référence, le code SH au niveau à 10 chiffres du HTSUS, le pays d'origine (ISO 3166 alpha-2), la valeur déclarée en USD et le numéro du connaissement. Chaque champ a un format défini et une plage de valeurs acceptables. Une solution OCR qui extrait ces champs sans valider la conformité du format transfère la charge de validation au transitaire en douane.
Normes ISO. Les systèmes de codes du secteur de la logistique sont régis par des normes internationales avec des règles de validation définies. Les numéros de conteneur peuvent être vérifiés à l'aide de l'algorithme de clé de contrôle ISO 6346. Les UN/LOCODE peuvent être vérifiés par rapport au fichier maître de la CEE-ONU. Les codes SCAC peuvent être confirmés auprès du registre NMFTA. Un outil d'extraction qui effectue ces validations au moment de l'extraction — signalant un numéro de conteneur avec une clé de contrôle invalide avant qu'il n'entre dans le TMS — élimine une boucle de correction d'erreurs en aval importante.
Contrôles à l'exportation. Pour les envois de marchandises contrôlées (ITAR, EAR), la désignation de la marchandise et la classification du code SH déterminent si une licence d'exportation est requise. Les systèmes OCR qui extraient ces champs peuvent déclencher des contrôles de conformité automatisés, réduisant le risque d'expédier des marchandises contrôlées sans l'autorisation requise.
Pour une perspective plus large sur la manière dont l'extraction de documents s'intègre dans le volet financier des opérations logistiques, consultez notre guide sur la saisie de données IA pour les équipes comptables — les principes de validation automatisée des données s'appliquent également au traitement des factures de fret et à l'évaluation en douane.
Comment choisir le bon outil OCR logistique
Chaque opération logistique est unique en termes de mix de transporteurs, de volume de documents et de paysage de systèmes en aval. Le cadre suivant aide à évaluer les outils selon les dimensions qui affectent réellement les flux de travail logistiques — et non des listes de fonctionnalités génériques.
Des outils comme ImageToTable.ai qui utilisent l'Extraction de colonnes personnalisées — vous définissez les champs par nom, et l'IA les localise sémantiquement n'importe où sur la page — sont particulièrement adaptés à la logistique car ils gèrent plusieurs formats de transporteurs via une configuration unique. Vous définissez des colonnes comme « Numéro de conteneur », « Code SCAC », « Port de chargement » et « Conditions de fret », et la même configuration fonctionne sur un BOL Maersk, un BOL MSC et un POD de transporteur routier sans ajustement. Pour les équipes traitant de grands volumes de documents de fret mixtes, cette indépendance du format est le principal moteur du ROI de l'automatisation. Si votre évaluation couvre l'ensemble du mix documentaire — BOL, factures de fret, déclarations douanières et listes de colisage ensemble, pas seulement l'OCR sur un seul type de document — notre guide d'achat d'extraction de documents logistiques couvre en profondeur les critères d'évaluation inter-documents.
L'option d'extension Google Sheets est également pertinente pour les petites équipes logistiques ou les transitaires qui gèrent les données d'expédition dans des feuilles de calcul plutôt que dans un TMS dédié. En extrayant les données des documents d'expédition directement dans Google Sheets — numéros de conteneur aux côtés des numéros de bon de commande et des frais de fret — l'extension remplace la saisie manuelle dans les feuilles de calcul sans nécessiter de migration de système. Si votre activité réconcilie actuellement les données d'expédition dans une feuille de calcul, cette approche offre les avantages de l'automatisation au sein de l'outil que votre équipe utilise déjà.
Questions fréquemment posées
L'OCR peut-il lire les signatures manuscrites sur les preuves de livraison (POD) ?
Partiellement. L'OCR moderne basé sur l'IA avec des modèles de vision-langage peut lire une écriture soignée et imprimée avec une précision de 75 à 90 %, mais les signatures cursives et l'écriture rapide restent difficiles — la précision chute à 60-75 % sur les entrées brouillonnes. Pour les POD où la signature manuscrite ou la notation de dommage constitue la preuve légale, la plupart des flux de travail logistiques traitent l'extraction OCR de ces champs comme une étape de « vérification avant utilisation » plutôt que d'automatisation directe. La valeur pratique de l'OCR sur les POD ne consiste pas à éliminer entièrement la vérification humaine — elle consiste à réduire le temps nécessaire pour localiser et vérifier les champs manuscrits de quelques minutes à quelques secondes.
L'OCR fonctionne-t-il avec des documents d'expédition internationaux dans plusieurs langues ?
Oui, les outils OCR basés sur l'IA traitent les documents multilingues nettement mieux que les moteurs OCR traditionnels. Les modèles de vision-langage entraînés sur des corpus de documents multilingues traitent toutes les écritures au sein d'un même modèle — ils ne nécessitent pas de configuration par langue. Cependant, la précision varie selon l'écriture. Les langues à écriture latine (anglais, français, espagnol, allemand) donnent les meilleurs résultats. Les caractères chinois, japonais et coréens présentent davantage de difficultés de reconnaissance en raison de la densité des caractères et de la complexité des traits, mais restent bien dans les capacités des modèles d'IA de dernière génération. Testez toujours l'outil sur votre combinaison réelle de documents plutôt que de vous fier aux références uniquement en anglais.
Comment fonctionne la validation du numéro de conteneur dans l'extraction OCR ?
Les numéros de conteneur suivent le format ISO 6346 : quatre lettres de code propriétaire, six chiffres de série et une clé de contrôle. Les outils OCR avancés peuvent valider le numéro de conteneur extrait par rapport à l'algorithme de clé de contrôle ISO — le système confirme mathématiquement que le préfixe de neuf caractères produit le dixième caractère de clé de contrôle. Cette validation détecte l'une des erreurs de saisie manuelle les plus courantes en logistique : un seul chiffre transposé dans un numéro de conteneur qui prendrait normalement des jours à identifier. Si le numéro extrait échoue à la validation, l'outil le signale pour vérification plutôt que de transmettre l'erreur en aval.
Quelle est la différence entre l'extraction BOL basée sur des modèles et l'extraction sémantique ?
L'extraction basée sur des modèles nécessite de définir les coordonnées et les étiquettes de champ pour le format BOL de chaque transporteur. Lorsqu'un transporteur met à jour sa mise en page — ou lorsque vous ajoutez un nouveau transporteur — le modèle se brise ou doit être configuré à partir de zéro. L'extraction sémantique lit le document en comprenant ce que chaque champ signifie, et non où il se trouve. Vous définissez les champs souhaités (numéro BOL, numéro de conteneur, port de chargement), et l'IA les trouve n'importe où sur la page. Cela signifie qu'une seule configuration fonctionne pour tous les formats de transporteur, et aucune maintenance n'est nécessaire lorsqu'un transporteur modifie sa mise en page. Pour les opérations logistiques qui traitent avec plusieurs transporteurs, l'extraction sémantique est la différence pratique entre une automatisation qui évolue et une automatisation qui crée une nouvelle charge de maintenance.
Quelle est la précision de l'extraction par IA sur les documents logistiques par rapport à la saisie manuelle ?
Sur les BOL imprimés propres des grands transporteurs, l'IA moderne atteint une précision de 90 à 99 % au niveau des champs standard (expéditeur, destinataire, navire, ports). Pour les codes spécifiques à la logistique comme SCAC et UN/LOCODE, la précision sur le contenu imprimé reste généralement supérieure à 85 %. Le contenu manuscrit descend à 60-90 % selon la lisibilité. Ces chiffres se comparent favorablement à la saisie manuelle, qui atteint généralement 95-98 % de précision sur les champs courants, mais à une vitesse bien inférieure — 10 à 15 minutes par document contre 5 à 10 secondes par document avec l'IA. La mesure clé est le débit : l'extraction par IA traite 60 à 100 documents pendant qu'un opérateur manuel en traite un, ce qui la rend adaptée aux opérations logistiques à volume élevé, même si une étape de vérification humaine reste nécessaire pour les champs manuscrits.
Puis-je exporter les données extraites des documents d'expédition directement dans mon TMS ou ERP ?
La plupart des outils d'extraction par IA proposent l'export CSV ou Excel comme base. Beaucoup offrent également un accès API pour le transfert automatisé de données vers les systèmes TMS et ERP. Certains outils proposent des intégrations directes avec des plateformes comme CargoWise, SAP, Oracle, QuickBooks et Xero, ou peuvent acheminer les données via Zapier, Make ou Power Automate. Le format de sortie et la méthode d'intégration sont des critères de sélection essentiels : si les données de l'outil d'extraction nécessitent un reformatage manuel avant d'entrer dans vos systèmes opérationnels, l'avantage de l'automatisation est considérablement réduit. Pour les workflows basés sur des feuilles de calcul, les outils dotés d'un module complémentaire Google Sheets permettent d'insérer directement les données extraites dans les feuilles sans exportation de fichiers intermédiaire.
Quels INCOTERMS dois-je m'attendre à voir apparaître sur les documents logistiques ?
Les 11 règles INCOTERMS 2020 sont divisées en deux catégories. Pour tout mode de transport : EXW (Départ Usine), FCA (Franco Transporteur), CPT (Port Payé Jusqu'à), CIP (Port Payé et Assurance Jusqu'à), DAP (Rendu au Lieu de Destination), DPU (Rendu au Lieu de Destination Déchargé) et DDP (Rendu Droits Acquittés). Pour transport maritime et fluvial uniquement : FAS (Franco le Long du Navire), FOB (Franco à Bord), CFR (Coût et Fret) et CIF (Coût, Assurance et Fret). Pour les expéditions conteneurisées, FCA ou CIP sont généralement plus appropriés que FOB ou CIF, bien que FOB reste couramment — et souvent incorrectement — utilisé. Un outil d'extraction compétent doit reconnaître les 11 termes et leurs abréviations.
Mettez l'extraction de documents d'expédition au travail
Les opérations logistiques n'ont pas le luxe de standardiser leur réception de documents. Les BOL arrivent de 20 transporteurs différents dans 20 formats différents. Les POD reviennent des conducteurs avec des signatures manuscrites et des annotations en marge. Les bordereaux d'emballage, les factures de fret et les déclarations douanières ajoutent chacun leur propre complexité de champs et exigences de validation. La question n'est pas de savoir si vous pouvez éliminer tout traitement manuel — pour certains champs, notamment les signatures manuscrites, la vérification humaine reste le bon point de contrôle. La question est de savoir si vous pouvez éliminer les 10 à 15 minutes par document de saisie manuelle qui consomment actuellement la bande passante de votre équipe sans ajouter de valeur opérationnelle.
L'OCR moderne pour la logistique — alimentée par l'extraction sémantique par IA plutôt que par la reconnaissance de caractères basée sur des modèles — rend cela possible en comprenant les documents d'expédition comme le ferait un professionnel de la logistique : en identifiant la signification de chaque champ, en le validant par rapport aux normes du secteur et en le produisant dans le format attendu par vos systèmes en aval. Une seule configuration fonctionne pour tous les formats de transporteurs, toutes les langues, tous les types de documents.
Téléversez un connaissement, une preuve de livraison ou un bon de livraison réel et voyez à quoi ressemble votre flux de documents une fois converti en données structurées — en quelques secondes, pas en quelques minutes.
Essayez avec votre propre document →Aucune inscription requise. Les fichiers sont traités en toute sécurité.