OCR para Logística:
Automatizando BOL, POD e Documentos de Embarque
Um transitário de médio porte processa 60 a 100 conhecimentos de embarque, mais de 80 comprovantes de entrega e dezenas de faturas de frete e romaneios de embarque todos os dias. Com a digitação manual consumindo 10 a 15 minutos por documento e ciclos de correção de erros que crescem mais rápido que o volume, a maioria das equipes de logística passa o tempo digitando — não movimentando carga. O OCR para logística é a abordagem sistemática para transformar esse fluxo de documentos em dados estruturados que alimentam um TMS, ERP ou planilha, sem manutenção de modelos por transportadora nem redigitação manual.
Principais Conclusões
- Sessenta a cem conhecimentos de embarque por dia, dez a quinze minutos cada — uma mesa de logística gasta de dez a quinze horas em digitação antes que uma única remessa se mova.
- O OCR que você implanta em faturas falhará em documentos de logística porque a logística usa sistemas de códigos — SCAC, UN/LOCODE, ISO 6346 — não linguagem natural, e uma ferramenta que extrai o texto bruto
MAEUnão automatizou a etapa de mapeá-lo para um nome de transportadora. - A extração semântica lê campos pelo que eles significam, não por onde ficam no layout de uma transportadora específica — uma configuração processa todos os formatos de BOL, e adicionar uma nova transportadora custa zero horas de manutenção de modelos.
O que "OCR para Logística" Realmente Significa — e Como Difere do OCR de Documentos Geral
OCR para logística é a extração e estruturação automatizada de dados dos tipos de documentos que circulam pelas cadeias de suprimentos: conhecimentos de embarque, comprovantes de entrega, romaneios de embarque, declarações aduaneiras e faturas de frete. O objetivo não é apenas digitalizar esses documentos em texto pesquisável — é produzir dados estruturados em nível de campo (números de contêiner, códigos SCAC, códigos SH, condições de frete, códigos de porto, quantidades, taxas) que possam fluir diretamente para um TMS, ERP, WMS ou planilha.
Essa distinção importa porque uma ferramenta de OCR de uso geral trata cada documento como "texto em uma página". Ela reconhece caracteres, mas não sabe que COSU8102804 é um número de contêiner (com o dígito verificador 4 regido pelas regras da ISO 6346) ou que NL RTM é o Porto de Roterdã expresso como UN/LOCODE. Documentos logísticos carregam códigos e relações de campo específicos do setor que os mecanismos de OCR genéricos nunca aprenderam durante o treinamento. Uma ferramenta otimizada para extração de faturas vai ignorar códigos SCAC e prefixos de contêiner porque seus dados de treinamento — faturas de contas a pagar — nunca os continham, como descobriu nossa comparação de ferramentas de extração para logística quando ferramentas treinadas em contas a pagar ficaram abaixo de 60% em campos específicos de logística.
Na prática, isso significa que o OCR para logística exige tanto compreensão semântica (a capacidade de identificar um campo pelo que ele significa, não por onde está na página) quanto conhecimento de códigos específicos do domínio (a capacidade de validar e normalizar as saídas de acordo com os padrões que os sistemas logísticos esperam). Para um olhar mais aprofundado sobre como a extração semântica difere do reconhecimento tradicional de caracteres, consulte nosso guia sobre o que é OCR de IA e como funciona.
Por que a logística precisa de OCR: o caso quantificado
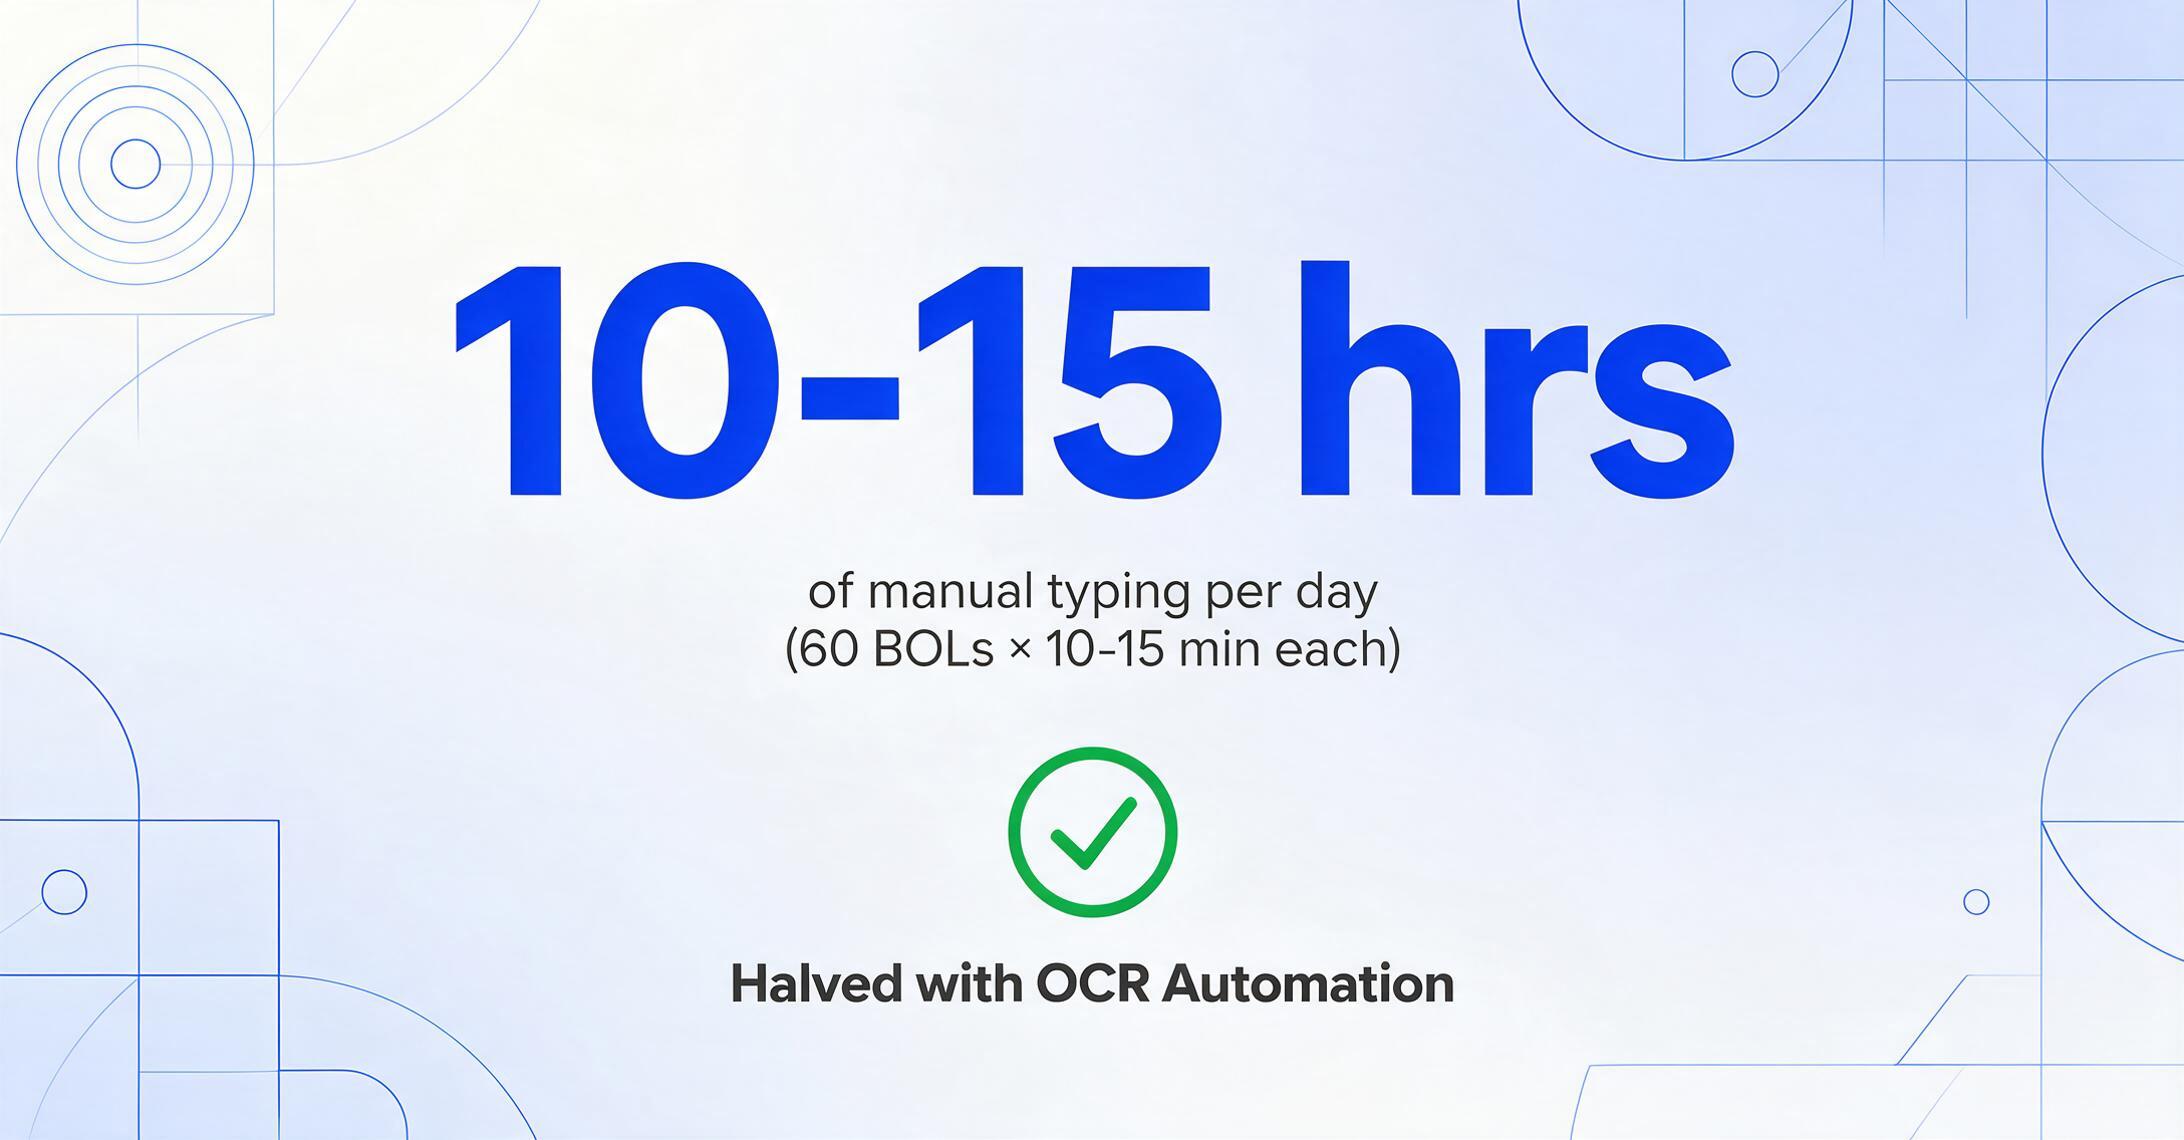
A escala do processamento de documentos logísticos raramente é visível para equipes fora da operação. Uma mesa de agente de carga que processa 50-80 embarques por dia recebe a documentação de cada embarque como um PDF ou imagem separado — muitas vezes de um transportador ou transitário diferente com um formato único. Com a entrada manual de dados consumindo cerca de 10-15 minutos por documento, um transitário que processa 60 conhecimentos de embarque (B/L) por dia gasta de 10 a 15 horas diárias apenas digitando, antes de contabilizar a verificação de comprovantes de entrega (POD), a conciliação de faturas de frete e a preparação de declarações aduaneiras.
Esse custo de tempo é agravado pelas taxas de erro. Estudos sobre entrada manual de dados em fluxos logísticos consistentemente encontram taxas de erro entre 2% e 5% em campos rotineiros — e maiores em entradas manuscritas. Em um conhecimento de embarque com 15-20 campos extraíveis, uma taxa de erro de 3% significa aproximadamente um erro a cada dois documentos. Na logística, um único dígito errado no Código SH pode acionar uma retenção aduaneira. Um número de contêiner digitado incorretamente pode enviar um embarque para o limbo de rastreamento por dias. Um valor de peso transposto pode gerar uma cobrança de frete que leva semanas para ser resolvida.
Para equipes de logística que processam grandes volumes, o argumento de negócio para a automação de OCR não é teórico. A automação da entrada de dados de conhecimentos de embarque e faturas de frete tem demonstrado reduzir o tempo de processamento em mais da metade, ao mesmo tempo que reduz as taxas de erro — liberando a equipe de entrada de dados para se concentrar no tratamento de exceções e no atendimento ao cliente, em vez de digitação repetitiva.
Os cinco tipos de documentos logísticos que precisam de OCR
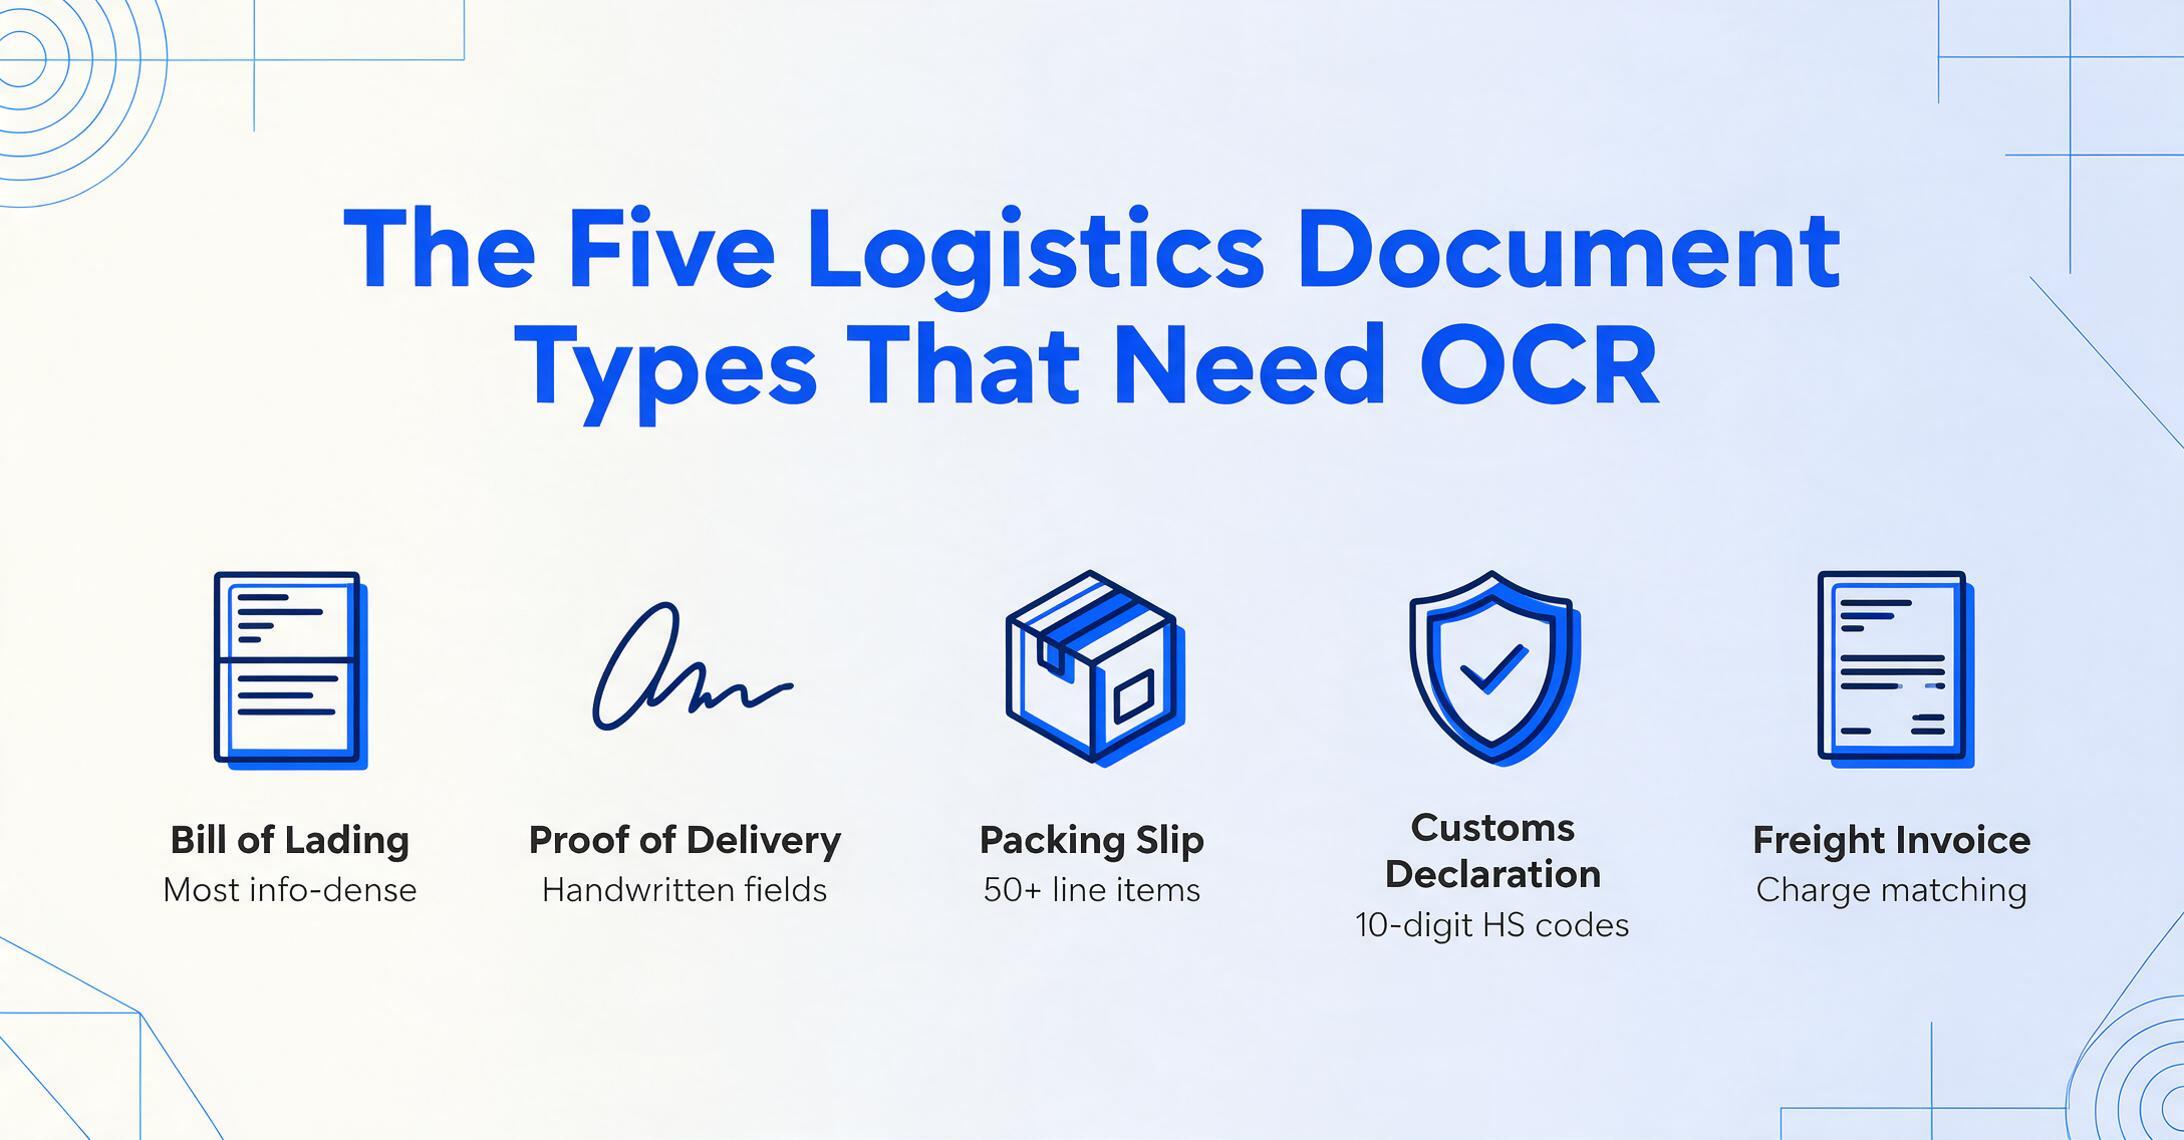
As operações logísticas não processam um único tipo de documento. Elas processam um fluxo misto de pelo menos cinco, cada um com seu próprio conjunto de campos, função legal e desafio de extração. Veja como o OCR se aplica a cada um.
1. Conhecimento de Embarque (B/L)
O conhecimento de embarque é o documento mais denso em informações da logística. Ele funciona como recibo, contrato de transporte e título de propriedade — quem detém o original pode reivindicar a carga. Um único B/L marítimo pode conter o nome do embarcador e o número EORI, o consignatário, o notificar, o nome do navio e o número da viagem, o porto de embarque e o porto de descarga (cada um expresso como UN/LOCODE), números de contêiner (formato ISO 6346 com dígitos verificadores), números de lacre, descrições da carga, pesos bruto e líquido, contagem de volumes, condições de frete (pré-pago ou a pagar no destino), a regra INCOTERM (FOB, CIF, FCA, etc.) e, muitas vezes, vários itens de linha com códigos SH. Os campos mudam de posição conforme o transportador — a Maersk coloca o número do contêiner no quadrante superior direito; a MSC o posiciona no meio da página, abaixo do nome do navio. Um Conhecimento de Embarque Filhote pode referenciar um número de Conhecimento de Embarque Master que um Conhecimento de Embarque Nominativo não carrega. Para uma análise completa desse tipo de documento, consulte nosso guia dedicado sobre extração de dados de conhecimento de embarque. Para extrair campos de B/L em uma planilha em segundos — sem configuração por transportador — use a ferramenta de conhecimento de embarque para Excel.
2. Comprovante de Entrega (POD)
O POD é o documento final do ciclo de transporte: confirma que as mercadorias chegaram, em que condição e quem as aceitou. O desafio da extração é que os campos mais importantes de um POD são os menos legíveis por máquina. As assinaturas de entrega são manuscritas — muitas vezes um rabisco rápido que até um leitor humano teria dificuldade em interpretar. Os carimbos de data e hora de entrega podem ser preenchidos à mão pelo motorista. Anotações de avaria ("1 caixa amassada — recusada"), anotações de quantidade parcial ("Recebidas 47 de 50") e carimbos de chegada tardia geralmente são manuscritos nas margens. As melhores ferramentas de OCR para caligrafia em 2026 lidam com impressão em bloco legível com 85-95% de precisão, mas assinaturas em cursivo e anotações à margem continuam sendo uma camada de verificação humana para a maioria dos fluxos de trabalho logísticos. A extração semântica com IA mitiga isso parcialmente: um modelo que entende a estrutura do documento pode pelo menos direcionar o verificador ao local correto na página, em vez de fazê-lo examinar cada campo.
3. Romaneio de Embarque
Os romaneios de embarque acompanham cada remessa e listam o que há dentro de cada caixa ou palete: descrições dos itens, códigos SKU, quantidades, números de lote ou partida e, às vezes, códigos SH e marcações de país de origem. O valor de extração dos romaneios de embarque está na eficiência do recebimento: conciliar automaticamente as quantidades recebidas com o pedido de compra, sinalizar remessas incompletas antes da chegada da fatura do fornecedor e alimentar o WMS sem digitação manual no nível do item. Os romaneios de embarque tendem a ter um layout mais simples que os B/Ls, mas apresentam maior densidade de itens de linha — um único romaneio pode listar mais de 50 SKUs, e cada linha deve ser capturada com precisão para a reconciliação de estoque. O OCR baseado em modelo tem dificuldades aqui porque cada 3PL e fornecedor formata o romaneio de maneira diferente. A extração semântica, que lê os campos pelo significado e não pela posição de coordenadas, lida com essa variabilidade de forma nativa.
4. Declarações Aduaneiras
As declarações aduaneiras — o Documento Administrativo Único (DAU) na UE, o CBP 3461 nos EUA, a declaração CDS no Reino Unido — são onde a precisão da extração se cruza diretamente com a conformidade legal. Cada campo de uma declaração aduaneira corresponde a um elemento de dados regulatório: o código SH determina a alíquota do imposto, o país de origem determina a elegibilidade a acordos comerciais, o valor declarado determina a base tributável para o IVA e os direitos aduaneiros. Um único dígito incorreto em um código SH pode resultar em pagamento a maior de imposto ou, no caso de mercadorias controladas, em apreensão da remessa e multa. As declarações aduaneiras também incorporam dados de outros documentos desta lista — o B/L fornece os detalhes de transporte, a fatura comercial fornece o valor, o romaneio de embarque fornece as quantidades dos itens de linha — tornando a consistência entre documentos um requisito de validação fundamental. O OCR para documentos aduaneiros deve, portanto, operar com limites de confiança mais altos do que a extração de uso geral.
5. Fatura de Frete
A fatura de frete é o documento de reconciliação financeira da logística. Ela detalha os custos de um embarque: tarifa base de frete, sobretaxa de combustível (geralmente 10-25% do total), taxas acessórias (plataforma elevatória, entrega interna, sobretaxa residencial), taxas de detenção ou demurrage e quaisquer descontos negociados. A carga de auditoria manual dessas faturas é significativa — uma única cobrança indevida pode ser de $50-$200 e, em escala, a cobrança excessiva sistemática pode custar dezenas de milhares anualmente. A extração automatizada de faturas de frete permite que as equipes de contas a pagar conciliem os valores cobrados com as tarifas contratadas, sinalizem discrepâncias de sobretaxas e encaminhem exceções para revisão sem digitar manualmente os itens de cobrança em uma planilha. O desafio de extração específico das faturas de frete é a variedade de códigos de cobrança e abreviações (muitas vezes específicos de cada transportador) que descrevem o mesmo serviço de forma diferente entre transportadores.
O Que Torna os Documentos de Logística Únicos e Difíceis para o OCR
Documentos de logística não são simplesmente "faturas com campos diferentes". Eles apresentam um conjunto de desafios estruturais que o OCR tradicional — e até muitas ferramentas de extração de IA de uso geral — não foram projetadas para lidar.
Sistemas de Códigos Proprietários Que Exigem Conhecimento de Domínio
A logística opera com códigos, não com linguagem natural. Um B/L não diz "o transportador é Maersk Line"; ele diz MAEU — o Código SCAC do transportador. Os portos não são escritos como "Rotterdam, Netherlands"; eles aparecem como NL RTM, o UN/LOCODE de cinco caracteres atribuído pela UNECE. Os números de contêiner seguem a ISO 6346: quatro letras de código do proprietário (por exemplo, MSCU), seis dígitos de série e um dígito verificador que pode ser validado matematicamente. Os Códigos SH são classificações de mercadorias de 6 a 10 dígitos mantidas pela Organização Mundial das Alfândegas. Um sistema de OCR que não reconhece essas estruturas de código produzirá texto bruto que exige recodificação manual antes de ser útil. Um sistema que as reconhece pode validar as saídas — por exemplo, confirmando que um número de contêiner extraído passa no cálculo do dígito verificador da ISO 6346 — reduzindo significativamente a carga de verificação posterior.
Assinaturas Manuscritas em POD e Anotações nas Margens
Os documentos com maior valor operacional — os comprovantes de entrega — são também os que têm o conteúdo menos legível por máquina. Os motoristas assinam com rabiscos à mão. Os destinatários anotam exceções de entrega nas margens. Os carimbos de data e hora são escritos à mão. Para o transportador, esses campos manuscritos são o registro legal da entrega e da condição. Para o sistema de OCR, representam o cenário de extração mais difícil: caligrafia variável em espaço bidimensional, sem limites fixos de campo. O OCR tradicional cai para menos de 50% de precisão em anotações de POD bagunçadas. A extração moderna com IA e modelos de visão-linguagem se sai melhor, mantendo 75-90% em impressão manual caprichada e 60-75% em letra cursiva, mas esses não são números de processamento direto — a verificação humana em campos manuscritos continua sendo um ponto de controle necessário para a maioria dos fluxos de trabalho logísticos.
Documentos em Vários Idiomas e Conjuntos de Caracteres
Logística internacional significa documentos internacionais. Um embarque de Xangai para Hamburgo gera documentação que pode incluir caracteres chineses (货物描述), alemão (Gefahrgutklasse) e inglês — às vezes na mesma página. Declarações aduaneiras na Tailândia usam escrita tailandesa. Portos japoneses aparecem em kanji. Conhecimentos de Embarque latino-americanos frequentemente misturam espanhol e inglês. Os motores de OCR tradicionais são específicos por idioma: você os configura para inglês ou alemão, e a precisão do reconhecimento se degrada fora do conjunto de idiomas configurado. Os modelos de visão de IA treinados em corpora de documentos multilíngues lidam com isso com mais elegância porque processam padrões visuais, não conjuntos de caracteres, mas a precisão ainda varia significativamente conforme a escrita. Uma solução de OCR logístico destinada a operações globais deve ser avaliada não pela precisão apenas em inglês, mas pelo seu desempenho em toda a mistura de idiomas que a operação realmente encontra.
Formatos Variáveis de Transportadoras sem Padronização
Não existe um modelo padronizado para um conhecimento de embarque. Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE e Evergreen — as sete maiores transportadoras marítimas — cada uma usa um layout diferente. O posicionamento dos campos varia entre transportadoras, entre o Conhecimento de Embarque Master e o Conhecimento de Embarque Filhote, e às vezes entre as versões eletrônica e em papel da mesma transportadora. Os conhecimentos aéreos da FedEx Express não se parecem em nada com os documentos da DHL Express — para extração de carga aérea especificamente, veja nossa ferramenta de conhecimento aéreo (AWB) para Excel. Os PODs de transportadoras rodoviárias variam de formulários coloridos de várias páginas a folhas únicas impressas em térmica com adições manuscritas. O OCR baseado em modelo exige uma configuração separada para cada variante — um fardo de manutenção que cresce a cada novo relacionamento com transportadora. A extração semântica com IA, que localiza campos pelo significado em vez de coordenadas, processa todas as variantes através de uma única configuração. Esta é a diferença central entre o OCR tradicional e a extração moderna com IA para logística.
Incoterms e a variabilidade das condições comerciais
Os Incoterms 2020, publicados pela Câmara de Comércio Internacional, definem 11 condições comerciais — de EXW (Ex Works) a DDP (Delivered Duty Paid) — que determinam a transferência de risco, a alocação de custos e as obrigações de seguro de cada embarque. Um único B/L pode listar o Incoterm como "CIF Shanghai", mas outros documentos do mesmo embarque podem mencionar "CIF" de forma diferente nos termos do contrato. Extrair o Incoterm é simples para a maioria das ferramentas de OCR; interpretá-lo — entender que FOB se aplica apenas ao frete marítimo, enquanto FCA se aplica a qualquer modal — exige uma lógica de domínio que a extração de uso geral não oferece.
OCR legado vs. extração moderna com IA para logística
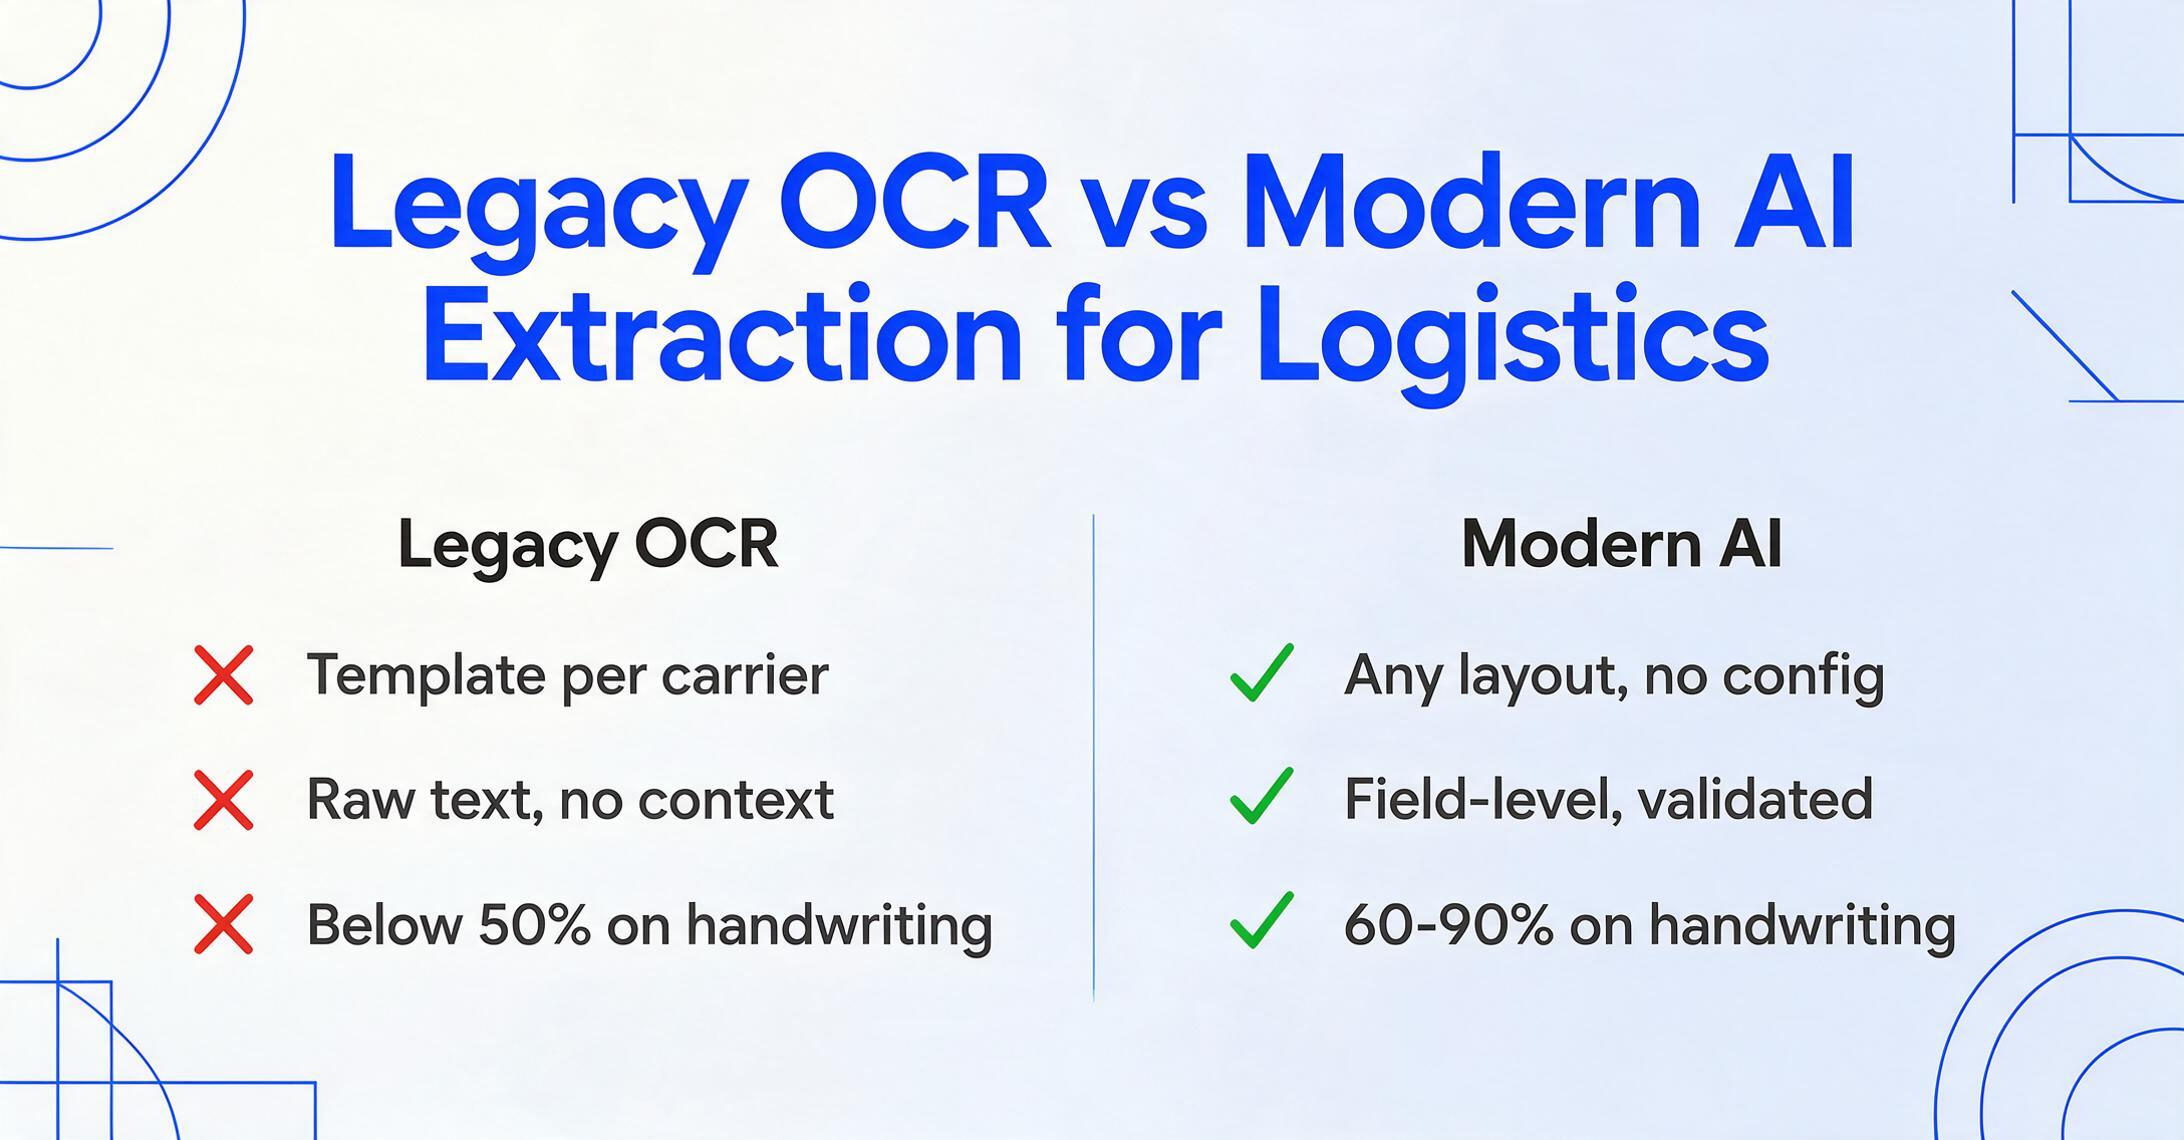
A diferença entre o OCR tradicional e a extração moderna com IA não é uma melhoria incremental — é uma abordagem diferente de leitura de documentos. Veja como os dois se comparam nas dimensões que importam para a logística.
| Dimensão | OCR tradicional | Extração com modelo de visão-linguagem de IA |
|---|---|---|
| Como lê | Caractere por caractere, linha por linha | De forma holística — processa a página como imagem e entende o layout |
| Tratamento de formatos de transportadoras | Exige modelo ou configuração de zona por formato | Lê qualquer layout; nenhuma configuração por transportadora necessária |
| Reconhecimento de códigos | Gera texto bruto (ex.: "MAEU") sem contexto | Identifica o tipo de campo; pode validar o formato (ex.: SCAC = 2 a 4 letras) |
| Tolerância a manuscrito | Abaixo de 50% em anotações de POD ilegíveis | 60-90% dependendo da legibilidade; ainda exige verificação humana |
| Multilíngue | Específico por idioma; degrada fora do conjunto configurado | Multilíngue por padrão; lida com documentos em vários alfabetos |
| Saída por campo | Produz um bloco de texto; os campos devem ser identificados manualmente | Mapeia os valores extraídos para campos definidos pelo usuário ou identificados pela IA |
| Tempo de configuração | Horas ou dias para configurar modelos por transportadora | Minutos; envie um documento e defina o que você precisa |
A tabela acima deixa claro: para operações logísticas que lidam com várias transportadoras, vários tipos de documento e uma mistura de conteúdo impresso e manuscrito, o OCR tradicional exige manutenção por formato que corrói o ROI da automação. Os modelos de visão-linguagem de IA que processam documentos semanticamente lidam com a variabilidade no momento da leitura, e não no momento da configuração. Para uma comparação mais aprofundada dessas duas abordagens tecnológicas, veja nosso artigo sobre AI OCR versus traditional OCR.
Campos-Chave na Extração de Documentos Logísticos
Abaixo está um detalhamento em nível de campo do que cada tipo de documento logístico contribui para o fluxo de dados. Os campos específicos que você extrai dependerão do seu fluxo de trabalho — uma equipe de operações precisa de dados de rastreamento de embarque, enquanto uma equipe de contas a pagar precisa de detalhes de cobranças — mas entender o mapa completo de campos orienta a avaliação de ferramentas.
| Tipo de Documento | Campos-Chave Extraíveis | Desafios Exclusivos |
|---|---|---|
| Conhecimento de Embarque (B/L) | Número do B/L, embarcador, consignatário, notificar, nome do navio, número da viagem, porto de embarque, porto de descarga, números de contêiner (ISO 6346), números de lacre, descrição da carga, códigos SH, peso bruto/líquido, volumes, condições de frete, INCOTERM | Os campos mudam de posição conforme o transportador; variação entre Conhecimento de Embarque Filhote e Master; extração do código SCAC; descrições de carga com várias linhas; validação do dígito verificador para contêineres |
| Comprovante de Entrega (POD) | Data/hora da entrega, nome do destinatário, imagem da assinatura, status da entrega, anotações de avarias, quantidade parcial, número de referência do POD, nome do transportador | Assinaturas manuscritas e anotações à margem; qualidade variável do documento (papel térmico desbota); formatos de data/hora não padronizados |
| Romaneio de Embarque / Packing List | Número do romaneio, número do pedido (PO), embarcador/recebedor, descrições dos itens, códigos SKU, quantidades por SKU, unidade de medida, números de lote/batch, total de caixas, peso bruto, códigos SH (em exportações) | Alta densidade de itens (50+ linhas); ordenação de colunas inconsistente entre fornecedores; correções de quantidade impressas vs. manuscritas |
| Declaração Aduaneira | Número da declaração, EORI do declarante, dados do exportador/importador, código SH (10 dígitos para UE/EUA), país de origem, valor declarado, moeda, peso bruto/líquido, modal de transporte, números de contêiner, referências de fatura | Validação regulatória necessária (estrutura do código SH, código de país ISO 3166); declarações com várias páginas; verificações de consistência entre documentos necessárias; alto custo dos erros |
| Fatura de Frete | Número da fatura, nome do transportador, código SCAC, número PRO, referência do B/L, tarifa base de frete, sobretaxa de combustível, taxas acessórias, valor total, condições de pagamento, classe NMFC (LTL) | Códigos de cobrança específicos do transportador para o mesmo serviço; fórmulas de sobretaxa de combustível variam; cálculos de detenção diferem por contrato; risco de estorno em valores incorretos |
O teste prático para qualquer ferramenta de extração: ela processa um B/L da Maersk e um B/L da MSC com a mesma configuração e extrai ambos os números de contêiner com precisão em nível de campo? Se não, a ferramenta exige manutenção por transportador, e o custo por unidade de extração não diminuirá à medida que você adiciona transportadores.
Considerações de Conformidade e Regulatórias
A extração de documentos logísticos não é puramente uma questão de eficiência — ela se cruza com obrigações regulatórias em vários pontos. Entender essas implicações de conformidade é importante durante a avaliação de ferramentas, porque nem todos os fluxos de extração exigem o mesmo nível de rigor de validação.
UCP 600 e Cartas de Crédito. O Artigo 20 dos Usos e Práticas Uniformes para Créditos Documentários (UCP 600) rege os conhecimentos de embarque apresentados sob cartas de crédito. Uma discrepância entre os dados do B/L e os termos da carta de crédito — a descrição das mercadorias, o porto de embarque ou descarga, a data da anotação "shipped on board" ou o nome do consignatário — pode provocar uma rejeição bancária, atrasando o pagamento em semanas. Para exportadores que usam L/C como mecanismo de pagamento, a ferramenta de OCR deve oferecer validação em nível de campo com base em regras predeterminadas, não apenas extração de texto em massa. Ferramentas de IA capazes de validar dados de B/L em relação aos termos da L/C podem identificar possíveis discrepâncias antes que os documentos sejam apresentados ao banco.
Alfândega e Proteção de Fronteiras dos EUA (CBP). Para remessas que entram nos Estados Unidos, o Ambiente Comercial Automatizado (ACE) da CBP exige elementos de dados específicos: o número do importador de registro, o Código SH no nível HTSUS de 10 dígitos, o país de origem (ISO 3166 alfa-2), o valor declarado em USD e o número do conhecimento de embarque. Cada campo tem um formato definido e uma faixa de valores aceitável. Uma solução de OCR que extrai esses campos sem validar a conformidade de formato transfere o ônus da validação para o despachante aduaneiro.
Normas ISO. Os sistemas de códigos da indústria logística são regidos por normas internacionais com regras de validação definidas. Os números de contêiner podem ser verificados pelo algoritmo de dígito verificador da ISO 6346. Os UN/LOCODEs podem ser conferidos no arquivo mestre da UNECE. Os códigos SCAC podem ser confirmados no registro da NMFTA. Uma ferramenta de extração que realiza essas validações no momento da extração — sinalizando um número de contêiner com dígito verificador inválido antes que ele entre no TMS — elimina um ciclo significativo de correção de erros a jusante.
Controles de Exportação. Para remessas de mercadorias controladas (ITAR, EAR), a descrição da carga e a classificação do Código SH determinam se uma licença de exportação é necessária. Sistemas de OCR que extraem esses campos podem acionar verificações automatizadas de conformidade, reduzindo o risco de embarcar mercadorias controladas sem a autorização exigida.
Para uma perspectiva mais ampla sobre como a extração de documentos se encaixa no lado financeiro das operações logísticas, consulte nosso guia sobre entrada de dados por IA para equipes de contabilidade — os princípios de validação automatizada de dados se aplicam igualmente ao processamento de faturas de frete e à valoração aduaneira.
Como Escolher a Ferramenta de OCR Logístico Certa
Cada operação logística é única em mix de transportadores, volume de documentos e panorama de sistemas downstream. O framework a seguir ajuda a avaliar ferramentas pelas dimensões que realmente afetam os fluxos de trabalho logísticos — não por listas genéricas de recursos.
Ferramentas como o ImageToTable.ai que usam Extração de Colunas Personalizadas — você define os campos por nome, e a IA os localiza semanticamente em qualquer lugar da página — são especialmente adequadas à logística porque lidam com múltiplos formatos de transportadores com uma única configuração. Você define colunas como "Número do contêiner", "Código SCAC", "Porto de embarque" e "Condições de frete", e a mesma configuração funciona em um BOL da Maersk, um BOL da MSC e um POD de transportador rodoviário sem ajustes. Para equipes que processam grandes volumes de documentos de frete mistos, essa independência de formato é o maior impulsionador do ROI de automação. Se a sua avaliação abrange todo o mix de documentos — BOLs, faturas de frete, declarações aduaneiras e packing lists juntos, não apenas OCR em um único tipo de documento — o nosso guia de compra de extração de documentos logísticos cobre os critérios de avaliação entre documentos em profundidade.
A opção de complemento do Google Sheets também é relevante para equipes de logística menores ou transitários que gerenciam dados de embarque em planilhas em vez de um TMS dedicado. Ao extrair dados de documentos de embarque diretamente para o Google Sheets — números de contêiner junto com números de PO e taxas de frete — o complemento substitui a entrada manual em planilhas sem exigir migração de sistema. Se sua operação atualmente concilia dados de embarque em uma planilha, essa abordagem oferece o benefício da automação dentro da ferramenta que sua equipe já usa.
Perguntas Frequentes
O OCR consegue ler assinaturas manuscritas em comprovantes de entrega?
Parcialmente. O OCR moderno com modelos de visão-linguagem de IA consegue ler caligrafia legível e em estilo impresso com 75-90% de precisão, mas assinaturas em cursivo e caligrafia apressada continuam difíceis — a precisão cai para 60-75% em registros desordenados. Para PODs em que a assinatura manuscrita ou a anotação de danos é o registro legal, a maioria dos fluxos de trabalho de logística trata a extração por OCR desses campos como uma etapa de "revisar antes de usar" em vez de automação direta. O valor prático do OCR em PODs não é eliminar totalmente a revisão humana — é reduzir o tempo necessário para localizar e verificar campos manuscritos de minutos para segundos.
O OCR funciona com documentos de embarque internacionais em vários idiomas?
Sim, ferramentas de OCR baseadas em IA lidam com documentos multilíngues significativamente melhor do que mecanismos de OCR tradicionais. Modelos de visão-linguagem treinados em corpora de documentos multilíngues processam todos os alfabetos dentro de um único modelo — eles não exigem configuração por idioma. No entanto, a precisão varia conforme o alfabeto. Idiomas de escrita latina (inglês, francês, espanhol, alemão) apresentam o melhor desempenho. Caracteres chineses, japoneses e coreanos apresentam mais dificuldade de reconhecimento devido à densidade de caracteres e à complexidade dos traços, mas estão bem dentro da capacidade dos modelos de IA da geração atual. Sempre teste a ferramenta com sua combinação real de documentos em vez de confiar em benchmarks apenas em inglês.
Como funciona a validação do número do contêiner na extração por OCR?
Os números de contêiner seguem o formato ISO 6346: quatro letras de código do proprietário, seis dígitos de série e um dígito verificador. Ferramentas avançadas de OCR podem validar o número do contêiner extraído contra o algoritmo de dígito verificador da ISO — o sistema confirma matematicamente que o prefixo de nove caracteres produz o décimo caractere, o dígito verificador. Essa validação captura um dos erros mais comuns de entrada manual de dados na logística: um único dígito transposto em um número de contêiner que normalmente levaria dias para ser identificado. Se o número extraído falhar na validação, a ferramenta o sinaliza para revisão em vez de propagar o erro adiante.
Qual é a diferença entre a extração de B/L baseada em modelo e a extração semântica?
A extração baseada em modelo exige que você defina as coordenadas e os rótulos de campo para o formato de B/L de cada transportador. Quando um transportador atualiza seu layout — ou quando você adiciona um novo transportador — o modelo quebra ou precisa ser configurado do zero. A extração semântica lê o documento entendendo o que cada campo significa, não onde ele está. Você define os campos que deseja (número do B/L, número do contêiner, porto de embarque), e a IA os encontra em qualquer lugar da página. Isso significa que uma única configuração funciona em todos os formatos de transportador, e nenhuma manutenção é necessária quando um transportador altera seu layout. Para operações logísticas que lidam com vários transportadores, a extração semântica é a diferença prática entre uma automação que escala e uma automação que cria um novo fardo de manutenção.
Quão precisa é a extração por IA em documentos logísticos em comparação com a entrada manual de dados?
Em B/Ls limpos, impressos por máquina, de grandes transportadores, a extração por IA moderna alcança 90-99% de precisão em nível de campo nos campos padrão (embarcador, consignatário, navio, portos). Em códigos específicos da logística, como SCAC e UN/LOCODE, a precisão em conteúdo impresso normalmente se mantém acima de 85%. O conteúdo manuscrito cai para 60-90%, dependendo da legibilidade. Esses números se comparam favoravelmente à entrada manual de dados, que normalmente alcança 95-98% de precisão em campos rotineiros, mas a uma velocidade muito menor — 10-15 minutos por documento contra 5-10 segundos por documento com IA. A métrica principal é a produtividade: a extração por IA processa 60-100 documentos no tempo em que um operador manual processa um, o que a torna adequada para operações logísticas de alto volume, mesmo quando uma etapa de verificação humana permanece para campos manuscritos.
Posso exportar os dados extraídos de documentos de transporte diretamente para meu TMS ou ERP?
A maioria das ferramentas de extração por IA oferece exportação em CSV ou Excel como base. Muitas também fornecem acesso via API para transferência automatizada de dados para sistemas TMS e ERP. Algumas ferramentas oferecem integrações diretas com plataformas como CargoWise, SAP, Oracle, QuickBooks e Xero, ou podem enviar dados através do Zapier, Make ou Power Automate. O formato de saída e o método de integração são critérios de seleção críticos: se os dados da ferramenta de extração exigirem reformatação manual antes de entrar em seus sistemas operacionais, o benefício da automação é significativamente reduzido. Para fluxos de trabalho baseados em planilhas, ferramentas com um complemento do Google Sheets permitem a inserção direta dos dados extraídos nas planilhas, sem exportações intermediárias de arquivos.
Quais INCOTERMS devo esperar encontrar em documentos logísticos?
As 11 regras dos INCOTERMS 2020 são divididas em duas categorias. Para qualquer modal de transporte: EXW (Ex Works), FCA (Free Carrier), CPT (Carriage Paid To), CIP (Carriage and Insurance Paid To), DAP (Delivered at Place), DPU (Delivered at Place Unloaded) e DDP (Delivered Duty Paid). Para transporte marítimo e por vias navegáveis interiores apenas: FAS (Free Alongside Ship), FOB (Free on Board), CFR (Cost and Freight) e CIF (Cost, Insurance and Freight). Para embarques conteinerizados, FCA ou CIP são normalmente mais apropriados do que FOB ou CIF, embora FOB continue sendo comumente — e muitas vezes incorretamente — usado. Uma ferramenta de extração competente deve reconhecer todos os 11 termos e suas abreviações.
Coloque a Extração de Documentos de Transporte para Trabalhar
As operações logísticas não têm o luxo de padronizar a entrada de seus documentos. Os Conhecimentos de Embarque (B/L) chegam de 20 transportadoras diferentes em 20 layouts diferentes. Os Comprovantes de Entrega (POD) voltam dos motoristas com assinaturas manuscritas e anotações à margem. Romaneios de Embarque, Faturas de Frete e Declarações Aduaneiras trazem, cada um, sua própria complexidade de campos e requisitos de validação. A questão não é se você pode eliminar todo o processamento manual — para alguns campos, especialmente assinaturas manuscritas, a verificação humana continua sendo o ponto de controle correto. A questão é se você pode eliminar os 10 a 15 minutos por documento de digitação manual de dados que atualmente consomem a capacidade da sua equipe sem agregar nenhum valor operacional.
O OCR moderno para logística — impulsionado por extração semântica com IA em vez de reconhecimento de caracteres baseado em modelo — torna isso possível ao entender os documentos de transporte como um profissional de logística: identificando o que cada campo significa, validando-o segundo os padrões do setor e gerando a saída no formato que seus sistemas downstream esperam. Uma única configuração funciona em todos os formatos de transportadora, todos os idiomas e todos os tipos de documento.
Envie um BOL, POD ou romaneio de embarque real e veja como seu fluxo de documentos fica em dados estruturados — em segundos, não minutos.
Experimente no Seu Próprio Documento →Não é necessário cadastro. Os arquivos são processados com segurança.