OCR para logística:
Automatización de B/L, POD y documentos de envío
Un transitario de nivel medio procesa de 60 a 100 conocimientos de embarque (B/L), más de 80 comprobantes de entrega (POD) y docenas de facturas de flete y listas de empaque cada día. Con la entrada manual que consume de 10 a 15 minutos por documento y los ciclos de corrección de errores que crecen más rápido que el volumen, la mayoría de los equipos de logística pasan su tiempo tecleando, no moviendo carga. El OCR para logística es el enfoque sistemático para convertir este flujo de documentos en datos estructurados que alimentan un TMS, ERP u hoja de cálculo, sin mantenimiento de plantillas por transportista ni reingreso manual.
Puntos clave
- De sesenta a cien conocimientos de embarque al día, de diez a quince minutos cada uno: un equipo de logística dedica de diez a quince horas al ingreso de datos antes de que un solo envío se mueva.
- El OCR que implementa en facturas fallará en documentos de logística porque la logística utiliza sistemas de códigos (SCAC, UN/LOCODE, ISO 6346), no lenguaje natural, y una herramienta que extrae texto sin formato
MAEUno ha automatizado el paso de asignarlo a un nombre de transportista. - La extracción semántica lee los campos por lo que significan, no por dónde están en el diseño de un transportista específico: una configuración procesa todos los formatos de B/L, y añadir un nuevo transportista cuesta cero horas de mantenimiento de plantillas.
Qué significa realmente «OCR para logística» — y en qué se diferencia del OCR de documentos general
El OCR para logística es la extracción y estructuración automatizada de datos de los tipos de documentos que circulan por las cadenas de suministro: conocimientos de embarque, comprobantes de entrega, listas de empaque, declaraciones de aduanas y facturas de flete. El objetivo no es solo digitalizar estos documentos para convertirlos en texto buscable — es producir datos estructurados a nivel de campo (números de contenedor, códigos SCAC, códigos SA, condiciones de flete, códigos de puerto, cantidades, cargos) que puedan fluir directamente a un sistema de gestión de transporte (TMS), un ERP, un sistema de gestión de almacén o una hoja de cálculo.
Esta distinción es importante porque una herramienta de OCR de propósito general trata cada documento como «texto en una página». Reconoce caracteres, pero no sabe que COSU8102804 es un número de contenedor (con el dígito de control 4 regido por las normas ISO 6346) ni que NL RTM es el Puerto de Róterdam expresado como UN/LOCODE. Los documentos logísticos contienen códigos específicos del sector y relaciones entre campos que los motores de OCR genéricos nunca aprendieron durante su entrenamiento. Una herramienta optimizada para la extracción de facturas pasará por alto los códigos SCAC y los prefijos de contenedor porque sus datos de entrenamiento — facturas de cuentas por pagar — nunca los contenían en primer lugar, como descubrió nuestra comparativa de herramientas de extracción logística cuando las herramientas entrenadas con facturas de cuentas por pagar cayeron por debajo del 60% en campos específicos de logística.
En la práctica, esto significa que el OCR para logística requiere tanto comprensión semántica (la capacidad de identificar un campo por lo que significa, no por dónde se encuentra en la página) como conocimiento de códigos específicos del sector (la capacidad de validar y normalizar los resultados según los estándares que los sistemas logísticos esperan). Para un análisis más profundo de cómo la extracción semántica difiere del reconocimiento de caracteres tradicional, consulte nuestra guía sobre qué es el OCR con IA y cómo funciona.
Por qué la logística necesita OCR: el caso cuantificado
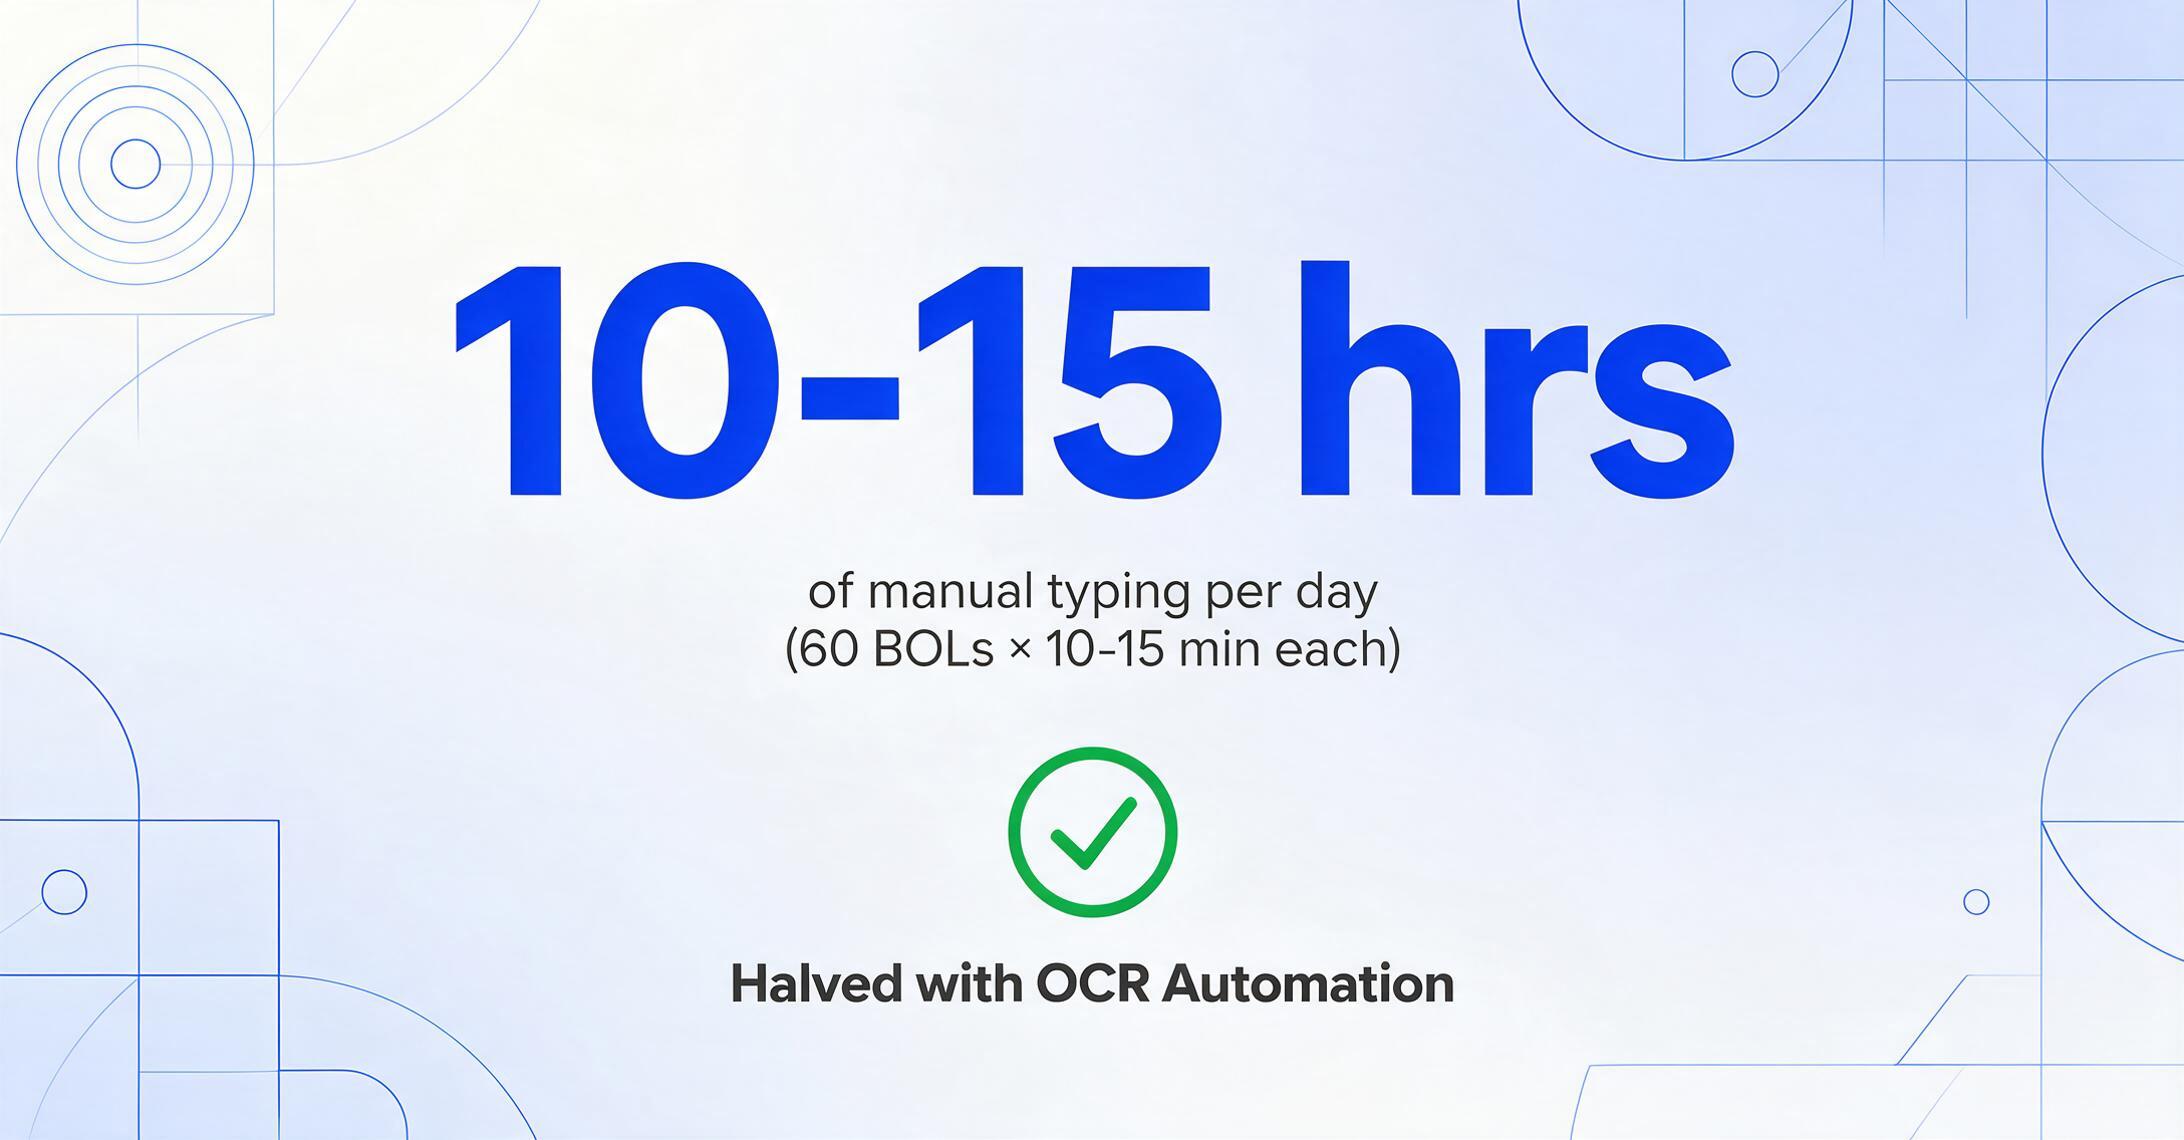
La escala del procesamiento de documentos logísticos rara vez es visible para los equipos fuera de operaciones. Un escritorio de transitario que gestiona de 50 a 80 envíos al día recibe la documentación de cada envío como un PDF o imagen independiente, a menudo de un transportista o transitario diferente con un formato único. Con la entrada manual de datos que consume un estimado de 10 a 15 minutos por documento, un transitario que procesa 60 conocimientos de embarque (B/L) al día dedica de 10 a 15 horas diarias solo a teclear, antes de considerar la verificación de comprobantes de entrega (POD), la conciliación de facturas de flete y la preparación de declaraciones de aduanas.
Ese costo de tiempo se ve agravado por las tasas de error. Los estudios sobre la entrada manual de datos en flujos de trabajo logísticos encuentran sistemáticamente tasas de error de entre el 2% y el 5% en campos rutinarios, y más altas en entradas manuscritas. En un B/L con 15 a 20 campos extraíbles, una tasa de error del 3% significa aproximadamente un error cada dos documentos. En logística, un solo dígito incorrecto en un código SA puede provocar una retención aduanera. Un número de contenedor mal tecleado puede enviar un envío al limbo del seguimiento durante días. Una cifra de peso transpuesta puede generar un cargo por flete que tarde semanas en resolverse.
Para los equipos logísticos que procesan grandes volúmenes, el caso de negocio para la automatización por OCR no es teórico. Se ha demostrado que automatizar la entrada de datos de B/L y facturas de flete reduce el tiempo de procesamiento en más de la mitad y, al mismo tiempo, reduce las tasas de error, liberando al personal de entrada de datos para centrarse en la gestión de excepciones y el servicio al cliente en lugar de teclear repetitivamente.
Los cinco tipos de documentos logísticos que necesitan OCR
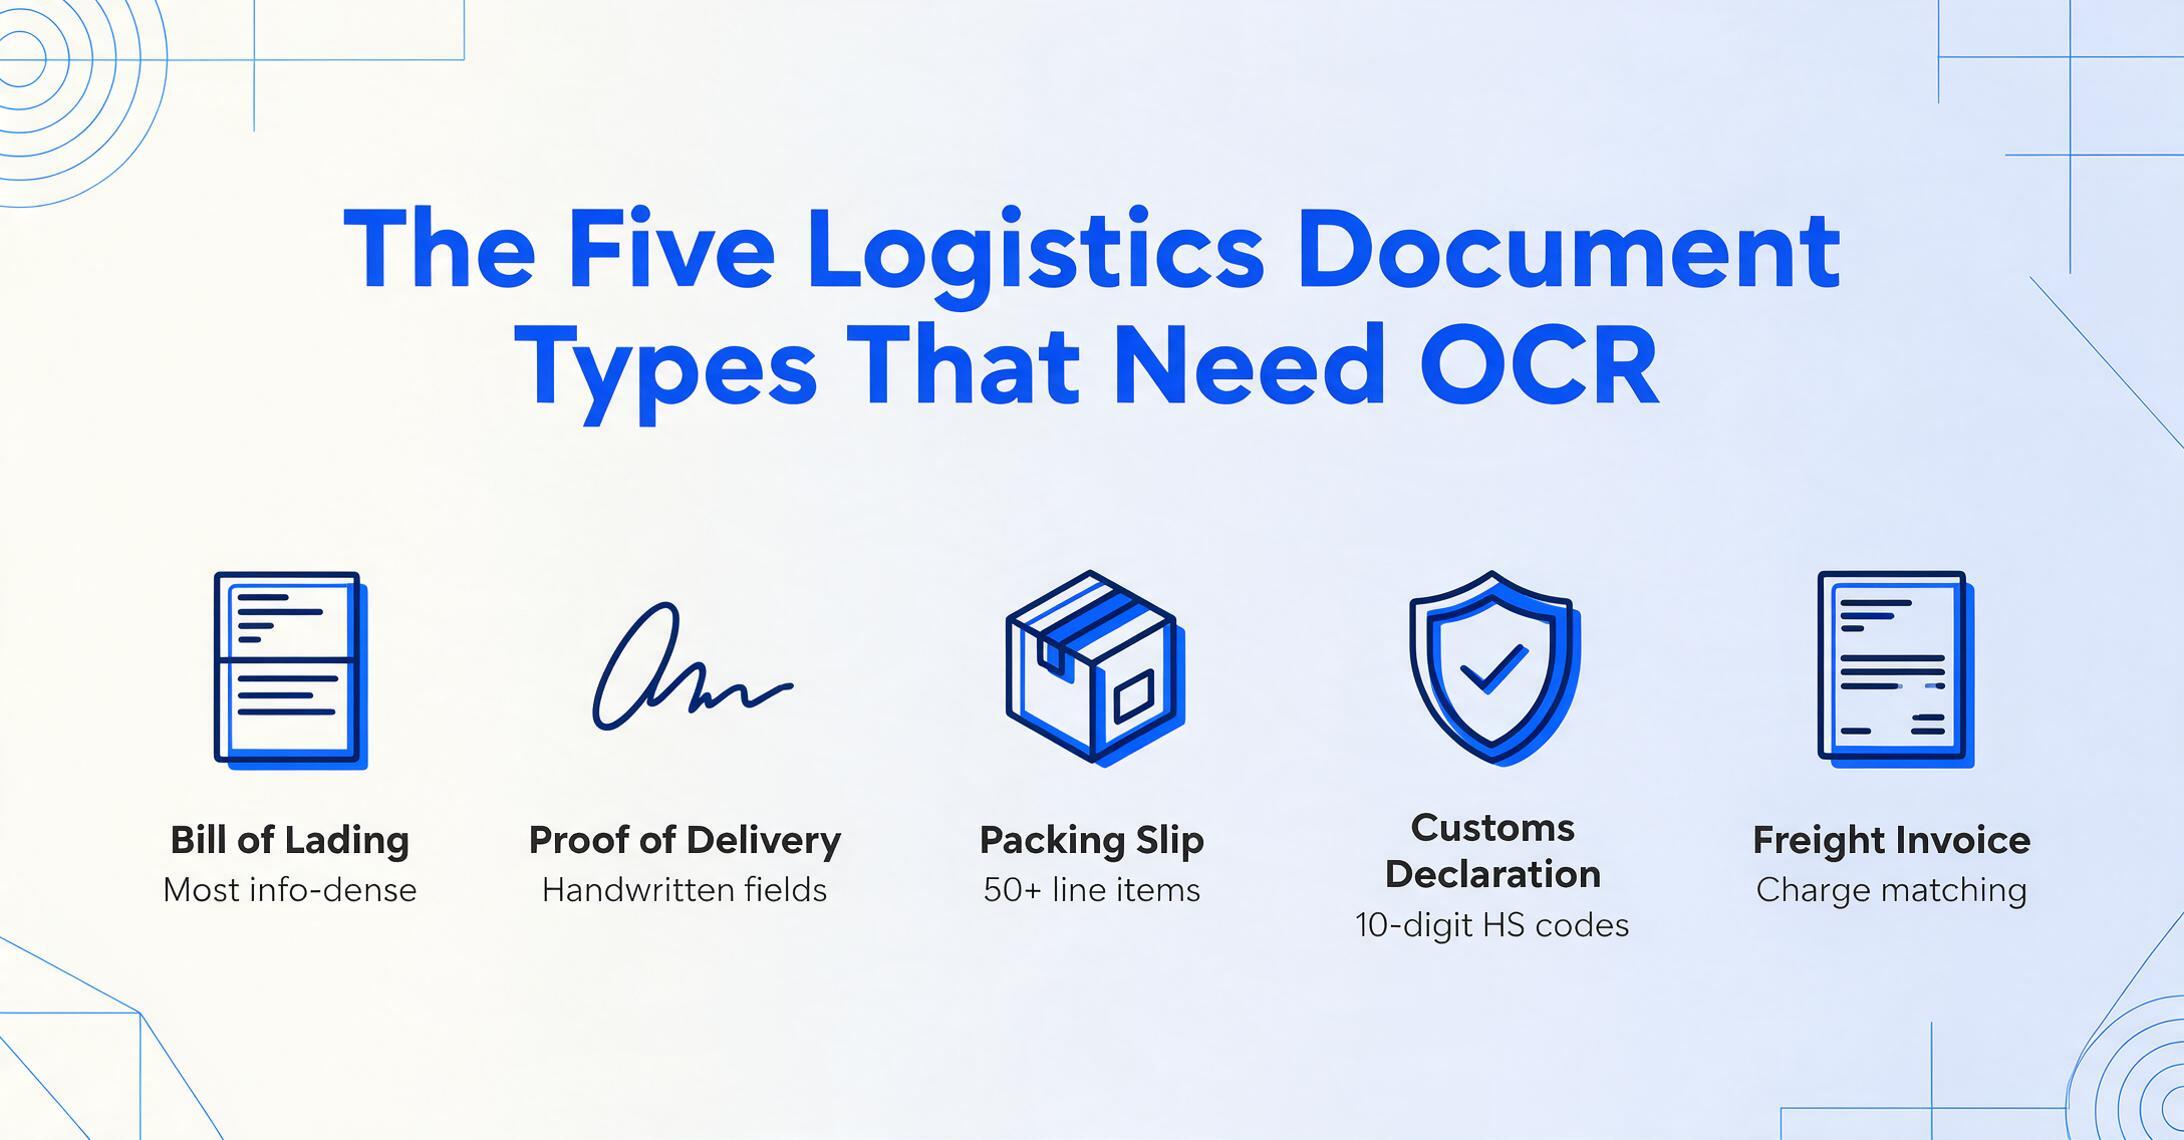
Las operaciones logísticas no procesan un solo tipo de documento. Procesan un flujo mixto de al menos cinco, cada uno con su propio conjunto de campos, función legal y desafío de extracción. Así es como se aplica el OCR a cada uno.
1. Conocimiento de embarque
El conocimiento de embarque es el documento con mayor densidad de información en logística. Sirve como recibo, contrato de transporte y título de propiedad: quien posee el original puede reclamar la mercancía. Un único B/L marítimo puede contener el nombre del cargador y el número EORI, el consignatario, el notificar a, el nombre del buque y el número de viaje, el puerto de carga y el puerto de descarga (cada uno expresado como UN/LOCODE), números de contenedor (formato ISO 6346 con dígitos de control), números de precinto, descripciones de la carga, pesos brutos y netos, recuentos de bultos, condiciones de flete (prepagado o debido), la regla Incoterms (FOB, CIF, FCA, etc.), y a menudo múltiples partidas con códigos SA. La posición de los campos varía según el transportista: Maersk coloca el número de contenedor en el cuadrante superior derecho; MSC lo sitúa a mitad de página, debajo del nombre del buque. Un conocimiento de embarque hijo puede hacer referencia a un número de conocimiento de embarque máster que un conocimiento de embarque nominativo no incluye. Para un desglose completo de este tipo de documento, consulte nuestra guía dedicada sobre extracción de datos de conocimientos de embarque. Para extraer campos de B/L a una hoja de cálculo en segundos, sin configuración por transportista, use la herramienta de conocimiento de embarque a Excel.
2. Comprobante de entrega (POD)
El comprobante de entrega es el documento final del ciclo de envío: confirma que la mercancía llegó, en qué condiciones y quién la aceptó. El desafío de la extracción es que los campos más importantes de un POD son los menos legibles por máquina. Las firmas de entrega están escritas a mano, a menudo con un garabato rápido que incluso un lector humano tendría dificultades para descifrar. Las marcas de hora de entrega pueden estar escritas por el conductor. Las anotaciones de daños («1 caja aplastada — rechazada»), las anotaciones de cantidad parcial («Recibidos 47 de 50») y los sellos de llegada tardía suelen estar escritos a mano en los márgenes. Las mejores herramientas de OCR para escritura a mano en 2026 manejan letra de imprenta clara con una precisión del 85-95 %, pero las firmas en cursiva y las notas marginales siguen siendo una capa de verificación humana en la mayoría de los flujos de trabajo logísticos. La extracción semántica con IA mitiga esto parcialmente: un modelo que comprende la estructura del documento puede al menos dirigir al verificador a la ubicación correcta en la página, en lugar de obligarlo a examinar cada campo.
3. Lista de empaque
Las listas de empaque acompañan a cada envío y detallan el contenido de cada caja o palé: descripciones de artículos, códigos SKU, cantidades, números de lote y, en ocasiones, códigos SA y marcas de país de origen. El valor de la extracción en las listas de empaque reside en la eficiencia de la recepción: cotejar automáticamente las cantidades recibidas con la orden de compra, detectar faltantes antes de que llegue la factura del proveedor y alimentar el WMS sin necesidad de captura manual a nivel de artículo. Las listas de empaque suelen tener un diseño más sencillo que los conocimientos de embarque (B/L), pero presentan una mayor densidad de líneas: una sola lista puede contener más de 50 SKU, y cada línea debe capturarse con precisión para la conciliación de inventario. El OCR basado en plantillas falla aquí porque cada 3PL y proveedor formatea la lista de manera distinta. La extracción semántica, que lee los campos por su significado y no por su posición en coordenadas, maneja esta variabilidad de forma nativa.
4. Declaraciones de aduanas
Las declaraciones de aduanas — el Documento Administrativo Único (DAU) en la UE, el CBP 3461 en EE. UU., la declaración CDS en el Reino Unido — son el punto donde la precisión de la extracción se cruza directamente con el cumplimiento legal. Cada campo de una declaración de aduanas corresponde a un elemento de datos reglamentario: el código SA determina el tipo de arancel, el país de origen determina la elegibilidad para acuerdos comerciales, y el valor declarado determina la base imponible para el IVA y los aranceles aduaneros. Un solo dígito incorrecto en un código SA puede resultar en un pago excesivo de aranceles o, en el caso de mercancías controladas, en la incautación del envío y sanciones. Las declaraciones de aduanas también incorporan datos de otros documentos de esta lista: el conocimiento de embarque (B/L) aporta los detalles de transporte, la factura comercial aporta el valor, y la lista de empaque aporta las cantidades por línea, lo que convierte la coherencia entre documentos en un requisito de validación clave. Por lo tanto, el OCR para documentos aduaneros debe operar con umbrales de confianza más altos que la extracción de propósito general.
5. Factura de flete
La factura de flete es el documento de conciliación financiera de la logística. Detalla los cargos de un envío: tarifa de flete base, recargo por combustible (a menudo 10-25% del total), cargos accesorios (plataforma elevadora, entrega en interiores, recargo por zona residencial), cargos por detención o demora, y cualquier descuento negociado. La carga de auditoría manual de estas facturas es significativa: un solo sobrecargo puede ser de $50-$200, y a escala, la sobrefacturación sistemática puede costar decenas de miles anualmente. La extracción automatizada de facturas de flete permite a los equipos de cuentas por pagar cotejar los montos facturados contra las tarifas contratadas, señalar discrepancias en recargos y enrutar excepciones para revisión sin teclear manualmente las partidas de cargos en una hoja de cálculo. El desafío de extracción específico de las facturas de flete es la variedad de códigos de cargo y abreviaturas (a menudo específicos del transportista) que describen el mismo servicio de manera diferente entre transportistas.
Qué Hace que los Documentos Logísticos Sean Particularmente Difíciles para el OCR
Los documentos logísticos no son simplemente "facturas con campos diferentes". Presentan un conjunto de desafíos estructurales que el OCR tradicional — e incluso muchas herramientas de extracción con IA de propósito general — no fueron diseñados para manejar.
Sistemas de Códigos Propietarios que Requieren Conocimiento del Dominio
La logística opera con códigos, no con lenguaje natural. Un B/L no dice "el transportista es Maersk Line"; dice MAEU — el código SCAC del transportista. Los puertos no se escriben como "Róterdam, Países Bajos"; aparecen como NL RTM, el UN/LOCODE de cinco caracteres asignado por la UNECE. Los números de contenedor siguen la norma ISO 6346: cuatro letras de código del propietario (p. ej., MSCU), seis dígitos seriales y un dígito de control que puede validarse matemáticamente. Los códigos SA son clasificaciones de mercancías de 6 a 10 dígitos mantenidas por la Organización Mundial de Aduanas. Un sistema de OCR que no reconozca estas estructuras de código generará texto sin procesar que requiere recodificación manual antes de ser útil. Un sistema que sí las reconoce puede validar los resultados — por ejemplo, confirmando que un número de contenedor extraído pasa el cálculo del dígito de control ISO 6346 — reduciendo significativamente la carga de verificación posterior.
Firmas manuscritas y anotaciones al margen en los POD
Los documentos con mayor valor operativo —los comprobantes de entrega— son también los que menos contenido legible por máquina contienen. Los conductores firman con garabatos manuscritos. Los destinatarios anotan excepciones de entrega en los márgenes. Las marcas de tiempo se escriben a mano. Para el transportista, estos campos manuscritos son el registro legal de la entrega y su estado. Para el sistema de OCR, representan el escenario de extracción más difícil: escritura manual variable en un espacio bidimensional sin límites de campo fijos. El OCR tradicional cae por debajo del 50% de precisión en anotaciones desordenadas de POD. La extracción moderna con IA y modelos de visión-lenguaje rinde mejor, manteniendo un 75-90% en letra de imprenta clara y un 60-75% en cursiva, pero no son cifras de procesamiento directo: la verificación humana de los campos manuscritos sigue siendo un punto de control necesario en la mayoría de los flujos de trabajo logísticos.
Documentos multilingües y con múltiples conjuntos de caracteres
La logística internacional implica documentos internacionales. Un envío de Shanghái a Hamburgo genera documentación que puede incluir caracteres chinos (货物描述), alemán (Gefahrgutklasse) e inglés —a veces en la misma página. Las declaraciones de aduanas en Tailandia usan escritura tailandesa. Los puertos japoneses aparecen en kanji. Los conocimientos de embarque (B/L) latinoamericanos suelen mezclar español e inglés. Los motores de OCR tradicionales son específicos de un idioma: se configuran para inglés o alemán, y la precisión del reconocimiento se degrada fuera del conjunto de idiomas configurado. Los modelos de visión con IA entrenados con corpus de documentos multilingües manejan esto con mayor soltura porque procesan patrones visuales, no conjuntos de caracteres, pero la precisión sigue variando significativamente según la escritura. Una solución de OCR logístico destinada a operaciones globales debe evaluarse no por su precisión solo en inglés, sino por su rendimiento en la combinación de idiomas que la operación realmente encuentra.
Formatos variables de transportistas sin estandarización
No existe una plantilla estandarizada para un conocimiento de embarque. Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE y Evergreen —las siete mayores navieras— usan cada una un diseño distinto. La ubicación de los campos varía entre transportistas, entre el conocimiento de embarque máster y el hijo, y a veces entre las versiones electrónica y en papel del mismo transportista. Las guías aéreas de FedEx Express no se parecen en nada a los documentos de DHL Express —para la extracción de carga aérea específicamente, consulte nuestra herramienta de guía aérea (AWB) a Excel. Los POD de transportistas terrestres van desde formularios de colores de varias páginas hasta hojas únicas impresas en térmico con añadidos manuscritos. El OCR basado en plantillas requiere una configuración separada para cada variante —una carga de mantenimiento que crece con cada nueva relación con un transportista. La extracción semántica con IA, que localiza los campos por significado y no por coordenadas, procesa todas las variantes con una sola configuración. Esta es la diferencia fundamental entre el OCR tradicional y la extracción moderna con IA para la logística.
Incoterms y variabilidad de los términos comerciales
Los Incoterms 2020, publicados por la Cámara de Comercio Internacional, definen 11 términos comerciales — desde EXW (En Fábrica) hasta DDP (Entregado con Derechos Pagados) — que determinan la transferencia de riesgo, la asignación de costos y las obligaciones de seguro para cada envío. Un único conocimiento de embarque (B/L) puede indicar el Incoterm como "CIF Shanghái", pero otros documentos del mismo envío pueden hacer referencia a "CIF" de manera diferente en los términos del contrato. Extraer el Incoterm es sencillo para la mayoría de las herramientas de OCR; interpretarlo — comprender que FOB se aplica solo al flete marítimo mientras que FCA se aplica a cualquier modo — requiere lógica de dominio que la extracción de propósito general no proporciona.
OCR tradicional vs. extracción moderna con IA para logística
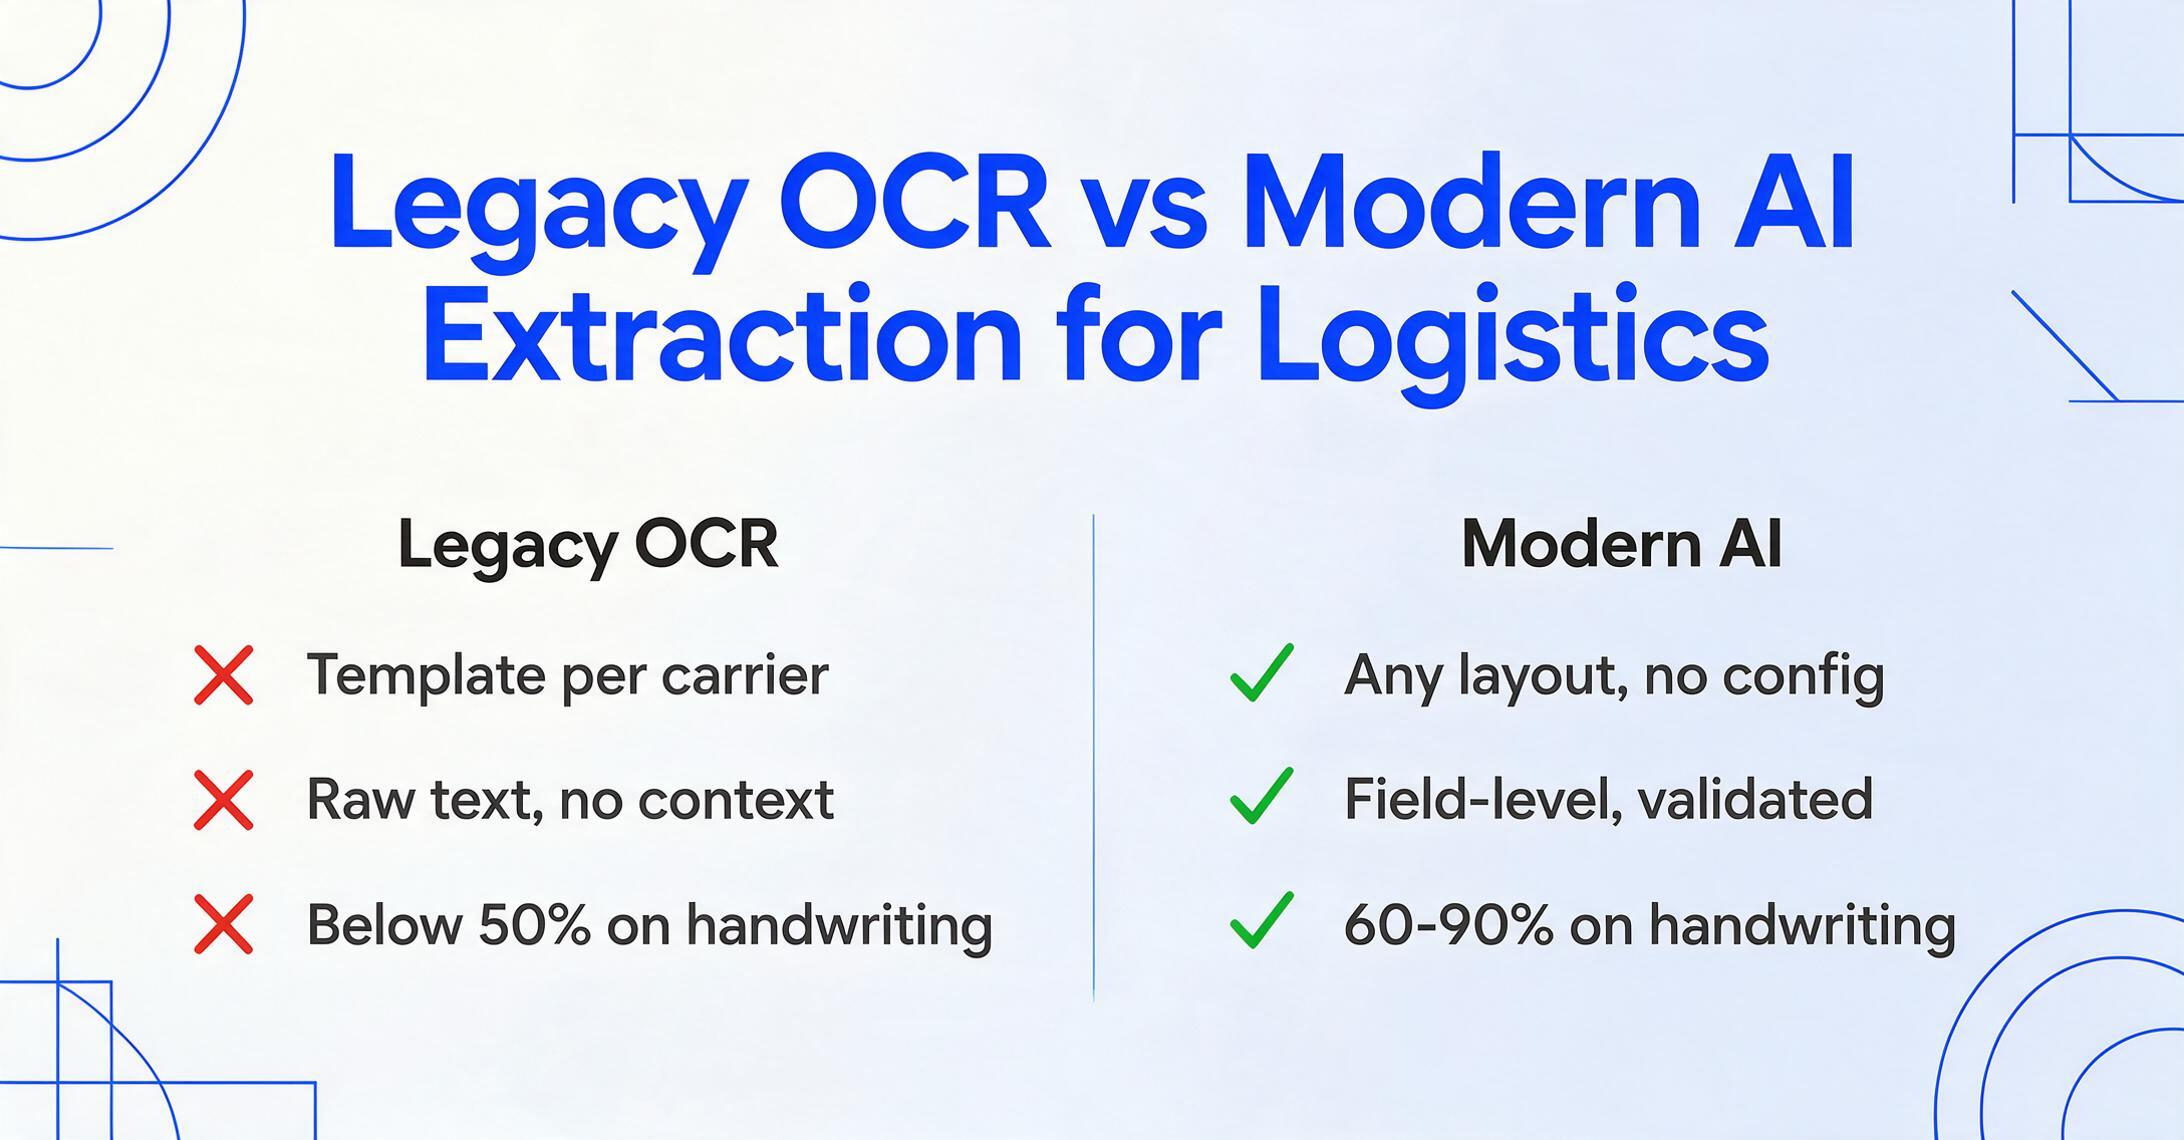
La diferencia entre el OCR tradicional y la extracción moderna con IA no es una mejora incremental — es un enfoque diferente para leer documentos. Así se comparan ambos en las dimensiones que importan para la logística.
| Dimensión | OCR tradicional | Extracción con modelo de visión-lenguaje con IA |
|---|---|---|
| Cómo lee | Carácter por carácter, línea por línea | De forma holística: procesa la página como una imagen y comprende el diseño |
| Manejo de formatos de transportistas | Necesita plantilla por formato o configuración de zonas | Lee cualquier diseño; no se necesita configuración por transportista |
| Reconocimiento de códigos | Genera texto sin procesar (p. ej., "MAEU") sin contexto | Identifica el tipo de campo; puede validar el formato (p. ej., Código SCAC = 2-4 letras) |
| Tolerancia a la escritura a mano | Inferior al 50 % en anotaciones de comprobante de entrega (POD) poco claras | 60-90 % según la legibilidad; aún requiere verificación humana |
| Multilingüe | Específico del idioma; se degrada fuera del conjunto configurado | Multilingüe por defecto; maneja documentos con escritura mixta |
| Salida a nivel de campo | Produce un bloque de texto; los campos deben identificarse manualmente | Asigna los valores extraídos a campos definidos por el usuario o identificados por IA |
| Tiempo de configuración | Horas o días para configurar plantillas por transportista | Minutos; suba un documento y defina lo que necesita |
La tabla anterior deja claro el argumento: para operaciones logísticas que manejan múltiples transportistas, múltiples tipos de documentos y una combinación de contenido impreso y escrito a mano, el OCR tradicional requiere un mantenimiento por formato que erosiona el retorno de la inversión de la automatización. Los modelos de visión-lenguaje con IA que procesan documentos semánticamente manejan la variabilidad en el punto de lectura en lugar de en el punto de configuración. Para una comparación más profunda de estos dos enfoques tecnológicos, consulte nuestro artículo sobre OCR con IA versus OCR tradicional.
Campos Clave en la Extracción de Documentos Logísticos
A continuación, se presenta un desglose a nivel de campo de lo que cada tipo de documento logístico aporta al flujo de datos. Los campos específicos que extraiga dependerán de su flujo de trabajo: un equipo de operaciones necesita datos de seguimiento de envíos, mientras que un equipo de cuentas por pagar necesita detalles de cargos. Sin embargo, comprender el mapa completo de campos orienta la evaluación de herramientas.
| Tipo de Documento | Campos Clave Extraíbles | Desafíos Únicos |
|---|---|---|
| Conocimiento de Embarque | Número BOL, embarcador, consignatario, parte notificada, nombre del buque, número de viaje, puerto de carga, puerto de descarga, números de contenedor (ISO 6346), números de precinto, descripción de la carga, códigos HS, peso bruto/neto, bultos, términos de flete, INCOTERM | Los campos cambian de posición según el transportista; variación entre BOL de casa y maestro; extracción del código SCAC; descripciones de carga de varias líneas; validación del dígito de control para contenedores |
| Comprobante de Entrega | Fecha/hora de entrega, nombre del destinatario, imagen de la firma, estado de la entrega, anotaciones de daños, cantidad parcial, número de referencia POD, nombre del transportista | Firmas manuscritas y notas al margen; calidad variable del documento (el papel térmico se desvanece); formatos de marca de tiempo no estándar |
| Lista de Empaque | Número de lista de empaque, número de OC, embarcador/receptor, descripciones de artículos, códigos SKU, cantidades por SKU, unidad de medida, números de lote/lote, total de cajas, peso bruto, códigos HS (en exportaciones) | Alta densidad de líneas de artículo (más de 50 filas); orden de columnas inconsistente entre proveedores; correcciones de cantidad impresas vs. manuscritas |
| Declaración de Aduana | Número de declaración, declarante EORI, detalles del exportador/importador, código HS (10 dígitos para UE/EE. UU.), país de origen, valor declarado, moneda, peso bruto/neto, modo de transporte, números de contenedor, referencias de factura | Se requiere validación regulatoria (estructura del código HS, código de país ISO 3166); declaraciones de varias páginas; necesarias verificaciones de coherencia entre documentos; alto costo de errores |
| Factura de Flete | Número de factura, nombre del transportista, código SCAC, número PRO, referencia BOL, cargo de flete base, recargo por combustible, cargos accesorios, monto total, términos de pago, clase NMFC (LTL) | Códigos de cargo específicos del transportista para el mismo servicio; las fórmulas de recargo por combustible varían; los cálculos de detención difieren según el contrato; riesgo de contracargo por montos incorrectos |
La prueba práctica para cualquier herramienta de extracción: ¿pasa un BOL de Maersk y un BOL de MSC a través de la misma configuración y extrae ambos números de contenedor con precisión a nivel de campo? Si no es así, la herramienta requiere mantenimiento por transportista y el costo unitario de extracción no disminuirá a medida que agregue transportistas.
Consideraciones de Cumplimiento y Regulatorias
La extracción de documentos logísticos no es únicamente una cuestión de eficiencia: se cruza con obligaciones regulatorias en múltiples puntos. Comprender estas implicaciones de cumplimiento es importante al evaluar herramientas, porque no todos los flujos de extracción requieren el mismo nivel de rigor de validación.
UCP 600 y Cartas de Crédito. El Artículo 20 de las Normas y Prácticas Uniformes para Créditos Documentarios (UCP 600) regula los conocimientos de embarque presentados bajo cartas de crédito. Una discrepancia entre los datos del B/L y los términos del crédito — la descripción de la mercancía, el puerto de carga o descarga, la fecha de la anotación "mercancía a bordo", o el nombre del consignatario — puede provocar el rechazo del banco, retrasando el pago por semanas. Para exportadores que utilizan la Carta de Crédito (L/C) como mecanismo de pago, la herramienta de OCR debe admitir validación a nivel de campo contra reglas predeterminadas, no solo extracción de texto en bloque. Las herramientas de IA capaces de validar los datos del B/L contra los términos de la L/C pueden identificar discrepancias potenciales antes de que los documentos se presenten al banco.
Oficina de Aduanas y Protección Fronteriza de EE. UU. (CBP). Para los envíos que ingresan a los Estados Unidos, el entorno comercial automatizado (ACE) de la CBP requiere elementos de datos específicos: el número del importador de registro, el código SA a nivel de 10 dígitos HTSUS, el país de origen (ISO 3166 alfa-2), el valor declarado en USD y el número de conocimiento de embarque. Cada campo tiene un formato definido y un rango de valores aceptable. Una solución de OCR que extraiga estos campos sin validar el cumplimiento del formato traslada la carga de validación al agente de aduanas.
Normas ISO. Los sistemas de códigos de la industria logística se rigen por normas internacionales con reglas de validación definidas. Los números de contenedor se pueden verificar contra el algoritmo de dígito de control ISO 6346. Los UN/LOCODE se pueden verificar contra el archivo maestro de datos de la UNECE. Los códigos SCAC se pueden confirmar contra el registro de la NMFTA. Una herramienta de extracción que realice estas validaciones en el punto de extracción — señalando un número de contenedor con un dígito de control no válido antes de que ingrese al TMS — elimina un bucle significativo de corrección de errores posterior.
Controles de Exportación. Para envíos de mercancías controladas (ITAR, EAR), la descripción de la carga y la clasificación del código SA determinan si se requiere una licencia de exportación. Los sistemas de OCR que extraen estos campos pueden activar verificaciones de cumplimiento automatizadas, reduciendo el riesgo de enviar mercancías controladas sin la autorización requerida.
Para una perspectiva más amplia sobre cómo la extracción de documentos se integra en el lado financiero de las operaciones logísticas, consulte nuestra guía sobre entrada de datos con IA para equipos de contabilidad — los principios de validación de datos automatizada se aplican igualmente al procesamiento de facturas de flete y a la valoración aduanera.
Cómo elegir la herramienta de OCR logístico adecuada
Cada operación logística es única en cuanto a la combinación de transportistas, volumen de documentos y panorama de sistemas downstream. El siguiente marco ayuda a evaluar las herramientas según las dimensiones que realmente afectan los flujos de trabajo logísticos, no listas genéricas de funciones.
Herramientas como ImageToTable.ai que utilizan la Extracción de Columnas Personalizadas — usted define los campos por nombre y la IA los ubica semánticamente en cualquier parte de la página — son especialmente adecuadas para la logística porque manejan múltiples formatos de transportistas con una sola configuración. Usted define columnas como «Número de contenedor», «Código SCAC», «Puerto de carga» y «Condiciones de flete», y la misma configuración funciona en un conocimiento de embarque (B/L) de Maersk, un conocimiento de embarque (B/L) de MSC y un comprobante de entrega (POD) de un transportista de camiones sin ajustes. Para equipos que procesan grandes volúmenes de documentos de carga mixtos, esta independencia del formato es el mayor impulsor del retorno de inversión en automatización. Si su evaluación abarca la combinación completa de documentos — conocimientos de embarque (B/L), facturas de flete, declaraciones de aduanas y listas de empaque juntos, no solo OCR en un único tipo de documento — nuestra guía del comprador de extracción de documentos logísticos cubre en profundidad los criterios de evaluación entre documentos.
La opción del complemento de Google Sheets también es relevante para equipos logísticos más pequeños o transitarios que gestionan datos de envíos en hojas de cálculo en lugar de un TMS dedicado. Al extraer datos de documentos de envío directamente en Google Sheets — números de contenedor junto con números de PO y cargos de flete — el complemento reemplaza la entrada manual en hojas de cálculo sin requerir una migración de sistema. Si su operación actualmente concilia datos de envíos en una hoja de cálculo, este enfoque ofrece el beneficio de la automatización dentro de la herramienta que su equipo ya utiliza.
Preguntas Frecuentes
¿Puede el OCR leer firmas manuscritas en documentos de comprobante de entrega?
Parcialmente. El OCR moderno impulsado por IA con modelos de visión-lenguaje puede leer escritura clara y de estilo impreso con una precisión del 75-90%, pero las firmas en cursiva y la escritura apresurada siguen siendo difíciles — la precisión cae al 60-75% en entradas desordenadas. Para comprobantes de entrega (POD) donde la firma manuscrita o la notación de daños es el registro legal, la mayoría de los flujos de trabajo logísticos tratan la extracción por OCR de estos campos como un paso de «revisión antes de usar» en lugar de automatización directa. El valor práctico del OCR en POD no es eliminar por completo la revisión humana — es reducir el tiempo necesario para localizar y verificar campos manuscritos de minutos a segundos.
¿Funciona el OCR con documentos de envío internacionales en varios idiomas?
Sí, las herramientas de OCR basadas en IA manejan documentos multilingües significativamente mejor que los motores de OCR tradicionales. Los modelos de visión-lenguaje entrenados con corpus de documentos multilingües procesan todos los alfabetos dentro de un solo modelo — no requieren configuración por idioma. Sin embargo, la precisión varía según el alfabeto. Los idiomas con alfabeto latino (inglés, francés, español, alemán) funcionan mejor. Los caracteres chinos, japoneses y coreanos presentan mayor dificultad de reconocimiento debido a la densidad de caracteres y la complejidad de los trazos, pero están dentro de la capacidad de los modelos de IA de generación actual. Siempre pruebe la herramienta con su combinación real de documentos en lugar de depender de puntos de referencia solo en inglés.
¿Cómo funciona la validación del número de contenedor en la extracción por OCR?
Los números de contenedor siguen el formato ISO 6346: cuatro letras de código de propietario, seis dígitos de serie y un dígito de control. Las herramientas avanzadas de OCR pueden validar el número de contenedor extraído contra el algoritmo de dígito de control ISO — el sistema confirma matemáticamente que el prefijo de nueve caracteres produce el décimo carácter de dígito de control. Esta validación detecta uno de los errores más comunes de entrada manual de datos en logística: un solo dígito transpuesto en un número de contenedor que normalmente tomaría días identificar. Si el número extraído no pasa la validación, la herramienta lo marca para revisión en lugar de pasar el error aguas abajo.
¿Cuál es la diferencia entre la extracción basada en plantillas y la extracción semántica de BOL?
La extracción basada en plantillas requiere definir las coordenadas y etiquetas de campo para el formato BOL de cada transportista. Cuando un transportista actualiza su diseño — o cuando agregas un nuevo transportista — la plantilla se rompe o debe configurarse desde cero. La extracción semántica lee el documento comprendiendo qué significa cada campo, no dónde está ubicado. Tú defines los campos que deseas (número de BOL, número de contenedor, puerto de carga) y la IA los encuentra en cualquier parte de la página. Esto significa que una configuración funciona con todos los formatos de transportistas y no requiere mantenimiento cuando un transportista cambia su diseño. Para operaciones logísticas que trabajan con múltiples transportistas, la extracción semántica es la diferencia práctica entre una automatización que escala y una que crea una nueva carga de mantenimiento.
¿Qué precisión tiene la extracción por IA en documentos logísticos en comparación con la entrada manual de datos?
En BOLs impresos limpios de transportistas importantes, la IA moderna alcanza una precisión del 90-99% a nivel de campo en campos estándar (remitente, consignatario, buque, puertos). En códigos logísticos específicos como SCAC y UN/LOCODE, la precisión en contenido impreso suele superar el 85%. El contenido manuscrito baja al 60-90% según la legibilidad. Estas cifras son favorables frente a la entrada manual de datos, que típicamente logra un 95-98% de precisión en campos rutinarios pero a una velocidad mucho menor — 10-15 minutos por documento frente a 5-10 segundos por documento con IA. La métrica clave es el rendimiento: la extracción por IA procesa 60-100 documentos en el tiempo que un operador manual procesa uno, lo que la hace adecuada para operaciones logísticas de alto volumen, incluso si se mantiene un paso de verificación humana para campos manuscritos.
¿Puedo exportar los datos extraídos de documentos de envío directamente a mi TMS o ERP?
La mayoría de las herramientas de extracción por IA ofrecen exportación a CSV o Excel como opción básica. Muchas también proporcionan acceso API para transferencia automatizada de datos a sistemas TMS y ERP. Algunas herramientas ofrecen integraciones directas con plataformas como CargoWise, SAP, Oracle, QuickBooks y Xero, o pueden canalizar datos a través de Zapier, Make o Power Automate. El formato de salida y el método de integración son criterios de selección críticos: si los datos de la herramienta de extracción requieren reformateo manual antes de ingresar a tus sistemas operativos, el beneficio de la automatización se reduce significativamente. Para flujos de trabajo basados en hojas de cálculo, las herramientas con un complemento de Google Sheets permiten insertar datos extraídos directamente en las hojas sin necesidad de exportaciones intermedias de archivos.
¿Qué INCOTERMS debería esperar encontrar en los documentos logísticos?
Las 11 reglas INCOTERMS 2020 se dividen en dos categorías. Para cualquier modo de transporte: EXW (En Fábrica), FCA (Franco Transportista), CPT (Transporte Pagado Hasta), CIP (Transporte y Seguro Pagados Hasta), DAP (Entregada en Lugar), DPU (Entregada en Lugar Descargada) y DDP (Entregada con Derechos Pagados). Para transporte marítimo y fluvial solamente: FAS (Franco al Costado del Buque), FOB (Franco a Bordo), CFR (Costo y Flete) y CIF (Costo, Seguro y Flete). Para envíos contenerizados, FCA o CIP suelen ser más apropiados que FOB o CIF, aunque FOB sigue siendo común — y a menudo incorrectamente — utilizado. Una herramienta de extracción competente debe reconocer los 11 términos y sus abreviaturas.
Ponga a trabajar la extracción de documentos de envío
Las operaciones logísticas no tienen el lujo de estandarizar la recepción de documentos. Los BOL llegan de 20 transportistas distintos en 20 formatos diferentes. Los POD regresan de los conductores con firmas manuscritas y notas al margen. Las notas de empaque, facturas de flete y declaraciones aduaneras añaden su propia complejidad de campos y requisitos de validación. La pregunta no es si puede eliminar todo el procesamiento manual — para algunos campos, especialmente las firmas manuscritas, la verificación humana sigue siendo el punto de control adecuado. La pregunta es si puede eliminar los 10 a 15 minutos por documento de ingreso manual de datos que actualmente consume el tiempo de su equipo sin agregar valor operativo.
El OCR moderno para logística — impulsado por extracción semántica con IA en lugar de reconocimiento de caracteres basado en plantillas — lo hace posible al comprender los documentos de envío como lo haría un profesional logístico: identificando el significado de cada campo, validándolo contra estándares de la industria y generándolo en el formato que sus sistemas posteriores esperan. Una sola configuración funciona con cualquier formato de transportista, cualquier idioma, cualquier tipo de documento.
Suba un B/L, POD o lista de empaque real y vea cómo se ve su flujo de documentos como datos estructurados, en segundos, no en minutos.
Pruébelo con su propio documento →No se requiere registro. Los archivos se procesan de forma segura.