OCR für die Logistik:
Automatisierung von BOL, POD & Versanddokumenten
Ein mittelgroßer Spediteur verarbeitet täglich 60–100 Frachtbriefe, über 80 Liefernachweise und Dutzende Frachtrechnungen und Packlisten. Bei 10–15 Minuten manueller Erfassung pro Dokument und Korrekturschleifen, die schneller wachsen als das Volumen, verbringen die meisten Logistikteams ihre Zeit mit Tippen – nicht mit dem Transport von Fracht. OCR für die Logistik ist der systematische Ansatz, um diesen Dokumentenstrom in strukturierte Daten zu verwandeln, die ein TMS, ERP oder eine Tabellenkalkulation speisen – ohne Wartung von Vorlagen pro Frachtführer oder manuelle Neueingabe.
Die wichtigsten Erkenntnisse
- 60 bis 100 Frachtbriefe pro Tag, 10 bis 15 Minuten pro Stück – ein Logistikschreibtisch verbringt 10 bis 15 Stunden mit Dateneingabe, bevor eine einzige Sendung verschickt wird.
- Die OCR, die Sie für Rechnungen einsetzen, scheitert an Logistikdokumenten, weil die Logistik Codesysteme verwendet – SCAC, UN/LOCODE, ISO 6346 – und keine natürliche Sprache; und ein Tool, das Rohtext
MAEUextrahiert, hat den Schritt der Zuordnung zu einem Spediteurnamen nicht automatisiert. - Semantische Extraktion liest Felder nach ihrer Bedeutung, nicht nach ihrer Position im Layout eines bestimmten Spediteurs – eine Konfiguration verarbeitet jedes BOL-Format, und das Hinzufügen eines neuen Spediteurs kostet null Stunden Vorlagenpflege.
Was „OCR für die Logistik" wirklich bedeutet – und wie es sich von allgemeiner Dokumenten-OCR unterscheidet
OCR für die Logistik ist die automatisierte Extraktion und Strukturierung von Daten aus den Dokumenttypen, die durch Lieferketten fließen: Frachtbriefe (B/L), Liefernachweise (POD), Packlisten, Zollanmeldungen und Frachtrechnungen. Das Ziel ist nicht nur, diese Dokumente in durchsuchbaren Text zu digitalisieren – es geht darum, feldspezifische strukturierte Daten (Containernummern, SCAC-Codes, HS-Codes, Frachtbedingungen, Hafencodes, Mengen, Gebühren) zu erzeugen, die direkt in ein TMS, ERP, WMS oder eine Tabellenkalkulation fließen können.
Diese Unterscheidung ist wichtig, weil ein allgemeines OCR-Tool jedes Dokument als „Text auf einer Seite" behandelt. Es erkennt Zeichen, weiß aber nicht, dass COSU8102804 eine Containernummer ist (mit der Prüfziffer 4 gemäß ISO-6346-Regeln) oder dass NL RTM der Hafen von Rotterdam als UN/LOCODE ist. Logistikdokumente enthalten branchenspezifische Codes und Feldbeziehungen, die generische OCR-Engines beim Training nie gelernt haben. Ein Tool, das für die Rechnungsextraktion optimiert ist, übersieht SCAC-Codes und Containerpräfixe, weil seine Trainingsdaten – AP-Rechnungen – diese nie enthalten haben, wie unser Vergleich von Logistik-Extraktionstools feststellte, als AP-trainierte Tools bei logistikspezifischen Feldern unter 60 % fielen.
In der Praxis bedeutet das, dass OCR für die Logistik sowohl semantisches Verständnis (die Fähigkeit, ein Feld nach seiner Bedeutung zu identifizieren, nicht nach seiner Position auf der Seite) als auch domänenspezifisches Code-Wissen (die Fähigkeit, Ausgaben gegen die Standards zu validieren und zu normalisieren, die Logistiksysteme erwarten) erfordert. Für einen tieferen Einblick, wie sich semantische Extraktion von traditioneller Zeichenerkennung unterscheidet, lesen Sie unseren Leitfaden zu was KI-OCR ist und wie es funktioniert.
Warum die Logistik OCR benötigt: Der quantitative Beleg
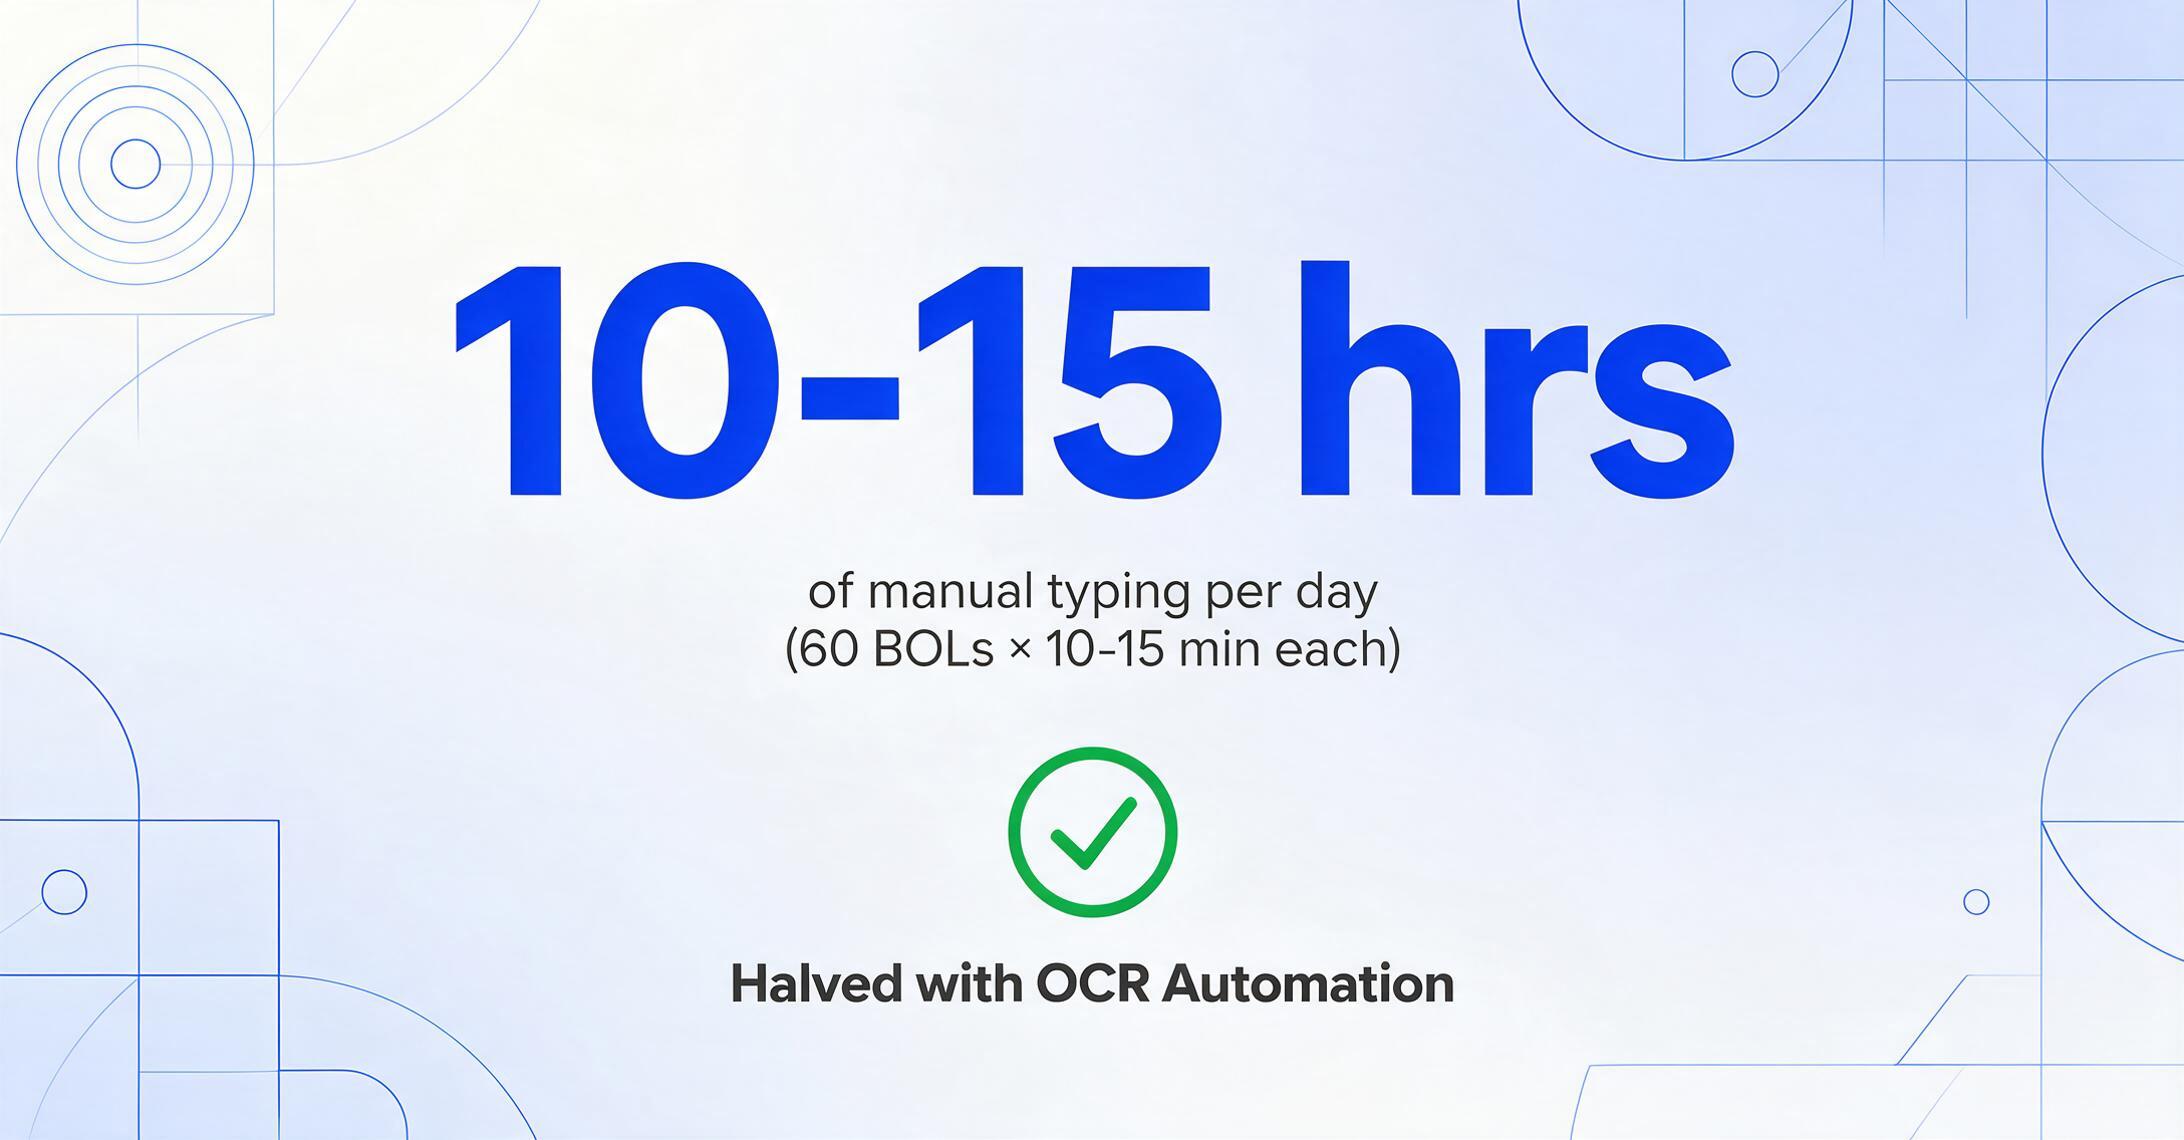
Das Ausmaß der Dokumentenverarbeitung in der Logistik ist Teams außerhalb des Betriebs selten sichtbar. Ein Speditionsschreibtisch, der 50-80 Sendungen pro Tag abwickelt, erhält die Dokumentation jeder Sendung als separates PDF oder Bild – oft von einem anderen Frachtführer oder Spediteur mit einem eigenen Format. Bei einem geschätzten Zeitaufwand von 10-15 Minuten pro Dokument für die manuelle Dateneingabe verbringt ein Spediteur, der 60 Frachtbriefe (B/L) pro Tag verarbeitet, täglich 10 bis 15 Stunden allein mit dem Abtippen – noch bevor Liefernachweise (POD) geprüft, Frachtrechnungen abgeglichen und Zollanmeldungen vorbereitet werden.
Diese Zeitkosten werden durch Fehlerquoten noch verstärkt. Studien zur manuellen Dateneingabe in Logistikabläufen finden durchgängig Fehlerquoten zwischen 2% und 5% bei Routinefeldern – und höhere bei handschriftlichen Einträgen. Bei einem Frachtbrief (B/L) mit 15-20 extrahierbaren Feldern bedeutet eine Fehlerquote von 3% etwa einen Fehler in jedem zweiten Dokument. In der Logistik kann eine einzige falsche HS-Code-Ziffer einen Zollstopp auslösen. Eine falsch getippte Containernummer kann eine Sendung tagelang in der Sendungsverfolgung verschwinden lassen. Eine vertauschte Gewichtsangabe kann eine Frachtrückbelastung erzeugen, deren Klärung Wochen dauert.
Für Logistikteams mit hohem Volumen ist das Geschäftsargument für OCR-Automatisierung nicht theoretisch. Es hat sich gezeigt, dass die Automatisierung der Dateneingabe von Frachtbriefen (B/L) und Frachtrechnungen die Verarbeitungszeit um mehr als die Hälfte reduziert und gleichzeitig die Fehlerquoten senkt – sodass sich Mitarbeiter der Dateneingabe auf die Bearbeitung von Ausnahmen und den Kundenservice konzentrieren können, statt sich mit repetitivem Abtippen zu beschäftigen.
Die fünf Logistikdokumenttypen, die OCR benötigen
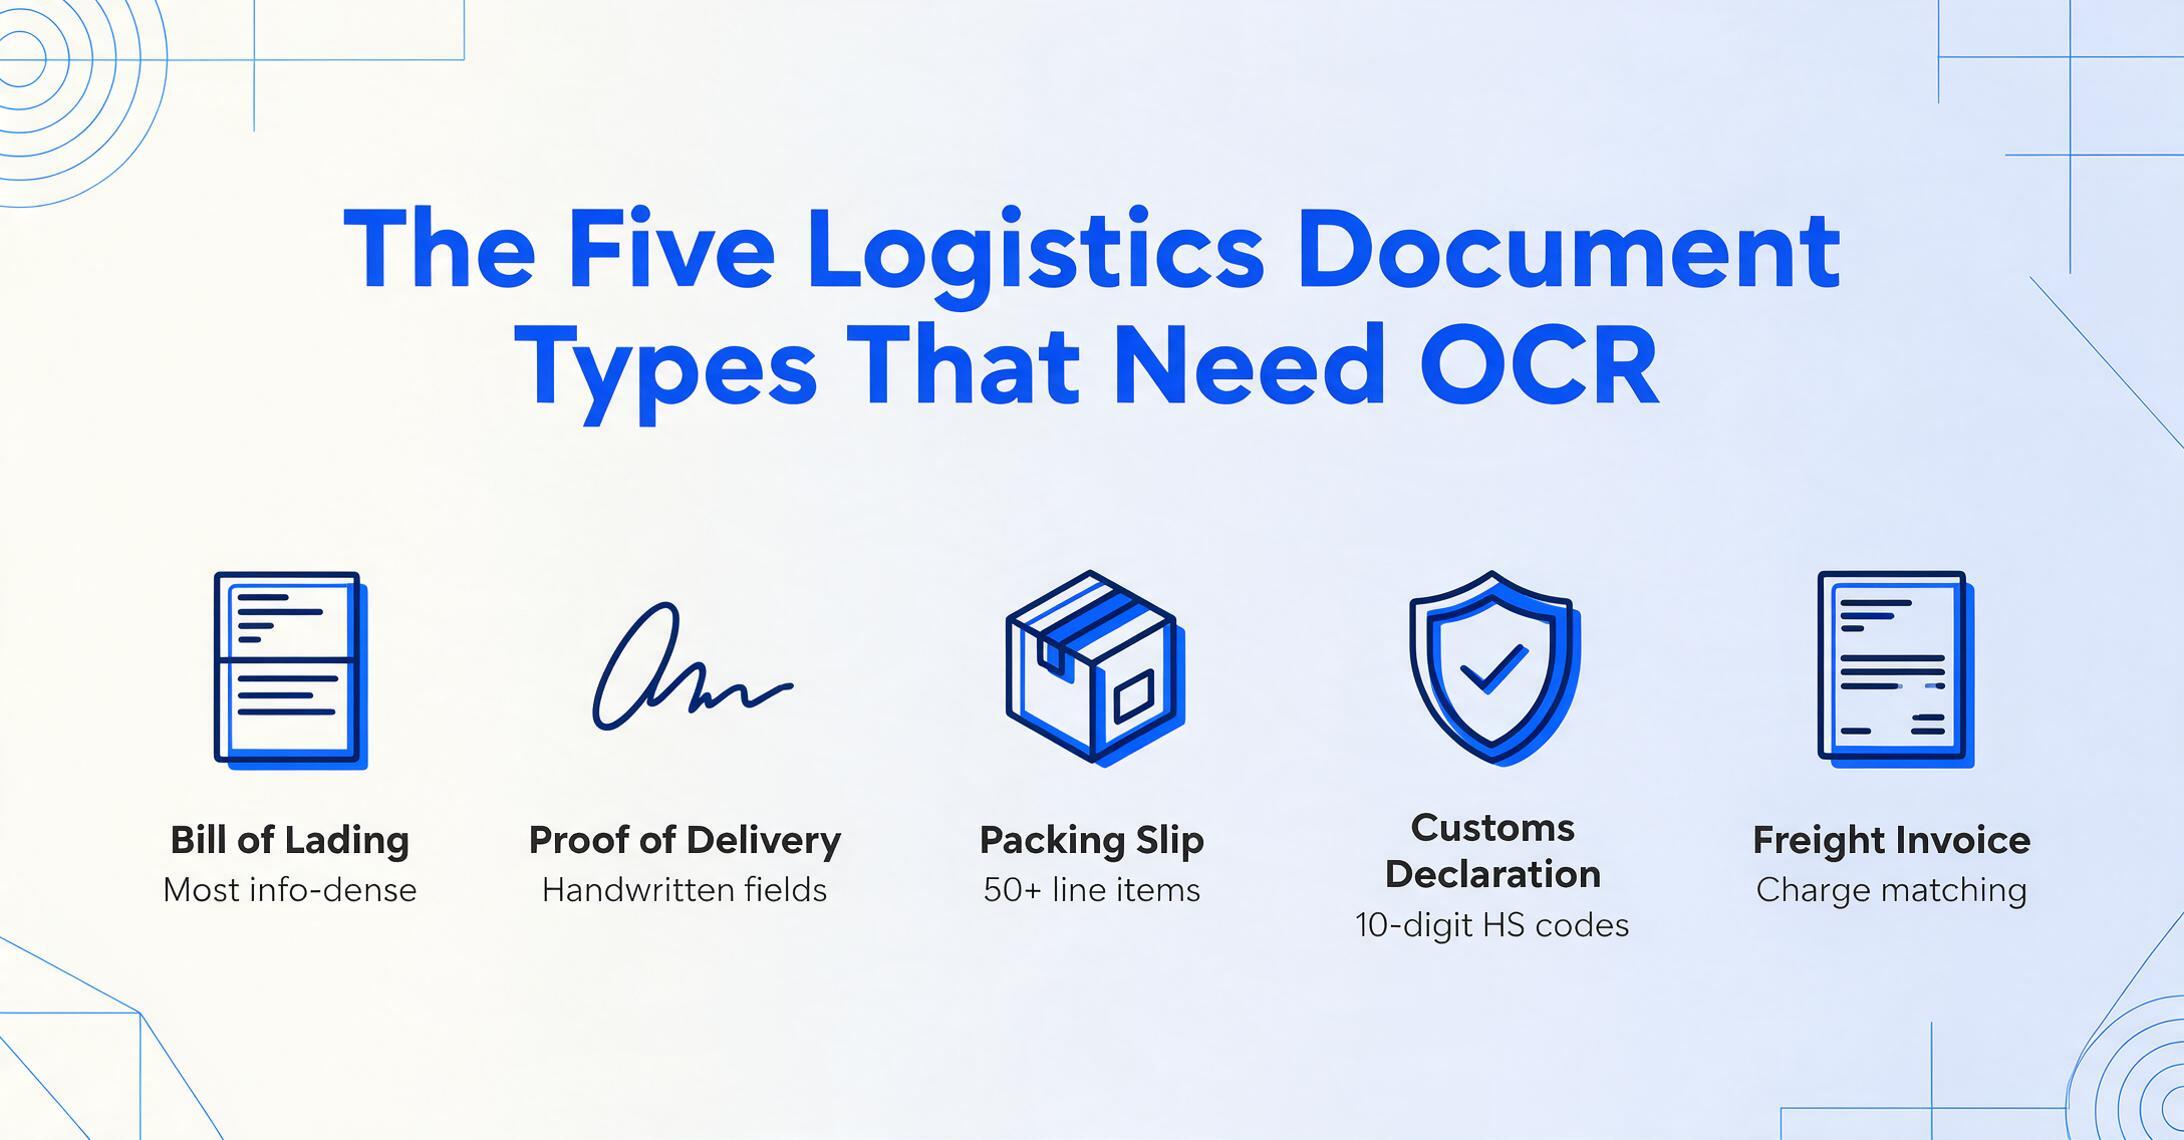
Logistikbetriebe verarbeiten nicht nur einen Dokumenttyp. Sie verarbeiten einen gemischten Strom aus mindestens fünf Typen, jeweils mit eigenem Feldsatz, rechtlicher Funktion und Extraktionsherausforderung. Hier ist, wie OCR auf jeden davon angewendet wird.
1. Frachtbrief (B/L)
Der Frachtbrief ist das informationsdichteste Dokument in der Logistik. Er dient als Empfangsbestätigung, Beförderungsvertrag und Traditionspapier – wer das Original besitzt, kann die Ware beanspruchen. Ein einzelner Seefrachtbrief kann den Versender und die EORI-Nummer, den Empfänger, die Notifyadresse, den Schiffsnamen und die Reisenummer, den Verladehafen und den Entladehafen (jeweils als UN/LOCODE ausgedrückt), Containernummern (ISO-6346-Format mit Prüfziffern), Siegelnummern, Warenbeschreibungen, Brutto- und Nettogewichte, Packstückzahlen, Frachtbedingungen (vorausbezahlt oder unfrei), die Incoterms-Regel (FOB, CIF, FCA usw.) und oft mehrere Positionen mit HS-Codes enthalten. Die Feldpositionen variieren je nach Frachtführer – Maersk platziert die Containernummer im oberen rechten Quadranten; MSC setzt sie mittig unter den Schiffsnamen. Ein Hausfrachtbrief kann eine Masterfrachtbriefnummer referenzieren, die ein Namensfrachtbrief nicht führt. Eine vollständige Aufschlüsselung dieses Dokumenttyps finden Sie in unserem speziellen Leitfaden zur Frachtbrief-Datenextraktion. Um B/L-Felder in Sekundenschnelle in eine Tabelle zu extrahieren – ohne Einrichtung pro Frachtführer – nutzen Sie das Frachtbrief-zu-Excel-Tool.
2. Liefernachweis (POD)
Der POD ist das Abschlussdokument des Versandzyklus: Er bestätigt, dass die Ware angekommen ist, in welchem Zustand und von wem sie angenommen wurde. Die Herausforderung bei der Extraktion besteht darin, dass die wichtigsten Felder eines POD am wenigsten maschinenlesbar sind. Zustellunterschriften sind handschriftlich – oft ein schneller Krakel, den selbst ein menschlicher Leser nur schwer entziffern könnte. Zustellzeitstempel können vom Fahrer handschriftlich eingetragen werden. Schadensvermerke („1 Karton zerquetscht – verweigert“), Teilmengenangaben („47 von 50 erhalten“) und Stempel für Verspätungen sind typischerweise handschriftlich an den Rändern. Die besten Handschrift-OCR-Tools im Jahr 2026 verarbeiten saubere Druckschrift mit 85–95 % Genauigkeit, aber kursiv geschriebene Unterschriften und Randnotizen bleiben für die meisten Logistik-Workflows eine Ebene der menschlichen Überprüfung. Semantische KI-Extraktion mildert dies teilweise: Ein Modell, das die Dokumentstruktur versteht, kann den Prüfer zumindest an die richtige Stelle auf der Seite führen, statt ihn jedes Feld genau prüfen zu lassen.
3. Packliste
Packlisten begleiten jede Sendung und listen auf, was sich in jedem Karton oder auf jeder Palette befindet: Warenbeschreibungen, SKU-Codes, Mengen, Chargen- oder Losnummern und manchmal HS-Codes sowie Ursprungslandkennzeichnungen. Der Extraktionswert von Packlisten liegt in der Effizienz beim Wareneingang: automatischer Abgleich der empfangenen Mengen mit der Bestellung, frühzeitige Kennzeichnung von Teillieferungen bevor die Lieferantenrechnung eintrifft, und Einspeisung ins WMS ohne manuelle Erfassung auf Artikelebene. Packlisten sind im Layout meist einfacher als Frachtbriefe (B/L), weisen aber eine höhere Positionsdichte auf – eine einzelne Liste kann 50+ SKUs enthalten, und jede Position muss für die Bestandsabstimmung korrekt erfasst werden. Vorlagenbasierte OCR scheitert hier, weil jeder 3PL und Lieferant die Liste anders formatiert. Semantische Extraktion, die Felder nach Bedeutung statt nach Koordinatenposition liest, kommt mit dieser Variabilität von Natur aus zurecht.
4. Zollanmeldung
Zollanmeldungen – das Einheitspapier (SAD) in der EU, das CBP-Formular 3461 in den USA, die CDS-Anmeldung im Vereinigten Königreich – sind der Bereich, in dem Extraktionsgenauigkeit direkt mit rechtlicher Compliance verknüpft ist. Jedes Feld einer Zollanmeldung entspricht einem regulatorischen Datenelement: Der HS-Code bestimmt den Zollsatz, das Ursprungsland bestimmt die Anspruchsberechtigung für Handelsabkommen, der erklärte Wert bestimmt die Bemessungsgrundlage für Mehrwertsteuer und Zollabgaben. Eine einzige falsche Ziffer in einem HS-Code kann zu Zollüberzahlung oder – bei kontrollierten Gütern – zu Sendungsbeschlagnahmung und Strafen führen. Zollanmeldungen integrieren auch Daten aus anderen Dokumenten dieser Liste – der Frachtbrief (B/L) liefert die Transportdetails, die Handelsrechnung den Wert, die Packliste die Positionsmengen – was die Konsistenz über Dokumente hinweg zu einer zentralen Validierungsanforderung macht. OCR für Zolldokumente muss daher mit höheren Konfidenzschwellen arbeiten als die allgemeine Extraktion.
5. Frachtrechnung
Die Frachtrechnung ist das finanzielle Abstimmungsdokument der Logistik. Sie listet die Kosten einer Sendung auf: Basisfrachtsatz, Treibstoffzuschlag (oft 10–25 % der Gesamtsumme), Nebengebühren (Ladebordwand, Innenzustellung, Wohngebietszuschlag), Standgeld- oder Liegegeldgebühren sowie etwaige ausgehandelte Rabatte. Der manuelle Prüfaufwand für diese Rechnungen ist erheblich – eine einzelne Überforderung kann 50–200 $ betragen, und in großem Umfang kann systematische Überabrechnung jährlich Zehntausende kosten. Die automatisierte Frachtrechnungsextraktion ermöglicht es AP-Teams, abgerechnete Beträge mit vertraglich vereinbarten Tarifen abzugleichen, Abweichungen bei Zuschlägen zu kennzeichnen und Ausnahmen zur Prüfung weiterzuleiten, ohne Gebührenpositionen manuell in eine Tabellenkalkulation einzutippen. Die besondere Herausforderung bei der Extraktion von Frachtrechnungen liegt in der Vielfalt der Gebührencodes und Abkürzungen (oft frachtführerspezifisch), die dieselbe Leistung bei verschiedenen Frachtführern unterschiedlich beschreiben.
Was Logistikdokumente für OCR besonders schwierig macht
Logistikdokumente sind nicht einfach „Rechnungen mit anderen Feldern“. Sie stellen eine Reihe struktureller Herausforderungen dar, für die herkömmliche OCR – und selbst viele allgemeine KI-Extraktionstools – nicht ausgelegt waren.
Proprietäre Codesysteme, die Fachwissen erfordern
Logistik arbeitet mit Codes, nicht mit natürlicher Sprache. Ein Frachtbrief (B/L) sagt nicht „der Frachtführer ist Maersk Line“; er sagt MAEU – der SCAC-Code des Frachtführers. Häfen werden nicht als „Rotterdam, Niederlande“ geschrieben; sie erscheinen als NL RTM, der von der UNECE vergebene fünfstellige UN/LOCODE. Containernummern folgen ISO 6346: vier Buchstaben des Eigentümercodes (z. B. MSCU), sechs Serienziffern und eine Prüfziffer, die mathematisch validiert werden kann. HS-Codes sind 6- bis 10-stellige Warenklassifikationen, die von der Weltzollorganisation gepflegt werden. Ein OCR-System, das diese Codestrukturen nicht erkennt, liefert Rohtext, der vor der Verwendung manuell neu codiert werden muss. Ein System, das sie erkennt, kann Ausgaben validieren – beispielsweise bestätigen, dass eine extrahierte Containernummer die ISO-6346-Prüfziffernberechnung besteht – und so den nachgelagerten Verifizierungsaufwand erheblich reduzieren.
Handschriftliche POD-Unterschriften und Randnotizen
Die Dokumente mit dem höchsten operativen Wert – die Liefernachweise – enthalten auch am wenigsten maschinenlesbaren Inhalt. Fahrer unterschreiben mit handschriftlichen Kritzeleien. Empfänger notieren Lieferausnahmen an den Rändern. Zeitstempel werden von Hand eingetragen. Für den Frachtführer sind diese handschriftlichen Felder der rechtliche Nachweis von Lieferung und Zustand. Für das OCR-System stellen sie das schwierigste Extraktionsszenario dar: variables Schriftbild im zweidimensionalen Raum ohne feste Feldgrenzen. Herkömmliche OCR fällt bei unordentlichen POD-Anmerkungen unter 50 % Genauigkeit. Moderne KI-Extraktion mit Vision-Language-Modellen schneidet besser ab und erreicht 75–90 % bei sauberer Handschrift und 60–75 % bei Schreibschrift, aber das sind keine Durchlaufzahlen – die menschliche Überprüfung handschriftlicher Felder bleibt für die meisten Logistik-Workflows ein notwendiger Kontrollpunkt.
Mehrsprachige Dokumente und Dokumente mit mehreren Zeichensätzen
Internationale Logistik bedeutet internationale Dokumente. Eine Sendung von Shanghai nach Hamburg erzeugt Unterlagen, die chinesische Schriftzeichen (货物描述), Deutsch (Gefahrgutklasse) und Englisch enthalten können – manchmal auf derselben Seite. Zollanmeldungen in Thailand verwenden die thailändische Schrift. Japanische Häfen erscheinen in Kanji. Lateinamerikanische Frachtbriefe mischen oft Spanisch und Englisch. Herkömmliche OCR-Engines sind sprachspezifisch: Sie werden für Englisch oder Deutsch konfiguriert, und die Erkennungsgenauigkeit nimmt außerhalb des konfigurierten Sprachsatzes ab. KI-Vision-Modelle, die mit mehrsprachigen Dokumentkorpora trainiert wurden, gehen damit besser um, weil sie visuelle Muster und nicht Zeichensätze verarbeiten, aber die Genauigkeit variiert je nach Schrift weiterhin erheblich. Eine Logistik-OCR-Lösung für den globalen Einsatz sollte nicht nur anhand der englischen Genauigkeit bewertet werden, sondern anhand ihrer Leistung über den Sprachmix hinweg, dem der Betrieb tatsächlich begegnet.
Variable Frachtführerformate ohne Standardisierung
Es gibt keine standardisierte Vorlage für einen Frachtbrief. Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE und Evergreen – die sieben größten Seefrachtführer – verwenden jeweils ein anderes Layout. Die Feldplatzierung variiert zwischen den Frachtführern, zwischen Masterfrachtbrief und Hausfrachtbrief und manchmal zwischen der elektronischen und der Papierfassung desselben Frachtführers. Luftfrachtbriefe von FedEx Express sehen völlig anders aus als DHL-Express-Dokumente – für die Luftfrachtextraktion im Speziellen siehe unser Tool für Luftfrachtbriefe (AWB) nach Excel. Die PODs von LKW-Frachtführern reichen von mehrseitigen Farbformularen bis zu thermisch bedruckten Einzelblättern mit handschriftlichen Ergänzungen. Vorlagenbasierte OCR erfordert eine separate Konfiguration für jede Variante – ein Wartungsaufwand, der mit jeder neuen Frachtführerbeziehung wächst. Semantische KI-Extraktion, die Felder nach Bedeutung statt nach Koordinaten lokalisiert, verarbeitet alle Varianten mit einer einzigen Konfiguration. Dies ist der Kernunterschied zwischen herkömmlicher OCR und moderner KI-Extraktion für die Logistik.
Incoterms und Variabilität der Handelsklauseln
Die Incoterms 2020, herausgegeben von der Internationalen Handelskammer, definieren 11 Handelsklauseln – von EXW (ab Werk) bis DDP (geliefert verzollt) – die den Gefahrenübergang, die Kostenverteilung und die Versicherungspflichten für jede Sendung festlegen. Ein einzelner Frachtbrief (B/L) kann die Incoterm als „CIF Shanghai" ausweisen, während andere Dokumente derselben Sendung „CIF" in den Vertragsbedingungen anders referenzieren. Das Extrahieren der Incoterm ist für die meisten OCR-Tools unkompliziert; sie zu interpretieren – zu verstehen, dass FOB nur für Seefracht gilt, während FCA für jede Transportart gilt – erfordert Domänenlogik, die eine allgemeine Extraktion nicht bietet.
Legacy-OCR vs. moderne KI-Extraktion für die Logistik
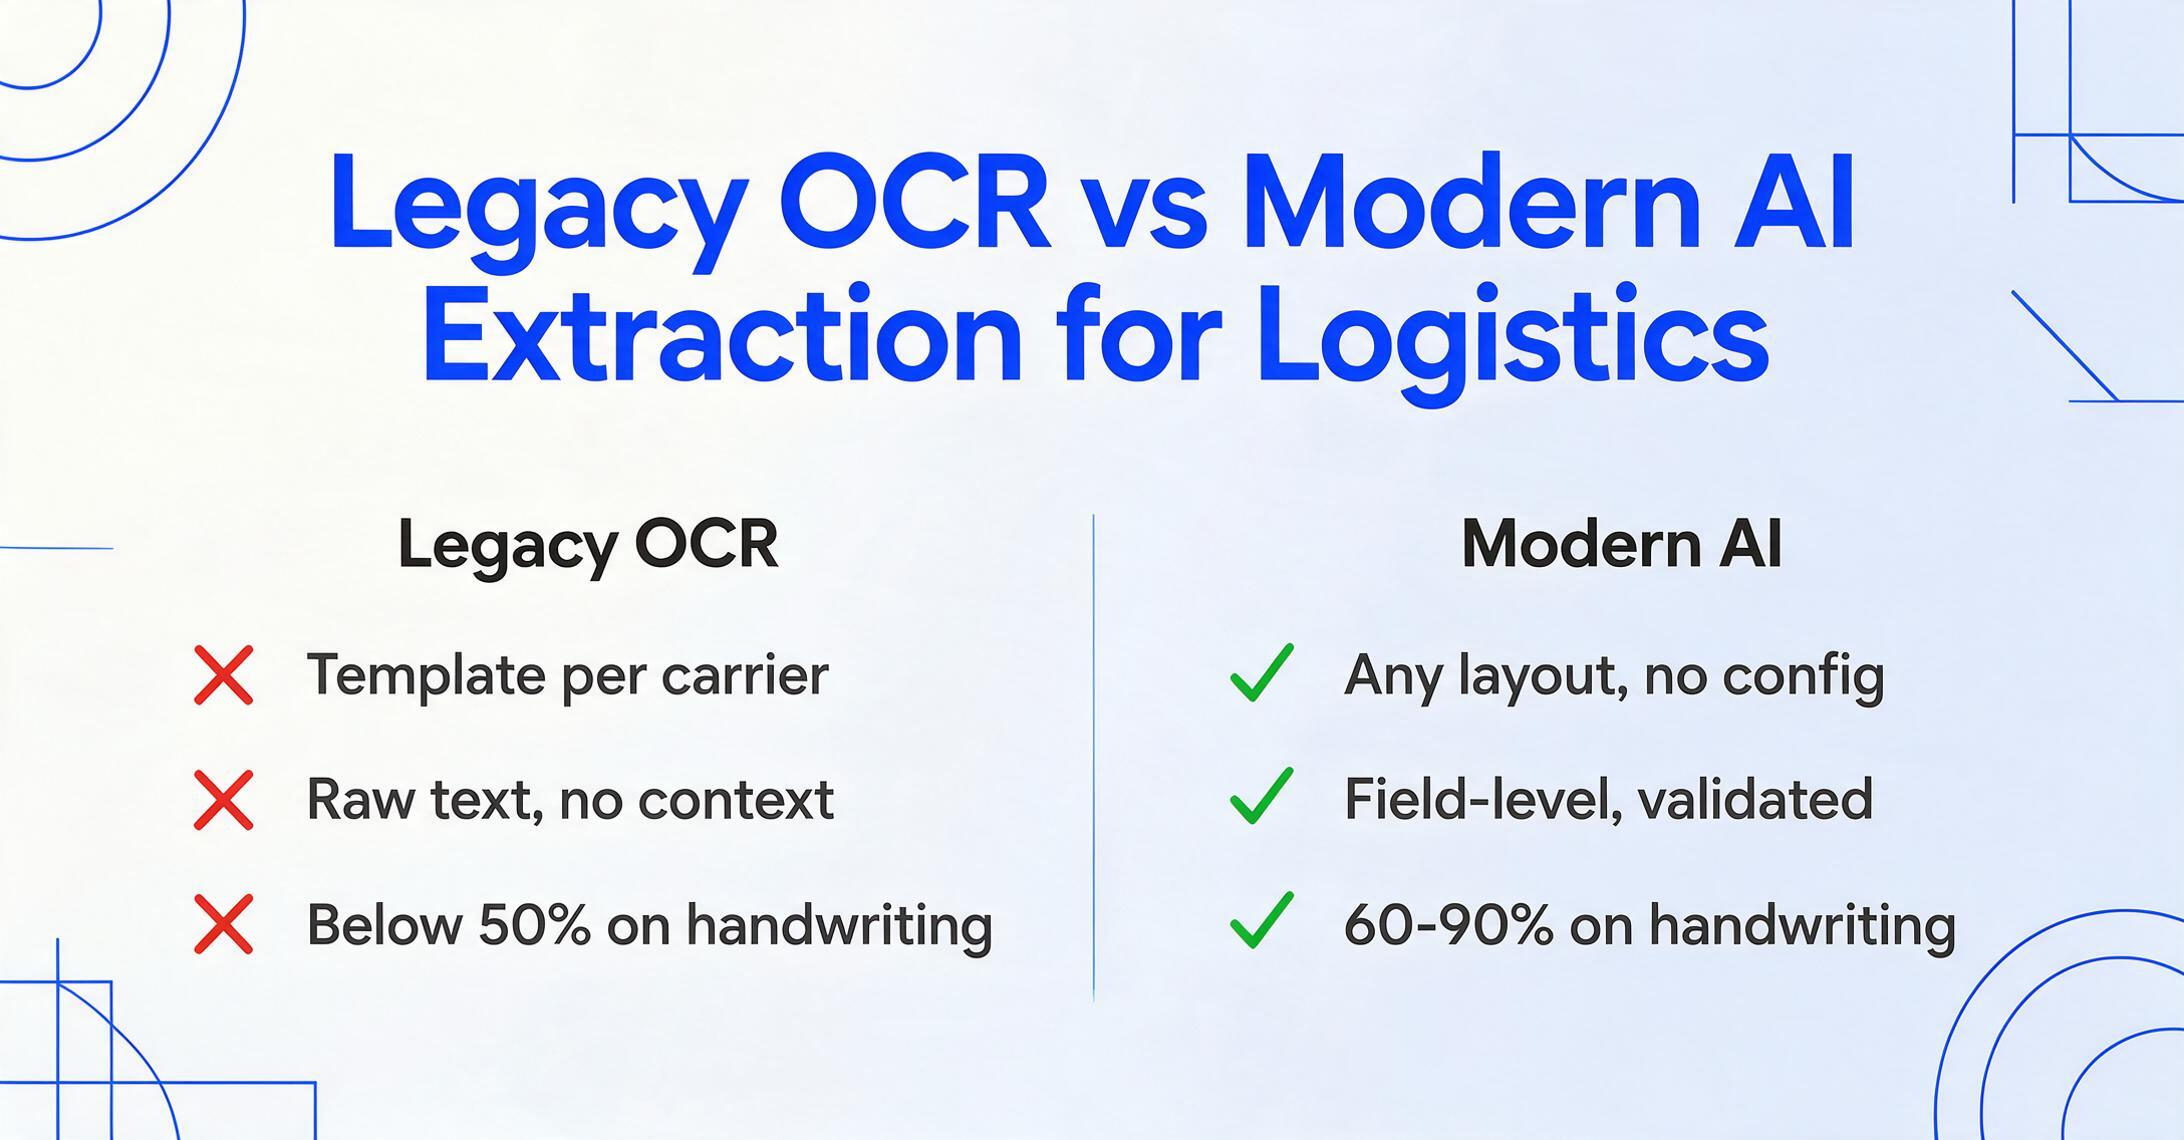
Der Unterschied zwischen traditioneller OCR und moderner KI-Extraktion ist keine schrittweise Verbesserung – es ist ein anderer Ansatz zum Lesen von Dokumenten. Hier ist ein Vergleich der beiden Ansätze in den Dimensionen, die für die Logistik relevant sind.
| Dimension | Traditionelle OCR | KI-Vision-Language-Extraktion |
|---|---|---|
| Art des Lesens | Zeichen für Zeichen, Zeile für Zeile | Ganzheitlich – verarbeitet die Seite als Bild und versteht das Layout |
| Umgang mit Speditionsformaten | Benötigt pro Format eine Vorlage oder Zonenkonfiguration | Liest jedes Layout; keine Konfiguration pro Spediteur erforderlich |
| Code-Erkennung | Gibt Rohtext aus (z. B. „MAEU") ohne Kontext | Identifiziert den Feldtyp; kann das Format validieren (z. B. SCAC = 2–4 Buchstaben) |
| Handschrift-Toleranz | Unter 50 % bei unleserlichen POD-Anmerkungen | 60–90 % je nach Lesbarkeit; erfordert dennoch menschliche Überprüfung |
| Mehrsprachigkeit | Sprachspezifisch; nimmt außerhalb des konfigurierten Satzes ab | Standardmäßig mehrsprachig; verarbeitet Dokumente mit gemischten Schriften |
| Feldspezifische Ausgabe | Erzeugt einen Textblock; Felder müssen manuell identifiziert werden | Ordnet extrahierte Werte benutzerdefinierten oder KI-identifizierten Feldern zu |
| Einrichtungszeit | Stunden oder Tage für die Konfiguration von Vorlagen pro Spediteur | Minuten; Dokument hochladen und definieren, was Sie benötigen |
Die obige Tabelle macht den Fall deutlich: Für Logistikabläufe, die mit mehreren Spediteuren, mehreren Dokumenttypen und einer Mischung aus gedruckten und handschriftlichen Inhalten arbeiten, erfordert die traditionelle OCR eine Wartung pro Format, die den ROI der Automatisierung schmälert. KI-Vision-Language-Modelle, die Dokumente semantisch verarbeiten, bewältigen die Variabilität beim Lesen und nicht bei der Konfiguration. Für einen tieferen Vergleich dieser beiden technologischen Ansätze lesen Sie unseren Artikel über KI-OCR versus traditionelle OCR.
Wichtige Felder bei der Logistikdokumentextraktion
Nachfolgend finden Sie eine Aufschlüsselung der Felder, die jeder Logistikdokumenttyp zum Datenfluss beiträgt. Die zu extrahierenden Felder hängen von Ihrem Workflow ab – ein Betriebsteam benötigt Sendungsverfolgungsdaten, während ein AP-Team Gebührendetails benötigt. Das Verständnis der vollständigen Feldübersicht hilft jedoch bei der Tool-Bewertung.
| Dokumenttyp | Wichtige extrahierbare Felder | Besondere Herausforderungen |
|---|---|---|
| Konnossement | BOL-Nummer, Versender, Empfänger, Benachrichtigungspartei, Schiffsname, Reisenummer, Verladehafen, Löschhafen, Containernummern (ISO 6346), Plombennummern, Frachtbeschreibung, HS-Codes, Brutto-/Nettogewicht, Packstücke, Frachtbedingungen, INCOTERM | Felder variieren je nach Spediteur; Unterschiede zwischen Haus- und Master-Konnossement; SCAC-Code-Extraktion; mehrzeilige Frachtbeschreibungen; Prüfziffernvalidierung für Container |
| Liefernachweis | Lieferdatum/-uhrzeit, Empfängername, Unterschriftsbild, Lieferstatus, Schadensvermerke, Teilmenge, POD-Referenznummer, Spediteurname | Handschriftliche Unterschriften und Randnotizen; variable Dokumentqualität (Thermopapier verblasst); nicht standardisierte Zeitstempelformate |
| Packliste | Packlistennummer, Bestellnummer, Versender/Empfänger, Artikelbeschreibungen, SKU-Codes, Mengen pro SKU, Maßeinheit, Chargen-/Losnummern, Gesamtkartons, Bruttogewicht, HS-Codes (bei Exporten) | Hohe Positionsdichte (50+ Zeilen); inkonsistente Spaltenreihenfolge bei Lieferanten; gedruckte vs. handschriftliche Mengenkorrekturen |
| Zollanmeldung | Anmeldenummer, Anmelder-EORI, Exporteur-/Importeurdetails, HS-Code (10-stellig für EU/US), Ursprungsland, Warenwert, Währung, Brutto-/Nettogewicht, Transportart, Containernummern, Rechnungsreferenzen | Erforderliche behördliche Validierung (HS-Code-Struktur, Ländercode ISO 3166); mehrseitige Anmeldungen; erforderliche dokumentenübergreifende Konsistenzprüfungen; hohe Fehlerkosten |
| Frachtrechnung | Rechnungsnummer, Spediteurname, SCAC-Code, PRO-Nummer, BOL-Referenz, Grundfracht, Treibstoffzuschlag, Nebengebühren, Gesamtbetrag, Zahlungsbedingungen, NMFC-Klasse (LTL) | Spediteurspezifische Gebührencodes für dieselbe Leistung; unterschiedliche Treibstoffzuschlagsformeln; abweichende Berechnung von Liegegeldern je Vertrag; Rückbelastungsrisiko bei falschen Beträgen |
Der Praxistest für jedes Extraktionstool: Kann es ein BOL von Maersk und ein MSC-BOL mit derselben Konfiguration verarbeiten und beide Containernummern feldspezifisch korrekt extrahieren? Wenn nicht, erfordert das Tool eine Wartung pro Spediteur, und die Stückkosten der Extraktion sinken nicht, wenn Sie weitere Spediteure hinzufügen.
Compliance und regulatorische Anforderungen
Die Extraktion von Logistikdokumenten ist nicht nur eine Frage der Effizienz – sie berührt an mehreren Stellen regulatorische Pflichten. Diese Compliance-Implikationen sind bei der Bewertung von Tools wichtig, da nicht alle Extraktions-Workflows das gleiche Maß an Validierungsstrenge erfordern.
UCP 600 und Akkreditive. Artikel 20 der Einheitlichen Richtlinien und Gebräuche für Dokumenten-Akkreditive (UCP 600) regelt Frachtbriefe, die unter Akkreditiven vorgelegt werden. Eine Abweichung zwischen den B/L-Daten und den Kreditbedingungen – die Warenbeschreibung, der Verlade- oder Entladehafen, das Datum der „an Bord“-Vermerkung oder der Name des Empfängers – kann eine Bankablehnung auslösen und die Zahlung um Wochen verzögern. Für Exporteure, die Akkreditive (L/C) als Zahlungsmechanismus nutzen, muss das OCR-Tool eine feldbezogene Validierung gegen vordefinierte Regeln unterstützen, nicht nur eine Massentextextraktion. KI-Tools, die B/L-Daten gegen L/C-Bedingungen validieren können, identifizieren potenzielle Abweichungen, bevor Dokumente der Bank vorgelegt werden.
US-Zoll- und Grenzschutzbehörde (CBP). Für Sendungen in die Vereinigten Staaten verlangt die Automated Commercial Environment (ACE) der CBP bestimmte Datenelemente: die Importeur-Registriernummer, den HS-Code auf 10-stelliger HTSUS-Ebene, das Ursprungsland (ISO 3166 alpha-2), den angegebenen Wert in USD und die Frachtbriefnummer. Jedes Feld hat ein definiertes Format und einen zulässigen Wertebereich. Eine OCR-Lösung, die diese Felder ohne Formatvalidierung extrahiert, verlagert die Validierungslast auf den Zollagenten.
ISO-Normen. Die Codesysteme der Logistikbranche unterliegen internationalen Normen mit definierten Validierungsregeln. Containernummern können gegen den ISO-6346-Prüfziffernalgorithmus verifiziert werden. UN/LOCODEs können gegen die UNECE-Masterdatei geprüft werden. SCAC-Codes können gegen das NMFTA-Register bestätigt werden. Ein Extraktionstool, das diese Validierungen zum Zeitpunkt der Extraktion durchführt – und eine Containernummer mit ungültiger Prüfziffer kennzeichnet, bevor sie in das TMS gelangt – eliminiert eine erhebliche nachgelagerte Fehlerkorrekturschleife.
Exportkontrollen. Für Sendungen kontrollierter Güter (ITAR, EAR) bestimmen die Warenbeschreibung und die HS-Code-Klassifizierung, ob eine Exportlizenz erforderlich ist. OCR-Systeme, die diese Felder extrahieren, können automatisierte Compliance-Prüfungen auslösen und so das Risiko verringern, kontrollierte Güter ohne die erforderliche Genehmigung zu versenden.
Für eine breitere Perspektive, wie Dokumentenextraktion in den finanziellen Bereich von Logistikabläufen passt, lesen Sie unseren Leitfaden zu KI-Dateneingabe für Buchhaltungsteams – die Prinzipien der automatisierten Datenvalidierung gelten gleichermaßen für die Verarbeitung von Frachtrechnungen und die Zollwertbestimmung.
So wählen Sie das richtige Logistik-OCR-Tool
Jeder Logistikbetrieb ist einzigartig in Bezug auf die Spediteursmischung, das Dokumentvolumen und die nachgelagerte Systemlandschaft. Der folgende Rahmen hilft Ihnen, Tools anhand der Dimensionen zu bewerten, die tatsächlich Logistikabläufe beeinflussen – nicht anhand generischer Funktions-Checklisten.
Tools wie ImageToTable.ai, die Benutzerdefinierte Spaltenextraktion verwenden – Sie definieren die Felder per Name, und die KI lokalisiert sie semantisch überall auf der Seite – eignen sich besonders gut für die Logistik, da sie mehrere Spediteursformate mit einer einzigen Einrichtung verarbeiten. Sie definieren Spalten wie „Containernummer“, „SCAC-Code“, „Verladehafen“ und „Frachtbedingungen“, und dieselbe Konfiguration funktioniert ohne Anpassung für einen Maersk-Frachtbrief (B/L), einen MSC-Frachtbrief (B/L) und einen Liefernachweis (POD) eines LKW-Spediteurs. Für Teams, die große Mengen gemischter Frachtdokumente verarbeiten, ist diese Formatunabhängigkeit der größte Treiber für den Automatisierungs-ROI. Wenn Ihre Bewertung die gesamte Dokumentmischung umfasst – Frachtbriefe (B/L), Frachtrechnungen, Zollanmeldungen und Packlisten zusammen, nicht nur OCR für einen einzelnen Dokumenttyp – behandelt unser Einkaufsführer für Logistikdokumentextraktion die dokumentübergreifenden Bewertungskriterien ausführlich.
Die Google-Sheets-Add-on-Option ist auch für kleinere Logistikteams oder Spediteure relevant, die Sendungsdaten in Tabellenkalkulationen statt in einem dedizierten TMS verwalten. Durch die direkte Extraktion von Versanddokumentdaten in Google Sheets – Containernummern neben Bestellnummern und Frachtkosten – ersetzt das Add-on die manuelle Tabelleneingabe, ohne dass eine Systemmigration erforderlich ist. Wenn Ihr Betrieb Sendungsdaten derzeit in einer Tabellenkalkulation abgleicht, bietet dieser Ansatz den Vorteil der Automatisierung innerhalb des Tools, das Ihr Team bereits nutzt.
Häufig gestellte Fragen
Kann OCR handschriftliche Unterschriften auf Liefernachweisen lesen?
Teilweise. Moderne KI-gestützte OCR mit Vision-Language-Modellen kann saubere, druckschriftartige Handschrift mit 75–90 % Genauigkeit lesen, aber kursiv geschriebene Unterschriften und hastige Handschrift bleiben schwierig – bei unordentlichen Einträgen sinkt die Genauigkeit auf 60–75 %. Bei Liefernachweisen (POD), bei denen die handschriftliche Unterschrift oder Schadensvermerk die rechtliche Grundlage darstellen, behandeln die meisten Logistikabläufe die OCR-Extraktion dieser Felder als Schritt „vor Verwendung prüfen“ statt als vollautomatische Verarbeitung. Der praktische Nutzen von OCR bei PODs liegt nicht darin, die menschliche Prüfung vollständig zu eliminieren – sondern darin, die Zeit zum Auffinden und Verifizieren handschriftlicher Felder von Minuten auf Sekunden zu reduzieren.
Funktioniert OCR mit internationalen Versanddokumenten in mehreren Sprachen?
Ja, KI-basierte OCR-Tools verarbeiten mehrsprachige Dokumente deutlich besser als herkömmliche OCR-Engines. Vision-Language-Modelle, die auf mehrsprachigen Dokumentkorpora trainiert wurden, verarbeiten alle Schriftsysteme innerhalb eines einzigen Modells – sie erfordern keine sprachspezifische Konfiguration. Die Genauigkeit variiert jedoch je nach Schriftsystem. Lateinische Schriften (Englisch, Französisch, Spanisch, Deutsch) schneiden am besten ab. Chinesische, japanische und koreanische Zeichen stellen aufgrund der Zeichendichte und Strichkomplexität eine größere Erkennungsschwierigkeit dar, liegen aber im Leistungsbereich aktueller KI-Modelle. Testen Sie das Tool stets mit Ihrem tatsächlichen Dokumentmix, statt sich auf englischsprachige Benchmarks zu verlassen.
Wie funktioniert die Validierung von Containernummern bei der OCR-Extraktion?
Containernummern folgen dem ISO-6346-Format: vier Buchstaben des Eigentümercodes, sechs Serienziffern und eine Prüfziffer. Fortschrittliche OCR-Tools können die extrahierte Containernummer anhand des ISO-Prüfziffernalgorithmus validieren – das System bestätigt mathematisch, dass das neunstellige Präfix die zehnte Prüfziffer erzeugt. Diese Validierung erkennt einen der häufigsten manuellen Dateneingabefehler in der Logistik: eine einzelne vertauschte Ziffer in einer Containernummer, deren Identifizierung normalerweise Tage dauern würde. Wenn die extrahierte Nummer die Validierung nicht besteht, markiert das Tool sie zur Überprüfung, statt den Fehler weiterzuleiten.
Was ist der Unterschied zwischen vorlagenbasierter und semantischer Extraktion von Frachtbriefen?
Bei der vorlagenbasierten Extraktion müssen Sie die Koordinaten und Feldbezeichnungen für jedes Speditionsformat definieren. Ändert ein Spediteur sein Layout – oder kommt ein neuer hinzu –, bricht die Vorlage oder muss komplett neu konfiguriert werden. Die semantische Extraktion liest das Dokument, indem sie die Bedeutung jedes Feldes versteht, nicht seine Position. Sie definieren die gewünschten Felder (Frachtbriefnummer, Containernummer, Verladehafen), und die KI findet sie überall auf der Seite. So funktioniert eine Konfiguration für jedes Speditionsformat, und bei Layoutänderungen ist keine Wartung nötig. Für Logistikbetriebe mit mehreren Spediteuren ist die semantische Extraktion der praktische Unterschied zwischen skalierender Automatisierung und einem neuen Wartungsaufwand.
Wie genau ist die KI-Extraktion bei Logistikdokumenten im Vergleich zur manuellen Dateneingabe?
Bei sauberen maschinell gedruckten Frachtbriefen großer Spediteure erreicht moderne KI-Extraktion eine Feldgenauigkeit von 90–99 % bei Standardfeldern (Versender, Empfänger, Schiff, Häfen). Bei logistikspezifischen Codes wie SCAC und UN/LOCODE liegt die Genauigkeit bei gedruckten Inhalten meist über 85 %. Handschriftliche Inhalte fallen je nach Lesbarkeit auf 60–90 %. Diese Werte schneiden im Vergleich zur manuellen Dateneingabe gut ab, die bei Routinefeldern typischerweise 95–98 % Genauigkeit erreicht, aber deutlich langsamer ist – 10–15 Minuten pro Dokument gegenüber 5–10 Sekunden mit KI. Der entscheidende Faktor ist der Durchsatz: KI-Extraktion verarbeitet 60–100 Dokumente in der Zeit, die ein manueller Bearbeiter für eines benötigt, was sie für Logistik mit hohem Volumen geeignet macht – selbst wenn handschriftliche Felder noch menschlich geprüft werden.
Kann ich extrahierte Versanddaten direkt in mein TMS oder ERP exportieren?
Die meisten KI-Extraktionstools bieten CSV- oder Excel-Export als Basis. Viele bieten auch eine API für den automatischen Datentransfer zu TMS- und ERP-Systemen. Einige Tools haben direkte Integrationen mit Plattformen wie CargoWise, SAP, Oracle, QuickBooks und Xero oder leiten Daten über Zapier, Make oder Power Automate weiter. Ausgabeformat und Integrationsmethode sind entscheidende Auswahlkriterien: Wenn die Daten des Extraktionstools vor der Nutzung in Ihren Betriebssystemen manuell umformatiert werden müssen, sinkt der Automatisierungsnutzen erheblich. Für tabellenbasierte Workflows ermöglichen Tools mit einem Google-Sheets-Add-on das direkte Einfügen extrahierter Daten in Tabellen ohne Zwischenexporte.
Welche INCOTERMS sollten auf Logistikdokumenten erscheinen?
Die 11 INCOTERMS 2020-Regeln sind in zwei Kategorien unterteilt. Für jeden Transportmodus: EXW (Ab Werk), FCA (Frei Frachtführer), CPT (Frachtfrei), CIP (Frachtfrei versichert), DAP (Geliefert benannter Ort), DPU (Geliefert benannter Ort entladen) und DDP (Geliefert verzollt). Für See- und Binnenschifffahrt: FAS (Frei längsseits Schiff), FOB (Frei an Bord), CFR (Kosten und Fracht) und CIF (Kosten, Versicherung und Fracht). Für Containerfrachten sind FCA oder CIP meist passender als FOB oder CIF, auch wenn FOB weiterhin häufig – und oft fälschlich – verwendet wird. Ein leistungsfähiges Extraktionstool sollte alle 11 Begriffe und ihre Abkürzungen erkennen.
Versanddokument-Extraktion einsetzen
Logistikbetriebe haben nicht den Luxus, ihre Dokumenteneingänge zu standardisieren. Frachtbriefe kommen von 20 verschiedenen Spediteuren in 20 verschiedenen Layouts. Liefernachweise kommen mit handschriftlichen Unterschriften und Randnotizen von Fahrern zurück. Packlisten, Frachtrechnungen und Zollerklärungen bringen jeweils eigene Feldkomplexitäten und Validierungsanforderungen mit sich. Die Frage ist nicht, ob Sie die manuelle Verarbeitung vollständig eliminieren können – bei einigen Feldern, insbesondere handschriftlichen Unterschriften, bleibt die menschliche Überprüfung der richtige Kontrollpunkt. Die Frage ist, ob Sie die 10-15 Minuten manueller Dateneingabe pro Dokument eliminieren können, die derzeit die Bandbreite Ihres Teams beanspruchen, ohne operativen Mehrwert zu schaffen.
Moderne OCR für die Logistik – basierend auf semantischer KI-Extraktion statt vorlagenbasierter Zeichenerkennung – macht dies möglich, indem sie Versanddokumente so versteht, wie ein Logistiker es tut: indem sie identifiziert, was jedes Feld bedeutet, es gegen Industriestandards validiert und im Format ausgibt, das Ihre nachgelagerten Systeme erwarten. Eine Konfiguration funktioniert über jedes Spediteurformat, jede Sprache und jeden Dokumententyp hinweg.
Laden Sie einen echten Frachtbrief, Liefernachweis oder eine Packliste hoch und sehen Sie, wie Ihr Dokumentenstrom als strukturierte Daten aussieht – in Sekunden, nicht Minuten.
Testen Sie es mit Ihrem eigenen Dokument →Keine Anmeldung erforderlich. Dateien werden sicher verarbeitet.