医療向けOCR:
診療記録・EOB・保険請求書の処理
1枚のCMS-1500請求書には30以上のフィールドがあります。患者情報、保険者識別情報、最大12件の診断コード(ICD-10-CM)、手技コード(CPT/HCPCS)、修飾子、診断ポインタ、請求額、提供者NPI番号などが、紙処理用に設計されたレイアウトで1ページに収められており、デジタル抽出には向いていません。さらに、Medicareだけでも毎週24万7,000件の紙請求が提出され続け、1,500以上の保険者固有フォーマットのEOB、入れ子になった結果テーブルを持つ検査レポート、受付で急いで書かれた走り書きの患者受付フォームが加わると、問いは「OCRは医療文書を処理できるか」から「どのアプローチがどの文書に適し、それぞれのアプローチはどこで限界を迎えるか」へと変わります。
医療請求処理のためのOCR:CMS-1500、EOB、検査レポートを正確に処理する方法医療文書のOCR処理に関する総合ガイド。CMS-1500請求書、EOB、検査レポートなど、さまざまな医療文書に最適なOCRアプローチと、HIPAA準拠のためのBAAの重要性について解説します。
重要なポイント
- 医療請求拒否の30%は、CPTまたはICD-10コードの誤入力が原因です。拒否された請求1件の再処理には48ドルかかりますが、提出前の検証には3ドルしかかからず、手動データ入力は自動化の16倍のコストになります。
- テンプレートOCRは、きれいなCMS-1500では99%のフィールド精度を達成します。しかし、同じフォームをコピーすると精度は80%未満に低下します。これはスキャナのキャリブレーションの問題であり、ベンダーの精度主張ではほとんど言及されません。
- 署名済みのビジネスアソシエイト契約(BAA)がなければ、OCRツールは患者データを含む文書を合法的に処理できません。抽出精度のベンチマークがどんなに高くても、HIPAAはBAAを必須としています。
医療向けOCRとは実際には何か
医療向けOCRとは、光学文字認識とAIベースの文書理解を、医療機関が扱う特定の文書に適用するものです。対象となる文書には、保険請求フォーム(専門請求用のCMS-1500、施設請求用のUB-04)、支払者からの給付明細書(EOB)、検査結果や病理レポート、患者受付・登録フォーム、処方箋、紹介状、退院サマリー、臨床メモなどが含まれます。
他の業界のOCRとの違いが重要なのは、医療文書が他の分野ではめったに同時に発生しない3つの課題を組み合わせているためです。それは、厳格な構造の多様性(1,500以上のEOB形式)、正確に転記する必要がある専門分野固有のコード(CPT、ICD-10-CM、HCPCS、NPI)、そして45 CFR §164.514のHIPAAプライバシー規則で定義された保護健康情報(PHI)に関する規制要件です。
医療向けOCRの検索意図の90%以上をカバーする6つの文書カテゴリは、EOB(支払者の送金明細)、CMS-1500(専門請求)、UB-04(施設請求)、検査レポート(臨床結果)、患者受付フォーム(登録および病歴)、処方箋(手書きまたは印刷された投薬指示)です。それぞれに固有の抽出プロファイルがあり、単一のOCRアプローチで6つすべてを同等にうまく処理できるものはありません。
OCRが一般的にどのように機能するかについての基礎的な理解は、OCRとは何か、どのように文書を読み取るかをご覧ください。医療が依存する非標準文書を処理するAIを活用した進化については、AI OCRとは何か、その違いをご覧ください。
医療にOCRが必要な理由 — 定量化された問題
医療請求における手動データ入力には、自動化が直接対処する特定の失敗パターンがあります。請求スタッフが不注意だからというわけではありません。紙ベースのデータ入力の量と複雑さが、8時間のシフトを通じて人間の精度が維持できる範囲を超えているからです。
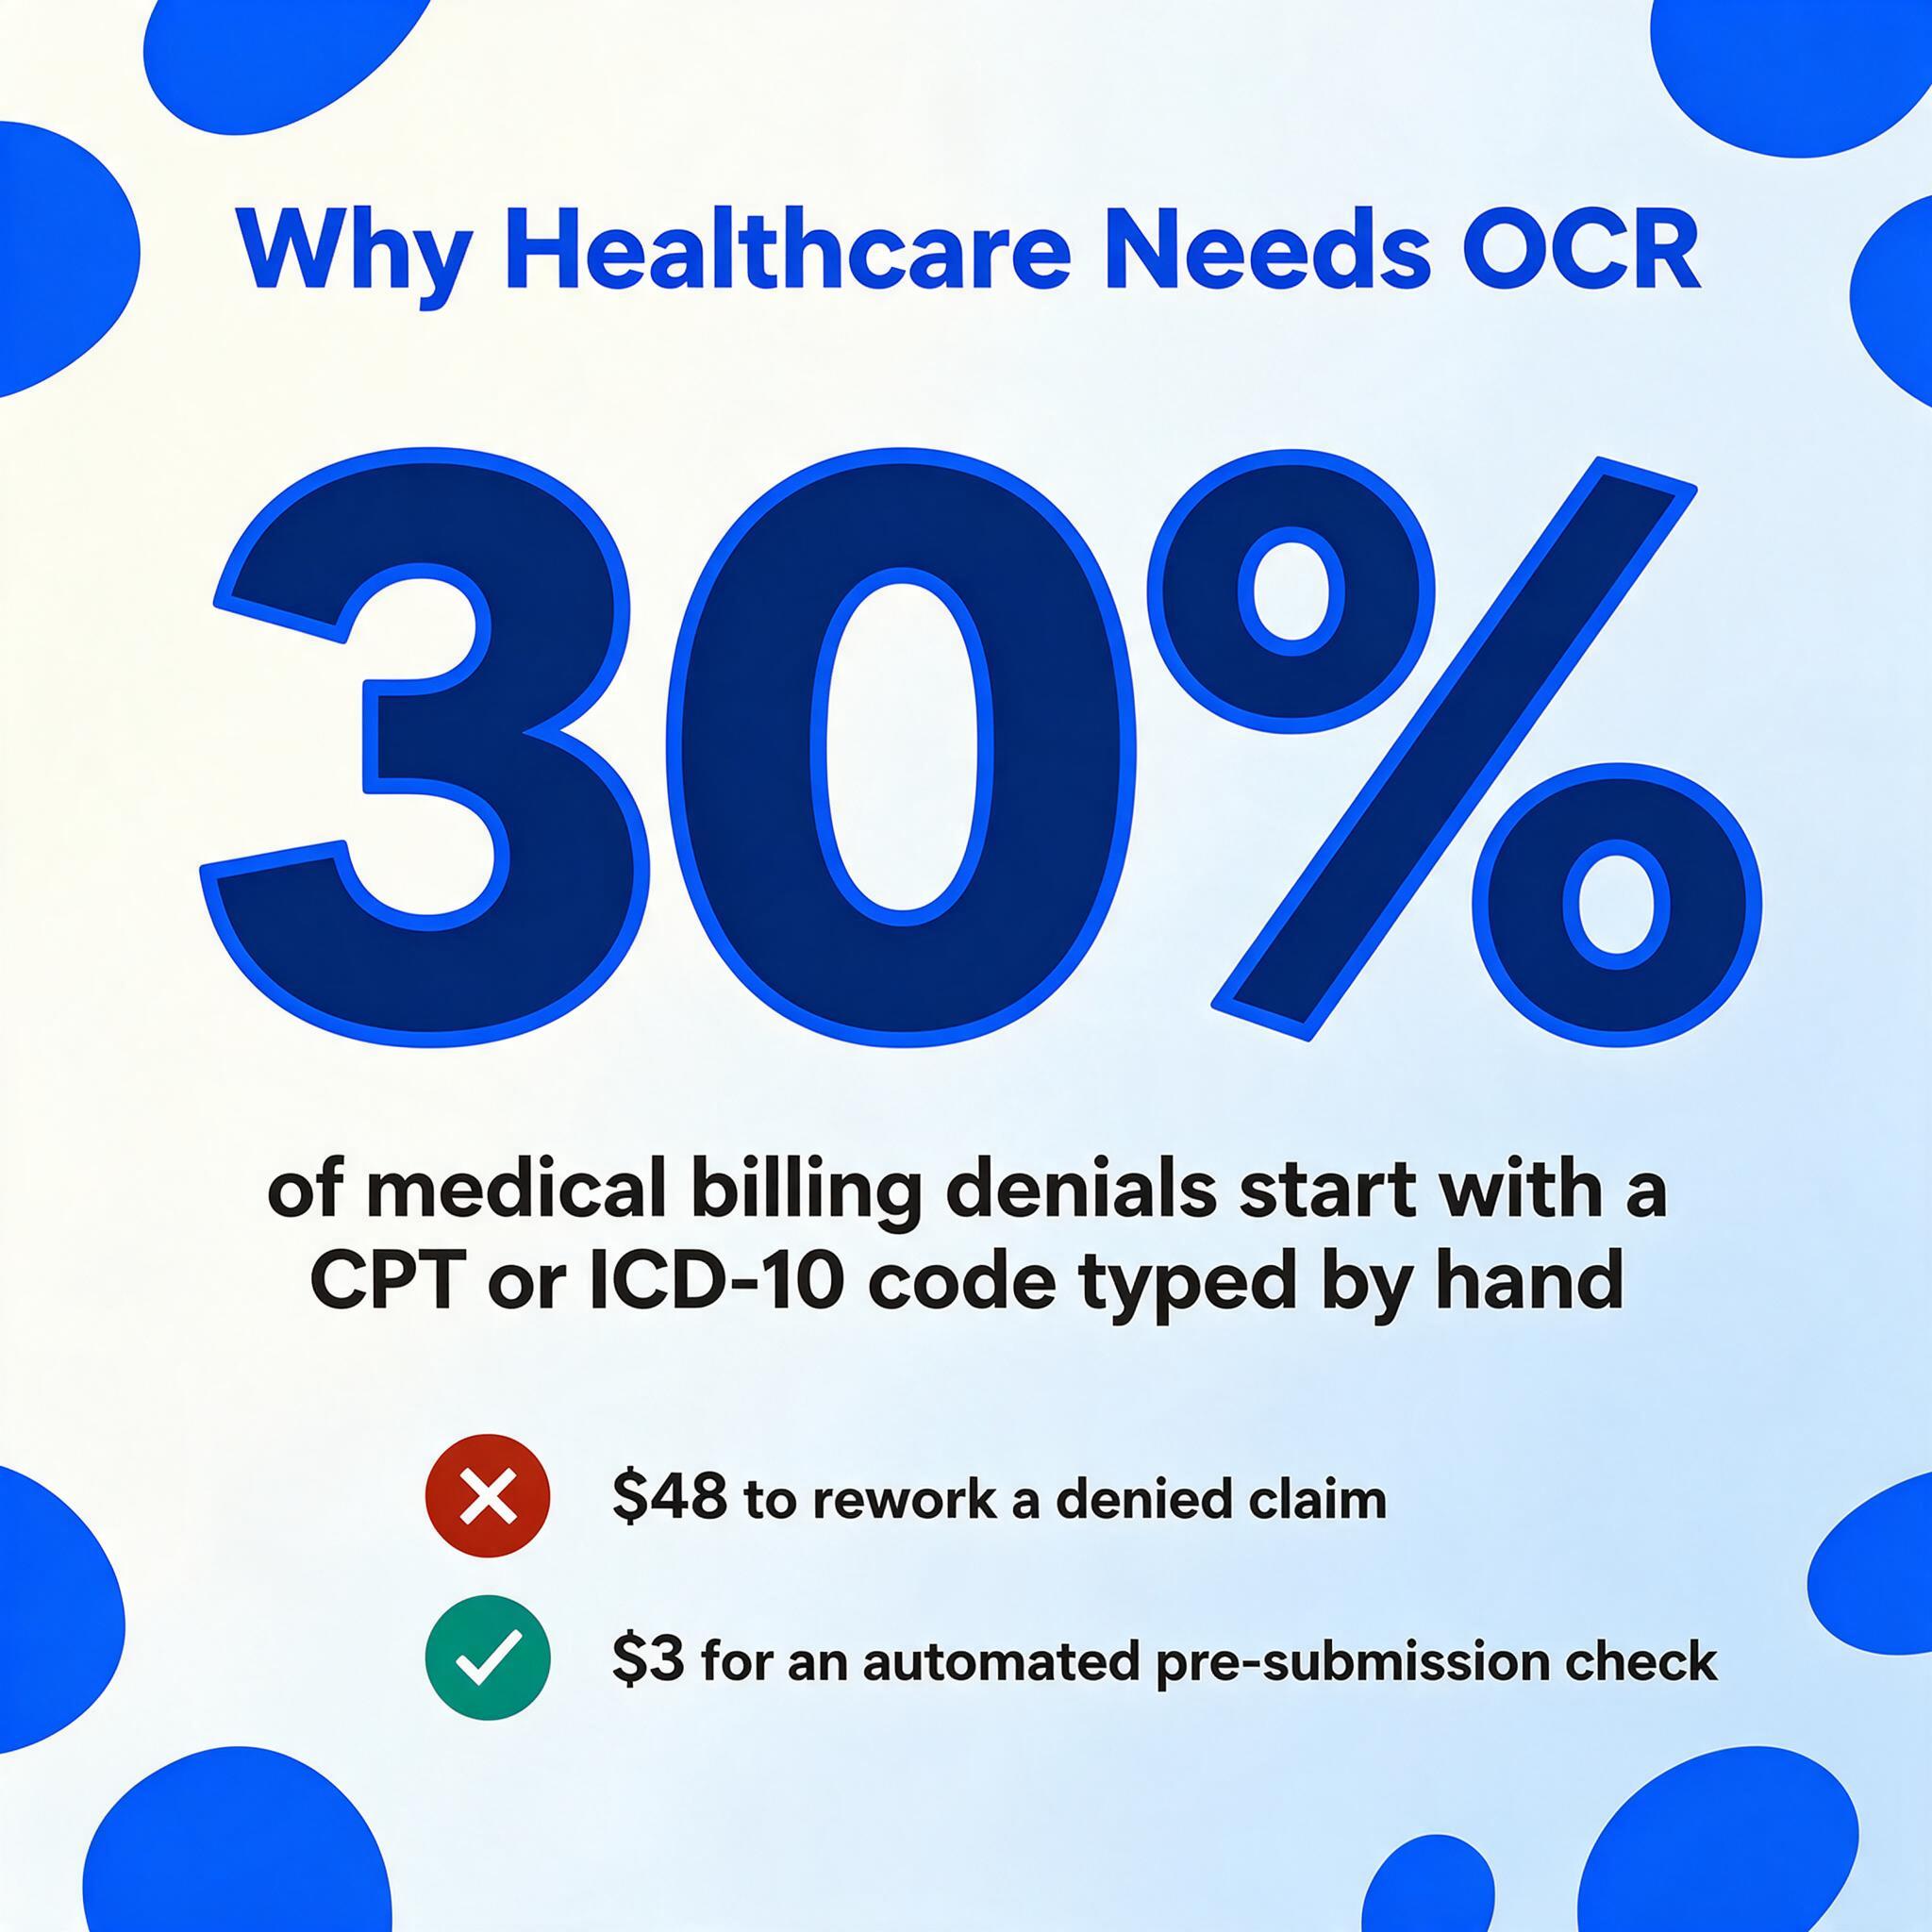
その数字は複数の方向から来ています。2021年以降、月100万件以上の請求を処理するテキサス州メディケイド展開を運営するOCR Solutionsは、すべての医療請求拒否の約30%が手動データ入力中の誤ったCPTまたはICD-10コードに起因すると報告しています。同じチームの別の分析では、平均的な拒否の再作業コストは1件あたり$48と推定されており、自動化された送信前チェックの$3と比較して、16:1のコスト比率になります。AMA自身のコーディングエラーに関するガイダンスは、最も一般的な間違い(誤った修飾子、診断と処置のリンクの不一致、古いコード)が構造的であり、ランダムではないことを確認しています。これらは、データを入力する人が、請求処理システムが後で強制するすべてのクロスフィールド依存関係を同時にチェックできないために発生します。
次に労務の計算があります。CMS-1500またはUB-04フォームの手作業入力には、1件あたり5〜10分かかります。1日500件の請求を処理する病院の収益サイクルチームは、入力だけで40〜80人時を費やします。照合も確認もせず、単に文字をある形式から別の形式に転記するだけです。自動抽出により、フォーム1件あたり60秒未満に短縮されます。これは人間の役割を排除するのではなく、転記から検証へと移行させるものであり、臨床および請求に関する判断が実際に重要となる作業です。
請求業務以外にも、検査結果の記録や患者受け入れのデジタル化も同様のパターンをたどります。紙の依頼書や登録フォームからの手作業での転記は、患者対応に費やせる時間を消費し、エラー率(大量データ入力では通常8〜12%)は、下流の照合や手戻りコストに蓄積されていきますが、ほとんどの医療機関はその全体像を把握していません。
主要な医療文書タイプとその抽出課題
医療分野の文書は単一のタイプではありません。各主要カテゴリは異なる抽出プロファイルを持ち、テンプレートベース、AIベース、ハイブリッドのいずれのOCRアプローチが適切かを決定します。
EOB(給付明細書)明細
EOBは、医療分野で最もフォーマットのばらつきが大きい文書といえるでしょう。民間保険者(BCBS、UnitedHealthcare、Aetna、Cigna、Humana)、政府系保険者(Medicare、Medicaid、Tricare)、労災保険会社を合わせて、保険者固有のEOBレイアウトは1,500以上存在します。Medicareは請求識別子を「ICN」(内部管理番号)と呼びます。BCBSは請求番号を右上に配置し、Aetnaは左側のヘッダーブロックに配置します。3つとも同じ意味(請求識別子)ですが、位置ベースのOCRテンプレートでは、これを取得するために3つの異なる設定が必要になります。
照合に重要なフィールドは、請求番号/ICN、患者名とID、診療日、修飾子付きCPT手順コード、請求額、許容額、保険支払額、自己負担額、共保険、患者負担額、拒否理由コードです。課題は文字の読み取りではありません。最新のOCRはそれを確実に実行します。課題は、各保険者の明細書で同じデータ項目が異なる位置に表示される場合に、各値を正しい列にマッピングすることです。
ここでテンプレートベースのOCRは限界に達し、セマンティックAI抽出(システムが「請求番号」の意味を理解し、位置ではなく概念でそれを見つける方式)が必要になります。詳細については、専用のEOBデータ抽出の完全ガイドをご覧いただくか、EOBをExcelに変換する抽出ツールを保険者明細書で直接お試しください。
CMS-1500(診療報酬請求書)
CMS-1500(別名HCFA-1500)は、医師、診療所、非施設提供者がメディケアや民間保険会社に請求する際に使用する標準的な紙ベースの請求書です。1ページに33の番号付きボックス(さらに細分化あり)が詰め込まれており、この密度が特徴です。請求審査に必要なすべての情報を標準化された紙面に収めていますが、その密度ゆえに汎用OCRでの正確な解析が最も難しい帳票の一つです。
構造上の重要な課題は、項目間の依存関係です。Box 24E(診断ポインタ)は、Box 21(診断名または傷病名)に記載された有効なICD-10-CMコードを参照する必要があります。ポインタのずれは手入力では見えにくく、入力者はBox 24Eの各ポインタコードがBox 21の有効なエントリと一致するかを複数のサービスラインにわたって同時に確認できません。保険者の審査システムは30~60日後に却下として検出します。テンプレートベースのOCRはこの帳票を得意としています。レイアウトがCMSの公式仕様に従って標準化されており、ドロップアウトスキャン版にはFlint OCR Redインクの使用が義務付けられているため、最適なスキャン条件下ではフィールドレベルで最大99%の精度を達成します。
しかし、ほとんどのベンダーが事前に説明しない落とし穴があります。CMS-1500のOCR精度はスキャナの設定に大きく依存します。メディケアキャリアが使用する「レッドドロップアウト」機能には、特定のスキャナキャリブレーションが必要です。小規模診療所でよく見られる帳票のコピーには必要なOCRレッドインクがないため、ドロップアウトゾーンが機能せず、抽出エンジンは入力フィールドのみを分離する代わりにページ全体を解析する必要があります。クリーンスキャンとコピーの差は、同じOCRエンジンでも精度が99%から80%未満に変動する可能性があります。
UB-04(施設請求書)
CMS-1500が33の欄であるのに対し、UB-04(CMS-1450とも呼ばれる)には81のフォームロケーターがあります。これは病院、熟練看護施設、在宅医療機関、その他の施設系プロバイダーが、一連の治療エピソード全体を請求するために使用します。複雑さは行レベルの構造にあります。フォームロケーター42から47は繰り返し行項目であり、収益コード、サービス内容、サービス日、単位数、総請求額、非対象額がすべて各行で整合している必要があります。収益コードを1つ誤読するだけで(例:救急外来サービスを示す0450とERトリアージを示す0452)、その行の価格設定全体が狂い、支払い側はどのフィールドが間違っているかを推測するよりも、請求を拒否します。
UB-04形式は施設向けであり、施設請求にはCMS-1500に相当するものがない状態コード、発生コード、値コード、収益コードが含まれるため、別途のマッピングおよび検証レイヤーが必要です。事前構築されたUB-04マッピングを備えたテンプレートベースのシステムはここでは業界標準であり、スキャン品質が一貫している場合にうまく機能します。
検査レポートと病理結果
検査レポートは請求書とは決定的に異なります。標準化されていないのです。各検査機関(Quest、LabCorp、病院併設の検査機関)は独自のレポートテンプレートを使用します。データ自体は構造化されていますが(検査名、結果値、基準範囲、フラグ(正常/異常))、レイアウトはさまざまです。一部の検査レポートは結果を縦のリストで表示し、他は表形式、また他は表を併用した混合形式の文章で表示します。抽出の課題は、検査名(例:「ヘモグロビンA1c」)、結果値(「7.2%」)、基準範囲(「<5.7%正常、5.7-6.4%前糖尿病、≥6.5%糖尿病」)、フラグ(「高」)を区別することです。これらをOCRテキストのブロックとして読み取っても、使用可能なデータにはなりません。値は正しい行の関連付けで別々の列に配置する必要があります。
患者情報収集・登録フォーム
インテークフォームには、OCRが苦手とする3つの要素が組み合わされています。チェックボックス(チェック、×印、丸印)、手書き(患者名、住所、来院理由、病歴)、そして混在形式のフィールド(一部は印刷済み、一部は自由記入)です。特にチェックボックスは厄介で、従来のOCRはテキストを読み取るものであり、ボックス内のマークの有無を検出するものではありません。AIベースのビジョンモデルは、文書を画像として捉え、マークの付け方に関係なくボックスが記入されているかどうかを検出できるため、この問題をよりうまく処理できます。手書き部分については、AI抽出技術は近年大幅に向上していますが、正確性は手書きの読みやすさに大きく左右されます。現在の技術で何ができて何ができないかについては、手書きOCRソフトウェアのガイドをご覧ください。
登録書類に特化して言えば、実用的な目標は患者1人につき1行です。患者インテークフォームのExcel変換により、チェックされたボックス、手書きの回答、保険情報フィールドが1回の処理でそれらの列にマッピングされます。
処方箋
処方箋は、手書き問題の最たる例です。終日診療を終えた医師が書く文字は、どの業界でも最も読みにくい筆記体のひとつです。リスクは大きく、薬剤名や用量の読み間違いは患者に害を及ぼす可能性があります。従来のOCRは筆記体を実質的に処理できません。AIベースのビジョンモデルは、品質が妥当な手書き処方箋では85〜95%の精度を達成しますが、品質の低いスキャンや急いで書かれた文字では精度が大幅に低下します。ほとんどの医療OCRワークフローでは、処方箋を完全自動化の対象ではなく、人間による検証が必要なカテゴリとして扱っています。
重要なフィールド:医療コード、識別子、PHI
医療文書には、他の業界には存在しないデータ要素が含まれています。請求書には日付と合計金額があります。医療請求にはそれらに加えて、支払い、拒否、監査のいずれになるかを決定するコードがあります。これらのコードが何であり、抽出においてなぜ重要なのかを理解することは、汎用OCRツールを購入することと、医療向けに機能するツールを購入することの違いです。
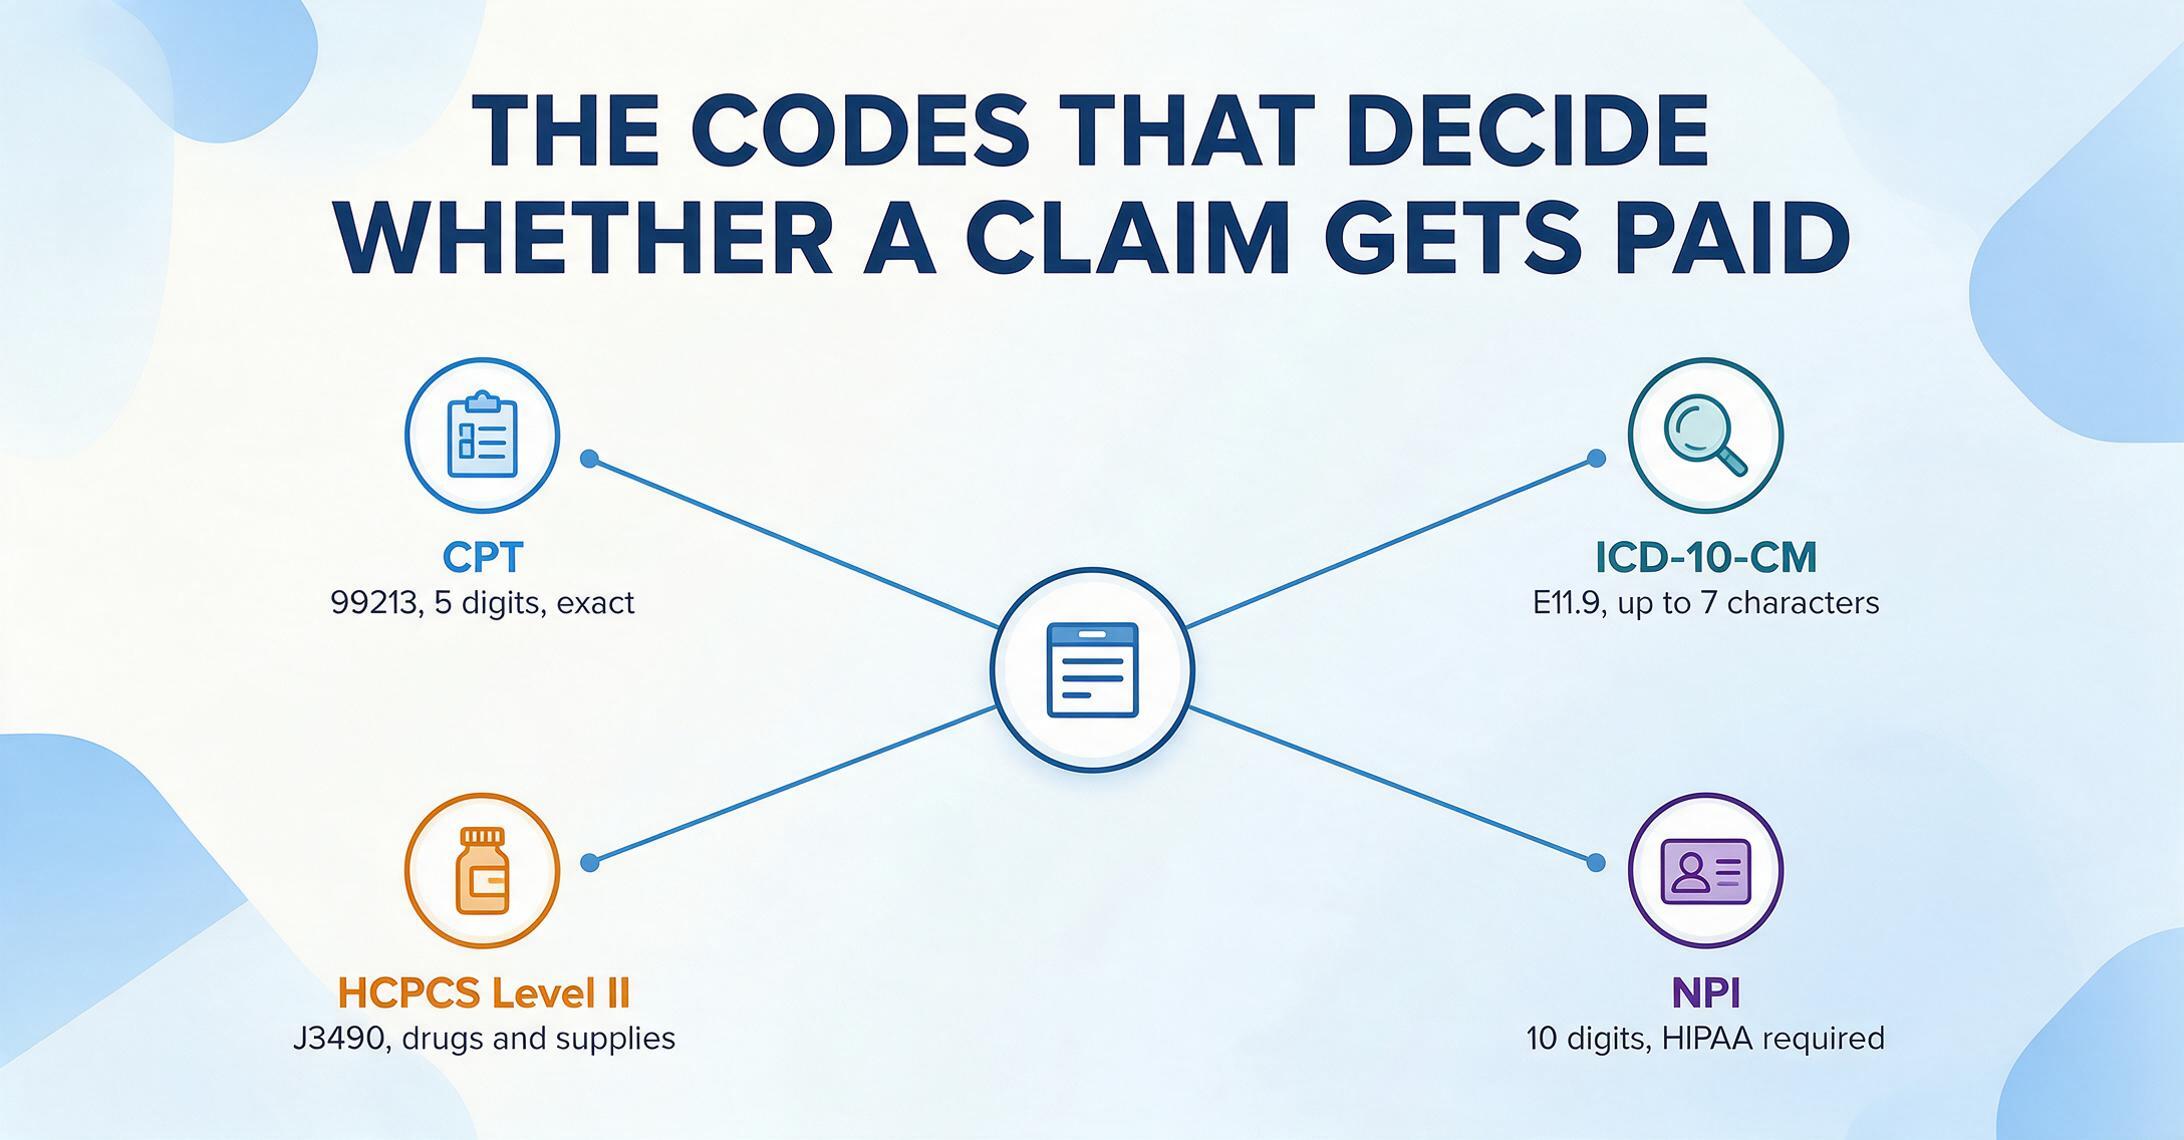
CPTコード
米国医師会が管理する現行処置用語集。医療処置とサービスを表す5桁の数字コードです。例: 99213(確立患者の診察、レベル3)。AIは診断コードと処置コードを区別する必要があります。これらは同じ行に表示されることがよくあります。
ICD-10-CMコード
国際疾病分類第10版臨床修正版。診断を表す最大7文字の英数字コードです。例: E11.9(合併症のない2型糖尿病)。約72,000件の有効コードがあり、文字単位での正確な抽出が必要です。
HCPCSレベルII
CMSが管理する医療共通手続きコード体系。CPTでカバーされない製品、備品、サービスを表す英数字コードです。例: J3490(未分類医薬品)。UB-04施設請求でよく見られます。
NPI番号
全国提供者識別子。HIPAAによりすべての医療提供者に義務付けられている10桁の数字識別子です。標準の10桁形式に従う必要があり、抽出検証ではこのパターンに照らして確認する必要があります。
さらにPHI(保護対象医療情報)があります。HIPAAプライバシールールに基づき、18カテゴリの識別子が医療情報を個人特定可能にします。これには名前、住所、社会保障番号などの明らかなものに加え、生年月日(生年月日、入院・退院日、死亡日)、電話番号、FAX番号、メールアドレス、医療記録番号、健康保険受益者番号、口座番号、証明書・免許番号、車両識別子、デバイス識別子とシリアル番号、URL、IPアドレス、生体識別子、顔写真、その他あらゆる固有の識別番号、特徴、コードが含まれます。
OCRツール選定における実際的な影響: これら18の識別子のいずれかを含む医療文書を処理するツール(患者名と請求番号なしのEOBは請求に役に立ちません)は、HIPAA開示を構成します。この開示には、45 CFR §164.504(e)に基づく署名済みのビジネスアソシエイト契約(BAA)が必要です。BAAに署名できない、または署名しないツールは、精度の数値に関係なく、医療文書処理の有力な候補とはなりません。
医療文書における従来型OCRとAIベース抽出の比較
問題は「どちらが優れているか」ではなく、「どの文書にどちらを使うか」です。医療分野では、従来型のテンプレートOCRと最新のAIベース抽出の両方に正当な役割があり、最適なアプローチは文書の種類によって異なります。
| 文書の種類 | 適したアプローチ | 理由 | 達成可能な精度 |
|---|---|---|---|
| CMS-1500(鮮明なスキャン) | テンプレートOCR | 固定レイアウト、既知のフィールド座標、赤色ドロップアウト対応 | フィールド単位で98〜99% |
| CMS-1500(コピー・FAX) | AI抽出 | 赤色ドロップアウト領域なし。AIが意味的にフィールド位置を推測可能 | フィールド単位で85〜92% |
| UB-04(鮮明) | テンプレートOCR | 81の固定フォームロケーター、既知の構造 | フィールド単位で98〜99% |
| EOB(任意の保険者) | AI抽出 | 1,500以上の独自レイアウト。固定フィールド位置なし | フィールド単位で85〜95% |
| 検査レポート | AI抽出 | 検査機関ごとに非標準レイアウト。意味的マッチングが必要 | フィールド単位で80〜92% |
| 患者受付フォーム | AI抽出 | チェックボックス+手書き+混在フィールド | 75〜90%(手書きに依存) |
| 処方箋 | AI抽出 | 筆記体の手書き。ビジョンモデルが必要 | 70〜88%(検証が必要) |
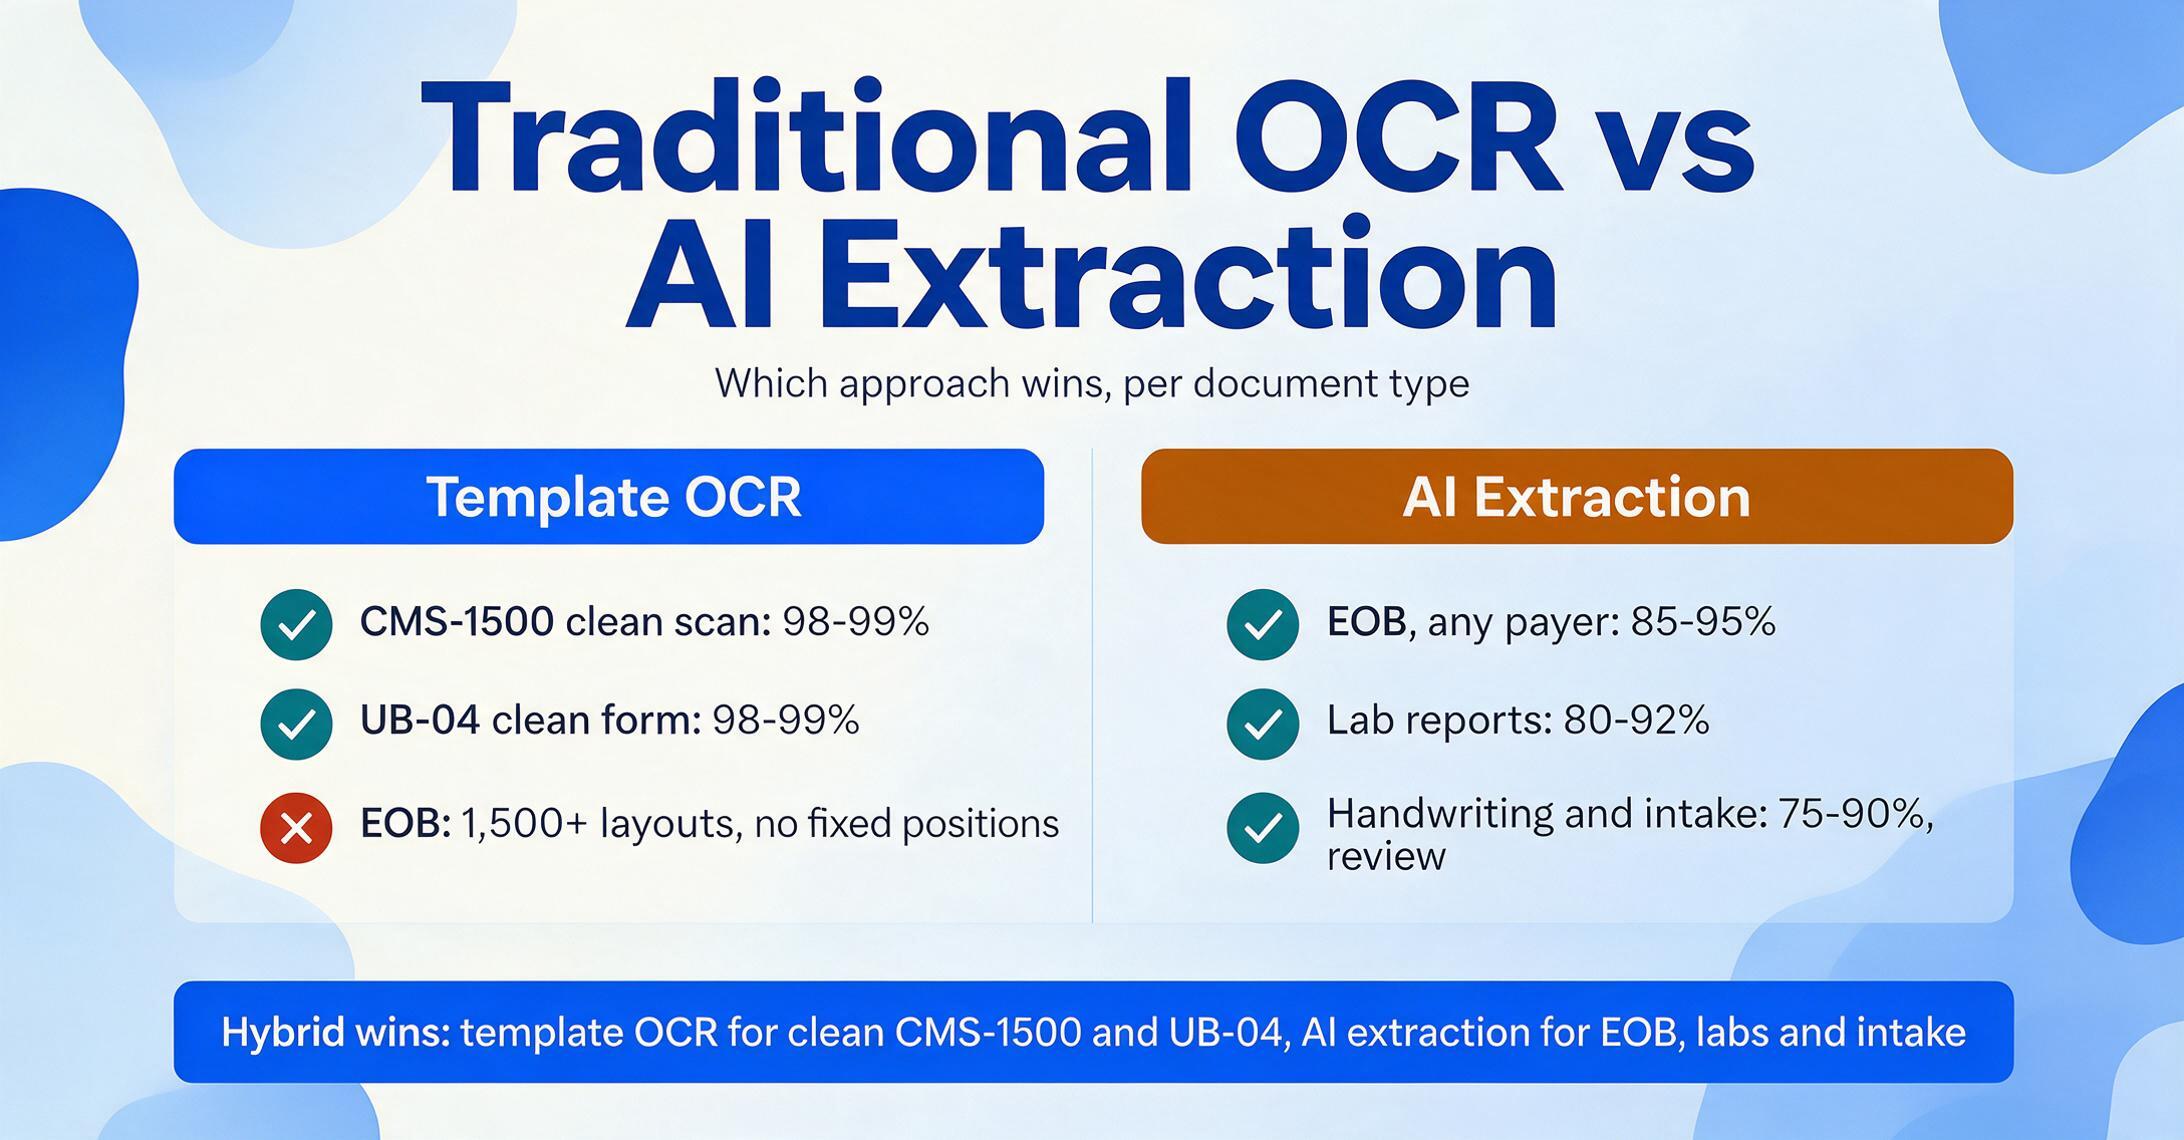
このため、多くの医療機関は最終的にハイブリッドワークフローを採用しています。精度が最も重要でフィールド単位の検証が不可欠な構造化された請求フォームにはテンプレートOCRを、EOB、検査レポート、受付フォームなど柔軟性が重視される非標準文書にはAI抽出を使用します。この2つのアプローチは医療分野では競合ではなく、文書スペクトラムの異なる部分に対応する補完的なツールです。
正直な答え:スキャン品質が良好なCMS-1500およびUB-04フォームでは、テンプレートベースのOCRが依然として精度のリーダーです。その他の医療文書タイプ(EOB、検査レポート、受付フォーム、処方箋)では、レイアウトが多様すぎてテンプレートでは対応できないため、AIベースの抽出が唯一の実現可能なアプローチです。
コンプライアンス考慮事項:選定基準としてのHIPAA
ここは多くのOCRツール記事がマーケティングコピーに変わるセクションです。代わりに、ここでは実践的な枠組みを提示します。
HIPAAコンプライアンスは、オンにする機能ではありません。これは、患者データとともにツールをどのように使用できるかを規定する法的枠組みです。関連する構成要素は以下のとおりです:
- ビジネスアソシエイト契約(BAA)(45 CFR §164.504(e)に基づく)— 組織とツールプロバイダー間の署名済み契約であり、プロバイダーをビジネスアソシエイトとして確立します。BAAがない場合、第三者ツールへのPHIの送信は、プライバシールールに違反する開示となります。
- 最小必要の原則(45 CFR §164.502(b)に基づく)— 開示するPHIは、意図した目的を達成するために必要な最小限に限定する必要があります。ドキュメント上のすべてを抽出し、後で出力を選別させるツールは、この要件と構造的に矛盾します。
- セキュリティルール(45 CFR §164.306に基づく)— 電子PHIに対する管理的、物理的、技術的保護措置。クラウドベースのOCRツールの場合、これは保存時の暗号化(AES-256)、転送中の暗号化(TLS 1.2+)、アクセス制御、監査ログを意味します。
医療向けOCRツールを評価する際は、次の3つの質問を順番に確認してください:
- BAAに署名していただけますか? 答えが「いいえ」の場合、そのツールはPHIを含むドキュメントには使用できません。つまり、実質的にすべての医療ドキュメントが対象外となります。
- データはどこで処理・保存されますか? BAAはデータの保存場所を特定する必要があります。コンプライアンスフレームワークでPHIを米国内に留めることが求められる場合(多くの医療機関がそうであるように)、ツールは米国内のサーバーでデータを処理する必要があります。
- 処理後、ドキュメントはどうなりますか? HIPAAのデータ保持および廃棄要件が適用されます。医療ドキュメントを無期限に保存するツールは、利用者とプロバイダーの両方にコンプライアンス上の負債を生み出します。定義された期間(24時間、7日など)内の自動削除が、クラウドベースの抽出ワークフローの標準です。
詳細については、HIPAAと医療ドキュメント抽出についてこちらで詳しく説明しています。ツールプロバイダーのコンプライアンス体制を検証するための詳細なチェックリストも含まれています。
また、言及しておく価値があるのは、最高のBAAでも、必要以上のデータを抽出するツールを使用している場合には保護されないということです。最小必要の原則は、対象事業者(つまりあなた)に、ツールが必要な特定のデータ要素のみにアクセスすることを保証する責任を課します。これは、カスタム列抽出(抽出するフィールドを正確に定義し、AIがそれらのみを抽出する)が、すべてを返して後処理が必要な全ページOCRよりも構造的な利点を提供する分野の1つです。
医療向けOCRソリューションの選び方
価格、精度、コンプライアンス対応の観点からツールを総合比較するには、2026年版・医療向け最適なOCRソフトウェアまとめをご覧ください。特にEOBやCMS-1500請求書フォームの抽出精度を重視する場合は、医療文書抽出ツールまとめで、実際の複数保険者文書を用いて7つのツールを検証しています。以下の概要は、初期評価で最も重要となる5つの基準をまとめたものです。
1. 文書カバレッジ
処理する文書の種類に対応しているかどうか。EOB抽出ツールは検査レポートには役に立ちません。CMS-1500専門ツールでは患者受付フォームを処理できません。複数の文書タイプを処理する組織(大多数が該当)では、全範囲をカバーするツールを選ぶか、カテゴリごとに別々のソリューションを維持する計画が必要です。
2. コードレベルの精度
請求書フォームやEOBでは、文字レベルの精度では不十分です。CPTコード(5桁の数字、正確に)、ICD-10-CMコード(最大7文字の英数字、正確に)、NPI番号(10桁、正確に)のフィールドレベルの精度が必要です。コードフィールドの1文字の誤りが拒否につながる可能性があります。ベンダー提供のサンプルではなく、実際の文書でツールをテストしてください。
3. コンプライアンス対応
PHIを含むワークロードにはBAAの提供が必須です。BAAに加えて、データの保存場所(サーバーは米国内か)、暗号化基準(保存時AES-256、転送時TLS 1.2以上)、データ保持期間(文書はどのくらい保存されるか)、SOC 2 Type 2監査または同等の第三者セキュリティ評価を完了しているかどうかを確認してください。
4. 既存システムとの統合
医療機関はEHR(Epic、Oracle Health Cerner、Meditech、Allscripts)、診療管理システム(athenahealth、AdvancedMD、Kareo、NextGen)、クリアリングハウス(Office Ally、Change Healthcare、ZirMed)を利用しています。理想的なOCRツールは、手動再入力なしで請求システムが取り込める形式(構造化されたExcel、CSV、JSON)でデータを出力します。ワークフローの変更が少ないほど、導入が迅速になります。
5. 手書き文字対応
ワークフローに処方箋、診療記録、自由記入欄のある患者受付フォームが含まれる場合、手書き文字の精度は重要な選択基準です。ベンダーが厳選したテストセットではなく、実際の手書きサンプルでテストしてください。人間による確認がまだ必要な箇所と、ワークフローがそのレビューステップをサポートしているかどうかを理解してください。
ファイルは安全に処理され、保存されることはありません。EOBドキュメントからデータ抽出をお試しください — 登録は不要です。
FAQ
OCRはCMS-1500およびUB-04フォームを正確に読み取れますか?
はい、クリーンなスキャンでテンプレートベースのOCRを使用する場合、これらの標準化されたフォームのフィールド精度は98〜99%に達します。コピー、ファックス、低品質のスキャンでは精度が低下します。そのため、スキャナーの較正とCMS仕様に準拠した適切なOCR-redフォームの使用が重要です。
OCRは手書きの医療記録や処方箋を処理できますか?
AI搭載のOCRは、読みやすさに応じて手書きを75〜90%の精度で読み取れますが、処方箋や臨床記録で一般的な筆記体や走り書きは、人間による確認が必要なカテゴリとして残ります。ほとんどの医療ワークフローでは、手書き抽出を「使用前にレビュー」するステップとして扱い、完全自動処理とはしません。詳細な精度ベンチマークについては、最高の手書きOCRツールをご覧ください。
HIPAAはクラウドベースのOCRツールにどのように適用されますか?
PHIを含む文書を第三者OCRツールに送信する場合、HIPAAプライバシールールに基づく開示を行っていることになります。その開示には、ツール提供者とのビジネスアソシエイト契約(BAA)の署名が必要です。BAAがない場合、ツールの暗号化やセキュリティ機能に関係なく、送信はコンプライアンス違反となります。また、データの保存場所、暗号化規格、提供者のデータ削除ポリシーも確認してください。
OCRは請求フォームからどの医療コードを抽出できますか?
最新のAIベースの抽出ツールは、CPT処置コード(5桁)、ICD-10-CM診断コード(英数字、最大7文字)、HCPCSレベルIIコード、NPI番号(10桁)を識別して抽出できます。重要な要件は、ツールがコードタイプを区別することです。すべてを単一の「Code」列にまとめるツールでは、手動での再分類が必要となり、自動化の利点が無効になります。
医療文書にはテンプレートOCRとAI抽出のどちらが適していますか?
文書によって異なります。テンプレートOCRは、クリーンなスキャンのCMS-1500およびUB-04フォームに優れています。レイアウトが固定され、既知で、標準化されているためです。AI抽出は、複数のペイヤー(1,500以上のレイアウト)からのEOB、検査レポート、患者受付フォーム、臨床記録、処方箋など、その他すべてに優れています。ハイブリッドアプローチ(構造化された請求にはテンプレート、可変形式の文書にはAI)が、医療機関にとって最も実用的な構成です。
医療用OCRのコストはいくらですか?
コストはツールと処理量によって大きく異なります。医療向けエントリーレベルのクラウドOCRツールは、低容量処理(100〜500ページ)で月額$29〜$99です。中容量プラン(月間1,000〜10,000ページ)は月額$100〜$500です。統合サポート、カスタムテンプレート、専用BAAを備えたエンタープライズ導入は、通常月額$1,000以上、または年間契約が必要です。ROI計算には、入力コストの削減だけでなく、拒否された請求の再作業削減(平均$48/請求)、コンプライアンスリスクの低減、売掛金回収期間の短縮を含める必要があります。
手作業で処理される1枚のEOBは5分かかり、8〜12%のエラー率があります。同じ文書をAI抽出で処理すると10秒で完了し、構造化データがスプレッドシートに格納されます。再入力ではなく照合の準備が整うのです。ご自身の医療文書が抽出パイプラインでどのように処理されるかをご確認ください。