OCR para Saúde:
Processamento de Prontuários Médicos, EOB e Formulários de Reclamação
Um único formulário de reclamação CMS-1500 contém mais de 30 campos — dados demográficos do paciente, identificadores de seguro, até 12 códigos de diagnóstico (ICD-10-CM), códigos de procedimento (CPT/HCPCS), modificadores, ponteiros de diagnóstico, cobranças e números de NPI do prestador — tudo em uma página em um layout projetado para processamento em papel, não para extração digital. Agora multiplique isso pelas 247.000 reclamações em papel ainda enviadas semanalmente só ao Medicare, adicione EOBs de mais de 1.500 formatos distintos de pagadores, laudos laboratoriais com tabelas de resultados aninhadas e formulários de admissão de pacientes preenchidos às pressas em letra cursiva na recepção, e a pergunta muda de "o OCR consegue lidar com documentos de saúde" para "qual abordagem lida com qual documento, e onde cada abordagem falha."
Principais Conclusões
- 30% de todas as negativas de faturamento médico começam com códigos CPT ou ICD-10 inseridos incorretamente — a $48 por reclamação negada para retrabalho, contra $3 para validação antes do envio, a entrada manual de dados custa 16 vezes o que custa a automação.
- O OCR com modelo atinge 99% de precisão de campo em um CMS-1500 limpo — mas fotocopie esse mesmo formulário e a precisão despenca abaixo de 80%, um detalhe de calibração de scanner que as alegações de precisão dos fornecedores quase nunca mencionam.
- Sem um Business Associate Agreement assinado, a ferramenta de OCR não pode processar legalmente nenhum documento que contenha dados de pacientes — a HIPAA exige isso independentemente de quantos noves os benchmarks de precisão de extração tenham.
O que o OCR para Saúde Realmente É
OCR para saúde é a aplicação de reconhecimento óptico de caracteres e compreensão de documentos baseada em IA aos documentos específicos que as organizações médicas lidam: formulários de reclamação de seguro (CMS-1500 para reclamações profissionais, UB-04 para reclamações institucionais), extratos de Explicação de Benefícios (EOB) das operadoras, resultados de laboratório e laudos patológicos, formulários de admissão e registro de pacientes, receituários, cartas de encaminhamento, resumos de alta e notas clínicas.
A distinção em relação ao OCR em outros setores importa porque os documentos médicos combinam três desafios que raramente aparecem juntos em outros lugares: variabilidade estrutural rígida (mais de 1.500 formatos de EOB), códigos específicos do domínio que devem ser transcritos com precisão (CPT, ICD-10-CM, HCPCS, NPI) e requisitos regulatórios em torno de informações de saúde protegidas (PHI) definidos pela Regra de Privacidade da HIPAA em 45 CFR §164.514.
As seis categorias de documentos que cobrem mais de 90% da intenção de busca por OCR para saúde são: EOBs (aviso de remessa da operadora), CMS-1500 (reclamações profissionais), UB-04 (reclamações institucionais), laudos de laboratório (resultados clínicos), formulários de admissão de pacientes (registro e histórico) e prescrições (ordens de medicamentos manuscritas ou impressas). Cada uma apresenta um perfil de extração único — e nenhuma abordagem única de OCR lida com todas as seis igualmente bem.
Para uma compreensão fundamental de como o OCR funciona em geral, veja o que é OCR e como ele lê documentos. Para a evolução impulsionada por IA que lida com os documentos não padronizados dos quais a saúde depende, veja o que é OCR com IA e como ele difere.
Por que a Saúde Precisa de OCR — O Problema Quantificado
A entrada manual de dados no faturamento de saúde tem um padrão de falha específico que a automação aborda diretamente. Não é que a equipe de faturamento seja descuidada. É que o volume e a complexidade da entrada de dados em papel excedem o que a precisão humana consegue sustentar ao longo de um turno de oito horas.
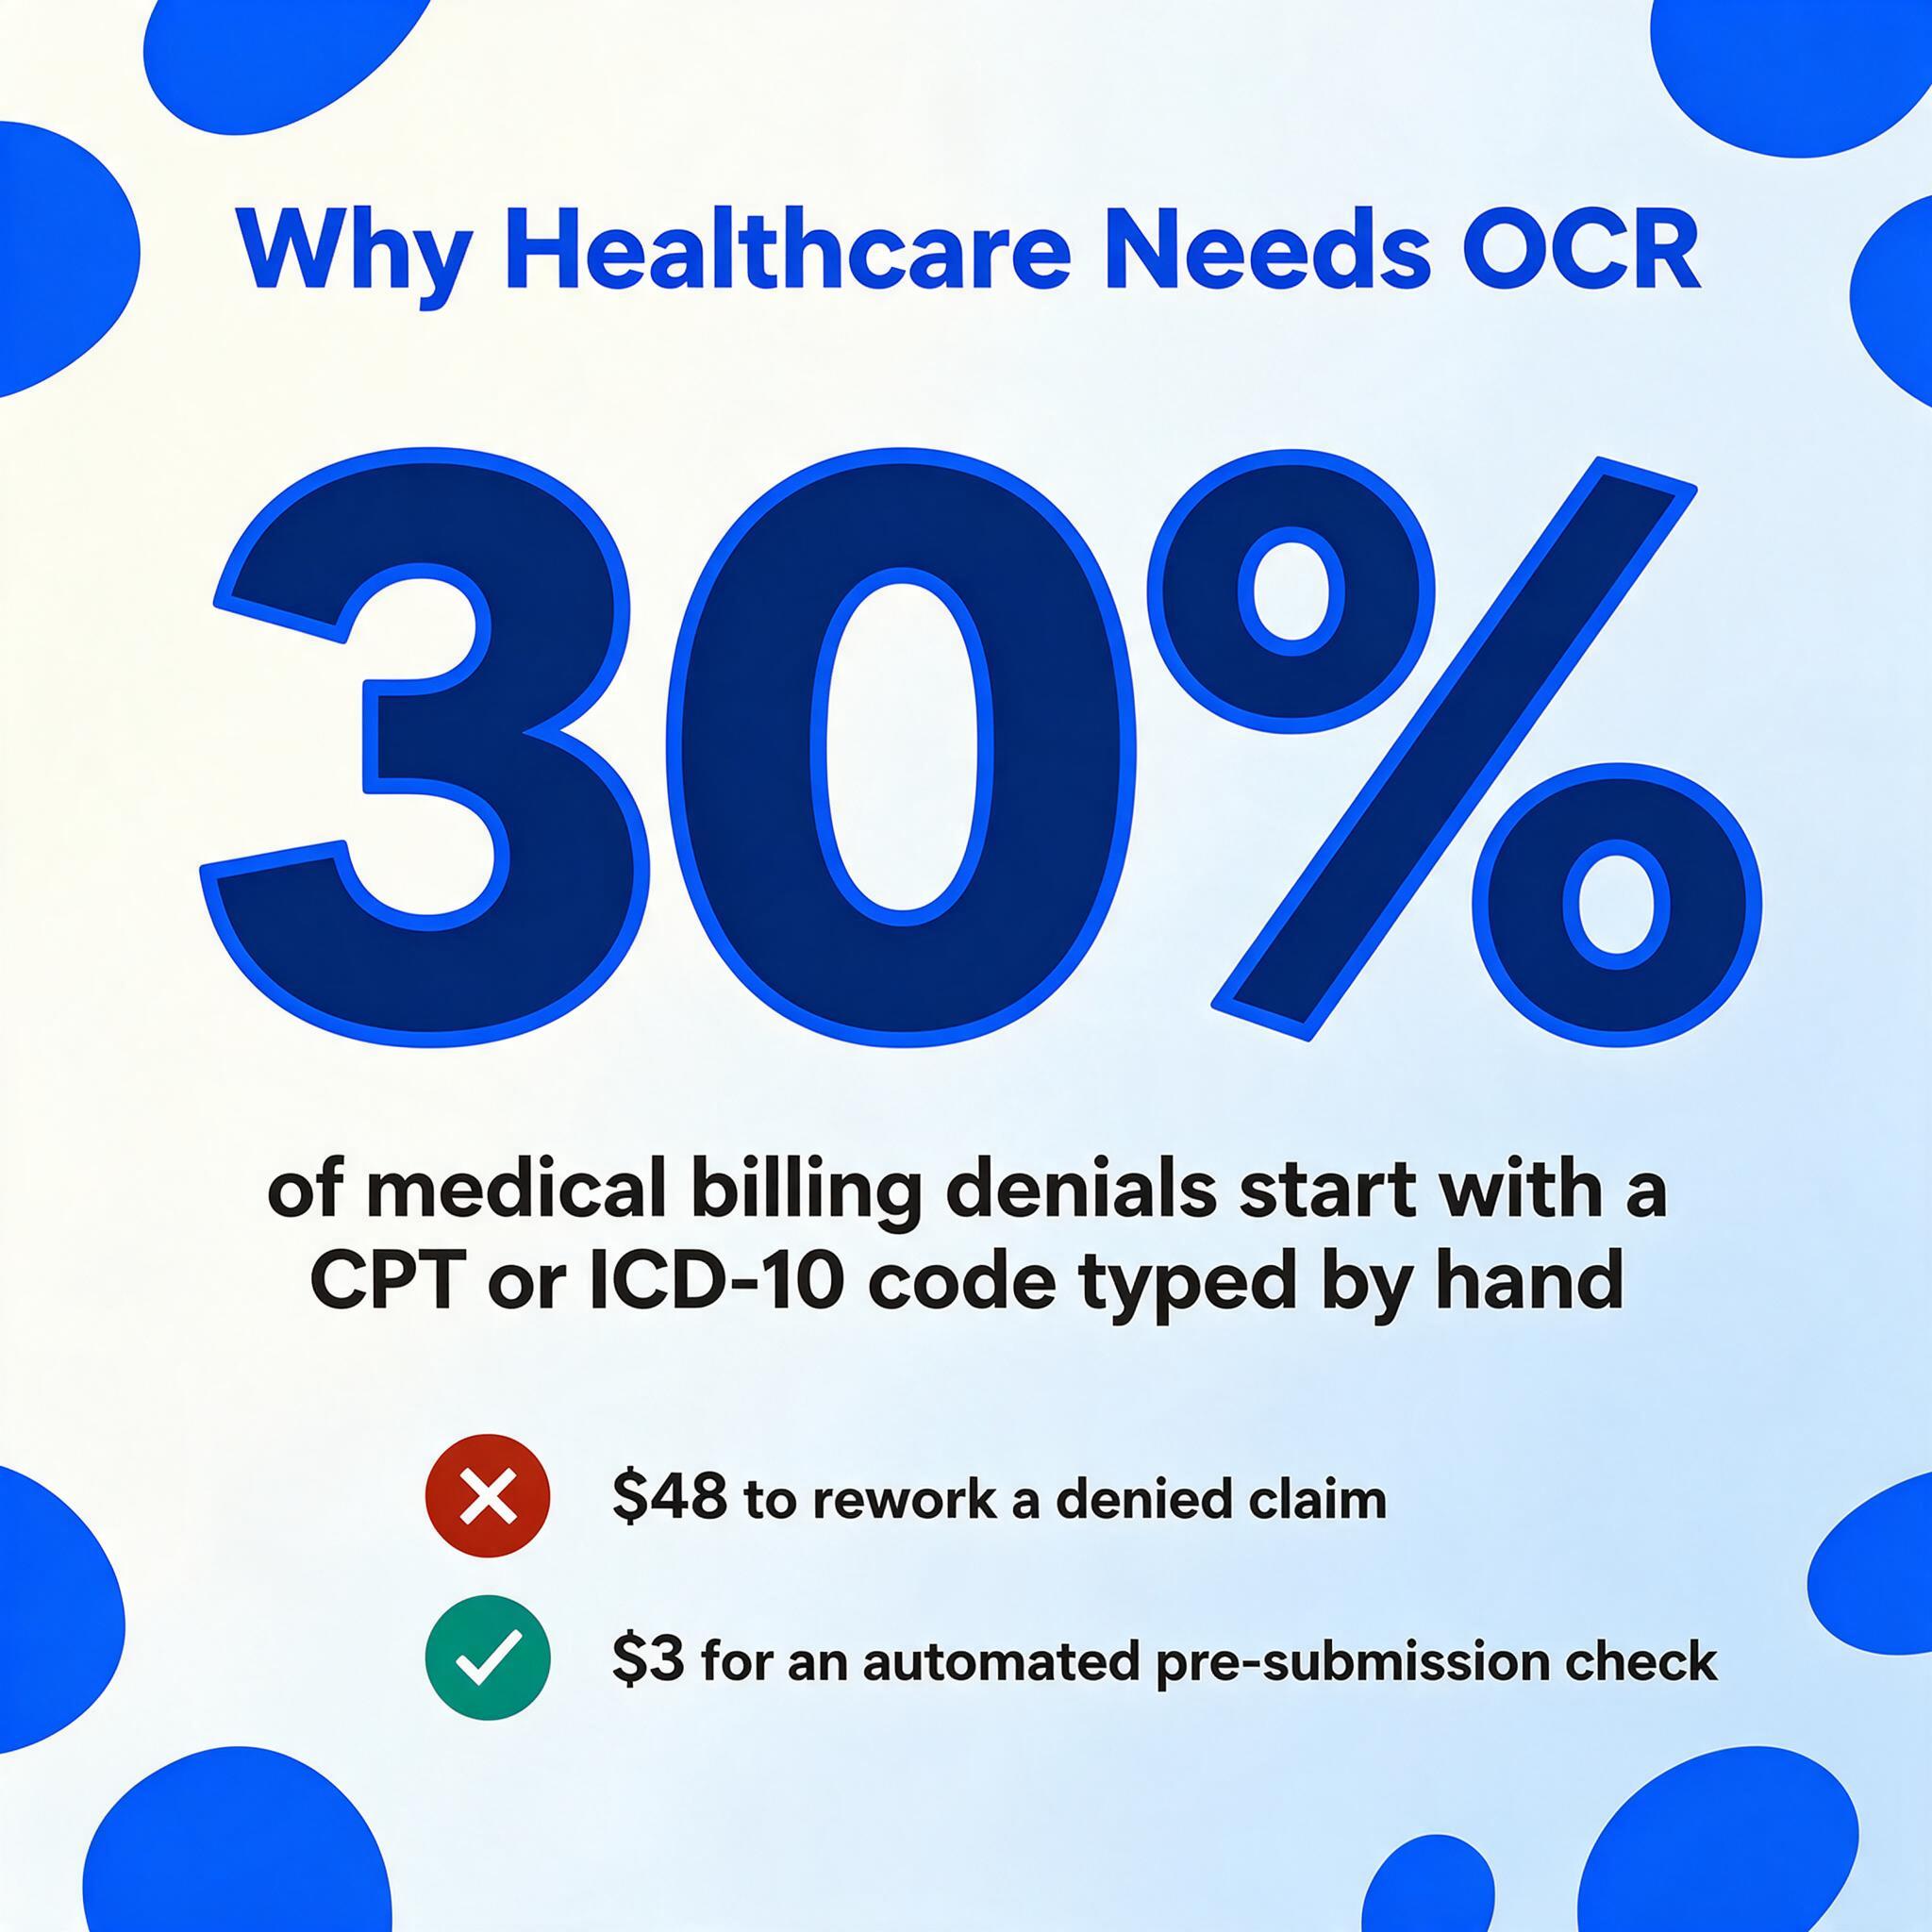
Os números vêm de várias direções. A OCR Solutions, que opera uma implantação do Medicaid do Texas processando mais de 1 milhão de reclamações por mês desde 2021, relata que cerca de 30% de todas as negativas de faturamento médico se originam de códigos CPT ou ICD-10 incorretos inseridos durante a captura manual de dados. Uma análise separada da mesma equipe estima o custo médio de retrabalho de negativas em $48 por reclamação, em comparação com $3 para uma verificação automatizada de pré-envio — uma proporção de custo de 16:1. A própria orientação da AMA sobre erros de codificação confirma que os erros mais comuns — modificador errado, vínculo inconsistente entre diagnóstico e procedimento, código desatualizado — são estruturais, não aleatórios. Eles acontecem porque a pessoa que insere os dados não consegue verificar simultaneamente todas as dependências entre campos que o sistema de processamento de reclamações exigirá depois.
Depois, há a matemática da mão de obra. A digitação manual de um único formulário CMS-1500 ou UB-04 leva de 5 a 10 minutos. Uma equipe de ciclo de receita hospitalar que processa 500 cobranças por dia gasta de 40 a 80 horas-pessoa só digitando — não reconciliando, não questionando, apenas transferindo caracteres de um formato para outro. A extração automatizada reduz isso para menos de 60 segundos por formulário, o que não elimina o papel humano, mas o desloca da transcrição para a verificação, onde o julgamento clínico e de faturamento realmente importa.
Além do faturamento, o registro de resultados de laboratório e a digitalização da admissão de pacientes seguem padrões semelhantes: a transcrição manual de requisições em papel e formulários de registro consome tempo que poderia ser dedicado ao atendimento ao paciente, e a taxa de erro — tipicamente de 8 a 12% em entrada de dados de alto volume — se acumula em custos de reconciliação e retrabalho que a maioria dos consultórios nunca contabiliza.
Principais Tipos de Documentos de Saúde e Seus Desafios de Extração
Saúde não é um único tipo de documento. Cada categoria principal apresenta um perfil de extração diferente que determina qual abordagem de OCR — baseada em modelo, baseada em IA ou híbrida — é apropriada.
Extratos de EOB (Explanation of Benefits)
O EOB é indiscutivelmente o documento mais variável em formato na área da saúde. Existem mais de 1.500 layouts de EOB específicos de cada operadora em seguradoras comerciais (BCBS, UnitedHealthcare, Aetna, Cigna, Humana), pagadores governamentais (Medicare, Medicaid, Tricare) e seguradoras de acidentes de trabalho. O Medicare chama seu identificador de cobrança de "ICN" (Internal Control Number). A BCBS coloca o número da cobrança no canto superior direito. A Aetna o coloca em um bloco de cabeçalho à esquerda. Os três significam a mesma coisa — o identificador de cobrança — mas um modelo de OCR baseado em posição precisaria de três configurações separadas para capturá-lo.
Os campos que importam para a reconciliação são: número da cobrança / ICN, nome e ID do paciente, data do serviço, códigos de procedimento CPT com modificadores, valor cobrado, valor permitido, valor pago pelo plano, franquia, coparticipação, cosseguro, responsabilidade do paciente e códigos de motivo de negativa. O desafio não é ler os caracteres — o OCR moderno faz isso de forma confiável. O desafio é mapear cada valor para a coluna correta quando o mesmo dado aparece em posições diferentes no extrato de cada operadora.
É aqui que o OCR baseado em modelo atinge seu limite e a extração semântica por IA — em que o sistema entende o que significa um "número de cobrança" e o encontra por conceito, não por posição — torna-se necessária. Para um aprofundamento, veja nosso guia completo de extração de dados de EOB, ou experimente a ferramenta de extração de EOB para Excel diretamente em um extrato de operadora.
CMS-1500 (Formulário de Reclamação Profissional)
O formulário CMS-1500, também conhecido como HCFA-1500, é o formulário de reclamação em papel padrão usado por médicos, clínicas e prestadores não institucionais para faturar o Medicare e a maioria das seguradoras comerciais. Ele tem 33 campos numerados (além de várias subdivisões) comprimidos em uma única página. A densidade é a característica — o formulário captura tudo o que é necessário para a adjudicação da reclamação em um espaço padronizado em papel —, mas essa mesma densidade o torna um dos formulários mais difíceis para o OCR de uso geral analisar corretamente.
A questão estrutural crítica são as dependências entre campos. O campo 24E (indicador de diagnóstico) deve referenciar um código ICD-10-CM válido listado no campo 21 (diagnóstico ou natureza da doença ou lesão). Um indicador desalinhado é invisível para a digitação humana — a pessoa que digita não consegue verificar simultaneamente que cada código indicador no campo 24E corresponde a uma entrada válida no campo 21 em várias linhas de serviço. O sistema de adjudicação da operadora detecta isso 30–60 dias depois como uma negativa. O OCR baseado em modelo lida bem com esse formulário — porque o layout é padronizado conforme as especificações oficiais do formulário do CMS, incluindo a exigência de tinta Flint OCR Red na versão scannable com drop-out — alcançando até 99% de precisão em nível de campo em condições ideais de digitalização.
Mas há um detalhe que a maioria dos fornecedores não menciona de antemão: a precisão do OCR do CMS-1500 depende muito da configuração do scanner. O recurso de "dropout vermelho" usado pelas operadoras do Medicare exige calibração específica do scanner. Uma fotocópia do formulário (comum em consultórios menores) não tem a tinta OCR-red exigida, então a zona de dropout não funciona, e o mecanismo de extração precisa analisar a página inteira em vez de isolar os campos preenchíveis. A diferença entre uma digitalização limpa e uma fotocópia pode fazer a precisão oscilar de 99% para menos de 80% no mesmo mecanismo de OCR.
UB-04 (Formulário de Reclamação Institucional)
Onde o CMS-1500 tem 33 campos, o UB-04 (também chamado de CMS-1450) tem 81 localizadores de formulário. Ele é usado por hospitais, instituições de cuidados prolongados, agências de saúde domiciliar e outros prestadores institucionais para faturar episódios completos de cuidado. A complexidade vem da sua estrutura em nível de linha: os localizadores de formulário 42 a 47 são itens de linha repetidos, onde código de receita, descrição do serviço, data do serviço, unidades, cobranças totais e cobranças não cobertas devem estar todos alinhados por linha. Um único código de receita lido incorretamente (por exemplo, 0450 para serviços de Pronto-Socorro vs. 0452 para Triagem de PS) desorganiza todo o preço daquela linha, e as operadoras rejeitam a reclamação em vez de adivinhar qual campo está errado.
Como o formato UB-04 é institucional — e o faturamento institucional envolve códigos de condição, códigos de ocorrência, códigos de valor e códigos de receita que não têm equivalente no CMS-1500 — é necessária uma camada separada de mapeamento e validação. Sistemas baseados em modelo com mapeamentos UB-04 pré-construídos são o padrão do setor aqui, e funcionam bem quando a qualidade da digitalização é consistente.
Laudos Laboratoriais e Resultados de Patologia
Laudos laboratoriais diferem dos formulários de reclamação de uma forma crítica: eles não são padronizados. Cada laboratório (Quest, LabCorp, laboratórios hospitalares) usa seu próprio modelo de laudo. Os dados em si são estruturados — nome do teste, valor do resultado, faixa de referência e indicador (normal/anormal) — mas o layout varia. Alguns laudos laboratoriais apresentam resultados em listas verticais, outros em tabelas, e outros em um formato misto de narrativa com tabela. O desafio da extração é distinguir entre o nome do teste (por exemplo, "Hemoglobina A1c"), o valor do resultado ("7,2%"), a faixa de referência ("<5,7% normal, 5,7-6,4% pré-diabetes, ≥6,5% diabetes") e o indicador ("Alto"). Ler esses itens como um bloco de texto de OCR não produz dados utilizáveis — os valores precisam cair em colunas separadas com a associação de linha correta.
Formulários de Admissão e Registro de Pacientes
Os formulários de admissão combinam três elementos pouco amigáveis ao OCR: caixas de seleção (marcadas, riscadas ou circuladas), caligrafia (nome do paciente, endereço, motivo da consulta, histórico médico) e campos de formato misto (alguns pré-impressos, outros de texto livre). As caixas de seleção são especialmente complicadas — o OCR tradicional lê texto, não a presença ou ausência de uma marca dentro de uma caixa. Modelos de visão baseados em IA lidam melhor com isso porque enxergam o documento como imagem e conseguem detectar se uma caixa está preenchida, independentemente do método de marcação. Para o componente de caligrafia, a extração por IA melhorou significativamente nos últimos anos, mas a precisão varia muito conforme a legibilidade da escrita. Consulte nosso guia de softwares de OCR para caligrafia para saber o que a tecnologia atual consegue e não consegue processar.
Para a papelada de registro especificamente, o objetivo prático é uma linha por paciente: uma execução de formulário de admissão de paciente para Excel mapeia as caixas marcadas, as respostas manuscritas e os campos de plano de saúde nessas colunas em uma única passagem.
Receitas
As receitas representam o caso extremo do problema da caligrafia. Médicos escrevendo após um dia inteiro de consultas produzem algumas das escritas cursivas mais desafiadoras de qualquer setor. As consequências são graves — um nome de medicamento ou dosagem lido incorretamente pode causar dano ao paciente. O OCR tradicional basicamente falha com caligrafia cursiva; modelos de visão baseados em IA alcançam 85–95% de precisão em receitas manuscritas de qualidade razoável, mas caem significativamente em digitalizações de baixa qualidade ou escritas apressadas. A maioria dos fluxos de trabalho de OCR na área da saúde trata as receitas como uma categoria que exige verificação humana, em vez de um alvo de automação direta.
Os Campos Que Importam: Códigos Médicos, Identificadores e PHI
Documentos médicos carregam elementos de dados que não têm equivalente em outros setores. Uma fatura tem uma data e um total. Uma cobrança médica tem esses itens mais códigos que determinam se a cobrança será paga, negada ou auditada. Entender o que esses códigos são e por que importam para a extração é a diferença entre comprar uma ferramenta de OCR de uso geral e comprar uma que funciona para a área da saúde.
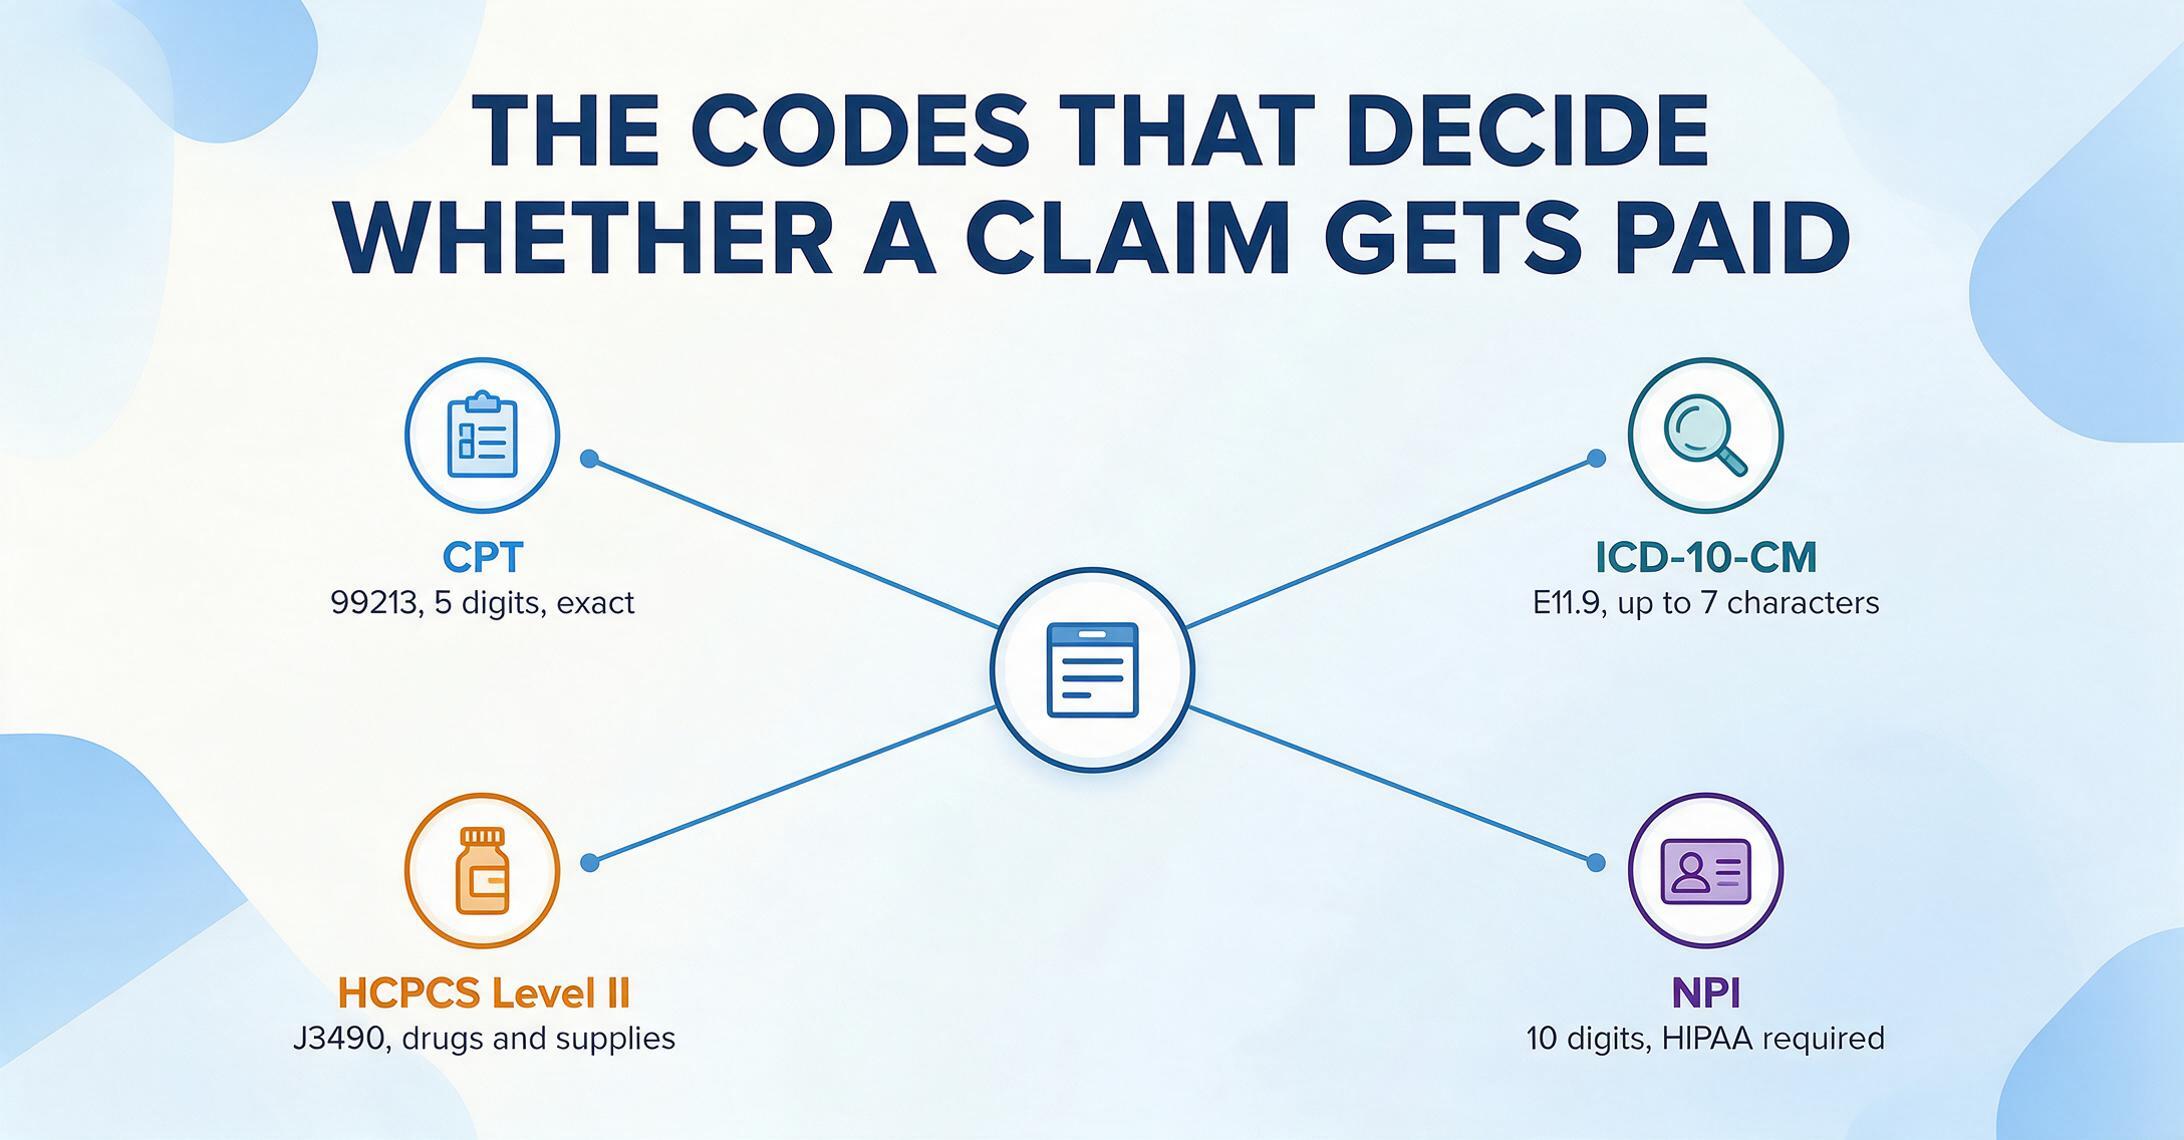
Códigos CPT
Current Procedural Terminology, mantida pela American Medical Association. Códigos numéricos de cinco dígitos que descrevem procedimentos e serviços médicos. Exemplo: 99213 (consulta de paciente estabelecido, nível 3). A IA precisa distinguir o código de procedimento do código de diagnóstico — eles costumam aparecer na mesma linha.
Códigos ICD-10-CM
International Classification of Diseases, 10th Revision, Clinical Modification. Códigos alfanuméricos de até 7 caracteres que descrevem diagnósticos. Exemplo: E11.9 (diabetes tipo 2 sem complicações). Aproximadamente 72.000 códigos ativos exigem extração precisa caractere por caractere.
HCPCS Nível II
Healthcare Common Procedure Coding System, mantido pelo CMS. Códigos alfanuméricos para produtos, suprimentos e serviços não cobertos pelo CPT. Exemplo: J3490 (medicamento não classificado). Comum em cobranças institucionais UB-04.
Números NPI
National Provider Identifier. Um identificador numérico de 10 dígitos exigido pela HIPAA para todos os prestadores de serviços de saúde. Deve seguir o formato padrão de 10 dígitos; a validação da extração deve verificar esse padrão.
Depois há o PHI — Protected Health Information. Segundo a Regra de Privacidade da HIPAA, 18 categorias de identificadores tornam a informação de saúde individualmente identificável. Isso inclui os óbvios — nomes, endereços, números de Seguro Social — mas também datas (data de nascimento, datas de admissão/alta, datas de óbito), números de telefone, números de fax, endereços de e-mail, números de prontuário médico, números de beneficiário do plano de saúde, números de conta, números de certificado/licença, identificadores de veículo, identificadores e números de série de dispositivos, URLs, endereços IP, identificadores biométricos, fotografias de rosto inteiro e qualquer outro número, característica ou código de identificação exclusivo.
A implicação prática para a escolha de ferramentas de OCR: qualquer ferramenta que processe documentos médicos contendo qualquer um desses 18 identificadores — e um EOB sem nome do paciente e número da cobrança é inútil para faturamento — cria uma divulgação sob a HIPAA. Essa divulgação exige um Business Associate Agreement (BAA) assinado, conforme 45 CFR §164.504(e). Uma ferramenta que não pode ou não quer assinar um BAA não é candidata viável para o processamento de documentos de saúde, independentemente de seus números de precisão.
OCR tradicional vs extração com IA para documentos de saúde
A questão não é "qual é melhor", mas "qual para qual documento". A área da saúde é incomum porque tanto o OCR tradicional com modelo quanto a extração moderna com IA têm papéis legítimos, e a abordagem ideal varia conforme o tipo de documento.
| Tipo de documento | Melhor abordagem | Por quê | Precisão alcançável |
|---|---|---|---|
| CMS-1500 (digitalização limpa) | OCR com modelo | Layout fixo, coordenadas de campo conhecidas, suporte a dropout vermelho | 98–99% no nível do campo |
| CMS-1500 (fotocópia/fax) | Extração com IA | Sem zona de dropout vermelho; a IA pode inferir a localização dos campos semanticamente | 85–92% no nível do campo |
| UB-04 (limpo) | OCR com modelo | 81 localizadores de formulário fixos, estrutura conhecida | 98–99% no nível do campo |
| EOB (qualquer operadora) | Extração com IA | Mais de 1.500 layouts exclusivos; sem posições fixas de campo | 85–95% no nível do campo |
| Laudos laboratoriais | Extração com IA | Layouts não padronizados por laboratório; correspondência semântica necessária | 80–92% no nível do campo |
| Formulários de admissão de pacientes | Extração com IA | Caixas de seleção + manuscrito + campos mistos | 75–90% (depende do manuscrito) |
| Receitas médicas | Extração com IA | Manuscrito cursivo; exige modelo de visão | 70–88% (exige verificação) |
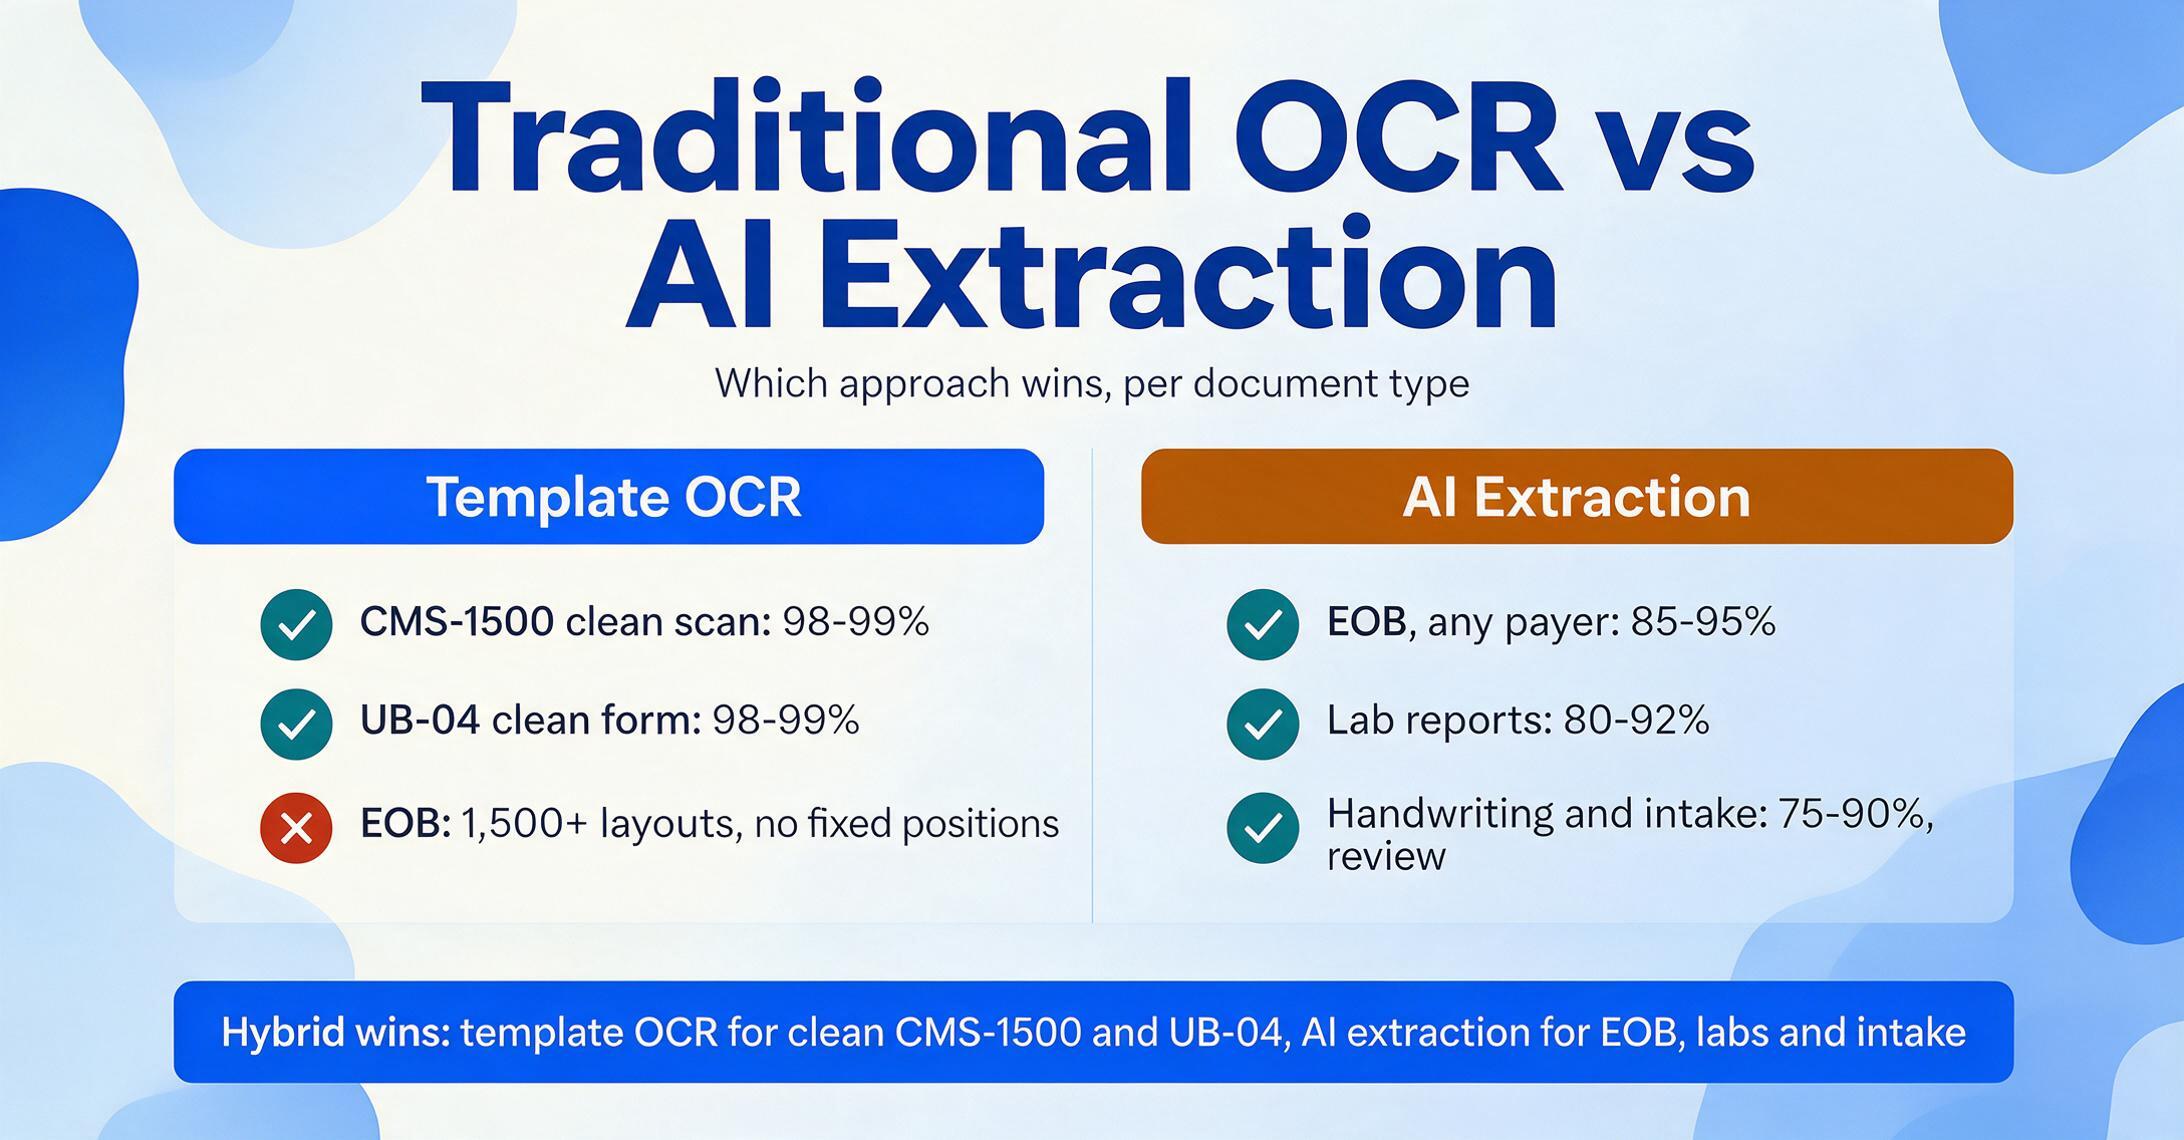
É por isso que muitas organizações de saúde acabam adotando um fluxo de trabalho híbrido: OCR com modelo para os formulários de cobrança estruturados, onde a precisão é mais importante e a validação no nível do campo é crítica, e extração com IA para os documentos não padronizados — EOBs, laudos laboratoriais, formulários de admissão — onde a flexibilidade importa mais. As duas abordagens não são concorrentes na área da saúde; são ferramentas complementares para partes diferentes do espectro de documentos.
A resposta honesta: para formulários CMS-1500 e UB-04 com boa qualidade de digitalização, o OCR baseado em modelo continua sendo o líder em precisão. Para todos os outros tipos de documentos de saúde — EOBs, laudos laboratoriais, formulários de admissão, receitas médicas — a extração com IA é a única abordagem viável, porque os layouts são variáveis demais para os modelos acompanharem.
Considerações de Conformidade: HIPAA como Critério de Seleção
Esta é a seção em que muitos artigos sobre ferramentas de OCR se transformam em texto de marketing. Aqui está o framework prático.
A conformidade com a HIPAA não é um recurso que você ativa. É um framework legal que rege como uma ferramenta pode ser usada com dados de pacientes. Os componentes relevantes são:
- Business Associate Agreement (BAA) sob 45 CFR §164.504(e) — Um contrato assinado entre sua organização e o fornecedor da ferramenta que estabelece o fornecedor como business associate. Sem um BAA, transmitir PHI para uma ferramenta de terceiros é uma divulgação que viola a Privacy Rule.
- Minimum Necessary Rule sob 45 CFR §164.502(b) — Você deve limitar o PHI divulgado ao mínimo necessário para atingir a finalidade pretendida. Uma ferramenta que extrai tudo o que é visível em um documento e faz você filtrar a saída depois é arquiteturalmente inconsistente com esse requisito.
- Security Rule sob 45 CFR §164.306 — Salvaguardas administrativas, físicas e técnicas para PHI eletrônico. Para ferramentas de OCR baseadas em nuvem, isso significa criptografia em repouso (AES-256) e em trânsito (TLS 1.2+), controles de acesso e registro de auditoria.
Ao avaliar uma ferramenta de OCR para a área da saúde, faça estas três perguntas na ordem:
- Vocês assinarão nosso BAA? Se a resposta for não, a ferramenta não pode ser usada com nenhum documento que contenha PHI — o que exclui essencialmente todos os documentos médicos.
- Onde os dados são processados e armazenados? O BAA precisa especificar a residência dos dados. Se seu framework de conformidade exige que o PHI permaneça dentro das fronteiras dos EUA (como muitas organizações de saúde exigem), a ferramenta deve processar dados em servidores localizados nos EUA.
- O que acontece com o documento após o processamento? Os requisitos de retenção e descarte de dados da HIPAA se aplicam. Uma ferramenta que armazena seus documentos médicos indefinidamente cria uma responsabilidade de conformidade tanto para você quanto para o fornecedor. A exclusão automatizada dentro de um prazo definido (24 horas, 7 dias, etc.) é o padrão para fluxos de trabalho de extração baseados em nuvem.
Discutimos HIPAA e extração de documentos médicos em profundidade aqui, incluindo um checklist detalhado para verificar a postura de conformidade do seu fornecedor de ferramentas.
Também vale notar: mesmo o melhor BAA não protege você se estiver usando uma ferramenta que extrai mais dados do que o necessário. A Minimum Necessary Rule coloca o ônus sobre a entidade coberta — você — de garantir que a ferramenta acesse apenas os elementos de dados específicos necessários. Esta é uma área em que a extração de colunas personalizadas (em que você define exatamente quais campos extrair e a IA extrai apenas esses) oferece uma vantagem estrutural sobre o OCR de página inteira que retorna tudo e exige pós-filtragem.
Como Escolher uma Solução de OCR para Saúde
Para uma comparação completa de ferramentas em preço, precisão e prontidão de conformidade, veja nosso resumo dos melhores softwares de OCR para saúde em 2026. Se sua prioridade é especificamente a precisão de extração de EOB e formulários de reclamação CMS-1500, nosso resumo de ferramentas de extração de documentos de saúde testa sete ferramentas em documentos reais de múltiplas operadoras. O resumo abaixo cobre os cinco critérios que mais importam durante a avaliação inicial.
1. Cobertura de Documentos
A ferramenta lida com os tipos específicos de documentos que você processa? Uma ferramenta de extração de EOB é inútil para laudos laboratoriais. Um especialista em CMS-1500 não consegue lidar com seus formulários de admissão de pacientes. Se sua organização processa vários tipos de documentos (a maioria processa), procure uma ferramenta que cubra todo o espectro ou planeje manter soluções separadas para cada categoria.
2. Precisão no Nível de Código
Para formulários de reclamação e EOBs, a precisão no nível de caractere é insuficiente. Você precisa de precisão no nível de campo em códigos CPT (cinco dígitos numéricos, exatos), códigos ICD-10-CM (alfanuméricos de até 7 caracteres, exatos) e números NPI (10 dígitos, exatos). Um único caractere errado em um campo de código pode gerar uma negativa. Teste a ferramenta nos seus documentos reais, não em amostras fornecidas pelo fornecedor.
3. Prontidão de Conformidade
A disponibilidade de BAA é inegociável para qualquer carga de trabalho que contenha PHI. Além do BAA, verifique a residência dos dados (os servidores são baseados nos EUA?), os padrões de criptografia (AES-256 em repouso, TLS 1.2+ em trânsito), a retenção de dados (por quanto tempo seus documentos são armazenados?) e se a ferramenta concluiu a auditoria SOC 2 Tipo 2 ou avaliação de segurança equivalente de terceiros.
4. Integração com Seus Sistemas Existentes
Organizações de saúde operam com EHRs (Epic, Oracle Health Cerner, Meditech, Allscripts), sistemas de gestão de consultório (athenahealth, AdvancedMD, Kareo, NextGen) e centrais de processamento (Office Ally, Change Healthcare, ZirMed). A ferramenta de OCR ideal gera dados em formatos que seu sistema de faturamento consegue importar — Excel estruturado, CSV ou JSON — sem redigitação manual. Quanto menos seu fluxo de trabalho mudar, mais rápida será a adoção.
5. Capacidade de Manuscrito
Se seu fluxo de trabalho inclui receitas, notas clínicas ou formulários de admissão de pacientes com campos de texto livre, a precisão de manuscrito é um critério de seleção relevante. Teste com suas próprias amostras de manuscrito — não com o conjunto de testes selecionado do fornecedor. Entenda onde a verificação humana ainda é necessária e se o fluxo de trabalho suporta essa etapa de revisão.
Os arquivos são processados com segurança e não são armazenados. Experimente extrair dados de um documento EOB — não é necessário cadastro.
FAQ
O OCR consegue ler com precisão os formulários CMS-1500 e UB-04?
Sim, em digitalizações limpas usando OCR baseado em modelo, a precisão em nível de campo chega a 98–99% para esses formulários padronizados. A precisão cai em fotocópias, faxes e digitalizações de baixa qualidade — por isso a calibração do scanner e o uso de formulários OCR-red adequados (conforme as especificações do CMS) são importantes.
O OCR lida com prontuários médicos e receitas manuscritas?
O OCR com IA consegue ler manuscritos com 75–90% de precisão, dependendo da legibilidade, mas a caligrafia cursiva e apressada — comum em receitas e anotações clínicas — continua sendo uma categoria que exige verificação humana. A maioria dos fluxos de trabalho de saúde trata a extração de manuscritos como uma etapa de "revisar antes de usar", em vez de automação direta. Veja nossas melhores ferramentas de OCR para manuscritos para benchmarks detalhados de precisão.
Como a HIPAA se aplica a ferramentas de OCR na nuvem?
Se você enviar qualquer documento contendo PHI para uma ferramenta de OCR de terceiros, estará fazendo uma divulgação sob a Regra de Privacidade da HIPAA. Essa divulgação exige um Business Associate Agreement (BAA) assinado com o fornecedor da ferramenta. Sem um BAA, a transmissão é uma violação de conformidade, independentemente dos recursos de criptografia ou segurança da ferramenta. Verifique também a residência dos dados, os padrões de criptografia e a política de exclusão de dados do fornecedor.
Quais códigos médicos o OCR consegue extrair de formulários de cobrança?
Ferramentas modernas de extração com IA conseguem identificar e extrair códigos de procedimento CPT (5 dígitos), códigos de diagnóstico ICD-10-CM (alfanuméricos, até 7 caracteres), códigos HCPCS Nível II e números NPI (10 dígitos). O requisito principal é que a ferramenta distinga entre os tipos de código — uma ferramenta que joga tudo em uma única coluna "Code" força uma reordenação manual que anula o benefício da automação.
OCR com modelo ou extração com IA: qual é melhor para documentos médicos?
Depende do documento. O OCR com modelo é superior para formulários CMS-1500 e UB-04 com digitalizações limpas — os layouts são fixos, conhecidos e padronizados. A extração com IA é superior para todo o resto: EOBs de vários pagadores (mais de 1.500 layouts), laudos laboratoriais, formulários de admissão de pacientes, anotações clínicas e receitas. Uma abordagem híbrida — modelo para cobranças estruturadas, IA para documentos de formato variável — é a configuração mais prática para organizações de saúde.
Quanto custa o OCR para a área da saúde?
Os custos variam muito conforme a ferramenta e o volume. Ferramentas de OCR na nuvem de nível básico para a área da saúde custam de $29 a $99/mês para processamento de baixo volume (100–500 páginas). Planos de volume médio (1.000–10.000 páginas/mês) ficam entre $100 e $500/mês. Implantações empresariais com suporte à integração, modelos personalizados e BAAs dedicados normalmente começam em $1.000+/mês ou exigem contratos anuais. O cálculo do ROI deve incluir não apenas o custo de digitação economizado, mas também a redução do retrabalho de glosas ($48/cobrança em média), menos riscos de conformidade e menos dias em contas a receber.
Um único EOB processado manualmente leva 5 minutos e tem uma taxa de erro de 8–12%. O mesmo documento processado com extração por IA leva 10 segundos e entrega dados estruturados em uma planilha — prontos para conciliação, não para redigitação. Veja como seus próprios documentos médicos ficam em um pipeline de extração.