OCR für das Gesundheitswesen:
Verarbeitung von Krankenakten, EOBs und Abrechnungsformularen
Ein einziges CMS-1500-Abrechnungsformular enthält über 30 Felder — Patientendemografie, Versicherungsidentifikatoren, bis zu 12 Diagnosecodes (ICD-10-CM), Prozedurcodes (CPT/HCPCS), Modifikatoren, Diagnosezeiger, Gebühren und NPI-Nummern der Leistungserbringer — alles auf einer Seite in einem Layout, das für die Papierverarbeitung und nicht für die digitale Extraktion konzipiert wurde. Multiplizieren Sie das nun mit den 247.000 Papierabrechnungen, die allein bei Medicare noch wöchentlich eingereicht werden, fügen Sie EOBs aus über 1.500 verschiedenen Kostenträgerformaten, Laborberichte mit verschachtelten Ergebnistabellen und Patientenaufnahmeformulare hinzu, die an der Anmeldung in eiliger Handschrift ausgefüllt werden, und die Frage verschiebt sich von „Kann OCR Dokumente im Gesundheitswesen verarbeiten?" zu „Welcher Ansatz verarbeitet welches Dokument, und wo versagt jeder Ansatz?"
Wichtige Erkenntnisse
- 30 % aller Ablehnungen im medizinischen Abrechnungswesen beginnen mit falsch eingegebenen CPT- oder ICD-10-Codes — bei $48 pro abgelehnter Abrechnung für die Nachbearbeitung gegenüber $3 für die Validierung vor der Einreichung kostet die manuelle Dateneingabe 16-mal so viel wie die Automatisierung.
- Vorlagen-OCR erreicht 99 % Feldgenauigkeit bei einem sauberen CMS-1500 — doch kopieren Sie dasselbe Formular, und die Genauigkeit stürzt unter 80 % ab, ein Kalibrierungsfehler des Scanners, den Genauigkeitsangaben von Anbietern fast nie erwähnen.
- Ohne unterzeichneten Business Associate Agreement darf das OCR-Tool rechtlich kein Dokument mit Patientendaten verarbeiten — HIPAA verlangt dies unabhängig davon, wie viele Neunen die Benchmarks zur Extraktionsgenauigkeit aufweisen.
Was OCR für das Gesundheitswesen tatsächlich ist
OCR für das Gesundheitswesen ist die Anwendung optischer Zeichenerkennung und KI-basierter Dokumentenerkennung auf die spezifischen Dokumente, die medizinische Organisationen verarbeiten: Krankenversicherungsformulare (CMS-1500 für professionelle Ansprüche, UB-04 für institutionelle Ansprüche), Explanation of Benefits (EOB)-Abrechnungen von Kostenträgern, Laborergebnisse und Pathologieberichte, Patientenaufnahme- und Registrierungsformulare, Rezeptblöcke, Überweisungsschreiben, Entlassungsberichte und klinische Notizen.
Die Unterscheidung zu OCR in anderen Branchen ist wichtig, weil medizinische Dokumente drei Herausforderungen kombinieren, die anderswo selten gemeinsam auftreten: strikte strukturelle Variabilität (über 1.500 EOB-Formate), domänenspezifische Codes, die präzise übertragen werden müssen (CPT, ICD-10-CM, HCPCS, NPI), und regulatorische Anforderungen an geschützte Gesundheitsinformationen (PHI), die durch die HIPAA Privacy Rule unter 45 CFR §164.514 definiert sind.
Die sechs Dokumentenkategorien, die über 90 % der Suchintention für OCR im Gesundheitswesen abdecken, sind: EOBs (Zahlungsavise der Kostenträger), CMS-1500 (professionelle Ansprüche), UB-04 (institutionelle Ansprüche), Laborberichte (klinische Ergebnisse), Patientenaufnahmeformulare (Registrierung und Anamnese) und Rezepte (handschriftliche oder gedruckte Medikamentenverordnungen). Jede stellt ein einzigartiges Extraktionsprofil dar — und kein einzelner OCR-Ansatz bewältigt alle sechs gleich gut.
Für ein grundlegendes Verständnis davon, wie OCR im Allgemeinen funktioniert, siehe was OCR ist und wie es Dokumente liest. Für die KI-gestützte Weiterentwicklung, die die nicht standardisierten Dokumente bewältigt, auf die das Gesundheitswesen angewiesen ist, siehe was KI-OCR ist und wie sie sich unterscheidet.
Warum das Gesundheitswesen OCR braucht — das quantifizierte Problem
Die manuelle Dateneingabe in der Abrechnung des Gesundheitswesens hat ein spezifisches Fehlermuster, das die Automatisierung direkt adressiert. Es liegt nicht daran, dass das Abrechnungspersonal nachlässig ist. Es liegt daran, dass das Volumen und die Komplexität der papierbasierten Dateneingabe die menschliche Genauigkeit über eine Acht-Stunden-Schicht hinaus übersteigen.
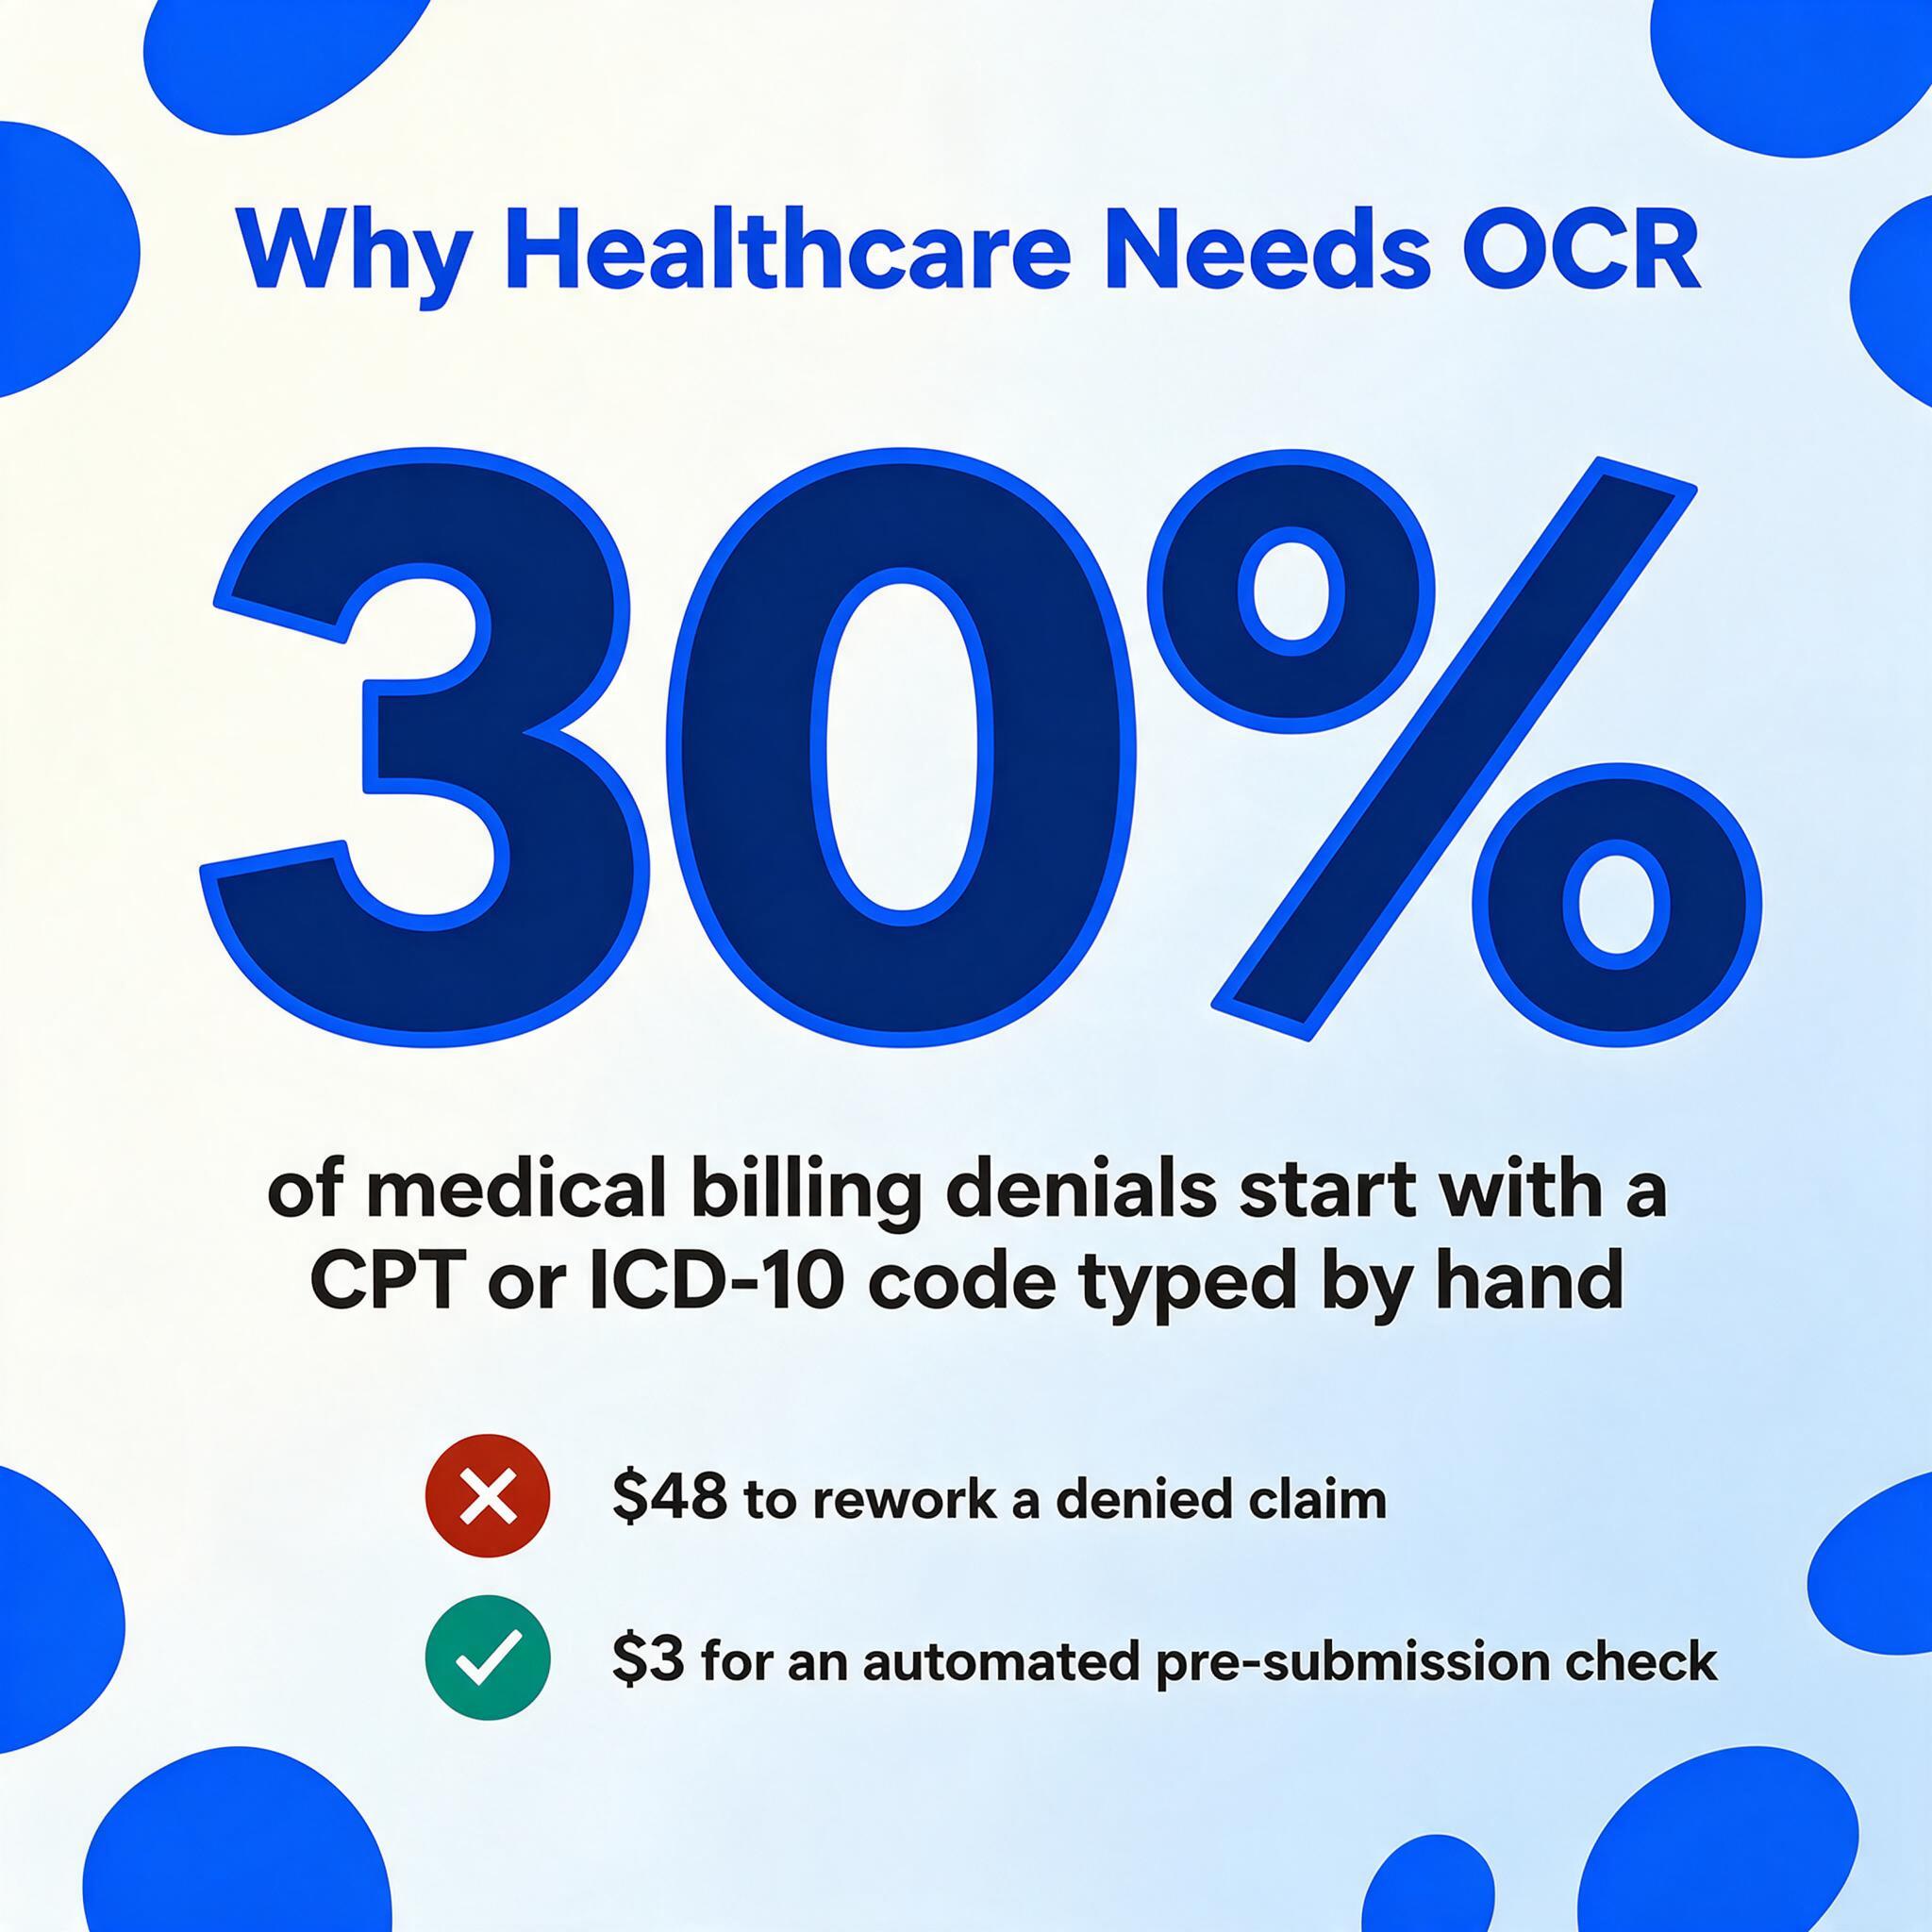
Die Zahlen kommen aus mehreren Richtungen. OCR Solutions, das seit 2021 einen Texas-Medicaid-Einsatz mit über 1 Million Ansprüchen pro Monat betreibt, berichtet, dass etwa 30 % aller Ablehnungen medizinischer Abrechnungen auf falsche CPT- oder ICD-10-Codes zurückzuführen sind, die bei der manuellen Datenerfassung eingegeben wurden. Eine separate Analyse desselben Teams schätzt die durchschnittlichen Nachbearbeitungskosten für Ablehnungen auf $48 pro Anspruch, verglichen mit $3 für eine automatisierte Prüfung vor der Einreichung — ein Kostenverhältnis von 16:1. Die eigene Anleitung der AMA zu Kodierungsfehlern bestätigt, dass die häufigsten Fehler — falscher Modifier, nicht übereinstimmende Verknüpfung von Diagnose und Prozedur, veralteter Code — struktureller Natur sind, nicht zufällig. Sie entstehen, weil die Person, die die Daten eingibt, nicht gleichzeitig jede feldübergreifende Abhängigkeit prüfen kann, die das Anspruchsverarbeitungssystem später durchsetzen wird.
Dann ist da die Arbeitsrechnung. Die manuelle Eingabe eines einzelnen CMS-1500- oder UB-04-Formulars dauert 5–10 Minuten. Ein Krankenhaus-Revenue-Cycle-Team, das 500 Ansprüche pro Tag verarbeitet, verbringt allein 40–80 Personenstunden mit Tippen — nicht mit Abstimmen, nicht mit Hinterfragen, sondern nur mit dem Übertragen von Zeichen von einem Format in ein anderes. Automatisierte Extraktion reduziert das auf unter 60 Sekunden pro Formular, was die menschliche Rolle nicht eliminiert, sondern sie von der Transkription zur Verifizierung verschiebt, wo klinisches und Abrechnungsurteilsvermögen tatsächlich zählt.
Über die Abrechnung hinaus folgen Laborergebnis-Erfassung und Digitalisierung der Patientenaufnahme ähnlichen Mustern: Manuelle Transkription aus Papier-Anforderungen und Registrierungsformularen verbraucht Zeit, die für patientennahe Arbeit aufgewendet werden könnte, und die Fehlerquote — typischerweise 8–12 % bei Dateneingabe mit hohem Volumen — summiert sich zu nachgelagerten Abstimmungs- und Nacharbeitskosten, die die meisten Praxen nie zusammenzählen.
Wichtige Dokumenttypen im Gesundheitswesen und ihre Extraktionsherausforderungen
Das Gesundheitswesen ist nicht ein Dokumenttyp. Jede Hauptkategorie weist ein anderes Extraktionsprofil auf, das bestimmt, welcher OCR-Ansatz — vorlagenbasiert, KI-basiert oder hybrid — geeignet ist.
EOB (Explanation of Benefits)-Abrechnungen
Der EOB ist wohl das formatvariabelste Dokument im Gesundheitswesen. Es gibt über 1.500 einzigartige kostenträgerspezifische EOB-Layouts bei kommerziellen Versicherern (BCBS, UnitedHealthcare, Aetna, Cigna, Humana), staatlichen Kostenträgern (Medicare, Medicaid, Tricare) und Trägern der Arbeiterunfallversicherung. Medicare nennt seine Anspruchskennung „ICN" (Internal Control Number). BCBS platziert die Anspruchsnummer in der oberen rechten Ecke. Aetna setzt sie in einen Kopfblock auf der linken Seite. Alle drei bedeuten dasselbe — die Anspruchskennung —, aber eine positionsbasierte OCR-Vorlage bräuchte drei separate Konfigurationen, um sie zu erfassen.
Die für die Abstimmung relevanten Felder sind: Anspruchsnummer / ICN, Patientenname und ID, Leistungsdatum, CPT-Prozedurcodes mit Modifikatoren, abgerechneter Betrag, zulässiger Betrag, Plan-Zahlung, Selbstbehalt, Zuzahlung, Eigenanteil, Patientenselbstzahlung und Ablehnungsgrundcodes. Die Herausforderung ist nicht das Lesen der Zeichen — moderne OCR erledigt das zuverlässig. Die Herausforderung ist die Zuordnung jedes Werts zur richtigen Spalte, wenn derselbe Datenpunkt auf jeder Kostenträgerabrechnung an unterschiedlichen Positionen erscheint.
Hier stößt vorlagenbasierte OCR an ihre Grenzen und semantische KI-Extraktion — bei der das System versteht, was eine „Anspruchsnummer" bedeutet, und sie nach Konzept findet, nicht nach Position — wird notwendig. Für einen tieferen Einblick lesen Sie unseren speziellen vollständigen Leitfaden zur EOB-Datenextraktion oder testen Sie das EOB-zu-Excel-Extraktionstool direkt an einer Kostenträgerabrechnung.
CMS-1500 (Professional Claim Form)
Das CMS-1500-Formular, auch als HCFA-1500 bekannt, ist das standardmäßige Papier-Abrechnungsformular, das Ärzte, Kliniken und nicht-institutionelle Leistungserbringer verwenden, um Medicare und die meisten kommerziellen Versicherer abzurechnen. Es enthält 33 nummerierte Felder (plus mehrere Unterteilungen), die auf einer einzigen Seite zusammengedrängt sind. Die Dichte ist das Merkmal — das Formular erfasst alles, was für die Anspruchsprüfung erforderlich ist, in einem standardisierten Papierformat —, aber genau diese Dichte macht es zu einem der schwierigsten Formulare für universelle OCR, um es korrekt zu erfassen.
Das kritische strukturelle Problem sind feldübergreifende Abhängigkeiten. Feld 24E (Diagnosezeiger) muss auf einen gültigen ICD-10-CM-Code verweisen, der in Feld 21 (Diagnose oder Art der Erkrankung oder Verletzung) aufgeführt ist. Ein falsch ausgerichteter Zeiger ist für die manuelle Eingabe unsichtbar — die eintippende Person kann nicht gleichzeitig überprüfen, ob jeder Zeigercode in Feld 24E mit einem gültigen Eintrag in Feld 21 über mehrere Leistungspositionen hinweg übereinstimmt. Das Prüfsystem des Kostenträgers erkennt dies 30–60 Tage später als Ablehnung. Vorlagenbasierte OCR verarbeitet dieses Formular gut — da das Layout gemäß den offiziellen Formularspezifikationen von CMS standardisiert ist, einschließlich der Anforderung von Flint OCR Red-Tinte auf der ausblendbaren scanbaren Version — und erreicht unter optimalen Scanbedingungen bis zu 99 % Genauigkeit auf Feldebene.
Doch es gibt einen Haken, den die meisten Anbieter nicht von vornherein erwähnen: Die CMS-1500-OCR-Genauigkeit hängt stark von der Scanner-Einrichtung ab. Die „Red Dropout"-Funktion, die von Medicare-Kostenträgern verwendet wird, erfordert eine spezifische Scanner-Kalibrierung. Eine Fotokopie des Formulars (in kleineren Praxen üblich) weist nicht die erforderliche OCR-Red-Tinte auf, sodass die Dropout-Zone nicht funktioniert und die Extraktions-Engine die gesamte Seite analysieren muss, anstatt die ausfüllbaren Felder zu isolieren. Der Unterschied zwischen einem sauberen Scan und einer Fotokopie kann die Genauigkeit bei derselben OCR-Engine von 99 % auf unter 80 % sinken lassen.
UB-04 (Institutionelles Leistungsverzeichnis)
Wo das CMS-1500 33 Felder hat, verfügt das UB-04 (auch CMS-1450 genannt) über 81 Formularpositionen. Es wird von Krankenhäusern, Pflegeeinrichtungen, ambulanten Pflegediensten und anderen institutionellen Leistungserbringern verwendet, um gesamte Behandlungsverläufe abzurechnen. Die Komplexität ergibt sich aus der zeilenweisen Struktur: Die Formularpositionen 42 bis 47 sind wiederkehrende Positionen, bei denen Revenue Code, Leistungsbeschreibung, Leistungsdatum, Einheiten, Gesamtkosten und nicht gedeckte Kosten pro Zeile übereinstimmen müssen. Ein einziger falsch gelesener Revenue Code (z. B. 0450 für Notaufnahmeleistungen gegenüber 0452 für ER-Triage) verfälscht die gesamte Abrechnung dieser Position, und die Kostenträger lehnen den Anspruch ab, anstatt zu raten, welches Feld falsch ist.
Da das UB-04-Format institutionell ist – und die institutionelle Abrechnung Condition Codes, Occurrence Codes, Value Codes und Revenue Codes umfasst, die keine Entsprechung im CMS-1500 haben – ist eine separate Zuordnungs- und Validierungsebene erforderlich. Vorlagenbasierte Systeme mit vorgefertigten UB-04-Zuordnungen sind hier der Branchenstandard, und sie funktionieren gut, wenn die Scanqualität gleichbleibend ist.
Laborberichte und Pathologieergebnisse
Laborberichte unterscheiden sich in einem entscheidenden Punkt von Leistungsverzeichnissen: Sie sind nicht standardisiert. Jedes Labor (Quest, LabCorp, krankenhauseigene Labore) verwendet seine eigene Berichtsvorlage. Die Daten selbst sind strukturiert – Testname, Ergebniswert, Referenzbereich und Flag (normal/abnormal) –, aber das Layout variiert. Manche Laborberichte präsentieren Ergebnisse in vertikalen Listen, andere in Tabellen und wieder andere in einem gemischten Format aus Fließtext und Tabelle. Die Herausforderung bei der Extraktion besteht darin, zwischen dem Testnamen (z. B. „Hemoglobin A1c"), dem Ergebniswert („7.2%"), dem Referenzbereich („<5.7% normal, 5.7-6.4% prediabetes, ≥6.5% diabetes") und dem Flag („High") zu unterscheiden. Diese als OCR-Textblock zu lesen, liefert keine nutzbaren Daten – die Werte müssen in separaten Spalten mit der korrekten Zeilenzuordnung landen.
Patientenaufnahme- und Registrierungsformulare
Aufnahmeformulare vereinen drei OCR-unfreundliche Elemente: Kontrollkästchen (angekreuzt, durchgestrichen oder eingekreist), Handschrift (Patientenname, Adresse, Grund des Besuchs, Krankengeschichte) und Felder mit gemischten Formaten (teils vorgedruckt, teils Freitext). Besonders knifflig sind die Kontrollkästchen — herkömmliche OCR liest Text, nicht das Vorhandensein oder Fehlen einer Markierung in einem Kästchen. KI-basierte Vision-Modelle kommen damit besser zurecht, weil sie das Dokument als Bild sehen und erkennen können, ob ein Kästchen ausgefüllt ist, unabhängig von der Markierungsmethode. Bei der Handschrift hat die KI-Extraktion in den letzten Jahren deutlich zugelegt, doch die Genauigkeit hängt stark von der Lesbarkeit der Handschrift ab. Lesen Sie unseren Leitfaden zu Handschrift-OCR-Software, um zu erfahren, was aktuelle Technologie leisten kann und was nicht.
Für die Registrierungsunterlagen specifically ist das praktische Ziel eine Zeile pro Patient: Ein Patientenaufnahmeformular-zu-Excel-Durchlauf ordnet die angekreuzten Kästchen, handschriftlichen Antworten und Versicherungsfelder in einem einzigen Durchgang diesen Spalten zu.
Rezepte
Rezepte stellen den Extremfall des Handschriftproblems dar. Ärzte, die nach einem vollen Kliniktag schreiben, produzieren einige der anspruchsvollsten Kursivschriften in jeder Branche. Der Einsatz ist hoch — ein falsch gelesener Medikamentenname oder eine falsche Dosierung kann Patienten schaden. Herkömmliche OCR scheitert an kursiver Handschrift praktisch immer; KI-basierte Vision-Modelle erreichen 85–95 % Genauigkeit bei handschriftlichen Rezepten angemessener Qualität, fallen aber bei schlechten Scans oder hastiger Handschrift deutlich ab. Die meisten OCR-Workflows im Gesundheitswesen behandeln Rezepte als Kategorie, die eine menschliche Überprüfung erfordert, statt als Ziel für durchgängige Automatisierung.
Die entscheidenden Felder: Medizinische Codes, Identifikatoren und PHI
Medizinische Dokumente enthalten Datenelemente, die in anderen Branchen keine Entsprechung haben. Eine Rechnung hat ein Datum und einen Gesamtbetrag. Ein medizinischer Anspruch hat diese plus Codes, die darüber entscheiden, ob der Anspruch bezahlt, abgelehnt oder geprüft wird. Zu verstehen, was diese Codes sind und warum sie für die Extraktion wichtig sind, ist der Unterschied zwischen dem Kauf eines Allzweck-OCR-Tools und dem Kauf eines Tools, das für das Gesundheitswesen funktioniert.
CPT-Codes
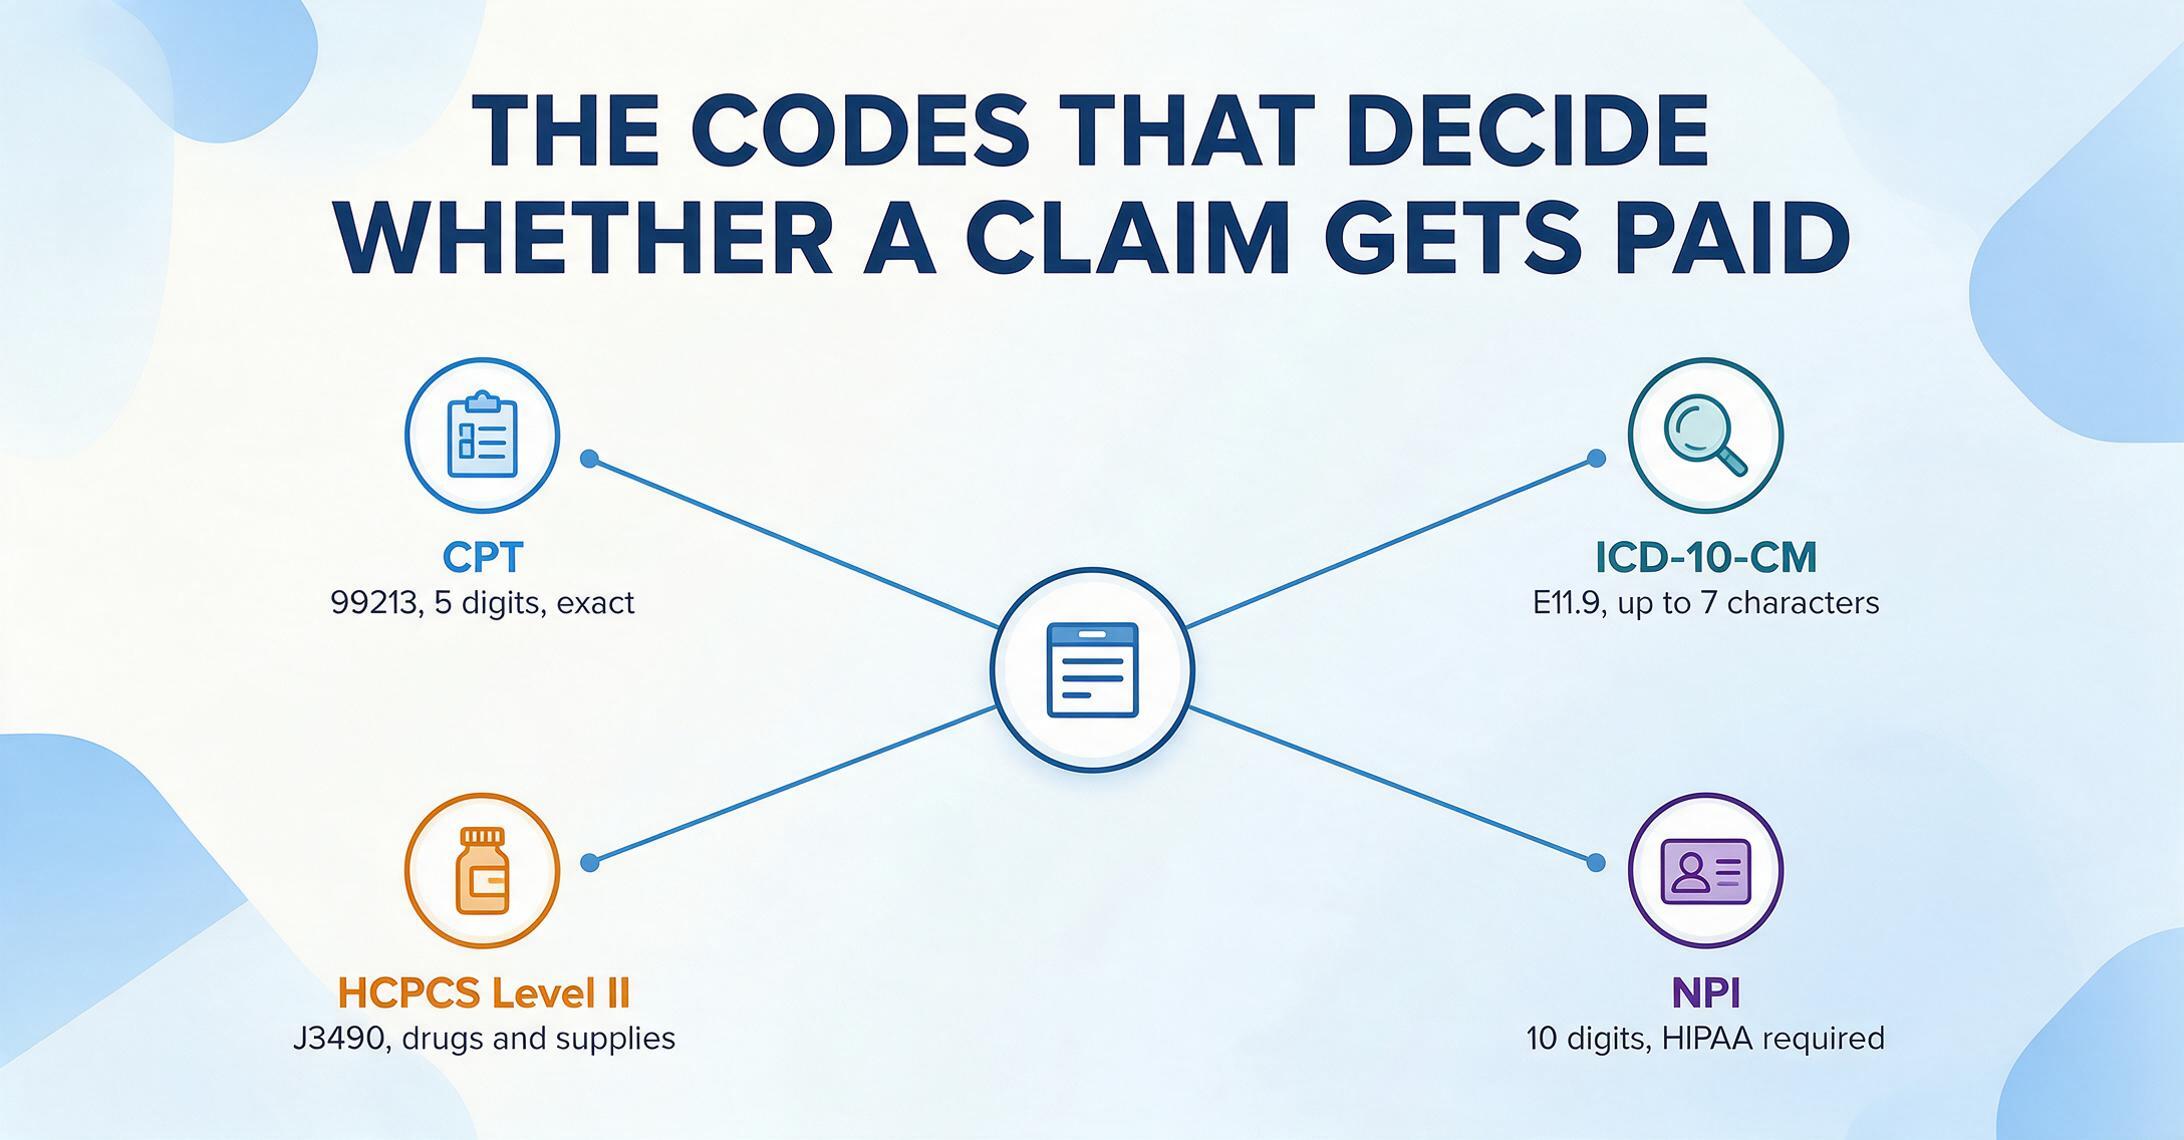
Current Procedural Terminology, gepflegt von der American Medical Association. Fünfstellige numerische Codes zur Beschreibung medizinischer Prozeduren und Leistungen. Beispiel: 99213 (Office Visit für Bestandspatienten, Level 3). Die KI muss den Prozedurcode vom Diagnosecode unterscheiden — beide stehen oft in derselben Zeile.
ICD-10-CM-Codes
International Classification of Diseases, 10th Revision, Clinical Modification. Alphanumerische Codes mit bis zu 7 Zeichen zur Beschreibung von Diagnosen. Beispiel: E11.9 (Typ-2-Diabetes ohne Komplikationen). Rund 72.000 aktive Codes erfordern eine präzise Extraktion Zeichen für Zeichen.
HCPCS Level II
Healthcare Common Procedure Coding System, gepflegt von CMS. Alphanumerische Codes für Produkte, Hilfsmittel und Leistungen, die nicht von CPT abgedeckt sind. Beispiel: J3490 (nicht klassifiziertes Arzneimittel). Häufig auf institutionellen UB-04-Abrechnungen.
NPI-Nummern
National Provider Identifier. Eine 10-stellige numerische Kennung, die HIPAA für alle Leistungserbringer im Gesundheitswesen vorschreibt. Muss dem Standardformat mit 10 Stellen entsprechen; die Extraktionsvalidierung sollte gegen dieses Muster prüfen.
Dann gibt es noch PHI — Protected Health Information. Nach der HIPAA Privacy Rule machen 18 Kategorien von Identifikatoren Gesundheitsinformationen individuell identifizierbar. Dazu gehören die offensichtlichen — Namen, Adressen, Social Security Numbers — aber auch Datumsangaben (Geburtsdatum, Aufnahme-/Entlassungsdatum, Sterbedatum), Telefonnummern, Faxnummern, E-Mail-Adressen, Krankenaktennummern, Versichertennummern, Kontonummern, Zertifikat-/Lizenznummern, Fahrzeugkennungen, Gerätekennungen und Seriennummern, URLs, IP-Adressen, biometrische Identifikatoren, Ganzgesichtsfotos sowie jede andere eindeutige identifizierende Nummer, Eigenschaft oder jeder Code.
Die praktische Konsequenz für die Auswahl eines OCR-Tools: Jedes Tool, das medizinische Dokumente mit einem dieser 18 Identifikatoren verarbeitet — und ein EOB ohne Patientennamen und Claim-Nummer ist für die Abrechnung nutzlos —, löst eine HIPAA-Offenlegung aus. Diese Offenlegung erfordert einen unterzeichneten Business Associate Agreement (BAA) nach 45 CFR §164.504(e). Ein Tool, das keinen BAA unterzeichnen kann oder will, ist für die Verarbeitung von Gesundheitsdokumenten nicht geeignet, unabhängig von seinen Genauigkeitswerten.
Traditionelle OCR vs. KI-basierte Extraktion für Gesundheitsdokumente
Die Frage ist nicht „Was ist besser?", sondern „Was für welches Dokument?". Das Gesundheitswesen ist insofern ungewöhnlich, als sowohl traditionelle Vorlagen-OCR als auch moderne KI-basierte Extraktion ihre berechtigte Rolle haben und der optimale Ansatz je nach Dokumenttyp variiert.
| Dokumenttyp | Besserer Ansatz | Warum | Erreichbare Genauigkeit |
|---|---|---|---|
| CMS-1500 (sauberer Scan) | Vorlagen-OCR | Festes Layout, bekannte Feldkoordinaten, Unterstützung für rote Dropout-Felder | 98–99 % auf Feldebene |
| CMS-1500 (Fotokopie/Fax) | KI-Extraktion | Keine rote Dropout-Zone; KI kann Feldpositionen semantisch ableiten | 85–92 % auf Feldebene |
| UB-04 (sauber) | Vorlagen-OCR | 81 feste Formularpositionen, bekannte Struktur | 98–99 % auf Feldebene |
| EOB (jeder Kostenträger) | KI-Extraktion | Über 1.500 unterschiedliche Layouts; keine festen Feldpositionen | 85–95 % auf Feldebene |
| Laborberichte | KI-Extraktion | Nicht standardisierte Layouts je Labor; semantischer Abgleich erforderlich | 80–92 % auf Feldebene |
| Aufnahmeformulare für Patienten | KI-Extraktion | Kontrollkästchen + Handschrift + gemischte Felder | 75–90 % (abhängig von Handschrift) |
| Rezepte | KI-Extraktion | Kursive Handschrift; erfordert Vision-Modell | 70–88 % (erfordert Verifizierung) |
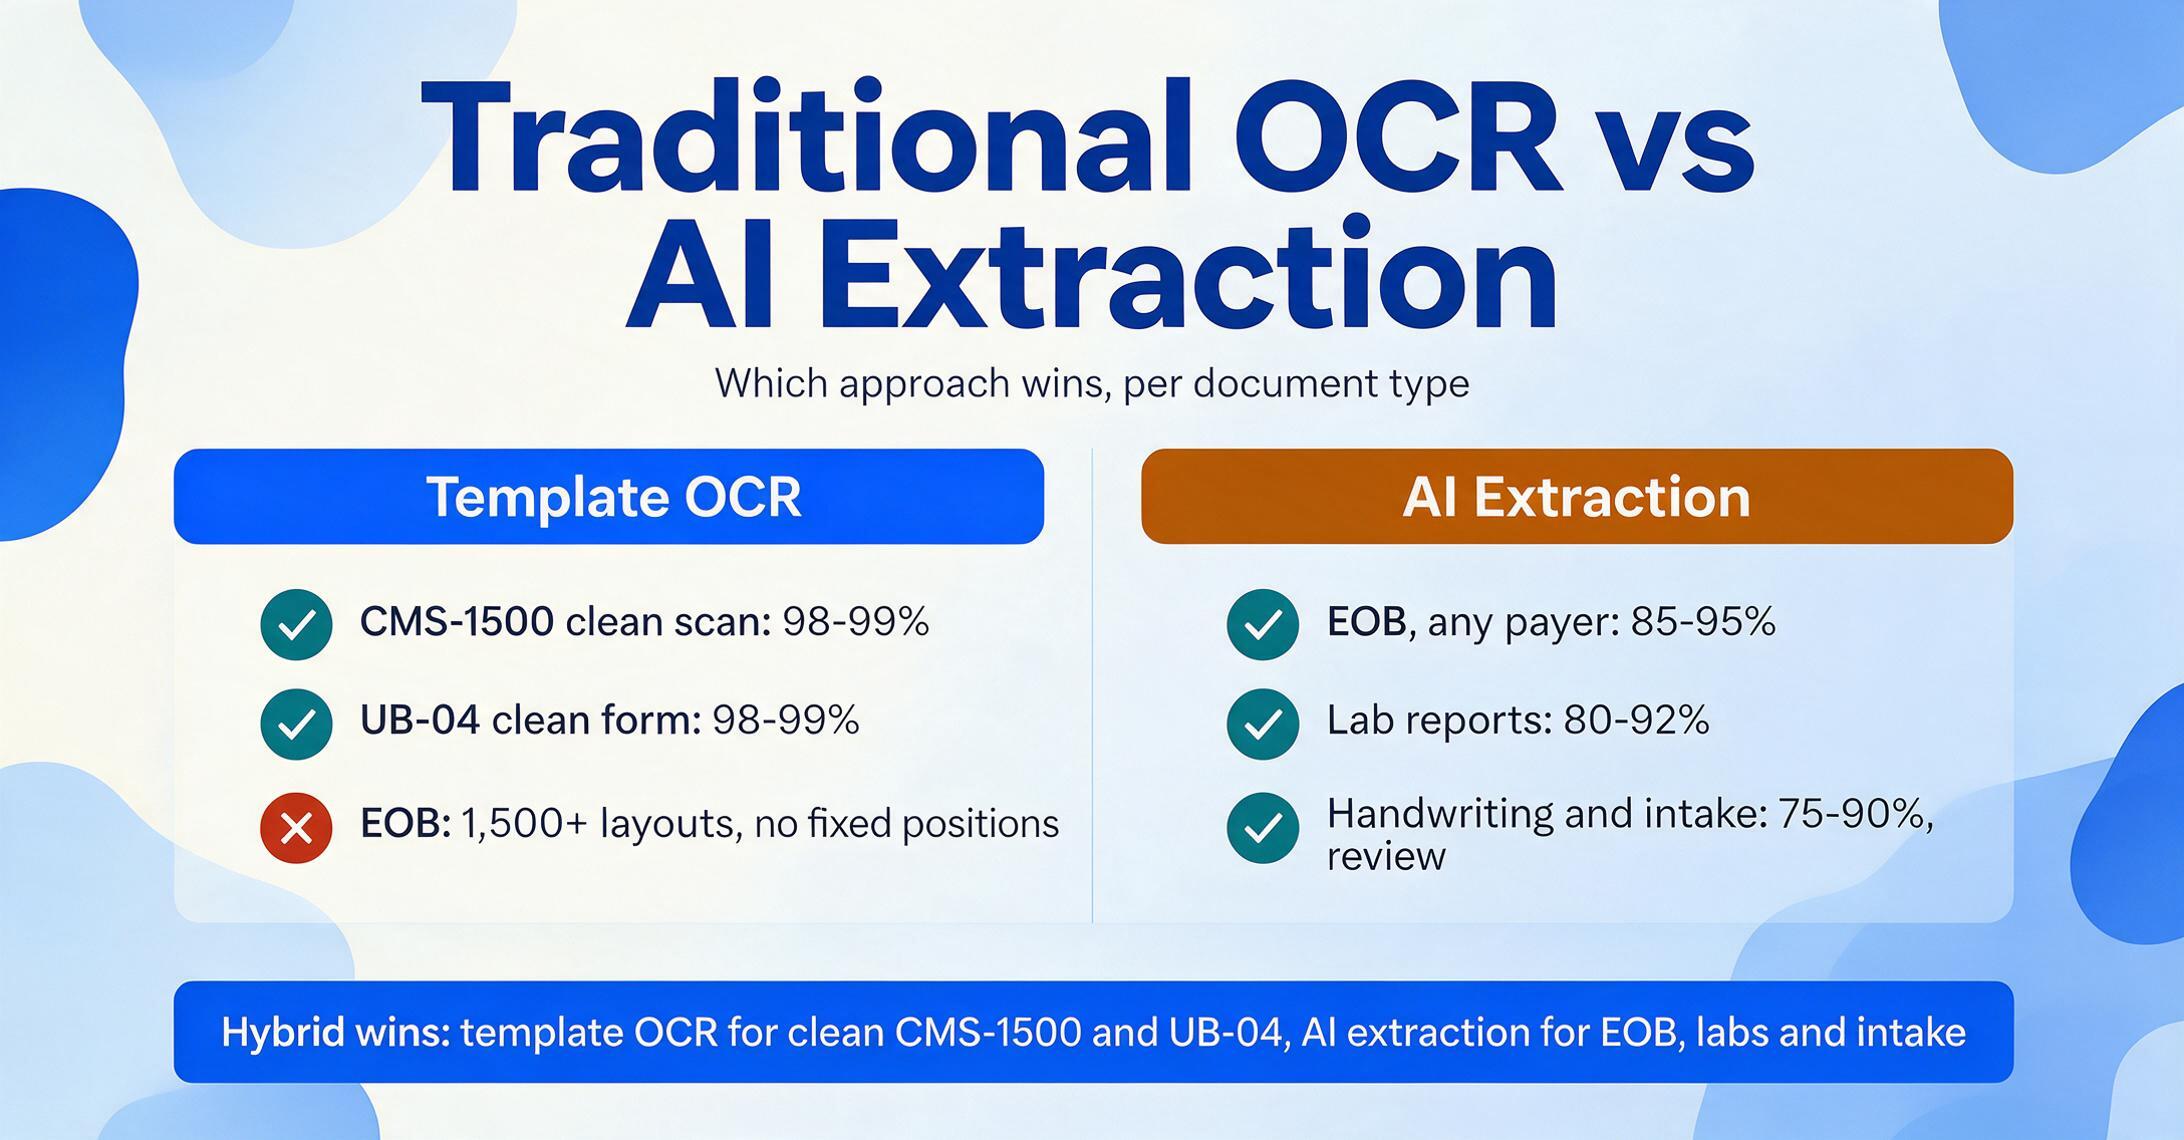
Deshalb betreiben viele Gesundheitseinrichtungen letztlich einen hybriden Workflow: Vorlagen-OCR für die strukturierten Abrechnungsformulare, bei denen Genauigkeit am wichtigsten und die Validierung auf Feldebene entscheidend ist, und KI-Extraktion für die nicht standardisierten Dokumente – EOBs, Laborberichte, Aufnahmeformulare –, bei denen Flexibilität wichtiger ist. Die beiden Ansätze sind im Gesundheitswesen keine Konkurrenten; sie sind komplementäre Werkzeuge für verschiedene Teile des Dokumentenspektrums.
Die ehrliche Antwort: Für CMS-1500- und UB-04-Formulare mit guter Scanqualität bleibt die vorlagenbasierte OCR der Genauigkeitsführer. Für jeden anderen Dokumenttyp im Gesundheitswesen – EOBs, Laborberichte, Aufnahmeformulare, Rezepte – ist die KI-basierte Extraktion der einzig praktikable Ansatz, weil die Layouts zu variabel sind, als dass Vorlagen mithalten könnten.
Compliance-Überlegungen: HIPAA als Auswahlkriterium
Dies ist der Abschnitt, in dem viele OCR-Tool-Artikel zu Marketingtext werden. Hier ist stattdessen das praktische Framework.
HIPAA-Compliance ist keine Funktion, die Sie einfach einschalten. Sie ist ein rechtlicher Rahmen, der regelt, wie ein Tool mit Patientendaten verwendet werden darf. Die relevanten Komponenten sind:
- Business Associate Agreement (BAA) gemäß 45 CFR §164.504(e) — Ein unterzeichneter Vertrag zwischen Ihrer Organisation und dem Tool-Anbieter, der den Anbieter als Business Associate etabliert. Ohne BAA ist die Übertragung von PHI an ein Drittanbieter-Tool eine Offenlegung, die gegen die Privacy Rule verstößt.
- Minimum Necessary Rule gemäß 45 CFR §164.502(b) — Sie müssen die offengelegte PHI auf das für den beabsichtigten Zweck erforderliche Minimum beschränken. Ein Tool, das alles Sichtbare auf einem Dokument extrahiert und Sie die Ausgabe anschließend durchsortieren lässt, ist architektonisch mit dieser Anforderung unvereinbar.
- Security Rule gemäß 45 CFR §164.306 — Administrative, physische und technische Schutzmaßnahmen für elektronische PHI. Für cloudbasierte OCR-Tools bedeutet dies Verschlüsselung im Ruhezustand (AES-256) und bei der Übertragung (TLS 1.2+), Zugriffskontrollen und Audit-Logging.
Wenn Sie ein OCR-Tool für das Gesundheitswesen bewerten, stellen Sie diese drei Fragen in dieser Reihenfolge:
- Werden Sie unseren BAA unterzeichnen? Wenn die Antwort Nein lautet, kann das Tool nicht mit Dokumenten verwendet werden, die PHI enthalten — was praktisch alle medizinischen Dokumente ausschließt.
- Wo werden Daten verarbeitet und gespeichert? Der BAA muss den Datenspeicherort festlegen. Wenn Ihr Compliance-Framework verlangt, dass PHI innerhalb der US-Grenzen bleibt (wie es viele Gesundheitsorganisationen tun), muss das Tool Daten auf US-basierten Servern verarbeiten.
- Was passiert mit dem Dokument nach der Verarbeitung? Die Datenaufbewahrungs- und Löschungsanforderungen von HIPAA gelten. Ein Tool, das Ihre medizinischen Dokumente unbegrenzt speichert, schafft eine Compliance-Haftung für Sie und den Anbieter. Automatische Löschung innerhalb eines definierten Zeitfensters (24 Stunden, 7 Tage usw.) ist der Standard für cloudbasierte Extraktions-Workflows.
Wir behandeln HIPAA und die Extraktion medizinischer Dokumente hier ausführlich, einschließlich einer detaillierten Checkliste zur Überprüfung der Compliance-Position Ihres Tool-Anbieters.
Es ist auch erwähnenswert: Selbst der beste BAA schützt Sie nicht, wenn Sie ein Tool verwenden, das mehr Daten extrahiert als nötig. Die Minimum Necessary Rule legt die Last auf die Covered Entity — also auf Sie — sicherzustellen, dass das Tool nur auf die spezifischen benötigten Datenelemente zugreift. Dies ist ein Bereich, in dem die benutzerdefinierte Spaltenextraktion (bei der Sie genau definieren, welche Felder abgerufen werden und die KI nur diese extrahiert) einen strukturellen Vorteil gegenüber vollseitiger OCR bietet, die alles zurückgibt und eine Nachfilterung erfordert.
Wie Sie eine OCR-Lösung für das Gesundheitswesen auswählen
Einen vollständigen Vergleich von Tools in Bezug auf Preisgestaltung, Genauigkeit und Compliance-Bereitschaft finden Sie in unserem Überblick über die beste OCR-Software für das Gesundheitswesen 2026. Wenn Ihr Schwerpunkt speziell auf der Extraktionsgenauigkeit von EOB- und CMS-1500-Antragsformularen liegt, testet unser Überblick über Tools zur Extraktion von Gesundheitsdokumenten sieben Tools an echten Dokumenten mehrerer Kostenträger. Die folgende Zusammenfassung behandelt die fünf Kriterien, die bei der Erstevaluierung am wichtigsten sind.
1. Dokumentenabdeckung
Verarbeitet das Tool die spezifischen Dokumenttypen, die Sie bearbeiten? Ein EOB-Extraktionstool ist für Laborberichte nutzlos. Ein CMS-1500-Spezialist kann Ihre Patientenaufnahmeformulare nicht verarbeiten. Wenn Ihre Organisation mehrere Dokumenttypen verarbeitet (was die meisten tun), suchen Sie ein Tool, das das gesamte Spektrum abdeckt, oder planen Sie separate Lösungen für jede Kategorie.
2. Genauigkeit auf Code-Ebene
Bei Antragsformularen und EOBs reicht Genauigkeit auf Zeichenebene nicht aus. Sie benötigen Genauigkeit auf Feldebene bei CPT-Codes (fünf Ziffern, exakt), ICD-10-CM-Codes (alphanumerisch bis zu 7 Zeichen, exakt) und NPI-Nummern (10 Ziffern, exakt). Ein einziges falsches Zeichen in einem Codefeld kann eine Ablehnung auslösen. Testen Sie das Tool an Ihren tatsächlichen Dokumenten, nicht an vom Anbieter bereitgestellten Beispielen.
3. Compliance-Bereitschaft
Die Verfügbarkeit eines BAA ist für jede PHI-haltige Arbeitslast nicht verhandelbar. Prüfen Sie über das BAA hinaus den Datenspeicherort (sind die Server in den USA?), Verschlüsselungsstandards (AES-256 im Ruhezustand, TLS 1.2+ bei der Übertragung), die Datenaufbewahrung (wie lange werden Ihre Dokumente gespeichert?) und ob das Tool ein SOC-2-Typ-2-Audit oder eine gleichwertige Sicherheitsbewertung durch Dritte abgeschlossen hat.
4. Integration in Ihre bestehenden Systeme
Gesundheitsorganisationen arbeiten mit EHRs (Epic, Oracle Health Cerner, Meditech, Allscripts), Praxisverwaltungssystemen (athenahealth, AdvancedMD, Kareo, NextGen) und Clearingstellen (Office Ally, Change Healthcare, ZirMed). Das ideale OCR-Tool gibt Daten in Formaten aus, die Ihr Abrechnungssystem aufnehmen kann — strukturiertes Excel, CSV oder JSON — ohne manuelle Nacherfassung. Je weniger sich Ihr Workflow ändert, desto schneller die Einführung.
5. Handschrifterkennung
Wenn Ihr Workflow Rezepte, klinische Notizen oder Patientenaufnahmeformulare mit Freitextfeldern umfasst, ist die Handschriftgenauigkeit ein wesentliches Auswahlkriterium. Testen Sie mit Ihren tatsächlichen Handschriftproben — nicht mit dem kuratierten Testsatz des Anbieters. Verstehen Sie, wo weiterhin eine menschliche Überprüfung erforderlich ist und ob der Workflow diesen Prüfschritt unterstützt.
Dateien werden sicher verarbeitet und nicht gespeichert. Testen Sie die Datenextraktion aus einem EOB-Dokument — keine Anmeldung erforderlich.
FAQ
Kann OCR CMS-1500- und UB-04-Formulare zuverlässig lesen?
Ja, bei sauberen Scans erreicht die feldgenaue Genauigkeit mit vorlagenbasierter OCR bei diesen standardisierten Formularen 98–99 %. Die Genauigkeit sinkt bei Fotokopien, Faxen und Scans minderer Qualität – deshalb sind die Kalibrierung des Scanners und die Verwendung geeigneter OCR-roter Formulare (gemäß CMS-Spezifikationen) wichtig.
Verarbeitet OCR handschriftliche Krankenakten und Rezepte?
KI-gestützte OCR kann Handschrift mit 75–90 % Genauigkeit lesen, abhängig von der Lesbarkeit, doch Kursivschrift und eilige Handschrift – häufig auf Rezepten und klinischen Notizen – bleiben eine Kategorie, die eine menschliche Prüfung erfordert. Die meisten Workflows im Gesundheitswesen behandeln die Extraktion von Handschrift als Schritt „vor der Verwendung prüfen" statt als durchgängige Automatisierung. Detaillierte Genauigkeits-Benchmarks finden Sie unter unseren besten OCR-Tools für Handschrift.
Wie gilt HIPAA für cloudbasierte OCR-Tools?
Wenn Sie ein Dokument mit PHI an ein OCR-Tool eines Drittanbieters senden, nehmen Sie eine Offenlegung nach der HIPAA Privacy Rule vor. Diese Offenlegung erfordert eine unterzeichnete Business Associate Agreement (BAA) mit dem Tool-Anbieter. Ohne BAA ist die Übertragung ein Compliance-Verstoß, unabhängig von den Verschlüsselungs- oder Sicherheitsfunktionen des Tools. Prüfen Sie außerdem Datenresidenz, Verschlüsselungsstandards und die Datenlöschungsrichtlinie des Anbieters.
Welche medizinischen Codes kann OCR aus Abrechnungsformularen extrahieren?
Moderne KI-basierte Extraktionstools können CPT-Leistungscodes (5-stellig), ICD-10-CM-Diagnosecodes (alphanumerisch, bis zu 7 Zeichen), HCPCS Level II Codes und NPI-Nummern (10-stellig) erkennen und extrahieren. Die entscheidende Anforderung ist, dass das Tool zwischen den Codetypen unterscheidet – ein Tool, das alles in eine einzige Spalte „Code" schreibt, erzwingt eine manuelle Neusortierung, die den Automatisierungsvorteil zunichtemacht.
Ist Vorlagen-OCR oder KI-Extraktion besser für medizinische Dokumente?
Das hängt vom Dokument ab. Vorlagen-OCR ist überlegen für CMS-1500- und UB-04-Formulare mit sauberen Scans – die Layouts sind fest, bekannt und standardisiert. KI-Extraktion ist überlegen für alles andere: EOBs von mehreren Kostenträgern (1.500+ Layouts), Laborberichte, Aufnahmeformulare für Patienten, klinische Notizen und Rezepte. Ein hybrider Ansatz – Vorlage für strukturierte Abrechnungen, KI für Dokumente mit variablem Format – ist die praktischste Konfiguration für Organisationen im Gesundheitswesen.
Wie viel kostet OCR für das Gesundheitswesen?
Die Kosten variieren stark je nach Tool und Volumen. Cloudbasierte OCR-Einstiegstools für das Gesundheitswesen reichen von $29–$99/Monat für die Verarbeitung geringer Mengen (100–500 Seiten). Tarife für mittlere Mengen (1.000–10.000 Seiten/Monat) liegen bei $100–$500/Monat. Enterprise-Bereitstellungen mit Integrationssupport, benutzerdefinierten Vorlagen und dedizierten BAAs beginnen in der Regel bei $1.000+/Monat oder erfordern Jahresverträge. Die ROI-Berechnung sollte nicht nur die eingesparten Tippkosten berücksichtigen, sondern auch die Verringerung von Nacharbeit bei Ablehnungen ($48/Anspruch im Durchschnitt), geringere Compliance-Risiken und schnellere Days in Accounts Receivable.
Ein einzelner manuell verarbeiteter EOB dauert 5 Minuten und hat eine Fehlerquote von 8–12 %. Dasselbe Dokument mit KI-Extraktion benötigt 10 Sekunden und liefert strukturierte Daten in einer Tabelle — bereit für den Abgleich, kein erneutes Abtippen. Sehen Sie, wie Ihre eigenen medizinischen Dokumente in einer Extraktionspipeline aussehen.