OCR para el sector salud:
Procesamiento de registros médicos, EOB y formularios de reclamación
Un solo formulario de reclamación CMS-1500 contiene más de 30 campos: datos demográficos del paciente, identificadores de seguro, hasta 12 códigos de diagnóstico (ICD-10-CM), códigos de procedimiento (CPT/HCPCS), modificadores, indicadores de diagnóstico, cargos y números NPI del proveedor, todo en una página con un diseño pensado para el procesamiento en papel, no para la extracción digital. Ahora multiplique eso por los 247,000 reclamos en papel que aún se envían semanalmente solo a Medicare, agregue los EOB de más de 1,500 formatos de pagadores únicos, informes de laboratorio con tablas de resultados anidadas y formularios de admisión de pacientes llenados con letra apresurada en la recepción, y la pregunta cambia de "¿puede el OCR manejar documentos de salud?" a "qué enfoque maneja qué documento, y dónde falla cada enfoque".
Conclusiones clave
- El 30% de todas las denegaciones de facturación médica comienzan con códigos CPT o ICD-10 ingresados incorrectamente, a $48 por reclamo denegado para corregir, frente a $3 por validación previa al envío, la entrada manual de datos cuesta 16 veces más que la automatización.
- El OCR con plantilla alcanza un 99% de precisión de campos en un CMS-1500 limpio, pero al fotocopiar ese mismo formulario, la precisión cae por debajo del 80%, una falla de calibración del escáner que las afirmaciones de precisión de los proveedores casi nunca mencionan.
- Sin un Acuerdo de Asociado Comercial firmado, la herramienta de OCR no puede procesar legalmente ningún documento que contenga datos de pacientes: HIPAA lo exige independientemente de cuántos nueves tengan los puntos de referencia de precisión de extracción.
Qué es realmente el OCR para el sector sanitario
El OCR para el sector sanitario es la aplicación del reconocimiento óptico de caracteres y la comprensión documental basada en IA a los documentos específicos que manejan las organizaciones médicas: formularios de reclamaciones de seguros (CMS-1500 para reclamaciones profesionales, UB-04 para reclamaciones institucionales), estados de Explicación de Beneficios (EOB) de los pagadores, resultados de laboratorio e informes de patología, formularios de admisión y registro de pacientes, recetarios, cartas de derivación, resúmenes de alta y notas clínicas.
La distinción con el OCR en otras industrias es importante porque los documentos médicos combinan tres desafíos que rara vez aparecen juntos en otros lugares: variabilidad estructural estricta (más de 1.500 formatos de EOB), códigos específicos del dominio que deben transcribirse con precisión (CPT, ICD-10-CM, HCPCS, NPI) y requisitos regulatorios en torno a la información de salud protegida (PHI) definidos por la Regla de Privacidad de HIPAA en 45 CFR §164.514.
Las seis categorías de documentos que cubren más del 90% de la intención de búsqueda de OCR para el sector sanitario son: EOBs (avisos de remesa del pagador), CMS-1500 (reclamaciones profesionales), UB-04 (reclamaciones institucionales), informes de laboratorio (resultados clínicos), formularios de admisión de pacientes (registro e historial) y recetas (órdenes de medicación manuscritas o impresas). Cada una presenta un perfil de extracción único — y ningún enfoque de OCR único maneja las seis igual de bien.
Para una comprensión fundamental de cómo funciona el OCR en general, consulte qué es el OCR y cómo lee los documentos. Para la evolución impulsada por IA que maneja los documentos no estándar de los que depende el sector sanitario, consulte qué es el OCR con IA y en qué se diferencia.
Por qué el sector sanitario necesita OCR — El problema cuantificado
La entrada manual de datos en la facturación sanitaria tiene un patrón de fallo específico que la automatización aborda directamente. No es que el personal de facturación sea descuidado. Es que el volumen y la complejidad de la entrada de datos en papel superan lo que la precisión humana puede sostener durante un turno de ocho horas.
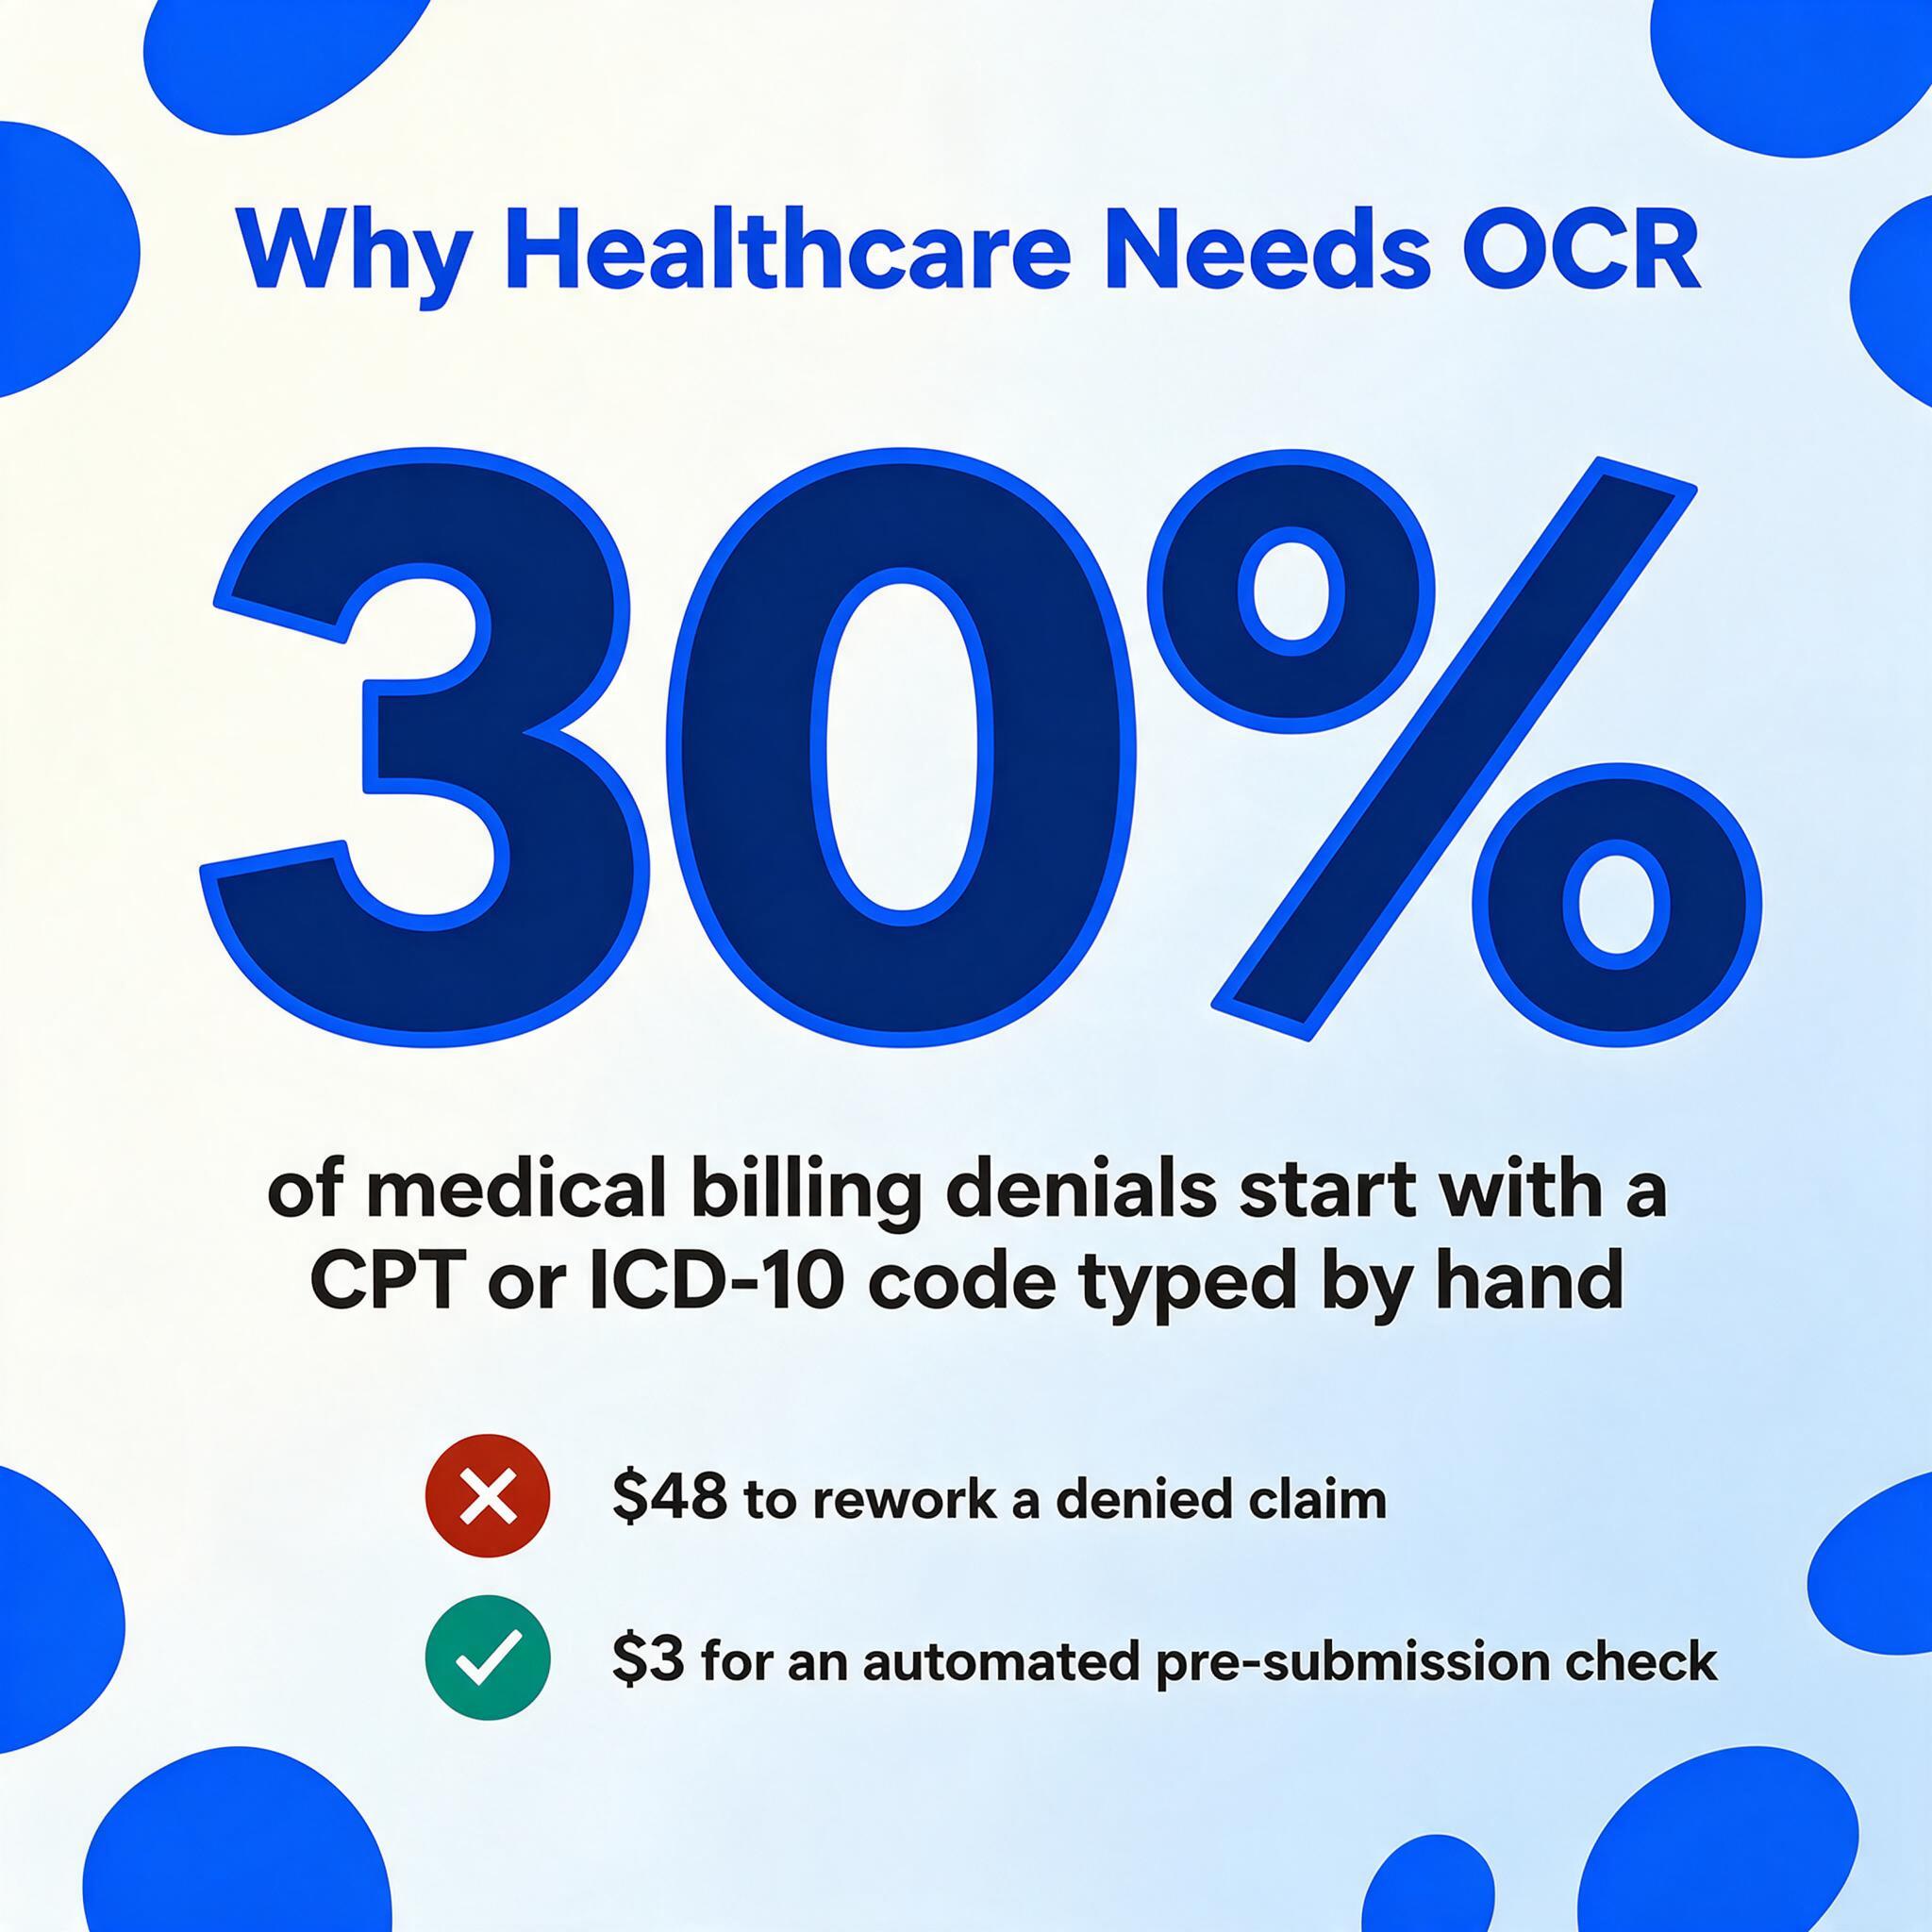
Las cifras provienen de múltiples direcciones. OCR Solutions, que opera un despliegue de Texas Medicaid procesando más de 1 millón de reclamaciones al mes desde 2021, informa que aproximadamente el 30% de todas las denegaciones de facturación médica se originan por códigos CPT o ICD-10 incorrectos ingresados durante la captura manual de datos. Un análisis separado del mismo equipo estima el costo promedio de retrabajo de denegación en $48 por reclamación, en comparación con $3 por una verificación automatizada previa al envío — una relación de costo de 16:1. La guía de la AMA sobre errores de codificación confirma que los errores más comunes — modificador incorrecto, vinculación de diagnóstico a procedimiento no coincidente, código desactualizado — son estructurales, no aleatorios. Ocurren porque la persona que ingresa los datos no puede verificar simultáneamente cada dependencia entre campos que el sistema de procesamiento de reclamaciones aplicará más adelante.
Luego está la matemática laboral. La entrada manual de un solo formulario CMS-1500 o UB-04 toma de 5 a 10 minutos. Un equipo de ciclo de ingresos hospitalario que procesa 500 reclamaciones por día dedica de 40 a 80 horas-persona solo a la mecanografía — sin conciliar, sin cuestionar, solo transfiriendo caracteres de un formato a otro. La extracción automatizada reduce eso a menos de 60 segundos por formulario, lo que no elimina el rol humano, pero lo traslada de la transcripción a la verificación, donde el juicio clínico y de facturación realmente importa.
Más allá de la facturación, el registro de resultados de laboratorio y la digitalización de admisión de pacientes siguen patrones similares: la transcripción manual de requisiciones en papel y formularios de registro consume tiempo que podría dedicarse al trabajo centrado en el paciente, y la tasa de error — típicamente del 8 al 12% en la entrada de datos de alto volumen — se acumula en costos posteriores de conciliación y retrabajo que la mayoría de las prácticas nunca totalizan.
Tipos Clave de Documentos de Salud y Sus Desafíos de Extracción
La salud no es un solo tipo de documento. Cada categoría principal presenta un perfil de extracción diferente que determina qué enfoque de OCR — basado en plantillas, basado en IA o híbrido — es el apropiado.
Declaraciones EOB (Explicación de Beneficios)
El EOB es posiblemente el documento más variable en formato dentro del sector salud. Hay más de 1,500 diseños de EOB específicos por pagador entre aseguradoras comerciales (BCBS, UnitedHealthcare, Aetna, Cigna, Humana), pagadores gubernamentales (Medicare, Medicaid, Tricare) y aseguradoras de compensación laboral. Medicare llama a su identificador de reclamación "ICN" (Número de Control Interno). BCBS coloca el número de reclamación en la esquina superior derecha. Aetna lo pone en un bloque de encabezado a la izquierda. Los tres significan lo mismo — el identificador de reclamación — pero una plantilla de OCR basada en posición necesitaría tres configuraciones separadas para capturarlo.
Los campos que importan para la conciliación son: número de reclamación / ICN, nombre e ID del paciente, fecha del servicio, códigos de procedimiento CPT con modificadores, monto facturado, monto permitido, pago del plan, deducible, copago, coseguro, responsabilidad del paciente y códigos de razón de denegación. El desafío no es leer los caracteres — el OCR moderno lo hace de manera confiable. El desafío es mapear cada valor a la columna correcta cuando el mismo dato aparece en posiciones diferentes en la declaración de cada pagador.
Aquí es donde el OCR basado en plantillas llega a su límite y la extracción semántica con IA — donde el sistema entiende qué significa un "número de reclamación" y lo encuentra por concepto, no por posición — se vuelve necesaria. Para un análisis profundo, consulte nuestra guía completa de extracción de datos EOB, o pruebe la herramienta de extracción EOB a Excel directamente con una declaración de pagador.
CMS-1500 (Formulario de Reclamación Profesional)
El formulario CMS-1500, también conocido como HCFA-1500, es el formulario estándar en papel para reclamaciones utilizado por médicos, clínicas y proveedores no institucionales para facturar a Medicare y a la mayoría de las aseguradoras comerciales. Tiene 33 casillas numeradas (más subdivisiones) comprimidas en una sola página. La densidad es la característica: el formulario captura todo lo necesario para la adjudicación de reclamaciones en un formato de papel estandarizado, pero esa misma densidad lo convierte en uno de los formularios más difíciles de procesar correctamente mediante OCR de propósito general.
El problema estructural crítico son las dependencias entre campos. La casilla 24E (indicador de diagnóstico) debe hacer referencia a un código ICD-10-CM válido listado en la casilla 21 (diagnóstico o naturaleza de la enfermedad o lesión). Un indicador desalineado es invisible para la entrada humana: la persona que escribe no puede verificar simultáneamente que cada código indicador en la casilla 24E coincida con una entrada válida en la casilla 21 en múltiples líneas de servicio. El sistema de adjudicación del pagador lo detecta 30 a 60 días después como una denegación. El OCR basado en plantillas maneja bien este formulario, porque el diseño está estandarizado según las especificaciones oficiales del formulario de CMS, incluido el requisito de tinta roja Flint OCR en la versión escaneable de fondo eliminable, logrando hasta un 99% de precisión a nivel de campo en condiciones óptimas de escaneo.
Pero hay un inconveniente que la mayoría de los proveedores no mencionan de antemano: la precisión del OCR del CMS-1500 depende en gran medida de la configuración del escáner. La función de "eliminación de rojo" utilizada por los transportistas de Medicare requiere una calibración específica del escáner. Una fotocopia del formulario (común en consultorios pequeños) no tiene la tinta roja OCR requerida, por lo que la zona de eliminación no funciona y el motor de extracción debe procesar la página completa en lugar de aislar los campos rellenables. La diferencia entre un escaneo limpio y una fotocopia puede hacer que la precisión pase del 99% a menos del 80% en el mismo motor de OCR.
UB-04 (Formulario de Reclamaciones Institucionales)
Mientras que el CMS-1500 tiene 33 casillas, el UB-04 (también llamado CMS-1450) tiene 81 localizadores de formulario. Lo utilizan hospitales, centros de enfermería especializada, agencias de salud a domicilio y otros proveedores institucionales para facturar episodios completos de atención. La complejidad proviene de su estructura a nivel de fila: los localizadores de formulario 42 a 47 son partidas repetibles donde el código de ingreso, la descripción del servicio, la fecha del servicio, las unidades, los cargos totales y los cargos no cubiertos deben coincidir en cada fila. Un solo código de ingreso mal leído (p. ej., 0450 para servicios de sala de emergencias frente a 0452 para triaje de urgencias) desajusta el precio de toda esa línea, y los pagadores rechazan la reclamación en lugar de adivinar qué campo es incorrecto.
Dado que el formato UB-04 es institucional — y la facturación institucional implica códigos de condición, códigos de ocurrencia, códigos de valor y códigos de ingreso que no tienen equivalente en el CMS-1500 — se requiere una capa independiente de mapeo y validación. Los sistemas basados en plantilla con mapeos UB-04 predefinidos son el estándar de la industria aquí, y funcionan bien cuando la calidad del escaneo es consistente.
Informes de Laboratorio y Resultados de Patología
Los informes de laboratorio difieren de los formularios de reclamaciones en un aspecto crítico: no están estandarizados. Cada laboratorio (Quest, LabCorp, laboratorios de hospital) utiliza su propia plantilla de informes. Los datos en sí están estructurados — nombre de la prueba, valor del resultado, rango de referencia e indicador (normal/anormal) — pero la disposición varía. Algunos informes de laboratorio presentan los resultados en listas verticales, otros en tablas, y otros en un formato mixto de narrativa con tabla. El desafío de la extracción es distinguir entre el nombre de la prueba (p. ej., "Hemoglobina A1c"), el valor del resultado ("7.2%"), el rango de referencia ("<5.7% normal, 5.7-6.4% prediabetes, ≥6.5% diabetes") y el indicador ("Alto"). Leer estos como un bloque de texto OCR no produce datos utilizables — los valores deben ubicarse en columnas separadas con la asociación de fila correcta.
Formularios de Admisión y Registro de Pacientes
Los formularios de admisión combinan tres elementos difíciles para el OCR: casillas de verificación (marcadas, cruzadas o circuladas), escritura a mano (nombre del paciente, dirección, motivo de la visita, historial médico) y campos de formato mixto (algunos preimpresos, otros de texto libre). Las casillas de verificación son particularmente complicadas: el OCR tradicional lee texto, no la presencia o ausencia de una marca dentro de una casilla. Los modelos de visión basados en IA manejan esto mejor porque ven el documento como una imagen y pueden detectar si una casilla está marcada, independientemente del método de marcado. En cuanto al componente de escritura a mano, la extracción con IA ha mejorado significativamente en los últimos años, pero la precisión varía mucho según la legibilidad de la escritura. Consulte nuestra guía de software de OCR para escritura a mano para saber qué puede y qué no puede manejar la tecnología actual.
Para el papeleo de registro específicamente, el objetivo práctico es una fila por paciente: una ejecución de formulario de admisión de pacientes a Excel mapea las casillas marcadas, las respuestas escritas a mano y los campos de seguro en esas columnas en una sola pasada.
Recetas Médicas
Las recetas médicas representan el caso extremo del problema de la escritura a mano. Los médicos que escriben después de un día completo de consulta producen una de las cursivas más difíciles de cualquier industria. Lo que está en juego es alto: un nombre de medicamento o una dosis mal leídos pueden causar daño al paciente. El OCR tradicional falla esencialmente con la escritura cursiva; los modelos de visión basados en IA logran una precisión del 85–95% en recetas manuscritas de calidad razonable, pero disminuyen significativamente con escaneos de baja calidad o escritura apresurada. La mayoría de los flujos de trabajo de OCR en el sector salud tratan las recetas como una categoría que requiere verificación humana en lugar de un objetivo de automatización directa.
Los Campos que Importan: Códigos Médicos, Identificadores y PHI
Los documentos médicos contienen elementos de datos que no tienen equivalente en otras industrias. Una factura tiene una fecha y un total. Una reclamación médica tiene esos elementos más códigos que determinan si la reclamación se paga, se deniega o se audita. Entender qué son estos códigos y por qué importan para la extracción es la diferencia entre comprar una herramienta de OCR de propósito general y comprar una que funcione para el sector salud.
Códigos CPT
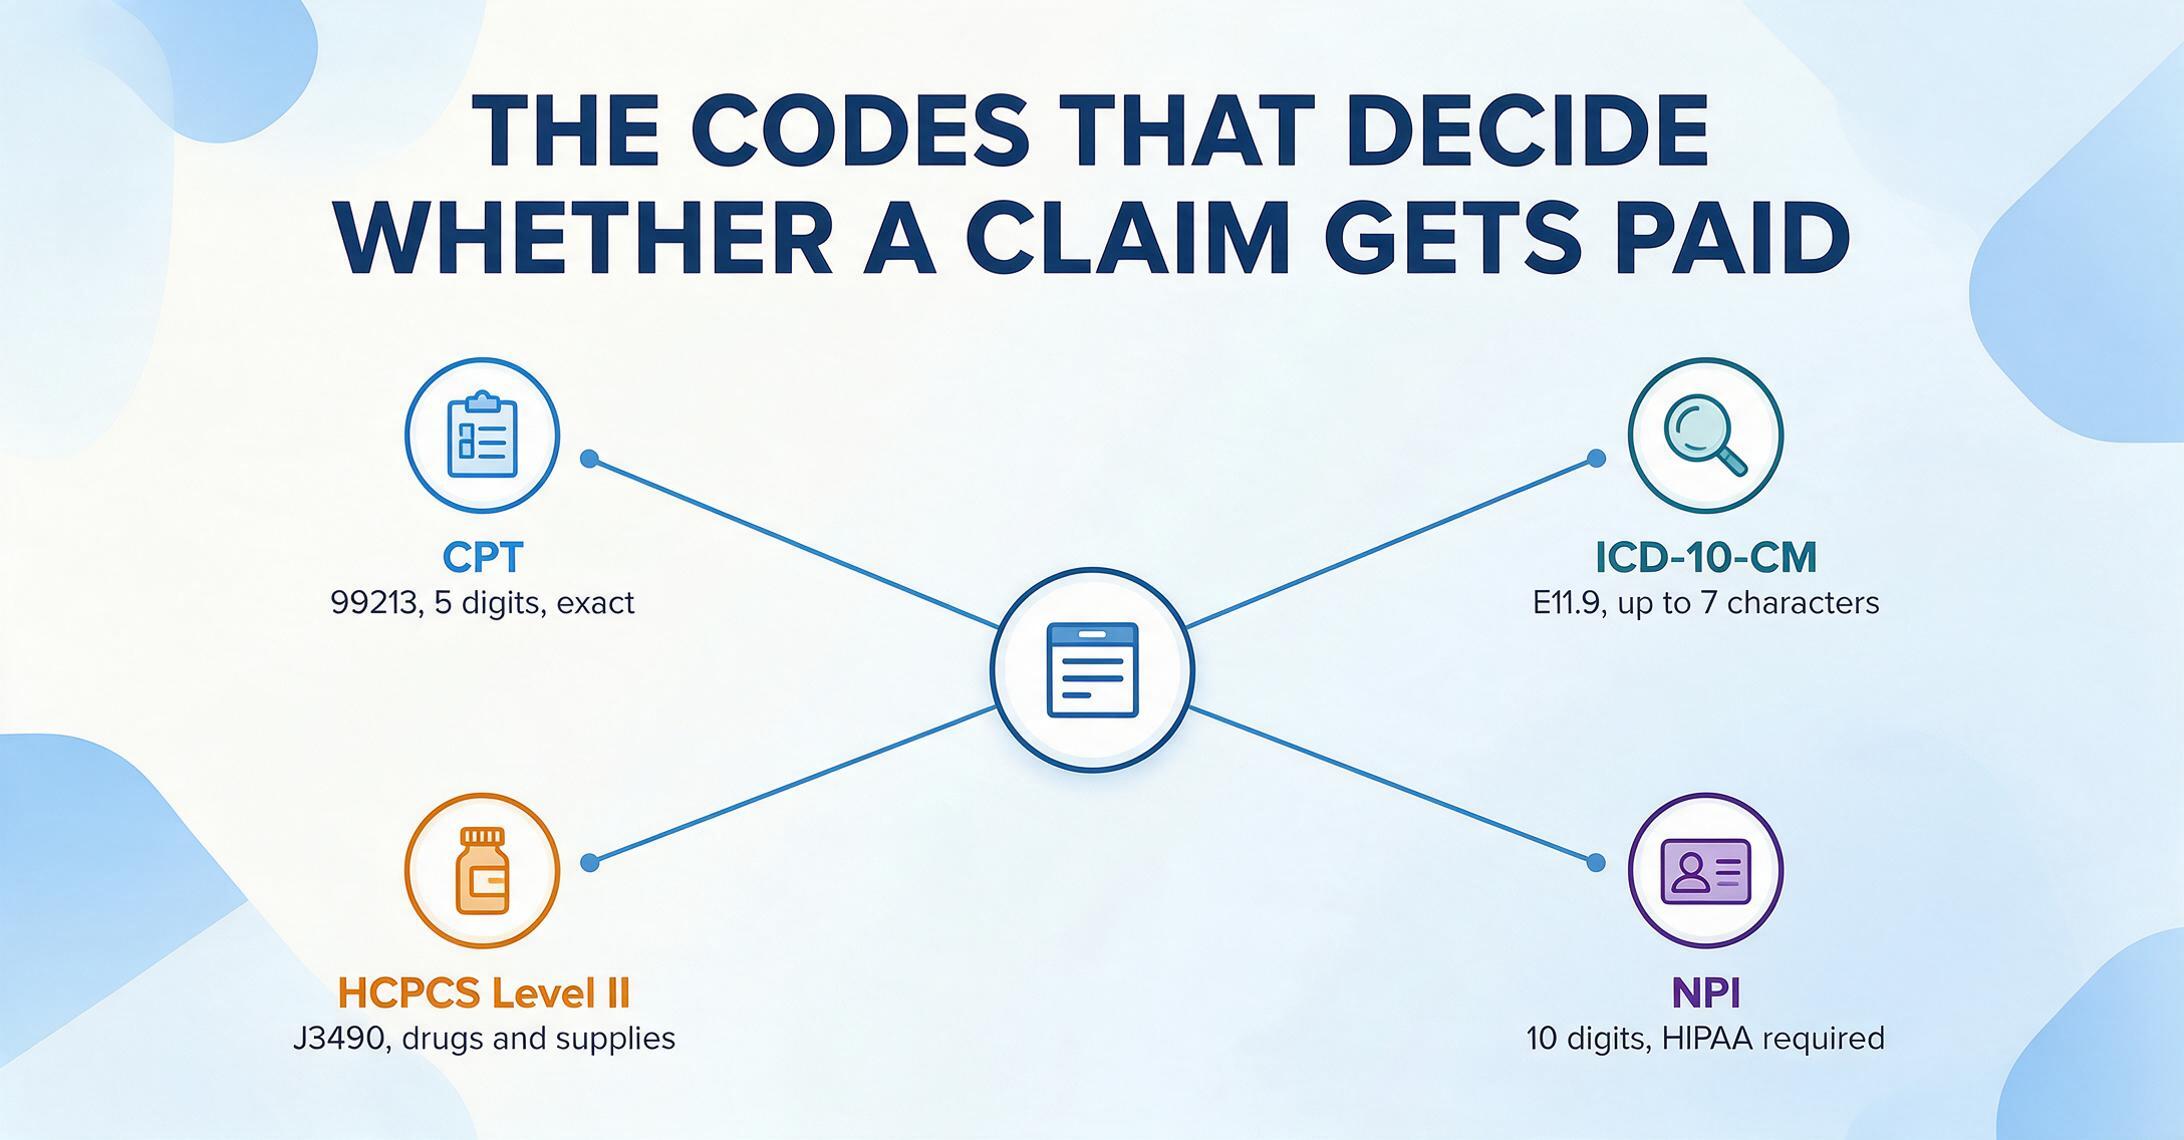
Terminología Procesal Actual, mantenida por la Asociación Médica Estadounidense. Códigos numéricos de cinco dígitos que describen procedimientos y servicios médicos. Ejemplo: 99213 (visita de paciente establecido en consultorio, nivel 3). La IA debe distinguir el código de procedimiento del código de diagnóstico; a menudo aparecen en la misma línea.
Códigos ICD-10-CM
Clasificación Internacional de Enfermedades, 10.ª Revisión, Modificación Clínica. Códigos alfanuméricos de hasta 7 caracteres que describen diagnósticos. Ejemplo: E11.9 (diabetes tipo 2 sin complicaciones). Aproximadamente 72,000 códigos activos requieren una extracción precisa carácter por carácter.
HCPCS Nivel II
Sistema de Codificación de Procedimientos Comunes de Atención Médica, mantenido por CMS. Códigos alfanuméricos para productos, suministros y servicios no cubiertos por CPT. Ejemplo: J3490 (medicamento no clasificado). Común en reclamaciones institucionales UB-04.
Números NPI
Identificador Nacional de Proveedor. Un identificador numérico de 10 dígitos requerido por HIPAA para todos los proveedores de atención médica. Debe seguir el formato estándar de 10 dígitos; la validación de extracción debe verificar este patrón.
Luego está la PHI — Información de Salud Protegida. Según la Regla de Privacidad de HIPAA, 18 categorías de identificadores hacen que la información de salud sea individualmente identificable. Estas incluyen las obvias — nombres, direcciones, números de Seguro Social — pero también fechas (fecha de nacimiento, fechas de admisión/alta, fechas de defunción), números de teléfono, números de fax, direcciones de correo electrónico, números de historial médico, números de beneficiario del plan de salud, números de cuenta, números de certificado/licencia, identificadores de vehículo, identificadores de dispositivo y números de serie, URL, direcciones IP, identificadores biométricos, fotografías de rostro completo y cualquier otro número, característica o código de identificación único.
La implicación práctica para la selección de herramientas de OCR: cualquier herramienta que procese documentos médicos que contengan cualquiera de estos 18 identificadores — y un EOB sin nombre del paciente y número de reclamación es inútil para facturación — crea una divulgación de HIPAA. Esa divulgación requiere un Acuerdo de Asociado Comercial (BAA) firmado bajo 45 CFR §164.504(e). Una herramienta que no pueda o no quiera firmar un BAA no es un candidato viable para el procesamiento de documentos de atención médica, independientemente de sus cifras de precisión.
OCR tradicional vs. extracción basada en IA para documentos de salud
La pregunta no es "cuál es mejor" sino "cuál para cada documento". El sector de la salud es inusual porque tanto el OCR tradicional con plantillas como la extracción moderna basada en IA tienen funciones legítimas, y el enfoque óptimo varía según el tipo de documento.
| Tipo de documento | Mejor enfoque | Por qué | Precisión alcanzable |
|---|---|---|---|
| CMS-1500 (escaneo limpio) | OCR con plantilla | Diseño fijo, coordenadas de campos conocidas, soporte de eliminación de rojo | 98–99% a nivel de campo |
| CMS-1500 (fotocopia/fax) | Extracción con IA | Sin zona de eliminación de rojo; la IA puede inferir la ubicación de los campos semánticamente | 85–92% a nivel de campo |
| UB-04 (limpio) | OCR con plantilla | 81 localizadores de formulario fijos, estructura conocida | 98–99% a nivel de campo |
| EOB (cualquier aseguradora) | Extracción con IA | Más de 1500 diseños únicos; sin posiciones de campo fijas | 85–95% a nivel de campo |
| Informes de laboratorio | Extracción con IA | Diseños no estándar por laboratorio; se requiere coincidencia semántica | 80–92% a nivel de campo |
| Formularios de admisión de pacientes | Extracción con IA | Casillas de verificación + escritura a mano + campos mixtos | 75–90% (depende de la escritura a mano) |
| Recetas médicas | Extracción con IA | Escritura cursiva; requiere modelo de visión | 70–88% (requiere verificación) |
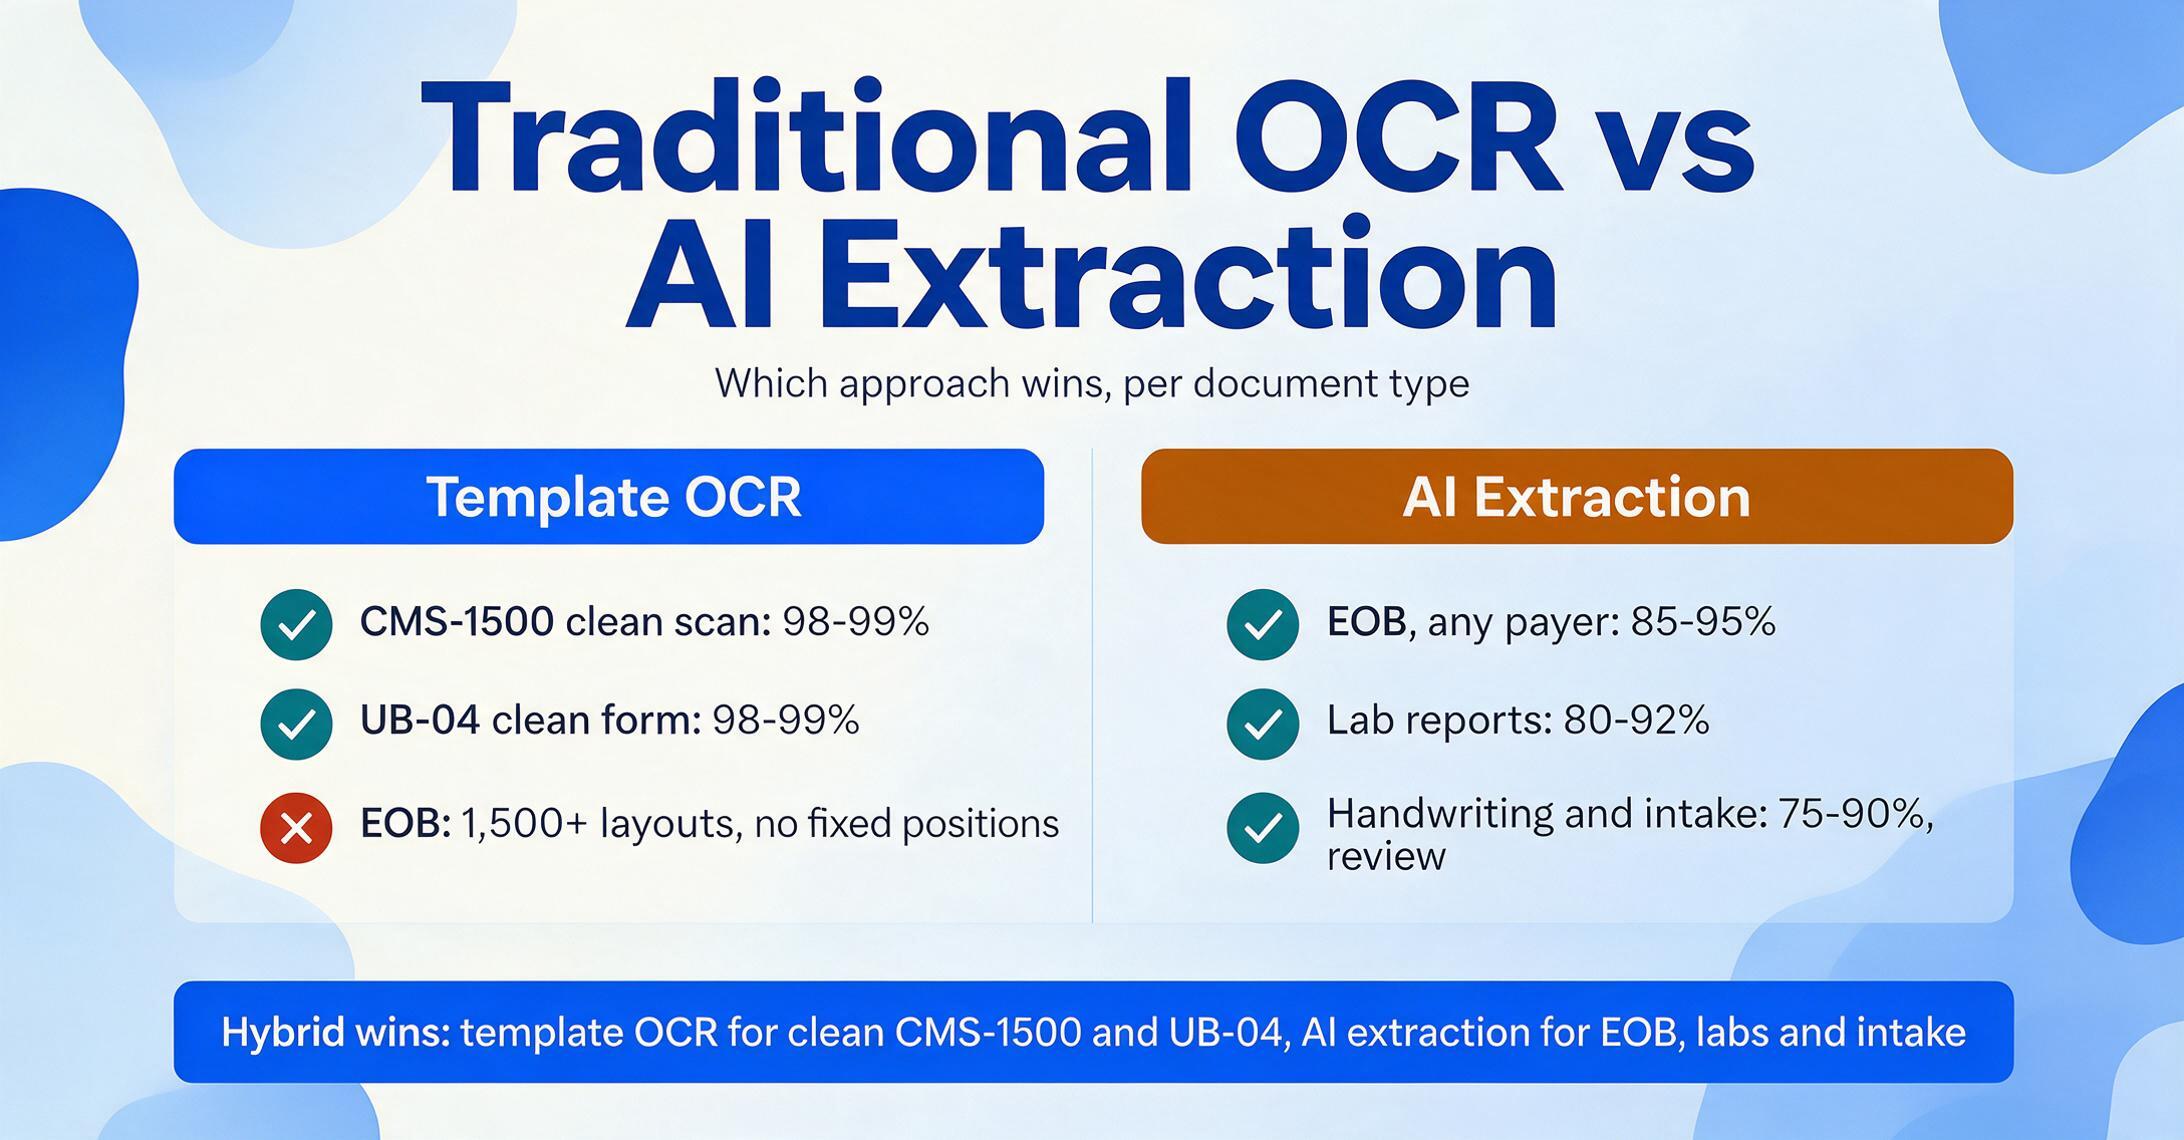
Por eso muchas organizaciones de salud terminan implementando un flujo de trabajo híbrido: OCR con plantilla para los formularios de reclamaciones estructurados donde la precisión importa más y la validación a nivel de campo es crítica, y extracción con IA para los documentos no estándar — EOB, informes de laboratorio, formularios de admisión — donde la flexibilidad importa más. Los dos enfoques no son competidores en el sector de la salud; son herramientas complementarias para diferentes partes del espectro documental.
La respuesta honesta: para formularios CMS-1500 y UB-04 con buena calidad de escaneo, el OCR basado en plantillas sigue siendo el líder en precisión. Para cualquier otro tipo de documento de salud — EOB, informes de laboratorio, formularios de admisión, recetas médicas — la extracción basada en IA es el único enfoque viable porque los diseños son demasiado variables para que las plantillas puedan seguirles el ritmo.
Consideraciones de Cumplimiento: HIPAA como Criterio de Selección
Esta es la sección donde muchos artículos sobre herramientas OCR se convierten en texto publicitario. Aquí está el marco práctico en su lugar.
El cumplimiento de HIPAA no es una función que se activa. Es un marco legal que rige cómo se puede usar una herramienta con datos de pacientes. Los componentes relevantes son:
- Acuerdo de Asociado de Negocio (BAA) según 45 CFR §164.504(e) — Un contrato firmado entre su organización y el proveedor de la herramienta que establece al proveedor como asociado de negocio. Sin un BAA, transmitir PHI a una herramienta de terceros es una divulgación que viola la Regla de Privacidad.
- Regla del Mínimo Necesario según 45 CFR §164.502(b) — Debe limitar la PHI divulgada al mínimo necesario para lograr el propósito previsto. Una herramienta que extrae todo lo visible en un documento y le obliga a revisar el resultado después es arquitectónicamente inconsistente con este requisito.
- Regla de Seguridad según 45 CFR §164.306 — Salvaguardas administrativas, físicas y técnicas para la PHI electrónica. Para herramientas OCR basadas en la nube, esto significa cifrado en reposo (AES-256) y en tránsito (TLS 1.2+), controles de acceso y registro de auditoría.
Al evaluar una herramienta OCR para el sector salud, haga estas tres preguntas en orden:
- ¿Firmarán nuestro BAA? Si la respuesta es no, la herramienta no se puede usar con ningún documento que contenga PHI — lo que descarta esencialmente todos los documentos médicos.
- ¿Dónde se procesan y almacenan los datos? El BAA debe especificar la residencia de los datos. Si su marco de cumplimiento requiere que la PHI permanezca dentro de las fronteras de EE. UU. (como exigen muchas organizaciones de salud), la herramienta debe procesar datos en servidores ubicados en EE. UU.
- ¿Qué sucede con el documento después del procesamiento? Los requisitos de retención y eliminación de datos de HIPAA aplican. Una herramienta que almacena sus documentos médicos indefinidamente crea una responsabilidad de cumplimiento tanto para usted como para el proveedor. La eliminación automática dentro de un período definido (24 horas, 7 días, etc.) es el estándar para los flujos de trabajo de extracción basados en la nube.
Discutimos HIPAA y la extracción de documentos médicos en profundidad aquí, incluyendo una lista de verificación detallada para verificar la postura de cumplimiento del proveedor de su herramienta.
También vale la pena señalar: incluso el mejor BAA no lo protege si está usando una herramienta que extrae más datos de los necesarios. La Regla del Mínimo Necesario coloca la carga en la entidad cubierta — usted — para garantizar que la herramienta solo acceda a los elementos de datos específicos necesarios. Esta es un área donde la Extracción de Columnas Personalizadas (donde usted define exactamente qué campos extraer y la IA extrae solo esos) proporciona una ventaja estructural sobre el OCR de página completa que devuelve todo y requiere filtrado posterior.
Cómo elegir una solución de OCR para el sector sanitario
Para una comparación completa de herramientas en cuanto a precios, precisión y preparación para el cumplimiento normativo, consulte nuestro análisis de los mejores software de OCR para el sector sanitario en 2026. Si su prioridad es específicamente la precisión en la extracción de EOB y formularios de reclamación CMS-1500, nuestro análisis de herramientas de extracción de documentos sanitarios evalúa siete herramientas con documentos reales de múltiples pagadores. El resumen a continuación cubre los cinco criterios más importantes durante la evaluación inicial.
1. Cobertura de documentos
¿La herramienta maneja los tipos de documentos específicos que usted procesa? Una herramienta de extracción de EOB es inútil para informes de laboratorio. Un especialista en CMS-1500 no puede manejar sus formularios de admisión de pacientes. Si su organización procesa múltiples tipos de documentos (como la mayoría), busque una herramienta que cubra todo el espectro o planee mantener soluciones separadas para cada categoría.
2. Precisión a nivel de código
Para formularios de reclamación y EOB, la precisión a nivel de carácter es insuficiente. Se necesita precisión a nivel de campo en códigos CPT (cinco dígitos numéricos, exactos), códigos ICD-10-CM (alfanuméricos de hasta 7 caracteres, exactos) y números NPI (10 dígitos, exactos). Un solo carácter incorrecto en un campo de código puede provocar una denegación. Pruebe la herramienta con sus documentos reales, no con muestras proporcionadas por el proveedor.
3. Preparación para el cumplimiento normativo
La disponibilidad de BAA no es negociable para cualquier carga de trabajo que contenga PHI. Más allá del BAA, verifique la residencia de datos (¿los servidores están en EE. UU.?), los estándares de cifrado (AES-256 en reposo, TLS 1.2+ en tránsito), la retención de datos (¿cuánto tiempo se almacenan sus documentos?) y si la herramienta ha completado una auditoría SOC 2 Tipo 2 o una evaluación de seguridad equivalente de terceros.
4. Integración con sus sistemas existentes
Las organizaciones sanitarias operan con EHR (Epic, Oracle Health Cerner, Meditech, Allscripts), sistemas de gestión de consultorios (athenahealth, AdvancedMD, Kareo, NextGen) y cámaras de compensación (Office Ally, Change Healthcare, ZirMed). La herramienta de OCR ideal genera datos en formatos que su sistema de facturación pueda ingerir (Excel estructurado, CSV o JSON) sin reingreso manual. Cuanto menos cambie su flujo de trabajo, más rápida será la adopción.
5. Capacidad de reconocimiento de escritura a mano
Si su flujo de trabajo incluye recetas, notas clínicas o formularios de admisión de pacientes con campos de texto libre, la precisión de la escritura a mano es un criterio de selección importante. Pruebe con sus propias muestras de escritura a mano, no con el conjunto de pruebas seleccionado por el proveedor. Comprenda dónde aún se requiere verificación humana y si el flujo de trabajo admite ese paso de revisión.
Los archivos se procesan de forma segura y no se almacenan. Pruebe a extraer datos de un documento EOB: no es necesario registrarse.
Preguntas frecuentes
¿Puede el OCR leer con precisión los formularios CMS-1500 y UB-04?
Sí, en escaneos limpios con OCR basado en plantillas, la precisión a nivel de campo alcanza el 98–99% para estos formularios estandarizados. La precisión disminuye en fotocopias, faxes y escaneos de baja calidad; por eso son importantes la calibración del escáner y el uso de formularios OCR-rojo adecuados (según las especificaciones de CMS).
¿El OCR maneja registros médicos escritos a mano y recetas?
El OCR impulsado por IA puede leer escritura a mano con una precisión del 75–90% según la legibilidad, pero la escritura cursiva y apresurada — común en recetas y notas clínicas — sigue siendo una categoría que requiere verificación humana. La mayoría de los flujos de trabajo de salud tratan la extracción de escritura a mano como un paso de "revisión antes de usar" en lugar de automatización directa. Consulte nuestras mejores herramientas OCR para escritura a mano para ver puntos de referencia de precisión detallados.
¿Cómo aplica HIPAA a las herramientas OCR en la nube?
Si envía cualquier documento que contenga PHI a una herramienta OCR de terceros, está realizando una divulgación según la Regla de Privacidad de HIPAA. Esa divulgación requiere un Acuerdo de Asociado de Negocio (BAA) firmado con el proveedor de la herramienta. Sin un BAA, la transmisión es una violación de cumplimiento independientemente del cifrado o las características de seguridad de la herramienta. También verifique la residencia de datos, los estándares de cifrado y la política de eliminación de datos del proveedor.
¿Qué códigos médicos puede extraer el OCR de los formularios de reclamación?
Las herramientas modernas de extracción basadas en IA pueden identificar y extraer códigos de procedimiento CPT (5 dígitos), códigos de diagnóstico ICD-10-CM (alfanuméricos, hasta 7 caracteres), códigos HCPCS Nivel II y números NPI (10 dígitos). El requisito clave es que la herramienta distinga entre tipos de códigos: una herramienta que lo vuelca todo en una sola columna "Code" obliga a reclasificar manualmente, lo que anula el beneficio de la automatización.
¿Es mejor el OCR de plantillas o la extracción con IA para documentos médicos?
Depende del documento. El OCR de plantillas es superior para formularios CMS-1500 y UB-04 con escaneos limpios — los diseños son fijos, conocidos y estandarizados. La extracción con IA es superior para todo lo demás: EOB de múltiples aseguradoras (más de 1,500 diseños), informes de laboratorio, formularios de admisión de pacientes, notas clínicas y recetas. Un enfoque híbrido — plantilla para reclamaciones estructuradas, IA para documentos de formato variable — es la configuración más práctica para organizaciones de salud.
¿Cuánto cuesta el OCR para el sector salud?
Los costos varían ampliamente según la herramienta y el volumen. Las herramientas OCR en la nube de nivel básico para el sector salud van de $29–$99/mes para procesamiento de bajo volumen (100–500 páginas). Los planes de volumen medio (1,000–10,000 páginas/mes) cuestan $100–$500/mes. Las implementaciones empresariales con soporte de integración, plantillas personalizadas y BAA dedicados generalmente comienzan en $1,000+/mes o requieren contratos anuales. El cálculo del ROI debe incluir no solo el costo de tipeo ahorrado, sino la reducción del retrabajo por denegaciones (promedio de $48 por reclamación), menos riesgos de cumplimiento y días más rápidos en cuentas por cobrar.
Un EOB procesado manualmente toma 5 minutos y tiene una tasa de error del 8–12%. El mismo documento procesado con extracción por IA toma 10 segundos y deja los datos estructurados en una hoja de cálculo, listos para conciliación, no para volver a escribirlos. Vea cómo se ven sus propios documentos médicos en un flujo de extracción.