의료 분야 OCR:
의료 기록, EOB 및 청구 양식 처리
단일 CMS-1500 청구 양식에는 30개 이상의 필드(환자 인적 사항, 보험 식별 정보, 최대 12개의 진단 코드(ICD-10-CM), 시술 코드(CPT/HCPCS), 수정자, 진단 포인터, 비용, 제공자 NPI 번호)가 모두 한 페이지에 포함되어 있으며, 이는 디지털 추출이 아닌 종이 처리를 위해 설계된 레이아웃입니다. 여기에 Medicare에만 매주 제출되는 247,000건의 종이 청구서, 1,500개 이상의 고유한 지불자 형식에서 생성되는 EOB, 중첩된 결과 테이블이 있는 검사실 보고서, 접수처에서 빠르게 작성된 필기체 환자 접수 양식을 더하면, 질문은 "OCR이 의료 문서를 처리할 수 있는가"에서 "어떤 접근 방식이 어떤 문서를 처리하며, 각 접근 방식은 어디에서 한계에 부딪히는가"로 바뀝니다.
주요 시사점
- 모든 의료 청구 거절의 30%는 CPT 또는 ICD-10 코드를 잘못 입력하여 발생합니다. 거절된 청구서 1건을 재처리하는 데는 $48이 들지만, 제출 전 검증에는 $3이 들므로 수동 데이터 입력 비용은 자동화 비용의 16배에 달합니다.
- 템플릿 OCR은 깨끗한 CMS-1500에서 99%의 필드 정확도를 달성하지만, 동일한 양식을 복사하면 정확도가 80% 미만으로 급락합니다. 이는 공급업체 정확도 주장에서 거의 언급되지 않는 스캐너 보정 문제입니다.
- 서명된 업무 제휴 계약(BAA)이 없으면 OCR 도구는 환자 데이터가 포함된 문서를 법적으로 처리할 수 없습니다. 추출 정확도 벤치마크가 아무리 높아도 HIPAA는 이를 요구합니다.
의료 분야 OCR이 실제로 하는 일
의료 분야 OCR은 광학 문자 인식과 AI 기반 문서 이해를 의료 기관이 다루는 특정 문서에 적용하는 것입니다: 보험 청구 양식, 지불자의 급여 명세서(EOB), 검사 결과 및 병리 보고서, 환자 접수 및 등록 양식, 처방전, 진료 의뢰서, 퇴원 요약, 임상 기록 등이 포함됩니다.
다른 산업의 OCR과의 차이는 의료 문서가 다른 곳에서는 거의 함께 나타나지 않는 세 가지 과제를 결합하기 때문에 중요합니다: 엄격한 구조적 변동성, 정확히 전사해야 하는 도메인별 코드(CPT, ICD-10-CM, HCPCS, NPI), 그리고 45 CFR §164.514의 HIPAA 개인정보 보호 규칙에 정의된 보호 건강 정보(PHI)에 관한 규제 요구 사항입니다.
의료 OCR 검색 의도의 90% 이상을 차지하는 여섯 가지 문서 범주는 다음과 같습니다: EOB, CMS-1500(전문 청구), UB-04(기관 청구), 검사 보고서, 환자 접수 양식, 처방전입니다. 각각은 고유한 추출 프로필을 제시하며 — 단일 OCR 접근 방식으로 여섯 가지 모두를 동등하게 잘 처리할 수는 없습니다.
OCR이 일반적으로 어떻게 작동하는지에 대한 기초적인 이해는 OCR이 무엇이며 문서를 읽는 방법을 참조하십시오. 의료 분야가 의존하는 비표준 문서를 처리하는 AI 기반 진화에 대해서는 AI OCR이 무엇이며 어떻게 다른지를 참조하십시오.
의료 분야에 OCR이 필요한 이유 — 정량화된 문제
의료 청구에서의 수동 데이터 입력은 자동화가 직접 해결하는 특정한 실패 패턴을 가지고 있습니다. 청구 담당 직원이 부주의해서가 아닙니다. 종이 기반 데이터 입력의 양과 복잡성이 8시간 근무 동안 인간의 정확도가 유지할 수 있는 수준을 초과하기 때문입니다.
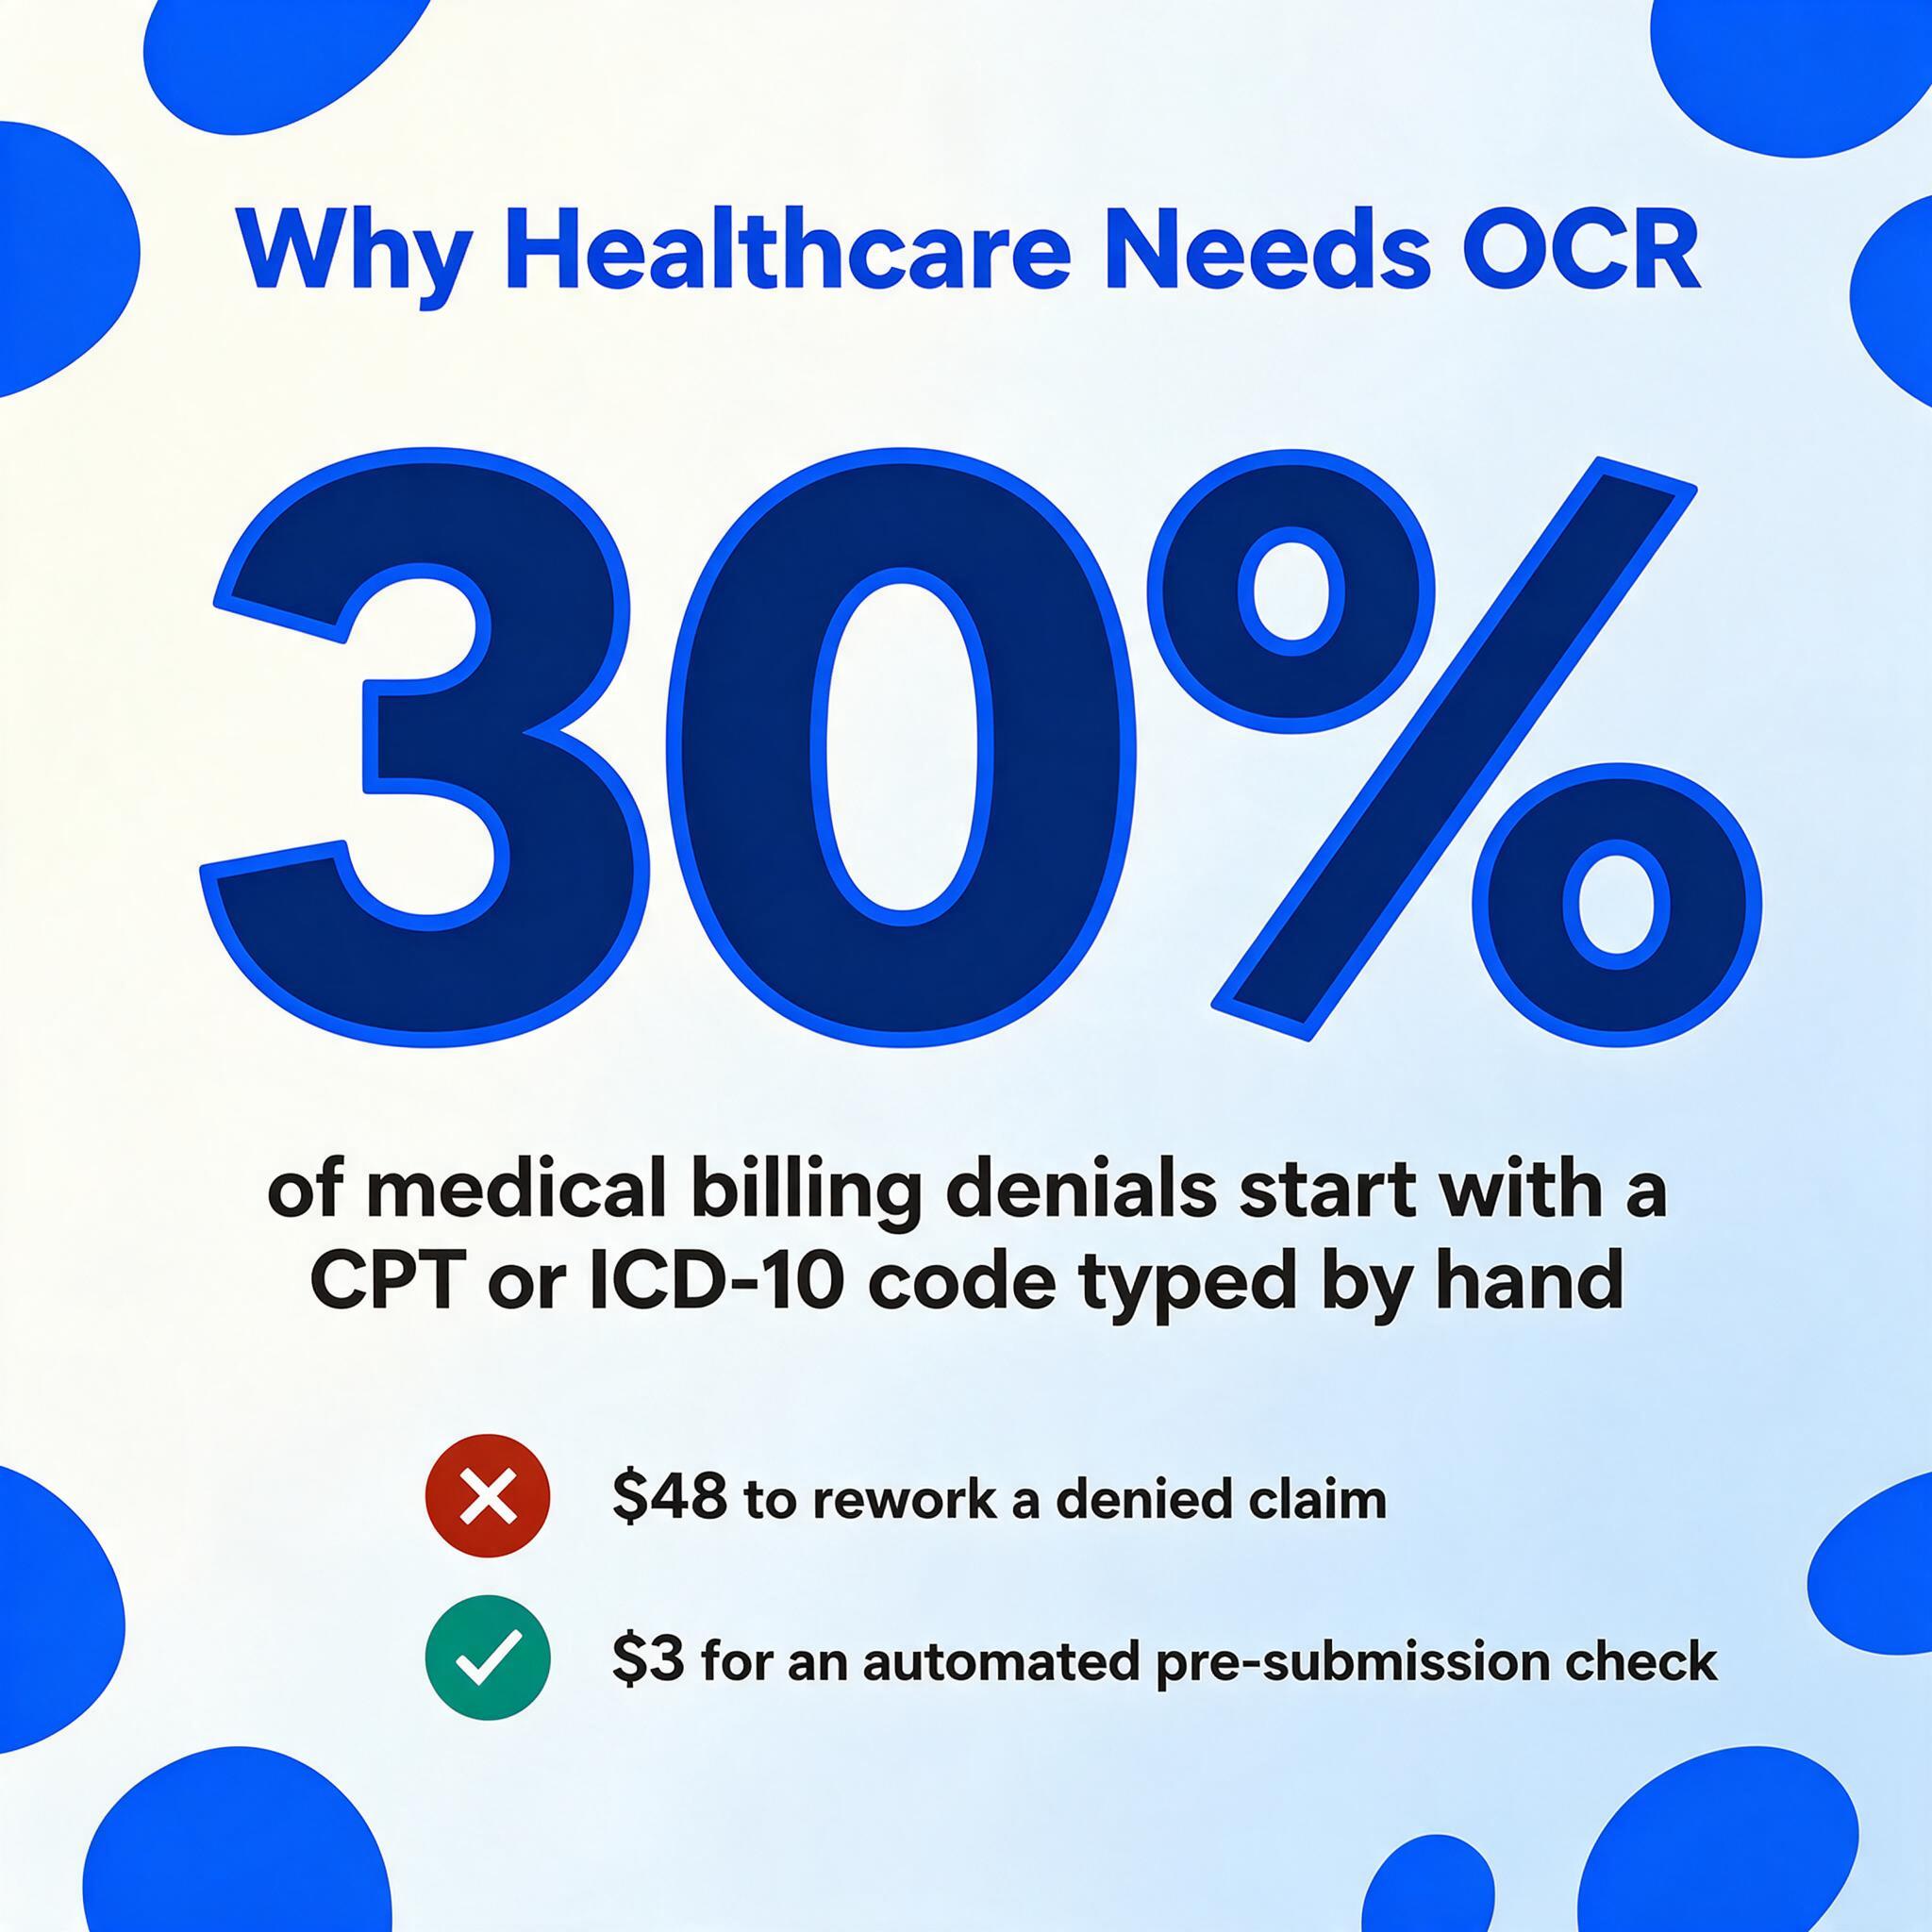
수치는 여러 방향에서 나옵니다. 2021년부터 월 100만 건 이상의 청구를 처리하는 텍사스 Medicaid 배포를 운영해 온 OCR Solutions는 모든 의료 청구 거절의 약 30%가 수동 데이터 캡처 중 잘못 입력된 CPT 또는 ICD-10 코드에서 비롯된다고 보고합니다. 같은 팀의 별도 분석은 평균 거절 재작업 비용을 청구 건당 $48로 추정하며, 자동 사전 제출 검사의 $3와 비교하여 16:1의 비용 비율을 보여줍니다. AMA의 코딩 오류에 관한 공식 지침은 가장 흔한 실수 — 잘못된 수식어, 진단-시술 연계 불일치, 오래된 코드 — 가 무작위가 아니라 구조적임을 확인합니다. 데이터를 입력하는 사람이 이후 청구 처리 시스템이 적용할 모든 교차 필드 의존성을 동시에 확인할 수 없기 때문에 발생합니다.
그 다음에는 인력 수학이 있습니다. 단일 CMS-1500 또는 UB-04 양식을 수동으로 입력하는 데는 5~10분이 소요됩니다. 하루에 500건의 청구를 처리하는 병원 수익 주기 팀은 타이핑만으로 40~80인시를 소비합니다. 조정도, 검토도 없이 단지 한 형식에서 다른 형식으로 문자를 옮기는 것뿐입니다. 자동 추출은 이를 양식당 60초 미만으로 줄여주며, 인간의 역할을 없애는 대신 임상 및 청구 판단이 실제로 중요한 검증 단계로 이동시킵니다.
청구 외에도 검사실 결과 기록 및 환자 접수 디지털화는 유사한 패턴을 따릅니다. 종이 요구서와 등록 양식에서의 수동 전사는 환자 대면 업무에 사용할 수 있는 시간을 소비하며, 오류율은 다운스트림 조정 및 재작업 비용으로 누적되어 대부분의 진료 현장에서 총계를 내지 않습니다.
주요 의료 문서 유형 및 추출 과제
의료 분야는 단일 문서 유형이 아닙니다. 각 주요 범주는 서로 다른 추출 프로필을 제시하며, 이는 템플릿 기반, AI 기반 또는 하이브리드 중 어떤 OCR 접근 방식이 적절한지 결정합니다.
EOB 명세서
EOB는 의료 분야에서 가장 형식 변동이 심한 문서라고 할 수 있습니다. 상업 보험사(BCBS, UnitedHealthcare, Aetna, Cigna, Humana), 정부 지불자(Medicare, Medicaid, Tricare) 및 산재 보험사를 통틀어 1,500개 이상의 고유한 지불자별 EOB 레이아웃이 있습니다. Medicare는 청구 식별자를 "ICN"이라고 부릅니다. BCBS는 청구 번호를 오른쪽 상단에 배치합니다. Aetna는 왼쪽 헤더 블록에 넣습니다. 세 가지 모두 동일한 의미를 갖지만, 위치 기반 OCR 템플릿은 이를 캡처하기 위해 세 가지 별도 구성을 필요로 합니다.
조정에 중요한 필드는 청구 번호/ICN, 환자 이름 및 ID, 서비스 날짜, 수정자가 포함된 CPT 절차 코드, 청구 금액, 허용 금액, 플랜 지불액, 공제액, 본인 부담금, 공동 보험, 환자 책임 및 거부 사유 코드입니다. 과제는 문자를 읽는 것이 아닙니다. 최신 OCR은 이를 안정적으로 수행합니다. 과제는 각 지불자의 명세서에서 동일한 데이터 포인트가 다른 위치에 나타날 때 각 값을 올바른 열에 매핑하는 것입니다.
이것이 템플릿 기반 OCR이 한계에 도달하고 의미론적 AI 추출이 필요해지는 지점입니다. 자세한 내용은 전용 EOB 데이터 추출 완전 가이드를 참조하거나 EOB to Excel 추출 도구를 지불자 명세서에 직접 사용해 보십시오.
CMS-1500
CMS-1500 양식은 의사, 클리닉 및 비기관 제공자가 메디케어 및 대부분의 상업 보험사에 청구하기 위해 사용하는 표준 종이 청구 양식입니다. 한 페이지에 33개의 번호가 매겨진 상자가 빽빽하게 들어 있습니다. 이러한 밀도가 특징입니다. 즉, 표준화된 종이 형식으로 청구 심사에 필요한 모든 정보를 담고 있지만, 동시에 범용 OCR이 정확하게 분석하기 가장 어려운 양식 중 하나입니다.
중요한 구조적 문제는 필드 간 종속성입니다. Box 24E는 Box 21에 나열된 유효한 ICD-10-CM 코드를 참조해야 합니다. 정렬이 잘못된 포인터는 사람이 입력할 때 눈에 띄지 않습니다. 입력자가 여러 서비스 라인에 걸쳐 Box 24E의 각 포인터 코드가 Box 21의 유효한 항목과 일치하는지 동시에 확인할 수 없기 때문입니다. 지불자의 심사 시스템은 30~60일 후에 이를 거부로 포착합니다. 템플릿 기반 OCR은 이 양식을 잘 처리합니다. 레이아웃이 CMS의 공식 양식 사양에 따라 표준화되어 최적의 스캔 조건에서 최대 99%의 필드 수준 정확도를 달성하기 때문입니다.
그러나 대부분의 공급업체가 사전에 언급하지 않는 문제가 있습니다. CMS-1500 OCR 정확도는 스캐너 설정에 크게 의존합니다. 메디케어 운송업체가 사용하는 "레드 드롭아웃" 기능은 특정 스캐너 보정이 필요합니다. 소규모 진료소에서 흔히 사용하는 양식의 복사본에는 필요한 OCR-레드 잉크가 없으므로 드롭아웃 영역이 작동하지 않으며 추출 엔진이 입력 가능한 필드를 분리하는 대신 전체 페이지를 구문 분석해야 합니다. 깨끗한 스캔과 복사본의 차이는 동일한 OCR 엔진에서 정확도를 99%에서 80% 미만으로 떨어뜨릴 수 있습니다.
UB-04
CMS-1500에 33개의 박스가 있는 반면, UB-04에는 81개의 폼 로케이터가 있습니다. 병원, 전문 요양 시설, 재택 의료 기관 및 기타 기관 제공자가 전체 치료 에피소드에 대해 청구할 때 사용합니다. 복잡성은 행 수준 구조에서 발생합니다. 폼 로케이터 42~47은 반복 라인 항목으로, 수익 코드, 서비스 설명, 서비스 날짜, 단위, 총 청구액, 비포함 청구액이 각 행에서 모두 일치해야 합니다. 수익 코드를 하나만 잘못 읽어도 해당 라인의 전체 가격이 어긋나며, 지불자는 어떤 필드가 잘못되었는지 추측하기보다 청구를 거부합니다.
UB-04 형식은 기관용이며, 기관 청구에는 CMS-1500에 해당 항목이 없는 조건 코드, 발생 코드, 값 코드, 수익 코드가 포함되므로 별도의 매핑 및 검증 레이어가 필요합니다. 사전 구축된 UB-04 매핑이 포함된 템플릿 기반 시스템이 업계 표준이며, 스캔 품질이 일관적일 때 잘 작동합니다.
검사 보고서 및 병리 결과
검사 보고서는 청구 양식과 중요한 점에서 다릅니다. 표준화되어 있지 않다는 것입니다. 각 검사 기관은 자체 보고 템플릿을 사용합니다. 데이터 자체는 구조화되어 있지만(검사명, 결과 값, 참고 범위, 플래그), 레이아웃은 다양합니다. 일부 검사 보고서는 결과를 세로 목록으로 제시하고, 일부는 표로, 일부는 표가 포함된 혼합 서술 형식으로 제시합니다. 추출 과제는 검사명, 결과 값("7.2%"), 참고 범위, 플래그를 구분하는 것입니다. 이를 OCR 텍스트 블록으로 읽으면 사용 가능한 데이터가 생성되지 않습니다. 값은 올바른 행 연결과 함께 별도의 열에 배치되어야 합니다.
환자 접수 및 등록 양식
접수 양식은 OCR에 취약한 세 가지 요소를 결합합니다: 체크박스, 필기, 그리고 혼합 형식 필드입니다. 체크박스는 특히 까다롭습니다 — 기존 OCR은 텍스트를 읽지, 박스 안의 표시 유무를 읽지 않습니다. AI 기반 비전 모델은 문서를 이미지로 보기 때문에 표시 방법과 관계없이 박스가 채워졌는지 감지할 수 있어 이 문제를 더 잘 처리합니다. 필기 요소의 경우, AI 추출 기술은 최근 몇 년간 크게 개선되었지만 정확도는 필기 가독성에 따라 크게 달라집니다. 현재 기술이 처리할 수 있는 것과 없는 것에 대해서는 필기 OCR 소프트웨어 가이드를 참조하십시오.
등록 서류의 경우, 실질적인 목표는 환자당 한 행입니다: 환자 접수 양식의 Excel 변환은 체크된 박스, 필기 답변, 보험 필드를 단일 패스로 해당 열에 매핑합니다.
처방전
처방전은 필기 문제의 극단적인 사례를 나타냅니다. 하루 종일 진료를 마친 의사들이 쓰는 필기는 어떤 업계에서도 가장 까다로운 필기체 중 하나입니다. 위험이 큽니다 — 약품명이나 용량을 잘못 읽으면 환자에게 해를 끼칠 수 있습니다. 기존 OCR은 필기체에서 사실상 실패합니다; AI 기반 비전 모델은 품질이 합리적인 필기 처방전에서 85–95%의 정확도를 달성하지만, 품질이 낮은 스캔이나 급하게 쓴 필기에서는 크게 떨어집니다. 대부분의 의료 OCR 워크플로우는 처방전을 완전 자동화 대상이 아닌 인간 검증 필수 범주로 취급합니다.
중요한 필드: 의료 코드, 식별자, PHI
의료 문서에는 다른 산업에는 없는 데이터 요소가 포함됩니다. 인보이스에는 날짜와 합계가 있습니다. 의료 청구서에는 그 외에도 청구가 지급, 거부 또는 감사 대상이 되는지 결정하는 코드가 있습니다. 이러한 코드가 무엇이고 추출에 왜 중요한지 이해하는 것은 범용 OCR 도구를 구매하는 것과 의료 분야에 적합한 도구를 구매하는 것의 차이입니다.
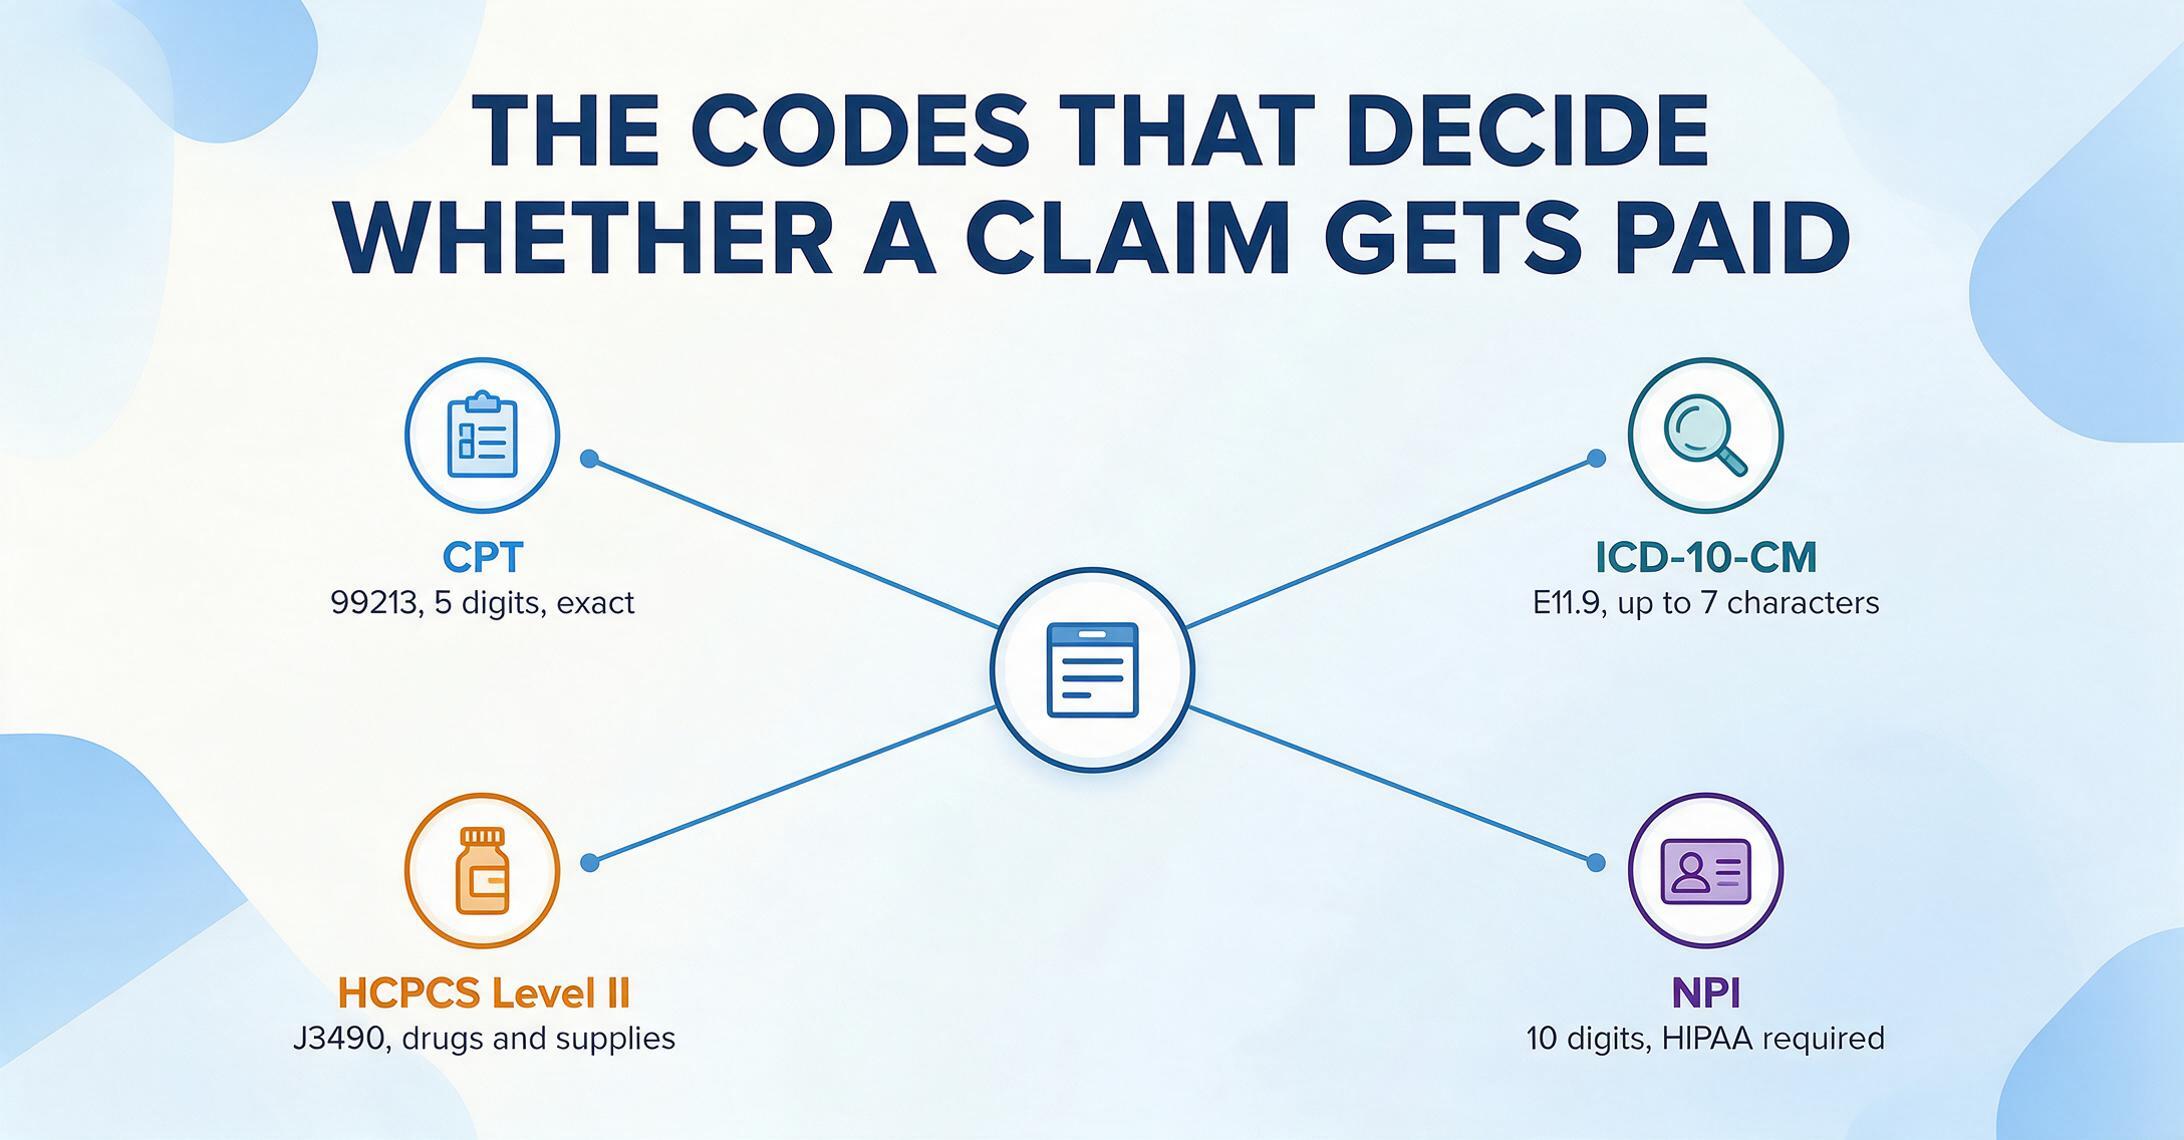
CPT 코드
Current Procedural Terminology로, 미국의사협회(American Medical Association)가 관리합니다. 의료 시술 및 서비스를 설명하는 5자리 숫자 코드입니다. 예: 99213. AI는 진단 코드와 시술 코드를 구분해야 합니다. 두 코드가 같은 줄에 표시되는 경우가 많습니다.
ICD-10-CM 코드
International Classification of Diseases, 10th Revision, Clinical Modification. 진단을 설명하는 최대 7자리의 영숫자 코드입니다. 예: E11.9. 약 72,000개의 활성 코드가 있어 문자 단위의 정밀한 추출이 필요합니다.
HCPCS Level II
Healthcare Common Procedure Coding System으로, CMS가 관리합니다. CPT에 포함되지 않는 제품, 소모품 및 서비스에 대한 영숫자 코드입니다. 예: J3490. UB-04 기관 청구서에서 흔히 볼 수 있습니다.
NPI 번호
National Provider Identifier. HIPAA가 모든 의료 제공자에게 요구하는 10자리 숫자 식별자입니다. 표준 10자리 형식을 따라야 하며, 추출 검증 시 이 패턴과 대조하여 확인해야 합니다.
그리고 PHI가 있습니다. HIPAA 개인정보 보호 규정에 따라 18개 범주의 식별자가 건강 정보를 개인 식별이 가능한 정보로 만듭니다. 여기에는 명백한 항목뿐만 아니라 날짜, 전화번호, 팩스 번호, 이메일 주소, 의무기록 번호, 건강보험 수급자 번호, 계좌 번호, 증명서/면허 번호, 차량 식별자, 기기 식별자 및 일련번호, URL, IP 주소, 생체 인식 식별자, 정면 사진, 그리고 기타 고유한 식별 번호, 특성 또는 코드가 포함됩니다.
OCR 도구 선택에 있어 실질적인 의미는 다음과 같습니다. 이러한 18개 식별자 중 하나라도 포함된 의료 문서를 처리하는 모든 도구는 HIPAA 공개에 해당합니다. 이러한 공개에는 45 CFR §164.504(e)에 따른 서명된 업무 제휴 계약(BAA, Business Associate Agreement)이 필요합니다. BAA에 서명할 수 없거나 서명하지 않으려는 도구는 정확도 수치와 관계없이 의료 문서 처리에 적합한 후보가 아닙니다.
헬스케어 문서 처리를 위한 기존 OCR과 AI 기반 추출 비교
핵심 질문은 "어느 쪽이 더 나은가"가 아니라 "어떤 문서에 어떤 방식을 쓸 것인가"입니다. 헬스케어 분야는 기존 템플릿 OCR과 현대적인 AI 기반 추출 모두 정당한 역할을 지닌 특수한 영역으로, 문서 유형에 따라 최적의 접근 방식이 달라집니다.
| 문서 유형 | 더 적합한 방식 | 이유 | 달성 가능한 정확도 |
|---|---|---|---|
| CMS-1500 | 템플릿 OCR | 고정 레이아웃, 알려진 필드 좌표, 레드 드롭아웃 지원 | 필드 기준 98–99% |
| CMS-1500 | AI 추출 | 레드 드롭아웃 영역 없음; AI가 의미론적으로 필드 위치를 추론 가능 | 필드 기준 85–92% |
| UB-04 | 템플릿 OCR | 81개의 고정 양식 로케이터, 알려진 구조 | 필드 기준 98–99% |
| EOB | AI 추출 | 1,500개 이상의 고유 레이아웃; 고정 필드 위치 없음 | 필드 기준 85–95% |
| 검사 결과지 | AI 추출 | 검사 기관마다 비표준 레이아웃; 의미론적 매칭 필요 | 필드 기준 80–92% |
| 환자 접수 양식 | AI 추출 | 체크박스 + 필기 + 혼합 필드 | 75–90% |
| 처방전 | AI 추출 | 필기체; 비전 모델 필요 | 70–88% |
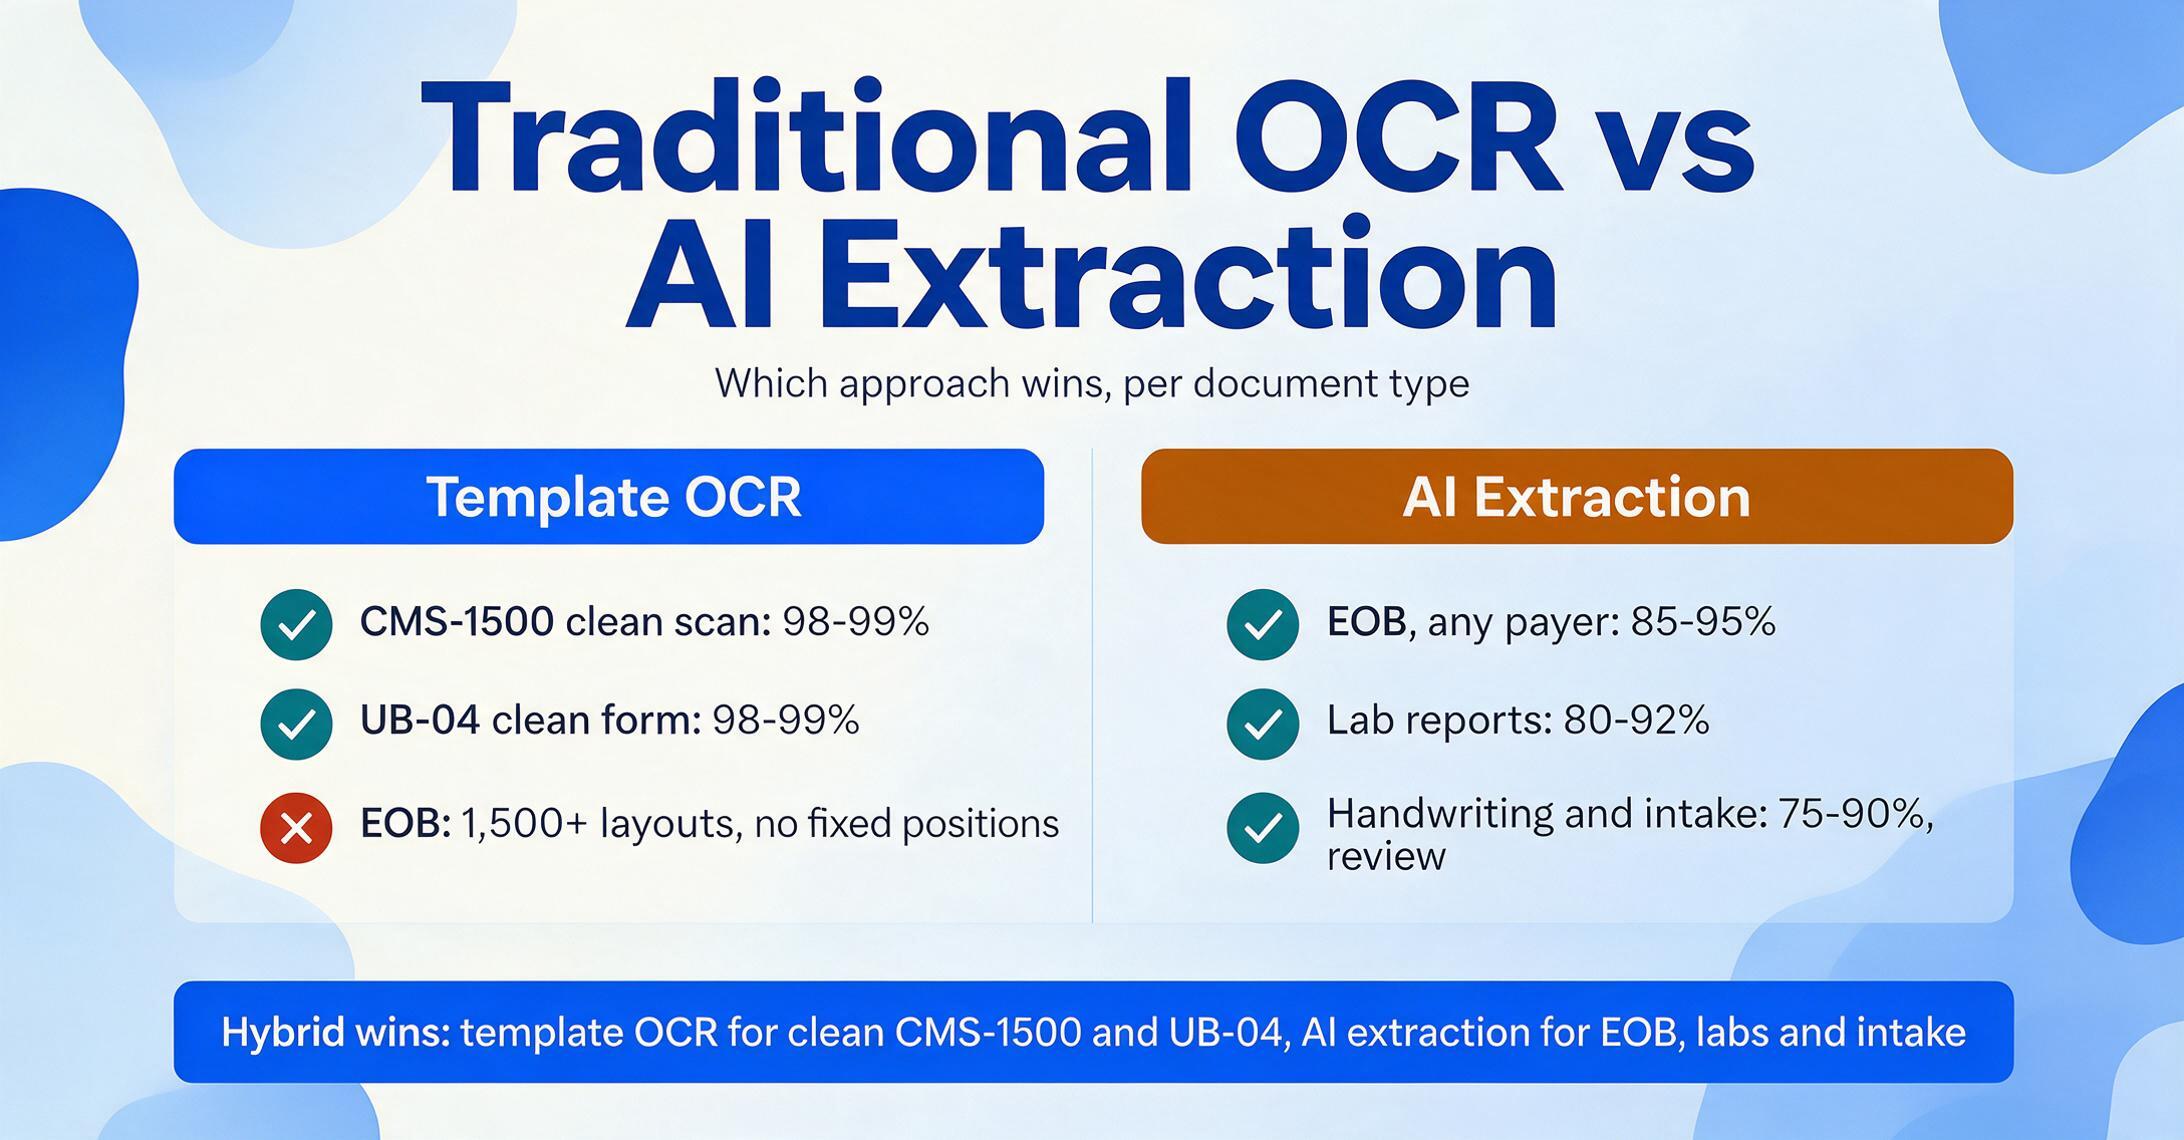
이것이 많은 헬스케어 조직이 결국 하이브리드 워크플로우를 운영하게 되는 이유입니다. 정확도가 가장 중요하고 필드 수준 검증이 필수적인 구조화된 청구 양식에는 템플릿 OCR을, 유연성이 더 중요한 비표준 문서에는 AI 추출을 사용하는 것입니다. 헬스케어에서 이 두 접근 방식은 경쟁 관계가 아니라 문서 스펙트럼의 서로 다른 부분을 담당하는 상호 보완적인 도구입니다.
솔직한 답변: 스캔 품질이 좋은 CMS-1500 및 UB-04 양식의 경우 템플릿 기반 OCR이 여전히 정확도 선두입니다. 그러나 EOB, 검사 결과지, 접수 양식, 처방전 등 기타 모든 헬스케어 문서 유형의 경우 레이아웃이 너무 다양하여 템플릿이 따라잡을 수 없으므로 AI 기반 추출만이 유일하게 실행 가능한 접근 방식입니다.
규정 준수 고려 사항: 선택 기준으로서의 HIPAA
많은 OCR 도구 관련 글들이 이 부분에서 마케팅 문구로 변질되곤 합니다. 여기서는 실용적인 프레임워크를 제시합니다.
HIPAA 규정 준수는 켜고 끄는 기능이 아닙니다. 환자 데이터와 함께 도구를 어떻게 사용할 수 있는지를 규율하는 법적 체계입니다. 관련 구성 요소는 다음과 같습니다:
- 업무 제휴 계약(BAA) — 45 CFR §164.504(e)에 따라, 귀하의 조직과 도구 제공업체 간에 체결되는 계약으로, 제공업체를 업무 제휴자로 설정합니다. BAA 없이 제3자 도구에 PHI를 전송하는 것은 프라이버시 규칙을 위반하는 공개에 해당합니다.
- 최소 필요 규칙 — 45 CFR §164.502(b)에 따라, 의도된 목적을 달성하는 데 필요한 최소한의 PHI만 공개해야 합니다. 문서에 보이는 모든 것을 추출한 후 결과물을 직접 분류해야 하는 도구는 구조적으로 이 요구 사항과 일치하지 않습니다.
- 보안 규칙 — 45 CFR §164.306에 따라, 전자 PHI에 대한 관리적, 물리적, 기술적 안전장치를 의미합니다. 클라우드 기반 OCR 도구의 경우 저장 데이터 암호화(AES-256), 전송 중 암호화(TLS 1.2+), 접근 통제, 감사 로깅이 포함됩니다.
의료 분야용 OCR 도구를 평가할 때 다음 세 가지 질문을 순서대로 던지십시오:
- BAA에 서명해 주시겠습니까? 아니요라는 답변이 나오면 해당 도구는 PHI가 포함된 문서에는 사용할 수 없습니다. 사실상 모든 의료 문서가 제외됩니다.
- 데이터는 어디에서 처리되고 저장됩니까? BAA에는 데이터 보관 위치가 명시되어야 합니다. 규정 준수 체계상 PHI가 미국 국경 내에 머물러야 한다면, 도구는 미국 내 서버에서 데이터를 처리해야 합니다.
- 처리 후 문서는 어떻게 됩니까? HIPAA의 데이터 보존 및 폐기 요구 사항이 적용됩니다. 의료 문서를 무기한 저장하는 도구는 귀하와 제공업체 모두에게 규정 준수 부담을 초래합니다. 정의된 기간 내 자동 삭제는 클라우드 기반 추출 워크플로우의 표준입니다.
HIPAA 및 의료 문서 추출에 대한 자세한 내용은 여기에서 심층적으로 다루고 있습니다. 도구 제공업체의 규정 준수 상태를 검증하기 위한 상세 체크리스트도 포함되어 있습니다.
또한 주목할 점: 필요한 것보다 더 많은 데이터를 추출하는 도구를 사용한다면 아무리 훌륭한 BAA라도 귀하를 보호하지 못합니다. 최소 필요 규칙은 도구가 특정 데이터 요소에만 접근하도록 보장할 책임을 피보장 기관, 즉 귀하에게 부과합니다. 이는 맞춤 열 추출이 모든 것을 반환하고 사후 필터링이 필요한 전체 페이지 OCR보다 구조적 우위를 제공하는 영역입니다.
의료용 OCR 솔루션 선택 방법
가격, 정확도, 규정 준수 측면에서 도구를 종합 비교하려면 2026년 의료용 최고의 OCR 소프트웨어 종합 리뷰를 참조하세요. 특히 EOB 및 CMS-1500 청구 양식 추출 정확도가 우선순위라면, 의료 문서 추출 도구 종합 리뷰에서 실제 다중 보험사 문서를 대상으로 7가지 도구를 테스트합니다. 아래 요약은 초기 평가에서 가장 중요한 5가지 기준을 다룹니다.
1. 문서 범위
도구가 처리하는 특정 문서 유형을 지원하는지 확인하세요. EOB 추출 도구는 검사실 보고서에는 쓸모가 없습니다. CMS-1500 전문 도구는 환자 접수 양식을 처리할 수 없습니다. 여러 문서 유형을 처리하는 조직이라면 전체 범위를 지원하는 도구를 찾거나, 각 범주별로 별도 솔루션을 유지하는 방안을 계획하세요.
2. 코드 수준 정확도
청구 양식과 EOB의 경우 문자 수준 정확도로는 충분하지 않습니다. CPT 코드, ICD-10-CM 코드, NPI 번호에 대한 필드 수준 정확도가 필요합니다. 코드 필드의 단 한 글자 오류도 거부 사유가 될 수 있습니다. 공급업체가 제공한 샘플이 아닌 실제 문서로 도구를 테스트하세요.
3. 규정 준수 준비 상태
PHI가 포함된 모든 워크로드에서 BAA 제공 여부는 필수 조건입니다. BAA 외에도 데이터 보관 위치, 암호화 표준, 데이터 보존 기간, SOC 2 Type 2 감사 또는 이에 상응하는 제3자 보안 평가 완료 여부를 확인하세요.
4. 기존 시스템과의 통합
의료 기관은 EHR(Epic, Oracle Health Cerner, Meditech, Allscripts), 진료 관리 시스템(athenahealth, AdvancedMD, Kareo, NextGen), 청구 중개 기관(Office Ally, Change Healthcare, ZirMed)을 사용합니다. 이상적인 OCR 도구는 수동 재입력 없이 청구 시스템이 수용할 수 있는 형식으로 데이터를 출력해야 합니다. 워크플로 변경이 적을수록 도입이 빨라집니다.
5. 필기 인식 기능
워크플로에 처방전, 임상 기록, 자유 텍스트 필드가 있는 환자 접수 양식이 포함된 경우 필기 정확도는 중요한 선택 기준입니다. 공급업체가 선별한 테스트 세트가 아닌 실제 필기 샘플로 테스트하세요. 인간 검증이 여전히 필요한 부분을 파악하고 워크플로가 해당 검토 단계를 지원하는지 확인하세요.
파일은 안전하게 처리되며 저장되지 않습니다. EOB 문서에서 데이터 추출을 시도해 보세요 — 회원가입이 필요 없습니다.
FAQ
OCR이 CMS-1500 및 UB-04 양식을 정확하게 읽을 수 있나요?
네, 깨끗한 스캔과 템플릿 기반 OCR을 사용하면 이러한 표준 양식의 필드 수준 정확도는 98~99%에 달합니다. 사본, 팩스, 저품질 스캔에서는 정확도가 떨어지므로 스캐너 보정과 CMS 사양에 따른 적절한 OCR-red 양식 사용이 중요합니다.
OCR이 손으로 쓴 의료 기록과 처방전을 처리할 수 있나요?
AI 기반 OCR은 필기체를 가독성에 따라 75~90% 정확도로 읽을 수 있지만, 처방전과 임상 기록에서 흔히 볼 수 있는 필기체와 급하게 쓴 글씨는 여전히 사람의 검증이 필요한 범주입니다. 대부분의 의료 워크플로우는 필기 추출을 자동화 대신 "사용 전 검토" 단계로 취급합니다. 자세한 정확도 벤치마크는 최고의 필기 OCR 도구를 참조하세요.
HIPAA는 클라우드 기반 OCR 도구에 어떻게 적용되나요?
PHI가 포함된 문서를 제3자 OCR 도구에 보내는 경우, 이는 HIPAA 프라이버시 규칙에 따른 공개에 해당합니다. 이 공개에는 도구 제공업체와의 서명된 업무 제휴 계약(BAA)이 필요합니다. BAA가 없으면 도구의 암호화 또는 보안 기능과 관계없이 전송은 규정 위반입니다. 또한 데이터 보관 위치, 암호화 표준, 제공업체의 데이터 삭제 정책도 확인해야 합니다.
OCR이 청구 양식에서 추출할 수 있는 의료 코드는 무엇인가요?
최신 AI 기반 추출 도구는 CPT 시술 코드, ICD-10-CM 진단 코드, HCPCS Level II 코드, NPI 번호를 식별하고 추출할 수 있습니다. 핵심 요구 사항은 도구가 코드 유형을 구분한다는 것입니다. 모든 것을 단일 "코드" 열에 덤프하는 도구는 자동화 이점을 무효화하는 수동 재분류를 강요합니다.
의료 문서에는 템플릿 OCR 또는 AI 추출 중 어느 것이 더 나은가요?
문서 유형에 따라 다릅니다. 템플릿 OCR은 깨끗한 스캔의 CMS-1500 및 UB-04 양식에 탁월합니다. 레이아웃이 고정되어 있고 알려져 있으며 표준화되어 있기 때문입니다. AI 추출은 그 외의 모든 것, 즉 여러 지불자의 EOB, 실험실 보고서, 환자 접수 양식, 임상 기록, 처방전에 탁월합니다. 하이브리드 접근 방식이 의료 기관에 가장 실용적인 구성입니다.
의료용 OCR 비용은 얼마인가요?
비용은 도구와 볼륨에 따라 크게 다릅니다. 의료용 엔트리 레벨 클라우드 OCR 도구는 저용량 처리에 월 $29~$99입니다. 중간 용량 요금제는 월 $100~$500입니다. 통합 지원, 맞춤 템플릿, 전용 BAA가 포함된 엔터프라이즈 배포는 일반적으로 월 $1,000 이상 또는 연간 계약이 필요합니다. ROI 계산에는 절약된 타이핑 비용뿐만 아니라 거절 재작업 감소, 규정 준수 위험 감소, 매출채권 회수 기간 단축도 포함해야 합니다.
EOB 한 건을 수동으로 처리하는 데는 5분이 걸리고 오류율은 8~12%입니다. 동일한 문서를 AI 추출로 처리하면 10초가 걸리며 구조화된 데이터가 스프레드시트에 입력됩니다 — 재입력이 아닌 대사 작업에 바로 사용할 수 있습니다. 자체 의료 문서가 추출 파이프라인에서 어떻게 처리되는지 확인해 보세요.