OCR pour la santé :
Traitement des dossiers médicaux, EOB et formulaires de réclamation
Un seul formulaire de réclamation CMS-1500 contient plus de 30 champs — données démographiques du patient, identifiants d'assurance, jusqu'à 12 codes de diagnostic (ICD-10-CM), codes de procédure (CPT/HCPCS), modificateurs, pointeurs de diagnostic, frais et numéros NPI du prestataire — le tout sur une seule page dans une mise en page conçue pour le traitement papier, pas pour l'extraction numérique. Multipliez cela par les 247 000 réclamations papier encore soumises chaque semaine à Medicare seul, ajoutez les EOB provenant de plus de 1 500 formats de payeurs uniques, les rapports de laboratoire avec des tableaux de résultats imbriqués et les formulaires d'admission des patients remplis en cursive précipitée à l'accueil, et la question passe de « l'OCR peut-il gérer les documents de santé » à « quelle approche gère quel document, et où chaque approche échoue ».
Points clés à retenir
- 30 % de tous les refus de facturation médicale commencent par des codes CPT ou ICD-10 saisis incorrectement — à 48 $ par réclamation refusée à retraiter, contre 3 $ pour une validation avant soumission, la saisie manuelle des données coûte 16 fois plus cher que l'automatisation.
- L'OCR basé sur modèle atteint une précision de 99 % sur un CMS-1500 propre — mais photocopiez ce même formulaire et la précision chute sous les 80 %, un problème d'étalonnage du scanner que les affirmations de précision des fournisseurs ne mentionnent presque jamais.
- Sans accord d'associé commercial signé, l'outil OCR ne peut pas traiter légalement un document contenant des données patient — la HIPAA l'exige, quel que soit le nombre de neuf dans les références de précision d'extraction.
Ce qu'est réellement l'OCR pour la santé
L'OCR pour la santé est l'application de la reconnaissance optique de caractères et de la compréhension documentaire basée sur l'IA aux documents spécifiques que les organismes médicaux traitent : formulaires de réclamation d'assurance (CMS-1500 pour les réclamations professionnelles, UB-04 pour les réclamations institutionnelles), relevés d'explication des prestations (EOB) des payeurs, résultats de laboratoire et rapports d'anatomopathologie, formulaires d'admission et d'inscription des patients, ordonnances, lettres d'orientation, résumés de sortie et notes cliniques.
La distinction avec l'OCR dans d'autres secteurs est importante car les documents médicaux combinent trois défis qui apparaissent rarement ensemble ailleurs : une variabilité structurelle stricte (plus de 1 500 formats EOB), des codes spécifiques au domaine qui doivent être transcrits avec précision (CPT, ICD-10-CM, HCPCS, NPI), et des exigences réglementaires concernant les informations de santé protégées (PHI) définies par la règle de confidentialité HIPAA au 45 CFR §164.514.
Les six catégories de documents qui couvrent plus de 90 % de l'intention de recherche « OCR pour la santé » sont : les EOB (avis de paiement du payeur), les CMS-1500 (réclamations professionnelles), les UB-04 (réclamations institutionnelles), les rapports de laboratoire (résultats cliniques), les formulaires d'admission des patients (inscription et antécédents), et les ordonnances (prescriptions médicamenteuses manuscrites ou imprimées). Chacune présente un profil d'extraction unique — et aucune approche OCR unique ne gère les six aussi bien.
Pour une compréhension fondamentale du fonctionnement général de l'OCR, voir ce qu'est l'OCR et comment il lit les documents. Pour l'évolution basée sur l'IA qui gère les documents non standard dont dépend la santé, voir ce qu'est l'OCR IA et en quoi il diffère.
Pourquoi la santé a besoin de l'OCR — Le problème quantifié
La saisie manuelle des données dans la facturation médicale présente un schéma d'échec spécifique que l'automatisation traite directement. Ce n'est pas que le personnel de facturation soit négligent. C'est que le volume et la complexité de la saisie manuelle des données sur papier dépassent ce que la précision humaine peut maintenir sur un quart de travail de huit heures.
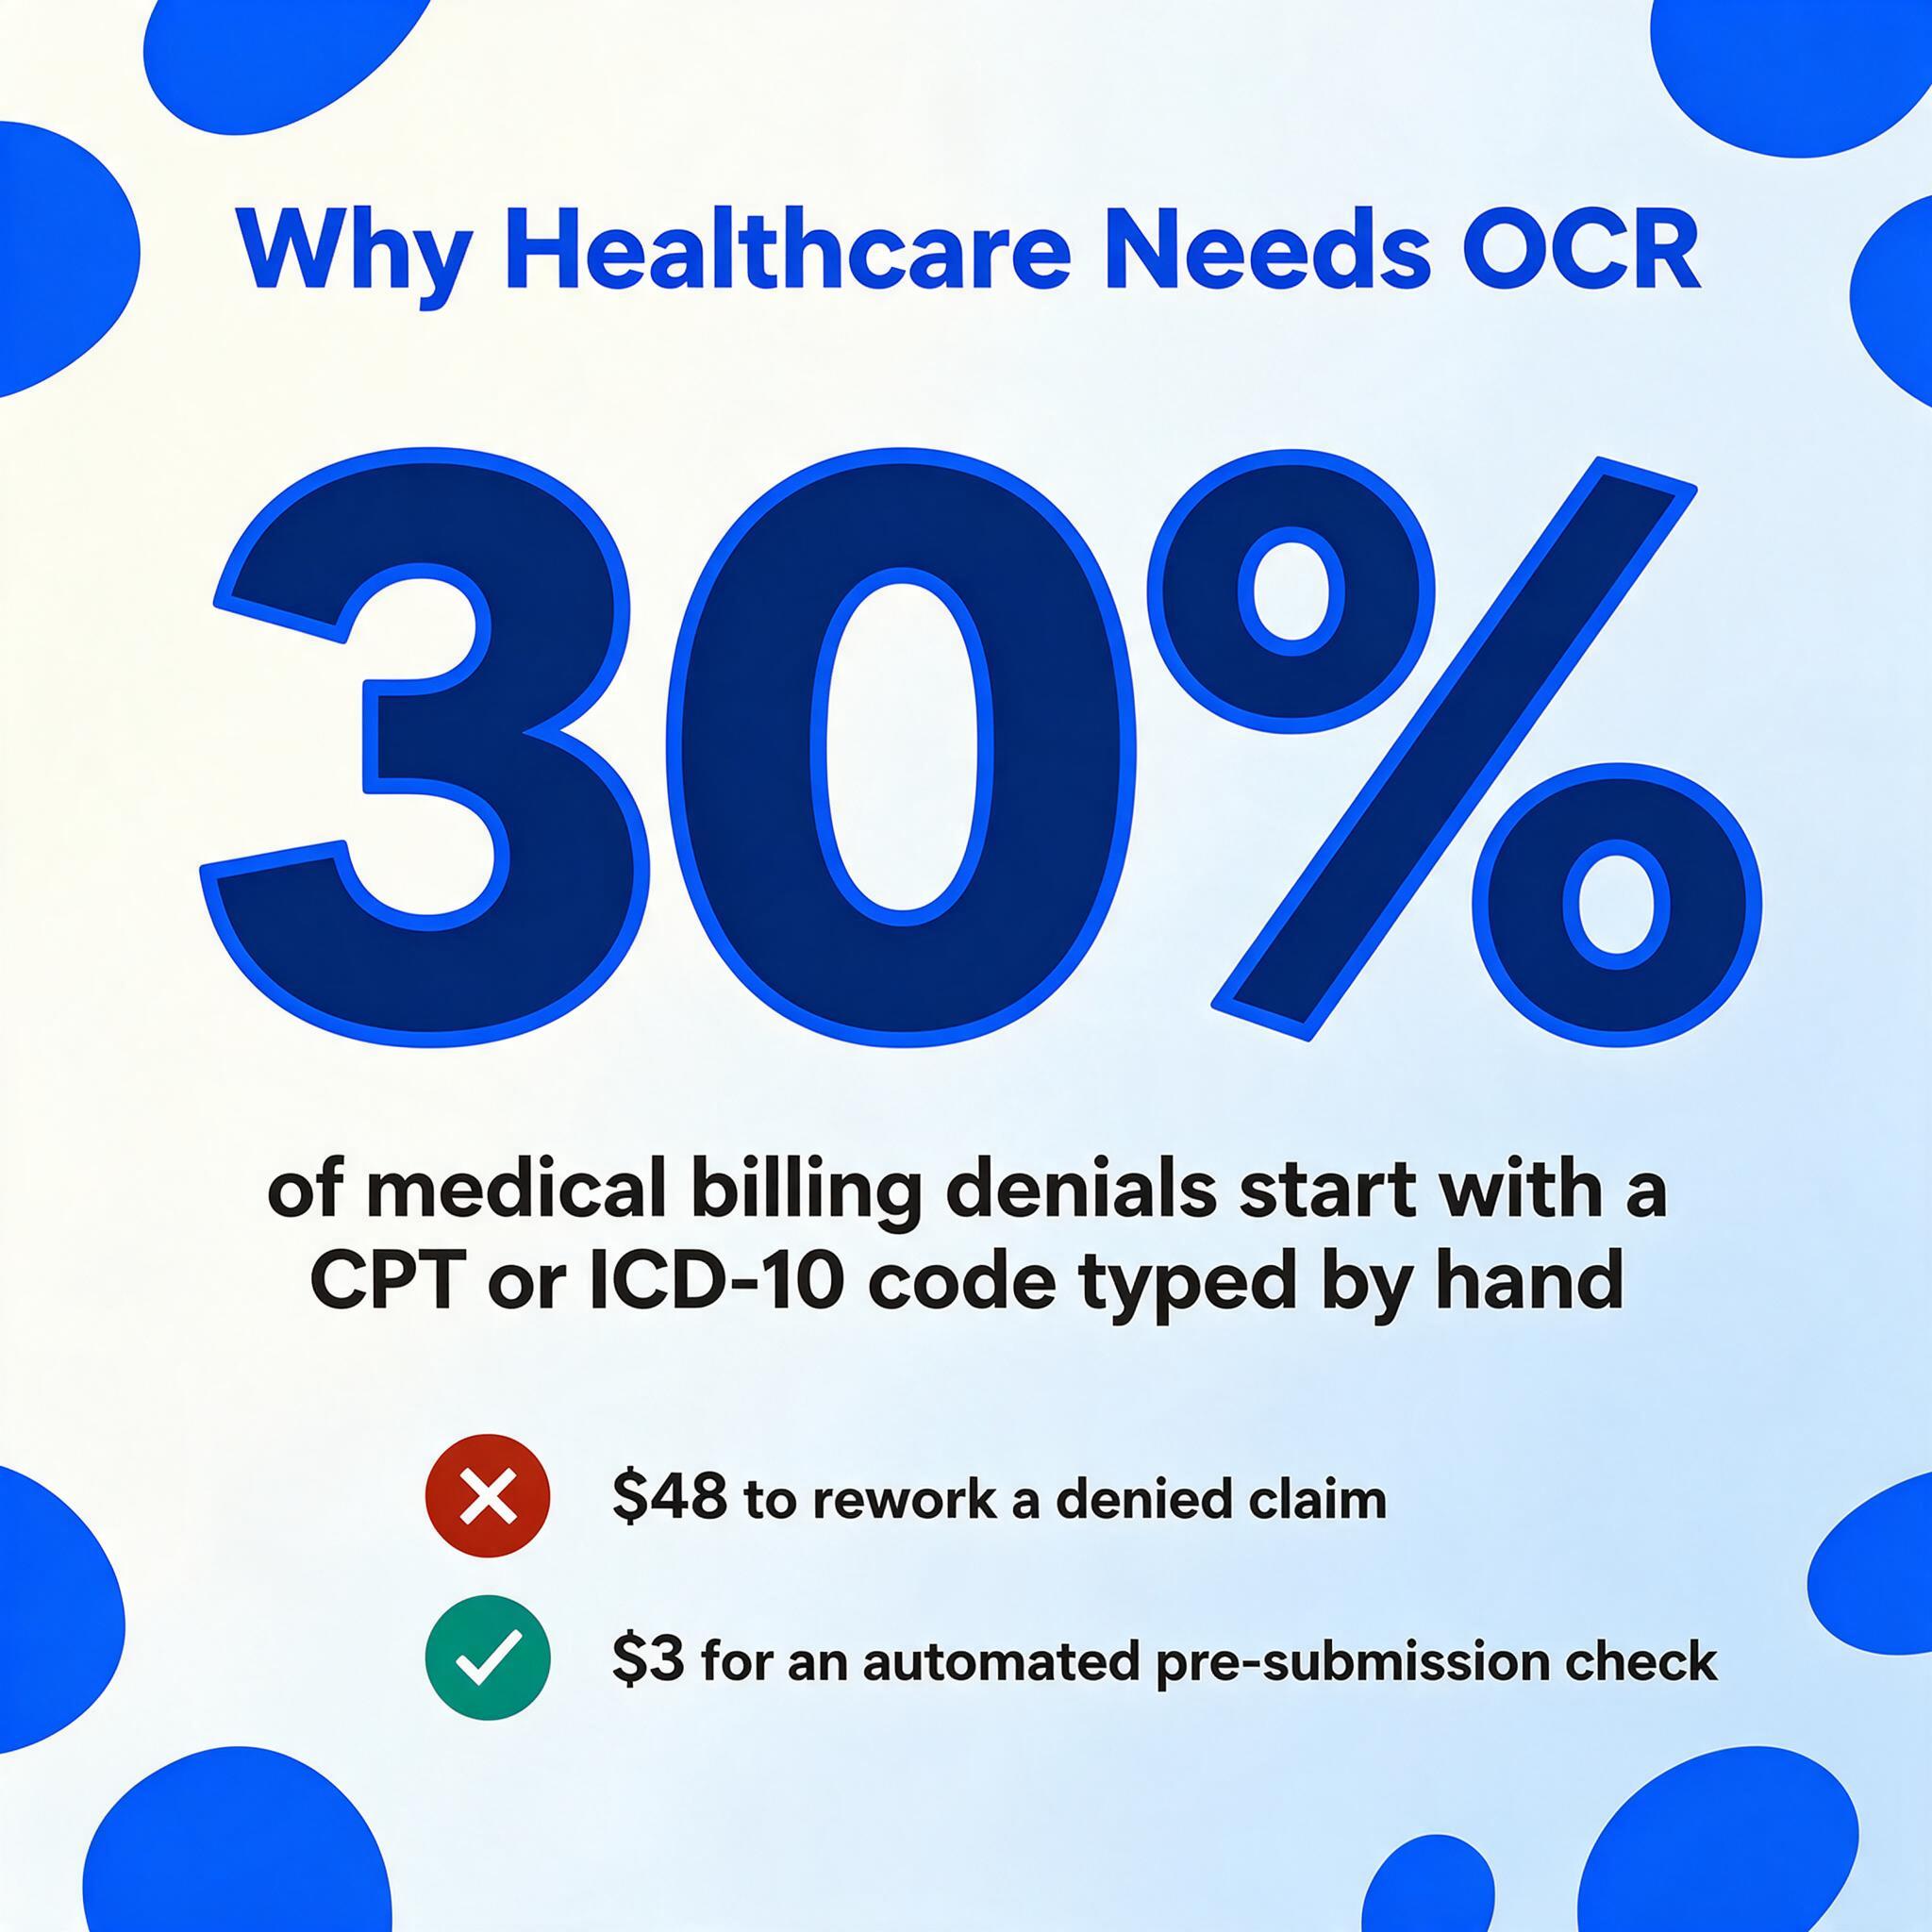
Les chiffres proviennent de plusieurs directions. OCR Solutions, qui exploite un déploiement Texas Medicaid traitant plus d'un million de réclamations par mois depuis 2021, rapporte qu'environ 30 % de tous les refus de facturation médicale proviennent de codes CPT ou ICD-10 incorrects saisis lors de la capture manuelle des données. Une analyse distincte de la même équipe estime le coût moyen de retraitement d'un refus à 48 $ par réclamation, contre 3 $ pour un contrôle automatisé avant soumission — un ratio de coût de 16:1. Les propres directives de l'AMA sur les erreurs de codage confirment que les erreurs les plus courantes — mauvais modificateur, lien diagnostic-procédure inadapté, code obsolète — sont structurelles, pas aléatoires. Elles se produisent parce que la personne qui saisit les données ne peut pas vérifier simultanément chaque dépendance inter-champs que le système de traitement des réclamations appliquera ensuite.
Ensuite, il y a le calcul de la main-d'œuvre. La saisie manuelle d'un seul formulaire CMS-1500 ou UB-04 prend 5 à 10 minutes. Une équipe de cycle de revenus hospitalier traitant 500 demandes par jour consacre 40 à 80 heures-personnes à la seule frappe — sans rapprochement, sans vérification, juste le transfert de caractères d'un format à un autre. L'extraction automatisée réduit cela à moins de 60 secondes par formulaire, ce qui n'élimine pas le rôle humain mais le fait passer de la transcription à la vérification, là où le jugement clinique et de facturation compte réellement.
Au-delà de la facturation, la saisie des résultats de laboratoire et la numérisation de l'admission des patients suivent des schémas similaires : la transcription manuelle des bons de demande papier et des formulaires d'inscription consomme un temps qui pourrait être consacré au travail en face des patients, et le taux d'erreur — généralement de 8 à 12 % dans la saisie de données à volume élevé — s'accumule en coûts de rapprochement et de reprise en aval que la plupart des cabinets ne totalisent jamais.
Principaux types de documents de santé et leurs défis d'extraction
Le secteur de la santé ne se limite pas à un seul type de document. Chaque grande catégorie présente un profil d'extraction différent qui détermine quelle approche OCR — basée sur un modèle, basée sur l'IA ou hybride — est appropriée.
Relevés EOB (Explication des prestations)
L'EOB est sans doute le document le plus variable en termes de format dans le secteur de la santé. Il existe plus de 1 500 mises en page EOB uniques selon les payeurs, couvrant les assureurs commerciaux (BCBS, UnitedHealthcare, Aetna, Cigna, Humana), les payeurs gouvernementaux (Medicare, Medicaid, Tricare) et les assureurs d'indemnisation des accidents du travail. Medicare appelle son identifiant de demande un « ICN » (Internal Control Number). BCBS place le numéro de demande dans le coin supérieur droit. Aetna le place dans un bloc d'en-tête à gauche. Les trois signifient la même chose — l'identifiant de demande — mais un modèle OCR basé sur la position nécessiterait trois configurations distinctes pour le capturer.
Les champs importants pour le rapprochement sont : le numéro de demande / ICN, le nom et l'identifiant du patient, la date de service, les codes de procédure CPT avec modificateurs, le montant facturé, le montant autorisé, le montant payé par le régime, la franchise, le ticket modérateur, la co-assurance, la responsabilité du patient et les codes de motif de refus. Le défi n'est pas de lire les caractères — l'OCR moderne le fait de manière fiable. Le défi est de mapper chaque valeur à la bonne colonne lorsque le même point de données apparaît à des positions différentes sur chaque relevé de payeur.
C'est là que l'OCR basée sur un modèle atteint sa limite et que l'extraction sémantique par IA — où le système comprend ce qu'est un « numéro de demande » et le trouve par concept, non par position — devient nécessaire. Pour une analyse approfondie, consultez notre guide complet sur l'extraction de données EOB, ou essayez l'outil d'extraction EOB vers Excel directement sur un relevé de payeur.
CMS-1500 (Formulaire de demande de remboursement professionnel)
Le formulaire CMS-1500, également connu sous le nom de HCFA-1500, est le formulaire papier standard utilisé par les médecins, cliniques et prestataires non institutionnels pour facturer Medicare et la plupart des assureurs commerciaux. Il comporte 33 cases numérotées (plus de nombreuses subdivisions) tassées sur une seule page. Cette densité est sa caractéristique — le formulaire capture tout ce qui est nécessaire au traitement de la demande dans un format papier standardisé — mais cette même densité en fait l'un des formulaires les plus difficiles à analyser correctement par une OCR généraliste.
Le problème structurel critique réside dans les dépendances entre champs. La case 24E (pointeur de diagnostic) doit référencer un code ICD-10-CM valide listé dans la case 21 (diagnostic ou nature de la maladie ou blessure). Un pointeur mal aligné est invisible lors de la saisie humaine — la personne qui tape ne peut pas vérifier simultanément que chaque code pointeur de la case 24E correspond à une entrée valide dans la case 21 sur plusieurs lignes de service. Le système de traitement du payeur le détecte 30 à 60 jours plus tard sous forme de refus. L'OCR basée sur des modèles gère bien ce formulaire — car la mise en page est standardisée selon les spécifications officielles du formulaire CMS, y compris l'exigence d'encre rouge Flint OCR pour la version scannable à fond perdu — atteignant jusqu'à 99 % de précision au niveau des champs dans des conditions de numérisation optimales.
Mais il y a un piège que la plupart des fournisseurs ne mentionnent pas d'emblée : la précision de l'OCR du CMS-1500 dépend fortement du réglage du scanner. La fonction « fond perdu rouge » utilisée par les transporteurs Medicare nécessite un calibrage spécifique du scanner. Une photocopie du formulaire (courante dans les petits cabinets) ne possède pas l'encre rouge OCR requise, donc la zone de fond perdu ne fonctionne pas, et le moteur d'extraction doit analyser la page entière au lieu d'isoler les champs remplissables. La différence entre une numérisation propre et une photocopie peut faire passer la précision de 99 % à moins de 80 % sur le même moteur OCR.
UB-04 (formulaire de réclamation institutionnel)
Là où le CMS-1500 compte 33 cases, le UB-04 (également appelé CMS-1450) en compte 81. Il est utilisé par les hôpitaux, les établissements de soins infirmiers spécialisés, les agences de soins à domicile et autres prestataires institutionnels pour facturer des épisodes de soins complets. La complexité vient de sa structure au niveau des lignes : les locators de formulaire 42 à 47 sont des postes récurrents où le code de revenu, la description du service, la date de service, les unités, les frais totaux et les frais non couverts doivent tous s'aligner par ligne. Une simple erreur de lecture du code de revenu (par exemple, 0450 pour les services des urgences contre 0452 pour le triage aux urgences) fausse l'ensemble de la tarification de cette ligne, et les payeurs rejettent la réclamation plutôt que de deviner quel champ est erroné.
Parce que le format UB-04 est institutionnel — et que la facturation institutionnelle implique des codes de condition, des codes d'occurrence, des codes de valeur et des codes de revenu qui n'ont pas d'équivalent sur le CMS-1500 — une couche de mappage et de validation distincte est requise. Les systèmes basés sur des modèles avec des mappages UB-04 préétablis sont la norme du secteur ici, et ils fonctionnent bien lorsque la qualité de numérisation est constante.
Rapports de laboratoire et résultats de pathologie
Les rapports de laboratoire diffèrent des formulaires de réclamation d'une manière cruciale : ils ne sont pas standardisés. Chaque laboratoire (Quest, LabCorp, laboratoires hospitaliers) utilise son propre modèle de rapport. Les données elles-mêmes sont structurées — nom du test, valeur du résultat, plage de référence et indicateur (normal/anormal) — mais la mise en page varie. Certains rapports de laboratoire présentent les résultats en listes verticales, d'autres en tableaux, et d'autres encore dans un format mixte de récit avec tableau. Le défi de l'extraction consiste à distinguer le nom du test (par exemple, « Hemoglobin A1c »), la valeur du résultat (« 7,2 % »), la plage de référence (« <5,7 % normal, 5,7-6,4 % prédiabète, ≥6,5 % diabète ») et l'indicateur (« Élevé »). Lire ces éléments comme un bloc de texte OCR ne produit pas de données exploitables — les valeurs doivent être placées dans des colonnes séparées avec la bonne association de lignes.
Formulaires d'admission et d'inscription des patients
Les formulaires d'admission combinent trois éléments peu adaptés à l'OCR : les cases à cocher (cochées, croisées ou entourées), l'écriture manuscrite (nom du patient, adresse, motif de la visite, antécédents médicaux) et les champs à format mixte (certains pré-imprimés, d'autres en texte libre). Les cases à cocher sont particulièrement délicates — l'OCR traditionnel lit le texte, pas la présence ou l'absence d'une marque dans une case. Les modèles de vision par IA gèrent mieux ce cas, car ils voient le document comme une image et peuvent détecter si une case est remplie, quelle que soit la méthode de marquage. Pour la composante manuscrite, l'extraction par IA s'est considérablement améliorée ces dernières années, mais la précision varie fortement selon la lisibilité de l'écriture. Consultez notre guide sur les logiciels d'OCR pour l'écriture manuscrite pour savoir ce que la technologie actuelle peut et ne peut pas gérer.
Pour les documents d'inscription en particulier, l'objectif pratique est une ligne par patient : une conversion de formulaire d'admission patient vers Excel mappe les cases cochées, les réponses manuscrites et les champs d'assurance dans ces colonnes en une seule passe.
Ordonnances
Les ordonnances représentent le cas extrême du problème de l'écriture manuscrite. Les médecins qui écrivent après une journée complète de consultation produisent certaines des écritures cursives les plus difficiles de tout secteur. Les enjeux sont élevés — une erreur de lecture du nom d'un médicament ou d'un dosage peut nuire au patient. L'OCR traditionnel échoue essentiellement sur l'écriture cursive ; les modèles de vision par IA atteignent une précision de 85 à 95 % sur les ordonnances manuscrites de qualité raisonnable, mais cette précision chute considérablement sur les scans de mauvaise qualité ou l'écriture rapide. La plupart des flux de travail OCR en santé traitent les ordonnances comme une catégorie nécessitant une vérification humaine plutôt qu'une cible d'automatisation directe.
Les champs qui comptent : codes médicaux, identifiants et PHI
Les documents médicaux contiennent des éléments de données sans équivalent dans d'autres secteurs. Une facture a une date et un total. Une réclamation médicale a ceux-ci plus des codes qui déterminent si la réclamation est payée, refusée ou auditée. Comprendre ce que sont ces codes et pourquoi ils importent pour l'extraction fait la différence entre acheter un outil d'OCR générique et acheter un outil qui fonctionne pour la santé.
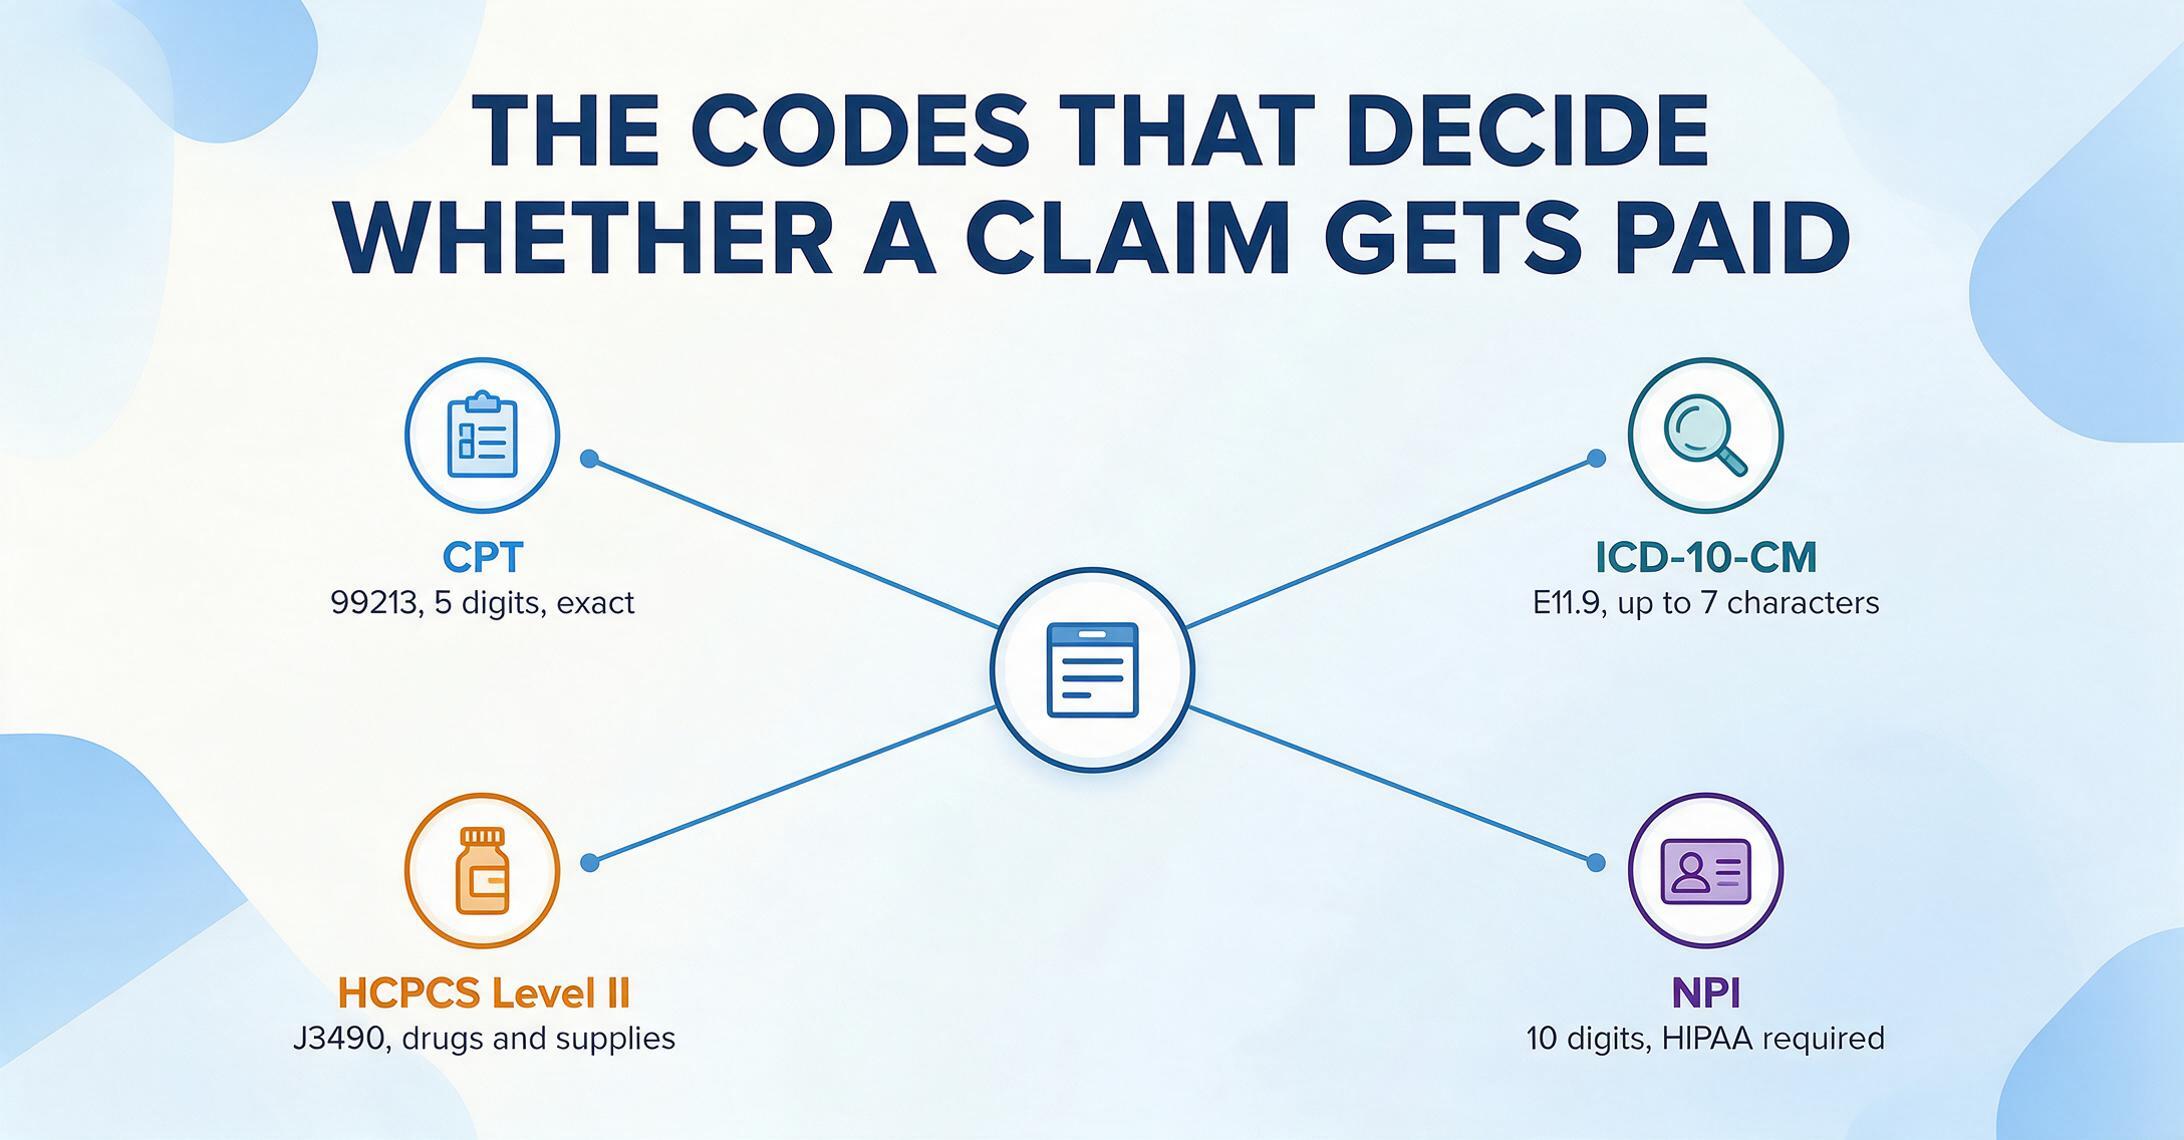
Codes CPT
Current Procedural Terminology, maintenu par l'American Medical Association. Codes numériques à cinq chiffres décrivant les procédures et services médicaux. Exemple : 99213 (consultation de patient établi au cabinet, niveau 3). L'IA doit distinguer le code de procédure du code de diagnostic — ils apparaissent souvent sur la même ligne.
Codes ICD-10-CM
International Classification of Diseases, 10e révision, modification clinique. Codes alphanumériques jusqu'à 7 caractères décrivant les diagnostics. Exemple : E11.9 (diabète de type 2 sans complications). Environ 72 000 codes actifs nécessitent une extraction précise, caractère par caractère.
HCPCS Niveau II
Healthcare Common Procedure Coding System, maintenu par CMS. Codes alphanumériques pour les produits, fournitures et services non couverts par CPT. Exemple : J3490 (médicament non classé). Courant sur les demandes institutionnelles UB-04.
Numéros NPI
National Provider Identifier. Identifiant numérique à 10 chiffres exigé par HIPAA pour tous les prestataires de soins de santé. Doit respecter le format standard à 10 chiffres ; la validation de l'extraction doit vérifier ce modèle.
Il y a ensuite la PHI — Protected Health Information. En vertu de la règle de confidentialité de HIPAA, 18 catégories d'identifiants rendent les informations de santé individuellement identifiables. Cela inclut les éléments évidents — noms, adresses, numéros de sécurité sociale — mais aussi les dates (date de naissance, dates d'admission/sortie, dates de décès), numéros de téléphone, numéros de fax, adresses e-mail, numéros de dossier médical, numéros de bénéficiaire de régime de santé, numéros de compte, numéros de certificat/licence, identifiants de véhicule, identifiants et numéros de série d'appareils, URL, adresses IP, identifiants biométriques, photographies du visage en entier, et tout autre numéro, caractéristique ou code d'identification unique.
L'implication pratique pour le choix d'un outil OCR : tout outil qui traite des documents médicaux contenant l'un de ces 18 identifiants — et un EOB sans nom de patient ni numéro de réclamation est inutile pour la facturation — crée une divulgation HIPAA. Cette divulgation exige un accord d'associé commercial (BAA) signé en vertu de 45 CFR §164.504(e). Un outil qui ne peut pas ou ne veut pas signer de BAA n'est pas un candidat viable pour le traitement de documents de santé, quels que soient ses chiffres de précision.
OCR traditionnel vs extraction basée sur l'IA pour les documents de santé
La question n'est pas « lequel est meilleur » mais « lequel pour quel document ». Le secteur de la santé est particulier : l'OCR traditionnel basé sur des modèles et l'extraction moderne basée sur l'IA ont tous deux des rôles légitimes, et l'approche optimale varie selon le type de document.
| Type de document | Meilleure approche | Pourquoi | Précision atteignable |
|---|---|---|---|
| CMS-1500 (scan propre) | OCR basé sur modèle | Mise en page fixe, coordonnées de champs connues, prise en charge de la suppression du rouge | 98–99 % au niveau du champ |
| CMS-1500 (photocopie/télécopie) | Extraction par IA | Pas de zone de suppression du rouge ; l'IA peut déduire sémantiquement l'emplacement des champs | 85–92 % au niveau du champ |
| UB-04 (propre) | OCR basé sur modèle | 81 emplacements de formulaire fixes, structure connue | 98–99 % au niveau du champ |
| EOB (tout payeur) | Extraction par IA | Plus de 1 500 mises en page uniques ; aucune position de champ fixe | 85–95 % au niveau du champ |
| Rapports de laboratoire | Extraction par IA | Mises en page non standard selon le laboratoire ; correspondance sémantique requise | 80–92 % au niveau du champ |
| Formulaires d'admission des patients | Extraction par IA | Cases à cocher + écriture manuscrite + champs mixtes | 75–90 % (dépend de l'écriture manuscrite) |
| Ordonnances | Extraction par IA | Écriture cursive ; nécessite un modèle de vision | 70–88 % (vérification requise) |
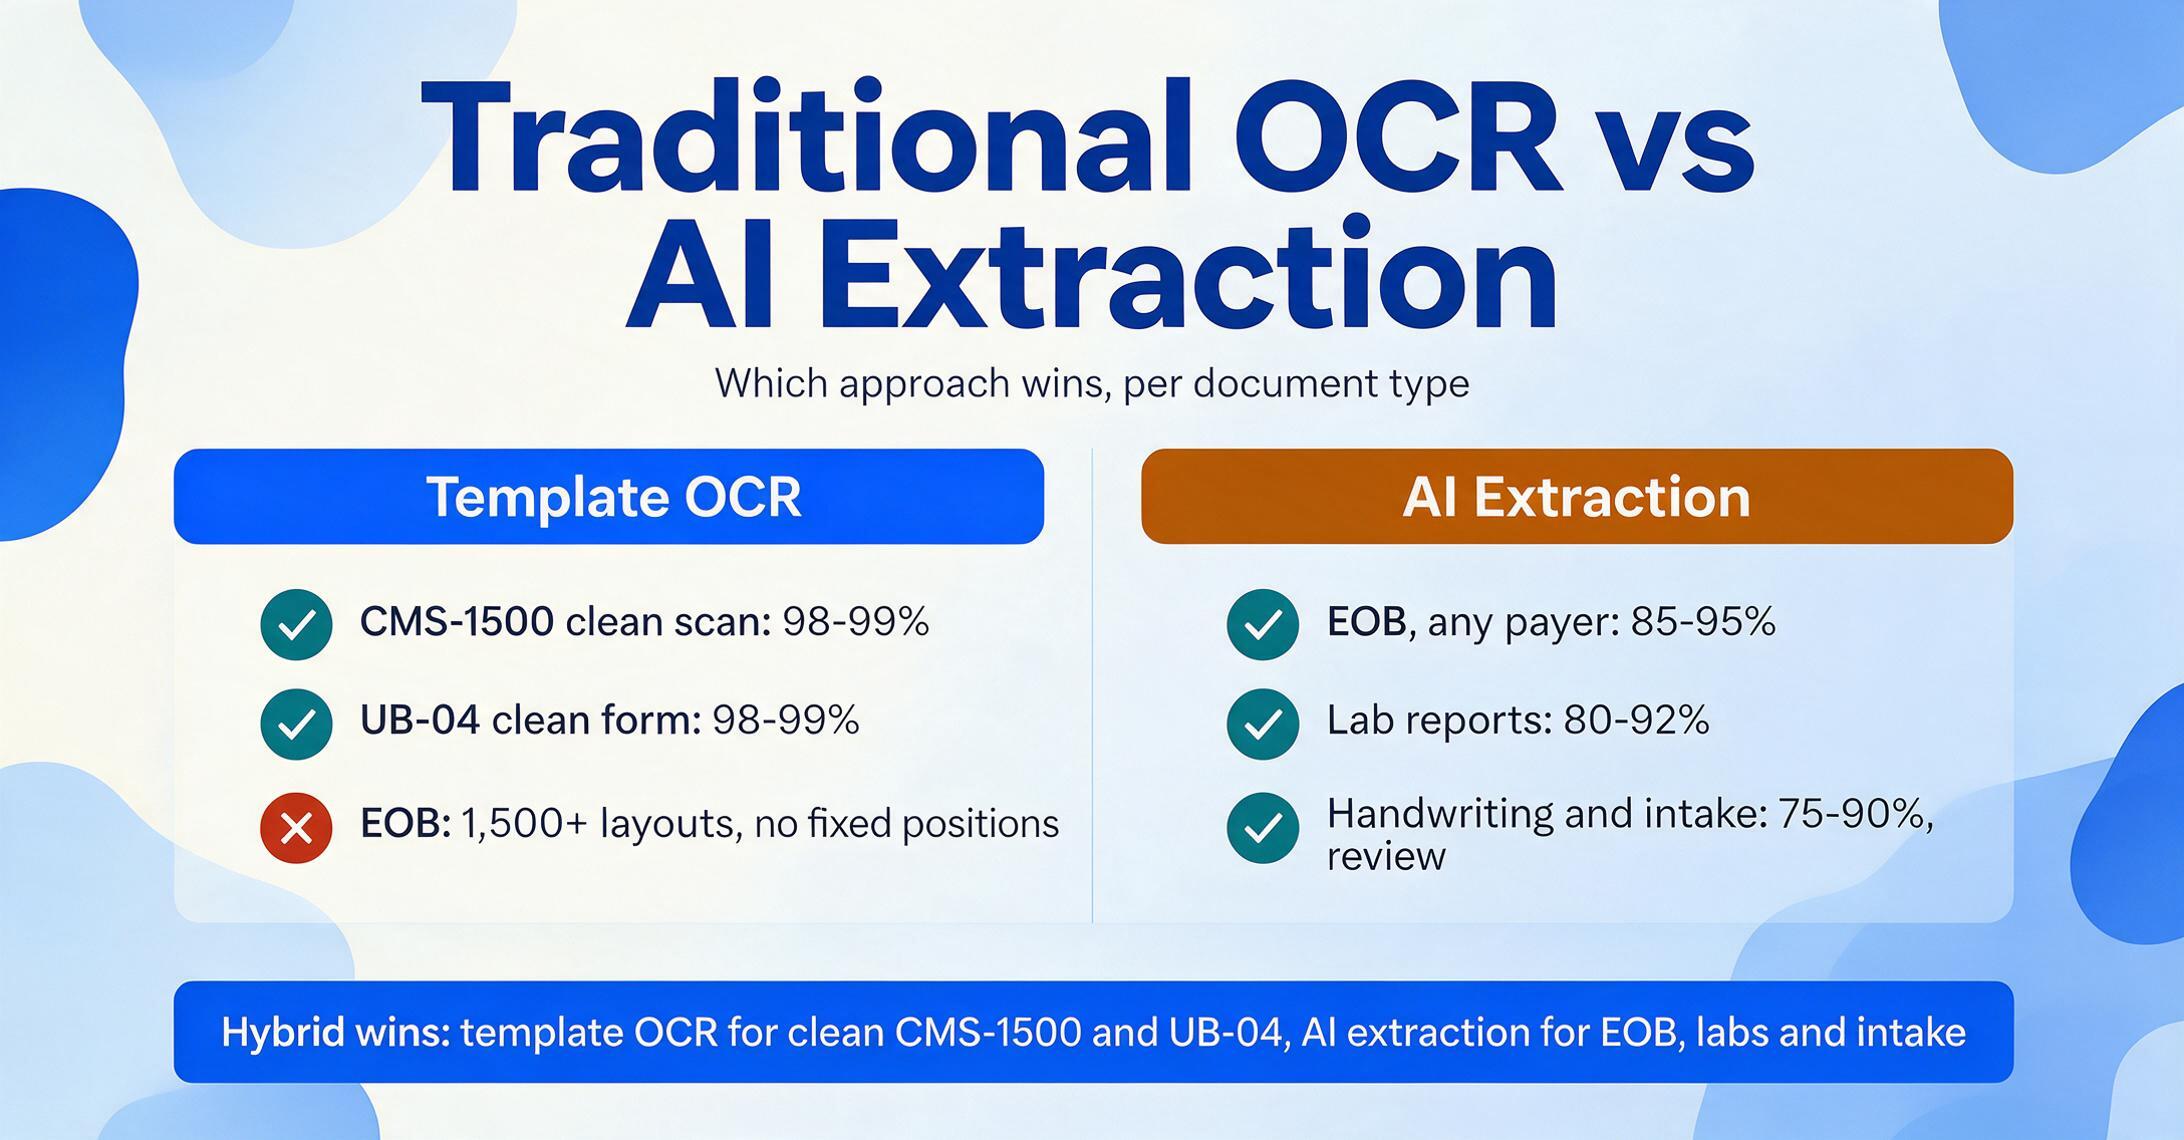
C'est pourquoi de nombreux organismes de santé finissent par adopter un flux de travail hybride : l'OCR basé sur modèle pour les formulaires de réclamation structurés où la précision est primordiale et la validation au niveau du champ est essentielle, et l'extraction par IA pour les documents non standard — EOB, rapports de laboratoire, formulaires d'admission — où la flexibilité est plus importante. Ces deux approches ne sont pas concurrentes dans le secteur de la santé ; ce sont des outils complémentaires pour différentes parties du spectre documentaire.
La réponse honnête : pour les formulaires CMS-1500 et UB-04 avec une bonne qualité de numérisation, l'OCR basé sur modèle reste le leader en matière de précision. Pour tous les autres types de documents de santé — EOB, rapports de laboratoire, formulaires d'admission, ordonnances — l'extraction basée sur l'IA est la seule approche viable, car les mises en page sont trop variables pour que les modèles puissent suivre.
Considérations de conformité : la HIPAA comme critère de sélection
C'est la section où de nombreux articles sur les outils OCR se transforment en contenu marketing. Voici plutôt le cadre pratique.
La conformité HIPAA n'est pas une fonctionnalité que l'on active. C'est un cadre juridique qui régit la manière dont un outil peut être utilisé avec des données patients. Les composants pertinents sont :
- Business Associate Agreement (BAA) en vertu de 45 CFR §164.504(e) — Un contrat signé entre votre organisation et le fournisseur de l'outil qui établit le fournisseur en tant que business associate. Sans BAA, la transmission de PHI à un outil tiers est une divulgation qui viole la Privacy Rule.
- Minimum Necessary Rule en vertu de 45 CFR §164.502(b) — Vous devez limiter les PHI divulguées au minimum nécessaire pour accomplir l'objectif visé. Un outil qui extrait tout ce qui est visible sur un document et vous oblige à trier les résultats ensuite est architecturalement incompatible avec cette exigence.
- Security Rule en vertu de 45 CFR §164.306 — Des garanties administratives, physiques et techniques pour les PHI électroniques. Pour les outils OCR basés sur le cloud, cela signifie un chiffrement au repos (AES-256) et en transit (TLS 1.2+), des contrôles d'accès et une journalisation des audits.
Lors de l'évaluation d'un outil OCR pour le secteur de la santé, posez ces trois questions dans l'ordre :
- Signerez-vous notre BAA ? Si la réponse est non, l'outil ne peut pas être utilisé avec un document contenant des PHI — ce qui exclut essentiellement tous les documents médicaux.
- Où les données sont-elles traitées et stockées ? Le BAA doit préciser la résidence des données. Si votre cadre de conformité exige que les PHI restent aux États-Unis (comme c'est le cas pour de nombreux organismes de santé), l'outil doit traiter les données sur des serveurs situés aux États-Unis.
- Qu'advient-il du document après le traitement ? Les exigences de conservation et de suppression des données de la HIPAA s'appliquent. Un outil qui stocke vos documents médicaux indéfiniment crée un passif de conformité pour vous et pour le fournisseur. La suppression automatique dans un délai défini (24 heures, 7 jours, etc.) est la norme pour les flux d'extraction basés sur le cloud.
Nous abordons la HIPAA et l'extraction de documents médicaux en profondeur ici, y compris une checklist détaillée pour vérifier la posture de conformité de votre fournisseur d'outils.
Il est également utile de noter : même le meilleur BAA ne vous protège pas si vous utilisez un outil qui extrait plus de données que nécessaire. La Minimum Necessary Rule place la charge sur l'entité couverte — vous — pour garantir que l'outil n'accède qu'aux éléments de données spécifiques nécessaires. C'est un domaine où l'extraction de colonnes personnalisées (où vous définissez exactement les champs à extraire et l'IA n'extrait que ceux-ci) offre un avantage structurel par rapport à l'OCR pleine page qui renvoie tout et nécessite un post-filtrage.
Comment choisir une solution OCR pour la santé
Pour une comparaison complète des outils en termes de prix, de précision et de conformité, consultez notre classement des meilleurs logiciels OCR pour la santé 2026. Si votre priorité est spécifiquement la précision de l'extraction des EOB et des formulaires de réclamation CMS-1500, notre classement des outils d'extraction de documents de santé teste sept outils sur de véritables documents multi-payeurs. Le résumé ci-dessous couvre les cinq critères les plus importants lors de l'évaluation initiale.
1. Couverture documentaire
L'outil gère-t-il les types de documents spécifiques que vous traitez ? Un outil d'extraction EOB est inutile pour les rapports de laboratoire. Un spécialiste CMS-1500 ne peut pas gérer vos formulaires d'admission des patients. Si votre organisation traite plusieurs types de documents (c'est le cas de la plupart), recherchez un outil qui couvre l'ensemble du spectre ou prévoyez de maintenir des solutions distinctes pour chaque catégorie.
2. Précision au niveau des codes
Pour les formulaires de réclamation et les EOB, la précision au niveau des caractères est insuffisante. Vous avez besoin d'une précision au niveau des champs pour les codes CPT (cinq chiffres numériques, exacts), les codes ICD-10-CM (alphanumériques jusqu'à 7 caractères, exacts) et les numéros NPI (10 chiffres, exacts). Un seul caractère erroné dans un champ de code peut déclencher un refus. Testez l'outil sur vos documents réels, et non sur des échantillons fournis par le fournisseur.
3. Préparation à la conformité
La disponibilité d'un BAA est non négociable pour toute charge de travail contenant des PHI. Au-delà du BAA, vérifiez la résidence des données (les serveurs sont-ils basés aux États-Unis ?), les normes de chiffrement (AES-256 au repos, TLS 1.2+ en transit), la conservation des données (combien de temps vos documents sont-ils stockés ?) et si l'outil a terminé un audit SOC 2 Type 2 ou une évaluation de sécurité tierce équivalente.
4. Intégration avec vos systèmes existants
Les organismes de santé s'appuient sur des DSE (Epic, Oracle Health Cerner, Meditech, Allscripts), des systèmes de gestion de cabinet (athenahealth, AdvancedMD, Kareo, NextGen) et des clearinghouses (Office Ally, Change Healthcare, ZirMed). L'outil OCR idéal produit des données dans des formats que votre système de facturation peut ingérer — Excel structuré, CSV ou JSON — sans ressaisie manuelle. Moins votre flux de travail change, plus l'adoption est rapide.
5. Capacité de reconnaissance de l'écriture manuscrite
Si votre flux de travail comprend des ordonnances, des notes cliniques ou des formulaires d'admission des patients avec des champs en texte libre, la précision de l'écriture manuscrite est un critère de sélection important. Testez avec vos véritables échantillons d'écriture manuscrite — pas avec l'ensemble de test organisé par le fournisseur. Comprenez où la vérification humaine est encore requise et si le flux de travail prend en charge cette étape de révision.
Les fichiers sont traités en toute sécurité et ne sont pas stockés. Essayez d'extraire des données d'un document EOB — aucune inscription requise.
FAQ
L'OCR peut-il lire avec précision les formulaires CMS-1500 et UB-04 ?
Oui, sur des scans propres utilisant l'OCR basé sur des modèles, la précision au niveau des champs atteint 98–99 % pour ces formulaires standardisés. La précision diminue sur les photocopies, les télécopies et les scans de faible qualité — c'est pourquoi le calibrage du scanner et l'utilisation de formulaires OCR rouges appropriés (selon les spécifications CMS) sont importants.
L'OCR gère-t-il les dossiers médicaux et les ordonnances manuscrits ?
L'OCR basé sur l'IA peut lire l'écriture manuscrite avec une précision de 75 à 90 % selon la lisibilité, mais l'écriture cursive et rapide — courante sur les ordonnances et les notes cliniques — reste une catégorie nécessitant une vérification humaine. La plupart des flux de travail en santé traitent l'extraction de l'écriture manuscrite comme une étape de « révision avant utilisation » plutôt que comme une automatisation directe. Consultez nos meilleurs outils OCR pour l'écriture manuscrite pour des benchmarks de précision détaillés.
Comment HIPAA s'applique-t-il aux outils OCR basés sur le cloud ?
Si vous envoyez un document contenant des PHI à un outil OCR tiers, vous effectuez une divulgation en vertu de la règle de confidentialité HIPAA. Cette divulgation nécessite un contrat d'association en affaires (BAA) signé avec le fournisseur de l'outil. Sans BAA, la transmission constitue une violation de conformité, indépendamment des fonctionnalités de chiffrement ou de sécurité de l'outil. Vérifiez également la résidence des données, les normes de chiffrement et la politique de suppression des données du fournisseur.
Quels codes médicaux l'OCR peut-il extraire des formulaires de réclamation ?
Les outils d'extraction modernes basés sur l'IA peuvent identifier et extraire les codes de procédure CPT (5 chiffres), les codes de diagnostic ICD-10-CM (alphanumériques, jusqu'à 7 caractères), les codes HCPCS niveau II et les numéros NPI (10 chiffres). L'exigence clé est que l'outil distingue les types de codes — un outil qui regroupe tout dans une seule colonne « Code » oblige à un tri manuel qui annule l'avantage de l'automatisation.
L'OCR par modèle ou l'extraction par IA est-il meilleur pour les documents médicaux ?
Cela dépend du document. L'OCR par modèle est supérieur pour les formulaires CMS-1500 et UB-04 avec des scans propres — les mises en page sont fixes, connues et standardisées. L'extraction par IA est supérieure pour tout le reste : les EOB de plusieurs payeurs (plus de 1 500 mises en page), les rapports de laboratoire, les formulaires d'admission des patients, les notes cliniques et les ordonnances. Une approche hybride — modèle pour les réclamations structurées, IA pour les documents à format variable — est la configuration la plus pratique pour les organismes de santé.
Combien coûte l'OCR pour le secteur de la santé ?
Les coûts varient considérablement selon l'outil et le volume. Les outils OCR cloud d'entrée de gamme pour la santé vont de 29 à 99 $/mois pour un traitement à faible volume (100–500 pages). Les plans de volume moyen (1 000–10 000 pages/mois) coûtent entre 100 et 500 $/mois. Les déploiements d'entreprise avec support d'intégration, modèles personnalisés et BAA dédiés commencent généralement à 1 000 $+/mois ou nécessitent des contrats annuels. Le calcul du retour sur investissement doit inclure non seulement le coût de la saisie économisé, mais aussi la réduction des reprises liées aux refus (48 $/réclamation en moyenne), moins de risques de conformité et des délais de recouvrement des comptes clients plus rapides.
Un EOB traité manuellement prend 5 minutes et présente un taux d'erreur de 8 à 12 %. Le même document traité avec l'extraction par IA prend 10 secondes et place les données structurées dans une feuille de calcul — prêtes pour le rapprochement, sans ressaisie. Découvrez à quoi ressemblent vos propres documents médicaux dans un pipeline d'extraction.