会計向けOCR:完全ガイド
請求書・領収書・銀行明細処理
会計向けOCRとは、自動テキスト認識とAIによる抽出を使用して、請求書、領収書、銀行明細、発注書、税務フォームなどの財務書類を、会計システムに直接取り込める構造化データに変換することを意味します。適切に導入すれば、手作業によるデータ入力を排除し、照合時間を短縮し、監査対応のデジタル記録を作成できます。しかし「会計向けOCR」は単一のテクノロジーではありません。3つの異なる抽出手法、それぞれ異なる処理要件を持つ5つの文書タイプ、そしてデジタル記録が監査の精査に耐えられるかを左右する規制の枠組み — 米国のIRS Rev. Proc. 97-22、英国のMaking Tax Digital、ドイツのGoBD — を包含します。本ガイドでは、会計チームが実際に遭遇する順序でそれらすべてを解説します。まずOCRが実際に何を意味するのかから始め、各文書タイプ、適用されるコンプライアンス規則、そして最後に会計スタックに適したツールの選び方を取り上げます。
主なポイント
- テンプレートベースのOCRはデータ入力を終わらせるのではなく、テンプレート保守という名目に置き換えるだけであり、取引先が50社になるとその保守は片手間の専任業務になります。
- 手作業によるデータ入力では100フィールドあたり2〜5件のエラーが発生し、その発見と修正に1件あたり$10かかります。つまり月500件の請求書には$2,500〜$12,500の目に見えない修正作業が潜んでいます。
- AIによる抽出は、フィールドがページ上のどこにあるかではなく、その意味に基づいて請求書を読み取ります。同じ設定がすべての取引先フォーマットで機能し、監査対応のソース文書リンクとともに構造化データをQuickBooksやXeroに取り込みます。
会計におけるOCRの実際の意味
会計の文脈では、OCRはスキャンしたテキストを検索可能なPDFに変換することではありません。文書の内容を構造化されたインポート可能なデータ、つまり勘定科目表、取引先レコード、取引履歴に対応する行と列に変換することです。
重要なのは「このツールはテキストを読み取れるか」ではなく、「このツールは請求書番号を抽出し、発注書と照合し、会計システム用に日付を整形し、その結果を他の99件の請求書と一緒に1つのExcelファイルに出力できるか」です。
この区別が重要なのは、1990年代から存在する従来のOCR技術は文書から文字を読み取ることはできても、その意味を理解できないからです。ページ上の「1,247.83」という文字列は正しく認識できますが、それが請求書の合計額なのか、税額なのか、明細行の小計なのかは、ページ上のどこを見るべきかを正確に指示しない限り分かりません。数十社から数百社の取引先から請求書を受け取る会計チームにとって、それぞれ異なるレイアウトを持つこの「どこを見るか指示する」ステップこそがボトルネックであり、OCRが何十年も利用可能でありながら手作業のデータ入力が生き残ってきた理由です。文字認識から文書理解への根本的な転換については、AI OCRとは何か、従来のOCRとの違いをご覧ください。
ここ3年でこれを変えたのは、AIによる意味抽出です。これは根本的に異なる技術アプローチです。固定座標で文字をスキャンする代わりに、視覚言語モデルは人間と同じように文書を読みます。レイアウトを見て、ラベルと値の関係を認識し、どこにあるかではなく意味に基づいてフィールドを抽出します。つまり、取引先が1ページの請求書を送っても4ページのPDFを送っても、合計額が右上隅に表示されても左下隅に表示されても、きれいなPDFでもサーマルレシートのスマホ写真でも、同じ抽出設定が機能します。
会計業務にOCRが必要な理由 — 定量化された根拠
会計業務におけるOCRの必要性は、技術の話ではありません。労働力の配分の話です。AP担当者が請求書番号や明細行の説明をスプレッドシートに入力するために費やす1時間は、差異分析、ベンダー関係の管理、キャッシュフロー予測に使えない1時間です。このトレードオフを定量化する数値は、複数の業界ベンチマークで広く確立されています。
請求書1件を手作業で入力すると、ヘッダー項目(ベンダー名、請求書番号、日付、PO番号、合計金額)だけで3〜5分かかります。明細行の抽出を加えると、請求書1件あたりの時間は倍になります。月500件の請求書なら、およそ40時間が純粋なデータ入力に消える計算です。毎月まる1週間分の作業時間を転記に費やすことになります。AP担当者の平均的な総コストが時給約$25とすると、週あたり$1,000、年間$52,000が、分析上の価値を一切生まない作業に支払われていることになります。エラー率はさらに問題を深刻にします。手作業の転記では、入力した100項目あたり2〜5件のエラーが日常的に発生し、APQCの財務ベンチマークによれば、各エラーの検出と修正には平均$10かかります。$12,000の請求書で1桁を打ち間違える — $12,000を$21,000と入力してしまう — と、その数字を入力するのにかかった時間よりも長くかかる照合問題が生じます。
多くの会計チームが見落としている構造的な洞察:手作業によるデータ入力のコストは、入力時間ではありません。その後のクリーンアップ時間です。入力時に生じたエラーはすべて発見しなければならず、発見には正しく入力するよりも多くのコストがかかります。OCRは入力作業だけでなく、エラーの発生源そのものを排除します。
出力側では、自動抽出は1ページを5〜10秒で処理します — 手作業の約18倍の速さです — そして印刷テキストに対するフィールド単位の精度は常に97%を超えます。トレードオフは速度対精度ではありません。速度と精度対、同じチームが毎月3日間データ入力に追われることなのです。文書タイプ別の精度の目安と、ご自身の文書で実行できる方法論の詳細については、OCRのフィールド単位精度ガイドをご覧ください。
会計でOCRが処理する5つのドキュメントタイプ
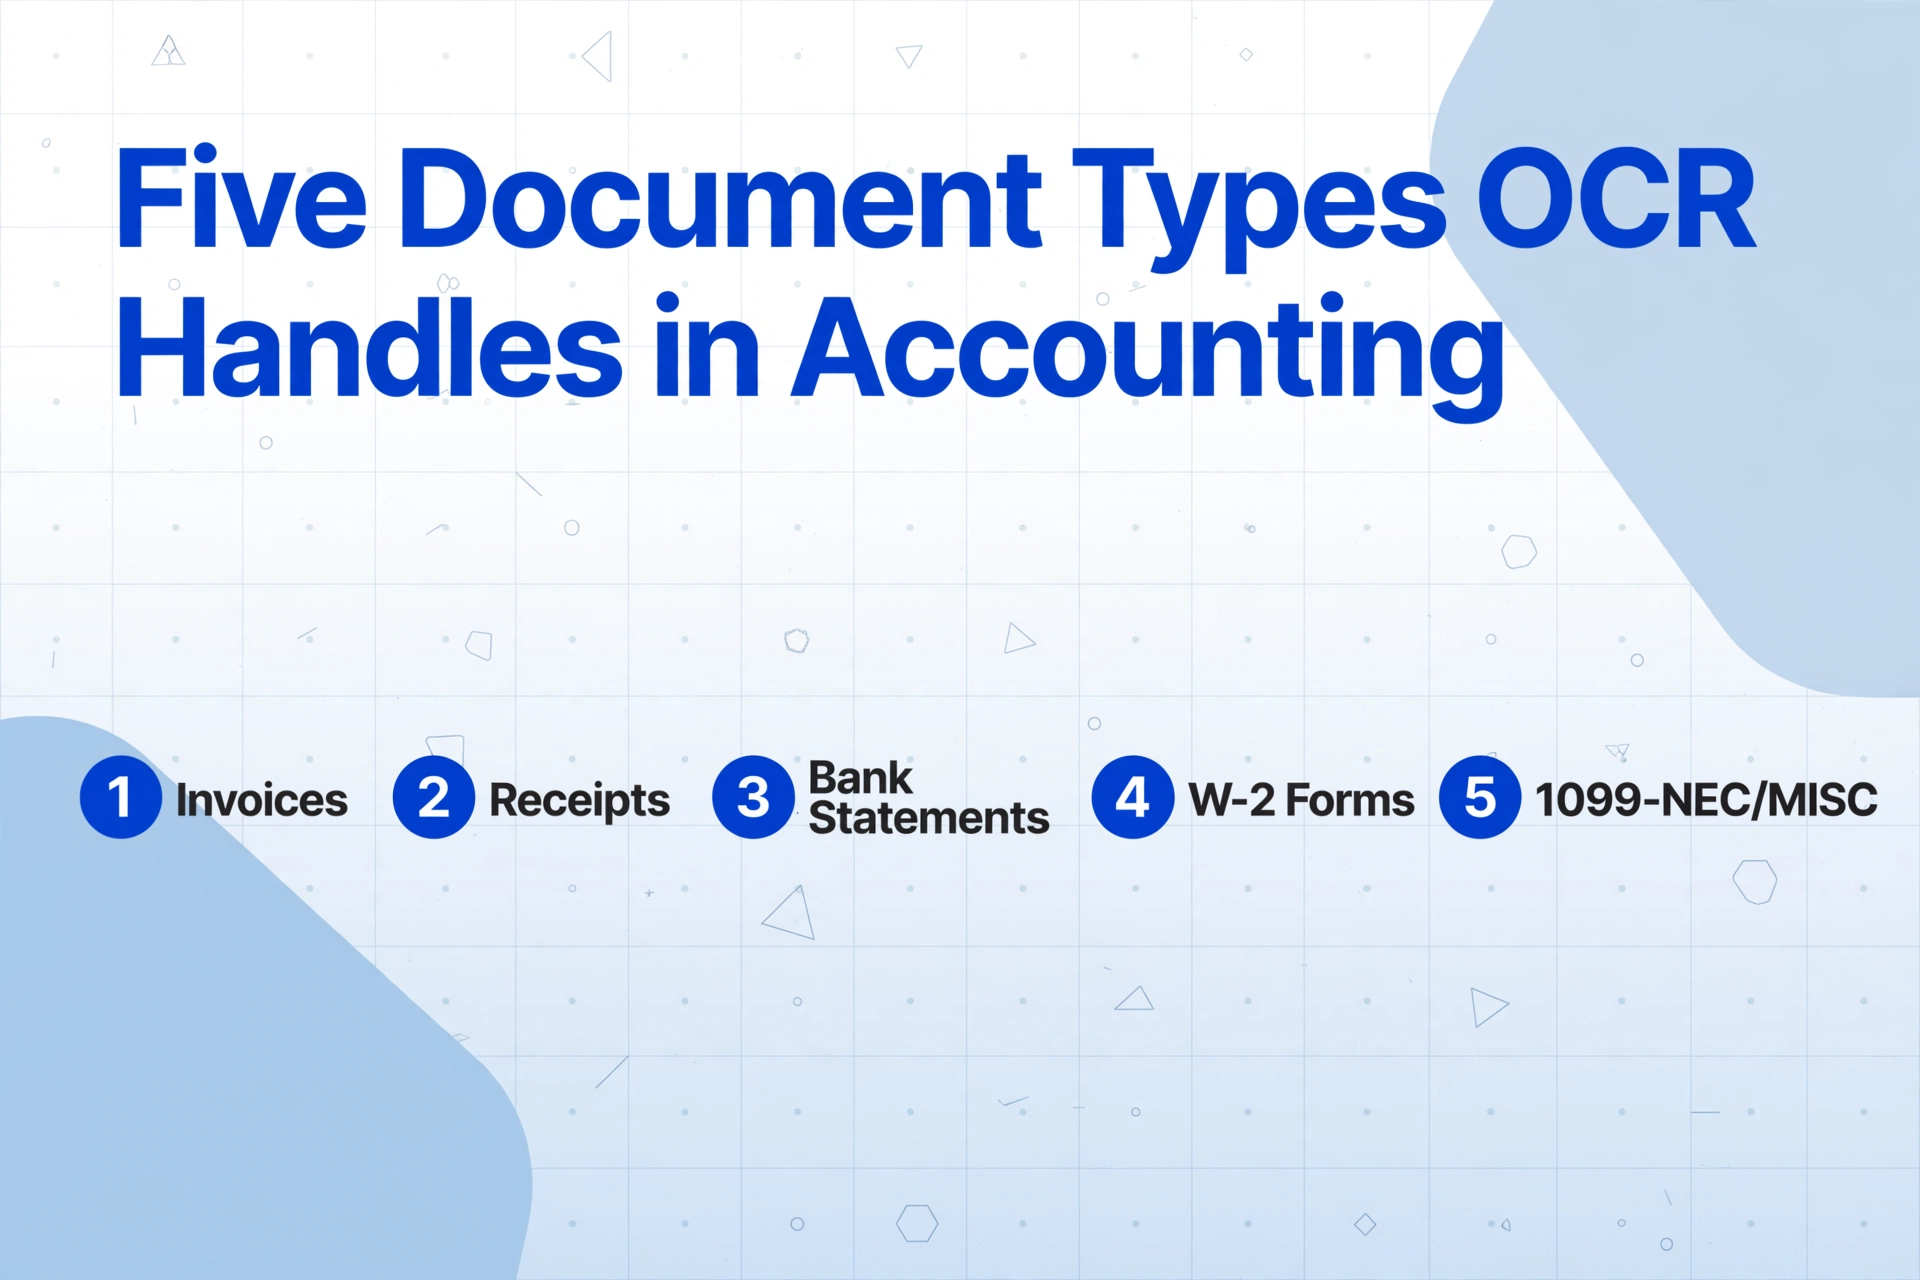
会計チームが処理するのは請求書だけではありません。完全なOCR環境は、共有受信トレイ、郵送物、経費精算の提出物に届くあらゆるドキュメントに対応する必要があります。ドキュメントタイプごとに抽出の課題は異なり、選ぶツールはタイプごとに別々の設定ではなく、同じ設定ですべてを処理できなければなりません。
1. 請求書 — 中心となるワークロード
請求書は会計OCRの処理量の大部分を占めます。標準的な抽出対象には、ヘッダー項目(ベンダー名、請求書番号、日付、支払期日、PO番号、合計金額、税額、通貨)と、明細行が含まれます。明細行は、ベンダーごとに列数、列の順序、ページ範囲が異なるため、より困難です。列構造が可変の複数ページ請求書から明細行を抽出できないツールは、AP業務で実運用に耐えません。請求書特有の抽出についての詳細は、請求書データ抽出の完全ガイドをご覧ください。
2. 領収書 — フォーマットの悪夢
領収書は、他のどの会計ドキュメントよりも多くのフォーマットで届きます。感熱紙、スマートフォンでの撮影、メールのPDF、ガソリンスタンドのしおりサイズのスキャン控え、複数ページのレストラン伝票。印刷品質は鮮明なものからほぼ判読不能なものまで幅広く(感熱紙は6〜12か月で退色します)。請求書と異なり、領収書が標準的なレイアウトに従うことはほとんどありません。タクシーの領収書と金物店の領収書には、「下部に合計がある」以外に共通する構造パターンはありません。IRSは、デジタル領収書がベンダー名、日付、各明細行、合計、支払方法を保持することを求めています — 合計だけでは不十分です。つまり、領収書のOCRは、機械読み取りを想定して設計されていないドキュメントから明細行の詳細を取得する必要があり、現場の従業員がスマートフォンで3秒で撮影した写真品質でも機能しなければなりません。
3. 銀行取引明細書 — 繰り返し行を含むマルチページ構造
銀行取引明細書は、請求書やレシートとは構造的に異なります。1つのPDFが20ページに及ぶこともあり、各ページには日付、摘要、参照番号、借方、貸方、残高を含む取引テーブルが繰り返し登場します。抽出要件は単に行を取得することではなく、マルチページにわたる明細データを、重複行(ページ境界でよく発生します)も欠落行もない単一の連続したテーブルにマージすることです。明細書のフォーマットは銀行ごとに大きく異なります。2列レイアウト(左に借方、右に貸方)を使う銀行もあれば、取引種別インジケーター付きの単一列を使う銀行もあり、口座種別に応じて同一ドキュメント内で両方を組み合わせる銀行もあります。詳しくは会計チーム向けの銀行取引明細書抽出の実際をご覧ください。
4. 税務フォーム — W-2と1099
W-2と1099のフォームは季節性がありますが、重要性は非常に高いものです。ほとんどの会計チームはこれらを集中的に処理します — 米国企業では1月から4月にかけて — そして正確性の要件は絶対です。1099のSSNやEINが誤っているとIRSからCP2100の通知が発行され、1月31日の提出期限後に修正フォームを再発行すると、フォームごとの罰則が3月にかけて段階的に増加します。抽出の課題は、税務フォームが小さな文字(ボックスレイアウトで8〜10 pt)を使用していること、似て見えても異なる意味を持つフィールド(Box 1 賃金 vs Box 3 社会保障賃金 vs Box 5 メディケア賃金)が含まれていること、そしてしばしば複数部構成のフォームに印刷されるためスキャン品質が低下することです。ほとんどのOCRツールはすべての税務フォームを「とにかく全部読み取る」ものとして扱います — しかし1099-NEC報告で重要なフィールドはBox 7(非従業員報酬)であり、W-2の給与照合で重要なフィールドはBox 1(賃金、チップ、その他の報酬)です。これらの意味的に類似したフィールドを区別しない抽出ツールは、処理から数か月後に表面化する下流の報告エラーを生み出します。
5. 発注書 — 三者照合の照合側面
発注書(PO)は、OCRにとって最も優先度の低い会計ドキュメントですが、三者照合ワークフロー(PO + 入荷記録 + 請求書)には不可欠です。POは、請求書が照合すべき確定支出、品目数量、合意価格を定義します。POデータ — PO番号、品目説明、発注数量、単価、納期 — を抽出することで、自動照合が可能になります。システムはPOの明細行と請求書の明細行を比較し、人間が2つの紙のドキュメントを照合することなく不一致を検出します。PO抽出がなければ、請求書抽出がどれほど優れていても、照合は手作業のデスク業務のままです。
本当の課題 — マルチフォーマットのベンダー請求書
APチームにデータ入力の何が難しいかを尋ねると、答えは一貫しています:「ドキュメントは何百もの異なるベンダーから届くので、すべてフォーマットが異なります。」この一文 — r/Accounting、r/Entrepreneur、r/smallbusinessのRedditスレッドで繰り返されている — は、ほとんどのOCRツールが解決できていない構造的な問題を捉えています。
問題は、請求書のレイアウトが異なることではありません。従来のOCRでは、各レイアウトを個別の設定として扱う必要があることです。ベンダーAの1ページ請求書用のテンプレートを生成します。2ページ目に明細行があるベンダーBの2ページ請求書用に別のテンプレートを構築します。合計を右上ではなく左下に配置するベンダーCの請求書用に3つ目のテンプレートを作成します。そして、取引先の数だけ掛け算します — さらに、ベンダーが会計ソフトを更新して請求書レイアウトが変わるたびに、テンプレートが壊れます。
あるRedditユーザーは限界点をこう説明しています:「以前は月に2,500件以上の請求書を手入力していました。同じフィールドの繰り返しです:請求書番号、日付、ベンダー、合計。反復的で遅く、疲労のせいでミスを繰り返していました。限界点は、同じ請求書を誤って2回入力してしまい、数字が一致しなくなった箇所を探すのに何時間も費やしたことでした。」
別のユーザーは、複数のフォーマットを処理するAPチーム向けにOCRソリューションを評価して:「いくつかのOCRソリューションを検討しましたが、新しいテンプレートごとに大規模なトレーニングが必要なことが多いです。ベンダーごとにカスタムパーサーを構築することなく、多様なドキュメントから明細行データを確実に抽出できるツールを使っている人はいますか?」
これが、従来のOCRとAI駆動の抽出の根本的な違いです。テンプレートベースのツールは、各ベンダーのフォーマットを個別の問題として扱います。AI抽出は、すべての請求書を同じ問題として扱います:「請求書番号を見つけ、合計を見つけ、明細行を見つける」 — AIは、特定のレイアウトに関係なく請求書がどのようなものかを理解しているからです。これら2つのアーキテクチャアプローチの詳細な比較については、OCR対AI抽出:あなたのドキュメント構成に合うのはどちらかをご覧ください。
従来のOCRとAIによる抽出の比較
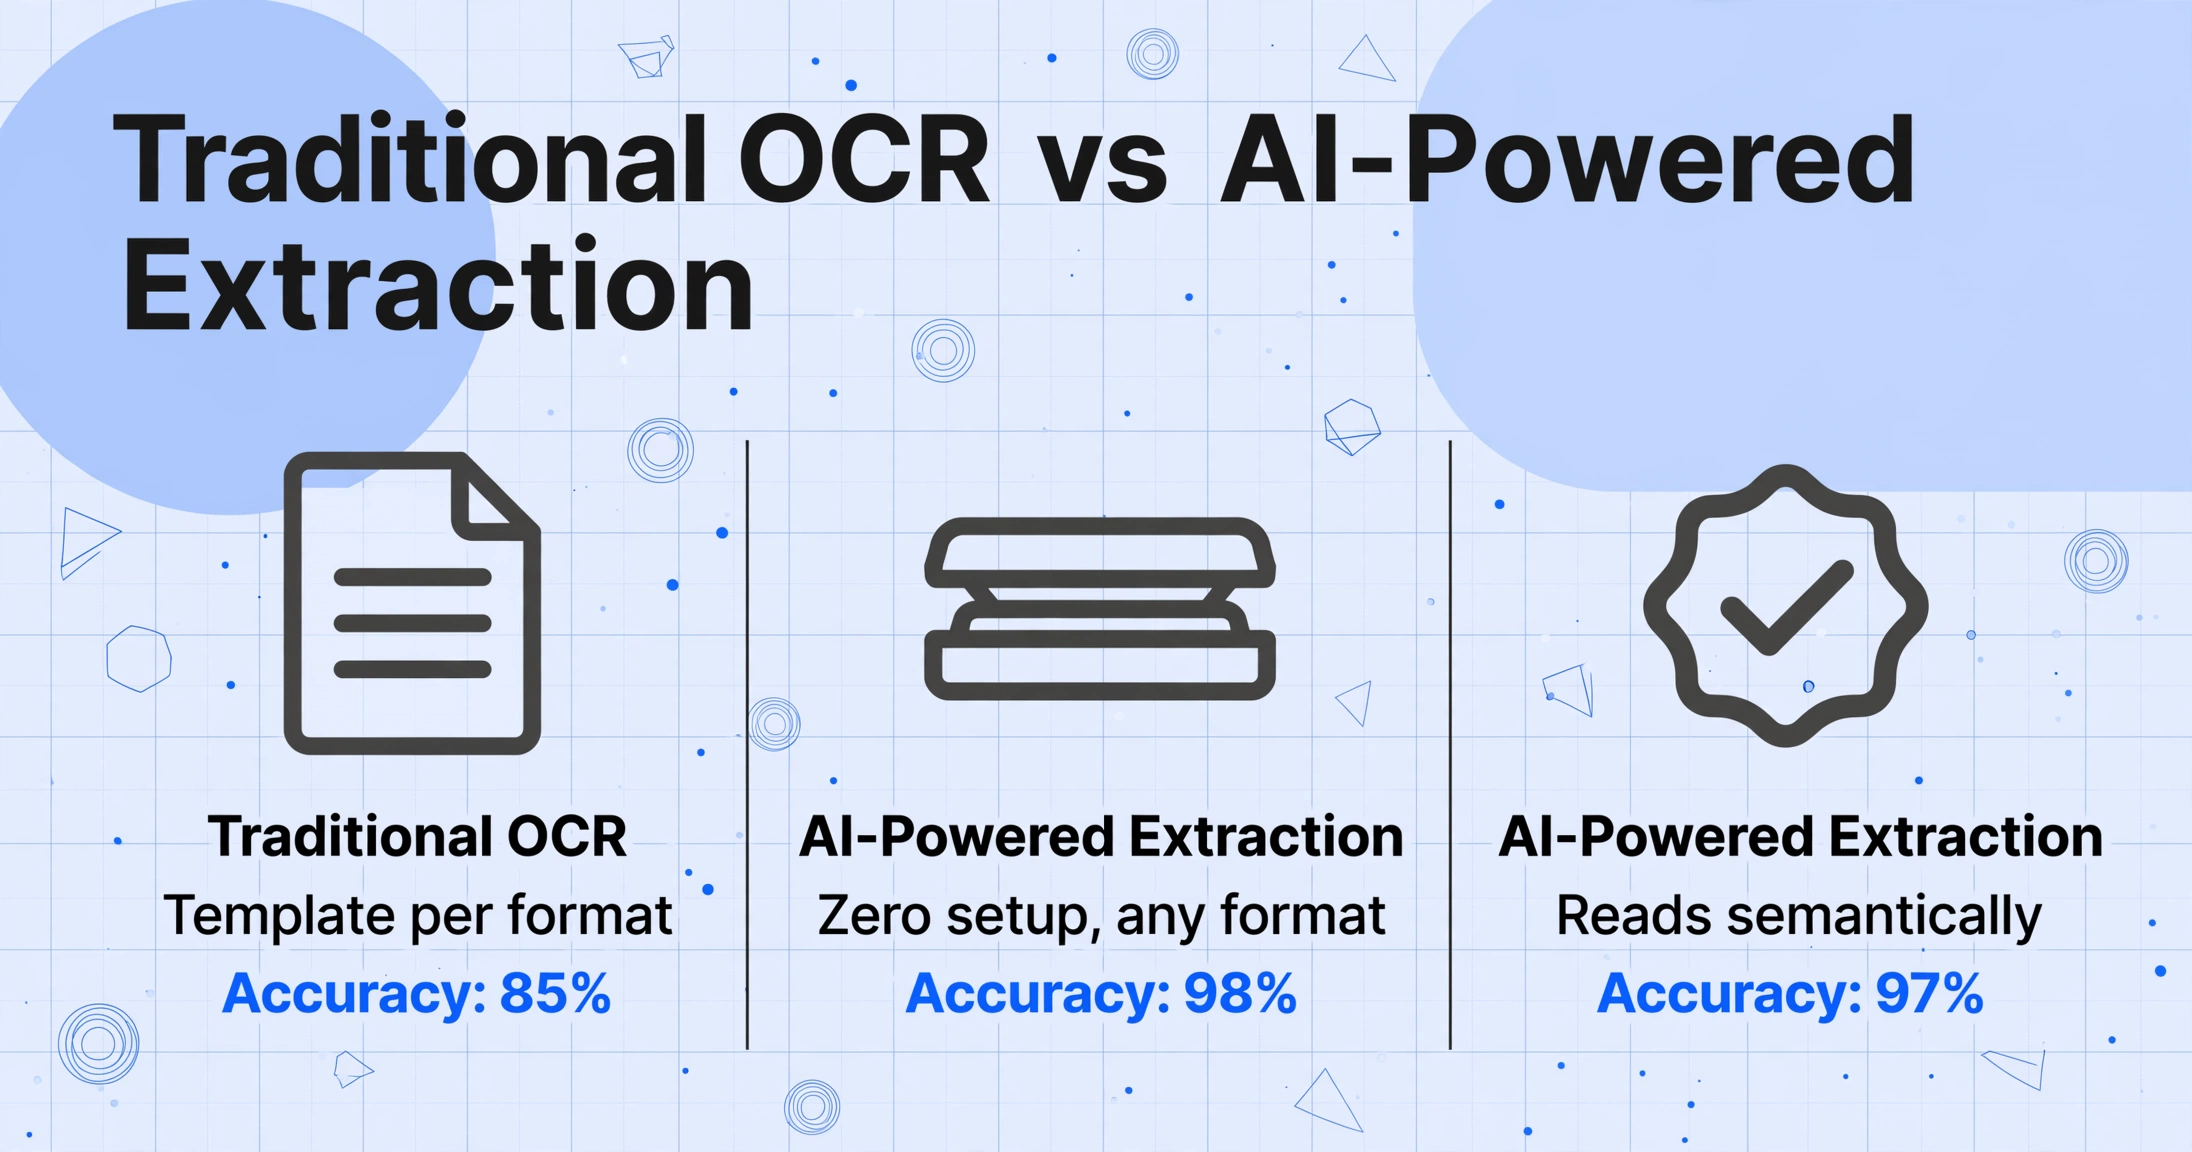
従来のOCRとAIによる抽出の違いは程度の問題ではなく、それぞれの技術がそもそも何をできるかの違いです。この区別を理解することは、会計用途のあらゆるツールを評価するために必要です。
| 機能 | 従来のOCR | AIによる抽出 |
|---|---|---|
| ベンダー形式ごとの設定 | 形式ごとに1つのテンプレート | 不要 — 同じ設定でどの形式にも対応 |
| ベンダーがレイアウトを変更した場合 | テンプレートが壊れる — 再構築が必要 | 変更不要 — AIが意味的に読み取る |
| 請求書の手書き文字 | <50%の精度 | 画質が良ければ85〜95% |
| 複数ページのドキュメントの表 | 2ページ目で壊れる | ページ境界をまたいで読み取る |
| 列数が変動する表 | 列のずれが発生 | 列数・構造に適応 |
| カスタム列抽出 | フィールドごとに範囲指定が必要 | フィールド名を入力 — AIが位置を特定 |
| 計算列 / 計算 | 非対応 | 標準搭載 — 抽出時に値を算出 |
| 出力形式 | テキストファイルまたは検索可能なPDF | Excel、CSV、JSON — フィールドごとに構造化 |
上の表は、「OCRは会計に適しているか」という問いがなぜ誤解を招くかを示しています。テキストを検索可能にするには有用な従来のOCRは、構造化されたフィールド単位のデータを必要とする会計ワークフローには不十分です。各フィールドの意味を理解してドキュメントを読み取るAIによる抽出こそ、データ入力を実際に不要にする技術です。この仕組みのより詳しい入門については、OCRとは何か、AIがそれをどう変えたかをご覧ください。
コンプライアンス — 会計OCR環境が満たすべき3つの規制要件
会計向けOCRはスピードだけの話ではありません。税務当局から資料を求められた際に、デジタル記録として要件を満たすことが重要です。3つの規制の枠組み — 米国、英国、ドイツの各1つ — が、実務上求められる準拠したデジタル記録管理の姿を定義しています。会計OCR環境がこれらの要件を満たしていなければ、監査対応可能な記録は作成できません。
米国 — IRS Revenue Procedure 97-22:デジタル記録を法的原本として扱う
IRSは、紙の原本の代わりに電子的に保存された記録を認めています。ただし、保存システムがRevenue Procedure 97-22の6つの条件を満たす場合に限られます。IRC Section 6001に基づき、すべての納税者は確定申告を裏付けるのに十分な記録を保持する義務があります。Rev. Proc. 97-22は、電子保存がその義務を満たす具体的な条件を定めています。
OCR出力に関わる実務上の3つの要件:(1) 電子画像は原本の完全かつ正確な複製でなければならない — 原本のすべての項目がデジタルコピーでも判読可能であること。(2) 記録は検索用にインデックス化されていること — 合理的な時間内に特定の文書を探し出せること。(3) システムは求めに応じて判読可能で読みやすいコピーを出力できること — 特定のソフトウェアなしでは開けない独自形式はこの基準を満たしません。
会計におけるOCRでは、これはつまり、抽出ツールが抽出データとともに原本を保持しなければならないということです。Excel出力だけでは不十分です — 監査時には、IRSの調査官は抽出された各値の元になったソース文書を確認したがります。適切な環境では、抽出データを会計システムにエクスポートしかつ、元のPDFや画像を、抽出行への参照リンク付きで検索可能なアーカイブに保持します。IRSの定義における準拠したデジタル領収書や請求書記録の詳細については、IRS receipt digital record requirementsをご覧ください。
英国 — Making Tax Digital:四半期ごとのデジタル報告
2026年4月から、所得税自己申告向けのMaking Tax Digital(MTD)が、自営業と不動産所得の合計が£50,000を超える個人事業主および地主に義務付けられます。第2段階では、2027年4月に£30,000超、2028年4月に£20,000超の所得がある人に拡大されます。VAT登録事業者にとっては、MTDはすでに2019年から義務化されています。
英国の会計におけるOCRに影響する主な要件は次のとおりです。
- デジタル記録はMTD対応ソフトウェアで保持する必要があります。 紙の領収書を1年分ためて3月にデジタル化することはできません。記録は機能的な互換ソフトウェア内でデジタルに作成・保存する必要があり、データは「デジタルリンク」を介してシステム間で転送可能でなければなりません(コピー&ペーストでは不十分です)。
- すべての取引は日付、金額、カテゴリとともに記録する必要があります。 領収書の合計額だけを取得するOCRでは不十分です — HMRCはデジタル記録において取引レベルの粒度を求めています。
- 四半期ごとの更新をHMRCに提出する必要があります。 ソフトウェアは3か月ごとにサマリーデータを生成して提出する必要があります。つまり、OCRは年に一度の確定申告シーズンの作業ではなく、日々の記帳ワークフローに統合されている必要があります。
- 別々の事業は別々のデジタル記録を持たなければなりません。 配管事業を営み、賃貸物件も所有している場合、同じFinal Declarationで報告するとしても、別々のデジタル元帳が必要です。
OCRツールを評価する英国の会計チームにとって、重要な問いは「領収書を読み取れるか」だけでなく、「その出力形式がXero、QuickBooks、FreeAgent、SageなどのMTD対応会計ソフトウェアで機能するか」です。OCRツールがエクスポートするデータを、MTD対応ソフトウェアがデジタルリンク経由でインポートできない場合、コンプライアンス上のギャップが生じます。
ドイツ — GoBD:機械可読性と10日ルール
ドイツのGoBD(Grundsätze zur ordnungsmäßigen Führung und Aufbewahrung von Büchern, Aufzeichnungen und Unterlagen in elektronischer Form)は、2019年11月28日付のBMF書簡によって改訂され、3つの枠組みの中でデジタル文書管理に関する最も厳格な基準を定めています。2019年の改訂では、特定の技術的・手続き的条件が満たされることを前提に、「ersetzendes Scannen」(置換スキャン)— 紙文書をデジタル化した後に原本を破棄すること — が明示的に認められました。
会計におけるOCRに最も関連する要件は以下のとおりです。
- 適時性(Zeitgerecht):文書は受領後10営業日以内に記録する必要があります。現金取引は毎日記録しなければなりません。月末にまとめてバッチでデジタル化するために領収書を溜め込むことは、Betriebsprüfung(税務調査)において適時性違反と指摘されます。
- 機械可読性(Maschinelle Auswertbarkeit):デジタル記録は、IDEAなどの監査ツールを用いて税務当局が自動評価できる形式でなければなりません。請求書を構造化データなしでフラットな画像スキャン(TIFF、JPEG)のみで保存することはこの原則に違反します — アーカイブはプログラムによって検索・並べ替え・相互参照が可能でなければなりません。
- 保存期間:税務関連文書は10年間。保存期間は、文書が作成された暦年の末日から起算されます。
- 画像品質:10〜12 ptのテキスト文書には最低300 DPI、小さなフォントや感熱紙の文書には400〜600 DPI。スタンプ、署名、ロゴの詳細が重要な文書には、白黒ではなくカラーまたはグレースケールを使用します。
- アーカイブ形式:PDF/AまたはTIFF。JPEG単体は、監査証跡の統合を欠き、再圧縮で劣化するため、改ざん防止とは見なされません。
ドイツの会計チームにとって、これはOCR出力にアーカイブされた文書画像と並んで構造化データフィールドを含める必要があり、ワークフローは10日以内に文書を取得・デジタル化しなければならないことを意味します。GoBDの機械可読性要件は、元文書への参照を含むExcelまたはCSV出力のほうが、フラットな画像アーカイブよりも実際に強力なコンプライアンス証拠となることを意味します。詳細な手順については、GoBD準拠の文書デジタル化ガイドをご覧ください。
文書タイプ別に抽出すべき主要フィールド
会計チームには、5つの文書タイプすべてにわたって一貫した抽出スキーマ(同じフィールド名とデータ型)が必要です。これがバッチ処理とERPインポートを可能にする鍵となります。すべての文書がフォーマットに関係なく同じ列構造を生成すれば、抽出後の統合は文書ごとのデータ整理作業ではなく、単純なマッピング作業になるからです。以下の表は、会計業務における各文書タイプの重要フィールドをまとめたものです。
| 文書タイプ | ヘッダーフィールド | 明細・詳細フィールド | コンプライアンスフィールド |
|---|---|---|---|
| 請求書 | 請求書番号、日付、支払期日、ベンダー名、PO番号、小計、税、合計、通貨 | 摘要、数量、単価、明細合計、SKU、税率 | VAT/税ID、ベンダーEIN、税登録番号 |
| 領収書 | ベンダー名、日付、合計、支払方法、カテゴリ | 品目摘要、数量、単価、明細合計 | 業務目的メモ、税カテゴリ(食事/出張/オフィス) |
| 銀行取引明細書 | 口座番号、明細期間、期首残高、期末残高 | 取引日、摘要、参照番号、借方、貸方、残高 | 該当なし — 銀行取引明細書は補足書類 |
| W-2 | 雇用主EIN、雇用主名、従業員SSN、従業員名 | Box 1〜14の賃金、Box 2の連邦税、Box 3〜6のSS/メディケア、Box 12〜14のコード | EINはIRSの記録と一致する必要あり、州EIN |
| 1099-NEC/MISC | 支払者EIN、支払者名、受取人TIN、受取人名 | Box 1/Box 7(非従業員報酬)、Box 3/4、連邦税源泉徴収 | 受取人TINはIRSデータベースで検証が必要 |
| 発注書 | PO番号、ベンダー名、発行日、合計金額、通貨 | 品目摘要、発注数量、単価、明細合計、納品日 | 該当なし — 発注書は社内承認書類 |
ほとんどの会計チームにとって実用的なおすすめは、すべての文書タイプでヘッダーフィールドから始めることです。これでデータ入力作業の80%をカバーできます。ヘッダーのワークフローが安定して運用できるようになったら、明細の抽出を追加してください。例外は銀行取引明細書です。ヘッダーフィールド(口座番号、期間、期首・期末残高)は照合に重要ですが、本当の価値は取引行にあり、これが銀行取引明細書における明細に相当します。
ファイルは安全に処理され、保存されません。
会計スタックに合ったOCRの選び方
会計向けOCRツールの選定は、日々の業務への影響が大きい順に5つの基準で判断します。ベンダーが謳う「99%の精度」よりも、既存の会計システムと連携し、新たに保守すべきデータパイプラインを増やさずに導入できるかどうかが重要です。
1. 会計ソフトウェアとの連携 — 必須条件
どれほど優れた抽出も、その出力が会計システムに自動で届かなければ価値はゼロです。連携の要件は「CSVをエクスポートできるか」ではありません。どのツールでもCSVはエクスポートできます。問題は、抽出したデータを仕入先レコード、勘定科目表、取引キューに直接送り込むネイティブ接続が、そのツールにあるかどうかです。
中小・中堅企業で最も広く使われている2つの会計プラットフォーム、QuickBooks OnlineとXeroでは、連携環境が成熟しています。専用コネクタを備えたツールは、抽出したフィールド(仕入先名 → QuickBooksの仕入先レコード、勘定科目コード → 勘定科目表のエントリ、税額 → 税コードの割り当て)をマッピングし、データをレビューと記帳のために会計キューへ直接送信できます。これにより、データ品質の問題を招き、エクスポートしたファイルを開いて列の整合性を確認し、形式の不一致を修正する作業を誰かが担う必要があったダウンロード・インポートの手順が不要になります。
あまり一般的でない会計プラットフォームを使用している場合は、そのOCRツールのAPIが、お使いのプラットフォームが受け入れる構造化JSONを出力できるか、またはミドルウェアコネクタ(Zapier、Make)がカスタム開発なしでそのギャップを埋められるかを確認してください。技術的アプローチとユースケース別に抽出ツールを包括的に比較したものは、2026年会計事務所向けベストOCRソフトウェアをご覧ください。
2. テンプレート不要 — 隠れたメンテナンスコストを排除
テンプレートベースのOCRには、取引先数に比例して増大する見えないコストがあります。それがテンプレートのメンテナンスです。新しい取引先のフォーマットごとに新しいテンプレートが必要になり、取引先のフォーマットが変わるたびに既存のテンプレートが壊れます。取引先が50社になると、テンプレートのメンテナンスは片手間の仕事ではなくなります。200社になれば、専任の業務になります。その代替となるテンプレート不要のAI抽出では、あらゆる取引先のフォーマット、言語、レイアウトに同じフィールド定義を使用できます。フィールド名「Invoice Number」は、ある取引先のドキュメントでラベルが「Invoice No.」であっても、別の取引先で「Rechnungsnummer」であっても機能します。これは、20種類以上の取引先フォーマットを処理する会計チームにとって、最も重要な判断基準です。
3. バッチ処理 — 1回の実行で1つのスプレッドシート
1件ずつドキュメントを処理するのは、会計業務の水準には達していません。ツールは、PDF、JPG、PNGを混在させた複数のファイルを1回のアップロードで受け付け、すべてを同じ抽出設定で処理し、各ソースドキュメントが1行(明細行の場合は1行のセット)に対応する1つの統合ファイルを出力する必要があります。各行にはソースファイルへの参照が必要です。そうすれば、行とファイルを手作業で突き合わせることなく、元のドキュメントまで追跡できます。
4. 明細行の抽出 — 難しいのはテーブル
ヘッダーのみの抽出では、請求書のデータの30〜50%しかカバーできません。明細行(数量、単価、説明、行合計)こそが、人件費がかかる部分です。ツールは、複数ページにわたるテーブル(多くの取引先の請求書は2〜4ページにまたがります)、変動する列数(6列のPOもあれば8列のPOもあります)、不規則な列の順序(DescriptionがQtyの前か、QtyがDescriptionの前か)に対応する必要があります。複数ページでフォーマットが変動する請求書から明細行を確実に抽出できないツールは、データ入力で最も時間のかかる部分をあなたのチームに押し付けることになります。
5. コンプライアンス水準の出力 — ソースドキュメントの保持
上記のコンプライアンスのセクションで述べたとおり、会計向けのOCR出力には、抽出されたデータおよびソースドキュメントへの参照を含める必要があります。ツールは、元のファイルを抽出結果と一緒に保存するか、両方を含むダウンロード可能なアーカイブを提供する必要があります。抽出されたExcelファイルだけを提供し、ソースドキュメントを保持しないツールは、コンプライアンス上のギャップを生み出します。これは、英国のMTD要件(ソースドキュメントをデジタル記録にリンクする必要があります)やGoBDのトレーサビリティ要件(Nachvollziehbarkeit — すべてのデータポイントが元のドキュメントまで追跡可能でなければなりません)にとって特に重要です。
FAQ
OCRは経費報告用のレシートのスマホ写真でも機能しますか?
はい、AI搭載のOCRはスマホ写真でも機能します。これは従来のスキャンに対する大きな利点の一つです。ただし、写真の品質は精度に直接影響します。スマホ写真から確実に抽出するには、十分な明るさで撮影し、スマホをレシートと平行に保ち(遠近の歪みを避ける)、四隅をすべて収め、光沢紙ではフラッシュを避けてください。感熱紙のレシート(時間とともに薄くなる)はすぐに撮影してください。数週間放置するだけで読み取れなくなることがあります。妥当な条件下では、レシート写真の印字テキストに対するフィールド単位の精度は85~95%で、手書きの場合はより低くなります。
OCRの出力をQuickBooks OnlineやXeroに直接連携できますか?
はい、OCRツールが直接連携に対応していれば可能です。QuickBooks OnlineとXeroにはどちらもAPIとアプリマーケットプレイスのエコシステムがあり、抽出ツールが請求書、支払明細、経費データを会計キューに直接登録できます。連携対応を評価する際は、次の点を確認してください。(1) フィールドマッピング — 抽出した取引先名を取引先リストに、抽出した勘定科目の説明を勘定科目表にマッピングできるか。(2) 登録形式 — レビュー可能な下書きの支払明細を作成するのか、それとも台帳に直接登録するのか。(3) 添付ファイルの紐付け — 監査証跡のために、元のドキュメントが会計ソフトの取引に添付されるか。直接連携がない場合の代替手段は、CSVエクスポートと手動インポートで、バッチごとに2~5分余分にかかりますが、どの会計プラットフォームでも機能します。
取引先ごとの請求書フォーマットにテンプレートを作成する必要がありますか?
AI搭載の抽出を使うなら不要です。これが最新のAI抽出と従来のテンプレートベースのOCRを分ける決定的な違いです。AI搭載ツールは、各フィールドが意味する内容をセマンティックに理解して請求書を読み取ります。「請求書番号」とは、ページ上のどこに記載されていても、この取引を取引先に対して識別する番号を意味します。フィールドを一度定義すれば(例:「請求書番号」「合計」「税額」)、同じ定義がこれまで見たことのないものを含め、あらゆる取引先のフォーマットで機能します。テンプレートベースのツールは、取引先のフォーマットごとに個別のテンプレートが必要です。経理チームが50社以上の取引先の請求書を処理しているなら、テンプレート不要の抽出が唯一の現実的な選択肢です。50以上のテンプレートを管理する保守負担は、手入力の人件費を上回ります。
デジタル記録がIRSの税務調査を通過することをどう確認すればよいですか?
IRS Revenue Procedure 97-22は3つの実務的な条件を定めています:(1) デジタルコピーは原本の完全かつ正確な複製でなければならない — 原本の領収書や請求書のすべてのフィールドがデジタル版でも判読可能であること;(2) 検索を可能にする索引システムが必要 — 合理的な時間内に特定のドキュメントを特定できること;(3) システムは要求に応じて判読可能なコピーを再現できなければならない — 標準的な画像形式(JPEG、PNG、PDF)は問題ありませんが、特定のソフトウェアなしでは開けない独自形式は不可です。実際には、準拠したシステムとは:原本のドキュメント画像(スキャンまたは写真)を保持し、抽出データと一緒に保存し、ベンダー/日付/金額で索引付けし、調査官が求めたときに提示できることです。抽出したExcel出力と一緒に原本画像を保持し、各行をソースファイルにリンクする参照を付けることが、3つの条件すべてを満たす最も簡単な方法です。
月100件未満の請求書を処理する小規模チームにとって、会計向けOCRは価値がありますか?
はい — ただし、大量処理チームに比べてメリットは小さくなります。月100件の請求書では、手動データ入力時間は月あたり約5〜8時間です(ヘッダーフィールドで請求書あたり3〜5分)。低コストのAI抽出サブスクリプション(月$20〜50)でその時間をなくせます。データ入力の実効時給が$15/時間を超えていれば計算は成り立ちます — 従業員を雇っている、あるいは自分の時間を使っているどのビジネスでも当てはまります。注意点はセットアップ時間です:最初に30〜60分を費やして抽出フィールドを設定し、サンプル請求書でテストし、会計ソフトウェアとの連携を設定する必要があります。月30件未満では、セットアップコストが節約分に見合わないかもしれません — ただし、繁忙期で量が急増する確定申告シーズンや年度末決算では価値があります。包括的な状況については、用途別に評価した2026年最高のOCRソフトウェアをご覧ください。
1つのOCRツールで請求書と銀行明細の両方を処理できますか?
はい — ただし、ツールは各ドキュメントタイプの特定の抽出要件をサポートしている必要があります。一部のOCRツールは請求書に特化しており、ページ境界をまたいで行が分割されたり、残高欄を誤読したりすることなく、複数ページの銀行明細テーブルを処理できません。混在するドキュメントタイプに対応するツールを評価する際は、サンプルファイルではなく実際のドキュメントでテストしてください。複数ページの銀行明細をアップロードして、次を確認してください:(1) すべての取引行がページ境界をまたいで取得されている、(2) 残高欄が正しく読み取られ、照合確認に使用できる、(3) 借方と貸方の金額が正しい列に明確に分離されている。特定の銀行の明細形式でこれらのテストに合格するツールは、請求書や領収書でもおそらく機能します。インタラクティブなテストについては、OCRソフトウェアがさまざまなドキュメントタイプでどのように機能するかをご覧ください。
信頼性の高いOCR抽出に必要な最小ドキュメント解像度は?
標準的な10〜12 ptの印刷文字の場合、信頼性の高いOCRには200 DPIが最低ラインで、良好な結果を得るには300 DPIが実用的な標準です。小さな文字(8 pt以下)、感熱紙、細部まで鮮明なドキュメントの場合は400〜600 DPIを推奨します。スマートフォンでの撮影では、解像度よりも照明とピントが重要です。十分な明るさで近距離から撮影した12 MPのスマートフォン写真は、悪い角度でスキャンした300 DPIのスキャンよりも良いOCR結果を生み出します。GoBD基準(ドイツ)では、標準ドキュメントには最低300 DPI、小さな文字のドキュメントには400〜600 DPIをカラーまたはグレースケールで明示的に要求しています。紙のドキュメントをアーカイブ目的でスキャンする場合は、カラーで300 DPIでスキャンしてください。ファイルサイズは大きくなりますが、特に時間とともに退色する感熱紙でも、長年にわたって判読可能性を確保できます。