OCR für die Buchhaltung: Ein vollständiger Leitfaden
zur Verarbeitung von Rechnungen, Belegen und Kontoauszügen
OCR für die Buchhaltung bedeutet den Einsatz automatisierter Texterkennung und KI-gestützter Extraktion, um Finanzdokumente – Rechnungen, Belege, Kontoauszüge, Bestellungen, Steuerformulare – in strukturierte Daten zu überführen, die direkt in Ihr Buchhaltungssystem fließen. Richtig umgesetzt eliminiert es die manuelle Dateneingabe, verkürzt die Abstimmungszeit und erstellt prüfungssichere digitale Aufzeichnungen. Doch „OCR für die Buchhaltung" ist keine einzelne Technologie. Es umfasst drei verschiedene Extraktionsansätze, fünf Dokumenttypen mit unterschiedlichen Verarbeitungsanforderungen und ein Geflecht regulatorischer Rahmenwerke – IRS Rev. Proc. 97-22 in den USA, Making Tax Digital in Großbritannien, GoBD in Deutschland – die darüber entscheiden, ob Ihre digitalen Aufzeichnungen einer Prüfung standhalten. Dieser Leitfaden behandelt alle diese Aspekte in der Reihenfolge, in der ein Buchhaltungsteam ihnen tatsächlich begegnet: beginnend mit der praktischen Bedeutung von OCR, dann jeder Dokumenttyp, die geltenden Compliance-Regeln und schließlich die Auswahl des richtigen Tools für Ihren Buchhaltungs-Stack.
Die wichtigsten Erkenntnisse
- Vorlagenbasiertes OCR beendet die Dateneingabe nicht – es benennt sie in Vorlagenpflege um, und bei 50 Lieferanten wird diese Pflege zu einer Teilzeitstelle.
- Manuelle Dateneingabe erzeugt 2–5 Fehler pro 100 Felder, deren Finden und Beheben jeweils $10 kostet – das bedeutet, dass 500 Rechnungen pro Monat $2.500 bis $12.500 an unsichtbaren Korrekturkosten verbergen.
- KI-gestützte Extraktion liest Rechnungen danach, was Felder bedeuten, nicht wo sie auf der Seite stehen – dieselbe Einrichtung funktioniert über jedes Lieferantenformat und überführt strukturierte Daten mit prüfungssicheren Quelldokument-Links in QuickBooks oder Xero.
Was OCR für das Rechnungswesen tatsächlich bedeutet
Im Kontext des Rechnungswesens geht es bei OCR nicht darum, gescannten Text in durchsuchbare PDFs umzuwandeln. Es geht darum, Dokumentinhalte in strukturierte, importierbare Daten zu verwandeln – Zeilen und Spalten, die sich Ihrem Kontenplan, Ihren Lieferantendatensätzen und Ihrem Transaktionsverlauf zuordnen lassen.
Die relevante Fähigkeit ist nicht „Kann dieses Tool den Text lesen?" – sondern „Kann dieses Tool die Rechnungsnummer extrahieren, sie einer Bestellung zuordnen, das Datum für mein Buchhaltungssystem formatieren und das Ergebnis zusammen mit 99 anderen Rechnungen in einer einzigen Excel-Datei ausgeben?"
Diese Unterscheidung ist wichtig, denn die traditionelle OCR-Technologie – die es seit den 1990er-Jahren gibt – kann Zeichen aus einem Dokument lesen, aber nicht verstehen, was sie bedeuten. Sie erkennt die Zeichenfolge „1.247,83" auf einer Seite korrekt, weiß aber nicht, ob es sich um den Rechnungsbetrag, den Steuerbetrag oder eine Positionszwischensumme handelt, es sei denn, Sie geben ihr genau an, wo auf der Seite sie suchen soll. Für Buchhaltungsteams, die Rechnungen von Dutzenden oder Hunderten von Lieferanten mit jeweils unterschiedlichem Layout erhalten, ist dieser Schritt „Sagen Sie ihr, wo sie suchen soll" der Engpass, der die manuelle Dateneingabe trotz jahrzehntelanger OCR-Verfügbarkeit am Leben erhalten hat. Um den grundlegenden Wandel von der Zeichenerkennung zum Dokumentverständnis zu verstehen, lesen Sie was KI-OCR ist und wie es sich von traditionellem OCR unterscheidet.
Der Wandel, der dies in den letzten drei Jahren verändert hat, ist die KI-gestützte semantische Extraktion – ein grundlegend anderer technischer Ansatz. Statt Zeichen an festen Koordinaten zu scannen, liest ein vision-language Modell das Dokument so, wie ein Mensch es tut: Es erkennt das Layout, versteht die Beziehung zwischen Beschriftungen und Werten und extrahiert Felder basierend auf ihrer Bedeutung, nicht auf ihrer Position. Das bedeutet, dass dasselbe Extraktionssetup funktioniert, ob Ihr Lieferant eine einseitige Rechnung oder ein vierseitiges PDF sendet, ob der Gesamtbetrag oben rechts oder unten links erscheint und ob das Dokument ein sauberes PDF oder ein Handyfoto eines Thermoscans ist.
Warum die Buchhaltung OCR braucht – die quantifizierte Argumentation
Die Argumentation für OCR in der Buchhaltung dreht sich nicht um Technologie. Es geht um die Verteilung von Arbeitskraft. Jede Stunde, die ein AP-Sachbearbeiter damit verbringt, Rechnungsnummern und Positionsbeschreibungen in eine Tabellenkalkulation einzutippen, ist eine Stunde, die er nicht für Abweichungsanalysen, Lieferantenbeziehungsmanagement oder Cashflow-Prognosen aufwendet. Die Zahlen, die diesen Zielkonflikt quantifizieren, sind in mehreren Branchen-Benchmarks gut belegt.
Eine manuell erfasste Einzelrechnung benötigt allein für die Kopffelder 3 bis 5 Minuten – Lieferantenname, Rechnungsnummer, Datum, Bestellnummer, Gesamtsumme. Kommt die Positionsextraktion hinzu, verdoppelt sich die Zeit pro Rechnung. Bei 500 Rechnungen pro Monat entspricht das rund 40 Stunden reiner Datenerfassung – eine volle Arbeitswoche pro Monat, die für Transkription aufgewendet wird. Bei voll belasteten Kosten eines AP-Sachbearbeiters von etwa $25 pro Stunde entspricht das $1.000 pro Woche oder $52.000 jährlich – für Arbeit, die keinerlei analytischen Mehrwert bietet. Die Fehlerquote verschärft das Problem zusätzlich: Manuelle Transkription erzeugt routinemäßig 2 bis 5 Fehler pro 100 erfassten Feldern, und jeder Fehler kostet durchschnittlich $10 für Erkennung und Korrektur, so die Finanz-Benchmarks von APQC. Eine einzelne vertauschte Ziffer bei einer Rechnung über $12.000 – $12.000 statt $21.000 eingegeben – erzeugt ein Abstimmungsproblem, dessen Suche länger dauert als das Eintippen der Zahl selbst.
Die strukturelle Erkenntnis, die die meisten Buchhaltungsteams übersehen: Die Kosten manueller Dateneingabe liegen nicht in der Tippzeit, sondern in der anschließenden Bereinigung. Jeder Fehler, den Sie bei der Erfassung einführen, muss gefunden werden – und das Finden kostet mehr, als die korrekte Eingabe gekostet hätte. OCR beseitigt die Fehlerquelle, nicht nur die Tipparbeit.
Auf der Ausgabenseite verarbeitet die automatisierte Extraktion eine einzelne Seite in 5 bis 10 Sekunden – etwa 18-mal schneller als die manuelle Erfassung – mit einer Feldgenauigkeit bei gedrucktem Text, die konstant über 97 % liegt. Der Zielkonflikt ist nicht Geschwindigkeit versus Genauigkeit. Es ist Geschwindigkeit und Genauigkeit versus dasselbe Team, das drei Tage im Monat Datenerfassung betreibt. Für eine detailliertere Aufschlüsselung der Genauigkeitserwartungen nach Dokumenttyp und eine Methodik, die Sie auf Ihren eigenen Dokumenten anwenden können, lesen Sie den Feldgenauigkeits-Leitfaden für OCR.
Fünf Dokumenttypen, die OCR in der Buchhaltung verarbeitet
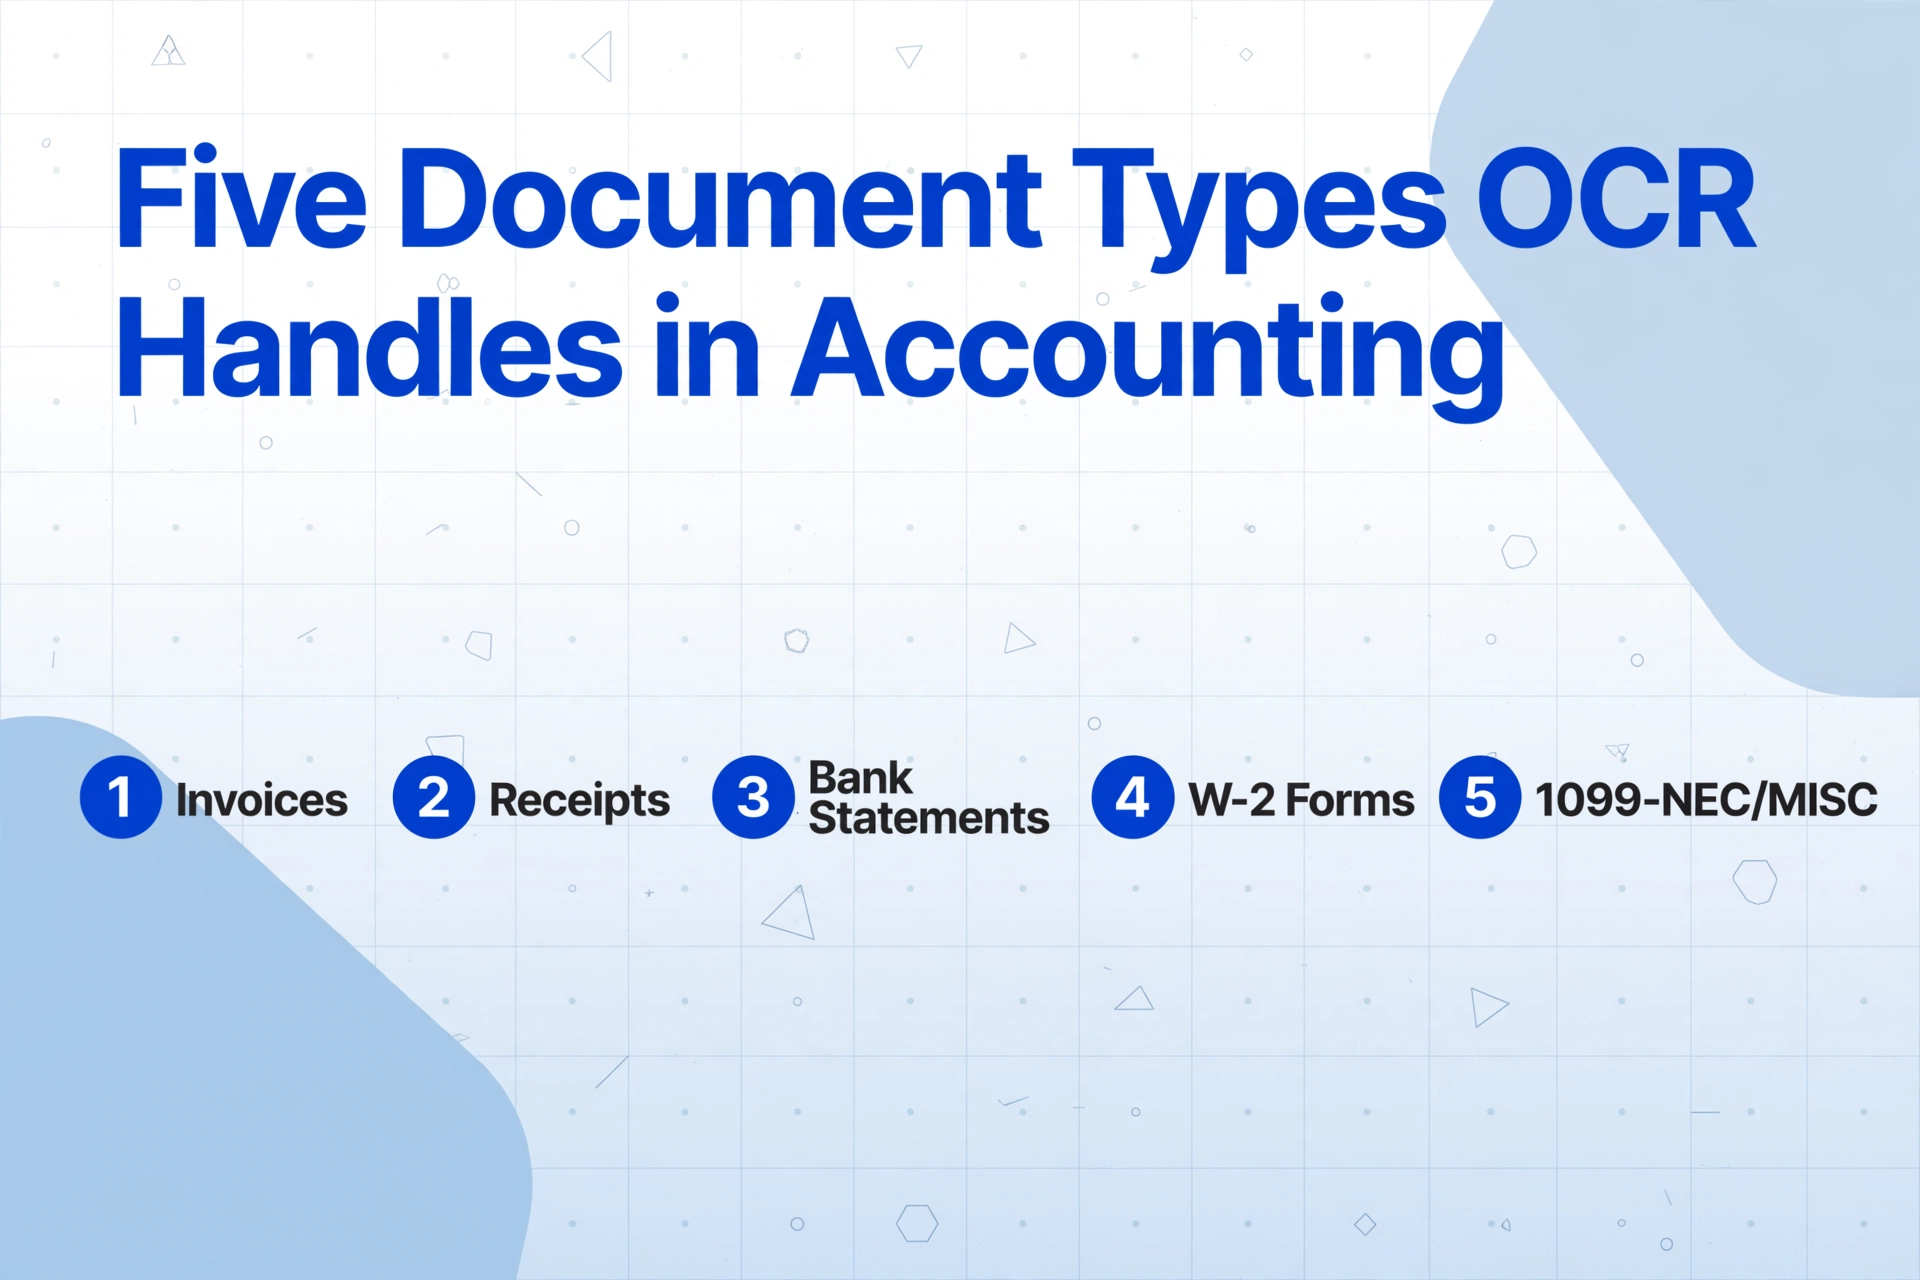
Buchhaltungsteams verarbeiten mehr als nur Rechnungen. Eine vollständige OCR-Einrichtung muss die gesamte Dokumentenmischung bewältigen, die in Ihrem gemeinsamen Posteingang, per Post und in Spesenabrechnungen landet. Jeder Dokumenttyp stellt unterschiedliche Extraktionsanforderungen – und das von Ihnen gewählte Tool muss alle mit derselben Konfiguration verarbeiten, nicht mit einer separaten Einrichtung pro Typ.
1. Rechnungen – Die Kernarbeitslast
Rechnungen machen den Großteil des OCR-Volumens in der Buchhaltung aus. Das Standard-Extraktionsziel umfasst Kopffelder – Lieferantenname, Rechnungsnummer, Datum, Fälligkeitsdatum, Bestellnummer, Gesamtbetrag, Steuerbetrag, Währung – sowie Positionspositionen, die schwieriger sind, da Tabellen in Spaltenanzahl, Spaltenreihenfolge und Seitenumfang je nach Lieferant variieren. Ein Tool, das keine Positionspositionsextraktion über mehrseitige Rechnungen mit variablen Spaltenstrukturen hinweg bewältigt, ist nicht produktionsreif für die Kreditorenbuchhaltung. Eine vollständige Behandlung der rechnungsspezifischen Extraktion finden Sie in der vollständigen Anleitung zur Rechnungsdatenextraktion.
2. Belege – Der Format-Albtraum
Belege kommen in mehr Formaten vor als jedes andere Buchhaltungsdokument. Thermopapier, Handyfotos, E-Mail-PDFs, gescannte kassenbon-große Zettel von Tankstellen, mehrseitige Restaurantmappen. Die Druckqualität reicht von gestochen scharf bis nahezu unleserlich (Thermopapier verblasst innerhalb von 6-12 Monaten). Anders als Rechnungen folgen Belege selten einem Standardlayout – ein Taxibeleg und ein Baumarktbeleg haben keine gemeinsame Struktur außer „hat unten eine Summe". Die IRS verlangt, dass digitale Belege Lieferantenname, Datum, jede Positionsposition, Gesamtsumme und Zahlungsmethode bewahren – nicht nur die Gesamtsumme. Das bedeutet, dass OCR für Belege Positionsdetailinformationen aus Dokumenten erfassen muss, die nie für maschinelles Lesen konzipiert wurden, und dass es mit der Fotoqualität funktionieren muss, die ein Außendienstmitarbeiter in drei Sekunden mit einem Handy produziert.
3. Kontoauszüge — mehrseitige Struktur mit sich wiederholenden Zeilen
Kontoauszüge unterscheiden sich strukturell von Rechnungen und Belegen. Eine einzelne PDF-Datei kann 20 Seiten umfassen, die jeweils eine sich wiederholende Transaktionstabelle mit Datum, Beschreibung, Referenznummer, Soll, Haben und laufendem Saldo enthalten. Die Extraktionsanforderung besteht nicht nur darin, die Zeilen zu erfassen, sondern sicherzustellen, dass mehrseitige Auszugsdaten zu einer einzigen durchgehenden Tabelle zusammengeführt werden, ohne doppelte Zeilen (häufig an Seitenübergängen) und ohne fehlende Zeilen. Die Auszugsformate variieren erheblich zwischen den Banken: Einige verwenden zweispaltige Layouts (Soll links, Haben rechts), andere verwenden eine einzelne Spalte mit Transaktionsart-Indikatoren, und wieder andere kombinieren beides innerhalb desselben Dokuments, abhängig vom Kontotyp. Eine ausführliche Behandlung finden Sie unter wie die Kontoauszugsextraktion für Buchhaltungsteams aussieht.
4. Steuerformulare — W-2 und 1099
W-2- und 1099-Formulare sind saisonal, aber mit hohem Risiko verbunden. Die meisten Buchhaltungsteams verarbeiten sie in Stößen — Januar bis April für US-Unternehmen — und die Genauigkeitsanforderungen sind absolut: Eine falsche SSN oder EIN auf einem 1099 erzeugt eine CP2100-Mitteilung vom IRS, und die erneute Ausstellung korrigierter Formulare nach der Einreichungsfrist am 31. Januar führt zu Strafen pro Formular, die bis März eskalieren. Die Herausforderung bei der Extraktion besteht darin, dass Steuerformulare kleine Schriftarten verwenden (8-10 pt in umrandeten Layouts), Felder enthalten, die ähnlich aussehen, aber unterschiedliche Bedeutungen haben (Box 1 Löhne vs. Box 3 Social-Security-Löhne vs. Box 5 Medicare-Löhne), und oft auf mehrteiligen Formularen gedruckt werden, die eine schlechte Scanqualität erzeugen. Die meisten OCR-Tools behandeln alle Steuerformulare als „einfach alles lesen" — aber das Feld, das für die 1099-NEC-Berichterstattung relevant ist, ist Box 7 (Vergütung für Nichtangestellte), und das Feld, das für den W-2-Lohnabgleich relevant ist, ist Box 1 (Löhne, Trinkgelder, sonstige Vergütung). Extraktionstools, die nicht zwischen diesen semantisch ähnlichen Feldern unterscheiden, erzeugen nachgelagerte Berichtsfehler, die Monate nach der Verarbeitung auftreten.
5. Bestellungen — Die Abgleichseite des Drei-Wege-Abgleichs
Bestellungen (POs) sind das am wenigsten priorisierte Buchhaltungsdokument für OCR, aber sie sind für Drei-Wege-Abgleich-Workflows (Bestellung + Wareneingang + Rechnung) unerlässlich. Bestellungen definieren die zugesagten Ausgaben, Artikelmengen und vereinbarten Preise, gegen die die Rechnung abgeglichen werden muss. Die Extraktion von Bestelldaten — Bestellnummer, Artikelbeschreibungen, bestellte Mengen, Einzelpreise, Liefertermine — ermöglicht den automatisierten Abgleich: Das System vergleicht die Bestellpositionen mit den Rechnungspositionen und kennzeichnet Abweichungen, ohne dass eine Person zwei Papierdokumente manuell abgleichen muss. Ohne Bestellextraktion bleibt der Abgleich eine manuelle Schreibtischtätigkeit, unabhängig davon, wie gut die Rechnungsextraktion funktioniert.
Die eigentliche Herausforderung — Lieferantenrechnungen in mehreren Formaten
Fragen Sie ein beliebiges AP-Team, was die Dateneingabe erschwert, und die Antwort ist konsistent: „Die Dokumente stammen von Hunderten verschiedener Lieferanten, daher sind sie alle unterschiedlich formatiert." Dieser eine Satz — wiederholt in Reddit-Threads in r/Accounting, r/Entrepreneur und r/smallbusiness — fasst das strukturelle Problem zusammen, das die meisten OCR-Tools nicht lösen können.
Das Problem ist nicht, dass Rechnungen unterschiedliche Layouts haben. Es ist, dass herkömmliche OCR erfordert, dass Sie jedes Layout als separate Konfiguration behandeln. Erstellen Sie eine Vorlage für die einseitige Rechnung von Lieferant A. Erstellen Sie eine weitere Vorlage für die zweiseitige Rechnung von Lieferant B mit Positionen auf der zweiten Seite. Erstellen Sie eine dritte Vorlage für die Rechnung von Lieferant C, die die Summe unten links statt oben rechts platziert. Multiplizieren Sie das nun mit jedem Lieferanten, mit dem Sie arbeiten — und jedes Mal, wenn ein Lieferant seine Buchhaltungssoftware aktualisiert und sich das Rechnungslayout ändert, bricht die Vorlage.
Ein Reddit-Nutzer beschrieb den Wendepunkt: „Ich habe früher manuell über 2.500 Rechnungen pro Monat erfasst. Immer wieder dieselben Felder: Rechnungsnummer, Datum, Lieferant, Summen. Es war repetitiv, langsam, und ich machte ständig Fehler, einfach wegen der Erschöpfung. Der Wendepunkt für mich war, als ich versehentlich dieselbe Rechnung zweimal erfasste und dann Stunden damit verbrachte, herauszufinden, wo die Zahlen nicht mehr übereinstimmten."
Ein anderer Nutzer, der OCR-Lösungen für ein AP-Team bewertete, das mehrere Formate verarbeitet: „Wir haben uns einige OCR-Lösungen angesehen, aber sie erfordern oft umfangreiches Training für jede neue Vorlage. Gibt es jemanden, der ein Tool verwendet, das zuverlässig Positionsdaten aus unterschiedlichen Dokumenten extrahieren kann, ohne für jeden einzelnen Lieferanten einen benutzerdefinierten Parser erstellen zu müssen?"
Dies ist der grundlegende Unterschied zwischen herkömmlicher OCR und KI-gestützter Extraktion. Vorlagenbasierte Tools behandeln jedes Lieferantenformat als separates Problem. KI-Extraktion behandelt alle Rechnungen als dasselbe Problem: „Rechnungsnummer finden, Summe finden, Positionen finden" — weil die KI versteht, wie eine Rechnung aussieht, unabhängig von ihrem spezifischen Layout. Für einen detaillierten Vergleich dieser beiden architektonischen Ansätze siehe OCR vs. KI-Extraktion: Welche Lösung zu Ihrem Dokumentenmix passt.
Traditionelle OCR vs. KI-gestützte Extraktion
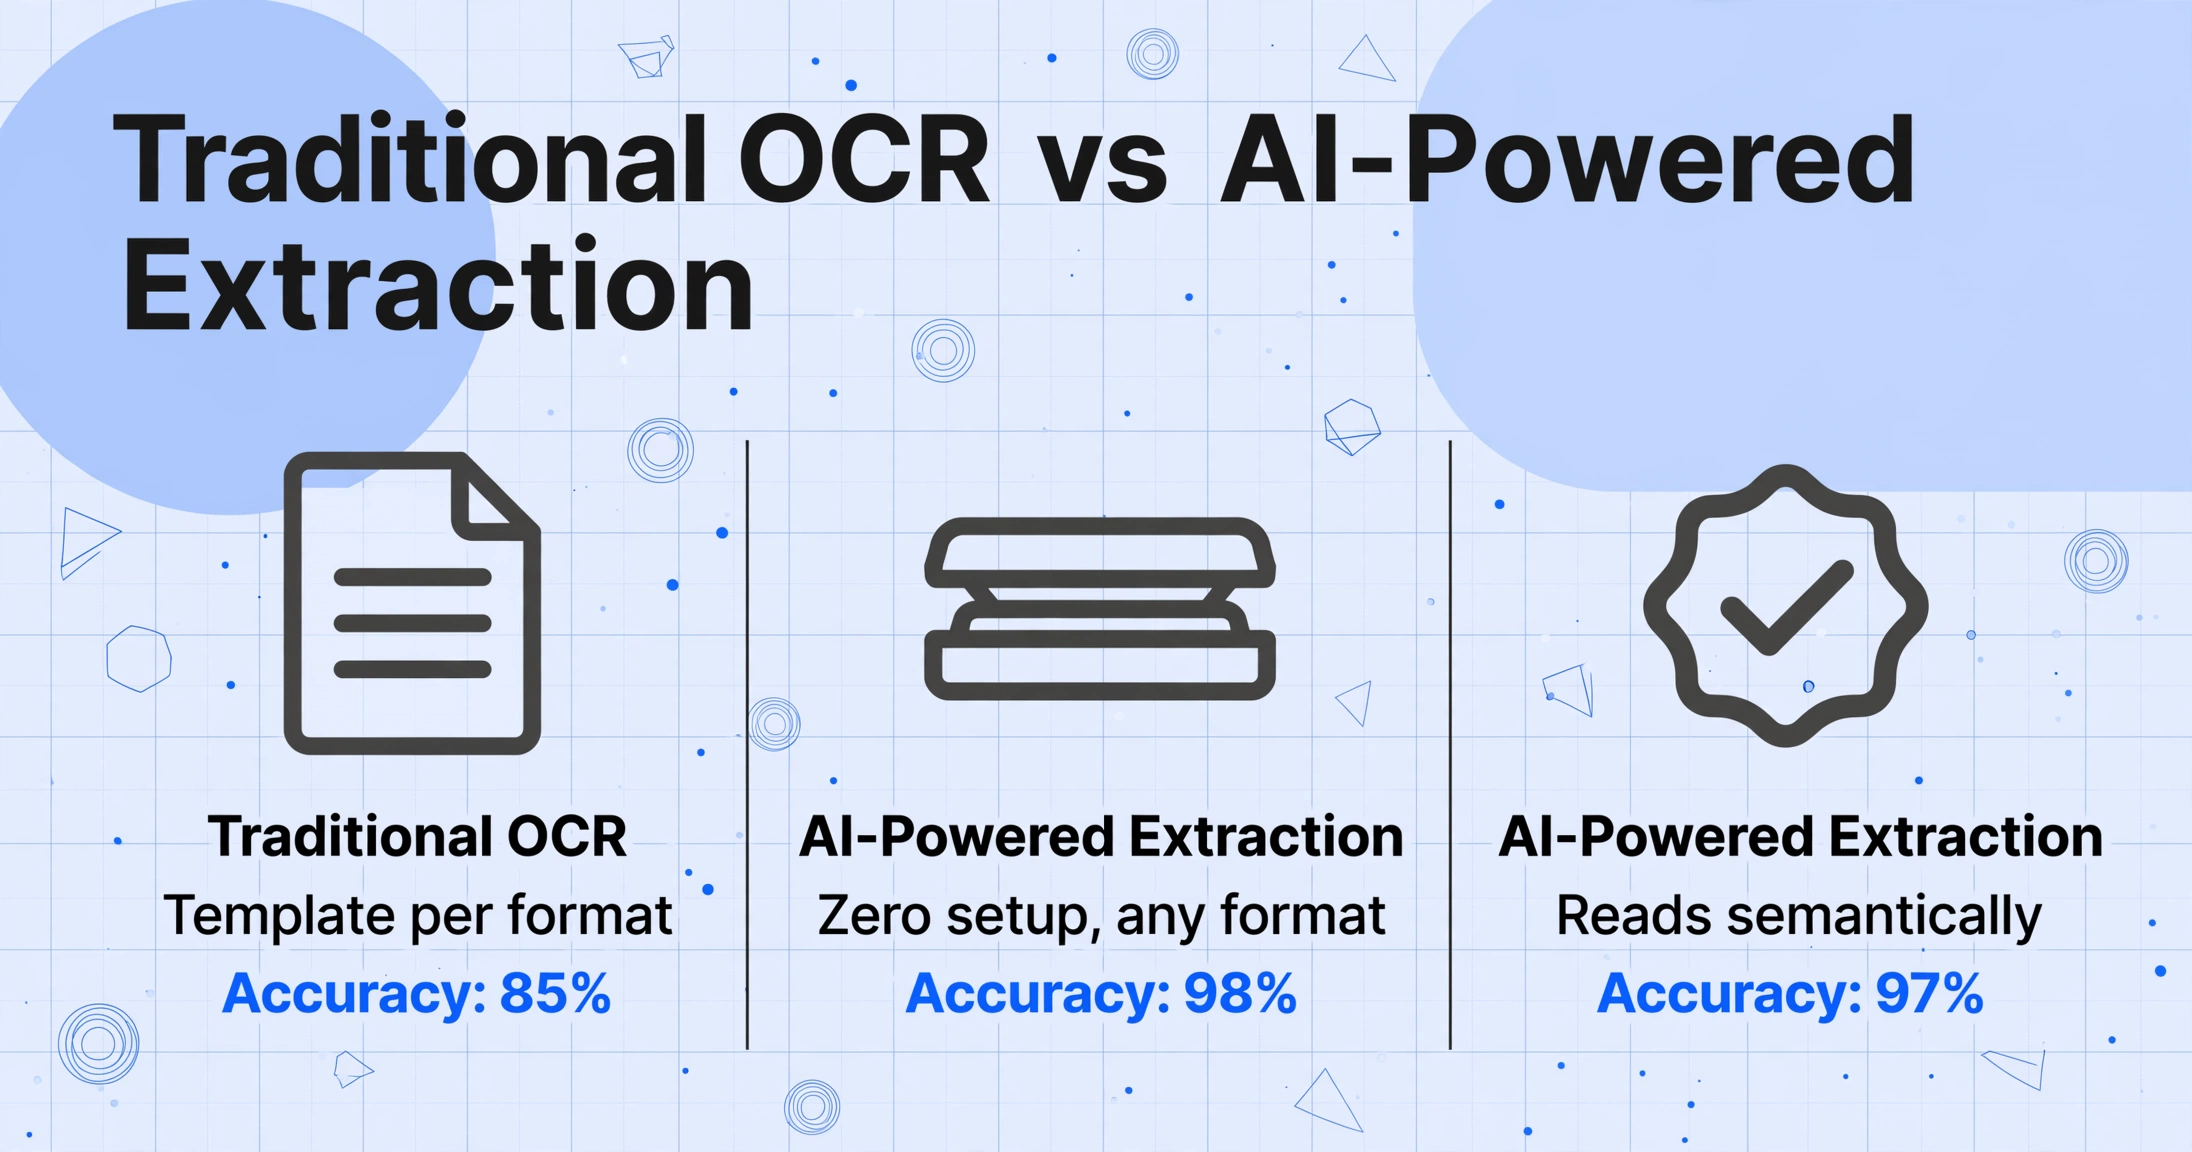
Der Unterschied zwischen traditioneller OCR und KI-gestützter Extraktion ist keine Frage des Grades – es ist ein Unterschied in dem, was die jeweilige Technologie überhaupt leisten kann. Diesen Unterschied zu verstehen ist notwendig, um jedes Tool für den Buchhaltungseinsatz zu bewerten.
| Funktion | Traditionelle OCR | KI-gestützte Extraktion |
|---|---|---|
| Einrichtung pro Lieferantenformat | Eine Vorlage pro Format | Keine – gleiche Einrichtung für jedes Format |
| Wenn der Lieferant das Layout ändert | Vorlage bricht – Neuaufbau erforderlich | Keine Änderung – KI liest semantisch |
| Handschrift auf Rechnungen | <50 % Genauigkeit | 85–95 % bei guter Bildqualität |
| Mehrseitige Dokumenttabellen | Bricht auf Seite 2 ab | Liest über Seitengrenzen hinweg |
| Tabelle mit variablen Spalten | Spaltenfehlausrichtung | Passt sich an Spaltenanzahl/-struktur an |
| Benutzerdefinierte Spaltenextraktion | Erfordert Zonenzeichnung pro Feld | Feldnamen eingeben – KI findet es |
| Berechnete Spalten / Mathematik | Nicht unterstützt | Integriert – Werte während der Extraktion ableiten |
| Ausgabeformat | Textdatei oder durchsuchbares PDF | Excel, CSV, JSON – nach Feld strukturiert |
Die obige Tabelle zeigt, warum die Frage „Ist OCR gut für die Buchhaltung?“ irreführend ist. Traditionelle OCR – nützlich, um Text durchsuchbar zu machen – ist für Buchhaltungsworkflows, die strukturierte Felddaten benötigen, unzureichend. KI-gestützte Extraktion, die Dokumente liest, indem sie versteht, was jedes Feld bedeutet, ist die Technologie, die Dateneingabe tatsächlich eliminiert. Für eine tiefergehende Einführung, wie das funktioniert, siehe was OCR ist und wie KI es verändert hat.
Compliance – Drei regulatorische Rahmenwerke, die jedes OCR-Setup für die Buchhaltung erfüllen muss
OCR für die Buchhaltung dient nicht nur der Geschwindigkeit. Es geht darum, digitale Aufzeichnungen zu erstellen, die den Anforderungen der Steuerbehörden genügen, wenn diese Unterlagen anfordern. Drei regulatorische Rahmenwerke – eines aus den USA, eines aus Großbritannien, eines aus Deutschland – definieren, wie konforme digitale Buchführung in der Praxis aussieht. Wenn Ihr OCR-Setup für die Buchhaltung diese Anforderungen nicht erfüllt, erzeugt es keine prüfungssicheren Aufzeichnungen.
USA – IRS Revenue Procedure 97-22: Digitale Aufzeichnungen als rechtliche Originale
Die IRS akzeptiert elektronisch gespeicherte Aufzeichnungen anstelle von Papieroriginalen – jedoch nur, wenn Ihr Speichersystem die sechs Bedingungen der Revenue Procedure 97-22 erfüllt. Gemäß IRC Section 6001 muss jeder Steuerpflichtige Aufzeichnungen führen, die ausreichen, um seine Steuererklärungen zu belegen. Rev. Proc. 97-22 definiert die spezifischen Bedingungen, unter denen elektronische Speicherung dieser Verpflichtung genügt.
Die drei praktischen Anforderungen, die für die OCR-Ausgabe relevant sind: (1) Das elektronische Abbild muss eine vollständige und genaue Wiedergabe des Originals sein – jedes Feld im Originaldokument muss in der digitalen Kopie lesbar sein; (2) Aufzeichnungen müssen für den Abruf indexiert sein – Sie müssen ein bestimmtes Dokument in angemessener Zeit auffinden können; (3) Das System muss auf Anfrage lesbare, gut lesbare Kopien erzeugen – proprietäre Formate, die ohne spezielle Software nicht geöffnet werden können, erfüllen diesen Standard nicht.
Für OCR in der Buchhaltung bedeutet dies: Ihr Extraktionstool muss das Originaldokument zusammen mit den extrahierten Daten aufbewahren. Nur eine Excel-Ausgabe ist nicht ausreichend – bei einer Prüfung möchte der IRS-Prüfer das Quelldokument sehen, das jeden extrahierten Wert erzeugt hat. Ein ordnungsgemäßes Setup exportiert extrahierte Daten in Ihr Buchhaltungssystem und behält das Original-PDF oder -Bild in einem abrufbaren Archiv mit einem Referenzlink zurück zur extrahierten Zeile. Für die vollständige Aufschlüsselung dessen, was in IRS-Begriffen eine konforme digitale Quittung oder Rechnungsaufzeichnung ausmacht, siehe IRS-Anforderungen an digitale Quittungsaufzeichnungen.
UK — Making Tax Digital: Quartalsweise digitale Berichterstattung
Ab April 2026 wird Making Tax Digital (MTD) für die Einkommensteuer-Selbstveranlagung für Einzelunternehmer und Vermieter mit einem kombinierten Einkommen aus selbstständiger Tätigkeit und Vermietung von über 50.000 £ verpflichtend. Phase 2 erweitert dies auf Personen mit einem Einkommen über 30.000 £ im April 2027 und 20.000 £ im April 2028. Für mehrwertsteuerpflichtige Unternehmen ist MTD seit 2019 bereits verpflichtend.
Die wichtigsten Anforderungen, die OCR für die Buchhaltung im Vereinigten Königreich betreffen:
- Digitale Aufzeichnungen müssen in MTD-kompatibler Software geführt werden. Sie können nicht das ganze Jahr über Papierbelege sammeln und diese im März digitalisieren. Aufzeichnungen müssen in funktionsfähiger, kompatibler Software digital erstellt und gespeichert werden – und die Daten müssen über „digitale Verbindungen" zwischen Systemen übertragbar sein (Kopieren und Einfügen ist nicht ausreichend).
- Jede Transaktion muss mit Datum, Betrag und Kategorie erfasst werden. OCR, die nur die Gesamtsumme auf einem Beleg erfasst, ist unzureichend – HMRC verlangt eine Granularität auf Transaktionsebene in Ihren digitalen Aufzeichnungen.
- Quartalsweise Updates müssen an HMRC übermittelt werden. Ihre Software muss alle drei Monate Zusammenfassungsdaten erstellen und übermitteln. Das bedeutet, dass OCR keine einmalige Aktivität zur Steuersaison ist – es muss in Ihren laufenden Buchhaltungsworkflow integriert werden.
- Getrennte Unternehmen müssen getrennte digitale Aufzeichnungen führen. Wenn Sie ein Klempnerunternehmen betreiben und eine Mietimmobilie besitzen, benötigen Sie getrennte digitale Hauptbücher – auch wenn beide in derselben endgültigen Steuererklärung gemeldet werden.
Für Buchhaltungsteams im Vereinigten Königreich, die OCR-Tools evaluieren, ist die entscheidende Frage nicht nur „kann es Belege lesen", sondern „funktioniert das Ausgabeformat mit MTD-kompatibler Buchhaltungssoftware wie Xero, QuickBooks, FreeAgent oder Sage". Wenn das OCR-Tool Daten exportiert, die Ihre MTD-kompatible Software nicht über eine digitale Verbindung importieren kann, schaffen Sie eine Compliance-Lücke.
Deutschland — GoBD: Maschinenlesbarkeit und die 10-Tage-Regel
Die deutsche GoBD (Grundsätze zur ordnungsmäßigen Führung und Aufbewahrung von Büchern, Aufzeichnungen und Unterlagen in elektronischer Form) — überarbeitet durch das BMF-Schreiben vom 28. November 2019 — legt die strengsten Standards für die digitale Dokumentenverwaltung der drei Rahmenwerke fest. Die Überarbeitung von 2019 erlaubt ausdrücklich das „ersetzende Scannen" — die Digitalisierung von Papierdokumenten mit anschließender Vernichtung der Originale — sofern bestimmte technische und verfahrenstechnische Bedingungen erfüllt sind.
Die für OCR in der Buchhaltung relevantesten Anforderungen:
- Zeitgerecht: Dokumente müssen innerhalb von 10 Werktagen nach Eingang erfasst werden. Bargeschäfte müssen täglich erfasst werden. Das Sammeln von Belegen für die Monatsend-Stapeldigitalisierung wird bei einer Betriebsprüfung als nicht zeitgerecht beanstandet.
- Maschinelle Auswertbarkeit: Digitale Aufzeichnungen müssen in Formaten vorliegen, die eine automatisierte Auswertung durch Steuerbehörden mit Prüfwerkzeugen wie IDEA ermöglichen. Die ausschließliche Speicherung von Rechnungen als flache Bildscans (TIFF, JPEG) ohne begleitende strukturierte Daten verstößt gegen diesen Grundsatz — das Archiv muss programmatisch durchsuchbar, sortierbar und referenzierbar sein.
- Aufbewahrungsfrist: 10 Jahre für steuerrelevante Dokumente. Die Aufbewahrungsfrist beginnt am Ende des Kalenderjahres, in dem das Dokument erstellt wurde.
- Bildqualität: Mindestens 300 DPI für Dokumente mit 10-12 pt Schrift, 400-600 DPI für Dokumente mit kleiner Schrift oder Thermodruck. Für Dokumente, bei denen Stempel, Unterschriften oder Logodetails relevant sind, Farbe oder Graustufen — nicht Schwarz-Weiß.
- Archivformate: PDF/A oder TIFF. JPEG allein gilt nicht als revisionssicher, da es keine Prüfpfad-Integration bietet und bei erneuter Komprimierung an Qualität verliert.
Für deutsche Buchhaltungsteams bedeutet dies, dass die OCR-Ausgabe strukturierte Datenfelder neben dem archivierten Dokumentbild enthalten muss — und der Workflow Dokumente innerhalb von 10 Tagen erfassen und digitalisieren muss. Die GoBD-Anforderung der Maschinenlesbarkeit bedeutet, dass Excel- oder CSV-Ausgabe mit Quellverweisen tatsächlich einen stärkeren Compliance-Nachweis darstellt als ein flaches Bildarchiv. Eine vollständige Anleitung finden Sie unter der GoBD-konformen Dokumentendigitalisierungs-Anleitung.
Wichtige Felder für die Extraktion über Dokumenttypen hinweg
Buchhaltungsteams benötigen ein konsistentes Extraktionsschema – dieselben Feldnamen und Datentypen – über alle fünf Dokumenttypen hinweg. Dies ermöglicht Batch-Verarbeitung und ERP-Import: Wenn jedes Dokument unabhängig vom Format dieselbe Spaltenstruktur erzeugt, ist die Integration nach der Extraktion eine einfache Zuordnungsübung und keine mühsame Datenaufbereitung pro Dokument. Die folgende Tabelle zeigt die kritischen Felder für jeden Dokumenttyp im Buchhaltungskontext.
| Dokumenttyp | Kopffelder | Positionen-/Detailfelder | Compliance-Felder |
|---|---|---|---|
| Rechnung | Rechnungsnr., Datum, Fälligkeitsdatum, Lieferantenname, Bestellnr., Zwischensumme, Steuern, Gesamtbetrag, Währung | Beschreibung, Menge, Einzelpreis, Positionssumme, SKU, Steuersatz | USt-IdNr., Lieferanten-EIN, Steuerregistrierungsnr. |
| Beleg | Lieferantenname, Datum, Gesamtbetrag, Zahlungsmethode, Kategorie | Artikelbeschreibung, Menge, Einzelpreis, Positionssumme | Geschäftszweck-Vermerk, Steuerkategorie (Verpflegung/Reise/Büro) |
| Kontoauszug | Kontonr., Auszugszeitraum, Anfangsbestand, Endbestand | Transaktionsdatum, Beschreibung, Referenz, Soll, Haben, Laufender Saldo | N/V – Kontoauszüge sind Belegdokumente |
| W-2 | Arbeitgeber-EIN, Arbeitgebername, Arbeitnehmer-SSN, Arbeitnehmername | Box 1–14 Löhne, Box 2 Bundessteuer, Box 3-6 SS/Medicare, Box 12-14 Codes | EIN muss mit IRS-Unterlagen übereinstimmen; Staat-EIN |
| 1099-NEC/MISC | Zahler-EIN, Zahlername, Empfänger-TIN, Empfängername | Box 1/Box 7 (Nichtangestelltenvergütung), Box 3/4, einbehaltene Bundessteuer | Empfänger-TIN muss gegen die IRS-Datenbank validiert werden |
| Bestellung | Bestellnr., Lieferantenname, Ausstellungsdatum, Gesamtbetrag, Währung | Artikelbeschreibung, bestellte Menge, Einzelpreis, Positionssumme, Lieferdatum | N/V – Bestellungen sind interne Genehmigungsdokumente |
Für die meisten Buchhaltungsteams ist die praktische Empfehlung, mit den Kopffeldern für jeden Dokumenttyp zu beginnen – diese decken 80 % des Datenerfassungsaufwands ab. Fügen Sie die Positionsextraktion hinzu, sobald der Kopffeld-Workflow zuverlässig läuft. Eine Ausnahme bilden Kontoauszüge: Die Kopffelder (Kontonummer, Zeitraum, Anfangs-/Endbestand) sind für den Abgleich wichtig, aber der eigentliche Wert liegt in den Transaktionszeilen, die das Äquivalent zu Positionen bei Kontoauszügen darstellen.
Dateien werden sicher verarbeitet und nicht gespeichert.
So wählen Sie OCR für Ihren Buchhaltungs-Stack
Die Auswahl eines OCR-Tools für die Buchhaltung hängt von fünf Kriterien ab, geordnet nach ihrer Auswirkung auf den täglichen Arbeitsablauf. Die Marketing-Behauptungen des Anbieters über „99 % Genauigkeit" sind weniger wichtig als die Frage, ob sich das Tool in Ihr bestehendes Buchhaltungssystem integrieren lässt, ohne eine neue Datenpipeline zu schaffen, die Sie warten müssen.
1. Buchhaltungssoftware-Integration – nicht verhandelbar
Die beste Extraktion der Welt erzeugt keinen Wert, wenn die Ausgabe nicht automatisch Ihr Buchhaltungssystem erreicht. Die Integrationsanforderung ist nicht „kann es CSV exportieren" – jedes Tool kann CSV exportieren. Die Frage ist, ob das Tool über eine native Verbindung zu Ihrer Buchhaltungsplattform verfügt, die extrahierte Daten direkt in Ihre Lieferantenstammdaten, Ihren Kontenplan und Ihre Transaktionswarteschlange sendet.
Für QuickBooks Online und Xero – die beiden am weitesten verbreiteten Buchhaltungsplattformen für kleine und mittlere Unternehmen – ist die Integrationslandschaft ausgereift. Tools mit dedizierten Konnektoren können extrahierte Felder zuordnen (Lieferantenname → QuickBooks-Lieferantendatensatz, Kontonummer → Kontenplan-Eintrag, Steuerbetrag → Steuercode-Zuordnung) und Daten direkt zur Prüfung und Buchung in die Buchhaltungswarteschlange einspielen. Dies eliminiert den Download-und-Import-Schritt, der Datenqualitätsprobleme verursacht und erfordert, dass jemand die exportierte Datei öffnet, die Spaltenausrichtung prüft und Formatabweichungen korrigiert, bevor die Daten im System landen.
Wenn Sie eine weniger verbreitete Buchhaltungsplattform verwenden, bestätigen Sie, dass die API des OCR-Tools strukturiertes JSON ausgeben kann, das Ihre Plattform akzeptiert, oder dass ein Middleware-Konnektor (Zapier, Make) die Lücke ohne individuelle Entwicklung überbrückt. Für einen umfassenden Vergleich von Extraktionstools nach technischem Ansatz und Anwendungsfall siehe die beste OCR-Software für Buchhaltungskanzleien im Jahr 2026.
2. Ohne Vorlage – eliminiert die versteckten Wartungskosten
Vorlagenbasierte OCR verursacht unsichtbare Kosten, die mit der Anzahl Ihrer Lieferanten wachsen: die Vorlagenwartung. Jedes neue Lieferantenformat erfordert eine neue Vorlage. Jede Formatänderung eines Lieferanten bricht die bestehende Vorlage. Bei 50 Lieferanten wird die Vorlagenwartung zu einem Teilzeitjob. Bei 200 Lieferanten wird sie zu einer Vollzeitstelle. Die Alternative – KI-Extraktion ohne Vorlage – verwendet dieselben Felddefinitionen für jedes Lieferantenformat, jede Sprache, jedes Layout. Der Feldname „Invoice Number“ funktioniert, ob die Bezeichnung „Invoice No.“ auf dem Dokument eines Lieferanten oder „Rechnungsnummer“ auf dem eines anderen steht. Dies ist das wichtigste Kriterium für jedes Buchhaltungsteam, das mehr als 20 Lieferantenformate verarbeitet.
3. Batch-Verarbeitung – ein Durchlauf, eine Tabelle
Die Verarbeitung eines Dokuments nach dem anderen entspricht nicht buchhaltungsgerechtem Arbeiten. Das Tool muss mehrere Dateien in einem einzigen Upload akzeptieren – mit einer Mischung aus PDFs, JPGs und PNGs – alle mit derselben Extraktionskonfiguration verarbeiten und eine einzige zusammengeführte Datei ausgeben, in der jedes Quelldokument einer Zeile entspricht (oder einem Zeilensatz für Positionen). Jede Zeile muss einen Verweis auf die Quelldatei enthalten, damit Sie zum Originaldokument zurückverfolgen können, ohne Zeilen manuell Dateien zuordnen zu müssen.
4. Positionsextraktion – Tabellen sind der schwierige Teil
Die reine Kopfdaten-Extraktion deckt 30–50 % der Daten einer Rechnung ab. Positionen – Mengen, Einzelpreise, Beschreibungen, Positionssummen – sind der Bereich, in dem der Arbeitsaufwand liegt. Das Tool muss mehrseitige Tabellen verarbeiten können (viele Lieferantenrechnungen erstrecken sich über 2–4 Seiten), variable Spaltenanzahlen (manche Bestellungen haben 6 Spalten, andere 8) und unregelmäßige Spaltenreihenfolgen (Beschreibung vor Menge vs. Menge vor Beschreibung). Tools, die Positionen aus mehrseitigen Rechnungen mit variablem Format nicht zuverlässig extrahieren können, lassen den zeitaufwendigsten Teil der Datenerfassung auf Ihrem Team liegen.
5. Konformitätsgerechte Ausgabe – Aufbewahrung des Quelldokuments
Wie im Abschnitt zur Konformität oben erläutert, muss die OCR-Ausgabe für die Buchhaltung die extrahierten Daten und einen Verweis auf das Quelldokument enthalten. Das Tool muss entweder die Originaldatei zusammen mit den Extraktionsergebnissen speichern oder ein herunterladbares Archiv bereitstellen, das beides enthält. Jedes Tool, das Ihnen die extrahierte Excel-Datei liefert und das Quelldokument nicht aufbewahrt, schafft eine Konformitätslücke. Dies ist besonders wichtig für die MTD-Anforderung im Vereinigten Königreich (Quelldokumente müssen mit digitalen Aufzeichnungen verknüpft sein) und die GoBD-Rückverfolgbarkeitsanforderung (Nachvollziehbarkeit – jeder Datenpunkt muss bis zu seinem Originaldokument zurückverfolgbar sein).
FAQ
Funktioniert OCR mit Handyfotos von Belegen für die Spesenabrechnung?
Ja, KI-gestützte OCR funktioniert mit Handyfotos – das ist einer ihrer entscheidenden Vorteile gegenüber herkömmlichem Scannen. Allerdings beeinflusst die Fotoqualität die Genauigkeit direkt. Für eine zuverlässige Extraktion aus Handyfotos: bei guter Beleuchtung aufnehmen, das Handy parallel zum Beleg halten (um perspektivische Verzerrungen zu vermeiden), alle vier Ecken einschließen und Blitz auf glänzendem Papier vermeiden. Belege aus Thermopapier (die mit der Zeit verblassen) sollten sofort fotografiert werden – selbst ein paar Wochen Wartezeit können sie unleserlich machen. Unter angemessenen Bedingungen liegt die Feldgenauigkeit bei Belegfotos bei 85–95 % für gedruckten Text, bei Handschrift niedriger.
Kann ich die OCR-Ausgabe direkt in QuickBooks Online oder Xero integrieren?
Ja, sofern das OCR-Tool eine direkte Integration unterstützt. QuickBooks Online und Xero verfügen beide über APIs und App-Marketplace-Ökosysteme, die es Extraktionstools ermöglichen, Rechnungen, Belege und Spesendaten direkt in Ihre Buchhaltungswarteschlange zu übertragen. Bei der Bewertung der Integrationsunterstützung sollten Sie auf Folgendes achten: (1) Feldzuordnung – ordnet das Tool extrahierte Lieferantennamen Ihrer Lieferantenliste und extrahierte Kontenbeschreibungen Ihrem Kontenplan zu? (2) Buchungsformat – erstellt es Entwurfsbelege zur Überprüfung oder bucht es direkt in das Hauptbuch? (3) Anlagenverknüpfung – wird das Quelldokument für Prüfzwecke an die Transaktion in Ihrer Buchhaltungssoftware angehängt? Wenn dem Tool die direkte Integration fehlt, ist der Ausweg der CSV-Export mit anschließendem manuellen Import, was 2–5 Minuten pro Batch dauert, aber mit jeder Buchhaltungsplattform funktioniert.
Muss ich für jedes Lieferanten-Rechnungsformat Vorlagen erstellen?
Nicht, wenn Sie KI-gestützte Extraktion verwenden. Das ist der entscheidende Unterschied zwischen moderner KI-Extraktion und herkömmlicher vorlagenbasierter OCR. KI-gestützte Tools lesen Rechnungen, indem sie verstehen, was jedes Feld semantisch bedeutet – „Rechnungsnummer" bedeutet die Nummer, die diese Transaktion für den Lieferanten identifiziert, egal wo sie auf der Seite erscheint. Sie definieren die Felder einmal (z. B. „Rechnungsnummer", „Gesamtbetrag", „Steuerbetrag") und dieselben Definitionen funktionieren über alle Lieferantenformate hinweg, einschließlich solcher, die Sie noch nie gesehen haben. Vorlagenbasierte Tools erfordern eine separate Vorlage pro Lieferantenformat. Wenn Ihr Buchhaltungsteam Rechnungen von 50+ Lieferanten verarbeitet, ist die Extraktion ohne Vorlage die einzige praktikable Option – der Wartungsaufwand für die Verwaltung von 50+ Vorlagen übersteigt die Arbeitskosten der manuellen Erfassung.
Wie stelle ich sicher, dass meine digitalen Aufzeichnungen einer IRS-Prüfung standhalten?
IRS Revenue Procedure 97-22 legt drei praktische Bedingungen fest: (1) Die digitale Kopie muss eine vollständige und genaue Wiedergabe des Originals sein – jedes Feld auf dem Originalbeleg oder der Originalrechnung muss in der digitalen Version lesbar sein; (2) Sie müssen über ein Indexierungssystem verfügen, das den Abruf ermöglicht – Sie sollten in der Lage sein, ein bestimmtes Dokument innerhalb angemessener Zeit zu finden; (3) Das System muss auf Anfrage lesbare Kopien reproduzieren – Standardbildformate (JPEG, PNG, PDF) sind geeignet; proprietäre Formate, die ohne spezielle Software nicht geöffnet werden können, sind es nicht. In der Praxis bedeutet ein konformes System: Bewahren Sie das Originaldokumentbild (Scan oder Foto) auf, speichern Sie es zusammen mit den extrahierten Daten, indexieren Sie es nach Lieferant/Datum/Betrag und können Sie es auf Verlangen des Prüfers vorlegen. Die Aufbewahrung des Originalbilds zusammen mit Ihrer extrahierten Excel-Ausgabe – mit einer Referenz, die jede Zeile mit ihrer Quelldatei verknüpft – ist der unkomplizierteste Weg, alle drei Bedingungen zu erfüllen.
Lohnt sich OCR für die Buchhaltung für ein kleines Team, das weniger als 100 Rechnungen pro Monat verarbeitet?
Ja – aber die Marge ist schmaler als bei Teams mit hohem Volumen. Bei 100 Rechnungen pro Monat beträgt der manuelle Dateneingabeaufwand etwa 5–8 Stunden pro Monat (3–5 Minuten pro Rechnung für Kopffelder). Ein kostengünstiges KI-Extraktionsabonnement (20–50 $/Monat) eliminiert diese Stunden. Die Rechnung geht auf, wenn Ihr effektiver Stundensatz für die Dateneingabe über 15 $/Stunde liegt – was für jedes Unternehmen gilt, das einen Mitarbeiter oder die eigene Zeit bezahlt. Der Haken ist die Einrichtungszeit: Sie müssen anfangs 30–60 Minuten investieren, um Ihre Extraktionsfelder zu konfigurieren, an Beispielrechnungen zu testen und die Integration mit Ihrer Buchhaltungssoftware einzurichten. Unter 30 Rechnungen pro Monat rechtfertigt der Einrichtungsaufwand möglicherweise nicht die Einsparungen – obwohl es sich während der Steuersaison oder beim Jahresabschluss lohnt, wenn das Volumen ansteigt. Für eine umfassende Übersicht siehe die beste OCR-Software für 2026, bewertet nach Anwendungsfall.
Kann ein einziges OCR-Tool sowohl Rechnungen als auch Kontoauszüge verarbeiten?
Ja – aber das Tool muss die spezifischen Extraktionsanforderungen jedes Dokumenttyps unterstützen. Einige OCR-Tools sind auf Rechnungen spezialisiert und können mehrseitige Kontoauszugstabellen nicht verarbeiten, ohne Zeilen über Seitenumbrüche hinweg zu brechen oder die Spalte mit dem laufenden Saldo falsch zu lesen. Wenn Sie ein Tool für gemischte Dokumenttypen bewerten, testen Sie es mit Ihren tatsächlichen Dokumenten – nicht mit Beispieldateien. Laden Sie einen mehrseitigen Kontoauszug hoch und prüfen Sie, dass: (1) alle Transaktionszeilen über Seitenumbrüche hinweg erfasst werden, (2) die Spalte mit dem laufenden Saldo korrekt gelesen und für die Abstimmungsprüfung verwendet werden kann, (3) Soll- und Habenbeträge sauber in die richtigen Spalten getrennt werden. Ein Tool, das diese Tests mit dem spezifischen Kontoauszugsformat Ihrer Bank besteht, funktioniert wahrscheinlich auch für Rechnungen und Belege. Für einen interaktiven Test siehe wie OCR-Software mit verschiedenen Dokumenttypen funktioniert.
Welche Mindestauflösung ist für eine zuverlässige OCR-Erfassung erforderlich?
Für gedruckten Text in Standardgröße (10-12 pt) ist 200 DPI das absolute Minimum für zuverlässige OCR, während 300 DPI der praktische Standard für gute Ergebnisse ist. Bei kleiner Schrift (8 pt oder kleiner), Thermopapier oder Dokumenten mit feinen Details werden 400-600 DPI empfohlen. Bei Handyfotos ist die Auflösung weniger wichtig als Beleuchtung und Fokus – ein 12-MP-Handyfoto mit guter Beleuchtung aus nächster Nähe liefert bessere OCR-Ergebnisse als ein 300-DPI-Scan aus einem ungünstigen Winkel. Die GoBD-Norm (Deutschland) verlangt ausdrücklich mindestens 300 DPI für Standarddokumente und 400-600 DPI für Dokumente mit kleiner Schrift, in Farbe oder Graustufen. Wenn Sie Papierdokumente für Archivierungszwecke scannen, scannen Sie mit 300 DPI in Farbe – dies erzeugt größere Dateien, gewährleistet aber jahrelange Lesbarkeit, insbesondere bei Thermopapier, das mit der Zeit verblasst.