OCR pour la comptabilité : un guide complet
sur le traitement des factures, reçus et relevés bancaires
L'OCR pour la comptabilité consiste à utiliser la reconnaissance automatisée de texte et l'extraction basée sur l'IA pour convertir des documents financiers — factures, reçus, relevés bancaires, bons de commande, formulaires fiscaux — en données structurées qui alimentent directement votre système comptable. Bien mis en œuvre, il élimine la saisie manuelle des données, réduit le temps de rapprochement et crée des enregistrements numériques prêts pour l'audit. Mais « l'OCR pour la comptabilité » n'est pas une technologie unique. Il couvre trois approches d'extraction différentes, cinq types de documents aux exigences de traitement distinctes, et un ensemble de cadres réglementaires — IRS Rev. Proc. 97-22 aux États-Unis, Making Tax Digital au Royaume-Uni, GoBD en Allemagne — qui déterminent si vos enregistrements numériques résistent à l'examen d'un audit. Ce guide aborde tous ces aspects, dans l'ordre où une équipe comptable les rencontre réellement : d'abord ce que l'OCR signifie en pratique, puis chaque type de document, les règles de conformité applicables, et enfin comment choisir le bon outil pour votre pile comptable.
Points clés à retenir
- L'OCR basé sur des modèles ne met pas fin à la saisie de données — il la rebaptise maintenance de modèles, et avec 50 fournisseurs, cette maintenance devient un poste à temps partiel.
- La saisie manuelle des données crée 2 à 5 erreurs pour 100 champs, chacune coûtant 10 $ à trouver et à corriger — ce qui signifie que 500 factures par mois cachent entre 2 500 $ et 12 500 $ de travail de correction invisible.
- L'extraction basée sur l'IA lit les factures selon la signification des champs, et non leur position sur la page — la même configuration fonctionne avec tous les formats de fournisseurs et place les données structurées dans QuickBooks ou Xero avec des liens vers les documents sources prêts pour l'audit.
Ce que l'OCR signifie réellement pour la comptabilité
Dans le contexte comptable, l'OCR ne consiste pas à transformer du texte scanné en PDF consultables. Il s'agit de convertir le contenu des documents en données structurées et importables — des lignes et des colonnes qui correspondent à votre plan comptable, à vos enregistrements de fournisseurs et à votre historique de transactions.
La capacité pertinente n'est pas « cet outil peut-il lire le texte » — c'est « cet outil peut-il extraire le numéro de facture, le faire correspondre à un bon de commande, formater la date pour mon système comptable et produire le résultat aux côtés de 99 autres factures dans un seul fichier Excel ».
Cette distinction est importante car la technologie OCR traditionnelle — qui existe depuis les années 1990 — peut lire les caractères d'un document mais ne peut pas comprendre leur signification. Elle reconnaîtra correctement la chaîne « 1 247,83 » sur une page, mais elle ne saura pas s'il s'agit du total de la facture, du montant de la taxe ou d'un sous-total d'article de ligne, à moins que vous ne lui indiquiez exactement où chercher sur la page. Pour les équipes comptables qui reçoivent des factures de dizaines ou de centaines de fournisseurs, chacun avec une mise en page différente, cette étape « indiquer où chercher » est le goulot d'étranglement qui a maintenu la saisie manuelle des données en vie malgré des décennies de disponibilité de l'OCR. Pour comprendre le changement fondamental entre la reconnaissance de caractères et la compréhension de documents, voir ce qu'est l'OCR par IA et en quoi il diffère de l'OCR traditionnel.
Le changement qui a transformé cela au cours des trois dernières années est l'extraction sémantique basée sur l'IA — une approche technique fondamentalement différente. Au lieu de rechercher des caractères à des coordonnées fixes, un modèle de langage visuel lit le document comme le ferait un humain : il voit la mise en page, reconnaît la relation entre les étiquettes et les valeurs, et extrait les champs en fonction de leur signification, et non de leur position. Cela signifie que la même configuration d'extraction fonctionne que votre fournisseur envoie une facture d'une page ou un PDF de quatre pages, que le total apparaisse dans le coin supérieur droit ou en bas à gauche, et que le document soit un PDF propre ou une photo de téléphone d'un reçu thermique.
Pourquoi la comptabilité a besoin de l'OCR — le cas chiffré
L'argument en faveur de l'OCR en comptabilité ne porte pas sur la technologie. Il porte sur la répartition du travail. Chaque heure qu'un employé de comptabilité fournisseurs passe à saisir des numéros de facture et des descriptions de lignes dans un tableur est une heure qu'il ne consacre pas à l'analyse des écarts, à la gestion des relations fournisseurs ou à la prévision des flux de trésorerie. Les chiffres qui quantifient ce compromis sont bien établis dans de multiples références sectorielles.
Une facture unique saisie manuellement prend 3 à 5 minutes pour les seuls champs d'en-tête — nom du fournisseur, numéro de facture, date, numéro de bon de commande, total. Ajoutez l'extraction des lignes et le temps par facture double. À 500 factures par mois, cela représente environ 40 heures de pure saisie de données — une semaine de travail complète chaque mois consacrée à la transcription. Au coût chargé moyen d'un employé de comptabilité fournisseurs d'environ $25 de l'heure, cela représente $1,000 par semaine, soit $52,000 par an, pour un travail qui n'apporte aucune valeur analytique. Le taux d'erreur aggrave le problème : la transcription manuelle produit régulièrement 2 à 5 erreurs pour 100 champs saisis, et chaque erreur coûte en moyenne $10 à détecter et à corriger, selon les références financières d'APQC. Un seul chiffre inversé sur une facture de $12,000 — $12,000 saisi comme $21,000 — crée un problème de rapprochement qui prend plus de temps à trouver qu'il n'en a fallu pour saisir le nombre au départ.
La vision structurelle que la plupart des équipes comptables négligent : le coût de la saisie manuelle des données n'est pas le temps de frappe. C'est le temps de nettoyage ensuite. Chaque erreur introduite lors de la saisie doit être trouvée — et la trouver coûte plus cher que de la saisir correctement. L'OCR élimine la source d'erreur, pas seulement le travail de frappe.
Côté sortie, l'extraction automatisée traite une page en 5 à 10 secondes — environ 18 fois plus vite que la saisie manuelle — avec une précision au niveau des champs sur texte imprimé qui dépasse régulièrement 97 %. Le compromis n'est pas la vitesse contre la précision. C'est la vitesse et la précision contre la même équipe qui fait de la saisie de données trois jours par mois. Pour une analyse plus détaillée des attentes de précision par type de document et une méthodologie que vous pouvez appliquer à vos propres documents, consultez le guide de précision au niveau des champs pour l'OCR.
Cinq types de documents que l'OCR gère en comptabilité
Les équipes comptables traitent bien plus que des factures. Une configuration OCR complète doit gérer l'ensemble des documents qui arrivent dans votre boîte de réception partagée, votre courrier physique et vos notes de frais. Chaque type de document présente des défis d'extraction différents — et l'outil que vous choisissez doit tous les gérer avec la même configuration, sans réglage distinct par type.
1. Factures — la charge de travail principale
Les factures représentent l'essentiel du volume traité par l'OCR en comptabilité. La cible d'extraction standard comprend les champs d'en-tête — nom du fournisseur, numéro de facture, date, date d'échéance, numéro de bon de commande, montant total, montant de la taxe, devise — ainsi que les lignes d'article, qui sont plus difficiles à extraire car les tableaux varient en nombre de colonnes, en ordre des colonnes et en répartition sur les pages selon les fournisseurs. Un outil incapable de gérer l'extraction des lignes d'article sur des factures multipages à structures de colonnes variables n'est pas prêt pour la production en comptabilité fournisseurs. Pour un traitement complet de l'extraction spécifique aux factures, consultez le guide complet sur l'extraction de données de factures.
2. Reçus — le cauchemar des formats
Les reçus arrivent dans plus de formats que tout autre document comptable. Papier thermique, photos de téléphone, PDF par e-mail, tickets de station-service scannés de la taille d'un marque-page, folios de restaurant multipages. La qualité d'impression va de nette à quasi illisible (le papier thermique s'estompe en 6 à 12 mois). Contrairement aux factures, les reçus suivent rarement une mise en page standard — un reçu de taxi et un reçu de quincaillerie ne partagent aucun schéma structurel au-delà du « total en bas ». L'IRS exige que les reçus numériques conservent le nom du fournisseur, la date, chaque ligne d'article, le total et le mode de paiement — pas seulement le total. Cela signifie que l'OCR pour les reçus doit capturer le détail des lignes d'article sur des documents qui n'ont jamais été conçus pour la lecture machine, et doit fonctionner avec la qualité photo qu'un employé de terrain produit en trois secondes avec un téléphone.
3. Relevés bancaires — structure multipage avec lignes répétitives
Les relevés bancaires se distinguent structurellement des factures et des reçus. Un seul PDF peut s'étendre sur 20 pages, chacune contenant un tableau de transactions répétitif avec date, description, numéro de référence, débit, crédit et solde courant. L'exigence d'extraction ne consiste pas seulement à capturer les lignes — il s'agit de garantir que les données des relevés multipages fusionnent en un seul tableau continu, sans lignes en double (fréquentes aux limites de pages) ni lignes manquantes. Les formats de relevés varient considérablement d'une banque à l'autre : certains utilisent des mises en page à deux colonnes (débits à gauche, crédits à droite), d'autres une colonne unique avec indicateurs de type de transaction, et d'autres combinent les deux dans le même document selon le type de compte. Pour un traitement ciblé, voir à quoi ressemble l'extraction de relevés bancaires pour les équipes comptables.
4. Formulaires fiscaux — W-2 et 1099
Les formulaires W-2 et 1099 sont saisonniers mais à fort enjeu. La plupart des équipes comptables les traitent par vagues — de janvier à avril pour les entreprises américaines — et les exigences de précision sont absolues : un SSN ou EIN erroné sur un 1099 génère un avis CP2100 de l'IRS, et la réémission de formulaires corrigés après la date limite de dépôt du 31 janvier entraîne des pénalités par formulaire qui augmentent jusqu'en mars. Le défi de l'extraction tient au fait que les formulaires fiscaux utilisent une petite police (8-10 pt dans des mises en page encadrées), contiennent des champs qui se ressemblent mais ont des significations différentes (case 1 salaires vs case 3 salaires de sécurité sociale vs case 5 salaires Medicare), et sont souvent imprimés sur des formulaires multipartites qui produisent une mauvaise qualité de numérisation. La plupart des outils OCR traitent tous les formulaires fiscaux comme « tout lire » — mais le champ qui importe pour la déclaration 1099-NEC est la case 7 (rémunération des non-employés), et le champ qui importe pour le rapprochement de la paie W-2 est la case 1 (salaires, pourboires, autres rémunérations). Les outils d'extraction qui ne distinguent pas ces champs sémantiquement similaires créent des erreurs de déclaration en aval qui apparaissent des mois après le traitement.
5. Bons de commande — le volet correspondance du rapprochement à trois volets
Les bons de commande (BC) sont les documents comptables les moins prioritaires pour l'OCR, mais ils sont essentiels aux flux de rapprochement à trois volets (BC + bon de réception + facture). Les BC définissent l'engagement de dépense, les quantités commandées et les prix convenus auxquels la facture doit correspondre. L'extraction des données des BC — numéro de BC, descriptions des articles, quantités commandées, prix unitaires, dates de livraison — permet un rapprochement automatisé : le système compare les lignes d'articles du BC à celles de la facture et signale les écarts sans qu'un humain n'ait à recouper deux documents papier. Sans extraction des BC, le rapprochement reste une tâche manuelle, quel que soit le niveau de performance de l'extraction des factures.
Le vrai défi — les factures fournisseurs multi-formats
Demandez à n'importe quelle équipe AP ce qui rend la saisie de données difficile, et la réponse est toujours la même : « Les documents proviennent de centaines de fournisseurs différents, ils sont donc tous formatés différemment. » Cette phrase unique — répétée sur les fils Reddit de r/Accounting, r/Entrepreneur et r/smallbusiness — résume le problème structurel que la plupart des outils OCR ne parviennent pas à résoudre.
Le problème n'est pas que les factures aient des mises en page différentes. C'est que l'OCR traditionnel exige de traiter chaque mise en page comme une configuration distincte. Générez un modèle pour la facture d'une page du fournisseur A. Créez un autre modèle pour la facture de deux pages du fournisseur B avec les lignes d'articles en deuxième page. Créez un troisième modèle pour la facture du fournisseur C qui place le total en bas à gauche au lieu d'en haut à droite. Multipliez maintenant par chaque fournisseur avec lequel vous travaillez — et à chaque fois qu'un fournisseur met à jour son logiciel de comptabilité et que la mise en page de ses factures change, le modèle casse.
Un utilisateur Reddit a décrit le point de rupture : « Je saisissais manuellement plus de 2 500 factures par mois. Toujours les mêmes champs : numéro de facture, date, fournisseur, totaux. C'était répétitif, lent, et je faisais des erreurs simplement à cause de la fatigue. Le point de rupture pour moi a été de saisir deux fois la même facture par erreur, puis de passer des heures à essayer de trouver où les chiffres ne correspondaient plus. »
Un autre utilisateur, évaluant des solutions OCR pour une équipe AP traitant plusieurs formats : « Nous avons examiné certaines solutions OCR, mais elles exigent souvent une formation approfondie pour chaque nouveau modèle. Quelqu'un utilise-t-il un outil capable d'extraire de manière fiable les données des lignes d'articles de documents variés sans avoir à créer un analyseur personnalisé pour chaque fournisseur ? »
C'est la distinction fondamentale entre l'OCR traditionnel et l'extraction basée sur l'IA. Les outils basés sur des modèles traitent chaque format fournisseur comme un problème distinct. L'extraction par IA traite toutes les factures comme le même problème : « trouver le numéro de facture, trouver le total, trouver les lignes d'articles » — car l'IA comprend ce qu'est une facture, quelle que soit sa mise en page spécifique. Pour une comparaison détaillée de ces deux approches architecturales, voir OCR vs extraction par IA : laquelle convient à votre mix documentaire.
OCR traditionnel vs extraction basée sur l'IA
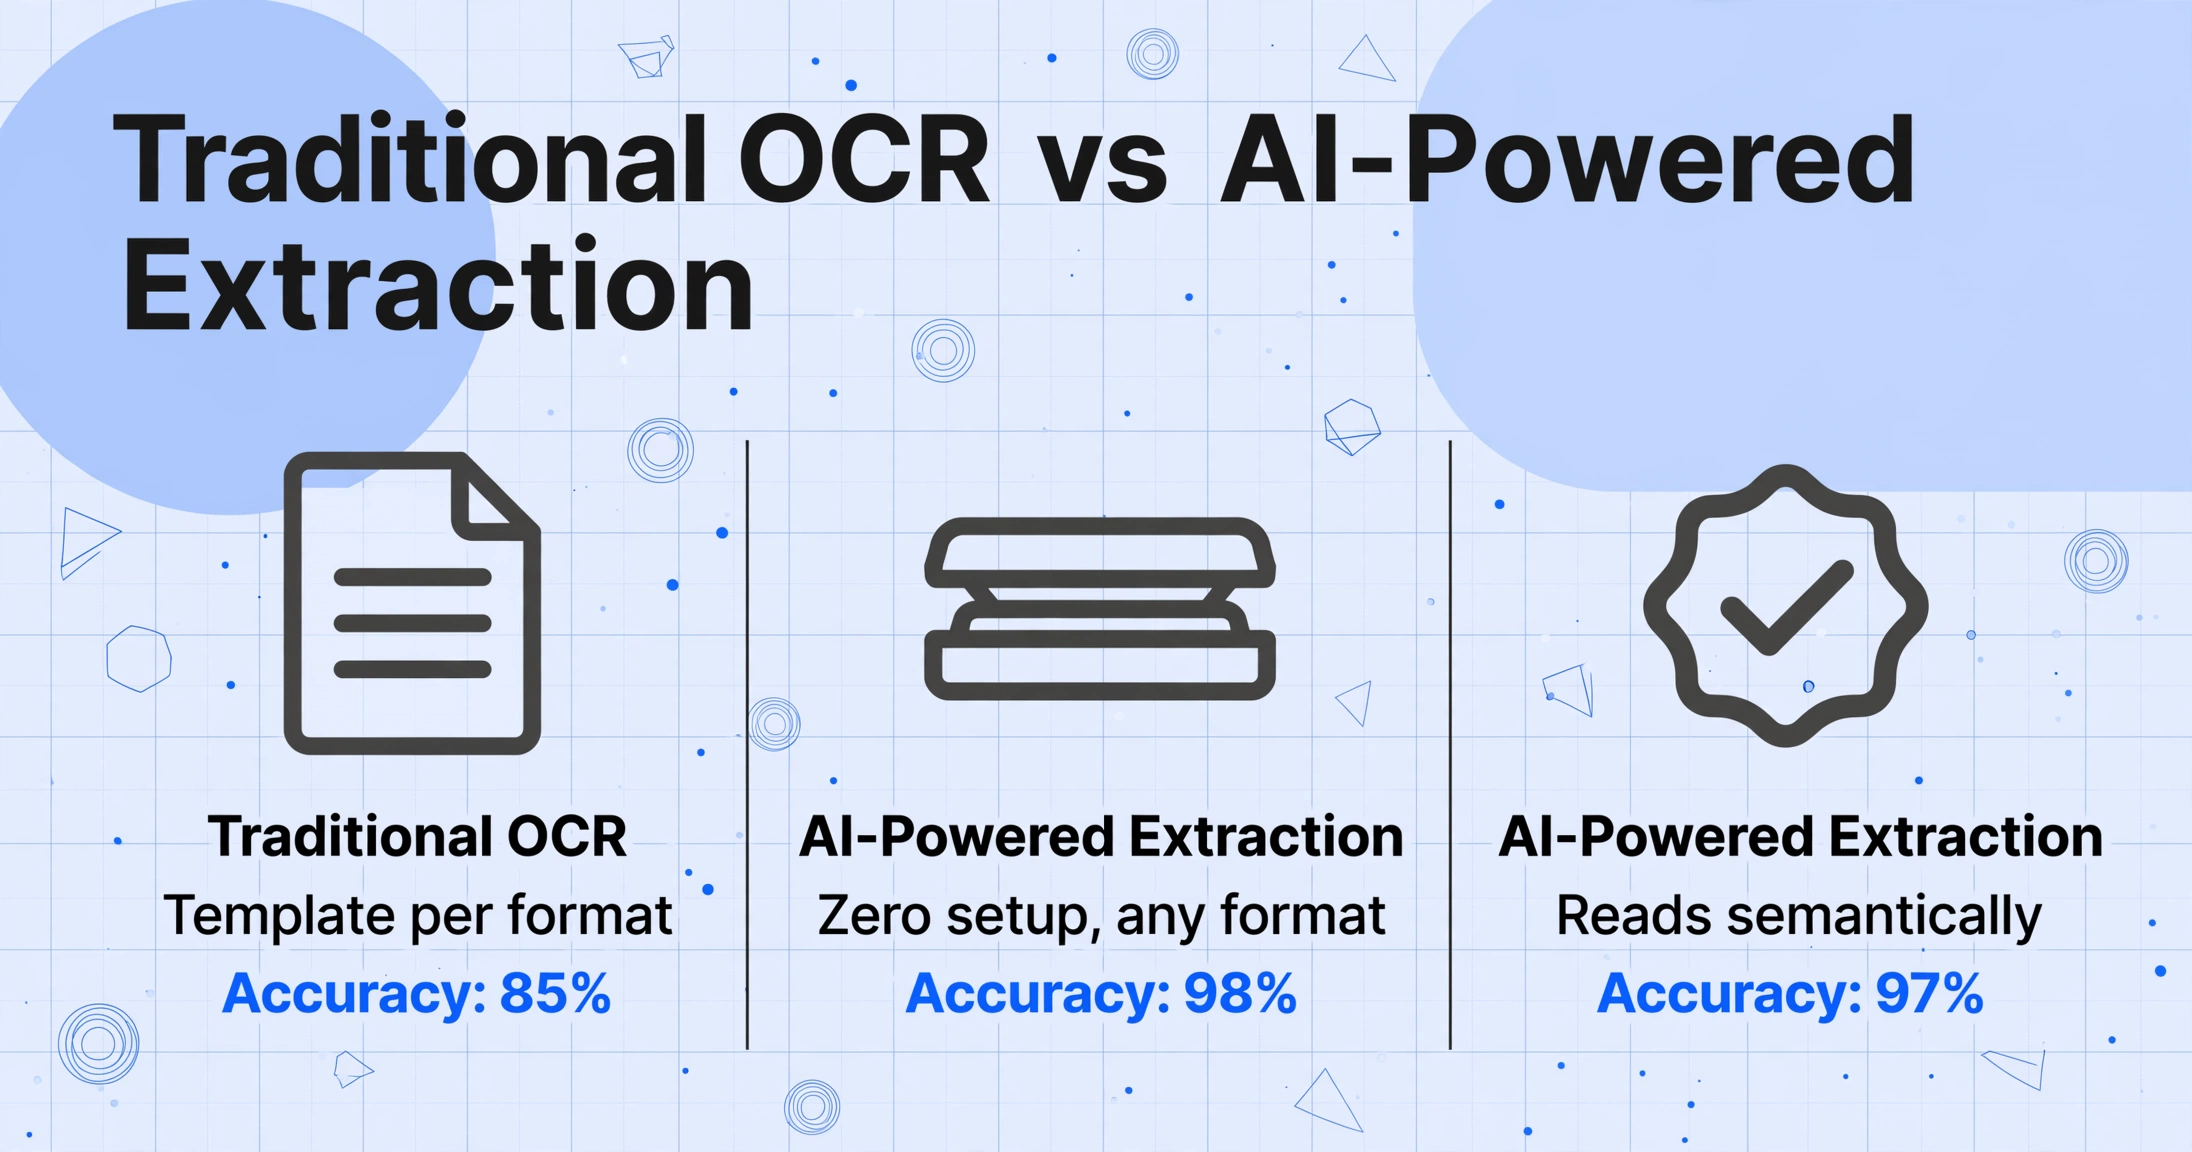
La différence entre l'OCR traditionnel et l'extraction basée sur l'IA n'est pas une question de degré — c'est une différence dans ce que chaque technologie peut accomplir. Comprendre cette distinction est essentiel pour évaluer tout outil destiné à un usage comptable.
| Capacité | OCR traditionnel | Extraction basée sur l'IA |
|---|---|---|
| Configuration par format de fournisseur | Un modèle par format | Aucune — la même configuration fonctionne pour tout format |
| Quand le fournisseur change la mise en page | Le modèle casse — reconstruction requise | Aucun changement — l'IA lit sémantiquement |
| Écriture manuscrite sur les factures | <50% de précision | 85-95% avec une bonne qualité d'image |
| Tableaux de documents multipages | Casse à la page 2 | Lit au-delà des limites de page |
| Tableau avec colonnes variables | Désalignement des colonnes | S'adapte au nombre/à la structure des colonnes |
| Extraction de colonnes personnalisées | Nécessite le dessin de zones par champ | Saisissez le nom du champ — l'IA le localise |
| Colonnes calculées / calculs | Non pris en charge | Intégré — dérive les valeurs pendant l'extraction |
| Format de sortie | Fichier texte ou PDF consultable | Excel, CSV, JSON — structuré par champ |
Le tableau ci-dessus montre pourquoi la question « l'OCR est-il adapté à la comptabilité » est trompeuse. L'OCR traditionnel — utile pour rendre le texte consultable — est insuffisant pour les flux de travail comptables qui nécessitent des données structurées au niveau des champs. L'extraction basée sur l'IA, qui lit les documents en comprenant la signification de chaque champ, est la technologie qui élimine réellement la saisie de données. Pour une introduction plus approfondie sur son fonctionnement, voir ce qu'est l'OCR et comment l'IA l'a transformé.
Conformité — Trois cadres réglementaires que toute configuration OCR comptable doit respecter
L'OCR en comptabilité ne se résume pas à la rapidité. Il s'agit de créer des enregistrements numériques qui satisfont aux exigences des autorités fiscales lorsqu'elles demandent des documents. Trois cadres réglementaires — un américain, un britannique, un allemand — définissent ce que signifie concrètement une tenue de registres numériques conforme. Si votre configuration OCR comptable ne respecte pas ces exigences, elle ne produit pas de documents probants pour un audit.
États-Unis — IRS Revenue Procedure 97-22 : les enregistrements numériques comme originaux légaux
L'IRS accepte les documents stockés électroniquement en lieu et place des originaux papier — mais uniquement si votre système de stockage respecte les six conditions de la Revenue Procedure 97-22. En vertu de l'IRC Section 6001, chaque contribuable doit conserver des documents suffisants pour appuyer ses déclarations fiscales. La Rev. Proc. 97-22 définit les conditions précises dans lesquelles le stockage électronique satisfait à cette obligation.
Les trois exigences pratiques qui comptent pour la sortie OCR : (1) l'image électronique doit être une reproduction complète et exacte de l'original — chaque champ du document original doit être lisible dans la copie numérique ; (2) les documents doivent être indexés pour la recherche — vous devez pouvoir localiser un document spécifique dans un délai raisonnable ; (3) le système doit produire des copies lisibles sur demande — les formats propriétaires qui ne peuvent pas être ouverts sans un logiciel spécifique ne répondent pas à cette norme.
Pour l'OCR en comptabilité, cela signifie : votre outil d'extraction doit conserver le document original en parallèle des données extraites. La sortie Excel seule ne suffit pas — lors d'un audit, l'examinateur de l'IRS voudra voir le document source qui a produit chaque valeur extraite. Une configuration adéquate exporte les données extraites vers votre système comptable et conserve le PDF ou l'image d'origine dans une archive consultable avec un lien de référence vers la ligne extraite. Pour le détail complet de ce qui constitue un enregistrement numérique conforme de reçu ou de facture selon l'IRS, voir exigences de l'IRS pour les enregistrements numériques de reçus.
Royaume-Uni — Making Tax Digital : Rapports numériques trimestriels
À partir d'avril 2026, Making Tax Digital (MTD) pour l'auto-évaluation de l'impôt sur le revenu devient obligatoire pour les travailleurs indépendants et les propriétaires bailleurs dont le revenu combiné d'activité indépendante et de location dépasse 50 000 £. La phase 2 étend cette obligation à ceux qui gagnent plus de 30 000 £ en avril 2027, puis 20 000 £ en avril 2028. Pour les entreprises assujetties à la TVA, la MTD est déjà obligatoire depuis 2019.
Les exigences clés qui affectent l'OCR pour la comptabilité au Royaume-Uni :
- Les registres numériques doivent être tenus dans un logiciel compatible MTD. Vous ne pouvez pas accumuler des reçus papier toute l'année et les numériser en mars. Les registres doivent être créés et stockés numériquement dans un logiciel compatible fonctionnel — et les données doivent être transférables entre les systèmes via des « liens numériques » (le copier-coller ne suffit pas).
- Chaque transaction doit être enregistrée avec sa date, son montant et sa catégorie. Un OCR qui ne capture que le total d'un reçu est insuffisant — HMRC exige une granularité au niveau de la transaction dans vos registres numériques.
- Des mises à jour trimestrielles doivent être soumises à HMRC. Votre logiciel doit générer et soumettre des données récapitulatives tous les trois mois. Cela signifie que l'OCR n'est pas une activité ponctuelle en fin d'année fiscale — il doit être intégré à votre flux de travail comptable continu.
- Les entreprises distinctes doivent avoir des registres numériques distincts. Si vous gérez une entreprise de plomberie et possédez un bien locatif, vous devez tenir des registres numériques séparés — même si les deux sont déclarés sur la même déclaration finale.
Pour les équipes comptables britanniques qui évaluent les outils OCR, la question cruciale n'est pas seulement « peut-il lire les reçus » mais « le format de sortie fonctionne-t-il avec un logiciel comptable compatible MTD comme Xero, QuickBooks, FreeAgent ou Sage ». Si l'outil OCR exporte des données que votre logiciel compatible MTD ne peut pas importer via un lien numérique, vous créez une lacune de conformité.
Allemagne — GoBD : lisibilité machine et règle des 10 jours
La GoBD (Grundsätze zur ordnungsmäßigen Führung und Aufbewahrung von Büchern, Aufzeichnungen und Unterlagen in elektronischer Form) — révisée par la lettre du BMF du 28 novembre 2019 — impose les normes les plus strictes en matière de gestion documentaire numérique parmi les trois cadres. La révision de 2019 autorise explicitement l'« ersetzendes Scannen » (numérisation de remplacement) — la numérisation de documents papier suivie de la destruction des originaux — à condition que des conditions techniques et procédurales spécifiques soient remplies.
Les exigences les plus pertinentes pour l'OCR en comptabilité :
- Rapidité (Zeitgerecht) : Les documents doivent être enregistrés dans les 10 jours ouvrés suivant leur réception. Les transactions en espèces doivent être enregistrées quotidiennement. L'accumulation de reçus pour une numérisation par lots en fin de mois est considérée comme non conforme lors d'une Betriebsprüfung (contrôle fiscal).
- Lisibilité machine (Maschinelle Auswertbarkeit) : Les enregistrements numériques doivent être dans des formats permettant une évaluation automatisée par les autorités fiscales à l'aide d'outils d'audit comme IDEA. Stocker des factures exclusivement sous forme de scans d'images plates (TIFF, JPEG) sans données structurées associées viole ce principe — l'archive doit être interrogeable, triable et référençable par programmation.
- Durée de conservation : 10 ans pour les documents fiscaux. La durée de conservation commence à la fin de l'année civile au cours de laquelle le document a été créé.
- Qualité d'image : 300 DPI minimum pour les documents en texte 10-12 pt, 400-600 DPI pour les documents à petite police ou sur papier thermique. Couleur ou niveaux de gris — pas noir et blanc — pour les documents où les tampons, signatures ou détails de logo sont pertinents.
- Formats d'archivage : PDF/A ou TIFF. Le JPEG seul n'est pas considéré comme infalsifiable car il manque d'intégration de piste d'audit et se dégrade lors de la recompression.
Pour les équipes comptables allemandes, cela signifie que la sortie OCR doit inclure des champs de données structurés aux côtés de l'image du document archivé — et que le flux de travail doit capturer et numériser les documents dans les 10 jours. L'exigence de lisibilité machine de la GoBD signifie qu'une sortie Excel ou CSV avec références aux documents sources constitue en réalité une preuve de conformité plus solide qu'une archive d'images plates. Pour un guide complet, consultez le guide de numérisation de documents conforme à la GoBD.
Champs clés à extraire selon les types de documents
Les équipes comptables ont besoin d'un schéma d'extraction cohérent — les mêmes noms de champs et types de données — pour les cinq types de documents. C'est ce qui rend le traitement par lots et l'import ERP possibles : lorsque chaque document produit la même structure de colonnes quel que soit le format, l'intégration post-extraction devient un simple exercice de mappage plutôt qu'une tâche de gestion des données au cas par cas. Le tableau ci-dessous répertorie les champs critiques pour chaque type de document dans un contexte comptable.
| Type de document | Champs d'en-tête | Champs de ligne / détail | Champs de conformité |
|---|---|---|---|
| Facture | N° de facture, Date, Date d'échéance, Nom du fournisseur, N° de bon de commande, Sous-total, Taxes, Total, Devise | Description, Quantité, Prix unitaire, Total de ligne, SKU, Taux de taxe | N° de TVA/ID fiscal, EIN du fournisseur, N° d'immatriculation fiscale |
| Reçu | Nom du fournisseur, Date, Total, Mode de paiement, Catégorie | Description de l'article, Quantité, Prix unitaire, Total de ligne | Mention de finalité professionnelle, Catégorie fiscale (Repas/Déplacements/Bureau) |
| Relevé bancaire | N° de compte, Période du relevé, Solde initial, Solde final | Date de transaction, Description, Référence, Débit, Crédit, Solde courant | N/A — les relevés bancaires sont des pièces justificatives |
| W-2 | EIN de l'employeur, Nom de l'employeur, SSN de l'employé, Nom de l'employé | Salaires cases 1 à 14, Impôt fédéral case 2, SS/Médicare cases 3 à 6, Codes cases 12 à 14 | L'EIN doit correspondre aux registres de l'IRS ; EIN d'État |
| 1099-NEC/MISC | EIN du payeur, Nom du payeur, TIN du bénéficiaire, Nom du bénéficiaire | Case 1/Case 7 (Rémunération non salariée), Cases 3/4, Impôt fédéral retenu | Le TIN du bénéficiaire doit être validé auprès de la base de données de l'IRS |
| Bon de commande | N° de bon de commande, Nom du fournisseur, Date d'émission, Montant total, Devise | Description de l'article, Quantité commandée, Prix unitaire, Total de ligne, Date de livraison | N/A — les bons de commande sont des documents d'autorisation internes |
Pour la plupart des équipes comptables, la recommandation pratique est de commencer par les champs d'en-tête pour chaque type de document — ils couvrent 80 % de la charge de saisie de données. Ajoutez l'extraction des lignes une fois que le flux d'en-têtes fonctionne de manière fiable. L'exception concerne les relevés bancaires : les champs d'en-tête (numéro de compte, période, solde initial/final) comptent pour le rapprochement, mais la vraie valeur réside dans les lignes de transaction, qui sont l'équivalent des lignes d'article pour un relevé bancaire.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Comment choisir un OCR pour votre pile comptable
Choisir un outil OCR pour la comptabilité se résume à cinq critères, classés par impact sur le flux de travail quotidien. Les affirmations marketing du fournisseur sur une « précision de 99 % » importent moins que la capacité de l'outil à s'intégrer à votre système comptable existant sans créer un nouveau pipeline de données à maintenir.
1. Intégration au logiciel comptable — non négociable
La meilleure extraction au monde ne produit aucune valeur si le résultat ne peut pas atteindre votre système comptable automatiquement. L'exigence d'intégration n'est pas « peut-il exporter en CSV » — tous les outils peuvent exporter en CSV. La question est de savoir si l'outil dispose d'une connexion native à votre plateforme comptable qui envoie les données extraites directement dans vos fiches fournisseurs, votre plan comptable et votre file de transactions.
Pour QuickBooks Online et Xero — les deux plateformes comptables les plus utilisées par les petites et moyennes entreprises — l'écosystème d'intégration est mature. Les outils dotés de connecteurs dédiés peuvent mapper les champs extraits (nom du fournisseur → fiche fournisseur QuickBooks, code de compte → écriture du plan comptable, montant de taxe → allocation du code de taxe) et pousser les données directement dans la file comptable pour révision et validation. Cela élimine l'étape de téléchargement et d'importation qui introduit des problèmes de qualité des données et exige que quelqu'un ouvre le fichier exporté, vérifie l'alignement des colonnes et corrige les écarts de format avant que les données n'arrivent dans le système.
Si vous utilisez une plateforme comptable moins courante, confirmez que l'API de l'outil OCR peut produire un JSON structuré que votre plateforme accepte, ou qu'un connecteur intermédiaire (Zapier, Make) comble l'écart sans nécessiter de développement sur mesure. Pour une comparaison complète des outils d'extraction par approche technique et cas d'usage, consultez le meilleur logiciel OCR pour les cabinets comptables en 2026.
2. Sans modèle — élimine le coût de maintenance caché
L'OCR basé sur des modèles a un coût invisible qui augmente avec le nombre de vos fournisseurs : la maintenance des modèles. Chaque nouveau format de fournisseur exige un nouveau modèle. Chaque changement de format de fournisseur casse le modèle existant. À 50 fournisseurs, la maintenance des modèles devient un travail à temps partiel. À 200 fournisseurs, elle devient un poste à temps plein. L'alternative — l'extraction IA sans modèle — utilise les mêmes définitions de champs pour tout format de fournisseur, toute langue, toute mise en page. Le nom de champ « Invoice Number » fonctionne que l'étiquette soit « Invoice No. » sur le document d'un fournisseur ou « Rechnungsnummer » sur celui d'un autre. C'est le critère le plus important pour toute équipe comptable qui traite plus de 20 formats de fournisseurs.
3. Traitement par lots — un seul passage, un seul tableur
Traiter un document à la fois n'est pas digne de la comptabilité. L'outil doit accepter plusieurs fichiers en un seul téléversement — en mélangeant PDF, JPG et PNG — tous traités avec la même configuration d'extraction, et produire un fichier fusionné unique où chaque document source correspond à une ligne (ou un ensemble de lignes pour les postes). Chaque ligne doit comporter une référence au fichier source pour pouvoir remonter au document original sans avoir à faire correspondre manuellement les lignes aux fichiers.
4. Extraction des postes — les tableaux sont la partie difficile
L'extraction des seuls en-têtes couvre 30 à 50 % des données d'une facture. Les postes — quantités, prix unitaires, descriptions, totaux de ligne — sont là où se trouve le coût de la main-d'œuvre. L'outil doit gérer les tableaux multipages (de nombreuses factures fournisseurs s'étendent sur 2 à 4 pages), les nombres de colonnes variables (certains bons de commande ont 6 colonnes, d'autres 8), et l'ordre irrégulier des colonnes (Description avant Qté vs Qté avant Description). Les outils qui ne peuvent pas extraire de manière fiable les postes de factures multipages et à format variable laissent la partie la plus chronophage de la saisie de données à votre équipe.
5. Sortie conforme — conservation du document source
Comme indiqué dans la section conformité ci-dessus, la sortie OCR pour la comptabilité doit inclure les données extraites et une référence au document source. L'outil doit soit stocker le fichier original à côté des résultats d'extraction, soit fournir une archive téléchargeable contenant les deux. Tout outil qui vous donne le fichier Excel extrait sans conserver le document source crée une lacune de conformité. C'est particulièrement critique pour l'exigence MTD du Royaume-Uni (les documents sources doivent être liés aux enregistrements numériques) et l'exigence de traçabilité de GoBD (Nachvollziehbarkeit — chaque donnée doit pouvoir être retracée jusqu'à son document original).
FAQ
L'OCR fonctionne-t-il avec les photos de reçus prises au téléphone pour les notes de frais ?
Oui, l'OCR basé sur l'IA fonctionne avec les photos prises au téléphone — c'est l'un de ses principaux avantages par rapport à la numérisation traditionnelle. Cependant, la qualité des photos affecte directement la précision. Pour une extraction fiable à partir de photos prises au téléphone : capturez dans de bonnes conditions d'éclairage, tenez le téléphone parallèlement au reçu (en évitant les distorsions de perspective), incluez les quatre coins et évitez le flash sur le papier glacé. Les reçus en papier thermique (qui s'estompent avec le temps) doivent être photographiés immédiatement — attendre même quelques semaines peut les rendre illisibles. Dans des conditions raisonnables, la précision au niveau des champs sur les photos de reçus est de 85 à 95 % pour le texte imprimé, et plus faible pour l'écriture manuscrite.
Puis-je intégrer directement la sortie OCR dans QuickBooks Online ou Xero ?
Oui, si l'outil OCR prend en charge l'intégration directe. QuickBooks Online et Xero disposent tous deux d'API et d'écosystèmes de places de marché d'applications qui permettent aux outils d'extraction de publier des factures, des notes et des données de dépenses directement dans votre file de comptabilité. Lors de l'évaluation de la prise en charge de l'intégration, recherchez : (1) le mappage des champs — l'outil mappe-t-il les noms de fournisseurs extraits à votre liste de fournisseurs, les descriptions de comptes extraites à votre plan comptable ? (2) le format de publication — crée-t-il des brouillons de factures prêts à être examinés, ou publie-t-il directement dans le grand livre ? (3) la liaison des pièces jointes — le document source est-il joint à la transaction dans votre logiciel de comptabilité à des fins de piste d'audit ? Si l'outil ne dispose pas d'intégration directe, la solution de repli est l'export CSV suivi d'une importation manuelle, ce qui ajoute 2 à 5 minutes par lot, mais fonctionne avec n'importe quelle plateforme comptable.
Dois-je créer des modèles pour le format de facture de chaque fournisseur ?
Non, si vous utilisez l'extraction basée sur l'IA. C'est la différence fondamentale entre l'extraction IA moderne et l'OCR traditionnel basé sur des modèles. Les outils basés sur l'IA lisent les factures en comprenant la signification sémantique de chaque champ — le « numéro de facture » désigne le numéro qui identifie cette transaction auprès du fournisseur, où qu'il apparaisse sur la page. Vous définissez les champs une seule fois (par exemple, « Numéro de facture », « Total », « Montant de la taxe ») et les mêmes définitions fonctionnent pour tous les formats de fournisseurs, y compris ceux que vous n'avez jamais vus auparavant. Les outils basés sur des modèles exigent un modèle distinct pour chaque format de fournisseur. Si votre équipe comptable traite des factures de plus de 50 fournisseurs, l'extraction sans modèle est la seule option pratique — la charge de maintenance de la gestion de plus de 50 modèles dépasse le coût de main-d'œuvre de la saisie manuelle.
Comment garantir que mes enregistrements numériques passent un contrôle de l'IRS ?
La Revenue Procedure 97-22 de l'IRS fixe trois conditions pratiques : (1) la copie numérique doit être une reproduction complète et exacte de l'original — chaque champ du reçu ou de la facture d'origine doit être lisible dans la version numérique ; (2) vous devez disposer d'un système d'indexation permettant la récupération — vous devez pouvoir localiser un document spécifique dans un délai raisonnable ; (3) le système doit produire des copies lisibles sur demande — les formats d'image standard (JPEG, PNG, PDF) conviennent ; les formats propriétaires qui ne peuvent pas être ouverts sans un logiciel spécifique ne conviennent pas. En pratique, un système conforme signifie : conserver l'image du document original (scan ou photo), la stocker avec les données extraites, l'indexer par fournisseur/date/montant, et pouvoir la produire lorsque l'auditeur le demande. Préserver l'image originale à côté de votre sortie Excel extraite — avec une référence reliant chaque ligne à son fichier source — est le moyen le plus simple de satisfaire aux trois conditions.
L'OCR pour la comptabilité vaut-il le coup pour une petite équipe traitant moins de 100 factures par mois ?
Oui — mais la marge est plus étroite que pour les équipes à volume élevé. À 100 factures par mois, la saisie manuelle des données prend environ 5 à 8 heures par mois (3 à 5 minutes par facture pour les champs d'en-tête). Un abonnement d'extraction IA à faible coût (20 à 50 $/mois) élimine ces heures. Le calcul fonctionne si votre taux horaire effectif pour la saisie de données dépasse 15 $/heure — ce qui est le cas pour toute entreprise qui paie un employé ou son propre temps. La réserve concerne le temps de configuration : vous devez investir 30 à 60 minutes au départ pour configurer vos champs d'extraction, tester sur des factures d'échantillon et mettre en place l'intégration avec votre logiciel comptable. En dessous de 30 factures par mois, le coût de configuration peut ne pas justifier les économies — même si cela devient rentable pendant la saison fiscale ou la clôture de fin d'année lorsque le volume augmente. Pour une vue d'ensemble complète, voir le meilleur logiciel OCR pour 2026 évalué par cas d'usage.
Un seul outil OCR peut-il traiter à la fois les factures et les relevés bancaires ?
Oui — mais l'outil doit prendre en charge les exigences d'extraction spécifiques à chaque type de document. Certains outils OCR se spécialisent dans les factures et ne peuvent pas traiter les tableaux de relevés bancaires multipages sans casser les lignes aux limites de page ou mal lire la colonne du solde courant. Lors de l'évaluation d'un outil pour des types de documents mixtes, testez-le sur vos documents réels — pas sur des fichiers d'échantillon. Téléchargez un relevé bancaire multipage et vérifiez que : (1) toutes les lignes de transactions sont capturées au-delà des limites de page, (2) la colonne du solde courant est correctement lue et peut être utilisée pour la vérification du rapprochement, (3) les montants au débit et au crédit sont proprement séparés dans les bonnes colonnes. Un outil qui réussit ces tests sur le format de relevé de votre banque fonctionnera probablement aussi pour les factures et les reçus. Pour un test interactif, voir comment le logiciel OCR fonctionne avec différents types de documents.
Quelle est la résolution minimale des documents pour une extraction OCR fiable ?
Pour du texte imprimé en taille de police standard de 10 à 12 pt, 200 DPI est le strict minimum pour une OCR fiable, et 300 DPI est la norme pratique pour de bons résultats. Pour les petits caractères (8 pt ou moins), le papier thermique ou les documents avec des détails fins, 400 à 600 DPI sont recommandés. Pour les photos prises au téléphone, la résolution importe moins que l'éclairage et la mise au point — une photo de 12 MP prise avec un bon éclairage à courte distance produit de meilleurs résultats OCR qu'un scan à 300 DPI pris sous un mauvais angle. La norme GoBD (Allemagne) exige explicitement un minimum de 300 DPI pour les documents standard et de 400 à 600 DPI pour les documents à petits caractères, en couleur ou en niveaux de gris. Si vous numérisez des documents papier à des fins d'archivage, scannez à 300 DPI en couleur — cela produit des fichiers plus volumineux mais garantit la lisibilité pendant des années, en particulier sur du papier thermique qui s'estompe avec le temps.