OCR para contabilidad: Guía completa
para el procesamiento de facturas, recibos y extractos bancarios
El OCR para contabilidad consiste en utilizar el reconocimiento automatizado de texto y la extracción impulsada por IA para convertir documentos financieros — facturas, recibos, extractos bancarios, órdenes de compra, formularios fiscales — en datos estructurados que fluyen directamente a su sistema contable. Si se hace correctamente, elimina la entrada manual de datos, reduce el tiempo de conciliación y crea registros digitales listos para auditoría. Pero el « OCR para contabilidad » no es una tecnología única. Abarca tres enfoques de extracción distintos, cinco tipos de documentos con requisitos de procesamiento específicos y una red de marcos regulatorios — Rev. Proc. 97-22 del IRS en EE. UU., Making Tax Digital en el Reino Unido, GoBD en Alemania — que determinan si sus registros digitales superan el escrutinio de una auditoría. Esta guía los aborda todos, en el orden en que un equipo de contabilidad los encuentra en la práctica: comenzando por lo que significa el OCR en la práctica, luego cada tipo de documento, las normas de cumplimiento aplicables y, finalmente, cómo elegir la herramienta adecuada para su stack contable.
Conclusiones clave
- El OCR basado en plantillas no elimina la entrada de datos — la transforma en mantenimiento de plantillas, y con 50 proveedores ese mantenimiento se convierte en un puesto de trabajo a tiempo parcial.
- La entrada manual de datos genera entre 2 y 5 errores por cada 100 campos, y cada uno cuesta $10 de localizar y corregir — lo que significa que 500 facturas al mes esconden entre $2,500 y $12,500 en trabajo de corrección invisible.
- La extracción impulsada por IA lee las facturas por lo que significan los campos, no por dónde están en la página — la misma configuración funciona con cualquier formato de proveedor y lleva los datos estructurados a QuickBooks o Xero con enlaces a los documentos fuente listos para auditoría.
Qué significa realmente el OCR para la contabilidad
En el contexto contable, el OCR no consiste en convertir texto escaneado en PDFs con búsqueda. Se trata de convertir el contenido de los documentos en datos estructurados e importables: filas y columnas que se asignan a su plan de cuentas, registros de proveedores e historial de transacciones.
La capacidad relevante no es «¿puede esta herramienta leer el texto?», sino «¿puede esta herramienta extraer el número de factura, cotejarlo con una orden de compra, formatear la fecha para su sistema contable y generar el resultado junto con otras 99 facturas en un solo archivo de Excel?».
Esa distinción es importante porque la tecnología OCR tradicional —que existe desde los años 90— puede leer caracteres de un documento, pero no comprende su significado. Reconocerá correctamente la cadena «1.247,83» en una página, pero no sabe si se trata del total de la factura, del importe de impuestos o de un subtotal de una línea de partida, a menos que usted le indique exactamente dónde mirar en la página. Para los equipos de contabilidad que reciben facturas de decenas o cientos de proveedores, cada uno con un diseño distinto, ese paso de «indicarle dónde mirar» es el cuello de botella que ha mantenido viva la introducción manual de datos a pesar de décadas de disponibilidad del OCR. Para comprender el cambio fundamental del reconocimiento de caracteres a la comprensión de documentos, consulte qué es el OCR con IA y en qué se diferencia del OCR tradicional.
El cambio que ha transformado esto en los últimos tres años es la extracción semántica impulsada por IA: un enfoque técnico fundamentalmente distinto. En lugar de escanear caracteres en coordenadas fijas, un modelo de visión y lenguaje lee el documento como lo haría una persona: ve el diseño, reconoce la relación entre etiquetas y valores, y extrae los campos según su significado, no según su ubicación. Esto significa que la misma configuración de extracción funciona tanto si su proveedor envía una factura de una página como un PDF de cuatro páginas, tanto si el total aparece en la esquina superior derecha como en la inferior izquierda, y tanto si el documento es un PDF limpio como una foto tomada con el teléfono de un recibo térmico.
Por qué la contabilidad necesita OCR — El caso cuantificado
El argumento a favor del OCR en contabilidad no se trata de tecnología. Se trata de la distribución del trabajo. Cada hora que un empleado de cuentas por pagar dedica a teclear números de factura y descripciones de partidas en una hoja de cálculo es una hora que no dedica al análisis de variaciones, a la gestión de relaciones con proveedores o a la previsión de flujo de caja. Las cifras que cuantifican esta disyuntiva están bien establecidas en múltiples referencias del sector.
Una sola factura introducida manualmente tarda de 3 a 5 minutos solo en los campos de cabecera — nombre del proveedor, número de factura, fecha, número de pedido, total. Añada la extracción de partidas y el tiempo por factura se duplica. Con 500 facturas al mes, eso supone aproximadamente 40 horas de pura introducción de datos — una semana laboral completa cada mes dedicada a la transcripción. Con un coste total medio de aproximadamente $25 por hora para un empleado de cuentas por pagar, eso equivale a $1,000 por semana, o $52,000 anuales, por un trabajo que no aporta ningún valor analítico. La tasa de error agrava el problema: la transcripción manual produce habitualmente de 2 a 5 errores por cada 100 campos introducidos, y cada error cuesta una media de $10 de detectar y corregir, según los puntos de referencia financieros de APQC. Un solo dígito transpuesto en una factura de $12,000 — $12,000 introducidos como $21,000 — crea un problema de conciliación que tarda más en localizarse de lo que se tardó en teclear el número en primer lugar.
La idea estructural que la mayoría de los equipos de contabilidad pasan por alto: el coste de la introducción manual de datos no es el tiempo de tecleo. Es el tiempo de limpieza posterior. Cada error que introduce durante la entrada debe encontrarse — y encontrarlo cuesta más de lo que habría costado introducirlo correctamente. El OCR elimina la fuente del error, no solo el trabajo de tecleo.
En el lado de la salida, la extracción automatizada procesa una sola página en 5 a 10 segundos — aproximadamente 18 veces más rápido que la entrada manual — con una precisión a nivel de campo en texto impreso que supera sistemáticamente el 97%. La disyuntiva no es velocidad frente a precisión. Es velocidad y precisión frente al mismo equipo dedicando tres días al mes a la introducción de datos. Para un desglose más detallado de las expectativas de precisión por tipo de documento y una metodología que puede aplicar a sus propios documentos, consulte la guía de precisión a nivel de campo para OCR.
Cinco tipos de documentos que el OCR maneja en contabilidad
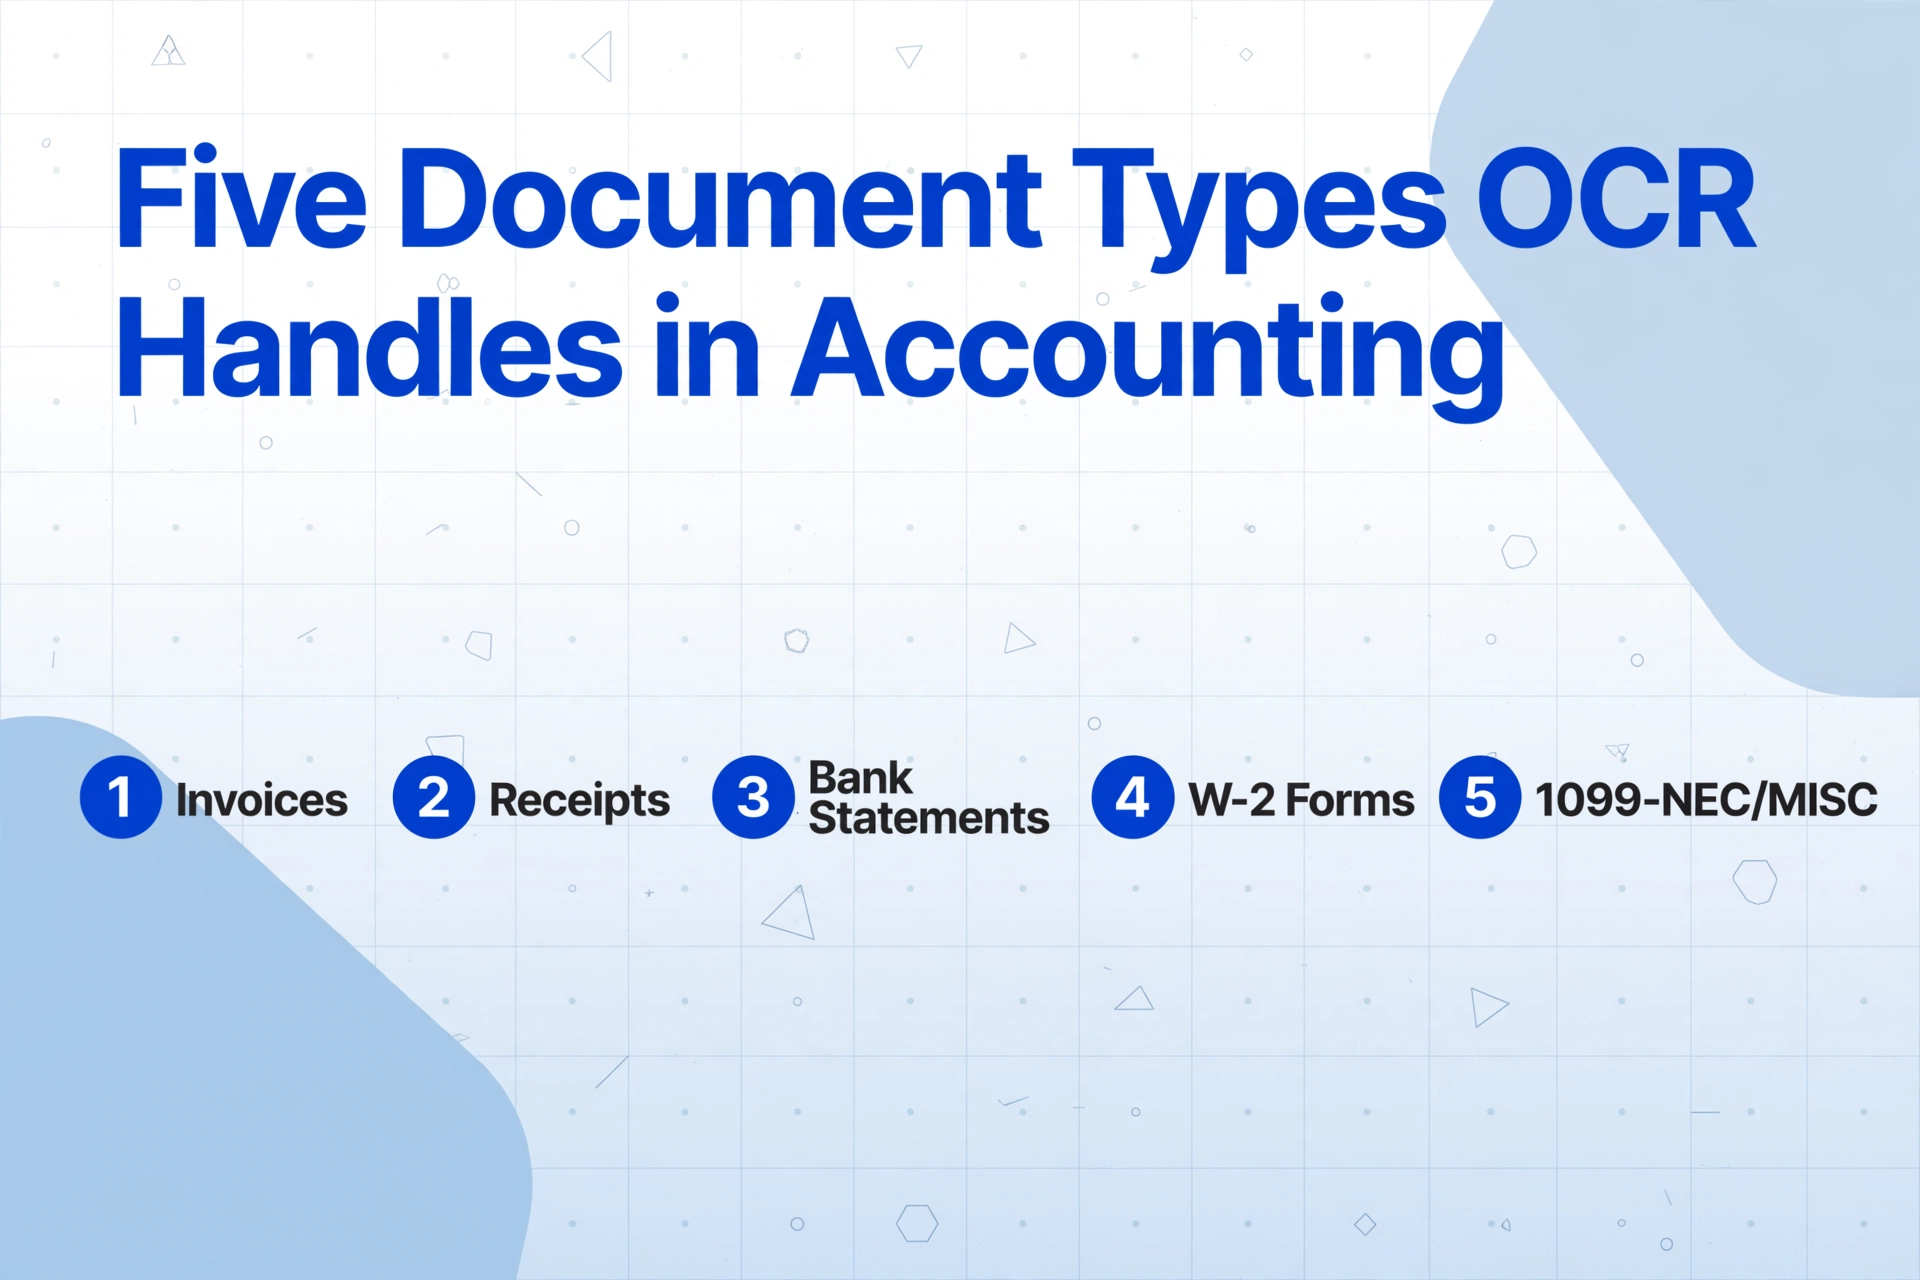
Los equipos de contabilidad procesan más que solo facturas. Una configuración de OCR completa debe manejar la mezcla completa de documentos que llega a su bandeja de entrada compartida, correo físico y envíos de informes de gastos. Cada tipo de documento presenta diferentes desafíos de extracción — y la herramienta que elija debe manejar todos ellos con la misma configuración, no con una configuración separada por tipo.
1. Facturas — La carga de trabajo principal
Las facturas representan la mayor parte del volumen de OCR en contabilidad. El objetivo de extracción estándar incluye campos de encabezado — nombre del proveedor, número de factura, fecha, fecha de vencimiento, número de orden de compra, monto total, monto de impuestos, moneda — y partidas individuales, que son más difíciles porque las tablas varían en número de columnas, orden de columnas y extensión de páginas entre proveedores. Una herramienta que no pueda manejar la extracción de partidas individuales en facturas de varias páginas con estructuras de columnas variables no está lista para producción en AP. Para un tratamiento completo de la extracción específica de facturas, consulte la guía completa de extracción de datos de facturas.
2. Recibos — La pesadilla de formatos
Los recibos llegan en más formatos que cualquier otro documento contable. Papel térmico, fotos de teléfono, PDFs por correo electrónico, recibos escaneados del tamaño de un marcapáginas de estaciones de servicio, folios de restaurante de varias páginas. La calidad de impresión varía desde nítida hasta casi ilegible (el papel térmico se desvanece en 6-12 meses). A diferencia de las facturas, los recibos rara vez siguen un diseño estándar — un recibo de taxi y un recibo de ferretería no comparten ningún patrón estructural más allá de "tener un total al final". El IRS requiere que los recibos digitales conserven el nombre del proveedor, la fecha, cada partida individual, el total y el método de pago — no solo el total. Esto significa que el OCR para recibos debe capturar el detalle de partidas individuales de documentos que nunca fueron diseñados para lectura por máquina, y debe funcionar con la calidad de foto que un empleado de campo produce en tres segundos con un teléfono.
3. Estados de cuenta bancarios: estructura de varias páginas con filas repetidas
Los estados de cuenta bancarios son estructuralmente distintos de las facturas y los recibos. Un solo PDF puede abarcar 20 páginas, cada una con una tabla de transacciones repetida que incluye fecha, descripción, número de referencia, débito, crédito y saldo corriente. El requisito de extracción no es solo capturar las filas: es garantizar que los datos de los estados de cuenta de varias páginas se fusionen en una sola tabla continua sin filas duplicadas (algo común en los límites de página) ni filas faltantes. Los formatos de los estados de cuenta varían significativamente entre bancos: algunos usan diseños de dos columnas (débitos a la izquierda, créditos a la derecha), otros usan una sola columna con indicadores de tipo de transacción, y otros combinan ambos dentro del mismo documento según el tipo de cuenta. Para un tratamiento específico, consulte cómo es la extracción de estados de cuenta bancarios para equipos de contabilidad.
4. Formularios de impuestos: W-2 y 1099
Los formularios W-2 y 1099 son estacionales pero de alto riesgo. La mayoría de los equipos de contabilidad los procesan en ráfagas (de enero a abril para las empresas estadounidenses) y los requisitos de precisión son absolutos: un SSN o EIN incorrecto en un 1099 genera un aviso CP2100 del IRS, y la reemisión de formularios corregidos después de la fecha límite de presentación del 31 de enero conlleva multas por formulario que aumentan hasta marzo. El desafío de la extracción es que los formularios de impuestos usan tipografía pequeña (8-10 pt en diseños de casillas), contienen campos que parecen similares pero tienen significados diferentes (salarios en la Casilla 1 frente a salarios del Seguro Social en la Casilla 3 frente a salarios de Medicare en la Casilla 5) y a menudo se imprimen en formularios de varias partes que producen una mala calidad de escaneo. La mayoría de las herramientas de OCR tratan todos los formularios de impuestos como «simplemente leer todo», pero el campo que importa para la declaración 1099-NEC es la Casilla 7 (compensación a no empleados), y el campo que importa para la conciliación de nómina W-2 es la Casilla 1 (salarios, propinas y otra compensación). Las herramientas de extracción que no distinguen entre estos campos semánticamente similares crean errores de declaración posteriores que se manifiestan meses después.
5. Órdenes de Compra — El Lado de la Conciliación en la Concordancia de Tres Vías
Las órdenes de compra (PO) son el documento contable con menor prioridad para el OCR, pero son esenciales para los flujos de trabajo de concordancia de tres vías (PO + recepción de mercancías + factura). Las PO definen el gasto comprometido, las cantidades de los artículos y los precios acordados con los que la factura debe coincidir. Extraer los datos de la PO — número de PO, descripciones de artículos, cantidades solicitadas, precios unitarios, fechas de entrega — permite la conciliación automatizada: el sistema compara las líneas de la PO con las líneas de la factura y señala las discrepancias sin que una persona tenga que cotejar dos documentos en papel. Sin la extracción de PO, la conciliación sigue siendo una actividad manual de escritorio, sin importar qué tan bien funcione la extracción de facturas.
El Verdadero Desafío — Facturas de Proveedores en Múltiples Formatos
Pregunte a cualquier equipo de cuentas por pagar qué hace difícil la entrada de datos, y la respuesta es consistente: "Los documentos provienen de cientos de proveedores diferentes, por lo que todos están formateados de manera distinta." Esta única frase — repetida en hilos de Reddit en r/Accounting, r/Entrepreneur y r/smallbusiness — captura el problema estructural que la mayoría de las herramientas de OCR no logran resolver.
El problema no es que las facturas tengan diseños diferentes. Es que el OCR tradicional requiere que maneje cada diseño como una configuración separada. Genere una plantilla para la factura de una página del Proveedor A. Cree otra plantilla para la factura de dos páginas del Proveedor B con las líneas de artículos en la segunda página. Haga una tercera plantilla para la factura del Proveedor C que coloca el total en la parte inferior izquierda en lugar de la superior derecha. Ahora multiplique por cada proveedor con el que trabaje — y cada vez que un proveedor actualice su software de contabilidad y su diseño de factura cambie, la plantilla se rompe.
Un usuario de Reddit describió el punto de quiebre: "Solía ingresar manualmente más de 2,500 facturas al mes. Los mismos campos una y otra vez: número de factura, fecha, proveedor, totales. Era repetitivo, lento, y seguía cometiendo errores simplemente por fatiga. El punto de quiebre para mí fue ingresar accidentalmente la misma factura dos veces y luego pasar horas tratando de encontrar dónde los números dejaban de coincidir."
Otro usuario, evaluando soluciones de OCR para un equipo de cuentas por pagar que procesa múltiples formatos: "Analizamos algunas soluciones de OCR, pero a menudo requieren un entrenamiento extenso para cada nueva plantilla. ¿Alguien usa una herramienta que pueda extraer de manera confiable datos de líneas de artículos de documentos variados sin necesidad de crear un parser personalizado para cada proveedor?"
Esta es la distinción fundamental entre el OCR tradicional y la extracción impulsada por IA. Las herramientas basadas en plantillas tratan cada formato de proveedor como un problema separado. La extracción con IA trata todas las facturas como el mismo problema: "encuentre el número de factura, encuentre el total, encuentre las líneas de artículos" — porque la IA entiende cómo se ve una factura independientemente de su diseño específico. Para una comparación detallada de estos dos enfoques arquitectónicos, consulte OCR vs extracción con IA: cuál se adapta a su combinación de documentos.
OCR tradicional vs. extracción impulsada por IA
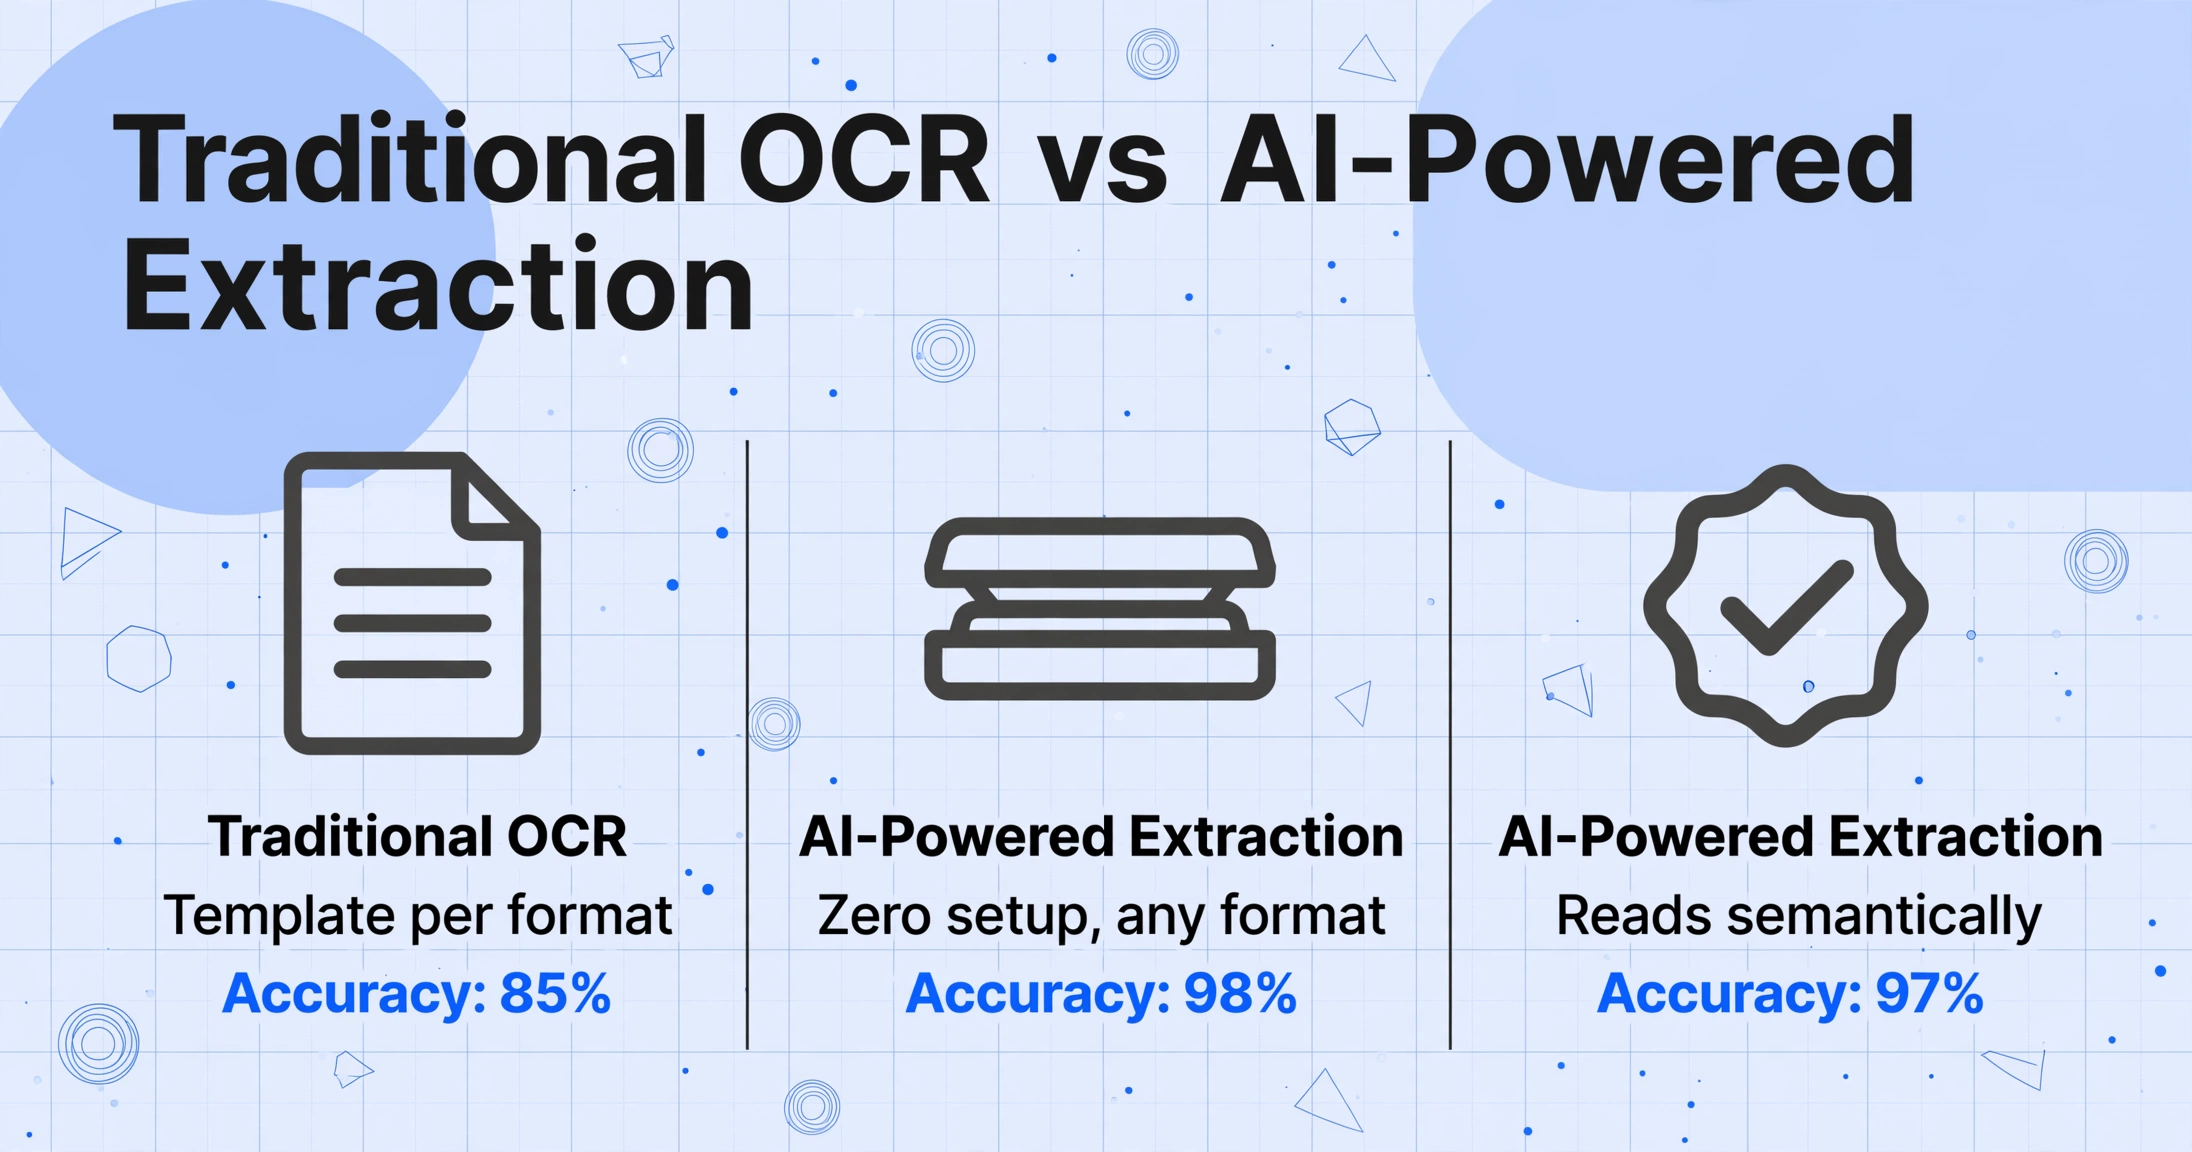
La diferencia entre el OCR tradicional y la extracción impulsada por IA no es una cuestión de grado: es una diferencia en lo que cada tecnología puede hacer en absoluto. Comprender esta distinción es necesario para evaluar cualquier herramienta para uso contable.
| Capacidad | OCR tradicional | Extracción impulsada por IA |
|---|---|---|
| Configuración por formato de proveedor | Una plantilla por formato | Cero: la misma configuración funciona para cualquier formato |
| Cuando el proveedor cambia el diseño | La plantilla se rompe: se requiere reconstrucción | Sin cambios: la IA lee semánticamente |
| Escritura a mano en facturas | <50% de precisión | 85-95% con buena calidad de imagen |
| Tablas de documentos de varias páginas | Se rompe en la página 2 | Lee a través de los límites de página |
| Tabla con columnas variables | Desalineación de columnas | Se adapta al número/estructura de columnas |
| Extracción de columnas personalizadas | Requiere dibujar zonas por campo | Escriba el nombre del campo: la IA lo localiza |
| Columnas calculadas / matemáticas | No compatible | Integrado: derive valores durante la extracción |
| Formato de salida | Archivo de texto o PDF buscable | Excel, CSV, JSON: estructurado por campo |
La tabla anterior muestra por qué la pregunta «¿es el OCR bueno para la contabilidad?» es engañosa. El OCR tradicional — útil para hacer que el texto sea buscable — es insuficiente para los flujos de trabajo contables que necesitan datos estructurados a nivel de campo. La extracción impulsada por IA, que lee documentos comprendiendo lo que significa cada campo, es la tecnología que realmente elimina la entrada de datos. Para una introducción más profunda sobre cómo funciona esto, consulte qué es el OCR y cómo la IA lo cambió.
Cumplimiento normativo: tres marcos regulatorios que todo sistema de OCR contable debe satisfacer
El OCR para contabilidad no se trata solo de velocidad. Se trata de crear registros digitales que satisfagan a las autoridades fiscales cuando soliciten documentación. Tres marcos regulatorios — uno de EE. UU., uno del Reino Unido y uno de Alemania — definen cómo se ve el registro digital conforme en la práctica. Si su configuración de OCR contable no cumple estos requisitos, no produce registros a prueba de auditoría.
EE. UU. — Procedimiento de Ingresos 97-22 del IRS: registros digitales como originales legales
El IRS acepta registros almacenados electrónicamente en lugar de originales en papel, pero solo si su sistema de almacenamiento cumple las seis condiciones del Procedimiento de Ingresos 97-22. Según la Sección 6001 del IRC, todo contribuyente debe conservar registros suficientes para respaldar sus declaraciones de impuestos. El Rev. Proc. 97-22 define las condiciones específicas bajo las cuales el almacenamiento electrónico satisface esa obligación.
Los tres requisitos prácticos que importan para la salida del OCR: (1) la imagen electrónica debe ser una reproducción completa y precisa del original — cada campo del documento original debe ser legible en la copia digital; (2) los registros deben estar indexados para su recuperación — usted debe poder localizar un documento específico en un tiempo razonable; (3) el sistema debe producir copias legibles y claras cuando se soliciten — los formatos propietarios que no pueden abrirse sin un software específico no cumplen este estándar.
Para el OCR en contabilidad, esto significa: su herramienta de extracción debe conservar el documento original junto con los datos extraídos. La salida en Excel por sí sola no es suficiente — durante una auditoría, el examinador del IRS querrá ver el documento fuente que produjo cada valor extraído. Una configuración adecuada exporta los datos extraídos a su sistema contable y conserva el PDF o la imagen original en un archivo recuperable con un enlace de referencia a la fila extraída. Para el desglose completo de lo que constituye un recibo o factura digital conforme en términos del IRS, consulte requisitos de registros digitales de recibos del IRS.
Reino Unido — Making Tax Digital: presentación digital trimestral
A partir de abril de 2026, Making Tax Digital (MTD) para la Autoliquidación del Impuesto sobre la Renta será obligatorio para autónomos y arrendadores con ingresos combinados por trabajo por cuenta propia y propiedad que superen las 50.000 £. La fase 2 amplía esta obligación a quienes ganen más de 30.000 £ en abril de 2027 y 20.000 £ en abril de 2028. Para las empresas registradas a efectos del IVA, MTD ya es obligatorio desde 2019.
Los requisitos clave que afectan al OCR para la contabilidad en el Reino Unido:
- Los registros digitales deben conservarse en software compatible con MTD. No puede acumular recibos en papel durante todo el año y digitalizarlos en marzo. Los registros deben crearse y almacenarse digitalmente en software funcional compatible, y los datos deben poder transferirse entre sistemas mediante «enlaces digitales» (copiar y pegar no es suficiente).
- Cada transacción debe registrarse con fecha, importe y categoría. Un OCR que solo capture el total de un recibo es insuficiente: HMRC exige granularidad a nivel de transacción en sus registros digitales.
- Las actualizaciones trimestrales deben presentarse ante HMRC. Su software debe generar y enviar datos resumidos cada tres meses. Esto significa que el OCR no es una actividad de una vez al año en la temporada de impuestos; debe integrarse en su flujo de trabajo contable continuo.
- Las empresas separadas deben tener registros digitales separados. Si gestiona un negocio de fontanería y posee una propiedad en alquiler, necesita libros de contabilidad digitales separados, aunque ambos se declaren en la misma Declaración Final.
Para los equipos contables del Reino Unido que evalúan herramientas de OCR, la pregunta crítica no es solo «¿puede leer recibos?», sino «¿el formato de salida funciona con software contable compatible con MTD como Xero, QuickBooks, FreeAgent o Sage?». Si la herramienta de OCR exporta datos que su software compatible con MTD no puede importar mediante enlace digital, está creando una brecha de cumplimiento.
Alemania — GoBD: Legibilidad por máquina y la regla de los 10 días
El GoBD (Grundsätze zur ordnungsmäßigen Führung und Aufbewahrung von Büchern, Aufzeichnungen und Unterlagen in elektronischer Form) de Alemania — revisado por la carta del BMF del 28 de noviembre de 2019 — establece los estándares más estrictos para la gestión de documentos digitales entre los tres marcos normativos. La revisión de 2019 permite explícitamente el "ersetzendes Scannen" (escaneo de sustitución) — la digitalización de documentos en papel seguida de la destrucción de los originales — siempre que se cumplan condiciones técnicas y procedimentales específicas.
Los requisitos más relevantes para el OCR en contabilidad:
- Oportunidad (Zeitgerecht): Los documentos deben registrarse dentro de los 10 días hábiles siguientes a su recepción. Las transacciones en efectivo deben registrarse a diario. La acumulación de recibos para la digitalización por lotes a fin de mes se considera inoportuna durante una Betriebsprüfung (auditoría fiscal).
- Legibilidad por máquina (Maschinelle Auswertbarkeit): Los registros digitales deben estar en formatos que permitan la evaluación automatizada por parte de las autoridades fiscales mediante herramientas de auditoría como IDEA. Almacenar facturas exclusivamente como escaneos de imagen planos (TIFF, JPEG) sin datos estructurados asociados viola este principio: el archivo debe ser consultable, ordenable y referenciable de forma programática.
- Período de conservación: 10 años para documentos relevantes a efectos fiscales. El período de conservación comienza al final del año calendario en el que se creó el documento.
- Calidad de imagen: Mínimo 300 DPI para documentos con texto de 10-12 puntos, 400-600 DPI para documentos con letra pequeña o papel térmico. Color o escala de grises — no blanco y negro — para documentos donde los sellos, firmas o detalles del logotipo sean relevantes.
- Formatos de archivo: PDF/A o TIFF. El JPEG por sí solo no se considera a prueba de revisión porque carece de integración de pista de auditoría y se degrada al re-comprimirse.
Para los equipos contables alemanes, esto significa que la salida del OCR debe incluir campos de datos estructurados junto con la imagen del documento archivado — y el flujo de trabajo debe capturar y digitalizar los documentos dentro de los 10 días. El requisito del GoBD de legibilidad por máquina implica que la salida en Excel o CSV con referencias al documento fuente constituye una evidencia de cumplimiento más sólida que un archivo de imágenes plano. Para obtener una guía completa, consulte la guía de digitalización de documentos conforme al GoBD.
Campos Clave para Extraer en Todos los Tipos de Documentos
Los equipos de contabilidad necesitan un esquema de extracción consistente — los mismos nombres de campos y tipos de datos — en los cinco tipos de documentos. Esto es lo que hace posible el procesamiento por lotes y la importación a ERP: cuando cada documento produce la misma estructura de columnas independientemente del formato, la integración posterior a la extracción es un simple ejercicio de mapeo en lugar de una tarea de manipulación de datos documento por documento. La tabla a continuación muestra los campos críticos para cada tipo de documento en un contexto contable.
| Tipo de Documento | Campos de Encabezado | Campos de Partidas / Detalle | Campos de Cumplimiento |
|---|---|---|---|
| Factura | N.º de factura, Fecha, Fecha de vencimiento, Nombre del proveedor, N.º de OC, Subtotal, Impuesto, Total, Moneda | Descripción, Cantidad, Precio unitario, Total de línea, SKU, Tasa de impuesto | N.º de IVA/ID fiscal, EIN del proveedor, N.º de registro fiscal |
| Recibo | Nombre del proveedor, Fecha, Total, Método de pago, Categoría | Descripción del artículo, Cantidad, Precio unitario, Total de línea | Nota de propósito comercial, Categoría fiscal (Comidas/Viajes/Oficina) |
| Estado de Cuenta Bancario | N.º de cuenta, Período del estado, Saldo inicial, Saldo final | Fecha de transacción, Descripción, Referencia, Débito, Crédito, Saldo corriente | N/D — los estados de cuenta bancarios son documentos de respaldo |
| W-2 | EIN del empleador, Nombre del empleador, SSN del empleado, Nombre del empleado | Casillas 1–14 salarios, Casilla 2 Impuesto federal, Casillas 3-6 SS/Medicare, Casillas 12-14 códigos | El EIN debe coincidir con los registros del IRS; EIN estatal |
| 1099-NEC/MISC | EIN del pagador, Nombre del pagador, TIN del beneficiario, Nombre del beneficiario | Casilla 1/Casilla 7 (Compensación no laboral), Casillas 3/4, Impuesto federal retenido | El TIN del beneficiario debe validarse contra la base de datos del IRS |
| Orden de Compra | N.º de OC, Nombre del proveedor, Fecha de emisión, Monto total, Moneda | Descripción del artículo, Cantidad solicitada, Precio unitario, Total de línea, Fecha de entrega | N/D — las OC son documentos de autorización interna |
Para la mayoría de los equipos de contabilidad, la recomendación práctica es comenzar con los campos de encabezado para cada tipo de documento — estos cubren el 80% de la carga de trabajo de ingreso de datos. Agregue la extracción de partidas una vez que el flujo de trabajo de encabezados funcione de manera confiable. La excepción son los estados de cuenta bancarios: los campos de encabezado (número de cuenta, período, saldo inicial/final) son importantes para la conciliación, pero el valor real está en las filas de transacciones, que son el equivalente de partidas en un estado de cuenta bancario.
Los archivos se procesan de forma segura y no se almacenan.
Cómo elegir OCR para su pila de contabilidad
Seleccionar una herramienta de OCR para contabilidad se reduce a cinco criterios, ordenados por su impacto en el flujo de trabajo diario. Las afirmaciones de marketing del proveedor sobre una « precisión del 99 % » son menos importantes que si la herramienta se integra con su sistema de contabilidad existente sin crear una nueva canalización de datos que mantener.
1. Integración con el software de contabilidad: innegociable
La mejor extracción del mundo no produce ningún valor si el resultado no puede llegar automáticamente a su sistema de contabilidad. El requisito de integración no es « ¿puede exportar CSV? » — toda herramienta puede exportar CSV. La cuestión es si la herramienta tiene una conexión nativa con su plataforma de contabilidad que envíe los datos extraídos directamente a sus registros de proveedores, plan de cuentas y cola de transacciones.
Para QuickBooks Online y Xero — las dos plataformas de contabilidad más utilizadas para pequeñas y medianas empresas — el panorama de integración es maduro. Las herramientas con conectores dedicados pueden mapear los campos extraídos (nombre del proveedor → registro de proveedor en QuickBooks, código de cuenta → entrada en el plan de cuentas, importe del impuesto → asignación del código de impuesto) y enviar los datos directamente a la cola de contabilidad para su revisión y contabilización. Esto elimina el paso de descargar e importar, que introduce problemas de calidad de datos y requiere que alguien abra el archivo exportado, verifique la alineación de las columnas y corrija los desajustes de formato antes de que los datos lleguen al sistema.
Si usted utiliza una plataforma de contabilidad menos común, confirme que la API de la herramienta de OCR pueda generar JSON estructurado que su plataforma acepte, o que un conector de middleware (Zapier, Make) cubra la brecha sin requerir desarrollo personalizado. Para una comparación exhaustiva de herramientas de extracción por enfoque técnico y caso de uso, consulte el mejor software de OCR para firmas de contabilidad en 2026.
2. Sin plantilla: elimina el costo oculto del mantenimiento
El OCR basado en plantillas tiene un costo invisible que crece con la cantidad de proveedores: el mantenimiento de plantillas. Cada nuevo formato de proveedor requiere una nueva plantilla. Cada cambio de formato del proveedor rompe la plantilla existente. Con 50 proveedores, el mantenimiento de plantillas se convierte en un trabajo a tiempo parcial. Con 200 proveedores, se convierte en un puesto a tiempo completo. La alternativa — la extracción de IA sin plantilla — usa las mismas definiciones de campos para cualquier formato de proveedor, cualquier idioma, cualquier diseño. El nombre del campo «Número de factura» funciona tanto si la etiqueta es «Invoice No.» en el documento de un proveedor como si es «Rechnungsnummer» en el de otro. Este es el criterio más importante para cualquier equipo de contabilidad que procese más de 20 formatos de proveedores.
3. Procesamiento por lotes: una sola ejecución, una sola hoja de cálculo
Procesar un documento a la vez no es de nivel contable. La herramienta debe aceptar varios archivos en una sola carga — combinando PDF, JPG y PNG — procesarlos todos con la misma configuración de extracción y generar un único archivo combinado donde cada documento de origen corresponda a una fila (o a un conjunto de filas para los artículos de línea). Cada fila debe incluir una referencia al archivo de origen para que pueda rastrear el documento original sin tener que emparejar filas con archivos manualmente.
4. Extracción de artículos de línea: las tablas son la parte difícil
La extracción solo de encabezados cubre el 30-50 % de los datos de una factura. Los artículos de línea — cantidades, precios unitarios, descripciones, totales por línea — son donde reside el costo de mano de obra. La herramienta debe manejar tablas de varias páginas (muchas facturas de proveedores abarcan de 2 a 4 páginas), cantidades variables de columnas (algunas órdenes de compra tienen 6 columnas, otras 8) y un orden irregular de columnas (Descripción antes de Cantidad vs. Cantidad antes de Descripción). Las herramientas que no pueden extraer de manera confiable los artículos de línea de facturas de varias páginas y formato variable dejan la parte más lenta de la captura de datos en manos de su equipo.
5. Salida de nivel de cumplimiento: conservación del documento de origen
Como se indicó en la sección de cumplimiento anterior, la salida del OCR para contabilidad debe incluir los datos extraídos y una referencia al documento de origen. La herramienta debe almacenar el archivo original junto con los resultados de extracción o proporcionar un archivo descargable que incluya ambos. Cualquier herramienta que le entregue el archivo de Excel extraído y no conserve el documento de origen crea una brecha de cumplimiento. Esto es especialmente crítico para el requisito de MTD del Reino Unido (los documentos de origen deben estar vinculados a los registros digitales) y el requisito de trazabilidad de GoBD (Nachvollziehbarkeit: cada dato debe poder rastrearse hasta su documento original).
Preguntas frecuentes
¿El OCR funciona con fotos de recibos tomadas con el teléfono para informes de gastos?
Sí, el OCR impulsado por IA funciona con fotos tomadas con el teléfono; esta es una de sus principales ventajas frente al escaneo tradicional. Sin embargo, la calidad de la foto afecta directamente la precisión. Para una extracción confiable a partir de fotos tomadas con el teléfono: capture con buena iluminación, sostenga el teléfono en paralelo al recibo (evitando la distorsión de perspectiva), incluya las cuatro esquinas y evite el flash sobre papel brillante. Los recibos de papel térmico (que se desvanecen con el tiempo) deben fotografiarse de inmediato; esperar incluso unas pocas semanas puede hacerlos ilegibles. En condiciones razonables, la precisión a nivel de campo en fotos de recibos es del 85-95 % para texto impreso, y menor para escritura a mano.
¿Puedo integrar la salida del OCR directamente en QuickBooks Online o Xero?
Sí, si la herramienta de OCR admite integración directa. QuickBooks Online y Xero tienen API y ecosistemas de mercado de aplicaciones que permiten a las herramientas de extracción publicar facturas, cuentas por pagar y datos de gastos directamente en su cola de contabilidad. Al evaluar la compatibilidad de integración, busque: (1) mapeo de campos: ¿la herramienta asigna los nombres de proveedores extraídos a su lista de proveedores y las descripciones de cuentas extraídas a su catálogo de cuentas? (2) formato de publicación: ¿crea borradores de facturas listos para revisión o publica directamente en el libro mayor? (3) vinculación de archivos adjuntos: ¿el documento fuente se adjunta a la transacción en su software de contabilidad con fines de pista de auditoría? Si la herramienta carece de integración directa, la alternativa es la exportación CSV seguida de importación manual, lo que añade de 2 a 5 minutos por lote, pero funciona con cualquier plataforma de contabilidad.
¿Necesito crear plantillas para el formato de factura de cada proveedor?
No, si utiliza extracción impulsada por IA. Esta es la diferencia fundamental entre la extracción moderna con IA y el OCR tradicional basado en plantillas. Las herramientas impulsadas por IA leen las facturas comprendiendo qué significa semánticamente cada campo: «número de factura» significa el número que identifica esta transacción ante el proveedor, dondequiera que aparezca en la página. Usted define los campos una sola vez (por ejemplo, «Número de factura», «Total», «Monto de impuestos») y las mismas definiciones funcionan en todos los formatos de proveedores, incluidos aquellos que nunca ha visto antes. Las herramientas basadas en plantillas requieren una plantilla separada por cada formato de proveedor. Si su equipo de contabilidad procesa facturas de más de 50 proveedores, la extracción sin plantilla es la única opción práctica: la carga de mantenimiento de gestionar más de 50 plantillas supera el costo laboral de la entrada manual.
¿Cómo puedo asegurarme de que mis registros digitales pasen una auditoría del IRS?
La Rev. Proc. 97-22 del IRS establece tres condiciones prácticas: (1) la copia digital debe ser una reproducción completa y exacta del original — cada campo del recibo o factura original debe ser legible en la versión digital; (2) debe contar con un sistema de indexación que permita la recuperación — debe poder localizar un documento específico en un tiempo razonable; (3) el sistema debe reproducir copias legibles bajo demanda — los formatos de imagen estándar (JPEG, PNG, PDF) son aceptables; los formatos propietarios que no pueden abrirse sin un software específico no lo son. En la práctica, un sistema conforme significa: conservar la imagen del documento original (escaneo o foto), almacenarla junto con los datos extraídos, indexarla por proveedor/fecha/monto y poder presentarla cuando el auditor la solicite. Conservar la imagen original junto con su salida extraída en Excel — con una referencia que vincule cada fila con su archivo fuente — es la forma más directa de cumplir las tres condiciones.
¿Vale la pena el OCR para contabilidad en un equipo pequeño que procesa menos de 100 facturas al mes?
Sí — pero el margen es más reducido que para equipos de alto volumen. Con 100 facturas al mes, el tiempo de captura manual de datos es de aproximadamente 5 a 8 horas mensuales (3 a 5 minutos por factura para los campos de encabezado). Una suscripción de extracción por IA de bajo costo ($20-50/mes) elimina esas horas. El cálculo funciona si su tarifa horaria efectiva para la captura de datos supera los $15/hora — lo cual es cierto para cualquier negocio que pague a un empleado o su propio tiempo. La salvedad es el tiempo de configuración: debe invertir entre 30 y 60 minutos inicialmente para configurar sus campos de extracción, probar con facturas de muestra y establecer la integración con su software de contabilidad. Por debajo de 30 facturas al mes, el costo de configuración puede no justificar el ahorro — aunque resulta rentable durante la temporada de impuestos o el cierre de año, cuando el volumen aumenta. Para un panorama completo, consulte el mejor software de OCR para 2026 evaluado por caso de uso.
¿Puede una sola herramienta de OCR manejar tanto facturas como estados de cuenta bancarios?
Sí — pero la herramienta debe admitir los requisitos de extracción específicos de cada tipo de documento. Algunas herramientas de OCR se especializan en facturas y no pueden procesar tablas de estados de cuenta bancarios de varias páginas sin dividir filas entre límites de página o leer incorrectamente la columna de saldo corriente. Al evaluar una herramienta para tipos de documentos mixtos, pruébela con sus documentos reales — no con archivos de muestra. Suba un estado de cuenta bancario de varias páginas y verifique que: (1) todas las filas de transacciones se capturen a través de los límites de página, (2) la columna de saldo corriente se lea correctamente y pueda usarse para verificar la conciliación, (3) los montos de débito y crédito estén claramente separados en las columnas correctas. Una herramienta que supere estas pruebas con el formato de estado de cuenta de su banco específico probablemente también funcionará con facturas y recibos. Para una prueba interactiva, consulte cómo funciona el software de OCR con diferentes tipos de documentos.
¿Cuál es la resolución mínima del documento para una extracción OCR fiable?
Para texto impreso con un tamaño de fuente estándar de 10-12 pt, 200 DPI es el mínimo absoluto para una extracción OCR fiable, y 300 DPI es el estándar práctico para obtener buenos resultados. Para letra pequeña (8 pt o menos), papel térmico o documentos con detalles finos, se recomienda 400-600 DPI. En el caso de fotografías tomadas con el teléfono, la resolución importa menos que la iluminación y el enfoque: una foto de 12 MP con buena iluminación y tomada de cerca produce mejores resultados de OCR que un escaneo de 300 DPI realizado en un ángulo incorrecto. El estándar GoBD (Alemania) exige explícitamente un mínimo de 300 DPI para documentos estándar y 400-600 DPI para documentos con letra pequeña, en color o en escala de grises. Si escanea documentos en papel con fines de archivo, escanee a 300 DPI en color; esto genera archivos más grandes, pero garantiza la legibilidad durante años, especialmente en papel térmico que se desvanece con el tiempo.