Comment extraire les formulaires d'inscription des élèves
vers une feuille de calcul de base de données scolaire
Un formulaire d'inscription d'élève demande le numéro de téléphone d'un parent une seule fois. Si ce parent a deux enfants inscrits dans le même district, ce numéro de téléphone est saisi deux fois dans un système d'information sur les élèves — PowerSchool, Infinite Campus ou Skyward. S'il a trois enfants, trois fois. Exactement les mêmes chiffres, saisis plusieurs fois, dans plusieurs dossiers, pour le même foyer. Cette duplication n'est pas un cas marginal. C'est la signature structurelle du traitement des données d'inscription, et elle explique pourquoi la vague d'inscriptions d'août n'est pas simplement un problème de volume, mais un problème de corrélation que les pipelines de saisie manuelle — et la plupart des outils d'extraction — n'ont jamais été conçus pour résoudre.
Points clés à retenir
- Le goulot d'étranglement des données d'inscription n'est pas la vitesse de lecture — c'est que le même numéro de téléphone parental est saisi trois fois pour trois frères et sœurs, et votre SIS pense qu'ils appartiennent à trois familles différentes.
- Un moteur OCR standard traite les 20 à 30 cases à cocher d'un dossier d'inscription comme du bruit, obligeant quelqu'un à vérifier manuellement chaque consentement photo et autorisation médicale déjà cochés sur le formulaire.
- Au lieu de dessiner des cadres sur la mise en page unique de chaque école, définissez ce dont vous avez besoin par nom de colonne une seule fois — l'IA trouve les champs selon la signification de l'étiquette, pas selon sa position sur la page, et le registraire passe de la saisie à l'examen de conformité.
Ce que contient réellement un formulaire d'inscription d'élève
Un dossier d'inscription d'élève — parfois appelé dossier d'inscription — n'est pas un document unique. Il s'agit d'un ensemble de formulaires qui établissent ensemble l'identité légale, la préparation médicale et l'éligibilité éducative d'un élève au sein d'un district scolaire. Bien que la disposition exacte varie d'un district à l'autre — et souvent d'une école à l'autre au sein du même district — les catégories de données sont remarquablement cohérentes dans l'éducation K-12 aux États-Unis.
Un dossier d'inscription papier typique contient les groupes de champs suivants :
| Catégorie de champ | Exemples | Méthode de saisie |
|---|---|---|
| Identité de l'élève | Nom légal complet, date de naissance, lieu de naissance, sexe | Écrit à la main (en lettres ou en cursive) |
| Informations sur le parent/tuteur | Nom(s), téléphone fixe, téléphone portable, e-mail, employeur, téléphone professionnel | Écrit à la main |
| Adresse et foyer | Adresse physique, adresse postale, langue parlée à la maison, nombre de résidents | Écrit à la main + case à cocher (sélection de la langue) |
| Contacts d'urgence | 2 à 3 noms de contacts, relations, numéros de téléphone | Écrit à la main |
| Informations médicales | Allergies, médicaments, maladies chroniques, statut vaccinal, médecin traitant | Écrit à la main + case à cocher |
| Scolarité antérieure | Dernière école fréquentée, niveau scolaire, date de retrait | Écrit à la main |
| Autorisations et accusés de réception | Autorisation de photographie, consentement pour les sorties scolaires, autorisation de traitement d'urgence, accord d'utilisation de l'ordinateur | Case à cocher + signature |
| Éligibilité aux programmes | Demande de repas gratuits/à prix réduit, statut ESL/ELL, orientation vers l'éducation spécialisée | Case à cocher + texte écrit à la main |
La variété des méthodes de saisie — écriture imprimée, cursive, cases à cocher, signatures — est le premier indice qu'un pipeline OCR générique ne gérera pas bien ces formulaires. Le deuxième indice est que ces groupes de champs ne sont pas indépendants : les champs parent/tuteur et contact d'urgence contiennent souvent des informations identiques entre frères et sœurs, mais les formulaires sont remplis séparément pour chaque enfant. Ce modèle de duplication au niveau du foyer — où les mêmes données se répètent dans plusieurs enregistrements liés — est un défi qui se présente également dans d'autres domaines, comme l'extraction de données de contrats de location dans un portefeuille immobilier où le même propriétaire ou la même société de gestion apparaît dans plusieurs dossiers de locataires.
L'analyse d'inscription de LINQ estime le taux d'erreur de saisie manuelle à environ 1 % par champ. Appliqué à un dossier d'inscription de 40 champs pour 500 élèves, cela représente 200 erreurs de transcription avant même le début de l'année scolaire — une estimation optimiste, car la fatigue s'accumule pendant la ruée d'août et la qualité de l'écriture des parents varie énormément. Les champs médicaux — allergies, médicaments, maladies chroniques — comportent les conséquences les plus graves en cas d'erreur, avec des exigences de précision similaires à celles observées dans l'extraction de formulaires de réclamation médicale (CMS-1500), où un code ou une date mal lu peut entraîner un refus de réclamation ou un problème de conformité.
La ruée des inscriptions d'août
Selon le Centre national des statistiques de l'éducation (NCES), les écoles publiques K-12 des États-Unis ont inscrit environ 50,1 millions d'élèves dans 99 200 écoles à l'automne 2024. La plupart de ces inscriptions sont traitées dans une fenêtre d'environ six à huit semaines entre la mi-juillet et le début septembre, avec une deuxième vague en janvier pour les transferts en cours d'année et les inscriptions en maternelle.
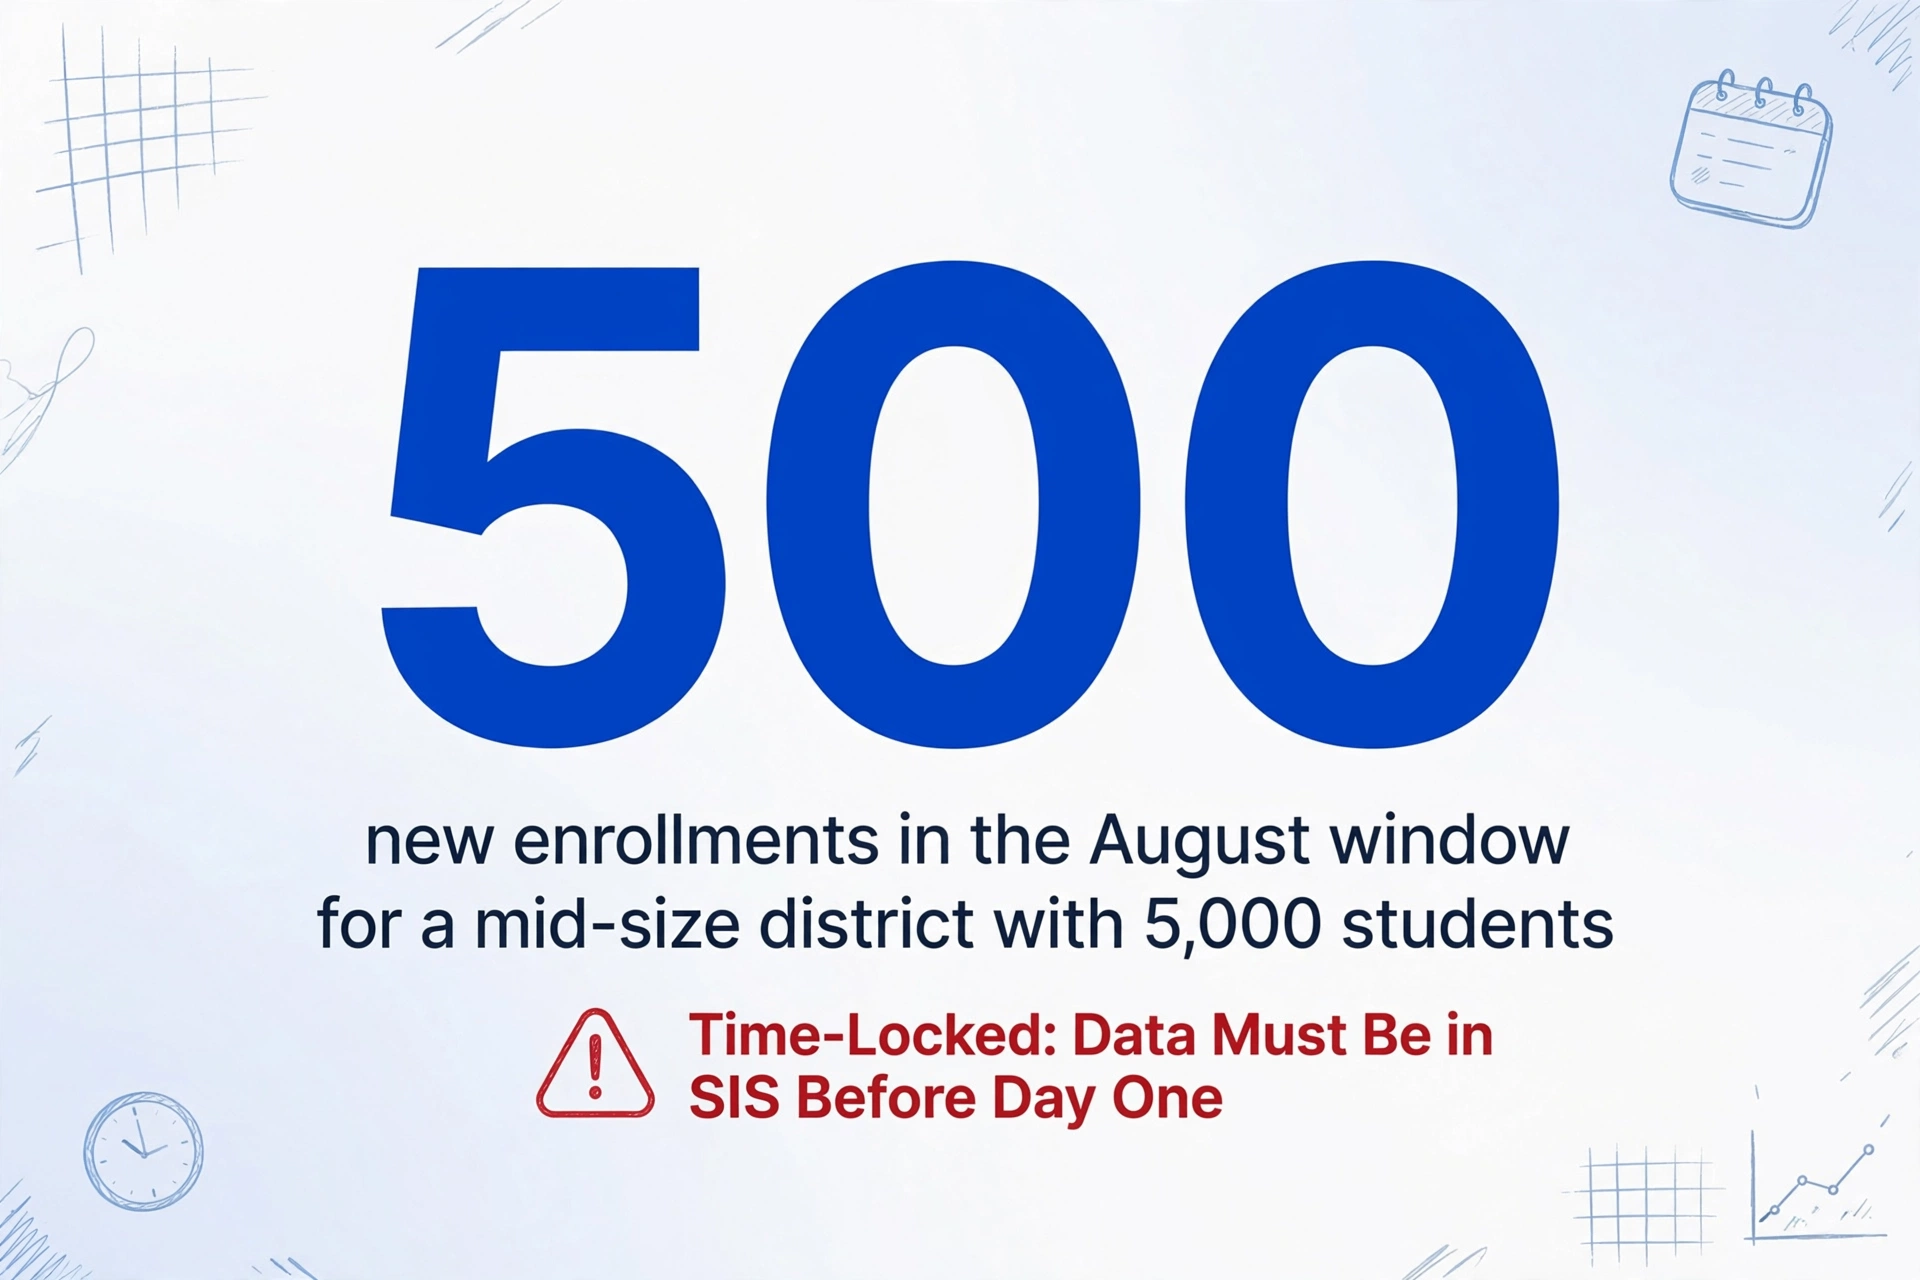
Un district de taille moyenne comptant 5 000 élèves pourrait traiter 500 nouvelles inscriptions pendant la fenêtre d'août — plus 4 500 réinscriptions qui nécessitent encore la vérification de l'adresse, la mise à jour des contacts d'urgence et le renouvellement des formulaires médicaux. Pour un bureau de registraire qui fonctionne avec deux à trois commis à la saisie de données à temps plein, cela représente environ 150 à 200 dossiers d'inscription par personne et par semaine en période de pointe.
Le problème n'est pas que le travail soit difficile. Le problème est qu'il est limité dans le temps. Les données doivent être dans le SIS avant l'arrivée des élèves le premier jour ; les écoles ne peuvent pas repousser la date de rentrée parce que la file de saisie de données est longue. Chaque jour où les informations de contact d'urgence ou d'allergie d'un élève restent dans un dossier papier au lieu d'être dans le SIS est un jour où l'infirmière scolaire et le bureau avant fonctionnent sans informations complètes. La plupart des administrateurs informatiques scolaires et des registraires que nous entendons sur des communautés comme r/k12sysadmin décrivent cela moins comme un défi technique que comme un défi logistique — un goulot d'étranglement annuel prévisible qu'aucune heure supplémentaire ne résout complètement, car les données sont sur papier et le papier avance à la vitesse des frappes manuelles.
Pourquoi l'OCR traditionnel échoue sur ces formulaires
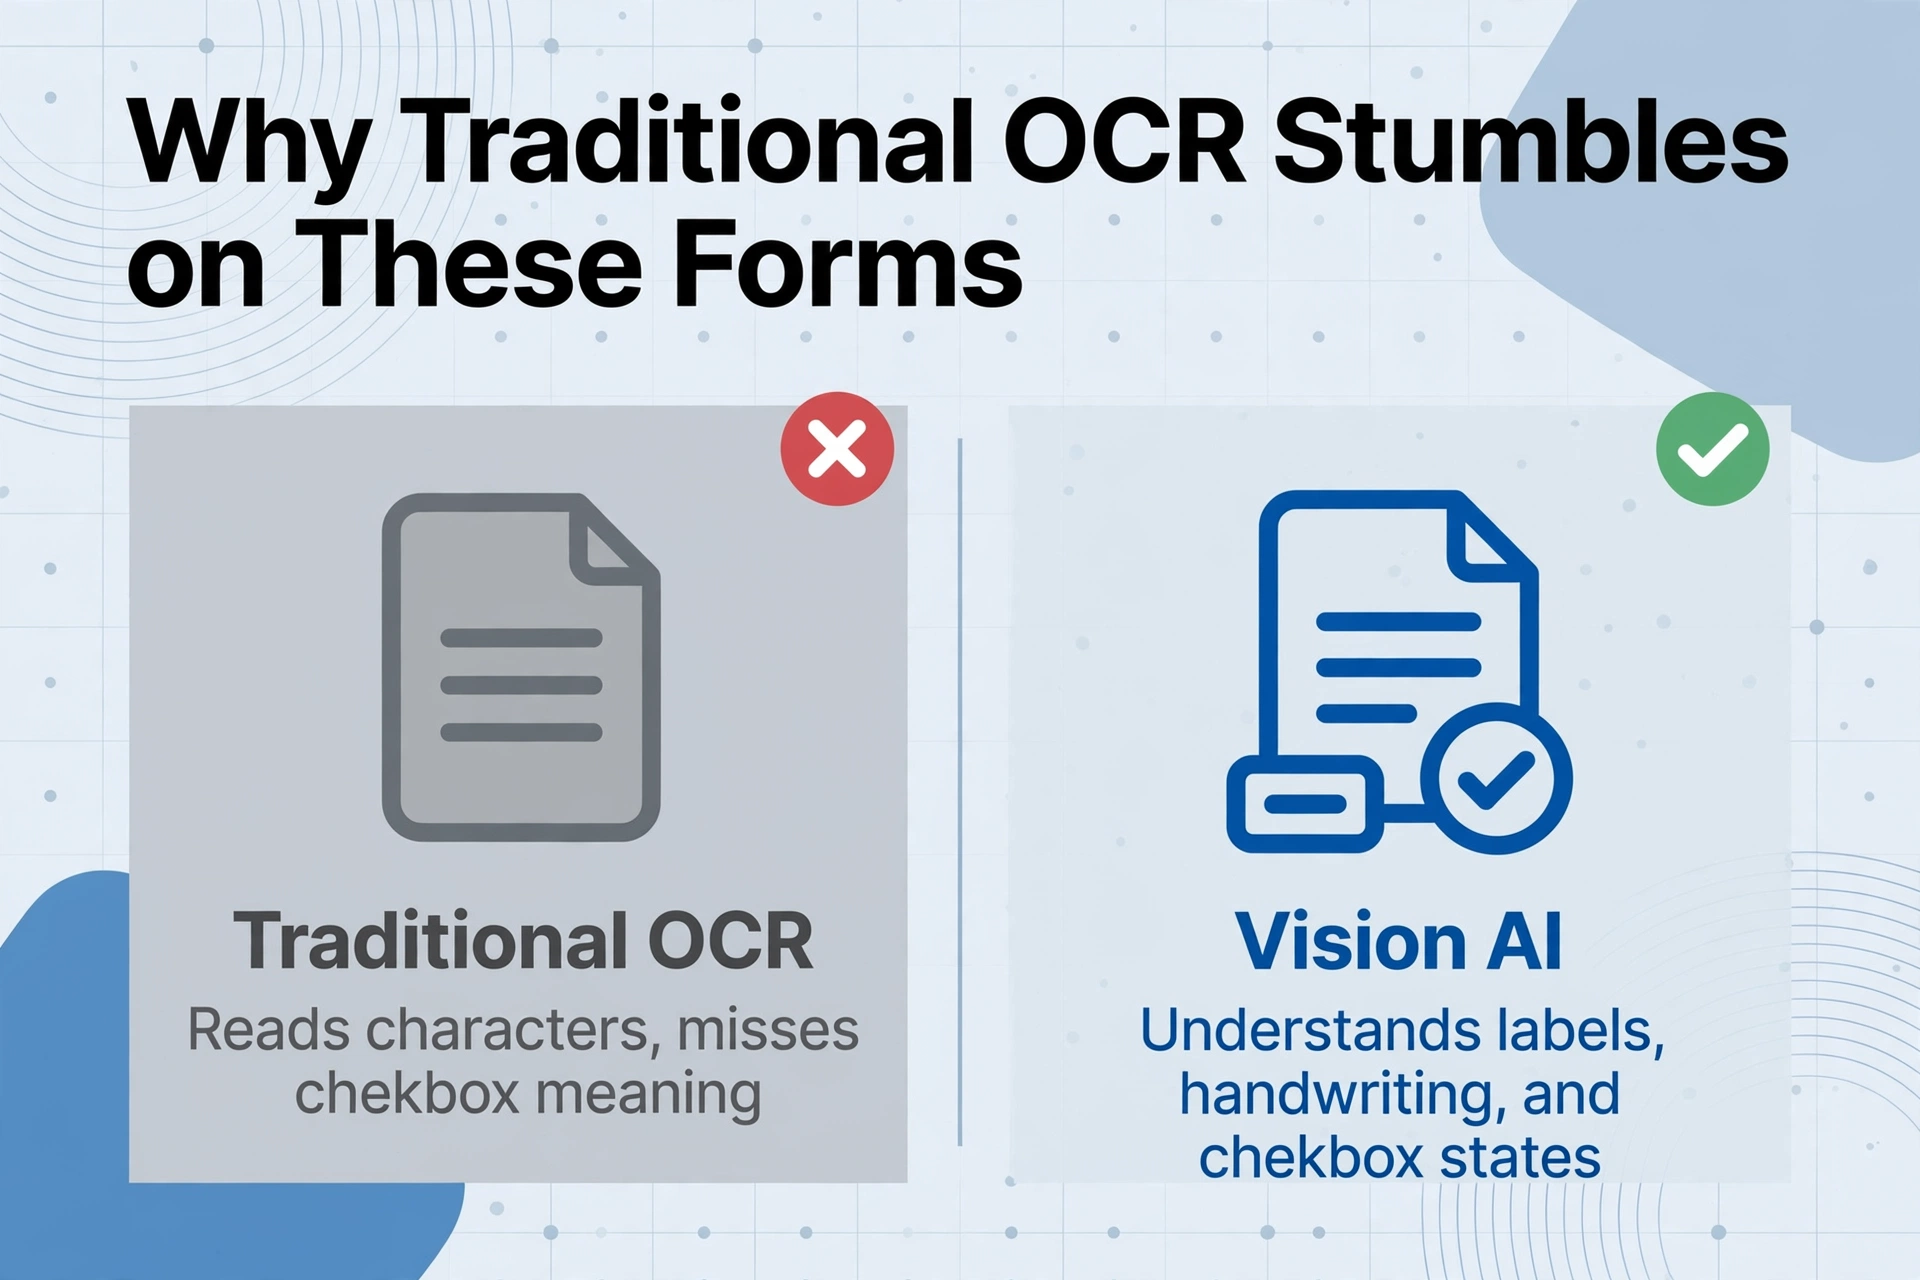
Si vous faites passer un dossier d'inscription scanné dans un moteur OCR standard, vous obtiendrez un mur de texte brut — sans étiquettes de champs, sans états de cases à cocher, sans distinction entre les numéros de téléphone. L'outil lit les caractères, mais il ne comprend pas qu'une case à cocher dans la section « Autorisation de photo » signifie quelque chose de différent d'une case dans la section « Autorisation de traitement d'urgence ».
Trois caractéristiques spécifiques des formulaires d'inscription brisent les pipelines OCR traditionnels d'une manière que les outils génériques d'extraction de documents ne gèrent pas :
1. Variabilité de l'écriture manuscrite. Les parents remplissent les formulaires d'inscription dans des conditions différentes — certains à une table de cuisine lors d'une soirée tranquille, d'autres dans une voiture pendant la file de ramassage, d'autres encore lors d'un événement d'inscription avec un presse-papiers et un stylo emprunté. Un benchmark communautaire Reddit 2024 des outils OCR pour l'écriture manuscrite a constaté que même les meilleurs systèmes montraient une grande variance de précision selon le style d'écriture, la pression du stylo et le fait que le texte restait dans les cases du formulaire. Les formulaires d'inscription ont rarement la disposition de champs propre et encadrée que les moteurs OCR préfèrent — beaucoup utilisent des espaces soulignés, des étiquettes séparées par des deux-points ou des champs ouverts qui fusionnent les entrées manuscrites avec le texte pré-imprimé.
2. Densité des cases à cocher. Un seul dossier d'inscription peut contenir 20 à 30 cases à cocher couvrant le consentement photo, les autorisations médicales, l'autorisation de ramassage d'urgence, la sélection de la langue, l'éligibilité au programme et l'acceptation du code de conduite. L'OCR traditionnel lit le texte ; les cases à cocher sont des symboles non textuels qui nécessitent une reconnaissance de forme et un contexte positionnel. Une case cochée, une option encerclée, une marque X ou un carré rempli sont tous sémantiquement équivalents dans le contexte de l'inscription — mais un moteur OCR standard les voit comme des caractères différents ou du bruit. C'est pourquoi de nombreuses écoles font encore examiner manuellement chaque champ de case à cocher par le personnel, même après avoir fait passer les formulaires dans un pipeline de numérisation vers texte, comme le note l'analyse AmyGB des défis de détection des cases à cocher.
3. Corrélation des ménages. C'est le défi que la plupart des outils d'extraction ne traitent tout simplement pas. Lorsqu'une famille avec trois enfants s'inscrit, le bureau d'accueil reçoit trois dossiers séparés avec les mêmes noms de parents, les mêmes numéros de téléphone, la même adresse, les mêmes contacts d'urgence — mais des noms d'élèves, des dates de naissance, des niveaux scolaires, des antécédents médicaux et des choix de permissions différents. Un outil qui traite chaque formulaire indépendamment produit trois lignes de données avec des champs parents redondants. Un outil qui comprend la relation du ménage peut signaler les doublons et regrouper les champs répétés dans un dossier familial lié. La différence n'est pas cosmétique — elle détermine si le SIS se retrouve avec trois dossiers de ménage séparés qu'un commis doit fusionner manuellement, ou une entrée familiale propre avec trois élèves liés.
Le goulot d'étranglement de la saisie de données dans le traitement des inscriptions n'est pas la lecture — c'est la corrélation. La partie la plus chronophage de la saisie des données d'inscription n'est pas de taper un numéro de téléphone une fois ; c'est de reconnaître que le même numéro de téléphone a été tapé trois fois dans trois dossiers différents et de décider quelles copies sont fiables.
Pour un aperçu plus approfondi des raisons pour lesquelles l'écriture manuscrite provoque ces échecs dans les flux d'extraction, consultez notre analyse détaillée dans OCR ne lit pas l'écriture manuscrite : causes courantes et solutions. Le même défi de variabilité de l'écriture manuscrite affecte également les formulaires de preuve de livraison en logistique et les listes de contrôle d'inspection HACCP, où les signatures en copie carbone et l'écriture manuscrite des travailleurs de terrain créent des obstacles d'extraction similaires.
Comment la Vision AI extrait les données d'inscription dans des feuilles de calcul structurées
La Vision AI — plus précisément, la classe de grands modèles multimodaux qui comprennent les images aussi bien que le texte — aborde les formulaires d'inscription différemment de l'OCR traditionnel. Au lieu de rechercher des formes de caractères, elle interprète le document dans son ensemble : elle reconnaît la relation entre une étiquette imprimée (« Nom du parent/tuteur ») et la valeur manuscrite à côté. Elle comprend qu'une coche dans un carré étiqueté « Oui, j'autorise le traitement d'urgence » signifie un vrai binaire, tandis qu'un carré vide à côté de la même étiquette signifie un faux binaire.
ImageToTable.ai applique cette capacité via un mécanisme appelé Extraction de colonnes personnalisées. Au lieu de dessiner des cadres autour de chaque champ — un processus qui doit être répété pour la mise en page unique de chaque école — vous définissez le résultat souhaité en tapant des noms de colonnes : « Nom de l'élève », « Date de naissance », « Téléphone du parent », « Autorisation photo (Oui/Non) », « Allergies ». L'IA localise chaque valeur en comprenant ce que signifie l'étiquette du champ, et non en faisant correspondre des coordonnées de pixels. C'est la différence entre dire à un outil où regarder et lui dire quoi trouver.
Pour les formulaires d'inscription, cette distinction est importante car un district scolaire peut recevoir des dossiers de cinq écoles élémentaires, chacune utilisant une mise en page de formulaire légèrement différente conçue par un directeur ou un assistant administratif différent il y a cinq ans. Un outil basé sur des modèles nécessite cinq configurations de zones distinctes. L'extraction de colonnes personnalisées nécessite une seule liste de colonnes — et gère automatiquement les variations de mise en page.
Pour une stratégie d'extraction champ par champ — quels champs d'inscription peuvent être fiabilisés au niveau du lot, et lesquels nécessitent toujours une vérification humaine — consultez notre guide complet sur l'extraction des formulaires d'inscription des élèves.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
L'outil gère également le défi de corrélation familiale grâce à son architecture de traitement par lots en priorité. Lorsque vous téléversez 50 dossiers d'inscription — certains provenant du même foyer, d'autres de familles différentes — l'IA traite chaque formulaire indépendamment pour les champs spécifiques à l'élève (nom, date de naissance, niveau scolaire, antécédents médicaux) et signale les données répétées de parent/tuteur comme des doublons probables. La feuille de calcul de sortie contient tous les enregistrements ; les champs de contact du parent en double sont présents dans chaque ligne, mais avec des valeurs cohérentes entre les frères et sœurs, ce qui facilite le regroupement en une vue au niveau familial lors de l'étape d'importation dans le SIS. Comme nous le détaillons dans comment vérifier les résultats d'extraction, le signalement et l'examen de ces entrées répétées constituent un contrôle qualité recommandé avant tout import groupé dans le SIS.
Des formulaires papier à votre SIS : un flux de travail pratique
L'objectif n'est pas d'éliminer le jugement du registraire — il est d'éliminer la saisie afin que le registraire puisse se concentrer sur les décisions importantes. Voici comment un flux de travail d'extraction par vision IA s'intègre au processus d'inscription existant d'un district :
Numérisez ou photographiez les dossiers entrants
Un scanner de bureau standard ou l'appareil photo d'un smartphone suffit. Pour l'afflux d'août, un scanner à alimentation dédié qui produit des PDF multipages maintient le flux de travail. Assurez-vous que chaque dossier est un fichier unique — un fichier par élève est plus facile à suivre que des documents mélangés.
Téléversez dans l'outil d'extraction
Téléversez les fichiers numérisés en lot. La conception de l'outil, qui privilégie le traitement par lots — abordée dans notre article sur le traitement par lots de documents sans codage — accepte simultanément les PDF, JPG et PNG, donc les types de fichiers mixtes provenant de différentes sources de numérisation ne posent aucun problème.
Définissez les colonnes d'extraction
Saisissez les noms de colonnes correspondant aux champs de votre SIS — « Nom de l'élève », « Date de naissance », « Nom du parent/tuteur 1 », « Téléphone du parent/tuteur 1 », « Nom du contact d'urgence », « Allergies », « Autorisation photo », « Éligible aux repas gratuits ». Chaque colonne devient un en-tête dans le tableur de sortie. Il n'est pas nécessaire de correspondre aux libellés exacts des champs du formulaire ; l'IA interprète le sens, pas le texte de surface.
Traitez et vérifiez
L'outil traite tous les fichiers en séquence. Un lot de 100 dossiers d'inscription — environ 300 à 400 pages — se termine généralement en moins de 15 minutes. Exportez les résultats vers Excel ou CSV, puis vérifiez un échantillon (10 à 15 % des enregistrements) pour détecter les champs nécessitant une correction. Portez une attention particulière aux champs médicaux/allergies et aux autorisations par cases à cocher, où la précision est primordiale.
Importez dans votre SIS
Utilisez la fonction d'importation en masse native du SIS (PowerSchool Data Export Manager, Infinite Campus Data Import Wizard, Skyward Import Utility) pour charger le tableur. Comme la sortie est déjà structurée par colonnes, l'étape de mappage d'importation — qui prend normalement des heures — ne prend que quelques minutes. Pour un modèle de colonnes prêt à l'emploi mappé sur ces champs d'importation SIS, consultez notre guide sur l'extraction des données des formulaires d'inscription des élèves vers Excel pour l'importation SIS. Pour les districts qui utilisent une approche d'extraction sans modèle, la liste des colonnes reste la même d'un cycle d'inscription à l'autre ; seuls les formulaires changent.
Ce flux de travail ne nécessite ni nouveau SIS, ni projet d'intégration logicielle, ni modification des procédures d'inscription existantes. L'outil d'extraction se situe en amont du SIS comme couche de préparation des données, convertissant le papier en lignes structurées que l'assistant d'importation du SIS sait déjà lire.
FERPA et confidentialité des données : ce que vous devez savoir
La Loi sur les droits éducatifs et la vie privée des familles (FERPA) — 20 U.S.C. § 1232g — régit la divulgation des dossiers scolaires dans tout établissement recevant des fonds fédéraux. En vertu de la FERPA, un formulaire d'inscription devient un « dossier scolaire » dès lors qu'il est conservé par l'école ou par une partie agissant pour le compte de l'école. La réglementation définit largement les dossiers scolaires — couvrant « l'écriture manuscrite, l'impression, les supports informatiques, les vidéocassettes, les audiocassettes, les films, les microfilms et les microfiches » (34 CFR § 99.2).
Lors de l'utilisation d'un outil tiers pour traiter les formulaires d'inscription, la principale considération FERPA est de savoir si l'outil est qualifié de « responsable scolaire ayant un intérêt éducatif légitime ». En vertu de l'exception de divulgation contractuelle de la FERPA, les écoles peuvent partager des dossiers scolaires avec des prestataires de services externes exerçant une fonction institutionnelle — comme le traitement de données — à condition que :
- Le prestataire soit sous le contrôle direct de l'école concernant l'utilisation et la conservation des dossiers scolaires
- Le prestataire utilise les données uniquement à des fins autorisées
- Le prestataire ne divulgue pas à nouveau les informations à des tiers sans consentement
- L'école conserve une trace de la divulgation dans le dossier de l'élève
En pratique, cela signifie que l'outil d'extraction doit traiter les fichiers sans conserver ni stocker les données extraites au-delà de la fenêtre de traitement. Le modèle de traitement d'ImageToTable.ai — les fichiers sont traités et les résultats mis à disposition en téléchargement, avec suppression automatique des originaux après une période définie — s'aligne sur ce cadre. Les écoles doivent également confirmer que les conditions de service de leur fournisseur de SIS tiennent compte des données importées depuis des outils d'extraction tiers, car la traçabilité des données du papier vers le SIS reste la responsabilité de l'école en vertu de la FERPA. Pour une vue d'ensemble plus large de la manière dont ces principes s'appliquent à des flux de travail documentaires similaires, voir comment les formulaires de réclamation d'assurance gèrent des exigences de confidentialité équivalentes — la structure réglementaire est différente (HIPAA vs FERPA), mais le modèle opérationnel de sous-traitance sous contrôle direct est comparable. D'autres scénarios d'extraction axés sur la conformité, tels que le traitement des rapports de paie certifiés en vertu de la loi Davis-Bacon, suivent une logique similaire : les données doivent quitter le papier et entrer dans une base de données structurée sans compromettre les obligations réglementaires.
Questions fréquemment posées
L'IA peut-elle extraire des formulaires d'inscription manuscrits avec suffisamment de précision pour une base de données scolaire ?
La Vision AI atteint une grande précision sur l'écriture manuscrite imprimée dans les champs de formulaire, en particulier lorsque le formulaire comporte des libellés clairs et une séparation entre les champs. La précision varie selon la qualité de l'écriture — une écriture soignée s'extrait bien ; une cursive rapide avec des lettres qui se chevauchent peut nécessiter une passe de vérification manuelle. Pour les formulaires d'inscription, l'approche pratique consiste à extraire tous les champs automatiquement, puis à vérifier ponctuellement les champs où les erreurs ont les conséquences les plus graves : informations médicales/allergies, numéros de contact d'urgence et autorisations par cases à cocher. La plupart des districts constatent que même avec un taux de vérification de 10 à 15 %, le temps total ne représente qu'une fraction de ce qu'exige une saisie entièrement manuelle.
L'outil reconnaît-il les cases à cocher — cochées, entourées, barrées ou remplies ?
Oui. La Vision AI interprète les cases à cocher dans tous les styles de marquage courants — coches, croix, cases remplies, options entourées — et les sort sous forme de valeurs booléennes (Oui/Non, Vrai/Faux) dans le tableur. Cette capacité est essentielle pour les formulaires d'inscription où le choix d'autorisation d'un parent (autorisation photo, traitement d'urgence, consentement pour les sorties scolaires) est communiqué par une simple marque dans une case. Nous abordons ce sujet plus en détail dans comment l'IA lit les formulaires manuscrits avec des cases à cocher.
Cet outil s'intègre-t-il à PowerSchool, Infinite Campus ou Skyward ?
Il n'existe pas d'intégration directe en un clic. L'outil exporte des données structurées sous forme de tableur (Excel ou CSV) qui peuvent être importées dans tout SIS prenant en charge l'importation en masse de données. Le Data Export Manager de PowerSchool, le Data Import Wizard d'Infinite Campus et l'Import Utility de Skyward acceptent tous les fichiers CSV avec des en-têtes de colonnes. L'étape de mappage d'importation — correspondance des colonnes du tableur avec les champs du SIS — doit être effectuée une fois par configuration SIS, mais les définitions de colonnes d'extraction restent cohérentes d'un cycle d'inscription à l'autre. Cette approche d'exportation vers un tableur fonctionne pour toute plateforme SIS, y compris Aeries, Illuminate et Gradelink.
Puis-je traiter les formulaires d'inscription avec l'appareil photo d'un téléphone plutôt qu'avec un scanner ?
Oui. L'outil accepte les photos de n'importe quel appareil photo — smartphone, tablette ou scanner de bureau — comme entrée. Pour obtenir les meilleurs résultats avec des formulaires d'inscription capturés par téléphone, placez le formulaire sur une surface plane et bien éclairée et assurez-vous que la page entière est visible dans le cadre, sans ombres ni reflets excessifs. Le modèle de vision IA est entraîné à gérer la distorsion de perspective et les variations d'éclairage propres aux photos prises avec un téléphone. Cela peut être particulièrement utile pour les inscriptions en cours d'année où les familles soumettent les formulaires à distance, comme expliqué dans le guide de numérisation de documents sans scanner.
Que se passe-t-il lorsque différentes écoles d'un même district utilisent des mises en page de formulaires d'inscription différentes ?
Parce que l'outil utilise l'Extraction de colonnes personnalisées — qui identifie les champs par le sens de leur libellé plutôt que par leur position à l'écran — il s'adapte automatiquement aux différences de mise en page. La même liste de colonnes (par exemple, « Nom de l'élève », « Allergies », « Autorisation de photo ») fonctionne avec les formulaires de différentes écoles. La condition essentielle est que les champs du formulaire papier comportent des libellés reconnaissables à proximité des valeurs manuscrites. Il s'agit d'un avantage pratique considérable par rapport aux outils basés sur des modèles, qui exigeraient une configuration distincte pour le formulaire unique de chaque école. Pour le mécanisme sous-jacent, voir notre explication sur l'extraction sémantique sans modèle.
Comment gérer le problème des doublons familiaux — les mêmes informations parentales pour plusieurs enfants ?
L'outil traite chaque formulaire de manière indépendante, de sorte que les champs parent/tuteur apparaissent dans chaque ligne appartenant à la même famille. Cependant, comme les valeurs sont extraites de manière cohérente (même format de numéro de téléphone, mêmes orthographes des noms des parents), les entrées en double sont prévisibles et faciles à regrouper. Le flux de travail recommandé consiste à extraire tous les enregistrements dans une feuille de calcul, à trier par champs de contact des parents pour regrouper les frères et sœurs, puis à utiliser la fonction de fusion familiale de votre SIS (disponible dans PowerSchool, Infinite Campus et Skyward) pour relier les enregistrements en un seul foyer. Les outils de ce type, axés sur le traitement par lots, sont abordés plus en détail dans le traitement par lots sans codage.
L'extraction de formulaires d'inscription qui ne suppose pas l'uniformité
Le défi fondamental de la saisie des formulaires d'inscription ne réside pas dans leur difficulté à lire — mais dans leur variété, les données médicales qu'ils contiennent et qui ne tolèrent aucune erreur de lecture, les pics d'arrivée prévisibles, et le fait qu'un même numéro de téléphone parental soit confié à trois agents de saisie différents pour trois enfants différents. Un outil qui suppose que tous les formulaires se ressemblent, qui traite chaque document isolément, ou qui ne sait pas distinguer de manière fiable une case cochée d'une case vide créera plus de travail de nettoyage qu'il n'en économise.
L'extraction par Vision AI ne résout pas le problème des données d'inscription en éliminant le registraire — elle le résout en éliminant la frappe, la saisie en double, les erreurs de fatigue et la vérification manuelle des cases à cocher. La vérification et les décisions de corrélation familiale restent entre les mains des personnes qui comprennent les élèves et les politiques de données du district. Ce qui change, c'est que ces décisions se prennent à la vitesse d'une revue de feuille de calcul, et non à celle d'un clavier.
Essayez sur un formulaire d'inscription →
Sans inscription · Sans carte de crédit · Résultats en 10 secondes