Como Extrair Formulários de Matrícula de Alunos
para uma Planilha de Banco de Dados Escolar
Um formulário de matrícula de aluno pede o número de telefone de um responsável uma única vez. Se esse responsável tiver dois filhos se matriculando no mesmo distrito, esse número de telefone é digitado em um sistema de informações do aluno — PowerSchool, Infinite Campus ou Skyward — duas vezes. Se tiver três filhos, três vezes. Exatamente os mesmos dígitos, inseridos várias vezes, em vários registros, para a mesma família. Essa duplicação não é um caso isolado. É a assinatura estrutural do processamento de dados de matrícula, e explica por que o pico de matrículas de agosto não é simplesmente um problema de volume, mas um problema de correlação que os pipelines de entrada manual de dados — e a maioria das ferramentas de extração — nunca foram projetados para resolver.
Principais Conclusões
- O gargalo dos dados de matrícula não é a velocidade de leitura — é que o mesmo número de telefone do responsável é digitado três vezes para três irmãos e seu SIS acha que eles pertencem a três famílias diferentes.
- Um mecanismo de OCR padrão trata as 20 a 30 caixas de seleção de um pacote de matrícula como ruído, forçando alguém a verificar manualmente cada consentimento de foto e autorização médica que já foi marcado no formulário.
- Em vez de desenhar caixas no layout exclusivo de cada escola, defina o que você precisa pelo nome da coluna uma vez — a IA encontra os campos pelo que o rótulo significa, não por onde ele está na página, e o registrador passa de digitar para revisão de conformidade.
O que um Formulário de Matrícula de Aluno Realmente Contém
Um pacote de matrícula de aluno — às vezes chamado de pacote de registro — não é um único documento. É um conjunto de formulários que juntos estabelecem a identidade legal, a prontidão médica e a elegibilidade educacional do aluno dentro de um distrito escolar. Embora o layout exato varie de distrito para distrito — e muitas vezes de escola para escola dentro do mesmo distrito — as categorias de dados são notavelmente consistentes na educação K-12 dos EUA.
Um pacote de matrícula em papel típico contém os seguintes grupos de campos:
| Categoria do Campo | Exemplos | Método de Entrada |
|---|---|---|
| Identidade do aluno | Nome legal completo, data de nascimento, local de nascimento, sexo | Manuscrito (letra de forma ou cursiva) |
| Informações dos pais/responsáveis | Nome(s), telefone residencial, celular, e-mail, empregador, telefone do trabalho | Manuscrito |
| Endereço e família | Endereço físico, endereço para correspondência, idioma falado em casa, número de residentes | Manuscrito + caixa de seleção (seleção de idioma) |
| Contatos de emergência | 2-3 nomes de contato, relacionamentos, números de telefone | Manuscrito |
| Informações médicas | Alergias, medicamentos, condições crônicas, status de imunização, médico de atenção primária | Manuscrito + caixa de seleção |
| Escolaridade anterior | Última escola frequentada, nível de série, data de desligamento | Manuscrito |
| Permissões e confirmações | Autorização de uso de imagem, consentimento para passeios escolares, autorização de tratamento de emergência, acordo de uso de computador | Caixa de seleção + assinatura |
| Elegibilidade para programas | Inscrição para almoço gratuito/ reduzido, status ESL/ELL, encaminhamento para educação especial | Caixa de seleção + narrativa manuscrita |
A variedade de métodos de entrada — letra de forma impressa, cursiva, caixas de seleção, assinaturas — é a primeira pista de que um pipeline de OCR genérico não lidará bem com esses formulários. A segunda pista é que esses grupos de campos não são independentes: os campos de pais/responsáveis e contatos de emergência frequentemente carregam informações idênticas entre irmãos, mas os formulários são preenchidos separadamente para cada criança. Esse padrão de duplicação em nível familiar — onde os mesmos dados se repetem em vários registros relacionados — é um desafio que também aparece em outros domínios, como extrair dados de contratos de aluguel em um portfólio de propriedades onde o mesmo proprietário ou empresa de administração aparece em vários registros de inquilinos.
A análise de registro da LINQ estima a taxa de erro de entrada manual de dados em aproximadamente 1% por campo. Aplicado a um pacote de matrícula de 40 campos para 500 alunos, isso representa 200 erros de transcrição antes do início do ano letivo — uma estimativa otimista, já que o cansaço aumenta durante a correria de agosto e a qualidade da caligrafia dos pais varia enormemente. Campos médicos — alergias, medicamentos, condições crônicas — têm a maior consequência para erros, semelhante aos requisitos de precisão vistos na extração de formulários de reivindicação médica (CMS-1500), onde um código ou data mal lido pode levar à negação da reivindicação ou a problemas de conformidade.
A Correria de Matrícula de Agosto
De acordo com o Centro Nacional de Estatísticas da Educação (NCES), as escolas públicas K-12 dos EUA matricularam aproximadamente 50,1 milhões de alunos em 99.200 escolas no outono de 2024. A maioria dessas matrículas é processada em uma janela de aproximadamente seis a oito semanas entre meados de julho e início de setembro, com um aumento secundário em janeiro para transferências de meio de ano e matrícula no jardim de infância.
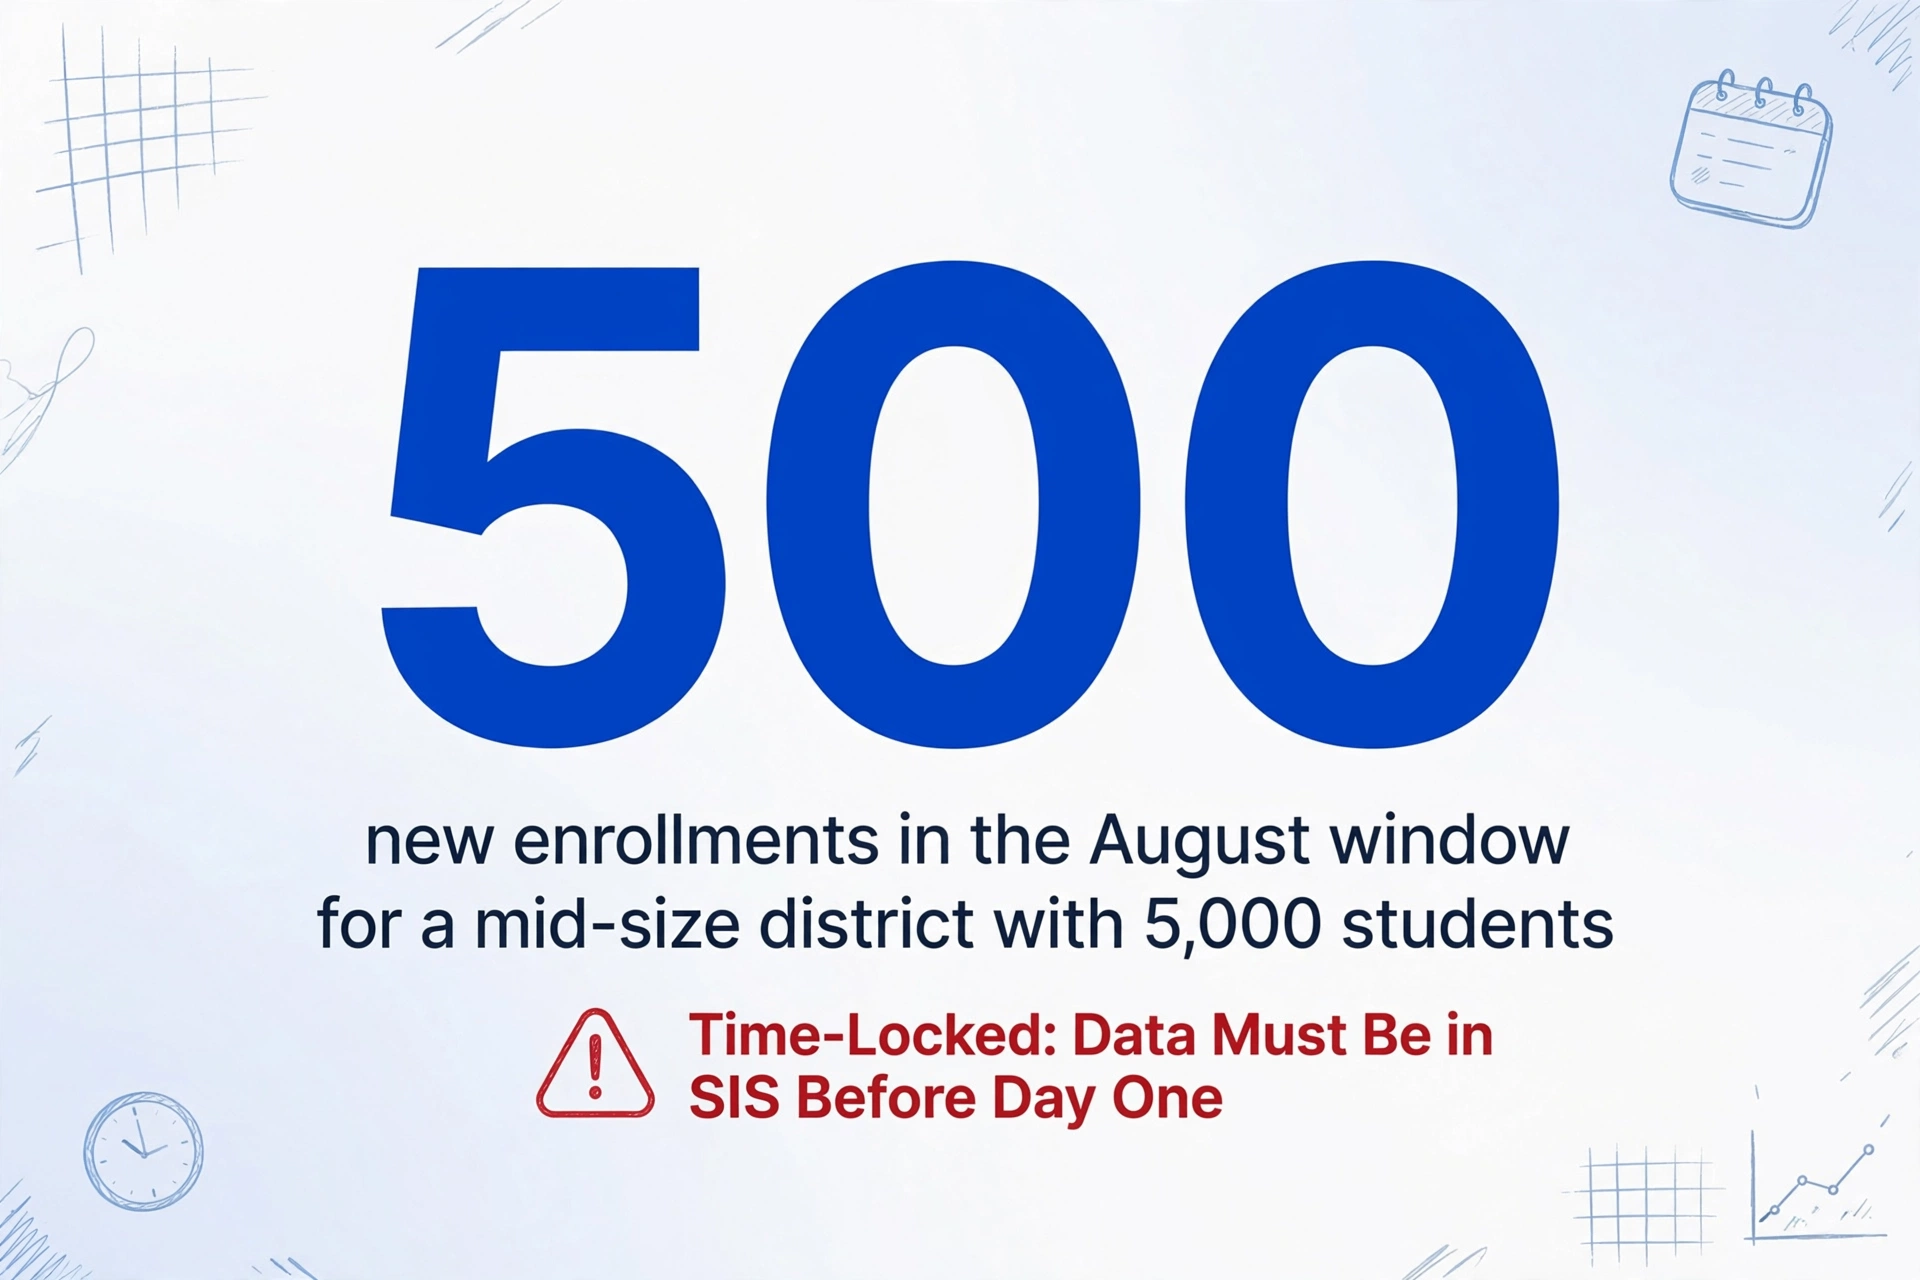
Um distrito de médio porte com 5.000 alunos pode processar 500 novas matrículas durante a janela de agosto — além de 4.500 rematrículas que ainda exigem verificação de endereço, atualização de contatos de emergência e renovação de formulários médicos. Para um escritório de registro que opera com dois a três funcionários de entrada de dados em tempo integral, isso se traduz em aproximadamente 150–200 pacotes de matrícula por pessoa por semana no pico.
O problema não é que o trabalho seja difícil. O problema é que ele é limitado pelo tempo. Os dados devem estar no SIS antes que os alunos cheguem no primeiro dia; as escolas não podem adiar a data de início porque a fila de entrada de dados está longa. Cada dia em que o contato de emergência ou as informações de alergia de um aluno permanecem em um pacote de papel em vez de no SIS é um dia em que a enfermeira da escola e o escritório da frente operam sem informações completas. A maioria dos administradores de TI escolar e registradores com quem falamos em comunidades como r/k12sysadmin descreve isso menos como um desafio técnico e mais como um logístico — um gargalo anual previsível que nenhuma quantidade de horas extras resolve completamente porque os dados estão em papel e o papel se move na velocidade das digitações manuais.
Por que o OCR tradicional falha nesses formulários
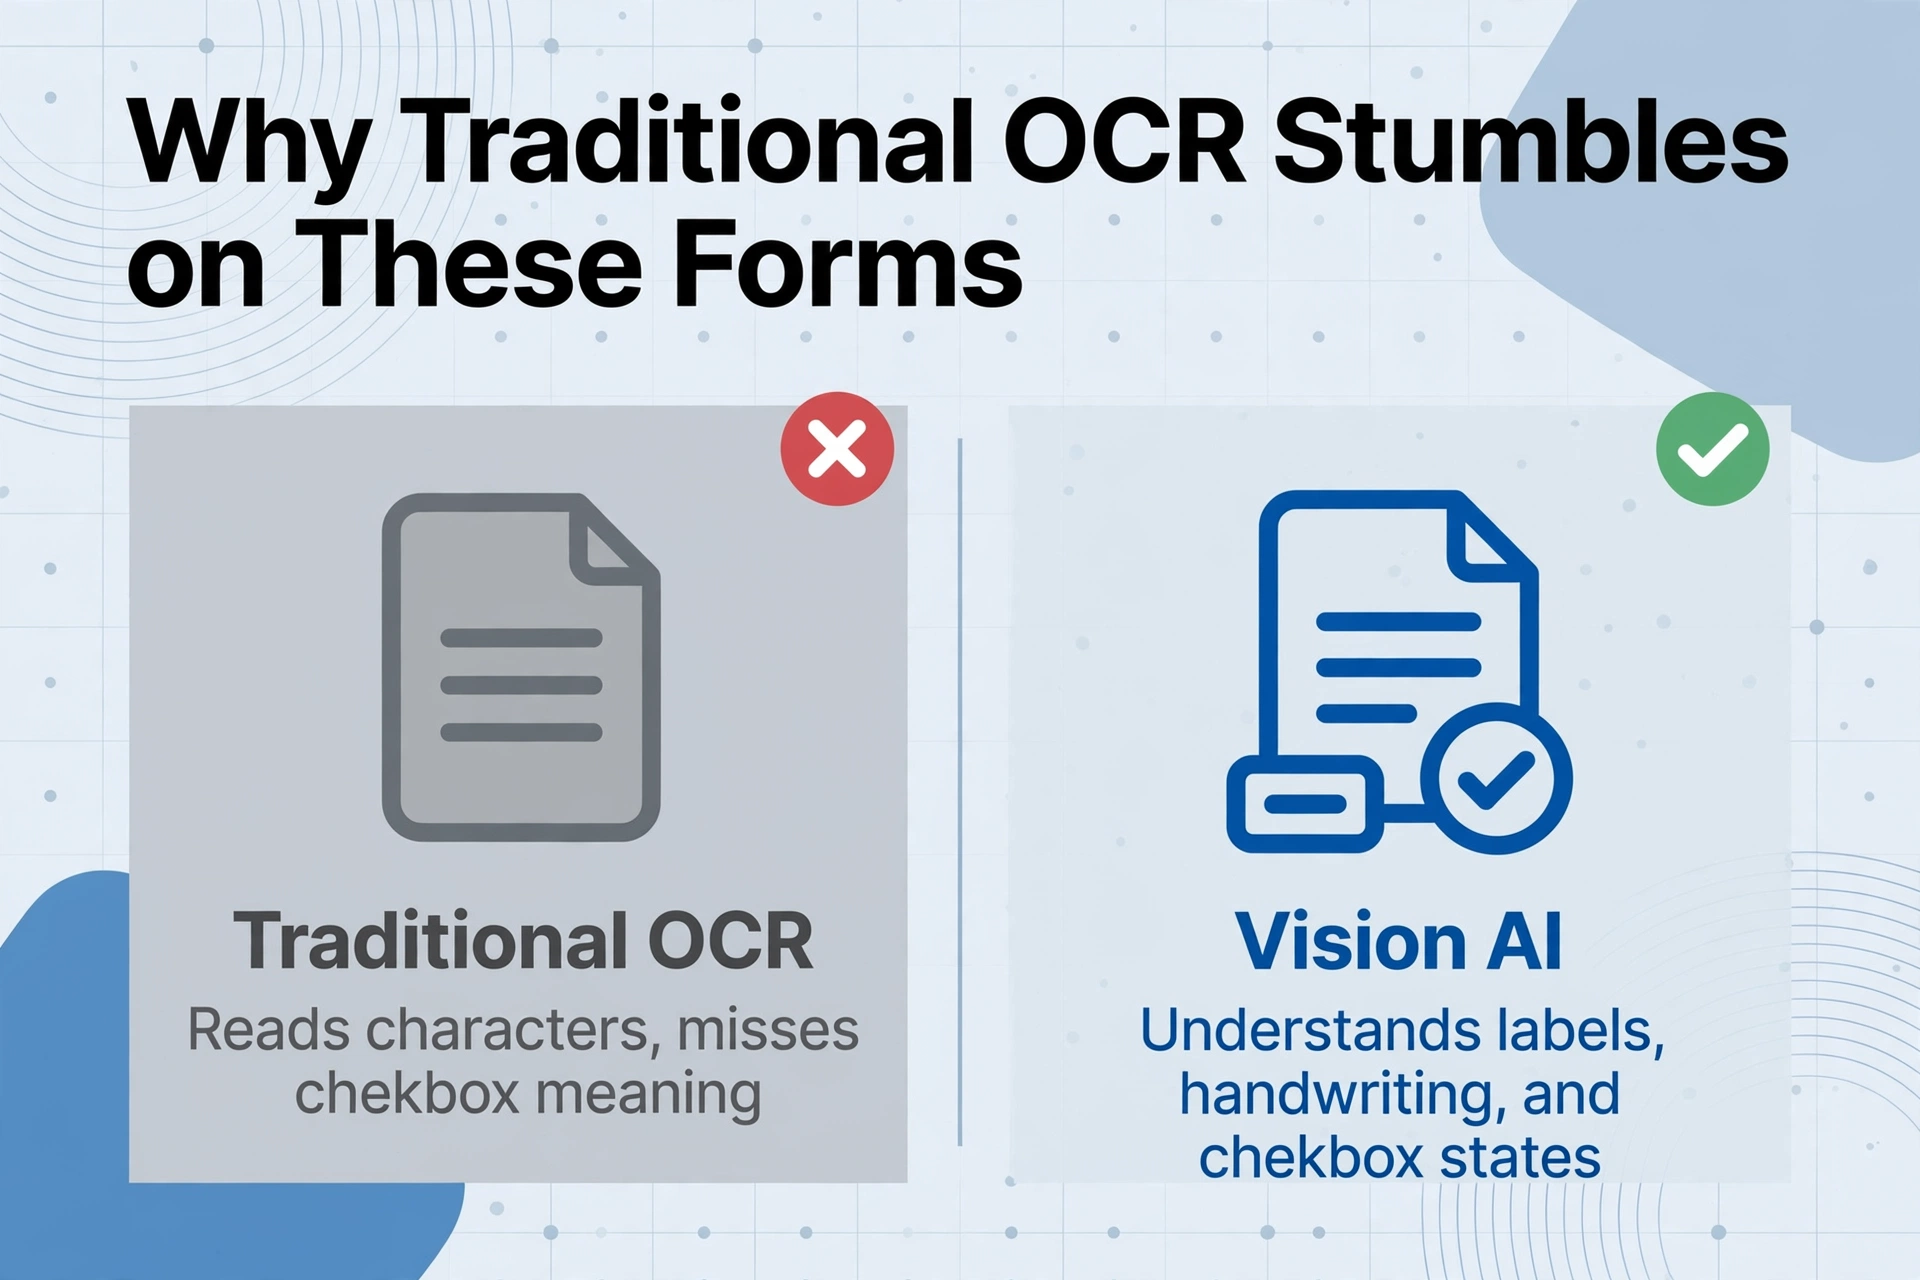
Se você executar um pacote de matrícula digitalizado em um mecanismo de OCR padrão, você receberá uma parede de texto bruto — sem rótulos de campos, sem estados de caixas de seleção, sem distinção sobre de quem é o número de telefone. A ferramenta lê caracteres, mas não entende que uma caixa de seleção na seção "Autorização de Foto" significa algo diferente de uma caixa de seleção na seção "Autorização de Tratamento de Emergência".
Três características específicas dos formulários de matrícula quebram os pipelines tradicionais de OCR de maneiras que as ferramentas genéricas de extração de documentos não lidam:
1. Variabilidade da caligrafia. Os pais preenchem os formulários de matrícula em condições diferentes — alguns na mesa da cozinha durante uma noite tranquila, outros no carro durante a fila de busca, e ainda outros em um evento de matrícula com uma prancheta e uma caneta emprestada. Um benchmark da comunidade Reddit de 2024 sobre ferramentas de OCR para caligrafia descobriu que até os melhores sistemas mostraram grande variação de precisão dependendo do estilo de escrita, pressão da caneta e se o texto permanecia dentro das caixas do formulário. Os formulários de matrícula raramente têm o layout limpo e com caixas que os mecanismos de OCR preferem — muitos usam espaços sublinhados, rótulos separados por dois pontos ou campos de espaço aberto que mesclam entradas manuscritas com texto pré-impresso.
2. Densidade de caixas de seleção. Um único pacote de matrícula pode conter de 20 a 30 caixas de seleção em consentimento de foto, permissões médicas, autorização de busca de emergência, seleção de idioma, elegibilidade do programa e reconhecimento do código de conduta. O OCR tradicional lê texto; caixas de seleção são símbolos não textuais que exigem reconhecimento de forma e contexto posicional. Uma caixa marcada, uma opção circulada, uma marca X ou um quadrado preenchido são todos semanticamente equivalentes no contexto de matrícula — mas um mecanismo de OCR padrão os vê como caracteres diferentes ou ruído. É por isso que muitas escolas ainda têm funcionários revisando manualmente cada campo de caixa de seleção mesmo depois de executar os formulários por um pipeline de scanner para texto, conforme observado na análise da AmyGB sobre os desafios da detecção de caixas de seleção.
3. Correlação familiar. Este é o desafio que a maioria das ferramentas de extração simplesmente não aborda. Quando uma família com três filhos se matricula, o escritório da frente recebe três pacotes separados com os mesmos nomes dos pais, mesmos números de telefone, mesmo endereço, mesmos contatos de emergência — mas nomes de alunos diferentes, datas de nascimento, séries, históricos médicos e escolhas de permissão diferentes. Uma ferramenta que processa cada formulário de forma independente produz três linhas de dados com campos de pais redundantes. Uma ferramenta que entende a relação familiar pode sinalizar duplicatas e consolidar campos repetidos em um registro familiar vinculado. A diferença não é cosmética — ela determina se o SIS acaba com três registros familiares separados que um funcionário deve mesclar manualmente, ou uma entrada familiar limpa com três alunos vinculados.
O gargalo da entrada de dados no processamento de inscripções não é a leitura — é a correlação. A parte que mais consome tempo na entrada de dados de registro não é digitar um número de telefone uma vez; é reconhecer que o mesmo número de telefone foi digitado três vezes em três registros diferentes e decidir em quais cópias confiar.
Para uma análise mais aprofundada de por que a escrita manual causa essas falhas nos fluxos de extração, consulte nosso detalhamento em OCR não lê escrita manual: causas comuns e soluções. O mesmo desafio de variabilidade da escrita manual também afeta formulários de comprovante de entrega na logística e listas de verificação de inspeção HACCP, onde assinaturas em papel carbono e escrita manual dos trabalhadores de campo criam obstáculos de extração semelhantes.
Como o Vision AI extrae dados de inscrição em planillas estruturadas
O Vision AI — especificamente, a classe de grandes modelos multimodais que entendem imagens além de texto — aborda os formulários de inscrição de forma diferente do OCR tradicional. Em vez de escanear formas de caracteres, ele interpreta o documento como um todo: reconhece a relação entre um rótulo impresso ("Nome do pai/tutor") e o valor manuscrito ao lado. Entende que uma marca de verificação dentro de um quadrado rotulado "Sí, autorizo tratamento de emergência" significa um valor booleano verdadeiro, enquanto um quadrado vazio ao lado do mesmo rótulo significa um valor booleano falso.
ImageToTable.ai aplica essa capacidade através de um mecanismo chamado Extraction de Colunas Personalizadas. Em vez de desenhar caixas ao redor de cada campo — um processo que deve ser repetido para o layout exclusivo de formulário de cada escola — você define a saída desejada digitando nomes de colunas: "Nome do aluno", "Data de nascimento", "Telefone do pai", "Autorização de foto (Sí/No)", "Alergias". A IA localiza cada valor entendendo o que o rótulo do campo significa, não combinando coordenadas de píxeles. Esta é a diferença entre dizer a uma ferramenta onde olhar e dizer o que encontrar.
Para formulários de inscrição, essa distinção importa porque um distrito escolar pode receber pacotes de cinco escolas primárias, cada uma usando um layout de formulário ligeramente diferente, desenhado por um diretor ou assistente administrativo diferente há cinco anos. Uma ferramenta baseada em modelos requer cinco configurações de zona separadas. A Extraction de Colunas Personalizadas requer uma lista de colunas — e maneja as variações de layout automaticamente.
Para uma estratégia de extração campo por campo — quais campos de inscrição podem ser confiáveis a nível de lote, e quais sempre precisam de verificação humana — consulte nosso guía completo para extração de formulários de inscripción de estudiantes.
Os arquivos são processados de forma segura e não são armazenados.
A ferramenta também resolve o desafio de correlação familiar através de sua arquitectura de processamento em lote. Quando você envia 50 pacotes de inscrição — alguns da mesma família, outros de famílias diferentes — a IA processa cada formulário de forma independente para campos específicos do aluno (nome, data de nascimento, série, histórico médico) e marca dados repetidos de pai/tutor como prováveis duplicados. A planilha de saída contém todos os registros; os campos de contato duplicados dos pais estão presentes em cada linha, mas com valores consistentes entre irmãos, o que facilita a consolidação em uma visão a nível familiar durante a etapa de importação no SIS. Como abordamos em como verificar os resultados da extração, marcar e revisar essas entradas repetidas é uma verificação de qualidade recomendada antes de qualquer importação em massa no SIS.
Dos Formulários em Papel ao seu SIS: Um Fluxo de Trabalho Prático
O objetivo não é eliminar o julgamento do registrador — é eliminar a digitação para que o registrador possa se concentrar nas decisões que importam. Veja como um fluxo de trabalho de extração com Vision AI se integra ao processo de matrícula existente de um distrito:
Digitalize ou fotografe os pacotes recebidos
Um scanner de escritório padrão ou a câmera de um smartphone funciona. Para o aumento de agosto, um scanner dedicado com alimentador de folhas que gera PDFs de várias páginas mantém o fluxo em movimento. Garanta que cada pacote seja um único arquivo — um arquivo por aluno é mais fácil de rastrear do que documentos misturados.
Envie para a ferramenta de extração
Envie os arquivos digitalizados em lote. O design de processamento prioritário em lote da ferramenta — abordado em nosso artigo sobre como processar documentos em lote sem programação — aceita PDFs, JPGs e PNGs simultaneamente, então tipos de arquivo mistos de diferentes fontes de digitalização não são um problema.
Defina as colunas de extração
Digite os nomes das colunas que correspondem aos campos do seu SIS — "Nome do Aluno", "Data de Nascimento", "Nome do Pai/Responsável 1", "Telefone do Pai/Responsável 1", "Nome do Contato de Emergência", "Alergias", "Autorização de Foto", "Elegível para Merenda Gratuita". Cada coluna se torna um cabeçalho na planilha de saída. Você não precisa corresponder exatamente aos rótulos dos campos do formulário; a IA interpreta o significado, não o texto superficial.
Processe e revise
A ferramenta processa todos os arquivos em sequência. Um lote de 100 pacotes de matrícula — aproximadamente 300–400 páginas — normalmente é concluído em menos de 15 minutos. Exporte os resultados para Excel ou CSV e verifique uma amostra (10–15% dos registros) para ver se há campos que precisam de correção. Preste atenção especial aos campos médicos/de alergias e às permissões de caixa de seleção, onde a precisão é mais importante.
Importe para o seu SIS
Use o recurso nativo de importação em massa do SIS (PowerSchool Data Export Manager, Infinite Campus Data Import Wizard, Skyward Import Utility) para carregar a planilha. Como a saída já está estruturada por coluna, a etapa de mapeamento de importação — que normalmente consome horas — leva minutos. Para um modelo de colunas pronto para uso mapeado para esses campos de importação do SIS, consulte nosso guia sobre extração de dados de formulários de matrícula de alunos para Excel para importação no SIS. Para distritos que usam uma abordagem de extração sem modelo, a lista de colunas permanece a mesma entre os ciclos de matrícula; apenas os formulários mudam.
Este fluxo de trabalho não exige um novo SIS, um projeto de integração de software ou uma mudança nos procedimentos de matrícula existentes. A ferramenta de extração fica antes do SIS como uma camada de preparação de dados, convertendo papel em linhas estruturadas que o assistente de importação do SIS já sabe ler.
FERPA e Privacidade de Dados: O Que Você Precisa Saber
A Lei de Direitos Educacionais e Privacidade da Família (FERPA) — 20 U.S.C. § 1232g — rege a divulgação de registros educacionais em qualquer instituição que receba financiamento federal. Sob a FERPA, um formulário de matrícula torna-se um "registro educacional" no momento em que é mantido pela escola ou por uma parte agindo em nome da escola. A regulamentação define registros educacionais de forma ampla — abrangendo "manuscritos, impressos, mídia de computador, videoteipe, audiotape, filme, microfilme e microficha" (34 CFR § 99.2).
Ao usar uma ferramenta de terceiros para processar formulários de matrícula, a principal consideração da FERPA é se a ferramenta se qualifica como um "funcionário escolar com interesse educacional legítimo." Sob a exceção de divulgação contratual da FERPA, as escolas podem compartilhar registros educacionais com provedores de serviços externos que realizam uma função institucional — como processamento de dados — desde que:
- O provedor esteja sob o controle direto da escola quanto ao uso e manutenção dos registros educacionais
- O provedor use os dados apenas para a finalidade autorizada
- O provedor não redivulgue as informações a terceiros sem consentimento
- A escola mantenha um registro da divulgação no arquivo do aluno
Na prática, isso significa que a ferramenta de extração deve processar arquivos sem reter ou armazenar os dados extraídos além da janela de processamento. O modelo de processamento do ImageToTable.ai — arquivos são processados e resultados disponibilizados para download, com exclusão automática dos originais após um período definido — está alinhado a esse quadro. As escolas também devem confirmar se os termos de serviço do fornecedor do seu SIS consideram dados importados de ferramentas de extração de terceiros, pois a linhagem dos dados, do papel ao SIS, permanece responsabilidade da escola sob a FERPA. Para uma visão geral mais ampla de como esses princípios se aplicam a fluxos de trabalho documentais semelhantes, consulte como formulários de sinistros de seguros lidam com requisitos de privacidade equivalentes — a estrutura regulatória é diferente (HIPAA vs. FERPA), mas o padrão operacional de contratar um processador sob controle direto é comparável. Outros cenários de extração orientados por conformidade, como processamento de relatórios de folha de pagamento certificada sob a Lei Davis-Bacon, seguem uma lógica semelhante: os dados devem sair do papel e entrar em um banco de dados estruturado sem comprometer as obrigações regulatórias.
Perguntas Frequentes
A IA consegue extrair formulários de matrícula manuscritos com precisão suficiente para um banco de dados escolar?
A Vision AI alcança alta precisão em letra de forma impressa dentro dos campos do formulário, especialmente quando o formulário usa rótulos claros e separação entre os campos. A precisão varia com a qualidade da caligrafia — escrita cuidadosa é extraída bem; cursiva apressada com letras sobrepostas pode precisar de uma revisão manual. Para formulários de matrícula, a abordagem prática é extrair todos os campos automaticamente e depois verificar os campos onde erros têm maior consequência: informações médicas/alergias, números de contato de emergência e permissões de caixas de seleção. A maioria dos distritos descobre que, mesmo com uma taxa de revisão de 10–15%, o tempo total é uma fração do que a entrada manual completa exige.
A ferramenta reconhece caixas de seleção — marcadas com tique, circuladas, com X ou preenchidas?
Sim. A Vision AI interpreta caixas de seleção em todos os estilos comuns de marcação — tiques, X, quadrados preenchidos, opções circuladas — e as gera como valores booleanos (Sim/Não, Verdadeiro/Falso) na planilha. Essa capacidade é essencial para formulários de matrícula onde a escolha de permissão dos pais (liberação de fotos, tratamento de emergência, consentimento para passeios escolares) é comunicada por uma única marca na caixa de seleção. Abordamos isso em mais detalhes em como a IA lê formulários manuscritos com caixas de seleção.
Isso se integra ao PowerSchool, Infinite Campus ou Skyward?
Não há integração direta de um clique. A ferramenta exporta dados estruturados em planilha (Excel ou CSV) que podem ser importados para qualquer SIS que suporte importação em massa de dados. O Data Export Manager do PowerSchool, o Data Import Wizard do Infinite Campus e o Import Utility do Skyward aceitam arquivos CSV com cabeçalhos de coluna. A etapa de mapeamento de importação — corresponder as colunas da planilha aos campos do SIS — deve ser feita uma vez por configuração do SIS, mas as definições de colunas de extração permanecem consistentes entre os ciclos de matrícula. Essa abordagem de exportação em planilha funciona para qualquer plataforma SIS, incluindo Aeries, Illuminate e Gradelink.
Posso processar formulários de matrícula usando a câmera do celular em vez de um scanner?
Sim. A ferramenta aceita fotos de qualquer câmera — smartphone, tablet ou scanner de escritório — como entrada. Para obter os melhores resultados com formulários de matrícula capturados pelo celular, coloque o formulário em uma superfície plana e bem iluminada e garanta que a página inteira esteja visível no quadro, sem sombras ou brilho excessivo. O modelo de Vision AI é treinado para lidar com a distorção de perspectiva e a variação de iluminação que vêm com fotos de celular. Isso pode ser especialmente útil para matrículas no meio do ano, quando as famílias enviam formulários remotamente, conforme abordado no guia para digitalizar documentos sem scanner.
O que acontece quando diferentes escolas do mesmo distrito usam layouts de formulários de matrícula diferentes?
Como a ferramenta usa a Extração de colunas personalizada — encontrando campos pelo significado do rótulo, e não pela posição na tela — ela se adapta automaticamente às diferenças de layout. A mesma lista de colunas (por exemplo, "Nome do Aluno", "Alergias", "Autorização de Foto") funciona em formulários de diferentes escolas. O requisito principal é que os campos no formulário em papel tenham rótulos reconhecíveis perto dos valores manuscritos. Essa é uma vantagem prática significativa em relação às ferramentas baseadas em modelo, que exigiriam uma configuração separada para o formulário exclusivo de cada escola. Para entender o mecanismo subjacente, consulte nossa explicação sobre extração semântica sem modelo.
Como lidar com o problema de duplicação de famílias — as mesmas informações dos pais em vários filhos?
A ferramenta processa cada formulário de forma independente, então os campos de pai/responsável aparecerão em todas as linhas da mesma família. No entanto, como os valores são extraídos de forma consistente (mesmo formato de número de telefone, mesma grafia dos nomes dos pais), as entradas duplicadas são previsíveis e fáceis de consolidar. O fluxo de trabalho recomendado é extrair todos os registros para uma planilha, classificar pelos campos de contato dos pais para agrupar irmãos e, em seguida, usar o recurso de mesclagem de famílias do seu SIS (disponível no PowerSchool, Infinite Campus e Skyward) para vincular os registros em uma única família. Ferramentas como essa, com abordagem orientada a lote, são discutidas em mais detalhes em processamento em lote sem programação.
A Extração de Formulários de Matrícula Que Não Assume Uniformidade
O desafio fundamental da entrada de dados em formulários de matrícula não é que os formulários sejam difíceis de ler — é que eles variam, contêm dados médicos que não toleram erros de leitura, chegam em picos previsíveis e entregam o mesmo número de telefone dos pais a três funcionários diferentes de entrada de dados para três filhos diferentes. Uma ferramenta que assume que todos os formulários são iguais, que processa cada documento isoladamente ou que não consegue distinguir com confiabilidade entre uma caixa de seleção marcada e uma vazia criará mais trabalho de limpeza do que economiza.
A extração com Vision AI não resolve o problema dos dados de matrícula eliminando o registrador — ela o resolve eliminando a digitação, a entrada duplicada, os erros de fadiga e a revisão manual das caixas de seleção. As decisões de verificação e correlação familiar permanecem com as pessoas que entendem os alunos e as políticas de dados do distrito. O que muda é que essas decisões acontecem na velocidade de uma revisão de planilha, não na velocidade de um teclado.
Experimente em um Formulário de Matrícula →
Sem cadastro · Sem cartão de crédito · Resultados em 10 segundos