学生登録フォームを
学校データベーススプレッドシートに抽出する方法
学生登録フォームでは、保護者の電話番号を一度だけ記入します。その保護者に同じ学区に登録する子どもが2人いる場合、その電話番号は学生情報システム(PowerSchool、Infinite Campus、Skyward)に2回入力されます。3人いる場合は3回です。まったく同じ数字が、同じ世帯の複数のレコードに、何度も手入力されるのです。この重複は特殊なケースではありません。これは登録データ処理の構造的な特徴であり、8月の登録ラッシュが単なる量の問題ではなく、手動データ入力パイプライン(およびほとんどの抽出ツール)が解決するように設計されていなかった相関問題である理由を説明しています。
重要なポイント
- 登録データのボトルネックは読み取り速度ではありません — 同じ保護者の電話番号が3人の兄弟姉妹のために3回入力され、SISが彼らを別々の家族と認識してしまうことです。
- 標準的なOCRエンジンは、登録パケットにある20〜30個のチェックボックスをノイズとして扱うため、フォーム上で既にマークされた写真同意書や医療承認をすべて手動で確認する必要が生じます。
- 各学校の独自のフォームレイアウトに枠を描く代わりに、必要なものを列名で一度定義するだけで — AIはラベルの意味に基づいてフィールドを見つけ、ページ上の位置には依存しません。登録担当者は入力作業からコンプライアンス確認へと移行できます。
学生登録フォームが実際に含むもの
学生登録書類一式(登録パケットとも呼ばれる)は、単一の文書ではありません。学校区内での生徒の法的身分、医療上の準備、教育上の資格を確立するためのフォームの束です。正確なレイアウトは学区ごとに異なりますが(同じ学区内の学校ごとに異なることもよくあります)、データカテゴリは米国のK-12教育全体で驚くほど一貫しています。
一般的な紙の登録書類一式には、以下のフィールドグループが含まれています:
| フィールドカテゴリ | 例 | 記入方法 |
|---|---|---|
| 生徒の身元 | 正式な氏名、生年月日、出生地、性別 | 手書き(活字または筆記体) |
| 保護者/後見人情報 | 氏名、自宅電話、携帯電話、メール、勤務先、勤務先電話 | 手書き |
| 住所と世帯 | 現住所、郵送先住所、家庭での使用言語、居住者数 | 手書き+チェックボックス(言語選択) |
| 緊急連絡先 | 連絡先2〜3名、続柄、電話番号 | 手書き |
| 医療情報 | アレルギー、服用中の薬、慢性疾患、予防接種状況、かかりつけ医 | 手書き+チェックボックス |
| 以前の在籍校 | 最終在籍校、学年、転出日 | 手書き |
| 許可と同意事項 | 写真使用許可、遠足同意書、緊急治療の承認、コンピューター使用同意書 | チェックボックス+署名 |
| プログラム対象資格 | 無料・割引ランチ申請、ESL/ELLステータス、特別教育紹介 | チェックボックス+手書きの説明 |
記入方法の多様さ(活字、筆記体、チェックボックス、署名)は、一般的なOCRパイプラインではこれらのフォームをうまく処理できないことを示す最初の手がかりです。2つ目の手がかりは、これらのフィールドグループが独立していないことです。保護者/後見人と緊急連絡先のフィールドは、兄弟姉妹間で同一の情報を持つことがよくありますが、フォームは子どもごとに個別に記入されます。この世帯レベルの重複パターン(同じデータが複数の関連レコードに繰り返し現れる)は、他の領域でも発生する課題であり、例えば不動産ポートフォリオ全体からリース契約データを抽出する場合、同じ家主や管理会社が複数のテナントレコードに登場します。
LINQの登録分析によると、手動データ入力のエラー率はフィールドあたり約1%です。500人の生徒の40フィールドの入学書類に適用すると、学年が始まる前に200件の転記エラーが発生することになります。これは楽観的な見積もりです。8月の繁忙期には疲労が重なり、保護者の筆跡の質も大きく異なるためです。アレルギー、投薬、慢性疾患などの医療フィールドは、エラーによる影響が最も大きく、医療請求書(CMS-1500)の抽出に見られる正確性要件と同様です。コードや日付の誤読は、請求の拒否やコンプライアンス上の問題につながる可能性があります。
8月の登録ラッシュ
全米教育統計センター(NCES)によると、米国のK-12公立学校には2024年秋時点で99,200校に約5,010万人の生徒が在籍しています。それらの入学手続きのほとんどは、7月中旬から9月上旬までの約6〜8週間の期間に処理され、1月には年度途中の転校や幼稚園の登録で二次的なピークがあります。
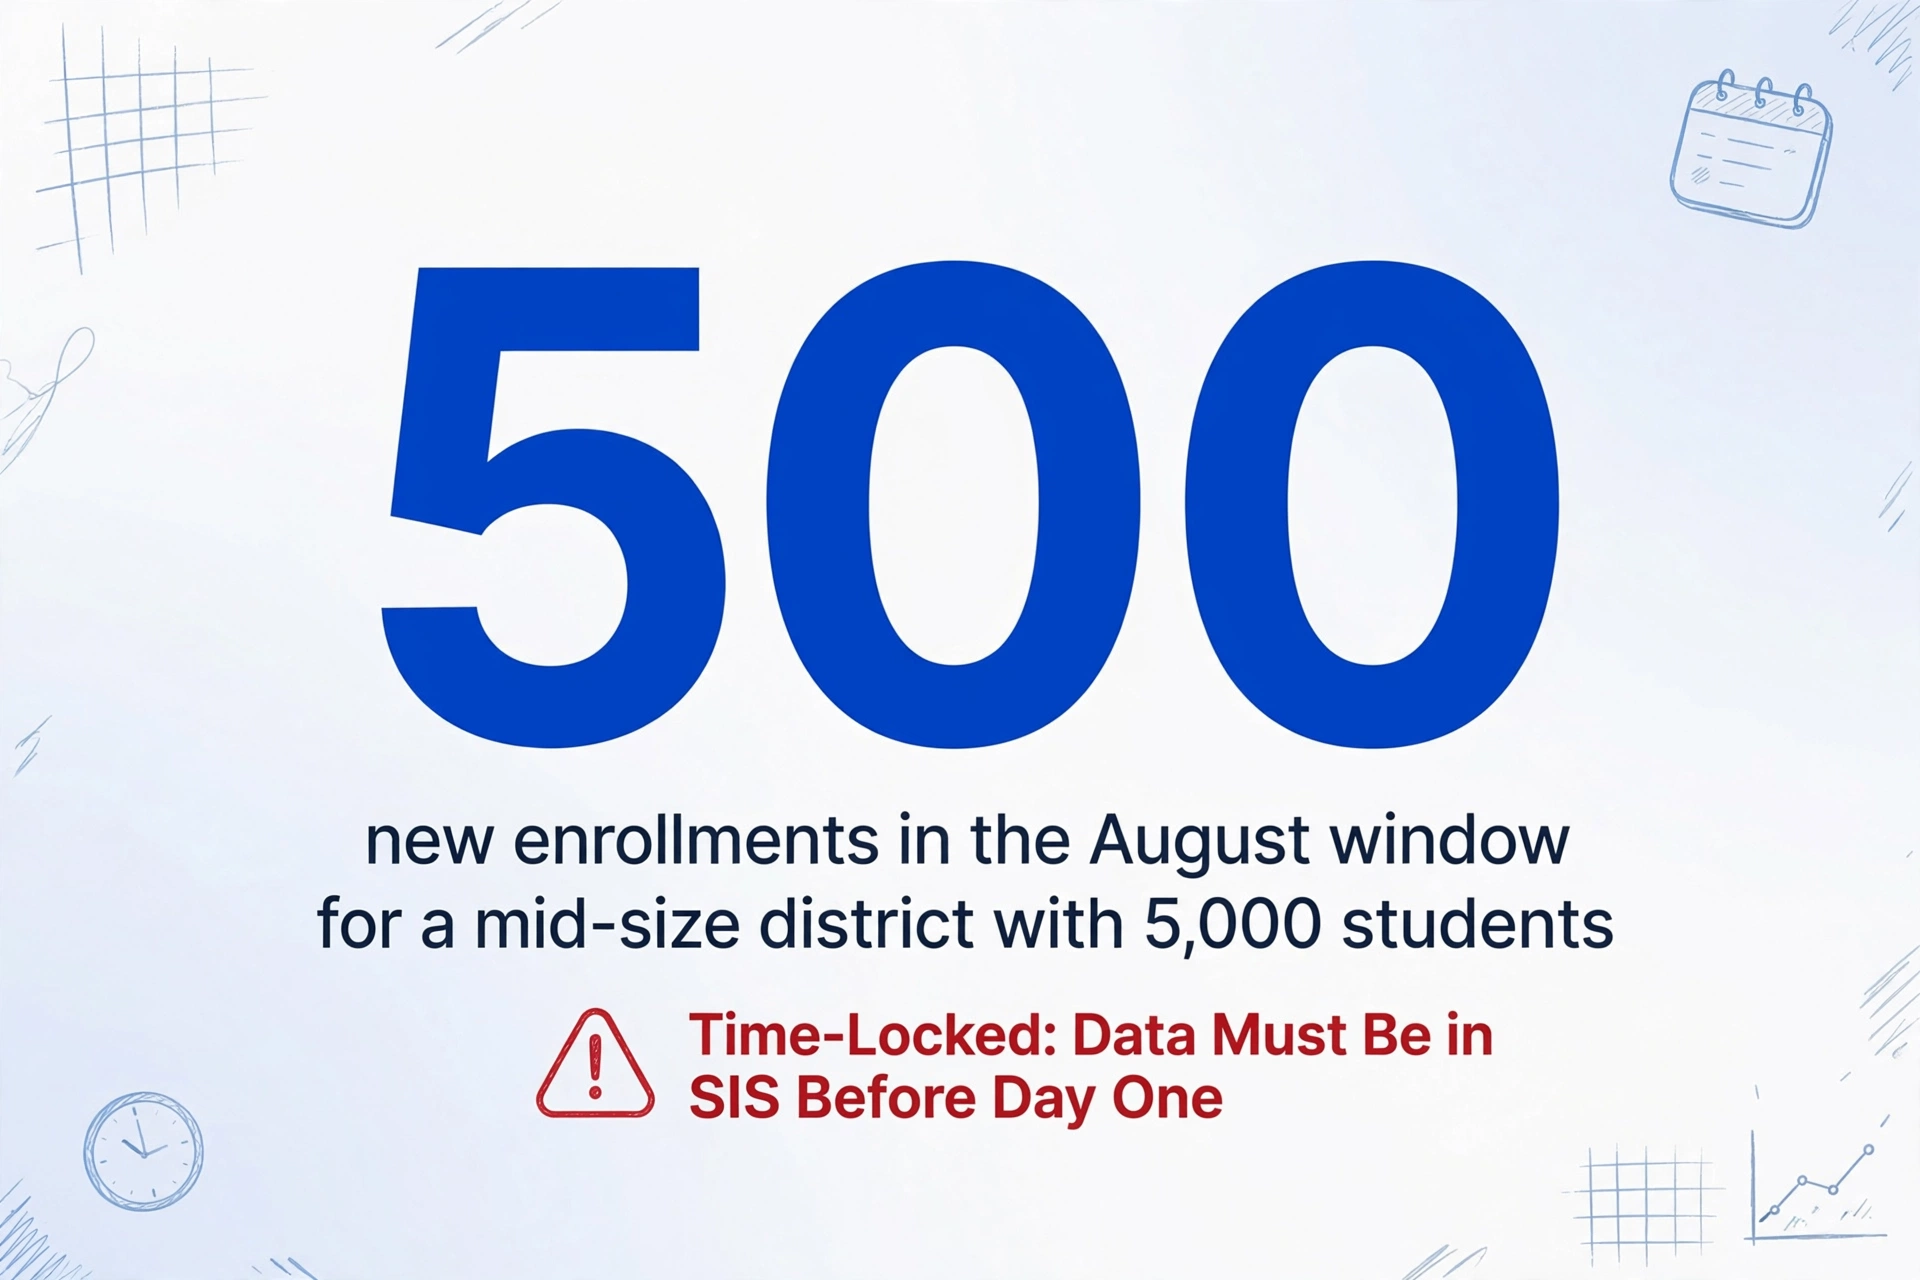
5,000人の生徒がいる中規模の学区では、8月の期間中に500件の新規入学を処理する可能性があります。さらに、住所確認、緊急連絡先の更新、医療フォームの更新が必要な4,500件の再登録もあります。2〜3人のフルタイムのデータ入力担当者がいる登録課では、ピーク時には1人あたり週に約150〜200件の入学書類を処理することになります。
問題は作業が難しいことではありません。問題はそれが時間に制約されていることです。データは生徒が初日に登校する前にSISに入力されていなければなりません。データ入力の待ち行列が長いからといって、学校が開始日を延期することはできません。生徒の緊急連絡先やアレルギー情報がSISではなく紙の書類に載っている日は、養護教諭や事務室が完全な情報なしで業務を行う日です。r/k12sysadminなどのコミュニティで話を聞く学校のIT管理者や登録担当者の多くは、これを技術的な課題というよりは物流上の課題と表現しています。データが紙にあり、紙は手動のキー入力の速度でしか動かないため、残業をいくらしても完全には解決できない、予測可能な毎年のボトルネックです。
従来のOCRがこれらのフォームでつまずく理由
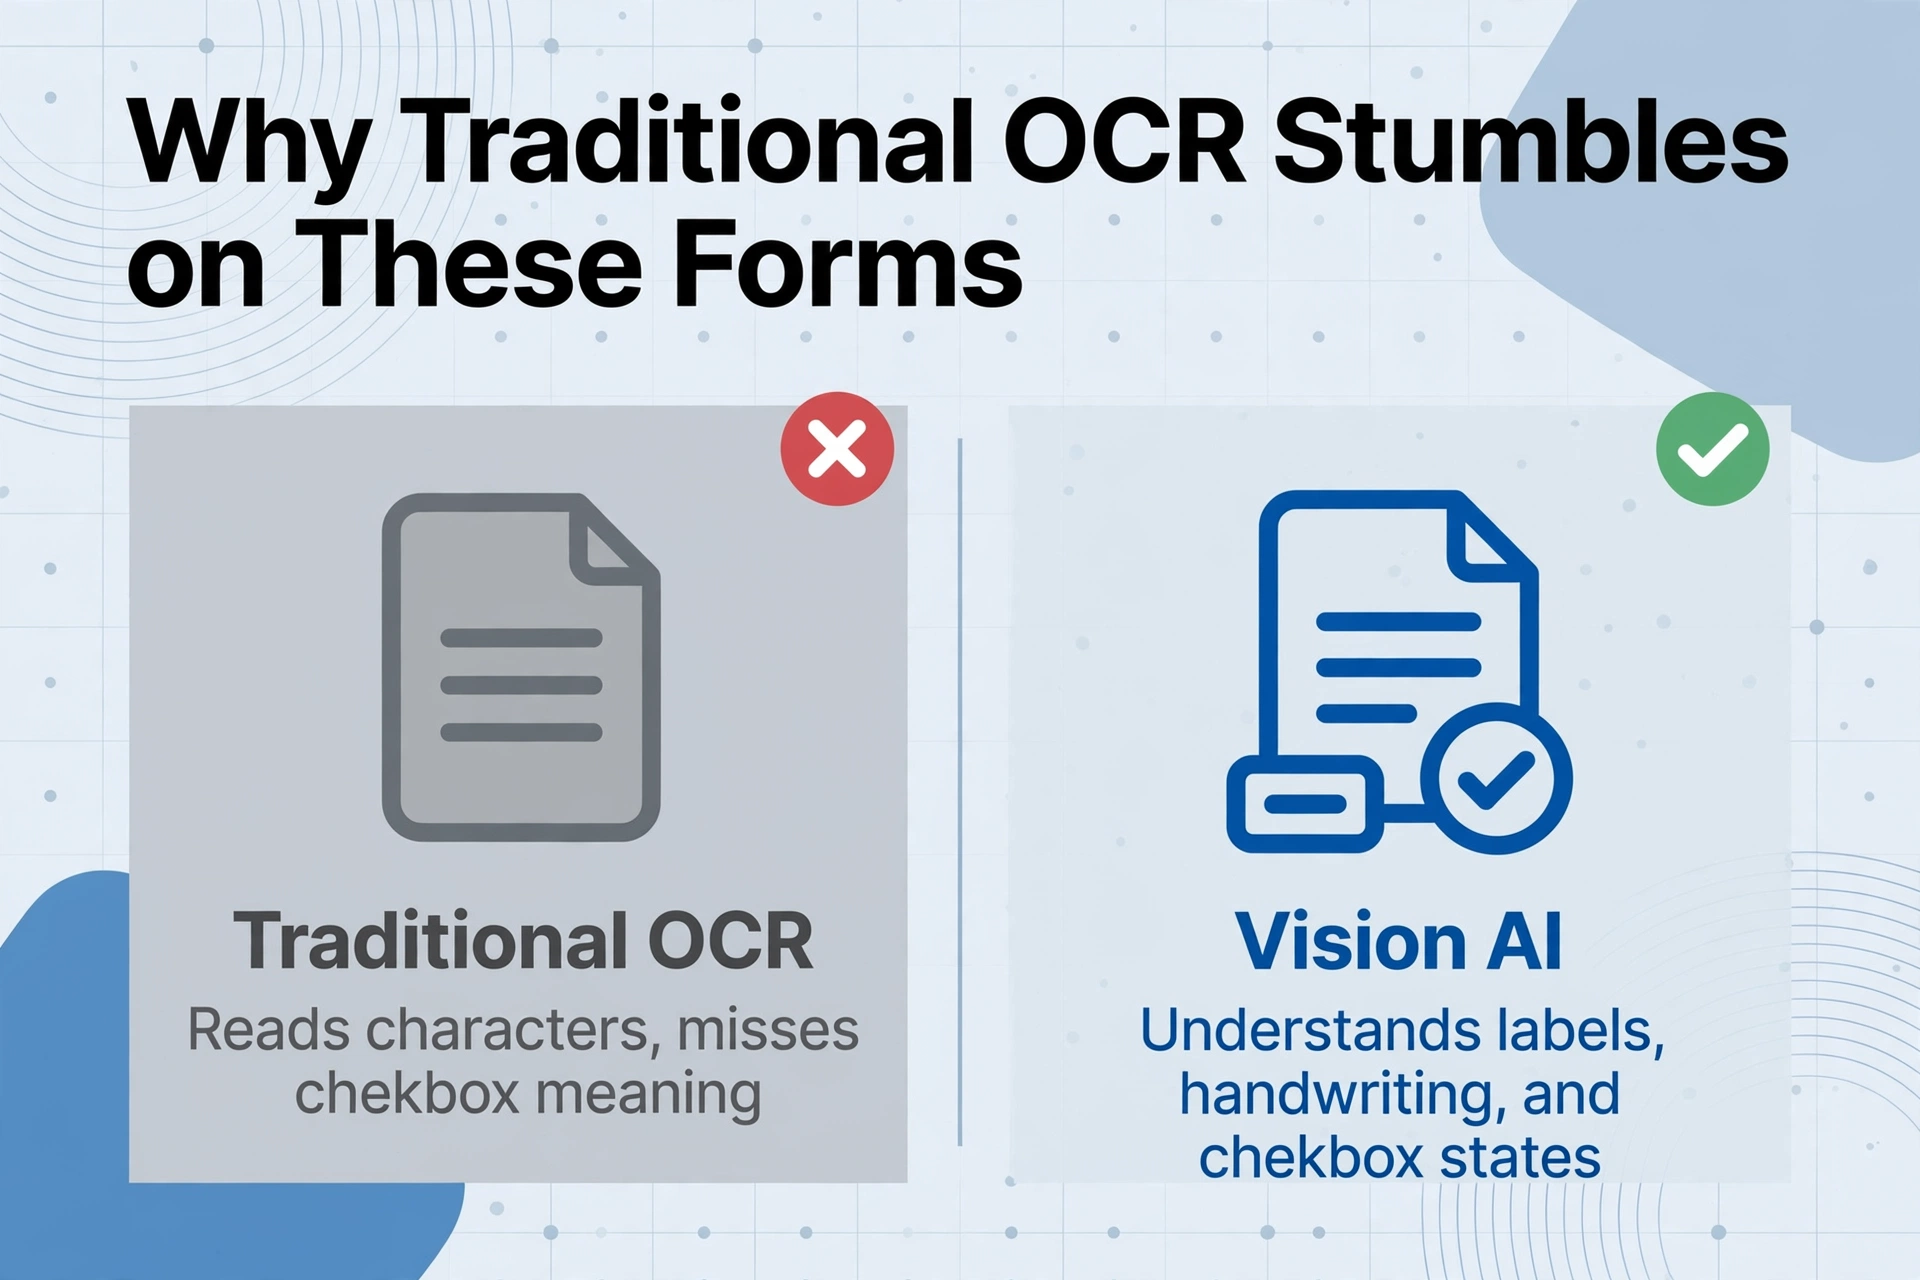
スキャンした入学書類一式を標準的なOCRエンジンにかけると、生のテキストの塊が返ってくるだけです。フィールドラベルもなく、チェックボックスの状態もなく、誰の電話番号なのかの区別もありません。ツールは文字を読み取りますが、「写真公開」セクションのチェックボックスと「緊急治療の同意」セクションのチェックボックスが異なる意味を持つことは理解しません。
入学フォームには、一般的な文書抽出ツールでは対応できない、従来のOCRパイプラインを壊す3つの特徴があります。
1. 手書きのばらつき。 保護者はさまざまな状況で入学フォームに記入します。静かな夜にキッチンテーブルで記入する人もいれば、車の送迎レーンで記入する人も、受付イベントでクリップボードと借りたペンで記入する人もいます。2024年のRedditコミュニティによる手書きOCRツールのベンチマークでは、最高のシステムでも、筆跡、ペンの圧力、テキストがフォームの枠内に収まっているかどうかによって、精度に大きなばらつきがあることが判明しました。入学フォームには、OCRエンジンが好むすっきりとした枠付きフィールドレイアウトがほとんどありません。下線付きの空欄、コロン区切りのラベル、手書きの記入と印刷済みテキストが混在するオープンスペースフィールドを使用しているものが多くあります。
2. チェックボックスの多さ。 1つの入学書類一式に、写真の同意、医療許可、緊急時の迎えの承認、言語選択、プログラムの資格、行動規範の同意など、20〜30個のチェックボックスが含まれることがあります。従来のOCRはテキストを読み取ります。チェックボックスはテキスト以外の記号であり、形状認識と位置的な文脈が必要です。チェックマーク、丸で囲んだ選択肢、×印、塗りつぶした四角はすべて入学の文脈では意味的に同等ですが、標準的なOCRエンジンはこれらを異なる文字やノイズとして認識します。そのため、多くの学校では、フォームをスキャナーからテキストへのパイプラインに通した後でも、スタッフが各チェックボックスフィールドを手動で確認しています。AmyGBによるチェックボックス検出の課題の分析で指摘されています。
3. 世帯の関連付け。 これは、ほとんどの抽出ツールが単純に対応していない課題です。3人の子どもがいる家族が入学する場合、受付には同じ保護者名、同じ電話番号、同じ住所、同じ緊急連絡先が記載された3つの別々の書類一式が届きますが、生徒名、生年月日、学年、病歴、許可の選択は異なります。各フォームを個別に処理するツールは、保護者フィールドが重複した3行のデータを生成します。世帯の関係を理解するツールは、重複をフラグし、繰り返されるフィールドをリンクされた家族レコードにまとめることができます。この違いは見た目の問題ではありません。SISが、事務員が手動で統合しなければならない3つの別々の世帯レコードになるか、3人のリンクされた生徒を持つ1つのきれいな家族エントリになるかを決定づけるのです。
入学処理におけるデータ入力のボトルネックは、読み取りではなく照合です。登録データ入力で最も時間がかかるのは、電話番号を一度入力することではなく、同じ電話番号が3つの異なるレコードに3回入力されていることを認識し、どのコピーを信頼するかを判断することです。
手書き文字が抽出ワークフローでこのような失敗を引き起こす理由について詳しくは、OCRが手書き文字を読み取れない場合の一般的な原因と修正方法をご覧ください。同じ手書きのばらつきという課題は、物流における配達証明書類やHACCP検査チェックリストにも影響しており、カーボンコピーの署名や現場作業員の手書き文字が同様の抽出上のハードルを生み出しています。
Vision AIが入学データを構造化スプレッドシートに抽出する仕組み
Vision AI — 具体的には、画像とテキストの両方を理解する大規模マルチモーダルモデルのクラス — は、従来のOCRとは異なるアプローチで入学フォームを処理します。文字の形状をスキャンする代わりに、文書全体を解釈します。印刷されたラベル(「保護者氏名」)とその隣の手書きの値との関係を認識します。「緊急処置を承認します」というラベルの付いた四角の中のチェックマークがバイナリのtrueを意味し、同じラベルの隣の空の四角がバイナリのfalseを意味することを理解します。
ImageToTable.aiは、カスタム列抽出と呼ばれるメカニズムを通じてこの機能を適用します。各フィールドの周りにボックスを描く代わりに — これは学校ごとの独自のフォームレイアウトごとに繰り返す必要があるプロセスです — 列名を入力して出力を定義します:「生徒名」「生年月日」「保護者電話」「写真使用許諾(はい/いいえ)」「アレルギー」。AIは、ピクセル座標を照合するのではなく、フィールドラベルの意味を理解することで各値を特定します。これは、ツールにどこを見るかを指示するのと、何を見つけるかを指示するのとの違いです。
入学フォームにとってこの違いが重要なのは、学区が5つの小学校から書類を受け取る場合、それぞれが5年前に異なる校長や事務補佐員によって設計されたわずかに異なるフォームレイアウトを使用している可能性があるためです。テンプレートベースのツールでは5つの個別のゾーン設定が必要です。カスタム列抽出では1つの列リストだけで済み、レイアウトのバリエーションを自動的に処理します。
フィールドごとの抽出戦略 — どの入学フィールドをバッチレベルで信頼でき、どのフィールドに常に人間による検証が必要か — については、学生入学フォーム抽出の完全ガイドをご覧ください。
ファイルは安全に処理され、保存されません。
このツールは、バッチファースト処理アーキテクチャにより、家族の関連付けという課題にも対応します。50件の登録パケット(同じ世帯のものもあれば、異なる家族のものもある)をアップロードすると、AIは各フォームを個別に処理して、生徒固有のフィールド(氏名、生年月日、学年、病歴)を抽出し、繰り返し出現する保護者・後見人データを重複の可能性があるものとしてフラグ付けします。出力されるスプレッドシートにはすべてのレコードが含まれ、重複する保護者の連絡先フィールドは各行に存在しますが、兄弟間で値が一貫しているため、SISインポート時に家族レベルのビューにまとめるのは簡単です。抽出結果の検証方法で説明しているように、一括SISインポートの前に、これらの繰り返しエントリをフラグ付けして確認することは、推奨される品質チェックです。
紙のフォームからSISへ:実践的なワークフロー
目的は登録担当者の判断をなくすことではなく、タイピングをなくして、登録担当者が重要な判断に集中できるようにすることです。ここでは、ビジョンAI抽出ワークフローが学区の既存の入学プロセスにどのように組み込まれるかを説明します。
受信した書類をスキャンまたは撮影する
一般的なオフィス用スキャナーやスマートフォンのカメラで対応できます。8月の繁忙期には、複数ページのPDFを出力できる専用のシートフィードスキャナーがあれば、処理を滞りなく進められます。各書類は1つのファイルにまとめてください。生徒1人につき1ファイルにすると、複数の書類が混在するよりも管理が容易です。
抽出ツールにアップロードする
スキャンしたファイルをまとめてアップロードします。このツールのバッチファースト設計(コード不要で文書を一括処理する方法に関する記事で詳しく解説)は、PDF、JPG、PNGを同時に受け付けるため、異なるスキャン元からの混在ファイル形式でも問題ありません。
抽出する列を定義する
SISのフィールドに合わせて列名を入力します。「生徒名」「生年月日」「保護者1氏名」「保護者1電話番号」「緊急連絡先氏名」「アレルギー」「写真掲載許可」「無料給食対象」などです。各列は出力スプレッドシートのヘッダーになります。フォームの正確なフィールド名と一致させる必要はありません。AIは表面のテキストではなく意味を解釈します。
処理と確認
ツールがすべてのファイルを順番に処理します。100件の入学書類(約300〜400ページ)のバッチは、通常15分以内で完了します。結果をExcelまたはCSVにエクスポートし、サンプル(レコードの10〜15%)を抜き取って修正が必要なフィールドがないか確認します。正確性が最も重要となる医療・アレルギー関連フィールドとチェックボックスによる許可項目には特に注意してください。
SISにインポートする
SIS標準の一括インポート機能(PowerSchool Data Export Manager、Infinite Campus Data Import Wizard、Skyward Import Utility)を使用してスプレッドシートを読み込みます。出力はすでに列ごとに構造化されているため、通常数時間かかるインポートマッピングの手順が数分で完了します。これらのSISインポートフィールドに対応したすぐに使える列テンプレートについては、SISインポート用に学生登録フォームのデータをExcelに抽出するガイドを参照してください。テンプレート不要の抽出アプローチを採用している学区では、登録サイクルが変わっても列リストは同じままで、フォームだけが変わります。
このワークフローには、新しいSIS、ソフトウェア統合プロジェクト、既存の登録手続きの変更は一切必要ありません。抽出ツールはSISの上流に位置するデータ準備レイヤーとして機能し、紙の書類をSISのインポートウィザードがそのまま読み取れる構造化された行に変換します。
FERPAとデータプライバシー:知っておくべきこと
家庭教育権利とプライバシー法(FERPA)— 合衆国法典第20編第1232条g項は、連邦政府の資金を受けているすべての教育機関における教育記録の開示を規定しています。FERPAの下では、入学フォームは学校または学校に代わって行動する者が管理した時点で「教育記録」となります。この規則は教育記録を広く定義しており、「手書き、印刷物、コンピュータメディア、ビデオテープ、オーディオテープ、フィルム、マイクロフィルム、マイクロフィッシュ」を含みます(連邦規則集第34編第99条2項)。
入学フォームの処理に第三者ツールを使用する場合、重要なFERPAの考慮事項は、そのツールが「正当な教育的関心を持つ学校関係者」に該当するかどうかです。FERPAの契約上の開示例外に基づき、学校はデータ処理などの機関機能を果たす外部サービスプロバイダーと教育記録を共有できます。ただし、以下の条件を満たす場合に限ります:
- プロバイダーが教育記録の使用と管理に関して学校の直接の管理下にあること
- プロバイダーが認可された目的にのみデータを使用すること
- プロバイダーが同意なしに第三者へ情報を再開示しないこと
- 学校が生徒のファイルに開示の記録を保持すること
実際には、抽出ツールは処理期間を超えて抽出データを保持または保存せずにファイルを処理する必要があります。ImageToTable.aiの処理モデル(ファイルが処理され、結果がダウンロード可能になり、一定期間後に原本が自動削除される)は、この枠組みに沿っています。学校はまた、SISベンダーの利用規約が第三者抽出ツールからインポートされたデータを考慮していることを確認する必要があります。紙からSISへのデータの来歴はFERPAの下で学校の責任であり続けるからです。これらの原則が類似の文書ワークフローにどのように適用されるかの概要については、保険請求フォームが同等のプライバシー要件をどのように処理するかを参照してください。規制構造は異なりますが(HIPAA対FERPA)、直接管理下のプロセッサーと契約するという運用パターンは同等です。他のコンプライアンス主導の抽出シナリオ、例えばデービス・ベーコン法に基づく認定給与報告書の処理も同様の論理に従います。データは紙から構造化データベースに入力され、規制上の義務を損なうことなく処理されなければなりません。
よくある質問
AIは、学校のデータベースに登録するのに十分な精度で手書きの入学フォームを抽出できますか?
Vision AIは、特にフォームに明確なラベルとフィールド間の区切りがある場合、フォームフィールド内の活字体の手書き文字を高い精度で認識します。精度は手書きの質によって異なります。丁寧に書かれた活字体は正確に抽出されますが、文字が重なり合う走り書きの筆記体は手動での確認が必要になる場合があります。入学フォームでは、すべてのフィールドを自動的に抽出し、エラーの影響が最も大きいフィールド(医療・アレルギー情報、緊急連絡先、チェックボックスによる許可)をスポットチェックするのが実用的なアプローチです。多くの学区では、10〜15%の確認率でも、完全な手動入力に比べて総作業時間は大幅に短縮されると報告しています。
チェックボックス(チェック、丸、×、塗りつぶし)を認識できますか?
はい。Vision AIは、チェックマーク、×印、塗りつぶし、丸囲みなど、あらゆる一般的なマークスタイルのチェックボックスを解釈し、スプレッドシートにブール値(はい/いいえ、真/偽)として出力します。この機能は、保護者の許可(写真公開、緊急処置、遠足の同意)が単一のチェックボックスで伝えられる入学フォームには不可欠です。詳細はAIがチェックボックス付きの手書きフォームを読み取る方法をご覧ください。
PowerSchool、Infinite Campus、Skywardと連携できますか?
ワンクリックで直接連携する機能はありません。このツールは、一括データインポートをサポートするあらゆるSISにインポートできる構造化スプレッドシートデータ(ExcelまたはCSV)をエクスポートします。PowerSchoolのData Export Manager、Infinite CampusのData Import Wizard、SkywardのImport Utilityはすべて、列ヘッダー付きのCSVファイルを受け入れます。インポートマッピング手順(スプレッドシートの列をSISフィールドに一致させる)はSIS設定ごとに一度だけ行う必要がありますが、抽出列の定義は入学サイクル全体で一貫しています。このスプレッドシートエクスポートアプローチは、Aeries、Illuminate、Gradelinkを含むあらゆるSISプラットフォームで機能します。
スキャナーではなくスマートフォンのカメラで入学フォームを処理できますか?
はい。このツールは、スマートフォン、タブレット、オフィスのスキャナーなど、あらゆるカメラで撮影した写真を入力として受け付けます。スマートフォンで撮影した入学フォームで最良の結果を得るには、フォームを平らな明るい場所に置き、ページ全体がフレームに収まり、影や過度なグレアがないことを確認してください。Vision AIモデルは、スマートフォン写真に伴う遠近歪みや照明の変化を処理できるようトレーニングされています。これは、家族が遠隔でフォームを提出する年度途中の登録に特に役立ちます。詳細はスキャナーなしで文書をデジタル化するガイドをご覧ください。
同じ学区の異なる学校で入学フォームのレイアウトが異なる場合はどうなりますか?
このツールはカスタム列抽出を使用しているため、画面上の位置ではなくラベルの意味でフィールドを探し、レイアウトの違いに自動的に対応します。同じ列リスト(例:「生徒名」「アレルギー」「写真公開」)が、異なる学校のフォームでも機能します。重要な要件は、紙のフォームのフィールドに、手書きの値の近くに認識可能なラベルがあることです。これは、学校ごとに個別の設定が必要なテンプレートベースのツールに比べて、大きな実用的な利点です。基盤となる仕組みについては、テンプレート不要の意味抽出の説明をご覧ください。
家族の重複問題(複数の子どもに同じ保護者情報がある場合)はどう処理すればよいですか?
このツールは各フォームを個別に処理するため、保護者・後見人フィールドは同じ家族に属するすべての行に表示されます。ただし、値は一貫して抽出されるため(同じ電話番号形式、同じ保護者名の綴り)、重複エントリは予測可能で、簡単に統合できます。推奨されるワークフローは、すべてのレコードをスプレッドシートに抽出し、保護者の連絡先フィールドで並べ替えて兄弟姉妹をグループ化し、SISの家族統合機能(PowerSchool、Infinite Campus、Skywardで利用可能)を使用してレコードを単一の世帯にリンクすることです。このようなバッチ指向のアプローチのツールについては、コーディング不要のバッチ処理で詳しく説明しています。
均一性を前提としない入学フォーム抽出
入学フォームのデータ入力における根本的な課題は、フォームが読みにくいことではありません。フォームが多様であり、誤読が許されない医療データを含み、予測可能なピーク時に届き、同じ保護者の電話番号が3人の異なる子どもについて3人の異なるデータ入力担当者に渡されることです。すべてのフォームが同じ見た目であると想定し、各文書を単独で処理し、チェック済みのチェックボックスと空のチェックボックスを確実に区別できないツールは、節約する以上にクリーンアップ作業を生み出します。
Vision AI抽出は、登録担当者を排除することで入学データの問題を解決するのではなく、タイピング、重複入力、疲労によるエラー、手動のチェックボックス確認を排除することで解決します。検証と家族の関連付けの判断は、生徒と学区のデータポリシーを理解している人々に委ねられます。変わるのは、それらの判断がキーボードの速度ではなく、スプレッドシートのレビューの速度で行われることです。
登録不要 · クレジットカード不要 · 10秒で結果