So extrahieren Sie Schüleranmeldeformulare
in eine Schuldatenbank-Tabelle
Ein Schüleranmeldeformular fragt einmal nach der Telefonnummer eines Elternteils. Wenn dieser Elternteil zwei Kinder in demselben Schulbezirk anmeldet, wird diese Telefonnummer zweimal in ein Schülerinformationssystem – PowerSchool, Infinite Campus oder Skyward – eingegeben. Bei drei Kindern dreimal. Dieselben Ziffern, mehrfach eingegeben, über mehrere Datensätze hinweg, für denselben Haushalt. Diese Duplizierung ist kein Randfall. Sie ist die strukturelle Signatur der Verarbeitung von Anmeldedaten und erklärt, warum die Anmeldewelle im August nicht nur ein Mengenproblem ist, sondern ein Korrelationsproblem, das manuelle Dateneingabe-Pipelines – und die meisten Extraktionstools – nie dafür ausgelegt waren zu lösen.
Die wichtigsten Erkenntnisse
- Der Engpass bei Anmeldedaten ist nicht die Lesegeschwindigkeit – sondern dass dieselbe Telefonnummer eines Elternteils für drei Geschwister dreimal eingegeben wird und Ihr SIS denkt, sie gehören zu drei verschiedenen Familien.
- Eine Standard-OCR-Engine behandelt die 20 bis 30 Kontrollkästchen auf einem Anmeldepaket als Rauschen, sodass jemand jedes bereits auf dem Formular markierte Foto-Einverständnis und jede medizinische Genehmigung manuell überprüfen muss.
- Statt auf dem einzigartigen Formularlayout jeder Schule Kästchen zu zeichnen, definieren Sie einmal, was Sie benötigen, anhand des Spaltennamens – die KI findet Felder anhand der Bedeutung der Beschriftung, nicht anhand ihrer Position auf der Seite, und der Anmeldekoordinator wechselt vom Tippen zur Compliance-Prüfung.
Was ein Schüleranmeldeformular tatsächlich enthält
Ein Schüleranmeldepaket – manchmal auch Registrierungspaket genannt – ist kein einzelnes Dokument. Es ist ein Bündel von Formularen, die gemeinsam die rechtliche Identität, die medizinische Bereitschaft und die schulische Berechtigung eines Schülers innerhalb eines Schulbezirks festlegen. Während das genaue Layout von Bezirk zu Bezirk variiert – und oft von Schule zu Schule innerhalb desselben Bezirks – sind die Datenkategorien im gesamten US-amerikanischen K-12-Bildungswesen bemerkenswert konsistent.
Ein typisches Papieranmeldepaket enthält die folgenden Feldgruppen:
| Feldkategorie | Beispiele | Eingabemethode |
|---|---|---|
| Schüleridentität | Vollständiger legaler Name, Geburtsdatum, Geburtsort, Geschlecht | Handschriftlich (Druck- oder Schreibschrift) |
| Eltern-/Erziehungsberechtigten-Informationen | Name(n), Festnetznummer, Mobilnummer, E-Mail, Arbeitgeber, dienstliche Telefonnummer | Handschriftlich |
| Adresse und Haushalt | Physische Adresse, Postanschrift, zu Hause gesprochene Sprache, Anzahl der Bewohner | Handschriftlich + Kontrollkästchen (Sprachauswahl) |
| Notfallkontakte | 2-3 Kontaktnamen, Beziehungen, Telefonnummern | Handschriftlich |
| Medizinische Informationen | Allergien, Medikamente, chronische Erkrankungen, Impfstatus, Hausarzt | Handschriftlich + Kontrollkästchen |
| Vorherige Schulbildung | Zuletzt besuchte Schule, Klassenstufe, Abmeldedatum | Handschriftlich |
| Berechtigungen und Bestätigungen | Fotoerlaubnis, Einwilligung für Ausflüge, Autorisierung für Notfallbehandlung, Computernutzungsvereinbarung | Kontrollkästchen + Unterschrift |
| Programmberechtigung | Antrag auf kostenloses/vergünstigtes Mittagessen, ESL/ELL-Status, Sonderpädagogik-Überweisung | Kontrollkästchen + handschriftliche Erläuterung |
Die Vielfalt der Eingabemethoden – Druckschrift, Schreibschrift, Kontrollkästchen, Unterschriften – ist der erste Hinweis darauf, dass eine generische OCR-Pipeline diese Formulare nicht gut verarbeiten kann. Der zweite Hinweis ist, dass diese Feldgruppen nicht unabhängig sind: Eltern-/Erziehungsberechtigten- und Notfallkontaktfelder enthalten bei Geschwistern oft identische Informationen, doch die Formulare werden für jedes Kind separat ausgefüllt. Dieses Haushalts-Duplikationsmuster – bei dem dieselben Daten über mehrere verwandte Datensätze hinweg wiederholt werden – ist eine Herausforderung, die auch in anderen Bereichen auftritt, etwa beim Extrahieren von Mietvertragsdaten aus einem Immobilienportfolio, wo derselbe Vermieter oder dieselbe Verwaltungsgesellschaft in mehreren Mieterdatensätzen erscheint.
Die LINQ-Registrierungsanalyse beziffert die Fehlerquote bei manueller Dateneingabe auf etwa 1 % pro Feld. Bezogen auf ein 40-Felder-Anmeldeformular für 500 Schüler ergibt das 200 Übertragungsfehler, bevor das Schuljahr beginnt – eine optimistische Schätzung, da sich Ermüdung während des August-Ansturms verstärkt und die Handschrift der Eltern stark variiert. Medizinische Felder – Allergien, Medikamente, chronische Erkrankungen – haben die schwerwiegendsten Folgen bei Fehlern, ähnlich den Genauigkeitsanforderungen bei der Extraktion von medizinischen Anspruchsformularen (CMS-1500), wo ein falsch gelesener Code oder ein falsches Datum zu einer Anspruchsablehnung oder Compliance-Problemen führen kann.
Der August-Anmeldungsansturm
Laut Nationales Zentrum für Bildungsstatistik (NCES) waren im Herbst 2024 an den öffentlichen K-12-Schulen in den USA etwa 50,1 Millionen Schüler an 99.200 Schulen eingeschrieben. Die meisten dieser Einschreibungen werden in einem Zeitfenster von etwa sechs bis acht Wochen zwischen Mitte Juli und Anfang September verarbeitet, mit einem zweiten Anstieg im Januar für Schulwechsel und Kindergarteneinschreibungen.
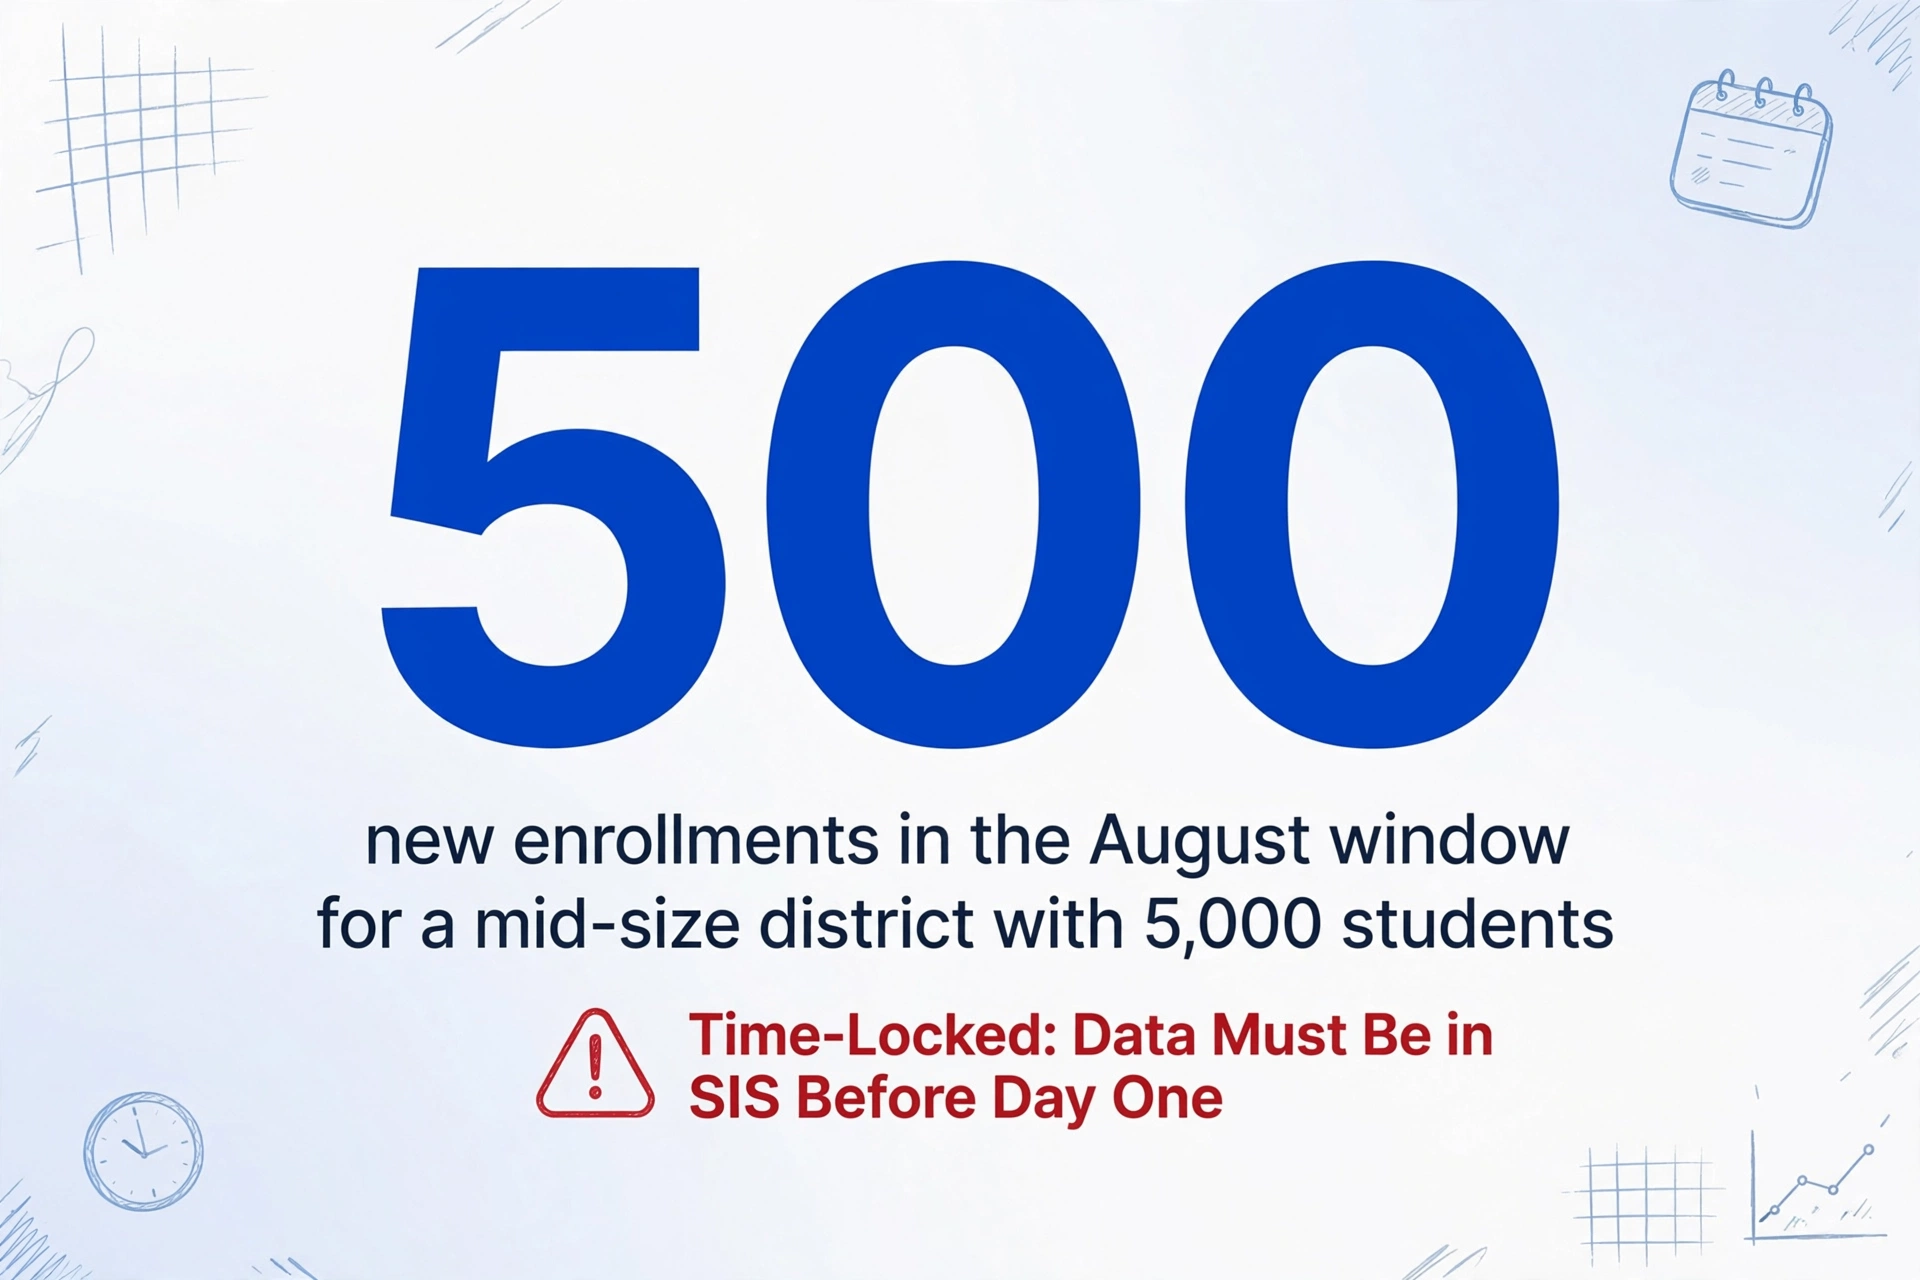
Ein mittelgroßer Bezirk mit 5.000 Schülern könnte im August-Fenster 500 neue Einschreibungen verarbeiten – plus 4.500 Wiedereinschreibungen, die dennoch die Überprüfung der Adresse, Aktualisierung der Notfallkontakte und Erneuerung medizinischer Formulare erfordern. Für ein Registrarbüro mit zwei bis drei Vollzeit-Datenerfassungskräften bedeutet das in der Spitze etwa 150–200 Anmeldepakete pro Person und Woche.
Das Problem ist nicht, dass die Arbeit schwer ist. Das Problem ist, dass sie zeitgebunden ist. Die Daten müssen im SIS sein, bevor die Schüler am ersten Tag eintreffen; Schulen können den Starttermin nicht verschieben, nur weil die Dateneingabe-Warteschlange lang ist. Jeder Tag, an dem die Notfallkontakt- oder Allergieinformationen eines Schülers in einem Papierpaket statt im SIS liegen, ist ein Tag, an dem die Schulkrankenschwester und das Sekretariat ohne vollständige Informationen arbeiten. Die meisten IT-Administratoren und Registrare, von denen wir in Communities wie r/k12sysadmin hören, beschreiben dies weniger als technische Herausforderung, sondern eher als logistische – ein vorhersehbarer jährlicher Engpass, den keine noch so große Überstundenleistung vollständig löst, weil die Daten auf Papier sind und Papier sich mit der Geschwindigkeit manueller Tastatureingaben bewegt.
Warum herkömmliche OCR bei diesen Formularen scheitert
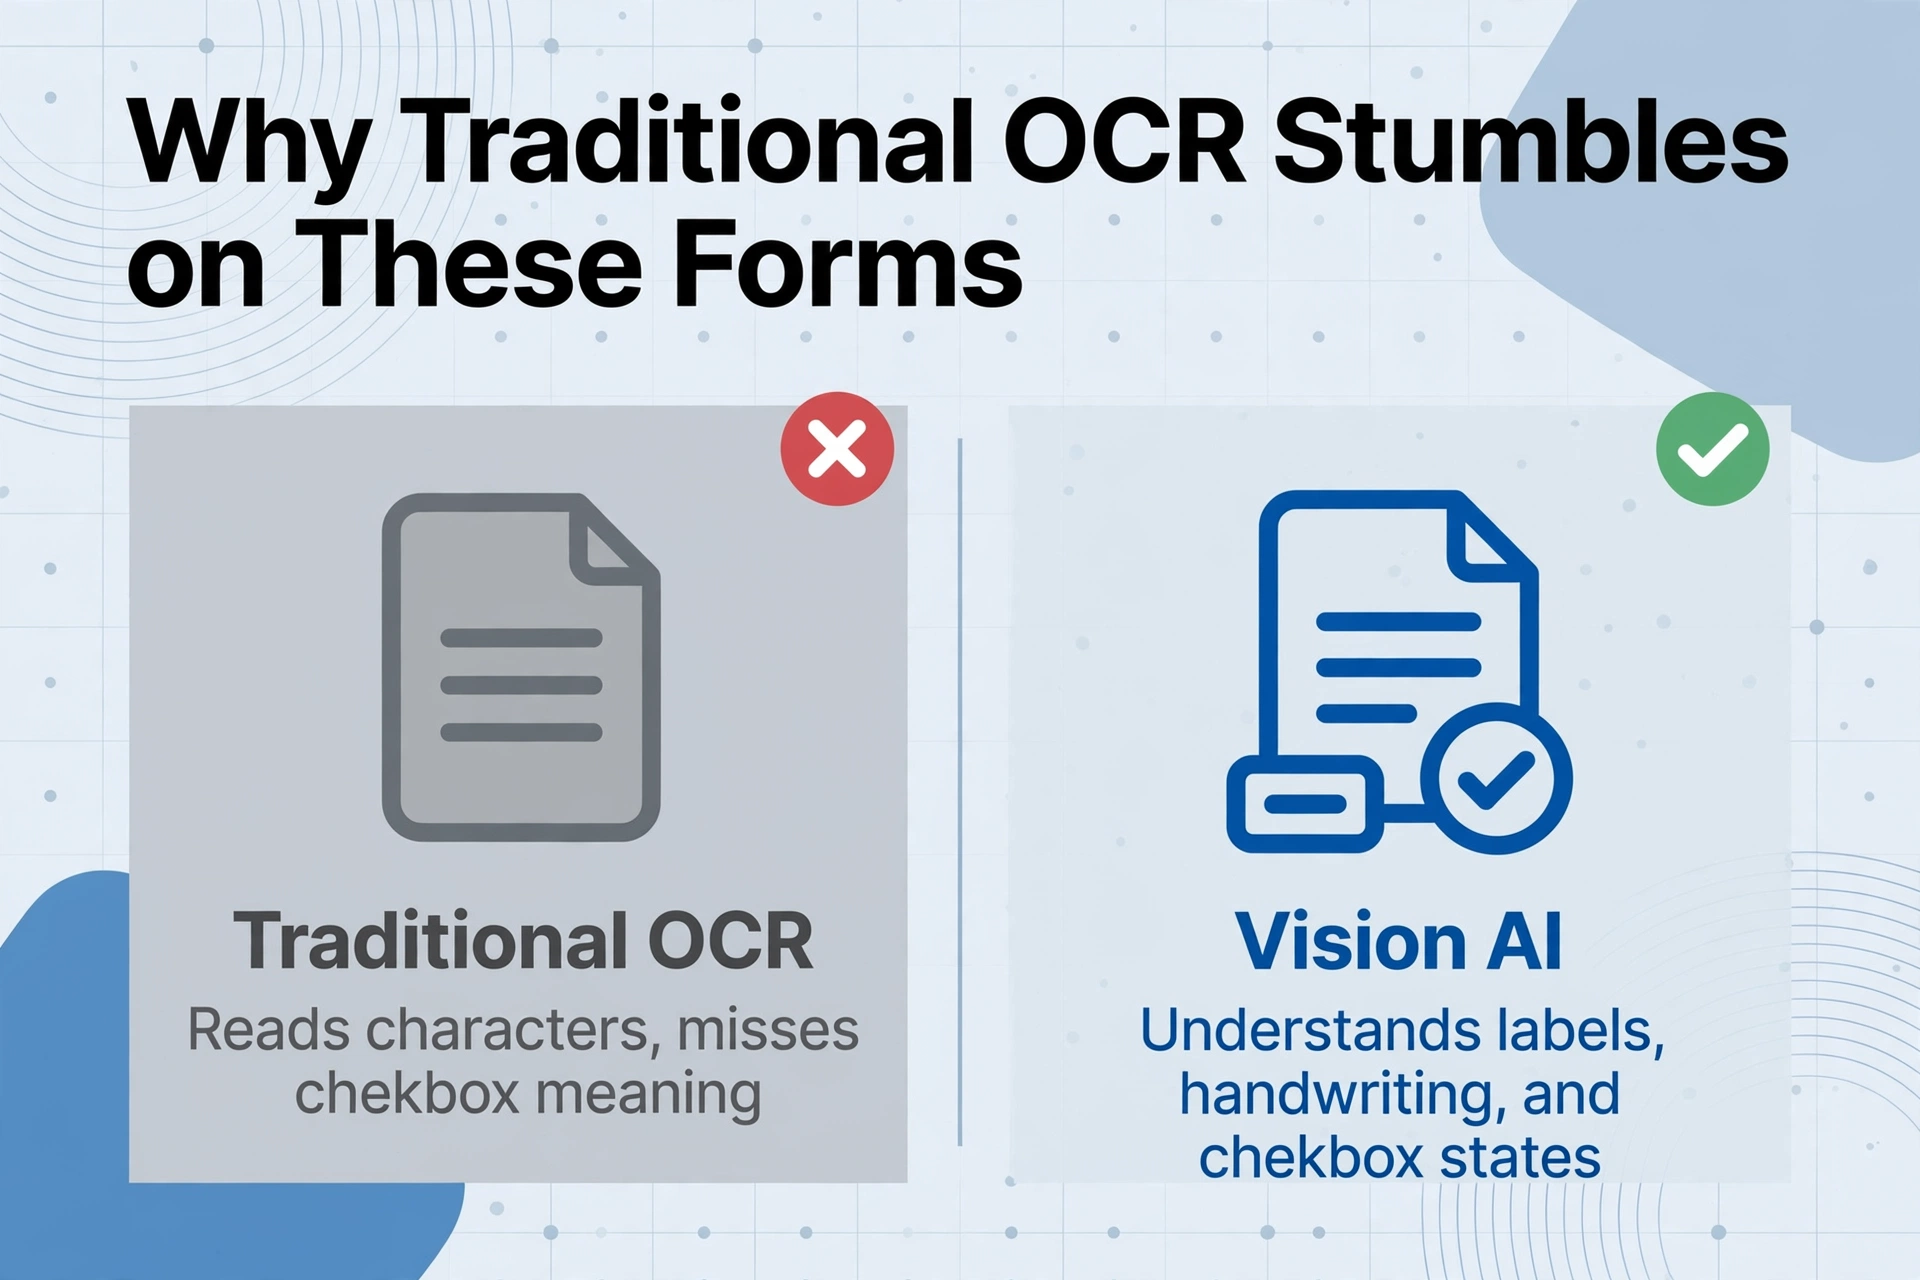
Wenn Sie ein gescanntes Anmeldepaket durch eine Standard-OCR-Engine laufen lassen, erhalten Sie eine Wand aus Rohtext zurück – ohne Feldbeschriftungen, ohne Kontrollkästchen-Status, ohne Unterscheidung, wessen Telefonnummer welche ist. Das Tool liest Zeichen, versteht aber nicht, dass ein Kontrollkästchen im Abschnitt „Foto-Freigabe“ etwas anderes bedeutet als ein Kontrollkästchen im Abschnitt „Genehmigung für Notfallbehandlung“.
Drei spezifische Merkmale von Anmeldeformularen bringen herkömmliche OCR-Pipelines auf eine Weise zum Scheitern, die generische Dokumentextraktions-Tools nicht bewältigen:
1. Variabilität der Handschrift. Eltern füllen Anmeldeformulare unter unterschiedlichen Bedingungen aus – einige am Küchentisch an einem ruhigen Abend, andere im Auto während der Abholschlange, wieder andere bei einer Registrierungsveranstaltung mit Klemmbrett und geliehenem Stift. Ein 2024 Reddit-Community-Benchmark für Handschrift-OCR-Tools ergab, dass selbst die besten Systeme je nach Schreibstil, Stiftdruck und ob der Text innerhalb der Formularfelder blieb, starke Genauigkeitsschwankungen aufwiesen. Anmeldeformulare haben selten das saubere, kastenförmige Feldlayout, das OCR-Engines bevorzugen – viele verwenden unterstrichene Leerfelder, durch Doppelpunkte getrennte Beschriftungen oder offene Freifelder, die handschriftliche Einträge mit vorgedrucktem Text vermischen.
2. Kontrollkästchendichte. Ein einzelnes Anmeldepaket kann 20-30 Kontrollkästchen enthalten – für Foto-Einwilligung, medizinische Genehmigungen, Abholberechtigung im Notfall, Sprachauswahl, Programmberechtigung und Bestätigung des Verhaltenskodex. Herkömmliche OCR liest Text; Kontrollkästchen sind nicht-textuelle Symbole, die Formerkenner und Positionskontext erfordern. Ein angekreuztes Kästchen, eine eingekreiste Option, ein X-Zeichen oder ein ausgefülltes Quadrat sind im Anmeldekontext semantisch gleichwertig – aber eine Standard-OCR-Engine sieht sie als unterschiedliche Zeichen oder Rauschen. Deshalb müssen viele Schulen auch nach dem Durchlaufen eines Scanner-zu-Text-Prozesses weiterhin Personal jedes Kontrollkästchen manuell überprüfen, wie in der AmyGB-Analyse der Herausforderungen bei der Kontrollkästchenerkennung festgestellt wurde.
3. Haushaltskorrelation. Dies ist die Herausforderung, die die meisten Extraktions-Tools schlicht nicht adressieren. Wenn eine Familie mit drei Kindern sich anmeldet, erhält das Sekretariat drei separate Pakete mit denselben Elterndaten, denselben Telefonnummern, derselben Adresse, denselben Notfallkontakten – aber unterschiedlichen Schülernamen, Geburtsdaten, Klassenstufen, Krankengeschichten und Berechtigungsentscheidungen. Ein Tool, das jedes Formular unabhängig verarbeitet, erzeugt drei Datenzeilen mit redundanten Elternfeldern. Ein Tool, das die Haushaltsbeziehung versteht, kann Duplikate kennzeichnen und wiederholte Felder zu einem verknüpften Familiendatensatz zusammenfassen. Der Unterschied ist nicht kosmetisch – er bestimmt, ob das SIS am Ende drei separate Haushaltsdatensätze enthält, die ein Sachbearbeiter manuell zusammenführen muss, oder einen sauberen Familieneintrag mit drei verknüpften Schülern.
Der Engpass bei der Dateneingabe in der Einschreibungsverarbeitung ist nicht das Lesen – sondern die Korrelation. Der zeitaufwendigste Teil der Registrierungsdateneingabe besteht nicht darin, eine Telefonnummer einmal einzutippen; es ist das Erkennen, dass dieselbe Telefonnummer dreimal in drei verschiedenen Datensätzen eingegeben wurde, und die Entscheidung, welchen Kopien man vertrauen kann.
Für einen tieferen Einblick, warum Handschrift diese Fehler in Extraktionsworkflows verursacht, finden Sie in unserer ausführlichen Analyse unter OCR liest Handschrift nicht: Häufige Ursachen und Lösungen. Dieselbe Herausforderung der handschriftlichen Variabilität betrifft auch Zustellnachweise in der Logistik und HACCP-Inspektionschecklisten, wo Durchschlagunterschriften und Handschrift von Außendienstmitarbeitern ähnliche Extraktionshürden schaffen.
Wie Vision AI Einschreibungsdaten in strukturierte Tabellen extrahiert
Vision AI – insbesondere die Klasse großer multimodaler Modelle, die sowohl Bilder als auch Text verstehen – geht Einschreibungsformulare anders an als herkömmliche OCR. Statt nach Zeichenformen zu suchen, interpretiert es das Dokument als Ganzes: Es erkennt die Beziehung zwischen einem gedruckten Label („Name des Erziehungsberechtigten") und dem handschriftlichen Wert daneben. Es versteht, dass ein Häkchen in einem Kästchen mit der Beschriftung „Ja, ich autorisiere Notfallbehandlung" einen binären Wahr-Wert bedeutet, während ein leeres Kästchen neben demselben Label einen binären Falsch-Wert bedeutet.
ImageToTable.ai wendet diese Fähigkeit über einen Mechanismus namens Benutzerdefinierte Spaltenextraktion an. Statt Kästchen um jedes Feld zu zeichnen – ein Prozess, der für jedes einzigartige Formularlayout jeder Schule wiederholt werden muss – definieren Sie die gewünschte Ausgabe, indem Sie Spaltennamen eingeben: „Schülername", „Geburtsdatum", „Telefon der Eltern", „Fotoerlaubnis (Ja/Nein)", „Allergien". Die KI lokalisiert jeden Wert, indem sie versteht, was das Feldlabel bedeutet, nicht durch den Abgleich von Pixelkoordinaten. Das ist der Unterschied zwischen einem Tool zu sagen, wo es suchen soll, und ihm zu sagen, was es finden soll.
Für Einschreibungsformulare ist diese Unterscheidung wichtig, weil ein Schulbezirk Pakete von fünf Grundschulen erhalten kann, die jeweils ein leicht unterschiedliches Formularlayout verwenden, das von einem anderen Schulleiter oder Verwaltungsassistenten vor fünf Jahren entworfen wurde. Ein vorlagenbasiertes Tool erfordert fünf separate Zonenkonfigurationen. Benutzerdefinierte Spaltenextraktion erfordert eine Spaltenliste – und handhabt die Layoutvariationen automatisch.
Für eine feldweise Extraktionsstrategie – welche Einschreibungsfelder auf Batchebene vertrauenswürdig sind und welche immer eine menschliche Überprüfung benötigen – finden Sie in unserem vollständigen Leitfaden zur Extraktion von Schüler-Einschreibungsformularen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Das Tool bewältigt auch die Herausforderung der Familienkorrelation durch seine Batch-First-Verarbeitung. Wenn Sie 50 Anmeldepakete hochladen – einige aus demselben Haushalt, einige von verschiedenen Familien – verarbeitet die KI jedes Formular unabhängig für schülerspezifische Felder (Name, Geburtsdatum, Klassenstufe, Krankengeschichte) und kennzeichnet wiederholte Eltern-/Erziehungsberechtigtendaten als wahrscheinliche Duplikate. Die Ausgabetabelle enthält alle Datensätze; die doppelten Felder für Elterndaten sind in jeder Zeile vorhanden, jedoch mit konsistenten Werten über Geschwister hinweg, was es einfach macht, sie während des SIS-Importschritts auf eine Familienebene zu reduzieren. Wie wir in So überprüfen Sie Extraktionsergebnisse behandeln, ist das Kennzeichnen und Überprüfen dieser wiederholten Einträge eine empfohlene Qualitätskontrolle vor jedem Massenimport in das SIS.
Vom Papierformular zum SIS: Ein praktischer Arbeitsablauf
Das Ziel ist nicht, das Ermessen des Registrars zu eliminieren — sondern das Tippen, damit sich der Registrar auf die wichtigen Ermessensentscheidungen konzentrieren kann. So fügt sich ein Vision-AI-Extraktionsworkflow in den bestehenden Einschreibungsprozess eines Schulbezirks ein:
Eingehende Unterlagen scannen oder fotografieren
Ein handelsüblicher Büroscanner oder die Kamera eines Smartphones genügen. Für den Ansturm im August hält ein spezieller Einzugsscanner, der mehrseitige PDFs ausgibt, den Arbeitsfluss in Gang. Stellen Sie sicher, dass jedes Paket eine einzige Datei ist – eine Datei pro Schüler lässt sich leichter nachverfolgen als gemischte Dokumente.
In das Extraktionstool hochladen
Laden Sie die gescannten Dateien als Stapel hoch. Das Batch-First-Design des Tools – behandelt in unserem Artikel über die Stapelverarbeitung von Dokumenten ohne Programmierung – akzeptiert PDFs, JPGs und PNGs gleichzeitig, sodass gemischte Dateitypen aus verschiedenen Scanquellen kein Problem darstellen.
Extraktionsspalten definieren
Geben Sie die Spaltennamen ein, die den Feldern in Ihrem SIS entsprechen – „Schülername“, „Geburtsdatum“, „Name Erziehungsberechtigter 1“, „Telefon Erziehungsberechtigter 1“, „Name Notfallkontakt“, „Allergien“, „Fotofreigabe“, „Anspruch auf kostenloses Mittagessen“. Jede Spalte wird zu einer Kopfzeile in der Ausgabetabelle. Sie müssen nicht die exakten Feldbezeichnungen des Formulars übernehmen; die KI interpretiert die Bedeutung, nicht den oberflächlichen Text.
Verarbeiten und prüfen
Das Tool verarbeitet alle Dateien der Reihe nach. Ein Stapel von 100 Anmeldeunterlagen – etwa 300–400 Seiten – ist in der Regel in unter 15 Minuten fertig. Exportieren Sie die Ergebnisse nach Excel oder CSV und prüfen Sie dann eine Stichprobe (10–15 % der Datensätze) auf Felder, die korrigiert werden müssen. Achten Sie besonders auf medizinische Felder und Allergiefelder sowie auf Checkbox-Berechtigungen, wo Genauigkeit am wichtigsten ist.
In Ihr SIS importieren
Nutzen Sie die native Stapelimportfunktion des SIS (PowerSchool Data Export Manager, Infinite Campus Data Import Wizard, Skyward Import Utility), um die Tabelle zu laden. Da die Ausgabe bereits spaltenweise strukturiert ist, dauert der Import-Mapping-Schritt – der normalerweise Stunden in Anspruch nimmt – nur Minuten. Eine einsatzbereite Spaltenvorlage, die auf diese SIS-Importfelder abgestimmt ist, finden Sie in unserem Leitfaden zum Extrahieren von Schüleranmeldeformulardaten nach Excel für den SIS-Import. Für Bezirke, die einen Ansatz ohne Vorlage verwenden, bleibt die Spaltenliste über die Anmeldezyklen hinweg gleich; nur die Formulare ändern sich.
Dieser Arbeitsablauf erfordert weder ein neues SIS, ein Software-Integrationsprojekt noch eine Änderung der bestehenden Anmeldeverfahren. Das Extraktionstool sitzt vorgelagert zum SIS als Datenaufbereitungsebene und wandelt Papier in strukturierte Zeilen um, die der SIS-Importassistent bereits zu lesen weiß.
FERPA und Datenschutz: Was Sie wissen müssen
Der Family Educational Rights and Privacy Act (FERPA) — 20 U.S.C. § 1232g — regelt die Offenlegung von Bildungsunterlagen an jeder Einrichtung, die Bundesmittel erhält. Gemäß FERPA wird ein Anmeldeformular in dem Moment zu einer „Bildungsunterlage“, in dem es von der Schule oder einer im Auftrag der Schule handelnden Partei aufbewahrt wird. Die Verordnung definiert Bildungsunterlagen weit gefasst – einschließlich „Handschrift, Druck, Computermedien, Videoband, Audioband, Film, Mikrofilm und Mikrofiche“ (34 CFR § 99.2).
Bei der Verwendung eines Drittanbieter-Tools zur Verarbeitung von Anmeldeformularen ist der wichtigste FERPA-Gesichtspunkt, ob das Tool als „Schulbeamter mit berechtigtem Bildungsinteresse“ qualifiziert. Gemäß der vertraglichen Offenlegungsausnahme von FERPA dürfen Schulen Bildungsunterlagen an externe Dienstleister weitergeben, die eine institutionelle Funktion – wie z. B. Datenverarbeitung – ausüben, sofern:
- Der Anbieter steht unter der direkten Kontrolle der Schule hinsichtlich der Nutzung und Aufbewahrung von Bildungsunterlagen
- Der Anbieter nutzt die Daten nur für den autorisierten Zweck
- Der Anbieter gibt die Informationen nicht ohne Zustimmung an Dritte weiter
- Die Schule führt eine Aufzeichnung der Offenlegung in der Schülerakte
In der Praxis bedeutet dies, dass das Extraktionstool Dateien verarbeiten sollte, ohne die extrahierten Daten über den Verarbeitungszeitraum hinaus zu speichern oder aufzubewahren. Das Verarbeitungsmodell von ImageToTable.ai – Dateien werden verarbeitet und Ergebnisse zum Download bereitgestellt, mit automatischer Löschung der Originale nach einem festgelegten Zeitraum – entspricht diesem Rahmen. Schulen sollten außerdem sicherstellen, dass die Nutzungsbedingungen ihres SIS-Anbieters Daten berücksichtigen, die aus Tools von Drittanbietern zur Extraktion importiert werden, da die Datenherkunft vom Papier zum SIS gemäß FERPA in der Verantwortung der Schule bleibt. Für einen breiteren Überblick darüber, wie diese Prinzipien auf ähnliche Dokumenten-Workflows angewendet werden, siehe wie Versicherungsanspruchsformulare gleichwertige Datenschutzanforderungen behandeln – die regulatorische Struktur ist unterschiedlich (HIPAA vs. FERPA), aber das operative Muster der Beauftragung eines Verarbeiters unter direkter Kontrolle ist vergleichbar. Andere compliance-getriebene Extraktionsszenarien, wie z. B. zertifizierte Lohnberichtsverarbeitung nach Davis-Bacon, folgen einer ähnlichen Logik: Die Daten müssen das Papier verlassen und in eine strukturierte Datenbank gelangen, ohne regulatorische Verpflichtungen zu gefährden.
Häufig gestellte Fragen
Kann KI handschriftliche Anmeldeformulare genau genug für eine Schuldatenbank erfassen?
Vision AI erreicht eine hohe Genauigkeit bei gedruckter Handschrift in Formularfeldern, insbesondere wenn das Formular klare Beschriftungen und eine Trennung zwischen den Feldern aufweist. Die Genauigkeit variiert mit der Handschriftqualität – sorgfältiges Drucken wird gut erfasst; hastige Schreibschrift mit überlappenden Buchstaben kann eine manuelle Prüfung erfordern. Bei Anmeldeformularen ist der praktische Ansatz, alle Felder automatisch zu erfassen und dann die Felder zu überprüfen, bei denen Fehler die größten Auswirkungen haben: medizinische/Allergie-Informationen, Notfallkontaktnummern und alle Checkbox-Berechtigungen. Die meisten Schulbezirke stellen fest, dass selbst bei einer Prüfrate von 10–15 % der Gesamtaufwand nur einen Bruchteil der vollständigen manuellen Eingabe beträgt.
Erkennt das Tool Kontrollkästchen – angekreuzt, eingekreist, durchgestrichen oder ausgefüllt?
Ja. Vision AI interpretiert Kontrollkästchen in allen gängigen Markierungsarten – Häkchen, X-Markierungen, ausgefüllte Quadrate, eingekreiste Optionen – und gibt sie als boolesche Werte (Ja/Nein, Wahr/Falsch) in der Tabelle aus. Diese Fähigkeit ist für Anmeldeformulare unerlässlich, bei denen die Zustimmung eines Elternteils (Fotoerlaubnis, Notfallbehandlung, Einverständnis für Ausflüge) durch eine einzelne Kontrollkästchen-Markierung übermittelt wird. Wir behandeln dies ausführlicher in wie KI handgeschriebene Formulare mit Kontrollkästchen liest.
Lässt sich dies in PowerSchool, Infinite Campus oder Skyward integrieren?
Es gibt keine direkte Ein-Klick-Integration. Das Tool exportiert strukturierte Tabellendaten (Excel oder CSV), die in jedes SIS importiert werden können, das den Massenimport von Daten unterstützt. PowerSchools Data Export Manager, Infinite Campus' Data Import Wizard und Skywards Import Utility akzeptieren alle CSV-Dateien mit Spaltenüberschriften. Der Import-Zuordnungsschritt – das Abgleichen der Tabellenspalten mit den SIS-Feldern – muss einmal pro SIS-Konfiguration durchgeführt werden, aber die Extraktionsspaltendefinitionen bleiben über die Anmeldezyklen hinweg konsistent. Dieser Tabellenexport-Ansatz funktioniert für jede SIS-Plattform, einschließlich Aeries, Illuminate und Gradelink.
Kann ich Anmeldeformulare mit einer Handykamera statt mit einem Scanner verarbeiten?
Ja. Das Tool akzeptiert Fotos von jeder Kamera – Smartphone, Tablet oder Büroscanner – als Eingabe. Für die besten Ergebnisse mit per Handy aufgenommenen Anmeldeformularen legen Sie das Formular auf eine flache, gut beleuchtete Oberfläche und stellen Sie sicher, dass die gesamte Seite ohne Schatten oder übermäßige Blendung im Bild sichtbar ist. Das Vision-AI-Modell ist darauf trainiert, die Perspektivverzerrung und Beleuchtungsvariationen zu verarbeiten, die bei Handyfotos auftreten. Dies kann besonders bei Anmeldungen während des Schuljahres nützlich sein, wenn Familien Formulare aus der Ferne einreichen, wie im Leitfaden zur Digitalisierung von Dokumenten ohne Scanner beschrieben.
Was passiert, wenn verschiedene Schulen im selben Bezirk unterschiedliche Anmeldeformular-Layouts verwenden?
Da das Tool die Benutzerdefinierte Spaltenextraktion verwendet – Felder werden anhand der Beschriftungsbedeutung statt der Bildschirmposition gefunden – passt es sich automatisch an Layout-Unterschiede an. Dieselbe Spaltenliste (z. B. „Schülername", „Allergien", „Fotofreigabe") funktioniert formularübergreifend für verschiedene Schulen. Die wichtigste Voraussetzung ist, dass die Felder auf dem Papierformular erkennbare Beschriftungen in der Nähe der handschriftlichen Werte haben. Dies ist ein erheblicher praktischer Vorteil gegenüber vorlagenbasierten Tools, die eine separate Konfiguration für jedes schulspezifische Formular erfordern. Weitere Informationen zum zugrunde liegenden Mechanismus finden Sie in unserer Erläuterung zur semantischen Extraktion ohne Vorlage.
Wie gehe ich mit dem Problem doppelter Familiendaten um – dieselben Elterninformationen bei mehreren Kindern?
Das Tool verarbeitet jedes Formular unabhängig, daher werden die Felder für Eltern/Erziehungsberechtigte in jeder Zeile derselben Familie erscheinen. Da die Werte jedoch konsistent extrahiert werden (gleiches Telefonnummernformat, gleiche Schreibweise der Elternteile), sind die Duplikate vorhersehbar und leicht zusammenzuführen. Der empfohlene Workflow besteht darin, alle Datensätze in eine Tabelle zu extrahieren, nach den Kontaktfeldern der Eltern zu sortieren, um Geschwister zu gruppieren, und dann die Familienzusammenführungsfunktion Ihres SIS zu verwenden (verfügbar in PowerSchool, Infinite Campus und Skyward), um die Datensätze zu einem einzigen Haushalt zu verknüpfen. Tools mit diesem batch-orientierten Ansatz werden in Batch-Verarbeitung ohne Programmierung näher erläutert.
Die Anmeldeformular-Extraktion, die keine Einheitlichkeit voraussetzt
Die grundlegende Herausforderung bei der Datenerfassung aus Anmeldeformularen liegt nicht darin, dass die Formulare schwer zu lesen sind – sondern darin, dass sie variieren, medizinische Daten enthalten, die keine Fehllesung tolerieren, in vorhersehbaren Wellen eintreffen und dieselbe Telefonnummer eines Elternteils an drei verschiedene Datenerfasser für drei verschiedene Kinder weitergeben. Ein Tool, das davon ausgeht, dass jedes Formular gleich aussieht, jedes Dokument isoliert verarbeitet oder nicht zuverlässig zwischen einem angekreuzten und einem leeren Kontrollkästchen unterscheiden kann, erzeugt mehr Bereinigungsaufwand, als es einspart.
Vision-AI-Extraktion löst das Anmeldedatenproblem nicht, indem sie das Anmeldebüro eliminiert – sie löst es, indem sie das Tippen, die doppelte Erfassung, die Ermüdungsfehler und die manuelle Kontrollkästchenprüfung eliminiert. Die Verifizierung und die Zuordnung von Familien bleiben bei den Personen, die die Schüler und die Datenrichtlinien des Bezirks verstehen. Was sich ändert, ist, dass diese Entscheidungen mit der Geschwindigkeit einer Tabellenkalkulationsprüfung getroffen werden, nicht mit der Geschwindigkeit einer Tastatur.
An einem Anmeldeformular ausprobieren →
Keine Anmeldung · Keine Kreditkarte · Ergebnisse in 10 Sekunden