Meilleur logiciel OCR en 2026 :
9 outils comparés pour tous les budgets
Le marché de la reconnaissance optique de caractères devrait passer d'environ 10,6 milliards de dollars en 2022 à 32,9 milliards de dollars d'ici 2030, selon Grand View Research — et l'essentiel de cette croissance va à des outils qui, techniquement, ne font pas du tout de l'OCR classique. Le mot « OCR » évoque encore une seule chose pour la plupart des gens (transformer une image de texte en caractères), mais le logiciel qui domine la catégorie en 2026 fait autre chose : il lit un document comme le ferait une personne, comprend ce que signifient les chiffres et restitue des données structurées. Ce guide compare neuf outils OCR sur tout ce spectre — scanners desktop, convertisseurs en ligne gratuits, API cloud et extraction par IA — afin que vous puissiez voir où chacun se situe et, tout aussi important, où il ne convient pas.
Points clés à retenir
- 32,9 milliards de dollars seront investis dans les logiciels « OCR » d'ici 2030 — pourtant, la plupart de cet argent achète des outils qui ne font pas vraiment de l'OCR (transformer des images de texte en caractères).
- L'OCR traditionnel lit où se trouve le texte sur la page ; l'OCR IA lit ce que signifie le texte — un même nom, deux tâches opposées.
- La vraie question n'a jamais été « quel OCR est le meilleur », mais « ai-je besoin de texte ou de données » — répondez-y et le bon camp se choisit tout seul.
Ce que « OCR » signifie en 2026 : traditionnel vs IA
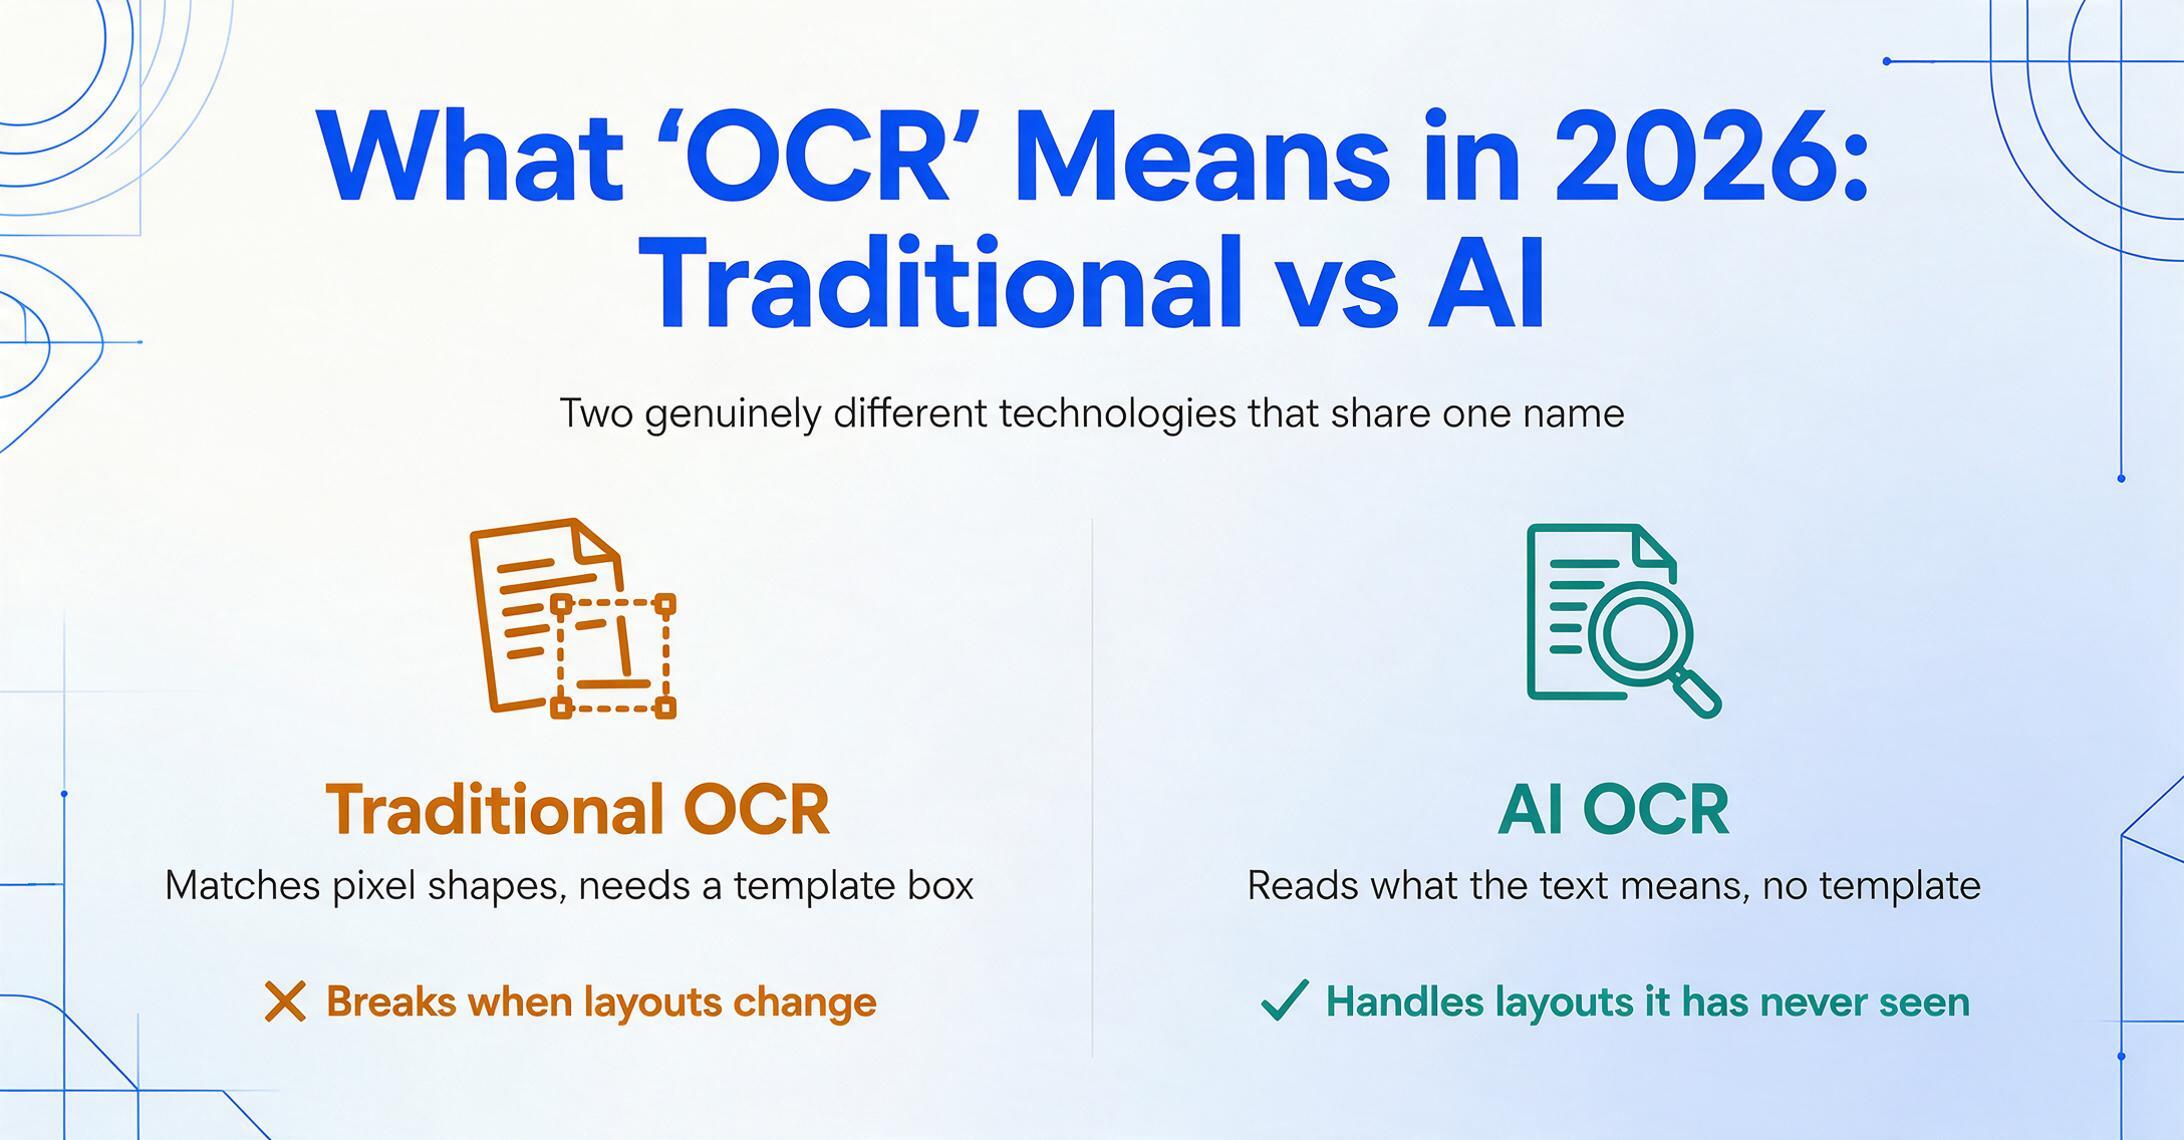
Le « logiciel OCR » se divise désormais en deux technologies réellement différentes qui partagent un même nom, et choisir la mauvaise est la raison la plus courante de déception. Avant de comparer les outils, prenez dix secondes pour tracer cette ligne clairement — car elle détermine de quelle moitié de cette liste vous devriez vous préoccuper.
L'OCR traditionnel est une reconnaissance de formes. Il analyse une image, fait correspondre les formes de pixels à une bibliothèque de caractères et produit du texte. Il excelle dans une tâche : transformer une page scannée propre en caractères consultables et copiables. Ce qu'il ne fait pas, c'est comprendre. Il n'a aucune idée de si « 1200 » est un total de facture ou un code postal — il sait seulement que ce sont les caractères qu'il a vus. Pour extraire un champ spécifique, les outils traditionnels s'appuient sur des modèles (aussi appelés OCR zonal) : vous dessinez une zone autour de l'emplacement du « numéro de facture », et l'outil copie ce qui apparaît à ces coordonnées sur chaque document. Déplacez le champ, changez de fournisseur, fournissez un scan légèrement incliné, et la zone vise la mauvaise chose.
L'OCR traditionnel lit où le texte se trouve sur la page. L'OCR IA lit ce que le texte signifie. Cette seule différence explique pourquoi l'OCR traditionnel casse lorsque la mise en page change, et pourquoi l'OCR IA peut distinguer une date de facture d'une date d'échéance sans qu'on lui indique où chacune se trouve.
L'OCR IA (aussi appelé OCR intelligent ou basé sur la vision) est construit sur un modèle de langage visuel. En plus de reconnaître les caractères, il raisonne sur l'ensemble de la page : il comprend qu'un montant en dollars appartient à un en-tête de colonne spécifique, déduit un mot peu clair du contexte et s'adapte à une mise en page jamais vue — sans modèle à construire. Le bénéfice pratique est qu'il peut renvoyer des données structurées, pas seulement un mur de texte. C'est la capacité qu'un utilisateur Reddit sur r/automation cherchait à décrire lorsqu'il évoquait son problème de PDF scanné : l'OCR brut « devait juste m'approcher du résultat, et l'automatisation s'occupait du reste », mais il avertissait les autres de « chercher d'abord un outil OCR avec une meilleure rétention de mise en page ». L'écart entre « des caractères sur une page » et « des données utilisables » est exactement l'écart que l'OCR IA comble.
La vraie première question n'est donc pas « quel est le meilleur outil OCR ? » — c'est « ai-je besoin de texte, ou ai-je besoin de données ? » Si vous avez seulement besoin qu'un PDF scanné devienne consultable et modifiable, un outil traditionnel de bureau ou en ligne est plus rapide et moins cher. Si vous avez besoin que le contenu soit transformé en feuille de calcul avec vos propres colonnes, c'est une tâche d'extraction IA. Ce guide couvre les deux camps. Si vous avez déjà décidé de ne vouloir que le côté IA, notre tour d'horizon des meilleurs logiciels d'OCR IA passe en détail chaque outil dans ce domaine plus restreint ; ici, l'objectif est de cartographier l'ensemble du paysage.
La ligne de démarcation entre « texte » et « données » est mesurable. Dans notre benchmark OCR interne, le meilleur moteur traditionnel et le meilleur modèle vision-langage ont fait jeu égal en précision brute des caractères sur des reçus propres (docTR CER 0,197 contre Surya2 0,191 sur SROIE 2019), mais leur comportement a divergé lors de l'extraction de champs : avec des règles regex fixes, le VLM a obtenu un F1 de 0,318 contre 0,077 pour docTR — car le texte brut du moteur traditionnel nécessite une structuration en aval, tandis que le VLM produit déjà un texte compris. L'ajout d'un postprocesseur LLM a ensuite porté les deux à ~0,61–0,62. Pour les acheteurs, la conclusion est la suivante : si vous consommez des champs, le pipeline de post-traitement importe plus que le moteur OCR ; si vous consommez du texte, le moteur traditionnel est moins cher et tout aussi précis. Notre analyse d'équité CER explique pourquoi les chiffres bruts de précision entre les deux familles nécessitent cette réserve.
Comment nous avons sélectionné et testé
Neuf outils figurent dans cette liste parce qu'ils représentent ensemble l'éventail réel du marché de l'OCR, et non parce qu'ils sont faciles à encenser. Nous sommes partis de ce que les acheteurs recherchent réellement et de ce que les comparatifs neutres et les plateformes d'avis incluent systématiquement : les vétérans de l'OCR de bureau (ABBYY, Adobe), les convertisseurs en ligne gratuits que tout le monde essaie en premier (iLovePDF, SmallPDF, OnlineOCR.net), les API cloud pour développeurs (Google, AWS) et les outils d'extraction IA (Nanonets, et notre propre ImageToTable.ai). Nous avons laissé de côté les moteurs open source comme Tesseract de la liste notée — ils sont puissants et gratuits, mais ce sont des bibliothèques pour développeurs, pas des outils que l'on « utilise », donc ils répondent à une question différente (et nous les comparons séparément dans notre guide des meilleurs outils OCR open source).
Chaque outil a été évalué sur quatre points : ce qu'il produit réellement (texte consultable ou données structurées ?), le prix réel (le chiffre publié le plus bas, pas « à partir de »), qui l'utilise (un particulier ou un développeur/une équipe ?), et l'adéquation honnête — les tâches où il excelle vraiment et celles où il échoue. Les prix ont été relevés sur les pages tarifaires publiques de chaque fournisseur et recoupés avec des plateformes neutres (Capterra, G2, TrustRadius, SoftwareAdvice). Tous les chiffres sont à jour au Prix vérifiés en juin 2026 ; lorsqu'un fournisseur ne communique ses tarifs entreprise que sur demande, nous le précisons plutôt que de deviner.
Une divulgation d'emblée : ImageToTable.ai — le produit auquel appartient ce site — est l'un des neuf outils examinés ci-dessous. Nous l'avons placé là où il s'intègre honnêtement (extraction IA sans code pour les petites équipes) et avons nommé les scénarios où Adobe, ABBYY, Google ou AWS est le meilleur choix. Un comparatif qui cacherait sa propre affiliation, ou prétendrait qu'un seul outil gagne dans tous les cas d'usage, ne mériterait pas votre temps.
Les 9 meilleurs outils OCR en un coup d'œil
Le tableau ci-dessous est la réponse rapide, regroupée selon les quatre pôles du paysage OCR. Le « Prix de départ » est le tarif mensuel publié le plus bas pour chaque outil (les API à l'usage sont affichées à leur tarif par page, car elles n'ont pas de minimum mensuel). « Tarifs vérifiés en juin 2026. »
| Outil | Prix de départ | Modèle tarifaire | Idéal pour | Limite principale | Essai gratuit ? |
|---|---|---|---|---|---|
| ABBYY FineReader | 16 $/mois (ou 199 $ en une fois) | Abonnement par poste / licence à vie | Précision critique, hors ligne, 198 langues | D'abord sur ordinateur ; l'IDP d'entreprise est piloté par les ventes | Oui |
| Adobe Acrobat Pro | 19,99 $/mois | Abonnement | Édition PDF avec OCR intégré | L'OCR est une fonctionnalité, pas une extraction de données en masse | Essai de 7 jours |
| iLovePDF | 7 $/mois (annuel) | Abonnement + offre gratuite | Conversions PDF/OCR ponctuelles rapides | La sortie est du texte/PDF, pas d'extraction de champs | Offre gratuite |
| SmallPDF | 12 $/mois | Abonnement + offre gratuite | PDF dans le navigateur vers texte/Word | Pas de champs personnalisés, pas de tableau de données fusionné | Offre gratuite |
| OnlineOCR.net | Gratuit (15 pages/h) | Gratuit + forfaits hebdo/mensuels (dès 9,95 $/sem.) | OCR occasionnel sans frais, sans installation | Limité en débit ; pas de sortie structurée | Gratuit (invité) |
| Google Document AI | 1,50 $ / 1 000 pages | À l'usage (par page) | OCR cloud à grand volume, pour développeurs | Nécessite une configuration technique ; la sortie brute demande du travail | Offre gratuite (GCP) |
| AWS Textract | 1,50 $ / 1 000 pages | À l'usage (par appel API/page) | OCR à grand volume dans les environnements AWS | Réservé aux développeurs ; formulaires/tableaux coûtent 10 à 33 fois plus | Offre gratuite (1 000 pages/mois, 3 mois) |
| Nanonets | 499 $/mois (Pro) | Crédits par exécution (0,30 $/extraction) | Automatisation AP pour entreprises de taille moyenne à grands comptes | Nécessite souvent un entraînement sur échantillons ; cher pour les PME | Offre gratuite/essai |
| ImageToTable.ai | 9 $/mois | Abonnement + paiement à l'usage (par crédits) | Extraction IA sans code vers des feuilles de calcul | Pas de synchronisation ERP native, ni SOC 2/HIPAA | Offre gratuite |
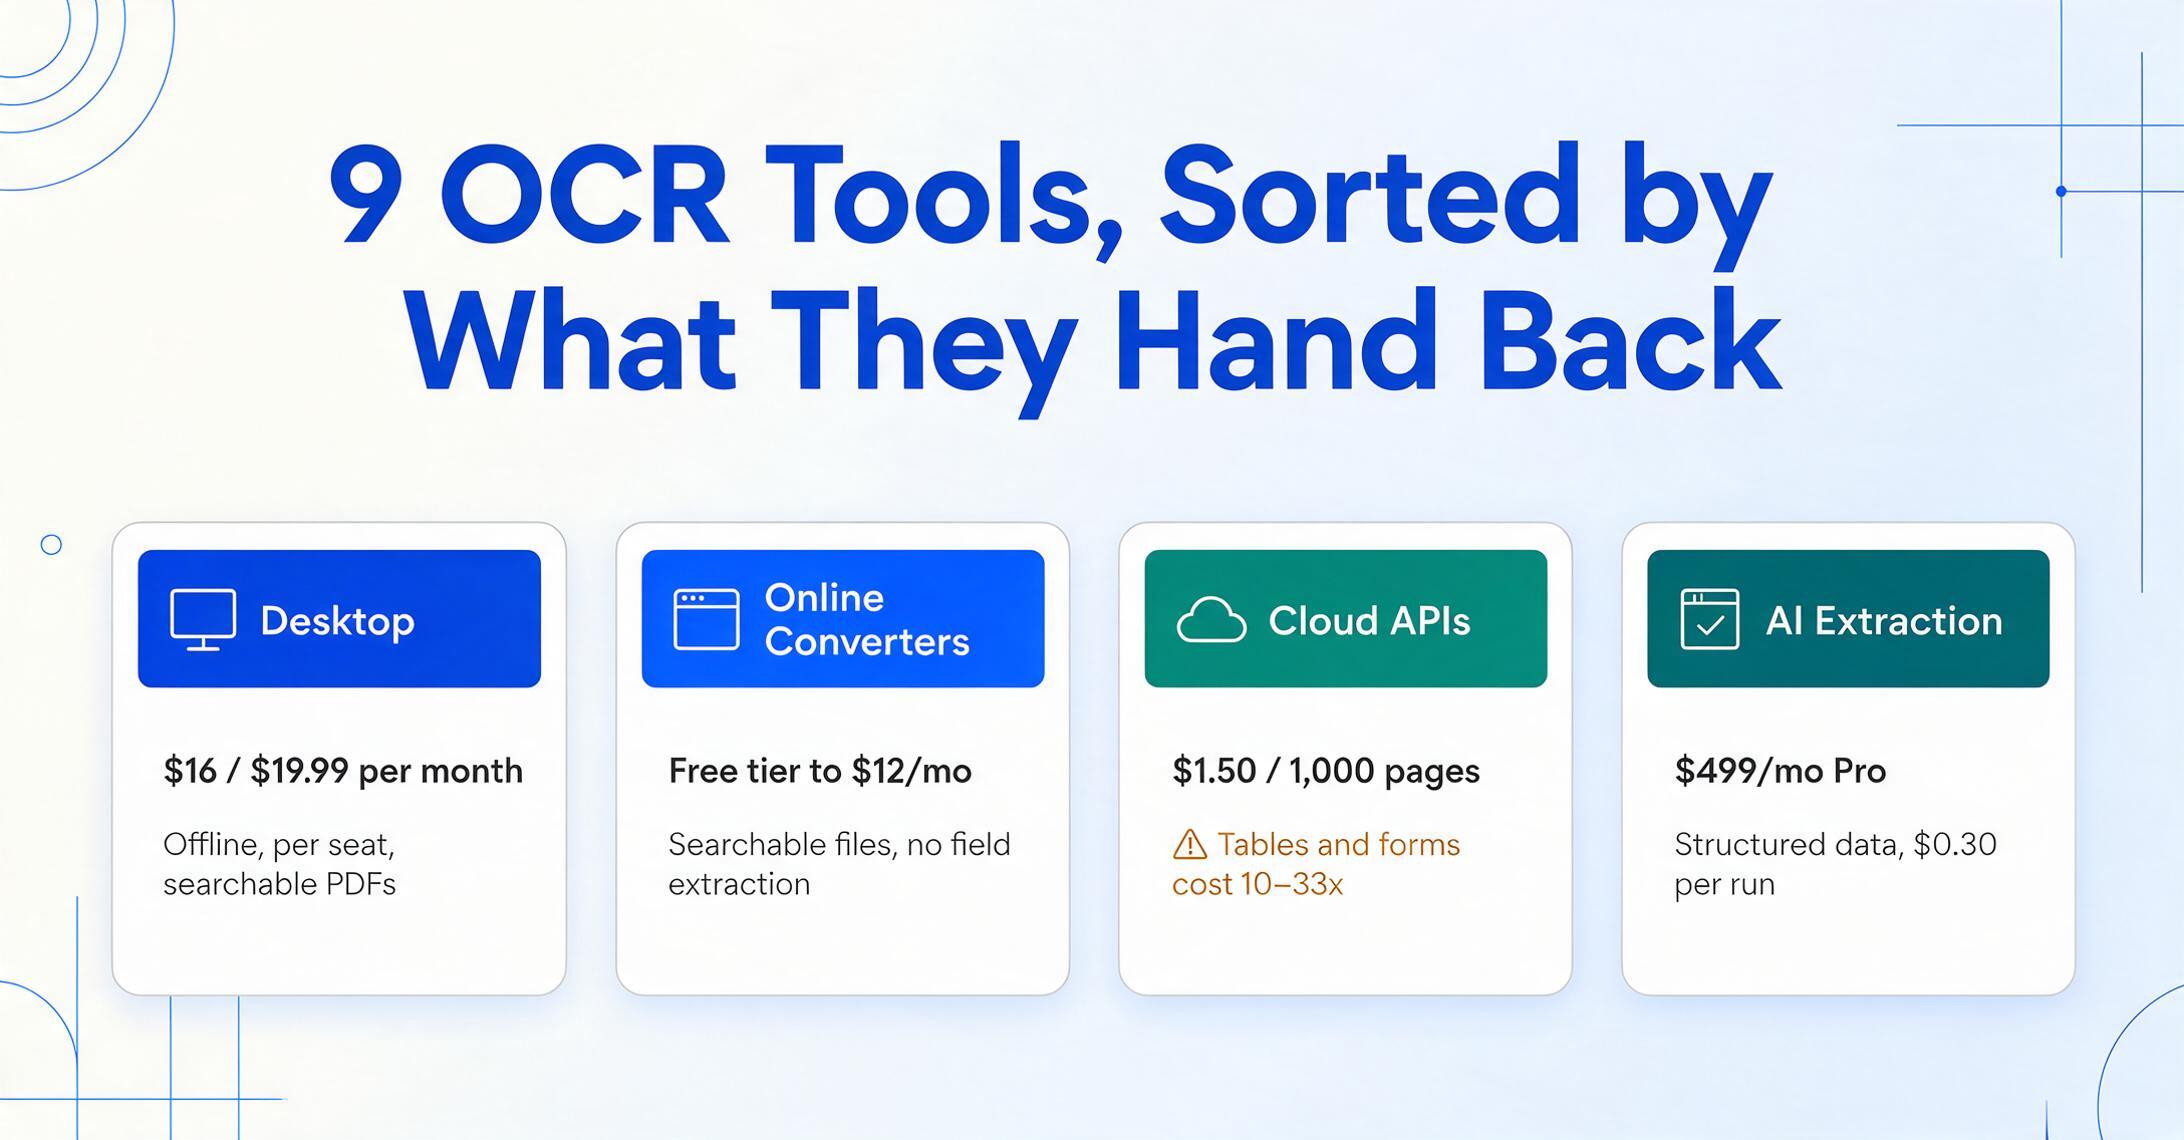
Un schéma mérite d'être souligné avant d'examiner chaque outil : le prix ne vous dit presque rien sur la qualité de lecture ici, mais presque tout sur ce qui entoure la lecture. Un convertisseur en ligne à 7 $/mois et une plateforme IA à 499 $/mois peuvent tous deux transformer une facture propre en texte précis. La différence de 70x permet d'obtenir une sortie structurée, des pipelines par lots, des intégrations et un support — des capacités dont vous avez besoin ou non. Le reste de ce guide vise à déterminer lesquelles.
Les poids lourds de l'OCR sur ordinateur : ABBYY FineReader & Adobe Acrobat Pro
Si votre objectif est le travail d'OCR classique — transformer un document scanné en fichier propre, consultable et modifiable sur votre propre machine — les deux vétérans du bureau restent la référence. Tous deux sont matures, capables de fonctionner hors ligne, et conçus autour du PDF, pas du tableur.
ABBYY FineReader PDF
ABBYY est le doyen de l'OCR et reste la référence en matière de précision, avec des comparaisons indépendantes citant jusqu'à 99,8 % dans 198 langues. FineReader PDF est un outil d'OCR et de PDF sur ordinateur à partir de 16 $/mois pour l'édition Standard Windows (Corporate à 24 $/mois), ou environ 199 $ en licence à vie — un véritable avantage si vous n'aimez pas les abonnements. Ses points forts sont la fidélité de la mise en page, les archives multilingues et le traitement entièrement hors ligne, ce qui compte pour les travaux sensibles à la confidentialité. ABBYY vend également des produits IDP pour entreprises (Vantage, FlexiCapture) facturés à la page via des devis personnalisés.
Idéal pour : les travaux d'OCR où la précision est critique, les archives documentaires multilingues, le travail sur site/hors ligne et les flux PDF exigeants. Pas idéal pour : ceux qui veulent une application cloud qui renvoie un tableur finalisé — FineReader desktop n'est pas conçu pour l'automatisation API par lots, et son niveau entreprise est piloté par la force de vente avec une vraie phase d'implémentation. Voir la confrontation dans notre comparaison ABBYY FineReader. Voir les tarifs ABBYY FineReader →
Adobe Acrobat Pro
Adobe Acrobat Pro intègre un OCR performant dans l'outil PDF que des millions de bureaux utilisent déjà, à 19,99 $/mois (Pro pour particuliers, facturation annuelle mensuelle ; Standard à 14,99 $, Studio à 24,99 $). Sa fonction « scan vers PDF modifiable » transforme les documents scannés en fichiers consultables et modifiables en quelques clics, et comme il vit dans la suite Acrobat complète, l'OCR côtoie l'édition, la signature, la comparaison et l'exportation. Pour la plupart des gens, l'attrait est simple : ils l'ont déjà.
Idéal pour : les professionnels qui vivent dans les PDF et veulent un OCR solide comme une fonction parmi d'autres — édition, signature, conversion et rendu des scans consultables au même endroit. Pas idéal pour : les travaux à volume élevé ou sur données structurées — l'OCR d'Acrobat rend un document consultable, mais il n'extraira pas « chaque ligne de 50 factures dans un seul tableur ». Pour cette conversion précise, voyez comment un PDF scanné devient un tableau Excel, et notre comparaison Adobe Acrobat pour les compromis. Voir les tarifs Adobe Acrobat →
Convertisseurs OCR gratuits et en ligne : iLovePDF, SmallPDF et OnlineOCR.net
Pour une conversion ponctuelle, l'OCR le plus rapide et le moins cher se trouve dans un onglet de navigateur — sans installation, souvent gratuit. Ces outils excellent par leur commodité et pèchent par tout ce qui exige de la répétabilité ou de la structure, ce qui constitue exactement le bon compromis pour un usage occasionnel.
iLovePDF
iLovePDF est une suite d'outils PDF basés sur le navigateur — fusionner, diviser, compresser, convertir et OCR — avec un niveau gratuit généreux et Premium à partir de 7 $/mois sur un plan annuel (environ 9 $ au mois). La fonction OCR rend les PDF numérisés consultables et les convertit en formats modifiables, et l'interface est aussi fluide que possible.
Idéal pour : les particuliers qui doivent OCR ou convertir un PDF occasionnel sans payer pour une suite de bureau. Moins adapté pour : l'extraction structurée ou le volume — le résultat est un texte consultable ou un fichier Word/Excel reflétant la page, pas des données mappées vers des colonnes de votre choix, et les niveaux gratuits plafonnent la taille des fichiers et les tâches quotidiennes. Voir les tarifs iLovePDF →
SmallPDF
SmallPDF couvre le même territoire PDF dans le navigateur — convertir, compresser, modifier et OCR des fichiers numérisés en documents consultables et modifiables — avec un niveau gratuit et Pro à 12 $/mois (108 $/an). Il obtient régulièrement des notes élevées en facilité d'utilisation, et Smallpdf Desktop ajoute un accès hors ligne pour les utilisateurs payants.
Idéal pour : les utilisateurs qui veulent une application web propre et fiable pour rendre des numérisations consultables et convertir des PDF en Word ou Excel de temps en temps. Moins adapté pour : les traitements par lots qui fusionnent de nombreux documents en un seul tableau cohérent, ou tout flux de travail nécessitant des champs personnalisés — comme ses pairs, il convertit un document, il ne modélise pas vos données. Voir les tarifs SmallPDF →
OnlineOCR.net
OnlineOCR.net est l'option minimaliste et réellement gratuite : en mode Invité (sans inscription), il convertit jusqu'à 15 pages par heure en Word, Excel ou texte. Si vous avez besoin de plus, les formules payantes commencent à 9,95 $/semaine (2 000 pages) ou 29,95 $/mois (10 000 pages). Rien à installer et aucun compte requis pour commencer.
Idéal pour : une conversion rapide, gratuite et sans inscription lorsque vous avez quelques pages et que la qualité importe peu. Pas idéal pour : les documents sensibles, les volumes importants ou toute sortie structurée — la limite de débit, la gestion de mise en page basique et l'absence d'extraction au niveau des champs en font un outil utilitaire, pas un outil de travail. Voir les tarifs d'OnlineOCR.net →
Ces trois outils partagent la même limite : ils vous remettent un document, pas des données. Dès que « j'ai besoin que ce soit recherchable » devient « j'ai besoin de ces champs à partir de 200 exemplaires dans un tableur », vous quittez la catégorie des convertisseurs — et vous choisissez entre une API pour développeurs et un outil d'extraction par IA. Si vous comparez les nouvelles options image-texte (y compris les chatbots comme ChatGPT et Claude), notre guide des meilleurs convertisseurs image-texte par IA les compare en tête-à-tête.
API OCR cloud pour développeurs : Google Document AI & AWS Textract
Si vous disposez de ressources d'ingénierie et d'un volume élevé et constant, les API OCR des grands fournisseurs cloud sont imbattables en coût brut par page. Ce ne sont pas des applications que l'on « utilise » — ce sont des services sur lesquels on construit, ce qui est à la fois leur force et leur inconvénient.
Google Document AI
Google Document AI est une plateforme cloud dotée d'une famille de processeurs : un processeur OCR général pour documents d'entreprise, plus un analyseur de formulaires et un extracteur personnalisé pour les champs structurés. L'OCR de base coûte 1,50 $ pour 1 000 pages (passant à 0,60 $ au-delà de 5 millions de pages/mois), tandis que l'extracteur personnalisé et l'analyseur de formulaires coûtent 30 $ pour 1 000 pages. La reconnaissance de l'écriture manuscrite est performante sur les formulaires structurés.
Idéal pour : les équipes de développement ayant besoin d'une reconnaissance évolutive basée sur API à volume élevé, en particulier celles déjà sur Google Cloud. Pas idéal pour : les non-développeurs — il n'y a pas d'application en quelques clics, et l'OCR renvoie des blocs de texte bruts nécessitant un post-traitement avant d'être exploitables dans un tableur. Le coût grimpe également rapidement dès que vous passez de l'OCR de base à l'extraction structurée. Voir les tarifs de Google Document AI →
AWS Textract
AWS Textract est le service OCR de documents d'Amazon, exposé via plusieurs API (Detect Document Text, Analyze Document, Analyze Expense, Analyze ID). Detect Document Text coûte 1,50 $ pour 1 000 pages (0,0015 $/page, tombant à 0,0006 $ au-delà de 1 million de pages), mais les fonctionnalités structurées sont bien plus chères — les tableaux coûtent environ 15 $ pour 1 000 pages et les formulaires environ 50 $ pour 1 000 pages. Un niveau gratuit couvre 1 000 pages/mois pendant les trois premiers mois.
Idéal pour : les équipes déjà dans l'écosystème AWS qui veulent l'OCR comme brique dans un pipeline plus large. Pas idéal pour : ceux qui n'ont pas de développeurs, ou les charges de travail dominées par les formulaires et les tableaux, où le coût par page est 10 à 33 fois le tarif de base. Nous détaillons les compromis dans notre comparaison AWS Textract. Voir les tarifs AWS Textract →
Les deux API partagent la même limite pour les acheteurs non techniques : elles lisent bien les documents, mais transformer leur sortie en feuille de calcul finie — avec vos noms de colonnes, vos formats, vos calculs — est un projet, pas une fonctionnalité. C'est précisément l'écart que les outils d'extraction IA comblent.
Extraction de données IA : Nanonets & ImageToTable.ai
À l'autre extrémité du spectre se trouvent les outils où « OCR » n'est que la première étape — ils lisent le document, puis le comprennent et renvoient des données structurées, sans modèle requis. C'est ce camp qui tire la croissance du marché, et il va des plateformes de workflow lourdes aux applications no-code légères.
Nanonets
Nanonets est une plateforme d'automatisation de workflows et d'IA documentaire destinée aux équipes de comptes fournisseurs. Elle propose un niveau Starter gratuit, mais le plan Pro commence à 499 $/mois, avec une extraction facturée à 0,30 $ par exécution sur un système de crédits. Elle est riche en intégrations (QuickBooks, Sage, Xero) et conçue pour exécuter un pipeline documentaire de bout en bout — et les fils Reddit sur l'extraction de reçus la citent régulièrement parmi les options les plus solides.
Idéal pour : l'automatisation AP de milieu de marché à entreprise, où les workflows d'approbation et les intégrations comptables justifient le prix. Pas idéal pour : les petites équipes ou ceux qui veulent zéro configuration — Nanonets implique souvent de télécharger des échantillons et d'entraîner des modèles pour les types de documents complexes, ce qui ajoute une courbe d'apprentissage. Notre comparaison Nanonets couvre les cas où cette configuration porte ses fruits. Voir les tarifs Nanonets →
ImageToTable.ai
ImageToTable.ai — le produit derrière ce site, et l'un des neuf outils de cette comparaison — est un outil d'extraction de données par IA basé sur un grand modèle de vision, conçu pour les personnes qui veulent des données structurées sans code, sans modèle ni phase d'entraînement. Son mécanisme central est l'Extraction de colonnes personnalisées : au lieu de dessiner des zones, vous tapez les noms des colonnes souhaitées — « Numéro de facture », « Date d'échéance », « Total » — et l'IA localise chaque valeur n'importe où sur la page en comprenant ce qu'elle signifie. Comme il est sans modèle, une nouvelle mise en page de fournisseur ne nécessite aucune configuration. Il ajoute deux choses qui manquent aux convertisseurs et à l'OCR de base : les colonnes calculées (définissez « Total de ligne (Qté × Prix unitaire) » et l'IA fait le calcul pendant l'extraction) et les colonnes inférées (une colonne « Catégorie » que l'IA remplit même lorsque le document ne comporte pas ce champ). Les résultats arrivent directement dans Excel, CSV, JSON ou Word, avec un module complémentaire natif pour Google Sheets. Les tarifs commencent avec un niveau gratuit, puis 9 $/mois, avec des crédits à l'utilisation qui n'expirent pas.
Idéal pour : les freelances, les comptables et les petites et moyennes équipes qui veulent une extraction sans code et sans modèle dans une feuille de calcul à faible coût par document — y compris les documents manuscrits et les photos prises au téléphone. Pas idéal pour : les entreprises ayant besoin d'une synchronisation ERP native en un clic, d'un déploiement sur site ou de la conformité SOC 2 / HIPAA — pour celles-ci, ABBYY, Google ou AWS est le bon choix. C'est un outil d'extraction, pas une plateforme de comptes fournisseurs avec routage d'approbation. Vous pouvez voir l'approche sans code sur notre page d'extraction OCR, ou comparer le domaine plus large dans notre tour d'horizon des outils d'extraction de données de documents. Essayez ImageToTable.ai gratuitement →
Il vaut la peine de mentionner brièvement les outils auxquels les gens se tournent souvent ici : les chatbots polyvalents comme ChatGPT et Gemini lisent les documents de manière impressionnante et conviennent pour un usage ponctuel, mais ils manquent d'un schéma de sortie imposé et d'un pipeline par lots, de sorte que la même invite peut renvoyer des structures de colonnes différentes d'une exécution à l'autre. Pour un processus reproductible, un outil spécialisé gagne. Si votre intérêt porte strictement sur le côté IA de l'OCR, notre guide des meilleurs logiciels d'OCR IA compare neuf de ces outils en profondeur.
Comment choisir : selon ce dont vous avez réellement besoin
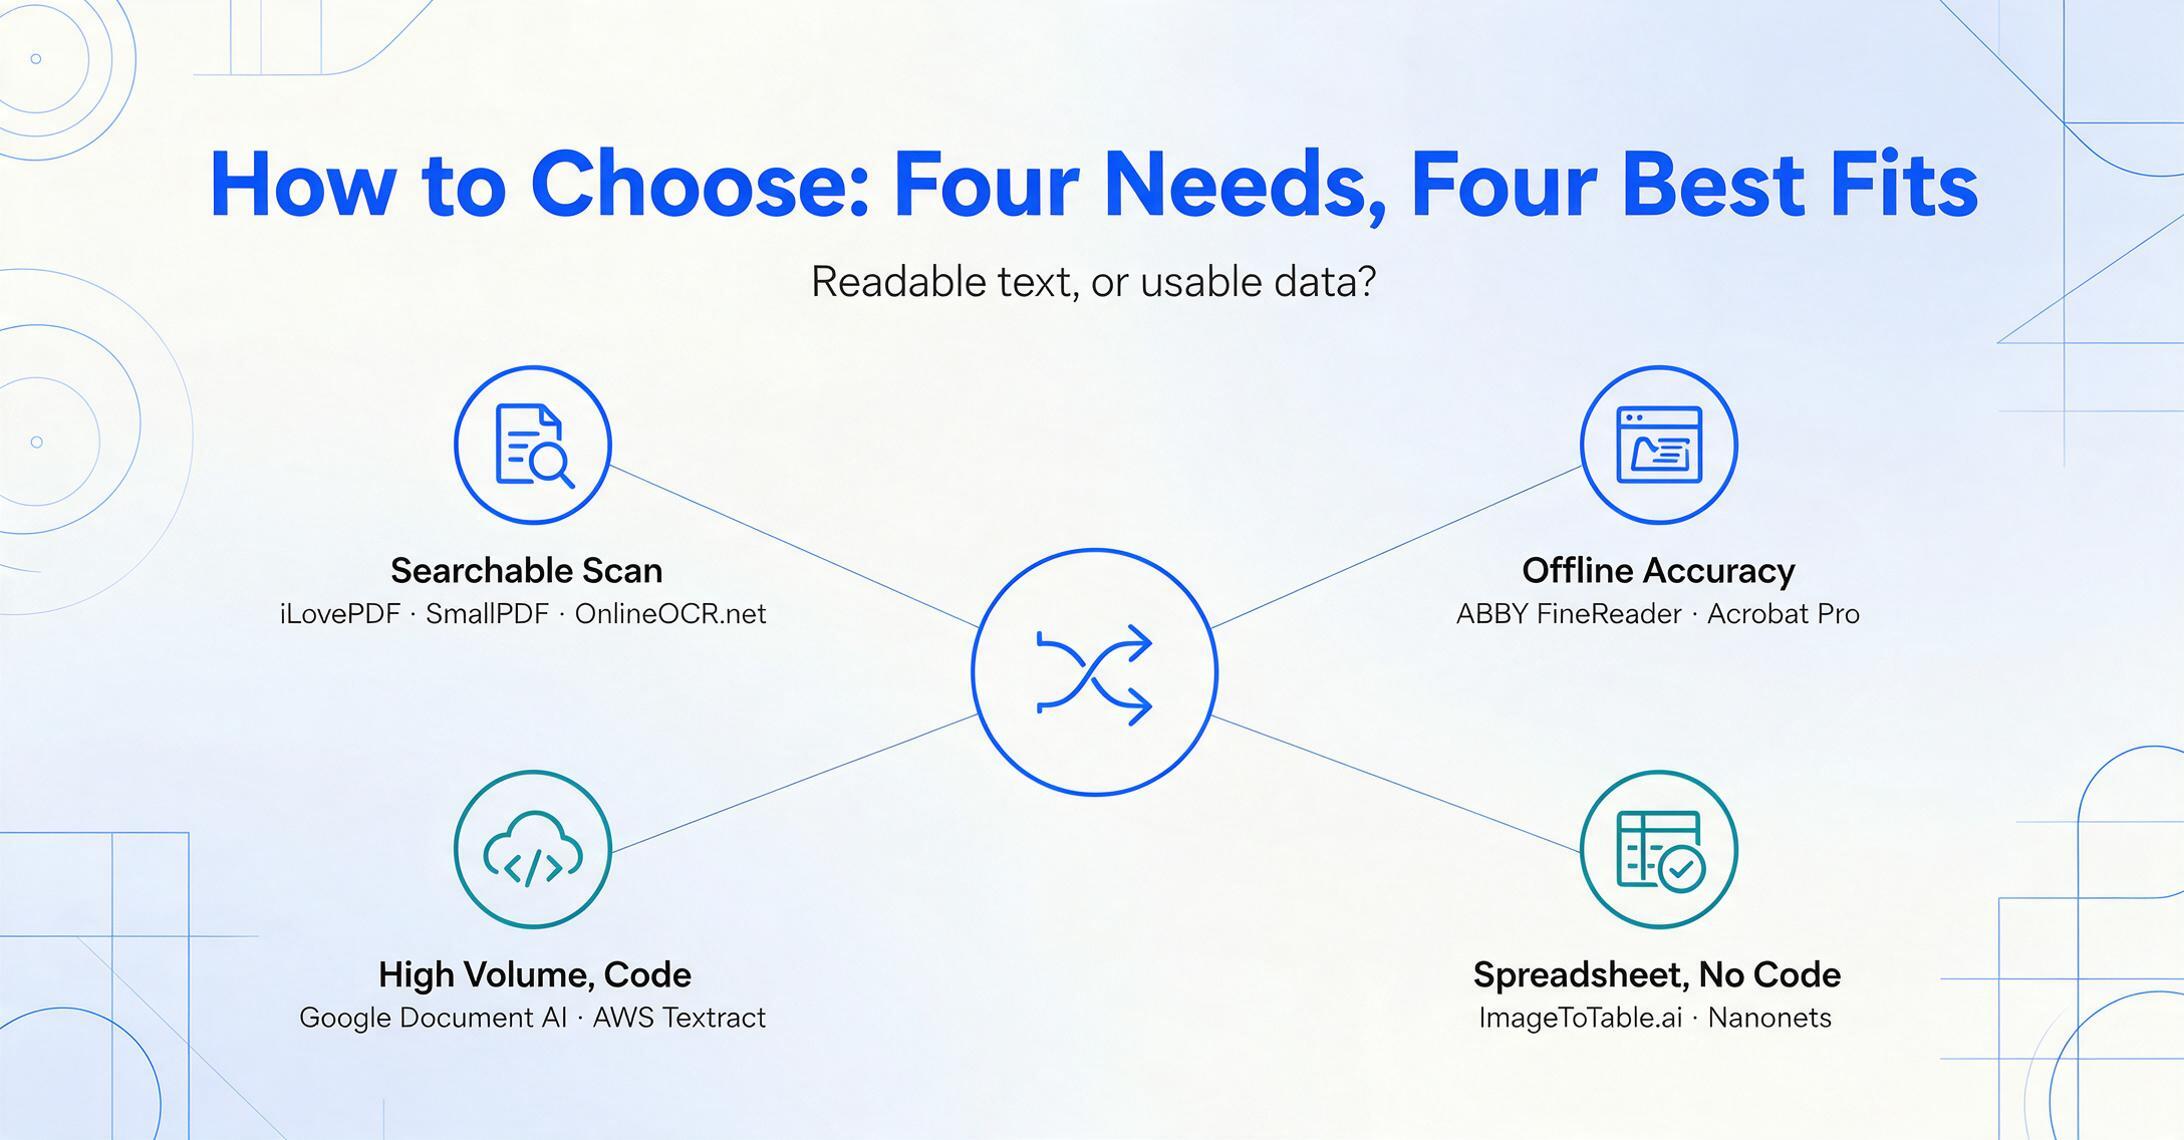
Le bon outil OCR découle directement d'une seule question — avez-vous besoin de texte lisible ou de données exploitables ? — puis de votre volume et de qui l'utilise. Voici la décision dans quatre situations courantes.
« J'ai juste besoin que ce scan soit recherchable »
Meilleur choix : iLovePDF, SmallPDF ou OnlineOCR.net
Quelques documents, un besoin occasionnel, le résultat est un fichier recherchable ou modifiable. Commencez gratuitement dans un navigateur ; ne payez que si vous atteignez les limites de volume ou de taille de fichier. Aucune raison d'acheter une plateforme pour cela.
« Je travaille sur des PDF toute la journée / j'ai besoin de précision hors ligne »
Meilleur choix : Adobe Acrobat Pro ou ABBYY FineReader
Contrôle sur ordinateur de bureau, précision de premier ordre, archives multilingues ou sensibles à la confidentialité, et OCR intégré à l'édition complète de PDF. Choisissez Adobe pour la suite familière, ABBYY pour une précision maximale et une utilisation hors ligne.
« J'ai des développeurs et un volume élevé et constant »
Meilleur choix : Google Document AI ou AWS Textract
Coût par page le plus bas à grande échelle, et vous pouvez transformer la sortie brute en données structurées par code. Choisissez selon le cloud que vous utilisez déjà, et prévoyez le budget pour le saut une fois que les formulaires et les tableaux entrent en jeu.
« J'ai besoin de données dans un tableur, sans code »
Meilleur choix : ImageToTable.ai (petites équipes) ou Nanonets (AP à grande échelle)
C'est le travail d'extraction par IA. Pour les utilisateurs solo et les équipes légères qui veulent des colonnes nommées par vos soins, commencez sans code et à moindre coût. Pour un pipeline AP de milieu de gamme avec approbations et intégrations, une plateforme comme Nanonets justifie son prix.
Si votre situation penche vers des données structurées plutôt que du texte recherchable, le côté IA de cette liste est là où se trouve la valeur — et il vaut la peine de lire les comparatifs plus approfondis par segment : la comparaison large des logiciels OCR IA, les options conçues pour les petites entreprises et les utilisateurs solo, et les outils qui fonctionnent nativement dans Google Sheets. Si vous avez surtout besoin d'un Word modifiable à partir d'un scan, notre comparatif des convertisseurs PDF vers Word couvre ce créneau.
Questions fréquemment posées
Quelle est la différence entre l'OCR traditionnel et l'OCR IA ?
L'OCR traditionnel convertit des images de texte en caractères en comparant des formes de pixels — il lit où se trouve le texte mais ne comprend pas ce qu'il signifie, il repose donc sur des modèles et échoue lorsque les mises en page changent. L'OCR IA utilise un modèle de langage visuel pour comprendre la structure et le contexte du document : il sait qu'un montant appartient à une colonne spécifique, distingue une date de facture d'une date d'échéance, gère des mises en page jamais vues et peut renvoyer des données structurées plutôt qu'un simple texte consultable — sans modèle requis.
Quel est le meilleur logiciel OCR gratuit ?
Pour des conversions occasionnelles, OnlineOCR.net est vraiment gratuit sans inscription (15 pages/heure), et iLovePDF et SmallPDF proposent tous deux des offres gratuites pour rendre les PDF consultables. Pour une extraction gratuite de qualité IA dans un tableur, ImageToTable.ai propose une offre gratuite, et les API cloud (Google, AWS) offrent des paliers d'utilisation gratuits si vous avez des développeurs. Les paliers gratuits plafonnent le volume et la taille des fichiers, ils conviennent donc à des tâches ponctuelles, pas à un flux de travail régulier.
Quel logiciel OCR est le plus précis ?
Sur des documents imprimés propres, les meilleurs outils atteignent tous les hautes années 90 — ABBYY FineReader est largement cité à 99,8 % dans 198 langues, et les outils IA modernes rapportent jusqu'à 99 % sur des données tabulaires imprimées. La précision diverge sur des entrées réelles désordonnées : mises en page variées, numérisations médiocres et surtout l'écriture manuscrite, où même les meilleurs modèles restent bien en dessous de la précision du texte imprimé. La question pratique n'est pas la précision maximale mais la fréquence à laquelle vos documents sortent du cas « propre et prévisible ».
Avez-vous besoin d'un logiciel OCR ou d'une extraction de données IA ?
Choisissez selon votre résultat. Si vous avez besoin qu'un document numérisé devienne consultable, modifiable ou un PDF, l'OCR traditionnel (de bureau ou en ligne) est plus rapide et moins cher. Si vous avez besoin que le contenu soit transformé en lignes et colonnes structurées — par exemple, des lignes d'articles de nombreuses factures fusionnées dans un seul tableur — c'est une tâche d'extraction de données IA, et un convertisseur ne vous y mènera pas, quelle que soit la précision de son OCR.
Le logiciel OCR peut-il lire l'écriture manuscrite ?
L'OCR basé sur l'IA/vision lit l'écriture manuscrite bien mieux que l'OCR traditionnel par reconnaissance de formes, car il interprète les lettres à l'aide du contexte. Cela dit, l'écriture manuscrite reste le cas le plus difficile — la précision chute nettement sur l'écriture cursive et les notes brouillonnes, même pour les modèles les plus performants — donc pour un travail axé sur l'écriture manuscrite, il vaut la peine de tester vos documents réels sur un niveau gratuit avant de vous engager.
L'OCR d'Adobe Acrobat est-il suffisant pour un usage professionnel ?
Pour rendre des PDF scannés consultables et modifiables dans un flux de travail PDF, oui — Adobe Acrobat Pro (19,99 $/mois) est fiable et pratique si vous utilisez déjà Acrobat. Là où il s'arrête, c'est l'extraction structurée à grande échelle : il rend un document consultable, mais il n'extraira pas des champs spécifiques de centaines de documents vers une seule feuille de calcul. Pour cela, une API cloud ou un outil d'extraction IA est mieux adapté.
En résumé
L'essentiel à retenir de cette comparaison, c'est que le « logiciel OCR » n'est pas une catégorie unique — c'est un spectre, et votre position sur ce spectre dépend d'une seule question : texte ou données ? Les outils de bureau (Adobe, ABBYY) et les convertisseurs en ligne (iLovePDF, SmallPDF, OnlineOCR.net) rendent les documents lisibles. Les API cloud (Google, AWS) et les outils d'extraction IA (Nanonets, ImageToTable.ai) rendent les documents structurés. Ils font tous « de l'OCR » ; ils diffèrent entièrement par ce qu'ils renvoient et par qui est censé les utiliser.
Ne choisissez pas l'outil OCR le plus puissant — choisissez celui dont le résultat correspond à votre besoin. Si vous voulez une numérisation consultable, le convertisseur le moins cher suffit. Si vous voulez une feuille de calcul, aucune précision OCR traditionnelle ne vous y mènera ; c'est un travail d'extraction IA.
Si vous réalisez que vous avez besoin de données et pas seulement de texte — des colonnes que vous nommez, remplies, sur une pile de documents — l'extrémité IA sans code de cette liste ne coûte rien à essayer, et quelques secondes suffiront à vous dire si elle lit correctement vos documents spécifiques. Téléversez-en un, saisissez les colonnes souhaitées, et regardez-les se remplir.
Divulgation : Ce guide est publié par ImageToTable.ai, qui est l'un des neuf outils examinés ci-dessus. Nous avons visé une évaluation équitable et technique — y compris en nommant les scénarios où les outils concurrents sont le meilleur choix. Les prix des concurrents proviennent de pages de tarification publiques et de plateformes d'avis neutres et sont à jour en juin 2026 ; vérifiez les chiffres les plus récents sur le site de chaque fournisseur avant d'acheter.