Meilleur logiciel OCR IA en 2026 :
8 outils intelligents comparés
La plupart des listes des « meilleurs OCR » mélangent discrètement deux choses différentes : les outils qui transforment des images de texte en caractères, et les outils qui comprennent ce que ces caractères signifient. Le deuxième groupe — l'OCR IA — est l'objet de ce guide. Le problème, c'est que l'« OCR IA » couvre désormais une plateforme d'entreprise à 1 500 $/mois nécessitant un déploiement de 90 jours et une application à 9 $/mois utilisable dans les dix prochaines minutes, et les deux revendiquent une précision de 99 %. Il s'agit d'une comparaison de conseiller technique portant sur huit d'entre eux : ce que chacun coûte réellement, à qui il convient et — tout aussi important — à qui il ne convient pas.
Points clés à retenir
- Huit outils d'OCR IA (logiciels qui lisent et comprennent les documents) annoncent tous environ 99 % de précision, ce qui signifie que la précision est le seul chiffre qui ne vous aidera pas à choisir entre eux.
- L'outil le moins cher coûte 9 $ par mois et le plus cher 18 000 $ par an — pourtant, les deux lisent les documents de la même manière, car cet écart de 200x finance l'infrastructure, les intégrations et la conformité, et non une lecture plus fine.
- Le bon choix n'est pas l'outil le plus puissant, mais celui dont la forme correspond à votre volume, à votre équipe et à votre budget — la seule question qui vaille la peine est donc de savoir lequel convient, et non lequel gagne.
Ce que « OCR IA » signifie réellement (et en quoi cela diffère de l'OCR traditionnel)
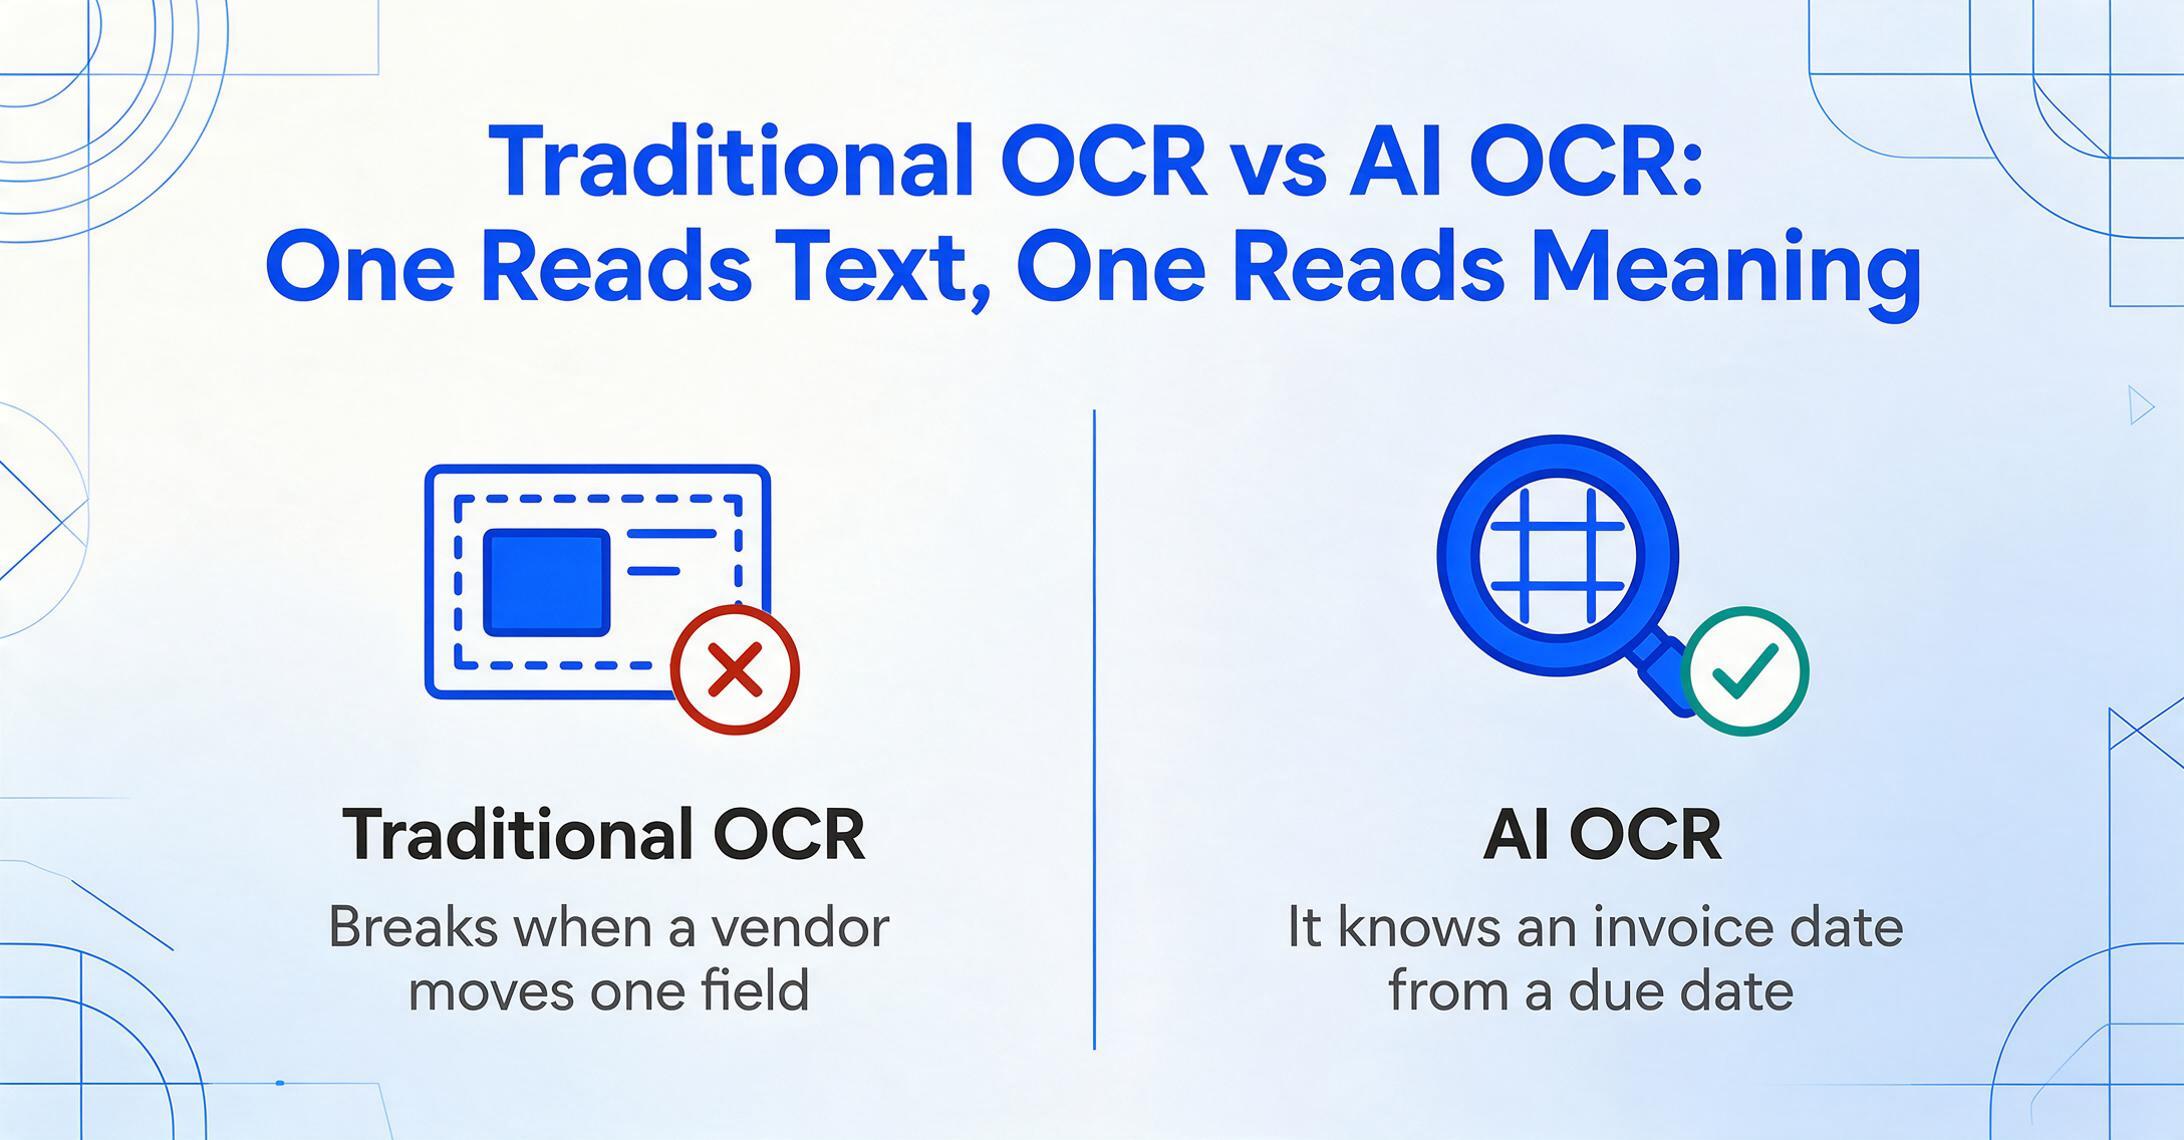
L'OCR IA est une reconnaissance optique de caractères qui utilise un modèle de langage visuel pour comprendre un document, et pas seulement le transcrire. Cette distinction est importante car elle change ce que vous pouvez demander à l'outil de faire — et ce que vous paierez pour cela.
L'OCR traditionnel est une technologie de reconnaissance de formes. Il scanne une image, compare les formes des pixels à une base de données de formes de caractères et produit du texte. Il n'a aucune idée de savoir si un nombre est un total de facture ou une référence de bon de commande ; il sait simplement que les caractères sont « 1 », « 2 », « 0 », « 0 ». Il fonctionne bien sur des mises en page propres et prévisibles et se casse dès qu'un fournisseur déplace un champ, change de police ou envoie un scan légèrement incliné. Pour extraire des champs spécifiques, les outils d'OCR traditionnels s'appuient sur des modèles — vous dessinez une boîte autour de l'endroit où se trouve le « numéro de facture », et l'outil copie tout ce qui apparaît à ces coordonnées sur chaque document. Changez la mise en page, et la boîte pointe vers la mauvaise chose.
L'OCR traditionnel lit où se trouvent les données. L'OCR IA lit ce que les données signifient — c'est pourquoi il continue de fonctionner lorsque la mise en page change et pourquoi il peut distinguer une date de facture d'une date d'échéance sans qu'on lui dise où chacune se trouve sur la page.
L'OCR IA, construit sur des modèles de langage visuel, ajoute un raisonnement contextuel par-dessus la reconnaissance de caractères. Il examine la page entière, reconnaît qu'un montant en dollars dans un tableau appartient à un en-tête de colonne spécifique, déduit un mot peu clair à partir du contexte environnant et comprend que les en-têtes se répètent dans un tableau multipage. C'est pourquoi on l'appelle souvent « OCR intelligent » ou, lorsqu'il alimente un flux de travail complet, IDP (traitement intelligent des documents). L'avantage pratique : il traite des documents qu'il n'a jamais vus auparavant, sans modèle à construire. Si vous voulez approfondir les mécanismes sous-jacents, nous couvrons la différence de précision entre l'OCR IA et l'OCR traditionnel et la frontière entre l'OCR, l'IA documentaire et l'IDP dans des guides séparés.
C'est la ligne que ce guide trace. Si vous comparez tous les OCR — y compris les scanners de bureau traditionnels et les moteurs open source gratuits — notre panorama complet du marché des logiciels OCR et notre analyse OCR IA vs OCR traditionnel sont de meilleurs points de départ. Ici, chaque outil examiné utilise l'IA pour lire des documents, et la question est de savoir lequel correspond à votre volume, votre budget et votre équipe.
Comment nous avons sélectionné et testé
Huit outils figurent dans cette liste parce qu'ils représentent l'éventail réel du marché de l'OCR IA, et non parce qu'ils sont les plus faciles à louer. Nous sommes partis des outils que les acheteurs recherchent réellement et que les comparatifs concurrents incluent systématiquement — les API cloud d'entreprise (Google, AWS), les plateformes IDP (traitement intelligent des documents) (ABBYY, Nanonets, Rossum, Docsumo, Affinda), et les applications no-code légères (notre propre ImageToTable.ai). Nous avons délibérément exclu les moteurs OCR traditionnels purs (Tesseract, scanners PDF basiques) car ils sortent du cadre de la question « OCR IA » — si votre pile technologique est open-source, nous couvrons ce domaine dans notre guide des meilleurs outils OCR open-source pour développeurs.
Chaque outil a été évalué sur quatre critères : approche d'extraction (comprend-il les documents ou correspond-il à des modèles ?), tarification réelle (le montant mensuel publié le plus bas, pas « à partir de »), charge de mise en place (un non-développeur peut-il l'utiliser, ou nécessite-t-il une phase d'entraînement de modèle ?), et adéquation honnête (les types de documents et tailles d'équipe où il excelle vraiment — et là où ce n'est pas le cas). Les prix ont été extraits de la page de tarification publique de chaque fournisseur ou de plateformes d'avis neutres (Capterra, G2, Software Advice) et sont à jour au Prix vérifiés en juin 2026. Lorsqu'un fournisseur ne publie pas de grille tarifaire (Rossum, niveau entreprise d'ABBYY), nous le disons plutôt que de deviner.
Une divulgation d'emblée : ImageToTable.ai — le produit auquel appartient ce site — est l'un des huit outils examinés. Nous l'avons positionné là où il s'intègre honnêtement (no-code, petites équipes, faible coût par document) et avons nommé les scénarios où ABBYY, Google, AWS ou Rossum sont le meilleur choix. Un comparatif qui prétendrait le contraire ne mériterait pas votre temps.
Sur la question de la précision qui sous-tend toute cette catégorie : notre propre benchmark interne de 8 moteurs OCR open-source sur des reçus identiques a révélé que le meilleur moteur traditionnel et le meilleur modèle de langage visuel étaient statistiquement à égalité sur la précision des caractères (docTR CER 0,197 contre Surya2 0,191 sur SROIE 2019), et que l'ajout d'un postprocesseur LLM fait passer six des huit moteurs dans une bande de F1 de champ de 0,57 à 0,62 — donc « le VLM bat l'OCR en précision » n'est pas une loi universelle ; cela dépend du mélange de documents et de ce que vous consommez. Les mises en garde concernant les mesures du CER sont quantifiées dans notre analyse pourquoi le CER induit en erreur. Ce contexte explique pourquoi cette liste évalue les outils sur l'adéquation au type de document et le prix plutôt que sur un seul chiffre de précision.
Les 8 meilleurs outils d'OCR IA en un coup d'œil
Le tableau ci-dessous est la réponse rapide. Le prix de départ est le tarif mensuel publié le plus bas pour chaque outil (les outils à l'usage sont affichés à leur tarif par page, car ils n'ont pas de minimum mensuel). « Tarifs vérifiés en juin 2026. »
| Outil | Prix de départ | Modèle tarifaire | Idéal pour | Limite clé | Essai gratuit ? |
|---|---|---|---|---|---|
| ImageToTable.ai | 9 $/mois | Abonnement + paiement à l'usage (crédits) | Sans code, petites équipes, export tableur | Pas de synchronisation ERP native, ni SOC 2/HIPAA | Offre gratuite |
| ABBYY FineReader / Vantage | 16 $/mois (bureau) | Par poste (bureau) ; par page sur mesure (entreprise) | OCR haute précision, 198 langues, sur site | IDP entreprise piloté par les ventes, configuration complexe | Oui |
| Google Document AI | 1,50 $ / 1 000 pages | À l'usage (par page) | OCR cloud haut volume, développeurs | Nécessite une configuration technique ; sortie brute à retraiter | Offre gratuite (GCP) |
| AWS Textract | 1,50 $ / 1 000 pages | À l'usage (par appel API/page) | OCR cloud haut volume dans les stacks AWS | Développeurs uniquement ; formulaires/tableaux coûtent 10 à 33 fois le prix de base | Offre gratuite (1 000 pages/mois, 3 mois) |
| Nanonets | 499 $/mois (Pro) | Crédits par exécution (0,30 $/extraction) | Automatisation AP pour entreprises de taille moyenne à grande | Nécessite souvent un apprentissage sur échantillon ; cher pour les PME | Offre gratuite / essai |
| Docsumo | ~500 $/mois | Par page / sur mesure entreprise | Workflows de documents financiers pour entreprises de taille moyenne | Tarification de production sur mesure ; pas adapté aux PME | Essai de 14 jours (1 000 pages) |
| Affinda | À l'usage (~299 $/mois en prod.) | Plateforme à l'usage | IA documentaire pour PME, parsing CV/RH | Pas de grille tarifaire publique ; sur devis | Oui |
| Rossum | 18 000 $/an (~1 500 $/mois) | Abonnement annuel entreprise, piloté par les ventes | Centres de services partagés AP en entreprise | Pas de libre-service ; mise en œuvre 30–90 jours | Essai sur demande |
Deux tendances ressortent. Premièrement, la tarification de l'« OCR IA » se divise en trois modèles : les abonnements forfaitaires (ImageToTable.ai, ABBYY desktop), la facturation à l'usage par page qui évolue avec le volume (Google, AWS, Nanonets, Affinda), et les contrats annuels pilotés par la vente sans prix publié (Rossum, Docsumo enterprise, ABBYY Vantage). Deuxièmement, le point d'entrée le moins cher (9 $/mois) et le plus cher (18 000 $/an) offrent tous deux une extraction IA — la différence de prix achète l'infrastructure, les intégrations et la conformité, pas une lecture fondamentalement meilleure. Ce dont vous avez réellement besoin est toute la décision, et le reste de ce guide vous l'explique outil par outil.
API OCR cloud pour développeurs : Google Document AI & AWS Textract
Si vous disposez de ressources d'ingénierie et d'un volume élevé et stable, les deux API OCR des hyperscalers sont difficiles à battre en termes de coût brut par page. Ce ne sont pas des produits que vous « utilisez » — ce sont des API sur lesquelles vous construisez.
Google Document AI
Document AI de Google est une plateforme cloud dotée d'une famille de processeurs : un processeur général Enterprise Document OCR, ainsi que des processeurs Form Parser et Custom Extractor qui extraient des champs structurés. L'OCR de base coûte 1,50 $ pour 1 000 pages (passant à 0,60 $ au-delà de 5 millions de pages/mois), tandis que Custom Extractor et Form Parser coûtent 30 $ pour 1 000 pages. La prise en charge de l'écriture manuscrite couvre plus de 60 langues avec une grande précision sur les formulaires structurés.
Idéal pour : les équipes de développement ayant besoin d'une reconnaissance API évolutive pour les formulaires professionnels à volume élevé, en particulier celles déjà sur Google Cloud. Pas idéal pour : les non-développeurs — il n'existe pas d'application cliquable, et l'OCR renvoie des blocs de texte bruts qui nécessitent un post-traitement avant d'être prêts pour un tableur. Les prix augmentent également rapidement dès que vous passez de l'OCR de base à l'extraction de champs structurés. Voir les tarifs de Google Document AI →
AWS Textract
Textract est le service d'OCR et d'extraction de données documentaires d'Amazon, exposé via plusieurs API (Detect Document Text, Analyze Document, Analyze Expense, Analyze ID). Detect Document Text coûte 1,50 $ pour 1 000 pages, mais les fonctionnalités structurées sont bien plus chères : les tableaux coûtent environ 15 $ pour 1 000 pages et les formulaires environ 50 $ pour 1 000 pages. Une offre gratuite couvre 1 000 pages/mois pendant les trois premiers mois. Un utilisateur Reddit qui l'utilise a noté que Textract est « assez raisonnable (~1 cent USD par document) » pour le texte de base — mais ce chiffre augmente fortement avec les formulaires et les tableaux.
Idéal pour : les équipes déjà dans l'écosystème AWS qui veulent l'OCR comme brique d'un pipeline plus large. Pas idéal pour : ceux qui n'ont pas de développeurs, ou les charges de travail dominées par les formulaires et les tableaux, où le coût par page est 10 à 33 fois le tarif de base. Nous détaillons les compromis dans notre comparaison AWS Textract. Voir les tarifs d'AWS Textract →
Ces deux API partagent la même limite fondamentale pour les acheteurs non techniques : elles lisent bien les documents, mais transformer leur sortie en tableur final — avec vos noms de colonnes, vos formats, vos calculs — est un projet, pas une fonctionnalité. C'est l'écart que les outils no-code plus loin dans cette liste comblent.
Plateformes IDP d'entreprise : ABBYY, Nanonets, Rossum, Docsumo & Affinda
Le milieu de marché est occupé par les plateformes de traitement intelligent des documents — des outils qui intègrent l'OCR IA dans des flux de travail, des validations et des intégrations. Ils sont conçus pour les organisations qui traitent des milliers de documents par mois avec des équipes dédiées à la gestion de ce pipeline.
ABBYY (FineReader PDF & Vantage)
ABBYY est le vétéran de l'OCR, et il vend deux produits très différents. FineReader PDF est un outil OCR-et-PDF pour poste de travail à partir de 16 $/mois (Standard pour Windows ; Corporate à 24 $/mois), réputé pour sa précision — des comparaisons indépendantes citent ~99,8 % — et sa prise en charge de 198 langues. ABBYY Vantage et FlexiCapture sont les produits IDP d'entreprise, facturés à la page via des devis personnalisés (les données d'achat anonymisées montrent environ 0,04 $–0,08 $/page à volume modéré).
Idéal pour : l'OCR exigeant en précision, les archives multilingues, les déploiements sur site et les flux de travail d'édition PDF où la finesse du poste de travail FineReader brille. Moins adapté pour : les équipes qui veulent une application cloud en libre-service — le niveau IDP d'entreprise est piloté par les ventes avec une vraie phase d'implémentation, et FineReader n'est pas conçu pour l'automatisation API par lots. Voir la comparaison détaillée dans notre comparaison ABBYY FineReader. Voir les tarifs ABBYY FineReader →
Nanonets
Nanonets est une plateforme d'automatisation de flux de travail et d'IA documentaire destinée principalement aux équipes de comptabilité fournisseurs (AP). Elle propose une offre gratuite Starter, mais le plan Pro commence à 499 $/mois, avec une extraction facturée à 0,30 $ par exécution sur un système de crédits. C'est un outil puissant et riche en intégrations, avec des connecteurs QuickBooks, Sage et Xero.
Idéal pour : l'automatisation AP de milieu de marché à entreprise, où les approbations de flux de travail et les intégrations comptables justifient le prix. Moins adapté pour : les petites équipes ou ceux qui veulent zéro configuration — Nanonets implique souvent le téléchargement d'échantillons et l'entraînement de modèles pour les types de documents complexes, ce qui ajoute une courbe d'apprentissage à l'intégration. Notre comparaison Nanonets couvre les cas où cette configuration porte ses fruits et ceux où elle ne les porte pas. Voir les tarifs Nanonets →
Rossum
Rossum se positionne autour d'un « LLM transactionnel » entraîné sur mesure : il entraîne un modèle d'extraction sur les documents historiques de chaque client, puis le déploie dans des flux de travail partagés de comptabilité fournisseurs (AP) avec validation humaine dans la boucle. La tarification est entièrement pilotée par l'équipe commerciale : le niveau d'entrée commencerait à 18 000 $/an (~1 500 $/mois), avec une tarification Business sur devis. Les avis publics sur G2 et Gartner Peer Insights sont solides de la part des acheteurs AP en entreprise.
Idéal pour : les grandes entreprises qui gèrent un volume élevé d'AP via un centre de services partagés, où une mise en œuvre de 30 à 90 jours et la formation d'un modèle sur mesure sont des investissements acceptables. Pas idéal pour : les PME, les comptables ou toute personne traitant moins de ~5 000 documents/mois — le calendrier de mise en œuvre et la tarification sont excessifs, et il n'y a pas d'inscription en libre-service. Plus de détails dans notre comparaison Rossum. Voir la tarification Rossum →
Docsumo
Docsumo est une plateforme IDP (traitement intelligent des documents) destinée au milieu de marché, avec un fort accent sur les documents financiers — relevés bancaires, factures et documents d'évaluation des risques — affichant des taux de traitement direct de 95 %+ pour certains clients. Elle propose un essai gratuit de 14 jours (1 000 pages), mais les plans de production commencent à environ 500 $/mois, avec une tarification entreprise adaptée au cas d'usage et aux besoins de support.
Idéal pour : les équipes financières et de prêt du milieu de marché qui ont besoin de résultats validés et prêts à l'intégration à volume. Pas idéal pour : les utilisateurs individuels et les petites entreprises — le prix d'entrée suppose une équipe et un flux de travail, pas un individu qui numérise des reçus. Comparez les approches dans notre comparaison Docsumo. Voir la tarification Docsumo →
Affinda
Affinda est une plateforme d'IA documentaire connue pour l'analyse de CV et des flux de travail RH et financiers plus larges, avec une couche de contrôle qui ancre chaque réponse extraite à sa source. La tarification est basée sur l'usage et largement déterminée sur devis ; les essais démarrent à très bas coût, tandis que les mises en production se situent généralement autour de 299 $/mois pour environ 5 000 pages.
Idéal pour : les équipes de tech RH et de milieu de marché ayant besoin d'une extraction gouvernée et auditable — en particulier les documents RH structurés. Moins adapté pour : les acheteurs qui veulent un prix transparent en libre-service ; comme la plupart des fournisseurs de plateformes, la tarification en production nécessite une conversation. Affinda n'a pas encore de page de comparaison dédiée sur ce site, mais elle se situe dans la même catégorie IDP de milieu de marché que Docsumo et Nanonets. Voir la tarification d'Affinda →
Le fil conducteur de ces cinq outils : de vraies capacités, de vraies fonctionnalités de flux de travail — et de vrais frais généraux. Ils ont du sens lorsque le traitement documentaire est un département, pas une tâche. Si c'est une tâche, les deux outils suivants sont faits pour vous.
OCR IA No-code pour les équipes légères : ImageToTable.ai
À l'extrémité accessible du marché se trouve un outil conçu pour les personnes qui veulent des données extraites dans une feuille de calcul sans écrire de code, sans entraîner de modèle et sans signer de contrat annuel. C'est là qu'ImageToTable.ai — le produit derrière ce site, et l'un des huit outils de cette comparaison — se situe.
ImageToTable.ai
ImageToTable.ai est un outil d'extraction de données par IA basé sur un modèle de langage visuel. Son mécanisme central est l'Extraction de colonnes personnalisées : au lieu de dessiner des zones ou d'entraîner un modèle, vous saisissez les noms de colonnes souhaités — « Numéro de facture », « Date d'échéance », « Total » — et l'IA localise chaque valeur n'importe où sur la page en comprenant ce qu'elle signifie. Comme il est sans modèle, une nouvelle mise en page de fournisseur ne nécessite aucune configuration ; vous téléversez et c'est parti. Il ajoute deux choses que la plupart des outils économiques n'ont pas : les colonnes calculées (définissez « Total ligne (Qté × Prix unitaire) » et l'IA fait le calcul pendant l'extraction) et les colonnes déduites (une colonne « Catégorie » que l'IA remplit même lorsque le document ne comporte pas ce champ). Les résultats arrivent directement dans Excel, CSV, JSON ou Word, avec un module complémentaire natif pour Google Sheets. La tarification commence avec une offre gratuite, puis 9 $/mois (Basic), avec des crédits de paiement à l'usage qui n'expirent pas.
Idéal pour : les freelances, les comptables et les petites et moyennes équipes qui veulent une extraction no-code et sans modèle dans une feuille de calcul au coût par document le plus bas — y compris les documents manuscrits et les photos prises au téléphone. Moins adapté pour : les entreprises ayant besoin d'une synchronisation ERP native en un clic, d'un déploiement sur site ou d'une conformité SOC 2 / HIPAA — pour celles-ci, ABBYY, Rossum ou les API des hyperscalers sont le bon choix. C'est un outil d'extraction, pas une plateforme de flux de travail AP avec routage d'approbation. Vous pouvez voir l'approche no-code en action sur notre page d'extraction OCR IA ou lire quand il est pertinent de passer de l'OCR traditionnel à l'extraction par IA. Essayez ImageToTable.ai gratuitement →
Qu'en est-il de ChatGPT et Gemini pour l'OCR ?
Les modèles multimodaux généralistes — ChatGPT, Gemini, Claude — lisent les documents de manière impressionnante, et ils figurent dans tous les classements OCR 2026 pour une bonne raison : leur précision contextuelle sur les écritures manuscrites difficiles est réellement solide. Pour un document ponctuel, coller une image dans une fenêtre de chat et demander un tableau est une option légitime.
Là où ils montrent leurs limites, c'est dans l'extraction répétitive et par lots. Ils n'ont pas de pipeline de traitement par lots intégré qui fusionne 50 factures en une seule feuille de calcul cohérente, pas de schéma de sortie imposé (la même invite peut renvoyer des structures de colonnes légèrement différentes d'une exécution à l'autre), et une tendance à « combler » occasionnellement avec des valeurs plausibles plutôt que de signaler un manque. Les outils OCR IA dédiés de ce guide enveloppent la même classe de modèles dans les garde-fous qui rendent la sortie fiable à grande échelle. Nous approfondissons les détails dans notre comparaison ChatGPT. En bref : utilisez un chatbot pour un document, utilisez un outil spécialisé pour un processus.
Comment choisir : selon la taille de l'équipe, le budget et le type de document
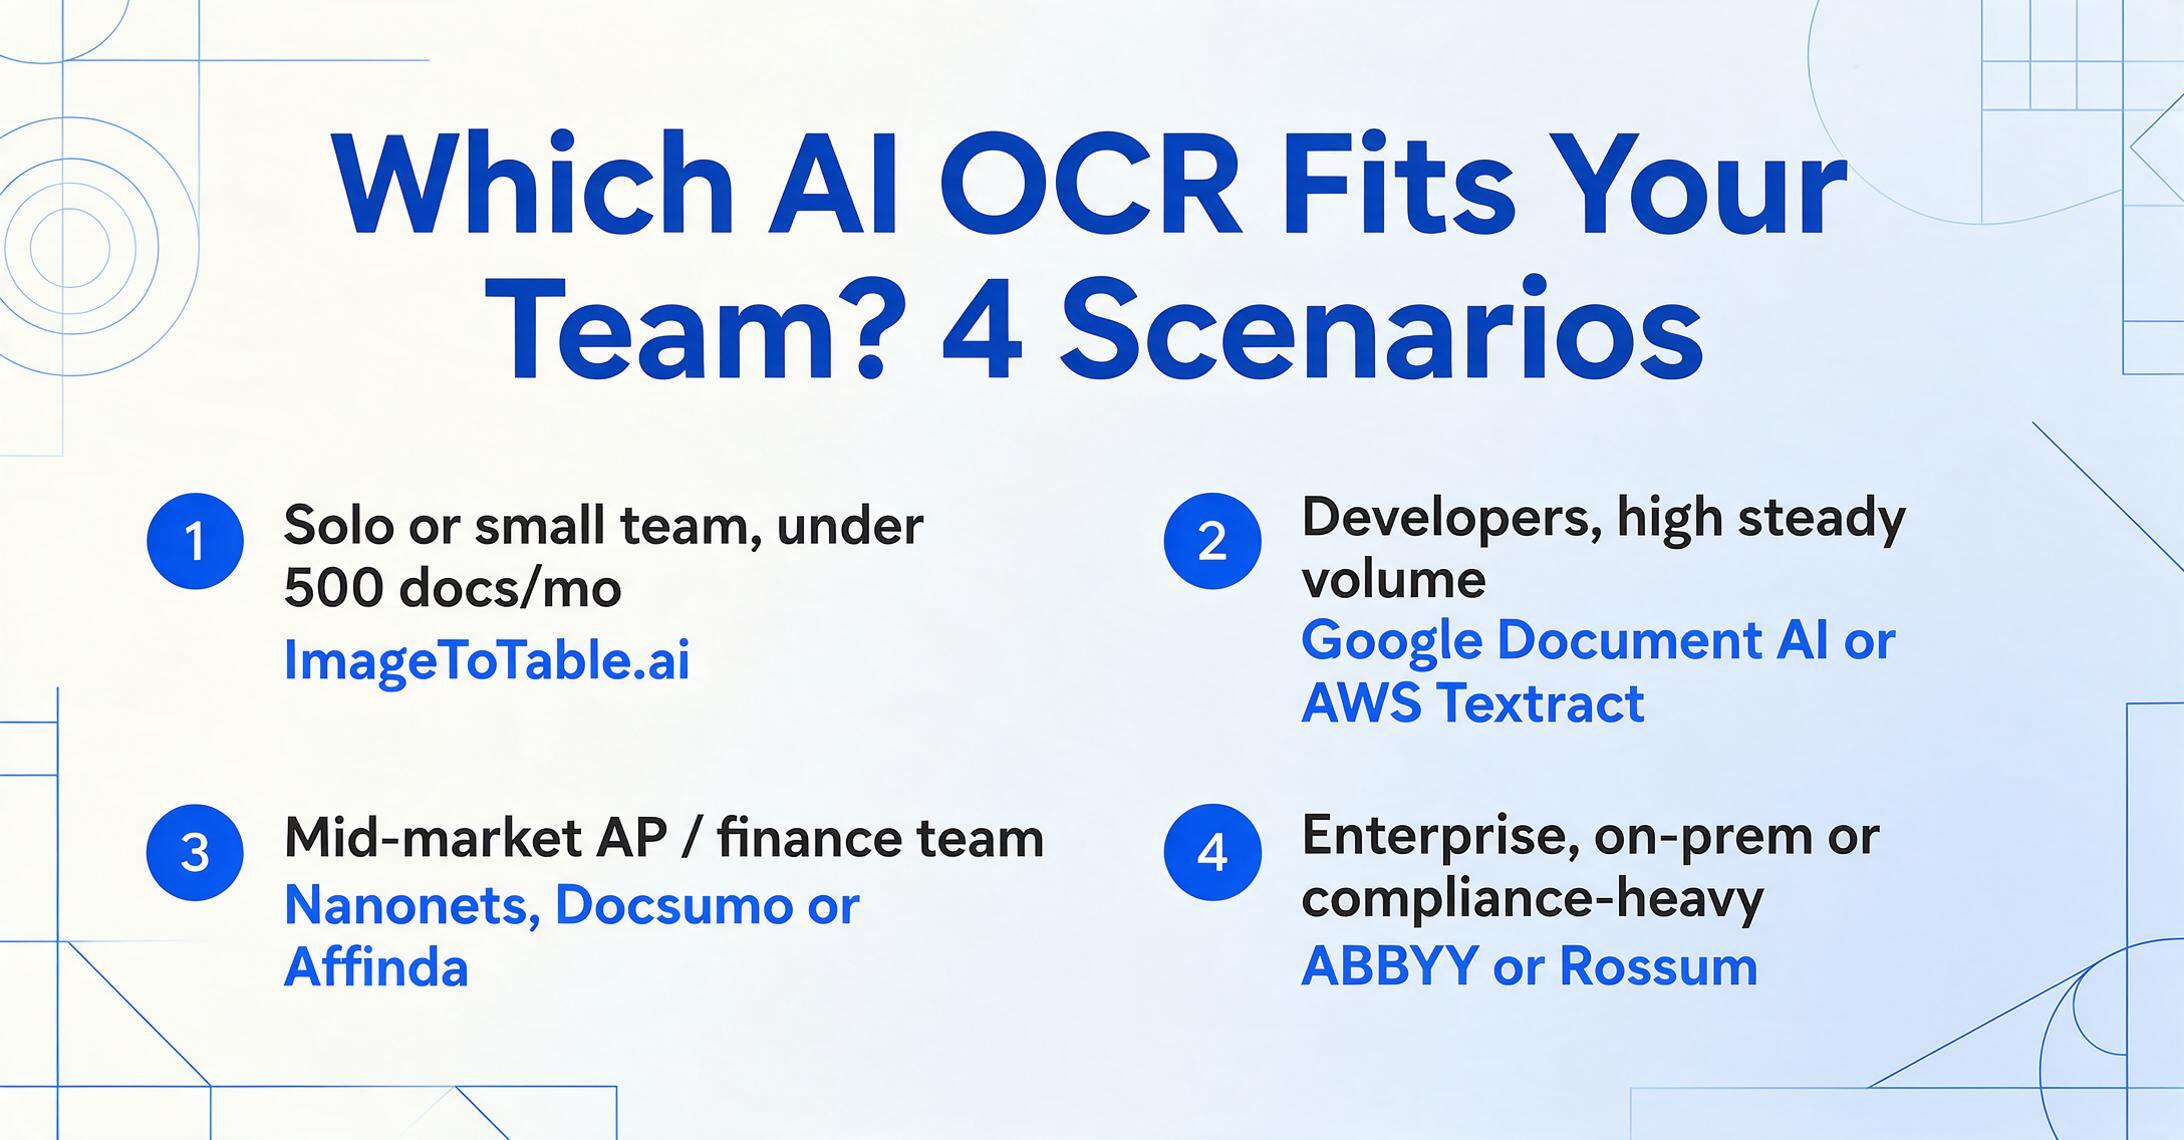
Le bon outil OCR IA dépend moins de celui qui est « le meilleur » en général que de celui qui correspond à votre situation. Voici la décision en quatre scénarios courants.
Solo / petite équipe, <500 docs/mois
Meilleur choix : ImageToTable.ai
No-code, aucune configuration requise, sortie en feuille de calcul et un prix adapté au volume. Une plateforme à 499 $/mois gaspille 90 % de sa capacité ici. Commencez avec une offre gratuite et confirmez que l'IA lit vos documents spécifiques avant de payer quoi que ce soit.
Développeurs, volume élevé et stable
Meilleur choix : Google Document AI ou AWS Textract
Coût par page le plus bas à grande échelle, et vous avez l'expertise technique pour transformer la sortie brute en données structurées. Choisissez en fonction du cloud que vous utilisez déjà. Prévoyez une hausse de prix dès que vous ajoutez des formulaires et des tableaux.
Équipe AP / finance de milieu de marché
Meilleur choix : Nanonets, Docsumo ou Affinda
Lorsque le traitement des documents est un flux de travail avec approbations, validation et intégrations au système comptable, les plateformes IDP justifient leur prix. Attendez-vous à un essai et à une période d'intégration. Comparez-les sur la profondeur d'intégration, pas seulement sur la précision.
Entreprise, sur site ou forte conformité
Meilleur choix : ABBYY ou Rossum
Déploiement sur site, couverture de 198 langues, modèles personnalisés et échelle de centre de services partagés. Tarification pilotée par les ventes et mise en œuvre réelle, mais c'est le prix d'une gouvernance de niveau entreprise.
Si votre situation chevauche plusieurs catégories — par exemple, une petite équipe aujourd'hui qui prévoit de passer à l'échelle — il vaut la peine de consulter les comparatifs complémentaires qui approfondissent chaque segment : outils d'extraction de données documentaires, plateformes de traitement intelligent des documents et logiciels d'extraction de données pour documents non structurés.
Comment évaluer un outil avant de l'acheter
La seule étape qui sépare un bon achat d'OCR IA d'un achat regretté est de tester sur vos documents — pas sur les PDF d'exemple soignés du fournisseur. Chaque outil de ce guide annonce une précision d'environ 99 % ; ce chiffre est mesuré sur du texte imprimé propre, et votre pile de documents est probablement plus désordonnée. Menez un test pilote avec 20 à 50 de vos fichiers réels — les scans de mauvaise qualité, les photos prises au téléphone, les tableaux multipages et l'écriture manuscrite que vous traitez réellement, pas les plus propres. Observez trois choses pendant le test pilote :
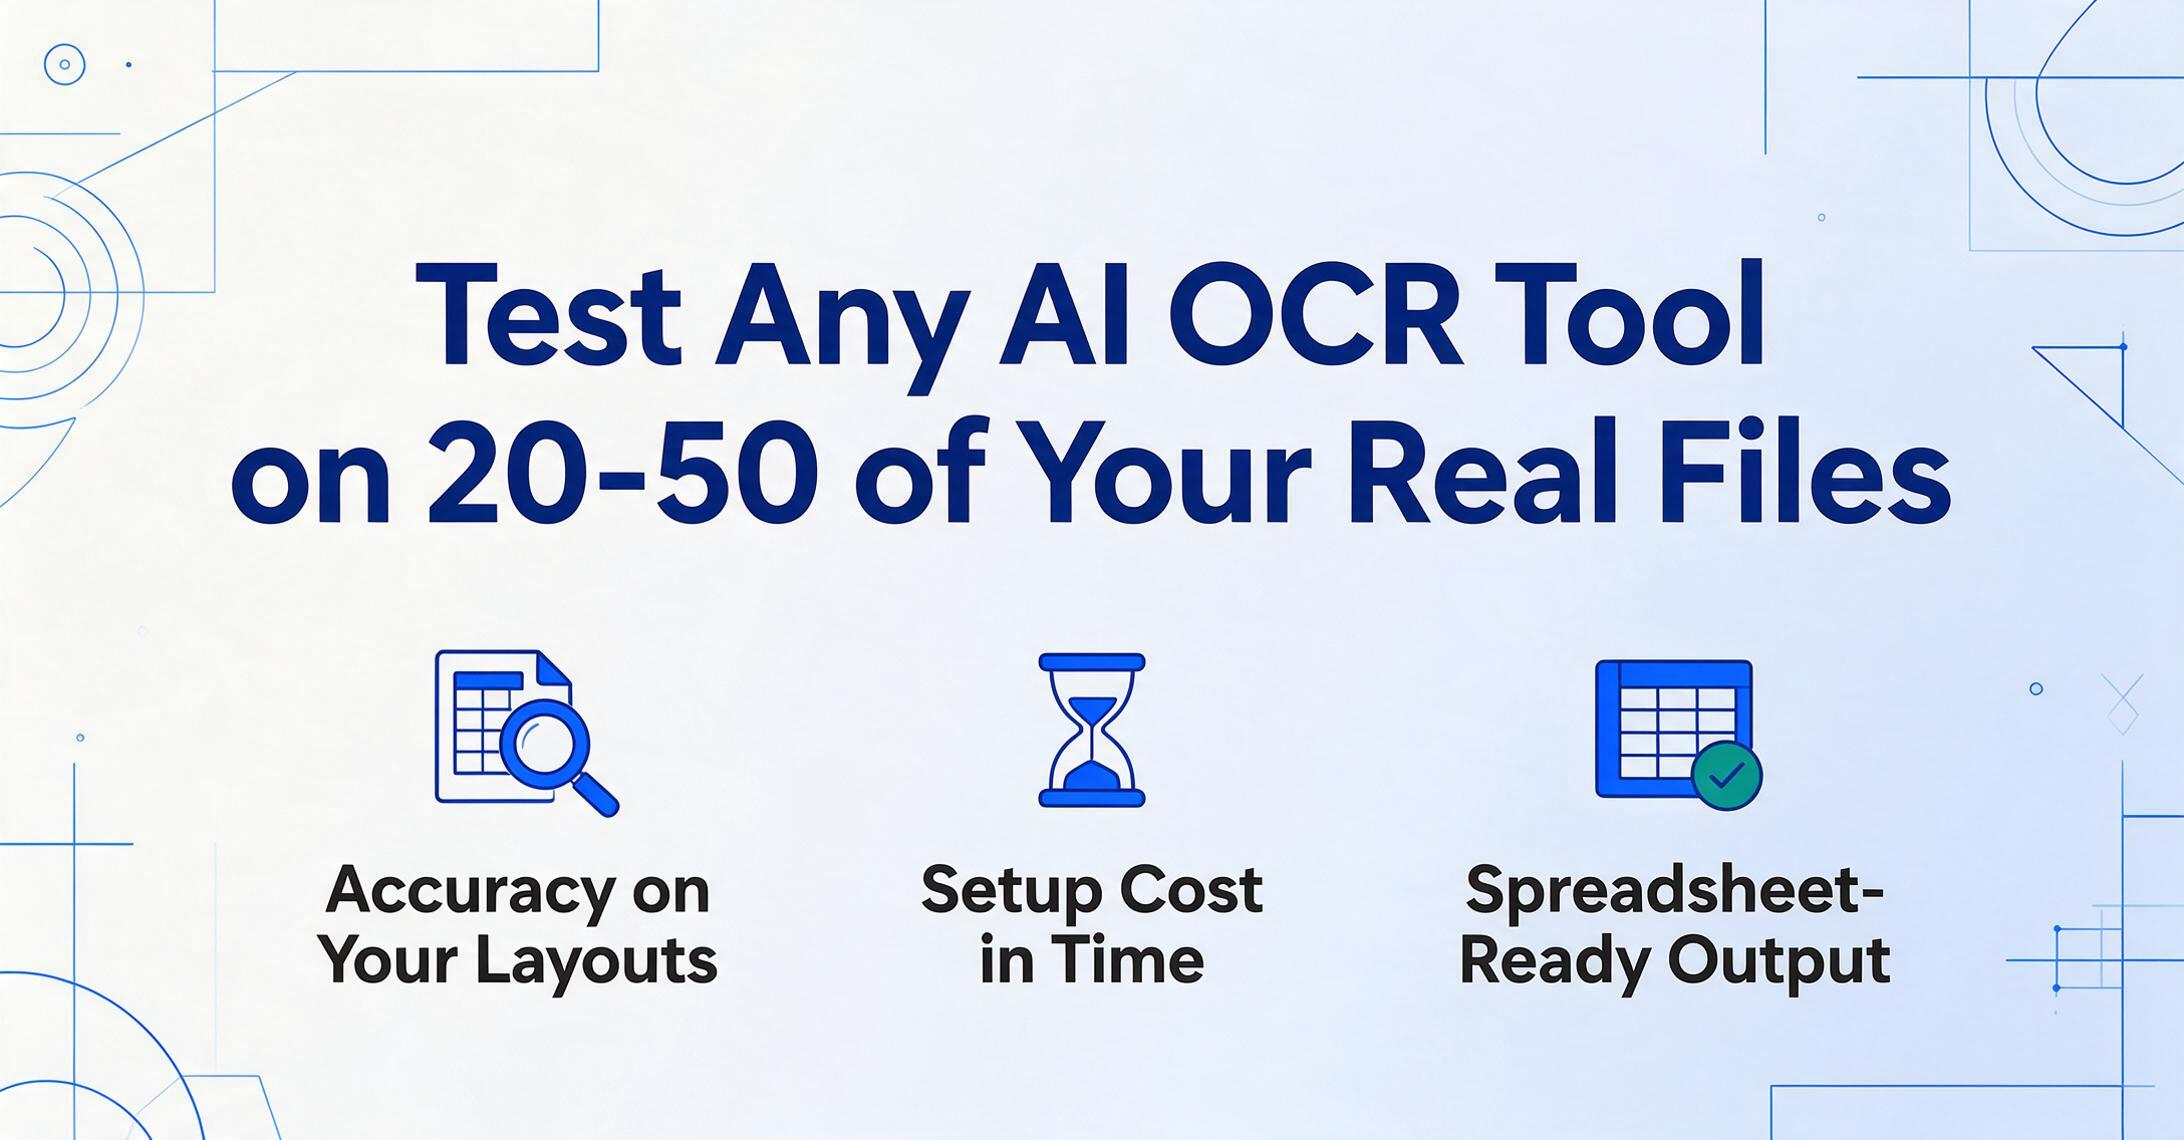
- Précision sur vos mises en page : l'outil lit-il correctement les champs qui vous intéressent, ou seulement « la plupart » de la page ? Vérifiez les types de documents spécifiques qui dominent votre flux de travail, pas le document de démonstration.
- Coût de configuration en temps : un non-développeur peut-il obtenir une sortie structurée en quelques minutes, ou faut-il un entraînement sur échantillons, des modèles, ou un appel commercial et une phase d'implémentation ? Ajoutez les heures d'intégration au prix lors de la comparaison des outils.
- Qualité de la sortie : ce qui revient est-il prêt pour un tableur — colonnes mappées à vos noms de champs — ou du texte brut que vous devrez encore nettoyer à la main ? Ce temps de nettoyage est un coût réel, et c'est exactement là que les outils d'extraction no-code comme ImageToTable.ai montrent leur valeur.
La plupart des outils ici offrent une offre gratuite ou un essai précisément pour ce test — utilisez-le. Si un outil ne peut pas réussir un test pilote de 20 documents sur vos fichiers réels, aucun tableau de référence ou score d'avis ne sauvera le déploiement.
Questions fréquemment posées
Quelle est la différence entre l'OCR IA et l'OCR traditionnel ?
L'OCR traditionnel convertit les images de texte en caractères en comparant les formes des pixels — il lit où se trouve le texte mais ne comprend pas ce qu'il signifie, il repose donc sur des modèles et échoue lorsque la mise en page change. L'OCR IA utilise un modèle de langage visuel pour comprendre la structure et le contexte du document : il sait qu'un montant appartient à une colonne spécifique, distingue la date d'une facture de sa date d'échéance, et gère des mises en page qu'il n'a jamais vues — sans modèle requis.
Quel logiciel d'OCR IA est le plus abordable ?
Parmi les huit outils présentés ici, ImageToTable.ai a le point d'entrée le plus bas à 9 $/mois (plus une offre gratuite et des crédits de paiement à l'usage sans expiration). Les API cloud (Google Document AI, AWS Textract) sont les moins chères par page à très haut volume — 1,50 $ pour 1 000 pages pour l'OCR de base — mais nécessitent une configuration par des développeurs. Les plateformes d'entreprise (Nanonets, Docsumo, Rossum) commencent à 499 $/mois ou plus.
L'OCR IA est-il plus précis que l'OCR traditionnel ?
Sur des documents propres et prévisibles, les deux peuvent atteindre une précision de plus de 90 %. La différence apparaît sur les documents réels — mises en page variées, scans de mauvaise qualité, écriture manuscrite, tableaux multipages — où l'OCR traditionnel se dégrade fortement tandis que l'OCR IA tient bon car il raisonne à partir du contexte. Notre benchmark open-source interne a quantifié la limite : sur des reçus anglais propres, le meilleur moteur traditionnel (docTR, CER 0,197) a fait jeu égal avec le meilleur VLM (Surya2, 0,191), et l'avantage du VLM n'apparaît que lorsque l'extraction de champs ou des mises en page complexes entrent en jeu. Les principaux outils d'IA rapportent jusqu'à 99 % de précision sur les données de tableaux imprimés ; la question pertinente n'est pas la précision maximale mais la fréquence à laquelle vos documents sortent du cas « propre et prévisible ».
Ai-je besoin de compétences en programmation pour utiliser l'OCR IA ?
Cela dépend de l'outil. Google Document AI et AWS Textract sont des API qui nécessitent des développeurs. ABBYY Vantage, Nanonets, Docsumo et Affinda sont des plateformes qui exigent une configuration et souvent une phase de formation de modèle ou d'intégration. ImageToTable.ai est no-code : vous téléversez un document, saisissez les colonnes souhaitées et obtenez une feuille de calcul — sans code, sans formation de modèle.
L'OCR IA peut-il lire l'écriture manuscrite ?
Oui, bien mieux que l'OCR traditionnel. Les outils basés sur des modèles de vision interprètent l'écriture manuscrite en utilisant le contexte, c'est pourquoi ils surpassent les moteurs de reconnaissance de formes sur l'écriture cursive et les notes désordonnées. La précision diminue toutefois sur une écriture très brouillonne. Pour les charges de travail très manuscrites, il vaut donc la peine de tester vos documents réels sur une offre gratuite avant de vous engager.
Que signifie « modèle tarifaire » — abonnement, paiement à l'usage ou vente directe ?
Les outils par abonnement (ImageToTable.ai, ABBYY desktop) facturent des frais mensuels fixes pour une capacité définie — prévisibles, adaptés à un volume stable. Les outils à l'usage (Google, AWS, Nanonets, Affinda) facturent par page ou par exécution — le coût évolue avec le volume, idéal si l'utilisation est variable ou très élevée. Les outils à vente directe (Rossum, ABBYY Vantage, Docsumo entreprise) proposent un prix annuel personnalisé après un processus commercial — conçus pour les entreprises aux exigences complexes.
En résumé
L'essentiel à retenir de cette comparaison est que « l'OCR IA » n'est pas une seule catégorie de produits — c'en est trois. Il y a le composant pour développeurs (Google, AWS), la plateforme d'entreprise (ABBYY, Nanonets, Rossum, Docsumo, Affinda) et l'application no-code (ImageToTable.ai). Tous lisent les documents intelligemment ; ils diffèrent entièrement par le profil d'utilisateur attendu et par ce qui entoure la lecture.
N'achetez pas l'outil d'OCR IA le plus puissant. Achetez celui dont la forme correspond à la vôtre — votre volume, votre équipe, votre budget — car chaque outil ici lit bien les documents, et la différence de prix finance des infrastructures que vous n'utiliserez peut-être jamais.
Si vous êtes une équipe légère ou un professionnel indépendant qui souhaite simplement obtenir des données documentaires dans une feuille de calcul — sans développeurs, sans formation de modèles, sans contrat annuel — l'extrémité no-code de cette liste est le bon point de départ, et il ne vous en coûte rien de découvrir si l'IA lit correctement vos documents spécifiques. Téléversez-en un et regardez une colonne que vous avez nommée apparaître, remplie, en quelques secondes.
Divulgation : Ce guide est publié par ImageToTable.ai, qui est l'un des huit outils examinés ci-dessus. Nous avons visé une évaluation juste et technique — y compris en nommant les scénarios où les outils concurrents sont le meilleur choix. Les tarifs des concurrents proviennent de pages tarifaires publiques et de plateformes d'évaluation neutres et sont à jour en date de juin 2026 ; vérifiez les chiffres les plus récents sur le site de chaque fournisseur avant d'acheter.