ImageToTable.ai vs AWS Textract :
Extraction de documents sans code vs pipeline sur mesure
AWS Textract est une API puissante de reconnaissance de documents — et ce n'est qu'une API. Son utilisation nécessite un compte AWS, un bucket S3 pour le stockage des documents, des rôles IAM pour le contrôle d'accès, du code pour appeler l'API, une logique pour analyser la réponse JSON, et votre propre couche d'export pour intégrer les données dans un tableur. ImageToTable.ai est ce que vous obtiendriez en transformant Textract en produit fini, si vous aviez six mois et une équipe d'ingénieurs : téléversez des documents dans un navigateur, nommez vos colonnes, téléchargez un fichier Excel fusionné. Aucune infrastructure requise.
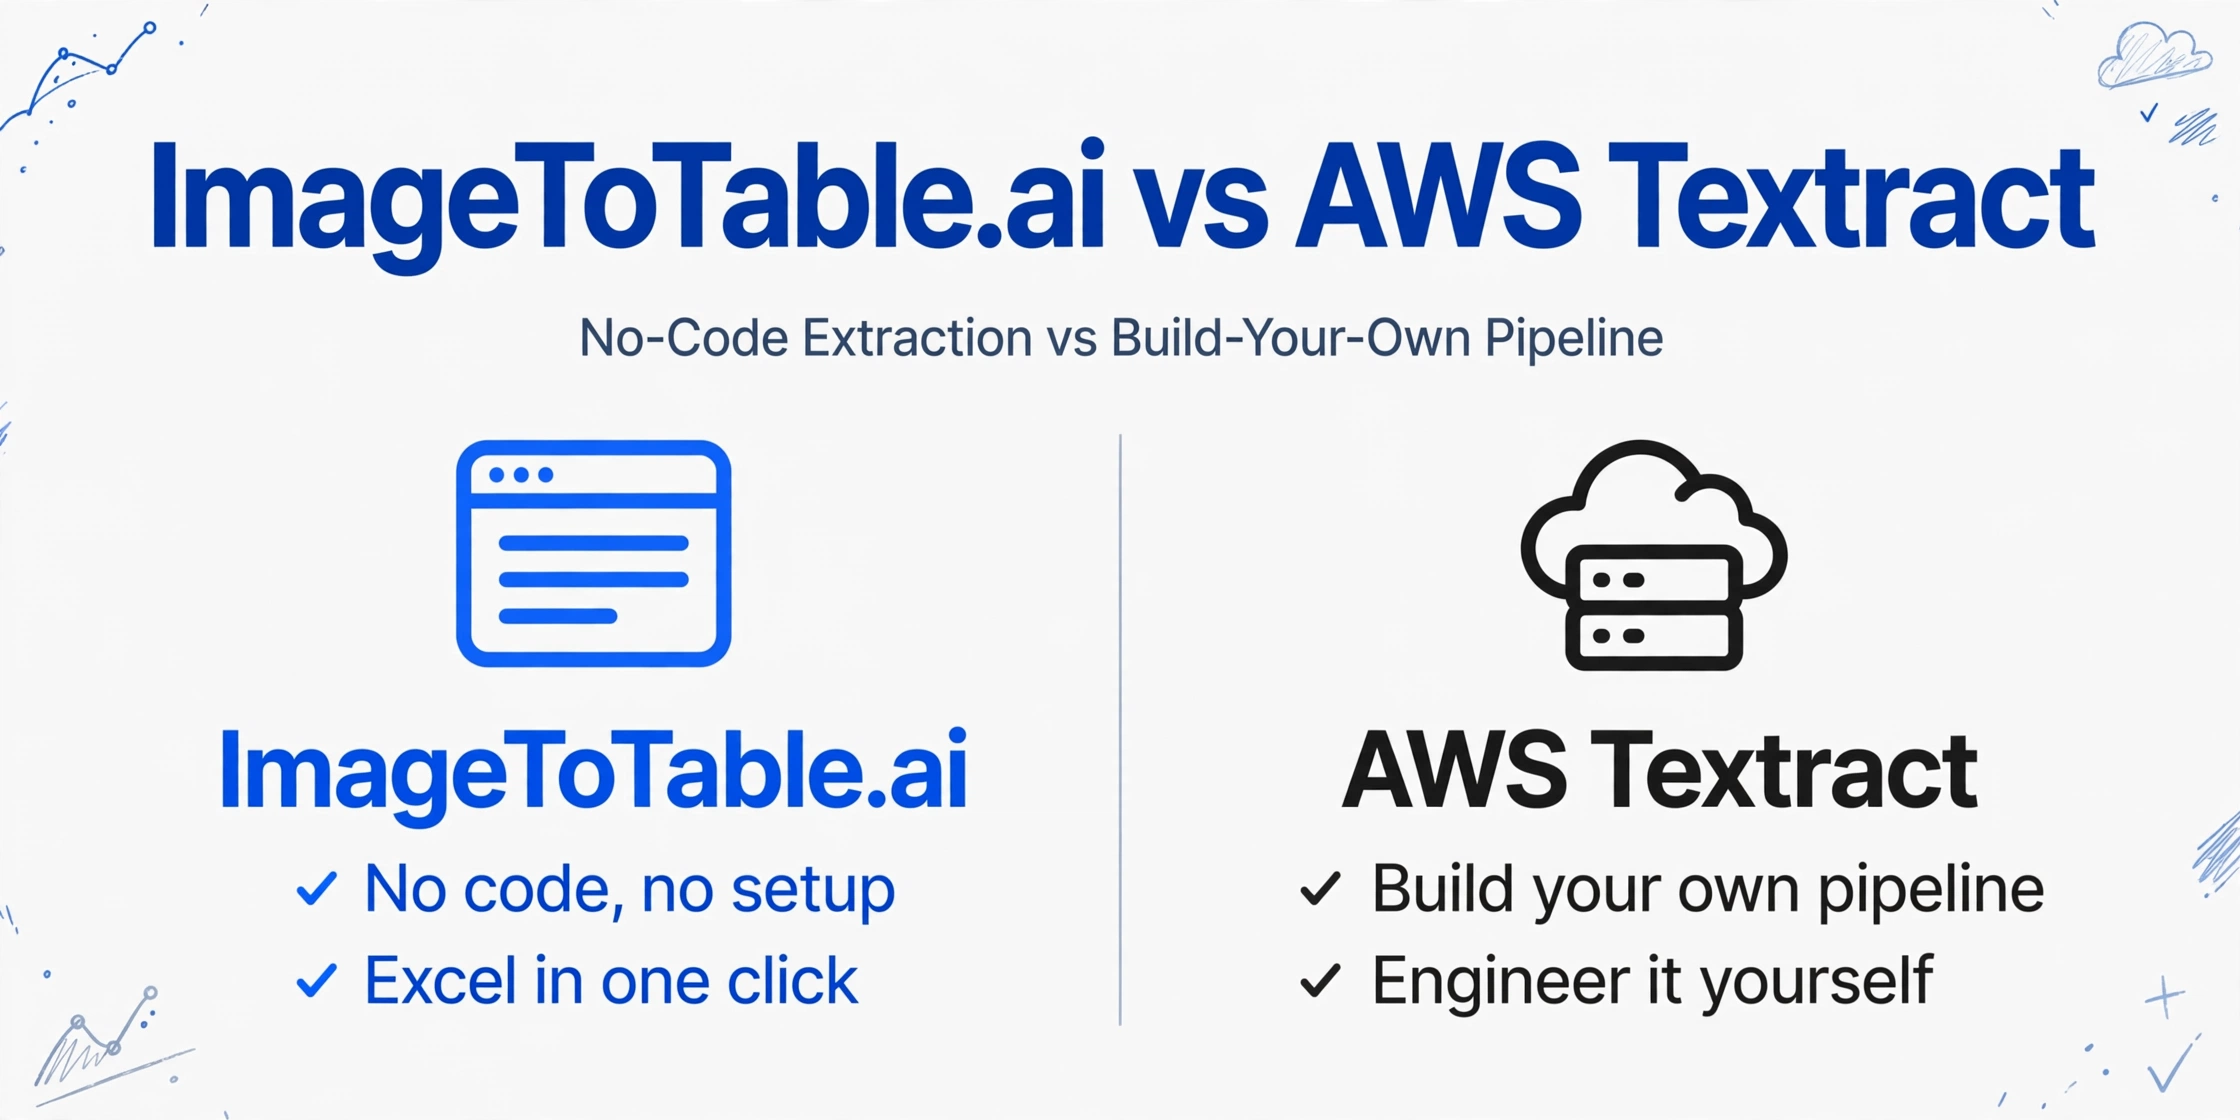
Comparaison rapide
Cette page s'adresse aux équipes métier et opérationnelles qui évaluent l'utilisation d'AWS Textract. Si vous êtes développeur et souhaitez intégrer l'extraction dans une application personnalisée, rendez-vous sur Quand choisir AWS Textract.
Choisissez ImageToTable.ai si…
- Vous devez extraire des données structurées de documents sans écrire de code
- Vous souhaitez définir les noms de colonnes en langage courant — sans requêtes AWS ni parsing JSON
- Vous avez besoin d'un outil navigateur que vos équipes opérationnelles ou financières peuvent utiliser dès aujourd'hui
- Vous traitez des lots de documents et souhaitez les fusionner en un seul tableau aligné
- Vous n'avez pas de compte AWS ou ne souhaitez pas configurer d'infrastructure cloud
- Vous voulez une exportation directe vers Excel — pas une réponse JSON nécessitant un traitement supplémentaire
Choisissez AWS Textract si…
- Vous êtes développeur et créez un pipeline de traitement documentaire personnalisé
- Vous devez intégrer l'extraction de documents dans une application AWS existante
- Vous avez besoin d'un traitement documentaire hautement scalable et programmatique à des millions de pages/mois
- Vous avez besoin de la flexibilité brute de l'API pour post-traiter les données extraites de manière personnalisée
- Votre équipe maîtrise AWS et dispose de la capacité d'ingénierie pour construire et maintenir l'intégration
Comparaison des fonctionnalités
| Fonctionnalité | AWS Textract | ImageToTable.ai |
|---|---|---|
| Interface utilisateur | Pas d'interface utilisateur finale — la console AWS est un outil développeur, pas un workflow de traitement de documents ; une utilisation en production nécessite le développement d'une interface personnalisée | Basée navigateur — importez des fichiers, saisissez les noms de colonnes, téléchargez Excel ; aucune compétence technique requise |
| Configuration requise | Compte AWS, bucket S3 (Textract n'accepte pas les téléchargements directs), rôles IAM, code d'intégration API, analyse JSON, gestion des erreurs, pipeline de sortie | Aucune configuration — fonctionne immédiatement dans un navigateur ; aucun compte requis pour essayer |
| Extraction de champs personnalisés | Nécessite d'écrire des requêtes (paramètres API structurés) et du code de post-traitement pour mapper la sortie JSON aux champs métier ; les champs standards comme le total d'une facture sont pré-entraînés, mais les champs personnalisés nécessitent du développement | Saisissez les noms de colonnes souhaités en langage courant ; l'IA les associe automatiquement au contenu du document |
| Format de sortie | Réponse JSON — données structurées renvoyées par l'API ; pour obtenir un Excel, il faut écrire une couche d'exportation supplémentaire ou connecter des outils en aval | Téléchargement direct en Excel (XLSX), CSV, JSON ou Word en une seule étape |
| Traitement par lots | API asynchrone par lots disponible ; nécessite des notifications SNS ou une interrogation pour vérifier l'état des tâches ; pas d'interface utilisateur intégrée pour la fusion par lots | Importez plusieurs fichiers à la fois ; tous les résultats sont automatiquement fusionnés dans un seul tableau aligné |
| Compétences techniques | Connaissances de l'infrastructure AWS requises ; à l'aise avec S3, IAM, Lambda et les appels API | Aucune compétence technique requise — n'importe quel membre de l'équipe peut l'utiliser |
| Modèle tarifaire | 1,50 $/1 000 pages pour l'OCR de base ; 15 $/1 000 pages pour l'extraction de formulaires et de tableaux ; offre gratuite de 3 mois (1 000 pages/mois) pour les nouveaux comptes — aws.amazon.com/textract/pricing | Mode invité gratuit ; forfaits à partir de 9 $/mois (150 crédits) ; paiement à l'utilisation à partir de 6 $/50 pages |
| Délai avant la première extraction | De quelques jours à plusieurs semaines — configuration du compte AWS, configuration S3, création de rôles IAM, intégration API et tests avant qu'un document ne soit traité en production | Moins de 2 minutes — importez votre premier document et voyez les résultats immédiatement |
L'infrastructure à construire en premier
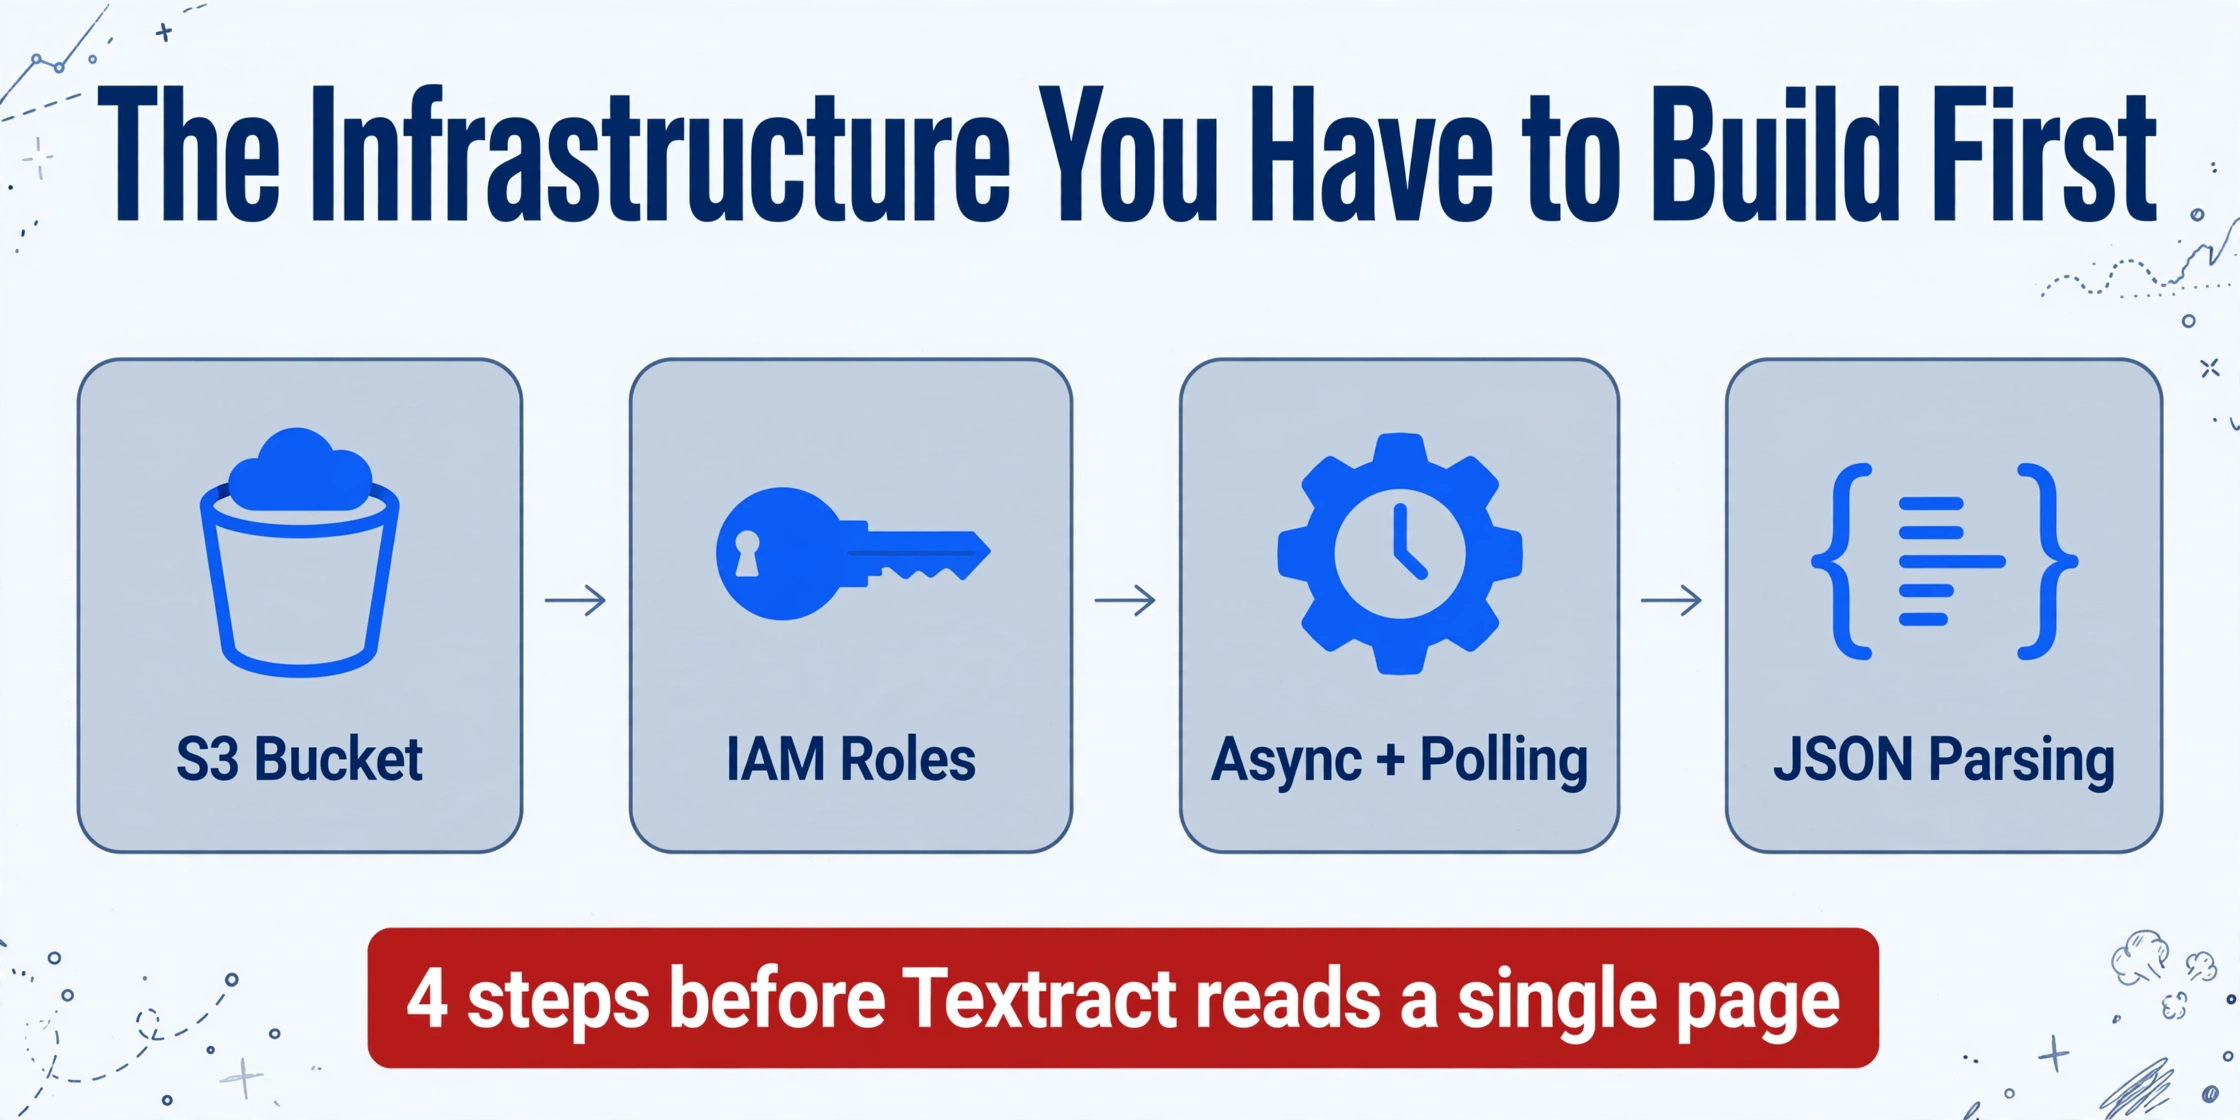
La page de tarification d'AWS Textract affiche 1,50 $ pour 1 000 pages d'extraction de texte de base — un tarif compétitif à grande échelle. Ce que la page de tarification ne montre pas, c'est l'infrastructure requise avant que ce tarif ne s'applique.
Première étape : Amazon Textract n'accepte pas les documents sous forme de téléversements directs. Vous avez besoin d'un bucket S3 pour stocker les fichiers avant que Textract puisse les lire. Deuxième étape : l'accès S3 nécessite des rôles IAM configurés avec les bonnes autorisations pour que Textract puisse lire depuis le bucket. Troisième étape : pour les PDF multipages, vous avez besoin d'un traitement asynchrone — l'API soumet la tâche et renvoie un identifiant de tâche ; vous interrogez ensuite la fin du traitement ou configurez des notifications SNS vers Lambda pour gérer la réponse. Quatrième étape : Textract renvoie du JSON. Pour intégrer ce JSON dans un tableur, vous devez écrire une logique d'analyse, un mappage de champs et un pipeline d'exportation.
Les évaluateurs G2 signalent systématiquement cet obstacle : "L'intégration de Textract dans les flux de travail peut nécessiter une solide compréhension de l'infrastructure AWS, ce qui peut être difficile pour les équipes sans expérience préalable d'AWS." — G2. Pour une équipe logicielle qui vit dans AWS, c'est un travail de routine. Pour une équipe des opérations ou des finances qui a besoin de données de factures dans Excel d'ici vendredi, c'est un prérequis insurmontable.
Les champs personnalisés nécessitent toujours de l'ingénierie
Textract est livré avec des modèles pré-entraînés pour les types de documents courants : factures, reçus, formulaires fiscaux et documents de prêt. Pour les champs standard sur des formats standard — montant total, nom du fournisseur, date — ces modèles fonctionnent immédiatement. La limite apparaît dès que vous avez besoin de quelque chose de personnalisé : un code de centre de coûts interne spécifique, un libellé de champ non standard provenant d'un fournisseur particulier, ou des données qui ne correspondent pas à la distribution d'entraînement de Textract.
La solution de Textract est Queries — des paramètres d'API structurés qui vous permettent de spécifier ce qu'il faut rechercher. "L'extraction de champs personnalisés nécessite une ingénierie supplémentaire." — G2. Écrire des Queries n'est pas difficile si vous êtes développeur ; cela nécessite de comprendre le schéma de l'API et de tester sur votre corpus de documents. Pour un utilisateur non technique, ce n'est tout simplement pas une option.
Les mises en page complexes présentent un défi distinct : "L'extraction de données tabulaires complexes est très compliquée" et "les tableaux complexes ne sont parfois pas traités correctement." — G2. Pour les documents avec des tableaux imbriqués, des cellules fusionnées ou des mises en page de colonnes non standard, une logique de post-traitement supplémentaire peut être nécessaire.
ImageToTable.ai gère les champs personnalisés grâce à des noms de colonnes en langage clair. Saisissez « Montant TPS », « Adresse de livraison » ou « Description de la ligne d'article » — le LLM de vision associe ces libellés au contenu pertinent de chaque document, quel que soit l'endroit où ce contenu apparaît sur la page ou la manière dont le document original a été formaté.
Comparaison des prix
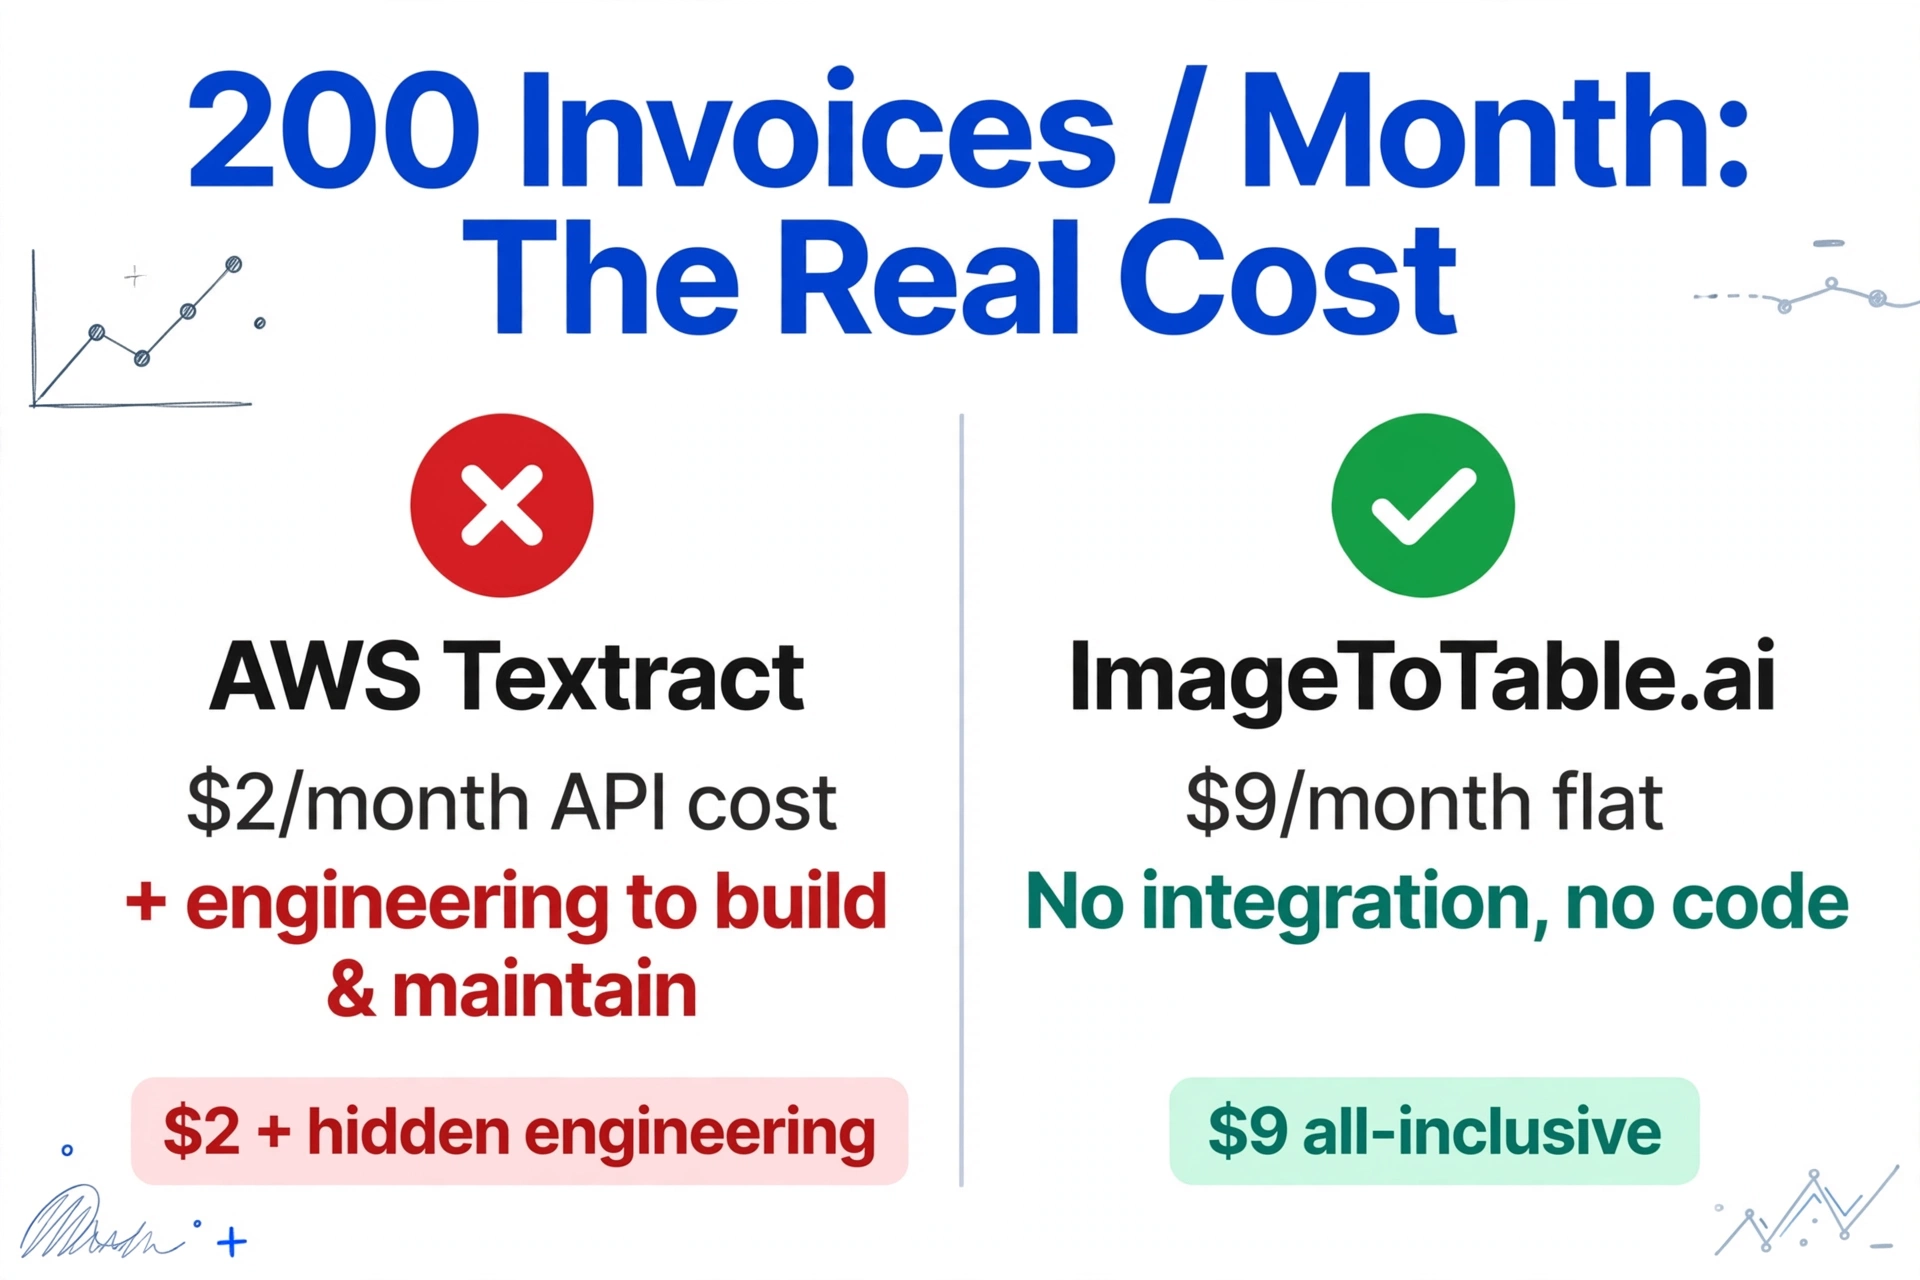
La tarification d'AWS Textract est calculée par page et évolue bien à volume élevé. Le problème, c'est que les fonctionnalités utiles — formulaires, tableaux et requêtes personnalisées — coûtent nettement plus cher que la détection de texte de base :
| Fonctionnalité | Coût AWS Textract | Équivalent ImageToTable.ai |
|---|---|---|
| Détection de texte de base (API Detect Document Text) | 1,50 $ / 1 000 pages (0,0015 $/page) | 9 $/mois pour 150 documents (complexité quelconque) ; 19 $/mois pour 400 ; 59 $/mois pour 1 500 |
| Formulaires + tableaux + requêtes (API Analyze Document) | 15 $ / 1 000 pages (0,015 $/page) — 10× le prix de base | |
| Extraction de factures/dépenses (API Analyze Expense) | 0,01 $/page (premier million de pages) — nécessite en plus du travail d'ingénierie pour exploiter la sortie |
Pour une équipe traitant 200 factures/mois et ayant besoin d'une extraction au niveau des champs (API Analyze Expense à 0,01 $/page) : 2 $/mois de coûts API — vraiment pas cher. Mais cela suppose que vous ayez déjà construit l'intégration, et le coût d'ingénierie continu pour la maintenir n'est pas nul. Les 9 $/mois d'ImageToTable.ai couvrent les mêmes 200 factures sans travail d'intégration, sans infrastructure et sans code.
Tarifs en vigueur en 2026-05. Voir la tarification AWS Textract et la tarification ImageToTable.ai pour les prix actuels.
Quand AWS Textract est le bon choix
Textract est l'outil adapté lorsque l'extraction de documents fait partie d'un projet d'ingénierie plus vaste — et non une fin en soi. Si vous n'avez besoin que de texte OCR brut et souhaitez éviter la configuration AWS, OCR.space propose une API gratuite — notre comparaison OCR.space couvre cette voie plus légère.
Créer une application de traitement de documents personnalisée. Si vous êtes développeur et créez un produit où l'extraction de documents n'est qu'une fonctionnalité parmi d'autres — une application de gestion des dépenses, une plateforme d'automatisation des factures, un outil de revue de contrats — Textract vous donne un accès API brut aux résultats d'extraction que vous pouvez façonner dans n'importe quel format de sortie dont votre application a besoin. La flexibilité est réelle et la précision est élevée.
Intégration approfondie avec l'écosystème AWS. Si votre pile technologique est déjà fortement basée sur AWS — Lambda pour le traitement, S3 pour le stockage, DynamoDB pour les résultats, SQS pour la file d'attente des tâches — Textract s'intègre nativement. L'infrastructure que vous devriez mettre en place pour Textract est une infrastructure que vous possédez peut-être déjà.
Très gros volumes à faible coût par page. À des centaines de milliers de pages par mois, le prix par page de Textract est très compétitif par rapport aux alternatives. L'investissement d'ingénierie dans l'intégration s'amortit sur de gros volumes, ce qui n'est pas le cas à 200 documents/mois. À l'autre extrême, les équipes traitant une poignée de documents n'ont peut-être pas besoin d'API du tout — notre comparaison ChatGPT couvre les cas où un outil conversationnel suffit.
Ce que les utilisateurs disent d'AWS Textract
"Intégrer Textract dans des flux de travail peut nécessiter une solide compréhension de l'infrastructure AWS, ce qui peut être difficile pour les équipes sans expérience préalable d'AWS." — Avis G2
"L'extraction de champs personnalisés nécessite une ingénierie supplémentaire — extraire des champs métier spécifiques propres au format de facture d'un fournisseur exige d'écrire des requêtes, de créer une logique de post-traitement ou d'entraîner des modèles personnalisés." — Avis G2
"L'extraction de données tabulaires complexes est très compliquée... les tableaux complexes ne sont parfois pas traités correctement." — Avis G2
Questions fréquemment posées
Est-ce qu'AWS Textract a une interface utilisateur pour télécharger et vérifier des documents ?
Non. AWS Textract est une API — elle n'inclut pas d'interface utilisateur permettant aux utilisateurs métier de télécharger des documents, vérifier les extractions, corriger les erreurs ou exporter les résultats. La console de gestion AWS propose une interface de démonstration pour les tests, mais c'est un outil pour développeurs, pas un workflow de production. Pour que des utilisateurs non techniques interagissent avec Textract, quelqu'un doit construire une interface personnalisée par-dessus l'API. ImageToTable.ai fournit une interface navigateur prête à l'emploi : téléchargez des fichiers, saisissez des noms de colonnes, téléchargez Excel — aucun développement nécessaire.
Combien coûte l'utilisation d'AWS Textract pour l'extraction de factures ?
L'API Analyze Expense de Textract (conçue pour les factures et reçus) coûte 0,01 $/page pour le premier million de pages par mois. Pour 200 factures/mois, cela représente 2 $/mois de coûts d'API — vraiment bas. Cependant, cela suppose que vous ayez déjà construit l'intégration : un bucket S3 pour stocker les fichiers, des rôles IAM pour l'accès, du code pour appeler l'API, une logique d'analyse JSON et un pipeline de sortie pour obtenir les données dans un tableur. Le coût d'infrastructure et d'ingénierie est distinct et souvent supérieur au coût de l'API. Le forfait Basic d'ImageToTable.ai couvre 150 factures/mois pour 9 $ forfaitaires, sans travail d'infrastructure ni d'intégration.
Est-ce qu'AWS Textract peut extraire des champs personnalisés des factures ?
Oui, grâce à la fonctionnalité Queries — des paramètres d'API structurés où vous spécifiez les champs à rechercher. Pour les champs de facture standard (total, nom du fournisseur, date), les modèles pré-entraînés les gèrent sans configuration personnalisée. Pour les champs non standard spécifiques à votre workflow, vous écrivez des requêtes personnalisées et pouvez avoir besoin de code de post-traitement pour gérer les cas particuliers. Les évaluateurs G2 notent que « l'extraction de champs personnalisés nécessite une ingénierie supplémentaire ». ImageToTable.ai gère les champs personnalisés via des noms de colonnes en langage courant : saisissez « Montant TVA » ou « Adresse de livraison » et le LLM de vision extrait ces champs de tout format de document.
AWS Textract est-il un bon choix pour une petite entreprise ou une équipe non technique ?
Généralement non. Textract nécessite une expertise AWS pour être configuré et maintenu — créer un bucket S3, configurer des rôles IAM, écrire du code d'intégration API et construire un pipeline de sortie sont des prérequis avant qu'un seul document puisse être traité en production. Les évaluateurs G2 signalent systématiquement cela comme un obstacle pour les équipes sans ressources d'ingénierie AWS dédiées. Si votre équipe a besoin d'obtenir des données de facture dans Excel sans écrire de code, un outil spécialisé comme ImageToTable.ai est mieux adapté. Textract est le bon choix lorsque l'extraction de documents est un composant d'un projet d'ingénierie plus vaste.
Comment AWS Textract se compare-t-il à ImageToTable.ai en termes de précision ?
AWS Textract atteint une précision supérieure à 99 % sur du texte imprimé dans des conditions standard — une référence élevée pour un OCR de base. Pour l'extraction structurée de champs (champs métier spécifiques à partir de factures), la précision dépend de la qualité du document, de la complexité de la mise en page et de la pertinence de vos requêtes par rapport à la structure du document. ImageToTable.ai utilise un LLM visuel qui interprète la sémantique du document plutôt que de se fier à la reconnaissance de motifs de mise en page, ce qui permet de mieux gérer les variations de mise en page et le contenu manuscrit. Pour les tableaux complexes et les formats de documents inhabituels, les évaluateurs G2 de Textract notent que la précision peut diminuer. Les deux outils fonctionnent bien sur les documents imprimés propres ; l'écart est le plus visible sur les mises en page variées et les formats non standard.
Essayez ImageToTable.ai gratuitement
Pas de compte AWS. Pas de bucket S3. Pas de rôles IAM. Pas de code. Téléchargez vos documents, nommez vos colonnes et téléchargez un fichier Excel fusionné en moins de deux minutes.
Aucune carte de crédit requise. Crédits gratuits inclus à l'inscription.