Meilleur logiciel OCR pour la santé 2026 :
12 outils pour documents médicaux testés
Ce guide évalue 12 outils d'OCR et d'extraction de documents par IA selon cinq critères qui comptent particulièrement pour les équipes soignantes : la précision sur la terminologie médicale et les systèmes de codage, la capacité à lire l'écriture manuscrite pour les notes cliniques et les ordonnances, la préparation à la conformité HIPAA, l'intégration avec les EHR et les logiciels de gestion de cabinet, et l'adéquation honnête de chaque outil aux différentes tailles d'organisations de santé et capacités techniques. Chaque prix provient de la page publique du fournisseur en date de juin 2026. Divulgation : ImageToTable.ai est inclus dans ce comparatif. Je n'ai aucune affiliation avec les autres outils répertoriés. Chaque lien externe pointe vers le site du fournisseur afin que vous puissiez vérifier les affirmations de manière indépendante.
Points clés
- Chaque outil OCR de santé de cette liste revendique une précision de 95%, mais ce critère a été testé sur des factures dactylographiées propres, alors que votre flux quotidien réel comprend des EOB avec des tableaux récapitulatifs imbriqués et des ordonnances écrites en cursive par un médecin qui était en retard pour ses visites.
- La fonction qui détermine si l'OCR vous fait gagner du temps ou vous en fait perdre est la discrimination des types de codes, car un outil qui regroupe les codes de procédure CPT et les codes de diagnostic ICD-10 dans une seule colonne Code crée une étape de re-tri manuel qui annule chaque seconde que l'extraction vous a fait gagner.
- Ignorez la comparaison des pourcentages de précision et demandez plutôt si l'outil signe un BAA pour votre charge de travail HIPAA et s'il peut lire l'écriture manuscrite que vos médecins produisent réellement à 11pm dans une clinique très fréquentée.
Tableau comparatif rapide
| Outil | Idéal pour | Écriture manuscrite | BAA disponible | Mise en place | Prix de départ |
|---|---|---|---|---|---|
| ImageToTable.ai | Extraction sans code pour divers documents médicaux | ✅ Forte | ❌ | Minutes | Gratuit / 9 $/mois |
| Amazon Textract | Pipelines natifs AWS à volume élevé | ✅ Bonne | ✅ | Heures–jours | Paiement par page |
| Google Document AI | Analyseurs de soins de santé basés sur GCP | ✅ Bonne | ✅ | Heures–jours | Paiement par page |
| Azure Document Intelligence | Systèmes de santé centrés Microsoft | ✅ Bonne | ✅ | Heures–jours | Paiement par page |
| ABBYY Vantage | IDP d'entreprise avec compétences low-code | ✅ Modérée | ✅ | Semaines | Devis personnalisé |
| Nanonets | Modèles personnalisés pour formats de niche | ✅ Modérée | ✅ | Jours–semaines | Gratuit / sur mesure |
| LlamaParse (LlamaIndex) | Produits d'IA de santé pilotés par les développeurs | ✅ Forte | Entreprise | Heures | Gratuit / sur mesure |
| Docsumo | Traitement de documents administratifs et d'assurance | ⚠️ Limitée | ✅ | Jours | Devis personnalisé |
| Hyland OnBase | GED d'entreprise avec capture | ⚠️ Limitée | ✅ | Mois | Devis personnalisé |
| Kofax | Capture de documents d'entreprise à grande échelle | ⚠️ Limitée | ✅ | Mois | Devis personnalisé |
| Koncile | OCR de santé axé sur les API | ✅ Bonne | ✅ | Jours | Devis personnalisé |
| Tesseract | Référence open-source gratuite | ❌ Faible | N/A (auto-hébergé) | Heures (développement) | Gratuit |
Comment nous avons sélectionné et testé
Le traitement des documents de santé n'est pas le même problème que l'OCR à usage général. Un outil qui gère parfaitement les factures peut échouer de manière catastrophique sur un relevé de prestations avec des tableaux imbriqués, un rapport de laboratoire avec des résultats à la fois numériques et narratifs, ou un formulaire de réclamation CMS-1500 où les erreurs de codage ont de réelles conséquences financières. Nous avons évalué chaque outil selon cinq dimensions spécifiques au secteur de la santé.
1. Précision de la terminologie médicale et du codage
Les documents de santé contiennent des codes de diagnostic ICD-10, des codes de procédure CPT, des Revenue Codes, des identifiants de laboratoire LOINC, des termes cliniques SNOMED CT et des codes de médicaments NDC. Ces éléments suivent des schémas syntaxiques précis — les codes CPT sont toujours à cinq chiffres, les codes ICD-10 sont des chaînes alphanumériques de trois à sept caractères, les Revenue Codes sont des identifiants de localisation à quatre chiffres. Un outil qui ne peut pas distinguer un code CPT d'un Revenue Code produit une sortie qui nécessite un re-tri manuel. Nous avons évalué la capacité de chaque outil à préserver ces structures de codage sans les regrouper dans des champs génériques « Code ».
2. Reconnaissance de l'écriture manuscrite
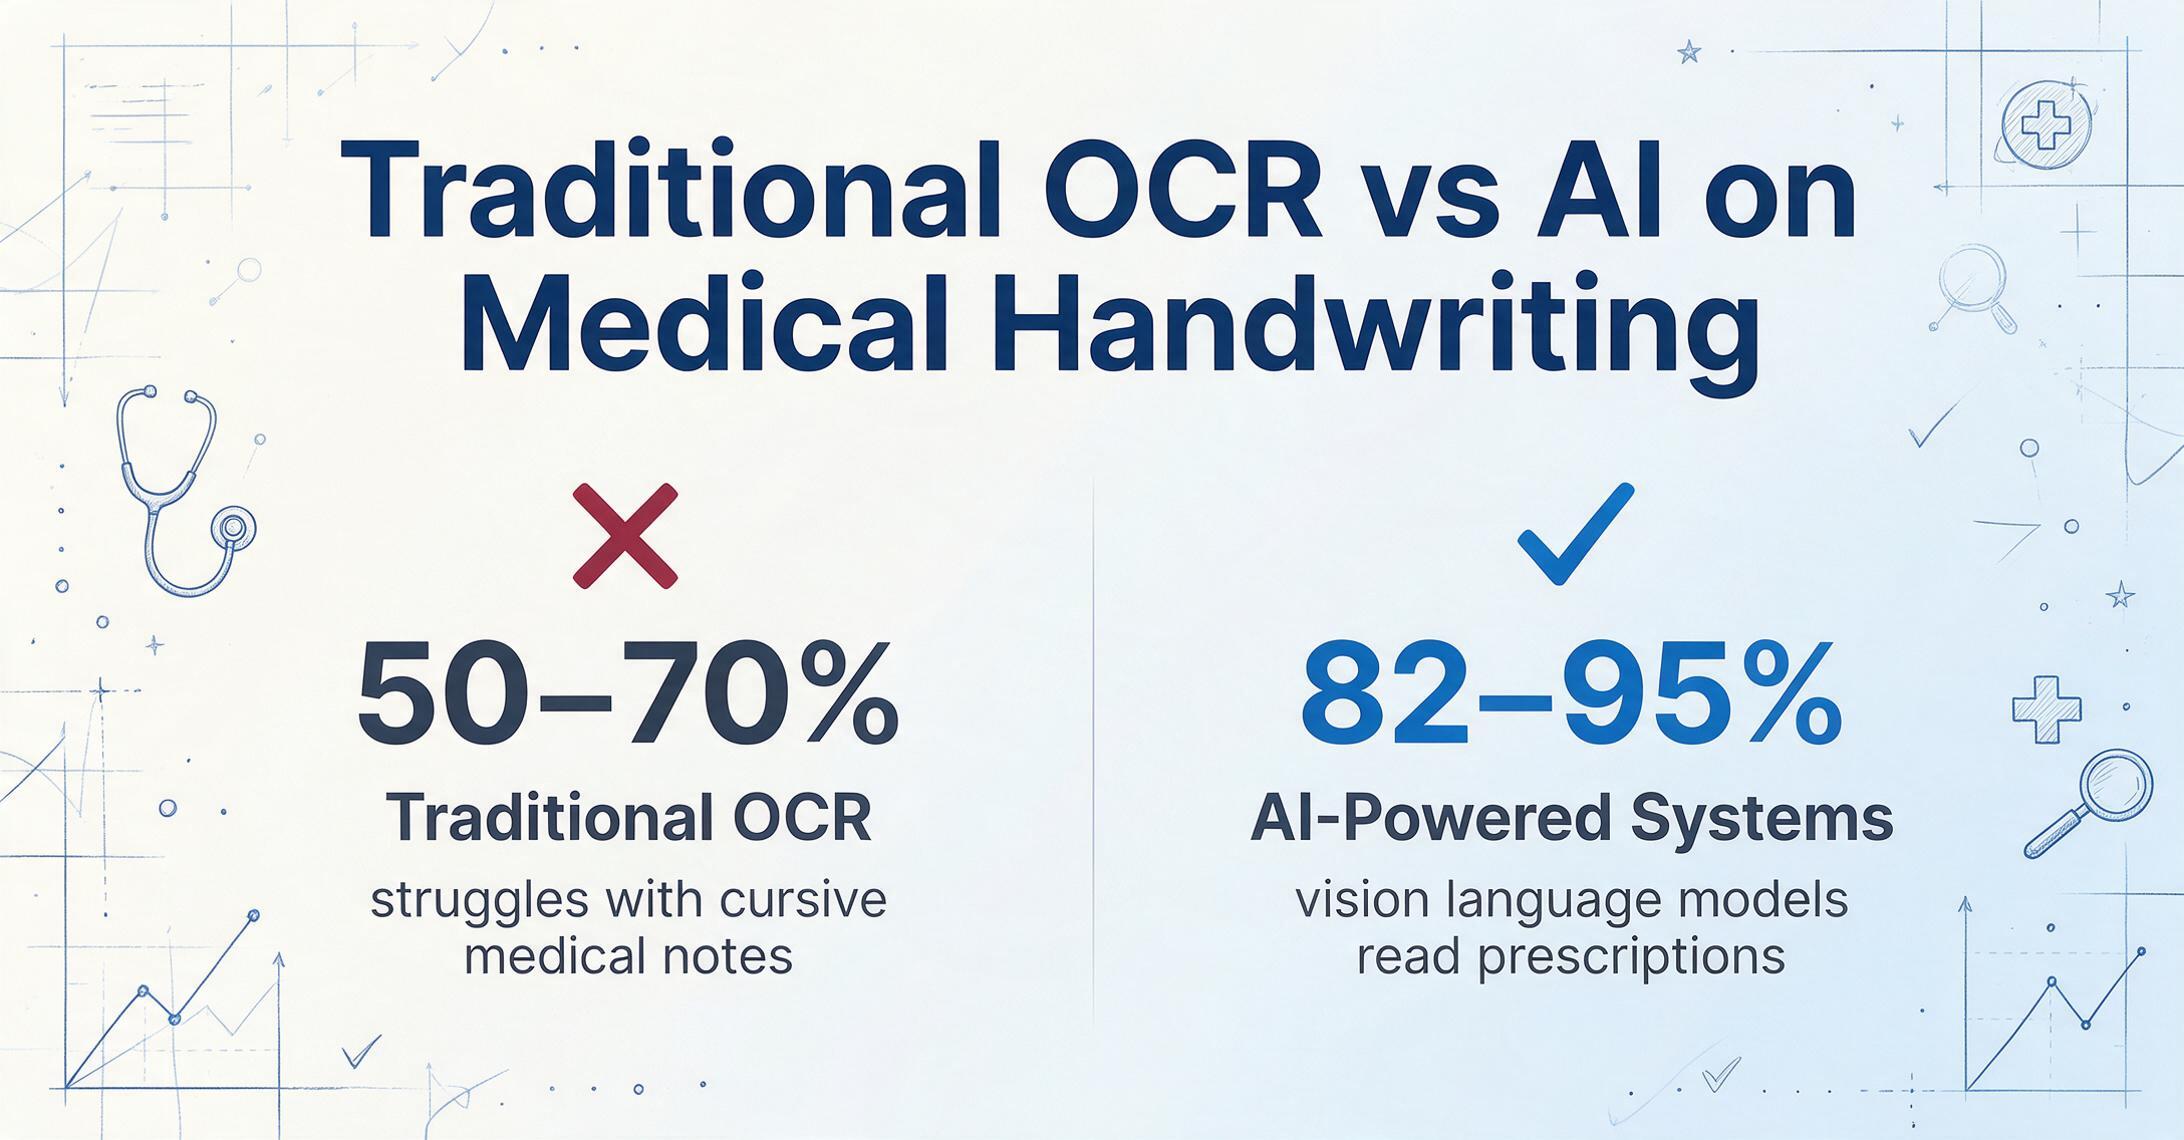
L'écriture des médecins est un goulot d'étranglement notoire dans le traitement des documents de santé. La recherche académique sur l'OCR pour les prescriptions médicales publiée dans l'European Journal of AI and Machine Learning confirme que l'OCR traditionnel atteint environ 50 à 70 % de précision sur l'écriture médicale, tandis que les systèmes basés sur l'IA atteignent 82 à 95 %. Nous avons évalué comment chaque outil gère les notes médicales cursives, les blocs d'ordonnances manuscrits et les annotations des cliniciens dans les marges. Un outil qui ne lit que le texte imprimé couvre peut-être 60 % de la surface réelle des documents de santé.
3. Conformité HIPAA et prise en charge du BAA
HIPAA ne certifie pas de logiciel spécifique. La conformité repose sur une combinaison des mesures de sécurité du fournisseur, de ses politiques et de sa volonté de signer un accord de partenariat commercial (BAA). Le Bureau des droits civiques (OCR) a considérablement renforcé l'application des règles en 2024–2025 : les sanctions financières HIPAA ont augmenté de 340 %, et Advocate Health a payé un règlement de 5,55 millions de dollars après une violation liée à un partenaire commercial qui ne disposait pas d'un BAA approprié. Pour tout outil qui traite des informations de santé protégées (PHI), la signature d'un BAA n'est pas facultative. Nous indiquons où chaque outil propose un BAA et, plus important encore, où il n'en propose pas.
4. Intégration avec les EHR et les systèmes de gestion de cabinet
Les organismes de santé fonctionnent sur des écosystèmes logiciels spécifiques : Epic domine les grands systèmes hospitaliers, Oracle Cerner (désormais Oracle Health) couvre les centres médicaux universitaires, Meditech dessert les hôpitaux communautaires, Athenahealth et eClinicalWorks sont leaders en soins ambulatoires, et Kareo et AdvancedMD servent les petits cabinets. Un outil qui produit des fichiers Excel mais ne peut pas pousser les données dans un flux de travail EHR nécessite une étape manuelle intermédiaire. Nous avons évalué la profondeur d'intégration de chaque outil — des connecteurs EHR natifs aux architectures API-first qu'un développeur peut intégrer dans un pipeline HL7 FHIR.
5. Modèle de déploiement et délai de valeur
Les équipes informatiques de santé sont chroniquement surchargées. Selon les données HIMSS 2025, 86 % des systèmes de santé utilisent une forme d'IA, mais seulement 18 % sont prêts à la déployer dans la prestation de soins. L'écart n'est pas une question de volonté — c'est une question de capacité de mise en œuvre. Nous avons évalué chaque outil sur un spectre allant de « quelques minutes jusqu'à la première extraction » (sans code, basé sur navigateur) à « déploiement d'entreprise de plusieurs mois » (installation sur site, entraînement du modèle, configuration du flux de travail). Le bon choix dépend de la capacité technique de votre équipe et de l'urgence du problème.
Pour un aperçu plus approfondi de la différence entre l'extraction basée sur l'IA et la reconnaissance traditionnelle de caractères dans le traitement de documents, notre guide sur ce qu'est l'OCR IA et comment il fonctionne couvre le changement technologique qui rend possible l'extraction sémantique. Le guide complet sur ce qu'est l'OCR fournit la compréhension de base du fonctionnement de l'OCR traditionnel et de ses limites.
ImageToTable.ai — La meilleure extraction sans code pour divers documents médicaux
Idéal pour : les équipes de santé — administrateurs de cliniques, personnel de facturation médicale, gestionnaires de réclamations d'assurance — qui doivent extraire des données structurées d'une grande variété de documents médicaux sans configurer de modèles ni entraîner de modèles. Pas idéal pour : les organisations qui exigent un accord de partenariat commercial signé pour la conformité HIPAA, une intégration native à l'EHR ou un déploiement sur site.
ImageToTable.ai utilise un modèle de langage vision qui lit les documents de la même manière qu'un humain : il comprend ce que chaque champ signifie, pas où il se trouve sur la page. Cela importe dans le secteur de la santé car les documents médicaux présentent plus de variations de mise en page que presque tout autre secteur. Un rapport de laboratoire d'un système hospitalier place le nom du patient dans le coin supérieur gauche ; un autre le place dans un en-tête centré. Un relevé de prestations de Cigna utilise des tableaux récapitulatifs imbriqués ; celui de UnitedHealthcare utilise des listes plates d'articles. Les outils basés sur des modèles échouent face à ces différences. L'extraction sémantique, non.
Extraction de colonnes personnalisées est le mécanisme central : vous saisissez les noms de colonnes souhaités — « code CPT », « code ICD-10 Dx », « Revenue Code », « nom du patient », « montant facturé » — et l'IA localise chaque valeur en comprenant la signification sémantique du champ. Elle distingue automatiquement un code CPT (identifiant de procédure à cinq chiffres) d'un Revenue Code (code de localisation à quatre chiffres), plaçant chacun dans la colonne de sortie correcte. Cela diffère fondamentalement des outils basés sur des modèles qui déversent tous les codes dans un seul champ « Code », quel que soit le type.
L'outil gère le texte imprimé, l'écriture manuscrite, les cases à cocher, les tableaux et les signatures. Le traitement par lots est de premier ordre : téléchargez 50 relevés de prestations de différents assureurs en un seul lot et obtenez un fichier Excel unifié avec des colonnes cohérentes. Le module complémentaire Google Sheets permet aux utilisateurs de télécharger des documents et d'ajouter les résultats directement dans une feuille de calcul sans quitter Sheets. Le traitement prend 5 à 10 secondes par page — une amélioration de 18 fois par rapport aux 3 minutes moyennes de saisie manuelle. Pour une présentation complète du flux de travail de relevé de prestations vers Excel — de la définition des colonnes à l'exportation du lot fusionné — consultez notre guide sur la conversion des relevés de prestations en Excel.
La tarification commence avec un niveau gratuit (extractions limitées par mois), puis 9 $/mois (Basic) et 59 $/mois (Pro). Aucune configuration requise au-delà de la création d'un compte. Le compromis est significatif pour le secteur de la santé : ImageToTable.ai n'offre pas d'accord de partenariat commercial aujourd'hui, il ne convient donc pas aux flux de travail qui exigent un traitement des informations de santé protégées par un fournisseur conforme à la HIPAA. Il fonctionne bien pour le traitement de documents dépersonnalisés, pour un usage administratif interne où les informations de santé protégées ne sont pas transmises au service, ou comme outil de productivité pour les professionnels de santé individuels qui gèrent leurs propres données.
Amazon Textract — Idéal pour les pipelines de santé à haut volume basés sur AWS
Idéal pour : les organismes de santé déjà investis dans AWS qui traitent de gros volumes de documents standardisés — formulaires d'admission, formulaires de réclamation, cartes d'assurance — et qui disposent d'une capacité DevOps pour créer et maintenir des pipelines d'extraction. Pas idéal pour : les équipes sans expertise en infrastructure AWS ou celles qui ont besoin d'une interface utilisateur clé en main.
Amazon Textract est un service AWS éligible HIPAA (BAA disponible via le BAA AWS standard), ce qui en fait l'une des options les plus simples pour les organismes de santé qui ont besoin d'une infrastructure cloud conforme. Il extrait le texte, l'écriture manuscrite, les formulaires et les tableaux de documents numérisés. Change Healthcare a utilisé Textract pour traiter plus de 16 millions de pages, réduisant le temps de traitement par document de 3 minutes à moins d'une minute et atteignant un taux d'automatisation de 68 %, selon les études de cas clients d'AWS.
Textract s'intègre nativement à AWS HealthLake, Amazon Comprehend Medical (pour la détection de PHI et l'extraction d'entités médicales) et d'autres services AWS, ce qui en fait un élément solide pour l'automatisation personnalisée des soins de santé. Il gère le texte imprimé et l'écriture manuscrite, avec une bonne précision sur les formulaires standardisés. Cependant, Textract est uniquement API — il n'y a pas d'interface graphique pour télécharger des documents et examiner les résultats. La conformité HIPAA nécessite une configuration manuelle de l'environnement AWS (chiffrement, contrôles d'accès, journalisation d'audit) plutôt que d'être par défaut. La tarification est par page et varie selon le volume ; à grande échelle, c'est l'une des options les plus rentables.
Google Document AI — Idéal pour les flux de travail de santé basés sur GCP
Idéal pour : les équipes de santé utilisant Google Cloud qui ont besoin de processeurs pré-entraînés pour les documents médicaux courants, avec des options de révision avec intervention humaine. Pas idéal pour : les équipes en dehors de l'écosystème GCP ou celles qui traitent des types de formulaires personnalisés très variables.
Google Document AI propose des processeurs pré-entraînés pour les factures, les reçus, les W-2 et les documents d'identité, ainsi que la possibilité de former des extracteurs personnalisés via son niveau AutoML. Son intégration avec Vertex AI et Gemini permet la synthèse et le raisonnement sur les données extraites — une capacité utile pour l'extraction de données d'essais cliniques, la synthèse de dossiers médicaux et l'automatisation de l'admission des patients. Google propose un BAA pour les services GCP, ce qui rend Document AI disponible pour les charges de travail éligibles HIPAA.
La force ici réside dans l'écosystème Google plus large : Document AI alimente BigQuery pour l'analyse, Healthcare API pour l'échange de données natives FHIR, et Vertex AI pour le développement de modèles personnalisés. La limite est que les processeurs pré-entraînés ne couvrent qu'un ensemble fixe de types de documents ; pour des formulaires médicaux très spécifiques (une mise en page unique de rapport de laboratoire d'un système hospitalier régional), une formation personnalisée est requise. La tarification combine le traitement OCR avec les fonctionnalités GenAI, ce qui peut devenir complexe à grande échelle pour les pipelines d'extraction en plusieurs étapes.
Azure Document Intelligence — Idéal pour les systèmes de santé centrés sur Microsoft
Idéal pour : les organismes de santé utilisant l'infrastructure Microsoft (Active Directory, Office 365, Dynamics 365) qui ont besoin d'un traitement de documents éligible HIPAA avec de solides contrôles de gouvernance. Pas idéal pour : les équipes sans expérience d'Azure ou celles qui ont besoin d'une interface d'extraction sans code.
Azure Document Intelligence (anciennement Form Recognizer) fournit des modèles prédéfinis pour les types de documents courants et des capacités d'extraction personnalisées via Azure AI. Il est couvert par l'accord de partenariat commercial Microsoft pour la conformité HIPAA lorsqu'il est configuré correctement, et s'intègre aux frameworks de contrôle d'accès basé sur les rôles, de journalisation d'audit et de chiffrement d'Azure — des atouts naturels pour les organisations qui gèrent déjà des informations de santé protégées dans le périmètre de conformité de Microsoft.
Azure DI gère le texte imprimé, l'écriture manuscrite, les tableaux et les paires clé-valeur. Ses modèles prédéfinis couvrent les factures, les reçus, les pièces d'identité et les cartes d'assurance maladie. Pour les documents spécifiques au secteur de la santé comme les rapports de laboratoire ou les relevés de prestations, une formation de modèle personnalisée est généralement requise. La plateforme prend en charge .NET, Python et les API REST, ce qui la rend accessible aux équipes de développement centrées sur Microsoft. La tarification suit un modèle de paiement par page avec des remises sur volume.
Visiter Azure Document Intelligence →
ABBYY Vantage — Meilleur IDP d'entreprise pour la santé réglementée
Idéal pour : les grands systèmes de santé et les payeurs d'assurance qui ont besoin d'une plateforme de traitement de documents mature et low-code avec des compétences pré-entraînées et des fonctionnalités de conformité complètes. Pas idéal pour : les petits cabinets ou les équipes qui ont besoin d'une extraction rapide sans modèle et sans cycle de déploiement.
ABBYY est l'un des leaders historiques de l'OCR et du traitement intelligent de documents, avec une plateforme utilisée dans les secteurs réglementés, y compris la santé. ABBYY Vantage propose des « compétences » pré-entraînées (modèles d'extraction pour des types de documents spécifiques), un créateur de compétences low-code pour les formulaires personnalisés, et des connecteurs d'intégration pour les systèmes ECM et les plateformes ERP. Il prend en charge la reconnaissance de l'écriture manuscrite, bien que la précision sur les notes médicales cursives denses soit modérée par rapport aux outils natifs IA plus récents.
ABBYY propose un accord de partenariat commercial et possède une expérience significative des déploiements dans le secteur de la santé. Sa force réside dans son ampleur : il peut couvrir les factures, les réclamations, les formulaires patients, les documents d'essais cliniques et la correspondance des prestataires au sein d'une seule plateforme. Le compromis est que le déploiement prend généralement des semaines à des mois, la tarification est personnalisée et de niveau entreprise (cinq chiffres par an et plus), et la plateforme exige un effort administratif dédié pour maintenir les compétences d'extraction à mesure que les formats de documents évoluent. Pour les grandes organisations disposant d'une équipe dédiée au traitement de documents, ABBYY Vantage est un choix éprouvé.
Nanonets — Le meilleur pour les modèles médicaux spécialisés entraînés sur mesure
Idéal pour : les organisations qui traitent un volume élevé d'un type de document médical spécifique et stable et qui disposent des ressources nécessaires pour entraîner et maintenir un modèle dédié. Pas idéal pour : les équipes qui ont besoin d'une extraction sans configuration préalable sur de nombreux formats de documents différents.
Nanonets propose une plateforme d'OCR IA avec plus de 300 modèles pré-entraînés couvrant des catégories de documents telles que les formulaires de santé, les documents d'assurance et les dossiers médicaux. Sa principale différence réside dans le pipeline d'entraînement : les utilisateurs téléchargent des documents échantillons (généralement 20 à 50 par format), étiquettent les champs, et la plateforme entraîne un modèle d'extraction personnalisé. Pour un système hospitalier qui traite le même format de rapport de laboratoire provenant de 50 cliniques affiliées, cela peut offrir une grande précision. Nanonets propose un accord de partenariat commercial (BAA) pour les clients entreprises et prend en charge le déploiement cloud et sur site.
La limite est que chaque nouveau format de document nécessite un nouveau cycle d'entraînement. Une clinique qui reçoit des rapports de laboratoire de cinq systèmes hospitaliers différents a besoin de cinq ensembles d'entraînement étiquetés. Une équipe de facturation médicale qui traite des relevés de prestations (EOB) de 20 régimes d'assurance différents a besoin de 20 itérations d'entraînement. Pour les formats stables et à volume élevé, l'investissement initial porte ses fruits. Pour des mélanges de documents divers et variables, le coût de maintenance de l'entraînement s'accumule. La tarification commence par un niveau gratuit (pages limitées) et évolue vers des plans d'entreprise personnalisés.
LlamaParse (LlamaIndex) — Le meilleur pour les produits d'IA de santé pilotés par les développeurs
Idéal pour : les équipes d'ingénierie qui créent des applications de santé agentiques — assistants cliniques, pipelines automatisés de codage médical, outils de synthèse de recherche — qui nécessitent une compréhension approfondie des documents avec des scores de confiance au niveau des champs et des citations de sources. Pas idéal pour : les équipes de santé non techniques qui ont besoin d'une interface graphique pour le traitement des documents.
LlamaParse adopte une approche agentique du traitement des documents : au lieu de modèles rigides ou d'une extraction basée sur la mise en page, il utilise l'IA multimodale pour comprendre la structure des documents, les tableaux, l'écriture manuscrite et les graphiques, puis extrait des données structurées avec des scores de confiance au niveau des champs. Il s'intègre à l'écosystème plus large de LlamaIndex pour les pipelines RAG, ce qui en fait un choix idéal pour les organisations qui créent des produits d'IA conscients des documents sur leurs propres données médicales.
La plateforme prend en charge l'extraction basée sur un schéma (LlamaExtract), où vous définissez les champs dont vous avez besoin (MRN, codes ICD-10, noms de médicaments, valeurs de laboratoire, posologies) et l'IA les extrait avec des citations au niveau de la page pour l'auditabilité. LlamaIndex propose un accord de partenariat commercial (BAA) pour les clients entreprises et prend en charge le déploiement cloud et auto-hébergé. Le compromis est qu'il est axé sur l'API et basé sur SDK (Python + TypeScript), sans interface no-code. La tarification commence par un niveau gratuit pour l'évaluation et évolue vers des devis personnalisés pour les entreprises.
Docsumo — Idéal pour le traitement administratif des assurances santé et des réclamations
Idéal pour : les assureurs santé, les tiers administrateurs (TPA) et les équipes de facturation médicale en back-office qui traitent de gros volumes de formulaires structurés, de documents de réclamation et de paperasse d'assurance. Pas idéal pour : l'extraction de documents cliniques à partir de notes manuscrites de médecins ou de rapports de laboratoire complexes.
Docsumo est une plateforme polyvalente de traitement intelligent de documents qui excelle sur les documents structurés et semi-structurés courants dans l'administration de la santé : formulaires de réclamation, relevés de prestations, documents de vérification d'éligibilité et demandes d'assurance. Elle propose des modèles pré-entraînés pour les types de documents courants, des règles de validation intégrées et une intégration aux flux de travail via API et webhooks. Un accord de partenariat commercial est disponible pour les clients du secteur de la santé.
Les points forts de Docsumo se situent du côté administratif de la santé — pour un assureur santé traitant 10 000 formulaires de réclamation par mois avec des mises en page stables, elle offre un traitement direct fiable. Sa reconnaissance de l'écriture manuscrite est limitée par rapport aux outils natifs IA, elle n'est donc pas le bon choix pour les ordonnances manuscrites ou les notes cliniques. Les tarifs sont personnalisés et basés sur le volume de documents.
Hyland OnBase — Meilleure gestion documentaire d'entreprise avec capture pour la santé
Idéal pour : les grands systèmes de santé qui ont besoin d'une plateforme unifiée de services de contenu d'entreprise combinant gestion documentaire, capture, flux de travail et conformité — avec l'OCR comme composant d'une infrastructure plus large. Pas idéal pour : les équipes qui ont besoin d'un outil autonome d'extraction de documents sans un déploiement ECM majeur.
Hyland OnBase est une plateforme mature de services de contenu d'entreprise avec une forte pénétration dans le secteur de la santé. Elle fournit la capture de documents, l'indexation, le stockage, l'automatisation des flux de travail et la gestion des demandes de divulgation — le tout dans un cadre conforme à la HIPAA avec un accord de partenariat commercial. Son module de capture utilise l'OCR pour classer et extraire les données des documents numérisés, les acheminant vers les flux de travail cliniques ou administratifs appropriés.
OnBase est utilisé par des centaines d'hôpitaux pour numériser et indexer les dossiers patients, les relevés de prestations et les documents administratifs. Les utilisateurs de Reddit sur r/healthIT décrivent l'utilisation d'« onbase pour indexer les numérisations / télécopies en masse dans le dossier » dans le cadre d'un flux de travail manuel mais flexible. Le compromis est qu'OnBase est une plateforme d'entreprise massive : le déploiement prend des mois, les coûts sont personnalisés et généralement à six chiffres, et la reconnaissance de l'écriture manuscrite est basique. C'est un investissement dans la gestion de contenu avec des capacités d'extraction, pas un outil axé sur l'extraction.
Kofax — Meilleure capture de documents d'entreprise à grande échelle
Idéal pour : les grands organismes de santé et les externalisateurs de processus métier qui traitent des millions de pages par mois via des flux de capture automatisés avec validation et classification. Pas idéal pour : les petites cliniques, les praticiens individuels ou toute équipe ayant besoin d'un outil d'extraction léger.
Kofax (faisant partie de Tungsten Automation) propose une capture intelligente de documents d'entreprise avec classification, extraction et validation basées sur l'IA. Sa plateforme numérise, classe, extrait les données et achemine les documents dans les flux de travail de la santé — de la numérisation à l'admission des patients au traitement des EOB dans le service du cycle de revenus. Kofax propose un BAA et possède une expérience significative dans le secteur de la santé.
La force de la plateforme réside dans la capture automatisée à haut volume : numérisation de 50 000 pages par jour, classification automatique des types de documents, extraction des champs clés et validation par rapport aux règles métier avant l'acheminement vers les systèmes en aval. Le compromis est la complexité : les déploiements Kofax nécessitent généralement des services professionnels, des mois de configuration et des dépenses d'investissement importantes. La reconnaissance de l'écriture manuscrite est limitée. Pour les organisations en dessous de l'échelle entreprise, c'est excessif.
Koncile — Meilleure OCR santé API-first pour ordonnances et documents médicaux
Idéal pour : les entreprises de technologie de la santé et les plateformes de santé numérique qui ont besoin d'un service OCR API-first avec de bonnes performances sur les ordonnances et le traitement de documents médicaux conformes au RGPD en français. Pas idéal pour : les équipes axées sur les États-Unis qui ont besoin d'une extraction sans code ou d'intégrations EHR approfondies avec Epic/Cerner.
Koncile est une plateforme OCR IA spécialisée dans la santé, conçue principalement pour le marché européen, avec de bonnes performances sur les ordonnances, les rapports médicaux et les documents cliniques. Elle propose des modèles d'extraction santé prêts à l'emploi et une architecture API-first qui la rend adaptée à l'intégration dans les produits de santé numérique et les plateformes d'automatisation de pharmacie. Koncile fournit un équivalent BAA dans le cadre du RGPD et héberge les données sur des serveurs français.
Sa reconnaissance de l'écriture manuscrite est plus performante que les outils OCR généralistes grâce à un entraînement spécialisé sur des échantillons d'écriture médicale, y compris les annotations d'ordonnances. Le compromis est géographique : l'entraînement documentaire de Koncile est le plus performant sur les formats médicaux européens, et son écosystème d'intégration n'inclut pas les systèmes EHR spécifiques aux États-Unis. Les prix sont sur devis personnalisé et basés sur le volume.
Tesseract — Meilleure base OCR open-source gratuite
Idéal pour : les développeurs qui créent des pipelines personnalisés de traitement de documents de santé et qui ont besoin d'un moteur OCR gratuit et auto-hébergé pour l'extraction de texte imprimé comme point de départ. Pas idéal pour : tout flux de travail de santé impliquant l'écriture manuscrite, des mises en page complexes, l'extraction de données structurées ou le traitement direct de PHI sans renforcement supplémentaire de la sécurité.
Tesseract est le moteur OCR open-source le plus utilisé, maintenu par Google depuis 2006. La version 5 (sortie en 2024) a ajouté la reconnaissance par réseau neuronal basé sur LSTM, améliorant la précision sur les textes imprimés propres. Il prend en charge plus de 100 langues et peut être personnalisé et étendu pour des types de documents spécifiques.
Pour la santé, la valeur de Tesseract se limite aux textes imprimés sur des documents propres et à contraste élevé. Il a une capacité minimale en écriture manuscrite — la recherche académique confirme que Tesseract atteint environ 64 % de précision sur l'écriture manuscrite médicale — et aucune extraction de données structurées. Un code ICD-10 extrait par Tesseract atterrit dans un bloc de texte plat sans étiquette de champ, nécessitant un traitement supplémentaire pour identifier et router chaque code. Tesseract n'a pas de BAA, pas de journalisation d'audit et aucune infrastructure de gestion de PHI par défaut ; toute utilisation conforme à la HIPAA exige que l'organisation qui le déploie construise des contrôles de sécurité autour de lui. C'est un composant utile dans un pipeline personnalisé, pas une solution OCR autonome pour la santé.
Quel outil convient à votre organisation de santé ?
Un seul outil ne convient pas à tous les besoins OCR en santé, car la santé n'est pas un flux de travail unique — c'est un ensemble de problèmes de traitement de documents radicalement différents qui partagent un cadre réglementaire. Voici comment faire correspondre votre situation à la bonne catégorie d'outil.
Vous gérez une petite clinique ou un cabinet solo
Vous traitez des formulaires d'admission de patients, des cartes d'assurance et un volume modeste de relevés de prestations. Vous n'avez pas d'équipe informatique et avez besoin de quelque chose qui fonctionne en quelques minutes. ImageToTable.ai est l'option la plus pratique pour transformer des formulaires numérisés en données structurées sans configuration. Pour un traitement conforme à la HIPAA de PHI via le cloud, Google Document AI ou Azure Document Intelligence avec un accord de partenariat commercial sont viables si vous avez la capacité administrative de configurer le compte cloud. Pour une option entièrement gratuite mais limitée, Tesseract via une interface graphique peut gérer les textes imprimés sur des documents propres — mais attendez-vous à vérifier chaque sortie.
Vous dirigez un groupe médical de taille moyenne ou un réseau de soins ambulatoires
Vous utilisez un EHR comme Athenahealth, eClinicalWorks ou Kareo. Votre volume de documents est de plusieurs milliers par mois — relevés de prestations, lettres d'orientation, rapports de laboratoire provenant de plusieurs laboratoires. Vous avez besoin de flexibilité entre les formats, mais vous n'avez peut-être pas d'équipe dédiée à l'ingénierie des données. ImageToTable.ai gère bien la diversité des formats et ne nécessite aucune configuration de modèle. Si votre organisation exige une protection BAA, Docsumo pour les documents administratifs ou Nanonets pour les documents à volume élevé et au format stable sont appropriés. Google Document AI avec son API Healthcare peut faire le pont vers FHIR si vous disposez des ressources techniques.
Vous travaillez dans un grand système de santé ou un réseau hospitalier
Vous utilisez Epic, Oracle Cerner ou Meditech. Vous traitez des millions de pages par an — dossiers patients, demandes d'assurance, documents d'essais cliniques, correspondance avec les prestataires. Vous disposez d'un service informatique et d'un bureau de conformité. Hyland OnBase ou Kofax sont les choix d'entreprise établis pour la capture et la gestion de contenu, avec une intégration éprouvée dans les flux de travail des grands hôpitaux. ABBYY Vantage offre une alternative davantage axée sur l'extraction avec la création de compétences low-code. Amazon Textract intégré à un pipeline AWS HealthLake FHIR est l'option cloud-native la plus évolutive pour les organisations disposant d'une capacité DevOps.
Vous travaillez pour un assureur santé ou un TPA
Votre besoin principal en OCR est le traitement des demandes — CMS-1500, UB-04, données de rencontre et relevés de prestations — à volume élevé avec des formats cohérents. Docsumo et Nanonets disposent tous deux d'un traitement de formulaires solide pour les documents d'assurance. Amazon Textract sur l'infrastructure santé AWS peut gérer un débit très élevé avec une prévisibilité des coûts. ABBYY Vantage couvre l'ensemble du cycle de vie des demandes, de la réception au soutien à l'adjudication.
Vous développez un produit technologique pour le secteur de la santé
Votre besoin en OCR est intégré à votre propre application — un assistant clinique, un outil d'automatisation du codage médical, un produit de données de santé destiné aux patients. LlamaParse offre la boîte à outils de développement la plus avancée avec une extraction guidée par schéma et des scores de confiance au niveau des champs. Amazon Textract est une API éprouvée pour les volumes élevés. Azure Document Intelligence s'intègre bien avec les piles .NET. Koncile est une option spécialisée pour les cas d'usage européens dans le secteur de la santé, conforme au RGPD.
Pour une vue plus large du paysage OCR, incluant les options gratuites et les alternatives open source, consultez notre guide des meilleurs logiciels OCR gratuits et notre comparatif des meilleurs outils OCR open source. Si les documents médicaux manuscrits sont votre principal défi — et c'est le cas pour de nombreuses équipes de santé — notre tour d'horizon de l'OCR pour l'écriture manuscrite approfondit cette capacité spécifique. Pour une vue d'ensemble incluant les outils d'entreprise non couverts ici, les meilleurs logiciels OCR 2026 cartographient l'ensemble du paysage.
Questions fréquentes
Qu'est-ce qui rend un outil OCR conforme à la HIPAA ?
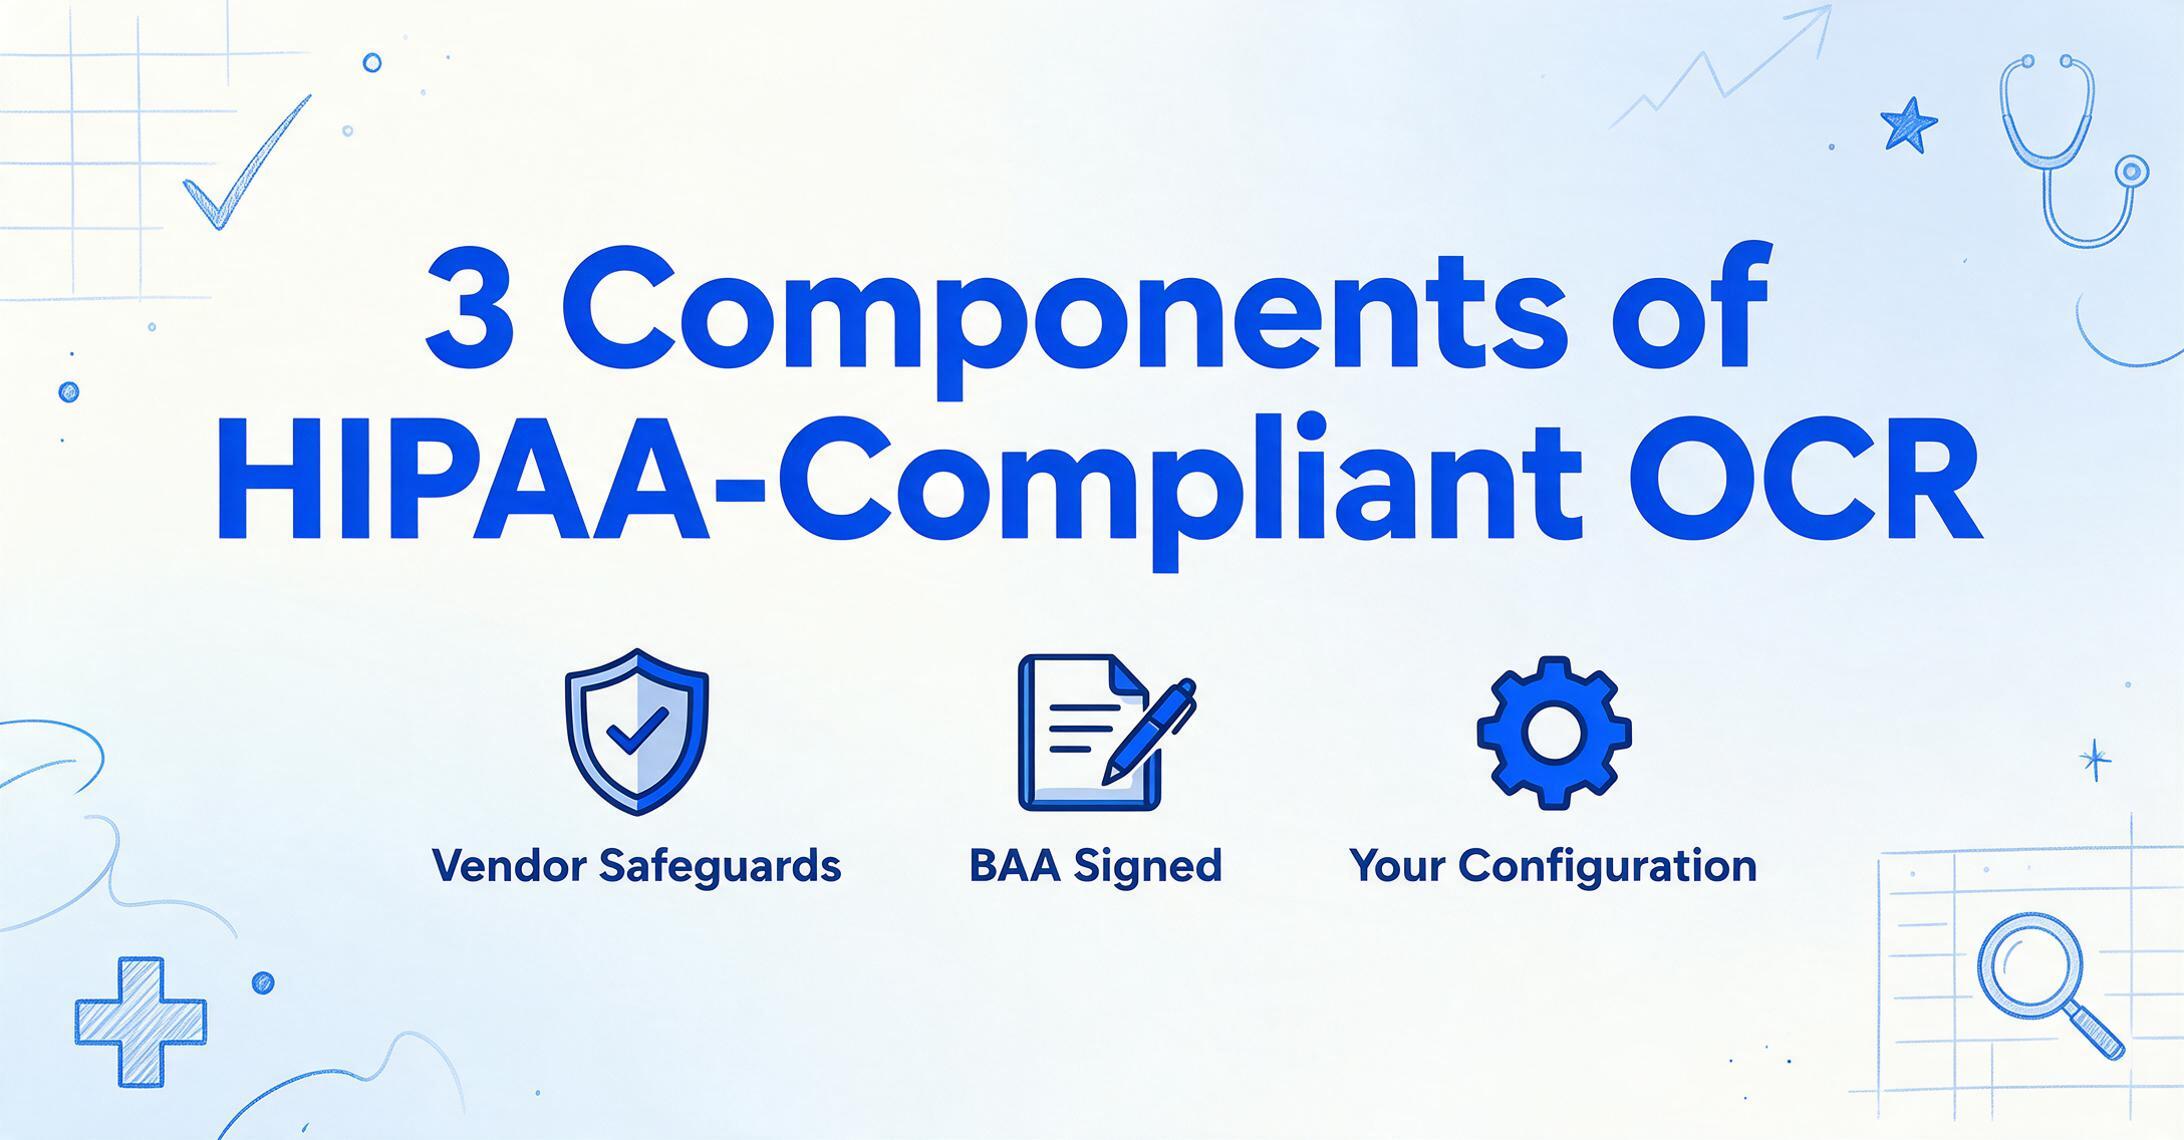
La conformité HIPAA d'un logiciel OCR repose sur trois composants qui fonctionnent ensemble. Premièrement, le fournisseur doit maintenir de solides protections de sécurité — chiffrement au repos et en transit, contrôles d'accès basés sur les rôles, journalisation complète des audits et politiques claires de gestion des informations de santé protégées. Deuxièmement, le fournisseur doit signer un accord de partenariat commercial qui le lie contractuellement aux exigences de la règle de confidentialité et de sécurité de la HIPAA pour toute information de santé protégée qu'il traite en votre nom. Troisièmement, votre organisation doit configurer et utiliser l'outil dans le cadre de son propre programme de conformité HIPAA — un accord de partenariat commercial ne rend pas votre flux de travail conforme si vous configurez l'outil pour stocker les informations de santé protégées dans un emplacement non chiffré ou si vous accordez l'accès à des utilisateurs non autorisés. Le Bureau des droits civiques a clairement indiqué, par le biais d'actions coercitives — y compris le règlement de 5,55 millions de dollars avec Advocate Health — que l'accord avec le fournisseur et les contrôles opérationnels doivent être en place.
L'OCR peut-il lire avec précision l'écriture des médecins ?
C'est la question la plus fréquente en matière d'OCR dans le domaine de la santé, et la réponse honnête est : cela dépend de l'écriture et de l'outil. L'OCR traditionnel atteint environ 50 à 70 % de précision sur les textes médicaux manuscrits. Les outils modernes basés sur l'IA, y compris les modèles de vision-langage, atteignent 82 à 95 % sur l'écriture médicale — une amélioration significative, mais toujours inférieure à la précision des textes imprimés. Les meilleurs résultats proviennent d'outils spécifiquement entraînés sur des échantillons d'écriture médicale ou construits sur des modèles de vision-langage qui comprennent le contexte sémantique (une chaîne de cinq caractères après « Dx : » est probablement un code de diagnostic, même si un caractère est ambigu). Aucun outil OCR n'atteint 99 % sur l'écriture manuscrite. Pour les données cliniques critiques — noms de médicaments, posologies, codes de diagnostic — prévoyez toujours du temps pour une vérification humaine par rapport au document original. Notre tour d'horizon de l'OCR pour l'écriture manuscrite couvre ce sujet en profondeur.
L'OCR peut-il extraire les codes CPT et les codes ICD-10 des documents médicaux ?
Oui, mais la qualité de l'extraction dépend de la capacité de l'outil à comprendre la structure des codes ou à simplement lire le texte brut. Les outils basés sur l'IA qui utilisent l'extraction sémantique peuvent distinguer les types de codes : les codes CPT sont des identifiants numériques à cinq chiffres (99213, 93000), les codes ICD-10 sont des chaînes alphanumériques (E11.9, I10), les Revenue Codes sont des identifiants de localisation à quatre chiffres (0450 pour les urgences), et les codes de médicaments NDC sont des identifiants à 11 chiffres. Un outil qui attribue chaque type de code à la bonne colonne de sortie est bien plus utile pour la facturation médicale et le traitement des demandes de remboursement en aval qu'un outil qui déverse tous les codes dans un seul champ de texte. Définissez des colonnes pour chaque type de code séparément — « CPT Code », « ICD-10 Dx », « Revenue Code », « NDC » — et laissez l'outil les router par type sémantique.
L'OCR s'intègre-t-il avec Epic, Cerner ou Meditech ?
L'intégration directe avec l'EHR est l'exception, pas la règle, parmi les outils OCR. La plupart des outils produisent des données structurées sous forme Excel, CSV ou JSON, qui doivent ensuite être importées dans l'EHR via une interface séparée ou une couche API. Les plateformes d'entreprise comme Hyland OnBase et Kofax disposent de connecteurs préconstruits vers les principaux systèmes EHR, car elles fonctionnent comme des plateformes de gestion de contenu qui s'articulent autour du dossier clinique. Les outils API cloud comme Amazon Textract s'intègrent à l'API FHIR d'AWS HealthLake, qui peut ensuite se connecter à un EHR. Pour la plupart des outils OCR sans code, le flux de travail est le suivant : extraire les données dans une feuille de calcul → valider → télécharger ou importer dans l'EHR. Cette étape intermédiaire n'est pas idéale, mais c'est la réalité pratique pour la plupart des organismes de santé.
Existe-t-il un outil OCR gratuit pour les documents de santé ?
Tesseract est gratuit et open-source, mais ses limites pratiques pour le secteur de la santé sont importantes : prise en charge minimale de l'écriture manuscrite, aucune extraction de données structurées, aucune infrastructure de sécurité PHI, et une interface réservée aux développeurs. L'OCR intégré de Google Drive est gratuit et peut produire des PDF consultables à partir de documents médicaux numérisés, mais il génère du texte brut — pas des données structurées avec des étiquettes de champs. ImageToTable.ai propose une offre gratuite pour des extractions limitées, utile pour tester si l'extraction sémantique fonctionne sur vos documents spécifiques avant de vous engager dans un plan payant. Pour une comparaison complète des options gratuites, consultez notre guide des meilleurs outils OCR gratuits.
L'OCR peut-il gérer les tableaux imbriqués des relevés de prestations ?
Les tableaux imbriqués des EOB sont l'un des types de documents les plus difficiles pour l'OCR traditionnel, car une seule cellule de tableau peut contenir à la fois un montant en dollars et une explication codée, avec des sous-lignes en retrait sous les lignes parentes. Les outils basés sur des modèles aplatissent généralement ces éléments en un seul bloc de texte par ligne, perdant ainsi la hiérarchie. Les outils basés sur l'IA avec compréhension de la mise en page obtiennent des résultats nettement meilleurs car ils peuvent identifier la relation parent-enfant entre une charge principale et ses ajustements. La clé est de définir des colonnes qui correspondent à la structure de l'EOB : « Billed Amount », « Allowed Amount », « Insurance Payment », « Patient Responsibility », « Adjustment Code » — et de laisser l'IA mapper chaque valeur en comprenant où elle se situe dans la hiérarchie logique du document, plutôt qu'en lisant une coordonnée de grille fixe. Pour un aperçu plus approfondi de la façon dont les outils d'extraction gèrent les EOB multi-payeurs et les formats de réclamation, consultez notre tour d'horizon des outils d'extraction de documents de santé ; pour les mécanismes OCR sous-jacents à travers les types de documents médicaux, notre guide OCR pour la santé couvre l'ensemble du spectre documentaire.
Qu'en est-il du traitement des ordonnances manuscrites ?
Les ordonnances manuscrites représentent un défi OCR unique, car les conséquences d'une erreur de lecture sont cliniques, pas seulement administratives. Une dose ou un nom de médicament mal lu peut directement affecter la sécurité du patient. Les études académiques sur l'OCR pour le traitement des ordonnances montrent que l'OCR traditionnel atteint environ 50 à 70 % de précision sur l'écriture manuscrite des ordonnances, tandis que les systèmes d'IA formés sur des échantillons médicaux atteignent 82 à 95 %. L'approche la plus pratique pour les pharmacies et les processeurs d'ordonnances est d'utiliser un outil basé sur l'IA capable de lire l'écriture manuscrite de manière contextuelle (en comprenant que « Metf » est probablement « Metformin »), combiné à une étape de vérification par un pharmacien pour chaque ordonnance. Aucun outil OCR ne devrait être le seul contrôle dans un flux de traitement des ordonnances — le risque clinique est trop élevé.
Combien de temps faut-il pour déployer l'OCR dans un environnement de santé ?
Le délai de déploiement varie considérablement selon la catégorie d'outil. Outils sans code comme ImageToTable.ai : quelques minutes pour une première extraction. API cloud comme Amazon Textract, Google Document AI ou Azure Document Intelligence : de quelques heures à quelques jours pour l'intégration API, plus du temps pour configurer une infrastructure conforme HIPAA. Plateformes basées sur l'apprentissage comme Nanonets : de quelques jours à quelques semaines, selon le nombre de formats de documents nécessitant des échantillons étiquetés et le nombre d'itérations du pipeline d'apprentissage. Plateformes d'entreprise comme ABBYY Vantage, Hyland OnBase ou Kofax : plusieurs mois, incluant services professionnels, configuration des workflows, développement d'intégration et validation de conformité. Selon les données HIMSS 2025, seulement 18 % des systèmes de santé se déclarent prêts à déployer des outils d'IA dans la prestation de soins — l'écart n'est pas la disponibilité technologique, mais la capacité de mise en œuvre. Choisissez un outil dont le délai de déploiement correspond à la capacité d'absorption de votre organisation.
L'Essentiel
Le traitement des documents de santé en 2026 se résume à deux écarts. L'écart technologique — ce que les outils d'IA peuvent réellement faire par rapport à ce que les équipes soignantes croient possible — se réduit rapidement. Les modèles de langage visuel peuvent désormais lire l'écriture médicale manuscrite, distinguer les codes CPT des codes ICD-10 par leur structure, et extraire des données de tableaux EOB imbriqués sans modèles. L'écart de mise en œuvre — le fossé entre ce qui est techniquement possible et ce que les organisations de santé ont la capacité de déployer — reste la contrainte majeure.
Le bon outil OCR pour votre organisation de santé est celui dont le modèle de déploiement correspond à la capacité technique de votre équipe et dont l'approche d'extraction correspond à la diversité de vos documents. Si vos documents sont standardisés et votre volume élevé, une plateforme basée sur l'apprentissage ou d'entreprise offrira une précision prévisible. Si vos documents varient d'une heure à l'autre — différents assureurs, laboratoires, cliniques — une approche sémantique sans modèle vous évite de maintenir des configurations d'extraction pour chaque variation de format. Et si vous traitez des données cliniques manuscrites — ordonnances, notes de médecins, rapports de laboratoire annotés — faites de la capacité de reconnaissance manuscrite un critère d'évaluation non négociable, pas une option.
Commencez par tester un outil sur les documents que votre équipe traite réellement — pas les documents parfaits, les désordonnés. L'outil qui rend vos documents réels extractibles est celui que vous devez utiliser.