Beste OCR-Software für das Gesundheitswesen 2026:
12 Tools für medizinische Dokumente getestet
Dieser Leitfaden bewertet 12 OCR- und KI-gestützte Dokumentextraktionstools anhand von fünf Kriterien, die speziell für Gesundheitsteams relevant sind: Genauigkeit bei medizinischer Terminologie und Kodierungssystemen, Handschrifterkennung für klinische Notizen und Rezepte, HIPAA-Compliance-Bereitschaft, EHR- und Praxisverwaltungsintegration sowie die ehrliche Eignung jedes Tools für unterschiedliche Größen und technische Fähigkeiten von Gesundheitsorganisationen. Alle Preisangaben stammen von der öffentlichen Seite des jeweiligen Anbieters, Stand Juni 2026. Offenlegung: ImageToTable.ai ist in diesem Roundup enthalten. Ich habe keine Verbindung zu anderen gelisteten Tools. Jeder externe Link führt zur Website des Anbieters, damit Sie Behauptungen unabhängig prüfen können.
Wichtigste Erkenntnisse
- Jedes OCR-Tool für das Gesundheitswesen auf dieser Liste behauptet 95 % Genauigkeit – aber dieser Benchmark wurde mit sauber getippten Rechnungen getestet, während Ihr tatsächlicher täglicher Stapel Leistungserklärungen mit verschachtelten Übersichtstabellen und Rezepte in Schreibschrift umfasst, die von einem Arzt geschrieben wurden, der zu spät zur Visite kam.
- Das eine Merkmal, das entscheidet, ob OCR Ihnen Zeit spart oder verschwendet, ist die Unterscheidung von Codetypen, denn ein Tool, das CPT-Prozedurencodes und ICD-10-Diagnosecodes in einer einzigen Code-Spalte zusammenfasst, erzeugt einen manuellen Neusortierungsschritt, der jede Sekunde zunichtemacht, die die Extraktion Ihnen gespart hat.
- Überspringen Sie den Genauigkeitsvergleich und fragen Sie stattdessen, ob das Tool eine BAA für Ihren HIPAA-Workload unterzeichnet und die Handschrift lesen kann, die Ihre Ärzte um 23 Uhr in einer vollen Klinik tatsächlich produzieren.
Schnellvergleichstabelle
| Tool | Am besten geeignet für | Handschrift | BAA verfügbar | Einrichtung | Startpreis |
|---|---|---|---|---|---|
| ImageToTable.ai | Codefreie Extraktion für diverse medizinische Dokumente | ✅ Stark | ❌ | Minuten | Kostenlos / 9 $/Monat |
| Amazon Textract | Hochvolumige AWS-native Pipelines | ✅ Gut | ✅ | Stunden–Tage | Pro Seite |
| Google Document AI | GCP-basierte Healthcare-Parser | ✅ Gut | ✅ | Stunden–Tage | Pro Seite |
| Azure Document Intelligence | Microsoft-zentrierte Gesundheitssysteme | ✅ Gut | ✅ | Stunden–Tage | Pro Seite |
| ABBYY Vantage | Enterprise-IDP mit Low-Code-Fähigkeiten | ✅ Mittel | ✅ | Wochen | Individuelles Angebot |
| Nanonets | Individuell trainierte Modelle für Nischenformate | ✅ Mittel | ✅ | Tage–Wochen | Kostenlos / individuell |
| LlamaParse (LlamaIndex) | Entwicklergeführte Healthcare-KI-Produkte | ✅ Stark | Enterprise | Stunden | Kostenlos / individuell |
| Docsumo | Verarbeitung von Verwaltungs- und Versicherungsdokumenten | ⚠️ Eingeschränkt | ✅ | Tage | Individuelles Angebot |
| Hyland OnBase | Enterprise-DMS mit Erfassung | ⚠️ Eingeschränkt | ✅ | Monate | Individuelles Angebot |
| Kofax | Enterprise-Dokumentenerfassung im großen Maßstab | ⚠️ Eingeschränkt | ✅ | Monate | Individuelles Angebot |
| Koncile | API-first Healthcare-OCR | ✅ Gut | ✅ | Tage | Individuelles Angebot |
| Tesseract | Kostenlose Open-Source-Basislinie | ❌ Schlecht | N/V (selbst gehostet) | Stunden (Entwicklung) | Kostenlos |
So haben wir ausgewählt und getestet
Die Verarbeitung von Gesundheitsdokumenten ist nicht dasselbe Problem wie allgemeine OCR. Ein Tool, das Rechnungen einwandfrei verarbeitet, kann bei einer Leistungserklärung mit verschachtelten Tabellen, einem Laborbericht mit Ergebnissen in numerischer und narrativer Form oder einem CMS-1500-Formular, bei dem Kodierungsfehler echte finanzielle Folgen haben, katastrophal versagen. Wir haben jedes Tool anhand von fünf gesundheitsspezifischen Dimensionen bewertet.
1. Genauigkeit bei medizinischer Terminologie und Kodierung
Gesundheitsdokumente enthalten ICD-10-Diagnosecodes, CPT-Prozedurencodes, Revenue Codes, LOINC-Laborkennungen, SNOMED-CT-Begriffe und NDC-Arzneimittelcodes. Diese folgen präzisen syntaktischen Mustern – CPT-Codes haben immer fünf Ziffern, ICD-10-Codes sind alphanumerische Zeichenfolgen mit drei bis sieben Zeichen, Revenue Codes sind vierstellige Standortkennungen. Ein Tool, das einen CPT-Code nicht von einem Revenue Code unterscheiden kann, erzeugt Ausgaben, die manuell neu sortiert werden müssen. Wir haben die Fähigkeit jedes Tools bewertet, diese Kodierungsstrukturen zu erhalten, ohne sie in generische „Code“-Felder zu überführen.
2. Handschrifterkennung
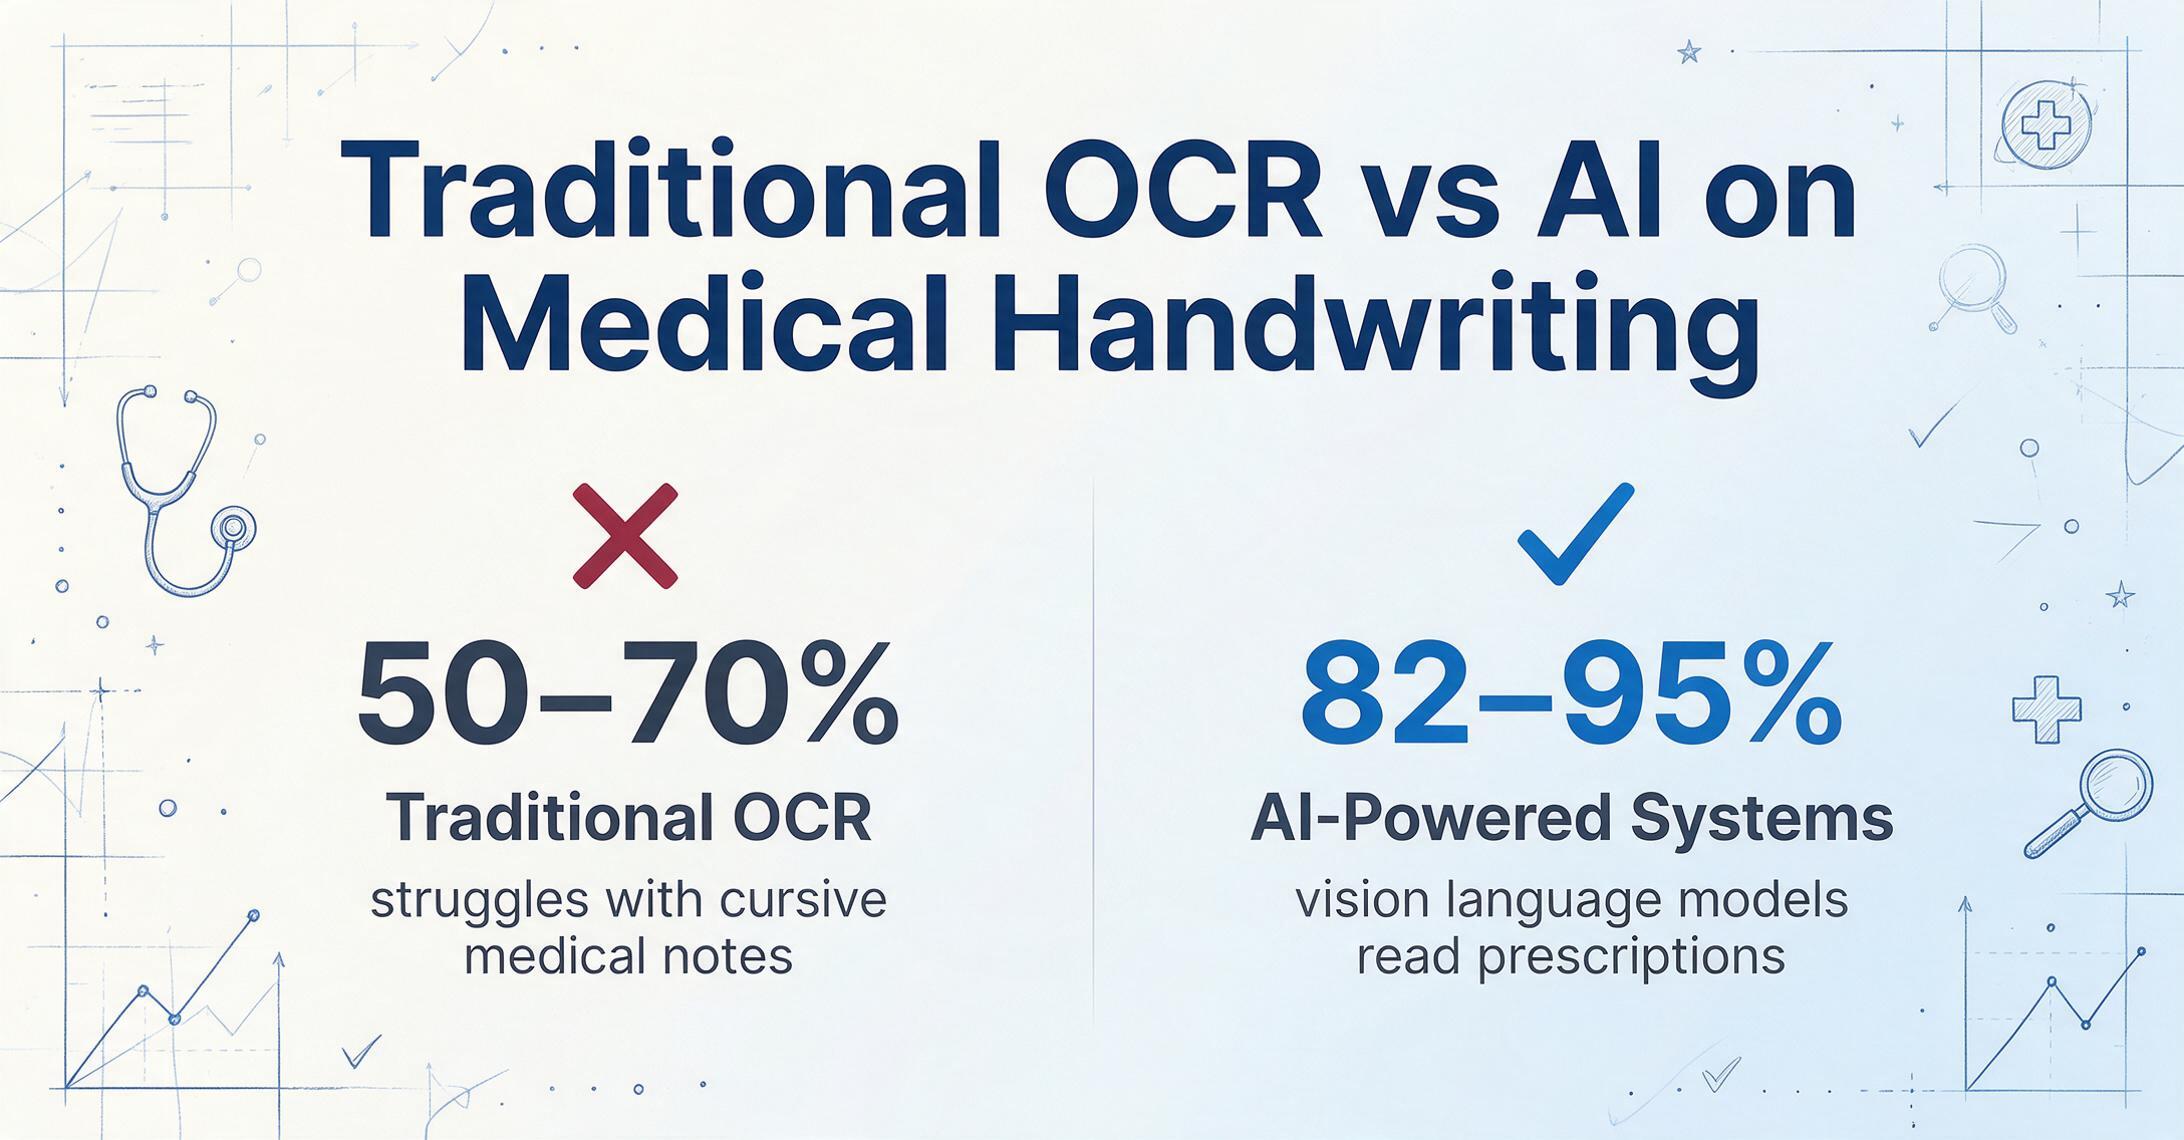
Die Handschrift von Ärzten ist ein bekannter Engpass bei der Verarbeitung von Gesundheitsdokumenten. Akademische Forschung zu OCR für medizinische Rezepte, veröffentlicht im European Journal of AI and Machine Learning, bestätigt, dass traditionelle OCR bei medizinischer Handschrift eine Genauigkeit von etwa 50–70 % erreicht, während KI-gestützte Systeme 82–95 % erreichen. Wir haben bewertet, wie jedes Tool mit kursiven medizinischen Notizen, handschriftlichen Rezeptblöcken und klinischen Anmerkungen am Rand umgeht. Ein Tool, das nur gedruckten Text liest, deckt vielleicht 60 % der tatsächlichen Oberfläche von Gesundheitsdokumenten ab.
3. HIPAA-Konformität und BAA-Unterstützung
HIPAA zertifiziert keine spezifische Software. Konformität ist eine Kombination aus den Sicherheitsvorkehrungen des Anbieters, seinen Richtlinien und seiner Bereitschaft, eine Geschäftspartnervereinbarung (BAA) zu unterzeichnen. Das Amt für Bürgerrechte (OCR) hat die Durchsetzung in den Jahren 2024–2025 drastisch verschärft: Die finanziellen Strafen nach HIPAA stiegen um 340 %, und Advocate Health zahlte einen Vergleich in Höhe von 5,55 Millionen US-Dollar nach einem Vorfall, der mit einem Geschäftspartner zusammenhing, dem eine ordnungsgemäße BAA fehlte. Für jedes Tool, das geschützte Gesundheitsinformationen (PHI) verarbeitet, ist eine unterzeichnete BAA nicht optional. Wir vermerken, wo jedes Tool eine BAA anbietet – und, was noch wichtiger ist, wo nicht.
4. EHR- und Praxisverwaltungsintegration
Gesundheitsorganisationen arbeiten mit spezifischen Software-Ökosystemen: Epic dominiert große Krankenhausverbünde, Oracle Cerner (jetzt Oracle Health) deckt akademische medizinische Zentren ab, Meditech bedient kommunale Krankenhäuser, Athenahealth und eClinicalWorks führen im ambulanten Bereich, und Kareo und AdvancedMD betreuen kleine Praxen. Ein Tool, das Excel-Dateien ausgibt, aber keine Daten in einen EHR-Workflow einspeisen kann, erfordert einen manuellen Zwischenschritt. Wir haben die Integrationstiefe jedes Tools bewertet – von nativen EHR-Konnektoren bis hin zu API-first-Architekturen, die ein Entwickler in eine HL7-FHIR-Pipeline einbinden kann.
5. Bereitstellungsmodell und Zeit bis zum Nutzen
IT-Teams im Gesundheitswesen sind chronisch überlastet. Laut HIMSS-Daten von 2025 nutzen 86 % der Gesundheitssysteme eine Form von KI, aber nur 18 % sind bereit, sie in der Patientenversorgung einzusetzen. Die Lücke ist nicht der Wille – es ist die Implementierungskapazität. Wir haben jedes Tool entlang eines Spektrums bewertet, das von „Minuten bis zur ersten Extraktion“ (No-Code, browserbasiert) bis zu „monatelanger Unternehmensbereitstellung“ (On-Premise-Installation, Modelltraining, Workflow-Konfiguration) reicht. Die richtige Wahl hängt von der technischen Kapazität Ihres Teams und der Dringlichkeit des Problems ab.
Für einen tieferen Einblick, wie sich KI-gestützte Extraktion von der traditionellen Zeichenerkennung in der Dokumentenverarbeitung unterscheidet, finden Sie in unserem Leitfaden zu was KI-OCR ist und wie es funktioniert den Technologiewandel, der semantische Extraktion ermöglicht. Der vollständige Leitfaden dazu, was OCR ist vermittelt das Grundverständnis dafür, wie traditionelle OCR funktioniert und wo ihre Grenzen liegen.
ImageToTable.ai — Beste No-Code-Extraktion für vielfältige medizinische Dokumente
Am besten geeignet für: Gesundheitsteams — Klinikverwaltung, medizinisches Abrechnungspersonal, Sachbearbeiter für Versicherungsansprüche — die strukturierte Daten aus einer Vielzahl medizinischer Dokumente extrahieren müssen, ohne Vorlagen zu konfigurieren oder Modelle zu trainieren. Nicht ideal für: Organisationen, die eine unterzeichnete Geschäftspartnervereinbarung für die DSGVO-Konformität, native EHR-Integration oder lokale Bereitstellung benötigen.
ImageToTable.ai verwendet ein visuelles Sprachmodell, das Dokumente auf dieselbe Weise liest wie ein Mensch: Es versteht, was jedes Feld bedeutet, nicht wo es auf der Seite steht. Dies ist im Gesundheitswesen wichtig, weil medizinische Dokumente in mehr Layout-Varianten vorkommen als in fast jeder anderen Branche. Ein Laborbericht eines Krankenhaussystems platziert den Patientennamen in der oberen linken Ecke; ein anderer platziert ihn in einer zentrierten Kopfzeile. Eine Leistungserklärung von Cigna verwendet verschachtelte Übersichtstabellen; eine von UnitedHealthcare verwendet flache Positionslisten. Vorlagenbasierte Tools scheitern an diesen Unterschieden. Semantische Extraktion nicht.
Benutzerdefinierte Spaltenextraktion ist der Kernmechanismus: Sie geben die gewünschten Spaltennamen ein — „CPT-Code", „ICD-10-Dx", „Revenue Code", „Patientenname", „Rechnungsbetrag" — und die KI lokalisiert jeden Wert, indem sie die semantische Bedeutung des Felds versteht. Sie unterscheidet automatisch einen CPT-Code (fünfstellige Prozedurkennung) von einem Revenue Code (vierstelliger Standortcode) und platziert jeden in der richtigen Ausgabespalte. Dies unterscheidet sich grundlegend von vorlagenbasierten Tools, die jeden Code unabhängig vom Typ in ein einzelnes „Code"-Feld ablegen.
Das Tool verarbeitet gedruckten Text, Handschrift, Kontrollkästchen, Tabellen und Unterschriften. Die Batch-Verarbeitung ist erstklassig: Laden Sie 50 Leistungserklärungen verschiedener Versicherer als einen einzigen Batch hoch und erhalten Sie eine einheitliche Excel-Datei mit konsistenten Spalten. Das Google-Sheets-Add-on ermöglicht es Benutzern, Dokumente hochzuladen und Ergebnisse direkt an eine Tabelle anzuhängen, ohne Sheets zu verlassen. Die Verarbeitung dauert 5–10 Sekunden pro Seite — eine 18-fache Verbesserung gegenüber den durchschnittlich 3 Minuten manueller Dateneingabe. Für eine vollständige Anleitung zum EOB-zu-Excel-Workflow — von der Definition der Spalten bis zum Export des zusammengeführten Batches — lesen Sie unseren Leitfaden zum Konvertieren von EOBs in Excel.
Die Preisgestaltung beginnt mit einer kostenlosen Stufe (begrenzte Extraktionen pro Monat), dann 9 $/Monat (Basic) und 59 $/Monat (Pro). Es ist keine Einrichtung erforderlich, außer der Erstellung eines Kontos. Der Kompromiss ist für das Gesundheitswesen erheblich: ImageToTable.ai bietet heute keine Geschäftspartnervereinbarung an, daher ist es nicht für Workflows geeignet, die eine DSGVO-konforme Verarbeitung geschützter Gesundheitsinformationen durch Anbieter erfordern. Es funktioniert gut für die Verarbeitung anonymisierter Dokumente, interne Verwaltungszwecke, bei denen keine geschützten Gesundheitsinformationen an den Dienst übertragen werden, oder als Produktivitätstool für einzelne medizinische Fachkräfte, die ihre eigenen Daten verwalten.
Amazon Textract – Am besten für AWS-native Healthcare-Pipelines mit hohem Volumen
Am besten geeignet für: Gesundheitsorganisationen, die bereits in AWS investiert haben, hohe Volumina standardisierter Dokumente verarbeiten – Aufnahmeformulare, Anspruchsformulare, Versicherungskarten – und über DevOps-Kapazitäten verfügen, um Extraktionspipelines aufzubauen und zu warten. Nicht ideal für: Teams ohne AWS-Infrastrukturkenntnisse oder solche, die eine schlüsselfertige Benutzeroberfläche benötigen.
Amazon Textract ist ein HIPAA-fähiger AWS-Dienst (BAA über die standardmäßige AWS-BAA verfügbar), was ihn zu einer der unkompliziertesten Optionen für Gesundheitsorganisationen macht, die eine konforme Cloud-Infrastruktur benötigen. Es extrahiert Text, Handschrift, Formulare und Tabellen aus gescannten Dokumenten. Change Healthcare hat Textract zur Verarbeitung von über 16 Millionen Seiten eingesetzt, wodurch die Verarbeitungszeit pro Dokument von 3 Minuten auf unter 1 Minute reduziert und eine Automatisierungsrate von 68 % erreicht wurde, so AWS-Kundenfallstudien.
Textract integriert sich nativ in AWS HealthLake, Amazon Comprehend Medical (für PHI-Erkennung und Extraktion medizinischer Entitäten) und andere AWS-Dienste, was es zu einem starken Baustein für kundenspezifische Healthcare-Automatisierung macht. Es verarbeitet gedruckten Text und Handschrift mit guter Genauigkeit bei standardisierten Formularen. Textract ist jedoch rein API-basiert – es gibt keine grafische Oberfläche zum Hochladen von Dokumenten und Überprüfen von Ergebnissen. Die HIPAA-Konformität erfordert eine manuelle Konfiguration der AWS-Umgebung (Verschlüsselung, Zugriffskontrollen, Audit-Logging) und ist nicht standardmäßig aktiviert. Die Preisgestaltung erfolgt pro Seite und variiert je nach Volumen; bei Skalierung gehört es zu den kostengünstigsten Optionen.
Google Document AI – Am besten für GCP-basierte Healthcare-Workflows
Am besten geeignet für: Healthcare-Teams, die Google Cloud nutzen und vortrainierte Prozessoren für gängige medizinische Dokumente sowie Optionen zur Überprüfung mit menschlicher Beteiligung benötigen. Nicht ideal für: Teams außerhalb des GCP-Ökosystems oder solche, die stark variierende, kundenspezifische Formulartypen verarbeiten.
Google Document AI bietet vortrainierte Prozessoren für Rechnungen, Belege, W-2-Formulare und Identitätsdokumente sowie die Möglichkeit, über die AutoML-Stufe benutzerdefinierte Extraktoren zu trainieren. Die Integration mit Vertex AI und Gemini ermöglicht Zusammenfassungen und Schlussfolgerungen auf Basis der extrahierten Daten – eine nützliche Funktion für die Extraktion klinischer Studiendaten, die Zusammenfassung medizinischer Aufzeichnungen und die Automatisierung der Patientenaufnahme. Google bietet eine BAA für GCP-Dienste an, wodurch Document AI für HIPAA-fähige Workloads verfügbar ist.
Die Stärke liegt hier im breiteren Google-Ökosystem: Document AI speist Daten in BigQuery für Analysen, in die Healthcare API für FHIR-nativen Datenaustausch und in Vertex AI für die Entwicklung benutzerdefinierter Modelle. Die Einschränkung besteht darin, dass vortrainierte Prozessoren nur eine feste Reihe von Dokumenttypen abdecken; für hochspezifische medizinische Formulare (z. B. ein einzigartiges Laborberichtslayout eines regionalen Krankenhaussystems) ist ein benutzerdefiniertes Training erforderlich. Die Preisgestaltung kombiniert OCR-Verarbeitung mit GenAI-Funktionen, was bei Skalierung für mehrstufige Extraktionspipelines komplex werden kann.
Azure Document Intelligence — Am besten für Microsoft-zentrierte Gesundheitssysteme
Am besten geeignet für: Gesundheitsorganisationen, die auf Microsoft-Infrastruktur (Active Directory, Office 365, Dynamics 365) setzen und eine HIPAA-konforme Dokumentenverarbeitung mit strengen Governance-Kontrollen benötigen. Nicht ideal für: Teams ohne Azure-Erfahrung oder solche, die eine No-Code-Extraktionsoberfläche benötigen.
Azure Document Intelligence (ehemals Form Recognizer) bietet vorgefertigte Modelle für gängige Dokumenttypen sowie benutzerdefinierte Extraktionsfunktionen über Azure AI. Es ist bei korrekter Konfiguration im Rahmen der Microsoft-Geschäftspartnervereinbarung für die HIPAA-Konformität abgedeckt und integriert sich in die rollenbasierte Zugriffskontrolle, Audit-Protokollierung und Verschlüsselungsframeworks von Azure – natürliche Stärken für Organisationen, die bereits geschützte Gesundheitsinformationen innerhalb der Microsoft-Compliance-Grenzen verwalten.
Azure DI verarbeitet gedruckten Text, Handschrift, Tabellen und Schlüssel-Wert-Paare. Die vorgefertigten Modelle decken Rechnungen, Belege, Ausweisdokumente und Krankenversicherungskarten ab. Für Gesundheitsspezifische Dokumente wie Laborberichte oder Leistungserklärungen ist in der Regel ein benutzerdefiniertes Modelltraining erforderlich. Die Plattform unterstützt .NET, Python und REST-APIs und ist damit für Microsoft-zentrierte Entwicklungsteams zugänglich. Die Preisgestaltung folgt einem Pay-per-Page-Modell mit Mengenrabatten.
Azure Document Intelligence besuchen →
ABBYY Vantage — Bestes Enterprise-IDP für reguliertes Gesundheitswesen
Am besten geeignet für: Große Gesundheitssysteme und Versicherer, die eine ausgereifte Low-Code-Dokumentenverarbeitungsplattform mit vortrainierten Skills und umfassenden Compliance-Funktionen benötigen. Nicht ideal für: Kleine Praxen oder Teams, die eine schnelle Extraktion ohne Vorlage ohne Bereitstellungszyklus benötigen.
ABBYY ist einer der historischen Marktführer in OCR und intelligenter Dokumentenverarbeitung, mit einer Plattform, die in regulierten Branchen einschließlich des Gesundheitswesens eingesetzt wird. ABBYY Vantage bietet vortrainierte „Skills“ (Extraktionsmodelle für bestimmte Dokumenttypen), einen Low-Code-Skill-Builder für benutzerdefinierte Formulare und Integrationskonnektoren für ECM-Systeme und ERP-Plattformen. Es unterstützt Handschrifterkennung, wobei die Genauigkeit bei dichten, kursiven medizinischen Notizen im Vergleich zu neueren KI-nativen Tools moderat ist.
ABBYY bietet eine Geschäftspartnervereinbarung an und verfügt über umfangreiche Erfahrung mit Bereitstellungen im Gesundheitswesen. Seine Stärke liegt in der Breite: Es kann Rechnungen, Ansprüche, Patientenformulare, klinische Studiendokumente und Korrespondenz von Leistungserbringern innerhalb einer einzigen Plattform abdecken. Der Kompromiss besteht darin, dass die Bereitstellung in der Regel Wochen bis Monate dauert, die Preisgestaltung individuell angeboten wird und auf Unternehmensniveau liegt (fünfstellige Beträge pro Jahr und mehr), und die Plattform erfordert einen dedizierten administrativen Aufwand, um Extraktions-Skills bei sich ändernden Dokumentformaten zu pflegen. Für große Organisationen mit einem dedizierten Dokumentenverarbeitungsteam ist ABBYY Vantage eine bewährte Wahl.
Nanonets — Am besten für individuell trainierte Nischenmodelle für medizinische Dokumente
Am besten geeignet für: Organisationen, die ein hohes Volumen eines bestimmten, stabilen medizinischen Dokumenttyps verarbeiten und über die Ressourcen verfügen, um ein dediziertes Modell zu trainieren und zu pflegen. Nicht ideal für: Teams, die eine Extraktion ohne Einrichtung über viele verschiedene Dokumentlayouts hinweg benötigen.
Nanonets bietet eine KI-OCR-Plattform mit über 300 vortrainierten Modellen für Dokumentkategorien wie Gesundheitsformulare, Versicherungsdokumente und Krankenakten. Das Kernunterscheidungsmerkmal ist die Trainingspipeline: Benutzer laden Beispieldokumente hoch (in der Regel 20–50 pro Format), beschriften die Felder, und die Plattform trainiert ein benutzerdefiniertes Extraktionsmodell. Für ein Krankenhaussystem, das dasselbe Laborberichtsformat von 50 angeschlossenen Kliniken verarbeitet, kann dies eine hohe Genauigkeit liefern. Nanonets bietet eine Geschäftspartnervereinbarung für Unternehmenskunden und unterstützt sowohl Cloud- als auch On-Premise-Bereitstellung.
Die Einschränkung besteht darin, dass jedes neue Dokumentformat einen neuen Trainingszyklus erfordert. Eine Klinik, die Laborberichte von fünf verschiedenen Krankenhaussystemen erhält, benötigt fünf beschriftete Trainingssätze. Ein medizinisches Abrechnungsteam, das Leistungserklärungen von 20 verschiedenen Versicherungsplänen verarbeitet, benötigt 20 Trainingsiterationen. Für stabile Formate mit hohem Volumen zahlt sich die anfängliche Investition aus. Bei vielfältigen, variablen Dokumentmischungen summieren sich die Wartungskosten für das Training. Die Preisgestaltung beginnt mit einer kostenlosen Stufe (begrenzte Seiten) und skaliert auf individuelle Unternehmenspläne.
LlamaParse (LlamaIndex) — Am besten für entwicklergeführte KI-Produkte im Gesundheitswesen
Am besten geeignet für: Entwicklungsteams, die agentische Gesundheitsanwendungen entwickeln — klinische Assistenten, automatisierte medizinische Kodierungspipelines, Forschungssynthese-Tools — die ein tiefes Dokumentverständnis mit feldbezogenen Konfidenzwerten und Quellenangaben benötigen. Nicht ideal für: nicht-technische Gesundheitsteams, die eine grafische Oberfläche für die Dokumentverarbeitung benötigen.
LlamaParse verfolgt einen agentischen Ansatz bei der Dokumentverarbeitung: Statt starrer Vorlagen oder layoutbasierter Extraktion verwendet es multimodale KI, um Dokumentstruktur, Tabellen, Handschrift und Diagramme zu verstehen und extrahiert dann strukturierte Daten mit feldbezogenen Konfidenzwerten. Es integriert sich in das breitere LlamaIndex-Ökosystem für RAG-Pipelines und ist damit eine starke Wahl für Organisationen, die dokumentbewusste KI-Produkte auf Basis ihrer eigenen medizinischen Daten entwickeln.
Die Plattform unterstützt schema-basierte Extraktion (LlamaExtract), bei der Sie die benötigten Felder definieren (MRN, ICD-10-Codes, Medikamentennamen, Laborwerte, Dosierungen) und die KI diese mit Seitenzitaten für die Auditierbarkeit extrahiert. LlamaIndex bietet eine Geschäftspartnervereinbarung für Unternehmenskunden und unterstützt sowohl Cloud- als auch Self-Hosted-Bereitstellung. Der Kompromiss besteht darin, dass es API-first und SDK-basiert ist (Python + TypeScript), ohne No-Code-Oberfläche. Die Preisgestaltung beginnt mit einer kostenlosen Stufe zur Evaluierung und skaliert auf individuelle Unternehmensangebote.
Docsumo — Am besten geeignet für Verwaltungs- und Schadensbearbeitung im Gesundheitswesen
Am besten geeignet für: Krankenversicherer, Drittanbieter-Administratoren (TPAs) und Backoffice-Teams für medizinische Abrechnung, die große Mengen strukturierter Formulare, Schadensdokumente und Versicherungsunterlagen verarbeiten. Nicht ideal für: die Extraktion klinischer Dokumente aus handschriftlichen Arztnotizen oder komplexen Laborberichten.
Docsumo ist eine universelle Plattform für intelligente Dokumentenverarbeitung, die sich durch strukturierte und halbstrukturierte Dokumente auszeichnet, die in der Gesundheitsverwaltung üblich sind: Schadensformulare, Leistungserklärungen, Berechtigungsprüfungsdokumente und Versicherungsanträge. Es bietet vortrainierte Modelle für gängige Dokumenttypen, integrierte Validierungsregeln und die Integration in Workflows über API und Webhooks. Eine Geschäftspartnervereinbarung ist für Gesundheitskunden verfügbar.
Die Stärken von Docsumo liegen auf der administrativen Seite des Gesundheitswesens – für einen Krankenversicherer, der 10.000 Schadensformulare pro Monat mit stabilen Layouts verarbeitet, bietet es zuverlässige Straight-Through-Verarbeitung. Die Handschrifterkennung ist im Vergleich zu KI-nativen Tools begrenzt, daher ist es nicht die richtige Wahl für handschriftliche Rezepte oder klinische Notizen. Die Preise werden individuell angeboten und basieren auf dem Dokumentvolumen.
Hyland OnBase — Beste Unternehmensdokumentenverwaltung mit Healthcare-Erfassung
Am besten geeignet für: große Gesundheitssysteme, die eine einheitliche Plattform für Unternehmensinhaltsdienste benötigen, die Dokumentenverwaltung, Erfassung, Workflow und Compliance kombiniert – mit OCR als einer Komponente innerhalb einer breiteren Infrastruktur. Nicht ideal für: Teams, die ein eigenständiges Dokumentextraktionstool ohne größere ECM-Bereitstellung benötigen.
Hyland OnBase ist eine ausgereifte Plattform für Unternehmensinhaltsdienste mit tiefer Durchdringung im Gesundheitswesen. Es bietet Dokumentenerfassung, Indexierung, Speicherung, Workflow-Automatisierung und Verwaltung der Informationsfreigabe – alles innerhalb eines HIPAA-konformen Rahmens mit einer Geschäftspartnervereinbarung. Das Erfassungsmodul verwendet OCR, um gescannte Dokumente zu klassifizieren und Daten zu extrahieren und sie in die entsprechenden klinischen oder administrativen Workflows zu leiten.
OnBase wird von Hunderten von Krankenhäusern zum Scannen und Indexieren von Patientenakten, Leistungserklärungen und Verwaltungsdokumenten verwendet. Reddit-Nutzer in r/healthIT beschreiben die Verwendung von „Onbase zum Indexieren von Massenscans / Faxen in die Patientenakte“ als Teil eines manuellen, aber flexiblen Workflows. Der Kompromiss besteht darin, dass OnBase eine massive Unternehmensplattform ist: Die Bereitstellung dauert Monate, die Kosten werden individuell angeboten und liegen typischerweise im sechsstelligen Bereich, und die Handschrifterkennung ist grundlegend. Es ist eine Investition in die Inhaltsverwaltung mit Extraktionsfunktionen, kein Tool, das auf Extraktion ausgerichtet ist.
Kofax — Beste Unternehmens-Dokumenterfassung im großen Maßstab
Am besten geeignet für: große Gesundheitsorganisationen und Business-Process-Outsourcer, die monatlich Millionen von Seiten über automatisierte Erfassungsworkflows mit Validierung und Klassifizierung verarbeiten. Nicht ideal für: kleine Kliniken, Einzelpraxen oder Teams, die ein leichtgewichtiges Extraktionstool benötigen.
Kofax (Teil von Tungsten Automation) bietet intelligente Unternehmens-Dokumenterfassung mit KI-gestützter Klassifizierung, Extraktion und Validierung. Die Plattform scannt, klassifiziert, extrahiert Daten aus und leitet Dokumente durch Gesundheitsworkflows – vom Scannen bei der Patientenaufnahme bis zur EOB-Verarbeitung in der Abteilung für Erlösmanagement. Kofax bietet eine BAA und verfügt über umfangreiche Erfahrung im Gesundheitswesen.
Die Stärke der Plattform ist die automatisierte Erfassung großer Mengen: das Scannen von 50.000 Seiten pro Tag, die automatische Klassifizierung von Dokumenttypen, die Extraktion wichtiger Felder und deren Validierung anhand von Geschäftsregeln, bevor sie an nachgelagerte Systeme weitergeleitet werden. Der Kompromiss ist die Komplexität: Kofax-Implementierungen erfordern in der Regel professionelle Dienstleistungen, monatelange Konfiguration und erhebliche Kapitalausgaben. Die Handschrifterkennung ist begrenzt. Für Organisationen unterhalb der Unternehmensebene ist es übertrieben.
Koncile — Beste API-First-Gesundheits-OCR für Rezepte und medizinische Dokumente
Am besten geeignet für: Gesundheitstechnologieunternehmen und digitale Gesundheitsplattformen, die einen API-First-OCR-Dienst mit starker Leistung bei Rezepten und DSGVO-konformer Verarbeitung französischer medizinischer Dokumente benötigen. Nicht ideal für: US-orientierte Teams, die No-Code-Extraktion oder tiefe EHR-Integrationen mit Epic/Cerner benötigen.
Koncile ist eine auf das Gesundheitswesen spezialisierte KI-OCR-Plattform, die hauptsächlich für den europäischen Markt entwickelt wurde und bei Rezepten, medizinischen Berichten und klinischen Dokumenten starke Leistungen erbringt. Sie bietet vorgefertigte Extraktionsmodelle für das Gesundheitswesen und eine API-First-Architektur, die sich für die Integration in digitale Gesundheitsprodukte und Apothekenautomatisierungsplattformen eignet. Koncile bietet ein BAA-Äquivalent unter der DSGVO und hostet Daten auf französischen Servern.
Die Handschrifterkennung ist dank spezieller Schulung an medizinischen Handschriftproben, einschließlich Rezeptnotationen, stärker als bei allgemeinen OCR-Tools. Der Kompromiss ist geografischer Natur: Die Dokumentenschulung von Koncile ist am stärksten bei europäischen medizinischen Formaten, und das Integrationsökosystem umfasst keine US-spezifischen EHR-Systeme. Die Preisgestaltung erfolgt individuell und volumenbasiert.
Tesseract — Beste kostenlose Open-Source-OCR-Basislinie
Am besten geeignet für: Entwickler, die benutzerdefinierte Pipelines zur Verarbeitung von Gesundheitsdokumenten erstellen und eine kostenlose, selbst gehostete OCR-Engine für die Extraktion von gedrucktem Text als Ausgangspunkt benötigen. Nicht ideal für: Arbeitsabläufe im Gesundheitswesen, die Handschrift, komplexe Layouts, strukturierte Datenextraktion oder die direkte Verarbeitung von PHI ohne zusätzliche Sicherheitsvorkehrungen umfassen.
Tesseract ist die am weitesten verbreitete Open-Source-OCR-Engine, die seit 2006 von Google gepflegt wird. Version 5 (veröffentlicht 2024) fügte eine auf LSTM basierende neuronale Netzerkennung hinzu, die die Genauigkeit bei sauberem gedrucktem Text verbesserte. Sie unterstützt über 100 Sprachen und kann für bestimmte Dokumenttypen angepasst und erweitert werden.
Für das Gesundheitswesen ist der Wert von Tesseract auf gedruckten Text auf sauberen, kontrastreichen Dokumenten beschränkt. Es hat nur minimale Handschrifterkennung — akademische Forschung bestätigt, dass Tesseract bei medizinischer Handschrift eine Genauigkeit von etwa 64 % erreicht — und keine strukturierte Datenextraktion. Ein von Tesseract extrahierter ICD-10-Code landet in einem flachen Textblock ohne Feldbezeichnung, was eine zusätzliche Verarbeitung erfordert, um jeden Code zu identifizieren und weiterzuleiten. Tesseract hat standardmäßig keine BAA, keine Audit-Protokollierung und keine PHI-Verarbeitungsinfrastruktur; jede HIPAA-konforme Nutzung erfordert, dass die bereitstellende Organisation Sicherheitskontrollen darum herum aufbaut. Es ist eine nützliche Komponente in einer benutzerdefinierten Pipeline, aber keine eigenständige OCR-Lösung für das Gesundheitswesen.
Welches Tool ist das richtige für Ihre Gesundheitsorganisation?
Ein Tool passt nicht für alle OCR-Anforderungen im Gesundheitswesen, denn das Gesundheitswesen ist nicht ein Arbeitsablauf — es ist eine Sammlung von grundlegend verschiedenen Dokumentverarbeitungsproblemen, die zufällig einen gemeinsamen regulatorischen Rahmen haben. So ordnen Sie Ihre Situation der richtigen Tool-Kategorie zu.
Sie betreiben eine kleine Klinik oder Einzelpraxis
Sie verarbeiten Patientenaufnahmeformulare, Versicherungskarten und ein moderates Volumen an Leistungserklärungen. Sie haben kein IT-Team und benötigen etwas, das in Minuten funktioniert. ImageToTable.ai ist die praktischste Option, um gescannte Formulare ohne Einrichtung in strukturierte Daten umzuwandeln. Für die HIPAA-konforme Verarbeitung von PHI über die Cloud sind Google Document AI oder Azure Document Intelligence mit einer Geschäftspartnervereinbarung geeignet, wenn Sie die administrative Kapazität haben, das Cloud-Konto einzurichten. Für eine völlig kostenlose, aber begrenzte Option kann Tesseract über eine GUI-Oberfläche gedruckten Text auf sauberen Dokumenten verarbeiten — aber rechnen Sie damit, jede Ausgabe zu überprüfen.
Sie leiten eine mittelgroße Arztpraxis oder ein ambulantes Versorgungsnetzwerk
Sie nutzen ein EHR wie Athenahealth, eClinicalWorks oder Kareo. Ihr Dokumentvolumen liegt bei Tausenden pro Monat – Leistungserklärungen, Überweisungsschreiben, Laborberichte von mehreren Laboren. Sie benötigen Flexibilität über Formate hinweg, haben aber möglicherweise kein dediziertes Datentechnik-Team. ImageToTable.ai bewältigt Formatvielfalt gut und erfordert keine Vorlagenkonfiguration. Wenn Ihre Organisation BAA-Schutz benötigt, sind Docsumo für Verwaltungsdokumente oder Nanonets für Dokumente mit hohem Volumen und stabilem Format geeignet. Google Document AI mit seiner Healthcare-API kann zu FHIR überbrücken, wenn Sie über die technischen Ressourcen verfügen.
Sie arbeiten in einem großen Gesundheitssystem oder Krankenhausnetzwerk
Sie nutzen Epic, Oracle Cerner oder Meditech. Sie verarbeiten jährlich Millionen von Seiten – Patientenakten, Versicherungsansprüche, klinische Studiendokumente, Korrespondenz von Leistungserbringern. Sie haben eine IT-Abteilung und ein Compliance-Büro. Hyland OnBase oder Kofax sind die etablierten Unternehmenslösungen für Erfassung plus Content-Management, mit nachgewiesener Integration in große Krankenhausabläufe. ABBYY Vantage bietet eine eher extraktionsfokussierte Alternative mit Low-Code-Fähigkeitsaufbau. Amazon Textract, eingebunden in eine AWS HealthLake-FHIR-Pipeline, ist die skalierbarste cloudnative Option für Organisationen mit DevOps-Kapazität.
Sie arbeiten für einen Krankenversicherer oder TPA
Ihr zentraler OCR-Bedarf ist die Anspruchsverarbeitung – CMS-1500, UB-04, Begegnungsdaten und Leistungserklärungen – in hohem Volumen mit konsistenten Formaten. Docsumo und Nanonets bieten beide starke Formularverarbeitung für Versicherungsdokumente. Amazon Textract auf der AWS-Gesundheitsinfrastruktur kann sehr hohen Durchsatz mit Kostenplanbarkeit bewältigen. ABBYY Vantage deckt den gesamten Anspruchslebenszyklus von der Erfassung bis zur Entscheidungsunterstützung ab.
Sie entwickeln ein Gesundheitstechnologie-Produkt
Ihr OCR-Bedarf ist in Ihre eigene Anwendung eingebettet – einen klinischen Assistenten, ein Tool zur Automatisierung der medizinischen Kodierung, ein patientenorientiertes Gesundheitsdatenprodukt. LlamaParse bietet das fortschrittlichste Entwickler-Toolkit mit schemagesteuerter Extraktion und feldbezogenen Konfidenzwerten. Amazon Textract ist eine bewährte Hochvolumen-API. Azure Document Intelligence lässt sich gut in .NET-Stacks integrieren. Koncile ist eine spezialisierte Option für europäische Gesundheitsanwendungsfälle mit DSGVO-Konformität.
Für einen breiteren Überblick über die OCR-Landschaft, einschließlich kostenloser Optionen und Open-Source-Alternativen, lesen Sie unseren Leitfaden zur besten kostenlosen OCR-Software und Vergleich der besten Open-Source-OCR-Tools. Wenn handschriftliche medizinische Dokumente Ihre größte Herausforderung sind – und das sind sie für viele Gesundheitsteams –, geht unsere spezielle Übersicht zur Handschrift-OCR näher auf diese spezifische Fähigkeit ein. Für einen allgemeinen Überblick, der auch hier nicht behandelte Unternehmenswerkzeuge umfasst, zeigt beste OCR-Software 2026 die gesamte Landschaft.
Häufig gestellte Fragen
Was macht ein OCR-Tool HIPAA-konform?
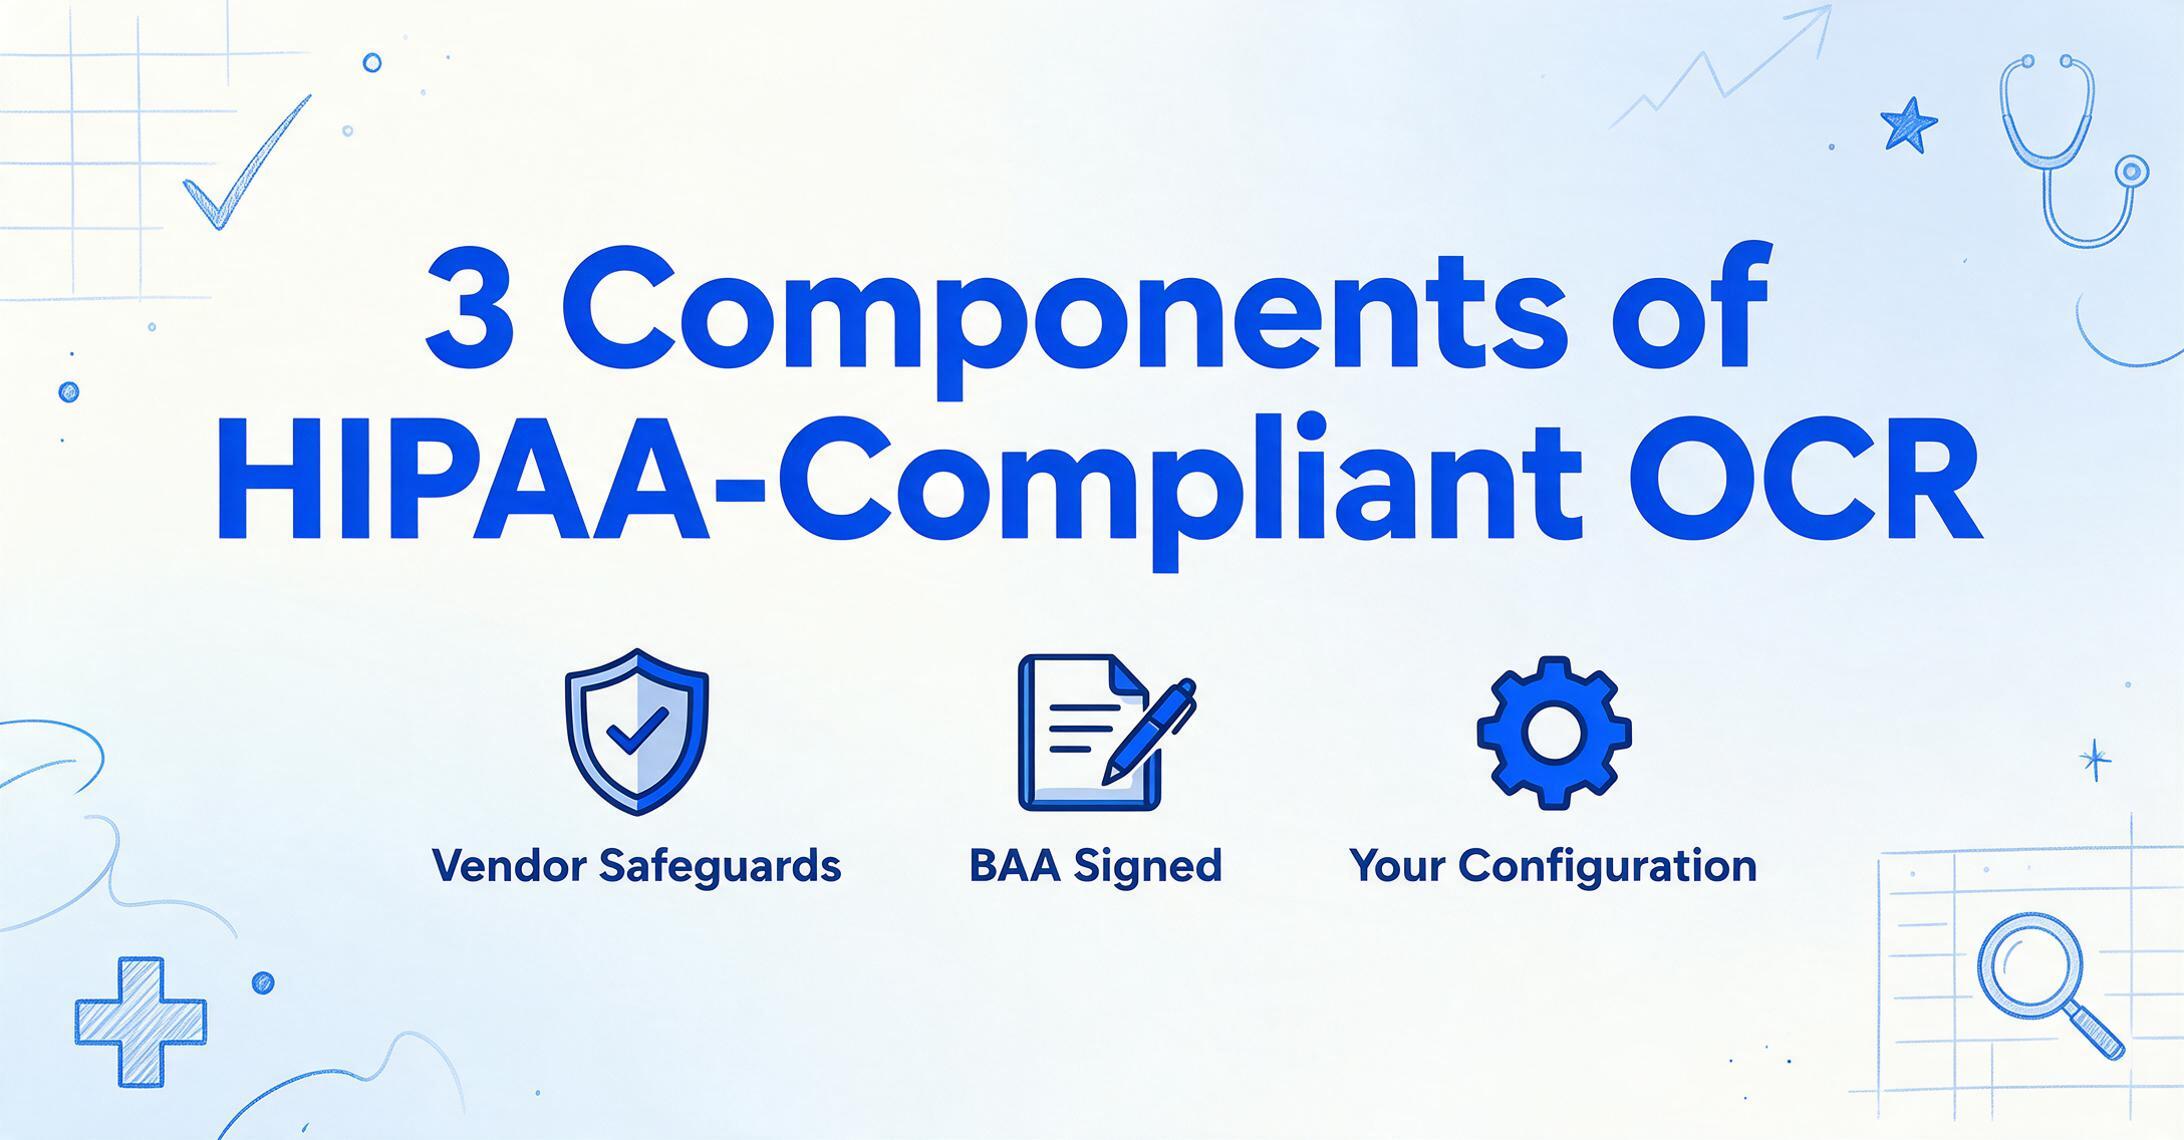
Die HIPAA-Konformität von OCR-Software erfordert drei Komponenten, die zusammenwirken. Erstens muss der Anbieter strenge Sicherheitsvorkehrungen aufrechterhalten – Verschlüsselung im Ruhezustand und während der Übertragung, rollenbasierte Zugriffskontrollen, umfassende Audit-Protokollierung und klare Richtlinien für den Umgang mit geschützten Gesundheitsinformationen. Zweitens muss der Anbieter eine Geschäftspartnervereinbarung unterzeichnen, die ihn vertraglich an die Anforderungen der HIPAA-Datenschutz- und Sicherheitsregeln für alle geschützten Gesundheitsinformationen bindet, die er in Ihrem Auftrag verarbeitet. Drittens muss Ihre Organisation das Tool im Rahmen Ihres eigenen HIPAA-Konformitätsprogramms konfigurieren und betreiben – eine BAA macht Ihren Workflow nicht konform, wenn Sie das Tool so konfigurieren, dass geschützte Gesundheitsinformationen an einem unverschlüsselten Ort gespeichert oder unbefugten Benutzern Zugriff gewährt wird. Das Amt für Bürgerrechte hat durch Durchsetzungsmaßnahmen – einschließlich des 5,55-Millionen-Dollar-Vergleichs mit Advocate Health – klargestellt, dass sowohl die Anbietervereinbarung als auch die operativen Kontrollen vorhanden sein müssen.
Kann OCR die Handschrift von Ärzten zuverlässig lesen?
Dies ist die mit Abstand häufigste Frage im Bereich Healthcare-OCR, und die ehrliche Antwort lautet: Es hängt von der Handschrift und dem Tool ab. Herkömmliche OCR erreicht bei handschriftlichen medizinischen Texten eine Genauigkeit von etwa 50–70 %. Moderne KI-gestützte Tools, einschließlich Vision-Language-Modellen, erreichen bei medizinischer Handschrift 82–95 % – eine deutliche Verbesserung, aber immer noch unter der Genauigkeit bei gedrucktem Text. Die besten Ergebnisse erzielen Tools, die speziell mit medizinischen Handschriftproben trainiert wurden oder auf Vision-Language-Modellen basieren, die den semantischen Kontext verstehen (eine Zeichenfolge aus fünf Zeichen nach „Dx:“ ist wahrscheinlich ein Diagnosecode, selbst wenn ein Zeichen mehrdeutig ist). Kein OCR-Tool erreicht 99 % bei Handschrift. Bei kritischen klinischen Daten – Medikamentennamen, Dosierungen, Diagnosecodes – sollten Sie immer Zeit für die manuelle Überprüfung anhand des Originaldokuments einplanen. Unser Handschrift-OCR-Überblick behandelt dieses Thema ausführlich.
Kann OCR CPT-Codes und ICD-10-Codes aus medizinischen Dokumenten extrahieren?
Ja, aber die Qualität der Extraktion hängt davon ab, ob das Tool die Codestruktur versteht oder nur Rohtext liest. KI-gestützte Tools, die semantische Extraktion verwenden, können zwischen Codetypen unterscheiden: CPT-Codes sind fünfstellige numerische Kennungen (99213, 93000), ICD-10-Codes sind alphanumerische Zeichenfolgen (E11.9, I10), Revenue Codes sind vierstellige Standortkennungen (0450 für die Notaufnahme) und NDC-Arzneimittelcodes sind 11-stellige Kennungen. Ein Tool, das jeden Codetyp der richtigen Ausgabespalte zuordnet, ist für die nachgelagerte medizinische Abrechnung und das Anspruchsmanagement weitaus nützlicher als eines, das alle Codes in ein einziges Textfeld ausgibt. Definieren Sie für jeden Codetyp separate Spalten – „CPT Code“, „ICD-10 Dx“, „Revenue Code“, „NDC“ – und lassen Sie das Tool sie nach semantischem Typ zuordnen.
Integriert sich OCR in Epic, Cerner oder Meditech?
Die direkte EHR-Integration ist bei OCR-Tools die Ausnahme, nicht die Regel. Die meisten Tools geben strukturierte Daten als Excel, CSV oder JSON aus, die dann über eine separate Schnittstelle oder API-Ebene in das EHR importiert werden müssen. Enterprise-Plattformen wie Hyland OnBase und Kofax verfügen über vorgefertigte Konnektoren zu großen EHR-Systemen, da sie als Content-Management-Plattformen fungieren, die die klinische Dokumentation umhüllen. Cloud-API-Tools wie Amazon Textract integrieren sich in die FHIR-API von AWS HealthLake, die dann eine Verbindung zu einem EHR herstellen kann. Bei den meisten No-Code-OCR-Tools sieht der Workflow so aus: Daten in eine Tabelle extrahieren → validieren → in das EHR hochladen oder importieren. Dieser Zwischenschritt ist nicht ideal, aber für die meisten Gesundheitsorganisationen die praktische Realität.
Gibt es ein kostenloses OCR-Tool für Gesundheitsdokumente?
Tesseract ist kostenlos und Open Source, aber seine praktischen Einschränkungen im Gesundheitswesen sind erheblich: minimale Handschriftunterstützung, keine strukturierte Datenextraktion, keine PHI-Sicherheitsinfrastruktur und eine reine Entwicklerschnittstelle. Die integrierte OCR von Google Drive ist kostenlos und kann durchsuchbare PDFs aus gescannten medizinischen Dokumenten erstellen, gibt aber nur Fließtext aus – keine strukturierten Daten mit Feldbezeichnungen. ImageToTable.ai bietet einen kostenlosen Tarif für begrenzte Extraktionen, der sich zum Testen eignet, ob die semantische Extraktion bei Ihren spezifischen Dokumenten funktioniert, bevor Sie sich für einen kostenpflichtigen Plan entscheiden. Einen umfassenden Vergleich kostenloser Optionen finden Sie in unserem Leitfaden zu den besten kostenlosen OCR-Softwarelösungen.
Kann OCR die verschachtelten Tabellen in Leistungserklärungen verarbeiten?
Verschachtelte EOB-Tabellen gehören zu den schwierigsten Dokumenttypen für herkömmliche OCR, da eine einzelne Tabellenzelle sowohl einen Dollarbetrag als auch eine codierte Erklärung enthalten kann, wobei Unterzeilen unter übergeordneten Positionen eingerückt sind. Vorlagenbasierte Tools glätten diese typischerweise zu einem einzigen Textblock pro Zeile und verlieren dabei die Hierarchie. KI-gestützte Tools mit Layout-Verständnis schneiden deutlich besser ab, da sie die Eltern-Kind-Beziehung zwischen einer primären Gebühr und ihren Anpassungen erkennen können. Der Schlüssel liegt darin, Spalten zu definieren, die der EOB-Struktur entsprechen: „Billed Amount", „Allowed Amount", „Insurance Payment", „Patient Responsibility", „Adjustment Code" – und die KI jeden Wert zuordnen zu lassen, indem sie versteht, wo er in der logischen Hierarchie des Dokuments steht, statt eine feste Rasterkoordinate zu lesen. Für einen tieferen Einblick, wie Extraktionstools mit Multi-Payer-EOB- und Anspruchsformaten umgehen, siehe unseren Überblick über Extraktionstools für Gesundheitsdokumente; für die zugrunde liegende OCR-Mechanik bei medizinischen Dokumenttypen deckt unser OCR-Leitfaden für das Gesundheitswesen das gesamte Dokumentenspektrum ab.
Wie sieht es mit der Verarbeitung handschriftlicher Rezepte aus?
Handschriftliche Rezepte stellen eine besondere OCR-Herausforderung dar, da die Folgen von Fehllesungen klinischer Natur sind und nicht nur administrativ. Eine falsch gelesene Dosierung oder ein falsch gelesener Medikamentenname kann die Patientensicherheit direkt beeinträchtigen. Akademische Studien zur OCR bei der Rezeptverarbeitung zeigen, dass herkömmliche OCR bei Rezepthandschrift eine Genauigkeit von etwa 50–70 % erreicht, während KI-Systeme, die mit medizinischen Stichproben trainiert wurden, 82–95 % erreichen. Der praktischste Ansatz für Apotheken und Rezeptverarbeiter ist ein KI-gestütztes Tool, das Handschrift kontextuell lesen kann (also versteht, dass „Metf" wahrscheinlich „Metformin" bedeutet), kombiniert mit einem pharmazeutischen Prüfschritt für jedes Rezept. Kein OCR-Tool sollte die einzige Kontrollinstanz in einem Rezeptabwicklungsworkflow sein – das klinische Risiko ist zu hoch.
Wie lange dauert die Einführung von OCR im Gesundheitswesen?
Der Zeitrahmen für die Einführung variiert je nach Tool-Kategorie um Größenordnungen. No-Code-Tools wie ImageToTable.ai: Minuten bis zur ersten Extraktion. Cloud-API-Tools wie Amazon Textract, Google Document AI oder Azure Document Intelligence: Stunden bis Tage für die API-Integration, zuzüglich Zeit für die Konfiguration einer HIPAA-konformen Infrastruktur. Trainingsbasierte Plattformen wie Nanonets: Tage bis Wochen, abhängig von der Anzahl der Dokumentformate, die beschriftete Beispiele benötigen, und der Anzahl der Iterationen im Trainingsprozess. Unternehmensplattformen wie ABBYY Vantage, Hyland OnBase oder Kofax: Monate, einschließlich professioneller Dienstleistungen, Workflow-Konfiguration, Integrationsentwicklung und Compliance-Validierung. Laut HIMSS-Daten von 2025 geben nur 18 % der Gesundheitssysteme an, bereit für den Einsatz von KI-Tools in der Patientenversorgung zu sein – die Lücke liegt nicht in der Technologieverfügbarkeit, sondern in der Implementierungskapazität. Wählen Sie ein Tool, dessen Einführungszeitplan zur Aufnahmefähigkeit Ihrer Organisation passt.
Fazit
Die Verarbeitung von Gesundheitsdokumenten im Jahr 2026 ist eine Geschichte zweier Lücken. Die Technologielücke – was KI-gestützte Tools tatsächlich leisten können versus das, was Gesundheitsteams glauben, dass sie leisten können – schließt sich rasant. Vision-Language-Modelle können mittlerweile medizinische Handschriften lesen, CPT-Codes von ICD-10-Codes anhand ihrer Struktur unterscheiden und Daten aus verschachtelten EOB-Tabellen ohne Vorlagen extrahieren. Die Implementierungslücke – die Kluft zwischen dem technisch Machbaren und dem, was Gesundheitsorganisationen tatsächlich einführen können – bleibt der entscheidende Engpass.
Das richtige OCR-Tool für Ihre Gesundheitsorganisation ist dasjenige, dessen Einführungsmodell zur technischen Kapazität Ihres Teams und dessen Extraktionsansatz zur Vielfalt Ihrer Dokumente passt. Wenn Ihre Dokumente standardisiert sind und das Volumen hoch ist, liefern eine trainingsbasierte oder Unternehmensplattform vorhersagbare Genauigkeit. Wenn Ihre Dokumente stündlich wechseln – verschiedene Versicherer, verschiedene Labore, verschiedene Kliniken – erspart Ihnen ein semantischer, vorlagenfreier Ansatz die Wartung von Extraktionskonfigurationen für jedes Format. Und wenn Sie handschriftliche klinische Daten verarbeiten – Rezepte, Arztnotizen, kommentierte Laborberichte – machen Sie die Handschrifterkennung zu einem nicht verhandelbaren Bewertungskriterium, nicht zu einem netten Extra.
Beginnen Sie damit, ein Tool mit den Dokumenten zu testen, die Ihr Team tatsächlich verarbeitet – nicht die perfekten Dokumente, sondern die unordentlichen. Das Tool, das Ihre realen Unterlagen extrahierbar macht, ist das Tool, das Sie verwenden sollten.