2026年医療向け最高のOCRソフトウェア:
テスト済み12の医療文書ツール
このガイドでは、医療チームに特に関係する5つの基準に基づいて、12のOCR・AI文書抽出ツールを評価します。医学用語やコーディングシステムの正確性、臨床メモや処方箋の手書き認識能力、HIPAA準拠の準備状況、EHRおよび診療管理システムとの統合、そして各ツールがさまざまな医療機関の規模や技術力にどれだけ正直に適合するかです。すべての価格は2026年6月時点のベンダーの公開ページに基づいています。開示:ImageToTable.aiがこの比較に含まれています。他の記載されたツールとは一切関係ありません。すべての外部リンクはベンダーのウェブサイトを指しており、ご自身で主張を確認できます。
重要なポイント
- このリストの医療用OCRツールはすべて95%の精度を主張していますが、そのベンチマークはきれいなタイプ済み請求書でテストされたものです。実際の日常業務には、入れ子になった集計表を含むEOBや、回診に遅れた医師が書いた筆記体の処方箋が含まれています。
- OCRが時間を節約するか無駄にするかを決める最大の機能はコード種別の識別です。CPT処置コードとICD-10診断コードを単一のCode列にまとめてしまうツールは、手動での再分類作業を生み出し、抽出で節約したすべての時間を無駄にしてしまいます。
- 精度のパーセンテージ比較は飛ばして、そのツールがHIPAA業務に対してBAAを締結してくれるか、忙しいクリニックで午後11時に医師が実際に書く手書き文字を読めるかを確認してください。
クイック比較表
| ツール | 最適な用途 | 手書き対応 | BAA対応 | 導入期間 | 初期費用 |
|---|---|---|---|---|---|
| ImageToTable.ai | 多様な医療文書をノーコードで抽出 | ✅ 強力 | ❌ | 数分 | 無料枠 / 月額9ドル |
| Amazon Textract | AWSネイティブの大量処理パイプライン | ✅ 良好 | ✅ | 数時間~数日 | 従量課金 |
| Google Document AI | GCPベースの医療パーサー | ✅ 良好 | ✅ | 数時間~数日 | 従量課金 |
| Azure Document Intelligence | Microsoft中心の医療システム | ✅ 良好 | ✅ | 数時間~数日 | 従量課金 |
| ABBYY Vantage | ローコードスキルによるエンタープライズIDP | ✅ 中程度 | ✅ | 数週間 | 個別見積 |
| Nanonets | ニッチなフォーマット向けカスタム学習モデル | ✅ 中程度 | ✅ | 数日~数週間 | 無料枠 / 個別見積 |
| LlamaParse (LlamaIndex) | 開発者主導の医療AIプロダクト | ✅ 強力 | エンタープライズ版 | 数時間 | 無料枠 / 個別見積 |
| Docsumo | 管理・保険書類の処理 | ⚠️ 限定的 | ✅ | 数日 | 個別見積 |
| Hyland OnBase | キャプチャ機能付きエンタープライズDMS | ⚠️ 限定的 | ✅ | 数ヶ月 | 個別見積 |
| Kofax | 大規模なエンタープライズ文書キャプチャ | ⚠️ 限定的 | ✅ | 数ヶ月 | 個別見積 |
| Koncile | APIファーストの医療OCR | ✅ 良好 | ✅ | 数日 | 個別見積 |
| Tesseract | 無料のオープンソースベースライン | ❌ 低い | なし(セルフホスト) | 数時間(開発) | 無料 |
選定方法とテスト基準
医療文書の処理は、一般的なOCRとは問題の性質が異なります。請求書を完璧に処理できるツールでも、入れ子になった表を含む給付説明書、数値と文章の両方で結果が記載された検査レポート、またはコードの誤りが金銭的な影響を及ぼすCMS-1500請求書では、致命的な失敗をすることがあります。私たちは、医療分野に特化した5つの観点で各ツールを評価しました。
1. 医療用語とコーディングの精度
医療文書には、ICD-10コード、CPTコード、レベニューコード、LOINCラボ識別子、SNOMED CT臨床用語、NDC医薬品コードが含まれます。これらは厳密な構文パターンに従います。CPTコードは常に5桁、ICD-10コードは3〜7文字の英数字、レベニューコードは4桁の場所識別子です。CPTコードとレベニューコードを区別できないツールは、手動での再分類が必要な出力を生成します。私たちは、各ツールがこれらのコーディング構造を維持し、一般的な「コード」フィールドに統合してしまわないかを評価しました。
2. 手書き文字認識
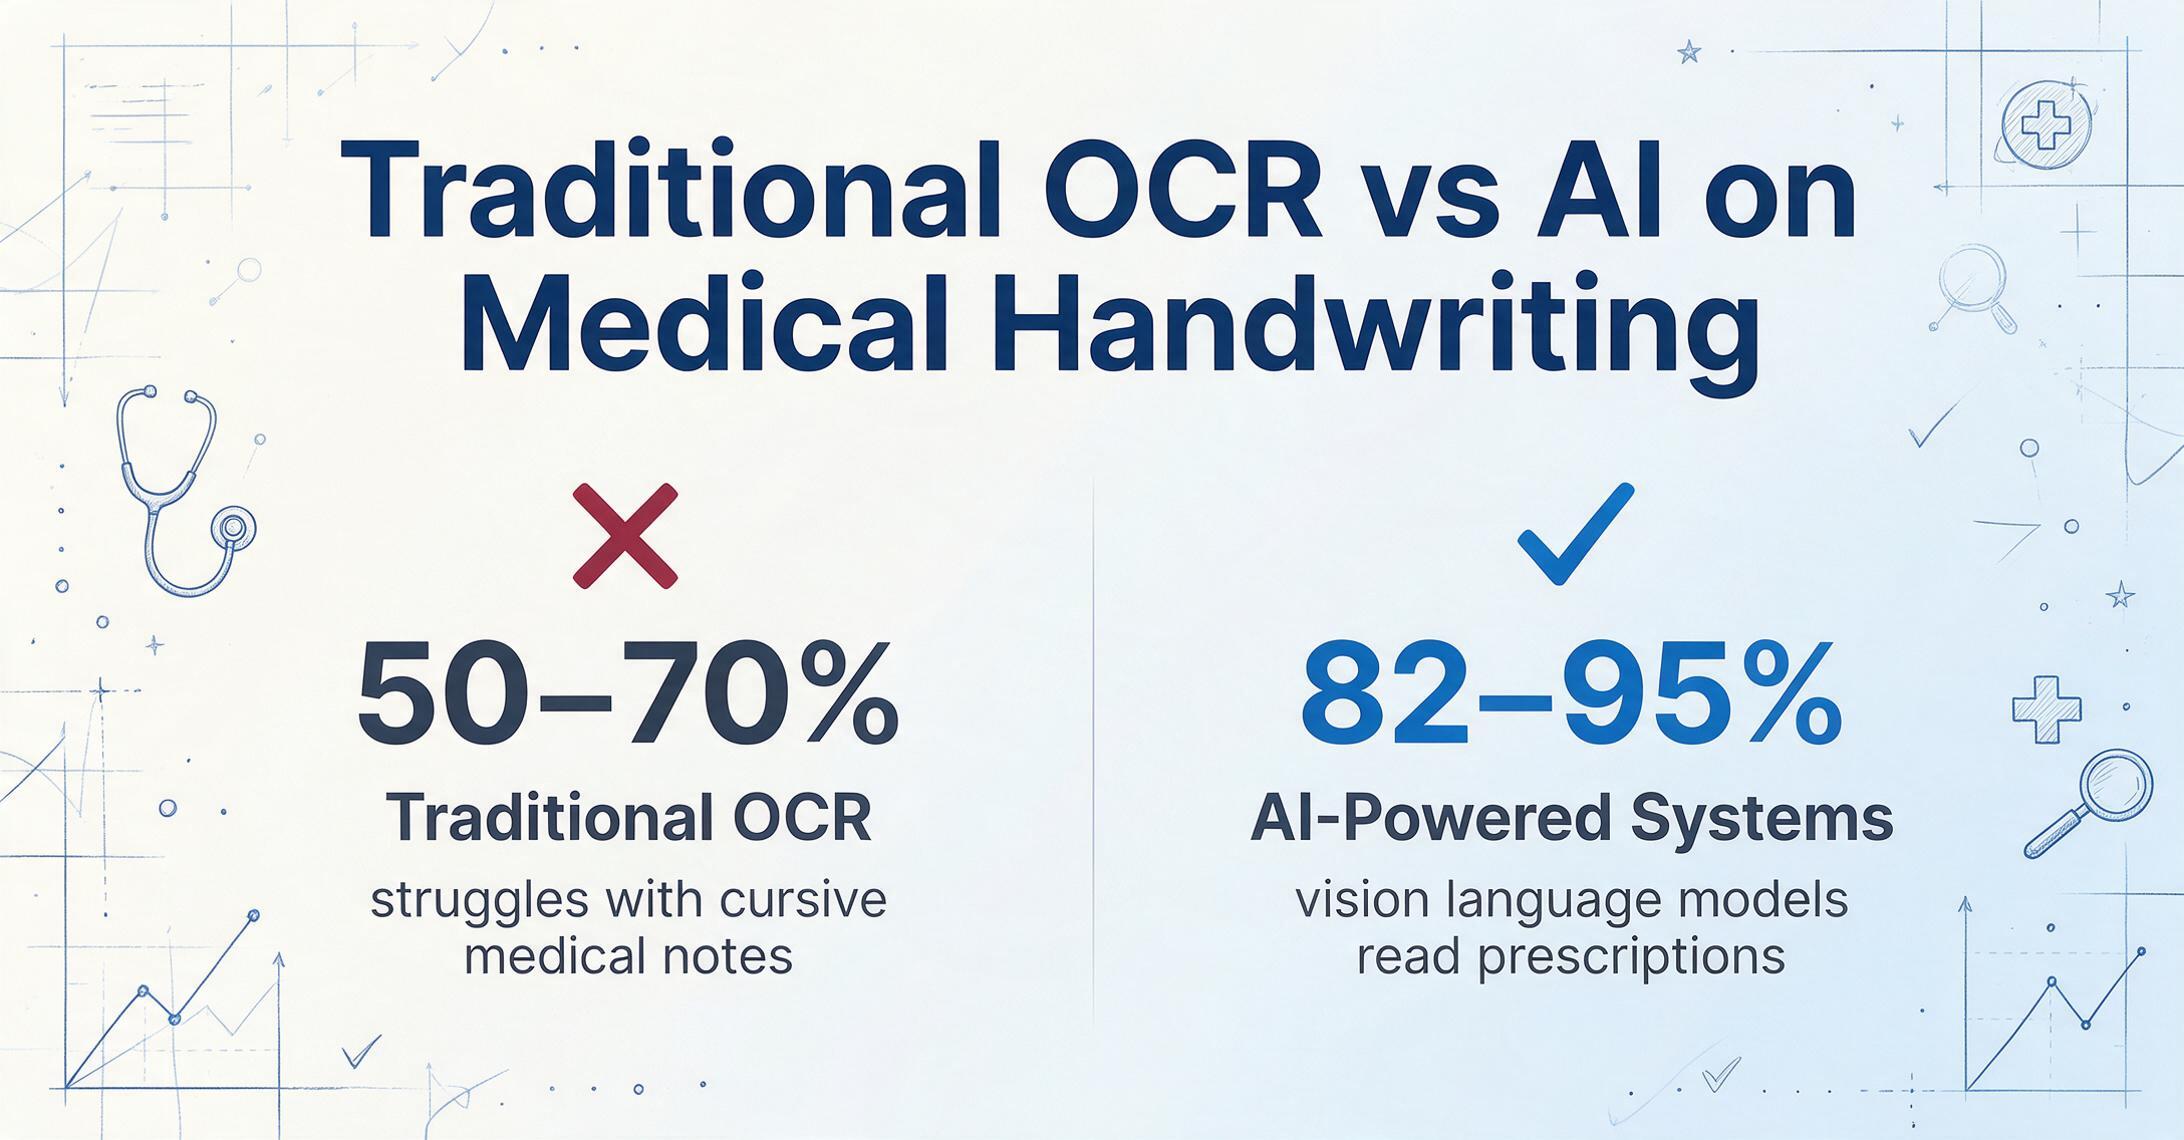
医師の手書き文字は、医療文書処理における有名なボトルネックです。欧州AI・機械学習ジャーナルに掲載された医療用処方箋のOCRに関する学術研究によると、従来型OCRは医療用手書き文字に対して約50〜70%の精度であるのに対し、AI搭載システムは82〜95%に達することが確認されています。私たちは、各ツールが筆記体の医療メモ、手書きの処方箋、欄外の臨床医の注釈をどのように処理するかを評価しました。印刷テキストのみを読み取れるツールは、実際の医療文書の表面積の約60%しかカバーできません。
3. HIPAAコンプライアンスとBAAサポート
HIPAAは特定のソフトウェアを認証するものではありません。コンプライアンスとは、ベンダーのセキュリティ対策、ポリシー、およびビジネスアソシエイト契約(BAA)に署名する意思の組み合わせです。公民権局(OCR)は2024年から2025年にかけて執行を大幅に強化しました。HIPAAの金銭的罰則は340%増加し、Advocate Healthは適切なBAAを欠いたビジネスアソシエイトに関連する情報漏洩により、555万ドルの和解金を支払いました。保護対象保健情報(PHI)を処理するツールには、署名済みBAAの保持は必須です。各ツールがBAAを提供するかどうか、そしてより重要なことに、提供しない場合についても指摘します。
4. EHRおよび診療管理システムとの統合
医療機関は特定のソフトウェアエコシステムで運用されています。Epicは大規模な病院システムを支配し、Oracle Cerner(現Oracle Health)はアカデミックメディカルセンターをカバーし、Meditechは地域病院にサービスを提供し、AthenahealthとeClinicalWorksは外来診療をリードし、KareoとAdvancedMDは小規模診療所にサービスを提供しています。Excelファイルを出力してもEHRワークフローにデータをプッシュできないツールでは、手動の中間ステップが必要になります。各ツールの統合の深さを評価しました。ネイティブなEHRコネクタから、開発者がHL7 FHIRパイプラインに組み込めるAPIファーストアーキテクチャまでです。
5. 導入モデルと価値実現までの時間
医療ITチームは慢性的に過負荷状態です。HIMSS 2025のデータによると、86%の医療システムが何らかの形でAIを利用していますが、診療提供に導入する準備ができているのはわずか18%です。そのギャップは意欲の問題ではなく、実装の余裕の問題です。各ツールを「初回抽出までの時間」(ノーコード、ブラウザベース)から「数か月にわたるエンタープライズ導入」(オンプレミスインストール、モデルトレーニング、ワークフロー設定)までのスペクトルで評価しました。最適な選択は、チームの技術的能力と問題の緊急性に依存します。
AIを活用した抽出が従来の文字認識とどう異なるかについて詳しく知りたい方は、AI OCRとは何か、その仕組みに関するガイドで、意味的抽出を可能にする技術的変革を取り上げています。OCRとは何かに関する完全ガイドは、従来のOCRの仕組みとその限界についての基礎的な理解を提供します。
ImageToTable.ai — 多様な医療文書に最適なノーコード抽出ツール
最適なケース: 医療チーム(クリニック管理者、医療請求スタッフ、保険請求処理担当者)で、テンプレート設定やモデル学習なしに多種多様な医療文書から構造化データを抽出する必要がある場合。不向きなケース: HIPAA準拠のための署名済みBAA、ネイティブEHR統合、またはオンプレミス展開を必要とする組織。
ImageToTable.aiは、人間と同じように文書を読む視覚言語モデルを使用します。つまり、各フィールドがページ上のどこにあるかではなく、何を意味するかを理解します。これは医療分野で重要です。なぜなら、医療文書はほぼどの業界よりもレイアウトのバリエーションが多いからです。ある病院システムの検査レポートでは患者名が左上にあり、別のシステムでは中央のヘッダーにあります。CignaのEOBは入れ子になったサマリーテーブルを使用し、UnitedHealthcareのものはフラットな明細リストを使用します。テンプレートベースのツールはこうした違いで機能しなくなりますが、セマンティック抽出はそうではありません。
カスタム列抽出が中核となる仕組みです。「CPTコード」「ICD-10 Dx」「レベニューコード」「患者名」「請求額」など、必要な列名を入力するだけで、AIがフィールドの意味を理解して各値を特定します。CPTコード(5桁の手技識別子)とレベニューコード(4桁の場所コード)を自動的に区別し、それぞれ正しい出力列に配置します。これは、種類に関係なくすべてのコードを単一の「コード」フィールドに出力するテンプレートベースのツールとは根本的に異なります。
このツールは、印刷テキスト、手書き、チェックボックス、表、署名を処理できます。バッチ処理は第一級の機能です。異なる保険会社のEOBを50件まとめてアップロードすると、一貫した列を持つ単一のExcelファイルが得られます。Google Sheetsアドオンを使用すると、Sheetsを離れることなく、文書をアップロードして結果をスプレッドシートに直接追加できます。処理時間は1ページあたり5〜10秒で、平均3分かかる手動データ入力と比較して18倍の改善です。EOBからExcelへのワークフロー(列の定義からマージされたバッチのエクスポートまで)の完全なチュートリアルについては、EOBをExcelに変換するガイドをご覧ください。
料金は、無料ティア(月間の抽出回数に制限あり)から始まり、その後$9/月(Basic)と$59/月(Pro)です。アカウント作成以外のセットアップは不要です。医療分野にとってのトレードオフは重要です。ImageToTable.aiは現在BAAを提供していないため、PHIのHIPAA準拠ベンダー処理を必要とするワークフローには適していません。非識別化された文書処理、PHIがサービスに送信されない内部管理用途、または自身のデータを扱う個人の医療専門家向けの生産性ツールとしてはうまく機能します。
Amazon Textract — 高ボリュームのAWSネイティブ医療パイプラインに最適
最適なケース: AWSに既に投資している医療機関で、大量の標準化された文書(申込書、請求書、保険証など)を処理し、抽出パイプラインを構築・維持できるDevOps体制を持つ組織。不向きなケース: AWSインフラの専門知識がないチームや、ターンキーなユーザーインターフェースを必要とするチーム。
Amazon Textractは、HIPAA対象となるAWSサービス(標準のAWS BAAを通じてBAAを取得可能)であり、コンプライアンス対応のクラウドインフラを必要とする医療機関にとって、最も簡単な選択肢の一つです。スキャン文書からテキスト、手書き文字、フォーム、表を抽出します。Change HealthcareはTextractを使用して1,600万ページ以上を処理し、文書あたりの処理時間を3分から1分未満に短縮、68%の自動化率を達成したと、AWSの顧客事例で報告されています。
TextractはAWS HealthLake、Amazon Comprehend Medical(PHI検出と医療エンティティ抽出用)、その他のAWSサービスとネイティブに統合されており、カスタム医療自動化の強力な基盤となります。印刷テキストと手書き文字の両方を処理し、標準化されたフォームでは高い精度を発揮します。ただし、TextractはAPIのみで、文書のアップロードや結果確認のためのグラフィカルインターフェースはありません。HIPAAコンプライアンスは、AWS環境の手動設定(暗号化、アクセス制御、監査ログ)が必要であり、デフォルトではありません。価格はページ単位で、ボリュームによって変動します。大規模利用では、最もコスト効率の高い選択肢の一つです。
Google Document AI — GCPベースの医療ワークフローに最適
最適なケース: Google Cloudを利用する医療チームで、一般的な医療文書向けの事前学習済みプロセッサと、人間によるレビューオプションを必要とする場合。不向きなケース: GCPエコシステム外のチームや、多様なカスタムフォームタイプを処理する場合。
Google Document AIは、請求書、領収書、W-2、身分証明書向けの事前学習済みプロセッサに加え、AutoML層によるカスタム抽出器のトレーニング機能を提供します。Vertex AIおよびGeminiとの統合により、抽出データの要約や推論が可能になり、臨床試験データ抽出、医療記録の要約、患者受付自動化に有用な機能です。GoogleはGCPサービス向けにBAAを提供しており、Document AIをHIPAA対象ワークロードで利用できます。
ここでの強みは、より広範なGoogleエコシステムです。Document AIはBigQuery(分析用)、Healthcare API(FHIRネイティブなデータ交換用)、Vertex AI(カスタムモデル開発用)にシームレスに連携します。制限としては、事前学習済みプロセッサがカバーする文書タイプが固定されていることです。特定の医療フォーム(地域の病院システム独自の検査レポートレイアウトなど)には、カスタムトレーニングが必要です。価格はOCR処理とGenAI機能を組み合わせたもので、多段階の抽出パイプラインでは大規模利用時に複雑になる可能性があります。
Azure Document Intelligence — Microsoft中心の医療システムに最適
最適なケース: Microsoftインフラ(Active Directory、Office 365、Dynamics 365)上で運用し、HIPAA準拠の文書処理と強力なガバナンス管理を必要とする医療機関向けです。 不向きなケース: Azureの経験がないチームや、ノーコードの抽出インターフェースを必要とするチームには不向きです。
Azure Document Intelligence(旧Form Recognizer)は、一般的な文書タイプ向けのプリビルトモデルと、Azure AIによるカスタム抽出機能を提供します。適切に構成すればMicrosoftのBAAに基づきHIPAA準拠となり、Azureのロールベースのアクセス制御、監査ログ、暗号化フレームワークと統合されます。これは、すでにMicrosoftのコンプライアンス境界内でPHIを管理している組織にとって自然な強みです。
Azure DIは、印刷テキスト、手書き文字、表、キーと値のペアを処理します。プリビルトモデルは、請求書、領収書、身分証明書、健康保険証に対応しています。検査レポートやEOBなどの医療特有の文書には、通常カスタムモデルのトレーニングが必要です。このプラットフォームは.NET、Python、REST APIをサポートしており、Microsoft中心の開発チームにとって使いやすい設計です。料金は1ページあたりの従量課金制で、ボリュームディスカウントがあります。
Azure Document Intelligenceを見る →
ABBYY Vantage — 規制の厳しい医療向けエンタープライズIDPの最適解
最適なケース: 成熟したローコードの文書処理プラットフォームと、事前トレーニング済みスキル、包括的なコンプライアンス機能を必要とする大規模な医療システムや保険会社向けです。 不向きなケース: 導入サイクルなしで迅速なテンプレート不要の抽出を必要とする小規模な診療所やチームには不向きです。
ABBYYはOCRおよびインテリジェント文書処理の歴史的リーダーの1つであり、医療を含む規制産業全体で使用されているプラットフォームです。ABBYY Vantageは、特定の文書タイプ向けの事前トレーニング済み「スキル」(抽出モデル)、カスタムフォーム用のローコードスキルビルダー、ECMシステムおよびERPプラットフォーム向けの統合コネクタを提供します。手書き文字認識にも対応していますが、密度の高い筆記体の医療メモの精度は、新しいAIネイティブツールと比較すると中程度です。
ABBYYはBAAを提供しており、医療分野での導入実績が豊富です。その強みは幅広さにあります。請求書、保険請求、患者フォーム、臨床試験文書、医療提供者とのやり取りを単一のプラットフォームでカバーできます。トレードオフとして、導入には通常数週間から数か月かかり、料金はカスタム見積もりでエンタープライズグレード(年間5桁以上)であり、文書形式の変更に応じて抽出スキルを維持するための専任の管理作業が必要です。専任の文書処理チームを持つ大規模組織にとって、ABBYY Vantageは実績のある選択肢です。
Nanonets — カスタム学習型ニッチ医療文書モデルに最適
最適なケース: 特定の安定した医療文書タイプを大量に処理し、専用モデルのトレーニングと維持にリソースを割ける組織。不向きなケース: 多種多様な文書レイアウトに対してセットアップ不要の抽出を必要とするチーム。
Nanonetsは、医療フォーム、保険書類、診療記録などの文書カテゴリにわたる300以上の事前学習モデルを備えたAI OCRプラットフォームを提供します。中核となる差別化要因はトレーニングパイプラインです。ユーザーがサンプル文書(通常フォーマットごとに20〜50件)をアップロードし、フィールドにラベルを付け、プラットフォームがカスタム抽出モデルをトレーニングします。50の提携クリニックから同じ検査レポート形式を処理する病院システムにとって、これは高い精度を実現できます。Nanonetsはエンタープライズ顧客向けにBAAを提供し、クラウドとオンプレミスの両方のデプロイをサポートしています。
制限事項は、新しい文書形式ごとに新しいトレーニングサイクルが必要になることです。5つの異なる病院システムから検査レポートを受け取るクリニックは、5つのラベル付きトレーニングセットが必要です。20の異なる保険プランからEOBを処理する医療請求チームは、20回のトレーニング反復が必要です。安定した大量のフォーマットでは、初期投資は報われます。多様で変動する文書ミックスでは、トレーニング保守コストが蓄積されます。価格は無料ティア(ページ数制限付き)から始まり、カスタムエンタープライズプランまで拡張されます。
LlamaParse(LlamaIndex) — 開発者主導のヘルスケアAI製品に最適
最適なケース: エージェント型ヘルスケアアプリケーション(臨床アシスタント、自動医療コーディングパイプライン、研究統合ツールなど)を構築するエンジニアリングチームで、フィールドレベルの信頼度スコアとソース引用を備えた深い文書理解を必要とする場合。不向きなケース: 文書処理用のグラフィカルインターフェースを必要とする非技術系ヘルスケアチーム。
LlamaParseは文書処理にエージェント型アプローチを採用しています。脆弱なテンプレートやレイアウトベースの抽出ではなく、マルチモーダルAIを使用して文書構造、表、手書き、チャートを理解し、フィールドレベルの信頼度スコア付きの構造化データを抽出します。RAGパイプライン用のより広範なLlamaIndexエコシステムと統合されており、自社の医療データ上で文書対応AI製品を構築する組織に最適です。
このプラットフォームはスキーマベースの抽出(LlamaExtract)をサポートしており、必要なフィールド(MRN、ICD-10コード、薬剤名、検査値、投与量)を定義すると、AIが監査可能性のためのページレベルの引用付きでそれらを抽出します。LlamaIndexはエンタープライズ顧客向けにBAAを提供し、クラウドとセルフホストの両方のデプロイをサポートしています。トレードオフは、APIファーストでSDKベース(Python + TypeScript)であり、ノーコードインターフェースがないことです。価格は評価用の無料ティアから始まり、エンタープライズ向けカスタム見積もりまで拡張されます。
Docsumo — 医療保険の管理業務と請求処理に最適
最適なケース: 健康保険会社、第三者管理者(TPA)、および大量の定型フォーム、請求書類、保険書類を処理するバックオフィスの医療請求チーム。 不向きなケース: 手書きの医師メモや複雑な検査レポートからの臨床文書抽出。
Docsumoは汎用インテリジェント文書処理プラットフォームであり、医療管理で一般的な定型・半定型文書(請求フォーム、給付説明書、資格確認書類、保険申込書など)に優れています。一般的な文書タイプ向けの事前学習モデル、組み込みの検証ルール、APIおよびWebhookによるワークフロー統合を提供します。医療機関向けにBAAも利用可能です。
Docsumoの強みは医療の管理業務側にあります。安定したレイアウトの請求フォームを毎月10,000件処理する健康保険会社にとって、信頼性の高いストレートスルー処理を実現します。手書き文字認識はAIネイティブなツールと比較して限定的であるため、手書きの処方箋や臨床メモには適していません。価格はカスタム見積もりで、文書量に基づいて決定されます。
Hyland OnBase — ヘルスケアキャプチャ機能を備えた最適なエンタープライズ文書管理
最適なケース: 文書管理、キャプチャ、ワークフロー、コンプライアンスを統合した統一エンタープライズコンテンツサービスプラットフォームを必要とする大規模医療システム。OCRはより広範なインフラストラクチャ内の1コンポーネントとして機能します。 不向きなケース: 大規模なECM導入なしに、スタンドアロンの文書抽出ツールを必要とするチーム。
Hyland OnBaseは、医療分野への深い浸透を誇る成熟したエンタープライズコンテンツサービスプラットフォームです。文書キャプチャ、インデックス作成、保存、ワークフロー自動化、情報公開管理を提供し、すべてBAA付きのHIPAA準拠フレームワーク内で実現します。キャプチャモジュールはOCRを使用してスキャン文書を分類・データ抽出し、適切な臨床または管理ワークフローにルーティングします。
OnBaseは、患者記録、EOB、管理文書のスキャンとインデックス作成のために数百の病院で使用されています。Redditのr/healthITユーザーは、「onbaseを使用してバルクスキャン/ファックスをカルテにインデックス作成する」ことを、手動だが柔軟なワークフローの一部として説明しています。トレードオフとして、OnBaseは大規模なエンタープライズプラットフォームであり、導入に数か月かかり、コストはカスタム見積もりで通常6桁に達し、手書き文字認識は基本的なレベルです。これは抽出機能を備えたコンテンツ管理への投資であり、抽出ファーストのツールではありません。
Kofax — 大規模なエンタープライズ文書取り込みに最適
最適なケース: 自動化された取り込みワークフロー(検証・分類機能付き)で毎月数百万ページを処理する大規模な医療機関やビジネスプロセスアウトソーサー向けです。 不向きなケース: 小規模なクリニック、個人開業医、または軽量な抽出ツールを必要とするチームには不向きです。
Kofax(Tungsten Automationの一部)は、AIを活用した分類、抽出、検証を備えたエンタープライズ向けインテリジェント文書取り込みを提供します。そのプラットフォームは、受付での患者受け入れスキャンから請求サイクル部門でのEOB処理まで、医療ワークフロー全体にわたって文書をスキャン、分類、データ抽出、ルーティングします。KofaxはBAAを提供しており、医療分野での豊富な導入実績があります。
このプラットフォームの強みは、大量の自動取り込み処理です。1日あたり50,000ページをスキャンし、文書タイプを自動分類し、主要フィールドを抽出して、下流システムへのルーティング前にビジネスルールに照らして検証します。トレードオフは複雑さです。Kofaxの導入には通常、プロフェッショナルサービス、数か月にわたる設定、そして多大な設備投資が必要です。手書き文字認識は限定的です。エンタープライズ規模に満たない組織にとっては、過剰な機能と言えます。
Koncile — 処方箋と医療文書に最適なAPIファーストの医療用OCR
最適なケース: 処方箋とフランス語/GDPR準拠の医療文書処理に強みを持つ、APIファーストのOCRサービスを必要とする医療テクノロジー企業やデジタルヘルスプラットフォーム向けです。 不向きなケース: ノーコード抽出やEpic/Cernerとの深いEHR統合を必要とする米国中心のチームには不向きです。
Koncileは、主に欧州市場向けに構築された医療特化型のAI OCRプラットフォームであり、処方箋、医療レポート、臨床文書に強い性能を発揮します。既製の医療用抽出モデルとAPIファーストのアーキテクチャを備えており、デジタルヘルス製品や調剤自動化プラットフォームへの統合に適しています。KoncileはGDPRに基づくBAA相当の契約を提供し、データをフランス国内のサーバーにホストしています。
その手書き文字認識は、処方箋の表記を含む医療用手書きサンプルに特化したトレーニングにより、一般的なOCRツールよりも強力です。トレードオフは地理的な側面です。Koncileの文書トレーニングは欧州の医療フォーマットに最も強く、その統合エコシステムには米国固有のEHRシステムが含まれていません。価格はカスタム見積もりで、ボリュームベースです。
Tesseract — 最高の無料オープンソースOCRベースライン
最適な用途: カスタム医療文書処理パイプラインを構築する開発者で、印刷テキスト抽出の出発点として無料で自己ホスト型のOCRエンジンを必要とする方。 不向きな用途: 手書き文字、複雑なレイアウト、構造化データ抽出、または追加のセキュリティ強化なしでの直接的なPHI処理を伴う医療ワークフロー。
Tesseractは最も広く使用されているオープンソースOCRエンジンで、2006年からGoogleによってメンテナンスされています。バージョン5(2024年リリース)ではLSTMベースのニューラルネットワーク認識が追加され、クリーンな印刷テキストでの精度が向上しました。100以上の言語をサポートし、特定の文書タイプ向けにカスタマイズおよび拡張が可能です。
医療分野では、Tesseractの価値はクリーンでコントラストの高い文書の印刷テキストに限定されます。手書き文字の能力は最小限で、学術研究によると医療手書き文字でのTesseractの精度は約64%であり、構造化データ抽出機能はありません。Tesseractによって抽出されたICD-10コードは、フィールドラベルなしのフラットなテキストブロックに格納されるため、各コードを識別してルーティングするには追加の処理が必要です。TesseractにはデフォルトでBAA、監査ログ、PHI処理インフラストラクチャがありません。HIPAA準拠の使用には、展開組織がその周囲にセキュリティ制御を構築する必要があります。これはカスタムパイプラインの有用なコンポーネントであり、スタンドアロンの医療OCRソリューションではありません。
あなたの医療機関に適したツールはどれですか?
医療は単一のワークフローではなく、規制枠組みを共有する多種多様な文書処理問題の集合体であるため、1つのツールがすべての医療OCRニーズに適合するわけではありません。ここでは、あなたの状況に適したツールカテゴリをマッチングする方法を説明します。
小規模クリニックまたは個人開業を運営している場合
患者受付フォーム、保険証、および適度な量のEOBを処理しています。ITチームがなく、数分で動作するものが必要です。 ImageToTable.ai は、セットアップなしでスキャンしたフォームを構造化データに変換するための最も実用的なオプションです。クラウドを通じたPHIのHIPAA準拠処理には、BAA付きの Google Document AI または Azure Document Intelligence が、クラウドアカウントを設定する管理帯域がある場合に有効です。完全に無料ですが制限のあるオプションとして、GUIラッパーを介した Tesseract はクリーンな文書の印刷テキストを処理できますが、すべての出力を検証する必要があります。
中規模の医療グループまたは外来ケアネットワークを運営している場合
Athenahealth、eClinicalWorks、KareoなどのEHRを使用している場合、月間の文書量は数千件に上ります — EOB、紹介状、複数の検査機関からの検査レポートなどです。フォーマットの多様性への対応が必要ですが、専任のデータエンジニアリングチームがないかもしれません。ImageToTable.aiはフォーマットの多様性に強く、テンプレート設定は不要です。BAA保護が必要な場合は、管理文書にはDocsumo、高ボリュームで安定したフォーマットの文書にはNanonetsが適しています。技術リソースがあれば、Google Document AIのHealthcare APIでFHIRへの橋渡しも可能です。
大規模な医療システムまたは病院ネットワークで働いている場合
Epic、Oracle Cerner、Meditechを使用している場合、年間で数百万ページを処理しています — 患者記録、保険請求、臨床試験文書、医療機関間のやり取りなどです。IT部門とコンプライアンス部門があります。Hyland OnBaseやKofaxは、大規模な病院ワークフローへの実績ある統合を備えた、確立されたエンタープライズ向けのキャプチャ+コンテンツ管理ソリューションです。ABBYY Vantageは、ローコードのスキル構築を備えた抽出特化型の代替案を提供します。Amazon TextractをAWS HealthLake FHIRパイプラインに組み込むと、DevOps能力を持つ組織にとって最もスケーラブルなクラウドネイティブな選択肢となります。
健康保険会社またはTPAで働いている場合
中核となるOCRニーズは請求処理です — CMS-1500、UB-04、遭遇データ、EOBなど — 高ボリュームで一貫したフォーマットのものです。DocsumoとNanonetsはどちらも保険文書のフォーム処理に強みがあります。AWS医療インフラ上のAmazon Textractは、コストの予測可能性を備えた非常に高いスループットを処理できます。ABBYY Vantageは、受付から審査支援まで請求ライフサイクル全体をカバーします。
ヘルスケア技術製品を開発している場合
OCRのニーズは、臨床アシスタント、医療コーディング自動化ツール、患者向け健康データ製品など、ご自身のアプリケーションに組み込まれています。LlamaParseは、スキーマガイド抽出とフィールドレベルの信頼度スコアを備えた、最も先進的な開発者ツールキットを提供します。Amazon Textractは、実績のある高容量APIです。Azure Document Intelligenceは、.NETスタックとの統合に優れています。Koncileは、GDPR準拠の欧州ヘルスケアユースケース向けの専門オプションです。
無料オプションやオープンソースの代替手段を含むOCRのより広い全体像については、最高の無料OCRソフトウェアガイドと最高のオープンソースOCRツール比較をご覧ください。手書きの医療文書が主な課題である場合(多くのヘルスケアチームにとってそうであるように)、専用の手書きOCRまとめでその特定の機能について詳しく説明しています。ここで取り上げていないエンタープライズツールを含む一般的な概要については、2026年の最高のOCRソフトウェアで全体像を把握できます。
よくある質問
OCRツールがHIPAA準拠であるための条件は?
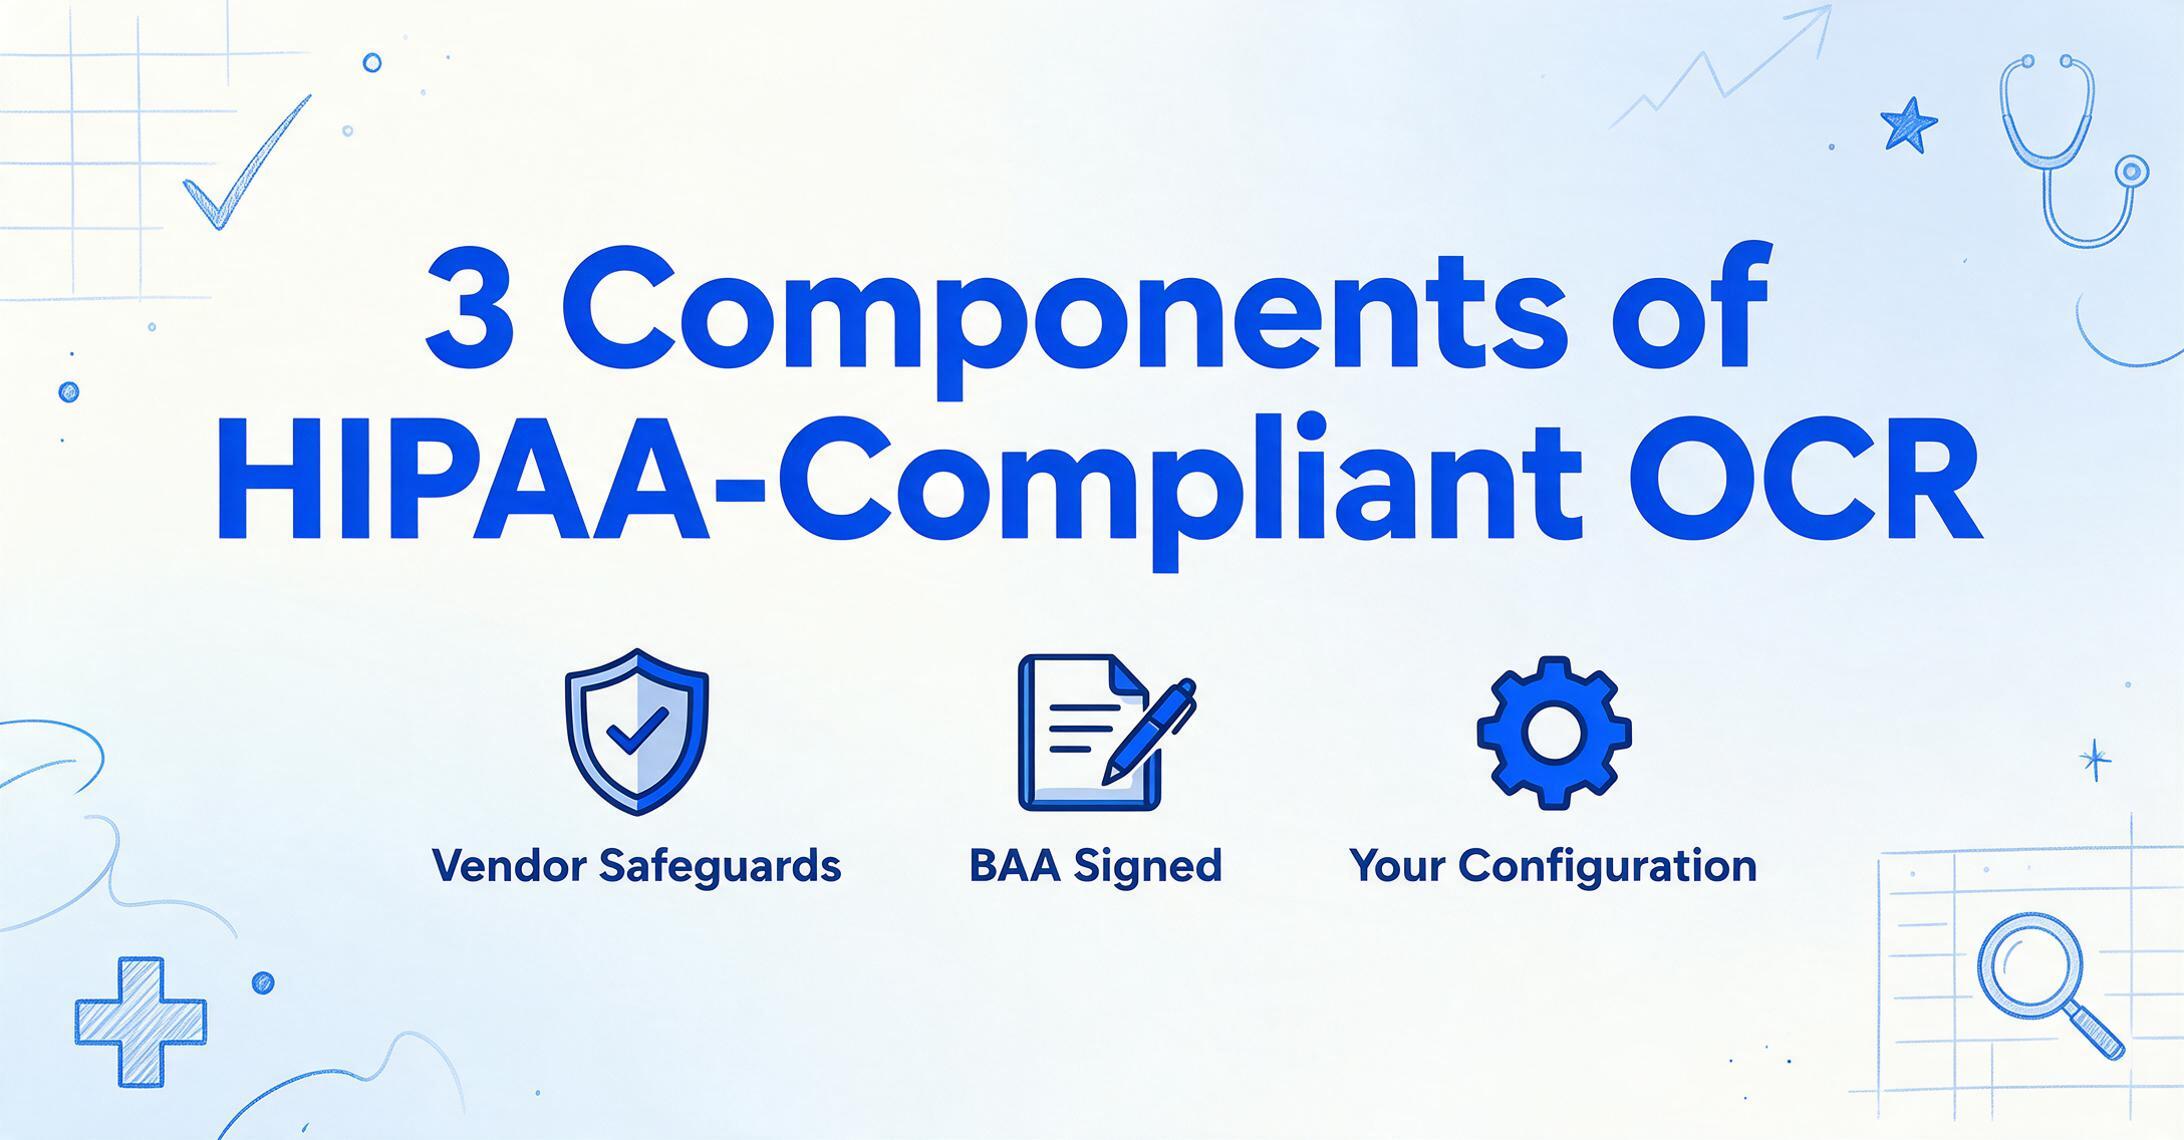
OCRソフトウェアのHIPAA準拠には、3つの要素が連携して機能する必要があります。第一に、ベンダーが強力なセキュリティ保護対策を維持していることです。保存時および転送時の暗号化、ロールベースのアクセス制御、包括的な監査ログ、明確なPHI取り扱いポリシーなどです。第二に、ベンダーがビジネスアソシエイト契約(BAA)に署名し、お客様に代わって処理するすべてのPHIについて、HIPAAのプライバシー規則およびセキュリティ規則の要件に契約上拘束されることです。第三に、お客様の組織が自社のHIPAA準拠プログラム内でツールを設定・運用することです。BAAがあっても、PHIを暗号化されていない場所に保存するようにツールを設定したり、許可のないユーザーにアクセス権を付与したりすれば、ワークフローが準拠することにはなりません。公民権局は、550万ドルのAdvocate Health和解を含む執行措置を通じて、ベンダー契約と運用管理の両方が整っている必要があることを明確にしています。
OCRは医師の手書き文字を正確に読み取れますか?
これは医療OCRで最もよく聞かれる質問であり、正直な答えは「手書きの質とツールによります」です。従来のOCRは医療用手書きテキストに対して約50〜70%の精度です。最新のAI搭載ツール(視覚言語モデルを含む)は医療用手書きで82〜95%に達します。これは大きな改善ですが、印刷テキストの精度には及びません。最良の結果は、医療用手書きサンプルで特別に訓練されたツール、または意味的文脈を理解する視覚言語モデルに基づくツールから得られます(「Dx:」の後の5文字の文字列は、1文字があいまいでも診断コードである可能性が高い)。手書き文字で99%の精度を達成するOCRツールはありません。投薬名、用量、診断コードなどの重要な臨床データについては、必ず元の文書と照合する人的検証の時間を確保してください。当社の手書きOCR総まとめでは、このトピックを詳しく取り上げています。
OCRは医療文書からCPTコードとICD-10コードを抽出できますか?
はい、ただし抽出品質は、ツールがコード構造を理解しているか、単に生のテキストを読み取っているかによって異なります。意味的抽出を使用するAI搭載ツールは、コードタイプを区別できます。CPTコードは5桁の数字識別子(99213、93000)、ICD-10コードは英数字文字列(E11.9、I10)、レベニューコードは4桁の場所識別子(救急外来は0450)、NDC医薬品コードは11桁の識別子です。各コードタイプを正しい出力列にマッピングするツールは、すべてのコードを単一のテキストフィールドに出力するツールよりも、医療請求や保険金処理の下流工程ではるかに有用です。各コードタイプに個別の列を定義してください。「CPTコード」「ICD-10診断」「レベニューコード」「NDC」のように、意味タイプに基づいてツールが振り分けられるようにします。
OCRはEpic、Cerner、Meditechと連携しますか?
OCRツールにおいて、EHRへの直接統合は一般的ではなく例外です。ほとんどのツールは構造化データをExcel、CSV、JSONとして出力し、それを別のインターフェースまたはAPIレイヤーを通じてEHRにインポートする必要があります。Hyland OnBaseやKofaxなどのエンタープライズプラットフォームには、主要なEHRシステム向けの構築済みコネクタがあります。これらは臨床記録を包み込むコンテンツ管理プラットフォームとして機能するためです。Amazon TextractなどのクラウドAPIツールは、AWS HealthLakeのFHIR APIと統合し、そこからEHRに接続できます。ほとんどのノーコードOCRツールでは、ワークフローは次のとおりです。データをスプレッドシートに抽出 → 検証 → EHRにアップロードまたはインポート。この中間ステップは理想的ではありませんが、ほとんどの医療機関にとって現実的な方法です。
ヘルスケア文書向けの無料OCRツールはありますか?
Tesseractは無料でオープンソースですが、ヘルスケア分野での実用的な限界は顕著です。手書き文字への対応は最小限で、構造化データの抽出はできず、PHIのセキュリティ基盤もなく、開発者専用のインターフェースしかありません。Google Driveの内蔵OCRは無料で、スキャンした医療文書から検索可能なPDFを生成できますが、出力はフラットなテキストのみで、フィールドラベル付きの構造化データは生成されません。ImageToTable.aiは限定回数の無料枠を提供しており、有料プランに commit する前に、お使いの文書でセマンティック抽出が機能するかテストするのに役立ちます。無料オプションの包括的な比較については、最高の無料OCRソフトウェアガイドをご覧ください。
OCRは給付説明書のネストされた表を処理できますか?
EOBのネストされた表は、従来のOCRにとって最も難しい文書タイプの1つです。単一の表セルに金額とコード化された説明の両方が含まれ、親の明細行の下にサブ行がインデントされることがあるからです。テンプレートベースのツールは通常、これらを行ごとに単一のテキストブロックに平坦化し、階層構造を失います。レイアウト理解を備えたAI搭載ツールは、主要な請求項目とその調整項目の間の親子関係を識別できるため、はるかに優れたパフォーマンスを発揮します。重要なのは、EOBの構造に一致する列を定義することです。「請求額」「許可額」「保険支払額」「患者負担額」「調整コード」—そして、固定のグリッド座標を読むのではなく、文書の論理階層内での位置を理解して各値をAIにマッピングさせることです。複数の保険者に対応するEOBや請求フォーマットを抽出ツールがどう処理するか詳しく知りたい方は、ヘルスケア文書抽出ツールのまとめをご覧ください。医療文書タイプ全体にわたる基礎的なOCRメカニズムについては、ヘルスケア向けOCRガイドで文書スペクトラム全体をカバーしています。
手書きの処方箋の処理はどうですか?
手書きの処方箋は、読み間違えた場合の結果が管理的なものではなく臨床的なものになるため、OCRにとって独特の課題となります。投薬量や薬剤名の読み間違いは、患者の安全に直接影響を与える可能性があります。処方箋処理に関するOCRの学術研究によると、従来のOCRは処方箋の手書き文字に対して約50〜70%の精度を達成する一方、医療サンプルでトレーニングされたAIシステムは82〜95%に達します。薬局や処方箋処理業者にとって最も実用的なアプローチは、「Metf」はおそらく「Metformin」であることを理解するなど、文脈的に手書き文字を読めるAI搭載ツールと、すべての処方箋に対する薬剤師の検証ステップを組み合わせることです。処方箋調剤のワークフローにおいて、OCRツールを唯一のチェック手段にしてはいけません。臨床リスクが高すぎます。
医療現場でOCRを導入するにはどのくらいの時間がかかりますか?
導入期間はツールの種類によって桁違いに異なります。ノーコードツール(ImageToTable.aiなど):初回抽出まで数分。クラウドAPIツール(Amazon Textract、Google Document AI、Azure Document Intelligenceなど):API統合に数時間から数日、さらにHIPAA準拠のインフラ設定に追加時間が必要。学習ベースのプラットフォーム(Nanonetsなど):数日から数週間。ラベル付きサンプルが必要な文書形式の数とトレーニングパイプラインの反復回数に依存します。エンタープライズプラットフォーム(ABBYY Vantage、Hyland OnBase、Kofaxなど):数ヶ月。プロフェッショナルサービスの契約、ワークフロー設定、統合開発、コンプライアンス検証が含まれます。HIMSS 2025のデータによると、AIツールをケア提供に導入する準備ができていると報告した医療システムはわずか18%です。そのギャップは技術の利用可能性ではなく、実装のキャパシティにあります。導入期間が自組織の吸収能力に合ったツールを選んでください。
結論
2026年の医療文書処理は、2つのギャップの物語です。技術ギャップ(AI搭載ツールが実際にできることと、医療チームができると信じていることの差)は急速に縮まっています。視覚言語モデルは現在、医療用手書き文字を読み取り、CPTコードとICD-10コードをその構造で区別し、テンプレートなしで複雑なEOB表からデータを抽出できます。実装ギャップ(技術的に可能なことと、医療機関が導入するキャパシティを持つことの間の溝)は、依然として制約となっています。
医療機関に適したOCRツールとは、その導入モデルがチームの技術力に合致し、抽出アプローチが文書の多様性に適合するものです。文書が標準化されており、ボリュームが多い場合は、学習ベースまたはエンタープライズプラットフォームが予測可能な精度を提供します。文書が時間ごとに異なる場合(異なる保険会社、異なる検査機関、異なる診療所)は、セマンティックでテンプレート不要のアプローチにより、あらゆる形式のバリエーションに対して抽出設定を維持する手間が省けます。また、手書きの臨床データ(処方箋、医師のメモ、注釈付き検査レポート)を処理する場合は、手書き文字認識機能を「あると便利な機能」ではなく、必須の評価基準にしてください。
まずは、チームが実際に処理する文書(完璧な文書ではなく、扱いにくい文書)で1つのツールをテストすることから始めてください。実際の書類を抽出可能にしてくれるツールこそ、使用すべきツールです。