El mejor software OCR para el sector salud 2026:
12 herramientas para documentos médicos probadas
Esta guía evalúa 12 herramientas de OCR y extracción de documentos con IA según cinco criterios que importan específicamente a los equipos de salud: precisión en terminología médica y sistemas de codificación, capacidad de reconocer escritura a mano en notas clínicas y recetas, preparación para el cumplimiento HIPAA, integración con EHR y sistemas de gestión de consultas, y el ajuste honesto de cada herramienta a los distintos tamaños y capacidades técnicas de las organizaciones de salud. Cada cifra de precios proviene de la página pública del proveedor a junio de 2026. Divulgación: ImageToTable.ai está incluida en esta comparativa. No tengo afiliación con ninguna otra herramienta listada. Cada enlace externo apunta al sitio web del proveedor para que puedas verificar las afirmaciones de forma independiente.
Conclusiones clave
- Cada herramienta de OCR para salud de esta lista afirma una precisión del 95%, pero ese punto de referencia se probó en facturas mecanografiadas limpias, mientras que tu pila diaria real incluye EOB con tablas resumen anidadas y recetas escritas en cursiva por un médico que iba tarde a sus rondas.
- La característica que determina si el OCR te ahorra tiempo o te lo hace perder es la discriminación por tipo de código, porque una herramienta que colapsa los códigos de procedimiento CPT y los códigos de diagnóstico ICD-10 en una sola columna de Código crea un paso manual de reclasificación que borra cada segundo que la extracción te ahorró.
- Omite la comparación de porcentajes de precisión y pregunta si la herramienta firma un BAA para tu carga de trabajo HIPAA y si puede leer la escritura a mano que tus médicos realmente producen a las 11pm en una clínica ocupada.
Tabla comparativa rápida
| Herramienta | Ideal para | Escritura a mano | BAA disponible | Configuración | Precio inicial |
|---|---|---|---|---|---|
| ImageToTable.ai | Extracción sin código para diversos documentos médicos | ✅ Fuerte | ❌ | Minutos | Gratuito / $9/mes |
| Amazon Textract | Pipelines nativos de AWS de alto volumen | ✅ Buena | ✅ | Horas–días | Pago por página |
| Google Document AI | Analizadores sanitarios basados en GCP | ✅ Buena | ✅ | Horas–días | Pago por página |
| Azure Document Intelligence | Sistemas de salud centrados en Microsoft | ✅ Buena | ✅ | Horas–días | Pago por página |
| ABBYY Vantage | IDP empresarial con habilidades low-code | ✅ Moderada | ✅ | Semanas | Cotización personalizada |
| Nanonets | Modelos entrenados a medida para formatos específicos | ✅ Moderada | ✅ | Días–semanas | Gratuito / personalizado |
| LlamaParse (LlamaIndex) | Productos de IA sanitaria liderados por desarrolladores | ✅ Fuerte | Empresarial | Horas | Gratuito / personalizado |
| Docsumo | Procesamiento de documentos administrativos y de seguros | ⚠️ Limitada | ✅ | Días | Cotización personalizada |
| Hyland OnBase | DMS empresarial con captura | ⚠️ Limitada | ✅ | Meses | Cotización personalizada |
| Kofax | Captura de documentos empresarial a gran escala | ⚠️ Limitada | ✅ | Meses | Cotización personalizada |
| Koncile | OCR sanitario API-first | ✅ Buena | ✅ | Días | Cotización personalizada |
| Tesseract | Base de referencia gratuita de código abierto | ❌ Mala | N/A (autogestionado) | Horas (desarrollo) | Gratuito |
Cómo seleccionamos y probamos
El procesamiento de documentos sanitarios no es el mismo problema que el OCR de propósito general. Una herramienta que maneja facturas a la perfección puede fallar estrepitosamente con una Explicación de Beneficios con tablas anidadas, un informe de laboratorio con resultados tanto numéricos como narrativos, o un formulario de reclamación CMS-1500 donde los errores de codificación tienen consecuencias financieras reales. Evaluamos cada herramienta según cinco dimensiones específicas del sector sanitario.
1. Precisión en terminología médica y codificación
Los documentos sanitarios contienen códigos de diagnóstico ICD-10, códigos de procedimiento CPT, revenue codes, identificadores de laboratorio LOINC, términos clínicos SNOMED CT y códigos de fármacos NDC. Estos siguen patrones sintácticos precisos: los códigos CPT siempre tienen cinco dígitos, los códigos ICD-10 son cadenas alfanuméricas de tres a siete caracteres, y los revenue codes son identificadores de ubicación de cuatro dígitos. Una herramienta que no puede distinguir un código CPT de un revenue code produce resultados que requieren una reclasificación manual. Evaluamos la capacidad de cada herramienta para preservar estas estructuras de codificación sin colapsarlas en campos genéricos de «Código».
2. Reconocimiento de escritura a mano
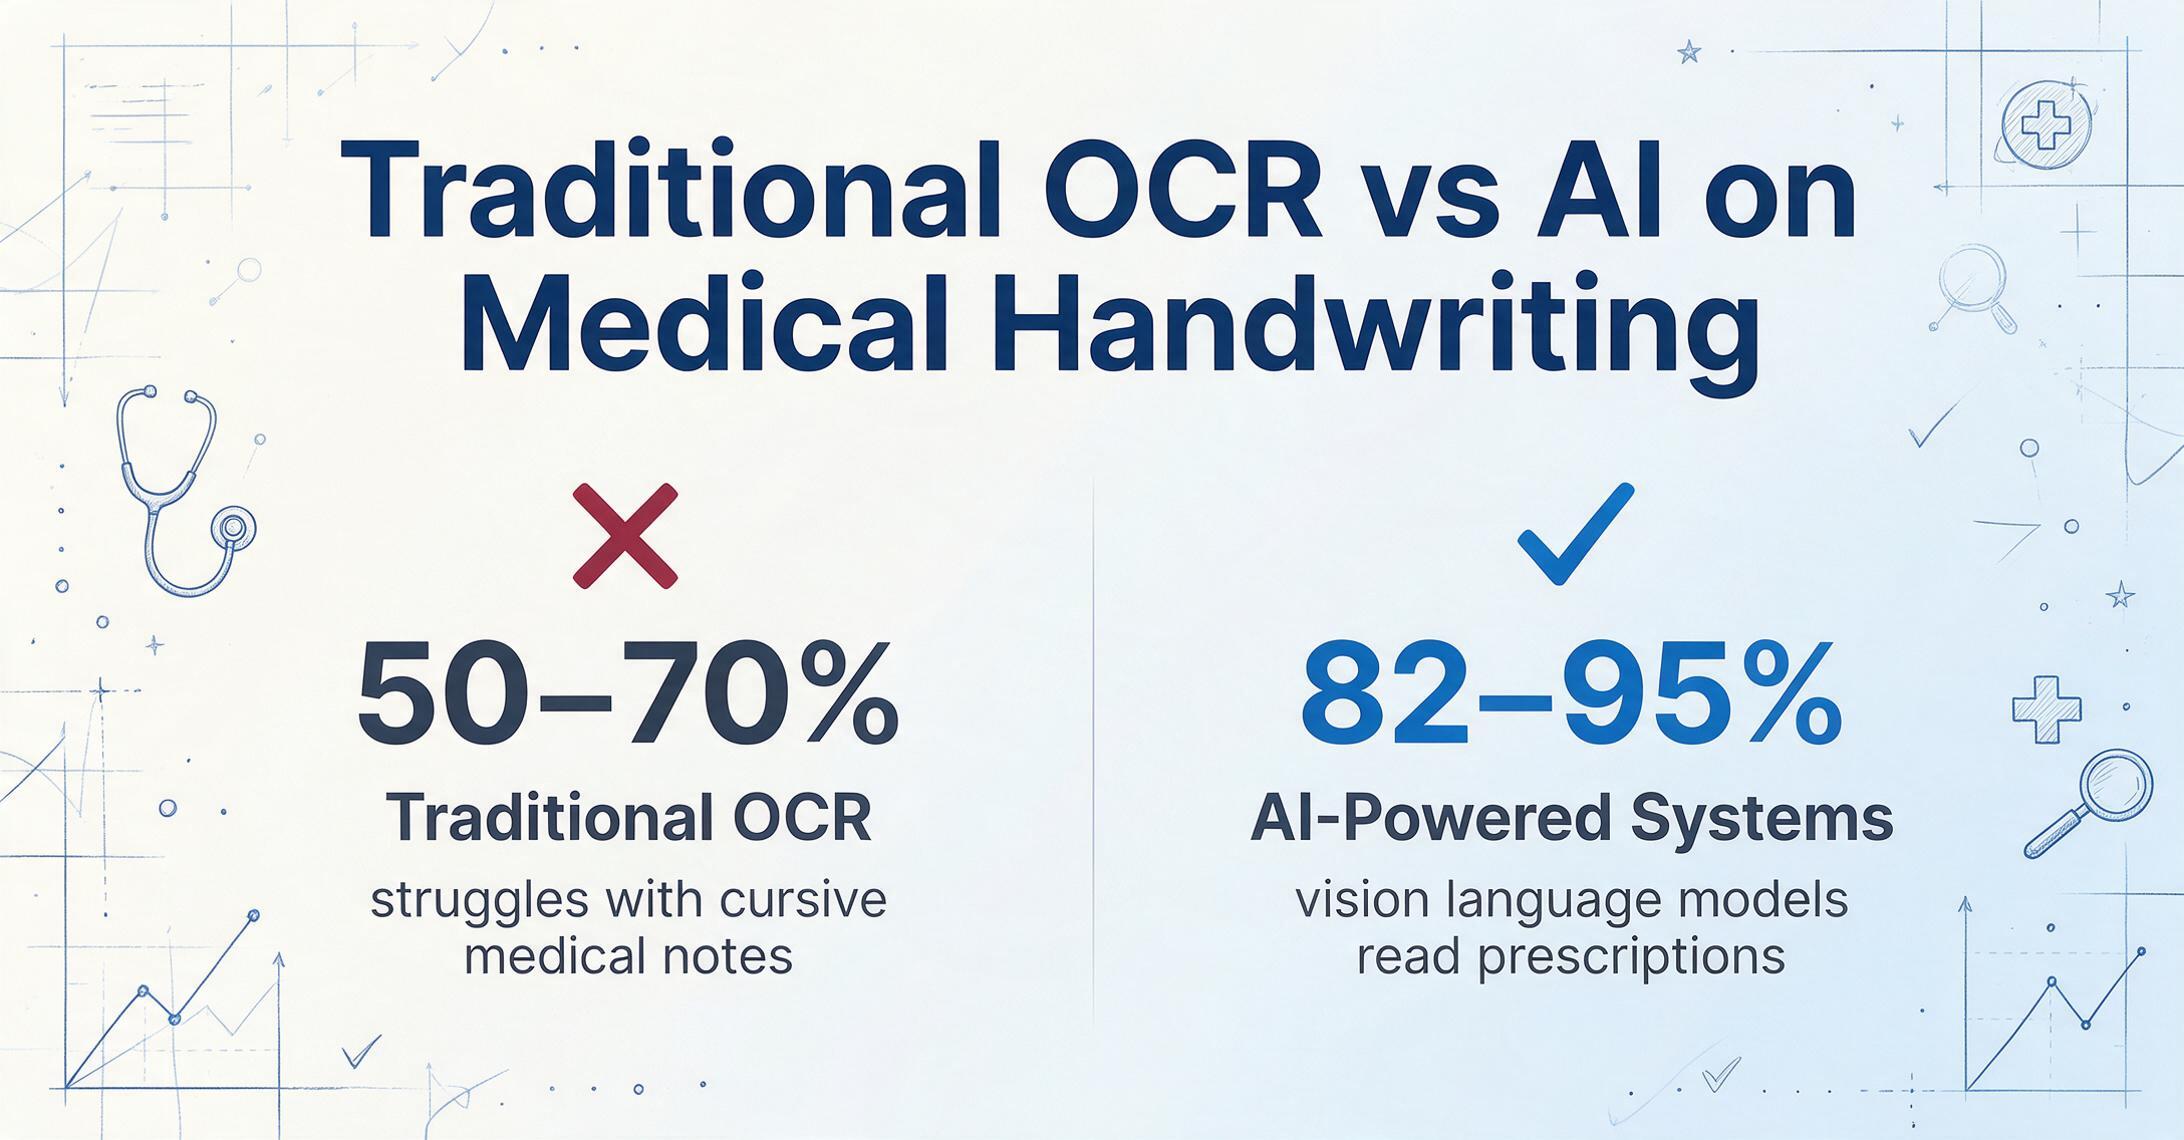
La escritura de los médicos es un cuello de botella notorio en el procesamiento de documentos sanitarios. La investigación académica sobre OCR para recetas médicas publicada en el European Journal of AI and Machine Learning confirma que el OCR tradicional logra aproximadamente un 50–70% de precisión en escritura médica, mientras que los sistemas impulsados por IA alcanzan el 82–95%. Evaluamos cómo maneja cada herramienta las notas médicas en cursiva, los recetarios manuscritos y las anotaciones clínicas en los márgenes. Una herramienta que solo lee texto impreso cubre quizás el 60% de la superficie real de los documentos sanitarios.
3. Cumplimiento de HIPAA y soporte BAA
HIPAA no certifica software específico. El cumplimiento es una combinación de las salvaguardas de seguridad del proveedor, sus políticas y su disposición a firmar un Acuerdo de Socio Comercial (BAA). La Oficina de Derechos Civiles (OCR) intensificó drásticamente la aplicación de la normativa en 2024–2025: las sanciones financieras de HIPAA aumentaron un 340%, y Advocate Health pagó un acuerdo de $5.55 millones tras una violación relacionada con un socio comercial que carecía de un BAA adecuado. Para cualquier herramienta que procese información de salud protegida (PHI), contar con un BAA firmado no es opcional. Señalamos dónde cada herramienta ofrece un BAA y, más importante aún, dónde no lo ofrece.
4. Integración con EHR y gestión de consultorios
Las organizaciones de salud operan con ecosistemas de software específicos: Epic domina los grandes sistemas hospitalarios, Oracle Cerner (ahora Oracle Health) cubre los centros médicos académicos, Meditech atiende a hospitales comunitarios, Athenahealth y eClinicalWorks lideran la atención ambulatoria, y Kareo y AdvancedMD sirven a consultorios pequeños. Una herramienta que genera archivos de Excel pero no puede enviar datos a un flujo de trabajo de EHR requiere un paso manual intermedio. Evaluamos la profundidad de integración de cada herramienta, desde conectores nativos de EHR hasta arquitecturas API-first que un desarrollador puede conectar a un pipeline de HL7 FHIR.
5. Modelo de implementación y tiempo para obtener valor
Los equipos de TI en salud están crónicamente sobrecargados. Según datos de HIMSS 2025, el 86% de los sistemas de salud utilizan alguna forma de IA, pero solo el 18% está listo para implementarla en la prestación de atención. La brecha no es de deseo, sino de capacidad de implementación. Evaluamos cada herramienta en un espectro que va desde "minutos para la primera extracción" (sin código, basado en navegador) hasta "implementación empresarial de meses" (instalación local, entrenamiento de modelos, configuración de flujos de trabajo). La elección correcta depende de la capacidad técnica de tu equipo y de la urgencia del problema.
Para un análisis más profundo sobre cómo la extracción impulsada por IA difiere del reconocimiento de caracteres tradicional en el procesamiento de documentos, nuestra guía sobre qué es la OCR con IA y cómo funciona cubre el cambio tecnológico que hace posible la extracción semántica. La guía completa sobre qué es la OCR proporciona la comprensión básica de cómo funciona la OCR tradicional y dónde están sus límites.
ImageToTable.ai — La mejor extracción sin código para documentos médicos diversos
Ideal para: equipos de atención médica — administradores de clínicas, personal de facturación médica, procesadores de reclamaciones de seguros — que necesitan extraer datos estructurados de una amplia variedad de documentos médicos sin configurar plantillas ni entrenar modelos. No es adecuado para: organizaciones que requieren un BAA firmado para el cumplimiento de HIPAA, integración nativa con EHR o implementación local.
ImageToTable.ai utiliza un modelo de lenguaje de visión que lee documentos de la misma manera que lo haría una persona: entiende qué significa cada campo, no dónde se encuentra en la página. Esto es importante en el sector salud porque los documentos médicos presentan más variaciones de diseño que casi cualquier otra industria. Un informe de laboratorio de un sistema hospitalario coloca el nombre del paciente en la esquina superior izquierda; otro lo coloca en un encabezado centrado. Una EOB de Cigna utiliza tablas resumidas anidadas; una de UnitedHealthcare utiliza listados planos de partidas. Las herramientas basadas en plantillas fallan con estas diferencias. La extracción semántica no.
Extracción de Columnas Personalizadas es el mecanismo central: escribes los nombres de las columnas que deseas — "Código CPT," "Dx ICD-10," "Revenue Code," "Nombre del paciente," "Monto del cargo" — y la IA localiza cada valor al comprender el significado semántico del campo. Distingue automáticamente un código CPT (identificador de procedimiento de cinco dígitos) de un Revenue Code (código de ubicación de cuatro dígitos), colocando cada uno en la columna de salida correcta. Esto es fundamentalmente diferente de las herramientas basadas en plantillas que vuelcan todos los códigos en un solo campo "Código" sin importar el tipo.
La herramienta maneja texto impreso, escritura a mano, casillas de verificación, tablas y firmas. El procesamiento por lotes es de primera clase: sube 50 EOB de diferentes aseguradoras como un solo lote y obtén un archivo de Excel unificado con columnas consistentes. El complemento de Google Sheets permite a los usuarios subir documentos y añadir los resultados directamente a una hoja de cálculo sin salir de Sheets. El procesamiento toma de 5 a 10 segundos por página — una mejora de 18x frente a los 3 minutos promedio de ingreso manual de datos. Para un recorrido completo del flujo de trabajo de EOB a Excel — desde definir columnas hasta exportar el lote fusionado — consulta nuestra guía sobre cómo convertir EOB a Excel.
Los precios comienzan con un plan gratuito (extracciones limitadas por mes), luego $9/mes (Basic) y $59/mes (Pro). No se requiere configuración más allá de crear una cuenta. La contrapartida es significativa para el sector salud: ImageToTable.ai no ofrece un BAA hoy, por lo que no es adecuado para flujos de trabajo que requieran manejo de PHI por parte de un proveedor conforme a HIPAA. Funciona bien para el procesamiento de documentos desidentificados, uso administrativo interno donde la PHI no se transmite al servicio, o como herramienta de productividad para profesionales de la salud individuales que manejan sus propios datos.
Amazon Textract: la mejor opción para pipelines sanitarios de alto volumen en AWS
Ideal para: organizaciones sanitarias que ya invierten en AWS y procesan grandes volúmenes de documentos estandarizados — formularios de admisión, formularios de reclamaciones, tarjetas de seguro — y que cuentan con capacidad de DevOps para construir y mantener pipelines de extracción. No es ideal para: equipos sin experiencia en infraestructura AWS o que necesiten una interfaz de usuario llave en mano.
Amazon Textract es un servicio de AWS elegible para HIPAA (BAA disponible a través del BAA estándar de AWS), lo que lo convierte en una de las opciones más sencillas para organizaciones sanitarias que necesitan infraestructura cloud conforme. Extrae texto, escritura a mano, formularios y tablas de documentos escaneados. Change Healthcare ha utilizado Textract para procesar más de 16 millones de páginas, reduciendo el tiempo de procesamiento por documento de 3 minutos a menos de 1 minuto y logrando una tasa de automatización del 68%, según casos de estudio de clientes de AWS.
Textract se integra de forma nativa con AWS HealthLake, Amazon Comprehend Medical (para detección de PHI y extracción de entidades médicas) y otros servicios de AWS, lo que lo convierte en un sólido bloque de construcción para la automatización sanitaria personalizada. Maneja texto impreso y escritura a mano, con buena precisión en formularios estandarizados. Sin embargo, Textract es solo API — no hay interfaz gráfica para subir documentos y revisar resultados. El cumplimiento de HIPAA requiere configuración manual del entorno AWS (cifrado, controles de acceso, registro de auditoría) en lugar de estar activado por defecto. El precio es por página y varía según el volumen; a escala, es una de las opciones más rentables.
Google Document AI: la mejor opción para flujos de trabajo sanitarios en GCP
Ideal para: equipos sanitarios que usan Google Cloud y necesitan procesadores preentrenados para documentos médicos comunes, con opciones de revisión humana en el circuito. No es ideal para: equipos fuera del ecosistema GCP o que procesen tipos de formularios personalizados muy variables.
Google Document AI ofrece procesadores preentrenados para facturas, recibos, W-2 y documentos de identidad, además de la capacidad de entrenar extractores personalizados mediante su nivel AutoML. Su integración con Vertex AI y Gemini permite resumir y razonar sobre los datos extraídos — una capacidad útil para la extracción de datos de ensayos clínicos, el resumen de historiales médicos y la automatización de admisión de pacientes. Google ofrece un BAA para servicios GCP, lo que hace que Document AI esté disponible para cargas de trabajo elegibles para HIPAA.
La fortaleza aquí es el ecosistema más amplio de Google: Document AI se alimenta de BigQuery para análisis, Healthcare API para intercambio de datos nativo FHIR y Vertex AI para desarrollo de modelos personalizados. La limitación es que los procesadores preentrenados cubren solo un conjunto fijo de tipos de documentos; para formularios médicos muy específicos (un diseño de informe de laboratorio único de un sistema hospitalario regional), se requiere entrenamiento personalizado. El precio combina el procesamiento OCR con funciones de GenAI, lo que puede volverse complejo a escala para pipelines de extracción de varios pasos.
Azure Document Intelligence: la mejor opción para sistemas de salud centrados en Microsoft
Ideal para: organizaciones de salud que operan con infraestructura de Microsoft (Active Directory, Office 365, Dynamics 365) y necesitan procesamiento de documentos elegible para HIPAA con sólidos controles de gobernanza. No es ideal para: equipos sin experiencia en Azure o aquellos que necesitan una interfaz de extracción sin código.
Azure Document Intelligence (antes Form Recognizer) ofrece modelos preentrenados para tipos de documentos comunes y capacidades de extracción personalizadas mediante Azure AI. Está cubierto por el BAA de Microsoft para el cumplimiento de HIPAA cuando se configura correctamente, y se integra con el control de acceso basado en roles de Azure, el registro de auditoría y los marcos de cifrado: fortalezas naturales para organizaciones que ya gestionan PHI dentro del perímetro de cumplimiento de Microsoft.
Azure DI maneja texto impreso, escritura a mano, tablas y pares clave-valor. Sus modelos preentrenados cubren facturas, recibos, documentos de identidad y tarjetas de seguro médico. Para documentos específicos del sector salud, como informes de laboratorio o EOB, normalmente se requiere entrenar modelos personalizados. La plataforma admite .NET, Python y API REST, lo que la hace accesible para equipos de desarrollo centrados en Microsoft. El precio sigue un modelo de pago por página con descuentos por volumen.
Visita Azure Document Intelligence →
ABBYY Vantage: el mejor IDP empresarial para el sector salud regulado
Ideal para: grandes sistemas de salud y aseguradoras que necesitan una plataforma madura de procesamiento de documentos de bajo código con habilidades preentrenadas y funciones de cumplimiento integrales. No es ideal para: consultorios pequeños o equipos que necesitan extracción rápida sin plantilla y sin un ciclo de implementación.
ABBYY es uno de los líderes históricos en OCR y procesamiento inteligente de documentos, con una plataforma utilizada en industrias reguladas, incluida la salud. ABBYY Vantage ofrece "habilidades" preentrenadas (modelos de extracción para tipos de documentos específicos), un creador de habilidades de bajo código para formularios personalizados y conectores de integración para sistemas ECM y plataformas ERP. Admite reconocimiento de escritura a mano, aunque la precisión en notas médicas densas en cursiva es moderada en comparación con herramientas más nuevas basadas en IA.
ABBYY ofrece un BAA y tiene una experiencia significativa en implementaciones en el sector salud. Su fortaleza es la amplitud: puede cubrir facturas, reclamaciones, formularios de pacientes, documentos de ensayos clínicos y correspondencia de proveedores en una sola plataforma. La contrapartida es que la implementación suele llevar de semanas a meses, el precio se cotiza de forma personalizada y es de nivel empresarial (cinco cifras anuales o más), y la plataforma requiere un esfuerzo administrativo dedicado para mantener las habilidades de extracción a medida que cambian los formatos de los documentos. Para organizaciones grandes con un equipo dedicado al procesamiento de documentos, ABBYY Vantage es una opción probada.
Nanonets — Mejor para modelos personalizados de documentos médicos especializados
Ideal para: organizaciones que procesan un gran volumen de un tipo específico y estable de documento médico y tienen los recursos para entrenar y mantener un modelo dedicado. No es ideal para: equipos que necesitan extracción sin configuración en muchos formatos de documentos diferentes.
Nanonets ofrece una plataforma de OCR con IA con más de 300 modelos preentrenados en categorías de documentos, incluyendo formularios de salud, documentos de seguros y registros médicos. Su diferenciador principal es el pipeline de entrenamiento: los usuarios suben documentos de muestra (normalmente 20–50 por formato), etiquetan los campos, y la plataforma entrena un modelo de extracción personalizado. Para un sistema hospitalario que procesa el mismo formato de informe de laboratorio de 50 clínicas afiliadas, esto puede ofrecer alta precisión. Nanonets ofrece un BAA para clientes empresariales y soporta implementación en la nube y local.
La limitación es que cada nuevo formato de documento requiere un nuevo ciclo de entrenamiento. Una clínica que recibe informes de laboratorio de cinco sistemas hospitalarios diferentes necesita cinco conjuntos de entrenamiento etiquetados. Un equipo de facturación médica que procesa EOBs de 20 planes de seguros diferentes necesita 20 iteraciones de entrenamiento. Para formatos estables y de alto volumen, la inversión inicial se amortiza. Para mezclas de documentos diversas y variables, el costo de mantenimiento del entrenamiento se acumula. El precio comienza con un nivel gratuito (páginas limitadas) y escala a planes empresariales personalizados.
LlamaParse (LlamaIndex) — Mejor para productos de IA de salud liderados por desarrolladores
Ideal para: equipos de ingeniería que construyen aplicaciones de salud agénticas — asistentes clínicos, pipelines automatizados de codificación médica, herramientas de síntesis de investigación — que necesitan comprensión profunda de documentos con puntuaciones de confianza a nivel de campo y citas de fuentes. No es ideal para: equipos de salud no técnicos que necesitan una interfaz gráfica para el procesamiento de documentos.
LlamaParse adopta un enfoque agéntico al procesamiento de documentos: en lugar de plantillas frágiles o extracción basada en diseño, utiliza IA multimodal para comprender la estructura del documento, tablas, escritura a mano y gráficos, y luego extrae datos estructurados con puntuaciones de confianza a nivel de campo. Se integra con el ecosistema más amplio de LlamaIndex para pipelines de RAG, lo que lo convierte en una opción sólida para organizaciones que construyen productos de IA conscientes de documentos con sus propios datos médicos.
La plataforma soporta extracción basada en esquemas (LlamaExtract), donde defines los campos que necesitas (MRN, códigos ICD-10, nombres de medicamentos, valores de laboratorio, dosis) y la IA los extrae con citas a nivel de página para auditoría. LlamaIndex ofrece un BAA para clientes empresariales y soporta implementación en la nube y autoalojada. La desventaja es que es API-first y basado en SDK (Python + TypeScript), sin interfaz sin código. El precio comienza con un nivel gratuito para evaluación y escala a cotizaciones empresariales personalizadas.
Docsumo — Mejor para el procesamiento administrativo y de reclamaciones de seguros de salud
Mejor para: aseguradoras de salud, administradores externos (TPAs) y equipos de facturación médica de back-office que procesan grandes volúmenes de formularios estructurados, documentos de reclamaciones y papeleo de seguros. No es ideal para: la extracción de documentos clínicos a partir de notas manuscritas de médicos o informes de laboratorio complejos.
Docsumo es una plataforma de procesamiento inteligente de documentos de propósito general que destaca en documentos estructurados y semiestructurados comunes en la administración sanitaria: formularios de reclamaciones, Explicación de Beneficios, documentos de verificación de elegibilidad y solicitudes de seguros. Ofrece modelos preentrenados para tipos de documentos comunes, reglas de validación integradas e integración con flujos de trabajo mediante API y webhooks. Hay un BAA disponible para clientes del sector sanitario.
Los puntos fuertes de Docsumo están en el lado administrativo de la atención sanitaria — para una aseguradora de salud que procesa 10,000 formularios de reclamaciones al mes con diseños estables, ofrece un procesamiento directo fiable. Su reconocimiento de escritura manuscrita es limitado en comparación con las herramientas nativas de IA, por lo que no es la opción adecuada para recetas manuscritas o notas clínicas. El precio se cotiza de forma personalizada y se basa en el volumen de documentos.
Hyland OnBase — Mejor gestión documental empresarial con captura sanitaria
Mejor para: grandes sistemas de salud que necesitan una plataforma unificada de servicios de contenido empresarial que combine gestión documental, captura, flujo de trabajo y cumplimiento — con OCR como un componente dentro de una infraestructura más amplia. No es ideal para: equipos que necesitan una herramienta independiente de extracción de documentos sin una implementación importante de ECM.
Hyland OnBase es una plataforma madura de servicios de contenido empresarial con una profunda penetración en el sector sanitario. Proporciona captura de documentos, indexación, almacenamiento, automatización de flujos de trabajo y gestión de liberación de información — todo dentro de un marco compatible con HIPAA y con un BAA. Su módulo de captura utiliza OCR para clasificar y extraer datos de documentos escaneados, enrutándolos hacia los flujos de trabajo clínicos o administrativos adecuados.
OnBase es utilizado por cientos de hospitales para escanear e indexar registros de pacientes, EOBs y documentos administrativos. Los usuarios de Reddit en r/healthIT describen el uso de "onbase para indexar escaneos masivos / faxes en el expediente" como parte de un flujo de trabajo manual pero flexible. La contrapartida es que OnBase es una plataforma empresarial masiva: la implementación lleva meses, los costos se cotizan de forma personalizada y suelen ser de seis cifras, y el reconocimiento de escritura manuscrita es básico. Es una inversión en gestión de contenido con capacidades de extracción, no una herramienta centrada en la extracción.
Kofax — La mejor captura de documentos empresarial a escala
Ideal para: grandes organizaciones de salud y externalizadores de procesos de negocio que procesan millones de páginas al mes mediante flujos de captura automatizados con validación y clasificación. No es ideal para: clínicas pequeñas, profesionales independientes o cualquier equipo que necesite una herramienta de extracción ligera.
Kofax (parte de Tungsten Automation) ofrece captura inteligente de documentos empresarial con clasificación, extracción y validación impulsadas por IA. Su plataforma escanea, clasifica, extrae datos de y enruta documentos a través de flujos de trabajo de salud — desde el escaneo de admisión de pacientes en el registro hasta el procesamiento de EOB en el departamento de ciclo de ingresos. Kofax ofrece un BAA y tiene una experiencia significativa en implementaciones de salud.
La fortaleza de la plataforma es la captura automatizada de alto volumen: escanear 50,000 páginas al día, clasificar tipos de documentos automáticamente, extraer campos clave y validarlos contra reglas de negocio antes de enrutarlos a sistemas posteriores. La contrapartida es la complejidad: las implementaciones de Kofax típicamente requieren servicios profesionales, meses de configuración y un gasto de capital significativo. El reconocimiento de escritura a mano es limitado. Para organizaciones por debajo de la escala empresarial, es excesivo.
Koncile — El mejor OCR de salud API-first para recetas y documentos médicos
Ideal para: empresas de tecnología de salud y plataformas de salud digital que necesitan un servicio OCR API-first con buen rendimiento en recetas y procesamiento de documentos médicos francés/compatible con RGPD. No es ideal para: equipos centrados en EE. UU. que necesiten extracción sin código o integraciones profundas con EHR como Epic/Cerner.
Koncile es una plataforma OCR de IA centrada en salud, construida principalmente para el mercado europeo, con un buen rendimiento en recetas, informes médicos y documentos clínicos. Ofrece modelos de extracción de salud listos para usar y una arquitectura API-first que la hace adecuada para la integración en productos de salud digital y plataformas de automatización de farmacias. Koncile proporciona un equivalente a BAA bajo el RGPD y aloja datos en servidores franceses.
Su reconocimiento de escritura a mano es más fuerte que el de las herramientas OCR de propósito general gracias a un entrenamiento especializado en muestras de escritura médica, incluidas anotaciones de recetas. La contrapartida es geográfica: el entrenamiento de documentos de Koncile es más fuerte en formatos médicos europeos, y su ecosistema de integración no incluye sistemas EHR específicos de EE. UU. El precio se cotiza de forma personalizada y se basa en el volumen.
Tesseract: la mejor línea base de OCR gratuita y de código abierto
Ideal para: desarrolladores que crean pipelines personalizados de procesamiento de documentos de salud y necesitan un motor de OCR gratuito y autohospedado para extraer texto impreso como punto de partida. No es ideal para: flujos de trabajo de salud que impliquen escritura a mano, diseños complejos, extracción de datos estructurados o procesamiento directo de PHI sin medidas de seguridad adicionales.
Tesseract es el motor de OCR de código abierto más utilizado, mantenido por Google desde 2006. La versión 5 (lanzada en 2024) incorporó reconocimiento por redes neuronales basadas en LSTM que mejoró la precisión en texto impreso limpio. Admite más de 100 idiomas y se puede personalizar y ampliar para tipos de documentos específicos.
Para el sector salud, el valor de Tesseract se limita al texto impreso en documentos limpios y de alto contraste. Tiene una capacidad mínima para escritura a mano — la investigación académica confirma que Tesseract alcanza aproximadamente un 64 % de precisión en escritura médica a mano — y no ofrece extracción de datos estructurados. Un código ICD-10 extraído por Tesseract termina en un bloque de texto plano sin etiqueta de campo, lo que requiere procesamiento adicional para identificar y enrutar cada código. Tesseract no tiene BAA, ni registro de auditoría, ni infraestructura de manejo de PHI por defecto; cualquier uso conforme a HIPAA exige que la organización que lo implemente construya controles de seguridad a su alrededor. Es un componente útil en un pipeline personalizado, no una solución de OCR independiente para el sector salud.
¿Qué herramienta es la adecuada para tu organización de salud?
Ninguna herramienta cubre todas las necesidades de OCR en salud, porque la salud no es un solo flujo de trabajo — es un conjunto de problemas de procesamiento de documentos muy distintos que comparten un marco regulatorio. Así puedes alinear tu situación con la categoría de herramienta correcta.
Tienes una clínica pequeña o un consultorio individual
Procesas formularios de admisión de pacientes, tarjetas de seguro y un volumen moderado de EOB. No tienes equipo de TI y necesitas algo que funcione en minutos. ImageToTable.ai es la opción más práctica para convertir formularios escaneados en datos estructurados sin configuración. Para el procesamiento de PHI conforme a HIPAA a través de la nube, Google Document AI o Azure Document Intelligence con un BAA son viables si tienes la capacidad administrativa para configurar la cuenta en la nube. Para una opción completamente gratuita pero limitada, Tesseract mediante una interfaz gráfica puede manejar texto impreso en documentos limpios — pero espera verificar cada resultado.
Diriges un grupo médico de tamaño mediano o una red de atención ambulatoria
Usas un EHR como Athenahealth, eClinicalWorks o Kareo. Tu volumen de documentos es de miles al mes: EOB, cartas de referencia, informes de laboratorio de varios laboratorios. Necesitas flexibilidad entre formatos, pero puede que no tengas un equipo dedicado de ingeniería de datos. ImageToTable.ai maneja bien la diversidad de formatos y no requiere configuración de plantillas. Si tu organización requiere protección BAA, Docsumo para documentos administrativos o Nanonets para documentos de alto volumen y formato estable son opciones adecuadas. Google Document AI con su Healthcare API puede conectarse a FHIR si tienes los recursos técnicos.
Trabajas en un gran sistema de salud o red hospitalaria
Usas Epic, Oracle Cerner o Meditech. Procesas millones de páginas al año: registros de pacientes, reclamaciones de seguros, documentos de ensayos clínicos, correspondencia de proveedores. Tienes un departamento de TI y una oficina de cumplimiento. Hyland OnBase o Kofax son las opciones empresariales establecidas para captura y gestión de contenido, con integración probada en flujos de trabajo hospitalarios grandes. ABBYY Vantage ofrece una alternativa más centrada en la extracción con creación de habilidades de bajo código. Amazon Textract conectado a un pipeline FHIR de AWS HealthLake es la opción nativa de nube más escalable para organizaciones con capacidad de DevOps.
Trabajas para una aseguradora de salud o TPA
Tu necesidad principal de OCR es el procesamiento de reclamaciones: CMS-1500, UB-04, datos de encuentros y EOB, a alto volumen y con formatos consistentes. Docsumo y Nanonets tienen un procesamiento de formularios sólido para documentos de seguros. Amazon Textract en la infraestructura de salud de AWS puede manejar un rendimiento muy alto con previsibilidad de costos. ABBYY Vantage cubre todo el ciclo de vida de las reclamaciones, desde la recepción hasta el soporte de adjudicación.
Estás creando un producto de tecnología sanitaria
Tu necesidad de OCR está integrada en tu propia aplicación: un asistente clínico, una herramienta de automatización de codificación médica, un producto de datos de salud orientado al paciente. LlamaParse ofrece el kit de herramientas para desarrolladores más avanzado con extracción guiada por esquema y puntuaciones de confianza a nivel de campo. Amazon Textract es una API probada de alto volumen. Azure Document Intelligence se integra bien con pilas .NET. Koncile es una opción especializada para casos de uso sanitarios europeos con cumplimiento del RGPD.
Para una visión más amplia del panorama de OCR que incluya opciones gratuitas y alternativas de código abierto, consulta nuestra guía de los mejores software de OCR gratuitos y comparativa de las mejores herramientas de OCR de código abierto. Si los documentos médicos escritos a mano son tu principal desafío — y para muchos equipos sanitarios lo son — nuestro resumen de OCR para escritura a mano profundiza en esa capacidad específica. Para una visión general que incluya herramientas empresariales no cubiertas aquí, mejor software de OCR 2026 mapea el panorama completo.
Preguntas Frecuentes
¿Qué hace que una herramienta de OCR sea compatible con HIPAA?
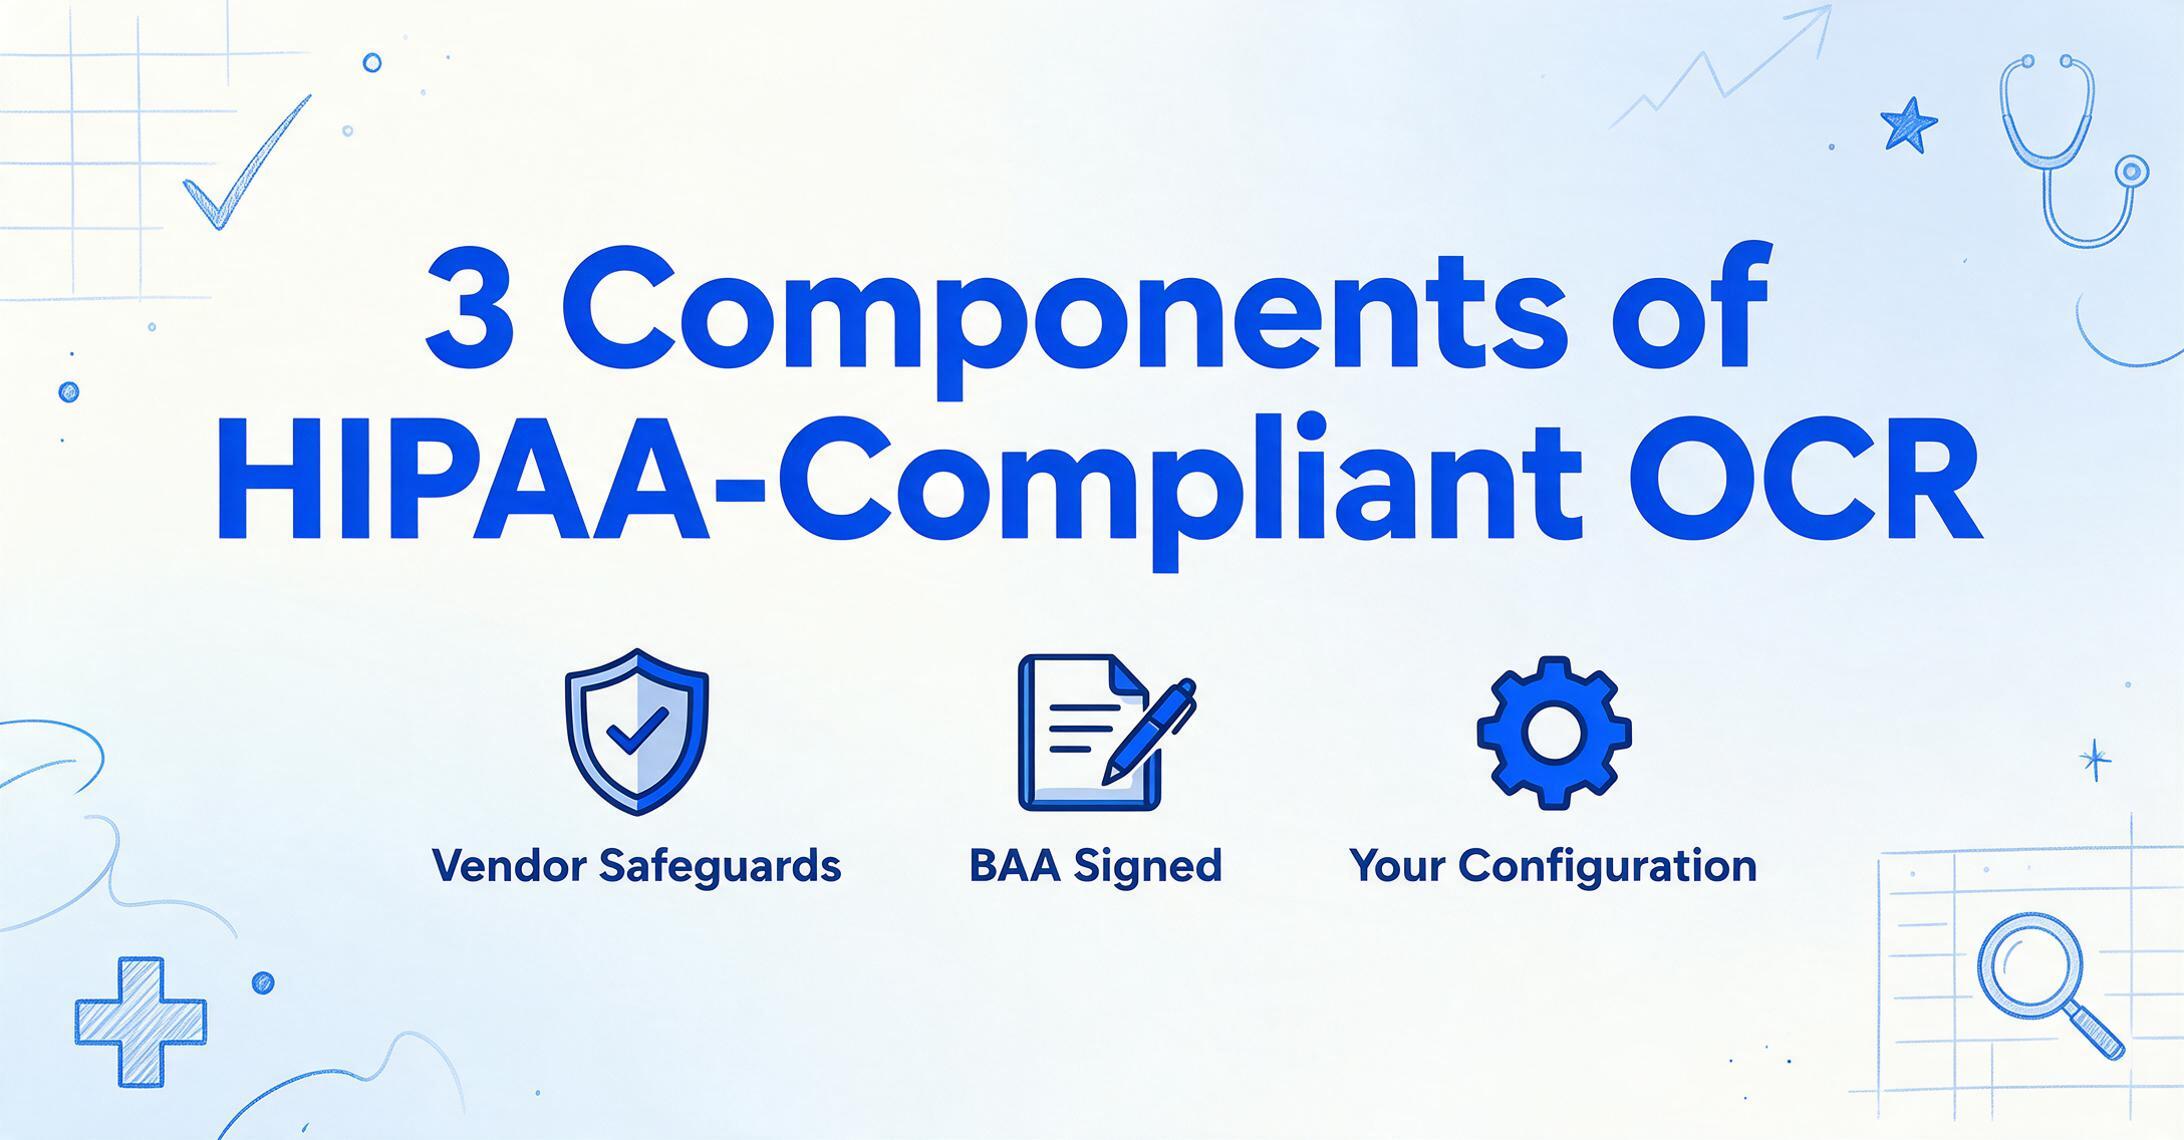
El cumplimiento de HIPAA para software de OCR requiere tres componentes trabajando juntos. Primero, el proveedor debe mantener sólidas salvaguardas de seguridad: cifrado en reposo y en tránsito, controles de acceso basados en roles, registro de auditoría integral y políticas claras de manejo de PHI. Segundo, el proveedor debe firmar un Acuerdo de Socio Comercial que lo vincule contractualmente a los requisitos de la Regla de Privacidad y Seguridad de HIPAA para cualquier PHI que procese en tu nombre. Tercero, tu organización debe configurar y operar la herramienta dentro de tu propio programa de cumplimiento de HIPAA: un BAA no hace que tu flujo de trabajo sea compatible si configuras la herramienta para almacenar PHI en una ubicación no cifrada o otorgas acceso a usuarios no autorizados. La Oficina de Derechos Civiles ha dejado claro a través de acciones de cumplimiento — incluido el acuerdo de $5.55 millones con Advocate Health — que tanto el acuerdo con el proveedor como los controles operativos deben estar en vigor.
¿Puede la OCR leer con precisión la letra de los médicos?
Esta es la pregunta más común en la OCR sanitaria, y la respuesta honesta es: depende de la letra y de la herramienta. La OCR tradicional logra aproximadamente un 50–70 % de precisión en texto médico manuscrito. Las herramientas modernas basadas en IA, incluidos los modelos de lenguaje de visión, alcanzan un 82–95 % en escritura médica — una mejora significativa, pero aún por debajo de la precisión del texto impreso. Los mejores resultados provienen de herramientas entrenadas específicamente con muestras de escritura médica o construidas sobre modelos de lenguaje de visión que entienden el contexto semántico (una cadena de cinco caracteres después de "Dx:" probablemente sea un código de diagnóstico, incluso si un carácter es ambiguo). Ninguna herramienta de OCR logra un 99 % en escritura manuscrita. Para datos clínicos críticos — nombres de medicamentos, dosis, códigos de diagnóstico — siempre reserva tiempo para la verificación humana contra el documento original. Nuestro análisis de OCR para escritura manuscrita cubre este tema en profundidad.
¿Puede la OCR extraer códigos CPT y códigos ICD-10 de documentos médicos?
Sí, pero la calidad de la extracción depende de si la herramienta entiende la estructura de los códigos o simplemente lee texto sin procesar. Las herramientas basadas en IA que usan extracción semántica pueden distinguir entre tipos de códigos: los códigos CPT son identificadores numéricos de cinco dígitos (99213, 93000), los códigos ICD-10 son cadenas alfanuméricas (E11.9, I10), los Revenue Code son identificadores de ubicación de cuatro dígitos (0450 para la sala de emergencias) y los códigos de medicamentos NDC son identificadores de 11 dígitos. Una herramienta que asigna cada tipo de código a la columna de salida correcta es mucho más útil para la facturación médica y el procesamiento de reclamaciones que una que vierte todos los códigos en un solo campo de texto. Define columnas para cada tipo de código por separado — "CPT Code," "ICD-10 Dx," "Revenue Code," "NDC" — y deja que la herramienta los enrute por tipo semántico.
¿Se integra la OCR con Epic, Cerner o Meditech?
La integración directa con el EHR es la excepción, no la regla, entre las herramientas de OCR. La mayoría de las herramientas generan datos estructurados en Excel, CSV o JSON, que luego deben importarse al EHR a través de una interfaz separada o una capa de API. Las plataformas empresariales como Hyland OnBase y Kofax tienen conectores preconstruidos para los principales sistemas EHR porque funcionan como plataformas de gestión de contenido que envuelven el registro clínico. Las herramientas de API en la nube como Amazon Textract se integran con la API FHIR de AWS HealthLake, que luego puede conectarse a un EHR. Para la mayoría de las herramientas de OCR sin código, el flujo de trabajo es: extraer datos a una hoja de cálculo → validar → subir o importar al EHR. Este paso intermedio no es ideal, pero es la realidad práctica para la mayoría de las organizaciones sanitarias.
¿Existe una herramienta OCR gratuita para documentos de atención médica?
Tesseract es gratuito y de código abierto, pero sus limitaciones prácticas para el sector salud son significativas: soporte mínimo para escritura a mano, sin extracción de datos estructurados, sin infraestructura de seguridad para PHI y una interfaz solo para desarrolladores. El OCR integrado de Google Drive es gratuito y puede generar PDFs con texto buscable a partir de documentos médicos escaneados, pero produce texto plano — no datos estructurados con etiquetas de campo. ImageToTable.ai ofrece un plan gratuito para extracciones limitadas, útil para probar si la extracción semántica funciona con tus documentos específicos antes de comprometerte con un plan de pago. Para una comparación completa de opciones gratuitas, consulta nuestra guía del mejor software OCR gratuito.
¿Puede el OCR manejar las tablas anidadas en los formularios de Explicación de Beneficios?
Las tablas anidadas de EOB son uno de los tipos de documento más difíciles para el OCR tradicional, porque una sola celda de tabla puede contener tanto un monto en dólares como una explicación codificada, con subfilas indentadas bajo los elementos principales. Las herramientas basadas en plantillas suelen aplanar esto en un solo bloque de texto por fila, perdiendo la jerarquía. Las herramientas impulsadas por IA con comprensión del diseño funcionan significativamente mejor porque pueden identificar la relación padre-hijo entre un cargo principal y sus ajustes. La clave es definir columnas que coincidan con la estructura del EOB: "Monto Facturado," "Monto Permitido," "Pago del Seguro," "Responsabilidad del Paciente," "Código de Ajuste" — y dejar que la IA mapee cada valor comprendiendo dónde se ubica en la jerarquía lógica del documento, no leyendo una coordenada fija de cuadrícula. Para un análisis más profundo de cómo las herramientas de extracción manejan formatos de EOB y reclamos de múltiples pagadores, consulta nuestro resumen de herramientas de extracción de documentos de salud; para conocer los mecanismos subyacentes del OCR en distintos tipos de documentos médicos, nuestra guía de OCR para el sector salud cubre todo el espectro documental.
¿Qué pasa con el procesamiento de recetas escritas a mano?
Las recetas manuscritas presentan un desafío único para el OCR porque las consecuencias de una mala lectura son clínicas, no solo administrativas. Una dosis o nombre de medicamento mal leído puede afectar directamente la seguridad del paciente. Los estudios académicos sobre OCR para el procesamiento de recetas muestran que el OCR tradicional logra aproximadamente un 50–70% de precisión en escritura a mano de recetas, mientras que los sistemas de IA entrenados con muestras médicas alcanzan un 82–95%. El enfoque más práctico para farmacias y procesadores de recetas es usar una herramienta impulsada por IA que pueda leer la escritura a mano contextualmente (entendiendo que "Metf" probablemente sea "Metformin") combinada con un paso de verificación por parte del farmacéutico en cada receta. Ninguna herramienta OCR debería ser el único control en un flujo de trabajo de cumplimiento de recetas — el riesgo clínico es demasiado alto.
¿Cuánto tiempo lleva implementar OCR en un entorno sanitario?
El tiempo de implementación varía drásticamente según la categoría de la herramienta. Herramientas sin código como ImageToTable.ai: minutos para la primera extracción. Herramientas API en la nube como Amazon Textract, Google Document AI o Azure Document Intelligence: horas o días para la integración de la API, más tiempo adicional para la configuración de infraestructura compatible con HIPAA. Plataformas basadas en entrenamiento como Nanonets: días o semanas, dependiendo de cuántos formatos de documentos necesiten muestras etiquetadas y de cuántas iteraciones requiera el proceso de entrenamiento. Plataformas empresariales como ABBYY Vantage, Hyland OnBase o Kofax: meses, incluyendo servicios profesionales, configuración de flujos de trabajo, desarrollo de integración y validación de cumplimiento. Según datos de HIMSS 2025, solo el 18% de los sistemas de salud reportan estar listos para implementar herramientas de IA en la prestación de atención; la brecha no es la disponibilidad de tecnología, sino la capacidad de implementación. Elija una herramienta cuyo tiempo de implementación coincida con la capacidad de su organización para absorberla.
El Resumen
El procesamiento de documentos sanitarios en 2026 es una historia de dos brechas. La brecha tecnológica — lo que las herramientas impulsadas por IA pueden hacer realmente frente a lo que los equipos sanitarios creen que pueden hacer — se está cerrando rápidamente. Los modelos de lenguaje de visión ahora pueden leer escritura médica, distinguir códigos CPT de códigos ICD-10 por su estructura y extraer datos de tablas EOB anidadas sin plantillas. La brecha de implementación — el abismo entre lo que es técnicamente posible y lo que las organizaciones sanitarias tienen la capacidad de implementar — sigue siendo la restricción vinculante.
La herramienta OCR adecuada para su organización sanitaria es aquella cuyo modelo de implementación coincida con la capacidad técnica de su equipo y cuyo enfoque de extracción coincida con la diversidad de sus documentos. Si sus documentos están estandarizados y su volumen es alto, una plataforma basada en entrenamiento o empresarial ofrecerá una precisión predecible. Si sus documentos varían cada hora — diferentes aseguradoras, diferentes laboratorios, diferentes clínicas — un enfoque semántico y sin plantillas le ahorrará mantener configuraciones de extracción para cada variación de formato. Y si procesa datos clínicos manuscritos — recetas, notas médicas, informes de laboratorio anotados — convierta la capacidad de manejo de escritura a mano en un criterio de evaluación innegociable, no en una característica adicional.
Comience probando una herramienta con los documentos que su equipo realmente procesa — no los documentos perfectos, sino los desordenados. La herramienta que haga extraíbles sus trámites del mundo real es la herramienta que debe usar.