Melhores Softwares de OCR para Saúde 2026:
12 Ferramentas para Documentos Médicos Testadas
Este guia avalia 12 ferramentas de OCR e extração de documentos com IA segundo cinco critérios que importam especificamente para equipes de saúde: precisão em terminologia médica e sistemas de codificação, capacidade de reconhecer manuscritos em anotações clínicas e receitas, prontidão para conformidade com HIPAA, integração com EHR e gestão de consultórios, e a adequação honesta de cada ferramenta para diferentes tamanhos de organizações de saúde e capacidades técnicas. Todo valor de preço é proveniente da página pública do fornecedor em junho de 2026. Divulgação: o ImageToTable.ai está incluído nesta lista. Não tenho vínculo com nenhuma outra ferramenta listada. Todo link externo aponta para o site do fornecedor para que você possa verificar as afirmações de forma independente.
Principais Conclusões
- Toda ferramenta de OCR para saúde nesta lista afirma ter 95% de precisão, mas esse benchmark foi testado em faturas digitadas limpas, enquanto seu fluxo diário real inclui EOBs com tabelas de resumo aninhadas e receitas escritas em cursivo por um médico que estava atrasado para as rondas.
- O único recurso que determina se o OCR economiza ou desperdiça seu tempo é a discriminação por tipo de código, porque uma ferramenta que junta códigos CPT de procedimentos e códigos ICD-10 de diagnóstico em uma única coluna Código cria uma etapa manual de reordenação que apaga cada segundo que a extração economizou.
- Deixe de lado a comparação de percentuais de precisão e pergunte se a ferramenta assina um BAA para sua carga de trabalho com HIPAA e consegue ler a caligrafia que seus médicos realmente produzem às 23h em uma clínica movimentada.
Tabela de Comparação Rápida
| Ferramenta | Melhor Para | Manuscrito | BAA Disponível | Configuração | Preço Inicial |
|---|---|---|---|---|---|
| ImageToTable.ai | Extração sem código para diversos documentos médicos | ✅ Forte | ❌ | Minutos | Plano gratuito / $9/mês |
| Amazon Textract | Pipelines nativos da AWS de alto volume | ✅ Bom | ✅ | Horas–dias | Pague por página |
| Google Document AI | Parsers de saúde baseados no GCP | ✅ Bom | ✅ | Horas–dias | Pague por página |
| Azure Document Intelligence | Sistemas de saúde centrados na Microsoft | ✅ Bom | ✅ | Horas–dias | Pague por página |
| ABBYY Vantage | IDP empresarial com habilidades low-code | ✅ Moderado | ✅ | Semanas | Orçamento personalizado |
| Nanonets | Modelos treinados sob medida para formatos de nicho | ✅ Moderado | ✅ | Dias–semanas | Plano gratuito / personalizado |
| LlamaParse (LlamaIndex) | Produtos de IA em saúde liderados por desenvolvedores | ✅ Forte | Empresarial | Horas | Plano gratuito / personalizado |
| Docsumo | Processamento de documentos administrativos e de seguros | ⚠️ Limitado | ✅ | Dias | Orçamento personalizado |
| Hyland OnBase | DMS empresarial com captura | ⚠️ Limitado | ✅ | Meses | Orçamento personalizado |
| Kofax | Captura de documentos empresariais em escala | ⚠️ Limitado | ✅ | Meses | Orçamento personalizado |
| Koncile | OCR de saúde com API em primeiro lugar | ✅ Bom | ✅ | Dias | Orçamento personalizado |
| Tesseract | Linha de base gratuita de código aberto | ❌ Ruim | N/A (auto-hospedado) | Horas (dev) | Grátis |
Como Escolhemos e Testamos
O processamento de documentos de saúde não é o mesmo problema que o OCR de uso geral. Uma ferramenta que lida perfeitamente com faturas pode falhar catastroficamente em um formulário de Explicação de Benefícios com tabelas aninhadas, um laudo de laboratório com resultados em formato numérico e narrativo, ou um formulário de sinistro CMS-1500 onde erros de codificação têm consequências financeiras reais. Avaliamos cada ferramenta com base em cinco dimensões específicas da área da saúde.
1. Precisão de terminologia médica e codificação
Documentos de saúde carregam códigos de diagnóstico ICD-10, códigos de procedimento CPT, Revenue Codes, identificadores de laboratório LOINC, termos clínicos SNOMED CT e códigos de medicamentos NDC. Eles seguem padrões sintáticos precisos — códigos CPT são sempre cinco dígitos, códigos ICD-10 são strings alfanuméricas de três a sete caracteres, Revenue Codes são identificadores de localização de quatro dígitos. Uma ferramenta que não consegue distinguir um código CPT de um Revenue Code produz resultados que exigem reordenação manual. Avaliamos a capacidade de cada ferramenta de preservar essas estruturas de codificação sem reduzi-las a campos genéricos de "Código".
2. Reconhecimento de caligrafia
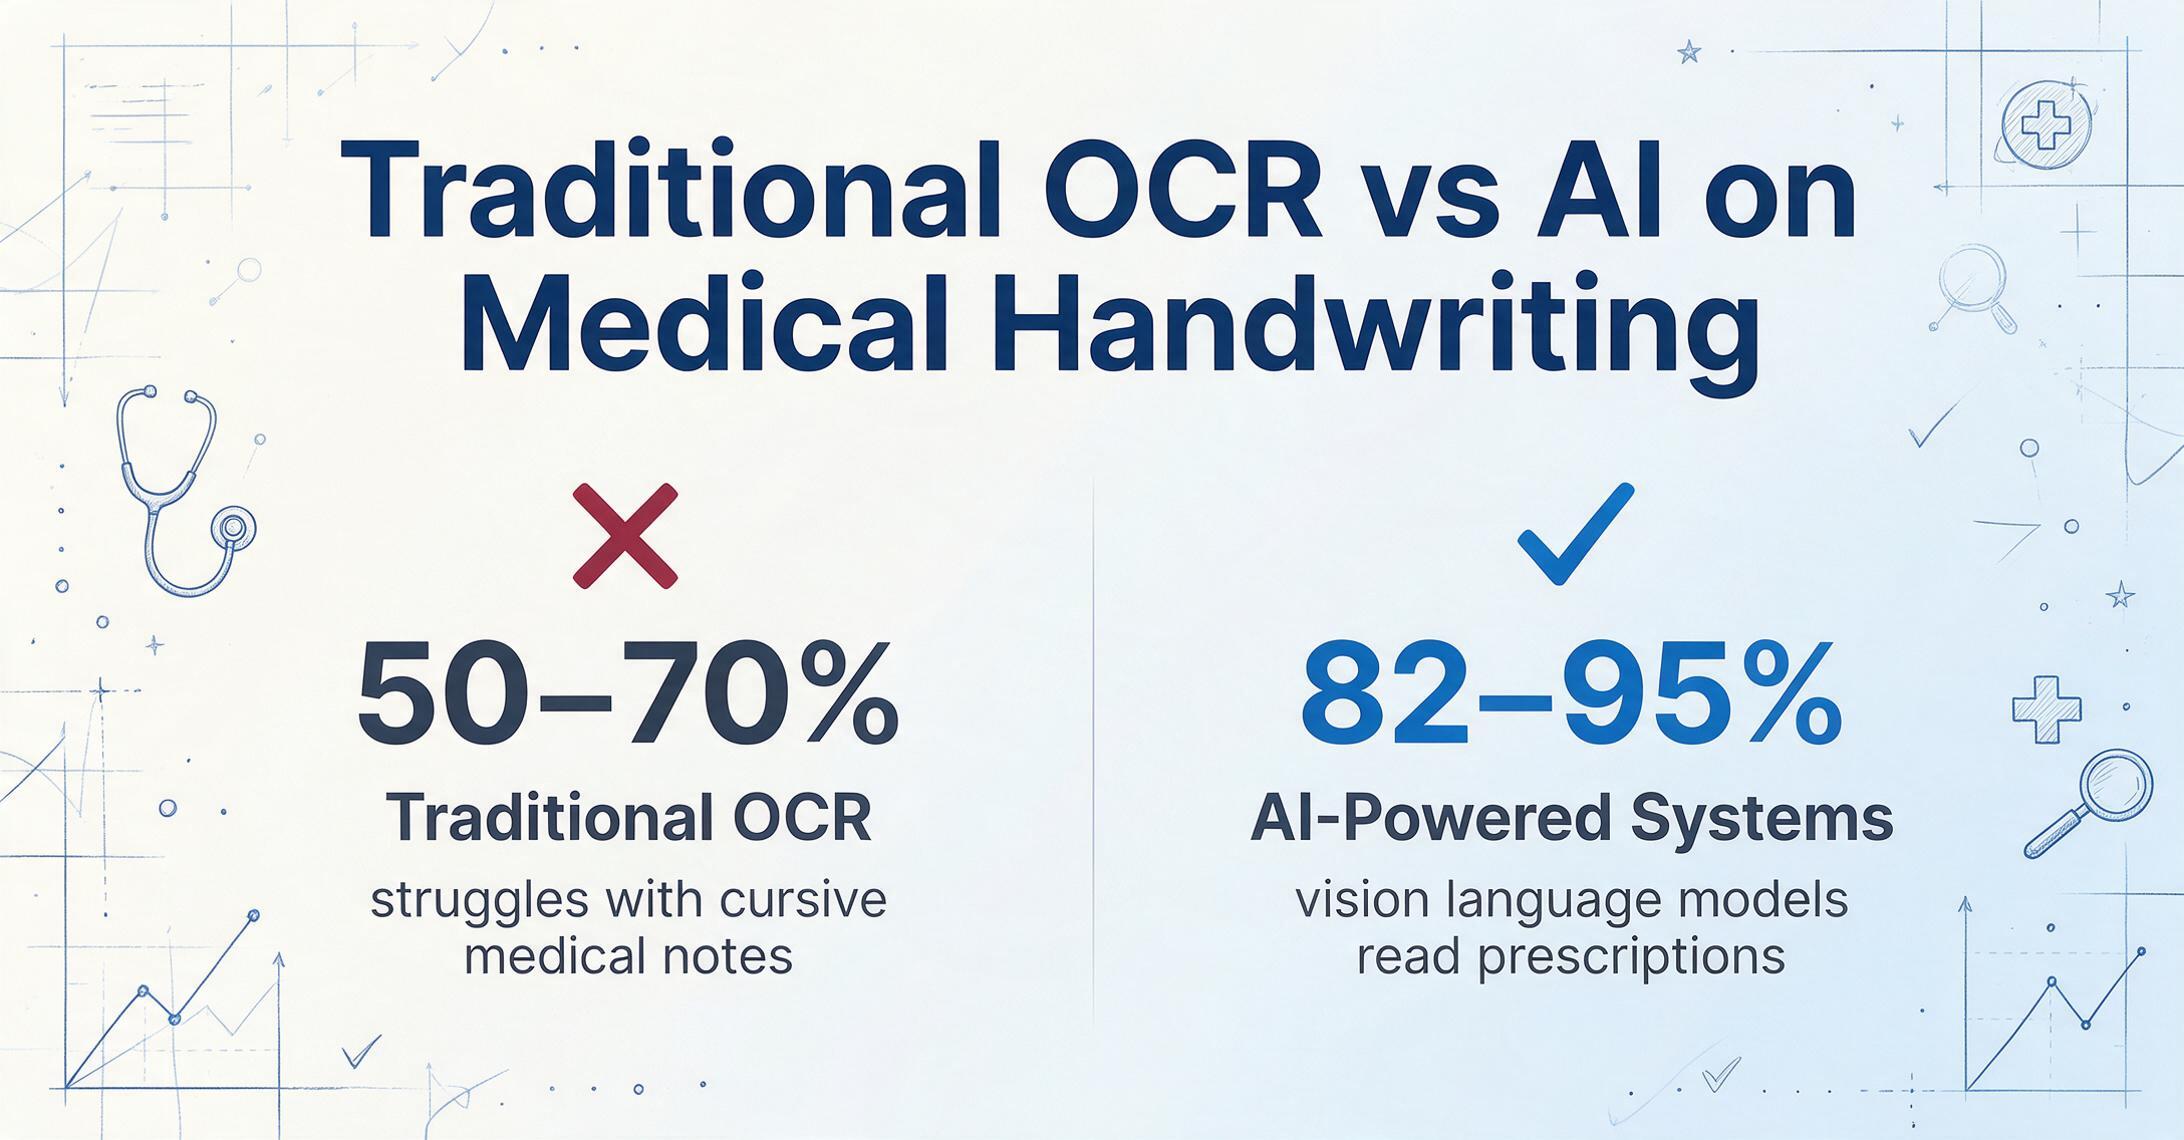
A caligrafia médica é um gargalo notório no processamento de documentos de saúde. Pesquisas acadêmicas sobre OCR para prescrições médicas publicadas no European Journal of AI and Machine Learning confirmam que o OCR tradicional atinge cerca de 50–70% de precisão em caligrafia médica, enquanto sistemas com IA chegam a 82–95%. Avaliamos como cada ferramenta lida com anotações médicas em cursivo, receituários manuscritos e anotações de profissionais nas margens. Uma ferramenta que só lê texto impresso cobre talvez 60% da superfície real dos documentos de saúde.
3. Conformidade com HIPAA e suporte a BAA
O HIPAA não certifica softwares específicos. A conformidade é uma combinação das salvaguardas de segurança do fornecedor, das políticas e da disposição de assinar um Acordo de Associado Comercial (BAA). O Escritório de Direitos Civis (OCR) intensificou drasticamente a fiscalização em 2024–2025: as penalidades financeiras do HIPAA aumentaram 340%, e a Advocate Health pagou um acordo de $5,55 milhões após uma violação ligada a um associado comercial que não tinha um BAA adequado. Para qualquer ferramenta que processe informações de saúde protegidas (PHI), ter um BAA assinado não é opcional. Indicamos onde cada ferramenta oferece um BAA e, mais importante, onde não oferece.
4. Integração com EHR e gestão de consultórios
As organizações de saúde funcionam em ecossistemas de software específicos: a Epic domina os grandes sistemas hospitalares, a Oracle Cerner (agora Oracle Health) atende centros médicos acadêmicos, a Meditech serve hospitais comunitários, a Athenahealth e a eClinicalWorks lideram o atendimento ambulatorial, e a Kareo e a AdvancedMD atendem consultórios pequenos. Uma ferramenta que gera arquivos Excel mas não consegue enviar dados para um fluxo de trabalho de EHR exige uma etapa manual intermediária. Avaliamos a profundidade de integração de cada ferramenta — de conectores nativos de EHR a arquiteturas API-first que um desenvolvedor pode conectar a um pipeline HL7 FHIR.
5. Modelo de implantação e tempo até o valor
As equipes de TI da área de saúde estão cronicamente sobrecarregadas. Segundo dados da HIMSS 2025, 86% dos sistemas de saúde usam alguma forma de IA, mas apenas 18% estão prontos para implantá-la na prestação de cuidados. A lacuna não é desejo — é capacidade de implementação. Avaliamos cada ferramenta em um espectro que vai de "minutos até a primeira extração" (sem código, baseado em navegador) a "implantação empresarial de meses" (instalação local, treinamento de modelo, configuração de fluxo de trabalho). A escolha certa depende da capacidade técnica da sua equipe e da urgência do problema.
Para um olhar mais aprofundado sobre como a extração com IA difere do reconhecimento de caracteres tradicional no processamento de documentos, nosso guia sobre o que é OCR com IA e como funciona aborda a mudança tecnológica que torna possível a extração semântica. O guia completo sobre o que é OCR fornece a compreensão básica de como o OCR tradicional funciona e onde estão seus limites.
ImageToTable.ai — Melhor Extração No-Code para Diversos Documentos Médicos
Ideal para: equipes de saúde — administradores de clínicas, equipes de faturamento médico, processadores de sinistros de seguros — que precisam extrair dados estruturados de uma grande variedade de documentos médicos sem configurar modelos ou treinar modelos. Não ideal para: organizações que exigem um BAA assinado para conformidade com HIPAA, integração nativa com EHR ou implantação local.
O ImageToTable.ai usa um modelo de linguagem visual que lê documentos da mesma forma que um humano: entende o que cada campo significa, não onde ele está na página. Isso importa na área da saúde porque os documentos médicos vêm em mais variações de layout do que quase qualquer outro setor. Um laudo de laboratório de um sistema hospitalar coloca o nome do paciente no canto superior esquerdo; outro o coloca em um cabeçalho centralizado. Um EOB da Cigna usa tabelas de resumo aninhadas; um da UnitedHealthcare usa listagens simples de itens. Ferramentas baseadas em modelo quebram com essas diferenças. A extração semântica não.
A Extração de Colunas Personalizadas é o mecanismo central: você digita os nomes das colunas que deseja — "Código CPT", "ICD-10 Dx", "Revenue Code", "Nome do Paciente", "Valor da Cobrança" — e a IA localiza cada valor entendendo o significado semântico do campo. Ela distingue automaticamente um código CPT (identificador de procedimento de cinco dígitos) de um Revenue Code (código de local de quatro dígitos), colocando cada um na coluna de saída correta. Isso é fundamentalmente diferente de ferramentas baseadas em modelo que despejam todos os códigos em um único campo "Código", independentemente do tipo.
A ferramenta lida com texto impresso, manuscrito, caixas de seleção, tabelas e assinaturas. O processamento em lote é prioridade: envie 50 EOBs de diferentes seguradoras como um único lote e receba um arquivo Excel unificado com colunas consistentes. O complemento do Google Sheets permite que os usuários enviem documentos e anexem resultados diretamente a uma planilha sem sair do Sheets. O processamento leva de 5 a 10 segundos por página — uma melhoria de 18x em relação à média de 3 minutos de entrada manual de dados. Para um passo a passo completo do fluxo de trabalho de EOB para Excel — desde a definição de colunas até a exportação do lote mesclado — consulte nosso guia sobre converter EOBs para Excel.
Os preços começam com um nível gratuito (extrações limitadas por mês), depois $9/mês (Basic) e $59/mês (Pro). Não é necessária nenhuma configuração além de criar uma conta. A desvantagem é significativa para a área da saúde: o ImageToTable.ai não oferece um BAA atualmente, portanto não é adequado para fluxos de trabalho que exigem tratamento de PHI por fornecedor em conformidade com HIPAA. Funciona bem para processamento de documentos desidentificados, uso administrativo interno onde o PHI não é transmitido ao serviço, ou como ferramenta de produtividade para profissionais de saúde individuais que lidam com seus próprios dados.
Amazon Textract — Melhor para pipelines de saúde nativos da AWS com alto volume
Melhor para: organizações de saúde que já investiram na AWS e processam grandes volumes de documentos padronizados — formulários de admissão, formulários de sinistros, cartões de seguro — e têm capacidade de DevOps para criar e manter pipelines de extração. Não ideal para: equipes sem experiência em infraestrutura AWS ou que precisam de uma interface de usuário pronta para uso.
O Amazon Textract é um serviço da AWS elegível para HIPAA (BAA disponível por meio do BAA padrão da AWS), o que o torna uma das opções mais diretas para organizações de saúde que precisam de infraestrutura de nuvem em conformidade. Ele extrai texto, manuscritos, formulários e tabelas de documentos digitalizados. A Change Healthcare usou o Textract para processar mais de 16 milhões de páginas, reduzindo o tempo de processamento por documento de 3 minutos para menos de 1 minuto e alcançando uma taxa de automação de 68%, segundo estudos de caso de clientes da AWS.
O Textract se integra nativamente ao AWS HealthLake, ao Amazon Comprehend Medical (para detecção de PHI e extração de entidades médicas) e a outros serviços da AWS, o que o torna um excelente bloco de construção para automação de saúde personalizada. Ele lida com texto impresso e manuscrito, com boa precisão em formulários padronizados. No entanto, o Textract é somente API — não há interface gráfica para enviar documentos e revisar resultados. A conformidade com HIPAA exige configuração manual do ambiente AWS (criptografia, controles de acesso, registro de auditoria) em vez de ser padrão. O preço é por página e varia conforme o volume; em escala, está entre as opções mais econômicas.
Google Document AI — Melhor para fluxos de trabalho de saúde baseados no GCP
Melhor para: equipes de saúde que usam o Google Cloud e precisam de processadores pré-treinados para documentos médicos comuns, com opções de revisão humana no processo. Não ideal para: equipes fora do ecossistema GCP ou que processam tipos de formulários personalizados altamente variáveis.
O Google Document AI oferece processadores pré-treinados para faturas, recibos, W-2s e documentos de identidade, além da capacidade de treinar extratores personalizados por meio de seu nível AutoML. Sua integração com o Vertex AI e o Gemini permite sumarização e raciocínio sobre os dados extraídos — um recurso útil para extração de dados de ensaios clínicos, sumarização de prontuários médicos e automação de admissão de pacientes. O Google oferece um BAA para serviços do GCP, tornando o Document AI disponível para cargas de trabalho elegíveis para HIPAA.
O ponto forte aqui é o ecossistema mais amplo do Google: o Document AI alimenta o BigQuery para análises, a Healthcare API para troca de dados nativos do FHIR e o Vertex AI para desenvolvimento de modelos personalizados. A limitação é que os processadores pré-treinados cobrem apenas um conjunto fixo de tipos de documentos; para formulários médicos altamente específicos (um layout exclusivo de laudo laboratorial de um sistema hospitalar regional), é necessário treinamento personalizado. O preço combina processamento de OCR com recursos de GenAI, o que pode se tornar complexo em escala para pipelines de extração de várias etapas.
Azure Document Intelligence — Melhor para sistemas de saúde centrados na Microsoft
Ideal para: organizações de saúde que usam infraestrutura Microsoft (Active Directory, Office 365, Dynamics 365) e precisam de processamento de documentos compatível com HIPAA com fortes controles de governança. Não ideal para: equipes sem experiência em Azure ou que precisam de uma interface de extração sem código.
O Azure Document Intelligence (antigo Form Recognizer) oferece modelos pré-construídos para tipos comuns de documentos e recursos de extração personalizada via Azure AI. Está coberto pelo BAA da Microsoft para conformidade com HIPAA quando configurado corretamente, e se integra aos frameworks de controle de acesso baseado em funções, registro de auditoria e criptografia do Azure — pontos fortes naturais para organizações que já gerenciam PHI dentro do limite de conformidade da Microsoft.
O Azure DI lida com texto impresso, manuscrito, tabelas e pares chave-valor. Seus modelos pré-construídos cobrem faturas, recibos, documentos de identidade e cartões de plano de saúde. Para documentos específicos da área da saúde, como laudos laboratoriais ou EOBs, geralmente é necessário treinar modelos personalizados. A plataforma oferece suporte a .NET, Python e APIs REST, o que a torna acessível a equipes de desenvolvimento centradas na Microsoft. O preço segue um modelo de pagamento por página, com descontos por volume.
Visite o Azure Document Intelligence →
ABBYY Vantage — Melhor IDP empresarial para saúde regulamentada
Ideal para: grandes sistemas de saúde e operadoras de seguros que precisam de uma plataforma madura de processamento de documentos com pouco código, com skills pré-treinadas e recursos abrangentes de conformidade. Não ideal para: consultórios pequenos ou equipes que precisam de extração rápida e sem modelo, sem um ciclo de implantação.
A ABBYY é uma das líderes históricas em OCR e processamento inteligente de documentos, com uma plataforma usada em setores regulamentados, incluindo a saúde. O ABBYY Vantage oferece "skills" pré-treinadas (modelos de extração para tipos específicos de documentos), um construtor de skills com pouco código para formulários personalizados e conectores de integração para sistemas ECM e plataformas ERP. Suporta reconhecimento de manuscrito, embora a precisão em anotações médicas cursivas densas seja moderada em comparação com ferramentas mais recentes nativas de IA.
A ABBYY oferece um BAA e tem experiência significativa com implantações na área da saúde. Seu ponto forte é a abrangência: consegue cobrir faturas, sinistros, formulários de pacientes, documentos de ensaios clínicos e correspondência de prestadores em uma única plataforma. A contrapartida é que a implantação geralmente leva de semanas a meses, o preço é cotado sob medida e de nível empresarial (cinco dígitos anuais ou mais), e a plataforma exige esforço administrativo dedicado para manter as skills de extração à medida que os formatos dos documentos mudam. Para grandes organizações com uma equipe dedicada de processamento de documentos, o ABBYY Vantage é uma escolha comprovada.
Nanonets — Melhor para modelos de documentos médicos de nicho treinados sob medida
Ideal para: organizações que processam um alto volume de um tipo específico e estável de documento médico e têm recursos para treinar e manter um modelo dedicado. Não ideal para: equipes que precisam de extração sem configuração em diversos layouts de documentos diferentes.
O Nanonets oferece uma plataforma de OCR com IA e mais de 300 modelos pré-treinados em categorias de documentos como formulários de saúde, documentos de seguros e prontuários médicos. Seu principal diferencial é o pipeline de treinamento: os usuários enviam documentos de exemplo (normalmente 20–50 por formato), rotulam os campos e a plataforma treina um modelo de extração personalizado. Para um sistema hospitalar que processa o mesmo formato de laudo laboratorial de 50 clínicas afiliadas, isso pode proporcionar alta precisão. O Nanonets oferece um BAA para clientes empresariais e suporta implantação em nuvem e local.
A limitação é que cada novo formato de documento exige um novo ciclo de treinamento. Uma clínica que recebe laudos laboratoriais de cinco sistemas hospitalares diferentes precisa de cinco conjuntos de treinamento rotulados. Uma equipe de faturamento médico que processa EOBs de 20 planos de saúde diferentes precisa de 20 iterações de treinamento. Para formatos estáveis e de alto volume, o investimento inicial compensa. Para conjuntos de documentos diversos e variáveis, o custo de manutenção do treinamento se acumula. Os preços começam com um plano gratuito (páginas limitadas) e escalam para planos empresariais personalizados.
LlamaParse (LlamaIndex) — Melhor para produtos de IA em saúde liderados por desenvolvedores
Ideal para: equipes de engenharia que criam aplicações agênticas de saúde — assistentes clínicos, pipelines automatizados de codificação médica, ferramentas de síntese de pesquisa — que precisam de compreensão profunda de documentos com pontuações de confiança em nível de campo e citações de fontes. Não ideal para: equipes de saúde não técnicas que precisam de uma interface gráfica para processamento de documentos.
O LlamaParse adota uma abordagem agêntica para o processamento de documentos: em vez de modelos frágeis ou extração baseada em layout, ele usa IA multimodal para entender a estrutura do documento, tabelas, caligrafia e gráficos, e então extrai dados estruturados com pontuações de confiança em nível de campo. Ele se integra ao ecossistema mais amplo do LlamaIndex para pipelines de RAG, o que o torna uma ótima opção para organizações que criam produtos de IA cientes de documentos com base em seus próprios dados médicos.
A plataforma suporta extração baseada em esquema (LlamaExtract), em que você define os campos necessários (MRN, códigos ICD-10, nomes de medicamentos, valores laboratoriais, dosagens) e a IA os extrai com citações em nível de página para auditabilidade. O LlamaIndex oferece um BAA para clientes empresariais e suporta implantação em nuvem e auto-hospedada. A desvantagem é que ele é API-first e baseado em SDK (Python + TypeScript), sem interface no-code. Os preços começam com um plano gratuito para avaliação e escalam para orçamentos empresariais personalizados.
Docsumo — Melhor para Processamento Administrativo e de Sinistros de Planos de Saúde
Melhor para: seguradoras de saúde, administradores terceirizados (TPAs) e equipes de faturamento médico de back-office que processam grandes volumes de formulários estruturados, documentos de sinistros e papéis de seguro. Não ideal para: extração de documentos clínicos de anotações manuscritas de médicos ou relatórios de laboratório complexos.
O Docsumo é uma plataforma de processamento inteligente de documentos de uso geral que se destaca em documentos estruturados e semiestruturados comuns na administração de saúde: formulários de sinistros, Explicação de Benefícios, documentos de verificação de elegibilidade e solicitações de seguro. Ele oferece modelos pré-treinados para tipos comuns de documentos, regras de validação integradas e integração com fluxos de trabalho via API e webhooks. Um BAA está disponível para clientes da área de saúde.
Os pontos fortes do Docsumo estão no lado administrativo da saúde — para uma seguradora de saúde que processa 10.000 formulários de sinistros por mês com layouts estáveis, ele oferece processamento direto confiável. Seu reconhecimento de manuscrito é limitado em comparação com ferramentas nativas de IA, então não é a escolha certa para receitas manuscritas ou anotações clínicas. O preço é cotado sob demanda e baseado no volume de documentos.
Hyland OnBase — Melhor Gerenciamento de Documentos Empresarial com Captura para Saúde
Melhor para: grandes sistemas de saúde que precisam de uma plataforma unificada de serviços de conteúdo empresarial combinando gerenciamento de documentos, captura, fluxo de trabalho e conformidade — com OCR como um componente dentro de uma infraestrutura mais ampla. Não ideal para: equipes que precisam de uma ferramenta de extração de documentos independente, sem uma grande implantação de ECM.
O Hyland OnBase é uma plataforma madura de serviços de conteúdo empresarial com forte penetração na área de saúde. Ele oferece captura de documentos, indexação, armazenamento, automação de fluxos de trabalho e gerenciamento de liberação de informações — tudo dentro de uma estrutura compatível com HIPAA e com um BAA. Seu módulo de captura usa OCR para classificar e extrair dados de documentos digitalizados, encaminhando-os para os fluxos de trabalho clínicos ou administrativos apropriados.
O OnBase é usado por centenas de hospitais para digitalizar e indexar prontuários de pacientes, EOBs e documentos administrativos. Usuários do Reddit no r/healthIT descrevem o uso do "onbase para indexar digitalizações/faxes em massa no prontuário" como parte de um fluxo de trabalho manual, mas flexível. A contrapartida é que o OnBase é uma plataforma empresarial enorme: a implantação leva meses, os custos são cotados sob demanda e normalmente chegam a seis dígitos, e o reconhecimento de manuscrito é básico. É um investimento em gerenciamento de conteúdo com recursos de extração, não uma ferramenta focada primeiro em extração.
Kofax — Melhor Captura de Documentos Empresarial em Escala
Ideal para: grandes organizações de saúde e terceirizadoras de processos de negócios que processam milhões de páginas por mês através de fluxos de captura automatizados com validação e classificação. Não ideal para: pequenas clínicas, profissionais autônomos ou qualquer equipe que precise de uma ferramenta de extração leve.
A Kofax (parte da Tungsten Automation) oferece captura inteligente de documentos empresarial com classificação, extração e validação com IA. Sua plataforma digitaliza, classifica, extrai dados e encaminha documentos por fluxos de trabalho de saúde — desde a digitalização na admissão de pacientes até o processamento de EOB no departamento de ciclo de receita. A Kofax oferece um BAA e tem experiência significativa em implantações na área de saúde.
O ponto forte da plataforma é a captura automatizada de alto volume: digitalizar 50.000 páginas por dia, classificar tipos de documentos automaticamente, extrair campos-chave e validá-los com base em regras de negócio antes de encaminhar aos sistemas downstream. O trade-off é a complexidade: implantações da Kofax normalmente exigem serviços profissionais, meses de configuração e gastos de capital significativos. O reconhecimento de escrita manual é limitado. Para organizações abaixo da escala empresarial, é exagero.
Koncile — Melhor OCR de Saúde API-First para Receitas e Documentos Médicos
Ideal para: empresas de tecnologia em saúde e plataformas de saúde digital que precisam de um serviço de OCR API-first com forte desempenho em receitas e processamento de documentos médicos em conformidade com o francês/GDPR. Não ideal para: equipes focadas nos EUA que precisam de extração no-code ou integrações profundas com EHR Epic/Cerner.
A Koncile é uma plataforma de OCR com IA focada em saúde, criada principalmente para o mercado europeu, com forte desempenho em receitas, laudos médicos e documentos clínicos. Ela oferece modelos de extração de saúde prontos e uma arquitetura API-first que a torna adequada para integração em produtos de saúde digital e plataformas de automação de farmácias. A Koncile oferece um equivalente ao BAA sob o GDPR e hospeda dados em servidores franceses.
Seu reconhecimento de escrita manual é mais forte que ferramentas de OCR de uso geral devido ao treinamento especializado em amostras de escrita médica, incluindo anotações de receitas. O trade-off é geográfico: o treinamento de documentos da Koncile é mais forte em formatos médicos europeus, e seu ecossistema de integração não inclui sistemas de EHR específicos dos EUA. O preço é cotado sob medida e baseado em volume.
Tesseract — Melhor OCR de código aberto gratuito como base
Ideal para: desenvolvedores que criam pipelines personalizados de processamento de documentos de saúde e precisam de um mecanismo de OCR gratuito e auto-hospedado para extração de texto impresso como ponto de partida. Não ideal para: qualquer fluxo de trabalho de saúde que envolva escrita à mão, layouts complexos, extração de dados estruturados ou processamento direto de PHI sem reforço de segurança adicional.
O Tesseract é o mecanismo de OCR de código aberto mais usado, mantido pelo Google desde 2006. A versão 5 (lançada em 2024) adicionou reconhecimento por rede neural baseada em LSTM, o que melhorou a precisão em texto impresso limpo. Ele oferece suporte a mais de 100 idiomas e pode ser personalizado e estendido para tipos específicos de documentos.
Na área da saúde, o valor do Tesseract se limita a texto impresso em documentos limpos e com alto contraste. Ele tem capacidade mínima para escrita à mão — pesquisas acadêmicas confirmam que o Tesseract alcança cerca de 64% de precisão em escrita médica à mão — e nenhuma extração de dados estruturados. Um código ICD-10 extraído pelo Tesseract cai em um bloco de texto simples, sem rótulo de campo, exigindo processamento adicional para identificar e encaminhar cada código. O Tesseract não tem BAA, não tem registro de auditoria e não tem infraestrutura de tratamento de PHI por padrão; qualquer uso compatível com HIPAA exige que a organização implantadora construa controles de segurança ao redor dele. É um componente útil em um pipeline personalizado, não uma solução de OCR de saúde autônoma.
Qual ferramenta é certa para sua organização de saúde?
Uma única ferramenta não atende a todas as necessidades de OCR na área da saúde, porque a saúde não é um único fluxo de trabalho — é uma coleção de problemas de processamento de documentos drasticamente diferentes que, por acaso, compartilham um mesmo arcabouço regulatório. Veja como combinar sua situação com a categoria de ferramenta certa.
Você administra uma clínica pequena ou consultório individual
Você processa fichas de admissão de pacientes, cartões de plano de saúde e um volume modesto de EOBs. Você não tem equipe de TI e precisa de algo que funcione em minutos. O ImageToTable.ai é a opção mais prática para transformar formulários digitalizados em dados estruturados sem configuração. Para processamento de PHI na nuvem em conformidade com a HIPAA, o Google Document AI ou o Azure Document Intelligence com um BAA são viáveis se você tiver disponibilidade administrativa para configurar a conta na nuvem. Para uma opção totalmente gratuita, mas limitada, o Tesseract por meio de uma interface gráfica consegue lidar com texto impresso em documentos limpos — mas espere verificar cada resultado.
Você administra um grupo médico de médio porte ou uma rede de atenção ambulatorial
Você usa um EHR como Athenahealth, eClinicalWorks ou Kareo. Seu volume de documentos é de milhares por mês — EOBs, cartas de encaminhamento, laudos laboratoriais de vários laboratórios. Você precisa de flexibilidade entre formatos, mas pode não ter uma equipe dedicada de engenharia de dados. O ImageToTable.ai lida bem com a diversidade de formatos e não exige configuração de modelo. Se sua organização exige proteção via BAA, o Docsumo para documentos administrativos ou o Nanonets para documentos de alto volume e formato estável são adequados. O Google Document AI com sua Healthcare API pode fazer a ponte para FHIR se você tiver os recursos técnicos.
Você trabalha em um grande sistema de saúde ou rede hospitalar
Você usa Epic, Oracle Cerner ou Meditech. Você processa milhões de páginas por ano — prontuários de pacientes, sinistros de seguro, documentos de ensaios clínicos, correspondência de prestadores. Você tem um departamento de TI e um escritório de conformidade. O Hyland OnBase ou o Kofax são as escolhas empresariais consolidadas para captura mais gestão de conteúdo, com integração comprovada em grandes fluxos de trabalho hospitalares. O ABBYY Vantage oferece uma alternativa mais focada em extração, com criação de habilidades low-code. O Amazon Textract conectado a um pipeline FHIR do AWS HealthLake é a opção nativa da nuvem mais escalável para organizações com capacidade de DevOps.
Você trabalha para uma operadora de saúde ou TPA
Sua necessidade central de OCR é o processamento de sinistros — CMS-1500, UB-04, dados de encontros e EOBs — em alto volume e com formatos consistentes. O Docsumo e o Nanonets têm forte processamento de formulários para documentos de seguro. O Amazon Textract na infraestrutura de saúde da AWS pode lidar com throughput muito alto com previsibilidade de custos. O ABBYY Vantage cobre todo o ciclo de vida dos sinistros, da entrada ao suporte à adjudicação.
Você está criando um produto de tecnologia para saúde
Sua necessidade de OCR está incorporada ao seu próprio aplicativo — um assistente clínico, uma ferramenta de automação de codificação médica, um produto de dados de saúde voltado ao paciente. O LlamaParse oferece o kit de ferramentas para desenvolvedores mais avançado, com extração guiada por esquema e pontuações de confiança por campo. O Amazon Textract é uma API comprovada para alto volume. O Azure Document Intelligence integra-se bem com stacks .NET. O Koncile é uma opção especializada para casos de uso de saúde na Europa com conformidade com o RGPD.
Para uma visão mais ampla do cenário de OCR, incluindo opções gratuitas e alternativas de código aberto, consulte nosso guia dos melhores softwares de OCR gratuitos e nossa comparação das melhores ferramentas de OCR de código aberto. Se documentos médicos manuscritos são seu principal desafio — e para muitas equipes de saúde são —, nosso resumo de OCR para manuscritos aprofunda essa capacidade específica. Para uma visão geral que inclui ferramentas empresariais não abordadas aqui, melhores softwares de OCR 2026 mapeia todo o cenário.
Perguntas frequentes
O que torna uma ferramenta de OCR compatível com a HIPAA?
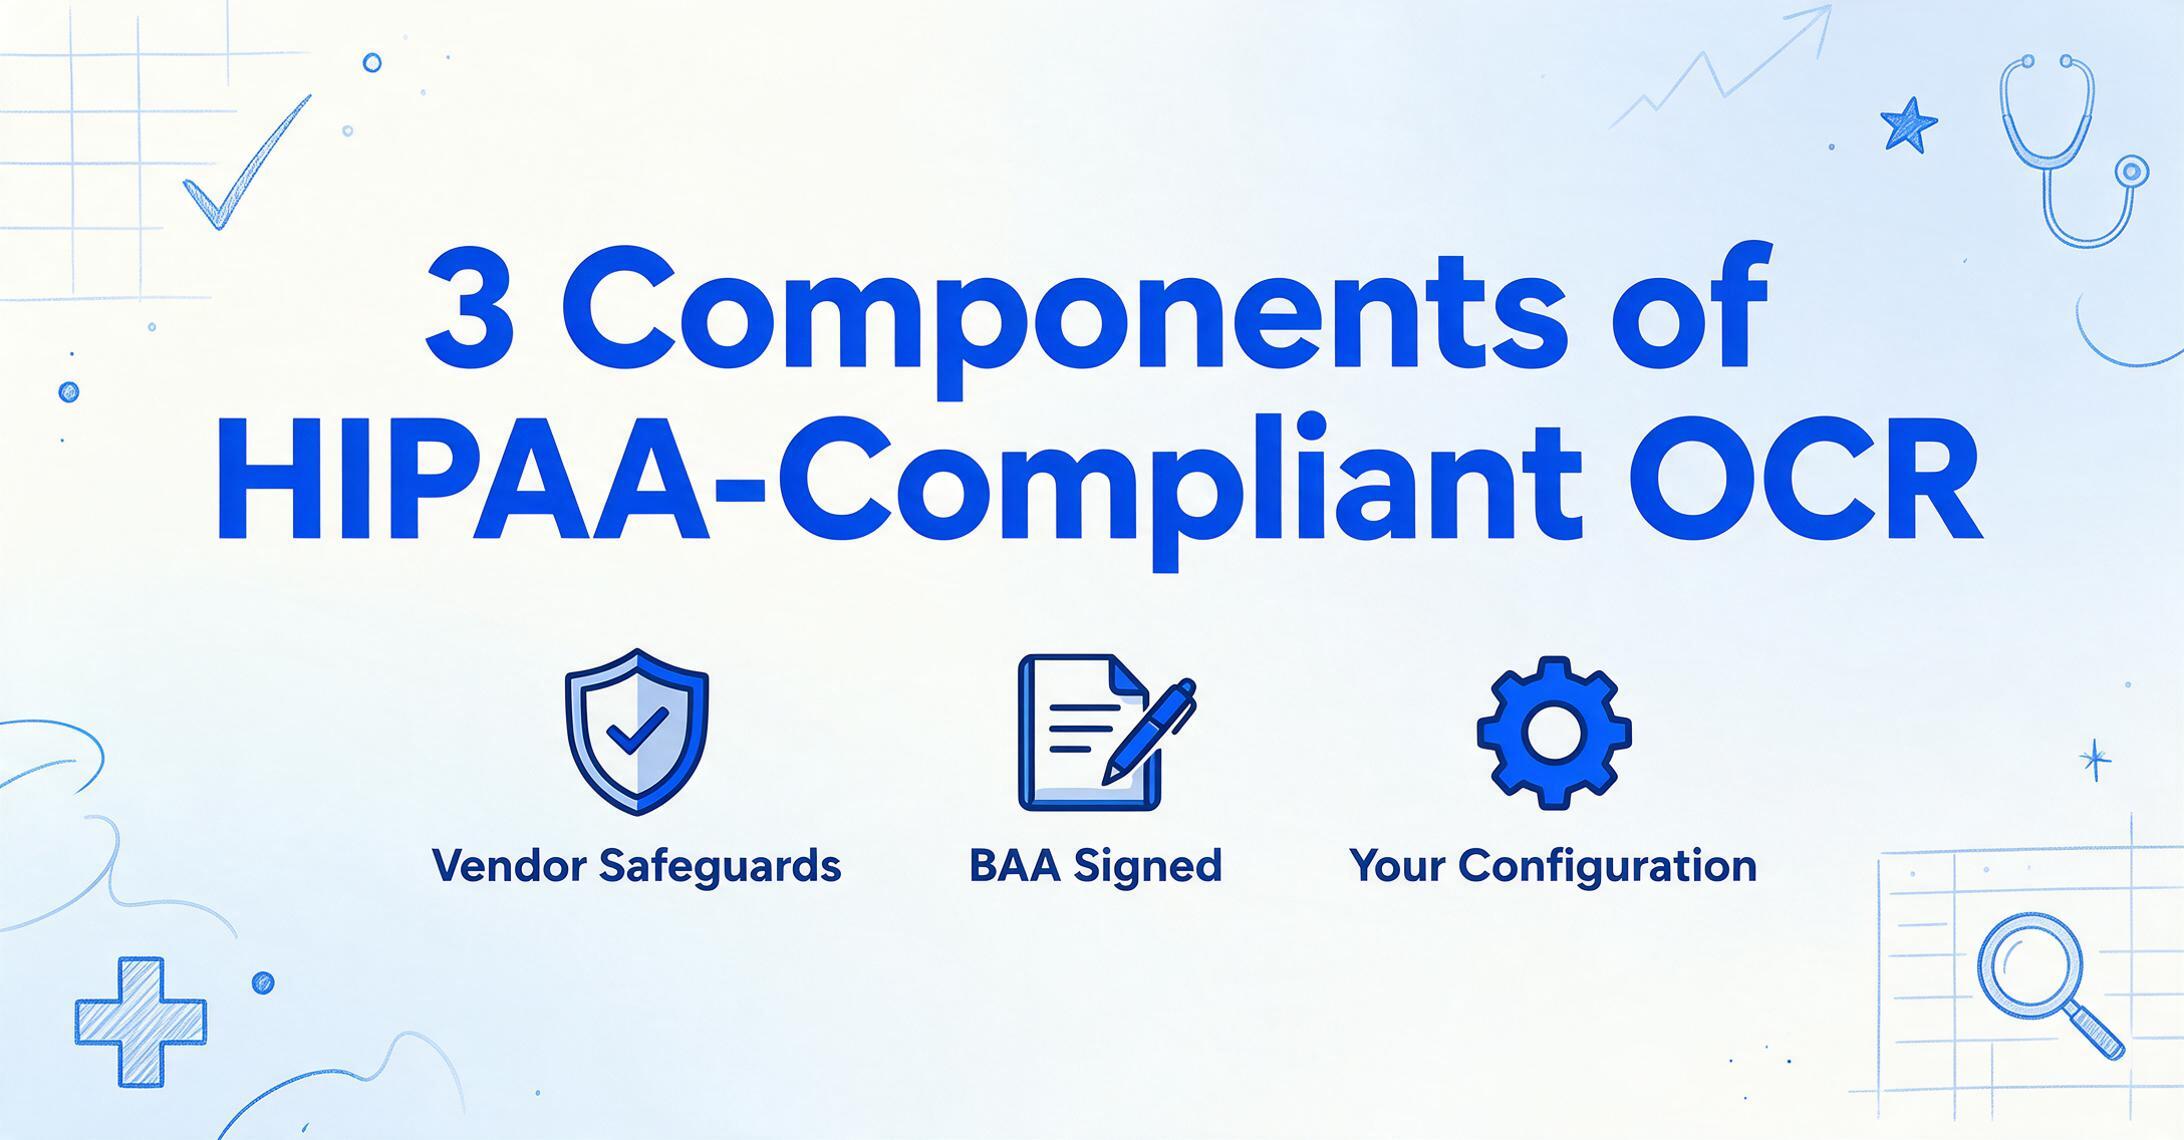
A conformidade com a HIPAA para softwares de OCR exige três componentes trabalhando em conjunto. Primeiro, o fornecedor deve manter salvaguardas de segurança robustas — criptografia em repouso e em trânsito, controles de acesso baseados em função, registro de auditoria abrangente e políticas claras de tratamento de PHI. Segundo, o fornecedor deve assinar um Acordo de Associado Comercial (BAA) que o vincule contratualmente aos requisitos da Regra de Privacidade e Segurança da HIPAA para qualquer PHI que processe em seu nome. Terceiro, sua organização deve configurar e operar a ferramenta dentro do seu próprio programa de conformidade com a HIPAA — um BAA não torna seu fluxo de trabalho compatível se você configurar a ferramenta para armazenar PHI em um local não criptografado ou conceder acesso a usuários não autorizados. O Escritório de Direitos Civis deixou claro, por meio de ações de fiscalização — incluindo o acordo de US$ 5,55 milhões da Advocate Health —, que tanto o acordo com o fornecedor quanto os controles operacionais devem estar em vigor.
O OCR consegue ler com precisão a caligrafia dos médicos?
Esta é a pergunta mais comum em OCR na área da saúde, e a resposta honesta é: depende da caligrafia e da ferramenta. O OCR tradicional atinge cerca de 50–70% de precisão em texto médico manuscrito. Ferramentas modernas com IA, incluindo modelos de linguagem visual, chegam a 82–95% em caligrafia médica — uma melhoria significativa, mas ainda abaixo da precisão de texto impresso. Os melhores resultados vêm de ferramentas treinadas especificamente com amostras de caligrafia médica ou construídas sobre modelos de linguagem visual que entendem o contexto semântico (uma sequência de cinco caracteres após "Dx:" provavelmente é um código de diagnóstico, mesmo que um caractere seja ambíguo). Nenhuma ferramenta de OCR atinge 99% em caligrafia. Para dados clínicos críticos — nomes de medicamentos, dosagens, códigos de diagnóstico — sempre reserve tempo para verificação humana com o documento original. Nosso resumo de OCR de caligrafia aborda este tema em profundidade.
O OCR consegue extrair códigos CPT e códigos ICD-10 de documentos médicos?
Sim, mas a qualidade da extração depende de a ferramenta entender a estrutura dos códigos ou apenas ler o texto bruto. Ferramentas com IA que usam extração semântica conseguem distinguir os tipos de código: códigos CPT são identificadores numéricos de cinco dígitos (99213, 93000), códigos ICD-10 são sequências alfanuméricas (E11.9, I10), Revenue Codes são identificadores de local de quatro dígitos (0450 para Pronto-Socorro) e códigos NDC de medicamentos são identificadores de 11 dígitos. Uma ferramenta que mapeia cada tipo de código para a coluna de saída correta é muito mais útil para faturamento médico e processamento de sinistros do que uma que despeja todos os códigos em um único campo de texto. Defina colunas separadas para cada tipo de código — "CPT Code", "ICD-10 Dx", "Revenue Code", "NDC" — e deixe a ferramenta encaminhá-los por tipo semântico.
O OCR se integra com Epic, Cerner ou Meditech?
A integração direta com EHR é a exceção, não a regra, entre as ferramentas de OCR. A maioria das ferramentas gera dados estruturados em Excel, CSV ou JSON, que depois precisam ser importados para o EHR por meio de uma interface ou camada de API separada. Plataformas empresariais como Hyland OnBase e Kofax têm conectores pré-construídos para os principais sistemas de EHR porque funcionam como plataformas de gestão de conteúdo que envolvem o registro clínico. Ferramentas de API em nuvem como o Amazon Textract se integram à API FHIR do AWS HealthLake, que por sua vez pode se conectar a um EHR. Para a maioria das ferramentas de OCR sem código, o fluxo de trabalho é: extrair dados para uma planilha → validar → enviar ou importar para o EHR. Esta etapa intermediária não é ideal, mas é a realidade prática para a maioria das organizações de saúde.
Existe alguma ferramenta de OCR gratuita para documentos de saúde?
O Tesseract é gratuito e de código aberto, mas suas limitações práticas para a área da saúde são significativas: suporte mínimo a escrita à mão, nenhuma extração de dados estruturados, nenhuma infraestrutura de segurança para PHI e uma interface apenas para desenvolvedores. O OCR integrado do Google Drive é gratuito e consegue gerar PDFs pesquisáveis a partir de documentos médicos digitalizados, mas produz texto simples — não dados estruturados com rótulos de campos. O ImageToTable.ai oferece um nível gratuito para extrações limitadas, o que é útil para testar se a extração semântica funciona nos seus documentos específicos antes de assinar um plano pago. Para uma comparação completa das opções gratuitas, veja nosso guia dos melhores softwares de OCR gratuitos.
O OCR consegue lidar com as tabelas aninhadas nos formulários de Explicação de Benefícios?
As tabelas aninhadas de EOB são um dos tipos de documento mais difíceis para o OCR tradicional, porque uma única célula da tabela pode conter tanto um valor em dólares quanto uma explicação codificada, com sublinhas indentadas sob os itens principais. Ferramentas baseadas em modelo geralmente achatam tudo em um único bloco de texto por linha, perdendo a hierarquia. Ferramentas com IA e compreensão de layout têm um desempenho muito melhor porque conseguem identificar a relação pai-filho entre uma cobrança principal e seus ajustes. O segredo é definir colunas que correspondam à estrutura do EOB: "Valor Cobrado", "Valor Permitido", "Pagamento do Seguro", "Responsabilidade do Paciente", "Código de Ajuste" — e deixar a IA mapear cada valor entendendo onde ele está na hierarquia lógica do documento, não lendo uma coordenada fixa da grade. Para um olhar mais aprofundado sobre como as ferramentas de extração lidam com EOB de múltiplos pagadores e formatos de sinistros, veja nossa seleção de ferramentas de extração de documentos de saúde; para a mecânica de OCR subjacente nos diversos tipos de documentos médicos, nosso guia de OCR para a área da saúde cobre todo o espectro de documentos.
E quanto ao processamento de receitas manuscritas?
Receitas manuscritas apresentam um desafio único para o OCR porque as consequências de uma leitura errada são clínicas, não apenas administrativas. Uma dosagem ou nome de medicamento lido incorretamente pode afetar diretamente a segurança do paciente. Estudos acadêmicos sobre OCR para processamento de receitas mostram que o OCR tradicional atinge cerca de 50–70% de precisão na escrita à mão de receitas, enquanto sistemas de IA treinados com amostras médicas chegam a 82–95%. A abordagem mais prática para farmácias e processadores de receitas é usar uma ferramenta com IA que consiga ler a escrita à mão de forma contextual (entendendo que "Metf" provavelmente é "Metformin") combinada com uma etapa de verificação por um farmacêutico para cada receita. Nenhuma ferramenta de OCR deve ser a única verificação em um fluxo de dispensação de receitas — o risco clínico é alto demais.
Quanto tempo leva para implantar OCR em um ambiente de saúde?
O prazo de implantação varia por categoria de ferramenta em ordens de magnitude. Ferramentas no-code como ImageToTable.ai: minutos até a primeira extração. Ferramentas de API em nuvem como Amazon Textract, Google Document AI ou Azure Document Intelligence: horas a dias para integração de API, além de tempo adicional para configurar infraestrutura compatível com HIPAA. Plataformas baseadas em treinamento como Nanonets: dias a semanas, dependendo de quantos formatos de documento precisam de amostras rotuladas e de quantas iterações o pipeline de treinamento exige. Plataformas empresariais como ABBYY Vantage, Hyland OnBase ou Kofax: meses, incluindo contratação de serviços profissionais, configuração de fluxos de trabalho, desenvolvimento de integrações e validação de conformidade. Segundo dados da HIMSS 2025, apenas 18% dos sistemas de saúde relatam estar prontos para implantar ferramentas de IA na prestação de cuidados — a lacuna não é a disponibilidade da tecnologia, é a capacidade de implementação. Escolha uma ferramenta cujo prazo de implantação corresponda à capacidade da sua organização de absorvê-la.
A Conclusão
O processamento de documentos de saúde em 2026 é uma história de duas lacunas. A lacuna tecnológica — o que as ferramentas com IA realmente conseguem fazer versus o que as equipes de saúde acreditam que elas conseguem fazer — está se fechando rapidamente. Os modelos de linguagem visual agora conseguem ler caligrafia médica, distinguir códigos CPT de códigos ICD-10 pela sua estrutura e extrair dados de tabelas de EOB aninhadas sem modelos. A lacuna de implementação — o abismo entre o que é tecnicamente possível e o que as organizações de saúde têm capacidade de implantar — continua sendo a restrição determinante.
A ferramenta de OCR certa para sua organização de saúde é aquela cujo modelo de implantação corresponde à capacidade técnica da sua equipe e cuja abordagem de extração corresponde à diversidade dos seus documentos. Se seus documentos são padronizados e seu volume é alto, uma plataforma baseada em treinamento ou empresarial entregará precisão previsível. Se seus documentos variam a cada hora — seguradoras diferentes, laboratórios diferentes, clínicas diferentes — uma abordagem semântica e sem modelo evita que você mantenha configurações de extração para cada variação de formato. E se você processa dados clínicos manuscritos — receitas, anotações médicas, laudos laboratoriais anotados — faça da capacidade de reconhecer caligrafia um critério de avaliação inegociável, não um recurso desejável.
Comece testando uma ferramenta nos documentos que sua equipe realmente processa — não os documentos perfeitos, os bagunçados. A ferramenta que torna sua papelada do mundo real extraível é a ferramenta que você deve usar.