ImageToTable.ai vs Nanonets :
Importer et extraire vs entraîner, configurer et maintenir
Nanonets est une plateforme de traitement de documents performante — mais avant d'extraire votre première facture, vous passerez 2 à 3 jours à collecter des échantillons d'entraînement étiquetés, à lancer des cycles d'entraînement de modèle et à itérer sur la précision. ImageToTable.ai n'exige rien de tout cela. La différence ne tient pas qu'à la commodité : c'est une architecture fondamentalement différente. L'une est conçue pour les équipes d'entreprise qui investissent dans la configuration de modèles en amont ; l'autre est conçue pour les équipes qui ont besoin de données structurées issues de documents dès aujourd'hui.
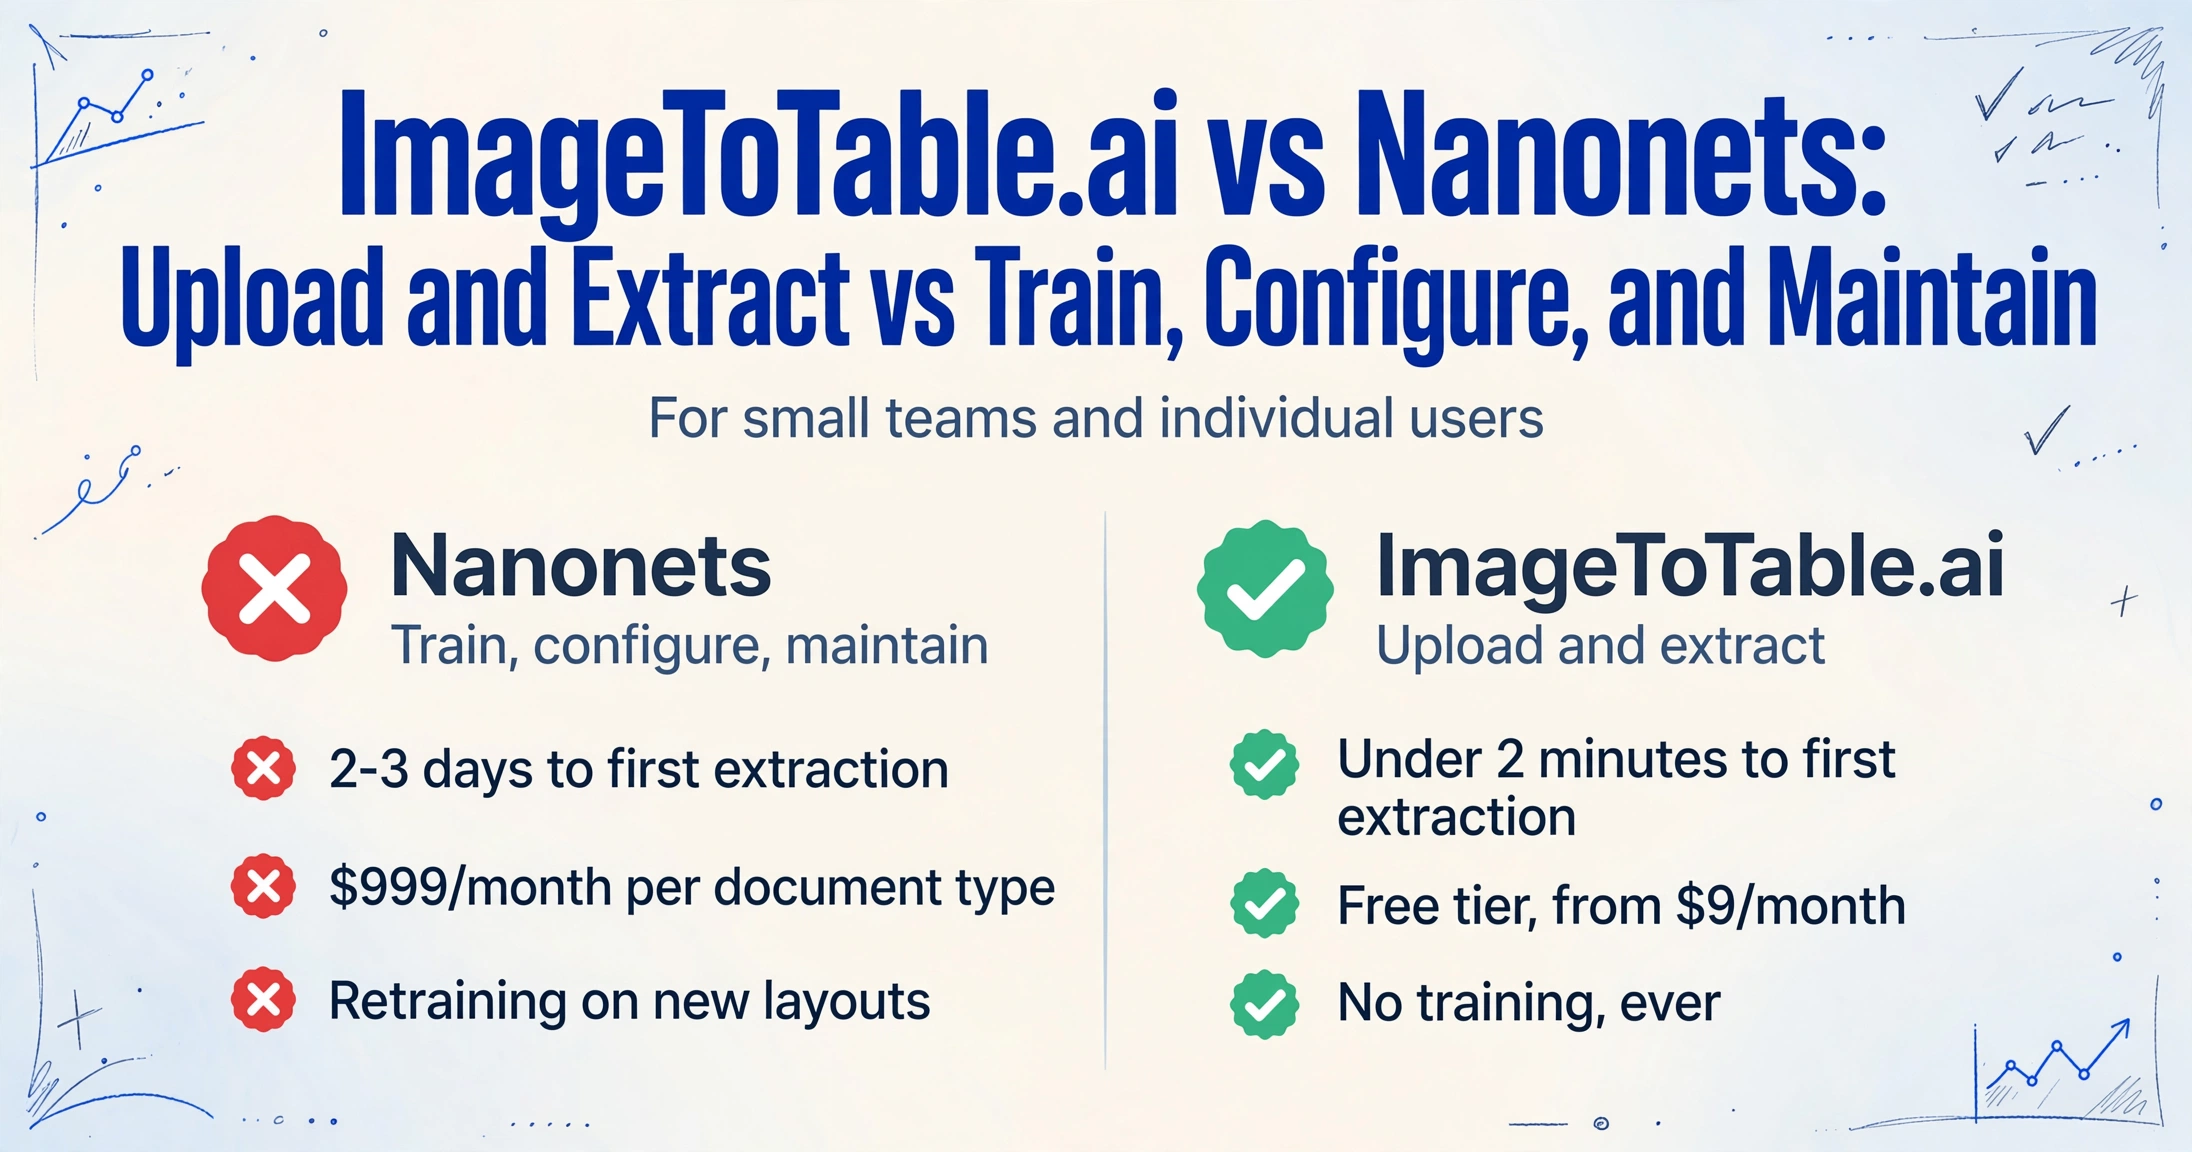
Comparaison rapide
Cette page s'adresse aux petites équipes et aux utilisateurs individuels. Si vous êtes une équipe AP d'entreprise traitant plus de 10 000 pages/mois et avez besoin d'intégrations ERP, lisez d'abord Quand Nanonets est le bon choix.
Choisissez ImageToTable.ai si…
- Vous avez besoin d'une extraction qui fonctionne aujourd'hui, pas après des jours d'entraînement de modèle
- Vos documents proviennent de nombreux fournisseurs avec des mises en page irrégulières
- Vous voulez définir les noms de colonnes en langage courant — sans construire de modèle
- Votre volume mensuel est inférieur à 5 000 pages et 999 $/mois par type de document est hors budget
- Vous avez besoin de résultats à partir d'images scannées, de photos de téléphone ou de formulaires manuscrits
Choisissez Nanonets si…
- Vous êtes une équipe AP ou financière d'entreprise traitant plus de 10 000 pages/mois
- Vous avez besoin d'intégrations ERP poussées : NetSuite, SAP, QuickBooks, Salesforce
- La conformité SOC 2, RGPD ou HIPAA est exigée par votre secteur
- Vous disposez de personnel technique pour configurer, entraîner et maintenir les modèles d'extraction
- Le traitement direct (sans relecture humaine par document) est l'objectif
Comparaison des fonctionnalités
| Fonctionnalité | Nanonets | ImageToTable.ai |
|---|---|---|
| Délai avant première extraction | 2–3 jours (collecte d'échantillons, annotation, entraînement du modèle, itération) ; modèles pré-entraînés disponibles pour les types courants, mais les champs personnalisés nécessitent un entraînement | Moins de 2 minutes — importez des fichiers, saisissez les noms de colonnes, téléchargez Excel |
| Entraînement du modèle requis | Oui pour les champs personnalisés — minimum 10 échantillons étiquetés par champ et par type de document ; réentraînement nécessaire en cas de nouvelles mises en page | Non — le LLM visuel lit directement la sémantique du document ; aucune donnée d'entraînement requise |
| Nommage personnalisé des colonnes | Configurable via l'annotation des champs dans le constructeur de modèle | Saisissez les noms de colonnes souhaités ; ils deviennent instantanément vos en-têtes Excel |
| Traitement par lots | Oui ; Starter limité à 2 pages/minute ; Pro à 20 pages/minute | Fichiers illimités par lot, tous fusionnés dans un seul tableau aligné |
| Documents scannés / manuscrits | Précision réduite sur les scans flous ; le modèle OCR ne prend pas en charge l'écriture manuscrite | Géré par le LLM visuel ; fonctionne sur les images scannées, les photos de téléphone et les formulaires manuscrits |
| Intégrations ERP / applications | Plus de 1 000 connecteurs natifs : NetSuite, SAP, Salesforce, QuickBooks, email, etc. | Export Excel, CSV, JSON, Word ; extension Google Sheets ; API REST sur les formules payantes |
| Certifications de conformité | SOC 2, RGPD, HIPAA | Non certifié pour les secteurs réglementés |
| Tarif d'entrée | 0,30 $/page (Starter, 2 pages/min) ; 500 premières pages gratuites | Niveau invité gratuit ; formules payantes à partir de 9 $/mois ; paiement à l'usage à partir de 6 $/50 pages |
| Tarifs équipe / workflow | Pro : 999 $/mois par workflow (par type de document), 10 000 pages incluses | Formule Équipe avec quota partagé ; pas de tarification par type de document |
| Facturation des extractions échouées | Le retraitement d'un document échoué consomme un crédit supplémentaire | Les extractions échouées ne consomment pas de crédits |
Avant votre première facture : la taxe de mise en place
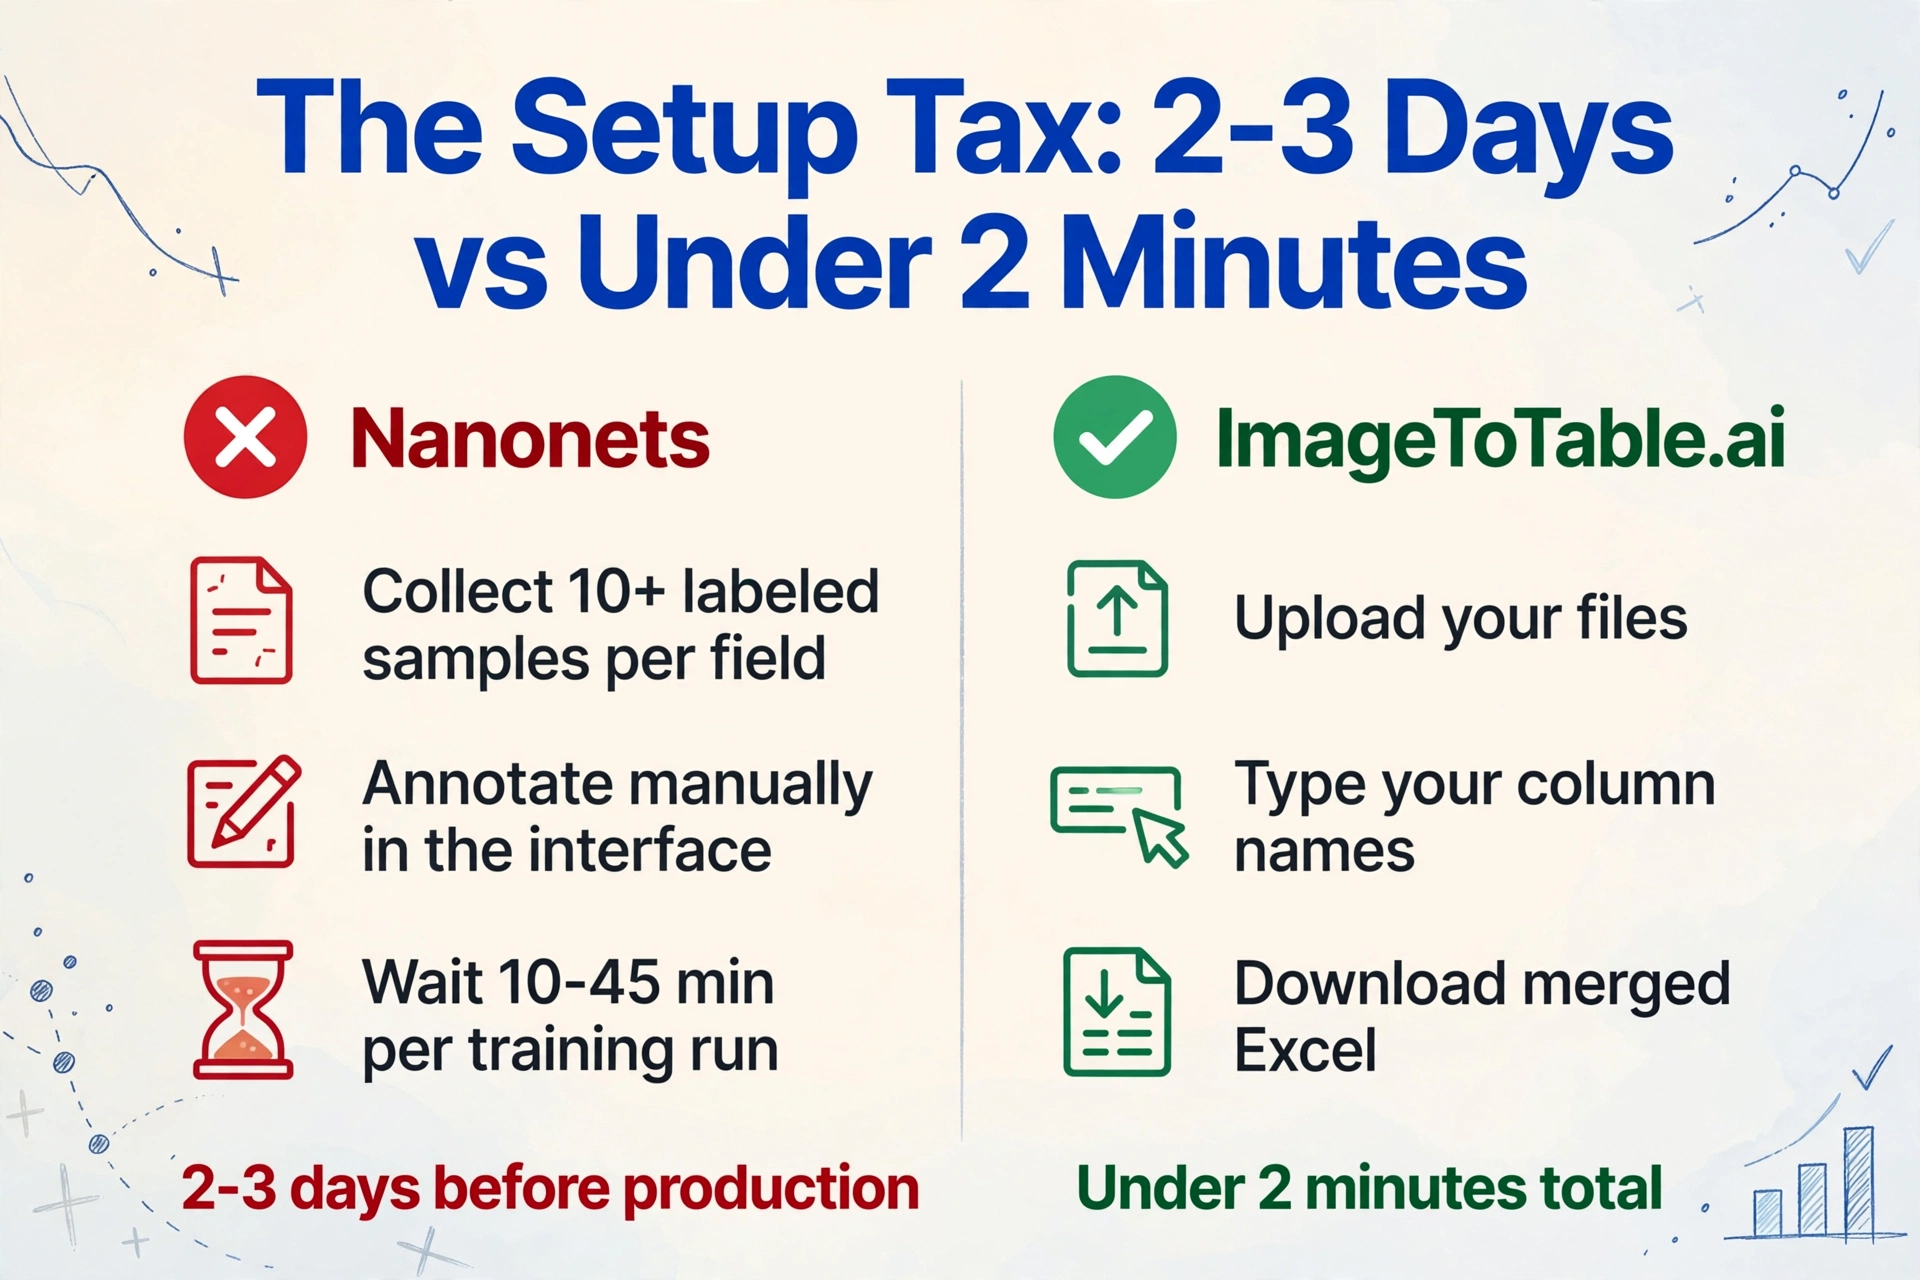
Nanonets fournit des modèles pré-entraînés pour les factures, les reçus et les bons de commande. Pour les champs courants des types de documents standard, ils fonctionnent sans formation. Les frictions commencent dès que vous avez besoin d'un champ personnalisé — et pour la plupart des flux de travail réels, c'est le cas.
Le processus : collecter au moins 10 fichiers d'échantillons étiquetés pour chaque champ à extraire, les annoter manuellement dans l'interface Nanonets, soumettre la formation, attendre 10 à 45 minutes que le modèle termine, examiner les résultats et itérer. Pour un flux de facturation simple, comptez 2 à 3 jours avant de traiter des documents de production de manière fiable.
Le problème de reformation ne s'arrête pas là. Chaque fois qu'une nouvelle mise en page de facture fournisseur apparaît — un ordre de colonnes différent, une nouvelle structure de tableau, un nom de champ légèrement différent — le modèle peut nécessiter une reformation pour la gérer. Un évaluateur G2 d'une entreprise de distribution de gaz traitant 27 000 documents par mois a décrit la réalité directement : « Nous passons énormément de temps à reformer les modèles. » — G2
Pour une équipe disposant d'un ensemble stable de deux ou trois formats fournisseurs connus et de la capacité technique à maintenir les modèles, cela reste gérable. Pour une petite équipe traitant des documents de dizaines de fournisseurs — chacun avec son propre format de facture — le cycle de reformation est pratiquement continu.
ImageToTable.ai contourne tout cela. Il n'y a aucun modèle à former ni aucun échantillon à collecter. Vous saisissez les noms de colonnes souhaités, et le LLM de vision extrait les données correspondantes de chaque document — y compris des documents jamais vus auparavant et des mises en page qui ne correspondent à aucune donnée de formation antérieure.
Le palier à 999 $/mois
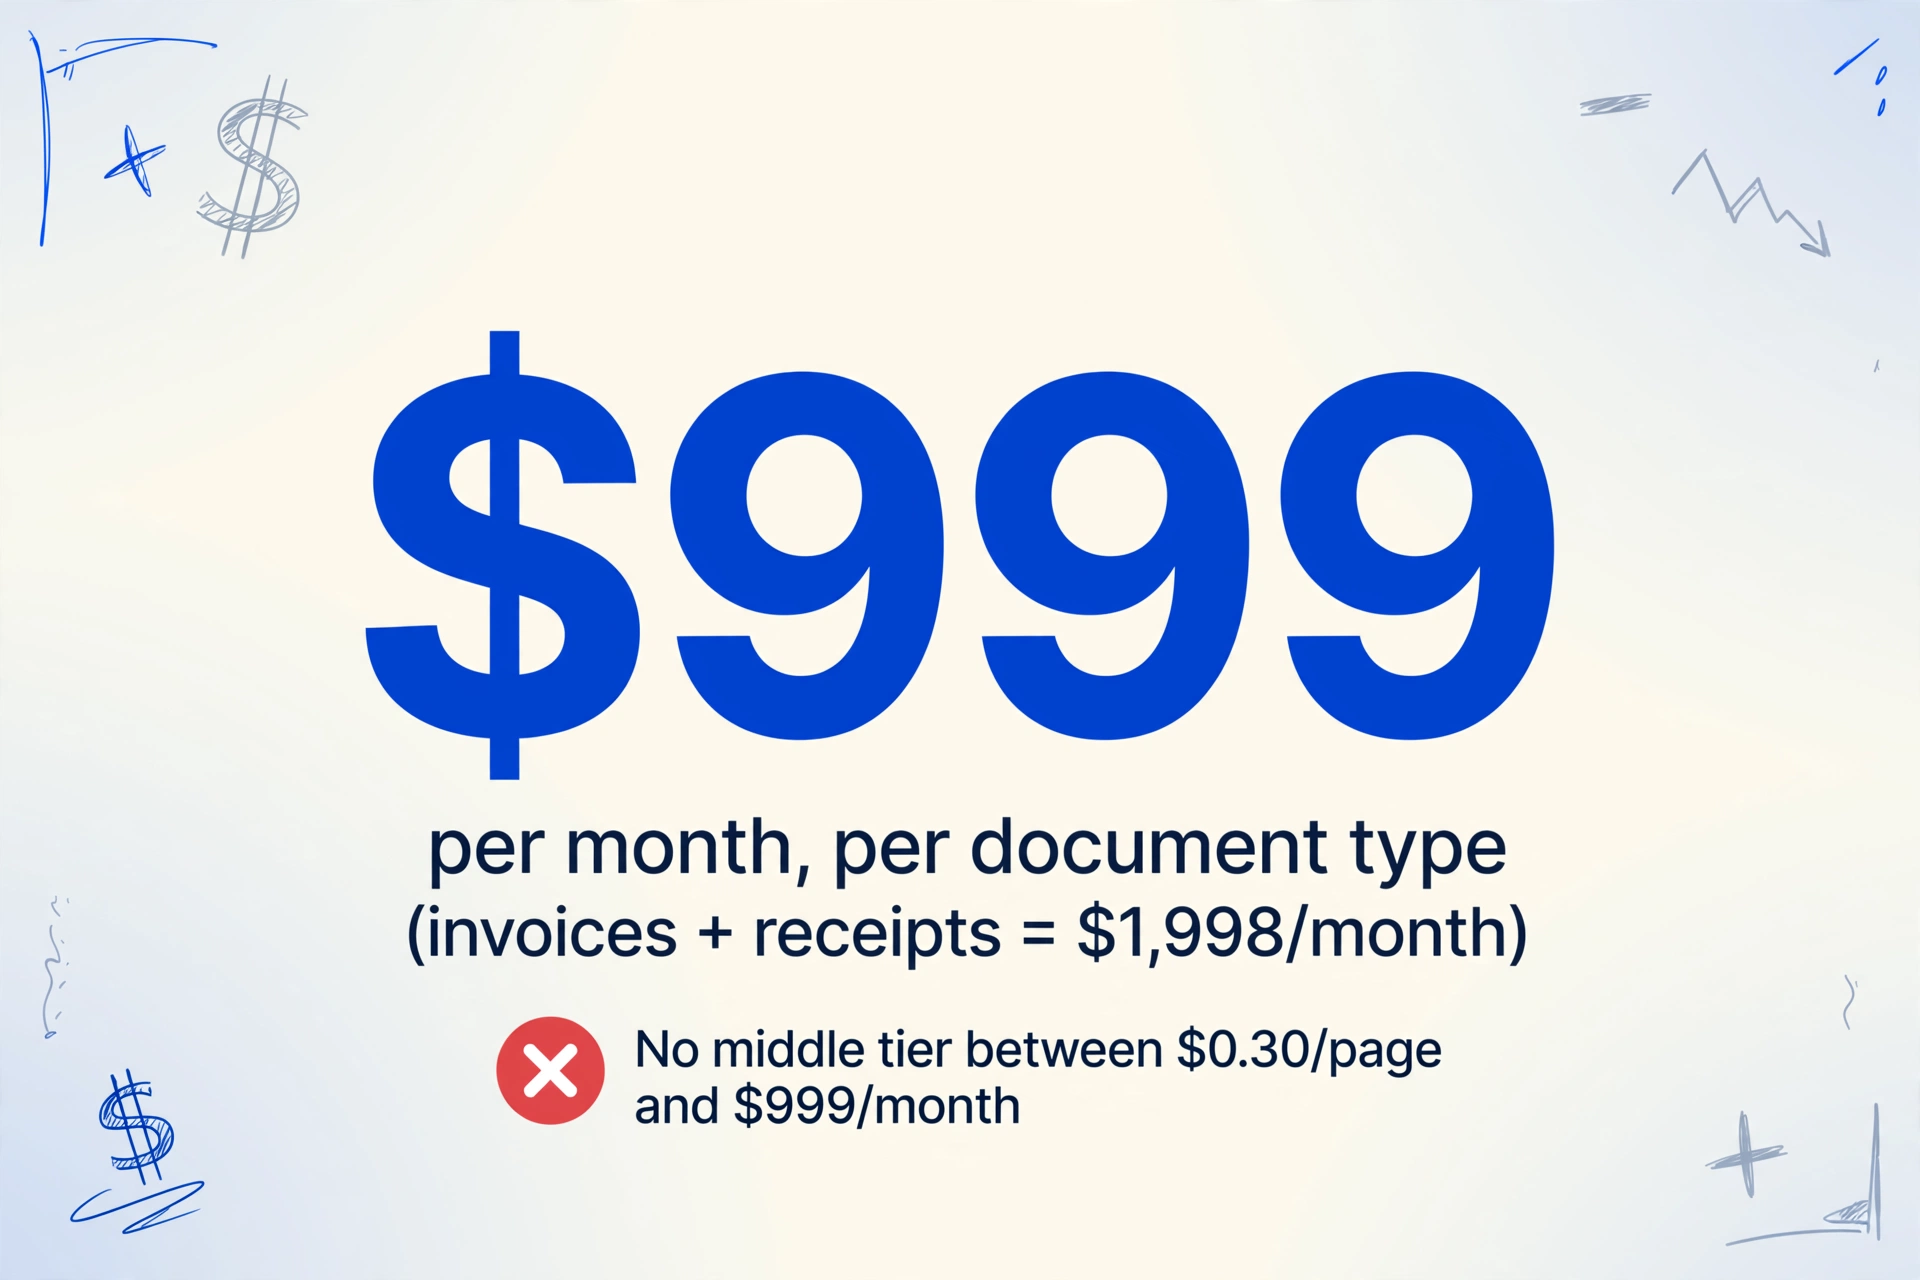
La tarification de Nanonets présente l'un des écarts de paliers les plus marqués du marché du traitement de documents. Le plan Starter facture 0,30 $ par page avec une limite de traitement de 2 pages par minute — acceptable pour de faibles volumes, mais lent pour tout lot réel. Le palier suivant est Pro à 999 $/mois par workflow, avec 10 000 pages incluses.
« Par workflow » signifie par type de document. Une petite entreprise qui extrait à la fois des factures et des reçus paie 1 998 $/mois — 23 976 $/an — avant même de traiter une seule page au-delà du quota inclus. Il n'existe aucun palier intermédiaire entre le lent 0,30 $/page et le 999 $/mois par type.
Au tarif Starter, le calcul est inconfortable pour une petite équipe : 500 pages coûtent 150 $ au-delà du niveau gratuit. Un indépendant ou une petite entreprise traitant 300 pages/mois paie 90 $/mois à 0,30 $/page, sans SLA ni support dédié. La tarification suppose soit un très faible volume (où Starter est tolérable), soit un volume d'entreprise (où Pro se justifie). Le juste milieu — une équipe financière de 5 personnes traitant 500 à 2 000 pages/mois — n'a pas de bonne option.
Il existe une friction tarifaire supplémentaire que les évaluateurs signalent constamment : les extractions échouées ne sont pas gratuites à relancer. Retraiter un document mal extrait consomme un autre crédit. Une agence gouvernementale ayant signé un contrat de 30 000 $ avec Nanonets a décrit cela comme un point de douleur clé dans son avis G2 — elle s'attendait à ce que les nouvelles tentatives sur les documents échoués soient incluses ; elles ne l'étaient pas.
Où Nanonets est le bon choix
Les critiques ci-dessus sont réelles, mais elles s'appliquent à un public spécifique. Pour le cas d'usage pour lequel Nanonets est réellement conçu, le produit est véritablement solide.
Automatisation AP d'entreprise à volume élevé. À partir de 10 000+ pages/mois avec des formats de documents stables, le niveau Pro à 999 $/mois devient défendable. Le coût par page tombe à 0,10 $ en dépassement, la vitesse de traitement atteint 20 pages/minute, et le moteur d'automatisation des flux de travail peut acheminer les données extraites directement vers les systèmes en aval — éliminant potentiellement la saisie manuelle pour 70 à 90 % des documents sur des implémentations matures. Rossum concurrence Nanonets pour le même budget AP d'entreprise avec un contrat annuel comparable — voir notre comparaison Rossum.
Intégration ERP approfondie. Nanonets se connecte nativement à NetSuite, SAP, QuickBooks, Salesforce et plus de 1 000 autres applications. Pour une équipe AP d'entreprise où les données de factures extraites doivent circuler directement vers un grand livre sans ressaisie humaine, cette profondeur d'intégration n'a pas d'équivalent dans les outils d'extraction légers. La plateforme de règles de validation de Docsumo est une autre option à ce niveau — notre moteur de validation de Docsumo en couvre les détails.
Secteurs sensibles à la conformité. Les certifications SOC 2, RGPD et HIPAA rendent Nanonets déployable dans les environnements de santé, gouvernementaux et de services financiers où les concurrents ne peuvent souvent pas se qualifier. Si votre équipe achats exige un fournisseur avec un BAA signé (Business Associate Agreement), Nanonets peut en fournir un. ImageToTable.ai ne le peut actuellement pas.
Traitement direct à grande échelle. Pour une entreprise qui traite des milliers de factures provenant d'un ensemble prévisible de fournisseurs chaque mois, l'investissement dans la formation des modèles porte ses fruits : les modèles deviennent suffisamment fiables pour que les documents circulent sans examen humain. C'est un objectif fondamentalement différent de l'extraction ad hoc — et c'est un objectif que Nanonets est conçu pour atteindre.
Questions fréquemment posées
Nanonets nécessite-t-il un entraînement du modèle avant de traiter des factures ?
Pour les champs standard des types de documents courants (numéro de facture, date, total), les modèles pré-entraînés fonctionnent sans entraînement supplémentaire. Pour les champs personnalisés — spécifiques à votre flux de travail — vous devez collecter au moins 10 documents échantillons étiquetés par champ, les annoter et entraîner le modèle (10 à 45 minutes par exécution). Les nouveaux formats de factures fournisseurs qui diffèrent de vos données d'entraînement nécessitent généralement un réentraînement. ImageToTable.ai ne nécessite aucun entraînement : vous saisissez les noms de colonnes souhaités et l'IA les extrait immédiatement de n'importe quel document.
Quelle est la différence entre l'offre Starter à 0,30 $/page et l'offre Pro à 999 $/mois de Nanonets ?
Le plan Starter traite à 2 pages/minute avec des champs personnalisables limités et sans assistance dédiée — utilisable pour des tests à faible volume mais lent pour un traitement par lots réel. Le plan Pro passe à 999 $/mois par flux de travail (par type de document), incluant 10 000 pages/mois et traitant à 20 pages/minute avec automatisation complète du flux et intégrations. Il n'existe pas de niveau intermédiaire. Une petite équipe traitant à la fois des factures et des reçus paierait 1 998 $/mois pour le niveau Pro sur deux types de documents.
Nanonets facture-t-il les pages dont l'extraction échoue ?
Oui. Retraiter un document mal extrait consomme un crédit page supplémentaire sur le plan Starter. C'est une plainte documentée dans les avis utilisateurs — une agence gouvernementale avec un contrat de 30 000 $ a signalé cela comme un problème majeur après avoir espéré des tentatives gratuites en cas d'échec d'extraction. ImageToTable.ai ne facture pas les extractions échouées.
ImageToTable.ai peut-il traiter les mêmes types de documents que Nanonets ?
Pour le cas d'usage principal d'extraction — factures, reçus, bons de commande, relevés bancaires, formulaires — oui. Les deux outils extraient des données structurées de ces types de documents. ImageToTable.ai traite également les images scannées, les photos de téléphone et les formulaires manuscrits sans configuration supplémentaire. L'écart se situe du côté de l'automatisation d'entreprise : Nanonets se connecte à NetSuite, SAP et plus de 1 000 systèmes en aval ; ImageToTable.ai exporte vers Excel, CSV, JSON et Word, avec un module complémentaire Google Sheets et une API REST sur les formules payantes. Si votre objectif est d'obtenir des données dans un tableur, les deux outils fonctionnent. Si votre objectif est d'acheminer les données directement vers un ERP sans relecture humaine, Nanonets est l'outil approprié.
Nanonets vaut-il le coup pour une petite équipe traitant 200 à 500 pages par mois ?
À ce volume, l'économie est difficile. Avec l'offre Starter à 0,30 $/page, 500 pages coûtent 150 $/mois — sans SLA ni support dédié, et avec une limite de traitement de 2 pages/minute qui ralentit le travail par lots. Le niveau Pro à 999 $/mois par type de document dépasse presque certainement le budget d'une équipe de cette taille. La tarification à l'utilisation d'ImageToTable.ai commence à 6 $/50 pages sans engagement mensuel, ce qui revient à un coût bien inférieur pour 200 à 500 pages par mois. La proposition de valeur de Nanonets s'active à volume élevé avec des types de documents stables — en dessous de ce seuil, l'investissement initial et le coût par page sont difficiles à justifier.
Essayez ImageToTable.ai gratuitement
Aucun entraînement de modèle. Aucun échantillon étiqueté. Téléversez vos documents, nommez vos colonnes et téléchargez un fichier Excel fusionné en moins de deux minutes — aucun compte requis pour essayer.
Aucune carte de crédit requise. Crédits gratuits inclus à l'inscription.