ImageToTable.ai vs. Nanonets:
Hochladen und Extrahieren vs. Trainieren, Konfigurieren und Warten
Nanonets ist eine leistungsfähige Plattform zur Dokumentenverarbeitung – aber bevor Sie Ihre erste Rechnung extrahieren, verbringen Sie 2–3 Tage damit, beschriftete Trainingsbeispiele zu sammeln, Modelltrainingszyklen auszuführen und die Genauigkeit zu iterieren. ImageToTable.ai erfordert nichts davon. Der Unterschied ist nicht nur Bequemlichkeit: Es ist eine grundlegend andere Architektur. Eine ist für Enterprise-Teams gebaut, die in die Modellkonfiguration im Voraus investieren; die andere ist für Teams gebaut, die heute strukturierte Daten aus Dokumenten benötigen.
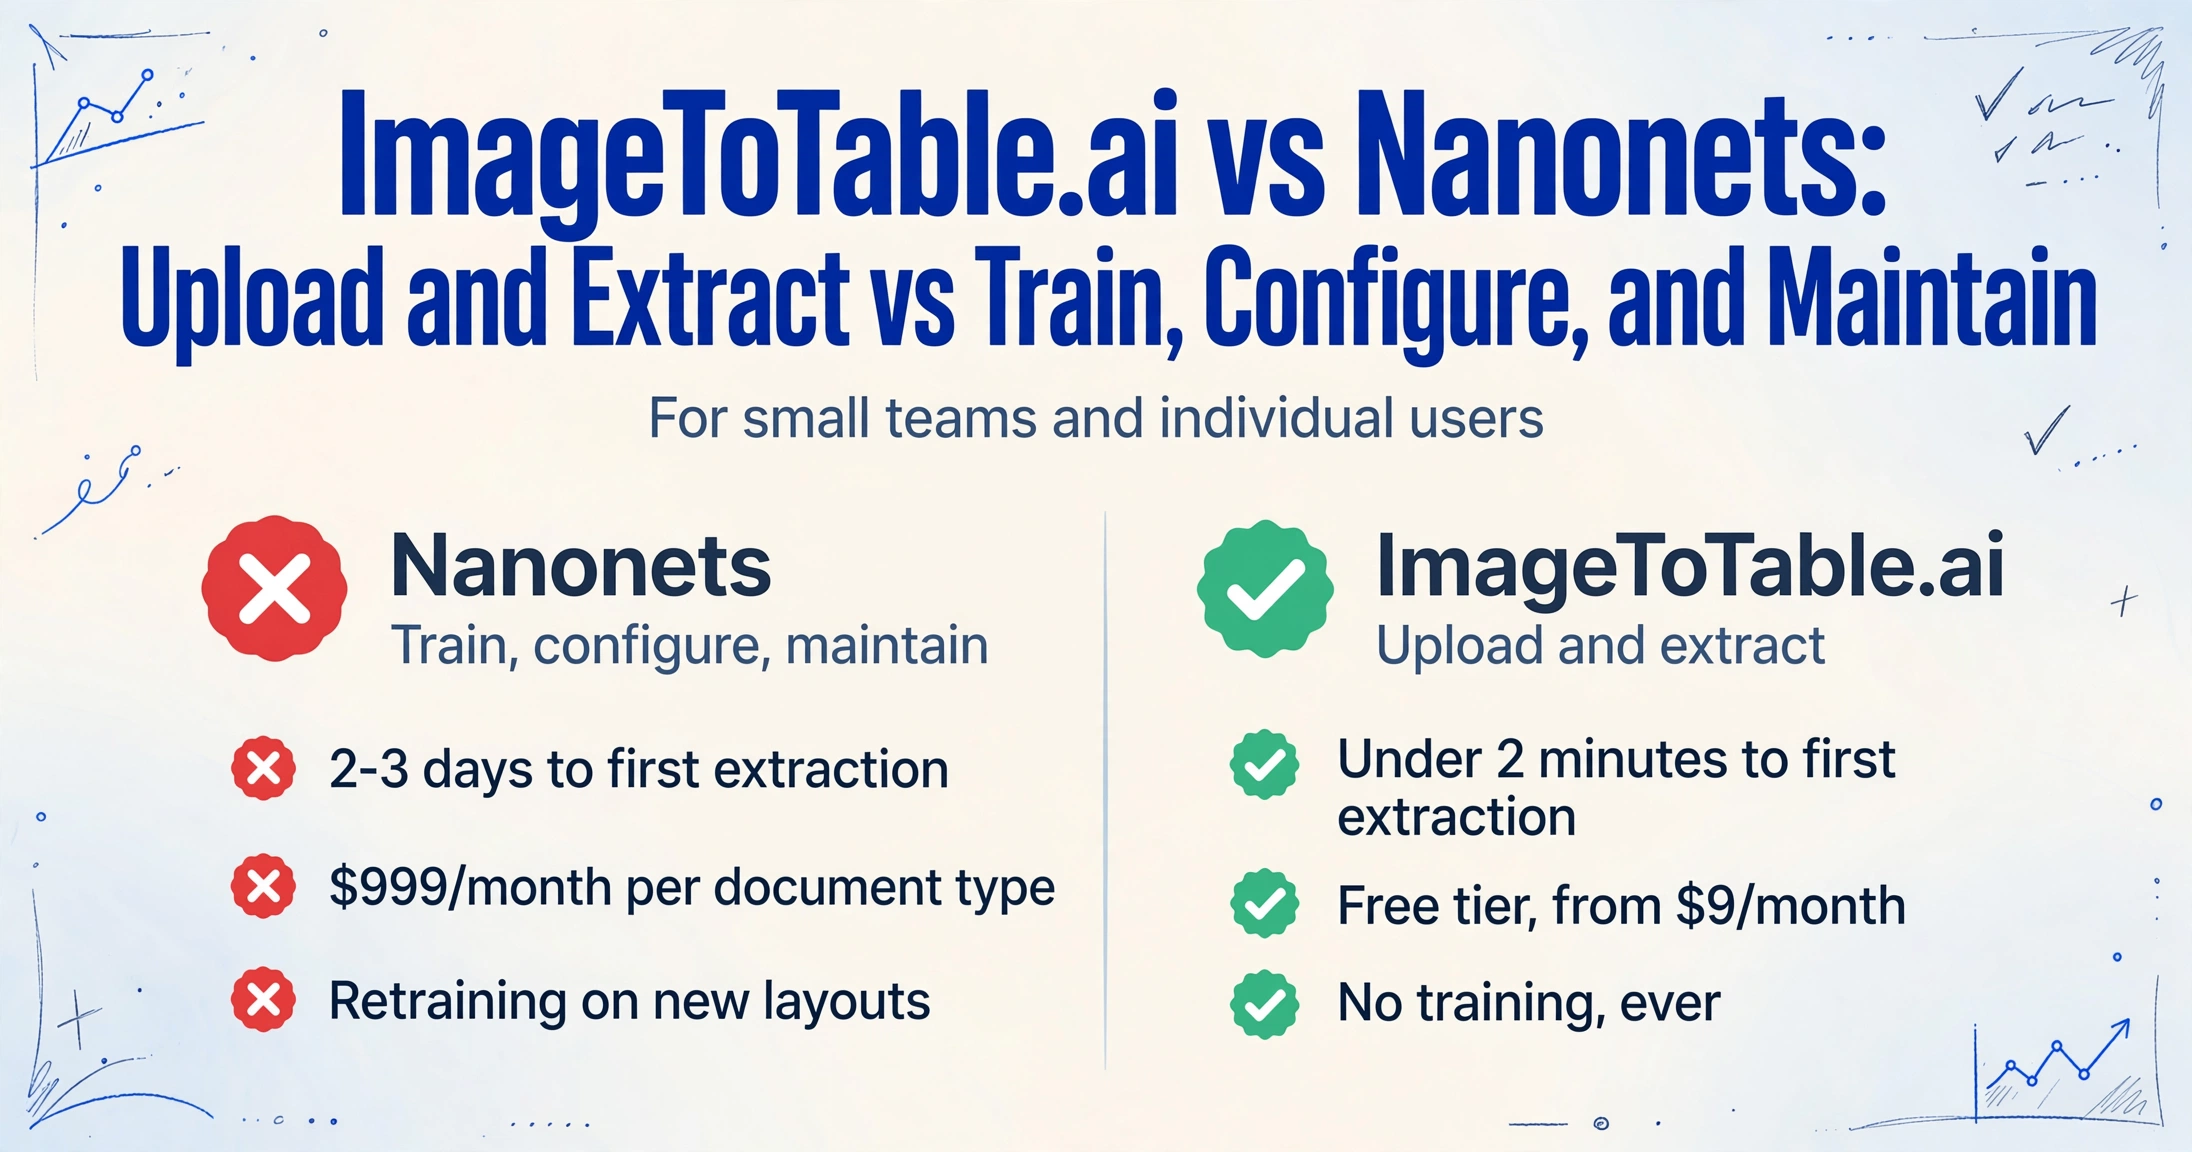
Kurzvergleich
Diese Seite richtet sich an kleine Teams und Einzelanwender. Wenn Sie ein Enterprise-AP-Team sind, das 10.000+ Seiten/Monat verarbeitet und ERP-Integrationen benötigt, scrollen Sie zuerst zu Wann Nanonets die richtige Wahl ist.
ImageToTable.ai wählen, wenn…
- Sie Extraktion sofort benötigen, nicht erst nach Tagen Modelltraining
- Ihre Dokumente von vielen Anbietern mit uneinheitlichen Layouts stammen
- Sie Spaltennamen in Klartext definieren möchten – ohne Modellaufbau
- Ihr monatliches Volumen unter 5.000 Seiten liegt und 999 €/Monat pro Dokumenttyp zu teuer ist
- Sie Ergebnisse aus gescannten Bildern, Handyfotos oder handschriftlichen Formularen benötigen
Nanonets wählen, wenn…
- Sie ein Enterprise-AP- oder Finanzteam sind, das 10.000+ Seiten/Monat verarbeitet
- Sie tiefe ERP-Integrationen benötigen: NetSuite, SAP, QuickBooks, Salesforce
- SOC 2, GDPR oder HIPAA-Compliance für Ihre Branche erforderlich ist
- Sie technisches Personal haben, um Extraktionsmodelle zu konfigurieren, trainieren und warten
- Durchgehende Verarbeitung (keine manuelle Prüfung pro Dokument) das Ziel ist
Funktionsvergleich
| Funktion | Nanonets | ImageToTable.ai |
|---|---|---|
| Zeit bis zur ersten Extraktion | 2–3 Tage (Samples sammeln, annotieren, Modell trainieren, iterieren); vortrainierte Modelle für gängige Typen verfügbar, benutzerdefinierte Felder erfordern Training | Unter 2 Minuten — Dateien hochladen, Spaltennamen eingeben, Excel herunterladen |
| Modelltraining erforderlich | Ja für benutzerdefinierte Felder — mindestens 10 beschriftete Samples pro Feld und Dokumenttyp; erneutes Training bei neuen Layouts nötig | Nein — Vision-LLM liest Dokumentsemantik direkt; keine Trainingsdaten erforderlich |
| Benutzerdefinierte Spaltennamen | Konfigurierbar über Feldannotation im Modell-Builder | Geben Sie die gewünschten Spaltennamen ein; diese werden sofort zu Ihren Excel-Überschriften |
| Stapelverarbeitung | Ja; Starter auf 2 Seiten/Minute begrenzt; Pro bei 20 Seiten/Minute | Unbegrenzte Dateien pro Stapel, alle in einer einheitlichen Tabelle zusammengeführt |
| Gescannte / handschriftliche Dokumente | Genauigkeit sinkt bei unscharfen Scans; OCR-s-Modell unterstützt keine Handschrift | Wird von Vision-LLM verarbeitet; funktioniert mit gescannten Bildern, Handyfotos und handschriftlichen Formularen |
| ERP-/App-Integrationen | Über 1.000 native Konnektoren: NetSuite, SAP, Salesforce, QuickBooks, E-Mail usw. | Excel-, CSV-, JSON-, Word-Export; Google Sheets-Add-on; REST-API in kostenpflichtigen Tarifen |
| Compliance-Zertifizierungen | SOC 2, GDPR, HIPAA | Nicht für regulierte Branchen zertifiziert |
| Preise Einstieg | 0,30 $/Seite (Starter, 2 Seiten/Min.); erste 500 Seiten kostenlos | Kostenlose Gaststufe; kostenpflichtige Tarife ab 9 $/Monat; Pay-as-you-go ab 6 $/50 Seiten |
| Team-/Workflow-Preise | Pro: 999 $/Monat pro Workflow (pro Dokumenttyp), 10.000 Seiten inklusive | Team-Tarif mit gemeinsamem Kontingent; keine Preisgestaltung pro Dokumenttyp |
| Kosten bei fehlgeschlagener Extraktion | Erneute Verarbeitung eines fehlgeschlagenen Dokuments verbraucht ein zusätzliches Guthaben | Fehlgeschlagene Extraktionen verbrauchen kein Guthaben |
Vor Ihrer ersten Rechnung: die Einrichtungsgebühr
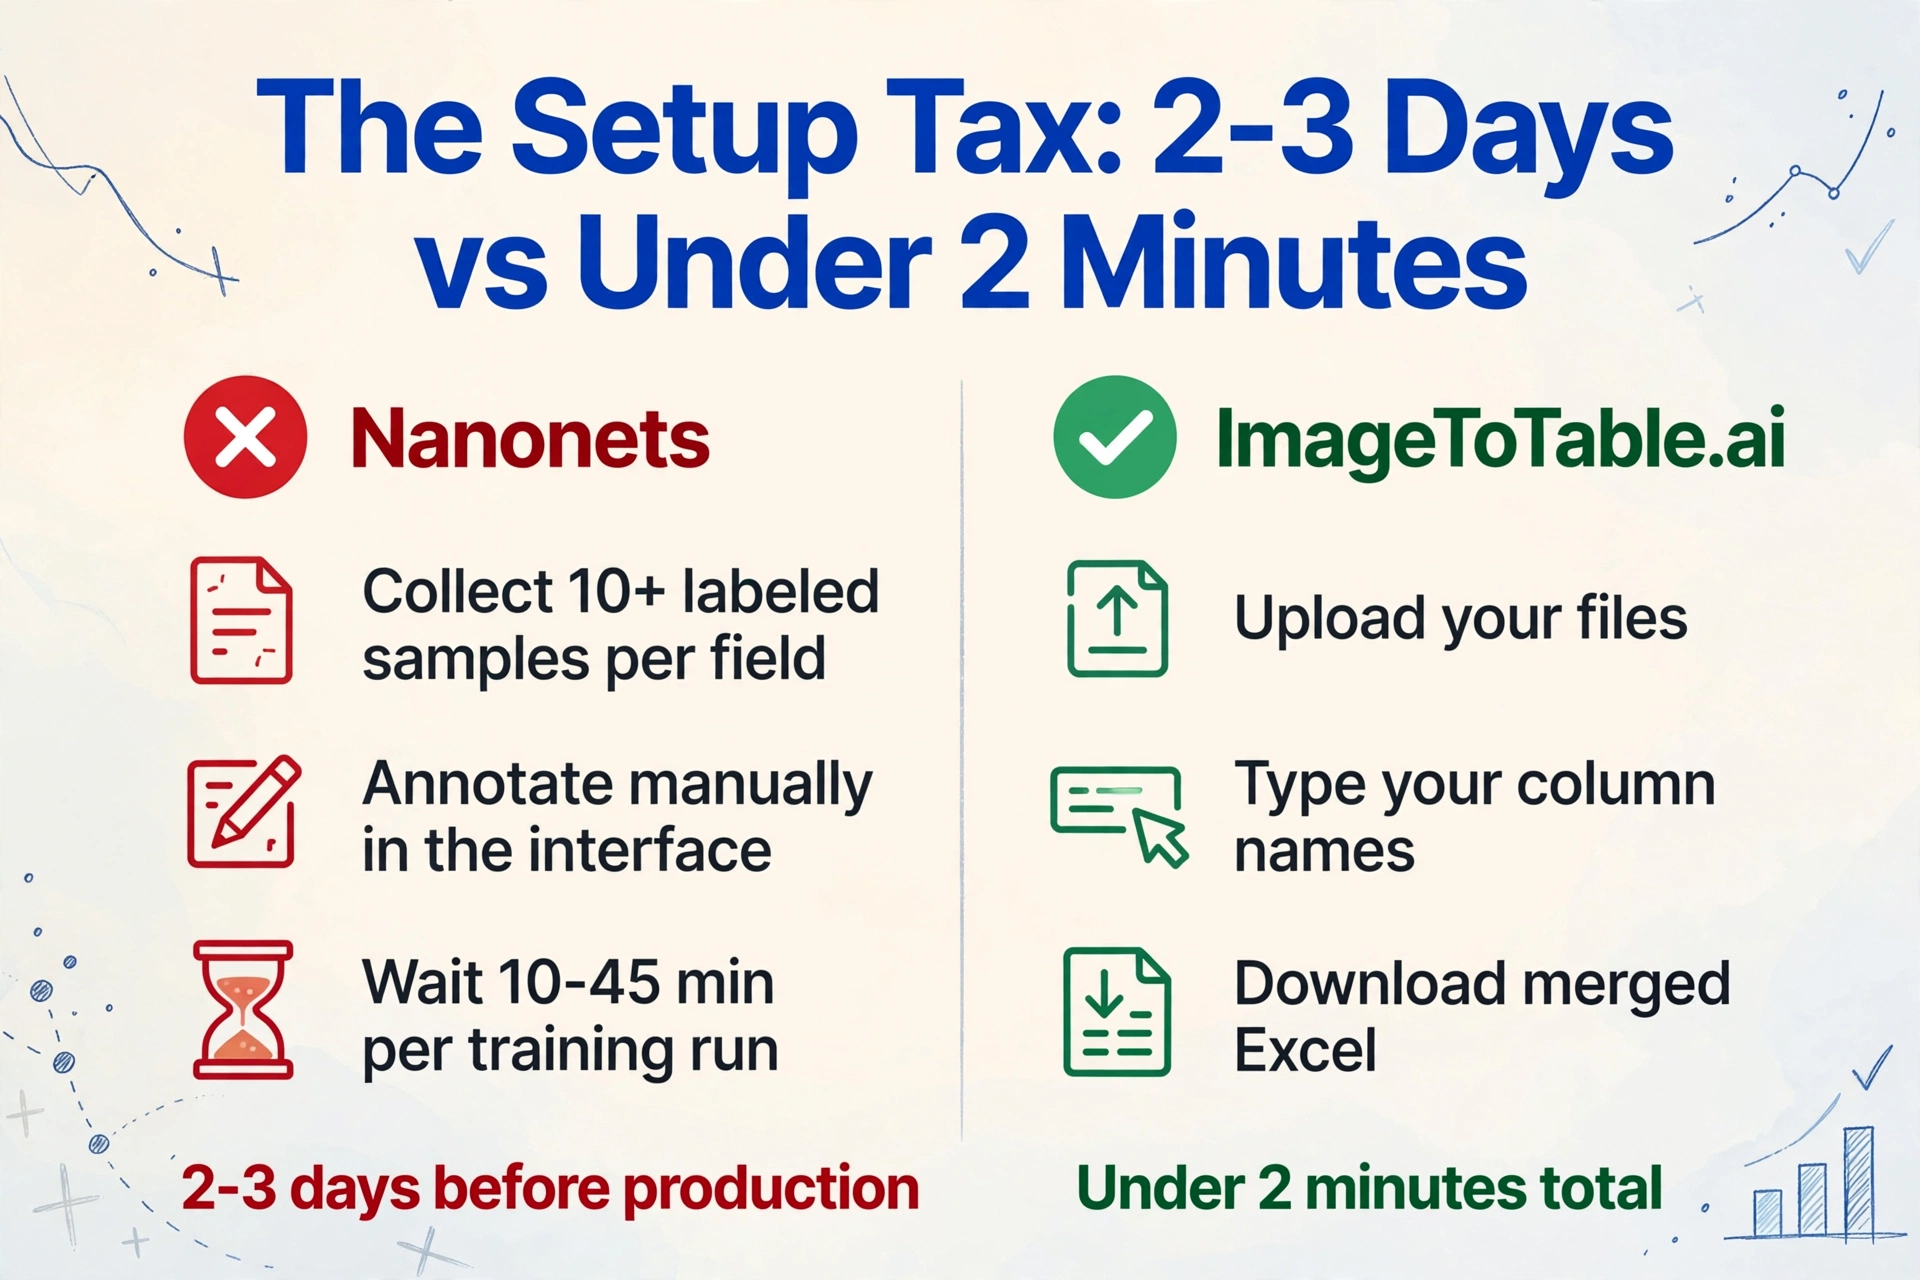
Nanonets liefert vortrainierte Modelle für Rechnungen, Belege und Bestellungen. Für gängige Felder bei Standarddokumenttypen funktionieren diese ohne Training. Die Reibung beginnt in dem Moment, in dem Sie ein benutzerdefiniertes Feld benötigen – und für die meisten realen Workflows ist das der Fall.
Der Ablauf: Sammeln Sie mindestens 10 beschriftete Beispieldateien für jedes Feld, das Sie extrahieren möchten, annotieren Sie diese manuell in der Nanonets-Oberfläche, reichen Sie sie zum Training ein, warten Sie 10 bis 45 Minuten, bis das Modell fertig ist, überprüfen Sie die Ergebnisse und iterieren Sie. Für einen einfachen Rechnungsworkflow sollten Sie mit 2–3 Tagen rechnen, bevor Sie Produktionsdokumente zuverlässig verarbeiten.
Das Nachschulungsproblem endet damit nicht. Jedes Mal, wenn ein neues Lieferantenrechnungslayout erscheint – eine andere Spaltenreihenfolge, eine neue Tabellenstruktur, ein leicht abweichender Feldname – muss das Modell möglicherweise neu trainiert werden, um es zu verarbeiten. Ein G2-Rezensent eines Gasverteilungsunternehmens, das 27.000 Dokumente pro Monat verarbeitet, beschrieb die Realität direkt: „Wir verbringen enorm viel Zeit damit, die Modelle neu zu trainieren.“ — G2
Für ein Team mit einem stabilen Satz von zwei oder drei bekannten Lieferantenformaten und der technischen Kapazität, Modelle zu pflegen, ist das machbar. Für ein kleines Team, das Dokumente von Dutzenden Lieferanten verarbeitet – jeder mit eigenem Rechnungsformat – ist der Nachschulungszyklus praktisch durchgehend aktiv.
ImageToTable.ai überspringt das vollständig. Es gibt kein Modell zu trainieren und keine Stichproben zu sammeln. Sie geben die gewünschten Spaltennamen ein, und das Vision-LLM extrahiert passende Daten aus jedem Dokument – einschließlich Dokumenten, die es noch nie gesehen hat, und Layouts, die zu keinen früheren Trainingsdaten passen.
Die 999-$-pro-Monat-Klippe
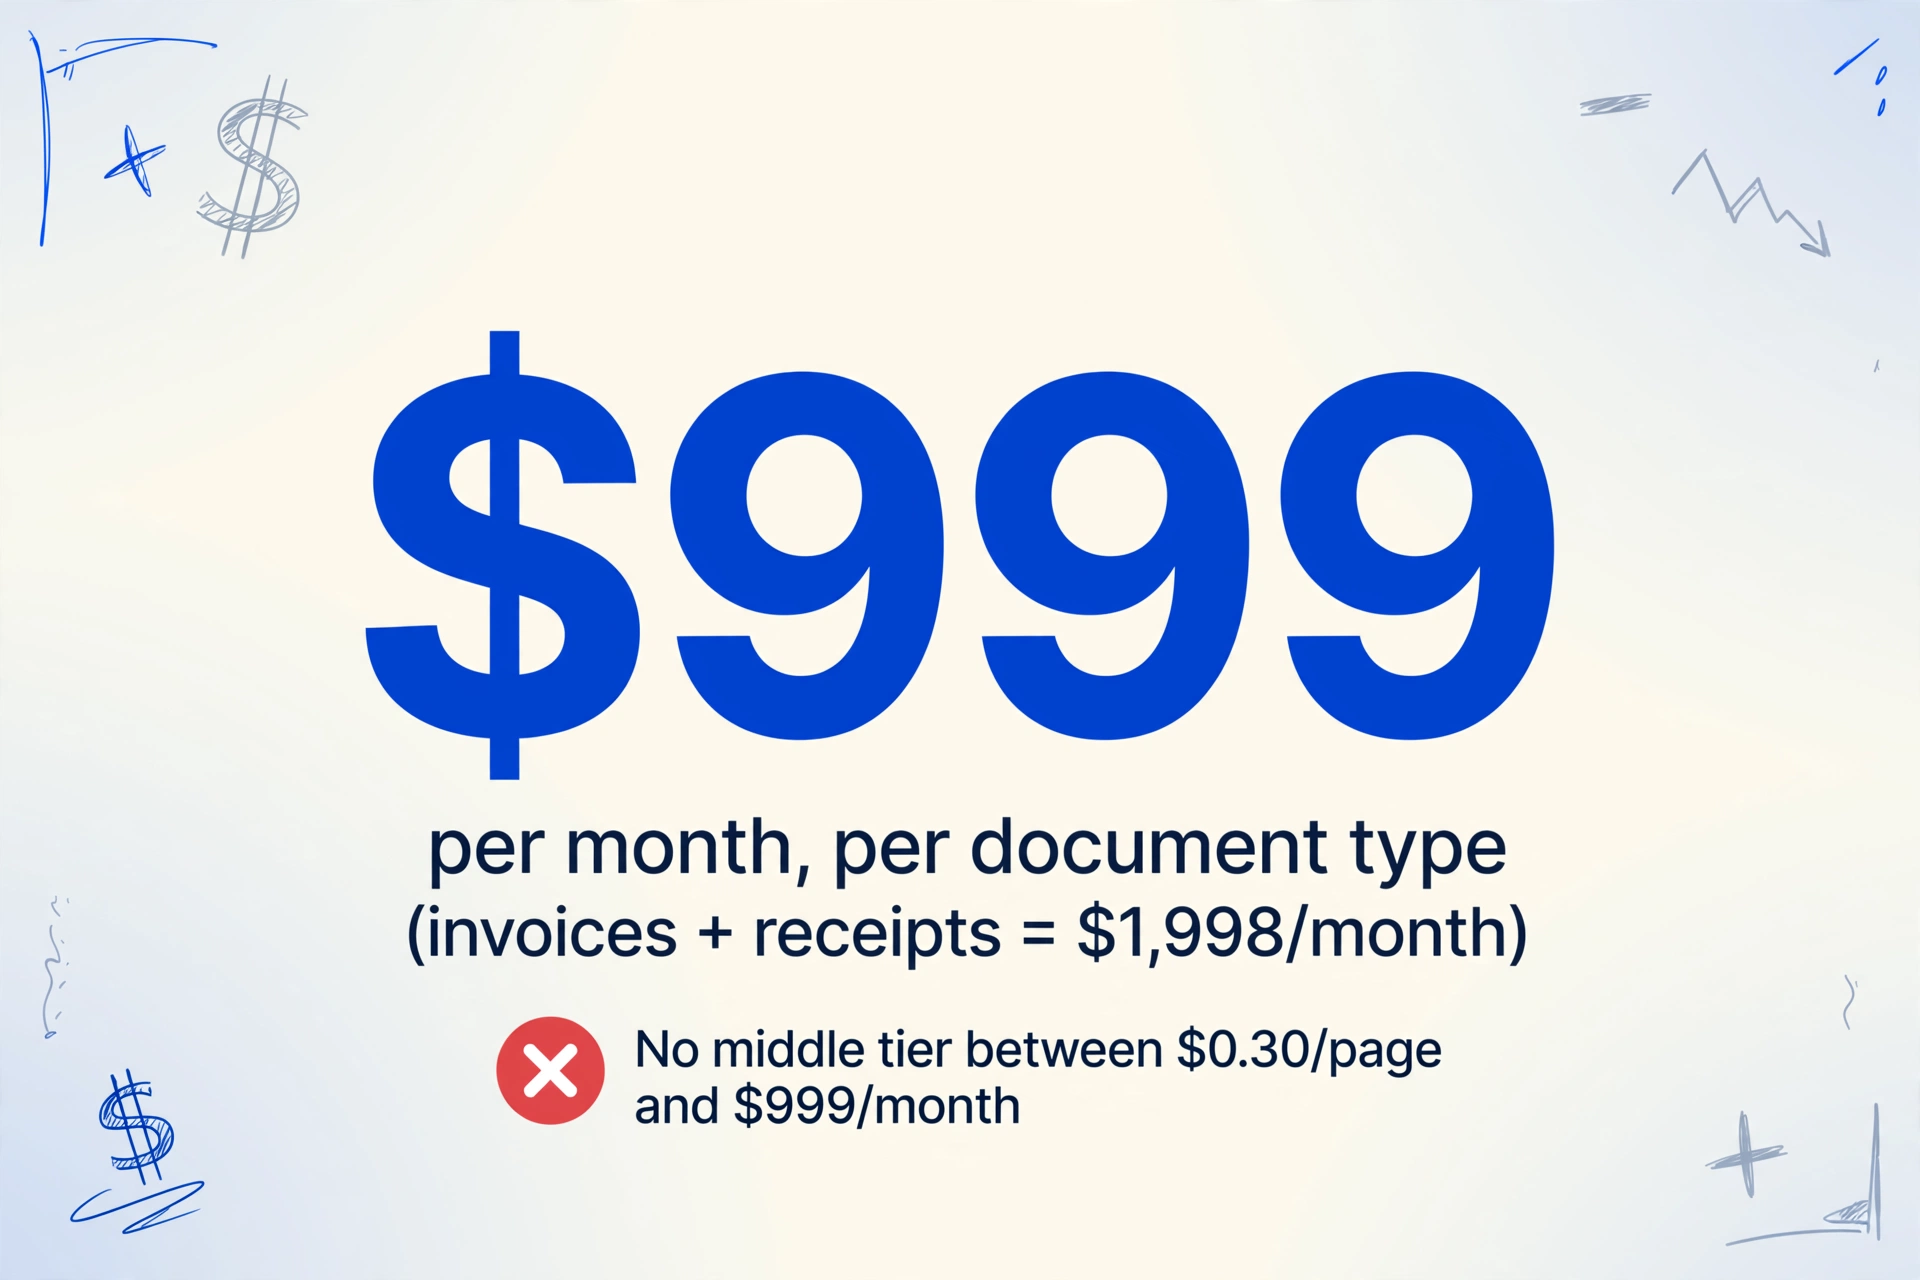
Die Preisgestaltung von Nanonets weist eine der schärfsten Stufensprünge im Markt für Dokumentenverarbeitung auf. Der Starter-Plan kostet 0,30 $ pro Seite mit einer Verarbeitungsgrenze von 2 Seiten pro Minute – für geringe Mengen brauchbar, aber für echte Batches zu langsam. Die nächste Stufe ist Pro mit 999 $ pro Monat und Workflow, inklusive 10.000 Seiten.
„Pro Workflow" bedeutet pro Dokumenttyp. Ein kleines Unternehmen, das sowohl Rechnungen als auch Belege extrahiert, zahlt 1.998 $ pro Monat – 23.976 $ pro Jahr – bevor es eine einzige Seite über das enthaltene Kontingent hinaus verarbeitet. Es gibt keine mittlere Stufe zwischen langsam für 0,30 $/Seite und 999 $/Monat pro Typ.
Beim Starter-Tarif ist die Rechnung für ein kleines Team unangenehm: 500 Seiten kosten 150 $ über dem kostenlosen Tarif. Ein Freiberufler oder ein kleines Unternehmen, das 300 Seiten pro Monat verarbeitet, zahlt 90 $ pro Monat bei 0,30 $/Seite, ohne SLA und ohne dedizierten Support. Die Preisgestaltung setzt entweder ein sehr geringes Volumen voraus (wo Starter tolerierbar ist) oder Unternehmensvolumen (wo Pro sich rechtfertigt). Die Mitte – ein 5-köpfiges Finanzteam, das 500–2.000 Seiten pro Monat verarbeitet – hat keine gute Option.
Es gibt eine zusätzliche preisliche Reibung, die Rezensenten durchgängig hervorheben: Fehlgeschlagene Extraktionen sind nicht kostenlos wiederholbar. Die erneute Verarbeitung eines Dokuments, das falsch extrahiert wurde, verbraucht ein weiteres Credit. Eine Regierungsbehörde, die einen Vertrag über 30.000 $ mit Nanonets abgeschlossen hat, beschrieb dies als zentralen Schmerzpunkt in ihrer G2-Bewertung – sie erwarteten, dass Wiederholungen bei fehlgeschlagenen Dokumenten enthalten sind; das waren sie nicht.
Wo Nanonets die richtige Wahl ist
Die oben genannten Kritikpunkte sind real, gelten aber für eine bestimmte Zielgruppe. Für den Anwendungsfall, für den Nanonets tatsächlich entwickelt wurde, ist das Produkt wirklich stark.
AP-Automatisierung für Unternehmen mit hohem Volumen. Ab 10.000+ Seiten/Monat mit stabilen Dokumentformaten wird die Pro-Stufe für 999 $/Monat vertretbar. Die Kosten pro Seite sinken bei Überschreitung auf 0,10 $, die Verarbeitungsgeschwindigkeit erreicht 20 Seiten/Minute, und die Workflow-Automatisierungs-Engine kann extrahierte Daten direkt in nachgelagerte Systeme leiten – was bei ausgereiften Implementierungen die manuelle Prüfung für 70–90 % der Dokumente überflüssig machen kann. Rossum konkurriert um dasselbe Enterprise-AP-Budget mit einem vergleichbaren Jahresvertrag – siehe unseren Rossum-Vergleich.
Tiefe ERP-Integration. Nanonets verbindet sich nativ mit NetSuite, SAP, QuickBooks, Salesforce und über 1.000 weiteren Anwendungen. Für ein Enterprise-AP-Team, bei dem extrahierte Rechnungsdaten ohne manuelle Neueingabe direkt in ein Hauptbuch fließen müssen, hat diese Integrationstiefe keine Entsprechung bei leichtgewichtigen Extraktionstools. Docsumos Validierungsregel-Plattform ist eine weitere Option auf dieser Stufe – unsere Docsumo-Validierungsengine deckt sie ab.
Compliance-sensible Branchen. SOC-2-, DSGVO- und HIPAA-Zertifizierungen machen Nanonets in Gesundheitswesen, Regierung und Finanzdienstleistungen einsetzbar, wo Wettbewerber oft nicht qualifiziert sind. Wenn Ihr Einkaufsteam einen Anbieter mit unterzeichnetem BAA (Business Associate Agreement) benötigt, kann Nanonets eines bereitstellen. ImageToTable.ai kann das derzeit nicht.
Durchgängige Verarbeitung in großem Maßstab. Für ein Unternehmen, das monatlich Tausende von Rechnungen von einem vorhersehbaren Satz von Lieferanten verarbeitet, zahlt sich die Investition in das Modelltraining aus: Die Modelle werden zuverlässig genug, dass Dokumente ohne menschliche Prüfung durchlaufen. Das ist ein grundlegend anderes Ziel als Ad-hoc-Extraktion – und genau das zu erreichen, ist Nanonets gebaut.
Häufig gestellte Fragen
Erfordert Nanonets ein Modelltraining vor der Rechnungsverarbeitung?
Für Standardfelder auf gängigen Dokumenttypen (Rechnungsnummer, Datum, Gesamtsumme) können vortrainierte Modelle ohne zusätzliches Training arbeiten. Für benutzerdefinierte Felder – alles, was für Ihren Workflow spezifisch ist – müssen Sie mindestens 10 beschriftete Belegmuster pro Feld sammeln, annotieren und das Modell trainieren (10–45 Minuten pro Durchlauf). Neue Lieferantenrechnungslayouts, die von Ihren Trainingsdaten abweichen, erfordern in der Regel ein erneutes Training. ImageToTable.ai benötigt kein Training: Sie geben die gewünschten Spaltennamen ein und die KI extrahiert sie sofort aus jedem Dokument.
Was ist der Unterschied zwischen Nanonets' Starter (0,30 $/Seite) und Pro (999 $/Monat)?
Der Starter-Plan verarbeitet 2 Seiten/Minute mit begrenzten anpassbaren Feldern und ohne dedizierten Support – nutzbar für Tests mit geringem Volumen, aber langsam für echte Stapelverarbeitung. Pro springt auf 999 $/Monat pro Workflow (pro Dokumenttyp), beinhaltet 10.000 Seiten/Monat und verarbeitet 20 Seiten/Minute mit vollständiger Workflow-Automatisierung und Integrationen. Es gibt keine Zwischenstufe. Ein kleines Team, das sowohl Rechnungen als auch Quittungen verarbeitet, würde für die Pro-Stufe über zwei Dokumenttypen hinweg 1.998 $/Monat zahlen.
Berechnet Nanonets Seiten, die nicht korrekt extrahiert werden?
Ja. Die erneute Verarbeitung eines Dokuments, das falsch extrahiert wurde, verbraucht im Starter-Plan ein zusätzliches Seitenkontingent. Dies ist eine dokumentierte Beschwerde in Nutzerbewertungen – eine Regierungsbehörde mit einem 30.000 $-Vertrag bemängelte dies als erhebliches Problem, da sie kostenlose Wiederholungen bei fehlgeschlagenen Extraktionen erwartet hatte. ImageToTable.ai berechnet keine fehlgeschlagenen Extraktionen.
Kann ImageToTable.ai dieselben Dokumenttypen wie Nanonets verarbeiten?
Für den Kernanwendungsfall der Extraktion – Rechnungen, Quittungen, Bestellungen, Kontoauszüge, Formulare – ja. Beide Tools extrahieren strukturierte Daten aus diesen Dokumenttypen. ImageToTable.ai verarbeitet auch gescannte Bilder, Handyfotos und handschriftliche Formulare ohne zusätzliche Konfiguration. Der Unterschied liegt auf der Seite der Unternehmensautomatisierung: Nanonets verbindet sich mit NetSuite, SAP und über 1.000 nachgelagerten Systemen; ImageToTable.ai exportiert nach Excel, CSV, JSON und Word, mit einem Google Sheets-Add-on und REST API in kostenpflichtigen Plänen. Wenn Ihr Ziel darin besteht, Daten in eine Tabelle zu bekommen, funktionieren beide Tools. Wenn Ihr Ziel darin besteht, Daten ohne menschliche Überprüfung direkt in ein ERP zu leiten, ist Nanonets das geeignete Werkzeug.
Lohnt sich Nanonets für ein kleines Team mit 200–500 Seiten/Monat?
Bei diesem Volumen ist die Wirtschaftlichkeit schwierig. Im Starter-Tarif zu 0,30 $/Seite kosten 500 Seiten 150 $/Monat – ohne SLA oder dedizierten Support und mit einer Verarbeitungsgrenze von 2 Seiten/Minute, die Batch-Arbeiten verlangsamt. Der Pro-Tarif mit 999 $/Monat pro Dokumententyp ist für ein Team dieser Größe mit ziemlicher Sicherheit über dem Budget. ImageToTable.ai bietet nutzungsabhängige Preise ab 6 $/50 Seiten ohne monatliche Bindung, was bei 200–500 Seiten/Monat deutlich günstiger ist. Der Nutzen von Nanonets entfaltet sich erst bei hohem Volumen und stabilen Dokumententypen – darunter sind der Einrichtungsaufwand und die Kosten pro Seite schwer zu rechtfertigen.
ImageToTable.ai kostenlos testen
Kein Modelltraining. Keine beschrifteten Stichproben. Laden Sie Ihre Dokumente hoch, benennen Sie Ihre Spalten und laden Sie in weniger als zwei Minuten eine zusammengeführte Excel-Datei herunter — kein Konto erforderlich zum Testen.
Keine Kreditkarte erforderlich. Kostenlose Credits bei der Anmeldung inklusive.