Beste KI-OCR-Software 2026:
8 intelligente Tools im Vergleich
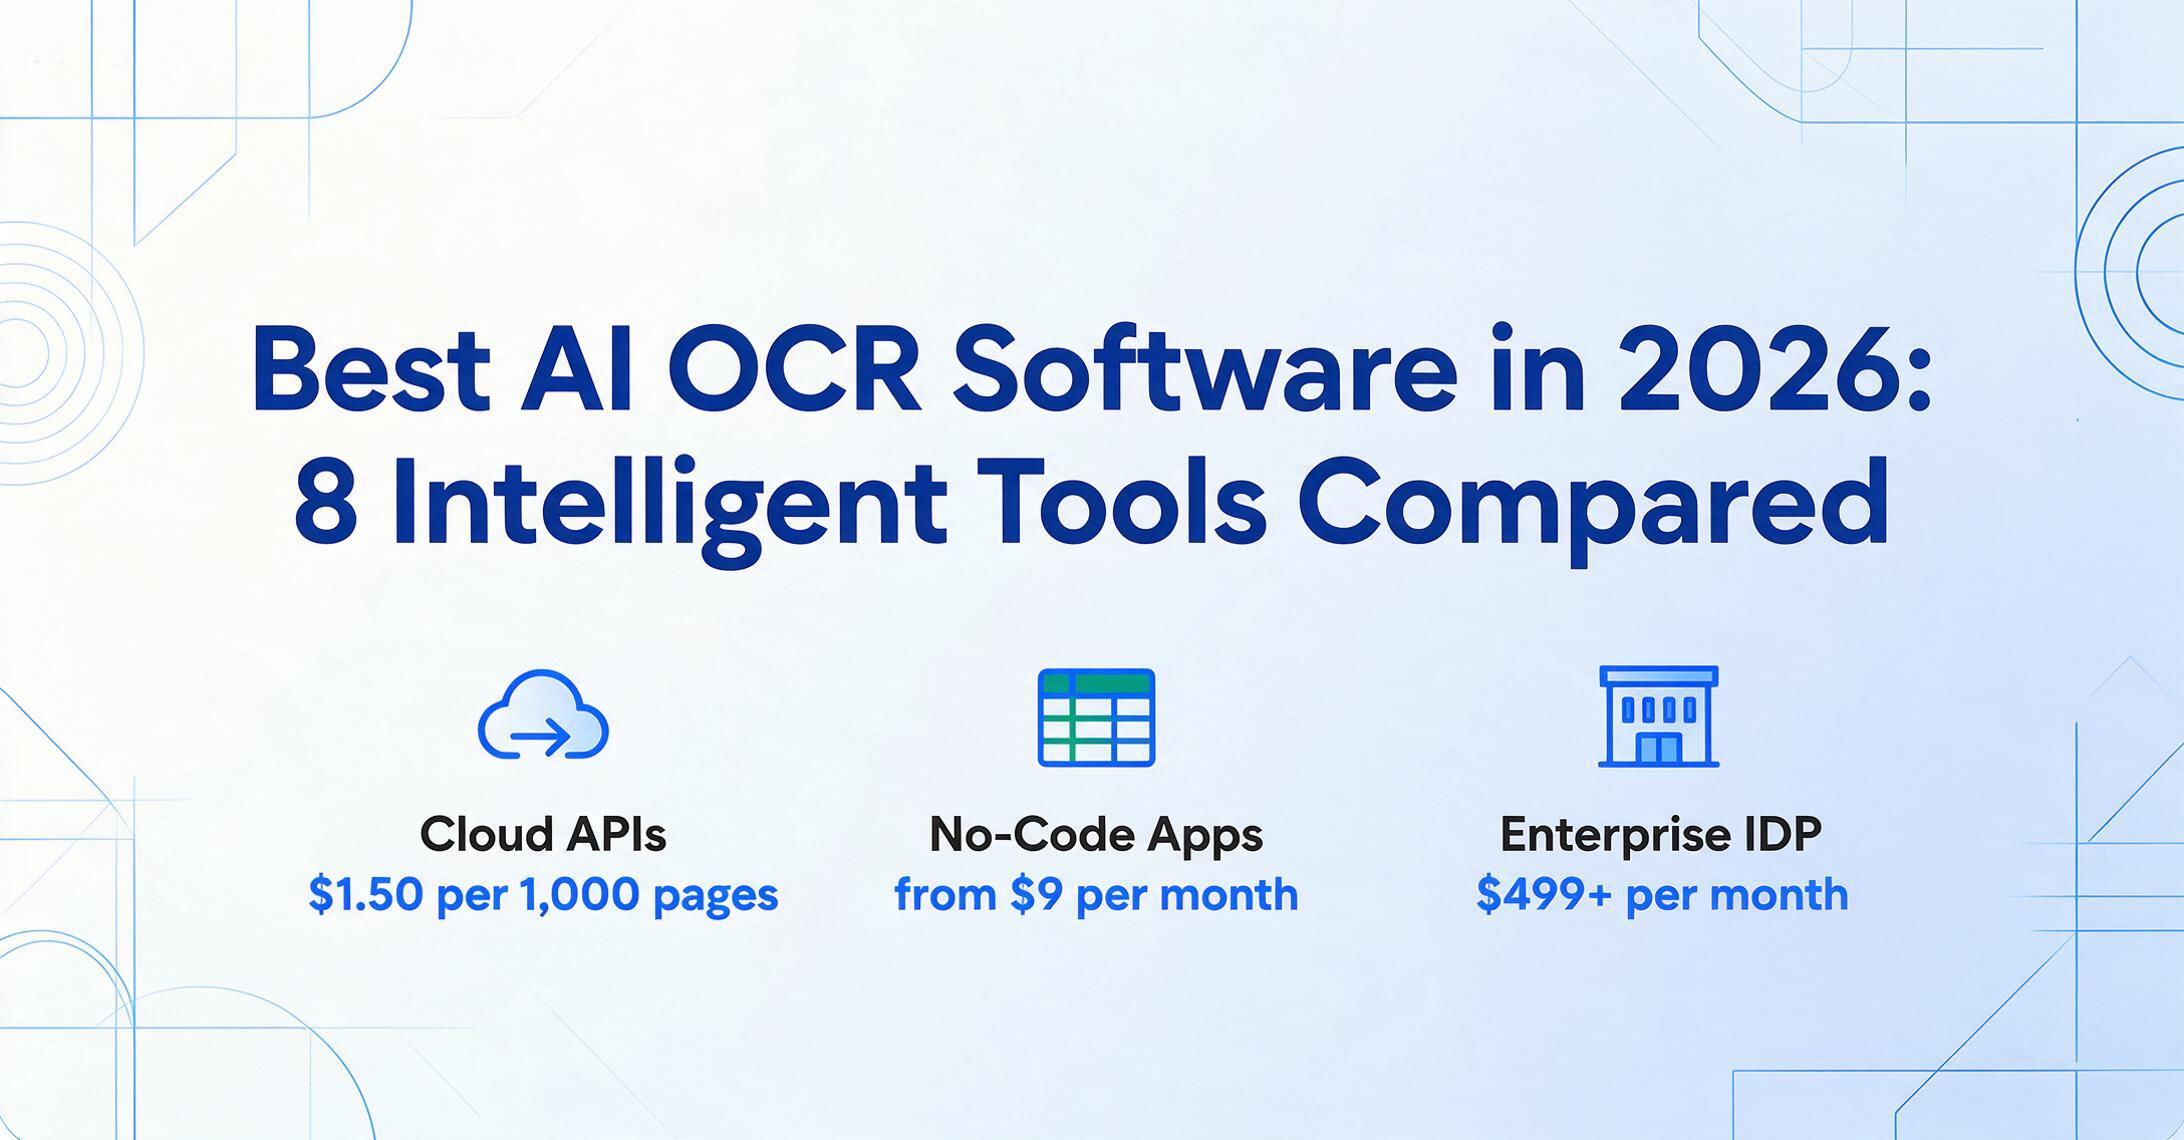
Die meisten „Besten-OCR“-Listen vermischen stillschweigend zwei verschiedene Dinge: Tools, die Bilder von Text in Zeichen umwandeln, und Tools, die verstehen, was diese Zeichen bedeuten. Die zweite Gruppe – KI-OCR – ist das Thema dieses Ratgebers. Die Krux ist, dass „KI-OCR“ heute von einer Enterprise-Plattform für 1.500 $/Monat, die eine 90-tägige Einführung benötigt, bis zu einer App für 9 $/Monat reicht, die Sie in den nächsten zehn Minuten nutzen können – und beide behaupten 99 % Genauigkeit. Dies ist ein technischer Beratervergleich von acht dieser Tools: was jedes tatsächlich kostet, zu wem es passt und – genauso wichtig – zu wem nicht.
Wichtigste Erkenntnisse
- Acht KI-OCR-Tools (Software, die Dokumente liest und versteht) werben alle mit rund 99 % Genauigkeit – das bedeutet, dass die Genauigkeit die eine Zahl ist, die Ihnen bei der Auswahl nicht weiterhilft.
- Das günstigste Tool kostet 9 $ pro Monat, das teuerste 18.000 $ pro Jahr – doch beide lesen Dokumente auf dieselbe Weise, denn diese 200-fache Lücke finanziert Infrastruktur, Integrationen und Compliance, nicht schärferes Lesen.
- Die richtige Wahl ist nicht das leistungsstärkste Tool, sondern das, dessen Form zu Ihrem Volumen, Ihrem Team und Ihrem Budget passt – die einzige Frage, die sich lohnt, ist also, welches passt, nicht welches gewinnt.
KI-OCR ist eine optische Zeichenerkennung, die ein Vision-Sprachmodell nutzt, um ein Dokument zu verstehen, statt es nur zu transkribieren. Dieser Unterschied ist wichtig, weil er bestimmt, was Sie von dem Tool verlangen können – und was Sie dafür bezahlen.
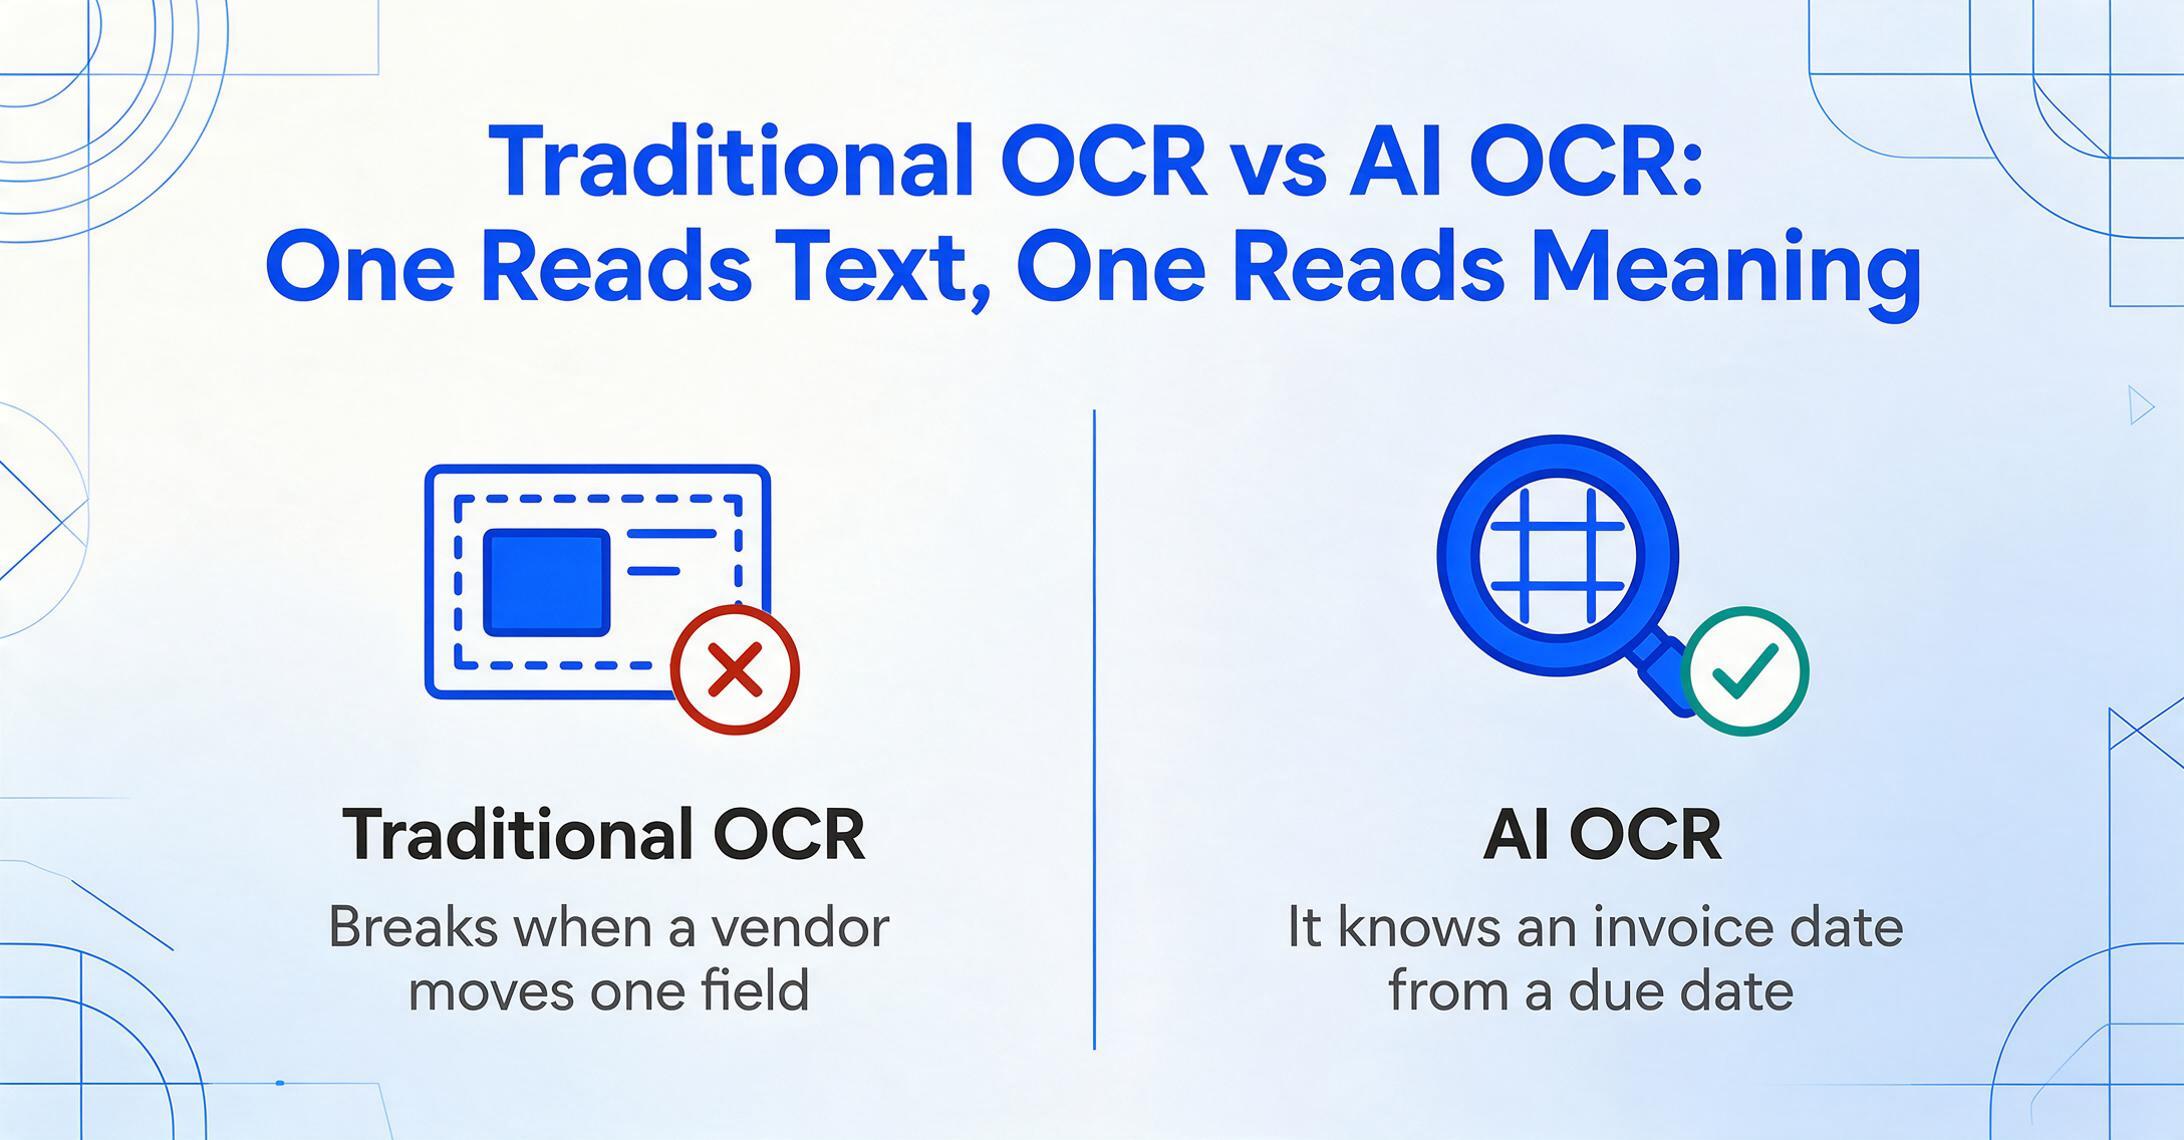
Traditionelle OCR ist eine Mustererkennungstechnologie. Sie scannt ein Bild, gleicht Pixelformen mit einer Datenbank von Zeichenformen ab und gibt Text aus. Sie hat keine Ahnung, ob eine Zahl eine Rechnungssumme oder eine Bestellnummer ist; sie weiß nur, dass die Zeichen „1“, „2“, „0“, „0“ sind. Sie funktioniert gut bei sauberen, vorhersehbaren Layouts und bricht zusammen, sobald ein Anbieter ein Feld verschiebt, eine Schriftart ändert oder einen leicht schiefen Scan sendet. Um bestimmte Felder zu extrahieren, verlassen sich traditionelle OCR-Tools auf Vorlagen – Sie zeichnen ein Feld um die Stelle, an der die „Rechnungsnummer“ steht, und das Tool kopiert, was auf jedem Dokument an diesen Koordinaten erscheint. Ändert sich das Layout, zeigt das Feld auf das Falsche.
Traditionelle OCR liest, wo die Daten stehen. KI-OCR liest, was die Daten bedeuten – deshalb funktioniert sie auch bei Layoutänderungen weiter und kann ein Rechnungsdatum von einem Fälligkeitsdatum unterscheiden, ohne dass ihr gesagt wird, wo sich eines davon auf der Seite befindet.
KI-OCR, die auf Vision-Sprachmodellen basiert, fügt der Zeichenerkennung kontextuelles Verständnis hinzu. Sie betrachtet die gesamte Seite, erkennt, dass ein Dollar-Betrag in einer Tabelle zu einem bestimmten Spaltenkopf gehört, leitet ein unklares Wort aus dem umgebenden Kontext ab und versteht, dass sich Kopfzeilen über eine mehrseitige Tabelle wiederholen. Deshalb wird sie oft als „intelligente OCR“ oder, wenn sie einen vollständigen Workflow speist, als IDP (Intelligente Dokumentenverarbeitung) bezeichnet. Der praktische Nutzen: Sie verarbeitet Dokumente, die sie noch nie gesehen hat, ohne dass eine Vorlage erstellt werden muss. Wenn Sie die zugrunde liegende Technik im Detail verstehen möchten, behandeln wir den Genauigkeitsunterschied zwischen KI-OCR und traditioneller OCR und die Abgrenzung zwischen OCR, Dokumenten-KI und IDP in separaten Leitfäden.
Das ist die Grenze, die dieser Leitfaden zieht. Wenn Sie sich über alle OCR-Angebote informieren – einschließlich traditioneller Desktop-Scanner und kostenloser Open-Source-Engines – sind unsere vollständige OCR-Software-Marktübersicht und unser KI-vs.-traditioneller-OCR-Vergleich die besseren Ausgangspunkte. Hier nutzt jedes bewertete Tool KI zum Lesen von Dokumenten, und die Frage ist, welches zu Ihrem Volumen, Budget und Team passt.
So haben wir ausgewählt und getestet
Acht Tools haben es auf diese Liste geschafft, weil sie die echte Bandbreite des KI-OCR-Marktes abbilden – nicht weil sie sich am leichtesten loben lassen. Wir sind von den Tools ausgegangen, nach denen Käufer tatsächlich suchen und die konkurrierende Übersichten durchgängig enthalten – die Enterprise-Cloud-APIs (Google, AWS), die IDP-Plattformen (ABBYY, Nanonets, Rossum, Docsumo, Affinda) und die leichten No-Code-Apps (unser eigenes ImageToTable.ai). Wir haben bewusst reine traditionelle OCR-Engines (Tesseract, einfache PDF-Scanner) ausgeschlossen, da sie außerhalb der Frage nach „KI-OCR" liegen – wenn Ihr Stack Open-Source ist, behandeln wir diesen Bereich in unserem Leitfaden beste Open-Source-OCR-Tools für Entwickler.
Jedes Tool wurde nach vier Kriterien bewertet: Extraktionsansatz (versteht es Dokumente oder gleicht es Vorlagen ab?), reale Preise (der niedrigste veröffentlichte Monatspreis, nicht „ab"), Einrichtungsaufwand (kann es ein Nicht-Entwickler nutzen, oder braucht es eine Modelltrainingsphase?) und ehrliche Passung (die Dokumenttypen und Teamgrößen, bei denen es wirklich überzeugt – und wo nicht). Die Preise stammen von den öffentlichen Preisseiten der Anbieter oder von neutralen Bewertungsplattformen (Capterra, G2, Software Advice) und sind aktuell mit Stand Preise geprüft Juni 2026. Wo ein Anbieter keine Preistabelle veröffentlicht (Rossum, Enterprise-Tier von ABBYY), sagen wir das deutlich, statt zu raten.
Ein Hinweis vorab: ImageToTable.ai – das Produkt, zu dem diese Website gehört – ist eines der acht bewerteten Tools. Wir haben es dort positioniert, wo es ehrlich hingehört (No-Code, kleine Teams, niedrige Kosten pro Dokument) und die Szenarien benannt, in denen ABBYY, Google, AWS oder Rossum die bessere Wahl sind. Eine Übersicht, die etwas anderes vorgibt, wäre Ihre Zeit nicht wert.
Zur Genauigkeitsfrage, die dieser ganzen Kategorie zugrunde liegt: Unser eigener Erstanbieter-Benchmark von 8 Open-Source-OCR-Engines mit identischen Belegen ergab, dass die beste traditionelle Engine und das beste VLM bei der Zeichengenauigkeit statistisch gleichauf lagen (docTR CER 0,197 vs. Surya2 0,191 auf SROIE 2019), und dass ein nachgeschalteter LLM-Postprozessor sechs von acht Engines in ein Feld-F1-Band von 0,57–0,62 bringt – „VLM schlägt OCR bei der Genauigkeit" ist also kein universelles Gesetz; es hängt von der Dokumentmischung und dem ab, was Sie konsumieren. Die Messunsicherheiten rund um CER sind in unserer Analyse warum CER in die Irre führt quantifiziert. Dieser Kontext ist der Grund, warum diese Liste Tools nach Dokumenttyp-Passung und Preis bewertet statt nach einer einzelnen Genauigkeitszahl.
Die 8 besten KI-OCR-Tools im Überblick
Die folgende Tabelle liefert die schnelle Antwort. Der Einstiegspreis ist der niedrigste veröffentlichte Monatspreis für jedes Tool (nutzungsbasierte Tools werden mit ihrem Preis pro Seite angegeben, da sie kein monatliches Minimum haben). „Preise geprüft im Juni 2026."
| Tool | Einstiegspreis | Preismodell | Am besten geeignet für | Wichtigste Einschränkung | Kostenlose Testversion? |
|---|---|---|---|---|---|
| ImageToTable.ai | 9 €/Monat | Abo + nutzungsabhängig (guthabenbasiert) | Kein Code, kleine Teams, Tabellenausgabe | Keine native ERP-Synchronisation, kein SOC 2/HIPAA | Kostenlose Basisversion |
| ABBYY FineReader / Vantage | 16 €/Monat (Desktop) | Pro Arbeitsplatz (Desktop); pro Seite individuell (Unternehmen) | Präzisions-OCR, 198 Sprachen, vor Ort | Enterprise-IDP vertriebsgesteuert, komplexe Einrichtung | Ja |
| Google Document AI | 1,50 $ / 1.000 Seiten | Nutzungsabhängig (pro Seite) | Hochvolumige Cloud-OCR, Entwickler | Erfordert Entwickler-Setup; Rohausgabe benötigt Nachbearbeitung | Kostenlose Stufe (GCP) |
| AWS Textract | 1,50 $ / 1.000 Seiten | Nutzungsabhängig (pro API-Aufruf/Seite) | Hochvolumige Cloud-OCR in AWS-Stacks | Nur für Entwickler; Formulare/Tabellen kosten 10–33× Basis | Kostenlose Stufe (1.000 S./Monat, 3 Monate) |
| Nanonets | 499 $/Monat (Pro) | Guthaben pro Ausführung (0,30 $/Extraktion) | Mittelstand bis Enterprise AP-Automatisierung | Oft Beispieltraining nötig; teuer für KMU | Kostenlose Stufe/Testversion |
| Docsumo | ~500 $/Monat | Pro Seite / individuell für Unternehmen | Finanzdokument-Workflows für den Mittelstand | Produktionspreise individuell; nicht KMU-freundlich | 14-Tage-Testversion (1.000 Seiten) |
| Affinda | Nutzungsabhängig (~299 $/Monat Produktion) | Nutzungsabhängige Plattform | Dokumenten-KI für den Mittelstand, Lebenslauf-/HR-Parsing | Keine einfache veröffentlichte Preisliste; Angebot erforderlich | Ja |
| Rossum | 18.000 $/Jahr (~1.500 $/Monat) | Jährliches Enterprise, vertriebsgesteuert | Enterprise-AP-Service-Shared-Service-Center | Kein Self-Service; 30–90 Tage Implementierung | Testversion auf Anfrage |
Zwei Muster fallen sofort auf. Erstens teilt sich die Preisgestaltung bei „KI-OCR" in drei Modelle: feste Abonnements (ImageToTable.ai, ABBYY Desktop), nutzungsbasierte Abrechnung pro Seite, die mit dem Volumen skaliert (Google, AWS, Nanonets, Affinda), und vertriebsgesteuerte Jahresverträge ohne veröffentlichten Preis (Rossum, Docsumo Enterprise, ABBYY Vantage). Zweitens liefern sowohl der günstigste Einstieg (9 $/Monat) als auch der teuerste (18.000 $/Jahr) KI-Extraktion – der Preisunterschied kauft Infrastruktur, Integrationen und Compliance, nicht grundlegend besseres Lesen. Welche davon Sie tatsächlich benötigen, ist die eigentliche Entscheidung, und der Rest dieses Leitfadens geht darauf Tool für Tool ein.
Cloud-OCR-APIs für Entwickler: Google Document AI & AWS Textract
Wenn Sie über technische Ressourcen und ein hohes, stabiles Volumen verfügen, sind die beiden Hyperscaler-OCR-APIs in Bezug auf die rohen Kosten pro Seite kaum zu schlagen. Sie sind keine Produkte, die Sie „nutzen" – es sind APIs, auf denen Sie aufbauen.
Google Document AI
Google Document AI ist eine Cloud-Plattform mit einer Familie von Prozessoren: einem allgemeinen Enterprise Document OCR-Prozessor sowie Form Parser- und Custom Extractor-Prozessoren, die strukturierte Felder extrahieren. Die Basis-OCR kostet 1,50 $ pro 1.000 Seiten (ab 5 Millionen Seiten/Monat sinkt der Preis auf 0,60 $), während Custom Extractor und Form Parser 30 $ pro 1.000 Seiten kosten. Die Handschrifterkennung unterstützt über 60 Sprachen mit hoher Genauigkeit bei strukturierten Formularen.
Am besten geeignet für: Entwicklungsteams, die eine skalierbare, API-basierte Erkennung für Geschäftsformulare mit hohem Volumen benötigen, insbesondere solche, die bereits Google Cloud nutzen. Nicht ideal für: Nicht-Entwickler – es gibt keine Point-and-Click-App, und die OCR liefert rohe Textblöcke, die erst nachbearbeitet werden müssen, bevor sie tabellenfertig sind. Die Preise steigen außerdem schnell, sobald man von der Basis-OCR zur strukturierten Feldextraktion wechselt. Google Document AI-Preise ansehen →
AWS Textract
Textract ist der Dokument-OCR- und Datenextraktionsdienst von Amazon, der über mehrere APIs verfügbar ist (Detect Document Text, Analyze Document, Analyze Expense, Analyze ID). Detect Document Text kostet 1,50 $ pro 1.000 Seiten, aber die strukturierten Funktionen sind deutlich teurer: Tabellen kosten etwa 15 $ pro 1.000 Seiten und Formulare etwa 50 $ pro 1.000 Seiten. Ein kostenloses Kontingent umfasst 1.000 Seiten/Monat für die ersten drei Monate. Ein Reddit-Nutzer, der darauf aufbaut, merkte an, dass Textract für Basistext „recht vernünftig (~1 Cent USD pro Dokument)“ ist – aber dieser Betrag steigt bei Formularen und Tabellen stark an.
Am besten geeignet für: Teams, die bereits im AWS-Ökosystem arbeiten und OCR als Baustein in einer größeren Pipeline nutzen möchten. Nicht ideal für: alle ohne Entwickler oder Workloads, die von Formularen und Tabellen dominiert werden, wo die Kosten pro Seite das 10- bis 33-fache des Basissatzes betragen. Wir erläutern die Abwägungen in unserem AWS Textract-Vergleich. AWS Textract-Preise ansehen →
Beide APIs haben für nicht-technische Käufer dieselbe grundlegende Grenze: Sie lesen Dokumente gut, aber die Umwandlung ihrer Ausgabe in eine fertige Tabelle – mit Ihren Spaltennamen, Ihren Formaten, Ihren Berechnungen – ist ein Projekt, kein Feature. Das ist die Lücke, die die No-Code-Tools weiter unten in dieser Liste schließen.
Enterprise-IDP-Plattformen: ABBYY, Nanonets, Rossum, Docsumo & Affinda
Die Mitte des Marktes wird von Plattformen für intelligente Dokumentenverarbeitung (IDP) eingenommen – Tools, die KI-OCR in Workflow, Validierung und Integrationen einbetten. Sie sind für Organisationen konzipiert, die monatlich Tausende von Dokumenten verarbeiten, mit Mitarbeitern, deren Aufgabe es ist, diese Pipeline zu verwalten.
ABBYY (FineReader PDF & Vantage)
ABBYY ist der Urvater der OCR und verkauft zwei sehr unterschiedliche Produkte. FineReader PDF ist ein Desktop-OCR- und PDF-Tool ab 16 $/Monat (Standard für Windows; Corporate für 24 $/Monat), geschätzt für seine Genauigkeit – unabhängige Vergleiche nennen etwa 99,8 % – und die Unterstützung von 198 Sprachen. ABBYY Vantage und FlexiCapture sind die Enterprise-IDP-Produkte, die pro Seite über individuelle Angebote abgerechnet werden (anonymisierte Käuferdaten zeigen etwa 0,04–0,08 $/Seite bei moderatem Volumen).
Am besten geeignet für: genauigkeitskritische OCR, mehrsprachige Archive, On-Premise-Bereitstellungen und PDF-Bearbeitungsworkflows, bei denen die Desktop-Politur von FineReader glänzt. Nicht ideal für: Teams, die eine Self-Service-Cloud-App wünschen – die Enterprise-IDP-Stufe ist vertriebsgesteuert mit einer echten Implementierungsphase, und FineReader Desktop ist nicht für die Batch-API-Automatisierung gebaut. Den direkten Vergleich finden Sie in unserem ABBYY-FineReader-Vergleich. ABBYY-FineReader-Preise ansehen →
Nanonets
Nanonets ist eine Plattform für Workflow-Automatisierung und Dokumenten-KI, die sich gezielt an Kreditorenbuchhaltungsteams (AP) richtet. Sie bietet ein kostenloses Starter-Kontingent, aber der Produktions-Pro-Plan beginnt bei 499 $/Monat, wobei die Extraktion über ein Creditsystem mit 0,30 $ pro Durchlauf abgerechnet wird. Die Plattform ist leistungsstark und integrierungsreich, mit Konnektoren für QuickBooks, Sage und Xero.
Am besten geeignet für: AP-Automatisierung im Mittelstand und Enterprise-Bereich, wo Workflow-Genehmigungen und Buchhaltungsintegrationen den Preis rechtfertigen. Nicht ideal für: kleine Teams oder alle, die keine Einrichtung wünschen – Nanonets erfordert oft das Hochladen von Mustern und das Trainieren von Modellen für komplexe Dokumenttypen, was eine Einarbeitungsphase mit sich bringt. Unser Nanonets-Vergleich zeigt, wo sich diese Einrichtung auszahlt und wo nicht. Nanonets-Preise ansehen →
Rossum
Rossum positioniert sich rund um ein individuell trainiertes „transaktionales LLM“ – es trainiert ein Extraktionsmodell auf den historischen Dokumenten jedes Kunden und setzt es dann in AP-Workflows in Shared-Service-Centern mit menschlicher Validierung ein. Die Preisgestaltung erfolgt vollständig über den Vertrieb: Die Einstiegsstufe beginnt Berichten zufolge bei 18.000 $/Jahr (~1.500 $/Monat), die Business-Preise werden auf Anfrage mitgeteilt. Öffentliche Bewertungen auf G2 und Gartner Peer Insights sind bei Enterprise-AP-Käufern stark.
Am besten geeignet für: große Unternehmen, die ein hohes AP-Volumen über ein Shared-Service-Center abwickeln und für die eine Implementierungsdauer von 30–90 Tagen sowie ein individuelles Modelltraining akzeptable Investitionen sind. Nicht ideal für: KMU, Buchhalter oder alle, die weniger als ~5.000 Dokumente pro Monat verarbeiten – der Implementierungszeitraum und die Preisgestaltung sind übertrieben, und es gibt keine Selbstanmeldung. Weitere Details in unserem Rossum-Vergleich. Rossum-Preise ansehen →
Docsumo
Docsumo ist eine IDP-Plattform für den Mittelstand mit starkem Fokus auf Finanzdokumente – Kontoauszüge, Rechnungen und Risikobewertungsunterlagen – und meldet für einige Kunden eine Straight-Through-Processing-Quote von über 95 %. Es bietet eine 14-tägige kostenlose Testversion (1.000 Seiten), aber Produktionspläne beginnen bei etwa 500 $/Monat, wobei Enterprise-Preise individuell auf Anwendungsfall und Supportbedarf zugeschnitten sind.
Am besten geeignet für: Finanz- und Kredit-Teams im Mittelstand, die validierte, integrierungsbereite Ergebnisse in großem Umfang benötigen. Nicht ideal für: Einzelnutzer und kleine Unternehmen – der Einstiegspreis setzt ein Team und einen Workflow voraus, nicht eine Einzelperson, die Belege digitalisiert. Vergleichen Sie die Ansätze in unserem Docsumo-Vergleich. Docsumo-Preise ansehen →
Affinda
Affinda ist eine Dokumenten-KI-Plattform, die für die Analyse von Lebensläufen sowie für breitere HR- und Finanzdokument-Workflows bekannt ist. Eine Kontrollebene stellt sicher, dass jede extrahierte Antwort mit ihrer Quelle verknüpft ist. Die Preisgestaltung erfolgt nutzungsbasiert und ist größtenteils angebotsorientiert; Testversionen starten sehr niedrig, während Produktionsumgebungen üblicherweise bei etwa 299 $/Monat für ca. 5.000 Seiten liegen.
Am besten geeignet für: Recruiting-Tech- und Mid-Market-Teams, die eine kontrollierte, prüfbare Extraktion benötigen – insbesondere bei strukturierten HR-Dokumenten. Weniger geeignet für: Käufer, die einen transparenten Self-Service-Preis wünschen; wie bei den meisten Plattformanbietern erfordert die Produktionspreisgestaltung ein Gespräch. Affinda hat auf dieser Website noch keine eigene Vergleichsseite, passt aber in dieselbe Mid-Market-IDP-Kategorie wie Docsumo und Nanonets. Affinda-Preise ansehen →
Die Gemeinsamkeit aller fünf: echte Leistungsfähigkeit, echte Workflow-Funktionen – und ein echtes Maß an Aufwand. Sie sind sinnvoll, wenn die Dokumentenverarbeitung eine Abteilung ist, nicht eine Aufgabe. Wenn es nur eine Aufgabe ist, sind die nächsten beiden Tools genau für Sie gemacht.
No-Code-KI-OCR für schlanke Teams: ImageToTable.ai
Am zugänglichen Ende des Marktes befindet sich ein Tool für Menschen, die extrahierte Daten in einer Tabellenkalkulation erhalten möchten, ohne Code zu schreiben, ein Modell zu trainieren oder einen Jahresvertrag zu unterschreiben. Hier liegt ImageToTable.ai – das Produkt hinter dieser Website und eines der acht Tools in diesem Vergleich.
ImageToTable.ai
ImageToTable.ai ist ein KI-Datenextraktionstool, das auf einem Vision-Sprachmodell basiert. Der Kernmechanismus ist die Benutzerdefinierte Spaltenextraktion: Statt Bereiche zu zeichnen oder ein Modell zu trainieren, geben Sie die gewünschten Spaltennamen ein – „Rechnungsnummer“, „Fälligkeitsdatum“, „Gesamtsumme“ – und die KI findet jeden Wert auf der Seite, indem sie dessen Bedeutung versteht. Da es vorlagenfrei ist, erfordert ein neues Lieferantenformat keine Einrichtung; Sie laden hoch und los geht's. Es bietet zwei Funktionen, die den meisten Budget-Tools fehlen: Berechnete Spalten (definieren Sie „Positionssumme (Menge × Einzelpreis)“ und die KI berechnet dies während der Extraktion) und Abgeleitete Spalten (eine „Kategorie“-Spalte, die die KI ausfüllt, auch wenn das Dokument kein solches Feld enthält). Die Ausgabe erfolgt direkt in Excel, CSV, JSON oder Word, mit einem nativen Google-Sheets-Add-on. Die Preisgestaltung beginnt mit einem kostenlosen Kontingent, danach 9 $/Monat (Basic), mit nutzungsbasierter Abrechnung über Credits, die nicht verfallen.
Am besten geeignet für: Freiberufler, Buchhalter und kleine bis mittlere Teams, die eine No-Code-, vorlagenfreie Extraktion in eine Tabellenkalkulation zu den niedrigsten Kosten pro Dokument wünschen – einschließlich handschriftlicher Dokumente und Handyfotos. Weniger geeignet für: Unternehmen, die eine native One-Click-ERP-Synchronisierung, eine On-Premise-Bereitstellung oder SOC-2-/HIPAA-Konformität benötigen – für diese sind ABBYY, Rossum oder die Hyperscaler-APIs die richtige Wahl. Es ist ein Extraktionstool, keine AP-Workflow-Plattform mit Genehmigungsrouting. Sie können den No-Code-Ansatz auf unserer KI-OCR-Extraktionsseite in Aktion sehen oder lesen, wann es sinnvoll ist, von traditioneller OCR auf KI-Extraktion umzusteigen. ImageToTable.ai kostenlos testen →
Was ist mit ChatGPT und Gemini für OCR?
Allgemeine multimodale Modelle – ChatGPT, Gemini, Claude – lesen Dokumente beeindruckend gut, und sie tauchen aus gutem Grund in jedem OCR-Ranking für 2026 auf: Ihre kontextuelle Genauigkeit bei unordentlicher Handschrift ist wirklich stark. Für ein einmaliges Dokument ist es eine legitime Option, ein Bild in ein Chat-Fenster einzufügen und nach einer Tabelle zu fragen.
Wo sie schwächeln, ist die wiederholbare Batch-Extraktion. Sie haben keine eingebaute Batch-Pipeline, die 50 Rechnungen zu einer konsistenten Tabelle zusammenführt, kein erzwungenes Ausgabeschema (derselbe Prompt kann bei verschiedenen Läufen leicht unterschiedliche Spaltenstrukturen zurückgeben) und die Tendenz, gelegentlich plausibel aussehende Werte zu „ergänzen", anstatt eine Lücke zu kennzeichnen. Die speziellen KI-OCR-Tools in diesem Leitfaden umgeben dieselbe Modellklasse mit den Schutzvorrichtungen, die die Ausgabe bei hohem Volumen zuverlässig machen. Wir gehen in unserem ChatGPT-Vergleich auf die Details ein. Die Kurzfassung: Nutzen Sie einen Chatbot für ein Dokument, aber ein zweckgebundenes Tool für einen Prozess.
So wählen Sie: Nach Teamgröße, Budget und Dokumenttyp
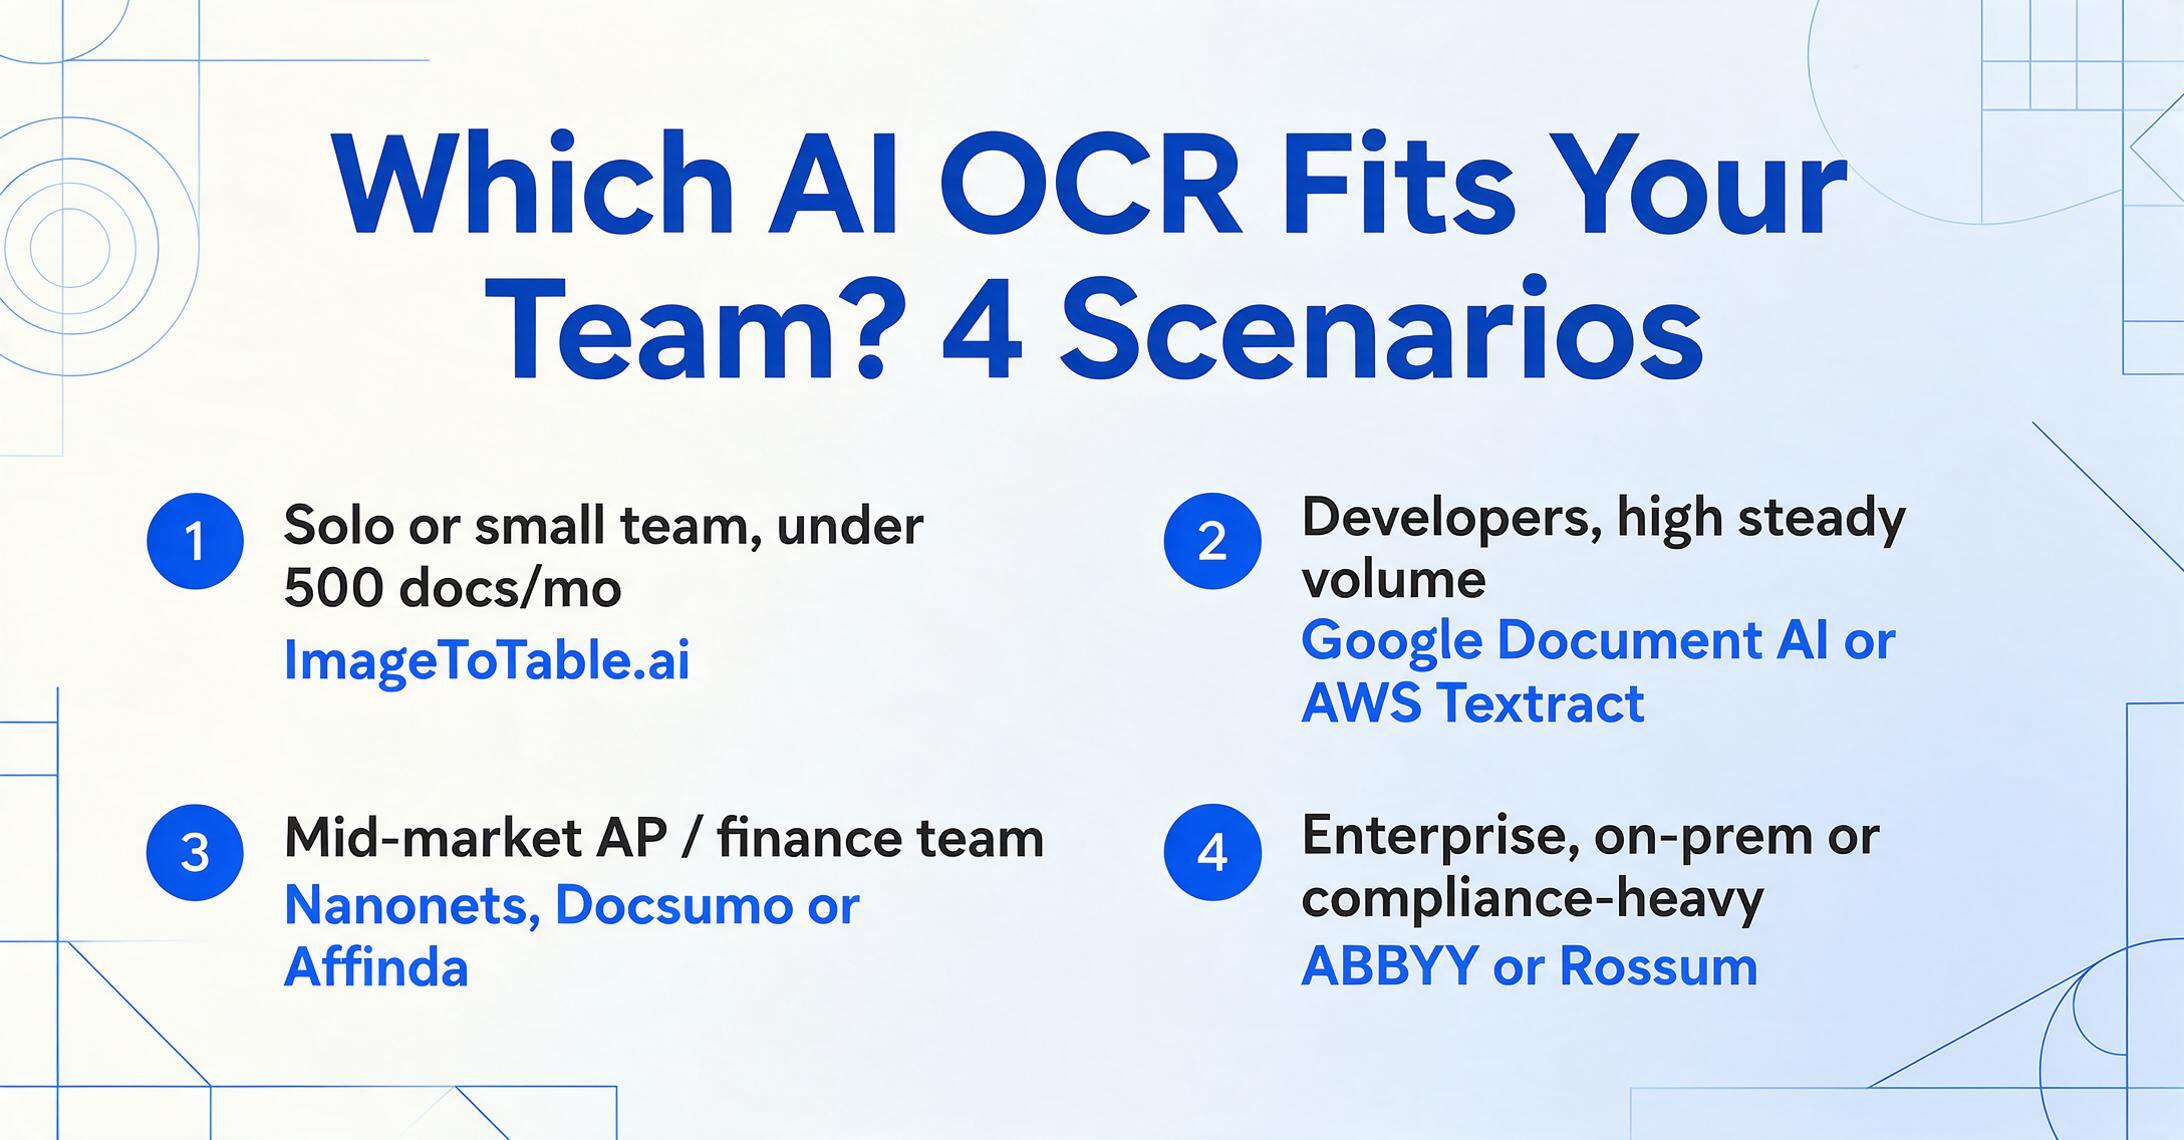
Das richtige KI-OCR-Tool hängt weniger davon ab, welches insgesamt das „beste" ist, sondern eher davon, welches zu Ihrer Situation passt. Hier ist die Entscheidung in vier häufigen Szenarien.
Solo / kleines Team, <500 Dokumente/Monat
Am besten geeignet: ImageToTable.ai
No-Code, keine Einrichtung, Tabellenkalkulations-Ausgabe und ein Preis, der zum Volumen passt. Eine Plattform für 499 $/Monat verschwendet hier 90 % ihrer Kapazität. Beginnen Sie mit einem kostenlosen Kontingent und bestätigen Sie, dass die KI Ihre spezifischen Dokumente liest, bevor Sie etwas bezahlen.
Entwickler, hohes konstantes Volumen
Am besten geeignet: Google Document AI oder AWS Textract
Niedrigste Kosten pro Seite bei großem Umfang, und Sie haben das technische Know-how, um rohe Ausgaben in strukturierte Daten umzuwandeln. Wählen Sie danach, in welcher Cloud Sie bereits arbeiten. Kalkulieren Sie den Preissprung ein, sobald Sie Formulare und Tabellen hinzufügen.
AP-/Finanzteam im Mittelstand
Am besten geeignet: Nanonets, Docsumo oder Affinda
Wenn die Dokumentenverarbeitung ein Workflow mit Genehmigungen, Validierung und Buchhaltungssystem-Anbindungen ist, verdienen die IDP-Plattformen ihren Preis. Rechnen Sie mit einer Testphase und einer Einarbeitungszeit. Vergleichen Sie sie hinsichtlich der Integrationstiefe, nicht nur der Genauigkeit.
Enterprise, On-Premises oder compliance-lastig
Am besten geeignet: ABBYY oder Rossum
On-Premises-Bereitstellung, Abdeckung von 198 Sprachen, individuell trainierte Modelle und Shared-Service-Center-Skalierung. Vertriebsgesteuerte Preise und eine echte Implementierung, aber das ist der Preis für Enterprise-Governance.
Wenn Ihre Situation mehrere Kategorien umfasst – etwa ein schlankes Team heute, das skalieren möchte – lohnt sich ein Blick auf die verwandten Übersichten, die tiefer in jedes Segment einsteigen: Tools zur Dokumentdatenextraktion, Plattformen für intelligente Dokumentenverarbeitung und Datenextraktionssoftware für unstrukturierte Dokumente.
So bewerten Sie jedes Tool, bevor Sie kaufen
Der entscheidende Schritt, der einen guten KI-OCR-Kauf von einem bereuten trennt, ist das Testen mit Ihren Dokumenten – nicht mit den polierten Beispiel-PDFs des Anbieters. Jedes Tool in diesem Leitfaden bewirbt eine Genauigkeit von ~99 %; dieser Wert wird an sauberen gedruckten Texten gemessen, und Ihr Dokumentenstapel ist wahrscheinlich unordentlicher. Führen Sie einen Pilottest mit 20–50 Ihrer echten Dateien durch – die minderwertigen Scans, Handyfotos, mehrseitigen Tabellen und Handschriften, die Sie tatsächlich verarbeiten, nicht die saubersten. Achten Sie während des Pilottests auf drei Dinge:
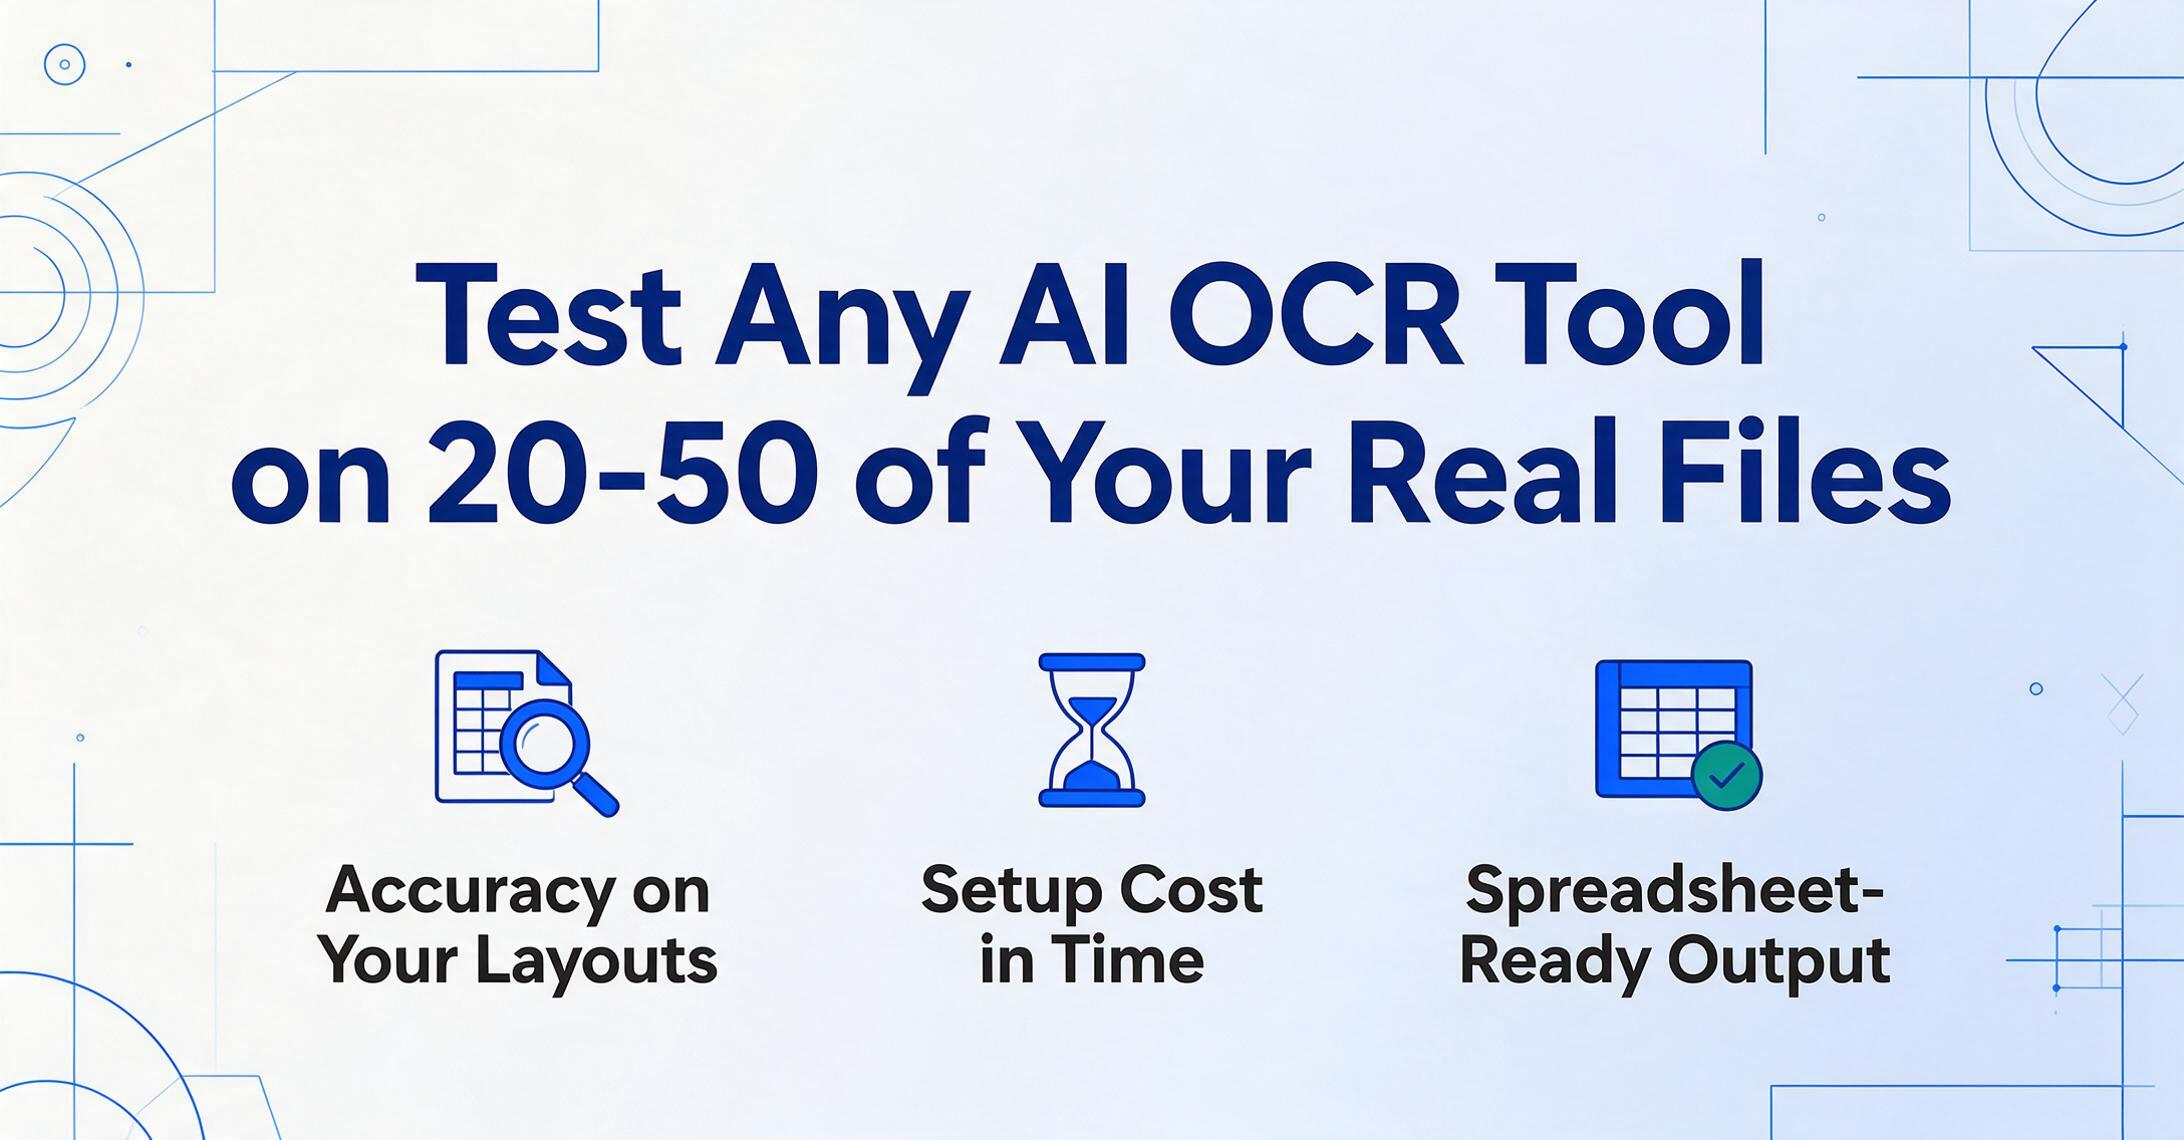
- Genauigkeit bei Ihren Layouts: Liest das Tool die Felder, die Ihnen wichtig sind, korrekt oder nur „den Großteil“ der Seite? Prüfen Sie die spezifischen Dokumenttypen, die Ihren Arbeitsablauf dominieren, nicht das Demo-Dokument.
- Einrichtungsaufwand in Zeit: Kann eine Person ohne Entwicklerkenntnisse in Minuten strukturierte Ausgaben erhalten, oder sind Beispieltraining, Vorlagen oder ein Vertriebsgespräch mit Implementierungsphase erforderlich? Addieren Sie die Onboarding-Stunden zum Preis, wenn Sie Tools vergleichen.
- Ausgabequalität: Ist das Ergebnis tabellenbereit – Spalten, die Ihren Feldnamen zugeordnet sind – oder Rohtext, den Sie noch von Hand bereinigen müssen? Diese Bereinigungszeit ist ein realer Kostenfaktor, und genau hier verdienen No-Code-Extraktionstools wie ImageToTable.ai ihren Wert.
Die meisten Tools hier bieten genau für diesen Test ein kostenloses Kontingent oder eine Testversion an – nutzen Sie es. Wenn ein Tool einen 20-Dokumenten-Pilottest mit Ihren echten Dateien nicht besteht, kann keine Benchmark-Tabelle oder Bewertung die Einführung retten.
Häufig gestellte Fragen
Was ist der Unterschied zwischen KI-OCR und herkömmlicher OCR?
Herkömmliche OCR wandelt Bilder von Text in Zeichen um, indem sie Pixelformen abgleicht – sie liest, wo Text sitzt, versteht aber nicht, was er bedeutet. Daher ist sie auf Vorlagen angewiesen und versagt, wenn sich Layouts ändern. KI-OCR nutzt ein Vision-Sprachmodell, um die Struktur und den Kontext des Dokuments zu verstehen: Sie erkennt, dass ein Betrag zu einer bestimmten Spalte gehört, unterscheidet ein Rechnungsdatum von einem Fälligkeitsdatum und verarbeitet Layouts, die sie noch nie gesehen hat – ganz ohne Vorlage.
Welche KI-OCR-Software ist am günstigsten?
Unter den acht hier vorgestellten Tools hat ImageToTable.ai den niedrigsten Einstiegspreis mit 9 $/Monat (plus einem kostenlosen Kontingent und nicht verfallenden nutzungsbasierten Credits). Die Cloud-APIs (Google Document AI, AWS Textract) sind pro Seite bei sehr hohem Volumen am günstigsten – 1,50 $ pro 1.000 Seiten für grundlegende OCR – erfordern aber Entwickler-Setup. Die Enterprise-Plattformen (Nanonets, Docsumo, Rossum) starten bei 499 $/Monat oder mehr.
Ist KI-OCR genauer als herkömmliche OCR?
Bei sauberen, vorhersehbaren Dokumenten können beide eine Genauigkeit im hohen 90er-Bereich erreichen. Der Unterschied zeigt sich bei realen Dokumenten – unterschiedliche Layouts, schlechte Scans, Handschrift, mehrseitige Tabellen – wo herkömmliche OCR stark nachlässt und KI-OCR standhält, weil sie aus dem Kontext heraus argumentiert. Unser hauseigener Open-Source-Benchmark hat die Grenze quantifiziert: Bei sauberen englischen Belegen erreichte die beste herkömmliche Engine (docTR, CER 0,197) ein Unentschieden gegen das beste VLM (Surya2, 0,191), und der VLM-Vorteil zeigt sich erst, wenn Feldextraktion oder unübersichtliche Layouts ins Spiel kommen. Führende KI-Tools berichten bis zu 99 % Genauigkeit bei gedruckten Tabellendaten; die entscheidende Frage ist nicht die Spitzengenauigkeit, sondern wie oft Ihre Dokumente außerhalb des Falls „sauber und vorhersehbar“ liegen.
Brauche ich Programmierkenntnisse, um KI-OCR zu nutzen?
Das hängt vom Tool ab. Google Document AI und AWS Textract sind APIs, die Entwickler erfordern. ABBYY Vantage, Nanonets, Docsumo und Affinda sind Plattformen, die Konfiguration und oft eine Modell-Trainings- oder Onboarding-Phase benötigen. ImageToTable.ai ist No-Code: Sie laden ein Dokument hoch, geben die gewünschten Spalten ein und erhalten eine Tabelle – ganz ohne Code und Modell-Training.
Kann KI-OCR Handschrift lesen?
Ja, deutlich besser als herkömmliche OCR. Tools auf Basis von Vision-Modellen interpretieren Handschrift mithilfe von Kontext – deshalb übertreffen sie Mustererkennungs-Engines bei Schreibschrift und unordentlichen Notizen. Bei sehr unleserlicher Handschrift sinkt die Genauigkeit jedoch weiterhin. Bei handschriftlastigen Arbeitslasten lohnt es sich daher, Ihre tatsächlichen Dokumente zunächst im kostenlosen Kontingent zu testen, bevor Sie sich festlegen.
Was bedeutet „Preismodell“ – Abonnement vs. nutzungsbasierte Abrechnung vs. vertriebsgesteuert?
Abonnement-Tools (ImageToTable.ai, ABBYY Desktop) berechnen eine feste monatliche Gebühr für eine bestimmte Kapazität – planbar und gut für gleichbleibendes Volumen. Nutzungsbasierte Tools (Google, AWS, Nanonets, Affinda) berechnen pro Seite oder pro Durchlauf – die Kosten skalieren mit dem Volumen, geeignet bei variabler oder sehr hoher Nutzung. Vertriebsgesteuerte Tools (Rossum, ABBYY Vantage, Docsumo Enterprise) bieten nach einem Vertriebsprozess einen individuellen Jahrespreis an – konzipiert für Unternehmen mit komplexen Anforderungen.
Das Fazit
Das Wichtigste, das Sie aus diesem Vergleich mitnehmen sollten: „KI-OCR“ ist keine einzelne Produktkategorie – es sind drei. Es gibt den Baustein für Entwickler (Google, AWS), die Unternehmensplattform (ABBYY, Nanonets, Rossum, Docsumo, Affinda) und die No-Code-Anwendung (ImageToTable.ai). Alle lesen Dokumente intelligent; sie unterscheiden sich grundlegend darin, wer sie bedienen soll und was rund um das Lesen geboten wird.
Kaufen Sie nicht das leistungsstärkste KI-OCR-Tool. Kaufen Sie das, dessen Form zu Ihnen passt – Ihr Volumen, Ihr Team, Ihr Budget – denn jedes Tool hier liest Dokumente gut, und der Preisunterschied zahlt für Infrastruktur, die Sie vielleicht nie nutzen.
Wenn Sie ein schlankes Team oder ein Solo-Profi sind, der einfach Dokumentdaten in einer Tabellenkalkulation haben möchte – keine Entwickler, kein Modelltraining, kein Jahresvertrag – dann ist das No-Code-Ende dieser Liste der richtige Einstieg. Und es kostet nichts, herauszufinden, ob die KI Ihre spezifischen Dokumente korrekt liest. Laden Sie eines hoch und beobachten Sie, wie eine von Ihnen benannte Spalte erscheint und in Sekunden ausgefüllt wird.
Offenlegung: Dieser Leitfaden wird von ImageToTable.ai veröffentlicht, einem der acht oben bewerteten Tools. Wir haben eine faire, technische Bewertung angestrebt – einschließlich der Nennung von Szenarien, in denen Konkurrenztools die bessere Wahl sind. Die Preise der Wettbewerber stammen von öffentlichen Preisseiten und neutralen Bewertungsplattformen und entsprechen dem Stand von Juni 2026; prüfen Sie vor dem Kauf die aktuellen Zahlen auf der Website jedes Anbieters.