AI OCR vs. Traditionelle OCR
Die Genauigkeitslücke, die Sie nicht länger ignorieren können
Im Jahr 2023 war die Genauigkeitslücke zwischen KI-gestützter OCR und traditioneller OCR noch umstritten. Mitte 2026 ist sie es nicht mehr. Wenn eine traditionelle OCR-Engine einen Batch mit Rechnungen verschiedener Lieferanten verarbeitet, liegt die Feldgenauigkeit in der Regel zwischen 60 % und 85 % – das bedeutet, dass 15 bis 40 von 100 Feldern manuell korrigiert werden müssen. Ein KI-Vision-Modell erreicht beim selben Batch: 95 % bis 99 %. Bei der Lücke geht es nicht mehr um „besser“ oder „schlechter“. Sie ist zu einem Kostenfaktor geworden, der sich in jedem Monatsabschluss, jeder AP-Abstimmung und jeder manuellen Prüfwarteschlange zeigt, die jemand besetzen muss. Dieser Artikel misst diese Lücke mit realen Zahlen, erklärt, was sich geändert hat, und zeigt den Punkt auf, an dem das Festhalten an traditioneller OCR teurer wird als der Wechsel.
Wichtigste Erkenntnisse
- Die „99 % Genauigkeit“ der traditionellen OCR misst Zeichen, nicht Datenfelder. Bei echten Rechnungen verschiedener Lieferanten sinkt die Feldgenauigkeit auf 40–60 % – die Hälfte Ihrer extrahierten Werte ist falsch, bevor jemand sie anfasst.
- Template-Drift ist der teuerste OCR-Fehler: Wenn ein Lieferant ein Feld verschiebt, zieht die Vorlage stillschweigend die falschen Daten in Ihr ERP. Kein Fehlerflag wird ausgelöst. Der Fehler fällt erst bei der Abstimmung auf, wenn die Behebung 10× mehr kostet.
- KI-Extraktion liest nach Bedeutung, nicht nach Pixelkoordinaten. Geben Sie Ihre Spaltennamen einmal ein – „Invoice Number“, „Due Date“ – und ImageToTable.ai findet sie sofort in jedem Layout. Vorlagenwartung und stiller Drift verschwinden.
Was traditionelle OCR leistet – und was sie nie geleistet hat
Optische Zeichenerkennung wurde entwickelt, um ein Problem zu lösen: ein Bild von Text in maschinenlesbare Zeichen umzuwandeln. Eine gescannte Seite geht hinein, eine Zeichenkette kommt heraus. Für diese eng umrissene Aufgabe arbeiten moderne OCR-Engines gut. Tesseract 5, der von Google gepflegte Open-Source-Maßstab, erreicht 95 % Zeichengenauigkeit bei sauberen Drucksachen – vergleichbar mit kommerziellen Engines unter kontrollierten Bedingungen.
Aber Zeichengenauigkeit ist nicht Datengenauigkeit. Zu wissen, dass die Zeichen „1.234,56“ auf einer Seite erscheinen, sagt Ihnen nicht, ob es sich um eine Rechnungssumme, eine Menge oder eine Referenznummer handelt. Traditionelle OCR arbeitet von unten nach oben: einzelne Zeichen erkennen, zu Wörtern zusammenfügen, Wörter zu Zeilen gruppieren. Das Ergebnis ist ein Textstrom, der nach Lesereihenfolge organisiert ist – von links nach rechts, von oben nach unten. Sie hat kein Verständnis dafür, was das alles bedeutet.
Die Folge davon ist, dass jede Layoutvariation zu einem separaten Parsing-Problem wird. Ein Anbieter, der die Rechnungsnummer in der oberen rechten Ecke platziert, erzeugt eine Koordinatenkarte. Ein Anbieter, der sie unter dem Logo platziert, erzeugt eine andere. Ändern Sie die Schriftart, fügen Sie ein neues Feld hinzu, ordnen Sie eine Tabelle neu an – und die Extraktionslogik bricht stillschweigend zusammen. Template-basierte OCR-Systeme versuchen, dies zu lösen, indem sie Pixelkoordinaten für jedes Feld auf jedem Dokumenttyp definieren. Das funktioniert, wenn Ihr Dokumentensatz fest und homogen ist. Es bricht zusammen, wenn Dokumente variieren – was die Norm für jedes Unternehmen ist, das Rechnungen, Bestellungen oder Belege von mehr als einer Quelle erhält.
Die Genauigkeitszahlen: Was Benchmarks 2026 tatsächlich zeigen
Die Genauigkeitslücke ist nicht theoretisch. Unabhängige Benchmarks quantifizieren sie jetzt über Dokumenttypen und Schwierigkeitsgrade hinweg. Hier ist, was die Daten Mitte 2026 sagen:
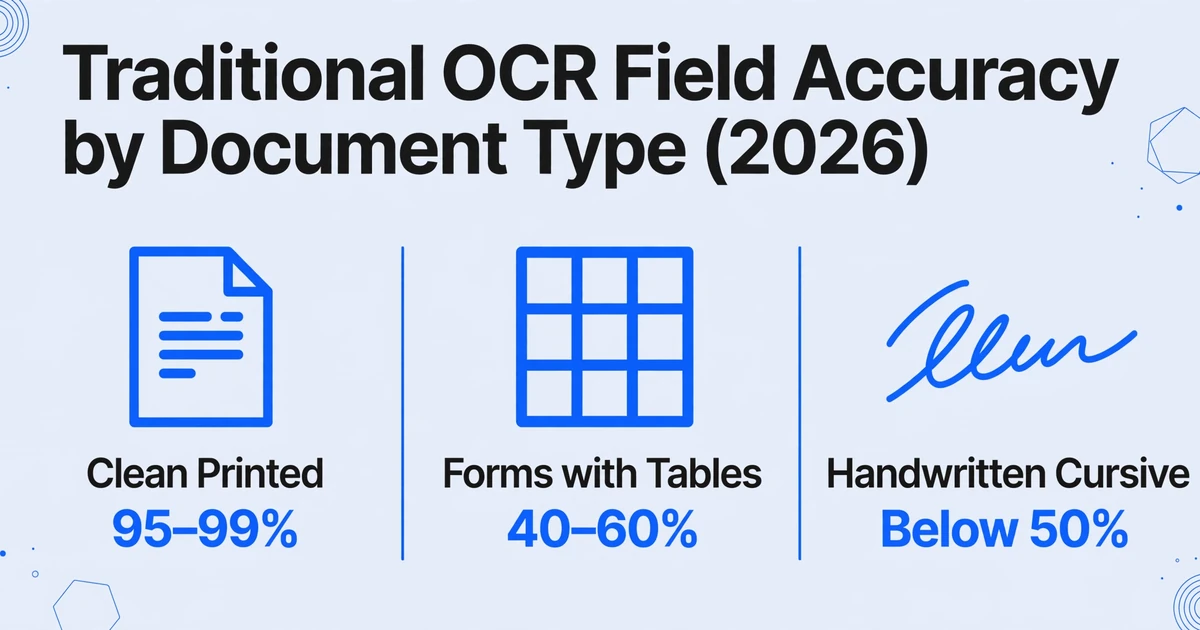
| Dokumenttyp | Traditionelle OCR | AI OCR (VLM-basiert) | Hauptfehlerquelle bei traditioneller OCR |
|---|---|---|---|
| Sauberer Drucktext, festes Layout | 95–99 % | 98–99 % | Minimale Lücke – beide liefern gute Ergebnisse |
| Formulare mit Tabellen & gemischten Spalten | 40–60 % | 85–95 % | Zeilen/Spalten werden bei der Extraktion zusammengeführt oder gehen verloren |
| Handschrift (Blockschrift) | 50–70 % | 85–93 % | Variationen der Zeichenform überfordern das Mustererkennungsverfahren |
| Handschrift (Schreibschrift) | Unter 50 % | 75–85 % | Verbundene Zeichen werden als einzelne Glyphen gelesen |
| Rechnungen verschiedener Anbieter (unterschiedliche Layouts) | 60–85 % (Feldebene) | 95–98 % (Feldebene) | Vorlagenabweichung; Koordinaten-Drift; Bezeichnungsvariation |
Quellen: Firstsource AI-Modell-Benchmarks (2026) für Genauigkeitsvergleiche bei komplexen Dokumenten; 47Billion Tesseract-vs.-docTR-Analyse für Basiswerte traditioneller OCR; AIMultiple-Handschrift-OCR-Benchmark (2026) für Handschriftwerte in beiden Kategorien. Alle Zahlen spiegeln die Feldgenauigkeit bei produktionsreifen Dokumenten wider, nicht Laborbedingungen mit sauberen Scans.
Diese Zahlen zeigen ein Muster. Bei sauberen, konsistenten Dokumenten – einem maschinengeschriebenen Formular, das mit 300 DPI gescannt wurde und vorhersehbare Felder enthält – liefert traditionelle OCR eine Genauigkeit, die zu diesem Preis kaum zu übertreffen ist. Sobald Dokumente jedoch Tabellen, Handschrift, gemischte Layouts oder Formatvariationen aus verschiedenen Quellen enthalten, fällt die Leistung stark ab. Ein Tesseract-Praktiker-Benchmark von 2025 mit realen Dokumenten ergab ohne aufwendige Vorverarbeitung nur 40–50 % Feldgenauigkeit – das bedeutet, dass mehr als die Hälfte der extrahierten Felder überprüft werden musste, bevor die Daten verwendbar waren.
Es gibt eine zweite Ebene dieser Zahlen, die die meisten Vergleiche übersehen. Eine Zeichengenauigkeit von 99 % – die jahrzehntelange Standard-OCR-Marketingaussage – bedeutet nicht, dass 99 % der benötigten Daten korrekt sind. Wenn eine Rechnungsseite 1.000 Zeichen enthält und 10 falsch gelesen werden, beträgt die Zeichengenauigkeit 99 %. Aber wenn diese 10 falschen Zeichen in 3 der 15 relevanten Felder fallen, sinkt die Feldgenauigkeit auf 80 %. TDWI dokumentierte genau dieses Szenario: Das Dashboard zeigt 99 %, aber 1 von 5 Geschäftsfeldern enthält einen Fehler. Multiplizieren Sie das über 500 Rechnungen, und die Prüfwarteschlange wird zum Engpass, den das Tool eigentlich beseitigen sollte.
Wo traditionelle OCR systematisch versagt – nicht „ungenau“, sondern strukturell blind
Es ist verlockend, die Fehler traditioneller OCR als Genauigkeitsprobleme zu beschreiben. Präziser ist es, sie als strukturelle blinde Flecken zu bezeichnen – Szenarien, in denen der Bottom-up-Ansatz, der Zeichen für Zeichen arbeitet, architektonisch nicht in der Lage ist, korrekte Ergebnisse zu liefern, unabhängig von der Bildqualität. Hier sind die Fehlermodi, die die Kosten für die Fehlerkorrektur in die Höhe treiben:
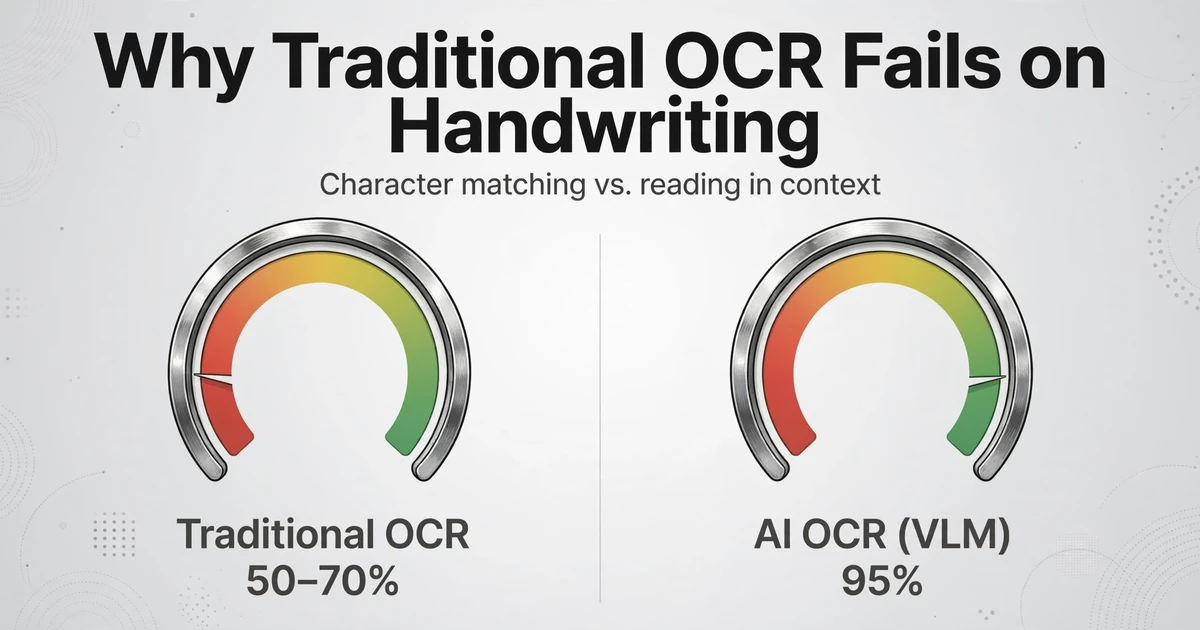
Handschrift. Traditionelle OCR basiert auf dem Abgleich von Zeichenformen. Eine „4“, die wie eine „9“ aussieht, ein kursives „r“, das mit dem nächsten Buchstaben verbunden ist, eine handgeschriebene „7“ mit Querbalken, die die Engine als separates Zeichen liest – jeder dieser Fälle ist ein vorhersehbarer Fehler. Unabhängige Benchmarks zu Google Cloud Vision, AWS Textract und Azure Document Intelligence zeigen für diese Systeme eine Handschriftgenauigkeit zwischen 50 % und 70 %. GPT-5, ein Vision-Language-Model, erreicht bei derselben Aufgabe 95 %, indem es Wörter im Kontext liest – Zeichen werden anhand dessen unterschieden, was in einem Satz Sinn ergibt, nicht nur anhand der Form.
Mehrspaltige Layouts. Traditionelle OCR liest von links nach rechts, von oben nach unten. Eine zweispaltige Rechnung – Lieferantendaten links, Positionen rechts auf halber Höhe der Seite, ein Summenfeld in der unteren Ecke – wird zu einem einzigen durcheinandergeworfenen Textstrom. Die Engine hat kein Konzept von räumlichen Grenzen jenseits ihres Koordinatengitters. Eine Microsoft-Q&A-Analyse von 2025 zu Fehlern traditioneller OCR in Geschäftsdokumenten identifizierte mehrspaltige Layouts als eine der häufigsten Ursachen dafür, dass Daten im falschen Feld landen, wobei „ganze Zeilen übersprungen“ ein häufiges Folgeproblem war.
Kontrollkästchen, Stempel und überlagerte Elemente. Ein „PAID“-Stempel, der über einer Rechnungsposition liegt, macht den darunterliegenden Text für traditionelle OCR unsichtbar. Ein Versicherungsformular mit Kontrollkästchen für „Ja / Nein“-Optionen wird als zufällige Zeichen in der Nähe geometrischer Formen gelesen. Ein Kontoauszug mit einem Logo, das die Kontonummer überlagert – die Engine sieht Rauschen, keine Daten. Das sind keine Randfälle. Ein einzelner fehlender Kontrollkästchenwert auf einem COI-Formular kann eine gesamte Compliance-Freigabe zum Stillstand bringen.
Geringer Kontrast und verschlechterte Scans. Thermopapierbelege verblassen. Handyfotos von Dokumenten erzeugen Schatten und Winkelverzerrungen. Gefaxte Bestellungen kommen mit Komprimierungsartefakten an, die Zeichen in Fragmente zerlegen. Traditionelle OCR-Engines verschlechtern sich stark unter 200 DPI oder bei ungleichmäßiger Beleuchtung. KI-Vision-Modelle, die mit Milliarden realer Bilder trainiert wurden, bewältigen diese Bedingungen, indem sie den visuellen Kontext interpretieren – ein verschmiertes Zeichen an einer bekannten Feldposition wird aus dem abgeleitet, was das Feld enthalten soll, nicht nur aus dem, was die Pixel zeigen.
Template-Drift. Das sind die stillen Kosten. Ein Lieferant gestaltet sein Rechnungslayout um – die Bestellnummer wandert von oben rechts unter die Lieferadresse. Die Vorlage der traditionellen OCR, die immer noch auf die alten Koordinaten schaut, extrahiert eine Straßenadresse und kennzeichnet sie als Bestellnummer. Kein Fehlerflag wird ausgelöst, weil das Feld gefunden wurde. Die Daten fließen in Ihr ERP, und die Abweichung wird entdeckt, wenn jemand Wochen später die Zahlung abgleicht. Template-Drift ist kein Fehler – es ist das erwartete Verhalten jedes Systems, das feste Koordinaten statt semantischem Verständnis verwendet.
Wie KI-OCR anders liest: Die ganze Seite, nicht einzelne Zeichen
KI-gestützte OCR – genauer gesagt Extraktion mittels Vision-Language-Modell (VLM) – verarbeitet ein Dokument wie ein Mensch: Sie erfasst die gesamte Seite auf einmal und versteht, was jede Region, Bezeichnung und jeder Wert bedeutet. Die zugrundeliegende Technologie ist ein multimodales KI-Modell, das mit Milliarden von Bild-Text-Paaren trainiert wurde. Wenn Sie ihm einen gescannten Lieferschein geben, scannt es nicht von links nach rechts nach Zeichenformen. Es identifiziert den Dokumenttyp, analysiert das räumliche Layout, liest den Text im Kontext und ordnet jeden Wert dem richtigen Datenfeld zu – basierend auf der Bedeutung, nicht der Position.
Der entscheidende Unterschied lässt sich am besten an einem konkreten Beispiel veranschaulichen. Betrachten Sie drei Textstrings auf einer Rechnung:
"Datum: 15.03.2026"
Herkömmliche OCR sieht: sechs Zeichen "Datum", gefolgt von zehn Zeichen "15.03.2026". Sie weiß nicht, ob dies das Ausstellungsdatum, das Fälligkeitsdatum oder das Versanddatum ist.
"Fällig am: 14.04.2026"
Herkömmliche OCR sieht: zwei weitere Wörter und zehn weitere Zeichen. Sie kann dies nicht mit "Datum" oben verknüpfen oder eines vom anderen unterscheiden. Beide sind nur Textstrings mit einem Datumsformat.
"Rechnungsdatum: 15.03.2026"
Herkömmliche OCR sieht: zwei weitere Wörter, gleiches Datum. Für die Engine ist dies ein dritter Textstring – ohne Bezug zu den ersten beiden. Es wird keine semantische Verbindung hergestellt.
KI-OCR sieht drei verschiedene Datenfelder. Sie liest die Bezeichnungen ("Datum", "Fällig am", "Rechnungsdatum"), versteht, was jede im Kontext einer Rechnung bedeutet, und setzt jeden Wert in die richtige Spalte Ihrer Tabelle. Das Rechnungsdatum kommt in die Spalte Rechnungsdatum. Das Fälligkeitsdatum kommt in die Spalte Fälligkeitsdatum. Selbst wenn "Rechnungsdatum" in der Kopfzeile, "Fällig am" im Zahlungsbedingungen-Abschnitt und ein bloßes "Datum" in einer Positionszeile steht – das Modell unterscheidet anhand des umgebenden Kontexts, nicht der Pixelposition.
Dieses semantische Verständnis macht die KI-Extraktion ohne Vorlage möglich – und genau das unterscheidet moderne Software zur Datenextraktion von traditionellen OCR-Tools. Sie müssen keine Pixelkoordinaten für „Rechnungsnummer“ auf jedem Lieferantenlayout definieren. Sie geben die gewünschten Spaltennamen ein – „Rechnungsnummer“, „Fälligkeitsdatum“, „Lieferantenname“, „Positionssumme“ – und die KI findet jeden Wert an beliebiger Stelle auf der Seite, indem sie dessen Bedeutung versteht. Die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen Ihrer finalen Tabelle. Dieser Mechanismus wird Benutzerdefinierte Spaltenextraktion genannt: Sie beschreiben das Ausgabeschema, und die KI ordnet den Inhalt des Dokuments Ihren Spalten zu – unabhängig davon, wo der Lieferant jedes Feld platziert hat.
Dateien werden sicher verarbeitet und nicht gespeichert.
Die Demo oben zeigt dies anhand einer Rechnung – geben Sie einen beliebigen Spaltennamen ein und beobachten Sie, wie die KI den Wert findet, egal wo er auf der Seite steht. Probieren Sie „Rechnungsnummer“, „Fälligkeitsdatum“ oder „Lieferantenname“. Derselbe Mechanismus funktioniert identisch bei Kontoauszügen, Bestellungen, Belegen und jedem Dokument, in dem Informationen in einem visuellen Layout und nicht in einem Datenbankfeld vorliegen.
Wo klassische OCR noch die Nase vorn hat – und warum das wichtig ist
Ein Vergleich, der nur die Vorteile von KI hervorhebt, ist ein Verkaufsgespräch, keine Analyse. Klassische OCR hat echte Stärken, die sie in bestimmten Szenarien zur richtigen Wahl machen. Diese anzuerkennen, verleiht dem KI-Argument Glaubwürdigkeit, wenn es zutrifft.
Standardisierte Dokumente in großem Maßstab. Wenn Sie jährlich eine Million W-2-Steuerformulare verarbeiten – identisches Layout, saubere Maschinenschrift, vorhersehbare Felder – liefert klassische OCR mit einer einzigen gut gepflegten Vorlage nahezu perfekte Genauigkeit zu einem Bruchteil der Kosten pro Dokument eines KI-Extraktionstools. Die Vorlageneinrichtung ist eine einmalige Investition, die sich über Millionen identischer Dokumente amortisiert. Bei diesem Maßstab spart ein OCR-API-Aufruf von 0,01 $ pro Seite gegenüber einem VLM-Extraktionsaufruf von 0,05 $ 40.000 $ pro Million Seiten.
Saubere, einfache Dokumente ohne Abweichungen. Ein einseitiges Textdokument – ein getippter Brief, eine einfache Notiz, ein übersichtlicher Kontoauszug mit einheitlicher Formatierung – ist für klassische OCR ein gelöstes Problem. Tesseract und ähnliche Engines verarbeiten diese mit über 99 % Genauigkeit und Verarbeitungszeiten unter einer Sekunde. Eine KI-Schicht hinzuzufügen, erhöht die Kosten, ohne einen Mehrwert zu schaffen.
Budgetbeschränkte Umgebungen mit homogenem Input. Eine Organisation, die nur ein Rechnungsformat von einem Lieferanten erhält, ohne Abweichungen und ohne Komplexität, benötigt möglicherweise keine KI-Extraktion. Open-Source-OCR ist kostenlos. Der Arbeitsaufwand für die Erstellung einer einzigen Vorlage für ein einziges Layout ist ein einmaliger Zeitaufwand von wenigen Stunden. In diesem engen Szenario sind die zusätzlichen Abonnementkosten eines KI-Tools schwer zu rechtfertigen.
Archivische Textdigitalisierung für die Suche. Wenn das Ziel die Volltextsuche ist – die Durchsuchbarkeit eines Korpus historischer Dokumente nach Stichwörtern – und nicht die strukturierte Datenextraktion, ist klassische OCR die effiziente Wahl. Sie müssen nicht wissen, welcher Text ein Datum und welcher ein Name ist. Sie müssen wissen, welcher Text auf der Seite steht. Genau das leistet klassische OCR, und das in großem Maßstab.
Der Wendepunkt: Wenn Fehlerkorrekturkosten die Abonnementkosten übersteigen
Die wirtschaftliche Entscheidung zwischen traditioneller OCR und KI-Extraktion hängt von drei Variablen ab: Dokumentvielfalt, Dokumentkomplexität und Verarbeitungsvolumen. Bei geringer Vielfalt und Komplexität und sehr hohem Volumen ist die traditionelle OCR kostengünstiger. Steigen Vielfalt oder Komplexität über eine Schwelle, kippt die Rechnung.
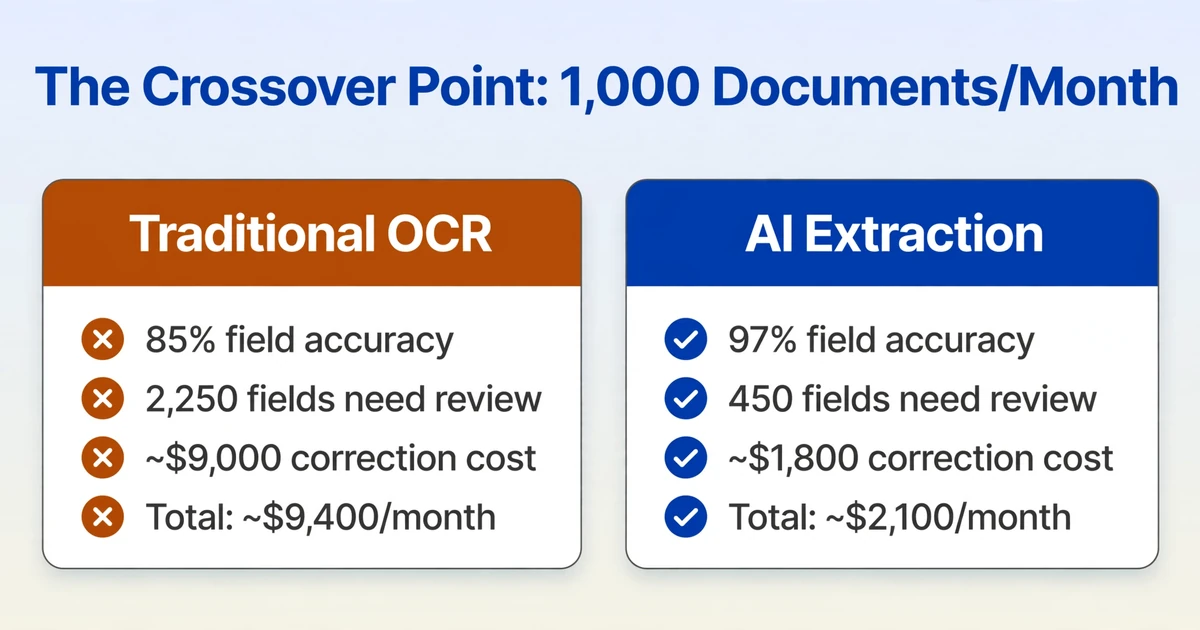
Hier ist die Wendepunkt-Arithmetik in praktischem Maßstab. Angenommen, ein Team verarbeitet 1.000 Dokumente pro Monat. Jedes Dokument enthält 15 Felder, die extrahiert werden müssen. Die Ausgangslage:
| Szenario | Feldgenauigkeit | Zu prüfende Felder / Monat | Korrekturkosten* | Toolkosten | Monatliche Gesamtkosten |
|---|---|---|---|---|---|
| Traditionelle OCR (Vorlagen) | 85 % (unterschiedliche Rechnungen) | 2.250 Felder | ~9.000 $ | 200–500 $ | ~9.400 $ |
| KI-Extraktion | 97 % (unterschiedliche Rechnungen) | 450 Felder | ~1.800 $ | 50–300 $ | ~2.100 $ |
* Geschätzt mit 4 $ pro Feldkorrektur (Prüfung, Nachschlagen, erneute Eingabe). Quelle: Analyse der Dateneingabefehlerkosten (2026). Die tatsächlichen Arbeitskosten variieren je nach Region und Rolle.
Bei 1.000 Dokumenten pro Monat mit je 15 Feldern und moderaten Layoutabweichungen bedeutet der Genauigkeitsunterschied von 12 Prozentpunkten zwischen 85 % und 97 %: 1.800 Felder weniger, die manuell geprüft werden müssen – also rund 7.200 $ pro Monat an vermeidbaren Korrekturkosten. Der genaue Wendepunkt verschiebt sich mit Volumen und Dokumentkomplexität, aber das Muster ist konsistent: Sinkt die Feldgenauigkeit unter 90 %, übersteigen die Kosten für die Fehlerkorrektur die Kosten des Tools bei Weitem.
Eine zweite Dimension des Wendepunkts ist die Vorlagenwartung. Wenn ein Team Vorlagen für 50 verschiedene Lieferantenlayouts pflegt und jeder Lieferant sein Layout alle 12 bis 18 Monate ändert, baut das Team ständig Vorlagen neu. Eine einzelne Vorlage benötigt 30–60 Minuten zur Einrichtung. Wenn drei Lieferanten ihr Rechnungsformat monatlich aktualisieren, sind das 1,5–3 Stunden Vorlagenarbeit – jeden Monat, auf unbestimmte Zeit. Die KI-Extraktion eliminiert dies vollständig, da sie nach Bedeutung liest und nicht nach Koordinaten.
Die dritte Dimension sind die Fehler, die herkömmliche OCR gar nicht erkennt. Die vorlagenbasierte Extraktion meldet nicht, wenn ein Wert falsch ist – sie meldet nur, wenn ein Wert an der erwarteten Koordinate fehlt. Eine Bestellnummer, die aufgrund einer verschobenen Vorlage von der falschen Position extrahiert wird, ist kein „Fehler", den das System erkennt. Es sind Daten, die in Ihr ERP fließen und Wochen später ein Abstimmungsproblem verursachen. Diese unentdeckten Fehler sind die teuersten – die durchschnittlichen Kosten für die Korrektur eines nach der Verarbeitung entdeckten Dateneingabefehlers betragen 50–500 $, gegenüber 3–5 $ für einen während der Prüfung entdeckten Fehler. Vorlagendrift erzeugt die teure Sorte in großem Stil.
Was sich nach der Umstellung ändert: Ein direkter Vergleich
Abstrakte Zahlen sind für Entscheidungen hilfreich. Konkrete Beispiele helfen zu verstehen, was die Zahlen in der Praxis bedeuten. Hier dieselbe Rechnungspartie, zwei Verarbeitungsansätze, Seite an Seite:
| Dimension | Herkömmliche OCR (vorlagenbasiert) | KI-Extraktion |
|---|---|---|
| Einrichtung für 20 Lieferanten | 20 Vorlagen × 30 Min. = 10 Stunden | Spaltennamen einmal definieren = 2 Minuten |
| Lieferant 21 kommt hinzu | Neue Vorlage erstellen = 30 Minuten | Keine Änderung. Gleiche Spalten funktionieren bei jedem Layout. |
| Lieferant 5 ändert Layout | Daten werden stillschweigend fehlgeleitet. Entdeckt beim Abgleich. | Felder werden anhand der semantischen Bedeutung erkannt. Layoutänderung ist unsichtbar. |
| Handschriftliche Notiz auf Rechnung | Nicht lesbar. Feld bleibt leer oder wird mit Zeichensalat gefüllt. | Im Kontext gelesen. Handschriftliches „Eilig" neben „Priorität:" wird zum Wert. |
| Handyfoto einer Quittung | Winkelverzerrung + geringer Kontrast = unbrauchbare Ausgabe | Visueller Kontext gleicht aus. Verblasster Thermodruck bleibt lesbar. |
| Kontrollkästchen im Formular | Zufällige Zeichen neben einem Kästchen. Manuelle Prüfung erforderlich. | Erkennt angehakte Option durch visuelle Hervorhebung. „Ja" oder „Nein" extrahiert. |
| 50 Rechnungen, 15 Lieferanten, 1 Ausgabe | Jeden Lieferanten durch seine Vorlage laufen lassen. Ausgaben zusammenführen. Abweichungen korrigieren. | Alle 50 hochladen. Spaltennamen einmal definieren. Konsolidierte Excel herunterladen. |
Die aufschlussreichste Zeile ist „Anbieter 5 gestaltet Layout um.“ In der traditionellen OCR-Spalte ist der Fehler unsichtbar – die Vorlage findet Text an den erwarteten Koordinaten und gibt ihn zurück, unabhängig davon, ob es der richtige Text ist. In der KI-Spalte ist die Layoutänderung irrelevant, da die Extraktion auf der Bedeutung des Textes basiert, nicht auf seiner Position. Dieser eine Unterschied – stille Vorlagenabweichung versus layoutresistente Extraktion – verursacht mehr nachgelagerte Abstimmungskosten als jeder andere Faktor.
Der hybride Ansatz ist für Teams zu empfehlen, die eine Mischung von Dokumenttypen verarbeiten. Viele Organisationen, die Dokumentextraktion in großem Maßstab betreiben – wie in Reddit-Communities wie r/mlops und r/fintech beobachtet – betreiben mehrschichtige Pipelines: traditionelle OCR für die standardisierten Dokumenttypen mit hohem Volumen, bei denen Vorlagen zuverlässig funktionieren, und KI-Extraktion für die variablen, komplexen oder handschriftlichen Dokumente, bei denen die Kosten für die Vorlagenpflege die Alternative übersteigen. Die Routing-Logik ist einfach: Wenn ein Dokument mit hoher Sicherheit einer bekannten Vorlage entspricht, wird es per OCR verarbeitet. Wenn nicht oder wenn die Sicherheit unter einen Schwellenwert fällt, wird es zur KI-Extraktion weitergeleitet. So wird der Kostenvorteil der traditionellen OCR dort genutzt, wo er zutrifft, während die Fehlerkorrektur-Strafe dort vermieden wird, wo sie nicht zutrifft.
FAQ
Kann ich einfach ChatGPT oder Claude verwenden, um Daten aus meinen Dokumenten zu extrahieren?
Für ein einzelnes Dokument – ja, GPT-5 erreicht 95 % Genauigkeit bei Handschrift und verarbeitet gemischte Formate gut. Aber Allzweck-Chatbots sind nicht für die Stapelverarbeitung ausgelegt: 50 Rechnungen hochladen und eine konsolidierte Tabelle mit einheitlichen Spalten über alle Dokumente hinweg erhalten. Jedes Dokument ist eine separate Unterhaltung, Spaltennamen müssen jedes Mal neu angegeben werden, und es gibt keinen integrierten Mechanismus, um Ausgaben in einer einzigen strukturierten Datei zusammenzuführen. Für einmalige Extraktionen funktionieren Chatbots. Für die wiederkehrende Dokumentenverarbeitung in großem Umfang erledigen speziell entwickelte Extraktionstools die Stapelverarbeitung, Schema-Konsistenz und den Export-Workflow, für den Chatbots nie ausgelegt waren.
Wie hoch ist der tatsächliche Kostenvorteil pro Dokument zwischen traditioneller OCR und KI-Extraktion?
Traditionelle OCR kostet im Massenbetrieb (API-Preise von Cloud-Anbietern) etwa 0,01–0,05 $ pro Seite. KI-Extraktion kostet etwa 0,05–0,30 $ pro Seite. Der reine Softwarekostenunterschied beträgt ungefähr das 3- bis 10-Fache. Doch die Gesamtbetriebskosten – einschließlich Korrekturarbeit, Vorlagenpflege und Folgekosten durch Fehler – kehren den Vergleich für jeden Workflow um, der mehr als etwa 200 unterschiedliche Dokumente pro Monat verarbeitet. Der Vergleich von kostenloser OCR gegenüber kostenpflichtiger KI-Extraktion deckt die vollständige TCO-Aufschlüsselung ab.
Funktioniert KI-OCR bei handschriftlichen Dokumenten?
Ja, und der Unterschied ist hier größer als bei gedrucktem Text. Traditionelle OCR-Engines erreichen bei Handschrift eine Genauigkeit von 50–70 %. Vision-Language-Modelle erreichen bei denselben Dokumenten 85–95 %, indem sie Kontextwissen nutzen – das Modell weiß, wie ein Datum in einem bestimmten Feld aussehen sollte, und verwendet dieses Wissen, um unklare Zeichen zu unterscheiden. Bei Schreibschrift vergrößert sich der Unterschied weiter: Traditionelle OCR fällt unter 50 %, während die VLM-basierte Extraktion 75–85 % beibehält. Die Einschränkungen sind real – sehr unleserliche Schreibschrift, nicht-lateinische Schriften mit begrenzten Trainingsdaten und Handschrift in extremen Winkeln fordern weiterhin alle Systeme heraus – aber der relative Vorteil der KI-Extraktion bei Handschrift ist über alle Dokumenttypen hinweg am größten.
Ab welchem Dokumentvolumen wird KI-Extraktion kosteneffektiv?
Der Wendepunkt hängt mehr von der Dokumentvielfalt als vom reinen Volumen ab. Ein Team, das 100 Dokumente pro Monat von 3 Anbietern mit festen Layouts verarbeitet, erreicht möglicherweise nie den Wendepunkt. Ein Team, das 200 Dokumente pro Monat von 20 Anbietern mit unterschiedlichen Layouts verarbeitet, überschreitet ihn sofort – allein die Vorlagenpflege verbraucht mehr Arbeitsstunden als die KI-Abonnementkosten. Als Faustregel gilt: Wenn Sie Vorlagen für mehr als 10 verschiedene Dokumentlayouts pflegen, haben Sie den Wendepunkt bereits überschritten. Siehe die Preisübersicht für KI-Dokumentextraktion 2026 für aktuelle Toolkosten auf jeder Volumenstufe.
Welche Genauigkeit kann ich bei der KI-Extraktion in der Produktion erwarten?
Eine Feldgenauigkeit von 95–97 % bei unterschiedlichen Geschäftsdokumenten ist eine realistische Produktionserwartung auf Basis aktueller VLM (Vision-Language-Model)-Benchmarks. Bei sauberen, standardisierten Dokumenten werden 98–99 % erreicht. Bei stark beschädigten Dokumenten — Faxen, Thermo-Belegen, Dokumenten mit überlagerten Stempeln — sind 85–93 % zu erwarten. Der entscheidende Unterschied liegt zwischen Zeichengenauigkeit und Feldgenauigkeit: Ein Tool, das 99 % Zeichengenauigkeit angibt, kann nur 80 % Feldgenauigkeit liefern, wenn die falsch erkannten Zeichen auf kritische Datenpunkte fallen. Messen Sie die Genauigkeit immer auf Feldebene — den Prozentsatz der Felder, die in der richtigen Spalte mit dem richtigen Wert gelandet sind. Für einen tieferen Einblick, was Genauigkeitszahlen im Verarbeitungsmaßstab bedeuten, siehe den praktischen Leitfaden zur KI-Extraktionsgenauigkeit.
Hat die traditionelle OCR noch eine Zukunft?
Ja, in drei Rollen. Erstens als Texterkennungsschicht innerhalb von KI-Extraktionspipelines — viele VLM-basierte Systeme nutzen OCR weiterhin als Vorverarbeitungsschritt für textlastige Dokumente. Zweitens für die Verarbeitung standardisierter Dokumente mit hohem Volumen, bei denen sich Vorlagenkosten effizient amortisieren. Drittens für Archivierungs-Digitalisierungsprojekte, bei denen das Ziel die Volltextsuche und nicht die strukturierte Datenextraktion ist. Die traditionelle OCR ist nicht veraltet — ihre Rolle schrumpft auf die spezifischen Anwendungsfälle, in denen ihre architektonischen Annahmen (feste Layouts, sauberer Text, zeichenbasierte Ausgabe) zu den tatsächlichen Dokumenteigenschaften passen.
Wo Sie anfangen sollten
Die Kluft zwischen traditioneller OCR und KI-Extraktion wird nicht kleiner. Vision-Language-Modelle verbessern sich weiterhin bei komplexen Dokumenten — GPT-5s 95 % Handschriftgenauigkeit im Jahr 2026 gegenüber GPT-4s 85 % im Jahr 2025 — während traditionelle OCR-Engines seit Jahrzehnten denselben Zeichenabgleichsansatz verfeinern. Die Genauigkeitslücke ist jetzt eine Kostenlücke, und sie zeigt sich in jeder manuellen Prüfwarteschlange, jedem Vorlagen-Neuaufbau und jedem Abstimmungsproblem, das auf stillschweigend falsch weitergeleitete Daten zurückzuführen ist.
Es gibt einen unkomplizierten Weg, um zu sehen, auf welcher Seite des Wendepunkts Ihre Dokumente liegen. Laden Sie eine Rechnung hoch — idealerweise eine, die Ihrem aktuellen Prozess Probleme bereitet hat — in ein KI-Extraktionstool ohne Vorlage. Geben Sie die benötigten Feldnamen ein und beobachten Sie, wo die Werte landen. Für mehr darüber, wie sich KI-Extraktion von OCR auf Datenebene statt auf Zeichenebene unterscheidet, führt der Erklärartikel zu KI-Dateneingabe versus OCR durch den Ausgabeunterschied mit realen Beispielen. Die Kosten für diesen Test betragen ein paar Minuten. Die Kosten, nicht zu wissen, wo Ihre Genauigkeit tatsächlich steht, summieren sich jeden Monat.