Was ist AI OCR?
Wie KI die traditionelle Zeichenerkennung transformiert
AI OCR — KI-gestützte optische Zeichenerkennung — ist eine Technologie, die Vision-Language-Modelle nutzt, um ganze Dokumente zu lesen und zu verstehen, nicht nur einzelne Zeichen, und die strukturierte Daten extrahiert, indem sie Layout, Kontext und Bedeutung erfasst. Das ist kein herkömmliches OCR mit einem Machine-Learning-Anstrich. Die zugrunde liegende Architektur ist grundlegend anders: Statt Pixelmuster mit einer Zeichendatenbank zu vergleichen, liest AI OCR eine Seite so, wie es ein menschlicher Leser tun würde — visuell, ganzheitlich, semantisch. Es weiß, dass eine Zahl unter „Gesamtbetrag" ein Rechnungsgesamtbetrag ist und dass „05/15/2026" ein Fälligkeitsdatum ist, keine Menge.
Wichtigste Erkenntnisse
- AI OCR ist keine bessere OCR-Engine — es ist eine völlig eigene Technologiekategorie, die die Bedeutung von Dokumenten liest, statt Zeichenformen einzeln abzugleichen.
- Der Unterschied zwischen herkömmlichem OCR und AI OCR lässt sich nicht allein in Genauigkeitspunkten messen — das eine sagt Ihnen, welche Zeichen auf einer Seite sind, das andere, welche Daten das Dokument enthält.
- Wenn jeder extrahierte Wert bereits sein eigenes Feldlabel trägt, entfällt der manuelle Schritt, undifferenzierten Text in Tabellenspalten zu sortieren, und die Dateneingabe wird zu einer schnellen Prüfung.
Was AI OCR wirklich ist — und was nicht
AI OCR ist keine bessere Version des OCR, das Sie bereits kennen. Es ist eine völlig andere Technologiekategorie. Herkömmliches OCR und AI OCR teilen sich einen Ausgangspunkt — beide nehmen ein Textbild auf und erzeugen digitale Ausgabe —, aber sie unterscheiden sich grundlegend darin, wie sie dorthin gelangen und was sie liefern können.
Herkömmliches OCR ist eine Mustererkennungs-Technologie. Es arbeitet bottom-up: Es scannt das Bild, erkennt Regionen, die wie Text aussehen, vergleicht jede Zeichenform mit einer Bibliothek bekannter Glyphen und gibt die erkannten Zeichen in Lesereihenfolge aus. Die Engine hat kein Verständnis dafür, was der Text bedeutet. Sie liest Formen, nicht Inhalt. Fragen Sie eine herkömmliche OCR-Engine, eine Rechnung zu verarbeiten, und sie wird Ihnen sagen, dass die Seite die Zeichen „$1.234,56" enthält — aber sie kann Ihnen nicht sagen, ob das der fällige Gesamtbetrag, eine Positionssumme, die Steuer oder eine Referenznummer ist. Jedes Feld ist nur eine weitere Zeichenfolge ohne semantisches Gewicht.
AI OCR ersetzt diese gesamte Pipeline durch ein Vision-Language-Modell (VLM) — ein neuronales Netzwerk, das auf Millionen von Dokumentbildern und deren entsprechenden Texten, Layouts und Strukturen trainiert wurde. Statt Zeichen einzeln zu erkennen, verarbeitet das VLM die gesamte Seite als visuelle Szene. Es identifiziert den Kopfbereich, die Positionstabelle, den Summenbereich, die Fußzeile. Es versteht, dass die Zahl in der unteren rechten Zelle sich von der Zahl in der oberen linken Zelle unterscheidet, selbst wenn beide die Ziffern „1.234,56" enthalten. Es liest nach Bedeutung, nicht nach Pixelkoordinaten.
Der Begriff „AI OCR" selbst ist irreführend — er suggeriert, dass es sich um OCR mit hinzugefügter KI handelt, wie Streusel auf einem Cupcake. In Wirklichkeit ist AI OCR näher am Dokumentlesen als an der Zeichenerkennung. Der Teil „OCR" beschreibt die Eingabe (Textbilder), nicht die Methode.
Diese Unterscheidung ist wichtig, weil sie verändert, was Sie von dem Tool erwarten können. Herkömmliches OCR liefert Ihnen eine digitale Kopie des Textes. AI OCR liefert Ihnen ein strukturiertes Verständnis des Dokuments. Das sind zwei unterschiedliche Ergebnisse, die zwei unterschiedliche Bedürfnisse erfüllen. Für einen tieferen Einblick in das, was herkömmliches OCR tatsächlich tut und wo seine Grenzen liegen, lesen Sie unseren Leitfaden zu was OCR ist und wie es funktioniert.
Herkömmliches OCR beantwortet die Frage „Welche Zeichen sind auf dieser Seite?" AI OCR beantwortet die Frage „Welche Daten enthält dieses Dokument?" Der Abstand zwischen diesen beiden Fragen ist die Lücke zwischen einer Textdatei und einer Tabellenkalkulation.
Der Unterschied, der alles verändert
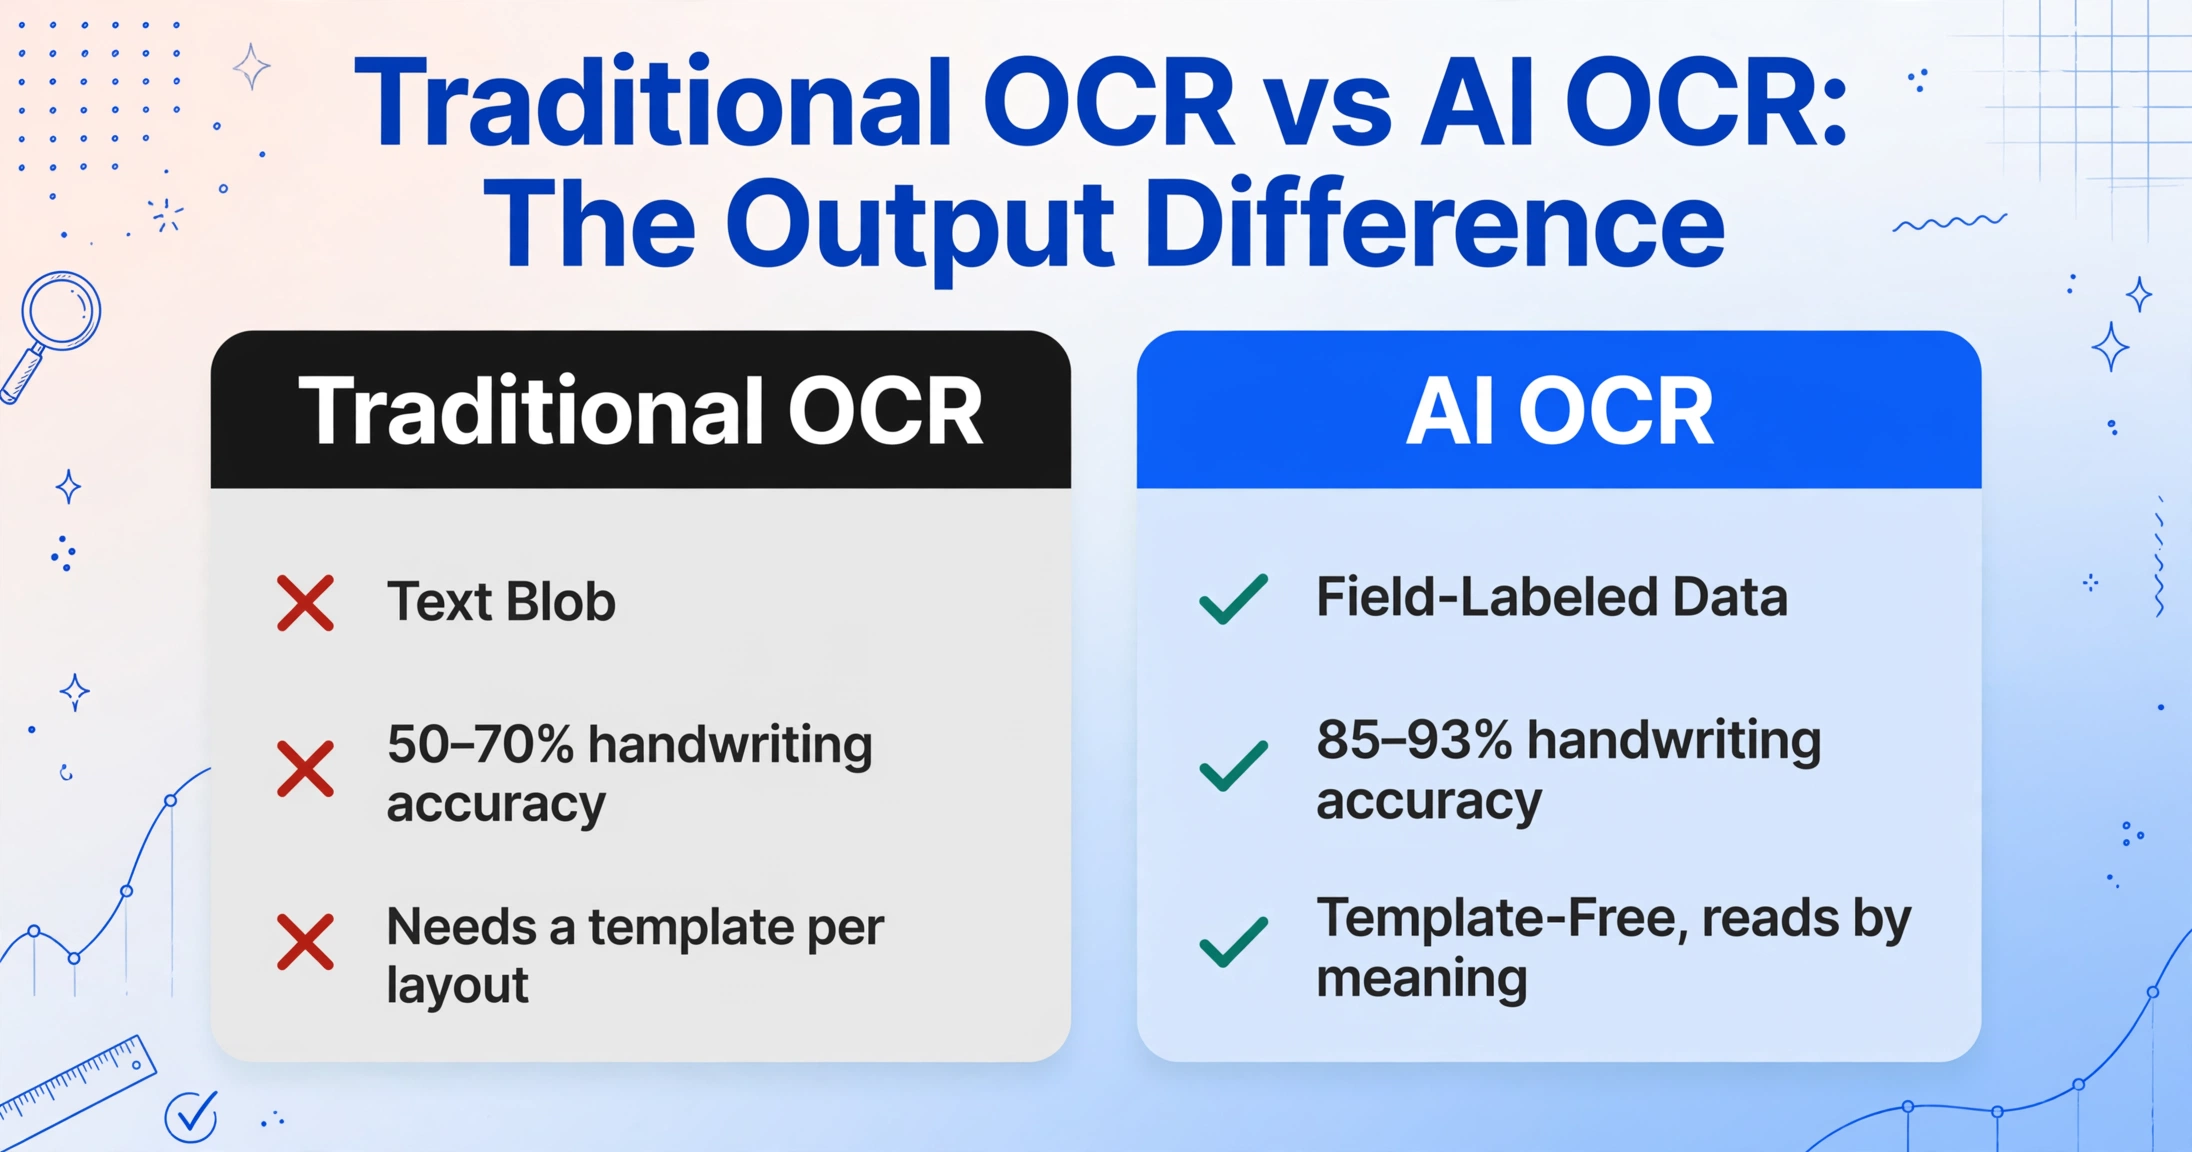
Der Unterschied zwischen herkömmlichem OCR und AI OCR ist keine Frage des Grades – es ist ein Unterschied der Art. So vergleichen sich die beiden Technologien in den Dimensionen, die tatsächlich zählen, wenn Sie echte Geschäftsdokumente verarbeiten:
| Dimension | Herkömmliches OCR | AI OCR |
|---|---|---|
| Kernmethode | Zeichenweise Mustererkennung gegen eine Glyphendatenbank | Ganzheitliches Seitenlesen mit Vision-Language-Modellen |
| Ausgabe | Undifferenzierter Textstring in Lesereihenfolge | Strukturierte Daten mit Feldbeschriftungen (Rechnungsnummer, Fälligkeitsdatum, Gesamtbetrag) |
| Handhabt Layoutänderungen | Nein – jedes Format erfordert eine neue Vorlage | Ja – liest nach Bedeutung, nicht nach Position |
| Handhabt Handschrift | Schwach (~50-70 % Feldgenauigkeit) | Gut (~85-93 % mit modernen VLMs) |
| Tabellenverständnis | Verliert Zeilen-/Spaltenbeziehungen | Bewahrt Tabellenstruktur mit Kopfzeilen |
| Einrichtungszeit | Tage bis Wochen pro Dokumentvorlage | Minuten – keine Vorlagen oder Schulung erforderlich |
Die Zeile, die in der Praxis am wichtigsten ist, ist die zweite: Ausgabe. Wenn Sie eine gescannte Rechnung durch herkömmliches OCR laufen lassen, erhalten Sie einen Textblock, den Sie immer noch lesen, interpretieren und in die richtigen Zellen Ihrer Tabellenkalkulation oder Buchhaltungssoftware kopieren müssen. Das ist keine Dateneingabeautomatisierung – es ist Digitalisierung mit einem manuellen Sortierschritt. AI OCR eliminiert diesen Sortierschritt, weil es bereits beschriftete Daten ausgibt. Die „Rechnungsnummer" landet in der Rechnungsnummernspalte, weil das Modell verstanden hat, dass es eine Rechnungsnummer ist.
Diese Verschiebung – von undifferenziertem Text zu feldbeschrifteten Daten – ist es, die OCR von einem Scan-Hilfsmittel in einen echten Ersatz für die Dateneingabe verwandelt. Für spezifische Genauigkeits-Benchmarks nach Dokumenttyp finden Sie unseren detaillierten Vergleich zur Genauigkeit von AI OCR vs. herkömmlichem OCR.
Wie AI OCR Dokumente liest
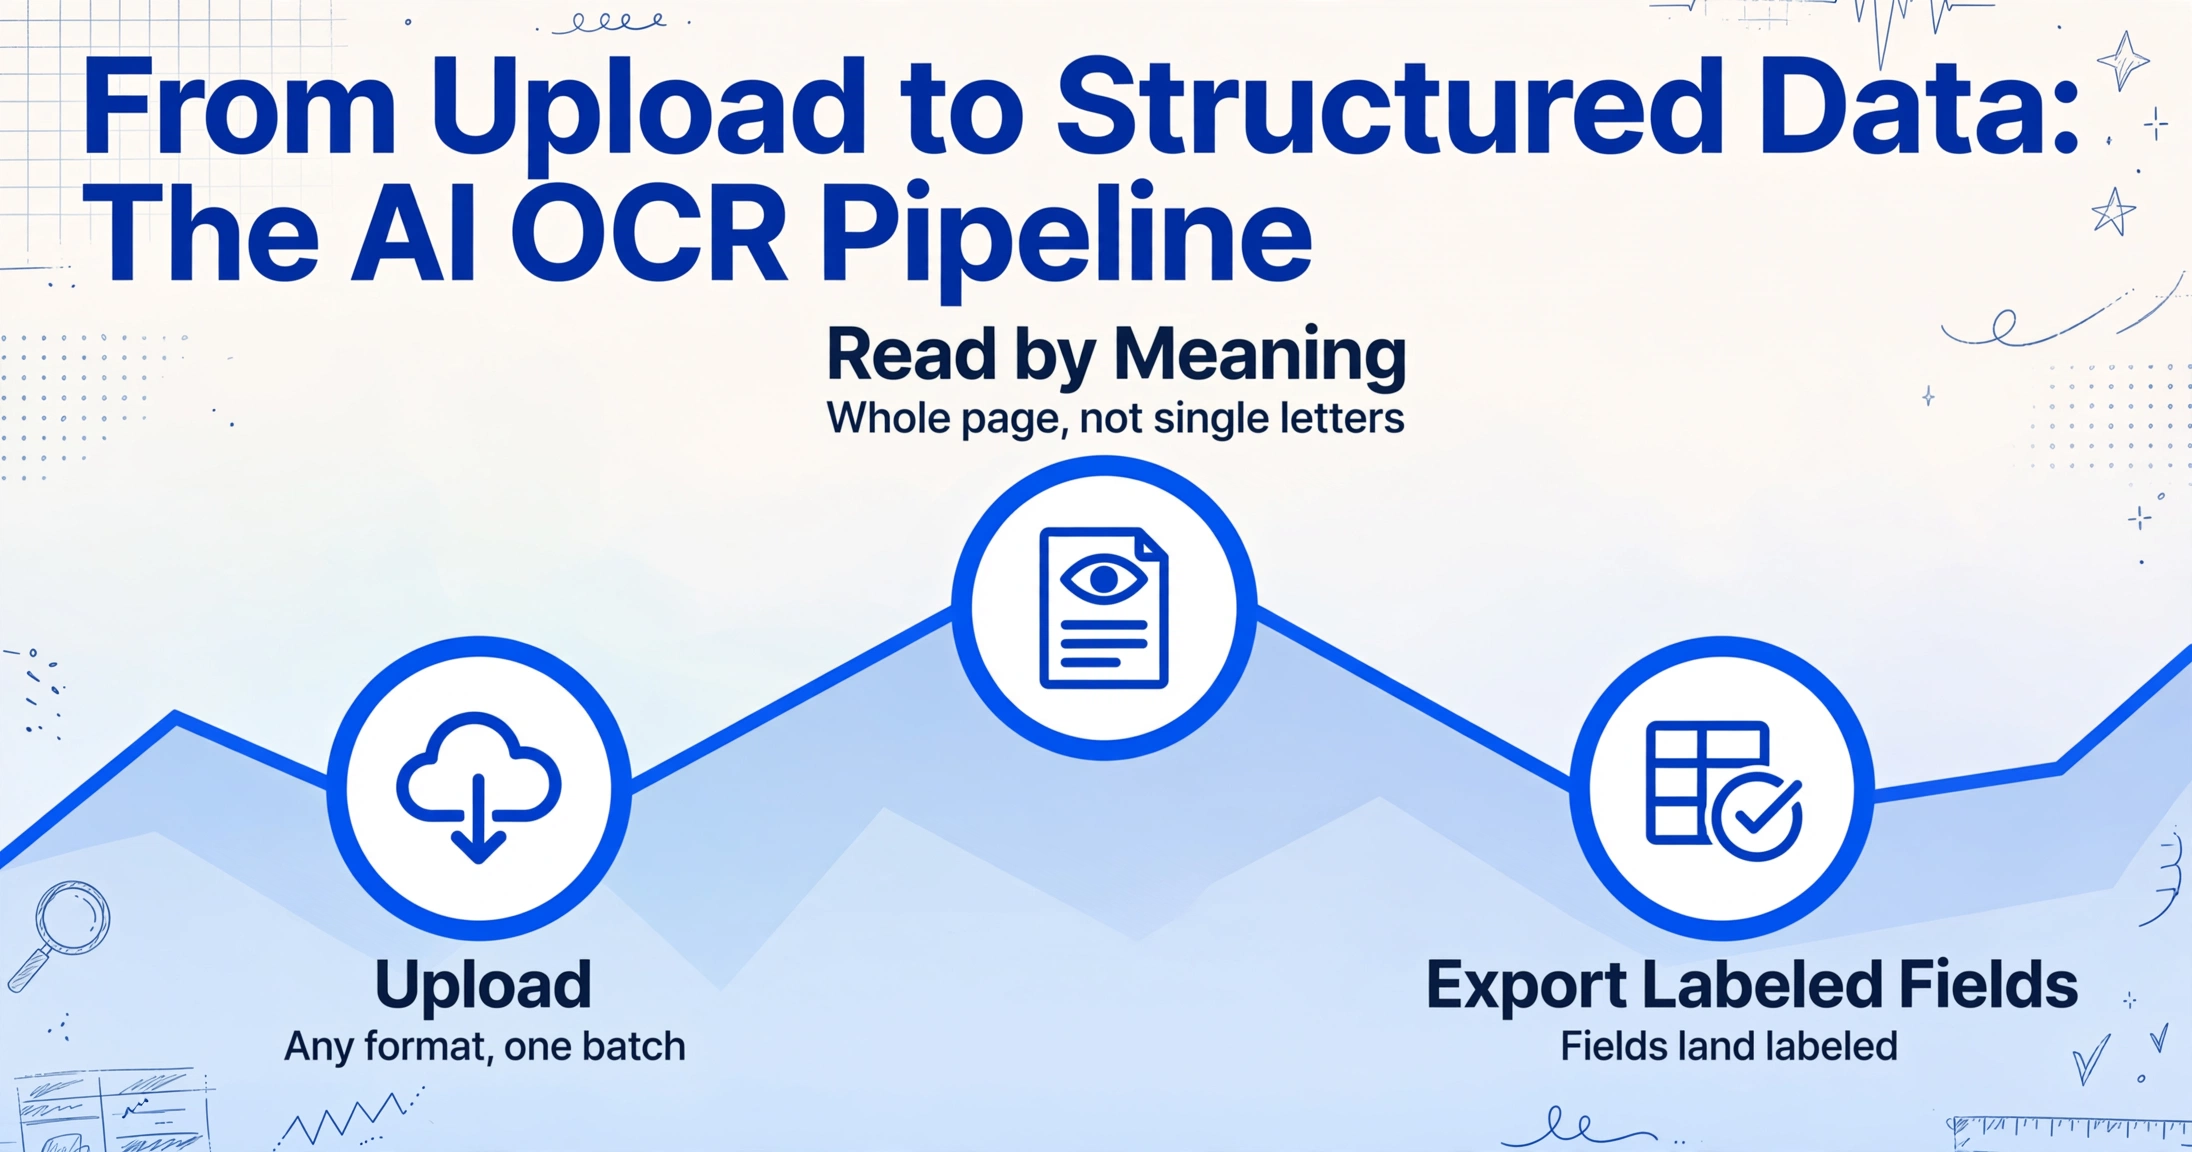
Um zu verstehen, wie AI OCR funktioniert, vergessen Sie alles, was Sie über Zeichenerkennung wissen. Der Ansatz ist ein völlig anderer.
Herkömmliches OCR verarbeitet ein Dokument wie ein Fließband einzelner Buchstaben: buchstabenförmige Region finden → mit Datenbank abgleichen → Zeichen ausgeben → zum nächsten weitergehen. Deshalb scheitert es an gedrehtem Text, gemischten Schriftarten, handschriftlichen Zeichen, die nicht zur Datenbank passen, und jedem Layout, bei dem die Lesereihenfolge nicht offensichtlich ist.
AI OCR verwendet ein Vision-Language-Modell (VLM), das die gesamte Seite als ein einziges Bild verarbeitet. Das Modell wurde mit Millionen von Dokumentseiten trainiert — Rechnungen, Belegen, Verträgen, Kontoauszügen, Bestellungen — gepaart mit Beschreibungen ihrer Struktur und ihres Inhalts. Durch dieses Training lernt das VLM, wie ein „Kopfbereich" aussieht, was eine „Tabelle" ist und dass ein Feld mit der Bezeichnung „Rechnungsnr." auf einem Dokument und „INV#" auf einem anderen dasselbe bedeutet.
Wenn Sie ihm ein neues Dokument geben, scannt das VLM nicht von links nach rechts auf der Suche nach Zeichen. Es betrachtet die gesamte Seite, identifiziert die visuellen Bereiche (Titelbereich, Tabellenbereich, Summenbereich, Fußzeile), liest jeden Bereich im Kontext und ordnet die extrahierten Informationen den richtigen Ausgabefeldern zu. Es versteht, dass eine fette Zahl in der unteren rechten Ecke einer Rechnung wahrscheinlich der Gesamtbetrag ist, selbst wenn kein explizites Label daneben steht. Es erkennt, dass eine mehrspaltige Tabelle auf Seite 2 dieselbe Struktur von Seite 1 fortsetzt, selbst wenn die Spaltenüberschriften nur auf der ersten Seite erscheinen.
Deshalb verarbeitet AI OCR Dokumente, an denen herkömmliches OCR völlig scheitert: zerknitterte Belege, Handyfotos von Rechnungen, gescannte mehrseitige Verträge mit eingebetteten Tabellen, handschriftliche Lieferscheine mit gedruckten Kopfzeileninformationen. Das VLM sucht nicht nach bekannten Zeichenformen — es sucht nach der Bedeutung des Dokuments.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wann Sie AI OCR benötigen (und wann herkömmliches OCR weiterhin funktioniert)
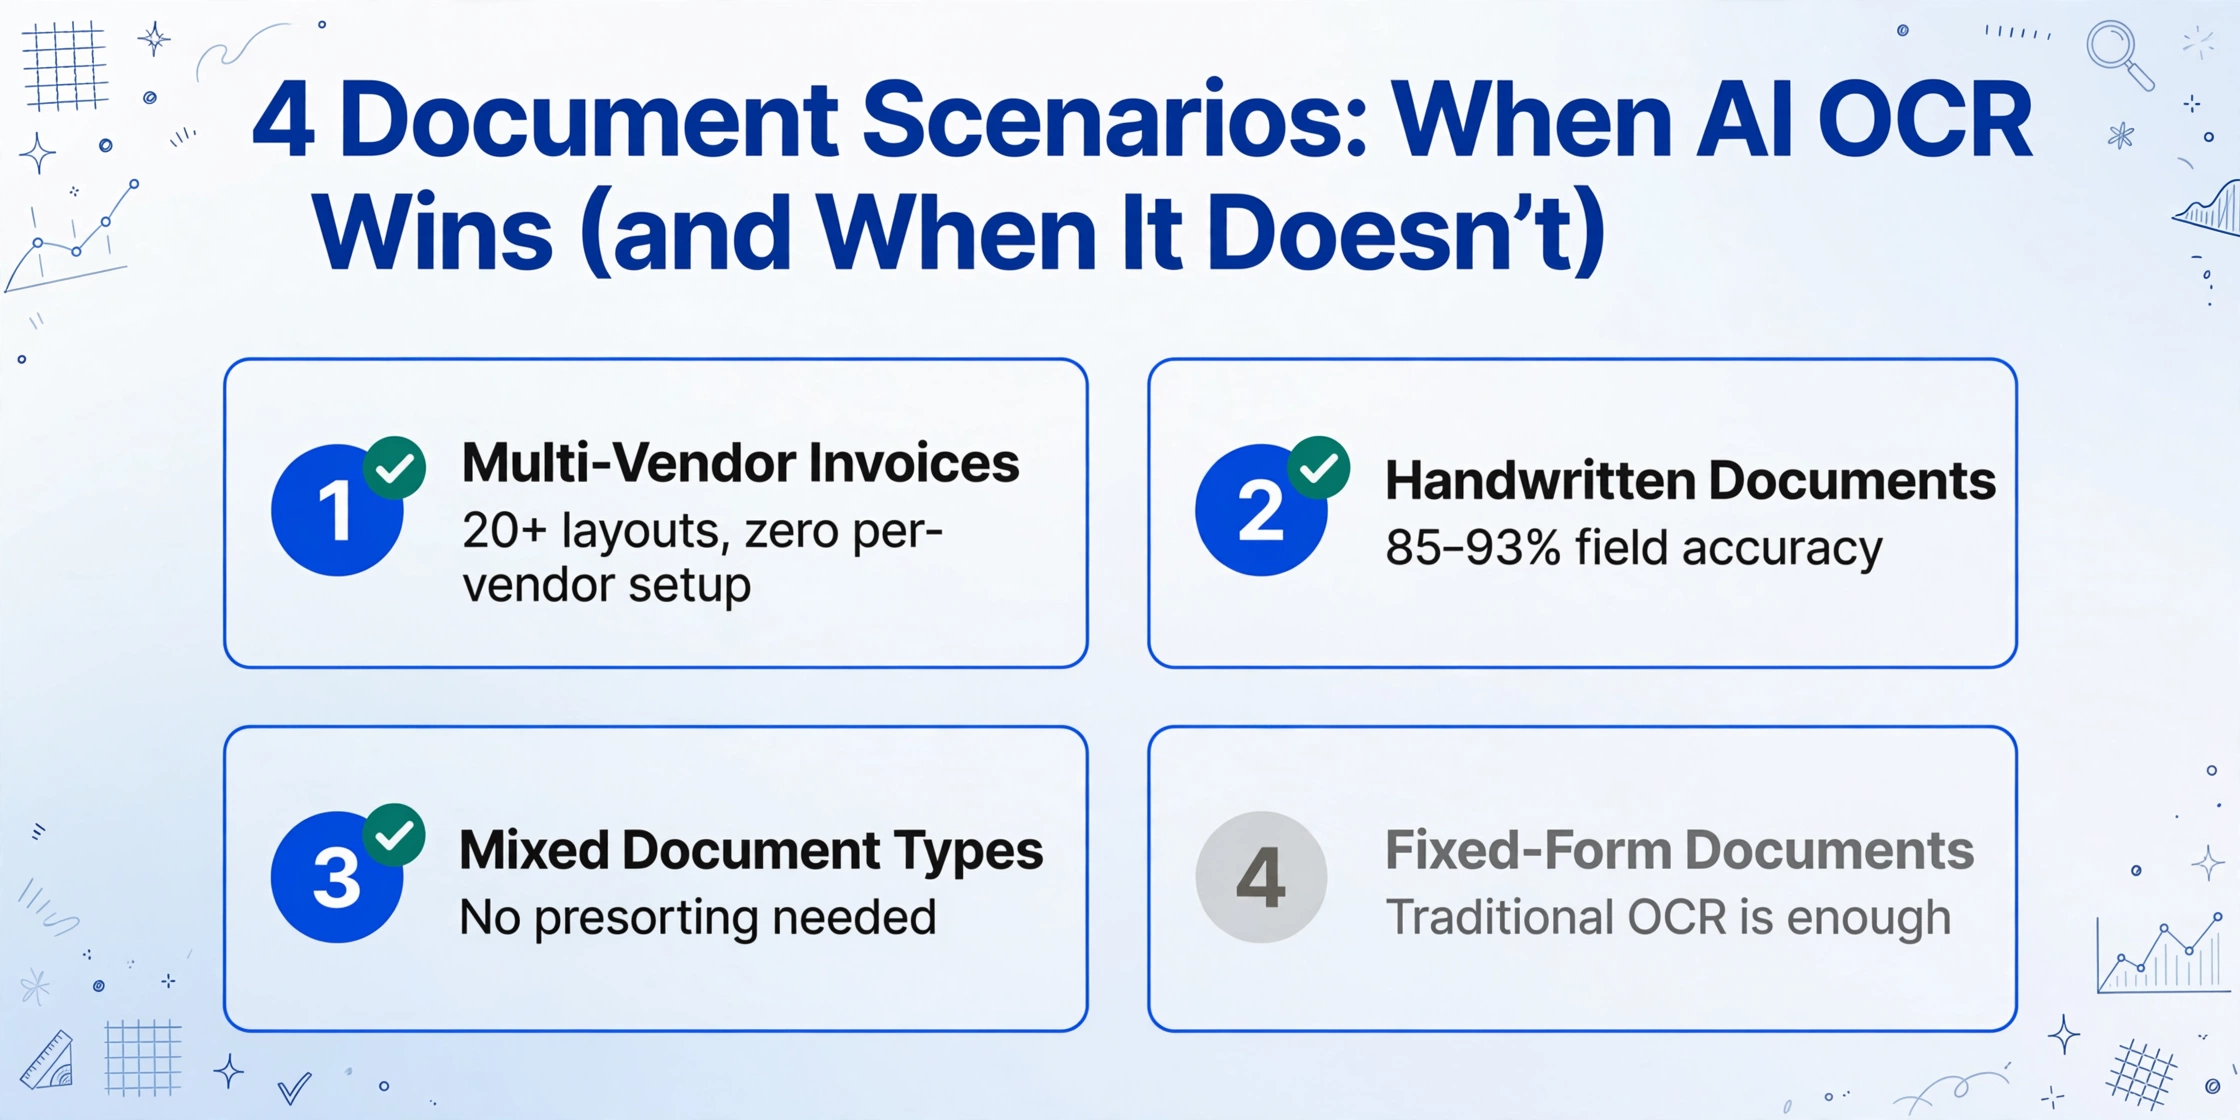
Nicht jede Dokumentenverarbeitung erfordert AI OCR. Zu wissen, wann man welche einsetzt, spart Zeit und Geld.
Rechnungsverarbeitung mehrerer Anbieter
Sie erhalten Rechnungen von über 20 Lieferanten, jeweils mit einem anderen Layout. Einige senden PDFs, einige E-Mail-Bilder, einige nutzen ein Webportal, das Sie als Screenshot erfassen. Herkömmliches OCR erfordert eine separate Vorlage für jedes Format – und jede Neugestaltung bricht sie. AI OCR verarbeitet alle ohne Einrichtung pro Anbieter. Dies ist der häufigste Auslöser.
Handschriftliche oder teilstrukturierte Dokumente
Feldserviceberichte, Lieferscheine mit handschriftlichen Unterschriften, Lagerkommissioniernotizen, Inspektionschecklisten. Herkömmliches OCR sieht Handschrift als zufällige Markierungen. AI OCR liest Druckschrift und Schreibschrift mit einer Feldgenauigkeit, die sie für die Dateneingabe nutzbar macht – nicht perfekt, aber deutlich besser als die 50–70 %, die herkömmliches OCR liefert.
Gemischte Dokumenttypen in einem Batch
Ein einzelner Sammel-Batch kann Rechnungen, Bestellungen, Packzettel und Lieferbestätigungen enthalten – alle von verschiedenen Absendern, alle in verschiedenen Formaten. Herkömmliches OCR kann dies ohne manuelles Sortieren und separate Vorlagen nicht bewältigen. AI OCR liest jeden Dokumenttyp automatisch und gibt die relevanten Felder aus, sodass Sie ohne Vorsortierung eine strukturierte Tabelle erhalten.
Wann herkömmliches OCR ausreicht
Wenn alle Ihre Dokumente sauberer gedruckter Text mit demselben Layout sind – ein festes Regierungsformular, ein standardisierter interner Bericht – kann herkömmliches OCR völlig ausreichend sein. Sie konvertieren Text in digitalen Text, nicht in strukturierte Daten. AI OCR würde ebenfalls funktionieren, aber wenn Geschwindigkeit und Kosten pro Seite Ihre Einschränkungen sind, bleibt herkömmliches OCR in diesem engen Szenario eine praktikable Option.
Worauf Sie bei einem AI-OCR-Tool achten sollten
Nicht jedes Tool, das sich „AI OCR" nennt, verwendet tatsächlich Vision-Language-Modelle. Manche sind herkömmliches OCR mit einem Skript, das nach der Extraktion versucht, Feldbezeichnungen zu erraten. Hier erfahren Sie, was echtes AI OCR von aufgemotzter Legacy-Software unterscheidet.
Erstens: Extraktion ohne Vorlage. Wenn das Tool Sie auffordert, Zonen zu definieren, Felder einzurahmen oder pro Anbieter Vorlagen zu erstellen, handelt es sich nicht um AI OCR – sondern um herkömmliches OCR mit einer hübscheren Oberfläche. Ein echtes AI-OCR-Tool extrahiert Daten aus jedem Dokumentlayout ohne formatspezifische Einrichtung. Das ist das nicht verhandelbare Merkmal, das entscheidet, ob sich das Tool an Ihre Dokumente anpasst oder Sie sich an das Tool anpassen müssen.
Zweitens: semantische Felderkennung. Laden Sie dieselbe Rechnung mit zwei verschiedenen Layouts hoch. Wenn das Tool in beiden Fällen Rechnungsnummer, Lieferantenname und Gesamtbetrag korrekt identifiziert, nutzt es semantisches Verständnis. Wenn es eines richtig und das andere falsch erkennt – oder Sie ihm sagen müssen, wo sich jedes Feld befindet –, basiert es im Hintergrund auf positionsbasierter Extraktion. ImageToTable.ai verwendet das, was es Benutzerdefinierte Spaltenextraktion nennt: Sie geben die gewünschten Spaltennamen ein (z. B. „Rechnungsnummer", „Fälligkeitsdatum", „Gesamtbetrag"), und die KI lokalisiert jeden Wert in jedem Dokumentlayout, indem sie versteht, was er bedeutet, nicht wo er steht. Derselbe Ansatz ist auch als dediziertes AI-OCR-Softwaretool für Teams verfügbar, die Dokumente in großem Umfang verarbeiten müssen.
Drittens: Batch-Verarbeitung, die die Struktur erhält. Der wahre Wert von AI OCR zeigt sich, wenn Sie 50 Dokumente auf einmal verarbeiten und eine einzige strukturierte Tabelle zurückerhalten – nicht 50 einzelne Ausgaben, die Sie manuell zusammenführen müssen. Ein Tool für die Batch-Extraktion sollte Ergebnisse automatisch in einer einzigen Tabelle zusammenführen, mit jedem Feld in einer eigenen Spalte, vom ersten bis zum letzten Dokument.
Viertens: Einrichtung ohne Training. Manche „KI"-Tools verlangen tatsächlich, dass Sie ein Modell trainieren, indem Sie 10–50 Beispieldokumente hochladen und die zu extrahierenden Felder manuell kennzeichnen. Das ist maschinelles Lernen, aber nicht das, was „AI OCR" im Jahr 2026 bedeuten sollte. Ein echtes AI-OCR-Tool sollte bei Ihrem ersten Upload funktionieren – ohne Training, ohne Beispiele und ohne Konfiguration außer der Benennung der gewünschten Felder.
Für einen vollständigen Vergleich, wie sich AI OCR von verwandter KI-Dokumentextraktion und anderen Datenverarbeitungskategorien unterscheidet, besuchen Sie unser Themen-Hub zur Dokumentextraktion.
Häufig gestellte Fragen
Ist KI-OCR dasselbe wie intelligente Dokumentenverarbeitung (IDP)?
Nein, auch wenn die Begriffe oft vermischt werden. KI-OCR ist die Leseschicht – sie wandelt Textbilder in strukturierte, beschriftete Daten um. IDP ist eine breitere Plattformkategorie, die KI-OCR sowie Workflow-Routing, Genehmigungsprozesse, ERP-Integration und Dokumentenklassifizierung umfasst. KI-OCR ist eine Fähigkeit, die IDP-Plattformen nutzen, aber nicht jedes KI-OCR-Tool ist eine IDP-Plattform.
Funktioniert KI-OCR mit handschriftlichen Dokumenten?
Ja, mit wichtigen Einschränkungen. Moderne Vision-Language-Modelle lesen Druckschrift mit einer Feldergenauigkeit von 85–93 % – eine deutliche Verbesserung gegenüber den 50–70 % traditioneller OCR. Kursivschrift und stark stilisierte Schriftarten bleiben jedoch herausfordernd. KI-OCR verarbeitet Handschrift am besten, wenn das Dokument eine klare Struktur aufweist (gedruckte Überschriften mit handschriftlichen Werten, Formulare mit definierten Feldern). Bei völlig freien handschriftlichen Seiten ist mit geringerer Genauigkeit und einem höheren Bedarf an manueller Überprüfung zu rechnen.
Kann KI-OCR PDFs und Bilder verarbeiten oder nur gescannte Dokumente?
KI-OCR kann jede visuelle Eingabe mit Text verarbeiten: gescannte PDFs, digital erstellte PDFs (auch mit eingebetteten Schriftarten), Handyfotos von Dokumenten, Screenshots und sogar Webseiten-Aufnahmen. Das Vision-Language-Modell behandelt alle als zu lesende Bilder, daher ist das Format der Originaldatei weit weniger wichtig als die Qualität und Klarheit des darin enthaltenen Textes.
Brauche ich Programmierkenntnisse, um ein KI-OCR-Tool zu nutzen?
Nicht bei modernen Tools, die für Geschäftsanwender entwickelt wurden. Der typische Arbeitsablauf ist: Dokument hochladen, die gewünschten Spaltennamen eingeben und das strukturierte Ergebnis herunterladen. Keine API-Konfiguration, kein Modelltraining, kein Vorlagendesign. Einige Tools bieten auch API-Zugriff für Entwickler, die die Extraktion in benutzerdefinierte Workflows integrieren möchten, aber der Kernanwendungsfall ist nicht-technisch.
Wie genau ist KI-OCR im Vergleich zu traditioneller OCR?
Bei sauberen gedruckten Dokumenten mit festen Layouts erzielen beide eine hohe Zeichengenauigkeit (95–99 %). Die Lücke vergrößert sich dramatisch bei Dokumenten mit komplexen Tabellen, mehreren Spalten, Handschrift oder wechselnden Layouts. Bei Rechnungssätzen mehrerer Lieferanten sinkt die Feldergenauigkeit traditioneller OCR auf 40–60 %, während KI-OCR 85–99 % erreicht. Der Unterschied liegt nicht in der Zeichenerkennung, sondern in der Feldidentifikation – KI-OCR erkennt korrekt, welcher extrahierte Wert zu welchem Feld gehört, was die Ausgabe ohne manuelle Neupositionierung nutzbar macht.