AI OCRとは?
AIが従来の文字認識をどう変えるか
AI OCR(AI搭載の光学文字認識)とは、視覚言語モデル(VLM)を使って個々の文字だけでなく文書全体を読み取り、レイアウト・文脈・意味を把握して構造化データを抽出する技術です。 これは機械学習をかぶせた従来のOCRではありません。基盤となるアーキテクチャが根本的に異なります。ピクセルパターンを文字データベースと照合する代わりに、AI OCRは人間の読者のようにページを視覚的・全体的・意味的に読み取ります。「合計」の下にある数字が請求書の合計金額であることや、「05/15/2026」が数量ではなく支払期日であることを理解します。
重要なポイント
- AI OCRはより優れたOCRエンジンではなく、文字の形を一つずつ照合する代わりに文書の意味を読み取る、まったく別の技術カテゴリです。
- 従来のOCRとAI OCRの差は、精度の数値だけでは測れません。一方はページ上にどの文字があるかを示し、もう一方は文書にどのデータが含まれているかを示します。
- 抽出されたすべての値にフィールドラベルが付いていれば、未分類のテキストをスプレッドシートの列に振り分ける手作業が不要になり、データ入力は素早い確認作業になります。
AI OCRの正体 — その実態と誤解
AI OCRは、従来のOCRの改良版ではありません。まったく別のカテゴリの技術です。従来のOCRとAI OCRは出発点を共有しています — どちらもテキストの画像を入力としてデジタル出力を生成します — しかし、その方法と成果物は完全に異なります。
従来のOCRはパターンマッチング技術です。ボトムアップで動作します:画像をスキャンし、テキストらしい領域を検出し、各文字の形状を既知のグリフのライブラリと照合し、認識した文字を読み順で出力します。エンジンはテキストの意味を理解しません。形状を読むのであって、内容を読むのではありません。従来のOCRエンジンに請求書を処理させると、ページに「$1,234.56」という文字が含まれているとは教えてくれますが、それが支払期日なのか、明細項目の小計なのか、税額なのか、参照番号なのかは判断できません。すべてのフィールドは意味を持たない単なる文字列です。
AI OCRはそのパイプライン全体をビジョンランゲージモデル(VLM)に置き換えます — 数百万のドキュメント画像と、それに対応するテキスト、レイアウト、構造でトレーニングされたニューラルネットワークです。VLMは文字を一つずつ認識する代わりに、ページ全体を視覚的なシーンとして処理します。ヘッダー、明細テーブル、合計セクション、フッターを識別します。右下のセルにある数字が左上のセルにある数字とは異なることを理解します。たとえ両方に「1,234.56」という数字が含まれていてもです。ピクセル座標ではなく、意味によって読み取ります。
「AI OCR」という言葉自体が誤解を招きます — OCRにAIを追加した技術、まるでカップケーキにスプリンクルを振りかけたような印象を与えます。実際には、AI OCRは文字認識というよりドキュメントリーディングに近い技術です。「OCR」の部分は入力(テキストの画像)を表しており、手法を表しているわけではありません。
この違いは重要です。なぜなら、ツールに期待できることが変わるからです。従来のOCRはテキストのデジタルコピーを提供します。AI OCRはドキュメントの構造化された理解を提供します。これらは異なる成果物であり、異なるニーズに応えるものです。従来のOCRが実際に何をするのか、その限界がどこにあるのかを詳しく知りたい方は、OCRとは何か、どのように機能するかのガイドをご覧ください。
従来のOCRは「このページにどんな文字があるか?」という問いに答えます。AI OCRは「このドキュメントにはどんなデータが含まれているか?」という問いに答えます。この二つの問いの距離こそ、テキストファイルとスプレッドシートの差です。
すべてを変える違い
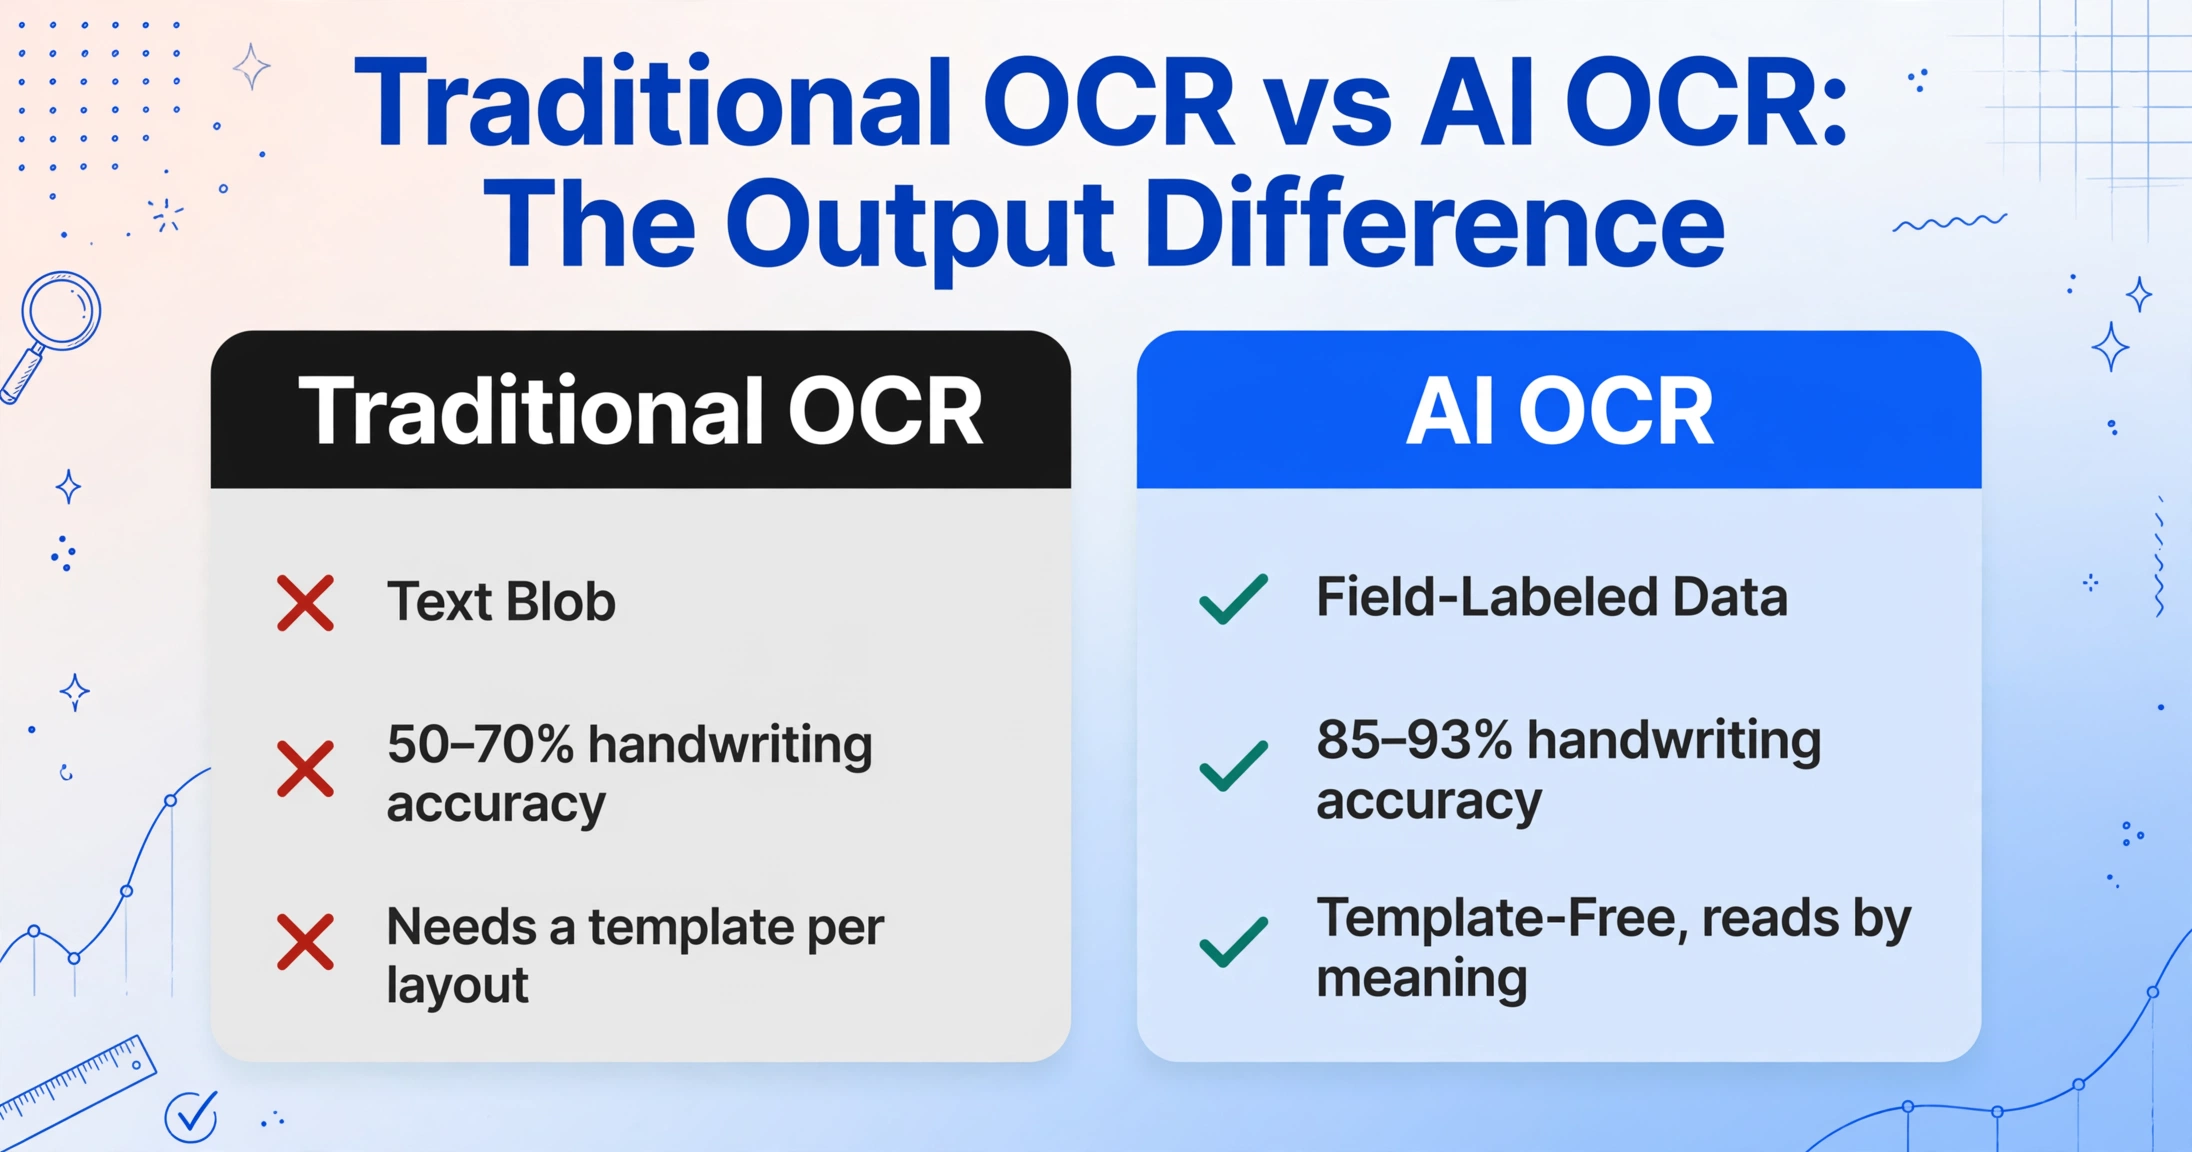
従来のOCRとAI OCRの違いは、程度の問題ではなく、本質的な違いです。実際のビジネス文書を処理する際に重要となる各側面について、2つのテクノロジーを比較した結果は次のとおりです。
| 項目 | 従来のOCR | AI OCR |
|---|---|---|
| コア方式 | グリフデータベースに対する文字単位のパターンマッチング | 視覚言語モデルによるページ全体の読解 |
| 出力 | 読み順に並んだ未分類のテキスト文字列 | フィールドラベル付きの構造化データ(請求書番号、支払期日、合計) |
| レイアウト変更への対応 | 不可 — 各フォーマットに新しいテンプレートが必要 | 可能 — 位置ではなく意味で読み取る |
| 手書き文字への対応 | 低い(フィールド精度 約50〜70%) | 高い(最新のVLMで約85〜93%) |
| 表の理解 | 行と列の関係が失われる | ヘッダー付きの表構造を保持 |
| セットアップ時間 | 文書テンプレートごとに数日〜数週間 | 数分 — テンプレートやトレーニングは不要 |
実際の運用で最も重要な行は2行目、出力です。スキャンした請求書を従来のOCRにかけると、テキストの塊が出力されますが、それを読んで解釈し、スプレッドシートや会計システムの正しいセルに手入力する必要があります。それはデータ入力の自動化ではなく、手作業による仕分けステップがまだ残っている単なるデジタル化です。AI OCRは、ラベル付けされたデータを出力するため、その仕分けステップを排除します。「請求書番号」は、モデルが請求書番号であると理解したため、請求書番号の列に入ります。
この変化 — 未分類のテキストからフィールドラベル付きデータへ — こそが、OCRをスキャン支援ツールから真のデータ入力代替手段へと変えるものです。文書タイプ別の具体的な精度ベンチマークについては、AI OCRと従来のOCRの精度比較をご覧ください。
AI OCRがドキュメントを読み取る仕組み
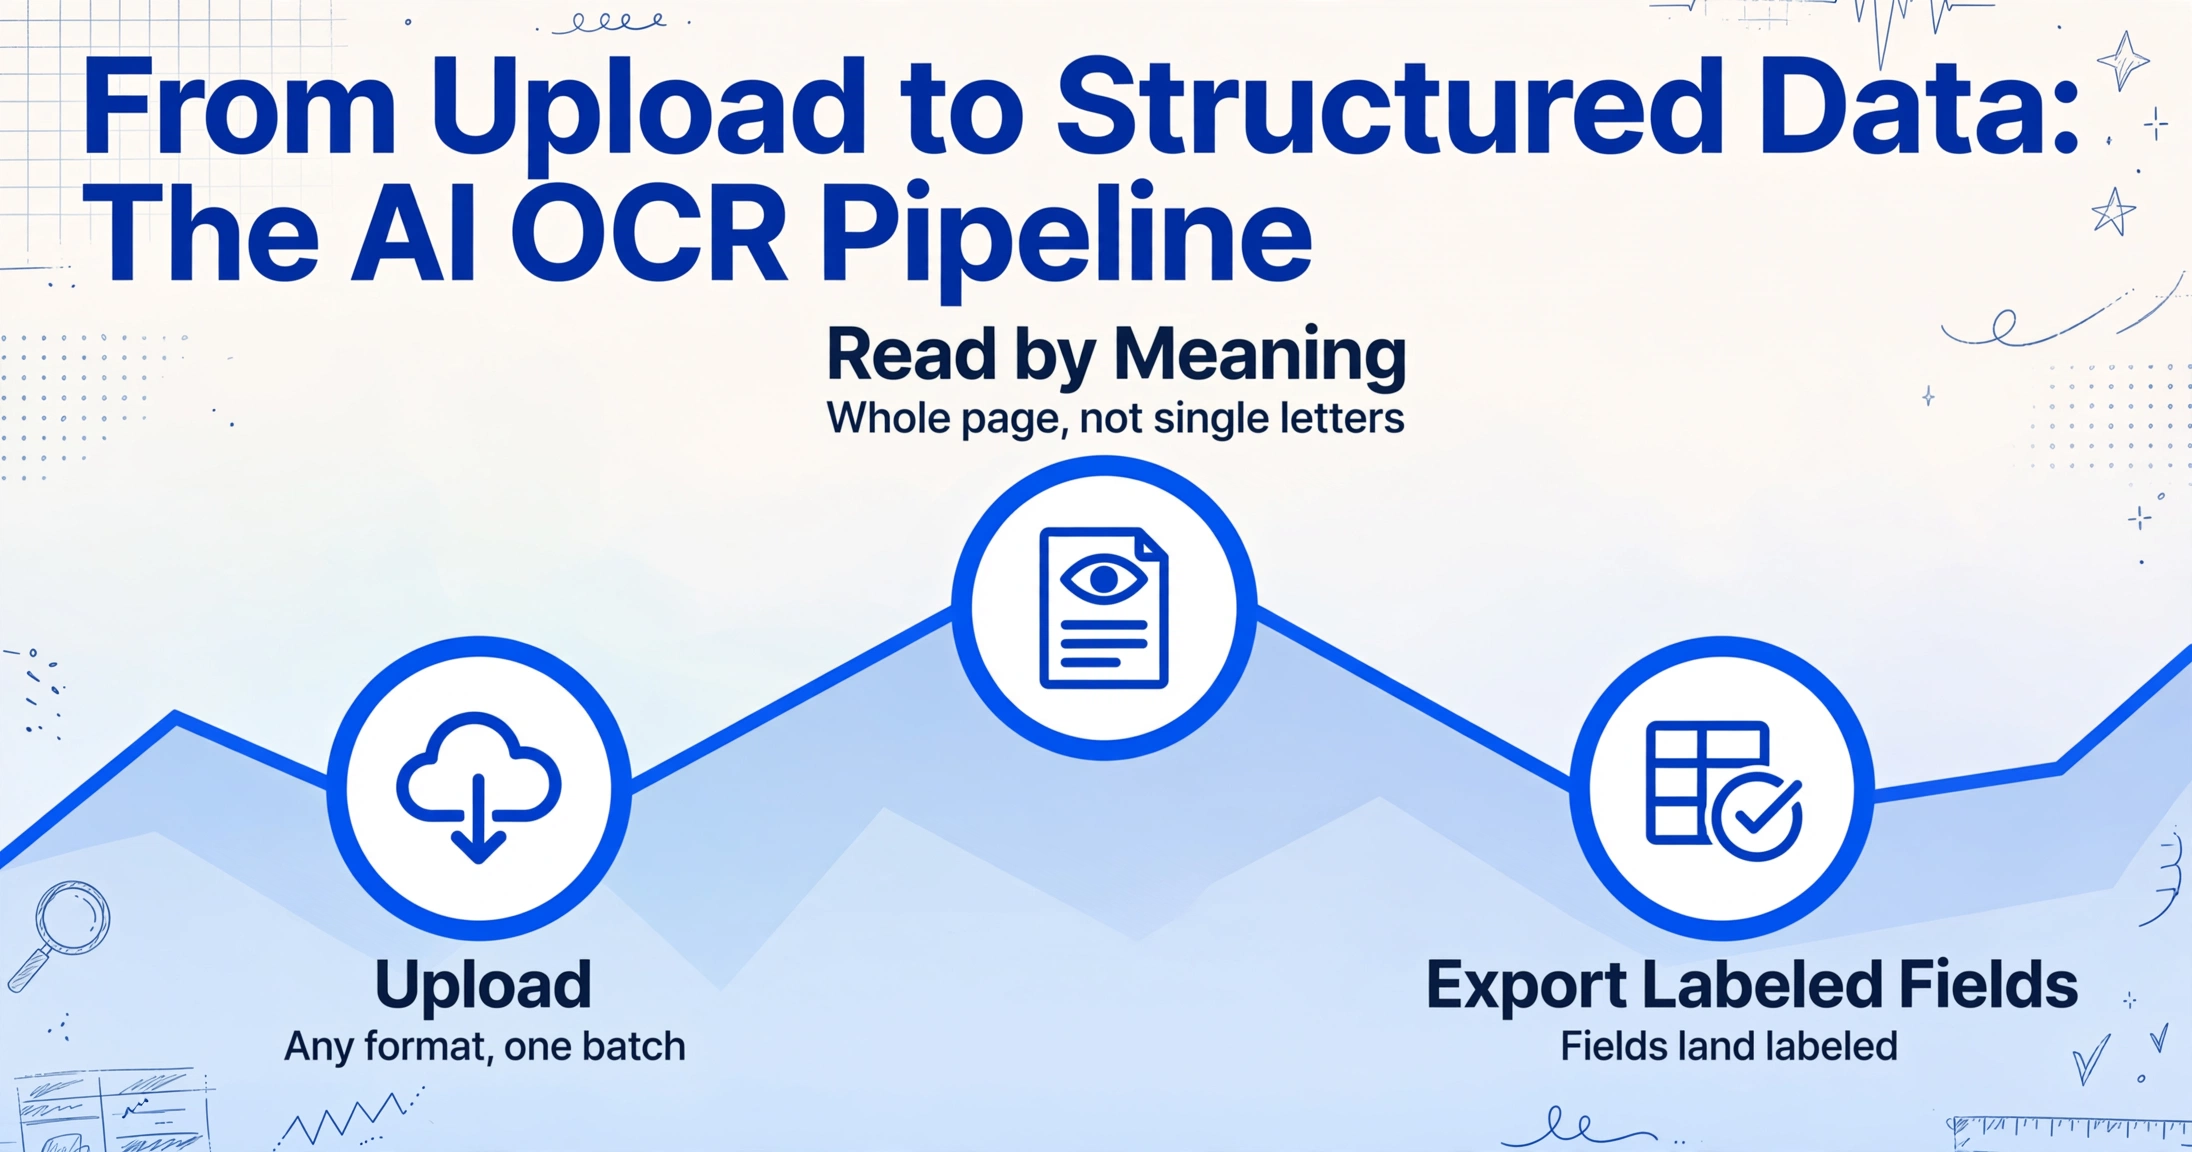
AI OCRの仕組みを理解するには、文字認識について知っていることをすべて忘れてください。そのアプローチはまったく異なります。
従来のOCRは、ドキュメントを個々の文字のコンベアベルトのように処理します。文字のような領域を見つける→データベースと照合する→文字を出力する→次へ進む。このため、回転したテキスト、混在フォント、データベースに一致しない手書き文字、読み取り順序が明確でないレイアウトに弱いのです。
AI OCRは、ページ全体を1枚の画像として処理する視覚言語モデル(VLM)を使用します。このモデルは、請求書、領収書、契約書、銀行明細書、注文書など、数百万枚のドキュメントページと、その構造と内容の説明をペアにして学習しています。この学習を通じて、VLMは「ヘッダー」がどのようなものか、「テーブル」が何かを学び、あるドキュメントの「請求書番号」というラベルと別のドキュメントの「INV#」というラベルが同じものを指していることを理解します。
新しいドキュメントを与えると、VLMは左から右へスキャンして文字を探すのではありません。ページ全体を見て、視覚的な領域(タイトル領域、テーブル領域、合計領域、フッター)を特定し、各領域を文脈に沿って読み取り、抽出した情報を正しい出力フィールドにマッピングします。請求書の右下隅にある太字の数字が、たとえ隣に明示的なラベルがなくても、おそらく合計であることを理解します。また、2ページ目の複数列テーブルが1ページ目と同じ構造を継続していること、たとえ列ヘッダーが1ページ目にしかなくても認識します。
これが、AI OCRが従来のOCRではまったく処理できないドキュメントを扱える理由です。しわくちゃのレシート、請求書のスマホ写真、埋め込みテーブルを含むスキャン済みの複数ページ契約書、印刷されたヘッダー情報付きの手書き納品書などです。VLMは既知の文字形状を探しているのではなく、ドキュメントの意味を探しているのです。
ファイルは安全に処理され、保存されません。
AI OCRが必要な場合(従来のOCRで十分な場合)
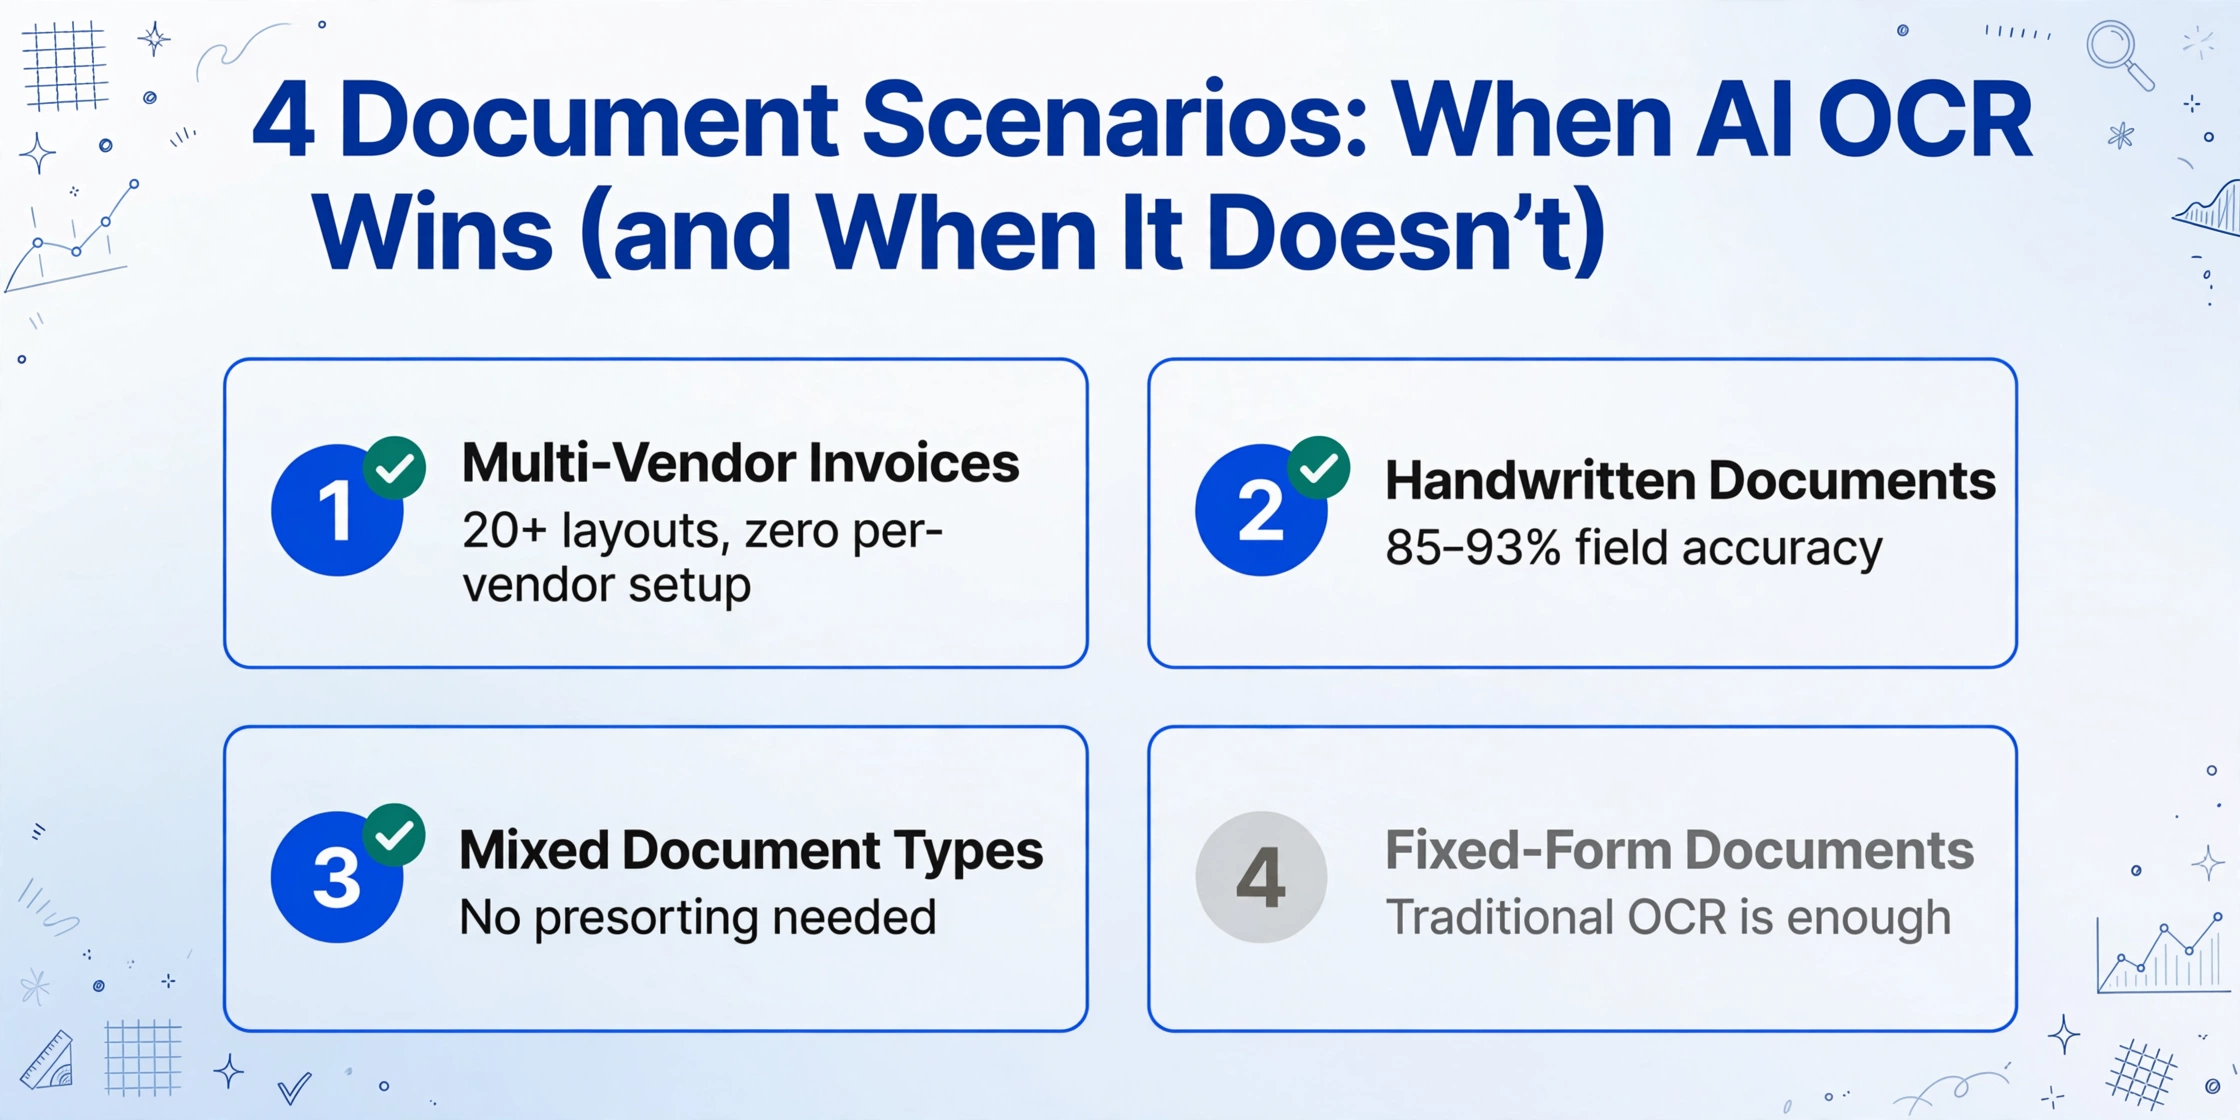
すべての文書処理タスクにAI OCRが必要なわけではありません。使い分けを理解すれば、時間とコストを節約できます。
複数ベンダーの請求書処理
20社以上のサプライヤーから、それぞれ異なるレイアウトの請求書を受け取るケース。PDFを送る会社もいれば、メールで画像を送る会社、Webポータルをスクリーンショットする会社もあります。従来のOCRでは各フォーマットに個別のテンプレートが必要で、レイアウトが変わるたびに機能しなくなります。AI OCRならベンダーごとの設定なしで全て処理できます。これが最も一般的な導入理由です。
手書き文書・半構造化文書
現場サービスレポート、手書きサイン入りの納品書、倉庫のピッキングメモ、点検チェックリストなど。従来のOCRは手書きを無意味な記号として認識します。AI OCRはブロック体・筆記体の手書きを読み取り、データ入力に使える精度のフィールド抽出が可能です。完璧ではありませんが、従来のOCRの50〜70%という精度よりはるかに優れています。
1つのバッチに混在する文書タイプ
1つのコレクションバッチに、請求書・発注書・納品書・配送確認書が混在することもあります。送信元もフォーマットもすべて異なります。従来のOCRでは手動での仕分けと個別テンプレートなしには対応できません。AI OCRは各文書タイプを自動で判別し、必要なフィールドを抽出するため、事前の仕分けなしで1つの構造化テーブルにまとめられます。
従来のOCRで十分な場合
すべての文書が毎回同じレイアウトのきれいな印刷テキストの場合—定型の政府申請書や標準化された社内レポートなど—従来のOCRで十分対応できます。構造化データの抽出ではなく、テキストをデジタルテキストに変換するだけだからです。AI OCRでも処理は可能ですが、速度と1ページあたりのコストが制約条件なら、この限定的なシナリオでは従来のOCRも有力な選択肢です。
AI OCRツールに求めるべきポイント
「AI OCR」を名乗るツールのすべてが、実際に視覚言語モデルを使用しているわけではありません。中には、抽出後にスクリプトでフィールドラベルを推測しようとする従来のOCRもあります。ここでは、本物のAI OCRと、見せかけだけのレガシーソフトウェアの違いを説明します。
まず、テンプレート不要の抽出です。ツールが領域の定義、フィールド周辺へのボックス描画、ベンダーごとのテンプレート作成を求める場合、それはAI OCRではなく、見た目だけ新しくなった従来のOCRです。本物のAI OCRツールは、フォーマットごとの設定なしに、あらゆるドキュメントレイアウトからデータを抽出します。これは、ツールがあなたのドキュメントに適応するのか、それともあなたがツールに適応するのかを決める、譲れない機能です。
次に、意味的なフィールド認識です。同じ請求書を2つの異なるレイアウトでアップロードしてください。ツールが両方で請求書番号、ベンダー名、合計を正しく識別できれば、意味的理解を使用しています。片方は正しくてももう片方は間違える場合、または各フィールドの位置を指定する必要がある場合は、内部で位置ベースの抽出に依存しています。ImageToTable.aiはカスタム列抽出と呼ばれる機能を使用します。抽出したい列名(例:「請求書番号」「支払期日」「合計」)を入力すると、AIが値の位置ではなく意味を理解して、あらゆるドキュメントレイアウト上の各値を特定します。同じアプローチは、スケールでドキュメントを処理する必要があるチーム向けの専用AI OCRソフトウェアツールとしても利用できます。
3つ目は、構造を保持するバッチ処理です。AI OCRの真の価値は、50件のドキュメントを一度に処理して、手動でマージしなければならない50件の個別出力ではなく、1つの構造化テーブルを得られるところに現れます。バッチ抽出用に設計されたツールは、最初のドキュメントから最後まで、各フィールドをそれぞれの列に配置し、結果を1つのスプレッドシートに自動的にマージする必要があります。
4つ目は、トレーニング不要のセットアップです。一部の「AI」ツールは、実際には10〜50件のサンプルドキュメントをアップロードして、抽出したいフィールドを手動でラベル付けするモデルのトレーニングを要求します。それは機械学習ですが、2026年の「AI OCR」が意味すべきものではありません。真のAI OCRツールは、トレーニングもサンプルも、抽出したいフィールド名の指定以外の設定もなしに、最初のアップロードで機能するはずです。
AI OCRが兄弟AIドキュメント抽出や他のデータ処理カテゴリとどう違うかの完全な比較については、ドキュメント抽出に関するトピックハブをご覧ください。
よくある質問
AI OCRとインテリジェント文書処理(IDP)は同じですか?
いいえ、混同されがちですが異なります。AI OCRは読み取り層であり、画像テキストを構造化・ラベル付けされたデータに変換します。IDPはより広範なプラットフォームで、AI OCRに加え、ワークフロー、承認プロセス、ERP連携、文書分類を含みます。AI OCRはIDPが利用する機能の一つであり、すべてのAI OCRツールがIDPプラットフォームというわけではありません。
AI OCRは手書き文書に対応していますか?
はい、ただし重要な注意点があります。最新の視覚言語モデルは、活字体の手書き文字を85~93%のフィールド精度で読み取れます。これは従来のOCR(50~70%)からの大幅な改善です。しかし、筆記体や装飾的なスタイルは依然として課題です。AI OCRは、明確な構造(印刷された見出しと手書きの値、定義されたフィールドを持つフォーム)がある文書で最も効果を発揮します。完全に自由形式の手書きページでは精度が低下し、手動確認の必要性が高まります。
AI OCRはスキャン文書だけでなく、PDFや画像も処理できますか?
AI OCRはテキストを含むあらゆる視覚入力を処理できます。スキャンPDF、デジタル生成PDF(埋め込みフォントを含む)、書類のスマホ写真、スクリーンショット、Webページのキャプチャなどです。視覚言語モデルはこれらすべてを読み取り対象の画像として扱うため、元のファイル形式よりも、テキストの品質と明瞭さが重要です。
AI OCRツールを使うにはコーディングスキルが必要ですか?
ビジネスユーザー向けの最新ツールでは不要です。一般的な流れは、文書をアップロードし、抽出したい列名を入力し、構造化された結果をダウンロードするだけです。API設定、モデルトレーニング、テンプレート設計は不要です。カスタムワークフローに統合したい開発者向けにAPIを提供するツールもありますが、中核的なユースケースは非技術者向けです。
AI OCRの精度は従来のOCRと比べてどうですか?
固定レイアウトのきれいな印刷文書では、どちらも高い文字精度(95~99%)を達成します。差が顕著になるのは、複雑な表、複数列、手書き、可変レイアウトを含む文書です。複数ベンダーの請求書バッチでは、従来のOCRのフィールド精度は40~60%に低下しますが、AI OCRは85~99%を維持します。違いは文字認識ではなくフィールド識別にあります。AI OCRは抽出された値がどのフィールドに属するかを正しく識別するため、手動での位置調整なしで出力を利用できます。