¿Qué es AI OCR?
Cómo la IA transforma el reconocimiento tradicional de caracteres
AI OCR — reconocimiento óptico de caracteres impulsado por IA — es una tecnología que utiliza modelos de visión y lenguaje para leer y comprender documentos completos, no solo caracteres individuales, extrayendo datos estructurados al captar el diseño, el contexto y el significado. Esto no es OCR tradicional con una capa de aprendizaje automático. La arquitectura subyacente es fundamentalmente diferente: en lugar de comparar patrones de píxeles contra una base de datos de caracteres, AI OCR lee una página como lo haría un lector humano: visual, holística y semánticamente. Sabe que un número debajo de "Total" es el total de una factura y que "05/15/2026" es una fecha de vencimiento, no una cantidad.
Conclusiones clave
- AI OCR no es un mejor motor de OCR: es una categoría de tecnología completamente distinta que lee el significado del documento en lugar de emparejar formas de caracteres una por una.
- La brecha entre el OCR tradicional y AI OCR no se puede medir solo en puntos de precisión: uno te dice qué caracteres hay en una página, el otro te dice qué datos contiene el documento.
- Cuando cada valor extraído ya lleva su propia etiqueta de campo, el paso manual de clasificar texto indiferenciado en columnas de hoja de cálculo desaparece y la captura de datos se convierte en una revisión rápida.
Qué es realmente el AI OCR — y qué no es
El AI OCR no es una versión mejorada del OCR que ya conoce. Es una categoría de tecnología completamente distinta. El OCR tradicional y el AI OCR comparten un punto de partida — ambos toman una imagen de texto y producen una salida digital — pero divergen por completo en cómo llegan a ese resultado y en lo que pueden ofrecer.
El OCR tradicional es una tecnología de coincidencia de patrones. Funciona de abajo hacia arriba: escanea la imagen, detecta regiones que parecen texto, compara cada forma de carácter contra una biblioteca de glifos conocidos y genera los caracteres reconocidos en orden de lectura. El motor no tiene comprensión de lo que el texto significa. Lee formas, no contenido. Pídale a un motor de OCR tradicional que procese una factura y le dirá que la página contiene los caracteres "$1,234.56" — pero no podrá decirle si eso es el total a pagar, un subtotal de una línea, el impuesto o un número de referencia. Cada campo es solo otra cadena de caracteres sin peso semántico.
El AI OCR reemplaza todo ese proceso con un modelo de visión y lenguaje (VLM) — una red neuronal entrenada con millones de imágenes de documentos y su texto, diseños y estructuras correspondientes. En lugar de reconocer caracteres uno por uno, el VLM procesa la página completa como una escena visual. Identifica el encabezado, la tabla de líneas, la sección de totales, el pie de página. Entiende que el número en la celda inferior derecha es diferente del número en la celda superior izquierda, incluso si ambos contienen los dígitos "1,234.56." Lee por significado, no por coordenadas de píxeles.
La frase "AI OCR" en sí misma es engañosa — sugiere que la tecnología es OCR con IA añadida, como chispitas sobre un pastel. En realidad, el AI OCR está más cerca de la lectura de documentos que del reconocimiento de caracteres. La parte "OCR" describe la entrada (imágenes de texto), no el método.
Esta distinción importa porque cambia lo que puede esperar de la herramienta. El OCR tradicional le da una copia digital del texto. El AI OCR le da una comprensión estructurada del documento. Son dos resultados diferentes que sirven a dos necesidades diferentes. Para un análisis más profundo de lo que hace realmente el OCR tradicional y dónde están sus límites, consulte nuestra guía sobre qué es el OCR y cómo funciona.
El OCR tradicional responde a la pregunta "¿qué caracteres hay en esta página?" El AI OCR responde a la pregunta "¿qué datos contiene este documento?" La distancia entre esas dos preguntas es la brecha entre un archivo de texto y una hoja de cálculo.
La diferencia que lo cambia todo
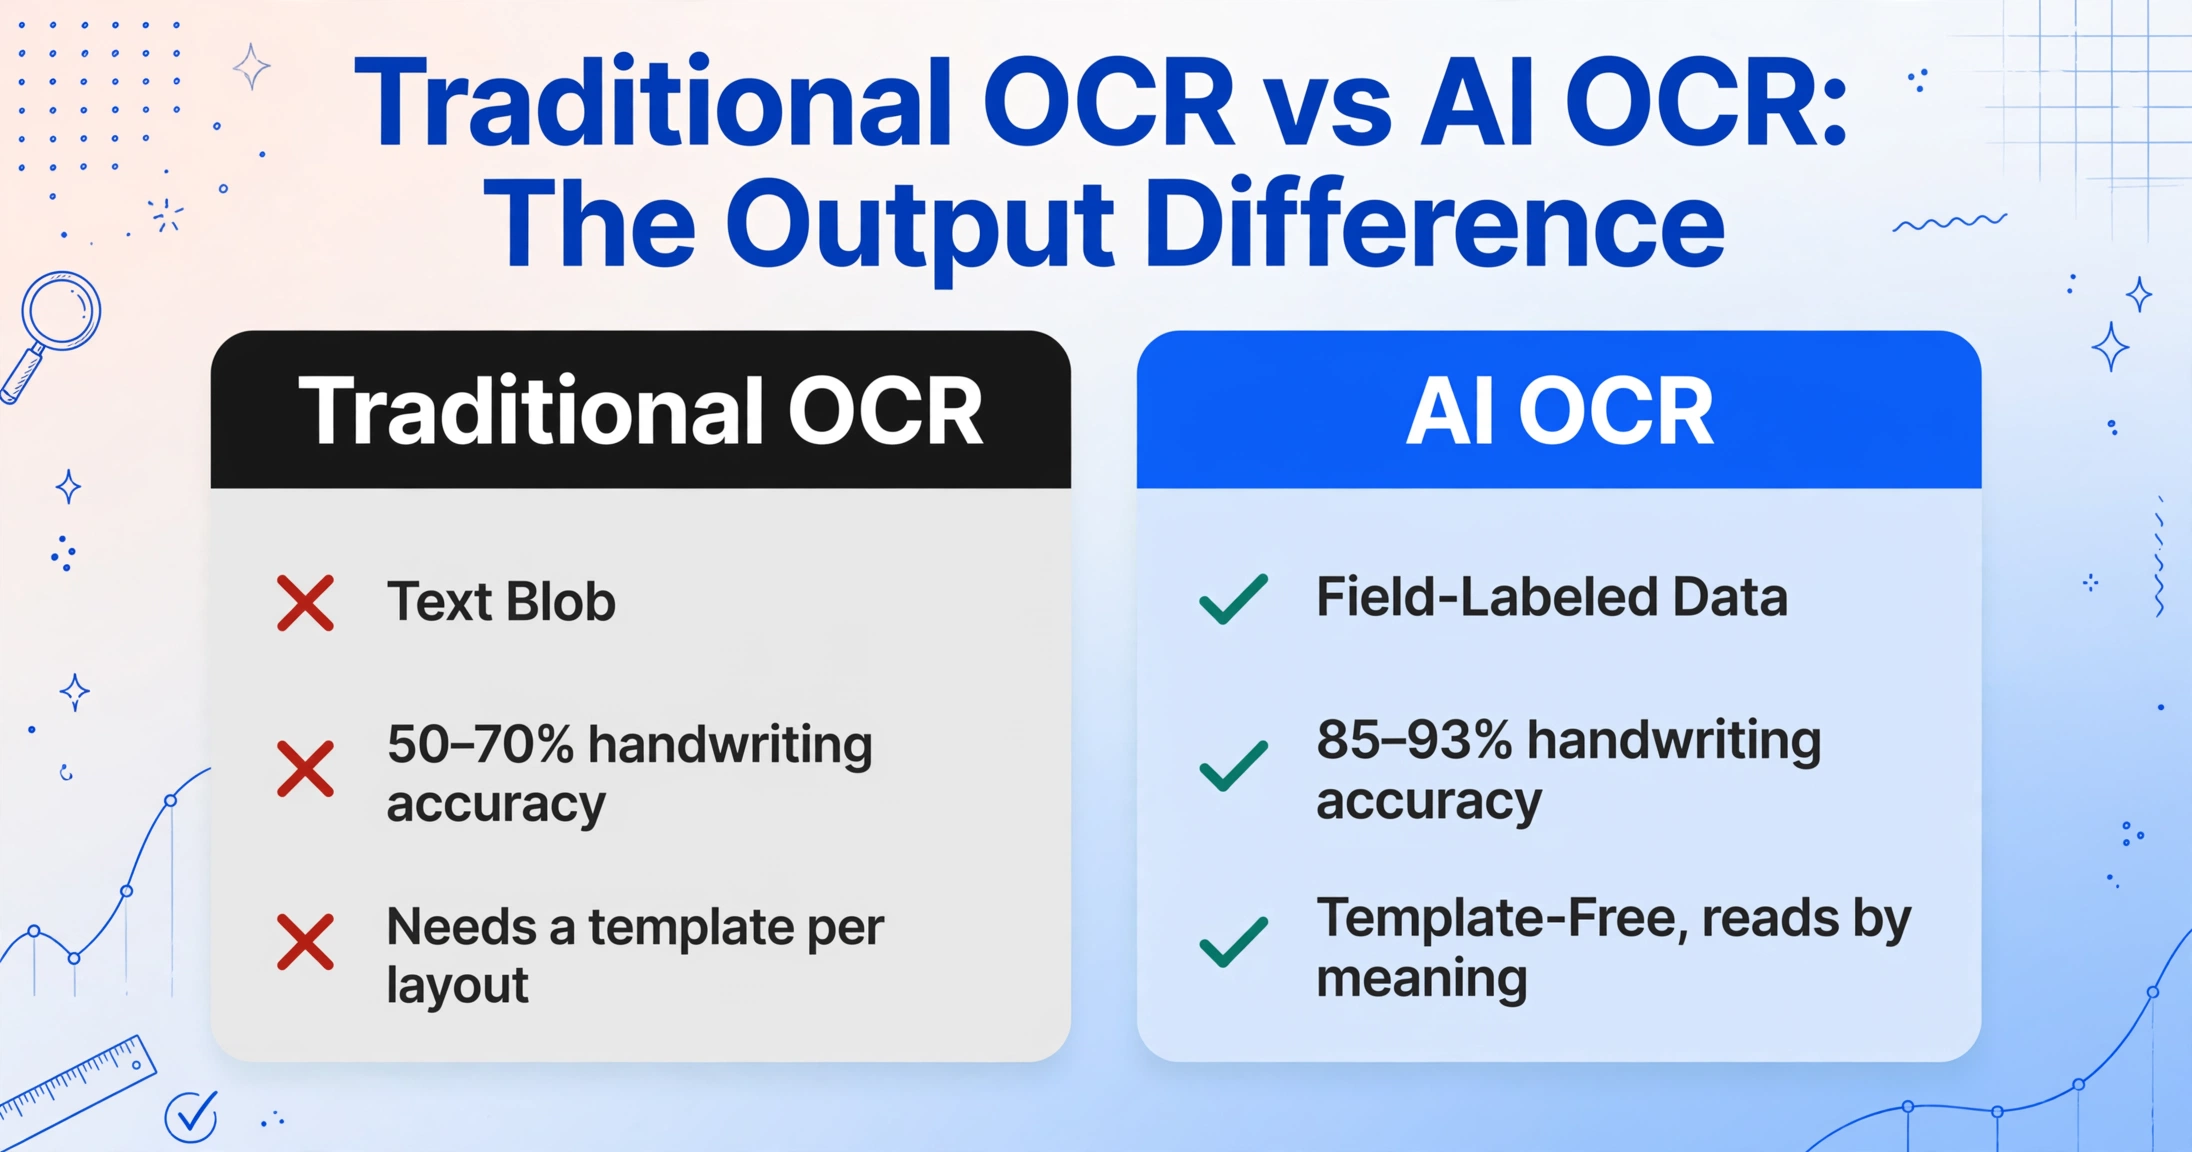
La brecha entre el OCR tradicional y el AI OCR no es una cuestión de grado: es una diferencia de naturaleza. Así se comparan las dos tecnologías en las dimensiones que realmente importan cuando se procesan documentos comerciales reales:
| Dimensión | OCR tradicional | AI OCR |
|---|---|---|
| Método principal | Coincidencia de patrones carácter por carácter contra una base de datos de glifos | Lectura holística de la página mediante modelos de visión y lenguaje |
| Resultado | Cadena de texto indiferenciada en orden de lectura | Datos estructurados con etiquetas de campo (Número de factura, Fecha de vencimiento, Total) |
| Maneja cambios de diseño | No: cada formato requiere una plantilla nueva | Sí: lee por significado, no por posición |
| Maneja escritura a mano | Deficiente (~50-70% de precisión por campo) | Buena (~85-93% con VLM modernos) |
| Comprensión de tablas | Pierde las relaciones entre filas y columnas | Preserva la estructura de la tabla con encabezados |
| Tiempo de configuración | De días a semanas por plantilla de documento | Minutos: no se necesitan plantillas ni entrenamiento |
La fila que más importa en la práctica es la segunda: resultado. Cuando se pasa una factura escaneada por un OCR tradicional, se obtiene un bloque de texto que aún hay que leer, interpretar y copiar en las celdas correctas de la hoja de cálculo o del sistema contable. Eso no es automatización de entrada de datos: es digitalización con un paso manual de clasificación todavía adjunto. El AI OCR elimina ese paso de clasificación porque genera datos que ya están etiquetados. El "Número de factura" va a la columna de número de factura porque el modelo entendió que era un número de factura.
Ese cambio —de texto indiferenciado a datos etiquetados por campo— es lo que transforma el OCR de una ayuda de escaneo en un verdadero reemplazo de la entrada de datos. Para puntos de referencia de precisión específicos según el tipo de documento, consulte nuestra comparación detallada de precisión de AI OCR frente a OCR tradicional.
Cómo la IA OCR lee documentos
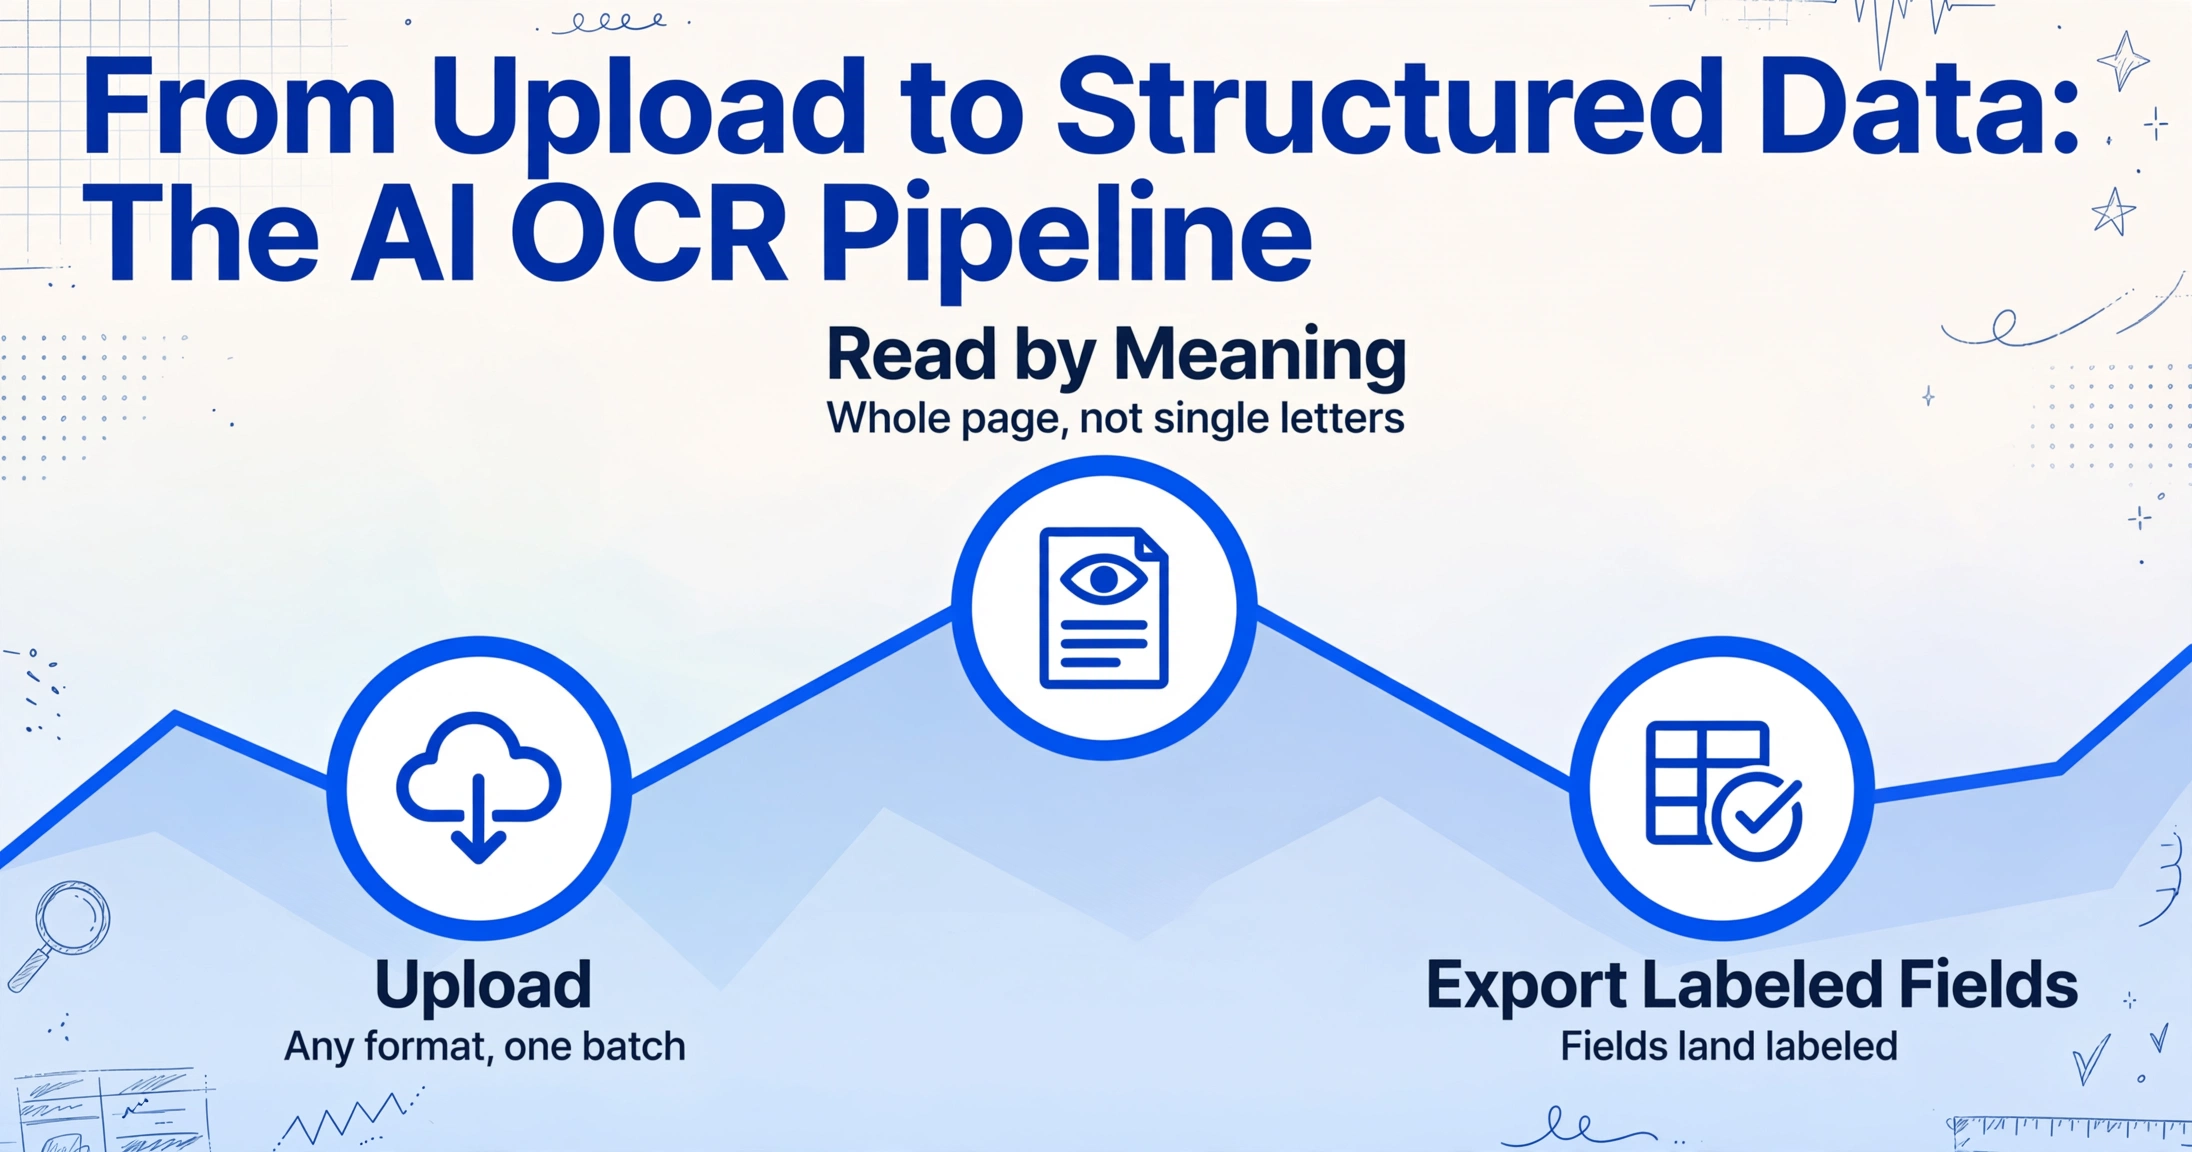
Para entender cómo funciona la IA OCR, olvídate de todo lo que sabes sobre el reconocimiento de caracteres. El enfoque es completamente diferente.
El OCR tradicional procesa un documento como una cinta transportadora de letras individuales: encuentra la región con forma de letra → compara con la base de datos → genera el carácter → pasa al siguiente. Por eso le cuesta el texto rotado, las fuentes mixtas, los caracteres manuscritos que no coinciden con la base de datos y cualquier diseño donde el orden de lectura no sea evidente.
La IA OCR utiliza un modelo de visión y lenguaje (VLM) que procesa la página completa como una sola imagen. El modelo se entrenó con millones de páginas de documentos (facturas, recibos, contratos, extractos bancarios, órdenes de compra) emparejadas con descripciones de su estructura y contenido. Mediante ese entrenamiento, el VLM aprende cómo se ve un "encabezado", qué es una "tabla" y que un campo etiquetado como "N.º de factura" en un documento y "INV#" en otro se refieren a lo mismo.
Cuando le das un documento nuevo, el VLM no escanea de izquierda a derecha buscando caracteres. Observa la página completa, identifica las regiones visuales (área del título, área de la tabla, área de totales, pie de página), lee cada región en contexto y asigna la información extraída a los campos de salida correctos. Entiende que un número en negrita en la esquina inferior derecha de una factura probablemente sea el total, incluso si no hay una etiqueta explícita junto a él. Reconoce que una tabla de varias columnas en la página 2 continúa la misma estructura de la página 1, incluso cuando los encabezados de columna solo aparecen en la primera página.
Por eso la IA OCR maneja documentos que rompen por completo el OCR tradicional: recibos arrugados, fotos de facturas tomadas con el teléfono, contratos escaneados de varias páginas con tablas integradas, notas de entrega manuscritas con información de encabezado impresa. El VLM no busca formas de caracteres conocidas, sino el significado del documento.
Los archivos se procesan de forma segura y no se almacenan.
Cuándo Necesita AI OCR (y Cuándo el OCR Tradicional Sigue Funcionando)
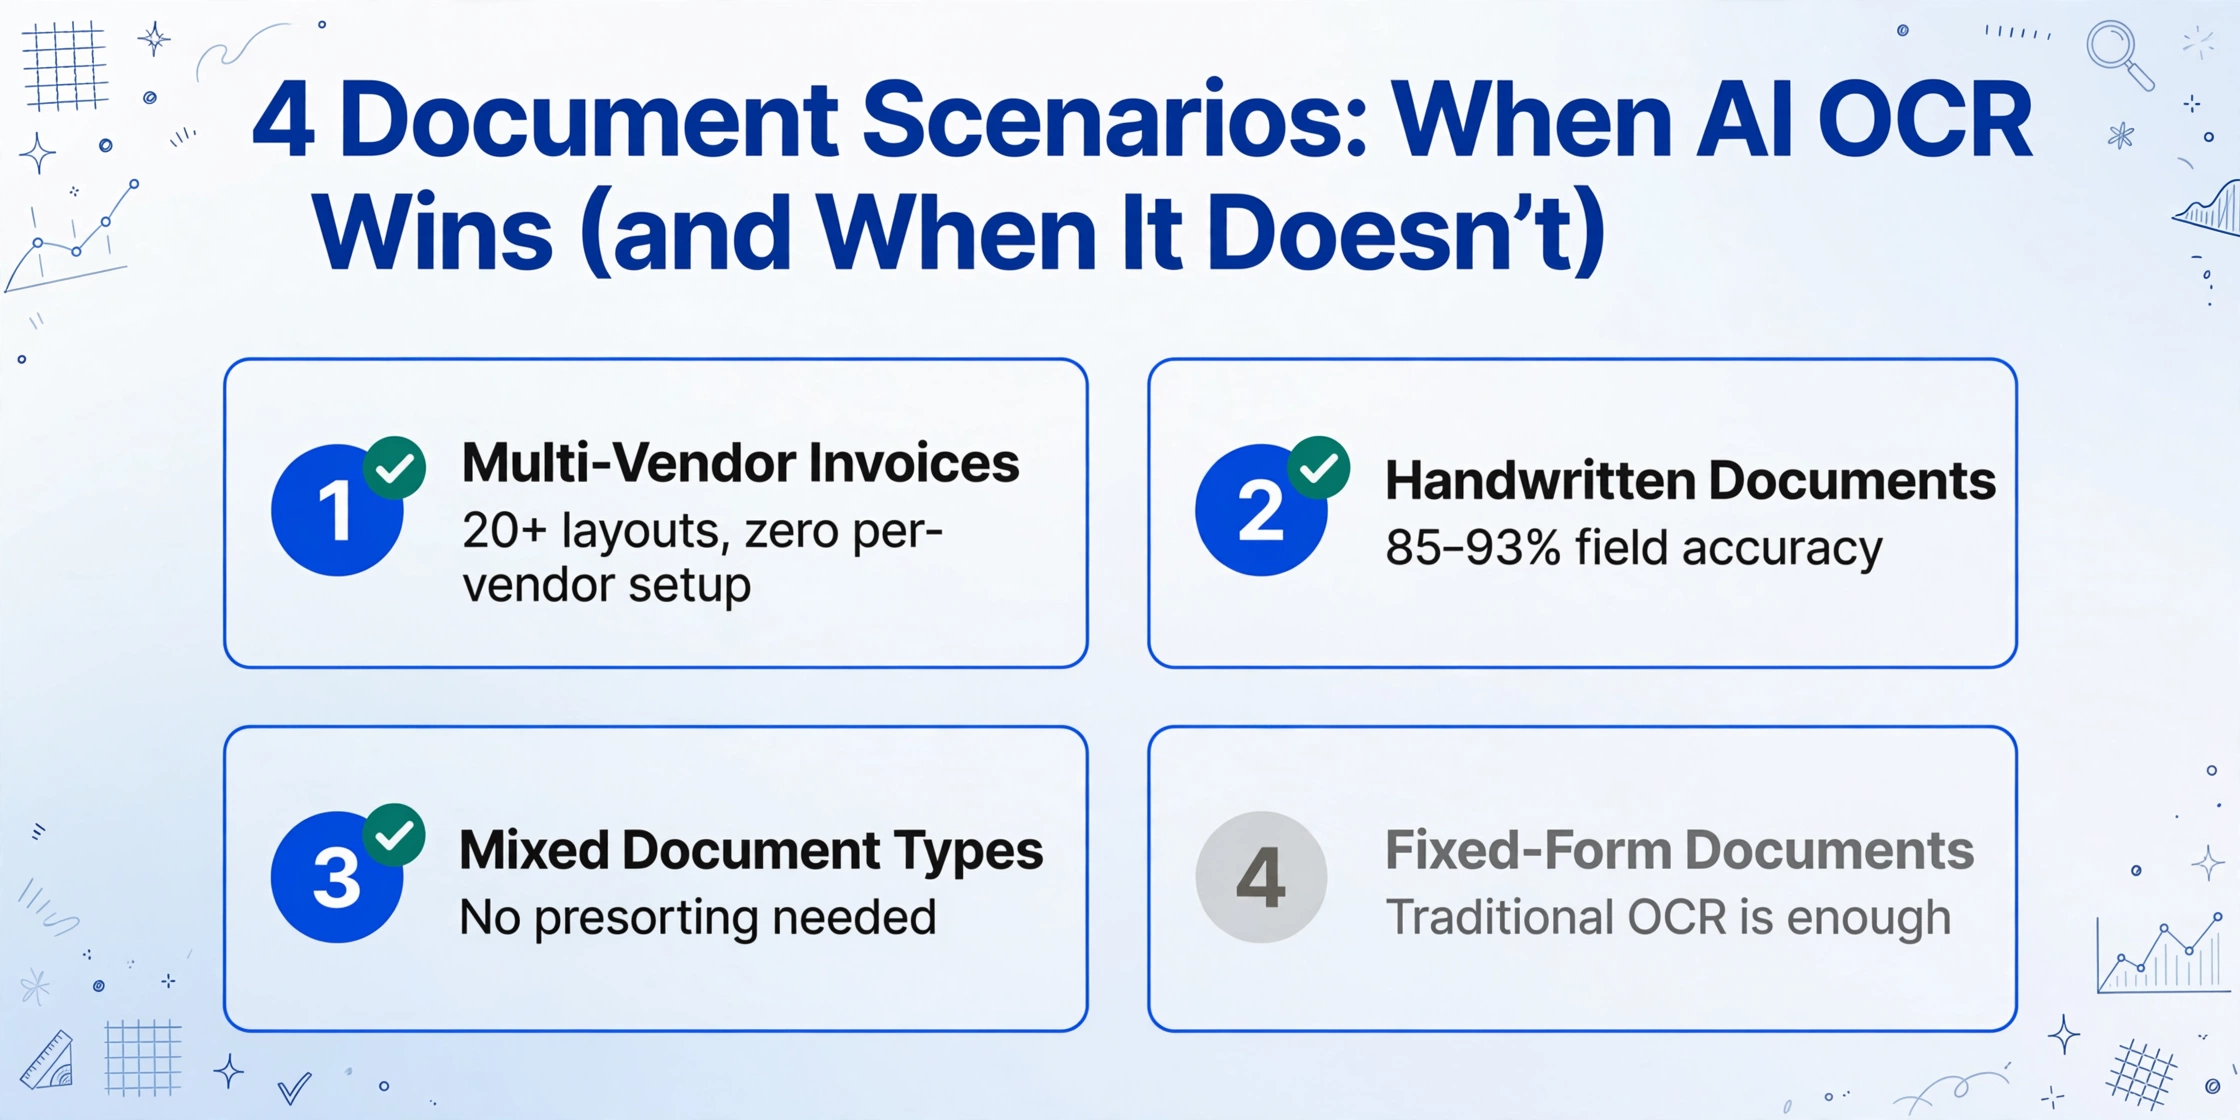
No toda tarea de procesamiento de documentos requiere AI OCR. Saber cuándo usar cada uno le ahorra tiempo y dinero.
Procesamiento de Facturas de Múltiples Proveedores
Usted recibe facturas de más de 20 proveedores, cada una con un diseño diferente. Algunos envían PDF, otros imágenes por correo electrónico, y otros usan un portal web que usted captura en pantalla. El OCR tradicional requiere una plantilla separada para cada formato — y cada rediseño las rompe. AI OCR las procesa todas sin configuración por proveedor. Este es el desencadenante más común.
Documentos Manuscritos o Semiestructurados
Informes de servicio en campo, recibos de entrega con firmas manuscritas, notas de preparación de almacén, listas de verificación de inspección. El OCR tradicional ve la escritura a mano como marcas aleatorias. AI OCR lee letra de molde y cursiva con una precisión de campo que la hace utilizable para entrada de datos — no perfecta, pero drásticamente mejor que el 50-70% que ofrece el OCR tradicional.
Tipos de Documentos Mixtos en un Solo Lote
Un solo lote de recopilación puede contener facturas, órdenes de compra, albaranes y confirmaciones de entrega — todos de remitentes diferentes y en formatos distintos. El OCR tradicional no puede manejar esto sin clasificación manual y plantillas separadas. AI OCR lee cada tipo de documento automáticamente y genera los campos relevantes, de modo que usted obtiene una tabla estructurada sin clasificación previa.
Cuándo el OCR Tradicional Es Suficiente
Si todos sus documentos son texto impreso limpio con el mismo diseño cada vez — un formulario gubernamental de formato fijo, un informe interno estandarizado — el OCR tradicional puede ser perfectamente adecuado. Usted está convirtiendo texto a texto digital, no extrayendo datos estructurados. AI OCR también funcionaría, pero si la velocidad y el costo por página son sus limitaciones, el OCR tradicional sigue siendo una opción viable en este escenario limitado.
Qué buscar en una herramienta de AI OCR
No todas las herramientas que se autodenominan "AI OCR" utilizan realmente modelos de visión y lenguaje. Algunas son OCR tradicional con un script que intenta adivinar las etiquetas de los campos después de la extracción. Esto es lo que distingue al AI OCR genuino del software heredado disfrazado.
Primero, extracción sin plantilla. Si la herramienta le pide definir zonas, dibujar cuadros alrededor de los campos o crear plantillas por proveedor, no es AI OCR — es OCR tradicional con una interfaz más vistosa. Una herramienta de AI OCR genuina extrae datos de cualquier diseño de documento sin configuración por formato. Esta es la característica innegociable que determina si la herramienta se adapta a sus documentos o si usted se adapta a la herramienta.
Segundo, reconocimiento semántico de campos. Suba la misma factura con dos diseños diferentes. Si la herramienta identifica correctamente el número de factura, el nombre del proveedor y el total en ambos, está utilizando comprensión semántica. Si acierta uno y falla el otro — o le exige indicarle dónde vive cada campo — está recurriendo a la extracción basada en posición. ImageToTable.ai utiliza lo que llama Extracción de Columnas Personalizadas: usted escribe los nombres de las columnas que desea (p. ej., "Número de factura", "Fecha de vencimiento", "Total"), y la IA localiza cada valor en cualquier diseño de documento comprendiendo qué significa, no dónde está. Este mismo enfoque está disponible como herramienta de software de AI OCR dedicada para equipos que necesitan procesar documentos a escala.
Tercero, procesamiento por lotes que preserva la estructura. El verdadero valor del AI OCR aparece cuando procesa 50 documentos a la vez y obtiene una sola tabla estructurada — no 50 resultados individuales que deba fusionar manualmente. Una herramienta diseñada para extracción por lotes debe fusionar los resultados en una sola hoja de cálculo automáticamente, con cada campo en su propia columna, del primer documento al último.
Cuarto, configuración sin entrenamiento. Algunas herramientas "IA" en realidad requieren que entrene un modelo subiendo 10 a 50 documentos de muestra y etiquetando manualmente los campos que desea extraer. Eso es aprendizaje automático, pero no es lo que "AI OCR" debería significar en 2026. Una verdadera herramienta de AI OCR debería funcionar desde su primera carga sin entrenamiento, sin muestras y sin configuración más allá de nombrar los campos que desea.
Para una comparación completa de cómo el AI OCR difiere de la extracción de documentos por IA y otras categorías de procesamiento de datos, consulte nuestro centro temático sobre extracción de documentos.
Preguntas Frecuentes
¿El OCR con IA es lo mismo que el procesamiento inteligente de documentos (IDP)?
No, aunque los términos suelen confundirse. El OCR con IA es la capa de lectura: convierte imágenes de texto en datos estructurados y etiquetados. El IDP es una categoría de plataforma más amplia que incluye OCR con IA, además de enrutamiento de flujos de trabajo, procesos de aprobación, integración con ERP y clasificación de documentos. El OCR con IA es una capacidad que utilizan las plataformas IDP, pero no toda herramienta de OCR con IA es una plataforma IDP.
¿El OCR con IA funciona con documentos escritos a mano?
Sí, con importantes salvedades. Los modelos modernos de lenguaje-visión pueden leer letra de imprenta con una precisión del 85-93% por campo, una mejora significativa frente al 50-70% del OCR tradicional. Sin embargo, la escritura cursiva y los estilos muy ornamentados siguen siendo un desafío. El OCR con IA funciona mejor con escritura a mano cuando el documento tiene una estructura clara (encabezados impresos con valores manuscritos, formularios con campos definidos). En páginas completamente libres, la precisión es menor y se requiere más revisión manual.
¿El OCR con IA procesa PDFs e imágenes, o solo documentos escaneados?
El OCR con IA procesa cualquier entrada visual que contenga texto: PDFs escaneados, PDFs nativos digitales (incluyendo los que tienen fuentes incrustadas), fotos de documentos tomadas con el móvil, capturas de pantalla e incluso capturas de páginas web. El modelo de lenguaje-visión trata todos como imágenes para leer, por lo que el formato del archivo original importa mucho menos que la calidad y claridad del texto.
¿Necesito saber programar para usar una herramienta de OCR con IA?
No, las herramientas modernas están diseñadas para usuarios de negocio. El flujo de trabajo típico es: subir un documento, escribir los nombres de las columnas que deseas extraer y descargar el resultado estructurado. Sin configuración de API, sin entrenamiento de modelos, sin diseño de plantillas. Algunas herramientas también ofrecen acceso a API para desarrolladores que quieran integrar la extracción en flujos personalizados, pero el caso de uso principal no requiere conocimientos técnicos.
¿Qué precisión tiene el OCR con IA en comparación con el OCR tradicional?
En documentos impresos limpios con diseños fijos, ambos alcanzan una alta precisión de caracteres (95-99%). La diferencia se amplía drásticamente cuando los documentos incluyen tablas complejas, múltiples columnas, escritura a mano o diseños variables. En lotes de facturas de múltiples proveedores, la precisión del OCR tradicional por campo cae al 40-60%, mientras que el OCR con IA mantiene un 85-99%. La diferencia no está en el reconocimiento de caracteres, sino en la identificación de campos: el OCR con IA identifica correctamente qué valor extraído pertenece a qué campo, lo que hace que el resultado sea utilizable sin necesidad de reubicación manual.