Was ist KI-Datenerfassung?
Strukturierte Daten, nicht nur OCR-Text
Nehmen Sie eine Rechnung. Lassen Sie sie durch OCR laufen. Sie erhalten Folgendes: Rechnung #INV-2024-0891 Datum: 15. März 2024 Gesamt: $4.230,50 Lieferant: Acme Corp. Ein Textblock. Um diese Daten in eine Tabelle zu bekommen, müssen Sie jedes Feld weiterhin markieren, kopieren und in die richtige Zelle einfügen – die OCR hat Ihnen die Datenerfassung nicht erspart. Sie hat den Text nur vom Papier auf den Bildschirm verschoben. Lassen Sie nun dieselbe Rechnung durch KI-Datenerfassung laufen. Sie erhalten vier Spalten – Rechnungsnummer, Datum, Gesamt, Lieferant – jeweils mit dem richtigen Wert, sofort verwendbar. Dasselbe Dokument. Ein völlig anderes Ergebnis. Das ist keine kleine Verbesserung gegenüber OCR. Es ist eine andere Kategorie von Werkzeug, und zu verstehen, warum, darum geht es in diesem Artikel.
Wichtigste Erkenntnisse
- OCR digitalisiert Text, übernimmt aber nie die eigentliche Datenerfassungsarbeit – jedes Feld sitzt weiterhin in einem undifferenzierten Textblock und wartet darauf, dass Sie jeden Wert von Hand in die richtige Tabellenzelle kopieren und einfügen.
- OCR liest Zeichen einzeln, ohne jegliches Verständnis ihrer Bedeutung. Deshalb kann es einen Dollar-Betrag in der Gesamt-Zeile nicht von derselben Zahl in einer Positionszeile unterscheiden – und deshalb frisst die manuelle Feldsuche auch nach der „Automatisierung“ weiterhin über 40 Stunden pro Monat.
- ImageToTable.ai schließt diese Lücke, indem es die gesamte Seite auf einmal liest, erkennt, dass ein mit „Rechnung #“ beschrifteter Wert in eine Spalte gehört und ein Wert namens „Gesamt“ in eine andere – bei jedem Layout, ohne Vorlagen oder Training.
Invoice Number | Date       | Due Date     | PO Number | Vendor Name          | Line Items
INV-2024-0891   | 2024-03-15 | 2024-04-14   | PO-77231  | Acme Industrial Supply | Hex Bolt M10 x200 @ $2.40 = $480.00
                |            |              |           |                      | Steel Washer M10 x500 @ $0.15 = $75.00
                |            |              |           |                      | Threaded Rod 1m x50 @ $12.80 = $640.00
Same document, same information — but now it's a spreadsheet. The invoice number is in the Invoice Number column, the date is in the Date column, and every line item is a row. No copying, no pasting, no manual reformatting. The data entry step is gone because the extraction step already did it.
How AI Data Entry Works Under the Hood
AI data entry tools like ImageToTable.ai use a vision language model (VLM) to read documents. A VLM is a type of AI trained on millions of images of documents paired with their structured data. When you upload a document, the model doesn't just see pixels — it sees the semantic structure: this is a header, this is a table, this is a total, this is a vendor name.
Here's the step-by-step process:
- Document ingestion. The document is converted to an image and fed to the VLM. The model processes the entire page at once, preserving the spatial layout.
- Semantic understanding. The model identifies what each region of the page represents — a field label, a value, a table header, a line item — based on context and meaning, not fixed coordinates.
- Column mapping. The model matches each identified value to the column names you specified. If you asked for "Invoice Number", it finds the value that semantically corresponds to an invoice number, regardless of where it appears on the page.
- Structured output. The matched values are written into a table with your column names as headers. Each document becomes one row (or multiple rows for line items), and the batch becomes a complete spreadsheet.
This is fundamentally different from template-based extraction, which relies on positional rules: "the invoice number is always 200 pixels from the top-left corner." If the layout changes, the rule breaks. Custom Column Extraction has no such dependency — it works on any layout because it understands meaning, not position.
What AI Data Entry Cannot Do (Yet)
It's worth being honest about the limits. AI data entry is not magic, and knowing its boundaries helps you use it correctly.
- It cannot read handwriting reliably. If your documents contain handwritten notes, expect errors. The model is trained primarily on printed text.
- It cannot interpret ambiguous fields. If a document has two dates and you ask for "Date", the model may pick the wrong one. You need to be specific: "Invoice Date" vs. "Due Date".
- It cannot perform calculations. If you need a computed total that isn't on the document, you'll need to use Computed Columns to add it after extraction.
- It cannot handle extremely poor image quality. Blurry scans, heavily skewed pages, or low-resolution photos will degrade accuracy. A clean scan or PDF works best.
These limitations are why the best workflow combines AI extraction with human review — which is exactly what ImageToTable.ai's Annotate on Image feature enables. You can visually verify and correct any field directly on the document image before exporting.
When AI Data Entry Makes Sense (and When It Doesn't)
AI data entry is the right tool for a specific set of problems. Here's a practical breakdown:
| Use it when | Skip it when |
|---|---|
| You process documents from many different vendors or layouts | You process a single, perfectly stable layout and volume is extremely high |
| You need structured data (columns, rows) ready for analysis or import | You only need searchable text (OCR is sufficient) |
| You want to add new document types without building templates | You have strict latency requirements and need sub-second responses |
| Your documents are mostly clean, printed text | Your documents are mostly handwritten or extremely poor quality |
The general rule: if your documents vary in layout and you need structured output, AI data entry is the right choice. If your documents are identical and you just need text, OCR is simpler and cheaper.
Getting Started with AI Data Entry
If you're ready to try AI data entry, here's a practical starting point:
- Start with a small batch. Upload 10–20 representative documents — not just the cleanest ones, but the range of layouts you actually receive.
- Define your columns carefully. Use the exact field names you want in your output. Be specific: "Invoice Date" not "Date", "Vendor Name" not "Name".
- Review the first results. Use Annotate on Image to check every field on every document. Correct any errors — the model learns from corrections within the session.
- Export and verify. Export to Excel or CSV, spot-check the totals, and confirm the data matches your source documents.
- Scale up. Once you're confident, process your full batch. With Batch Export, you can handle thousands of documents in one run.
AI data entry is not a futuristic concept — it's a working tool that's already replacing manual data entry in accounting, logistics, healthcare, and finance. The question isn't whether it works. It's whether you're still doing the work it can do for you.
| Rechnungsnummer | Datum | Fälligkeitsdatum | Bestellnummer | Lieferantenname | Zwischensumme | Steuer | Versand | Gesamtsumme |
|---|---|---|---|---|---|---|---|---|
| INV-2024-0891 | 2024-03-15 | 2024-04-14 | PO-77231 | Acme Industrial Supply | $1.195,00 | $104,56 | $45,00 | $1.344,56 |
Jedes Feld wurde der richtigen Spalte zugeordnet. Positionen wurden in eigenen Zeilen extrahiert. Daten wurden in ein einheitliches Format standardisiert. Kein Kopieren und Einfügen. Kein manuelles Suchen von Feldern. Der Unterschied liegt nicht in der Geschwindigkeit – obwohl KI deutlich schneller ist –, sondern darin, dass die Ausgabe bereits strukturiert ist. Die OCR-Ausgabe erfordert einen zweiten Schritt (manuelle Datenerfassung), bevor sie nutzbar ist. Die Ausgabe der KI-Datenerfassung ist sofort nutzbar.
Die EY-Studie aus dem Jahr 2025 ergab, dass eine einzige manuelle HR-Datenerfassungsaufgabe Unternehmen heute durchschnittlich $4,86 kostet – gegenüber $4,39 im Jahr 2018, mit steigender Tendenz jedes Jahr. Bei Tausenden von Dokumenten summiert sich die Kluft zwischen „OCR hat den Text digitalisiert“ und „KI hat die Daten strukturiert“ zu erheblichen operativen Kosten.
Wie KI Dokumente liest: Vision trifft Sprache
OCR arbeitet Zeichen für Zeichen. Es betrachtet ein Muster aus dunklen und hellen Pixeln, gleicht es mit einer Bibliothek bekannter Formen ab und gibt den nächstliegenden Buchstaben aus. Deshalb kann OCR „rn“ erzeugen, wenn es „m“ lesen wollte – es trifft Entscheidungen auf Zeichenebene, ohne Bewusstsein für das Wort, geschweige denn für die Struktur des Dokuments. Wenn OCR auf eine Tabelle mit zusammengeführten Zellen stößt, liest es Zeile für Zeile und verliert die Spaltenbeziehungen vollständig.
KI-Datenerfassung verwendet Vision-Language-Modelle (VLMs) – eine Klasse von KI, die Dokumente so verarbeitet, wie es ein Mensch tut: indem sie die gesamte Seite auf einmal betrachtet. Ein VLM analysiert gleichzeitig drei Informationsebenen:
Visuelles Layout.
Wo ist jedes Element positioniert? Befindet es sich in einem Kopfbereich, einer Tabelle, einem Fußbereich? Ist dieser Text fett, eingerückt oder in einer umrandeten Box? Das Modell versteht die Dokumentstruktur – nicht nur, wie die Pixel aussehen, sondern auch, wie die Seite organisiert ist.
Textinhalt.
Was sagt der Text? Das Modell liest Zeichen, Wörter und Zahlen – aber anders als OCR liest es sie im Kontext ihrer Position auf der Seite und ihrer Beziehung zu benachbarten Elementen.
Semantische Bedeutung.
Was repräsentiert jedes Datenelement? Eine Zahl in der oberen rechten Ecke neben dem Wort „Rechnungsnr.“ ist eine Rechnungsnummer. Eine fette Zahl in der unteren rechten Ecke neben „Gesamt“ ist der fällige Betrag. Das Modell verbindet visuelle Position mit semantischer Rolle – es liest nicht nur „INV-2024-0891“, sondern versteht, dass dies die Rechnungskennung ist.
Diese drei Ebenen – Layout, Inhalt und Bedeutung – werden gemeinsam verarbeitet, nicht nacheinander. Wenn die KI einen Dollar-Betrag in der Zeile „Gesamt“ am Ende einer Rechnung sieht, muss sie nicht erst entscheiden „ist das Text oder eine Zahl?“ und dann „was bedeutet diese Zahl?“ als getrennte Schritte. Sie versteht das Gesamtbild auf einmal: Dies ist ein Geldwert, er befindet sich am Ende des Dokuments, er ist mit „Gesamt“ beschriftet und ist wahrscheinlich die Summe aller darüber liegenden Positionen. Die Ausgabe ist ein Wert mit einer semantischen Beschriftung, nicht nur eine Zeichenfolge von Ziffern.
Das ist es, was gemeint ist, wenn man sagt, KI „versteht Kontext“. Das ist keine Magie – es sind Modelle, die auf Millionen von Dokumenten trainiert wurden und gelernt haben, dass eine Zahl unter einer Spalte von Zahlen und neben dem Wort „Gesamt“ eine bestimmte Bedeutung hat, die eine Zahl in der Mitte einer Positionstabelle nicht hat.
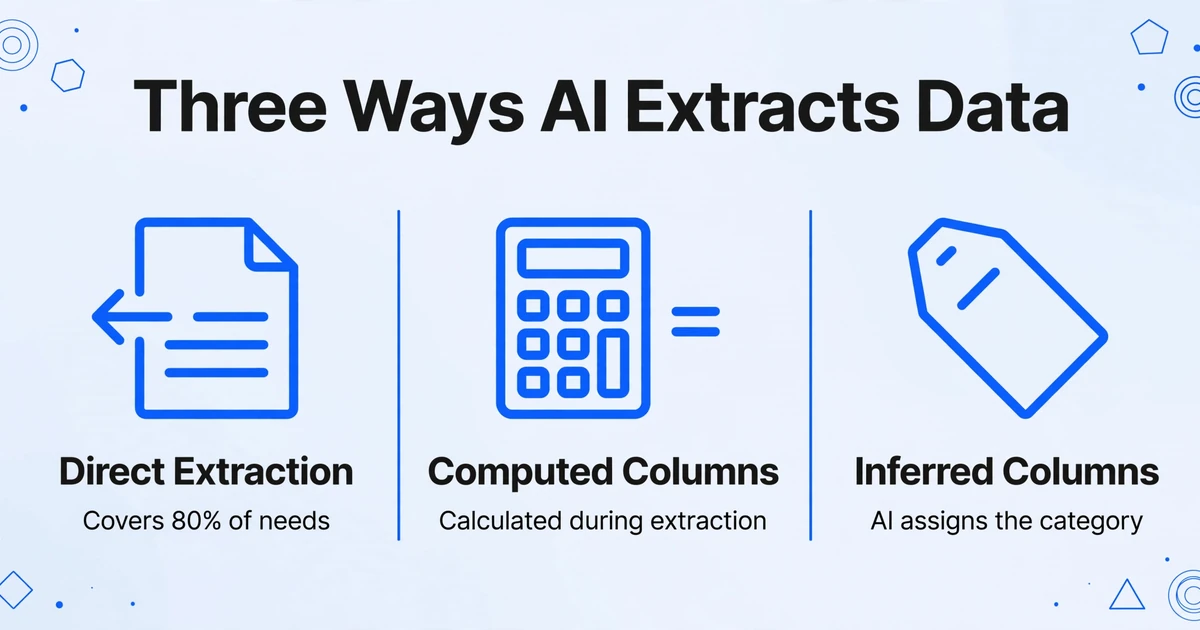
Drei Möglichkeiten, wie KI Daten aus einem Dokument extrahiert
Nicht jede Extraktion ist gleich. Die KI-Datenerfassung arbeitet in drei verschiedenen Modi, die jeweils ein anderes Problem lösen. Zu verstehen, welcher Modus für welches Feld gilt, unterscheidet eine funktionierende Extraktion von einer, die unvollständige Ergebnisse liefert.
Direkte Extraktion – wenn die Daten auf der Seite gedruckt sind
Dies ist der unkomplizierteste Modus: Das gewünschte Feld ist sichtbar auf dem Dokument vorhanden. Eine Rechnung hat ein gedrucktes Datum. Eine Quittung hat einen Gesamtbetrag. Ein Auftrag hat einen Lieferantennamen. Die KI lokalisiert den Wert, indem sie seine semantische Rolle versteht, und platziert ihn in der richtigen Spalte.
Die direkte Extraktion deckt etwa 80 % dessen ab, was die meisten Menschen bei der Dokumentenverarbeitung benötigen. Sie verarbeitet gedruckten Text, Tabellen mit klaren Spalten und Felder an vorhersehbaren Positionen – selbst wenn diese Positionen je nach Layout variieren. Da die KI keine feste Koordinate abgleicht, werden ein Datum in der oberen rechten Ecke einer Rechnung und ein Datum in der unteren linken Ecke einer anderen Rechnung beide korrekt der Spalte „Datum“ zugeordnet.
Berechnete Spalten – wenn die Antwort nicht geschrieben ist, aber die Zutaten vorhanden sind
Manchmal ist die benötigte Zahl nirgendwo auf dem Dokument gedruckt – aber die Komponenten zu ihrer Berechnung sind es. Hier kommen Berechnete Spalten ins Spiel. Anstatt einen Wert zu extrahieren, führt die KI während der Extraktion eine Berechnung durch und fügt das Ergebnis in Ihre Tabelle ein.
Ein Auftrag könnte beispielsweise eine Menge von 200 und einen Stückpreis von $2.40 auflisten, aber nirgendwo steht „Positionssumme: $480.00“. Mit Berechneten Spalten definieren Sie eine Spalte namens Positionssumme (Menge × Stückpreis). Die KI extrahiert die beiden Quellwerte, führt die Multiplikation durch und gibt $480.00 aus – alles in einem einzigen Durchgang. Keine Formelarbeit nach der Extraktion in Excel erforderlich.
Berechnete Spalten unterstützen zeilenweise Arithmetik, spaltenübergreifende Aggregation (Summierung aller Positionszeilen in einem Abschnitt), bedingte Logik (Kennzeichnung, wenn berechnete Summen nicht mit der gedruckten Summe übereinstimmen) und feste Parameterreferenzen (Einbettung eines Steuersatzes, der für alle Dokumente in einem Batch gilt). Die Berechnung erfolgt während der Extraktion, sodass Ihre Ausgabe gebrauchsfertige Antworten sind – keine Rohdaten, die Sie noch verarbeiten müssen.
Abgeleitete Spalten – Wenn die KI ergänzt, was nicht da ist
Der dritte Modus löst ein Problem, das OCR und vorlagenbasierte Tools nicht angehen können: Was, wenn die benötigte Information gar nicht auf dem Dokument steht? Abgeleitete Spalten lassen die KI ein Dokument lesen und eine Entscheidung darüber treffen, welche Kategorie, welches Tag oder welche Kennzeichnung zutrifft – und tragen das dann in Ihre Tabelle ein.
Ein klassisches Beispiel ist die Ausgabenkategorisierung. Eine Quittung aus einem Restaurant sagt nicht „Kategorie: Verpflegung“. Aber Sie müssen Ausgaben für die Steuererklärung sortieren. Mit Abgeleiteten Spalten definieren Sie eine Spalte namens Kategorie (Optionen: Verpflegung/Transport/Büro/Sonstiges). Die KI liest jede Quittung – eine Mittagsquittung aus einem Sushi-Restaurant, eine Tankstellenquittung, eine Staples-Quittung – und bestimmt die richtige Kategorie für jede. Das Ergebnis ist eine Tabelle, in der jeder Zeile bereits ihre Kategorie zugewiesen ist. Extraktion und Klassifizierung erfolgen in einem einzigen Durchgang.
Abgeleitete Spalten funktionieren bei jedem Dokumenttyp gleich: Eilaufträge aus Lieferscheinen kennzeichnen, Währungstyp aus internationalen Rechnungen erkennen, Dokumentuntertyp aus Versicherungszertifikaten identifizieren. Die KI liest den Dokumentinhalt und trifft eine strukturierte Schlussfolgerung – etwas, das OCR ohne semantisches Verständnis nicht kann.
Was das im Alltag bedeutet
Die drei Extraktionsmodi führen zu einer einzigen operativen Änderung: Sie müssen dem Tool nicht mehr beibringen, wie Ihre Dokumente aussehen. Sie beschreiben, was Sie daraus gewinnen möchten.
In einem vorlagenbasierten OCR-Workflow bedeutet das Hinzufügen eines neuen Lieferantenrechnungsformats: den Vorlageneditor öffnen, Zonen um jedes Feld ziehen, gegen ein Muster testen und hoffen, dass sich die Zonen bei der nächsten Rechnung nicht verschieben. Multiplizieren Sie das mit 20 Lieferanten, und Sie verbringen mehr Zeit mit der Pflege von Vorlagen, als Sie für die manuelle Eingabe gebraucht hätten. Mit KI-Datenerfassung geben Sie Ihre Spaltennamen einmal ein. Sie funktionieren über jedes Layout hinweg, das die KI antrifft – weil die KI das Dokument versteht, statt Koordinaten zu messen.
Die Stapelverarbeitung geht noch weiter. Laden Sie 50 Rechnungen von 15 verschiedenen Lieferanten hoch. Geben Sie Ihre Spaltennamen einmal ein. Die KI verarbeitet alle 50, identifiziert jedes Feld über jede Layoutvariation hinweg und exportiert eine einzige Tabelle mit 50 Zeilen – eine pro Rechnung – mit jedem Feld in der richtigen Spalte. Was früher ein Nachmittag manueller Eingabe war, wird zu wenigen Minuten aus Hochladen und Prüfen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Für einen breiteren Überblick darüber, wie sich KI-Extraktion mit traditionellen Ansätzen der Dokumentenverarbeitung vergleicht, behandelt unsere Einführung in Datenextraktionssoftware die gesamte Kategorielandschaft. Und wenn Sie Tools evaluieren, führt Sie das Evaluierungsframework durch die Kriterien, die produktionsreife Extraktion von Demos unterscheiden, die nur mit einem Beispieldokument funktionieren.
Was KI-Datenerfassung gut kann
KI-Datenerfassung verarbeitet jedes Dokument, in dem strukturierte Informationen in einem visuellen Layout vorhanden sind. Die häufigsten Anwendungen konzentrieren sich auf einige Dokumenttypen mit hohem Volumen.
Rechnungsverarbeitung. Der Hauptanwendungsfall. Rechnungen verschiedener Lieferanten haben radikal unterschiedliche Layouts, teilen aber dieselbe semantische Struktur: Lieferantenname, Rechnungsnummer, Datum, Positionen, Summen. KI liest über Layouts hinweg und macht es praktikabel, Rechnungsfelder nach Excel zu extrahieren, ohne für jeden Lieferanten eine Vorlage zu erstellen. Gartner prognostiziert, dass bis 2030 bis zu 80 % der B2B-Rechnungen weltweit automatisch verarbeitet werden – eine Prognose, die genau die hier beschriebene layoutunabhängige Extraktion voraussetzt.
Belegscannen. Belege sind der schwierigste Dokumenttyp für vorlagenbasierte OCR: Jedes Geschäft druckt ein anderes Format, viele sind thermisch bedruckt und verblasst, und sie kommen oft als Handyfotos in seltsamen Winkeln an. KI-Datenerfassung konvertiert Belege in strukturierte Tabellenzeilen, indem sie das Layout des Belegs visuell versteht – und Händlername, Datum, Summe und Positionen unabhängig vom Format identifiziert.
Kontoauszugsabstimmung. Kontoauszüge stellen eine besondere Herausforderung dar: mehrseitige PDFs mit Transaktionstabellen, die sich über Spalten und Seitenumbrüche erstrecken, Soll- und Habenspalten, die sich manchmal überlappen, und laufende Salden, deren Integrität gewahrt bleiben muss. KI-Datenerfassung konvertiert Kontoauszüge nach Excel und bewahrt dabei die Transaktionsstruktur – jede Zeile ist eine Transaktion, jede Spalte ein Feld – sodass die Abstimmung in Ihrer Tabelle erfolgen kann, statt einen Papierauszug mit einem Bildschirm abzugleichen.
Formularverarbeitung. Papierformulare – Bewerbungen, Patientenaufnahmebögen, Umfrageantworten – kommen in Stapeln mit konsistenten Fragen, aber stark uneinheitlicher Handschrift, Kontrollkästchen und Ausfüllmustern an. KI liest die Formularstruktur und extrahiert jedes Feld in eine Spalte, digitalisiert Formulardaten ohne Einrichtung pro Formular.
Handschriftliche Dokumente. Moderne KI-Datenerfassung verarbeitet lesbare Handschrift – ausgefüllte Formulare, Lieferscheine mit handschriftlichen Unterschriften und Mengen, Stundenzettel mit handschriftlich eingetragenen Stunden. Die Genauigkeit bei Handschrift ist geringer als bei gedrucktem Text (mehr dazu im Abschnitt zu Einschränkungen), aber bei strukturierten Formularen, bei denen der handschriftliche Inhalt auf bekannte Felder beschränkt ist, sind die Ergebnisse für viele Anwendungsfälle produktionsreif. Unser Leitfaden zur Handschrifterkennung für die Datenextraktion behandelt die Details.
Womit KI-Datenerfassung weiterhin zu kämpfen hat
KI-Datenerfassung ist kein gelöstes Problem. Es gibt Dokumenttypen und Bedingungen, bei denen die Genauigkeit unter das für eine unbeaufsichtigte Automatisierung akzeptable Niveau fällt. Diese Einschränkungen klar zu benennen, ist wichtig – es macht den Unterschied zwischen einem Workflow, der funktioniert, und einem, der ein neues Bereinigungsproblem schafft.
Extrem schlechte Scanqualität. Dokumente, die stark verblasst sind, bei schlechtem Licht mit Bewegungsunschärfe fotografiert oder mit sehr niedriger Auflösung (unter 150 DPI) gescannt wurden, verschlechtern die Extraktionsgenauigkeit. Die KI kann moderate Qualitätsprobleme ausgleichen – leichte Unschärfe, Kippung, ungleichmäßige Beleuchtung – aber wenn Zeichen für einen menschlichen Leser wirklich mehrdeutig werden, hat auch die KI Schwierigkeiten. Konfidenzbewertungen (bei denen die KI Felder mit geringer Sicherheit zur menschlichen Überprüfung kennzeichnet) mildern dies, beseitigen es aber nicht.
Sich überlappender handschriftlicher Text. Wenn Handschrift klar und getrennt ist, verarbeitet moderne KI sie gut. Wenn sich Zeichen überlappen – eine hastig geschriebene Korrektur, die zwischen zwei Zeilen gequetscht ist, ein Durchstreichen mit neuem Text darüber – sinkt die Genauigkeit stark. Das Modell muss entscheiden, wo ein Zeichen endet und ein anderes beginnt, und ab einem gewissen Überlappungsgrad wird diese Entscheidung selbst für einen Menschen zum Raten.
Dokumente, in denen Daten rein visuell oder grafisch sind. Wenn ein Dokument Informationen ausschließlich über Diagramme, Schaubilder ohne Datentabellen oder farbcodierte Karten ohne Textbeschriftungen vermittelt, hat die KI-Datenerfassung nichts zu extrahieren. Die KI liest Text und Layout – sie interpretiert nicht die Höhe eines Balkendiagramms in einen Zahlenwert oder entschlüsselt eine Farblegende in Kategorien. Bei Dokumenten, die Text und Visuals mischen (ein Bericht mit sowohl einer Datentabelle als auch einem Diagramm), ist die Tabelle extrahierbar; das Diagramm in der Regel nicht.
Extreme Schreibschrift und nicht standardisierte Handschrift. Saubere Handschrift auf einem strukturierten Formular ist machbar. Schnelle Schreibschrift mit stark stilisierten Buchstabenformen – wie sie in einigen medizinischen Rezepten oder alten handschriftlichen Registern vorkommt – bleibt eine Herausforderung. Die Lücke schließt sich, da die Modelle besser werden, aber Mitte 2026 liefert stark stilisierte Schreibschrift weiterhin unzuverlässige Ergebnisse, die eine menschliche Überprüfung erfordern.
Mehrseitige Tabellen mit komplexer Spannenlogik. Wenn sich eine Tabelle über drei Seiten erstreckt, mit verbundenen Zellen, geteilten Zeilen und Zwischensummen, die auf Werte einer vorherigen Seite verweisen, verliert selbst KI den Faden. Moderne VLMs verarbeiten einfache mehrseitige Kontinuität gut, aber komplexe Spannenlogik – bei der die Beschreibung einer einzelnen Position über zwei Seiten läuft und ihre Menge auf einer dritten steht – erzeugt weiterhin in einem nennenswerten Prozentsatz der Fälle Fehler.
Die ehrliche Zusammenfassung: KI-Datenerfassung verarbeitet die 80 % der Dokumente, die sauber, lesbar und strukturell klar sind, mit hoher Genauigkeit (bis zu 99 % für gedruckte Tabellendaten). Sie verarbeitet die nächsten 15 % – moderate Qualitätsprobleme, leichte Handschrift, einfache mehrseitige Tabellen – mit einer Genauigkeit, die noch brauchbar ist, aber möglicherweise stichprobenartige Kontrollen erfordert. Die letzten 5 % – die sich überlappende Handschrift, die stark degradierten Scans, die rein grafischen Dokumente – benötigen weiterhin menschliche Aufmerksamkeit. Unser Genauigkeitsvergleich der Extraktionstools bietet detaillierte Benchmarks für spezifische Dokumenttypen.
Häufig gestellte Fragen
Ist KI-Datenerfassung dasselbe wie OCR?
Nein. OCR wandelt Bilder von Text in digitale Textzeichen um – es liest Buchstaben. KI-Datenerfassung versteht, was diese Buchstaben im Kontext bedeuten, und ordnet sie strukturierten Spalten zu. OCR liefert eine Textdatei. KI-Datenerfassung liefert eine Tabelle. OCR ist eine Komponente, die KI-Datenerfassungssysteme verwenden können, aber für sich genommen führt OCR keine Strukturierung oder Verständnis durch.
Muss ich die KI mit meinen Dokumenten trainieren?
Nein. Moderne KI-Datenerfassungstools, die Vision-Language-Modelle verwenden, funktionieren sofort mit Dokumenten, die sie noch nie gesehen haben. Sie laden keine Trainingsbeispiele hoch, kennzeichnen keine Felder oder konfigurieren Vorlagen. Sie geben die gewünschten Spaltennamen ein, laden Ihre Dokumente hoch, und die KI extrahiert die Daten, indem sie das Dokument visuell und semantisch versteht – nicht durch Abgleich mit einem Muster aus früheren Beispielen. Zum Vergleich: Ältere Machine-Learning-Ansätze erforderten Hunderte gekennzeichneter Dokumente pro Format; neuere VLM-basierte Tools benötigen null.
Welche Dokumentformate unterstützt die KI-Datenerfassung?
PDFs (sowohl native als auch gescannte), JPEG, PNG, WebP, AVIF und Webseiten-Screenshots. Die KI verarbeitet jedes Bild oder Dokument, das Sie hochladen – die Quelle muss keine saubere digitale Datei sein. Ein Foto einer Quittung, das mit dem Telefon aufgenommen wurde, funktioniert genauso wie ein PDF, das von Buchhaltungssoftware erzeugt wurde. Für einen detaillierten Vergleich der Formatunterstützung verschiedener Tools, siehe unser Evaluierungs-Framework.
Wie genau ist KI-Datenerfassung im Vergleich zur manuellen Erfassung?
Bei gedruckten Tabellendaten erreicht die KI-Extraktion eine Genauigkeit von bis zu 99 %. Die manuelle Datenerfassung liegt typischerweise bei 96–98 % und nimmt mit Ermüdung, Mengendruck und ungewohnten Dokumentformaten ab. Bei 1.000 Dokumenten pro Monat beträgt der Unterschied etwa 10–40 Fehler (manuell) gegenüber weniger als 10 (KI). Eine einzelne Seite, die manuell 3 Minuten dauert, wird mit KI in 5–10 Sekunden verarbeitet – ein Effizienzgewinn von über 18x. Die Genauigkeit hängt jedoch stark von der Dokumentqualität ab: Ein sauberer, gut beleuchteter Scan einer gedruckten Rechnung erreicht nahezu perfekte Genauigkeit; ein verblasstes, niedrig aufgelöstes Foto einer handschriftlichen Quittung wird geringer ausfallen.
Kann KI-Datenerfassung Handschrift lesen?
Ja, aber mit Einschränkungen. Lesbare Handschrift auf strukturierten Formularen (ein gedrucktes Formular, das von Hand ausgefüllt wurde) wird von moderner KI gut verarbeitet – die Struktur des Formulars liefert Kontext, der dem Modell hilft, den handschriftlichen Inhalt zu interpretieren. Freie handschriftliche Notizen, schnelle Schreibschrift und überlappende Handschrift führen zu weniger zuverlässigen Ergebnissen. Wenn Ihr Anwendungsfall stark handschriftliche Dokumente umfasst, sollten Sie die Ergebnisse überprüfen, anstatt sie direkt durchzuverarbeiten. Weitere Details finden Sie in unserem Leitfaden zur Handschrifterkennung.
Was kostet KI-Datenerfassung im Vergleich zu herkömmlicher OCR?
KI-Datenerfassungstools sind in der Regel abonnementbasiert mit Preisstufen pro Seite oder pro Dokument. Herkömmliche OCR-Tools sind auf Basisebene oft günstiger, erfordern jedoch zusätzliche Investitionen in Vorlageneinrichtung, Wartung und die manuelle Arbeit zur Strukturierung des von ihnen ausgegebenen Rohtexts. Der Kostenunterschied liegt selten allein im Softwarepreis – es geht um die gesamten Betriebskosten, einschließlich der Zeit für die Datenaufbereitung nach der Extraktion. Unser Kostenvergleich zwischen kostenloser OCR und KI-Extraktion und die Übersicht der Preislandschaft 2026 behandeln dies im Detail.
Was passiert mit meinen Dokumenten nach der Verarbeitung?
Das hängt vom Anbieter ab. Seriöse Tools verarbeiten Dokumente, extrahieren die Daten und verwerfen die Originaldateien – sie speichern Ihre Dokumente nicht und trainieren nicht mit ihnen. Prüfen Sie vor dem Hochladen sensibler Dokumente immer die Datenverarbeitungsrichtlinie des Anbieters. Achten Sie auf ausdrückliche Zusagen zur Dateilöschung, zum Verzicht auf Training mit Benutzerdaten und zur Verschlüsselung während der Übertragung und im Ruhezustand.
KI-Datenerfassung verändert, was bei der Dokumentenverarbeitung möglich ist – nicht indem sie dasselbe schneller erledigt, sondern indem sie etwas völlig anderes tut. Die Frage ist nicht, ob sie besser als OCR ist. Es ist die Frage, ob die Dokumente, die Sie täglich verarbeiten, strukturiert genug für KI sind und ob die eingesparte Zeit mehr wert ist als die Kosten des Tools. Der einzige Weg, das herauszufinden, ist, es mit Ihren eigenen Dokumenten auszuprobieren.