¿Qué es la captura de datos con IA?
Datos estructurados, no solo texto OCR
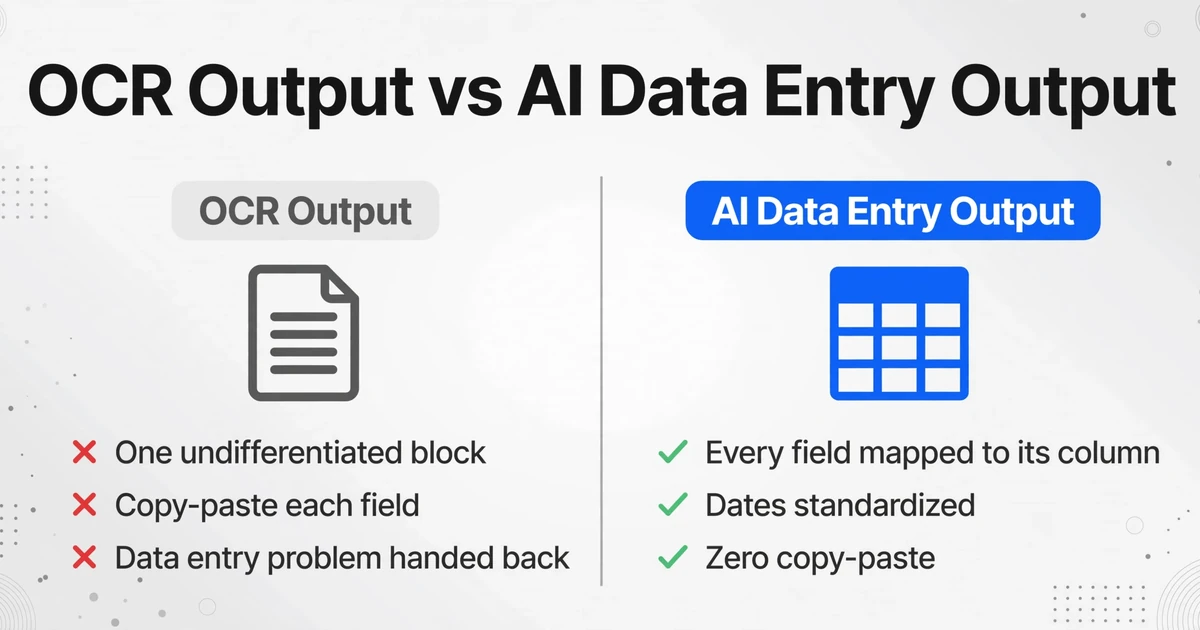
Tome una factura. Pásala por OCR. Obtiene esto: Factura #INV-2024-0891 Fecha: 15 de marzo de 2024 Total: $4,230.50 Proveedor: Acme Corp. Un muro de texto. Para llevar esos datos a una hoja de cálculo, aún debe resaltar cada campo, copiarlo y pegarlo en la celda correcta: el OCR no le ahorró la captura de datos. Solo movió el texto del papel a la pantalla. Ahora pase la misma factura por la captura de datos con IA. Obtiene cuatro columnas — Número de Factura, Fecha, Total, Proveedor — cada una con el valor correcto, listas para usar. El mismo documento. Un resultado completamente diferente. Esto no es una mejora menor sobre el OCR. Es una categoría de herramienta distinta, y entender por qué es el tema de este artículo.
Conclusiones clave
- El OCR digitaliza texto pero nunca toca el trabajo real de captura de datos: cada campo sigue en un bloque de texto indiferenciado, esperando que copie y pegue cada valor en la celda correcta de la hoja de cálculo manualmente.
- El OCR lee caracteres uno a uno sin entender su significado, por eso no puede distinguir un monto en dólares en la fila Total del mismo número en una partida — y por eso la búsqueda manual de campos sigue consumiendo más de 40 horas al mes después de la "automatización".
- ImageToTable.ai cierra esta brecha leyendo toda la página de una vez, reconociendo que un valor etiquetado como "Factura #" pertenece a una columna y un valor llamado "Total" pertenece a otra — en cualquier diseño, sin plantillas ni entrenamiento.
Qué significa realmente la captura de datos con IA
La captura de datos con IA es un software que lee un documento, comprende qué significa cada dato y lo coloca en la columna correcta de una hoja de cálculo, automáticamente. A diferencia del OCR, que convierte imágenes de texto en caracteres digitales, la captura de datos con IA produce resultados estructurados: filas y columnas donde el Número de Factura está en la columna de Número de Factura, la Fecha está en la columna de Fecha y el Total está en la columna de Total, en todos los documentos de un lote.
El mecanismo que lo hace posible es la Extracción de Columnas Personalizadas: en lugar de programar reglas de extracción o dibujar recuadros alrededor de campos en una plantilla, usted escribe los nombres de las columnas que desea — "Número de Factura", "Fecha de Vencimiento", "Nombre del Proveedor", "Total por Línea" — y la IA localiza cada valor en cualquier parte de la página comprendiendo su significado semántico, no mediante una posición fija. Los nombres de columna que escribe se convierten en los encabezados de su hoja de cálculo final. Ese es el cambio fundamental: usted describe el resultado, no la entrada.
Esta distinción importa porque cambia quién puede usar la herramienta. La extracción basada en plantillas requiere que alguien cree y mantenga plantillas para cada diseño de documento que llegue. La Extracción de Columnas Personalizadas funciona igual si procesa 50 facturas de un proveedor o 50 facturas de 50 proveedores diferentes con diseños completamente distintos.
Idea clave: el OCR digitaliza caracteres. La captura de datos con IA estructura la información. Uno produce texto con el que aún debe trabajar. La otra produce una hoja de cálculo que ya puede usar.
Por qué el OCR por sí solo nunca fue captura de datos
Para entender qué hace diferente la captura de datos con IA, conviene ver la brecha que el OCR siempre ha dejado. Aquí hay una factura real, procesada de ambas maneras.
Resultado del OCR — lo que obtiene de una herramienta OCR tradicional aplicada a una factura estándar de proveedor:
INVOICE
Acme Industrial Supply
451 Commerce Drive, Suite 200
Chicago, IL 60607
Invoice #INV-2024-0891
Date: March 15, 2024
Due Date: April 14, 2024
PO Number: PO-77231
Item | Qty | Unit Price | Total
Hex Bolt M10 | 200 | $2.40 | $480.00
Steel Washer M10 | 500 | $0.15 | $75.00
Threaded Rod 1m | 50 | $12.80 | $640.00
Subtotal: $1,195.00
Tax (8.75%): $104.56
Shipping: $45.00
Total: $1,344.56
Todo está ahí. Los caracteres son correctos. Pero es un bloque indiferenciado. Para llevar el "Número de Factura" a su hoja de cálculo, debe encontrar la línea que comienza con "Invoice #", seleccionar el identificador, copiarlo, cambiar a su hoja de cálculo y pegarlo. Luego encontrar la fecha. Luego el número de orden de compra. Luego cada línea de artículo. El OCR le dio el texto, pero le devolvió el problema de la captura de datos.
Resultado de la captura de datos con IA — lo que obtiene de la extracción impulsada por IA con la misma factura:
| Número de Factura | Fecha | Fecha de Vencimiento | Número de OC | Nombre del Proveedor | Subtotal | Impuestos | Envío | Total |
|---|---|---|---|---|---|---|---|---|
| INV-2024-0891 | 2024-03-15 | 2024-04-14 | PO-77231 | Acme Industrial Supply | $1,195.00 | $104.56 | $45.00 | $1,344.56 |
Cada campo asignado a su columna correcta. Los elementos de línea extraídos en sus propias filas. Las fechas estandarizadas en un formato consistente. Cero copiar y pegar. Cero búsqueda manual de campos. La diferencia no se trata de velocidad — aunque la IA es significativamente más rápida — se trata de que el resultado ya esté estructurado. La salida del OCR requiere un segundo paso (captura manual de datos) antes de ser útil. La salida de la captura de datos con IA es útil de inmediato.
La investigación de EY de 2025 encontró que una sola tarea manual de captura de datos de RR. HH. ahora cuesta a las organizaciones un promedio de $4.86 — frente a $4.39 en 2018, y con tendencia al alza cada año. En miles de documentos, la brecha entre «el OCR digitalizó el texto» y «la IA estructuró los datos» se acumula en costos operativos reales.
Cómo lee la IA los documentos: la visión se encuentra con el lenguaje
El OCR funciona carácter por carácter. Observa un patrón de píxeles oscuros y claros, los compara con una biblioteca de formas conocidas y genera la letra más cercana. Por eso el OCR puede producir «rn» cuando pretendía leer «m» — toma decisiones a nivel de carácter, sin conocimiento de la palabra, y mucho menos de la estructura del documento. Cuando el OCR se encuentra con una tabla con celdas combinadas, lee línea por línea y pierde por completo las relaciones entre columnas.
La captura de datos con IA utiliza modelos de visión y lenguaje (VLM) — una clase de IA que procesa documentos como lo haría un humano: observando la página completa de una vez. Un VLM analiza simultáneamente tres capas de información:
Diseño visual.
¿Dónde está posicionado cada elemento? ¿Está en un encabezado, una tabla, un pie de página? ¿Este texto está en negrita, con sangría o dentro de un recuadro con borde? El modelo comprende la estructura del documento, no solo cómo se ven los píxeles, sino cómo está organizada la página.
Contenido del texto.
¿Qué dice el texto? El modelo lee caracteres, palabras y números, pero a diferencia del OCR, los lee en el contexto de su posición en la página y su relación con los elementos cercanos.
Significado semántico.
¿Qué representa cada dato? Un número en la esquina superior derecha junto a la palabra «Factura n.º» es un número de factura. Un número en negrita en la esquina inferior derecha junto a «Total» es el importe adeudado. El modelo conecta la posición visual con el rol semántico: no solo lee «INV-2024-0891», sino que comprende que este es el identificador de la factura.
Estas tres capas (diseño, contenido y significado) se procesan juntas, no de forma secuencial. Cuando la IA ve un importe en dólares en la fila «Total» al final de una factura, no tiene que decidir «¿es texto o un número?» y luego «¿qué significa este número?» como pasos separados. Comprende la imagen completa de una vez: este es un valor monetario, está posicionado al final del documento, está etiquetado como «Total» y probablemente sea la suma de todas las partidas anteriores. El resultado es un valor con una etiqueta semántica, no solo una cadena de dígitos.
Esto es lo que la gente quiere decir cuando afirma que la IA «comprende el contexto». No es magia: son modelos entrenados con millones de documentos que aprenden que cuando un número aparece debajo de una columna de cifras y junto a la palabra «Total», ese número tiene un significado específico que no tiene un número en medio de una tabla de partidas.
Tres formas en que la IA extrae datos de un documento
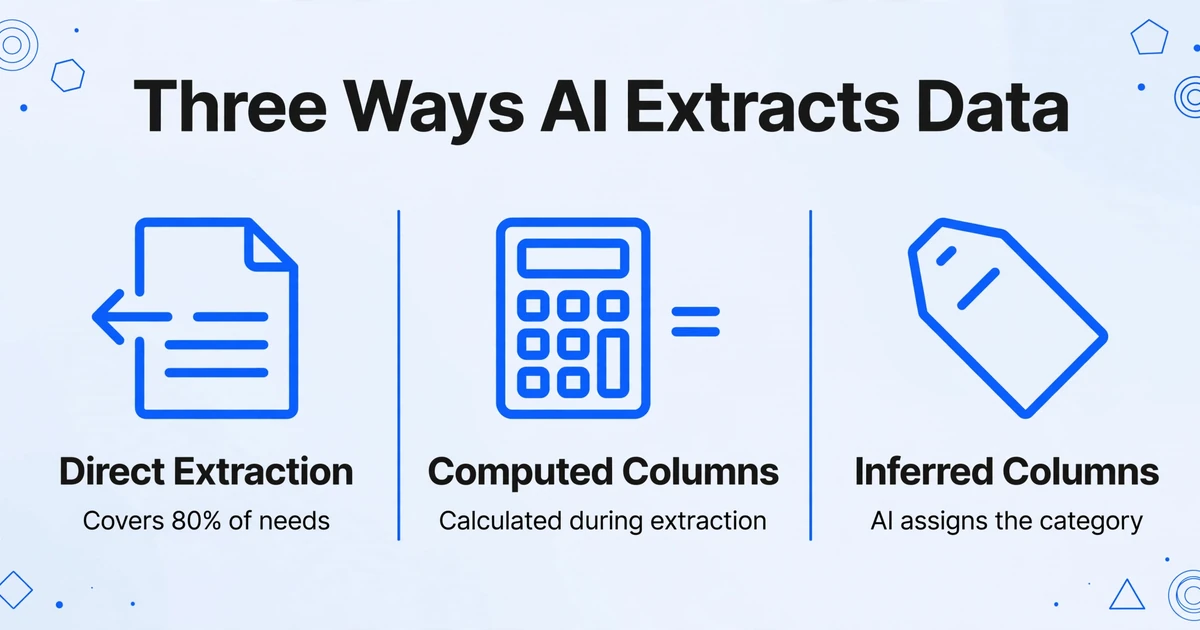
No toda extracción es igual. La captura de datos con IA opera en tres modos distintos, cada uno diseñado para resolver un problema diferente. Comprender qué modo aplica a cada campo es lo que separa una extracción funcional de una que produce resultados incompletos.
Extracción Directa — Cuando los datos están impresos en la página
Este es el modo más sencillo: el campo que desea está visiblemente presente en el documento. Una factura tiene una fecha impresa. Un recibo tiene un total. Una orden de compra tiene el nombre del proveedor. La IA localiza el valor al comprender su función semántica y lo coloca en la columna correcta.
La extracción directa cubre aproximadamente el 80% de lo que la mayoría de las personas necesita del procesamiento de documentos. Maneja texto impreso, tablas con columnas claras y campos en posiciones predecibles, incluso cuando esas posiciones varían entre diseños. Como la IA no coincide con una coordenada fija, una fecha en la esquina superior derecha de una factura y una fecha en la esquina inferior izquierda de otra factura se asignan correctamente a la columna "Fecha".
Columnas calculadas — Cuando la respuesta no está escrita, pero los ingredientes sí
A veces el número que necesita no está impreso en ningún lugar del documento, pero los componentes para calcularlo sí están. Aquí es donde entran las Columnas calculadas. En lugar de extraer un valor, la IA realiza un cálculo durante la extracción y coloca el resultado en su hoja de cálculo.
Por ejemplo, una orden de compra puede listar una cantidad de 200 y un precio unitario de $2.40, pero en ningún lugar imprime "Total de línea: $480.00". Con las Columnas calculadas, usted define una columna llamada Total de línea (Cant. × Precio unitario). La IA extrae los dos valores de origen, realiza la multiplicación y genera $480.00, todo en una sola pasada. Sin necesidad de fórmulas posteriores a la extracción en Excel.
Las Columnas calculadas admiten aritmética a nivel de fila, agregación entre filas (sumando todos los elementos de línea en una sección), lógica condicional (señalando cuando los totales calculados no coinciden con el total impreso) y referencias a parámetros fijos (incorporando una tasa de impuesto que aplica a todos los documentos de un lote). El cálculo ocurre durante la extracción, por lo que su resultado son respuestas listas para usar, no datos crudos que aún deba procesar.
Columnas inferidas: cuando la IA completa lo que no está presente
El tercer modo aborda un problema que el OCR y las herramientas basadas en plantillas no pueden resolver: ¿qué sucede si la información que necesita no está escrita en el documento? Las columnas inferidas permiten que la IA lea un documento y emita un juicio sobre qué categoría, etiqueta o rótulo corresponde, y luego lo complete en su hoja de cálculo.
Un caso clásico es la categorización de gastos. Un recibo de un restaurante no dice «Categoría: comidas». Pero usted necesita clasificar los gastos para la declaración de impuestos. Con las columnas inferidas, define una columna llamada Categoría (opciones: comidas/transporte/oficina/otros). La IA lee cada recibo (un recibo de almuerzo de un restaurante de sushi, un recibo de gasolinera, un recibo de Staples) y determina la categoría correcta para cada uno. El resultado es una hoja de cálculo en la que cada fila ya tiene asignada su categoría. La extracción y la clasificación se realizan en una sola pasada.
Las columnas inferidas funcionan de la misma manera en cualquier tipo de documento: marcar pedidos urgentes a partir de notas de entrega, detectar el tipo de moneda en facturas internacionales, identificar el subtipo de documento en certificados de seguro. La IA lee el contenido del documento y realiza una inferencia estructurada, algo que el OCR, que no tiene comprensión semántica, no puede hacer.
Qué significa esto en el uso diario
Los tres modos de extracción convergen en un único cambio operativo: ya no necesita enseñar a la herramienta cómo son sus documentos. Usted describe lo que quiere obtener de ellos.
En un flujo de trabajo de OCR basado en plantillas, añadir el formato de factura de un nuevo proveedor implica abrir el editor de plantillas, dibujar zonas alrededor de cada campo, probarlo con una muestra y esperar que las zonas no se desplacen en la siguiente factura. Multiplique eso por 20 proveedores y estará dedicando más tiempo a mantener plantillas del que habría invertido en la captura manual. Con la captura de datos con IA, escribe los nombres de sus columnas una sola vez. Funcionan en todos los formatos que la IA encuentre, porque la IA comprende el documento, no mide coordenadas.
El procesamiento por lotes lleva esto más lejos. Suba 50 facturas de 15 proveedores distintos. Escriba los nombres de sus columnas una sola vez. La IA procesa las 50, identifica cada campo en todas las variaciones de formato y exporta una única hoja de cálculo con 50 filas (una por factura) con cada campo en la columna correcta. Lo que antes era una tarde de captura manual se convierte en unos minutos de carga y revisión.
Los archivos se procesan de forma segura y no se almacenan.
Para una visión más amplia de cómo la extracción con IA se compara con los enfoques tradicionales de procesamiento de documentos, nuestra introducción al software de extracción de datos cubre todo el panorama de categorías. Y si está evaluando herramientas, el marco de evaluación repasa los criterios que separan la extracción de nivel de producción de las demos que funcionan con un solo documento de muestra.
Lo que la captura de datos con IA hace bien
La captura de datos con IA maneja cualquier documento donde exista información estructurada en un diseño visual. Las aplicaciones más comunes se agrupan en torno a unos pocos tipos de documentos de alto volumen.
Procesamiento de facturas. El caso de uso insignia. Las facturas de diferentes proveedores tienen diseños radicalmente distintos, pero comparten la misma estructura semántica: nombre del proveedor, número de factura, fecha, partidas, totales. La IA lee a través de los diseños, lo que hace práctico extraer campos de facturas a Excel sin crear una plantilla para cada proveedor. Gartner proyecta que para 2030, hasta el 80% de las facturas B2B en todo el mundo se procesarán automáticamente, una predicción que asume exactamente el tipo de extracción independiente del diseño descrito aquí.
Escaneo de recibos. Los recibos son el tipo de documento más difícil para el OCR basado en plantillas: cada tienda imprime un formato diferente, muchos son impresos térmicamente y descoloridos, y a menudo llegan como fotos de teléfono en ángulos extraños. La captura de datos con IA convierte recibos en filas estructuradas de hoja de cálculo al comprender visualmente el diseño del recibo, identificando el nombre del comerciante, la fecha, el total y las partidas sin importar el formato.
Conciliación de extractos bancarios. Los extractos bancarios presentan un desafío particular: PDFs de varias páginas con tablas de transacciones que abarcan columnas a través de saltos de página, columnas de débito y crédito que a veces se superponen, y saldos corrientes que deben mantener su integridad. La captura de datos con IA convierte extractos bancarios a Excel preservando la estructura de transacciones — cada fila es una transacción, cada columna es un campo — para que la conciliación pueda realizarse en su hoja de cálculo en lugar de cotejar un extracto en papel contra una pantalla.
Procesamiento de formularios. Los formularios en papel — solicitudes de empleo, formularios de admisión de pacientes, respuestas de encuestas — llegan en lotes con preguntas consistentes pero caligrafía, casillas de verificación y patrones de relleno muy inconsistentes. La IA lee la estructura del formulario y extrae cada campo en una columna, digitalizando datos de formularios sin configuración por formulario.
Documentos manuscritos. La captura de datos con IA moderna maneja caligrafía legible — formularios impresos completados a mano, notas de entrega con firmas y cantidades manuscritas, hojas de tiempo con horas escritas a mano. La precisión en escritura a mano es menor que en texto impreso (más sobre esto en la sección de limitaciones), pero para formularios estructurados donde el contenido manuscrito se limita a campos conocidos, los resultados están listos para producción en muchos casos de uso. Nuestra guía de reconocimiento de escritura a mano para extracción de datos cubre los detalles.
Con lo que la captura de datos con IA aún tiene dificultades
La captura de datos con IA no está resuelta. Hay tipos de documentos y condiciones donde la precisión cae por debajo de lo aceptable para la automatización sin intervención. Ser claros sobre estas limitaciones es importante: es la diferencia entre configurar un flujo de trabajo que funciona y uno que crea un nuevo problema de limpieza.
Calidad de escaneo extremadamente deficiente. Los documentos muy desvaídos, fotografiados con poca luz y desenfoque por movimiento, o escaneados a muy baja resolución (menos de 150 DPI) degradan la precisión de la extracción. La IA puede compensar problemas de calidad moderados (ligero desenfoque, inclinación, iluminación inconsistente), pero cuando los caracteres se vuelven genuinamente ambiguos para un lector humano, la IA también tendrá dificultades. La puntuación de confianza (donde la IA marca campos de baja certeza para revisión humana) mitiga esto, pero no lo elimina.
Texto manuscrito superpuesto. Cuando la escritura es clara y está separada, la IA moderna la maneja bien. Cuando los caracteres se superponen (una corrección escrita rápidamente entre dos líneas, un tachado con texto nuevo escrito encima), la precisión cae drásticamente. El modelo debe decidir dónde termina un carácter y comienza otro, y en cierto nivel de superposición, esa decisión se convierte en una suposición incluso para un humano.
Documentos donde los datos son puramente visuales o gráficos. Si un documento comunica información exclusivamente mediante diagramas, gráficos sin tablas de datos o mapas codificados por colores sin etiquetas de texto, la captura de datos con IA no tiene nada que extraer. La IA lee texto y diseño; no interpreta la altura de un gráfico de barras en un valor numérico ni decodifica una leyenda de colores en categorías. Para documentos que combinan texto y elementos visuales (un informe con una tabla de datos y un gráfico), la tabla es extraíble; el gráfico generalmente no.
Escritura cursiva extrema y caligrafía no estándar. La escritura ordenada en un formulario estructurado es manejable. La cursiva rápida con formas de letras muy estilizadas (como la que se encuentra en algunas recetas médicas o libros de contabilidad antiguos escritos a mano) sigue siendo un desafío. La brecha se está reduciendo a medida que los modelos mejoran, pero a mediados de 2026, la cursiva muy estilizada aún produce resultados poco fiables que requieren verificación humana.
Tablas multipágina con lógica de expansión compleja. Cuando una tabla abarca tres páginas con celdas combinadas, filas divididas y subtotales que hacen referencia a valores de una página anterior, incluso la IA puede perder el hilo. Los VLM modernos manejan bien la continuidad multipágina simple, pero la lógica de expansión compleja (donde la descripción de una partida se extiende a lo largo de dos páginas y su cantidad está en una tercera) aún produce errores en un porcentaje significativo de casos.
El resumen honesto: la captura de datos con IA maneja el 80% de los documentos que son limpios, legibles y estructuralmente claros con alta precisión (hasta el 99% para datos de tablas impresas). Maneja el siguiente 15% (problemas de calidad moderados, escritura ligera, tablas multipágina simples) con una precisión que sigue siendo utilizable pero puede necesitar verificación puntual. El último 5% (la escritura superpuesta, los escaneos severamente degradados, los documentos puramente gráficos) aún necesita atención humana. Nuestra comparación de precisión entre herramientas de extracción proporciona puntos de referencia detallados para tipos de documentos específicos.
Preguntas Frecuentes
¿La captura de datos con IA es lo mismo que el OCR?
No. El OCR convierte imágenes de texto en caracteres de texto digitales — lee letras. La captura de datos con IA comprende lo que esas letras significan en contexto y las coloca en columnas estructuradas. El OCR le da un archivo de texto. La captura de datos con IA le da una hoja de cálculo. El OCR es un componente que los sistemas de captura de datos con IA pueden usar, pero por sí solo, el OCR no realiza estructuración ni comprensión.
¿Necesito entrenar la IA con mis documentos?
No. Las herramientas modernas de captura de datos con IA que usan modelos de visión y lenguaje funcionan de inmediato con documentos que nunca han visto antes. No tiene que subir muestras de entrenamiento, etiquetar campos ni configurar plantillas. Usted escribe los nombres de las columnas que desea, sube sus documentos y la IA extrae los datos comprendiendo el documento visual y semánticamente — no haciendo coincidir un patrón aprendido de ejemplos anteriores. En comparación, los enfoques más antiguos de aprendizaje automático requerían cientos de documentos etiquetados por formato; las herramientas más nuevas basadas en VLM no necesitan ninguno.
¿Qué formatos de documentos admite la captura de datos con IA?
PDF (tanto nativos como escaneados), JPEG, PNG, WebP, AVIF y capturas de pantalla de páginas web. La IA procesa cualquier imagen o documento que usted suba — no necesita que la fuente sea un archivo digital limpio. Una foto de un recibo tomada con el teléfono funciona igual que un PDF generado por un software de contabilidad. Para una comparación detallada de la compatibilidad de formatos entre herramientas, consulte nuestro marco de evaluación.
¿Qué tan precisa es la captura de datos con IA en comparación con la captura manual?
Para datos de tablas impresas, la extracción con IA alcanza hasta un 99% de precisión. La precisión de la captura manual de datos suele oscilar entre el 96 y el 98% y se degrada con la fatiga, la presión por volumen y los formatos de documentos desconocidos. Con 1,000 documentos al mes, la diferencia es de aproximadamente 10 a 40 errores frente a menos de 10 (IA). Una página que tarda 3 minutos en capturarse manualmente se procesa en 5 a 10 segundos con IA — una ganancia de eficiencia de más de 18 veces. Sin embargo, la precisión depende en gran medida de la calidad del documento: un escaneo limpio y bien iluminado de una factura impresa logrará una precisión casi perfecta; una foto descolorida y de baja resolución de un recibo escrito a mano será menor.
¿La captura de datos con IA puede leer escritura a mano?
Sí, pero con matices. La escritura legible en formularios estructurados (un formulario impreso llenado a mano) es manejada bien por la IA moderna — la estructura del formulario proporciona contexto que ayuda al modelo a interpretar el contenido escrito a mano. Las notas manuscritas de forma libre, la cursiva rápida y la escritura superpuesta producen resultados menos fiables. Si su caso de uso involucra documentos muy manuscritos, espere verificar los resultados en lugar de procesarlos directamente. Para más detalles, consulte nuestra guía de reconocimiento de escritura a mano.
¿Cuánto cuesta la captura de datos con IA en comparación con el OCR tradicional?
Las herramientas de captura de datos con IA suelen basarse en suscripciones con niveles de precios por página o por documento. Las herramientas de OCR tradicionales suelen ser más económicas en el nivel básico, pero requieren una inversión adicional en la configuración de plantillas, el mantenimiento y el trabajo manual de estructurar el texto sin procesar que generan. La diferencia de coste rara vez se debe únicamente al precio del software: se trata del coste operativo total, incluido el tiempo dedicado al manejo de los datos posteriores a la extracción. Nuestra comparación de costes entre el OCR gratuito y la extracción con IA y la descripción general del panorama de precios para 2026 lo cubren en detalle.
¿Qué ocurre con mis documentos después del procesamiento?
Esto varía según el proveedor. Las herramientas de confianza procesan los documentos, extraen los datos y eliminan los archivos originales; no almacenan sus documentos ni los utilizan para entrenar modelos. Compruebe siempre la política de manejo de datos del proveedor antes de cargar documentos confidenciales. Busque compromisos explícitos sobre la eliminación de archivos, la no utilización de los datos de los usuarios para entrenamiento y el cifrado tanto en tránsito como en reposo.
La captura de datos con IA cambia lo que es posible en el procesamiento de documentos, no al hacer lo mismo más rápido, sino al hacer algo completamente distinto. La pregunta no es si es mejor que el OCR. Es si los documentos que procesa a diario están lo suficientemente estructurados para que la IA los maneje, y si el tiempo que ahorraría vale más que el coste de la herramienta. La única forma de saberlo es probarla con sus propios documentos.