OCR gratuito vs extracción de documentos con IA:
El costo real de lo «gratis»
Las herramientas de OCR gratuito nunca han sido tan capaces. Google Lens puede extraer texto de la foto de un recibo. El OCR de Google Drive convierte una factura escaneada en texto buscable. Tesseract funciona localmente y no cuesta nada. La pregunta no es si las herramientas gratuitas pueden leer sus documentos — pueden. La pregunta es si lo que generan es utilizable sin horas de limpieza manual. Para la mayoría de las personas que procesan más de un puñado de documentos, la respuesta cambia más rápido de lo que esperan.
Conclusiones clave
- El OCR gratuito lee cada carácter de su factura a la perfección y entrega el resultado como un flujo de texto indiferenciado, sin columnas, sin etiquetas de campo y sin estructura de tabla.
- Convertir ese texto sin procesar en una hoja de cálculo utilizable requiere cinco pasos manuales por página y, a 30 páginas al mes, la mano de obra de corrección cuesta $37.50, más que la suscripción de $9 que intentaba evitar.
- ImageToTable.ai genera columnas estructuradas que usted mismo nombra directamente en Excel, de modo que diez páginas toman segundos en lugar de 30 minutos de reparación de texto.
Lo que realmente ofrece el OCR gratuito
El reconocimiento óptico de caracteres fue diseñado para resolver un problema: convertir una imagen de texto en caracteres legibles por máquina. En esa tarea específica, ha mejorado notablemente. Los motores OCR modernos aplicados a documentos impresos limpios superan habitualmente el 98% de precisión de caracteres. Google Lens, Google Drive OCR, Tesseract y servicios gratuitos en línea como OnlineOCR manejan bien este nivel básico; consulte nuestra reseña completa de herramientas OCR gratuitas si desea la lista completa con los límites reales del nivel gratuito.
El problema es lo que se obtiene. El OCR lee un documento de izquierda a derecha, de arriba a abajo, y produce un flujo de texto. Si introduce una factura de proveedor en Google Drive OCR, obtendrá algo como esto: cada palabra de la página, en orden de lectura, sin estructura conservada:
ACME Supplies Ltd
123 Commerce Street, Chicago IL 60601
INVOICE
Invoice No: INV-2024-0892 Date: March 15, 2024
Bill To: Greenfield Corp Due: April 14, 2024
Description Qty Unit Price Amount
Office chairs 4 $285.00 $1,140.00
Desk lamps 10 $45.00 $450.00
Total: $1,590.00
Todo está ahí. Pero "Invoice No" y "Date" están en la misma línea separados solo por un espacio. La tabla de partidas se aplana en líneas de texto: las relaciones entre columnas de descripción, cantidad, precio unitario e importe desaparecen. El total queda al final, desconectado de todo lo anterior. Si necesita poner estos datos en una hoja de cálculo con columnas etiquetadas — "Invoice Number," "Date," "Vendor," "Line Item Description," "Qty," "Unit Price," "Amount" — tendrá que empezar desde cero.
Esto no es un error del OCR. Es para lo que fue diseñado el OCR: leer caracteres, no comprender documentos. El problema es que la tarea que la mayoría de la gente realmente tiene — "llevar estos datos de factura a mi hoja de cálculo" — requiere comprensión de documentos, no solo reconocimiento de caracteres.
La brecha entre el texto sin procesar y los datos utilizables
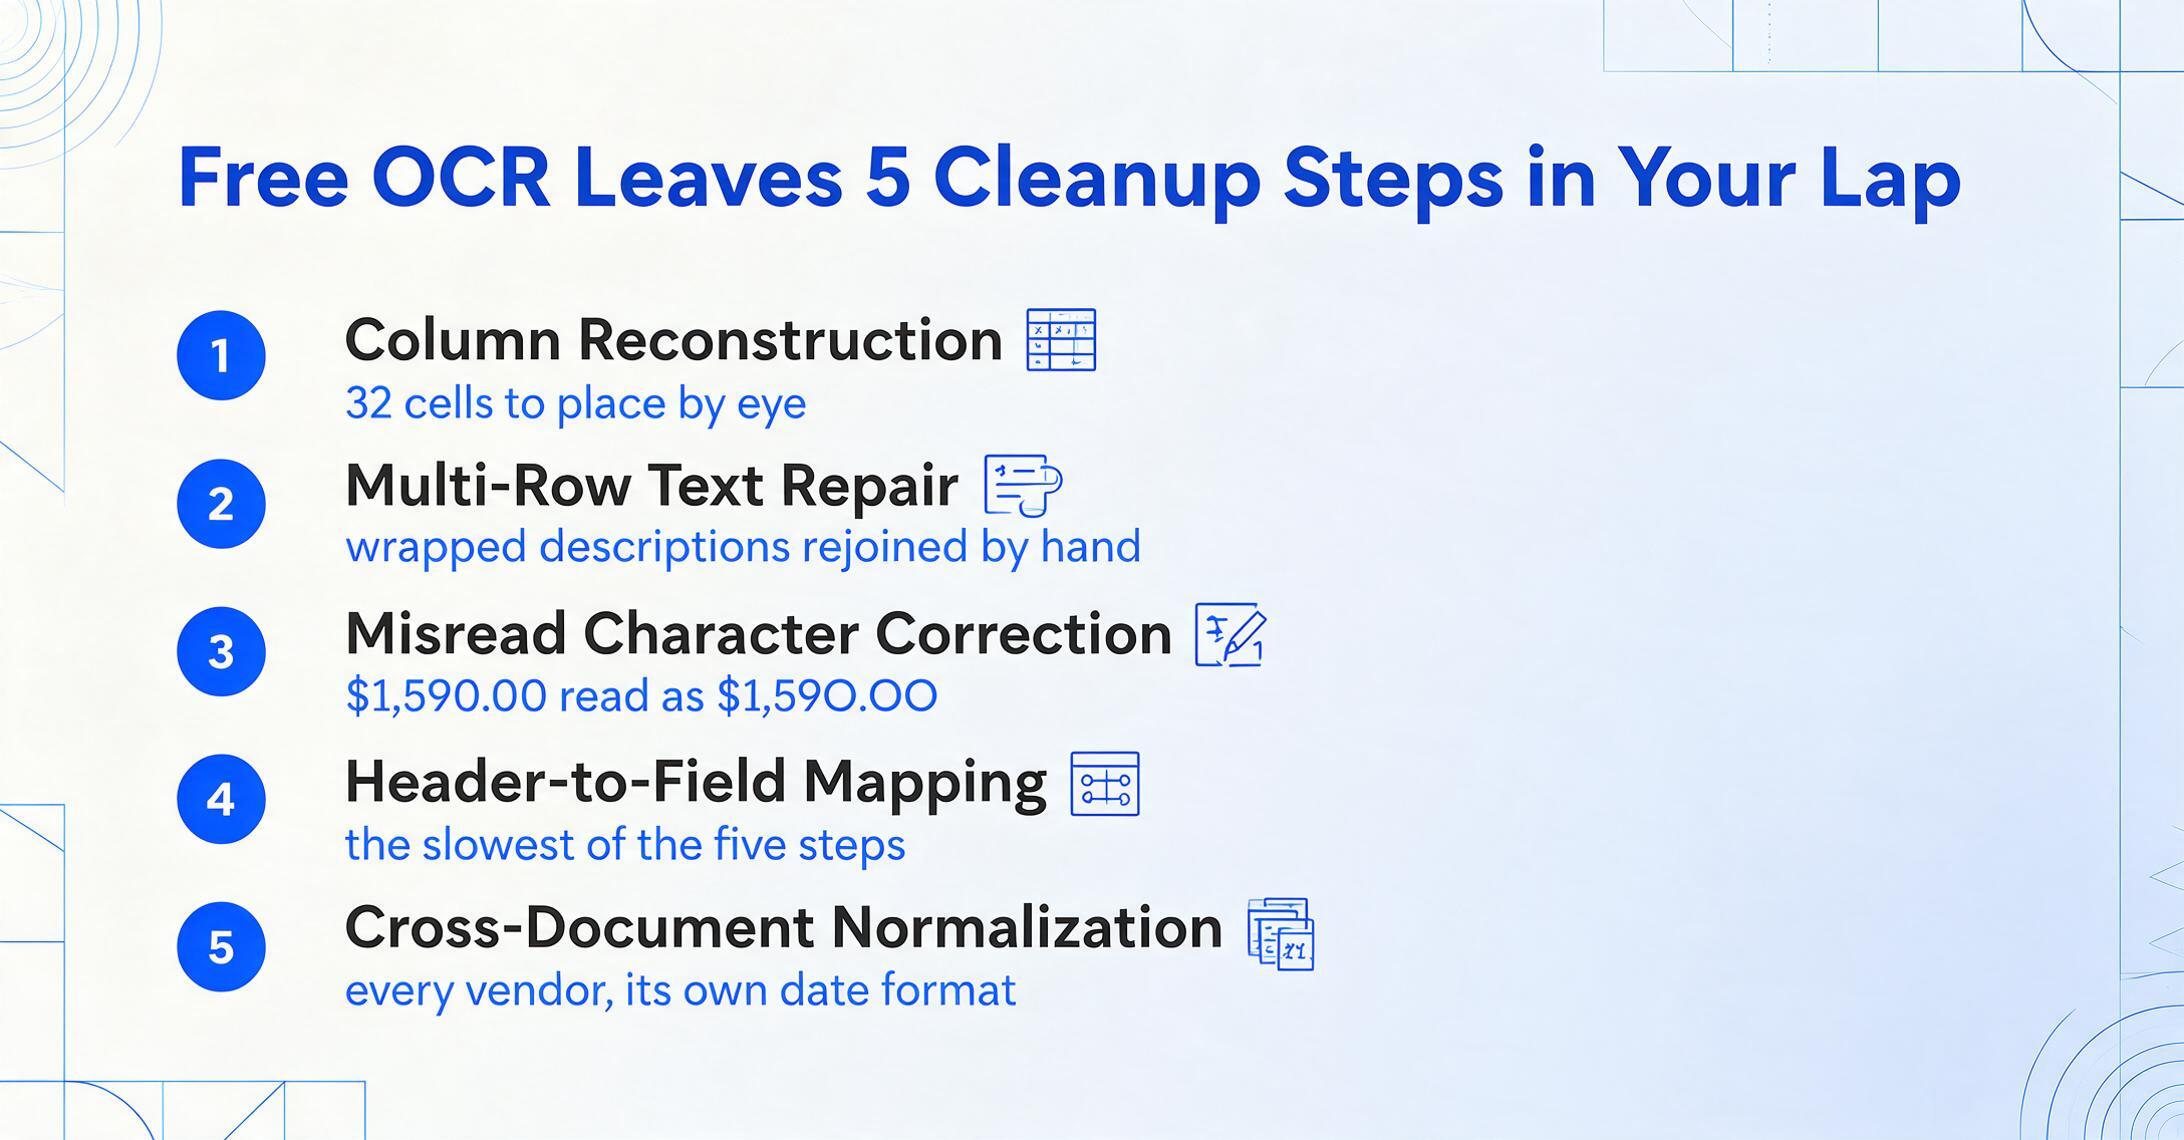
Cuando la gente dice «usé OCR gratuito en estas facturas y funcionó», lo que suele querer decir es «el texto estaba ahí», no «los datos estaban estructurados y listos para usar». Entre la salida del OCR y una hoja de cálculo limpia, hay una secuencia de pasos manuales de los que nadie habla en la narrativa de «gratis».
Tomemos un informe de gastos típico con 8 partidas en 4 columnas: descripción, cantidad, precio unitario y total de la línea. Esto es lo que ocurre con la salida del OCR gratuito:
Reconstrucción de columnas
La salida del OCR es un flujo de texto continuo. Debe reasignar visualmente qué fragmento de texto pertenece a cada columna. Una tabla de cuatro columnas con 8 filas significa 32 celdas individuales que identificar y colocar.
Reparación de texto en varias filas
Las descripciones de artículos que abarcan dos líneas en el documento original se dividen en filas separadas en la salida del OCR. Debe volver a unirlas manualmente, para cada artículo con una descripción larga, en todos los documentos.
Corrección de caracteres mal leídos
Incluso con una precisión de caracteres del 98%, una página con 500 caracteres tiene un promedio de 10 errores. "$1,590.00" se convierte en "$1,59O.OO" (letra O por cero). "Qty" se convierte en "Qtv". Cada error debe detectarse y corregirse a mano.
Asignación de encabezados a campos
El número de factura, la fecha, el nombre del proveedor y el total están en algún lugar del flujo de texto. Debe encontrar cada uno, extraerlo y asignarlo al encabezado de columna correcto en su hoja de cálculo. Este es el paso que más tiempo lleva y el que la mayoría de la gente omite en sus estimaciones de tiempo.
Normalización de formato entre documentos
El proveedor A formatea las fechas como "03/15/2024". El proveedor B usa "15 March 2024". El proveedor C usa "2024-03-15". Si combina 20 facturas en una sola hoja de cálculo, necesita un formato de fecha coherente, y eso es otra pasada manual.
Para una sola página, estos cinco pasos pueden llevar 3 minutos. Eso no parece mucho, y para una página no lo es. Las matemáticas cambian con el volumen, y cambian más rápido de lo que la mayoría calcula. Diez páginas: 30 minutos. Treinta páginas: 90 minutos. Cincuenta páginas al cierre de fin de mes: dos horas y media de trabajo de corrección, además del tiempo que ya tomó el OCR.
Este es el costo oculto del OCR gratuito. La herramienta no cuesta nada, pero cada minuto de limpieza manual es tiempo que no dedica a algo que realmente genera valor: analizar los datos, conciliar cuentas o cerrar el próximo cliente. Con un salario administrativo típico de $25/hora, 2,5 horas de trabajo de corrección suponen $62,50 en costo laboral. De repente, "gratis" no es la opción más barata.
Qué hace diferente la extracción con IA — y por qué importa para el tiempo
La extracción de documentos con IA — el enfoque que utilizan herramientas como ImageToTable.ai — no intenta leer cada carácter de la página y luego averiguar qué significa. Lee el documento visualmente como lo haría una persona: ve el diseño, entiende qué bloques de texto pertenecen juntos e identifica campos específicos por significado, no por posición.
El mecanismo práctico es lo que ImageToTable.ai llama Extracción de Columnas Personalizadas: usted escribe los nombres de los campos que desea — "Número de Factura", "Fecha", "Proveedor", "Total de Línea" — y la IA localiza cada valor en cualquier parte de la página comprendiendo qué significa, no dónde está. Un campo etiquetado como "INV#" en la factura de un proveedor y "Referencia de Factura" en la de otro se reconocen como lo mismo y se colocan bajo la misma columna. Sin plantillas, sin mapeo de coordenadas, sin configuración por proveedor. Si desea ver cómo se compara esto con otras herramientas de extracción con IA y no solo con el OCR gratuito, nuestra comparativa de software de extracción de datos cubre nueve de ellas.
Tres consecuencias posteriores hacen que la diferencia de tiempo sea significativa:
Flujo de trabajo con OCR gratuito
- Resultado: flujo de texto sin procesar, toda la estructura se pierde
- Tablas: aplanadas — las relaciones entre columnas se destruyen
- Campos: usted busca en el volcado de texto y copia cada valor
- Varias páginas: cada página es un bloque de texto separado que corregir
- Escritura a mano: la precisión cae al 60–70%
- Formatos mixtos: cada tipo de diseño es un nuevo problema de análisis
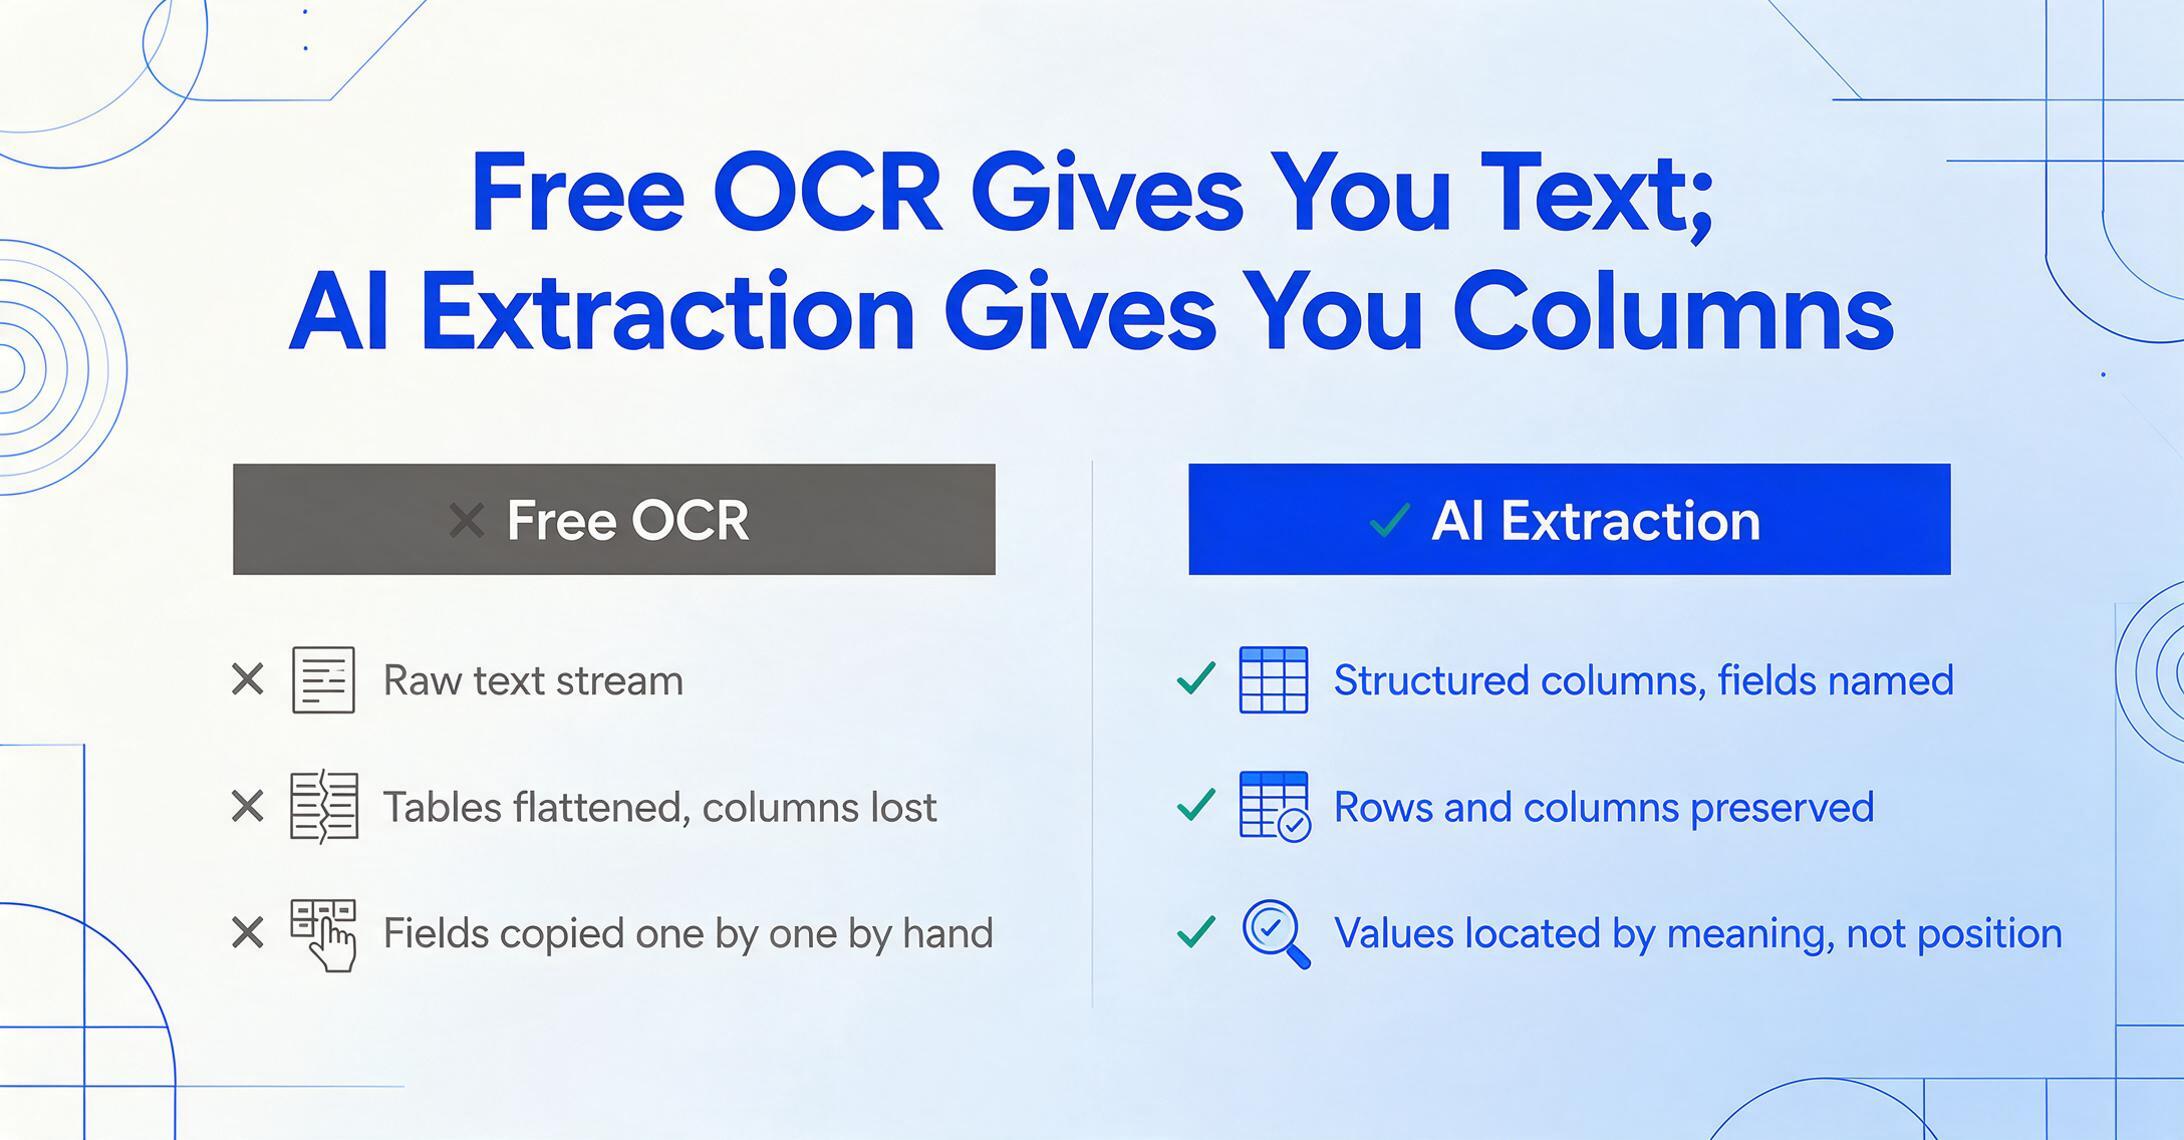
Flujo de trabajo con extracción con IA
- Resultado: columnas estructuradas — los campos que usted nombró, con valores completados
- Tablas: filas y columnas conservadas — listas para Excel
- Campos: la IA los encuentra por significado semántico, no por ubicación de píxeles
- Varias páginas: fusión automática en una única tabla de resultados coherente
- Escritura a mano: 85–95% de precisión con modelos de IA visual
- Formatos mixtos: el mismo esquema de columnas funciona en todos los diseños
Más allá de la extracción básica, la extracción con IA añade capacidades que no tienen equivalente en el OCR gratuito. Las columnas calculadas le permiten definir cálculos que se ejecutan durante la extracción — por ejemplo, una columna llamada "Total de línea (Cantidad × Precio unitario)" calcula automáticamente el producto de cada fila, detectando discrepancias entre el total de línea indicado y el cálculo real. Las columnas inferidas permiten que la IA clasifique o derive información que no está escrita explícitamente en el documento, como asignar una categoría ("Comidas", "Transporte", "Oficina") según el contenido del recibo. Estos no son pasos de posprocesamiento en Excel — ocurren durante la extracción y aparecen directamente en su tabla de salida.
El ahorro de tiempo se acumula cuando procesa documentos por lotes. Cargue 30 facturas en una herramienta de extracción con IA: un esquema de columna, una ejecución de procesamiento, un archivo de salida. Las mismas 30 facturas con OCR gratuito: 30 volcados de texto separados, 30 rondas del proceso de limpieza de cinco pasos. Una comparación en profundidad de la extracción visual con IA frente al OCR tradicional encontró que los sistemas de OCR basados en plantillas fallan cada vez que un proveedor cambia el diseño de su factura o cuando añade un nuevo proveedor — y la mayoría de las herramientas de OCR gratuitas son mucho más primitivas que incluso los sistemas basados en plantillas.
Dónde "Gratis" Deja de Ser Gratis
El argumento económico para quedarse con el OCR gratuito es más sólido en volúmenes muy bajos. ¿Una o dos páginas al mes, procesadas de una en una? La limpieza es manejable. La pregunta es dónde está el punto de equilibrio: ¿a qué volumen mensual el tiempo de corrección manual cuesta más que una suscripción de $9?
El cálculo utiliza tres supuestos, todos conservadores. Tiempo de corrección manual por página: 3 minutos, basado en el proceso de cinco pasos anterior (esto asume que usted es rápido y que los documentos están limpios — para notas manuscritas o escaneos desvaídos, el tiempo puede duplicarse). Tarifa horaria efectiva: $25/hora, un salario típico de administración/contabilidad en EE. UU. Y una suscripción de extracción con IA a $9/mes para el plan Basic de ImageToTable.ai, que incluye 150 créditos (páginas) por mes.
| Volumen mensual | Tiempo gratuito de corrección de OCR | Costo laboral de corrección | Costo de extracción con IA | Ahorro neto con IA |
|---|---|---|---|---|
| 5 páginas | 15 min | $6.25 | $9.00 | -$2.75 (zona de equilibrio) |
| 10 páginas | 30 min | $12.50 | $9.00 | +$3.50 |
| 30 páginas | 90 min | $37.50 | $9.00 | +$28.50 |
| 50 páginas | 150 min (2.5 h) | $62.50 | $19.00 (Pro plan) | +$43.50 |
| 100 páginas | 300 min (5 h) | $125.00 | $19.00 (Pro plan) | +$106.00 |
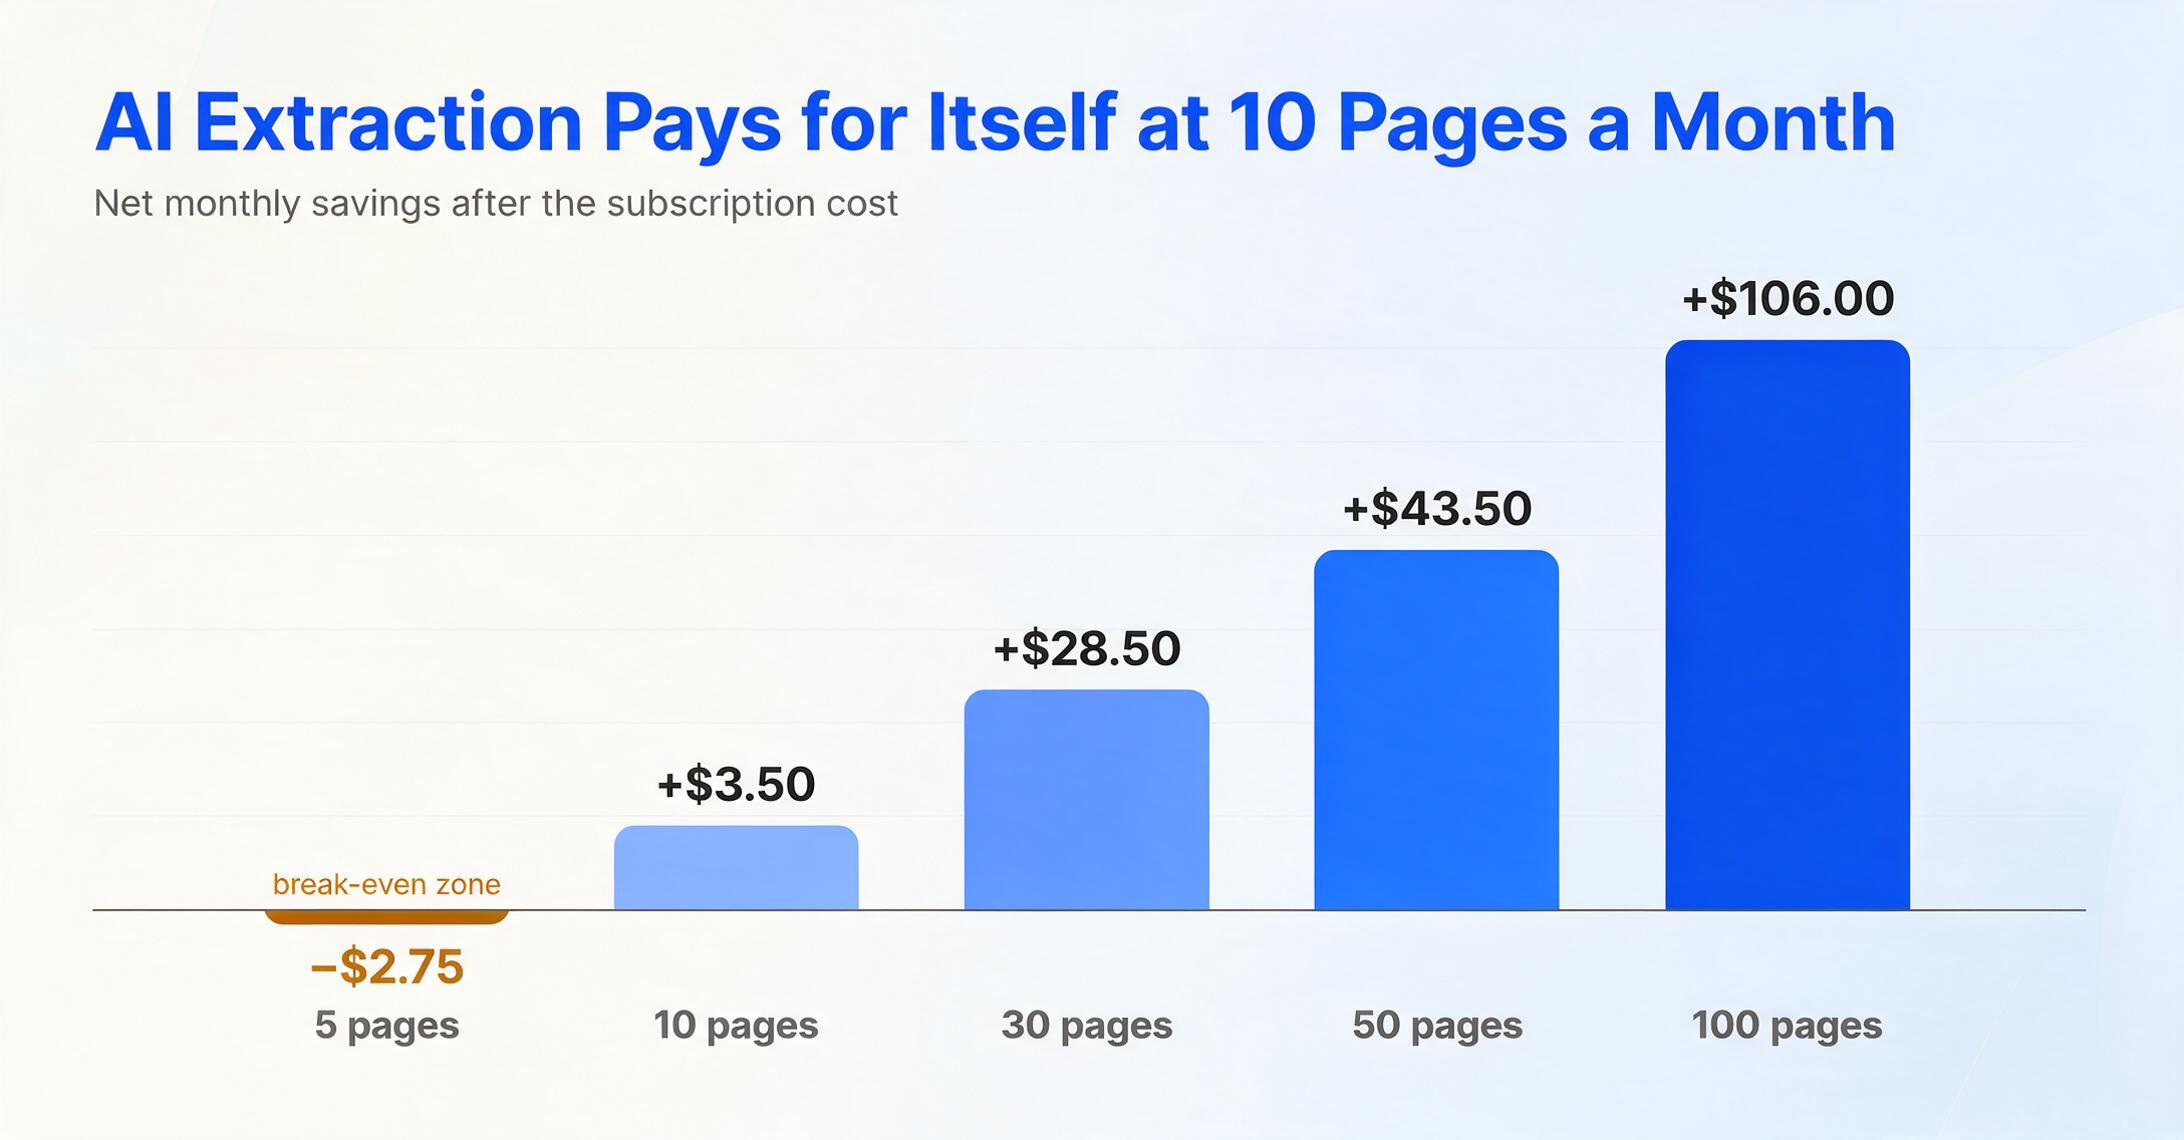
Con 5 páginas al mes, la corrección gratuita de OCR cuesta unos $6.25 en mano de obra, ligeramente menos que una suscripción de $9/mes. Este es el volumen en el que la decisión realmente depende de qué más podría hacer con esos 15 minutos. Pero la línea no se mantiene ahí por mucho tiempo. A las 10 páginas, ya está ahorrando dinero con una suscripción, incluso antes de considerar la ventaja en precisión y la menor frustración. A las 30 páginas — un volumen realista para un freelancer con unos pocos clientes habituales — un plan de $9 ahorra más de $28 al mes solo en mano de obra.
Las cifras se vuelven más contundentes a volúmenes mayores. Si procesa 50 facturas a fin de mes, dos horas y media de corrección no son solo dinero — es tiempo que no puede recuperar. Y a diferencia de un trabajador por horas, el OCR gratuito no se vuelve más rápido con la práctica. El mismo proceso de cinco pasos se repite en cada página, cada lote, cada mes. Para una visión más amplia de lo que realmente cuestan las diferentes herramientas y planes, consulte nuestra guía de precios 2026 para la extracción de documentos con IA, que desglosa el costo por documento en todos los niveles.
También vale la pena señalar que este cálculo solo cuenta el tiempo — no incluye los costos de errores. Un dígito mal leído en un total ($1,590 vs $1,5O0) o un valor de columna mal ubicado (cantidad donde debería estar el precio unitario) genera problemas posteriores que tardan más en corregirse que la extracción original. Esos ciclos de corrección de errores son invisibles en la narrativa de "gratis" y muy visibles en el cierre mensual.
Cuándo el OCR Gratis Sigue Siendo la Respuesta Correcta
Nada de esto significa que el OCR gratis sea inútil. Significa que su utilidad tiene límites, y conocer esos límites ahorra tiempo.
Las herramientas de OCR gratis funcionan bien para:
- Hacer que un PDF sea buscable. Si necesitas buscar una cláusula específica en un contrato escaneado, el OCR de Google Drive te llevará allí.
- Extraer un bloque corto de texto. Un párrafo de un escaneo, una dirección de un formulario — extracción de bajo riesgo y bajo volumen.
- Flujos de trabajo de un solo formato, alto volumen y documentos estables. Si procesas 1,000 formularios idénticos con exactamente el mismo diseño cada mes, un pipeline de OCR basado en plantillas (incluso uno gratis, con suficiente configuración) puede funcionar — aunque esto es cada vez más un caso de uso de nicho fuera del gobierno y los sistemas heredados.
- Documentos donde la estructura no importa. OCR para indexación de archivos, donde el objetivo es "encontrar qué documento contiene esta palabra clave", no "obtener campos específicos en una hoja de cálculo".
El OCR gratis falla cuando tu flujo de trabajo requiere extracción a nivel de campo de documentos con diseños variables — lo que describe la mayoría del procesamiento de documentos en el mundo real. Si manejas facturas de múltiples proveedores, recibos de diferentes comercios o estados de cuenta de distintos bancos, el OCR gratis te da texto sin procesar que aún necesita ser interpretado. Ese paso de interpretación es donde realmente vive el costo.
Para una visión práctica de lo que obtienes en cada punto de precio — desde herramientas de $0 hasta planes de $9/mes y planes de $19/mes con mayor capacidad — nuestra comparación de usar una sola herramienta para todos los tipos de documentos versus múltiples herramientas especializadas analiza las matemáticas del costo total de propiedad en diferentes escenarios de volumen.
Para freelancers y emprendedores individuales específicamente — un grupo que a menudo comienza con herramientas gratuitas porque el presupuesto parece demasiado ajustado para una suscripción — la pregunta merece su propio análisis. Nuestro desglose de extracción de documentos con un presupuesto de freelancer compara los volúmenes mensuales típicos con los tamaños de los planes para que puedas ver si tu uso real justifica un plan de pago o no. Spoiler: la mayoría de las personas que procesan más de 10 páginas al mes cruzan la línea.
Qué Obtienes por $9/Mes que el OCR Gratuito Nunca Te Dará
En este punto, la pregunta pasa de "gratis vs. de pago" a "¿qué ofrece realmente el nivel de pago más bajo que las herramientas gratuitas no pueden?". La respuesta se reduce a cinco capacidades que eliminan directamente los cinco pasos de limpieza manual descritos anteriormente.
Extracción de Columnas Personalizadas
Tú nombras las columnas. La IA las rellena con datos de cualquier documento, independientemente del diseño. Sin búsquedas, sin copiar, sin crear plantillas. Los nombres de columna que escribes se convierten en los encabezados de tu archivo de salida — directamente, sin pasos intermedios.
Preservación de la Estructura de la Tabla
Las tablas de artículos con múltiples columnas se mantienen como tablas. Las relaciones entre filas y columnas se preservan, de modo que la descripción se mantiene con la cantidad y el importe correctos, sin aplanarse en un flujo de texto indiferenciado.
Procesamiento por Lotes
Sube 30 facturas y recibe un archivo de Excel con todos los datos fusionados en una sola tabla. Cada documento se procesa con el mismo esquema de columnas. Solo esto ahorra más tiempo de lo que cuesta la suscripción, cada mes.
Normalización de Formato
Las fechas, los importes y los números se estandarizan automáticamente en todos los documentos de entrada, sin importar cómo los formatee cada proveedor. Sin necesidad de un pase de reformateo manual.
La comparación se vuelve especialmente clara cuando se considera el modelo de autoservicio. Sin llamadas de ventas, sin compromisos mínimos, sin proceso de adquisición: el proceso de registro a primer resultado dura menos de dos minutos. Para obtener más información sobre por qué los contratos de extracción de documentos de nivel empresarial no son el único camino, consulta cómo la extracción de documentos con IA sin contrato empresarial se compara con el modelo tradicional de "reserva una demo, habla con ventas, firma un acuerdo de 12 meses" que los usuarios de OCR gratuito intentan evitar en primer lugar.
Preguntas frecuentes
¿Puede Google Lens extraer datos de tablas a Excel?
Google Lens puede reconocer texto de una imagen de tabla y permitirte copiarlo al portapapeles de tu dispositivo. Sin embargo, la estructura de la tabla (filas, columnas, celdas combinadas y alineación de columnas) no se conserva. Lo que pegues en Excel requerirá una reorganización manual: separar texto combinado, realinear columnas y corregir el formato. Google Lens está diseñado para la captura rápida de texto, no para la extracción estructurada de tablas. Si necesitas los datos en columnas listas para una hoja de cálculo, dedicarás mucho tiempo a la limpieza posterior a la extracción.
¿Es el OCR gratuito lo suficientemente preciso para documentos empresariales?
En texto impreso limpio, las herramientas de OCR gratuitas alcanzan una precisión del 98–99 % a nivel de caracteres. El problema no es la precisión bruta de caracteres: es que esa precisión no equivale a un resultado utilizable. Una precisión del 99 % a nivel de caracteres sigue significando aproximadamente de 5 a 10 errores por página, y esos errores tienden a concentrarse en los números que más importan: montos en dólares, fechas y números de factura. Además, la precisión de caracteres no indica si se conservan las estructuras de las tablas ni si las etiquetas de los campos se asignan correctamente a sus valores. Para documentos que solo necesitan ser buscables —no estructurados—, el OCR gratuito es suficiente. Para documentos en los que campos específicos deben ubicarse en columnas específicas de la hoja de cálculo, la brecha entre «texto preciso» y «datos utilizables» requiere trabajo manual para cerrarse.
¿Cuál es la alternativa de pago más económica al OCR gratuito?
Las herramientas de extracción de documentos con IA más económicas comienzan alrededor de $9/mes —aproximadamente $0.06 por página en el nivel de entrada—. El plan Basic de ImageToTable.ai por $9/mes incluye 150 páginas de extracción con IA con columnas personalizadas, preservación de la estructura de tablas y procesamiento por lotes. Para comparar, los analizadores basados en plantillas como Docparser comienzan en $39/mes, y las plataformas empresariales de IA como Nanonets comienzan en $499/mes. El nivel económico existe —simplemente no es el nivel del que la mayoría oye hablar porque las herramientas empresariales dominan los resultados de búsqueda—. Si solo necesitas extracción ocasional, ImageToTable.ai también ofrece créditos de pago por uso desde $6 por 50 páginas, sin fecha de vencimiento y sin compromiso mensual.
¿La extracción con IA funciona en documentos escritos a mano?
Sí, con expectativas realistas. Los modelos de visión con IA alcanzan una precisión del 85–95 % en texto manuscrito, frente al 60–70 % del OCR tradicional. La precisión depende de la legibilidad de la caligrafía, la calidad del documento y el modelo utilizado. Una caligrafía clara y consistente en un escaneo limpio producirá resultados utilizables. Una caligrafía apretada y apresurada en un recibo arrugado supondrá un reto para cualquier herramienta, incluida la IA. Para un análisis más profundo de la precisión según los tipos de documento y niveles de calidad, nuestra comparativa de la extracción con IA frente al OCR tradicional aborda la dimensión de la precisión en detalle, incluido cómo los modelos de IA manejan la escritura manual, los escaneos de baja calidad y los documentos de contenido mixto.
¿Cuánto tiempo ahorra realmente la extracción con IA por página?
Según puntos de referencia del sector y datos de usuarios, la introducción manual de datos de un documento tarda una media de 2 a 3 minutos por página. La extracción con IA reduce el tiempo de procesamiento a aproximadamente 5 a 10 segundos por página, una mejora de 18 veces. El ahorro de tiempo real, sin embargo, no reside en la velocidad de extracción en sí, sino en la eliminación de la limpieza posterior. El OCR gratuito le ahorra el paso de teclear manualmente, pero añade un paso de corrección manual. La extracción con IA elimina ambos. Para una sola página, la diferencia es de 3 minutos frente a 10 segundos. Para 50 páginas a fin de mes, la diferencia es de 2,5 horas de trabajo frente a menos de 10 minutos, y eso sin contar los errores que introduce la corrección manual.
La economía de las herramientas gratuitas depende de una variable: cuánto vale su tiempo. Para cualquiera que procese documentos con regularidad, las matemáticas se inclinan hacia la extracción de pago mucho antes de que el volumen parezca «grande». El coste de la herramienta es visible en la página de facturación. El coste de la corrección manual es visible en su calendario; una vez que lo note, dejará de llamar «gratuito» al OCR gratuito.
Sin tarjeta de crédito. No es necesario registrarse para la primera página.