OCR gratuit vs extraction de documents par IA :
Le vrai coût du « gratuit »
Les outils d'OCR gratuit n'ont jamais été aussi performants. Google Lens peut extraire le texte d'une photo de reçu. Google Drive OCR transforme une facture scannée en texte consultable. Tesseract fonctionne localement et ne coûte rien. La question n'est pas de savoir si les outils gratuits peuvent lire vos documents — ils le peuvent. La question est de savoir si ce qu'ils produisent est utilisable sans des heures de nettoyage manuel. Pour la plupart des personnes qui traitent plus de quelques documents, la réponse change plus vite qu'elles ne le pensent.
Points clés
- L'OCR gratuit lit parfaitement chaque caractère de votre facture et livre le résultat sous forme de flux de texte indifférencié, sans colonnes, sans étiquettes de champs et sans structure de tableau.
- Transformer ce texte brut en feuille de calcul utilisable demande cinq étapes manuelles par page, et à 30 pages par mois, le travail de correction coûte 37,50 $ — plus que l'abonnement de 9 $ que vous cherchiez à éviter.
- ImageToTable.ai génère des colonnes structurées que vous avez nommées directement dans Excel, de sorte que dix pages prennent quelques secondes au lieu de 30 minutes de réparation de texte.
Ce que l'OCR gratuit offre réellement
La reconnaissance optique de caractères a été conçue pour résoudre un seul problème : transformer une image de texte en caractères exploitables par une machine. Sur cette tâche précise, elle est devenue remarquablement performante. Les moteurs OCR modernes dépassent régulièrement 98 % de précision au niveau des caractères sur des documents imprimés propres. Google Lens, Google Drive OCR, Tesseract et les services gratuits en ligne comme OnlineOCR gèrent tous bien ce niveau de base — consultez notre tour d'horizon complet des outils OCR gratuits si vous voulez la liste complète avec les vraies limites de l'offre gratuite.
Le problème, c'est ce que vous récupérez. L'OCR lit un document de gauche à droite et de haut en bas, puis produit un flux de texte. Déposez une facture fournisseur dans Google Drive OCR et vous obtenez quelque chose comme ceci — chaque mot de la page, dans l'ordre de lecture, sans structure préservée :
ACME Supplies Ltd
123 Commerce Street, Chicago IL 60601
FACTURE
N° de facture : INV-2024-0892 Date : 15 mars 2024
Facturé à : Greenfield Corp Échéance : 14 avril 2024
Description Qté Prix unitaire Montant
Chaises de bureau 4 $285.00 $1,140.00
Lampes de bureau 10 $45.00 $450.00
Total : $1,590.00
Tout y est. Mais « N° de facture » et « Date » sont sur la même ligne, séparés uniquement par un espace. Le tableau des lignes d'article est aplati en lignes de texte — les relations de colonnes entre description, quantité, prix unitaire et montant ont disparu. Le total se trouve en bas, déconnecté de tout ce qui précède. Si vous devez intégrer ces données dans un tableur avec des colonnes étiquetées — « Numéro de facture », « Date », « Fournisseur », « Description de l'article », « Qté », « Prix unitaire », « Montant » — vous repartez de zéro.
Ce n'est pas un bug de l'OCR. C'est ce pour quoi l'OCR a été conçue : lire des caractères, pas comprendre les documents. Le problème, c'est que la tâche que la plupart des gens ont réellement — « intégrer ces données de facture dans mon tableur » — nécessite une compréhension du document, et pas seulement une reconnaissance de caractères.
L'écart entre le texte brut et les données exploitables
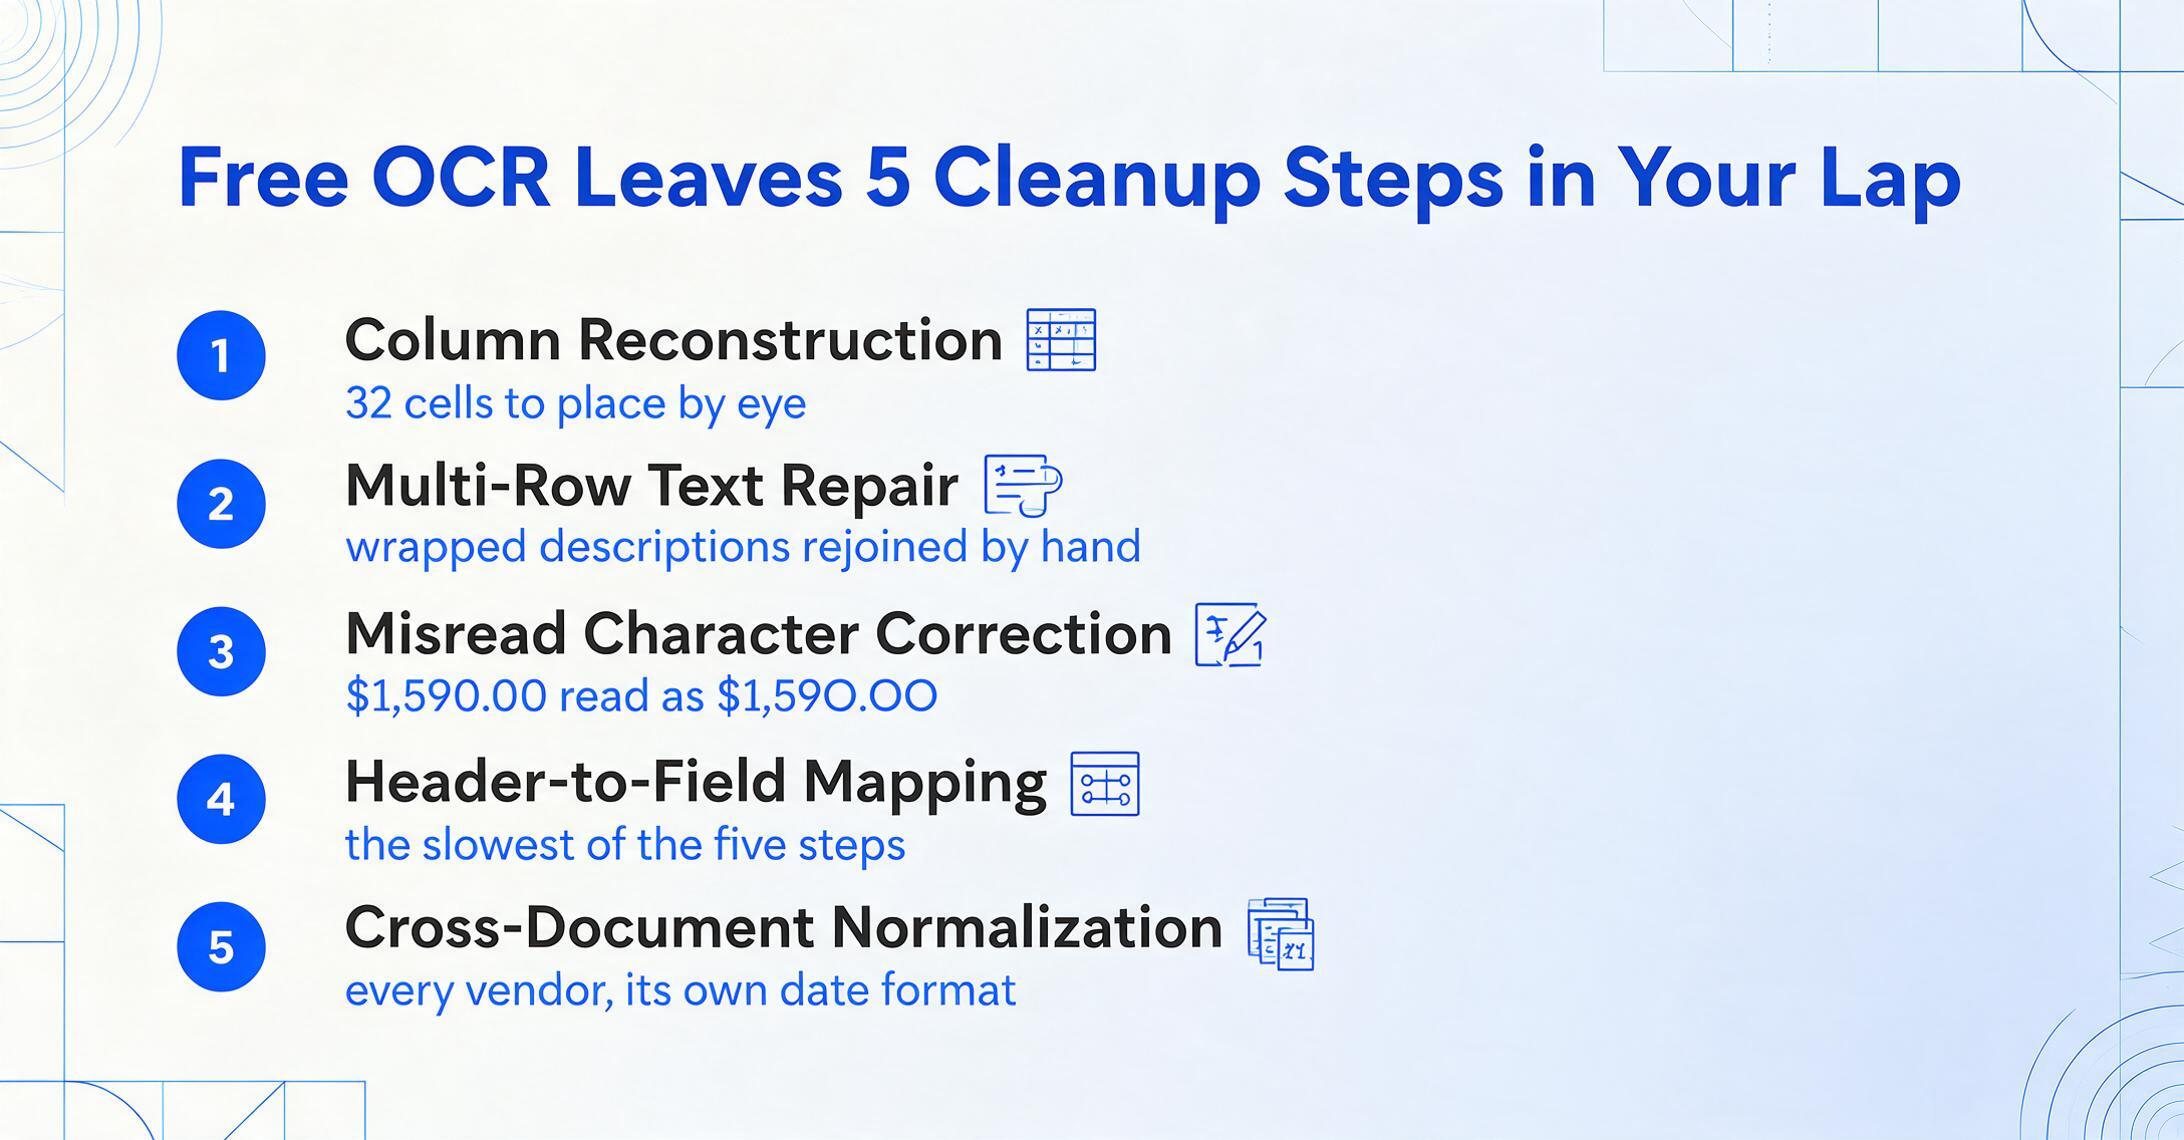
Quand les gens disent « j'ai utilisé un OCR gratuit sur ces factures et ça a fonctionné », ils veulent généralement dire « le texte était là » — pas « les données étaient structurées et prêtes à l'emploi ». Entre la sortie de l'OCR et une feuille de calcul propre, il y a une série d'étapes manuelles dont personne ne parle dans le discours « gratuit ».
Prenons un rapport de dépenses typique avec 8 lignes réparties sur 4 colonnes : description, quantité, prix unitaire, total de ligne. Voici ce qui se passe avec la sortie d'un OCR gratuit :
Reconstruction des colonnes
La sortie OCR est un flux de texte continu. Vous devez réattribuer visuellement chaque morceau de texte à sa colonne. Un tableau à quatre colonnes et 8 lignes signifie 32 cellules individuelles à identifier et à placer.
Réparation du texte sur plusieurs lignes
Les descriptions d'articles qui s'étendent sur deux lignes dans le document d'origine sont divisées en lignes distinctes dans la sortie OCR. Vous devez les réassembler manuellement — pour chaque article avec une description longue, dans chaque document.
Correction des caractères mal lus
Même avec une précision de 98 % sur les caractères, une page de 500 caractères contient en moyenne 10 erreurs. « $1,590.00 » devient « $1,59O.OO » (la lettre O pour le zéro). « Qty » devient « Qtv. » Chaque erreur doit être repérée et corrigée à la main.
Mappage en-tête-vers-champ
Le numéro de facture, la date, le nom du fournisseur et le total se trouvent quelque part dans le flux de texte. Vous devez trouver chacun d'eux, l'extraire et le mapper à l'en-tête de colonne correct dans votre feuille de calcul. C'est l'étape la plus longue — et celle que la plupart des gens oublient dans leurs estimations de temps.
Normalisation du format entre documents
Le fournisseur A formate les dates comme « 03/15/2024 ». Le fournisseur B utilise « 15 mars 2024 ». Le fournisseur C utilise « 2024-03-15 ». Si vous combinez 20 factures dans une seule feuille de calcul, vous avez besoin d'un format de date cohérent — et c'est une autre passe manuelle.
Pour une seule page, ces cinq étapes peuvent prendre 3 minutes. Cela ne semble pas énorme — et pour une page, ça ne l'est pas. Le calcul change avec le volume, et il change plus vite que la plupart des gens ne le calculent. Dix pages : 30 minutes. Trente pages : 90 minutes. Cinquante pages à la clôture de fin de mois : deux heures et demie de travail de correction, en plus du temps déjà pris par l'OCR.
C'est le coût caché de l'OCR gratuit. L'outil ne coûte rien, mais chaque minute de nettoyage manuel est du temps que vous ne consacrez pas à quelque chose qui génère réellement de la valeur — analyser les données, rapprocher les comptes ou conclure le prochain client. Au salaire administratif typique de 25 $/heure, 2,5 heures de correction représentent 62,50 $ de coût de main-d'œuvre. Soudainement, « gratuit » n'est plus l'option la moins chère.
Ce que l'extraction de documents par IA fait différemment — et pourquoi cela compte pour le temps
L'extraction de documents par IA — l'approche qu'utilisent des outils comme ImageToTable.ai — ne tente pas de lire chaque caractère de la page pour ensuite comprendre ce que cela signifie. Elle lit le document visuellement comme le ferait une personne : elle voit la mise en page, comprend quels blocs de texte vont ensemble et identifie des champs spécifiques par leur sens plutôt que par leur position.
Le mécanisme pratique est ce qu'ImageToTable.ai appelle l'Extraction de colonnes personnalisées : vous saisissez les noms de champs souhaités — « Numéro de facture », « Date », « Fournisseur », « Total de ligne » — et l'IA localise chaque valeur n'importe où sur la page en comprenant ce qu'elle signifie, et non où elle se trouve. Un champ étiqueté « INV# » sur la facture d'un fournisseur et « Référence de facture » sur celle d'un autre sont tous deux reconnus comme la même chose et placés sous la même colonne. Pas de modèles, pas de mappage de coordonnées, pas de configuration par fournisseur. Si vous souhaitez voir comment cela se compare à d'autres outils d'extraction par IA plutôt qu'à un simple OCR gratuit, notre comparaison des logiciels d'extraction de données en couvre neuf.
Trois conséquences en aval rendent la différence de temps significative :
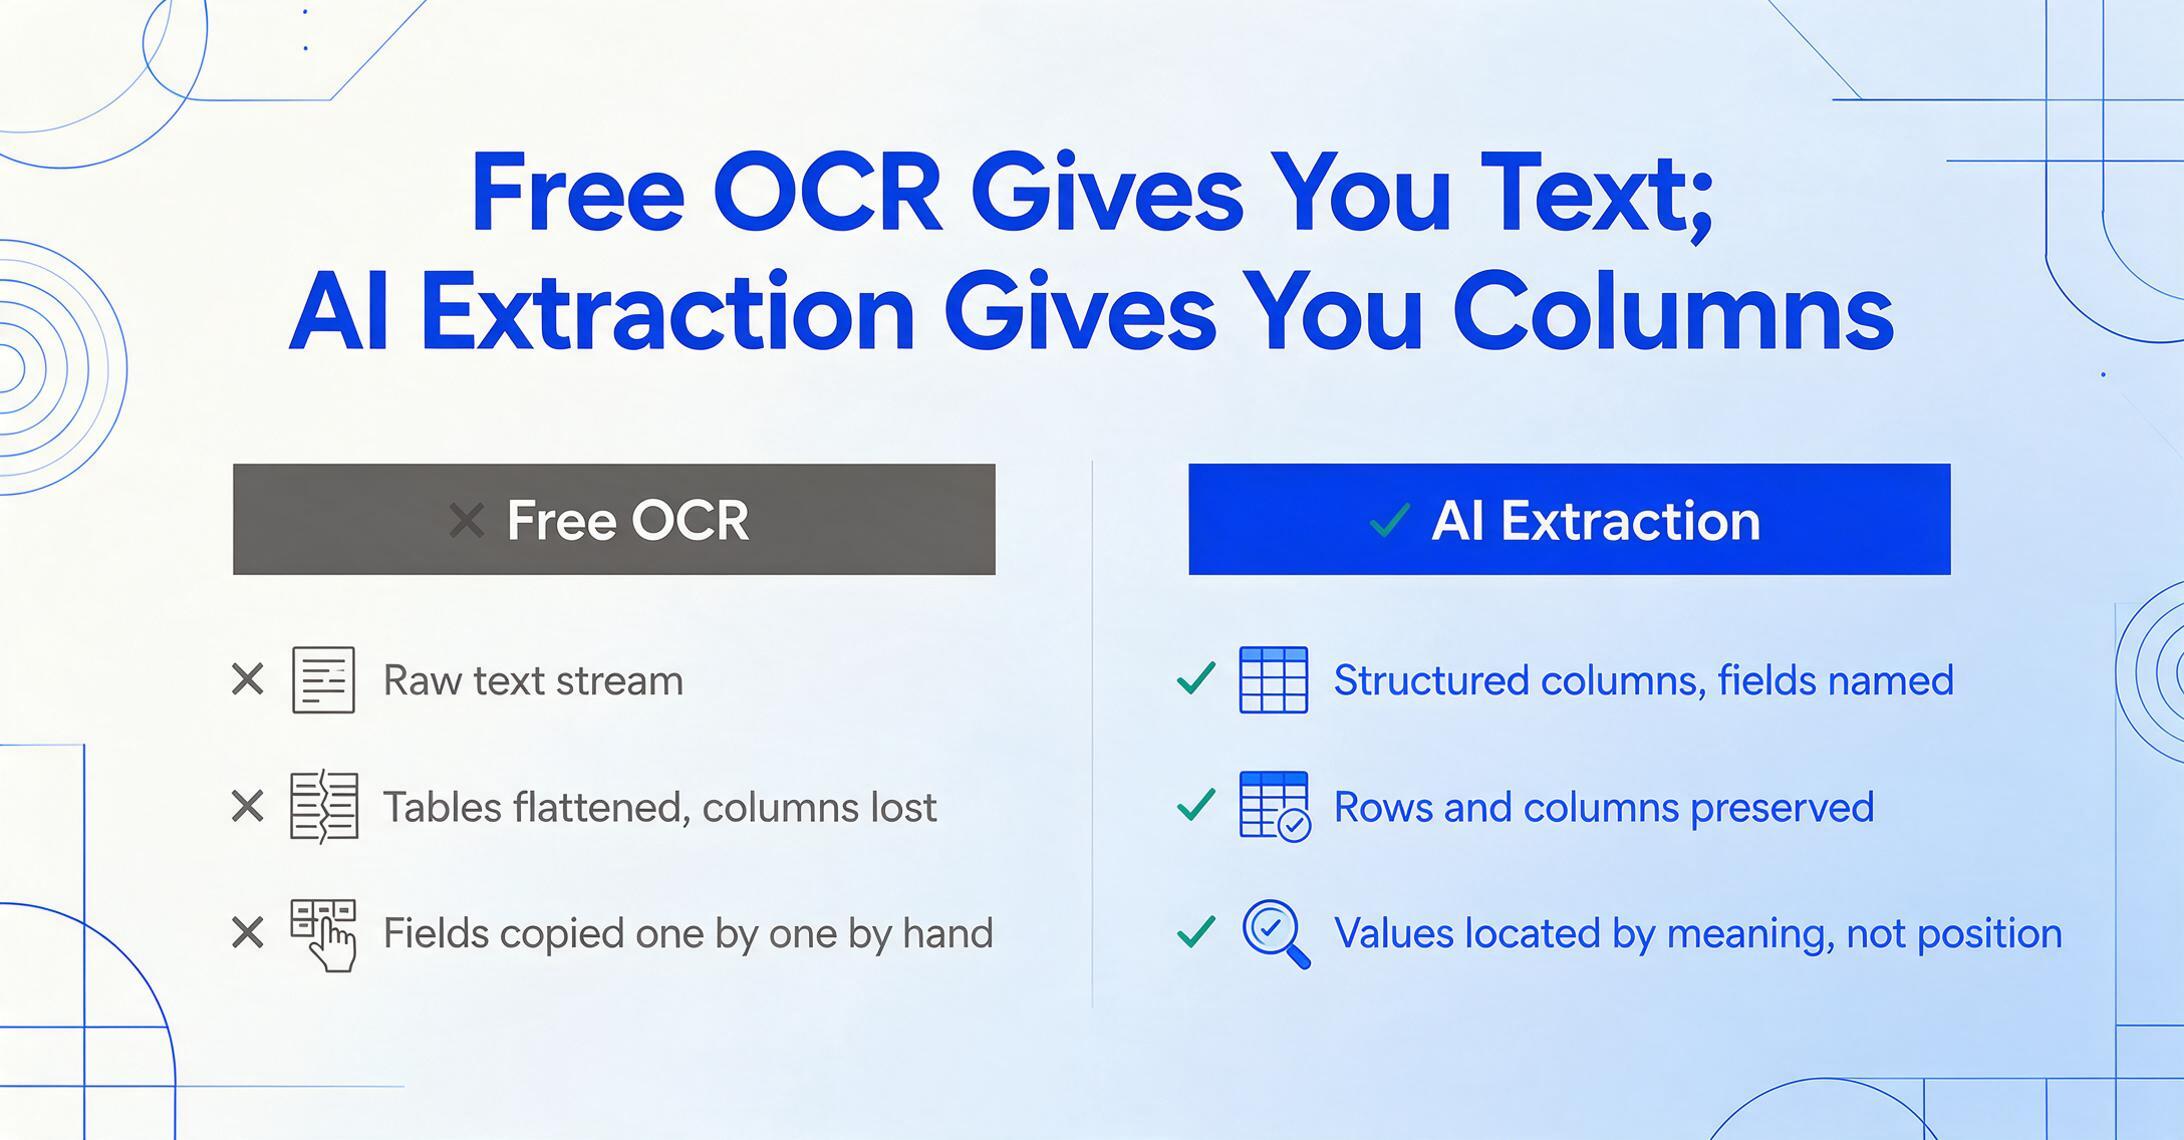
Flux de travail OCR gratuit
- Sortie : flux de texte brut, toute la structure est perdue
- Tableaux : aplatis — les relations entre colonnes sont détruites
- Champs : vous recherchez dans le texte et copiez chaque valeur
- Multi-pages : chaque page est un bloc de texte distinct à corriger
- Écriture manuscrite : la précision chute à 60–70 %
- Formats mixtes : chaque type de mise en page est un nouveau problème d'analyse
Flux de travail d'extraction par IA
- Sortie : colonnes structurées — les champs que vous avez nommés, les valeurs remplies
- Tableaux : lignes et colonnes préservées — prêts pour Excel
- Champs : l'IA les trouve par sens sémantique, pas par emplacement de pixel
- Multi-pages : fusion automatique en un seul tableau de sortie cohérent
- Écriture manuscrite : précision de 85–95 % avec les modèles d'IA visuelle
- Formats mixtes : le même schéma de colonnes fonctionne sur toutes les mises en page
Au-delà de l'extraction de base, l'extraction par IA ajoute des capacités sans équivalent dans l'OCR gratuit. Les colonnes calculées vous permettent de définir des calculs exécutés pendant l'extraction — par exemple, une colonne nommée « Line Total (Qty × Unit Price) » calcule automatiquement le produit pour chaque ligne, détectant les écarts entre le total de ligne indiqué et le calcul réel. Les colonnes inférées permettent à l'IA de classer ou de déduire des informations non explicitement écrites sur le document, comme l'attribution d'une catégorie (« Repas », « Transport », « Bureau ») en fonction du contenu du reçu. Il ne s'agit pas d'étapes de post-traitement dans Excel — elles se produisent pendant l'extraction et apparaissent directement dans votre tableau de sortie.
Les économies de temps se cumulent lorsque vous traitez des documents par lot. Déposez 30 factures dans un outil d'extraction par IA : un schéma de colonnes, un traitement, un fichier de sortie. Les mêmes 30 factures via l'OCR gratuit : 30 extractions de texte distinctes, 30 cycles du processus de nettoyage en cinq étapes. Une comparaison approfondie de l'extraction visuelle par IA par rapport à l'OCR traditionnel a montré que les systèmes OCR basés sur des modèles échouent dès qu'un fournisseur modifie la mise en page de ses factures ou que vous ajoutez un nouveau fournisseur — et la plupart des outils OCR gratuits sont bien plus rudimentaires que les systèmes basés sur des modèles.
Là où « Gratuit » cesse d'être gratuit
L'argument économique en faveur de l'OCR gratuit est le plus fort à très faible volume. Une ou deux pages par mois, traitées une à la fois ? Le nettoyage est gérable. La question est de savoir où se situe le point de bascule : à quel volume mensuel le temps de correction manuelle coûte-t-il plus cher qu'un abonnement à 9 $ ?
Le calcul repose sur trois hypothèses, toutes prudentes. Temps de correction manuelle par page : 3 minutes, sur la base du processus en cinq étapes ci-dessus (en supposant que vous êtes rapide et que les documents sont propres — pour les notes manuscrites ou les scans délavés, le temps peut doubler). Taux horaire effectif : 25 $/heure, un salaire administratif/comptable typique aux États-Unis. Et un abonnement d'extraction par IA à 9 $/mois pour le plan Basic d'ImageToTable.ai, qui inclut 150 crédits (pages) par mois.
| Volume mensuel | Temps de correction OCR gratuit | Coût de main-d'œuvre pour la correction | Coût d'extraction par IA | Économies nettes avec l'IA |
|---|---|---|---|---|
| 5 pages | 15 min | $6.25 | $9.00 | -$2.75 (zone d'équilibre) |
| 10 pages | 30 min | $12.50 | $9.00 | +$3.50 |
| 30 pages | 90 min | $37.50 | $9.00 | +$28.50 |
| 50 pages | 150 min (2,5 h) | $62.50 | $19.00 (Pro plan) | +$43.50 |
| 100 pages | 300 min (5 h) | $125.00 | $19.00 (Pro plan) | +$106.00 |
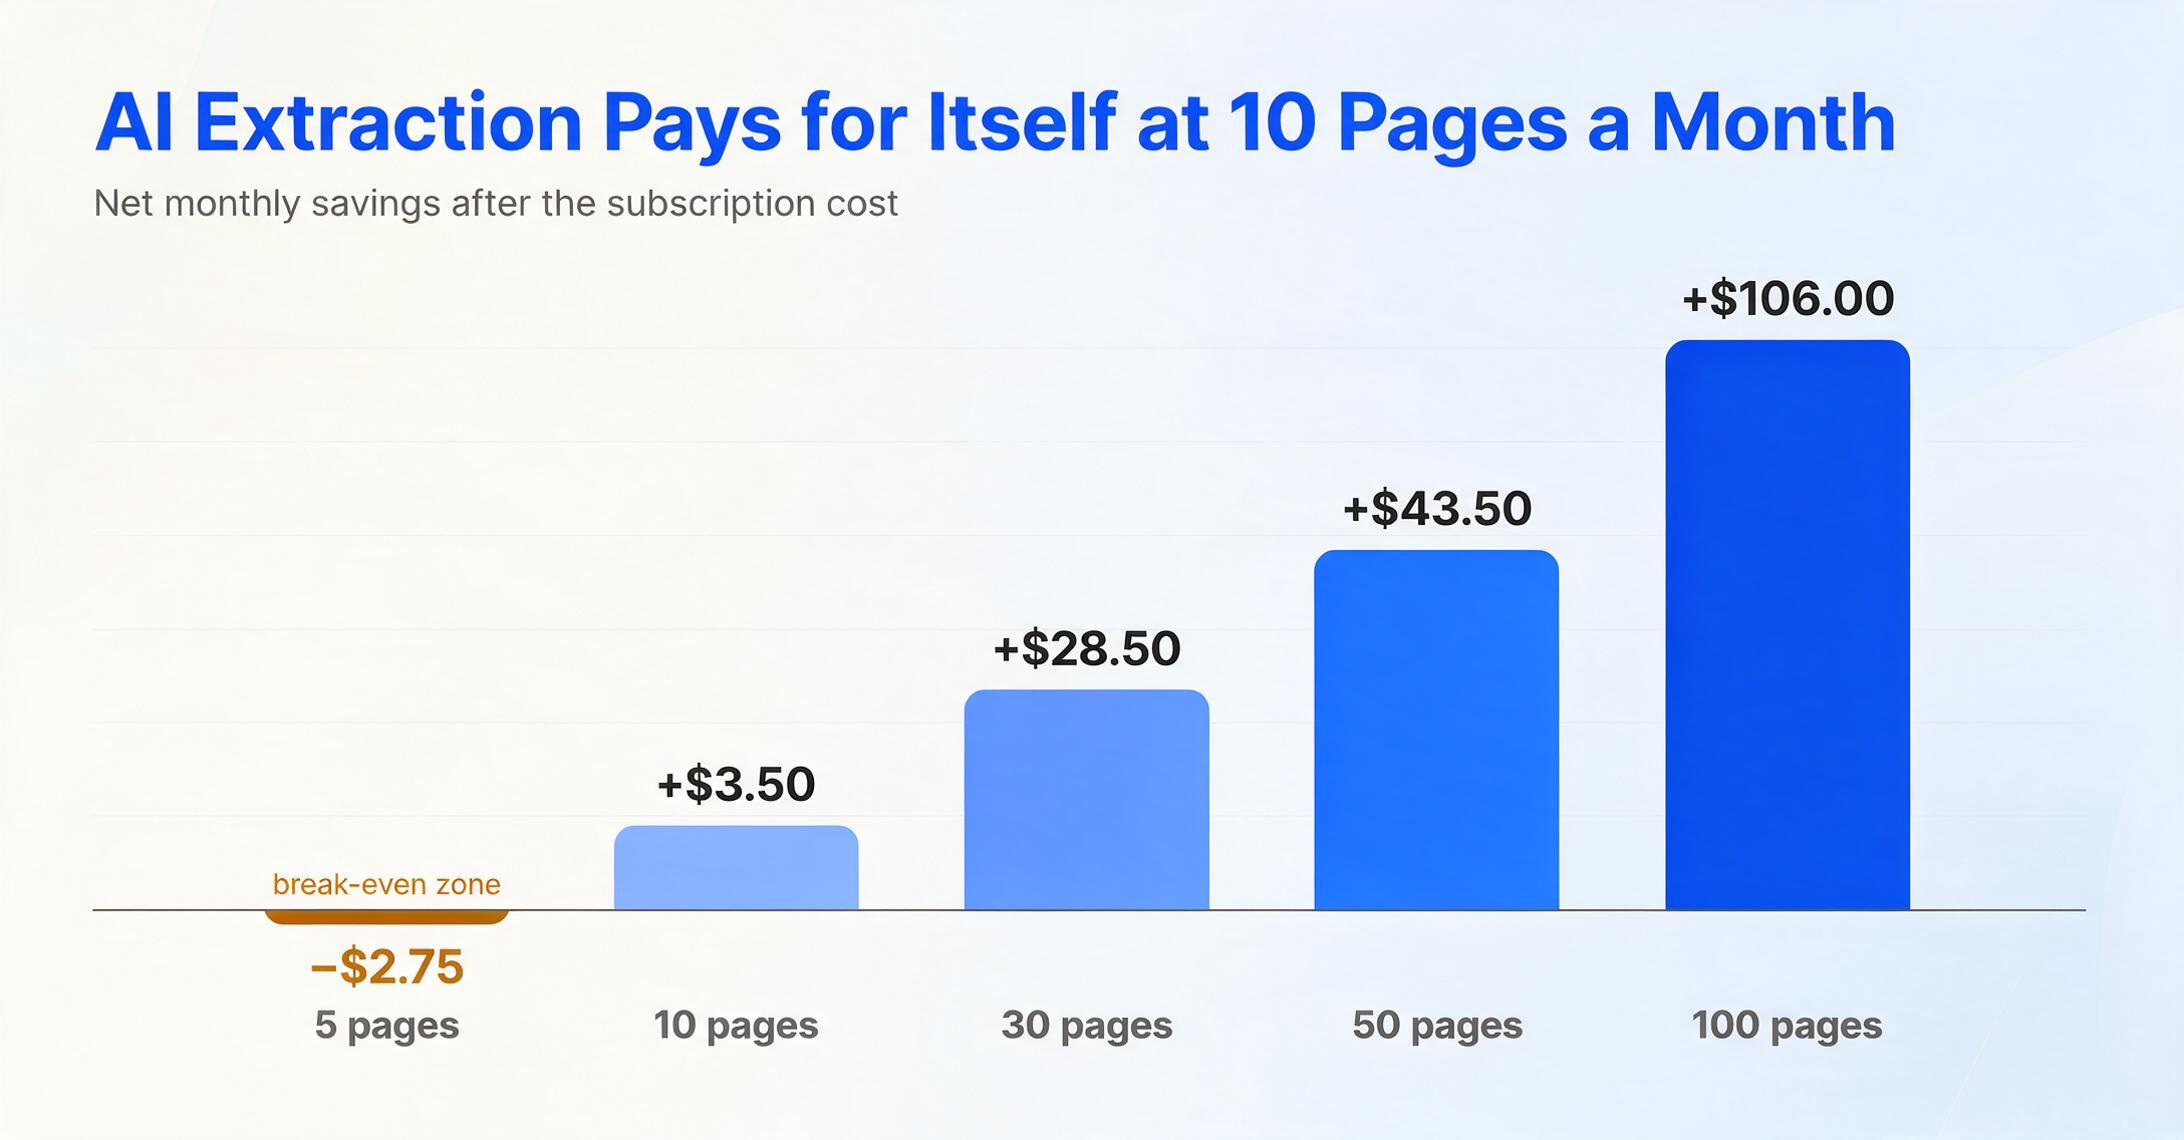
À 5 pages par mois, la correction OCR gratuite coûte environ $6.25 en main-d'œuvre — légèrement moins qu'un abonnement à $9/mois. C'est le volume où la décision dépend réellement de ce que vous pourriez faire d'autre avec ces 15 minutes. Mais la tendance ne s'arrête pas là longtemps. À 10 pages, vous économisez de l'argent avec un abonnement, même avant de prendre en compte l'avantage en précision et la frustration réduite. À 30 pages — un volume réaliste pour un freelance avec quelques clients réguliers — un plan à $9 permet d'économiser plus de $28 par mois en main-d'œuvre seule.
Les chiffres deviennent plus frappants à des volumes plus élevés. Si vous traitez 50 factures en fin de mois, deux heures et demie de correction ne représentent pas seulement de l'argent — c'est du temps que vous ne pouvez pas récupérer. Et contrairement à un travailleur horaire, l'OCR gratuit ne devient pas plus rapide avec la pratique. Le même processus en cinq étapes se répète pour chaque page, chaque lot, chaque mois. Pour une vue d'ensemble de ce que coûtent réellement les différents outils et plans, consultez notre guide des prix 2026 pour l'extraction de documents par IA, qui détaille le coût par document pour chaque niveau.
Il convient également de noter que ce calcul ne compte que le temps — il ne prend pas en compte les coûts liés aux erreurs. Un chiffre mal lu dans un total (1 590 $ vs 1 5O0 $) ou une valeur de colonne mal placée (quantité là où devrait se trouver le prix unitaire) crée des problèmes en aval qui prennent plus de temps à corriger que l'extraction initiale. Ces cycles de correction d'erreurs sont invisibles dans le récit « gratuit » et très visibles à la clôture mensuelle.
Quand l'OCR gratuit reste la bonne réponse
Rien de tout cela ne signifie que l'OCR gratuit est inutile. Cela signifie que son utilité a des limites, et connaître ces limites fait gagner du temps.
Les outils d'OCR gratuits fonctionnent bien pour :
- Rendre un PDF interrogeable. Si vous devez rechercher une clause spécifique dans un contrat scanné, l'OCR de Google Drive vous y mènera.
- Extraire un court bloc de texte. Un paragraphe d'un scan, une adresse d'un formulaire — une extraction à faible enjeu et à faible volume.
- Les flux de travail à format unique, à volume élevé et à documents stables. Si vous traitez 1 000 formulaires identiques avec exactement la même mise en page chaque mois, un pipeline d'OCR basé sur un modèle (même gratuit, avec une configuration suffisante) peut fonctionner — même s'il s'agit de plus en plus d'un cas d'utilisation de niche en dehors des systèmes gouvernementaux et hérités.
- Les documents où la structure n'a pas d'importance. L'OCR pour l'indexation d'archives, où l'objectif est de « trouver quel document contient ce mot-clé », et non « d'obtenir des champs spécifiques dans une feuille de calcul ».
L'OCR gratuit échoue lorsque votre flux de travail exige une extraction au niveau des champs à partir de documents aux mises en page variées — ce qui décrit la plupart des traitements documentaires réels. Si vous gérez des factures de plusieurs fournisseurs, des reçus de différents commerçants ou des relevés bancaires de différentes banques, l'OCR gratuit vous donne un texte brut qui doit encore être analysé. C'est dans cette étape d'analyse que se trouve le coût réel.
Pour une vue pratique de ce que vous obtenez à chaque niveau de prix — des outils à 0 $ aux formules à 9 $/mois en passant par les formules à 19 $/mois avec une capacité supérieure — notre comparaison de l'utilisation d'un seul outil pour tous les types de documents par rapport à plusieurs outils spécialisés détaille le calcul du coût total de possession selon différents scénarios de volume.
Pour les freelances et les indépendants en particulier — un groupe qui commence souvent avec des outils gratuits parce que le budget semble trop serré pour un abonnement — la question mérite sa propre analyse. Notre analyse de l'extraction de documents avec un budget de freelance fait correspondre les volumes mensuels typiques aux tailles de formules afin que vous puissiez voir si votre utilisation réelle justifie ou non une formule payante. Spoiler : la plupart des personnes qui traitent plus de 10 pages par mois franchissent la ligne.
Ce que 9 $/mois vous apporte et que l’OCR gratuit n’offrira jamais
À ce stade, la question passe de « gratuit ou payant » à « que propose réellement le niveau payant le plus bas que les outils gratuits ne peuvent pas offrir ? » La réponse tient en cinq capacités qui éliminent directement les cinq étapes de nettoyage manuel décrites précédemment.
Extraction de colonnes personnalisées
Vous définissez les colonnes. L’IA les remplit avec les données de n’importe quel document, quel que soit sa mise en page. Aucune recherche, aucun copier-coller, aucune création de modèle. Les noms de colonnes que vous saisissez deviennent les en-têtes de votre fichier de sortie — directement, sans étape intermédiaire.
Préservation de la structure des tableaux
Les tableaux de lignes détaillées avec plusieurs colonnes restent des tableaux. Les relations entre lignes et colonnes sont préservées, de sorte que la description reste associée à la bonne quantité et au bon montant — sans être aplatie dans un flux de texte indifférencié.
Traitement par lots
Déposez 30 factures, recevez un seul fichier Excel avec toutes les données fusionnées dans un tableau unique. Chaque document est traité selon le même schéma de colonnes. Cela seul fait gagner plus de temps que ne coûte l’abonnement — et ce, chaque mois.
Normalisation du format
Les dates, montants et nombres sont automatiquement standardisés sur tous les documents sources, quelle que soit la façon dont chaque fournisseur les formate. Aucune passe de reformatage manuel.
La comparaison devient particulièrement claire si l’on considère le modèle en libre-service. Aucun appel commercial, aucun engagement minimum, aucune procédure d’achat — le parcours de l’inscription au premier résultat prend moins de deux minutes. Pour en savoir plus sur pourquoi les contrats d’extraction de documents de type entreprise ne sont pas la seule voie, voyez comment l’extraction de documents par IA sans contrat d’entreprise se compare au modèle traditionnel « réserver une démo, parler aux ventes, signer un contrat de 12 mois » que les utilisateurs d’OCR gratuit cherchent justement à éviter.
FAQ
Google Lens peut-il extraire des données de tableau dans Excel ?
Google Lens peut reconnaître le texte d'une image de tableau et vous permettre de le copier dans le presse-papiers de votre appareil. Cependant, la structure du tableau — lignes, colonnes, cellules fusionnées et alignement des colonnes — n'est pas préservée. Ce que vous collez dans Excel nécessitera une réorganisation manuelle : séparer le texte fusionné, réaligner les colonnes et corriger la mise en forme. Google Lens est conçu pour une capture de texte rapide, pas pour une extraction structurée de tableaux. Si vous avez besoin des données dans des colonnes prêtes pour un tableur, vous passerez un temps considérable au nettoyage après extraction.
L'OCR gratuit est-il assez précis pour les documents professionnels ?
Sur un texte imprimé propre, les outils OCR gratuits atteignent une précision de 98 à 99 % au niveau des caractères. Le problème n'est pas la précision brute des caractères — c'est que la précision des caractères ne signifie pas une sortie exploitable. Une précision de 99 % au niveau des caractères signifie encore environ 5 à 10 erreurs par page, et ces erreurs ont tendance à se concentrer sur les chiffres les plus importants : montants en dollars, dates et numéros de facture. De plus, la précision des caractères ne dit rien sur la préservation des structures de tableau ou sur le bon mappage des étiquettes de champs avec leurs valeurs. Pour les documents qui doivent seulement être consultables — et non structurés — l'OCR gratuit suffit. Pour les documents où des champs spécifiques doivent atterrir dans des colonnes précises d'un tableur, l'écart entre « texte précis » et « données exploitables » exige un travail manuel pour être comblé.
Quelle est l'alternative payante la moins chère à l'OCR gratuit ?
Les outils d'extraction de documents par IA les moins chers commencent autour de 9 $/mois — soit environ 0,06 $ par page au niveau d'entrée. Le plan Basic d'ImageToTable.ai à 9 $/mois comprend 150 pages d'extraction par IA avec colonnes personnalisées, préservation de la structure du tableau et traitement par lots. À titre de comparaison, les analyseurs basés sur des modèles comme Docparser commencent à 39 $/mois, et les plateformes d'entreprise axées sur l'IA comme Nanonets commencent à 499 $/mois. Le niveau économique existe — c'est juste celui dont on parle le moins, car les outils d'entreprise dominent les résultats de recherche. Si vous n'avez besoin que d'une extraction occasionnelle, ImageToTable.ai propose également des crédits à l'utilisation à partir de 6 $ pour 50 pages, sans date d'expiration et sans engagement mensuel.
L'extraction par IA fonctionne-t-elle sur les documents manuscrits ?
Oui, avec des attentes réalistes. Les modèles de vision par IA atteignent une précision de 85 à 95 % sur le texte manuscrit, contre 60 à 70 % pour l'OCR traditionnel. La précision dépend de la lisibilité de l'écriture, de la qualité du document et du modèle utilisé. Une écriture claire et régulière sur un scan propre produira des résultats utilisables. Une écriture serrée et hâtive sur un reçu froissé mettra au défi n'importe quel outil — y compris l'IA. Pour un traitement plus approfondi de la précision selon les types de documents et les niveaux de qualité, notre comparaison de l'extraction par IA et de l'OCR traditionnel couvre la dimension de la précision en détail, y compris la façon dont les modèles d'IA gèrent l'écriture manuscrite, les scans de faible qualité et les documents à contenu mixte.
Combien de temps l'extraction par IA fait-elle réellement gagner par page ?
D'après les références du secteur et les données utilisateurs, la saisie manuelle des données d'un document prend en moyenne 2 à 3 minutes par page. L'extraction par IA réduit le temps de traitement à environ 5 à 10 secondes par page — une amélioration de la vitesse de 18×. Les gains de temps réels ne résident toutefois pas dans la vitesse d'extraction elle-même, mais dans l'élimination du nettoyage après extraction. L'OCR gratuit vous évite l'étape de saisie manuelle, mais ajoute une étape de correction manuelle. L'extraction par IA élimine les deux. Pour une seule page, la différence est de 3 minutes contre 10 secondes. Pour 50 pages en fin de mois, la différence est de 2,5 heures de travail contre moins de 10 minutes — et ce, avant de tenir compte des erreurs introduites par la correction manuelle.
L'économie des outils gratuits repose sur une variable : la valeur de votre temps. Pour quiconque traite des documents régulièrement, le calcul penche vers l'extraction payante bien avant que le volume ne semble « important ». Le coût de l'outil est visible sur une page de facturation. Le coût de la correction manuelle est visible sur votre calendrier — une fois que vous le remarquez, vous cessez de qualifier l'OCR gratuit de « gratuit ».
Aucune carte de crédit requise. Aucune inscription nécessaire pour la première page.