無料OCR vs AI文書抽出:
「無料」の本当のコスト
無料OCRツールはかつてないほど高性能になっています。Google Lensはレシート写真からテキストを抽出できます。Google DriveのOCRはスキャンした請求書を検索可能なテキストに変換します。Tesseractはローカルで動作し、費用はかかりません。問題は、無料ツールがドキュメントを読み取れるかどうかではありません。読み取れます。問題は、その出力が手動でのクリーンアップなしに使えるかどうかです。数枚以上のドキュメントを処理するほとんどの人にとって、その答えは予想以上に早く変わります。
重要なポイント
- 無料OCRは請求書のすべての文字を完璧に読み取り、列もフィールドラベルもテーブル構造もない、区別のないテキストの流れとして結果を出力します。
- その生のテキストを使えるスプレッドシートにするには、ページごとに5つの手動ステップが必要で、月30ページの場合、修正作業のコストは37.50ドルになります。これは、回避しようとしていた月9ドルのサブスク料金を上回ります。
- ImageToTable.aiは、指定した構造化列をExcelに直接出力するため、10ページが30分のテキスト修正ではなく数秒で完了します。
無料OCRが実際に提供するもの
OCR(光学文字認識)は、テキストの画像を機械可読な文字に変換するという単一の課題を解決するために設計されました。その限定的なタスクに限れば、OCRは驚くほど優れています。最新のOCRエンジンは、きれいな印刷文書で98%を超える文字精度を日常的に達成します。Google Lens、Google Drive OCR、Tesseract、そしてOnlineOCRのような無料オンラインサービスも、この基本レベルをしっかり処理できます。実際の無料枠の制限を含む完全なリストが必要な場合は、無料OCRツールの完全ガイドをご覧ください。
問題は、何が返ってくるかです。OCRは文書を左から右、上から下に読み取り、テキストストリームを出力します。サプライヤーの請求書をGoogle Drive OCRに入れると、次のような出力が得られます。ページ上のすべての単語が、読み順のまま、構造が一切保持されずに出力されます。
ACME Supplies Ltd
123 Commerce Street, Chicago IL 60601
請求書
請求書番号: INV-2024-0892 日付: 2024年3月15日
請求先: Greenfield Corp 支払期限: 2024年4月14日
品目 数量 単価 金額
オフィスチェア 4 $285.00 $1,140.00
デスクランプ 10 $45.00 $450.00
合計: $1,590.00
すべての情報は含まれています。しかし「請求書番号」と「日付」は、スペースだけで区切られた同じ行にあります。明細の表はテキストの行に平坦化され、品目・数量・単価・金額という列の関係は失われています。合計は一番下にあり、その上のすべてから切り離されています。このデータを「請求書番号」「日付」「仕入先」「品目説明」「数量」「単価」「金額」といったラベル付きの列を持つスプレッドシートに入れる必要がある場合、ゼロから始めることになります。
これはOCRのバグではありません。OCRが設計された目的は、文字を読むことであり、文書を理解することではありません。問題は、ほとんどの人が実際に抱えるタスク、つまり「この請求書のデータを自分のスプレッドシートに入れる」という作業が、単なる文字認識ではなく、文書の理解を必要とする点です。
生テキストと利用可能なデータのギャップ
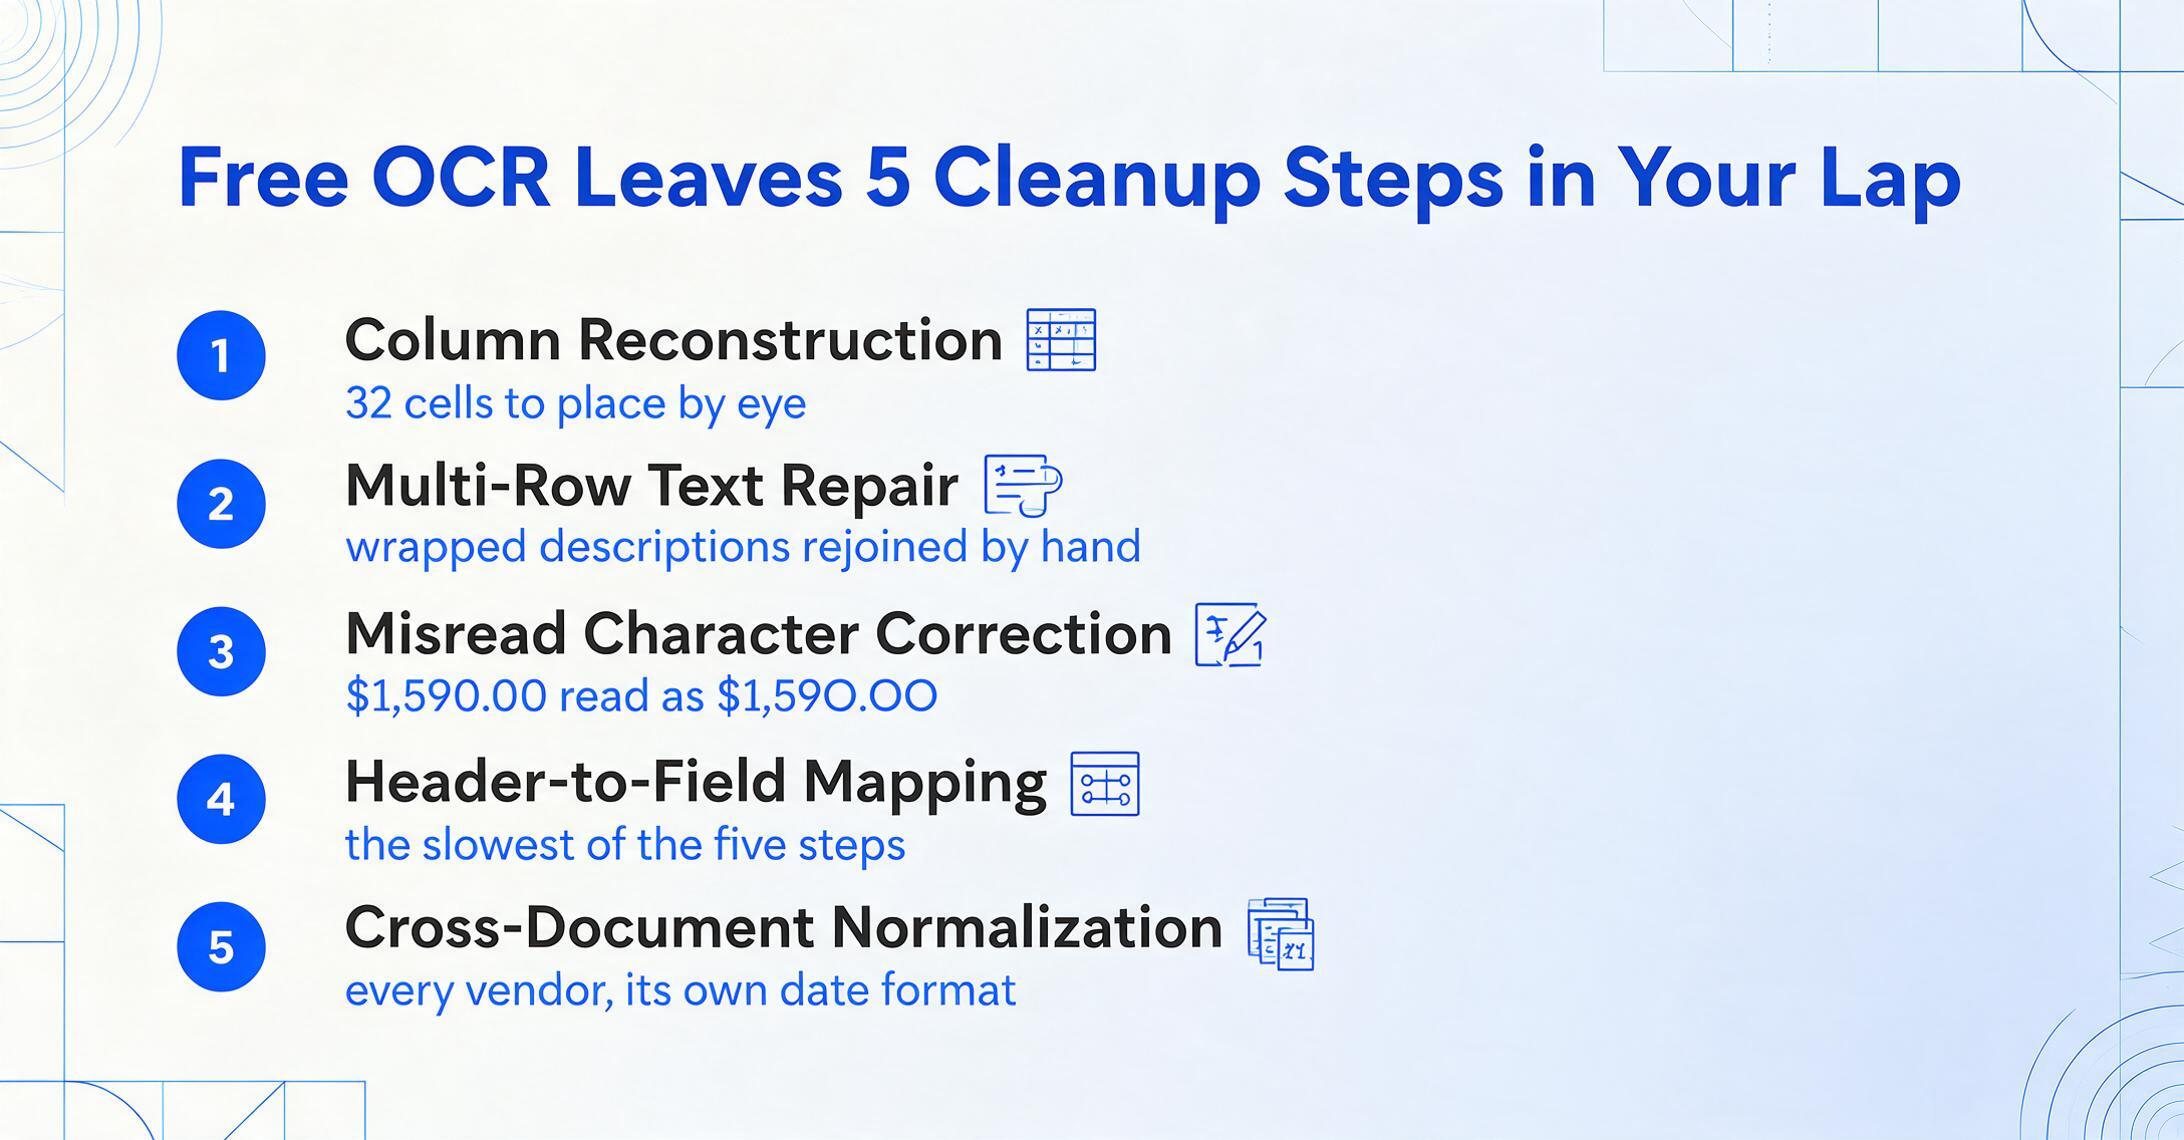
人々が「これらの請求書に無料OCRを使ったらうまくいった」と言うとき、通常は「テキストはそこにあった」という意味であって、「データが構造化され、すぐに使える状態だった」という意味ではありません。OCR出力とクリーンなスプレッドシートの間には、「無料」という話では誰も触れない一連の手動ステップが存在します。
4つの列(説明、数量、単価、行合計)に8つの明細項目がある典型的な経費報告書を考えてみましょう。無料のOCR出力では次のようなことが起こります。
列の再構築
OCRの出力は連続したテキストストリームです。どのテキストがどの列に属するかを視覚的に再マッピングする必要があります。4列・8行のテーブルは、識別して配置すべきセルが32個あることを意味します。
複数行テキストの修復
元の文書で2行にまたがる品目説明は、OCR出力では別々の行に分割されます。長い説明があるすべての品目について、すべての文書で手動で再結合する必要があります。
誤読文字の修正
文字精度が98%でも、500文字のページでは平均10件のエラーが発生します。「$1,590.00」が「$1,59O.OO」(ゼロが文字Oに)になったり、「Qty」が「Qtv.」になったりします。各エラーを発見して手動で修正する必要があります。
ヘッダーへのフィールドマッピング
請求書番号、日付、ベンダー名、合計金額はテキストストリームのどこかにあります。それぞれを見つけ出し、抽出し、スプレッドシートの正しい列ヘッダーにマッピングする必要があります。これは最も時間がかかるステップであり、ほとんどの人が時間見積もりで忘れがちなステップでもあります。
文書間のフォーマット統一
ベンダーAは日付を「03/15/2024」形式で、ベンダーBは「15 March 2024」形式で、ベンダーCは「2024-03-15」形式で表記します。20件の請求書を1つのスプレッドシートにまとめる場合、一貫した日付形式が必要です。これもまた手動での作業が発生します。
1ページの場合、これら5つのステップに約3分かかるかもしれません。それほど大したことには聞こえません。実際、1ページなら大したことはありません。しかし、ボリュームが増えると計算は変わります。しかも、ほとんどの人が計算するよりも速く変わります。10ページ:30分。30ページ:90分。月末締めで50ページ:OCRがすでに要した時間に加えて、2時間半の修正作業が必要になります。
これが無料OCRの隠れたコストです。ツール自体は無料でも、手動クリーンアップに費やす毎分は、データ分析、勘定照合、次のクライアント獲得といった、実際に価値を生む作業に使えない時間です。一般的な事務職の時給25ドルで計算すると、2.5時間の修正作業は人件費62.50ドルに相当します。そうなると、「無料」が最も安い選択肢とは限らなくなります。
AI抽出が異なる点 — それが時間に与える影響
AI文書抽出 — ImageToTable.aiのようなツールが採用するアプローチ — は、ページ上のすべての文字を読み取ってから意味を解釈するのではありません。人間と同じように文書を視覚的に読み取ります。レイアウトを認識し、どのテキストブロックがまとまりかを理解し、位置ではなく意味によって特定のフィールドを識別します。
実際の仕組みは、ImageToTable.aiが「カスタム列抽出」と呼ぶものです。「請求書番号」「日付」「仕入先」「行合計」など、必要なフィールド名を入力すると、AIがページ上のどこにあっても、その意味を理解して各値を特定します。ある仕入先の請求書では「INV#」、別の仕入先では「Bill Reference」とラベル付けされたフィールドも、同じものとして認識され、同じ列に配置されます。テンプレートも、座標マッピングも、仕入先ごとの設定も不要です。無料OCRではなく他のAI抽出ツールと比較したい場合は、データ抽出ソフトウェア比較で9つのツールを取り上げています。
時間の差を顕著にする、3つの下流への影響があります。
無料OCRのワークフロー
- 出力: 生のテキストストリーム、構造はすべて失われる
- 表: フラット化され、列の関係が破壊される
- フィールド: テキストダンプを検索し、各値を手動でコピーする
- 複数ページ: 各ページが個別のテキストブロックとなり、修正が必要
- 手書き文字: 精度が60〜70%に低下
- 混在フォーマット: レイアウトの種類ごとに新たな解析問題が発生
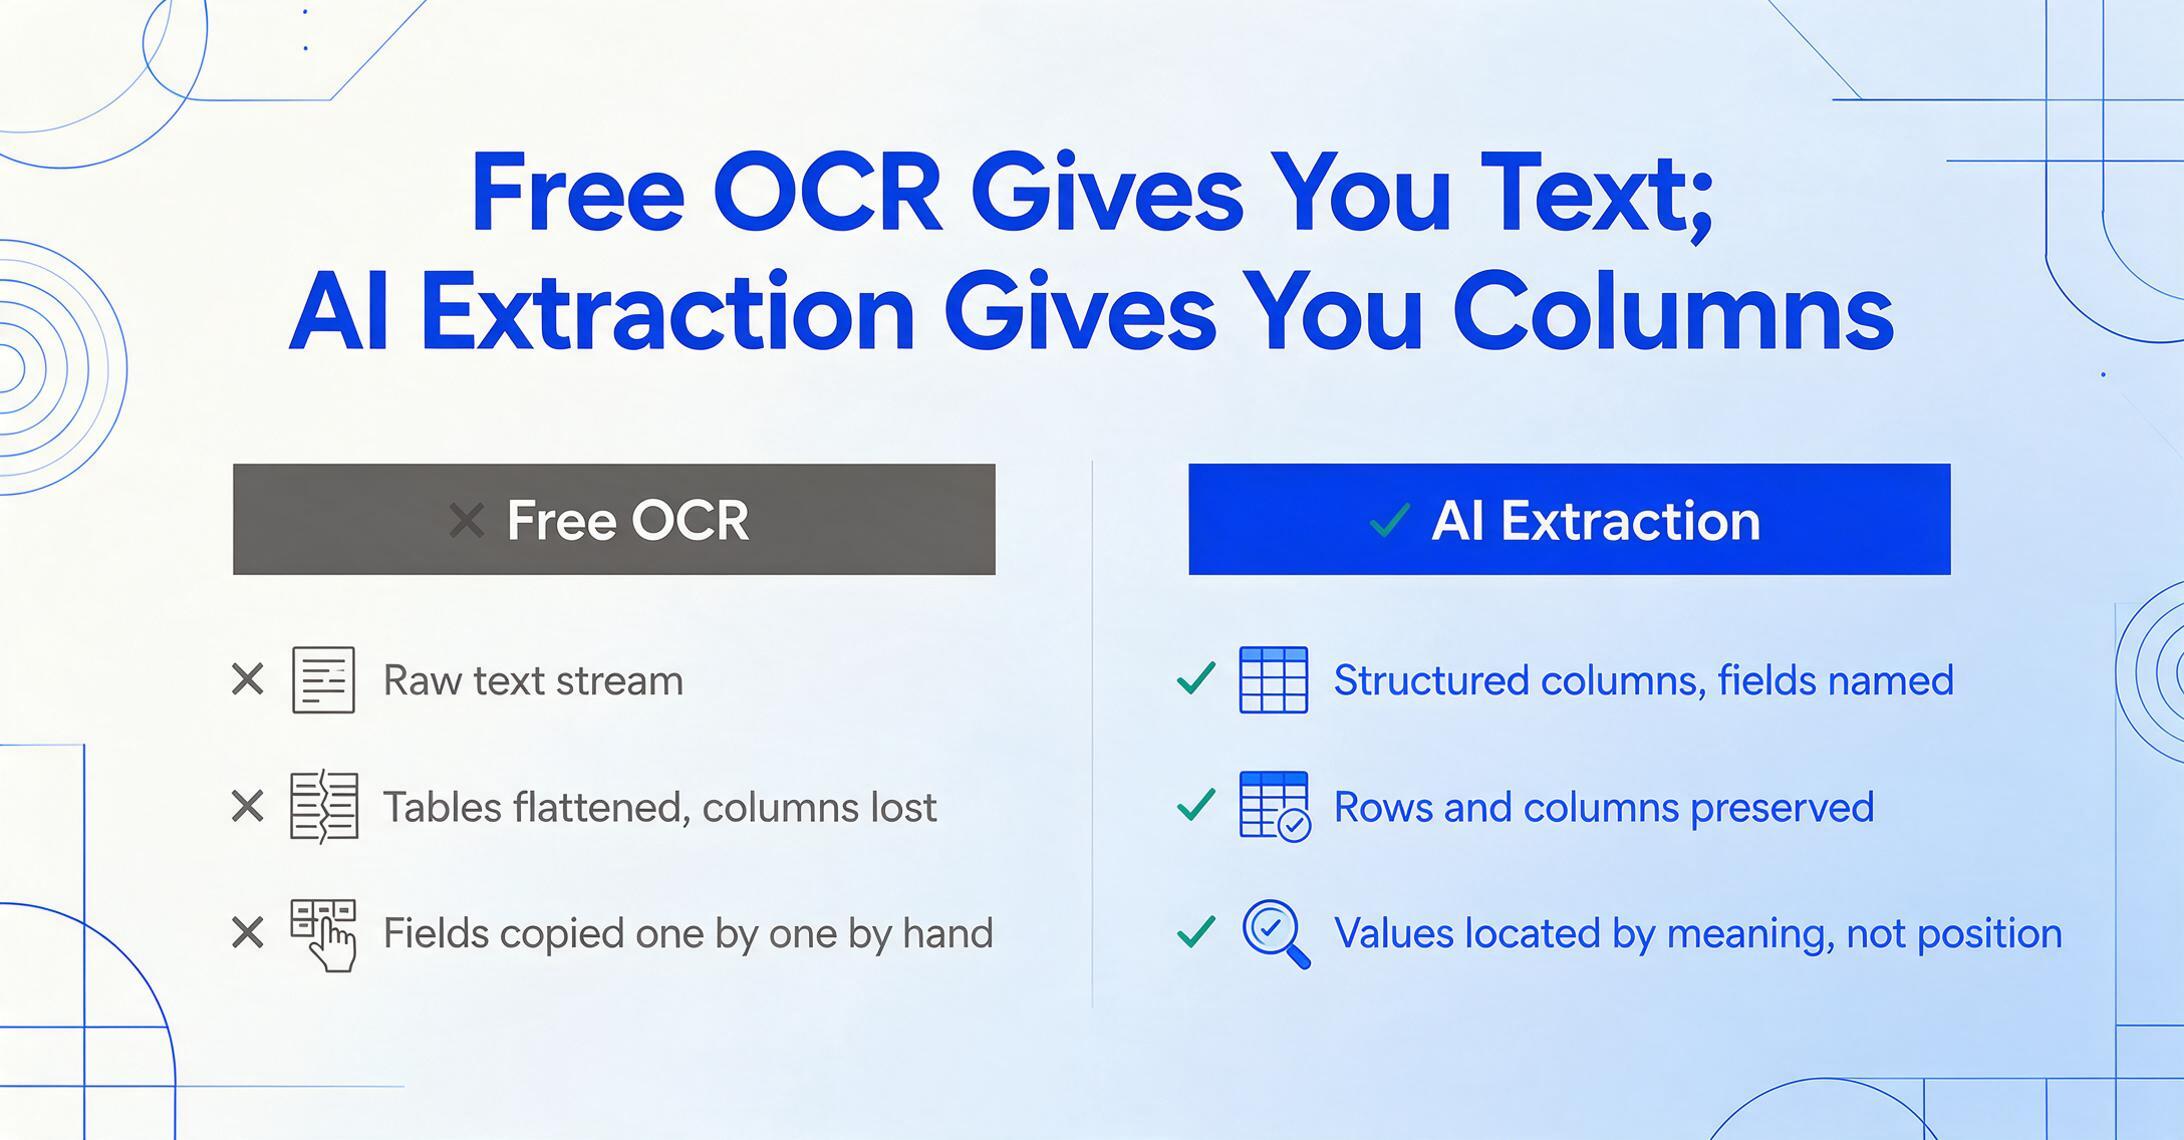
AI抽出のワークフロー
- 出力: 構造化された列 — 指定したフィールド名と入力された値
- 表: 行と列が保持され、Excelですぐに使用可能
- フィールド: AIがピクセル位置ではなく意味で特定
- 複数ページ: 1つの一貫した出力テーブルに自動マージ
- 手書き文字: 視覚AIモデルで85〜95%の精度
- 混在フォーマット: 同じ列スキーマが全レイアウトで機能
基本的な抽出を超えて、AI抽出は無料のOCRにはない機能を追加します。計算列では、抽出中に実行される計算を定義できます。たとえば、「Line Total (Qty × Unit Price)」という名前の列は、各行の積を自動的に計算し、記載された行合計と実際の計算との間の不一致を検出します。推論列では、AIがドキュメントに明示的に書かれていない情報を分類または導出できます。たとえば、レシートの内容に基づいてカテゴリ(「Meals」「Transport」「Office」)を割り当てることができます。これらはExcelでの後処理ステップではなく、抽出中に実行され、出力テーブルに直接表示されます。
ドキュメントをバッチで処理すると、時間の節約はさらに大きくなります。30枚の請求書をAI抽出ツールに入れると、1つの列スキーマ、1回の処理実行、1つの出力ファイルで完了します。同じ30枚の請求書を無料のOCRで処理すると、30個の別々のテキストダンプと、5ステップのクリーンアッププロセスを30回繰り返すことになります。AIビジョン抽出と従来のOCRの詳細な比較では、テンプレートベースのOCRシステムは、ベンダーが請求書のレイアウトを変更したり、新しいサプライヤーを追加したりするたびに壊れることが判明しています。そして、ほとんどの無料OCRツールは、テンプレートベースのシステムよりもはるかに原始的です。
「無料」が無料でなくなる地点
無料のOCRを使い続ける経済的根拠が最も強いのは、非常に低いボリュームの場合です。月に1〜2ページを1枚ずつ処理する場合?クリーンアップは管理可能です。問題は、クロスオーバーポイントがどこにあるかです。どの月間ボリュームで、手動修正の時間コストが9ドルのサブスクリプションよりも高くなるのでしょうか?
この計算では3つの前提を使用しており、すべて控えめなものです。ページあたりの手動修正時間:3分(上記の5ステッププロセスに基づく。これは、あなたが速く、ドキュメントがきれいであることを前提としています。手書きのメモや色あせたスキャンの場合、時間は2倍になる可能性があります)。実効時給:25ドル/時間(米国における一般的な管理・簿記の賃金)。そして、ImageToTable.aiのBasicプランのAI抽出サブスクリプションは月額9ドルで、月150クレジット(ページ)が含まれます。
| 月間ボリューム | 無料OCR修正時間 | 修正の人件費 | AI抽出コスト | AIによる純節約額 |
|---|---|---|---|---|
| 5ページ | 15分 | $6.25 | $9.00 | -$2.75(損益分岐点ゾーン) |
| 10ページ | 30分 | $12.50 | $9.00 | +$3.50 |
| 30ページ | 90分 | $37.50 | $9.00 | +$28.50 |
| 50ページ | 150分(2.5時間) | $62.50 | $19.00(Proプラン) | +$43.50 |
| 100ページ | 300分(5時間) | $125.00 | $19.00(Proプラン) | +$106.00 |
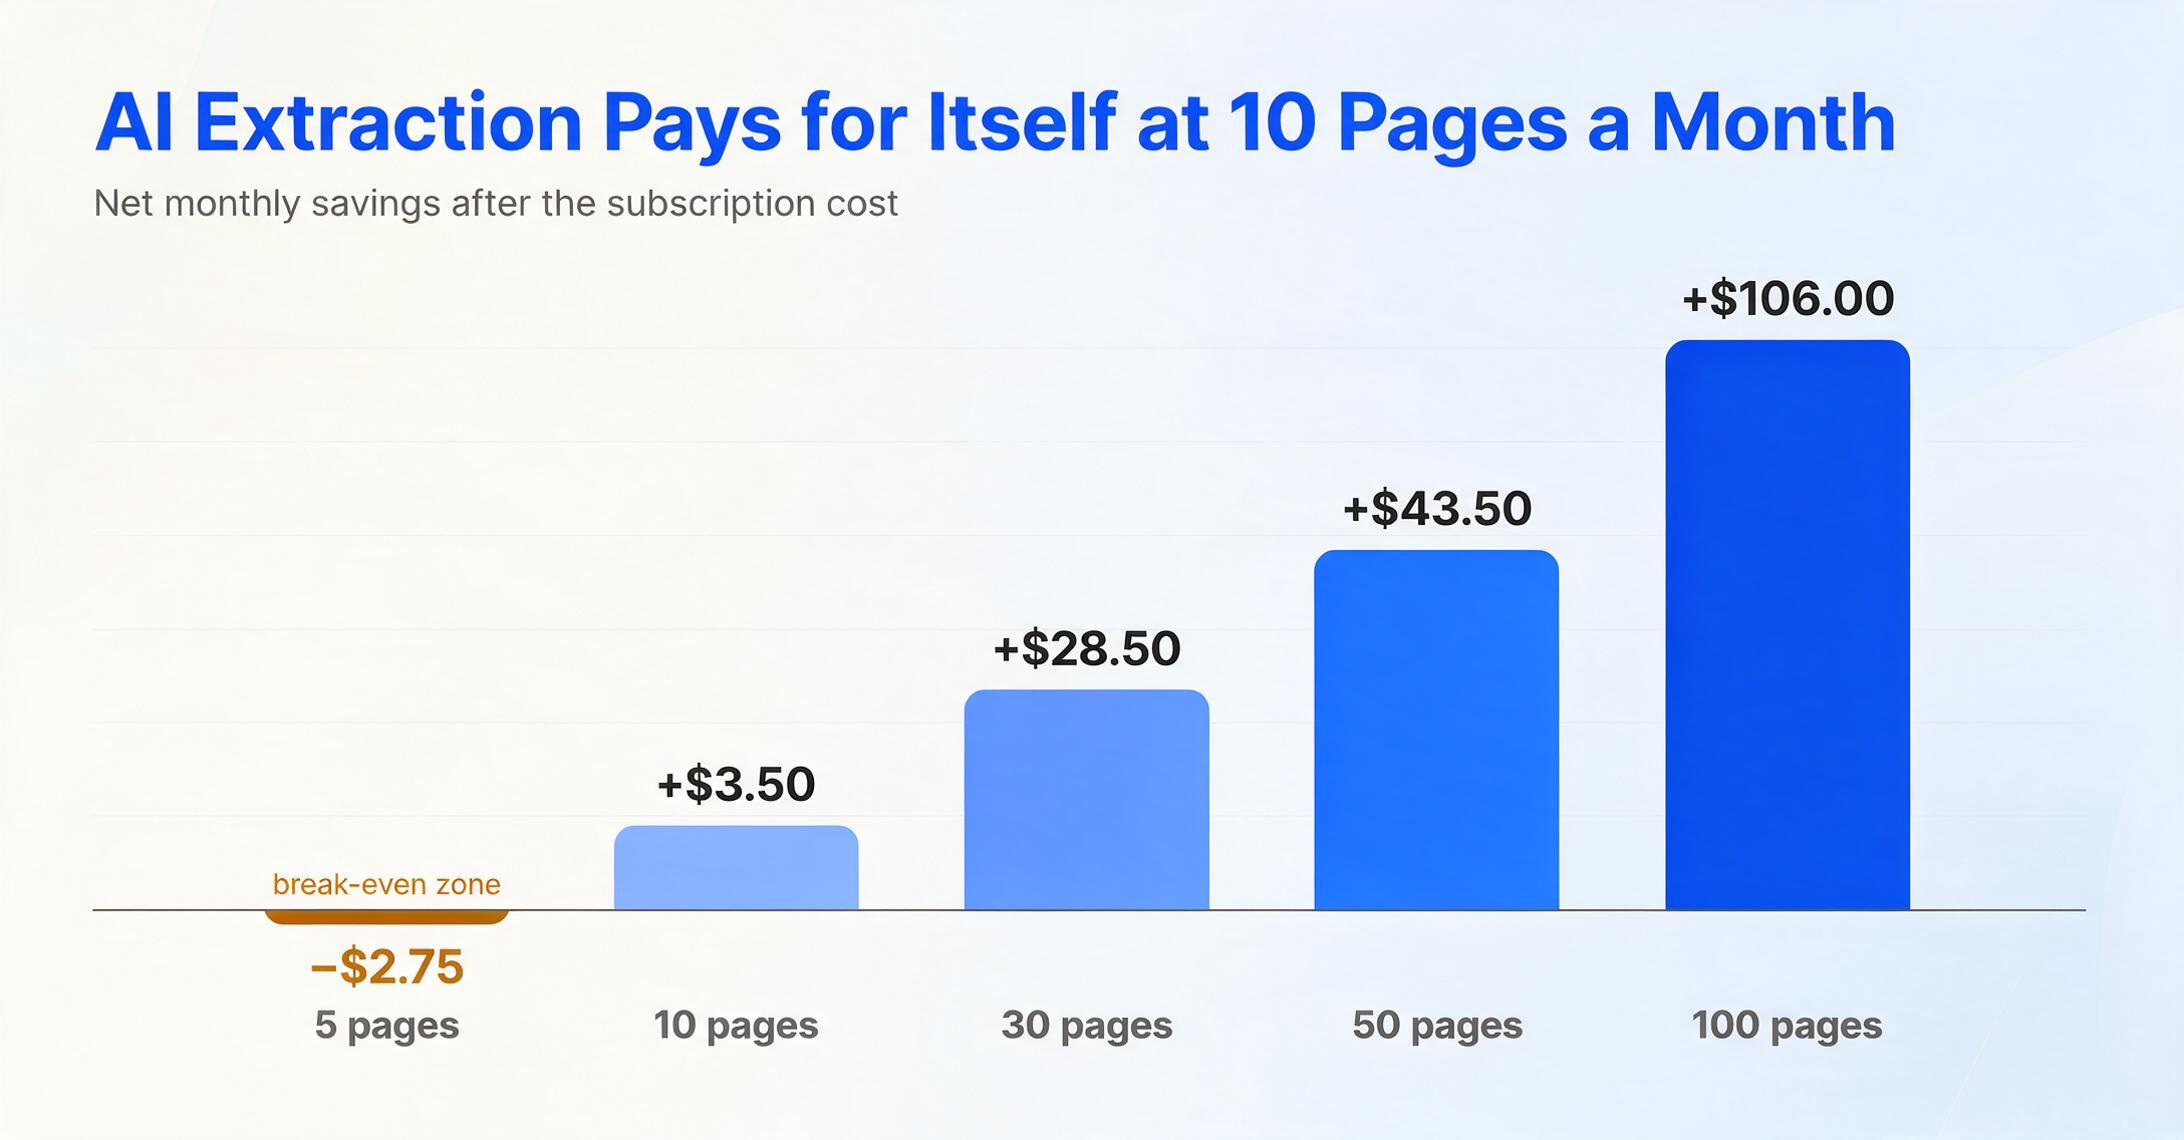
月5ページの場合、無料OCRの修正にかかる人件費は約$6.25で、月額$9のサブスクリプションよりわずかに安くなります。このボリュームでは、その15分を他に何に使えるかによって判断が本当に分かれるところです。しかし、この状況は長くは続きません。10ページになると、精度面の優位性やストレスの軽減を考慮する前から、サブスクリプションでコストを節約できます。30ページ—数人の定期的なクライアントがいるフリーランサーにとって現実的なボリューム—では、$9のプランで人件費だけで月に$28以上節約できます。
ボリュームが増えると、その数字はさらに顕著になります。月末に50件の請求書を処理する場合、2.5時間の修正は単なるお金の問題ではありません—取り戻せない時間です。また、時給制の労働者と違い、無料OCRは練習しても速くなりません。同じ5ステップのプロセスが、すべてのページ、すべてのバッチ、すべての月で繰り返されます。さまざまなツールとプランの実際のコストを幅広く確認するには、AI文書抽出の2026年版価格ガイドをご覧ください。全ティアのドキュメントあたりのコストを詳しく解説しています。
また、この計算は時間だけを数えている点も注目に値します。エラーによるコストは考慮されていません。合計額の数字の読み間違い($1,590 と $1,5O0)や、列の値の入れ違い(単価が入るべき場所に数量が入るなど)は、元の抽出よりも修正に時間がかかる下流の問題を引き起こします。こうしたエラー修正のサイクルは「無料」という説明には表れず、月次決算でははっきりと見えてきます。
無料OCRが依然として正しい選択である場合
これは無料OCRが役に立たないという意味ではありません。その有用性には限界があり、その限界を知ることで時間を節約できる、ということです。
無料OCRツールは以下の用途に適しています。
- PDFを検索可能にする。スキャンした契約書から特定の条項を検索する必要がある場合、Google DriveのOCRで対応できます。
- 短いテキストブロックを抽出する。スキャンからの1段落、フォームからの1つの住所など、影響が小さく、量も少ない抽出に適しています。
- 単一フォーマット・大量・定型ドキュメントのワークフロー。毎月、まったく同じレイアウトの1,000枚の同一フォームを処理する場合、テンプレートベースのOCRパイプライン(無料のものでも、十分に設定すれば)は機能します。ただし、これは政府機関やレガシーシステム以外では、ますますニッチなユースケースになりつつあります。
- 構造が重要でないドキュメント。アーカイブのインデックス作成のためのOCR。目的が「どのドキュメントにこのキーワードが含まれるかを見つける」ことであり、「特定のフィールドをスプレッドシートに入力する」ことではない場合です。
無料OCRは、ワークフローでレイアウトが異なるドキュメントからのフィールドレベルの抽出が必要な場合に限界に達します。これは、実際のドキュメント処理のほとんどに当てはまります。複数のサプライヤーからの請求書、異なる事業者からの領収書、異なる銀行からの銀行明細書を扱う場合、無料OCRが提供するのは、まだ解析が必要な生のテキストです。コストが実際に発生するのは、この解析の段階です。
各価格帯($0のツールから、$9/月のプラン、より高い容量を持つ$19/月のプランまで)で得られるものについて実用的に知りたい場合は、すべてのドキュメントタイプに1つのツールを使う場合と、複数の専門ツールを使う場合の比較で、さまざまなボリュームシナリオにおける総所有コストの計算を詳しく説明しています。
特にフリーランサーやソロプレナーにとっては、サブスクリプションの予算が足りないと感じて無料ツールから始めることが多いため、この問題は独自の分析に値します。フリーランサー予算でのドキュメント抽出に関する私たちの分析では、一般的な月間処理量をプランサイズと照合し、実際の使用状況が有料プランを正当化するかどうかを確認できます。ネタバレ:月に10ページ以上処理する人のほとんどは、そのラインを超えます。
月額9ドルで手に入る、無料OCRでは絶対に得られないもの
ここで議論の焦点は「無料か有料か」から「最安の有料プランが、無料ツールではできないことを実際に何をもたらすのか」に移ります。答えは、前述の5つの手動クリーンアップ手順を直接排除する5つの機能に集約されます。
カスタム列抽出
列名を指定するだけで、レイアウトに関係なくAIが任意のドキュメントからデータを取得して列を埋めます。検索もコピーもテンプレート作成も不要です。入力した列名がそのまま出力ファイルのヘッダーになります。中間ステップは一切ありません。
テーブル構造の保持
複数の列を持つ明細テーブルはテーブルとして維持されます。行と列の関係が保持されるため、説明文は正しい数量と金額に対応したままになります。区別のないテキストの流れに平準化されることはありません。
バッチ処理
30件の請求書をドロップすると、すべてのデータが1つのテーブルに統合された1つのExcelファイルが出力されます。すべてのドキュメントが同じ列スキーマで処理されます。これだけで、サブスクリプション費用以上の時間を毎月節約できます。
フォーマットの正規化
日付、金額、数値は、各ベンダーがどのような形式で入力しても、すべての入力ドキュメント間で自動的に標準化されます。手動での再フォーマット作業は不要です。
セルフサービスのモデルを考えれば、その違いはさらに明確になります。営業電話も最低契約期間も調達プロセスも不要で、登録から最初の結果を得るまでのプロセスは2分未満です。エンタープライズ向け文書抽出の契約だけが唯一の道ではない理由について詳しくは、エンタープライズ契約なしのAI文書抽出が、無料OCRユーザーがそもそも避けたいと思っている従来の「デモ予約、営業との商談、12ヶ月契約の締結」というモデルとどう違うかをご覧ください。
よくある質問
Googleレンズで表のデータをExcelに抽出できますか?
Googleレンズは表の画像からテキストを認識し、デバイスのクリップボードにコピーできます。ただし、表の構造(行、列、結合セル、列の配置)は保持されません。Excelに貼り付けた内容は、結合テキストの分離、列の再配置、書式の修正など、手動での再整理が必要になります。Googleレンズは迅速なテキスト取得を目的として設計されており、構造化された表の抽出には対応していません。スプレッドシートでそのまま使える列形式のデータが必要な場合、抽出後のクリーンアップにかなりの時間を費やすことになります。
無料のOCRは業務文書に十分な精度ですか?
きれいな印刷テキストであれば、無料のOCRツールは文字レベルで98〜99%の精度を達成します。問題は生の文字精度ではなく、文字精度がそのまま使える出力に直結しないことです。文字レベルで99%の精度でも、1ページあたりおよそ5〜10件のエラーが発生し、そのエラーは最も重要な数字(金額、日付、請求書番号)に集中する傾向があります。さらに、文字精度は表の構造が保持されるか、フィールドラベルが値に正しく対応付けられるかについては何も示しません。検索可能であれば十分な文書には無料のOCRで足りますが、特定のフィールドをスプレッドシートの特定の列に配置する必要がある文書では、「正確なテキスト」と「使えるデータ」のギャップを埋めるために手作業が必要になります。
無料のOCRに代わる最安の有料ツールは何ですか?
最安のAI文書抽出ツールは月額約9ドルから始まり、エントリープランでは1ページあたり約0.06ドルです。ImageToTable.aiのBasicプランは月額9ドルで、カスタム列、表構造の保持、バッチ処理に対応したAI抽出を150ページ分含みます。比較として、テンプレートベースのパーサーであるDocparserは月額39ドルから、AIファーストのエンタープライズプラットフォームであるNanonetsは月額499ドルから始まります。予算向けのプランは存在しますが、エンタープライズ向けツールが検索結果を独占しているため、多くの人が目にしないだけです。たまに抽出が必要なだけなら、ImageToTable.aiでは有効期限なし・月額契約なしの都度払いクレジットも50ページ6ドルから提供しています。
AI抽出は手書き文書でも機能しますか?
はい、ただし現実的な期待を持ってください。AIビジョンモデルは手書きテキストに対して85〜95%の精度を達成します。従来のOCRは60〜70%です。精度は手書きの読みやすさ、文書の品質、使用するモデルによって異なります。クリーンなスキャン上の明瞭で一貫した手書きは、実用的な結果を生み出します。くしゃくしゃのレシートに書かれた窮屈で走り書きの文字は、AIを含むどんなツールにとっても困難です。文書タイプと品質レベルにわたる精度の詳細な扱いについては、AI抽出と従来のOCRの比較で、AIモデルが手書き、低品質スキャン、混合コンテンツ文書をどのように処理するかを含め、精度の側面を詳しく説明しています。
AI抽出は1ページあたり実際にどのくらいの時間を節約しますか?
業界ベンチマークとユーザーデータに基づくと、文書からの手動データ入力は1ページあたり平均2〜3分かかります。AI抽出は処理時間を1ページあたり約5〜10秒に短縮します — 18倍の速度向上です。しかし、実際の時間節約は抽出速度そのものではなく、抽出後のクリーンアップの排除にあります。無料のOCRは手動入力のステップを省きますが、手動修正のステップを追加します。AI抽出は両方を排除します。1ページの場合、差は3分対10秒です。月末の50ページの場合、差は2.5時間の作業対10分未満です — そしてそれは手動修正がもたらすエラーを考慮する前の話です。
無料ツールの経済性は、1つの変数にかかっています:あなたの時間の価値です。定期的に文書を処理する人にとって、数学的には、ボリュームが「多い」と感じるずっと前に有料抽出に傾きます。ツールのコストは請求ページに表示されます。手動修正のコストはカレンダーに表示されます — それに気づいたら、無料のOCRを「無料」と呼ぶのをやめるでしょう。
クレジットカード不要。最初のページはサインアップ不要です。