Kostenlose OCR vs. KI-Dokumentenextraktion:
Die wahren Kosten von „kostenlos“
Kostenlose OCR-Tools waren noch nie so leistungsfähig. Google Lens kann Text aus einem Belegfoto extrahieren. Google Drive OCR verwandelt einen gescannten Rechnungsbeleg in durchsuchbaren Text. Tesseract läuft lokal und kostet nichts. Die Frage ist nicht, ob kostenlose Tools Ihre Dokumente lesen können — das können sie. Die Frage ist, ob das, was sie ausgeben, brauchbar ist, ohne stundenlange manuelle Nachbereitung. Für die meisten Menschen, die mehr als eine Handvoll Dokumente verarbeiten, ändert sich die Antwort schneller, als sie erwarten.
Die wichtigsten Erkenntnisse
- Kostenlose OCR liest jedes Zeichen auf Ihrer Rechnung perfekt und liefert das Ergebnis als undifferenzierten Textstrom ohne Spalten, ohne Feldbeschriftungen und ohne Tabellenstruktur.
- Um diesen Rohtext in eine brauchbare Tabellenkalkulation zu bringen, sind fünf manuelle Schritte pro Seite nötig, und bei 30 Seiten pro Monat kostet die Korrekturarbeit $37,50 – mehr als das $9-Abo, das Sie vermeiden wollten.
- ImageToTable.ai gibt strukturierte Spalten, die Sie benannt haben, direkt in Excel aus, sodass zehn Seiten Sekunden statt 30 Minuten Textreparatur dauern.
Was kostenlose OCR tatsächlich leistet
Die optische Zeichenerkennung wurde entwickelt, um ein Problem zu lösen: ein Bild von Text in maschinenlesbare Zeichen zu verwandeln. Bei dieser eng umrissenen Aufgabe ist sie bemerkenswert gut geworden. Moderne OCR-Engines erreichen bei sauberen, gedruckten Dokumenten regelmäßig eine Zeichengenauigkeit von über 98 %. Google Lens, Google Drive OCR, Tesseract und kostenlose Online-Dienste wie OnlineOCR meistern diese Grundanforderung gut – siehe unseren vollständigen Überblick über kostenlose OCR-Tools, wenn Sie die komplette Liste mit den tatsächlichen Grenzen der kostenlosen Tarife möchten.
Das Problem ist das, was Sie zurückbekommen. OCR liest ein Dokument von links nach rechts, von oben nach unten und gibt einen Textstrom aus. Ziehen Sie eine Lieferantenrechnung in Google Drive OCR, erhalten Sie etwa Folgendes – jedes Wort auf der Seite, in Lesereihenfolge, ohne dass die Struktur erhalten bleibt:
ACME Supplies Ltd
123 Commerce Street, Chicago IL 60601
INVOICE
Invoice No: INV-2024-0892 Date: March 15, 2024
Bill To: Greenfield Corp Due: April 14, 2024
Description Qty Unit Price Amount
Office chairs 4 $285.00 $1,140.00
Desk lamps 10 $45.00 $450.00
Total: $1,590.00
Alles ist vorhanden. Aber „Invoice No“ und „Date“ stehen in derselben Zeile, nur durch ein Leerzeichen getrennt. Die Positionstabelle wird zu Textzeilen eingeebnet – die Spaltenbeziehungen zwischen Beschreibung, Menge, Einzelpreis und Betrag gehen verloren. Die Summe steht am Ende, ohne Verbindung zu allem darüber. Wenn Sie diese Daten in eine Tabellenkalkulation mit beschrifteten Spalten übernehmen müssen – „Rechnungsnummer“, „Datum“, „Lieferant“, „Positionsbeschreibung“, „Menge“, „Einzelpreis“, „Betrag“ –, beginnen Sie bei null.
Das ist kein Fehler in der OCR. Es ist das, wofür OCR entwickelt wurde: Zeichen lesen, nicht Dokumente verstehen. Das Problem ist, dass die Aufgabe, die die meisten Menschen tatsächlich haben – „diese Rechnungsdaten in meine Tabellenkalkulation bekommen“ – Dokumentenverständnis erfordert, nicht nur Zeichenerkennung.
Die Lücke zwischen Rohtext und nutzbaren Daten
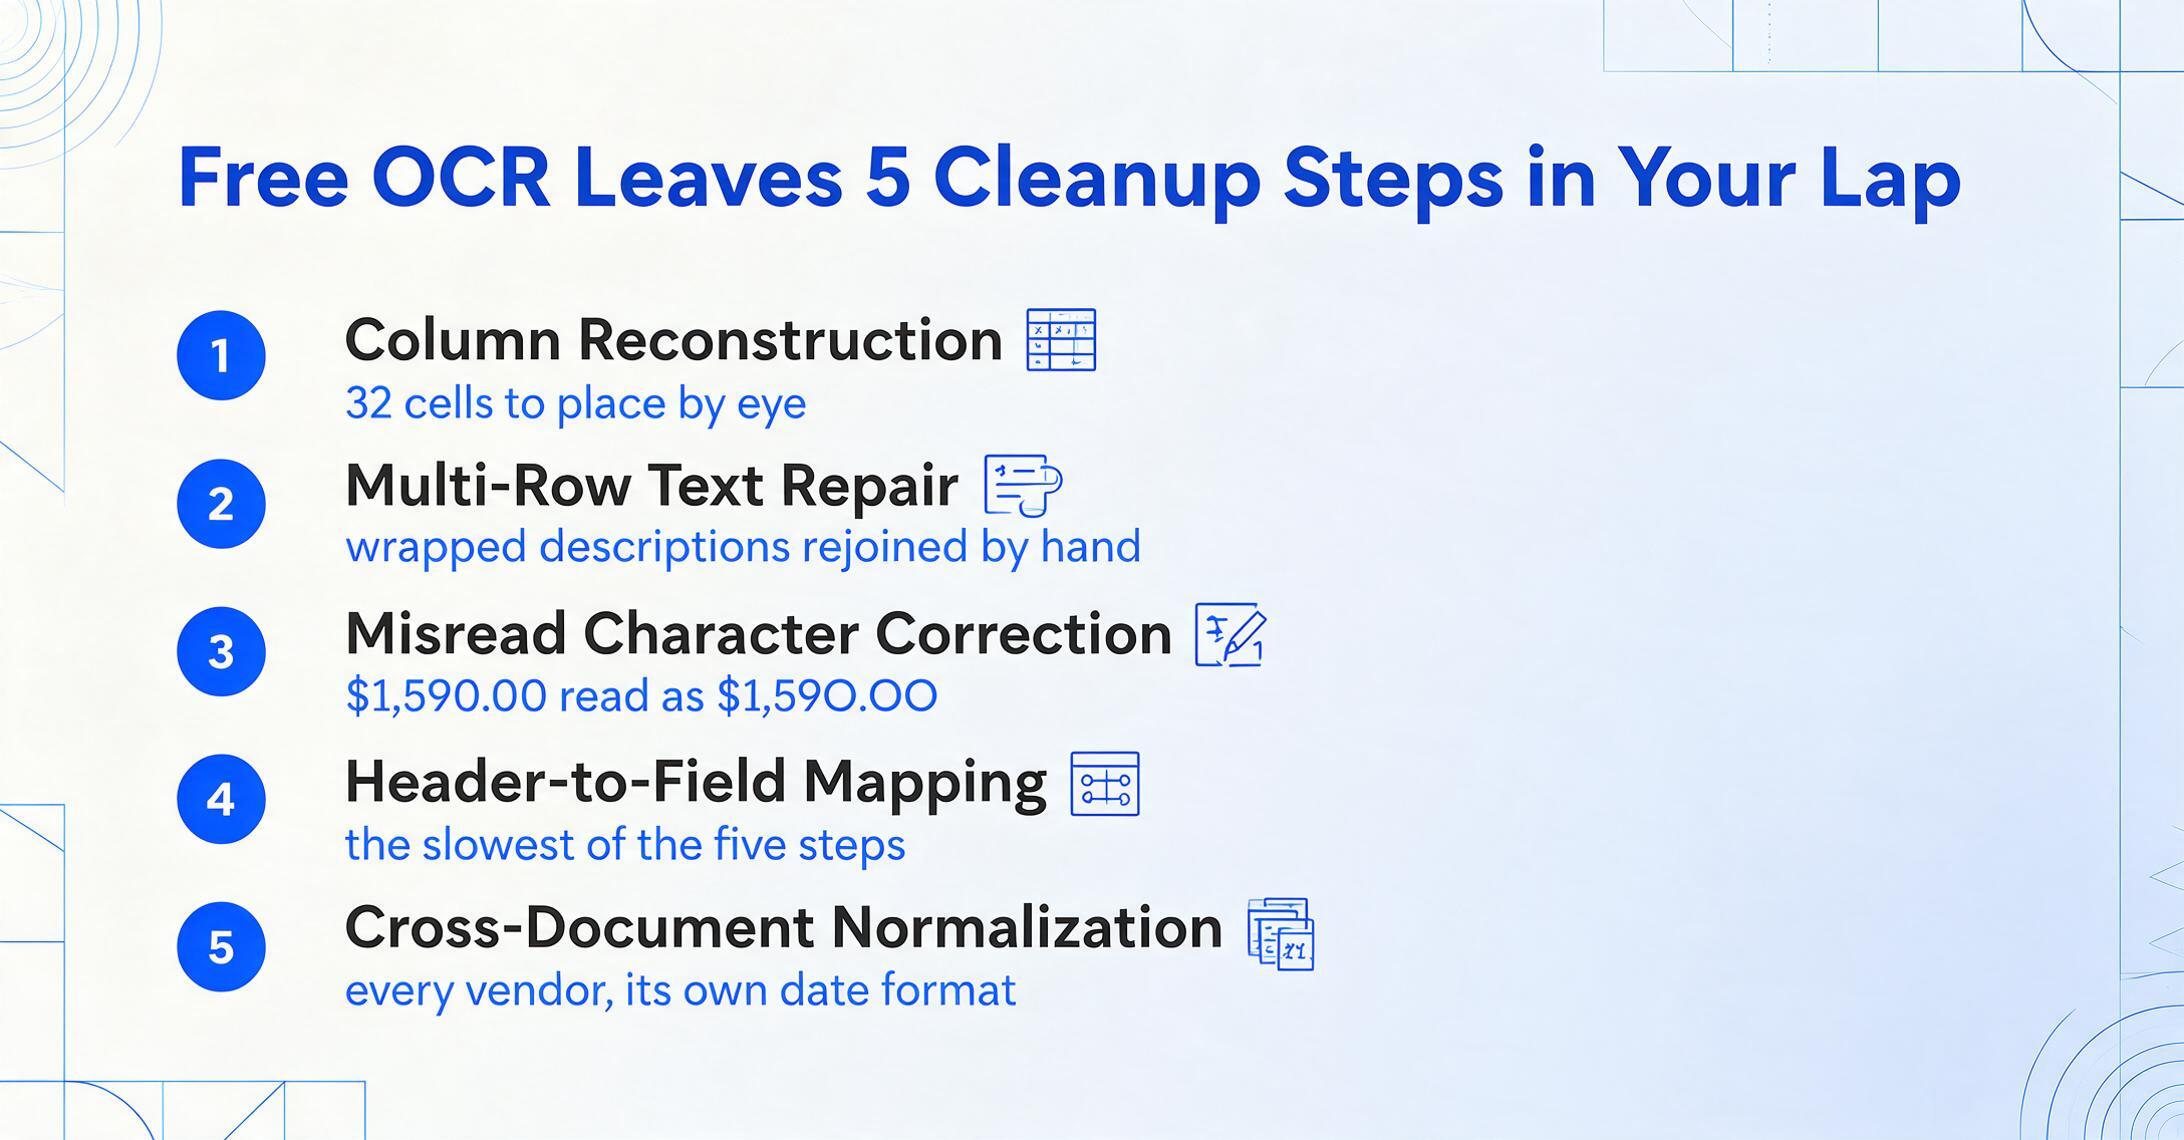
Wenn Leute sagen „Ich habe kostenlose OCR für diese Rechnungen verwendet, und es hat funktioniert“, meinen sie damit meist „der Text war da“ – nicht „die Daten waren strukturiert und einsatzbereit“. Zwischen der OCR-Ausgabe und einer sauberen Tabelle liegt eine Abfolge manueller Schritte, über die in der „kostenlosen“ Erzählung niemand spricht.
Nehmen Sie einen typischen Spesenbericht mit 8 Positionen in 4 Spalten: Beschreibung, Menge, Einzelpreis, Positionssumme. Folgendes passiert mit der Ausgabe kostenloser OCR:
Spaltenrekonstruktion
Die OCR-Ausgabe ist ein kontinuierlicher Textstrom. Sie müssen visuell neu zuordnen, welcher Textabschnitt zu welcher Spalte gehört. Eine Tabelle mit vier Spalten und 8 Zeilen bedeutet 32 einzelne Zellen, die Sie identifizieren und platzieren müssen.
Reparatur mehrzeiliger Texte
Artikelbeschreibungen, die im Originaldokument über zwei Zeilen gehen, werden in der OCR-Ausgabe in separate Zeilen aufgeteilt. Sie müssen sie manuell wieder zusammenführen – für jeden Artikel mit langer Beschreibung, in jedem Dokument.
Korrektur falsch erkannter Zeichen
Selbst bei 98 % Zeichengenauigkeit hat eine Seite mit 500 Zeichen durchschnittlich 10 Fehler. „$1,590.00“ wird zu „$1,59O.OO“ (Buchstabe O statt Null). „Qty“ wird zu „Qtv.“ Jeder Fehler muss erkannt und manuell korrigiert werden.
Zuordnung Kopfzeile zu Feld
Rechnungsnummer, Datum, Lieferantenname und Gesamtsumme befinden sich irgendwo im Textstrom. Sie müssen jeden Wert finden, extrahieren und der richtigen Spaltenüberschrift in Ihrer Tabelle zuordnen. Dieser Schritt dauert am längsten – und wird in Zeitplanungen am häufigsten übersehen.
Formatvereinheitlichung über Dokumente hinweg
Lieferant A formatiert Daten als „03/15/2024“. Lieferant B verwendet „15 March 2024“. Lieferant C verwendet „2024-03-15“. Wenn Sie 20 Rechnungen in einer Tabelle zusammenführen, benötigen Sie ein einheitliches Datumsformat – und das ist ein weiterer manueller Durchgang.
Für eine einzelne Seite können diese fünf Schritte 3 Minuten dauern. Das klingt nicht nach viel – und für eine Seite ist es das auch nicht. Die Rechnung ändert sich mit der Menge, und sie ändert sich schneller, als die meisten Menschen kalkulieren. Zehn Seiten: 30 Minuten. Dreißig Seiten: 90 Minuten. Fünfzig Seiten beim Monatsabschluss: zweieinhalb Stunden Korrekturarbeit, zusätzlich zu der Zeit, die die OCR bereits in Anspruch genommen hat.
Dies sind die versteckten Kosten kostenloser OCR. Das Tool kostet nichts, aber jede Minute manueller Nachbereitung ist Zeit, die Sie nicht für etwas aufwenden, das tatsächlich Wert schafft – Datenanalyse, Kontenabgleich oder den Abschluss des nächsten Kunden. Bei einem typischen Verwaltungsgehalt von 25 $/Stunde entsprechen 2,5 Stunden Korrekturarbeit Arbeitskosten von 62,50 $. Plötzlich ist „kostenlos“ nicht mehr die günstigste Option.
Was KI-Extraktion anders macht – und warum das für die Zeit entscheidend ist
KI-Dokumentenextraktion – der Ansatz, den Tools wie ImageToTable.ai verwenden – versucht nicht, jedes Zeichen auf der Seite zu lesen und anschließend zu interpretieren. Sie liest das Dokument visuell, so wie es ein Mensch tut: Sie erkennt das Layout, versteht, welche Textblöcke zusammengehören, und identifiziert bestimmte Felder anhand ihrer Bedeutung statt ihrer Position.
Der praktische Mechanismus ist das, was ImageToTable.ai Benutzerdefinierte Spaltenextraktion nennt: Sie geben die gewünschten Feldnamen ein – „Rechnungsnummer“, „Datum“, „Lieferant“, „Positionssumme“ – und die KI findet jeden Wert überall auf der Seite, indem sie versteht, was er bedeutet, nicht wo er steht. Ein Feld mit der Bezeichnung „INV#“ auf einer Lieferantenrechnung und „Bill Reference“ auf einer anderen werden beide als dasselbe erkannt und in dieselbe Spalte eingeordnet. Keine Vorlagen, keine Koordinatenzuordnung, keine Einrichtung pro Lieferant. Wenn Sie sehen möchten, wie sich dies im Vergleich zu anderen KI-Extraktionstools statt nur kostenloser OCR verhält, finden Sie in unserem Vergleich von Datenextraktionssoftware neun davon.
Drei nachgelagerte Konsequenzen machen den Zeitunterschied erheblich:
Workflow mit kostenloser OCR
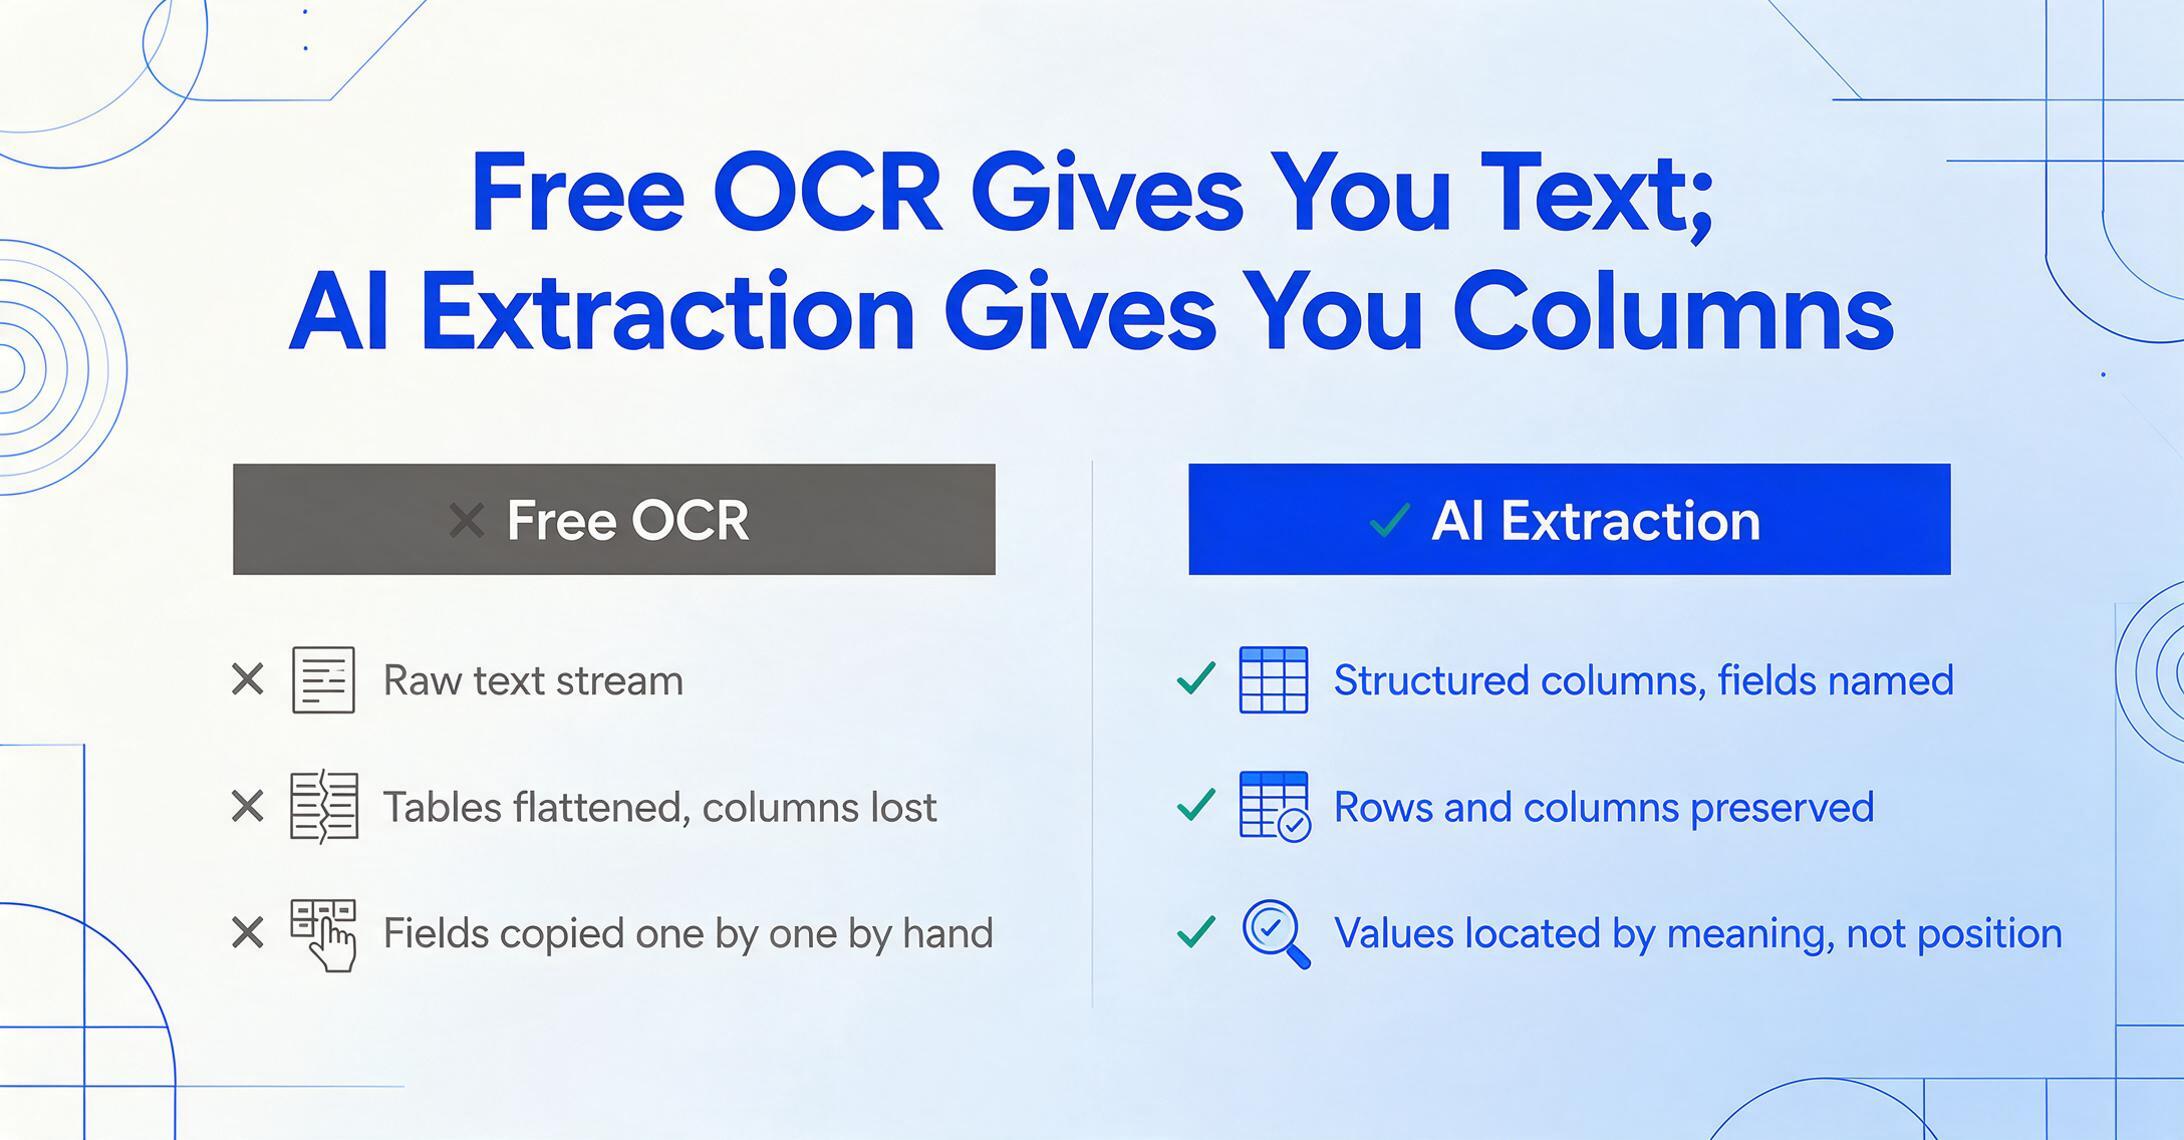
- Ausgabe: roher Textstrom, gesamte Struktur geht verloren
- Tabellen: abgeflacht – Spaltenbeziehungen zerstört
- Felder: Sie durchsuchen den Textauszug und kopieren jeden Wert
- Mehrseitig: jede Seite ist ein separater Textblock, der korrigiert werden muss
- Handschrift: Genauigkeit sinkt auf 60–70 %
- Gemischte Formate: jeder Layouttyp ist ein neues Parsing-Problem
Workflow mit KI-Extraktion
- Ausgabe: strukturierte Spalten – benannte Felder, ausgefüllte Werte
- Tabellen: Zeilen und Spalten bleiben erhalten – bereit für Excel
- Felder: Die KI findet sie anhand der semantischen Bedeutung, nicht der Pixelposition
- Mehrseitig: automatisch zu einer konsistenten Ausgabetabelle zusammengeführt
- Handschrift: 85–95 % Genauigkeit mit visuellen KI-Modellen
- Gemischte Formate: dasselbe Spaltenschema funktioniert über alle Layouts hinweg
Über die grundlegende Extraktion hinaus bietet die KI-Extraktion Funktionen, die in kostenloser OCR kein Pendant haben. Berechnete Spalten ermöglichen es Ihnen, Berechnungen zu definieren, die während der Extraktion ausgeführt werden – zum Beispiel berechnet eine Spalte namens „Zeilenbetrag (Menge × Einzelpreis)“ automatisch das Produkt für jede Zeile und deckt so Abweichungen zwischen dem angegebenen Zeilenbetrag und der tatsächlichen Berechnung auf. Abgeleitete Spalten lassen die KI Informationen klassifizieren oder ableiten, die nicht explizit auf dem Dokument stehen, etwa das Zuweisen einer Kategorie („Mahlzeiten“, „Transport“, „Büro“) basierend auf dem Beleginhalt. Dies sind keine Nachbearbeitungsschritte in Excel – sie erfolgen während der Extraktion und erscheinen direkt in Ihrer Ausgabetabelle.
Die Zeitersparnis summiert sich, wenn Sie Dokumente im Batch verarbeiten. Laden Sie 30 Rechnungen in ein KI-Extraktionstool: ein Spaltenschema, ein Verarbeitungslauf, eine Ausgabedatei. Dieselben 30 Rechnungen durch kostenlose OCR: 30 separate Textausgaben, 30 Runden des fünfstufigen Nachbereitungsprozesses. Ein detaillierter Vergleich von KI-Vision-Extraktion versus traditioneller OCR ergab, dass vorlagenbasierte OCR-Systeme versagen, sobald ein Anbieter sein Rechnungslayout ändert oder Sie einen neuen Lieferanten hinzufügen – und die meisten kostenlosen OCR-Tools sind weitaus primitiver als selbst vorlagenbasierte Systeme.
Wo „kostenlos“ aufhört, kostenlos zu sein
Das wirtschaftliche Argument für kostenlose OCR ist bei sehr geringen Mengen am stärksten. Ein oder zwei Seiten pro Monat, einzeln verarbeitet? Die Nachbereitung ist machbar. Die Frage ist, wo der Wendepunkt liegt: Ab welcher monatlichen Menge kosten die manuellen Korrekturen mehr als ein Abonnement für 9 $?
Die Berechnung basiert auf drei Annahmen, die alle konservativ sind. Manuelle Korrekturzeit pro Seite: 3 Minuten, basierend auf dem oben genannten fünfstufigen Prozess (dies setzt voraus, dass Sie schnell sind und die Dokumente sauber sind – bei handschriftlichen Notizen oder verblassten Scans kann sich die Zeit verdoppeln). Effektiver Stundensatz: 25 $/Stunde, ein typischer Verwaltungs-/Buchhaltungslohn in den USA. Und ein KI-Extraktionsabonnement für 9 $/Monat für den ImageToTable.ai Basic Plan, der 150 Credits (Seiten) pro Monat umfasst.
| Monatliches Volumen | Kostenlose OCR-Korrekturzeit | Arbeitskosten der Korrektur | KI-Extraktionskosten | Nettogewinn mit KI |
|---|---|---|---|---|
| 5 Seiten | 15 Min. | $6.25 | $9.00 | -$2.75 (Break-even-Zone) |
| 10 Seiten | 30 Min. | $12.50 | $9.00 | +$3.50 |
| 30 Seiten | 90 Min. | $37.50 | $9.00 | +$28.50 |
| 50 Seiten | 150 Min. (2,5 Std.) | $62.50 | $19.00 (Pro Plan) | +$43.50 |
| 100 Seiten | 300 Min. (5 Std.) | $125.00 | $19.00 (Pro Plan) | +$106.00 |
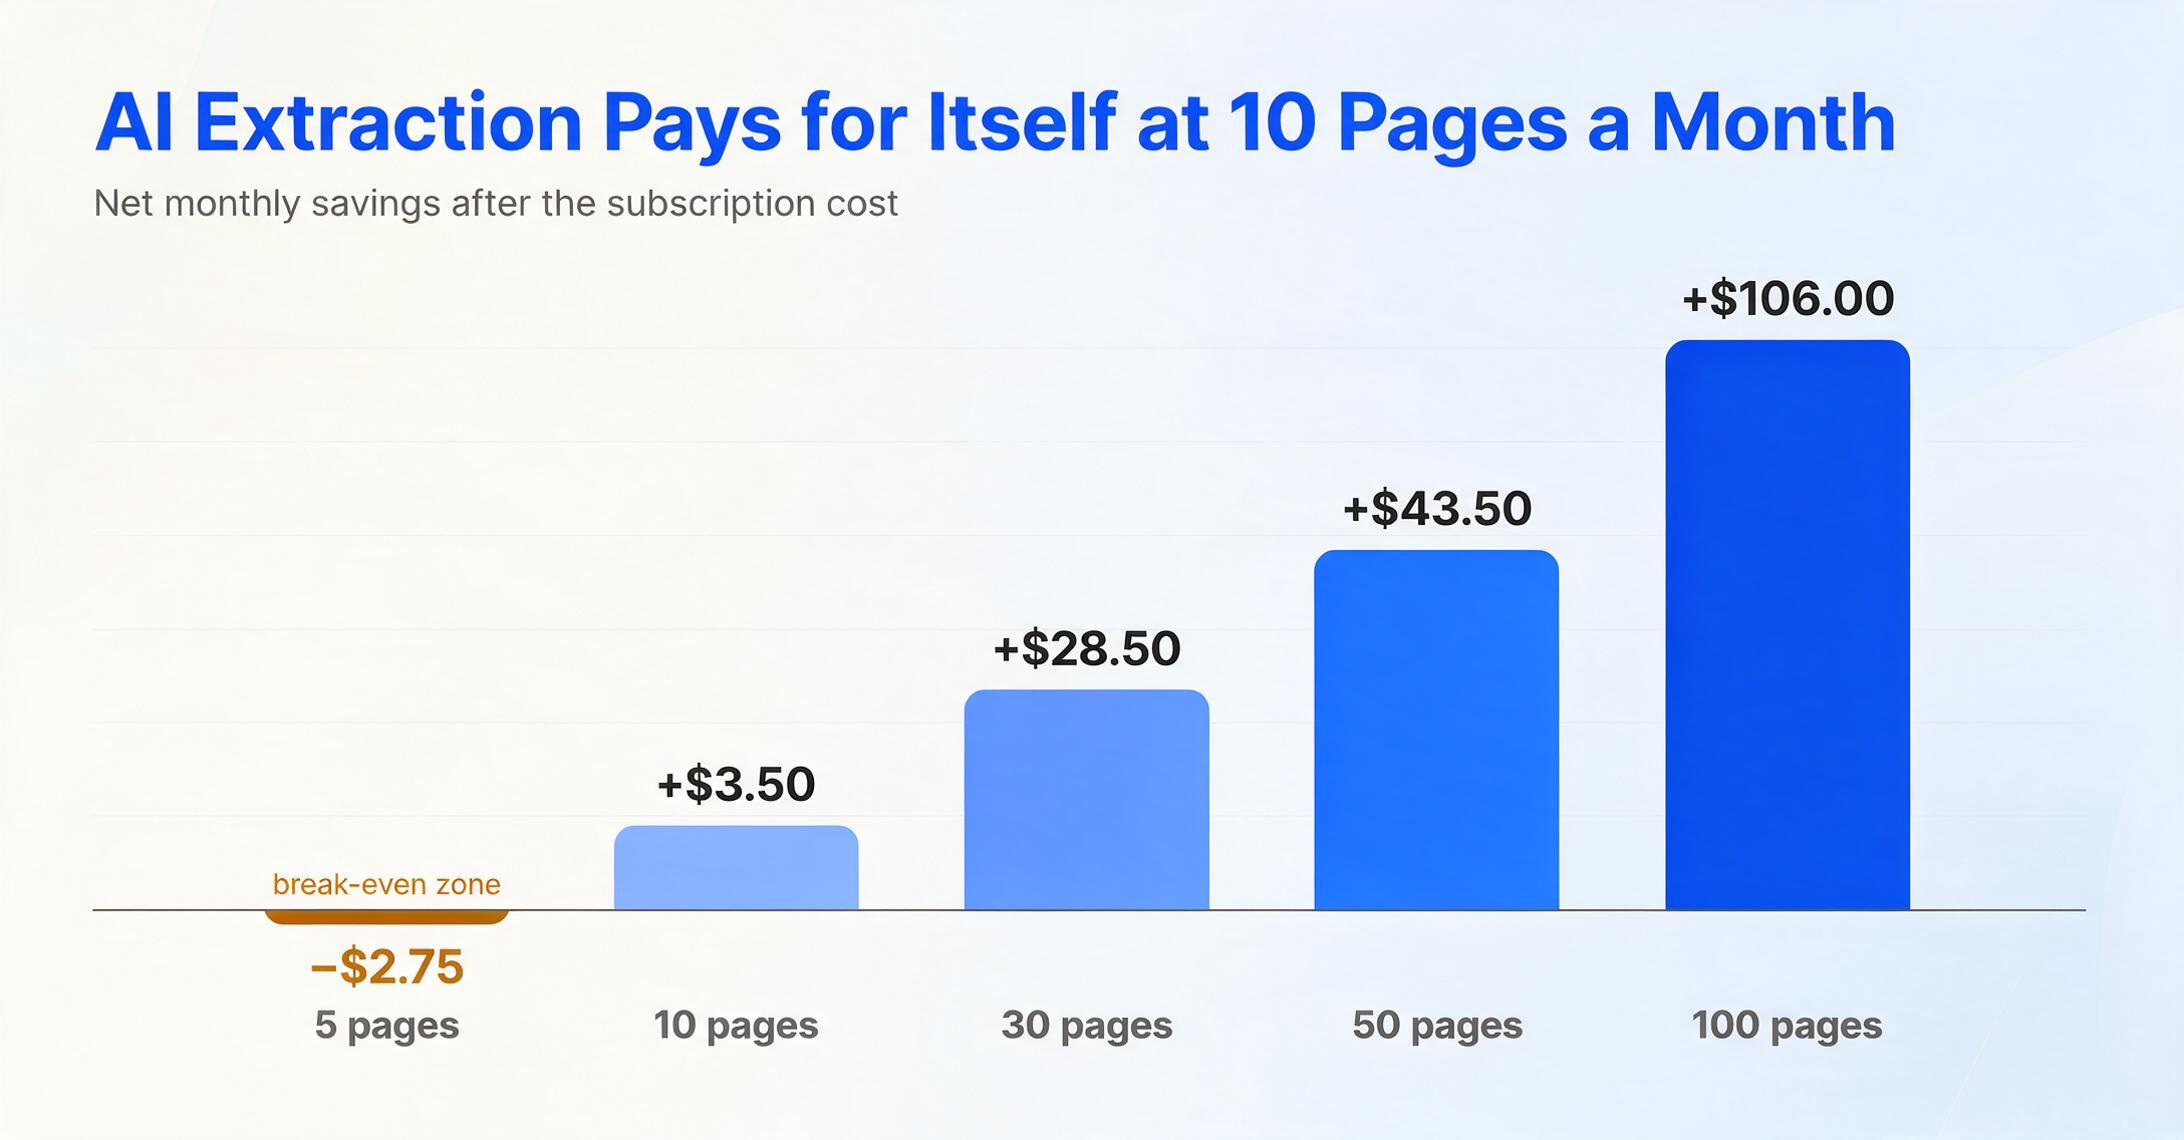
Bei 5 Seiten pro Monat kostet die kostenlose OCR-Korrektur etwa $6.25 an Arbeitszeit – etwas weniger als ein Abonnement für $9/Monat. Bei diesem Volumen hängt die Entscheidung wirklich davon ab, was Sie sonst mit diesen 15 Minuten anfangen könnten. Aber diese Linie bleibt nicht lange dort. Ab 10 Seiten sparen Sie mit einem Abonnement Geld, noch bevor Sie den Genauigkeitsvorteil und die geringere Frustration berücksichtigen. Bei 30 Seiten – einem realistischen Volumen für einen Freiberufler mit einigen Stammkunden – spart ein $9-Plan über $28 pro Monat allein an Arbeitszeit.
Bei höheren Volumina werden die Zahlen noch deutlicher. Wenn Sie am Monatsende 50 Rechnungen verarbeiten, sind zweieinhalb Stunden Korrektur nicht nur Geld – es ist Zeit, die Sie nicht zurückbekommen. Und anders als ein Stundenarbeiter wird kostenlose OCR mit der Übung nicht schneller. Derselbe fünfstufige Prozess wiederholt sich bei jeder Seite, jedem Batch, jedem Monat. Für einen breiteren Überblick darüber, was verschiedene Tools und Pläne tatsächlich kosten, lesen Sie unseren Preis-Leitfaden 2026 für KI-Dokumentenextraktion, der die Kosten pro Dokument für jede Stufe aufschlüsselt.
Erwähnenswert ist auch, dass diese Berechnung nur die Zeit berücksichtigt – nicht die Kosten für Fehler. Eine falsch gelesene Ziffer in einer Summe (1.590 $ statt 1.5O0 $) oder ein falsch platzierter Spaltenwert (Menge anstelle des Stückpreises) verursacht Folgeprobleme, deren Behebung länger dauert als die ursprüngliche Extraktion. Diese Fehlerkorrekturzyklen sind in der „kostenlosen“ Erzählung unsichtbar, aber beim Monatsabschluss sehr deutlich sichtbar.
Wann kostenlose OCR weiterhin die richtige Antwort ist
Das bedeutet nicht, dass kostenlose OCR nutzlos ist. Es bedeutet, dass ihr Nutzen Grenzen hat – und diese Grenzen zu kennen, spart Zeit.
Kostenlose OCR-Tools eignen sich gut für:
- Ein PDF durchsuchbar machen. Wenn Sie einen gescannten Vertrag nach einer bestimmten Klausel durchsuchen müssen, führt Sie die Google-Drive-OCR zum Ziel.
- Einen kurzen Textblock extrahieren. Ein Absatz aus einem Scan, eine Adresse aus einem Formular – Extraktion mit geringen Konsequenzen und geringem Volumen.
- Workflows mit einheitlichem Format, hohem Volumen und stabilen Dokumenten. Wenn Sie jeden Monat 1.000 identische Formulare mit exakt demselben Layout verarbeiten, kann eine vorlagenbasierte OCR-Pipeline (auch eine kostenlose, mit ausreichender Konfiguration) funktionieren – auch wenn dies außerhalb von Regierungs- und Legacy-Systemen zunehmend ein Nischenanwendungsfall ist.
- Dokumente, bei denen die Struktur keine Rolle spielt. OCR für Archivindexierung, bei der das Ziel „finde heraus, welches Dokument dieses Schlüsselwort enthält“ ist, nicht „bringe bestimmte Felder in eine Tabellenkalkulation“.
Kostenlose OCR scheitert, wenn Ihr Workflow eine feldgenaue Extraktion aus Dokumenten mit unterschiedlichen Layouts erfordert – was die meisten realen Dokumentenverarbeitungsfälle beschreibt. Wenn Sie Rechnungen von mehreren Lieferanten, Belege von verschiedenen Händlern oder Kontoauszüge von verschiedenen Banken verarbeiten, liefert kostenlose OCR Rohtext, der dennoch geparst werden muss. In diesem Parsing-Schritt liegen die tatsächlichen Kosten.
Für eine praktische Sicht darauf, was Sie auf jeder Preisstufe erhalten – von Tools für 0 $ über Pläne für 9 $/Monat bis zu Plänen für 19 $/Monat mit höherer Kapazität – führt unser Vergleich von ein Tool für alle Dokumenttypen versus mehrere spezialisierte Tools durch die Gesamtkostenrechnung für verschiedene Volumenszenarien.
Für Freiberufler und Solopreneure im Besonderen – eine Gruppe, die oft mit kostenlosen Tools beginnt, weil das Budget für ein Abonnement zu knapp erscheint – verdient die Frage eine eigene Analyse. Unsere Aufschlüsselung zur Dokumentenextraktion mit einem Freiberufler-Budget stellt typische monatliche Volumina den Plandimensionen gegenüber, sodass Sie sehen können, ob Ihre tatsächliche Nutzung einen kostenpflichtigen Plan rechtfertigt oder nicht. Spoiler: Die meisten Personen, die mehr als 10 Seiten pro Monat verarbeiten, überschreiten diese Grenze.
Was Sie für 9 $/Monat bekommen, was kostenlose OCR nie bietet
An diesem Punkt verschiebt sich die Frage von „kostenlos vs. kostenpflichtig“ zu „Was liefert die günstigste kostenpflichtige Stufe tatsächlich, was kostenlose Tools nicht können?“ Die Antwort läuft auf fünf Fähigkeiten hinaus, die direkt die fünf zuvor beschriebenen manuellen Nachbereitungsschritte überflüssig machen.
Benutzerdefinierte Spaltenextraktion
Sie benennen die Spalten. Die KI füllt sie mit Daten aus jedem Dokument, unabhängig vom Layout. Kein Suchen, kein Kopieren, keine Vorlagenerstellung. Die von Ihnen eingegebenen Spaltennamen werden direkt zu den Kopfzeilen Ihrer Ausgabedatei – ohne Zwischenschritt.
Erhaltung der Tabellenstruktur
Positionstabellen mit mehreren Spalten bleiben Tabellen. Zeilen- und Spaltenbeziehungen bleiben erhalten, sodass die Beschreibung bei der richtigen Menge und dem richtigen Betrag bleibt – nicht in einen undifferenzierten Textstrom geebnet.
Batch-Verarbeitung
30 Rechnungen hochladen, eine Excel-Datei mit allen Daten in einer einzigen Tabelle erhalten. Jedes Dokument wird mit demselben Spaltenschema verarbeitet. Das allein spart jeden Monat mehr Zeit, als das Abonnement kostet.
Formatnormalisierung
Daten, Beträge und Zahlen werden automatisch über alle Eingabedokumente hinweg standardisiert, unabhängig davon, wie jeder Anbieter sie formatiert. Kein manueller Neuformatierungsdurchgang.
Der Vergleich wird besonders deutlich, wenn man das Self-Serve-Modell betrachtet. Keine Vertriebsgespräche, keine Mindestlaufzeiten, kein Beschaffungsprozess – die Pipeline von der Registrierung bis zum ersten Ergebnis dauert unter zwei Minuten. Weitere Informationen darüber, warum Enterprise-Dokumentenextraktionsverträge nicht der einzige Weg sind, finden Sie unter KI-Dokumentenextraktion ohne Enterprise-Vertrag im Vergleich zum traditionellen Modell „Demo buchen, mit dem Vertrieb sprechen, 12-Monats-Vertrag unterschreiben“, das kostenlose OCR-Nutzer von vornherein vermeiden wollen.
FAQ
Kann Google Lens Tabellendaten in Excel extrahieren?
Google Lens kann Text aus einem Tabellenbild erkennen und in die Zwischenablage Ihres Geräts kopieren. Die Tabellenstruktur – Zeilen, Spalten, verbundene Zellen und Spaltenausrichtung – bleibt jedoch nicht erhalten. Was Sie in Excel einfügen, erfordert eine manuelle Nachbereitung: zusammengeführte Texte trennen, Spalten neu ausrichten und Formatierungen korrigieren. Google Lens ist für die schnelle Texterfassung konzipiert, nicht für die strukturierte Tabellenextraktion. Wenn Sie die Daten in tabellenfertigen Spalten benötigen, müssen Sie erheblichen Zeitaufwand für die Nachbearbeitung einplanen.
Ist kostenlose OCR für Geschäftsdokumente genau genug?
Bei sauberem, gedrucktem Text erreichen kostenlose OCR-Tools eine Zeichengenauigkeit von 98–99 %. Das Problem ist nicht die reine Zeichengenauigkeit – sondern dass Zeichengenauigkeit nicht gleichbedeutend mit brauchbarer Ausgabe ist. Eine Zeichengenauigkeit von 99 % bedeutet dennoch etwa 5 bis 10 Fehler pro Seite, und diese Fehler konzentrieren sich tendenziell auf die Zahlen, die am wichtigsten sind: Beträge, Daten und Rechnungsnummern. Darüber hinaus sagt die Zeichengenauigkeit nichts darüber aus, ob Tabellenstrukturen erhalten bleiben oder Feldbezeichnungen korrekt ihren Werten zugeordnet werden. Für Dokumente, die lediglich durchsuchbar sein müssen – nicht strukturiert – ist kostenlose OCR ausreichend. Für Dokumente, bei denen bestimmte Felder in bestimmten Tabellenspalten landen müssen, erfordert die Lücke zwischen „genauem Text" und „brauchbaren Daten" manuelle Arbeit, um sie zu schließen.
Was ist die günstigste kostenpflichtige Alternative zu kostenloser OCR?
Die günstigsten KI-Dokumentenextraktionstools beginnen bei etwa 9 $/Monat – ungefähr 0,06 $ pro Seite in der Einstiegsstufe. Der Basic-Plan von ImageToTable.ai für 9 $/Monat umfasst 150 Seiten KI-gestützter Extraktion mit benutzerdefinierten Spalten, Erhalt der Tabellenstruktur und Stapelverarbeitung. Zum Vergleich: Vorlagenbasierte Parser wie Docparser beginnen bei 39 $/Monat, und KI-First-Unternehmensplattformen wie Nanonets beginnen bei 499 $/Monat. Die Budgetstufe existiert – sie ist nur nicht die Stufe, von der die meisten Menschen hören, weil die Unternehmenslösungen die Suchergebnisse dominieren. Wenn Sie nur gelegentlich extrahieren müssen, bietet ImageToTable.ai auch Guthaben nach Verbrauch ab 6 $ für 50 Seiten an, ohne Ablaufdatum und ohne monatliche Verpflichtung.
Funktioniert KI-Extraktion bei handschriftlichen Dokumenten?
Ja, mit realistischen Erwartungen. KI-Vision-Modelle erreichen bei handschriftlichem Text eine Genauigkeit von 85–95 %, verglichen mit 60–70 % bei herkömmlicher OCR. Die Genauigkeit hängt von der Lesbarkeit der Handschrift, der Dokumentqualität und dem verwendeten Modell ab. Eine klare, gleichmäßige Handschrift auf einem sauberen Scan liefert brauchbare Ergebnisse. Eine krakelige, hastige Handschrift auf einem zerknitterten Beleg stellt jedes Werkzeug vor Herausforderungen — auch KI. Für eine vertiefte Betrachtung der Genauigkeit über Dokumenttypen und Qualitätsstufen hinweg finden Sie in unserem Vergleich von KI-Extraktion und herkömmlicher OCR eine detaillierte Darstellung, einschließlich der Frage, wie KI-Modelle mit Handschrift, minderwertigen Scans und Dokumenten mit gemischten Inhalten umgehen.
Wie viel Zeit spart KI-Extraktion tatsächlich pro Seite?
Basierend auf Branchen-Benchmarks und Nutzerdaten dauert die manuelle Dateneingabe aus einem Dokument durchschnittlich 2–3 Minuten pro Seite. KI-Extraktion reduziert die Verarbeitungszeit auf etwa 5–10 Sekunden pro Seite — eine 18-fache Beschleunigung. Die tatsächliche Zeitersparnis liegt jedoch nicht in der Extraktionsgeschwindigkeit selbst, sondern in der Eliminierung der Nachbearbeitung. Kostenlose OCR erspart Ihnen den manuellen Tippaufwand, fügt aber einen Schritt der manuellen Korrektur hinzu. KI-Extraktion eliminiert beides. Für eine einzelne Seite beträgt der Unterschied 3 Minuten gegenüber 10 Sekunden. Bei 50 Seiten zum Monatsende beträgt der Unterschied 2,5 Stunden Arbeit gegenüber unter 10 Minuten — und das ohne Berücksichtigung der Fehler, die die manuelle Korrektur verursacht.
Die Wirtschaftlichkeit kostenloser Tools hängt von einer Variablen ab: dem Wert Ihrer Zeit. Für alle, die regelmäßig Dokumente verarbeiten, spricht die Rechnung schon lange vor einem gefühlten „großen“ Volumen für bezahlte Extraktion. Die Kosten des Tools sind auf der Rechnungsseite sichtbar. Die Kosten der manuellen Korrektur sind in Ihrem Kalender sichtbar — sobald Sie sie bemerken, nennen Sie kostenlose OCR nicht mehr „kostenlos“.
Keine Kreditkarte. Keine Anmeldung für die erste Seite erforderlich.