OCR gratuito vs extração de documentos com IA:
O custo real do "grátis"
As ferramentas de OCR gratuito nunca foram tão capazes. O Google Lens consegue extrair texto de uma foto de recibo. O OCR do Google Drive transforma uma fatura digitalizada em texto pesquisável. O Tesseract roda localmente e não custa nada. A questão não é se as ferramentas gratuitas conseguem ler seus documentos — elas conseguem. A questão é se o que elas geram é utilizável sem horas de limpeza manual. Para a maioria das pessoas que processam mais do que alguns documentos, a resposta muda mais rápido do que elas esperam.
Principais Conclusões
- O OCR gratuito lê perfeitamente cada caractere da sua fatura e entrega o resultado como um fluxo de texto indiferenciado, sem colunas, sem rótulos de campos e sem estrutura de tabela.
- Transformar esse texto bruto em uma planilha utilizável exige cinco etapas manuais por página e, com 30 páginas por mês, o trabalho de correção custa $37,50 — mais do que a assinatura de $9 que você tentava evitar.
- O ImageToTable.ai gera colunas estruturadas que você nomeia diretamente no Excel, então dez páginas levam segundos em vez de 30 minutos de reparo de texto.
O que o OCR gratuito realmente entrega
O Reconhecimento Óptico de Caracteres foi criado para resolver um problema: transformar uma imagem de texto em caracteres legíveis por máquina. Nessa tarefa específica, ele se tornou notavelmente bom. Os mecanismos de OCR modernos em documentos impressos e limpos superam rotineiramente 98% de precisão de caracteres. O Google Lens, o OCR do Google Drive, o Tesseract e serviços online gratuitos como o OnlineOCR lidam bem com esse nível básico — veja nossa análise completa das ferramentas de OCR gratuitas se quiser a lista completa com os limites reais dos planos gratuitos.
O problema é o que você recebe de volta. O OCR lê um documento da esquerda para a direita, de cima para baixo, e gera um fluxo de texto. Coloque uma fatura de fornecedor no OCR do Google Drive e você obterá algo assim — cada palavra na página, em ordem de leitura, sem nenhuma estrutura preservada:
ACME Supplies Ltd
123 Commerce Street, Chicago IL 60601
INVOICE
Invoice No: INV-2024-0892 Date: March 15, 2024
Bill To: Greenfield Corp Due: April 14, 2024
Description Qty Unit Price Amount
Office chairs 4 $285.00 $1,140.00
Desk lamps 10 $45.00 $450.00
Total: $1,590.00
Tudo está lá. Mas "Invoice No" e "Date" estão na mesma linha, separados apenas por um espaço. A tabela de itens é achatada em linhas de texto — as relações entre as colunas de descrição, quantidade, preço unitário e valor se perdem. O total fica na parte inferior, desconectado de tudo acima. Se você precisar colocar esses dados em uma planilha com colunas rotuladas — "Invoice Number," "Date," "Vendor," "Line Item Description," "Qty," "Unit Price," "Amount" — você está começando do zero.
Isso não é um bug do OCR. É para isso que o OCR foi criado: ler caracteres, não entender documentos. O problema é que a tarefa que a maioria das pessoas realmente tem — "colocar os dados desta fatura na minha planilha" — exige compreensão de documentos, não apenas reconhecimento de caracteres.
A Lacuna Entre Texto Bruto e Dados Utilizables
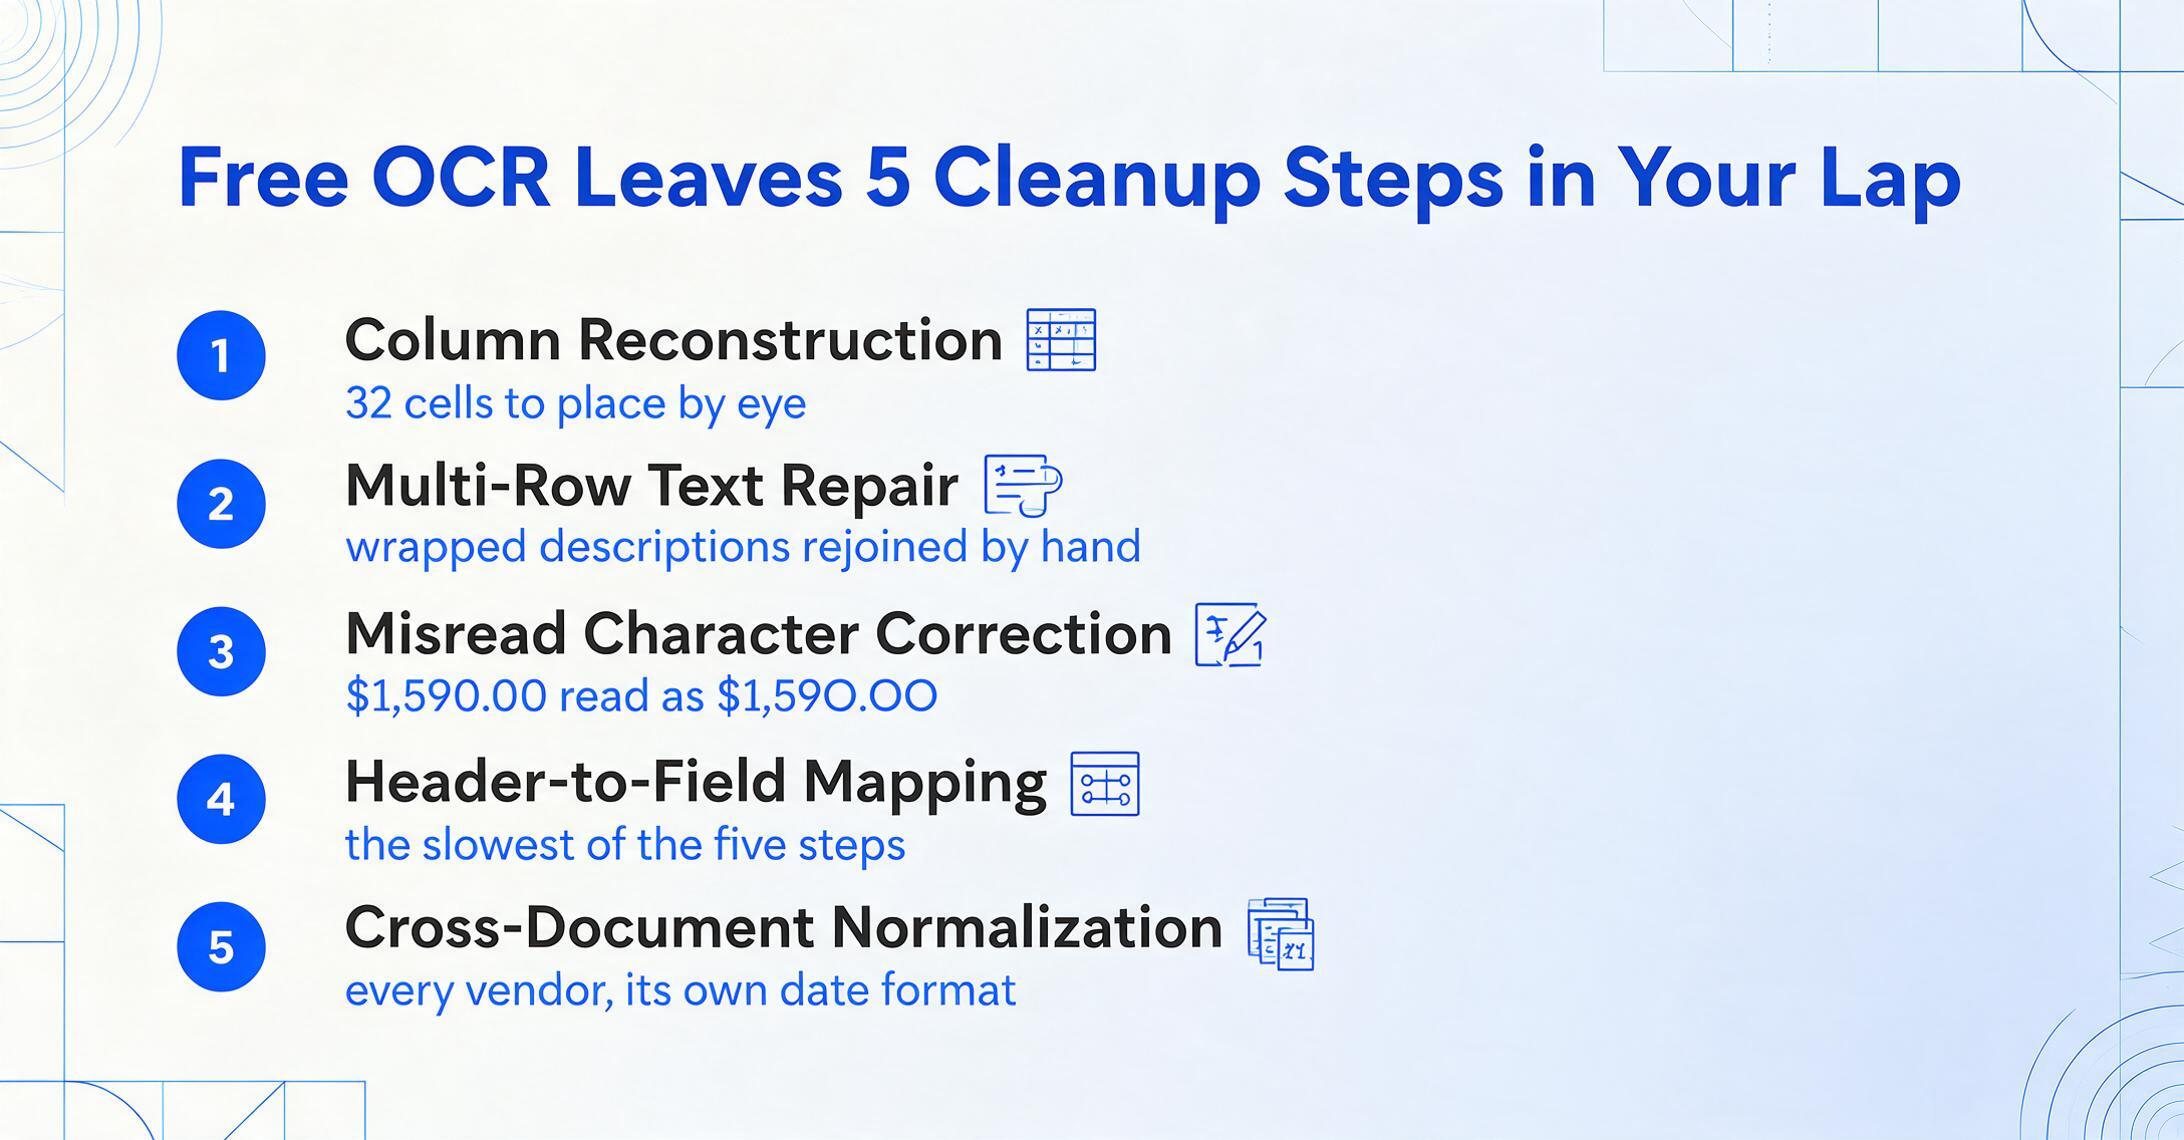
Quando as pessoas dizem "usei OCR gratuito nestas faturas e funcionou", o que geralmente querem dizer é "o texto estava lá" — não "os dados estavam estruturados e prontos para usar". Entre a saída do OCR e uma planilha limpa, há uma sequência de etapas manuais sobre as quais ninguém fala na narrativa "gratuita".
Tomemos um reporte de gastos típico com 8 itens de linha em 4 colunas: descrição, quantidade, preço unitário, total da linha. Aqui está o que acontece com a saída do OCR gratuito:
Reconstrução de colunas
A saída do OCR é um fluxo de texto contínuo. Você precisa remapear visualmente qual parte do texto pertence a qual columna. Uma tabela de quatro colunas com 8 filas significa 32 células individuais para identificar e colocar.
Reparo de texto em várias filas
Descripções de itens que abarcan duas líneas no documento original são divididas em filas separadas na saída do OCR. Você precisa reuni-las manualmente — para cada item com uma descrição longa, em todos os documentos.
Correção de caracteres mal lidos
Incluso com 98% de precisão de caracteres, uma página com 500 caracteres tem em média 10 erros. "$1,590.00" se converte em "$1,59O.OO" (letra O em vez de zero). "Qty" se converte em "Qtv." Cada erro precisa ser detectado e corrigido manualmente.
Mapeamento de cabeçalho a campo
O número de fatura, a data, o nome do fornecedor e o total estão em algum lugar do fluxo de texto. Você precisa encontrar cada um, extraí-lo e mapeá-lo ao cabeçalho de columna correto em sua planilha. Este é o passo que leva mais tempo — e o que a maioria das pessoas omite em suas estimações de tempo.
Normalização de formato entre documentos
O fornecedor A formata as datas como "03/15/2024." O fornecedor B usa "15 March 2024." O fornecedor C usa "2024-03-15." Se você está combinando 20 faturas em uma planilha, precisa de um formato de data consistente — e isso é outra passada manual.
Para uma única página, estes cinco passos podem levar 3 minutos. Isso não parece muito — e para uma página, não é. A matemática muda com o volume, e muda mais rápido do que a maioria das pessoas calcula. Dez páginas: 30 minutos. Trinta páginas: 90 minutos. Cinquenta páginas no fechamento de fin de mês: duas horas e meia de trabalho de correção, além do tempo que o OCR já levou.
Este é o custo oculto do OCR gratuito. A ferramenta não custa nada, mas cada minuto de limpeza manual é tempo que você não está gastando em algo que realmente gera valor — analisar os dados, conciliar contas ou fechar o próximo cliente. Com um salário administrativo típico de $25/hora, 2,5 horas de trabalho de correção são $62,50 em custo de mão de obra. De repente, "gratuito" não é a opção mais barata.
O Que a Extração com IA Faz de Diferente — E Por Que Isso Importa para o Tempo
A extração de documentos com IA — a abordagem que ferramentas como ImageToTable.ai usam — não tenta ler cada caractere da página e depois descobrir o que significa. Ela lê o documento visualmente como uma pessoa faria: vê o layout, entende quais blocos de texto pertencem uns aos outros e identifica campos específicos pelo significado, não pela posição.
O mecanismo prático é o que ImageToTable.ai chama de Extração de Colunas Personalizadas: você digita os nomes dos campos que deseja — "Número da Fatura", "Data", "Fornecedor", "Total da Linha" — e a IA localiza cada valor em qualquer lugar da página entendendo o que ele significa, não onde está. Um campo rotulado como "INV#" na fatura de um fornecedor e "Bill Reference" na de outro é reconhecido como a mesma coisa e colocado na mesma coluna. Sem modelos, sem mapeamento de coordenadas, sem configuração por fornecedor. Se você quiser ver como isso se compara a outras ferramentas de extração com IA, em vez de apenas OCR gratuito, nossa comparação de software de extração de dados cobre nove delas.
Três consequências práticas tornam a diferença de tempo relevante:
Fluxo de Trabalho com OCR Gratuito
- Saída: fluxo de texto bruto, toda a estrutura perdida
- Tabelas: achatadas — relações entre colunas destruídas
- Campos: você pesquisa no texto e copia cada valor
- Várias páginas: cada página é um bloco de texto separado para corrigir
- Escrita manual: precisão cai para 60–70%
- Formatos mistos: cada tipo de layout é um novo problema de análise
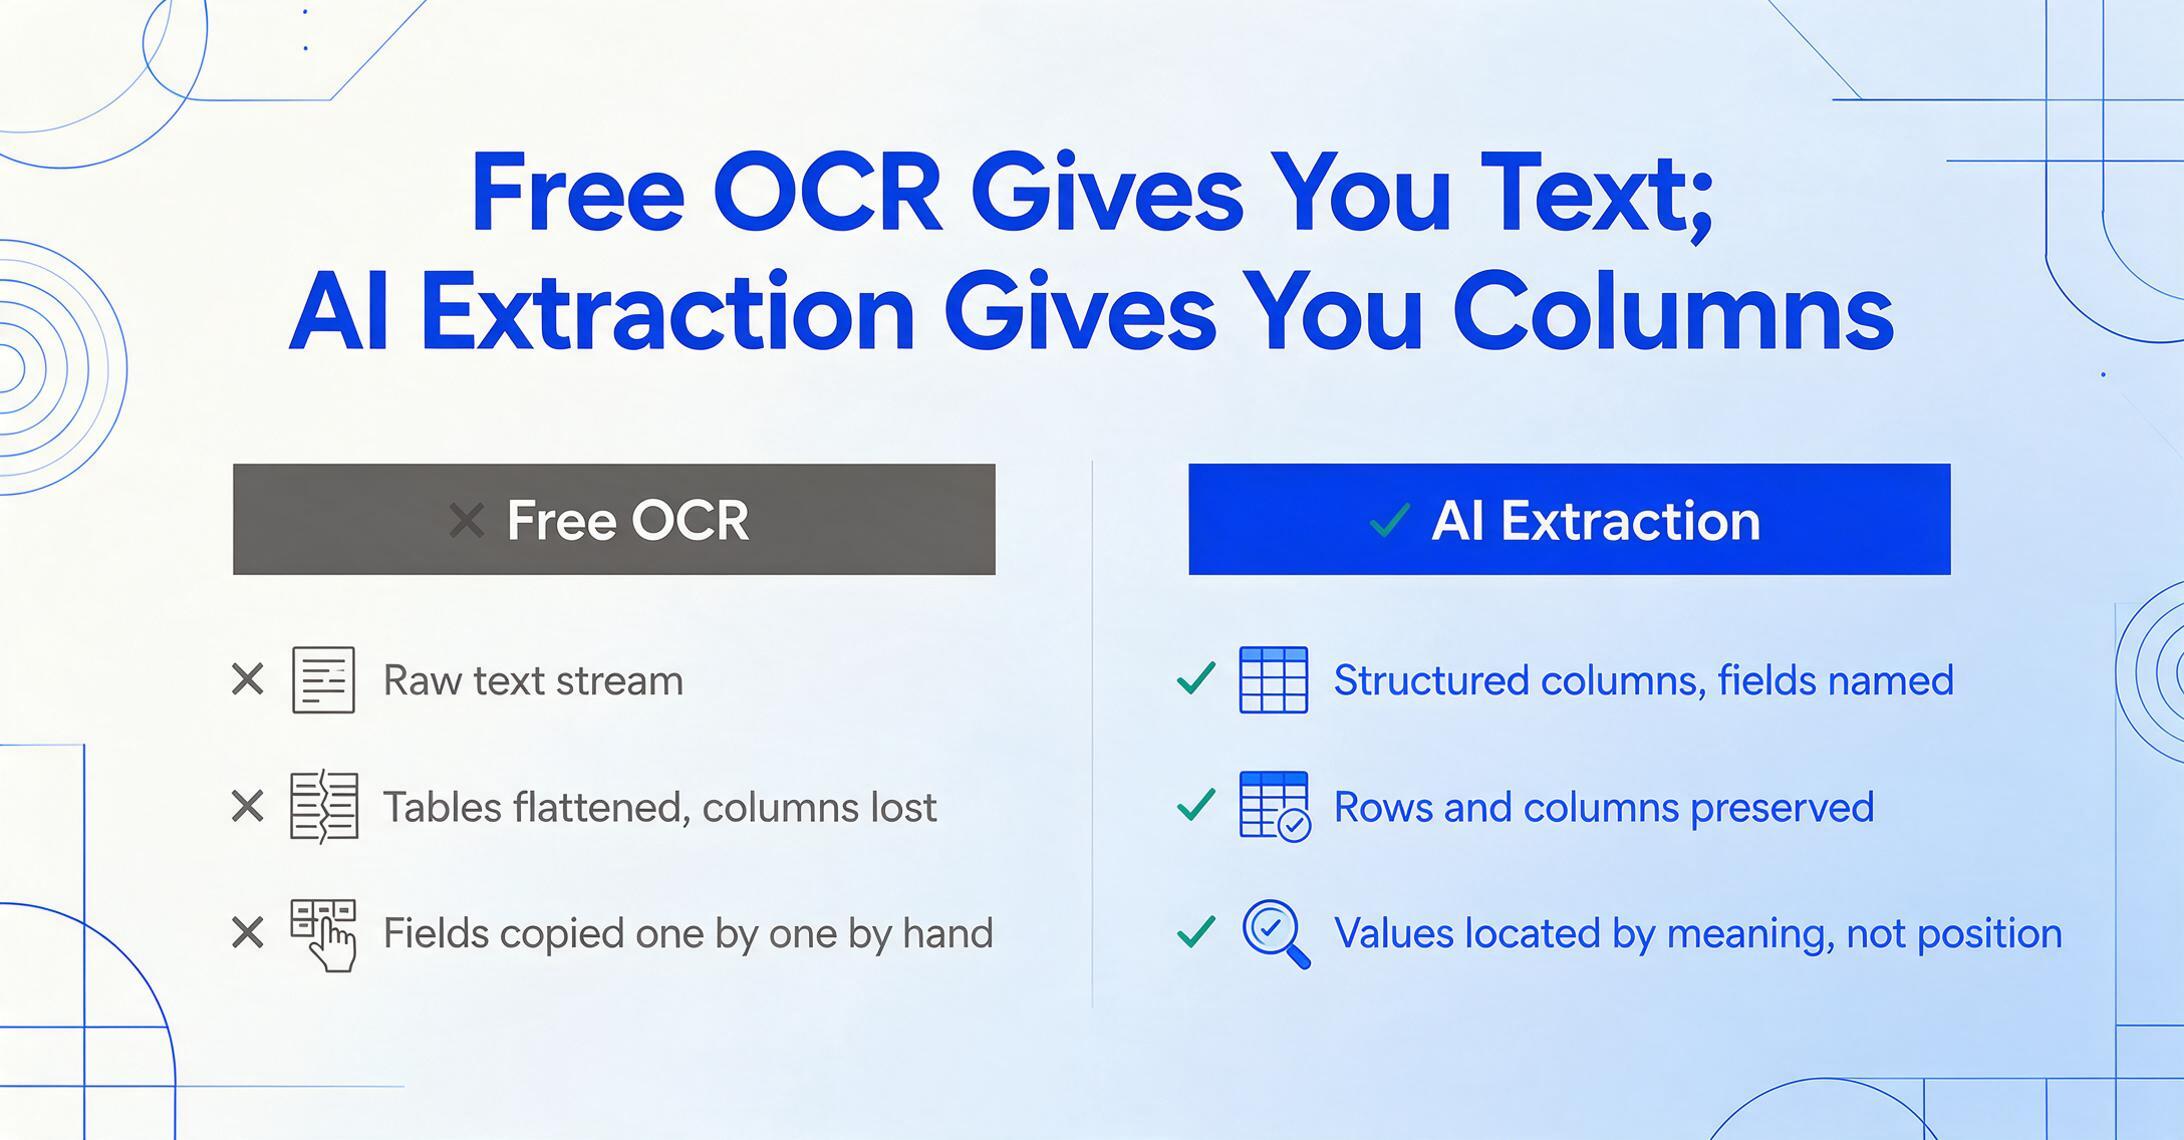
Fluxo de Trabalho com Extração com IA
- Saída: colunas estruturadas — campos que você nomeou, valores preenchidos
- Tabelas: linhas e colunas preservadas — prontas para o Excel
- Campos: a IA os encontra pelo significado semântico, não pela localização de pixels
- Várias páginas: mescladas automaticamente em uma tabela de saída consistente
- Escrita manual: 85–95% de precisão com modelos visuais de IA
- Formatos mistos: o mesmo esquema de colunas funciona em todos os layouts
Além da extração básica, a extração com IA adiciona recursos que não têm equivalente em OCR gratuito. coluna calculada permite definir cálculos que rodam durante a extração — por exemplo, uma coluna chamada "Total da Linha (Qtd × Preço Unitário)" calcula automaticamente o produto de cada linha, detectando discrepâncias entre o total informado e o cálculo real. coluna inferida permite que a IA classifique ou derive informações não escritas explicitamente no documento, como atribuir uma categoria ("Refeições", "Transporte", "Escritório") com base no conteúdo do recibo. Esses não são passos de pós-processamento no Excel — eles acontecem durante a extração e aparecem diretamente na sua tabela de saída.
A economia de tempo aumenta quando você processa documentos em lote. Coloque 30 notas fiscais em uma ferramenta de extração com IA: um esquema de colunas, uma execução de processamento, um arquivo de saída. As mesmas 30 notas fiscais em OCR gratuito: 30 despejos de texto separados, 30 rodadas do processo de limpeza em cinco etapas. Uma comparação aprofundada entre extração visual com IA e OCR tradicional descobriu que sistemas de OCR baseados em modelo quebram sempre que um fornecedor muda o layout da nota fiscal ou quando você adiciona um novo fornecedor — e a maioria das ferramentas de OCR gratuito é muito mais primitiva do que até mesmo os sistemas baseados em modelo.
Onde o "Grátis" Deixa de Ser Grátis
O argumento econômico para continuar com OCR gratuito é mais forte em volumes muito baixos. Uma ou duas páginas por mês, processadas uma de cada vez? A limpeza é gerenciável. A questão é onde fica o ponto de equilíbrio: em qual volume mensal o tempo de correção manual custa mais do que uma assinatura de $9?
O cálculo usa três premissas, todas conservadoras. Tempo de correção manual por página: 3 minutos, com base no processo de cinco etapas acima (isso assume que você é rápido e os documentos estão limpos — para anotações manuscritas ou digitalizações desbotadas, o tempo pode dobrar). Taxa horária efetiva: $25/hora, um salário típico de administração/contabilidade nos EUA. E uma assinatura de extração com IA a $9/mês para o plano Basic do ImageToTable.ai, que inclui 150 créditos (páginas) por mês.
| Volume Mensal | Tempo Grátis de Correção de OCR | Custo de Mão de Obra da Correção | Custo de Extração com IA | Economia Líquida com IA |
|---|---|---|---|---|
| 5 páginas | 15 min | $6.25 | $9.00 | -$2.75 (zona de equilíbrio) |
| 10 páginas | 30 min | $12.50 | $9.00 | +$3.50 |
| 30 páginas | 90 min | $37.50 | $9.00 | +$28.50 |
| 50 páginas | 150 min (2,5 h) | $62.50 | $19.00 (plano Pro) | +$43.50 |
| 100 páginas | 300 min (5 h) | $125.00 | $19.00 (plano Pro) | +$106.00 |
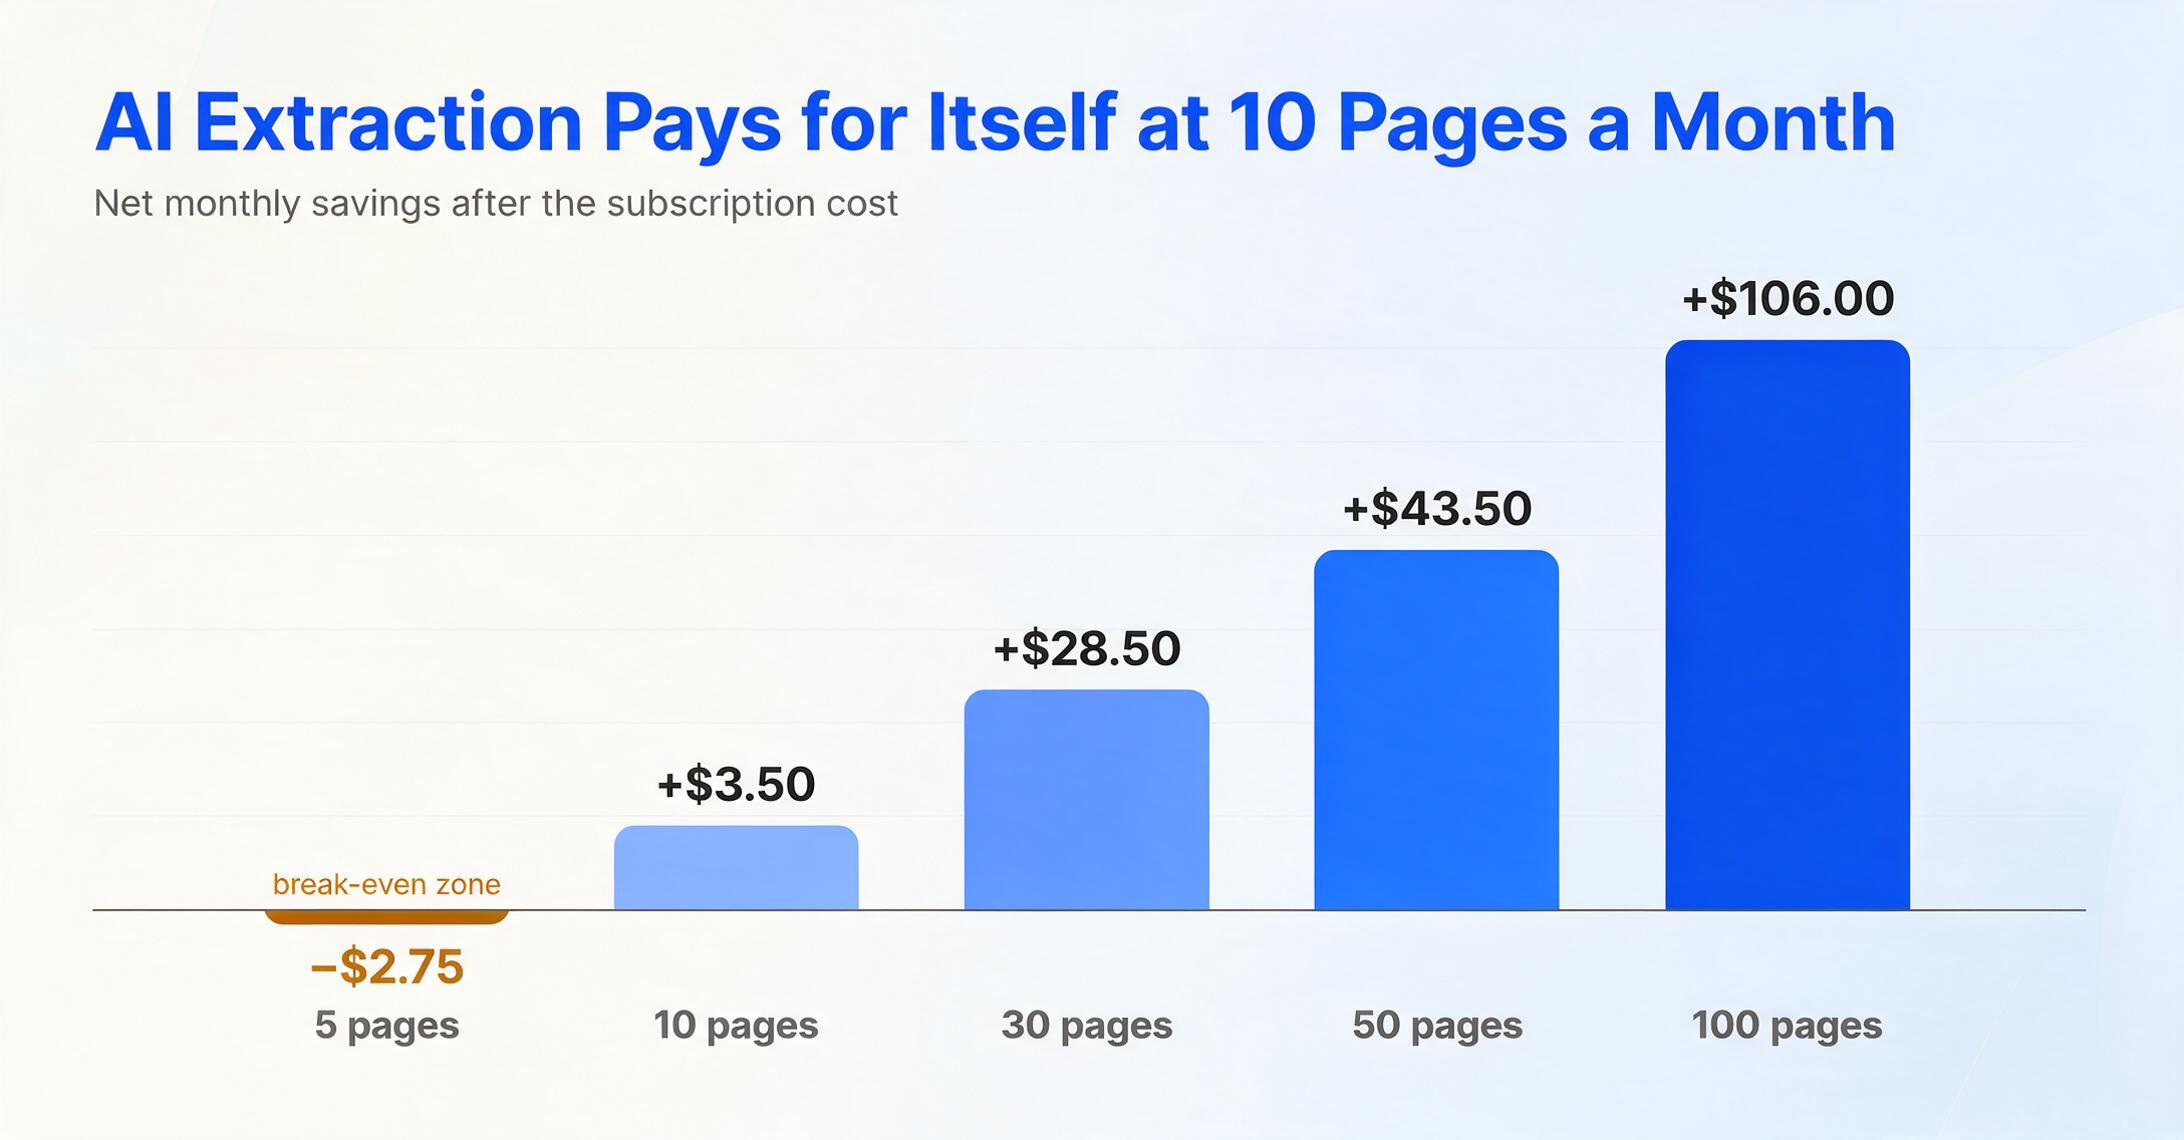
Com 5 páginas por mês, a correção gratuita de OCR custa cerca de $6.25 em mão de obra — um pouco menos que uma assinatura de $9/mês. Este é o volume em que a decisão realmente depende do que mais você poderia fazer com esses 15 minutos. Mas a linha não permanece assim por muito tempo. Com 10 páginas, você já está economizando dinheiro com uma assinatura, mesmo antes de considerar a vantagem de precisão e a redução da frustração. Com 30 páginas — um volume realista para um freelancer com alguns clientes regulares — um plano de $9 economiza mais de $28 por mês apenas em mão de obra.
Os números ficam ainda mais expressivos em volumes maiores. Se você processa 50 faturas no fim do mês, duas horas e meia de correção não são apenas dinheiro — é tempo que você não recupera. E, ao contrário de um trabalhador horista, o OCR gratuito não fica mais rápido com a prática. O mesmo processo de cinco etapas se repete para cada página, cada lote, cada mês. Para uma visão mais ampla do que diferentes ferramentas e planos realmente custam, veja nosso guia de preços de 2026 para extração de documentos com IA, que detalha o custo por documento em todos os níveis.
Também vale notar que esse cálculo conta apenas o tempo — não leva em conta os custos de erros. Um dígito lido incorretamente em um total ($1.590 vs $1.5O0) ou um valor de coluna deslocado (quantidade onde deveria estar o preço unitário) cria problemas a jusante que demoram mais para corrigir do que a extração original. Esses ciclos de correção de erros são invisíveis na narrativa "gratuito" e muito visíveis no fechamento mensal.
Quando o OCR Gratuito Ainda é a Resposta Certa
Nada disso significa que o OCR gratuito é inútil. Significa que sua utilidade tem limites, e conhecer esses limites economiza tempo.
Ferramentas de OCR gratuitas funcionam bem para:
- Tornar um PDF pesquisável. Se você precisa pesquisar uma cláusula específica em um contrato escaneado, o OCR do Google Drive resolve.
- Extrair um bloco curto de texto. Um parágrafo de uma digitalização, um endereço de um formulário — extração de baixo risco e baixo volume.
- Fluxos de trabalho de formato único, alto volume e documentos estáveis. Se você processa 1.000 formulários idênticos com exatamente o mesmo layout todo mês, um pipeline de OCR baseado em modelo (até mesmo um gratuito, com configuração suficiente) pode funcionar — embora isso seja cada vez mais um caso de uso de nicho fora de sistemas governamentais e legados.
- Documentos onde a estrutura não importa. OCR para indexação de arquivos, onde o objetivo é "descobrir qual documento contém esta palavra-chave", não "colocar campos específicos em uma planilha".
O OCR gratuito falha quando seu fluxo de trabalho exige extração em nível de campo de documentos com layouts variados — o que descreve a maioria do processamento de documentos no mundo real. Se você lida com faturas de vários fornecedores, recibos de diferentes comerciantes ou extratos bancários de diferentes bancos, o OCR gratuito fornece texto bruto que ainda precisa ser analisado. Essa etapa de análise é onde o custo realmente está.
Para uma visão prática do que você obtém em cada faixa de preço — de ferramentas de $0 a planos de $9/mês a planos de $19/mês com maior capacidade — nossa comparação de usar uma ferramenta para todos os tipos de documento versus várias ferramentas especializadas analisa a matemática do custo total de propriedade em diferentes cenários de volume.
Para freelancers e profissionais autônomos especificamente — um grupo que muitas vezes começa com ferramentas gratuitas porque o orçamento parece apertado demais para uma assinatura — a questão merece uma análise própria. Nossa análise de extração de documentos com orçamento de freelancer mapeia volumes mensais típicos em relação aos tamanhos de plano para que você possa ver se seu uso real justifica um plano pago ou não. Spoiler: a maioria das pessoas que processam mais de 10 páginas por mês cruza essa linha.
O que US$ 9/mês oferece que o OCR gratuito nunca vai oferecer
Nesse ponto, a pergunta passa de "gratuito vs pago" para "o que o nível pago mais baixo realmente entrega que as ferramentas gratuitas não conseguem?" A resposta se resume a cinco capacidades que eliminam diretamente os cinco passos de limpeza manual descritos anteriormente.
Extração de Colunas Personalizadas
Você define os nomes das colunas. A IA preenche com dados de qualquer documento, independentemente do layout. Sem busca, sem cópia, sem criação de modelo. Os nomes de colunas que você digita se tornam os cabeçalhos do arquivo de saída — diretamente, sem etapa intermediária.
Preservação da Estrutura da Tabela
Tabelas com itens de linha e múltiplas colunas permanecem como tabelas. As relações entre linhas e colunas são preservadas, mantendo a descrição junto com a quantidade e o valor corretos — sem achatar em um fluxo de texto indiferenciado.
Processamento em Lote
Envie 30 faturas e receba um único arquivo Excel com todos os dados mesclados em uma única tabela. Cada documento é processado com o mesmo esquema de colunas. Isso, por si só, economiza mais tempo do que o custo da assinatura — todos os meses.
Normalização de Formato
Datas, valores e números são padronizados automaticamente em todos os documentos de entrada, independentemente de como cada fornecedor os formata. Sem etapa de reformatação manual.
A comparação fica especialmente clara quando você considera o modelo de autoatendimento. Sem ligações de vendas, sem compromissos mínimos, sem processo de licitação — o caminho do registro ao primeiro resultado leva menos de dois minutos. Para saber mais sobre por que os contratos de extração de documentos no estilo empresarial não são o único caminho, veja como a extração de documentos com IA sem contrato empresarial se compara ao modelo tradicional de "agendar uma demonstração, falar com vendas, assinar um contrato de 12 meses" que os usuários de OCR gratuito tentam evitar em primeiro lugar.
FAQ
O Google Lens consegue extrair dados de tabelas para o Excel?
O Google Lens consegue reconhecer texto de uma imagem de tabela e permitir que você o copie para a área de transferência do seu dispositivo. No entanto, a estrutura da tabela — linhas, colunas, células mescladas e alinhamento das colunas — não é preservada. O que você colar no Excel exigirá reorganização manual: separar textos mesclados, realinhar colunas e corrigir a formatação. O Google Lens foi projetado para captura rápida de texto, não para extração estruturada de tabelas. Se você precisar dos dados em colunas prontas para planilha, gastará um tempo considerável com a limpeza pós-extração.
O OCR gratuito é preciso o suficiente para documentos empresariais?
Em textos impressos e limpos, as ferramentas de OCR gratuitas alcançam 98–99% de precisão em nível de caractere. A questão não é a precisão bruta dos caracteres — é que a precisão dos caracteres não equivale a uma saída utilizável. Uma precisão de 99% em nível de caractere ainda significa cerca de 5 a 10 erros por página, e esses erros tendem a se concentrar nos números que mais importam: valores em dólar, datas e números de nota fiscal. Além disso, a precisão dos caracteres não diz nada sobre se as estruturas das tabelas foram preservadas ou se os rótulos dos campos foram mapeados corretamente para seus valores. Para documentos que só precisam ser pesquisáveis — e não estruturados — o OCR gratuito é suficiente. Para documentos em que campos específicos precisam chegar a colunas específicas da planilha, a lacuna entre "texto preciso" e "dados utilizáveis" exige trabalho manual para ser fechada.
Qual é a alternativa paga mais barata ao OCR gratuito?
As ferramentas de extração de documentos com IA mais baratas começam em torno de US$ 9/mês — aproximadamente US$ 0,06 por página no nível inicial. O plano Basic do ImageToTable.ai, por US$ 9/mês, inclui 150 páginas de extração com IA, com colunas personalizadas, preservação da estrutura da tabela e processamento em lote. Para comparação, os parsers baseados em modelo, como o Docparser, começam em US$ 39/mês, e as plataformas empresariais com foco em IA, como a Nanonets, começam em US$ 499/mês. O nível econômico existe — só não é o nível que a maioria das pessoas conhece, porque as ferramentas empresariais dominam os resultados de busca. Se você só precisa de extração ocasional, o ImageToTable.ai também oferece créditos pré-pagos a partir de US$ 6 por 50 páginas, sem data de validade e sem compromisso mensal.
A extração com IA funciona em documentos manuscritos?
Sim, com expectativas realistas. Os modelos de visão por IA alcançam 85–95% de precisão em texto manuscrito, em comparação com 60–70% do OCR tradicional. A precisão depende da legibilidade da caligrafia, da qualidade do documento e do modelo utilizado. Caligrafia clara e consistente em um scan limpo produzirá resultados utilizáveis. Caligrafia apertada e apressada em um recibo amassado desafiará qualquer ferramenta — inclusive a IA. Para um tratamento mais aprofundado da precisão em diferentes tipos de documento e níveis de qualidade, nossa comparação entre extração com IA e OCR tradicional aborda a dimensão da precisão em detalhes, incluindo como os modelos de IA lidam com manuscritos, scans de baixa qualidade e documentos de conteúdo misto.
Quanto tempo a extração com IA realmente economiza por página?
Com base em benchmarks do setor e dados de usuários, a entrada manual de dados de um documento leva em média 2–3 minutos por página. A extração com IA reduz o tempo de processamento para aproximadamente 5–10 segundos por página — uma melhoria de 18× na velocidade. A economia de tempo real, no entanto, não está na velocidade da extração em si, mas na eliminação da limpeza pós-extração. O OCR gratuito economiza a etapa de digitação manual, mas adiciona uma etapa de correção manual. A extração com IA elimina ambas. Para uma única página, a diferença é de 3 minutos versus 10 segundos. Para 50 páginas no fechamento do mês, a diferença é de 2,5 horas de trabalho versus menos de 10 minutos — e isso sem contar os erros que a correção manual introduz.
A economia das ferramentas gratuitas depende de uma variável: quanto vale o seu tempo. Para qualquer pessoa que processa documentos regularmente, a matemática pende para a extração paga muito antes de o volume parecer "grande". O custo da ferramenta é visível na página de cobrança. O custo da correção manual é visível na sua agenda — quando você percebe isso, para de chamar o OCR gratuito de "gratuito".
Sem cartão de crédito. Sem necessidade de cadastro para a primeira página.