OCR vs Extração com IA:
Entendendo a Diferença Entre Ler e Compreender
OCR e extração com IA processam documentos, mas respondem a perguntas fundamentalmente diferentes: o OCR informa quais caracteres aparecem na página, enquanto a extração com IA informa o que esses caracteres significam. A confusão entre os dois é compreensível — ambos pegam imagens de documentos e produzem saída digital — mas confundi-los é como trocar uma máquina de escrever por um editor. Um transcreve. O outro interpreta.
Principais Conclusões
- Seu OCR lê cada caractere perfeitamente — e entrega um bloco de texto plano sem rótulos. Um ERP não consegue distinguir o número da fatura do endereço do fornecedor, então alguém ainda abre cada arquivo e os classifica manualmente.
- Toda vez que um fornecedor muda o layout da fatura, você cria um novo modelo. O custo real não é o modelo — é que a extração baseada em posição trata todos os documentos como idênticos, e o mundo nunca envia documentos idênticos.
- A extração com IA encontra o "Total da Fatura" esteja ele no canto superior direito de um documento ou no canto inferior esquerdo de outro. Ela não pergunta onde na página — ela pergunta o que os dados significam, como uma pessoa faria.
O que OCR e Extração com IA Realmente Fazem (e Não Fazem)
Reconhecimento Óptico de Caracteres (OCR) é uma tecnologia que converte imagens de texto datilografado, manuscrito ou impresso em texto legible por máquina. Ele reconhece caracteres individuais — letras, números, símbolos — comparando-os com padrões conhecidos ou usando algoritmos de correspondência de padrões. A saída é texto bruto: uma string de caracteres que representa o que foi fisicamente impresso na página.
Extração de documentos com IA — às vezes chamada de processamento inteligente de documentos ou extração com tecnologia de IA — usa modelos de visão e linguagem, processamento de linguagem natural e aprendizado profundo para entender o conteúdo de um documento. Não se limita a ler caracteres; identifica o que esses caracteres significam no contexto. Um sistema de extração com IA pode dizer que um número específico é o total da fatura, que uma data é a data de vencimento e que um nome é o fornecedor — porque entende o papel semântico que cada informação desempeña.
A distinção central: OCR converte imagens em texto. A extração com IA converte imagens em dados estruturados e significativos. Uma é uma tecnologia de transcrição. A outra é uma tecnologia de compreensão.
Essa diferença importa porque os sistemas downstream — planillas de cálculo, software de contabilidade, ERPs — não querem texto bruto. Eles querem campos limpos com significado conhecido: "Número de Fatura: INV-2026-0891", "Total: $1.234,56", "Data de Vencimento: 2026-07-15". O OCR pode fornecer a primeira parte (os caracteres de texto), mas não pode fornecer a segunda parte (o que cada pedazo de texto significa).
O Mesmo Documento, Duas Respostas Diferentes
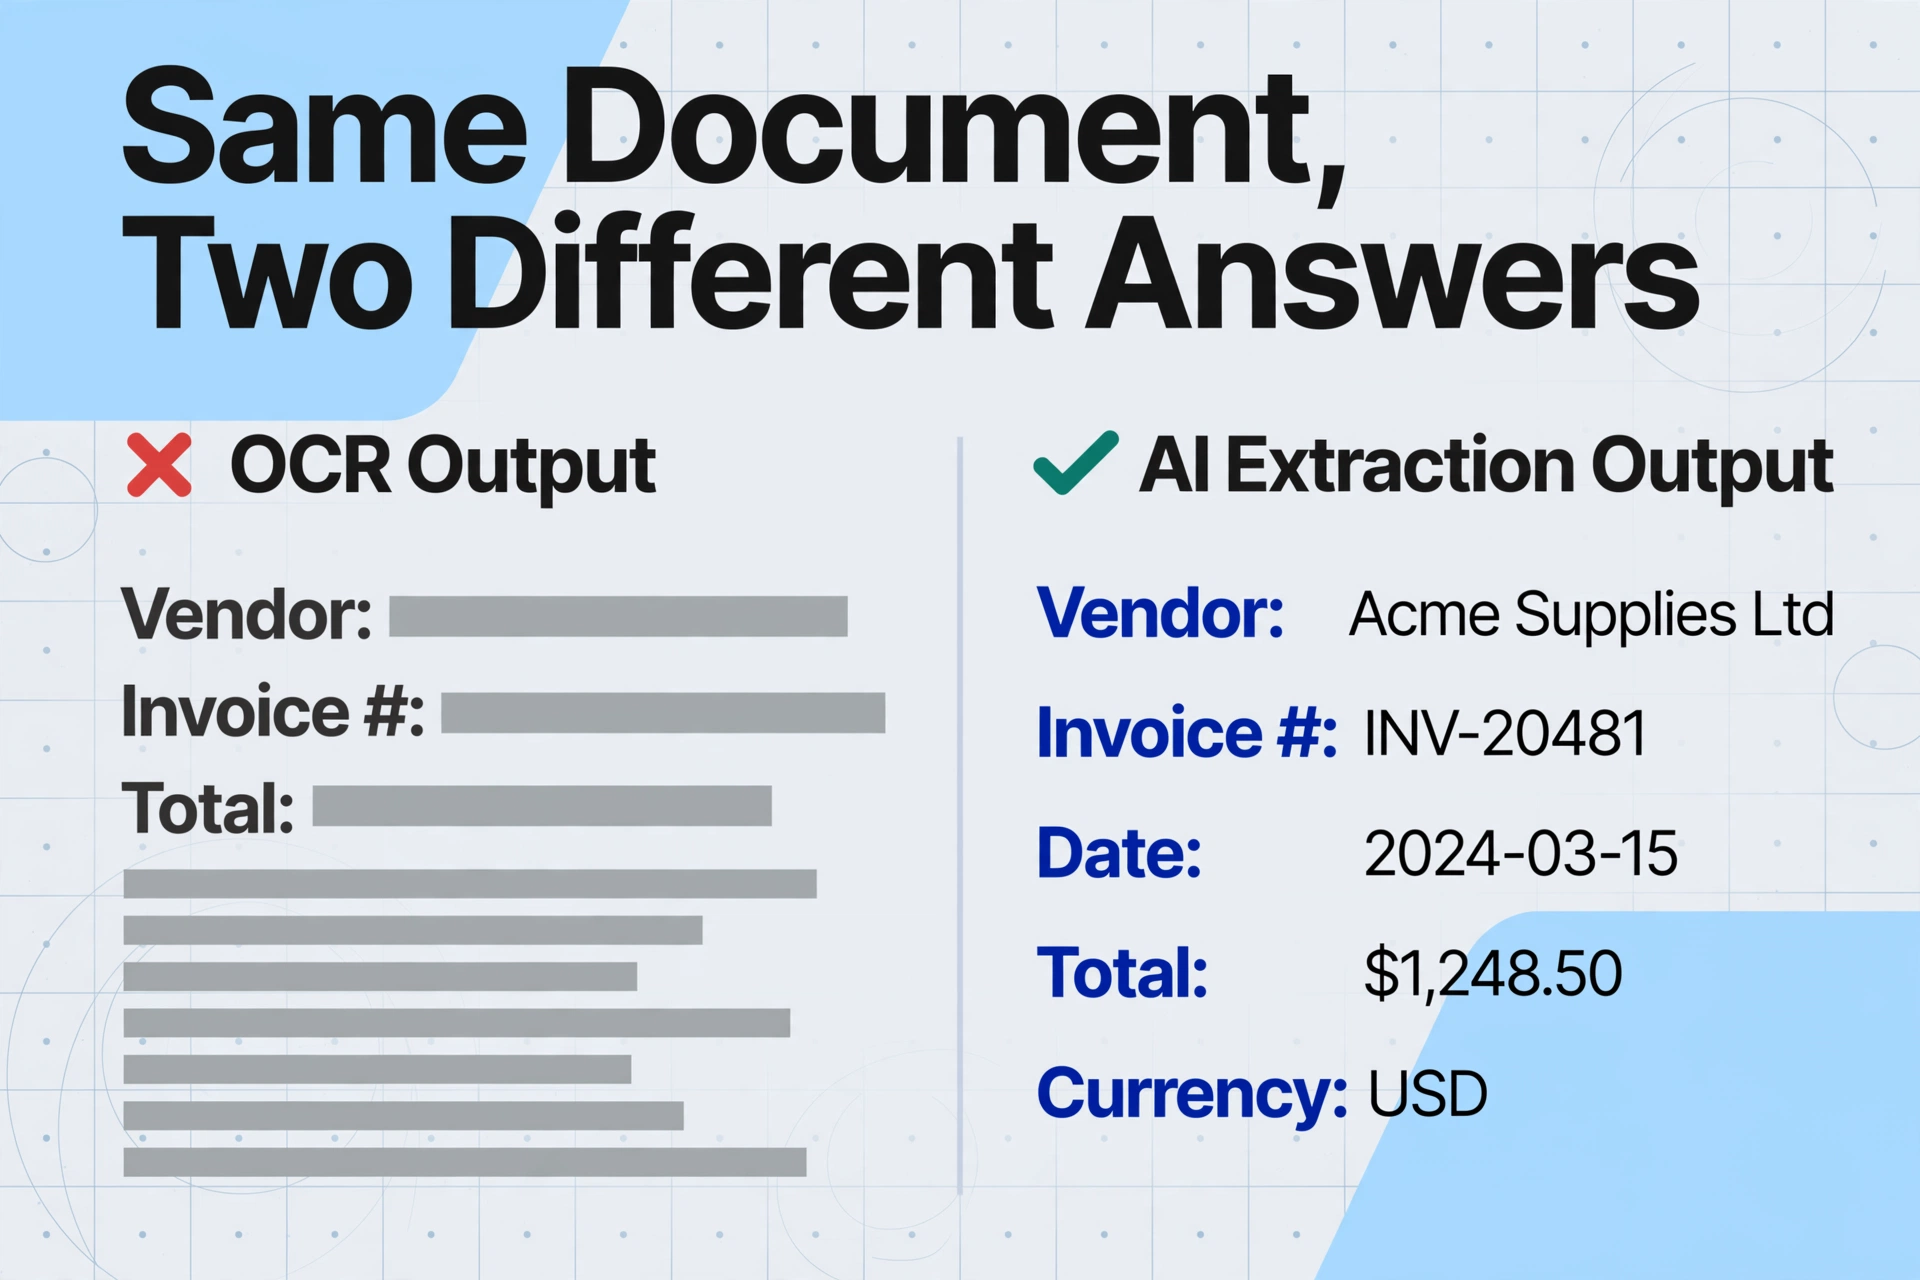
A maneira mais eficaz de entender a distinção é ver o que cada tecnologia realmente produz quando recebe o mesmo documento. Considere uma fatura padrão com o seguinte conteúdo:
Fragmento de fatura de exemplo:
Vendor: Pacific Maritime Supplies
Invoice #: INV-2026-0891
Date: 06/15/2026
Due Date: 2026-07-15
Description: 40ft Shipping Container – Refurbished
Qty: 2 × Unit Price: $3,800.00
Subtotal: $7,600.00
Tax (8.25%): $627.00
Invoice Total: $8,227.00
Saída de OCR — uma única string de caracteres reconhecidos, despojada de significado:
O OCR transcreveu cada caractere com sucesso. Mas a saída é um bloco de texto plano. Para extrair significado — para saber que "INV-2026-0891" é o número da fatura e "$8.227,00" é o total — você precisa de uma pessoa para ler, ou de um modelo que diga ao sistema onde cada campo está, por posição.
Saída da extração com IA — dados estruturados com rótulos semânticos:
| Campo | Valor |
|---|---|
| Nome do fornecedor | Pacific Maritime Supplies |
| Número da fatura | INV-2026-0891 |
| Data da fatura | 2026-06-15 |
| Data de vencimento | 2026-07-15 |
| Descrição do item | 40ft Shipping Container – Refurbished |
| Quantidade | 2 |
| Preço unitário | $3.800,00 |
| Subtotal | $7.600,00 |
| Imposto | $627,00 |
| Total da fatura | $8.227,00 |
A diferença é clara. A extração com IA não apenas transcreve o texto — ela entende o que cada valor representa e o organiza em campos rotulados. O total da fatura não é apenas uma sequência de caracteres ($8.227,00); é o Total da Fatura — um dado semântico que uma planilha pode somar, um ERP pode lançar e um relatório pode analisar.
Esta é a diferença fundamental: o OCR entrega texto. A extração com IA entrega respostas.
Mito 1: "OCR e Extração com IA São o Mesmo Tipo de Tecnologia"
Este é o equívoco mais comum — e é compreensível. Tanto o OCR quanto a extração com IA recebem imagens de documentos como entrada e produzem dados digitais como saída. Ambos são vendidos sob termos de marketing sobrepostos, como "captura de documentos", "extração de dados" e "OCR inteligente". Mas a tecnologia subjacente é fundamentalmente diferente.
O OCR é uma tecnologia de correspondência de padrões. O OCR tradicional funciona comparando formatos de caracteres com um banco de dados interno de glifos conhecidos. Ele pergunta: "Este padrão de pixels corresponde à letra 'A', ao número '8' ou ao símbolo '$'?" Ele opera no nível do caractere — cada glifo é reconhecido de forma independente, sem compreensão da palavra ou frase à qual pertence. O OCR moderno melhorou com o aprendizado de máquina, mas sua tarefa fundamental continua sendo o reconhecimento de caracteres.
A extração com IA é uma tecnologia de compreensão semântica. Ela usa modelos de visão e linguagem (VLMs) que processam o documento inteiro como uma cena visual — não apenas caracteres individuais, mas o layout, as relações espaciais entre blocos de texto, as pistas de formatação (negrito = cabeçalho, fonte grande = título) e o significado contextual de cada dado. Ela pergunta: "Considerando tudo nesta página, qual é o número da fatura? Qual é o total? Qual é o nome do fornecedor?"
Uma analogia útil: o OCR é como uma pessoa que consegue soletrar cada palavra de um livro, mas não consegue dizer sobre o que é a história. A extração com IA é como um leitor que entende o enredo, os personagens e os temas — e consegue resumi-los para você.
O guia completo sobre o que é OCR explica isso em mais profundidade, incluindo as três gerações de tecnologia de OCR de 1974 até hoje.
Mito 2: "A Extração por IA Substitui o OCR — Você Só Precisa de Um"
Esse equívoco leva muitas empresas a acreditarem que precisam escolher entre as duas tecnologias. A realidade é que elas operam em camadas diferentes da mesma pilha, e muitos pipelines de extração por IA usam o OCR como primeiro passo.
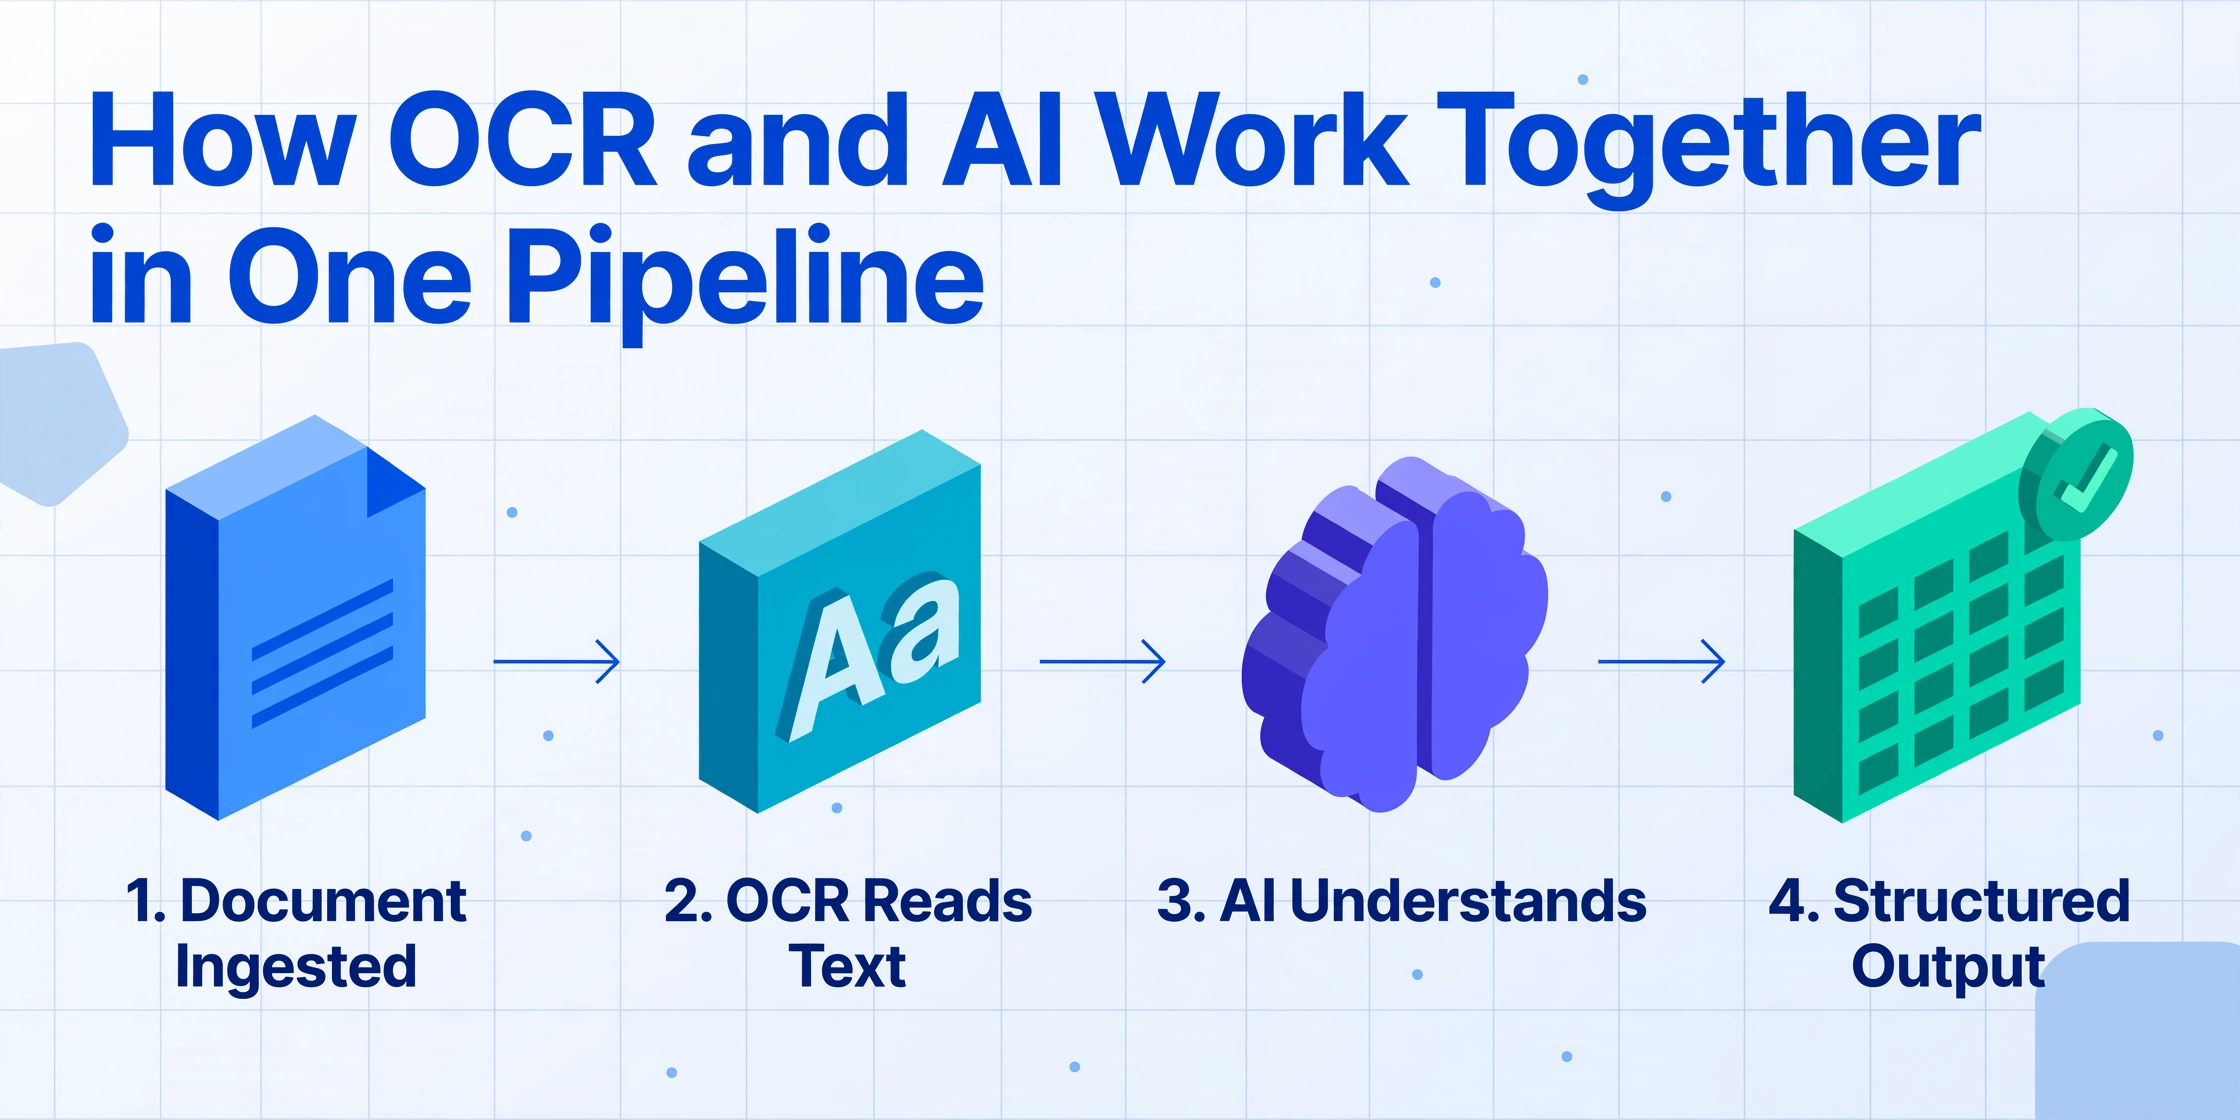
Pense assim: o OCR é a fundação — ele converte o documento visual em texto legível por máquina. A extração por IA é a camada acima — ela pega esse texto (ou os dados visuais brutos) e o interpreta. Um pipeline típico de processamento de documentos com IA se parece com isto:
PDF, imagem ou captura de tela entra no sistema.
Os caracteres são identificados e extraídos como texto bruto — é aqui que o OCR faz seu trabalho.
O modelo de IA analisa o layout do documento, o contexto e as relações para identificar o que cada dado significa.
Os dados interpretados são organizados em campos rotulados e exportados para uma planilha, banco de dados ou API.
Em muitos sistemas modernos, as camadas de OCR e IA são tão integradas que o usuário nunca vê a fronteira. Mas conceitualmente, a separação é importante: O OCR fornece a matéria-prima. A extração por IA dá significado a ela.
Essa também é a principal diferença entre o OCR tradicional com IA — que é essencialmente OCR aprimorado com aprendizado de máquina para melhor reconhecimento de caracteres — e a extração completa de documentos por IA, que entende a semântica do documento. O artigo sobre o que é OCR com IA e como ele difere do OCR tradicional explora essa distinção em detalhes.
Mito 3: "Se você tem OCR, não precisa de extração com IA"
Esse mito persiste porque o OCR tem sido "bom o suficiente" para muitas tarefas com documentos por anos. E em certos cenários, ele realmente é. Mas esses cenários estão diminuindo à medida que o volume de documentos cresce e os formatos se multiplicam.
Quando o OCR sozinho é suficiente
O OCR funciona bem quando os documentos são estruturalmente consistentes — todo documento segue o mesmo modelo, usa o mesmo layout e coloca as informações principais nas mesmas posições. Exemplos incluem:
- Digitalizar formulários governamentais padronizados (W-2s, 1099s) de uma única fonte
- Converter páginas de livros impressos em texto pesquisável
- Processar formulários internos da empresa onde todos os departamentos usam o mesmo modelo
- Criar arquivos PDF pesquisáveis a partir de documentos digitalizados, onde o objetivo é a busca em texto completo, não a extração de dados
Nesses casos, o OCR mais um modelo (ou revisão manual) pode produzir resultados utilizáveis. A variabilidade dos documentos é baixa, então a extração baseada em posição funciona.
Quando você precisa de extração com IA
A extração com IA se torna essencial quando qualquer uma das seguintes condições existir:
| Condição | Por que o OCR sozinho falha | O que a extração com IA faz |
|---|---|---|
| Múltiplos fornecedores ou fontes | Cada fornecedor usa um layout de fatura diferente — o OCR baseado em modelos falha a cada mudança de formato | Entende o significado do campo independentemente da posição — adapta-se automaticamente |
| Conteúdo manuscrito | O OCR tradicional tem dificuldade com a variabilidade da caligrafia | Modelos de visão e linguagem interpretam a caligrafia usando contexto visual |
| Tipos de documentos mistos | Cada tipo precisa do seu próprio modelo — a manutenção cresce linearmente | Um único modelo de IA lida com faturas, recibos, ordens de compra e contratos |
| Necessidade de campos específicos, não de todo o texto | O OCR gera tudo — você ainda precisa encontrar os dados que deseja | Você define os campos (Número da Fatura, Total, Data de Vencimento) — a IA extrai apenas o que você pediu |
| Digitalizações ou fotos de baixa qualidade | Imagens borradas, ângulos inclinados e baixo contraste degradam a precisão | Os VLMs lidam melhor com a degradação — eles processam a imagem como uma cena visual, não apenas como formatos de caracteres |
| Necessidade de dados calculados ou inferidos | O OCR não calcula — ele apenas lê o que está impresso | A IA pode calcular totais de linhas, categorizar despesas ou inferir dados não escritos explicitamente |
Se o seu fluxo de trabalho com documentos envolve apenas o primeiro cenário — modelos consistentes de uma única fonte — o OCR pode ser suficiente para você. Para praticamente qualquer outra necessidade moderna de processamento de documentos, a extração com IA é a escolha prática.
A Mudança: Da Extração Baseada em Posição para a Extração Baseada em Semântica
A confusão entre OCR e extração com IA não é apenas um problema de terminologia. Ela reflete uma mudança mais profunda em como a extração de dados de documentos funciona — uma mudança da extração baseada em posição para a extração baseada em semântica.
Por décadas, a extração de dados de documentos seguiu uma fórmula simples: o OCR extrai todo o texto → um modelo mapeia as posições dos campos → o sistema lê o valor em cada coordenada. Este é o paradigma baseado em posição. Ele funciona enquanto cada documento colocar seus campos exatamente no mesmo local.
O problema é que documentos do mundo real não funcionam assim. Fornecedores usam layouts de fatura diferentes. Extratos bancários vêm em formatos variados. Ordens de compra de empresas diferentes organizam as informações de maneiras distintas. Em um sistema baseado em posição, cada variação de formato exige um novo modelo ou um ajuste de regra — é por isso que os fluxos de trabalho tradicionais de OCR falham à medida que a variedade de documentos cresce.
A extração baseada em semântica — o paradigma que a extração com IA possibilita — inverte a fórmula. Em vez de perguntar "onde estão os dados na página?", ela pergunta "o que os dados significam?". O modelo de IA lê o documento inteiro como uma cena visual unificada, entende as relações entre os blocos de texto e identifica cada dado pelo seu papel semântico — independentemente de onde ele está na página.
Isso não é uma melhoria incremental. É uma abordagem diferente para o problema — uma que transfere o ônus da adaptação do usuário (criar modelos) para a tecnologia (entender documentos).
O ImageToTable.ai, por exemplo, opera inteiramente nesse paradigma baseado em semântica. Você define a saída — os nomes das colunas que deseja — e a IA localiza os dados correspondentes em qualquer layout de documento, entendendo o que cada campo representa. É isso que a descrição do produto chama de extração sem modelo e independente de formato — capacidades simplesmente impossíveis apenas com OCR, porque o OCR não tem conceito do que significa "Nome do Fornecedor" ou "Total da Fatura".
O conceito emergente de OCR agêntico representa a próxima evolução — onde a IA não apenas lê e entende documentos, mas também pode raciocinar sobre a estrutura do documento e agir sobre os dados extraídos. Mas o salto fundamental é da leitura para a compreensão.
Para uma visão geral mais ampla de como todas essas tecnologias se encaixam, o guia de extração de documentos com IA serve como o hub deste cluster de tópicos.
Perguntas Frequentes
A extração com IA usa OCR?
Muitos sistemas de extração com IA usam OCR como um componente do pipeline — normalmente como a camada de reconhecimento de texto. Mas a camada de IA vai muito além do que o OCR sozinho pode fazer, entendendo o significado, o contexto e as relações entre os pontos de dados. Alguns modelos modernos de visão e linguagem contornam o OCR tradicional por completo, processando a imagem do documento diretamente.
OCR e extração com IA podem trabalhar juntos?
Sim — e em muitos sistemas é exatamente o que acontece. O OCR cuida da etapa de reconhecimento de caracteres, convertendo o texto visual em formato legible por máquina. A extração com IA interpreta esse texto para identificar campos específicos, validar dados e estruturar a saída. São tecnologias complementarias, não concorrentes.
A extração com IA é mais precisa que o OCR?
Depende da tarefa. Para reconhecimento simples de caracteres em documentos limpos e padronizados, o OCR pode alcanzar alta precisão. Mas para extraer campos de dados específicos — como encontrar o total da fatura entre dezenas de números em uma página — a extração com IA é significativamente mais precisa, porque entende qual número é o total com base no contexto, não apenas na posição. Para dados de tabelas impressas com formato consistente, os sistemas modernos com IA podem alcanzar até 99% de precisão.
Que tipos de documentos funcionam melhor com a extração com IA?
A extração com IA funciona bem com praticamente qualquer tipo de documento que tenha conteúdo de texto: faturas, recibos, ordens de compra, extratos bancários, contratos, notas de remessa, planillas de horas, certificados de seguro e mais. Maneja documentos estruturados (formulários com layouts fixos), documentos semiestructurados (faturas com layouts variáveis) e até documentos não estruturados (notas manuscritas, informes de inspección). A principal vantagem é que não requer modelos para nenhum deles.
Ainda preciso de OCR se uso extração com IA?
Não necessariamente — muitas herramientas modernas de extração com IA manejan todo o pipeline, desde a imagem até os dados estruturados, sem expor o OCR como uma etapa separada. A IA lê o documento diretamente e gera os campos que você precisa. Não é necessário executar OCR primeiro e depois alimentar a saída em uma herramienta de IA. O sistema de extração com IA maneja tanto a leitura como a comprensión em uma única passada.
O que é mais caro: OCR ou extração com IA?
A comparação direta de custos depende da ferramenta específica e do volume. No entanto, o custo total de propriedade muitas vezes favorece a extração com IA quando você considera os custos ocultos do OCR: criação e manutenção de modelos, validação manual de campos extraídos incorretamente e gestão de exceções quando os formatos mudam. As ferramentas de extração com IA geralmente usan precios por assinatura e eliminam a maior parte dos gastos relacionados a modelos. Muitas oferecen níveis gratuitos ou acesso de demonstração para testar com seus próprios documentos.
Veja a Diferença em Seus Próprios Documentos
A melhor maneira de entender a diferença entre OCR e extração com IA é vê-la com seus próprios documentos. O que segue é uma demonstração ao vivo — envie qualquer fatura, recibo ou documento e veja o que um sistema de extração com IA produz. Sem modelos. Sem configuração. Basta enviar e ver os campos estruturados que a IA identifica.
Os arquivos são processados com segurança e não são armazenados.
Envie um documento e digite alguns nomes de colunas — "Número da Fatura", "Total", "Nome do Fornecedor", "Data de Vencimento" — e veja a IA localizar e extrair cada campo entendendo o que ele significa, não onde está na página. Essa é a diferença entre ler caracteres e entender um documento.
É isso que separa o OCR da extração com IA: o OCR lê o que está escrito. A extração com IA sabe o que significa. E em um mundo onde os documentos vêm em infinitas variações, entender importa.