OCR vs extraction IA :
Comprendre la différence entre lire et comprendre
L'OCR et l'extraction IA traitent tous deux des documents, mais ils répondent à des questions fondamentalement différentes : l'OCR vous dit quels caractères apparaissent sur la page, tandis que l'extraction IA vous dit ce que ces caractères signifient. La confusion entre les deux est compréhensible — les deux prennent des images de documents et produisent une sortie numérique — mais les confondre revient à confondre une machine à écrire avec un éditeur. L'une transcrit. L'autre interprète.
Points clés à retenir
- Votre OCR lit chaque caractère sans faute — et vous remet un bloc de texte brut non étiqueté. Un ERP ne peut pas distinguer le numéro de facture de l'adresse du fournisseur, alors quelqu'un doit encore ouvrir chaque fichier et les trier à la main.
- Chaque fois qu'un fournisseur modifie la mise en page de sa facture, vous créez un nouveau modèle. Le vrai coût n'est pas le modèle — c'est que l'extraction basée sur la position traite chaque document comme identique, et le monde ne vous envoie jamais des documents identiques.
- L'extraction IA trouve « Total de la facture » qu'il soit en haut à droite d'un document ou en bas à gauche d'un autre. Elle ne demande pas où sur la page — elle demande ce que la donnée signifie, comme le ferait une personne.
Ce que font (et ne font pas) l'OCR et l'extraction IA
La reconnaissance optique de caractères (OCR) est une technologie qui convertit des images de texte tapé, manuscrit ou imprimé en texte lisible par machine. Elle reconnaît les caractères individuels — lettres, chiffres, symboles — en les comparant à des motifs connus ou en utilisant des algorithmes de correspondance de formes. Le résultat est du texte brut : une chaîne de caractères qui représente ce qui était physiquement imprimé sur la page.
L'extraction de documents par IA — parfois appelée traitement intelligent de documents ou extraction basée sur l'IA — utilise des modèles vision-langage, le traitement du langage naturel et l'apprentissage profond pour comprendre le contenu d'un document. Elle ne se contente pas de lire les caractères ; elle identifie ce que ces caractères signifient dans leur contexte. Un système d'extraction par IA peut vous dire qu'un nombre particulier est le total de la facture, qu'une date est la date d'échéance, et qu'un nom est le fournisseur — car il comprend le rôle sémantique que joue chaque information.
La distinction essentielle : l'OCR convertit les images en texte. L'extraction IA convertit les images en données structurées et significatives. L'une est une technologie de transcription. L'autre est une technologie de compréhension.
Cette différence compte car les systèmes en aval — feuilles de calcul, logiciels comptables, ERP — ne veulent pas de texte brut. Ils veulent des champs propres avec une signification connue : « Numéro de facture : INV-2026-0891 », « Total : 1 234,56 $ », « Date d'échéance : 2026-07-15 ». L'OCR peut vous donner la première partie (les caractères du texte), mais elle ne peut pas vous donner la seconde (ce que chaque morceau de texte signifie).
Le même document, deux réponses différentes
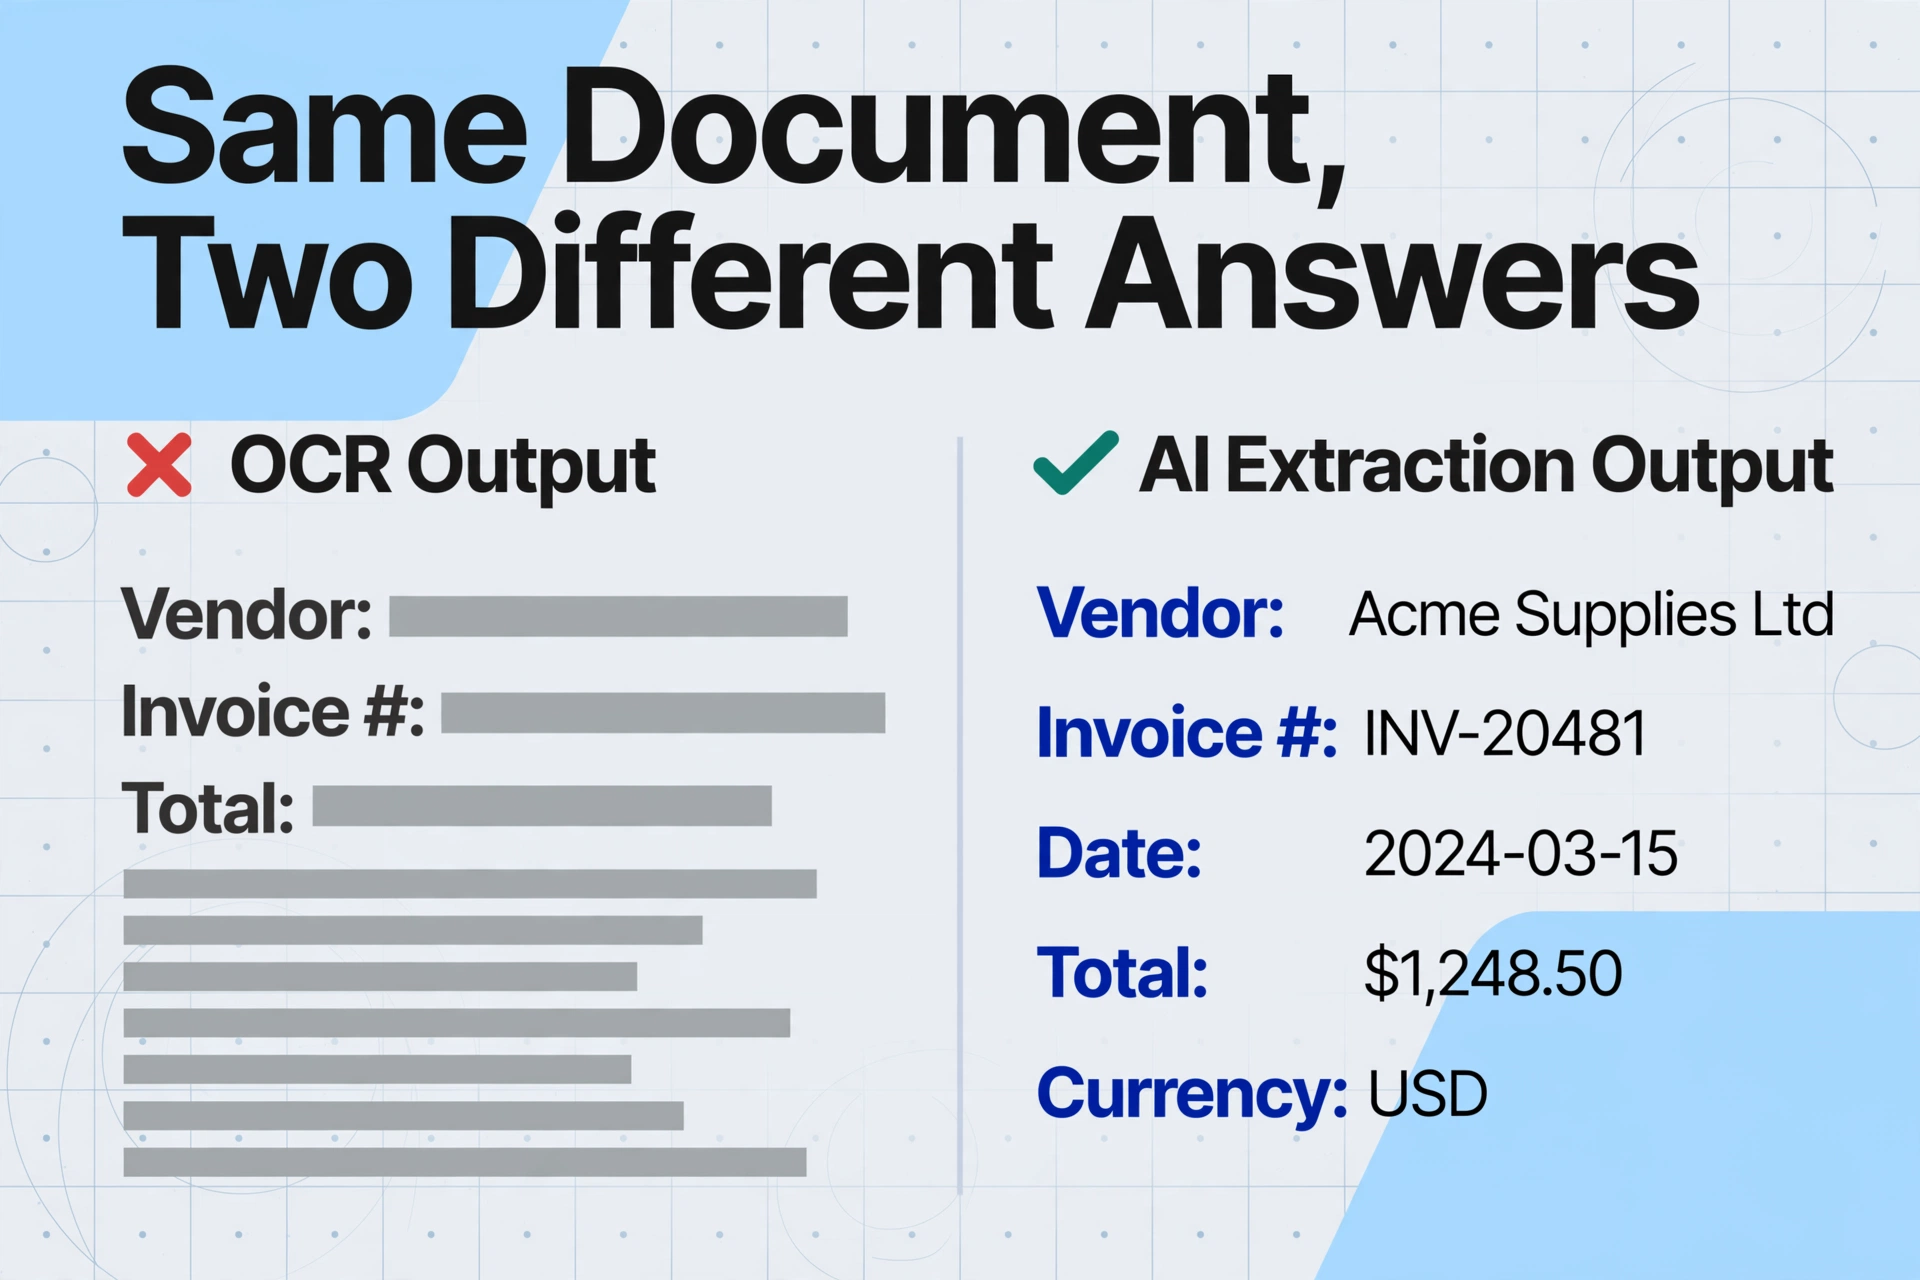
La façon la plus efficace de comprendre la distinction est de voir ce que chaque technologie produit réellement lorsqu'on lui donne le même document. Prenons une facture standard avec le contenu suivant :
Extrait de facture d'exemple :
Fournisseur : Pacific Maritime Supplies
Facture n° : INV-2026-0891
Date : 15/06/2026
Date d'échéance : 2026-07-15
Description : Conteneur maritime 40 pieds – Remis à neuf
Qté : 2 × Prix unitaire : 3 800,00 $
Sous-total : 7 600,00 $
Taxe (8,25 %) : 627,00 $
Total de la facture : 8 227,00 $
Sortie OCR — une simple chaîne de caractères reconnus, dépourvue de sens :
L'OCR a transcrit avec succès chaque caractère. Mais le résultat est un bloc de texte plat. Pour en extraire le sens — pour savoir que « INV-2026-0891 » est le numéro de facture et que « 8 227,00 $ » est le total — vous avez besoin qu'un humain le lise, ou d'un modèle qui indique au système où se trouve chaque champ en fonction de sa position.
Sortie de l'extraction IA — données structurées avec des étiquettes sémantiques :
| Champ | Valeur |
|---|---|
| Nom du fournisseur | Pacific Maritime Supplies |
| Numéro de facture | INV-2026-0891 |
| Date de facture | 2026-06-15 |
| Date d'échéance | 2026-07-15 |
| Description de la ligne d'article | Conteneur maritime 40 pieds – remis à neuf |
| Quantité | 2 |
| Prix unitaire | 3 800,00 $ |
| Sous-total | 7 600,00 $ |
| Taxe | 627,00 $ |
| Total de la facture | 8 227,00 $ |
La différence est frappante. L'extraction IA ne se contente pas de transcrire le texte — elle comprend ce que représente chaque valeur et l'organise en champs étiquetés. Le total de la facture n'est pas qu'une chaîne de caractères (8 227,00 $) ; c'est le Total de la facture — un point de données sémantique qu'un tableur peut additionner, qu'un ERP peut comptabiliser et qu'un rapport peut analyser.
C'est la différence fondamentale : l'OCR vous donne du texte. L'extraction IA vous donne des réponses.
Mythe 1 : « L'OCR et l'extraction IA sont le même type de technologie »
C'est l'idée fausse la plus courante — et c'est compréhensible. L'OCR et l'extraction IA prennent toutes deux des images de documents en entrée et produisent des données numériques en sortie. Les deux sont vendues sous des termes marketing qui se chevauchent comme « capture de documents », « extraction de données » et « OCR intelligent ». Mais la technologie sous-jacente est fondamentalement différente.
L'OCR est une technologie de correspondance de formes. L'OCR traditionnel fonctionne en comparant les formes des caractères à une base de données interne de glyphes connus. Il se demande : « Ce motif de pixels correspond-il à la lettre « A », au chiffre « 8 » ou au symbole « $ » ? » Il opère au niveau du caractère — chaque glyphe est reconnu indépendamment, sans comprendre le mot ou la phrase auquel il appartient. L'OCR moderne s'est amélioré grâce à l'apprentissage automatique, mais sa tâche fondamentale reste la reconnaissance de caractères.
L'extraction IA est une technologie de compréhension sémantique. Elle utilise des modèles vision-langage (VLM) qui traitent le document entier comme une scène visuelle — non seulement les caractères individuels, mais aussi la mise en page, les relations spatiales entre les blocs de texte, les indices de formatage (gras = en-tête, grande police = titre) et le sens contextuel de chaque point de données. Elle se demande : « Compte tenu de tout ce qui se trouve sur cette page, quel est le numéro de facture ? Quel est le total ? Quel est le nom du fournisseur ? »
Une analogie utile : l'OCR est comme une personne qui peut déchiffrer chaque mot d'un livre mais qui ne peut pas vous dire de quoi parle l'histoire. L'extraction IA est comme un lecteur qui comprend l'intrigue, les personnages et les thèmes — et qui peut vous les résumer.
Le guide complet sur ce qu'est l'OCR explique cela plus en détail, y compris les trois générations de technologie OCR de 1974 à aujourd'hui.
Mythe 2 : « L'extraction IA remplace l'OCR — vous n'avez besoin que d'un seul outil »
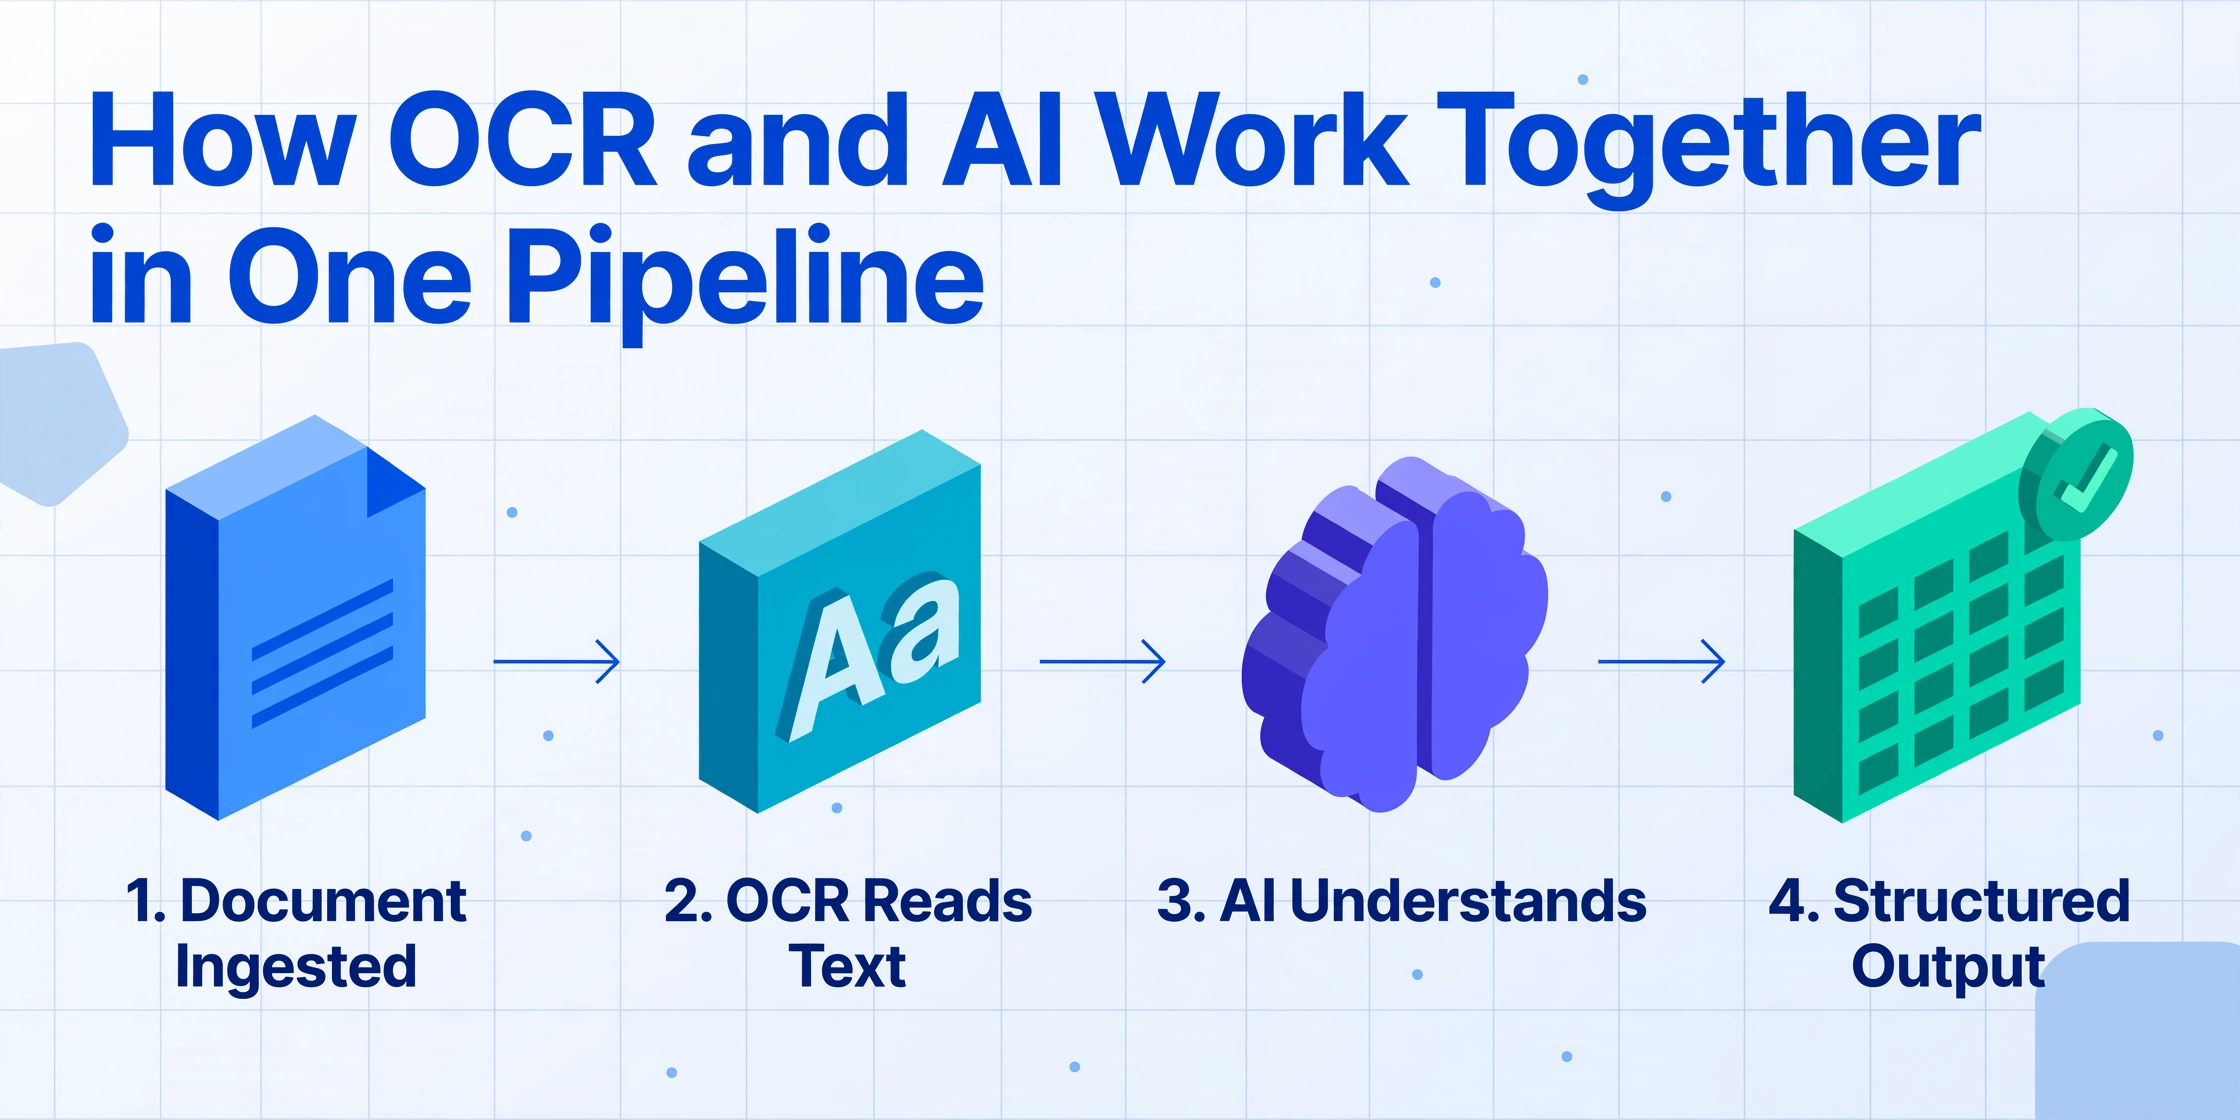
Cette idée reçue pousse de nombreuses entreprises à croire qu'elles doivent choisir entre les deux technologies. En réalité, elles opèrent à différentes couches de la même pile, et de nombreux pipelines d'extraction IA utilisent en fait l'OCR comme première étape.
Voyez les choses ainsi : l'OCR est la fondation — il convertit le document visuel en texte lisible par machine. L'extraction IA est la couche supérieure — elle prend ce texte (ou les données visuelles brutes) et l'interprète. Un pipeline typique de traitement de documents par IA ressemble à ceci :
Un PDF, une image ou une capture d'écran entre dans le système.
Les caractères sont identifiés et extraits sous forme de texte brut — c'est là que l'OCR fait son travail.
Le modèle d'IA analyse la mise en page, le contexte et les relations du document pour identifier la signification de chaque donnée.
Les données interprétées sont organisées en champs étiquetés et exportées vers un tableur, une base de données ou une API.
Dans de nombreux systèmes modernes, les couches OCR et IA sont si étroitement intégrées que l'utilisateur ne voit jamais la frontière. Mais conceptuellement, la séparation est importante : l'OCR fournit la matière première. L'extraction IA lui donne du sens.
C'est aussi la différence clé entre l'OCR IA traditionnel — qui est essentiellement de l'OCR amélioré par l'apprentissage automatique pour une meilleure reconnaissance des caractères — et l'extraction complète de documents par IA, qui comprend la sémantique du document. L'article sur ce qu'est l'OCR IA et en quoi il diffère de l'OCR traditionnel explore cette distinction en détail.
Mythe 3 : « Si vous avez un OCR, vous n'avez pas besoin d'extraction IA »
Ce mythe persiste parce que l'OCR a été « suffisant » pour de nombreuses tâches documentaires pendant des années. Et dans certains scénarios, il l'est réellement. Mais ces scénarios se réduisent à mesure que le volume de documents augmente et que les formats se multiplient.
Quand l'OCR seul suffit
L'OCR fonctionne bien lorsque les documents sont structurellement cohérents — chaque document suit le même modèle, utilise la même mise en page et place les informations clés aux mêmes positions. Exemples :
- Numérisation de formulaires gouvernementaux standardisés (W-2, 1099) provenant d'une source unique
- Conversion de pages de livres imprimés en texte consultable
- Traitement de formulaires internes d'entreprise où tous les départements utilisent le même modèle
- Création d'archives PDF consultables à partir de documents scannés lorsque l'objectif est la recherche en texte intégral, et non l'extraction de données
Dans ces cas, l'OCR plus un modèle (ou une relecture manuelle) peut produire des résultats utilisables. La variabilité des documents est faible, donc l'extraction basée sur la position fonctionne.
Quand vous avez besoin d'extraction IA
L'extraction IA devient essentielle lorsque l'une des conditions suivantes existe :
| Condition | Pourquoi l'OCR seul échoue | Ce que fait l'extraction IA |
|---|---|---|
| Plusieurs fournisseurs ou sources | Chaque fournisseur utilise une mise en page de facture différente — l'OCR basé sur des modèles casse à chaque changement de format | Comprend la signification des champs indépendamment de la position — s'adapte automatiquement |
| Contenu manuscrit | L'OCR traditionnel peine face à la variabilité de l'écriture manuscrite | Les modèles vision-langage interprètent l'écriture manuscrite en utilisant le contexte visuel |
| Types de documents mixtes | Chaque type nécessite son propre modèle — la maintenance augmente linéairement | Un seul modèle IA gère les factures, reçus, bons de commande et contrats |
| Besoin de champs spécifiques, pas de tout le texte | L'OCR produit tout — vous devez encore trouver les données que vous voulez | Vous définissez les champs (Numéro de facture, Total, Date d'échéance) — l'IA extrait uniquement ce que vous demandez |
| Scans ou photos de mauvaise qualité | Les images floues, les angles inclinés et le faible contraste dégradent la précision | Les VLM gèrent mieux la dégradation — ils traitent l'image comme une scène visuelle, pas seulement comme des formes de caractères |
| Besoin de données calculées ou inférées | L'OCR ne peut pas calculer — il lit uniquement ce qui est imprimé | L'IA peut calculer les totaux de lignes, catégoriser les dépenses ou inférer des données non explicitement écrites |
Si votre flux de travail documentaire ne concerne que le premier scénario — des modèles cohérents provenant d'une source unique — l'OCR peut vous convenir. Pour pratiquement tous les autres besoins modernes de traitement de documents, l'extraction IA est le choix pratique.
Le changement : de l'extraction basée sur la position à l'extraction basée sur la sémantique
La confusion entre OCR et extraction IA n'est pas qu'un problème de terminologie. Elle reflète un changement plus profond dans la façon dont fonctionne l'extraction de données documentaires — un passage de l'extraction basée sur la position à l'extraction basée sur la sémantique.
Pendant des décennies, l'extraction de données documentaires a suivi une formule simple : l'OCR extrait tout le texte → un modèle cartographie les positions des champs → le système lit la valeur à chaque coordonnée. C'est le paradigme basé sur la position. Il fonctionne tant que chaque document place ses champs exactement au même endroit.
Le problème, c'est que les documents du monde réel ne fonctionnent pas ainsi. Les fournisseurs utilisent des mises en page de factures différentes. Les relevés bancaires se présentent sous des formats variés. Les bons de commande de différentes entreprises organisent l'information différemment. Dans un système basé sur la position, chaque variation de format exige un nouveau modèle ou un ajustement de règle — c'est pourquoi les flux de travail OCR traditionnels s'effondrent à mesure que la variété des documents augmente.
L'extraction basée sur la sémantique — le paradigme que permet l'extraction IA — inverse la formule. Au lieu de se demander « où se trouvent les données sur la page ? », elle se demande « que signifient les données ? ». Le modèle d'IA lit le document entier comme une scène visuelle unifiée, comprend les relations entre les blocs de texte et identifie chaque donnée par son rôle sémantique — indépendamment de sa position sur la page.
Ce n'est pas une amélioration progressive. C'est une approche différente du problème — une approche qui déplace la charge de l'adaptation de l'utilisateur (créer des modèles) vers la technologie (comprendre les documents).
ImageToTable.ai, par exemple, fonctionne entièrement sur ce paradigme basé sur la sémantique. Vous définissez la sortie — les noms de colonnes souhaités — et l'IA localise les données correspondantes dans toute mise en page de document en comprenant ce que représente chaque champ. C'est ce que la description du produit appelle l'extraction sans modèle et indépendante du format — des capacités tout simplement impossibles avec l'OCR seul, car l'OCR n'a aucun concept de ce que signifient « Nom du fournisseur » ou « Total de la facture ».
Le concept émergent d'OCR agentique représente la prochaine évolution — où l'IA non seulement lit et comprend les documents, mais peut aussi raisonner sur la structure des documents et agir sur les données extraites. Mais le saut fondamental va de la lecture à la compréhension.
Pour une vue d'ensemble plus large de la façon dont toutes ces technologies s'articulent, le guide d'extraction de documents par IA sert de hub pour ce groupe thématique.
Questions fréquemment posées
L'extraction IA utilise-t-elle l'OCR ?
De nombreux systèmes d'extraction IA utilisent l'OCR comme l'un des composants de leur pipeline — généralement comme couche de reconnaissance de texte. Mais la couche IA va bien au-delà de ce que l'OCR peut faire seul en comprenant le sens, le contexte et les relations entre les points de données. Certains modèles vision-langage modernes contournent entièrement l'OCR traditionnel en traitant directement l'image du document.
L'OCR et l'extraction IA peuvent-elles fonctionner ensemble ?
Oui — et dans de nombreux systèmes, c'est le cas. L'OCR gère l'étape de reconnaissance des caractères, convertissant le texte visuel en un format lisible par machine. L'extraction IA interprète ensuite ce texte pour identifier des champs spécifiques, valider les données et structurer la sortie. Ce sont des technologies complémentaires, pas des concurrentes.
L'extraction IA est-elle plus précise que l'OCR ?
Cela dépend de la tâche. Pour la reconnaissance simple de caractères sur des documents propres et standardisés, l'OCR peut atteindre une grande précision. Mais pour extraire des champs de données spécifiques — comme trouver le total d'une facture parmi des dizaines de nombres sur une page — l'extraction IA est nettement plus précise car elle comprend quel nombre est le total en se basant sur le contexte, et non seulement sur la position. Pour les données de tableaux imprimés avec un formatage cohérent, les systèmes modernes basés sur l'IA peuvent atteindre jusqu'à 99 % de précision.
Quels types de documents fonctionnent le mieux avec l'extraction IA ?
L'extraction IA fonctionne bien avec pratiquement tout type de document contenant du texte : factures, reçus, bons de commande, relevés bancaires, contrats, bordereaux d'expédition, feuilles de temps, certificats d'assurance, et plus encore. Elle gère les documents structurés (formulaires avec des mises en page fixes), les documents semi-structurés (factures avec des mises en page variables), et même les documents non structurés (notes manuscrites, rapports d'inspection). L'avantage clé est qu'elle ne nécessite aucun modèle pour aucun d'entre eux.
Ai-je encore besoin de l'OCR si j'utilise l'extraction IA ?
Pas nécessairement — de nombreux outils d'extraction IA modernes gèrent l'ensemble du pipeline, de l'image aux données structurées, sans exposer l'OCR comme une étape séparée. L'IA lit le document directement et génère les champs dont vous avez besoin. Vous n'avez pas besoin d'exécuter l'OCR d'abord, puis d'introduire la sortie dans un outil d'IA. Le système d'extraction IA gère à la fois la lecture et la compréhension en une seule passe.
Qu'est-ce qui coûte le plus cher : l'OCR ou l'extraction IA ?
La comparaison des coûts directs dépend de l'outil spécifique et du volume. Cependant, le coût total de possession favorise souvent l'extraction IA lorsque vous prenez en compte les coûts cachés de l'OCR : création et maintenance de modèles, validation manuelle des champs mal extraits, et gestion des exceptions lorsque les formats changent. Les outils d'extraction IA utilisent généralement un abonnement et éliminent la plupart des frais liés aux modèles. Beaucoup proposent des versions gratuites ou un accès de démonstration pour tester sur vos propres documents.
Voyez la différence sur vos propres documents
La meilleure façon de comprendre l'écart entre l'OCR et l'extraction IA est de le constater sur vos propres documents. Voici une démo en direct — téléversez n'importe quelle facture, reçu ou document et voyez ce qu'un système d'extraction IA produit. Sans modèles. Sans configuration. Il suffit de téléverser et de voir les champs structurés que l'IA identifie.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Téléversez un document et saisissez quelques noms de colonnes — « Numéro de facture », « Total », « Nom du fournisseur », « Date d'échéance » — et regardez l'IA localiser et extraire chaque champ en comprenant ce qu'il signifie, et non où il se trouve sur la page. C'est la différence entre lire des caractères et comprendre un document.
C'est ce qui distingue l'OCR de l'extraction IA : l'OCR lit ce qui est écrit. L'extraction IA sait ce que cela signifie. Et dans un monde où les documents se présentent sous d'innombrables variations, la compréhension compte.