OCR vs extracción con IA:
Entendiendo la diferencia entre leer y comprender
El OCR y la extracción con IA procesan documentos, pero responden preguntas fundamentalmente diferentes: el OCR te dice qué caracteres aparecen en la página, mientras que la extracción con IA te dice qué significan esos caracteres. La confusión entre ambos es comprensible — ambos toman imágenes de documentos y producen salida digital — pero confundirlos es como mezclar una máquina de escribir con un editor. Uno transcribe. El otro interpreta.
Conclusiones clave
- Tu OCR lee cada carácter a la perfección — y te entrega un bloque de texto plano sin etiquetar. Un ERP no puede distinguir el número de factura de la dirección del proveedor, así que alguien sigue abriendo cada archivo y clasificándolos a mano.
- Cada vez que un proveedor cambia el diseño de su factura, creas una nueva plantilla. El costo real no es la plantilla — es que la extracción basada en posición trata cada documento como idéntico, y el mundo nunca te envía documentos idénticos.
- La extracción con IA encuentra "Total de factura" ya sea en la esquina superior derecha de un documento o en la inferior izquierda de otro. No pregunta dónde en la página — pregunta qué significa el dato, como lo haría una persona.
Qué hacen (y qué no hacen) el OCR y la extracción con IA
El reconocimiento óptico de caracteres es una tecnología que convierte imágenes de texto impreso, escrito a mano o mecanografiado en texto legible por máquina. Reconoce caracteres individuales (letras, números, símbolos) comparándolos con patrones conocidos o mediante algoritmos de coincidencia de patrones. El resultado es texto sin formato: una cadena de caracteres que representa lo que estaba impreso físicamente en la página.
La extracción de documentos con IA —a veces llamada procesamiento inteligente de documentos o extracción impulsada por IA— utiliza modelos de visión y lenguaje, procesamiento del lenguaje natural y aprendizaje profundo para comprender el contenido de un documento. No solo lee caracteres; identifica qué significan esos caracteres en su contexto. Un sistema de extracción con IA puede decirte que un número concreto es el total de la factura, que una fecha es la fecha de vencimiento y que un nombre es el proveedor, porque comprende el rol semántico que desempeña cada dato.
La distinción clave: el OCR convierte imágenes en texto. La extracción con IA convierte imágenes en datos estructurados y con significado. Una es una tecnología de transcripción. La otra es una tecnología de comprensión.
Esta diferencia importa porque los sistemas posteriores —hojas de cálculo, software de contabilidad, ERP— no quieren texto sin formato. Quieren campos limpios con un significado conocido: "Número de factura: INV-2026-0891", "Total: $1,234.56", "Fecha de vencimiento: 2026-07-15". El OCR puede darte la primera parte (los caracteres de texto), pero no puede darte la segunda (qué significa cada fragmento de texto).
El mismo documento, dos respuestas diferentes
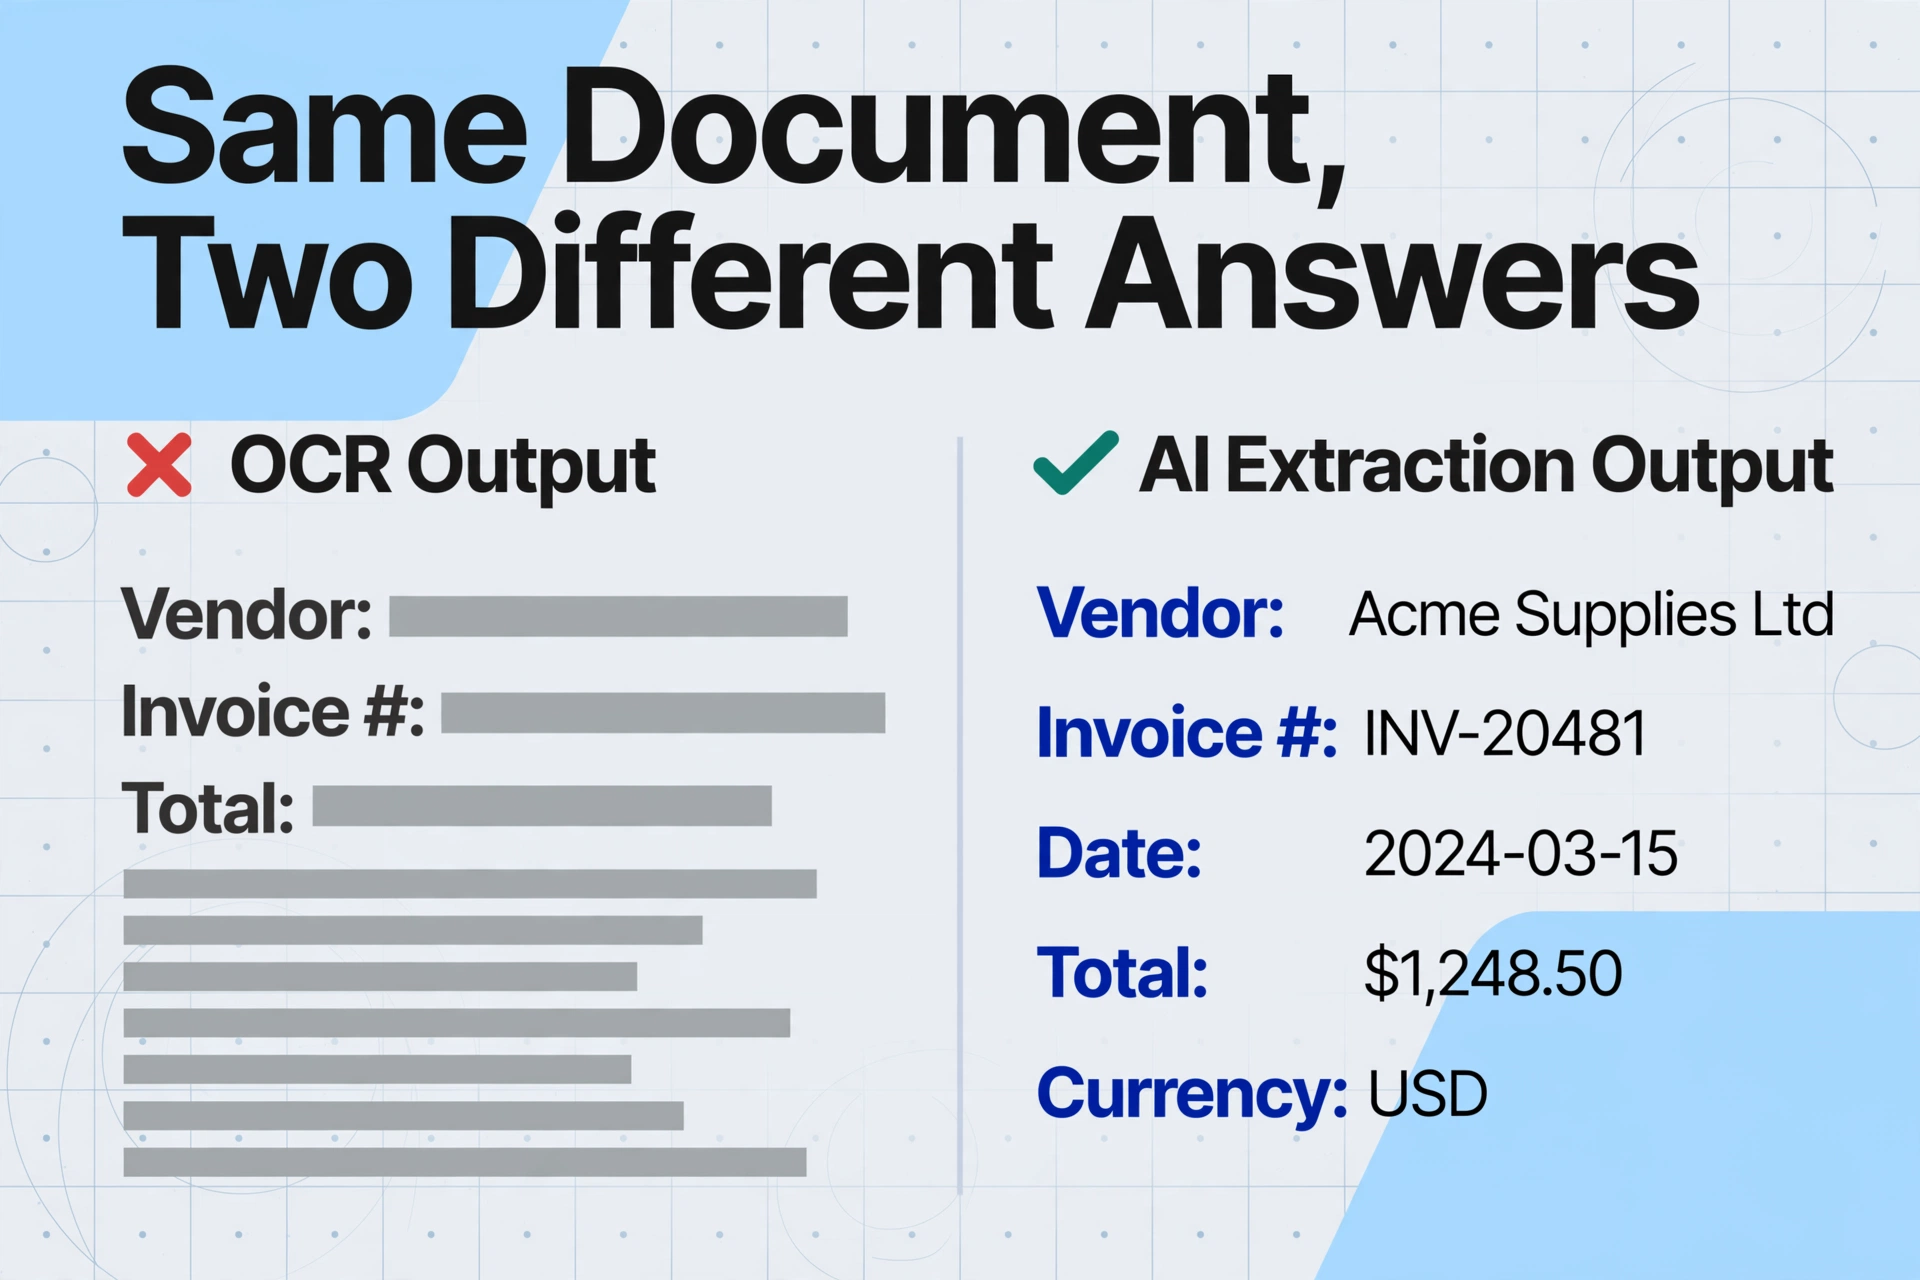
La forma más eficaz de entender la diferencia es ver qué produce cada tecnología cuando se le da el mismo documento. Considera una factura estándar con el siguiente contenido:
Fragmento de factura de ejemplo:
Proveedor: Pacific Maritime Supplies
Factura n.º: INV-2026-0891
Fecha: 06/15/2026
Fecha de vencimiento: 2026-07-15
Descripción: Contenedor de envío de 40 pies – Reacondicionado
Cant.: 2 × Precio unitario: $3,800.00
Subtotal: $7,600.00
Impuesto (8.25%): $627.00
Total de la factura: $8,227.00
Salida del OCR — una sola cadena de caracteres reconocidos, despojada de significado:
El OCR transcribió correctamente cada carácter. Pero la salida es un bloque de texto plano. Para extraer el significado — saber que "INV-2026-0891" es el número de factura y que "$8,227.00" es el total — necesitas que una persona lo lea, o una plantilla que le indique al sistema dónde está cada campo según su posición.
Salida de extracción con IA — datos estructurados con etiquetas semánticas:
| Campo | Valor |
|---|---|
| Nombre del proveedor | Pacific Maritime Supplies |
| Número de factura | INV-2026-0891 |
| Fecha de factura | 2026-06-15 |
| Fecha de vencimiento | 2026-07-15 |
| Descripción de la partida | Contenedor de carga de 40 pies – Reacondicionado |
| Cantidad | 2 |
| Precio unitario | $3,800.00 |
| Subtotal | $7,600.00 |
| Impuestos | $627.00 |
| Total de la factura | $8,227.00 |
La diferencia es evidente. La extracción con IA no solo transcribe el texto — entiende qué representa cada valor y lo organiza en campos etiquetados. El total de la factura no es solo una cadena de caracteres ($8,227.00); es el Total de la factura — un dato semántico que una hoja de cálculo puede sumar, un ERP puede contabilizar y un informe puede analizar.
Esta es la diferencia clave: el OCR te da texto. La extracción con IA te da respuestas.
Mito 1: "El OCR y la extracción con IA son el mismo tipo de tecnología"
Esta es la idea errónea más común — y es comprensible. Tanto el OCR como la extracción con IA reciben imágenes de documentos como entrada y producen datos digitales como salida. Ambos se venden bajo términos de marketing superpuestos como "captura de documentos", "extracción de datos" y "OCR inteligente". Pero la tecnología subyacente es fundamentalmente diferente.
El OCR es una tecnología de coincidencia de patrones. El OCR tradicional funciona comparando las formas de los caracteres con una base de datos interna de glifos conocidos. Se pregunta: "¿Este patrón de píxeles coincide con la letra 'A', el número '8' o el símbolo '$'?" Opera a nivel de carácter — cada glifo se reconoce de forma independiente, sin entender la palabra o frase a la que pertenece. El OCR moderno ha mejorado con el aprendizaje automático, pero su tarea fundamental sigue siendo el reconocimiento de caracteres.
La extracción con IA es una tecnología de comprensión semántica. Utiliza modelos de visión y lenguaje (VLM) que procesan el documento completo como una escena visual — no solo caracteres individuales, sino el diseño, las relaciones espaciales entre bloques de texto, las señales de formato (negrita = encabezado, fuente grande = título) y el significado contextual de cada dato. Se pregunta: "Dado todo lo que hay en esta página, ¿cuál es el número de factura? ¿Cuál es el total? ¿Cuál es el nombre del proveedor?"
Una analogía útil: el OCR es como una persona que puede pronunciar cada palabra de un libro pero no puede decirte de qué trata la historia. La extracción con IA es como un lector que entiende la trama, los personajes y los temas — y puede resumírtelos.
La guía completa sobre qué es el OCR explica esto con más profundidad, incluidas las tres generaciones de tecnología OCR desde 1974 hasta hoy.
Mito 2: "La extracción con IA reemplaza al OCR — solo necesitas uno"
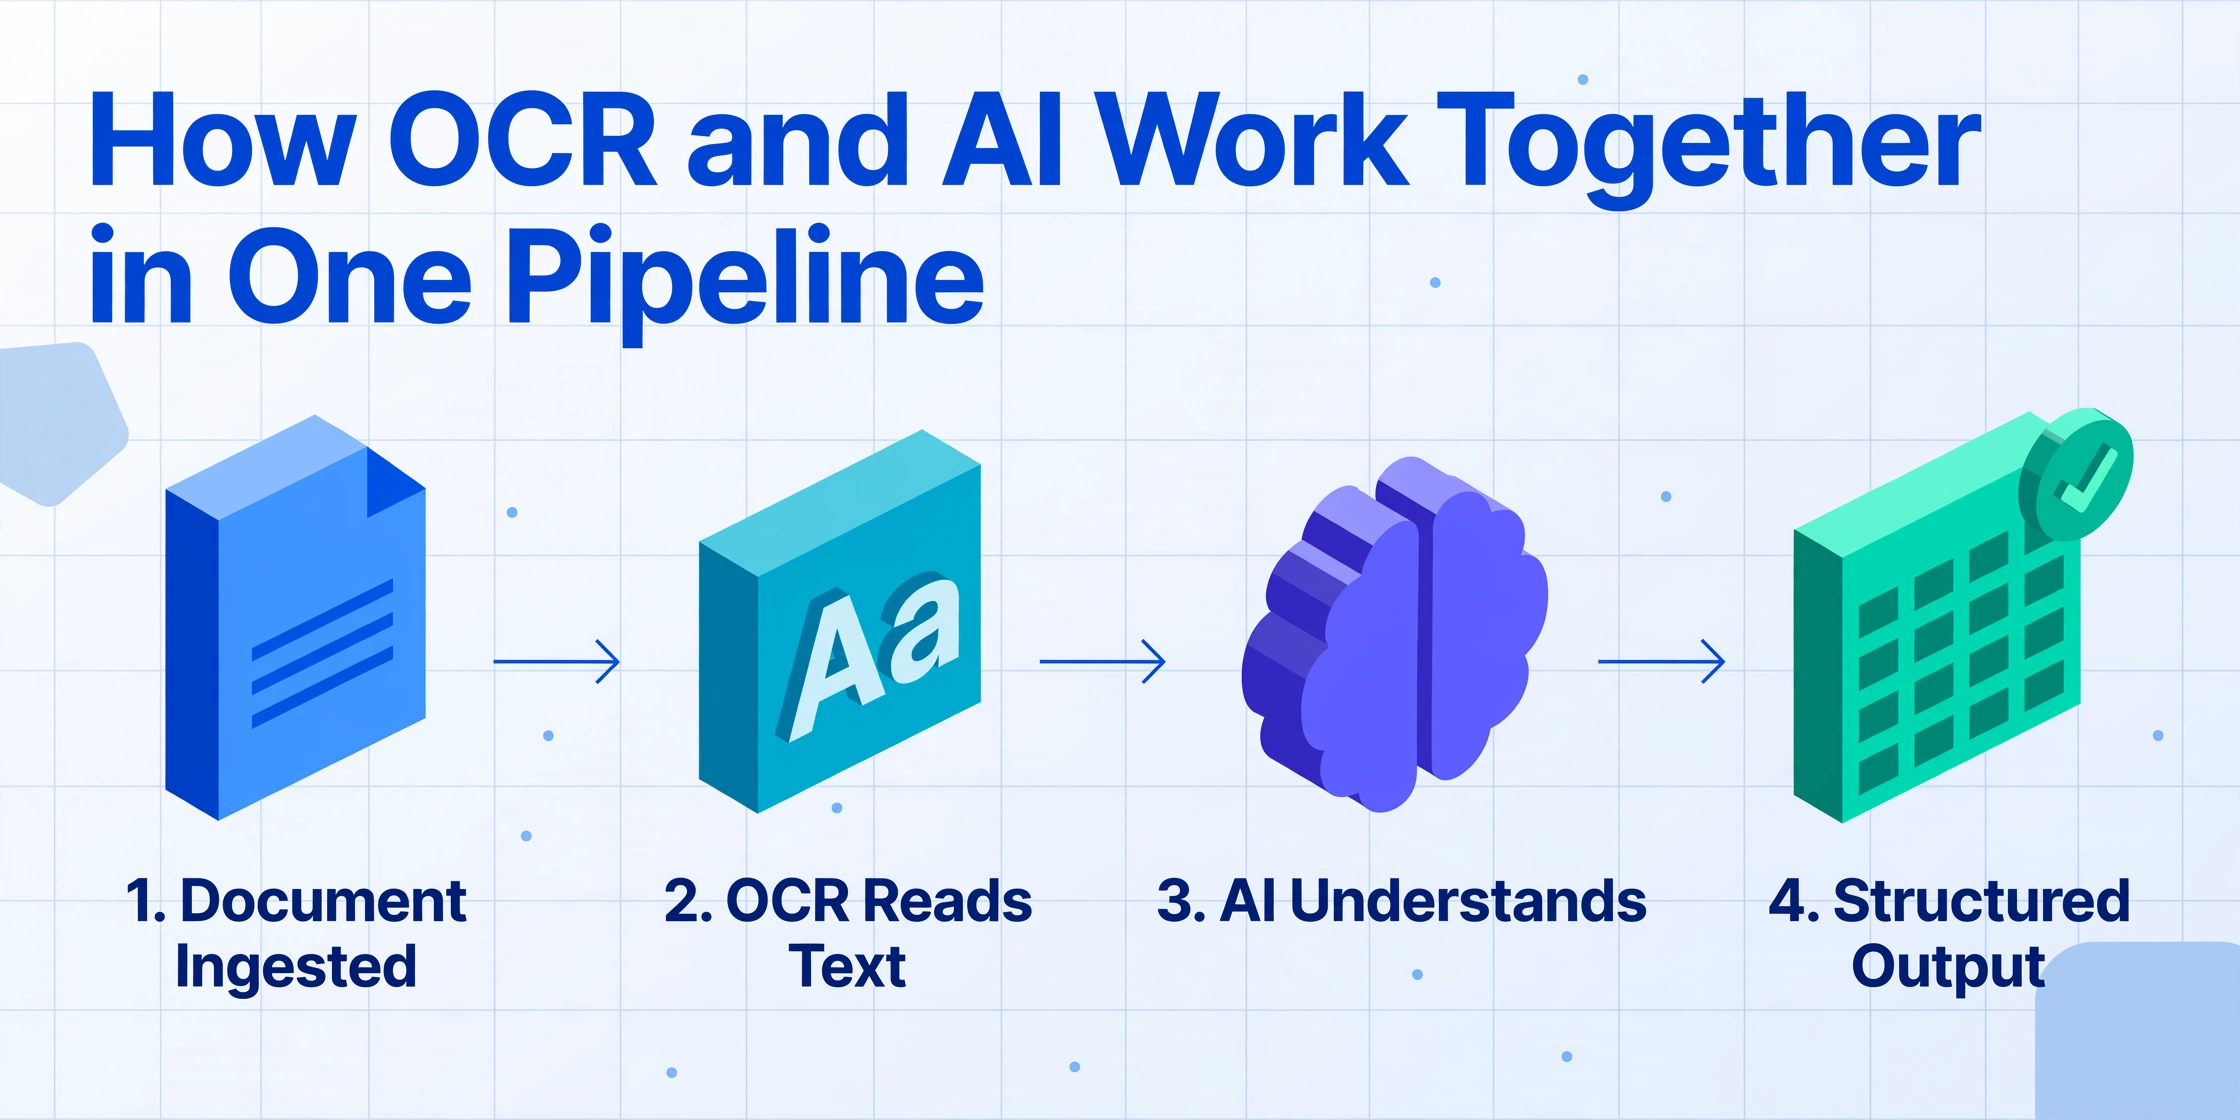
Esta idea errónea lleva a muchas empresas a creer que deben elegir entre las dos tecnologías. La realidad es que operan en diferentes capas de la misma pila, y muchos procesos de extracción con IA usan el OCR como su primer paso.
Piénsalo así: el OCR es la base: convierte el documento visual en texto legible por máquina. La extracción con IA es la capa superior: toma ese texto (o los datos visuales sin procesar) y lo interpreta. Un proceso típico de procesamiento de documentos con IA se ve así:
El PDF, la imagen o la captura de pantalla entran al sistema.
Los caracteres se identifican y se extraen como texto sin formato; aquí es donde el OCR hace su trabajo.
El modelo de IA analiza el diseño del documento, el contexto y las relaciones para identificar qué significa cada dato.
Los datos interpretados se organizan en campos etiquetados y se exportan a una hoja de cálculo, base de datos o API.
En muchos sistemas modernos, las capas de OCR e IA están tan integradas que el usuario nunca ve el límite. Pero conceptualmente, la separación es importante: el OCR proporciona la materia prima. La extracción con IA le da significado.
Esta es también la diferencia clave entre el OCR con IA tradicional — que es esencialmente OCR mejorado con aprendizaje automático para un mejor reconocimiento de caracteres — y la extracción completa de documentos con IA, que comprende la semántica del documento. El artículo sobre qué es el OCR con IA y en qué se diferencia del OCR tradicional explora esta distinción en detalle.
Mito 3: "Si tienes OCR, no necesitas extracción con IA"
Este mito persiste porque el OCR ha sido "suficientemente bueno" para muchas tareas documentales durante años. Y en ciertos escenarios, realmente lo es. Pero esos escenarios se están reduciendo a medida que crece el volumen de documentos y se multiplican los formatos.
Cuando el OCR por sí solo es suficiente
El OCR funciona bien cuando los documentos son estructuralmente consistentes — cada documento sigue la misma plantilla, usa el mismo diseño y coloca la información clave en las mismas posiciones. Algunos ejemplos:
- Digitalizar formularios gubernamentales estandarizados (W-2, 1099) de una sola fuente
- Convertir páginas de libros impresos en texto buscable
- Procesar formularios internos de empresa donde todos los departamentos usan la misma plantilla
- Crear archivos PDF buscables a partir de documentos escaneados donde el objetivo es la búsqueda de texto completo, no la extracción de datos
En estos casos, el OCR más una plantilla (o revisión manual) puede producir resultados utilizables. La variabilidad de los documentos es baja, por lo que la extracción basada en posición funciona.
Cuándo necesitas extracción con IA
La extracción con IA se vuelve esencial cuando existe cualquiera de las siguientes condiciones:
| Condición | Por qué el OCR por sí solo falla | Qué hace la extracción con IA |
|---|---|---|
| Múltiples proveedores o fuentes | Cada proveedor usa un diseño de factura diferente — el OCR basado en plantillas falla con cada cambio de formato | Comprende el significado del campo independientemente de la posición — se adapta automáticamente |
| Contenido manuscrito | El OCR tradicional tiene dificultades con la variabilidad de la escritura a mano | Los modelos de visión y lenguaje interpretan la escritura a mano usando el contexto visual |
| Tipos de documentos mixtos | Cada tipo necesita su propia plantilla — el mantenimiento escala linealmente | Un solo modelo de IA maneja facturas, recibos, órdenes de compra y contratos |
| Necesidad de campos específicos, no de todo el texto | El OCR genera todo — todavía tienes que encontrar los datos que quieres | Tú defines los campos (Número de Factura, Total, Fecha de Vencimiento) — la IA extrae solo lo que pediste |
| Escaneos o fotos de mala calidad | Las imágenes borrosas, los ángulos sesgados y el bajo contraste degradan la precisión | Los VLM manejan mejor la degradación — procesan la imagen como una escena visual, no solo como formas de caracteres |
| Necesidad de datos calculados o inferidos | El OCR no puede calcular — solo lee lo que está impreso | La IA puede calcular totales de línea, categorizar gastos o inferir datos que no están escritos explícitamente |
Si tu flujo de trabajo documental solo implica el primer escenario — plantillas consistentes de una sola fuente — el OCR puede servirte bien. Para prácticamente cualquier otra necesidad moderna de procesamiento de documentos, la extracción con IA es la opción práctica.
El cambio: de la extracción basada en posición a la extracción basada en semántica
La confusión entre OCR y extracción con IA no es solo un problema de terminología. Refleja un cambio más profundo en cómo funciona la extracción de datos de documentos: un cambio de la extracción basada en posición a la extracción basada en semántica.
Durante décadas, la extracción de datos de documentos siguió una fórmula simple: el OCR extrae todo el texto → una plantilla mapea las posiciones de los campos → el sistema lee el valor en cada coordenada. Este es el paradigma basado en posición. Funciona siempre que cada documento coloque sus campos exactamente en la misma ubicación.
El problema es que los documentos del mundo real no funcionan así. Los proveedores usan diferentes diseños de facturas. Los extractos bancarios vienen en formatos variados. Las órdenes de compra de diferentes empresas organizan la información de manera distinta. En un sistema basado en posición, cada variación de formato requiere una plantilla nueva o un ajuste de regla, por eso los flujos de trabajo tradicionales de OCR se desmoronan a medida que crece la variedad de documentos.
La extracción basada en semántica — el paradigma que habilita la extracción con IA — invierte la fórmula. En lugar de preguntar "¿dónde están los datos en la página?", pregunta "¿qué significan los datos?". El modelo de IA lee el documento completo como una escena visual unificada, comprende las relaciones entre los bloques de texto e identifica cada dato por su rol semántico, sin importar dónde se encuentre en la página.
Esto no es una mejora incremental. Es un enfoque diferente al problema: uno que traslada la carga de la adaptación del usuario (crear plantillas) a la tecnología (comprender documentos).
ImageToTable.ai, por ejemplo, opera completamente bajo este paradigma basado en semántica. Tú defines la salida — los nombres de columna que quieres — y la IA localiza los datos correspondientes en cualquier diseño de documento al comprender qué representa cada campo. Esto es lo que la descripción del producto llama extracción sin plantilla e independiente del formato — capacidades que son simplemente imposibles con OCR solo, porque el OCR no tiene concepto de lo que significa un "Nombre de proveedor" o un "Total de factura".
El concepto emergente de OCR agéntico representa la siguiente evolución: donde la IA no solo lee y comprende documentos, sino que también puede razonar sobre la estructura del documento y actuar sobre los datos extraídos. Pero el salto fundamental es de leer a comprender.
Para una visión general más amplia de cómo encajan todas estas tecnologías, la guía de extracción de documentos con IA sirve como el centro de este grupo temático.
Preguntas Frecuentes
¿La extracción con IA usa OCR?
Muchos sistemas de extracción con IA usan OCR como un componente de su proceso, normalmente como la capa de reconocimiento de texto. Pero la capa de IA va mucho más allá de lo que el OCR puede hacer por sí solo, ya que comprende el significado, el contexto y las relaciones entre los datos. Algunos modelos modernos de visión y lenguaje omiten el OCR tradicional por completo al procesar la imagen del documento directamente.
¿Pueden trabajar juntos el OCR y la extracción con IA?
Sí, y en muchos sistemas lo hacen. El OCR se encarga del paso de reconocimiento de caracteres, convirtiendo el texto visual en un formato legible por máquina. Luego, la extracción con IA interpreta ese texto para identificar campos específicos, validar datos y estructurar la salida. Son tecnologías complementarias, no competidoras.
¿La extracción con IA es más precisa que el OCR?
Depende de la tarea. Para el reconocimiento simple de caracteres en documentos limpios y estandarizados, el OCR puede lograr una alta precisión. Pero para extraer campos de datos específicos — como encontrar el total de una factura entre docenas de números en una página — la extracción con IA es significativamente más precisa porque entiende qué número es el total según el contexto, no solo la posición. Para datos tabulares impresos con formato consistente, los sistemas modernos impulsados por IA pueden alcanzar hasta un 99% de precisión.
¿Qué tipos de documentos funcionan mejor con la extracción con IA?
La extracción con IA funciona bien con prácticamente cualquier tipo de documento que tenga contenido de texto: facturas, recibos, órdenes de compra, estados de cuenta bancarios, contratos, albaranes, hojas de tiempo, certificados de seguro y más. Maneja documentos estructurados (formularios con diseños fijos), documentos semiestructurados (facturas con diseños variables) e incluso documentos no estructurados (notas manuscritas, informes de inspección). La ventaja clave es que no requiere plantillas para ninguno de ellos.
¿Todavía necesito OCR si uso extracción con IA?
No necesariamente: muchas herramientas modernas de extracción con IA manejan todo el proceso, desde la imagen hasta los datos estructurados, sin exponer el OCR como un paso separado. La IA lee el documento directamente y genera los campos que necesitas. No necesitas ejecutar OCR primero y luego alimentar la salida en una herramienta de IA. El sistema de extracción con IA maneja tanto la lectura como la comprensión en una sola pasada.
¿Qué es más caro: el OCR o la extracción con IA?
La comparación de costos directos depende de la herramienta específica y del volumen. Sin embargo, el costo total de propiedad suele favorecer a la extracción con IA si se tienen en cuenta los costos ocultos del OCR: creación y mantenimiento de plantillas, validación manual de campos mal extraídos y gestión de excepciones cuando cambian los formatos. Las herramientas de extracción con IA suelen usar precios por suscripción y eliminan la mayor parte de los gastos generales relacionados con plantillas. Muchas ofrecen niveles gratuitos o acceso de demostración para probarlas con tus propios documentos.
Ve la Diferencia en Tus Propios Documentos
La mejor manera de entender la brecha entre OCR y la extracción con IA es verla con tus propios documentos. Lo que sigue es una demostración en vivo: sube cualquier factura, recibo o documento y observa lo que produce un sistema de extracción con IA. Sin plantillas. Sin configuración. Solo sube y observa los campos estructurados que la IA identifica.
Los archivos se procesan de forma segura y no se almacenan.
Sube un documento y escribe algunos nombres de columnas — "Número de Factura", "Total", "Nombre del Proveedor", "Fecha de Vencimiento" — y observa cómo la IA localiza y extrae cada campo al entender lo que significa, no dónde se encuentra en la página. Esa es la diferencia entre leer caracteres y entender un documento.
Esto es lo que separa al OCR de la extracción con IA: el OCR lee lo que está escrito. La extracción con IA sabe lo que significa. Y en un mundo donde los documentos vienen en infinitas variaciones, entender importa.