OCRとAI抽出:
読み取りと理解の違いを理解する
OCRとAI抽出はどちらもドキュメントを処理しますが、根本的に異なる質問に答えます。OCRはページにどの文字が表示されているかを示し、AI抽出はそれらの文字が何を意味するかを示します。両者の混同は理解できます。どちらもドキュメント画像を受け取り、デジタル出力を生成します。しかし、両者を同一視することは、タイプライターと編集者を混同するようなものです。一方は転写し、もう一方は解釈します。
重要なポイント
- OCRはすべての文字を完璧に読み取りますが、ラベルのないテキストの塊を1つ渡すだけです。ERPは請求書番号と仕入先住所を区別できないため、誰かが各ファイルを開いて手作業で分類する必要があります。
- ベンダーが請求書のレイアウトを変更するたびに、新しいテンプレートを作成する必要があります。本当のコストはテンプレート自体ではなく、位置ベース抽出がすべてのドキュメントを同一として扱うことです。しかし、現実の世界が同一のドキュメントを送ってくることはありません。
- AI抽出は、あるドキュメントの右上隅にある「請求書合計」も、別のドキュメントの左下隅にある「請求書合計」も見つけ出します。ページ上のどこにあるかではなく、データが何を意味するかを、人間と同じように問いかけます。
OCRとAI抽出が実際にやること(やらないこと)
光学文字認識(OCR)は、タイプされた文字、手書き文字、印刷された文字の画像を機械読み取り可能なテキストに変換する技術です。既知のパターンと比較したり、パターンマッチングアルゴリズムを使用したりして、個々の文字(文字、数字、記号)を認識します。出力は生テキスト、つまりページに物理的に印刷された内容を表す文字列です。
AIドキュメント抽出は、インテリジェントドキュメント処理やAI搭載抽出と呼ばれることもあり、ビジョン言語モデル、自然言語処理、ディープラーニングを使用して文書の内容を理解します。単に文字を読むだけでなく、その文字が文脈上何を意味するかを識別します。AI抽出システムは、特定の数字が請求書の合計であること、日付が支払期日であること、名前がベンダーであることを教えてくれます。これは、各情報が果たす意味役割を理解しているからです。
核心的な違い:OCRは画像をテキストに変換します。AI抽出は画像を構造化された意味のあるデータに変換します。一方は転写技術です。もう一方は理解技術です。
この違いが重要なのは、下流システム(スプレッドシート、会計ソフト、ERP)は生テキストを必要としないからです。それらが求めるのは意味が明確なクリーンなフィールドです。「請求書番号:INV-2026-0891」「合計:$1,234.56」「支払期日:2026-07-15」。OCRは最初の部分(テキスト文字)を提供できますが、2番目の部分(各テキストが意味するもの)は提供できません。
同じ文書、2つの異なる答え
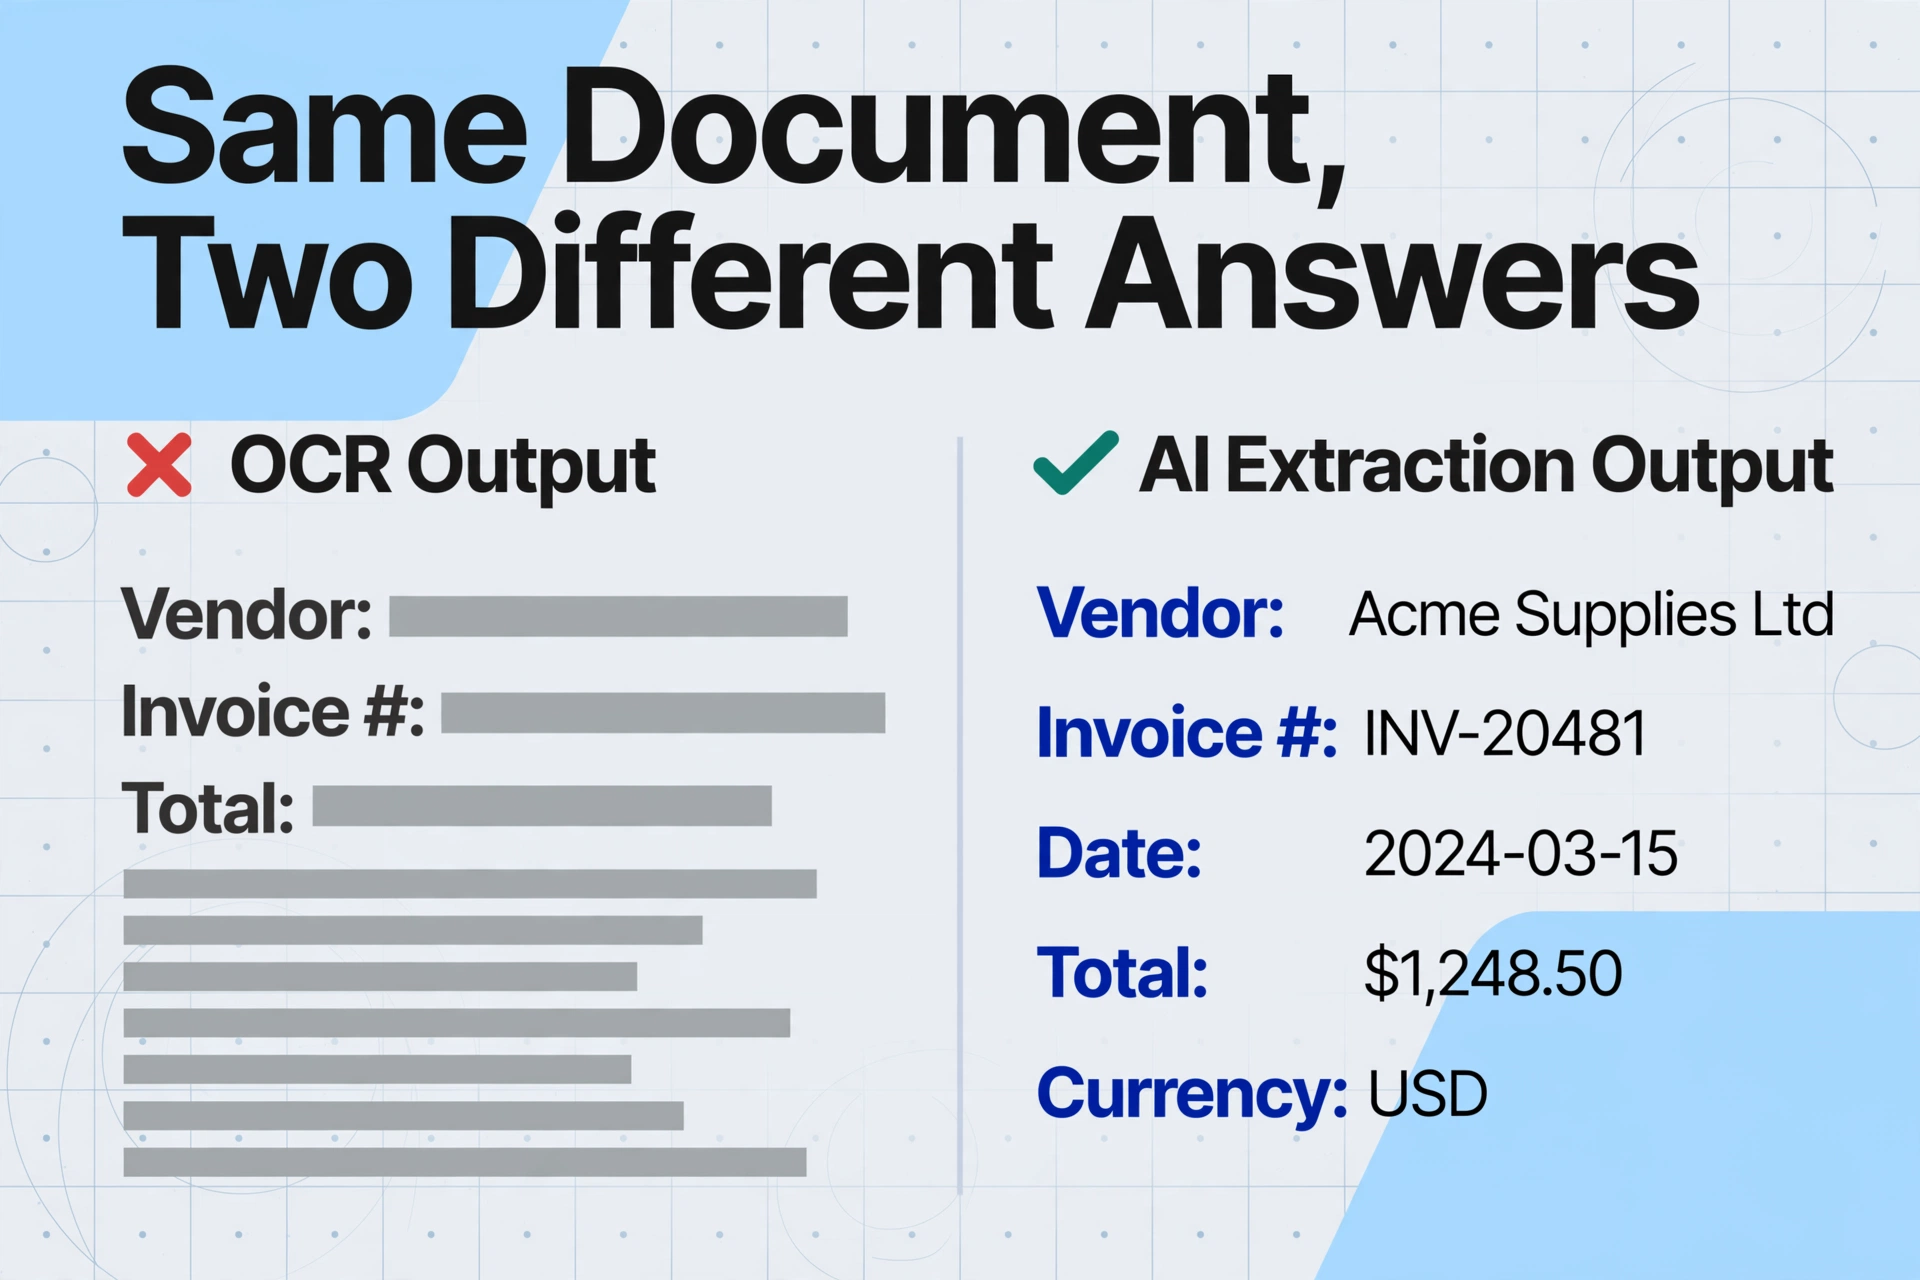
この違いを理解する最も効果的な方法は、同じ文書を与えたときに各技術が実際に何を出力するかを見ることです。以下の内容を含む標準的な請求書を考えてみましょう:
サンプル請求書の抜粋:
ベンダー:Pacific Maritime Supplies
請求書番号:INV-2026-0891
日付:06/15/2026
支払期日:2026-07-15
説明:40ft輸送用コンテナ – 再生品
数量:2 × 単価:$3,800.00
小計:$7,600.00
税(8.25%):$627.00
請求書合計:$8,227.00
OCR出力 — 意味が取り除かれた、認識された文字の単一の文字列:
OCRはすべての文字を正確に読み取りました。しかし、出力はフラットなテキストの塊です。意味を抽出するには—「INV-2026-0891」が請求書番号で「$8,227.00」が合計金額だと理解するには—人間が読むか、各フィールドの位置をシステムに教えるテンプレートが必要です。
AI抽出の出力 — 意味ラベル付きの構造化データ:
| フィールド | 値 |
|---|---|
| 仕入先名 | Pacific Maritime Supplies |
| 請求書番号 | INV-2026-0891 |
| 請求日 | 2026-06-15 |
| 支払期日 | 2026-07-15 |
| 明細項目の説明 | 40ft Shipping Container – Refurbished |
| 数量 | 2 |
| 単価 | $3,800.00 |
| 小計 | $7,600.00 |
| 税額 | $627.00 |
| 請求書合計 | $8,227.00 |
その違いは歴然としています。AI抽出はテキストを書き写すだけでなく、各値が何を表すかを理解し、ラベル付きフィールドに整理します。請求書の合計金額は単なる文字列($8,227.00)ではなく、請求書合計—スプレッドシートで合計でき、ERPで転記でき、レポートで分析できる意味のあるデータポイントです。
これが決定的な違いです:OCRはテキストを提供します。AI抽出は答えを提供します。
誤解1:「OCRとAI抽出は同じ種類の技術である」
これは最も一般的な誤解です—そして無理もありません。OCRもAI抽出も、ドキュメント画像を入力として受け取り、デジタルデータを出力として生成します。どちらも「ドキュメントキャプチャ」「データ抽出」「インテリジェントOCR」といった重複するマーケティング用語で販売されています。しかし、基盤となる技術は根本的に異なります。
OCRはパターンマッチング技術です。従来のOCRは、既知のグリフの内部データベースと文字の形状を比較することで機能します。「このピクセルパターンは文字の'A'、数字の'8'、または記号の'$'に一致するか?」と問いかけます。これは文字レベルで動作します—各グリフは独立して認識され、それが属する単語やフレーズの理解はありません。現代のOCRは機械学習によって改善されていますが、その基本的なタスクは文字認識のままです。
AI抽出は意味理解技術です。ビジョン言語モデル(VLM)を使用して、ドキュメント全体を視覚的なシーンとして処理します—個々の文字だけでなく、レイアウト、テキストブロック間の空間的関係、書式の手がかり(太字=見出し、大きなフォント=タイトル)、各データポイントの文脈上の意味も考慮します。「このページのすべてを考慮して、請求書番号は何か?合計金額は何か?仕入先名は何か?」と問いかけます。
わかりやすい例え:OCRは、本のすべての単語を音読できるが、物語の内容を説明できない人のようなものです。AI抽出は、プロット、登場人物、テーマを理解し、それらを要約できる読者のようなものです。
OCRとは何かに関する完全ガイドでは、1974年から現在までのOCR技術の3世代を含め、この点をさらに詳しく説明しています。
誤解2:「AI抽出がOCRを置き換える——1つあれば十分」
この誤解により、多くの企業が2つの技術のどちらかを選ばなければならないと考えてしまいます。実際には、これらは同じスタックの異なるレイヤーで動作しており、多くのAI抽出パイプラインは最初のステップとしてOCRを利用しています。
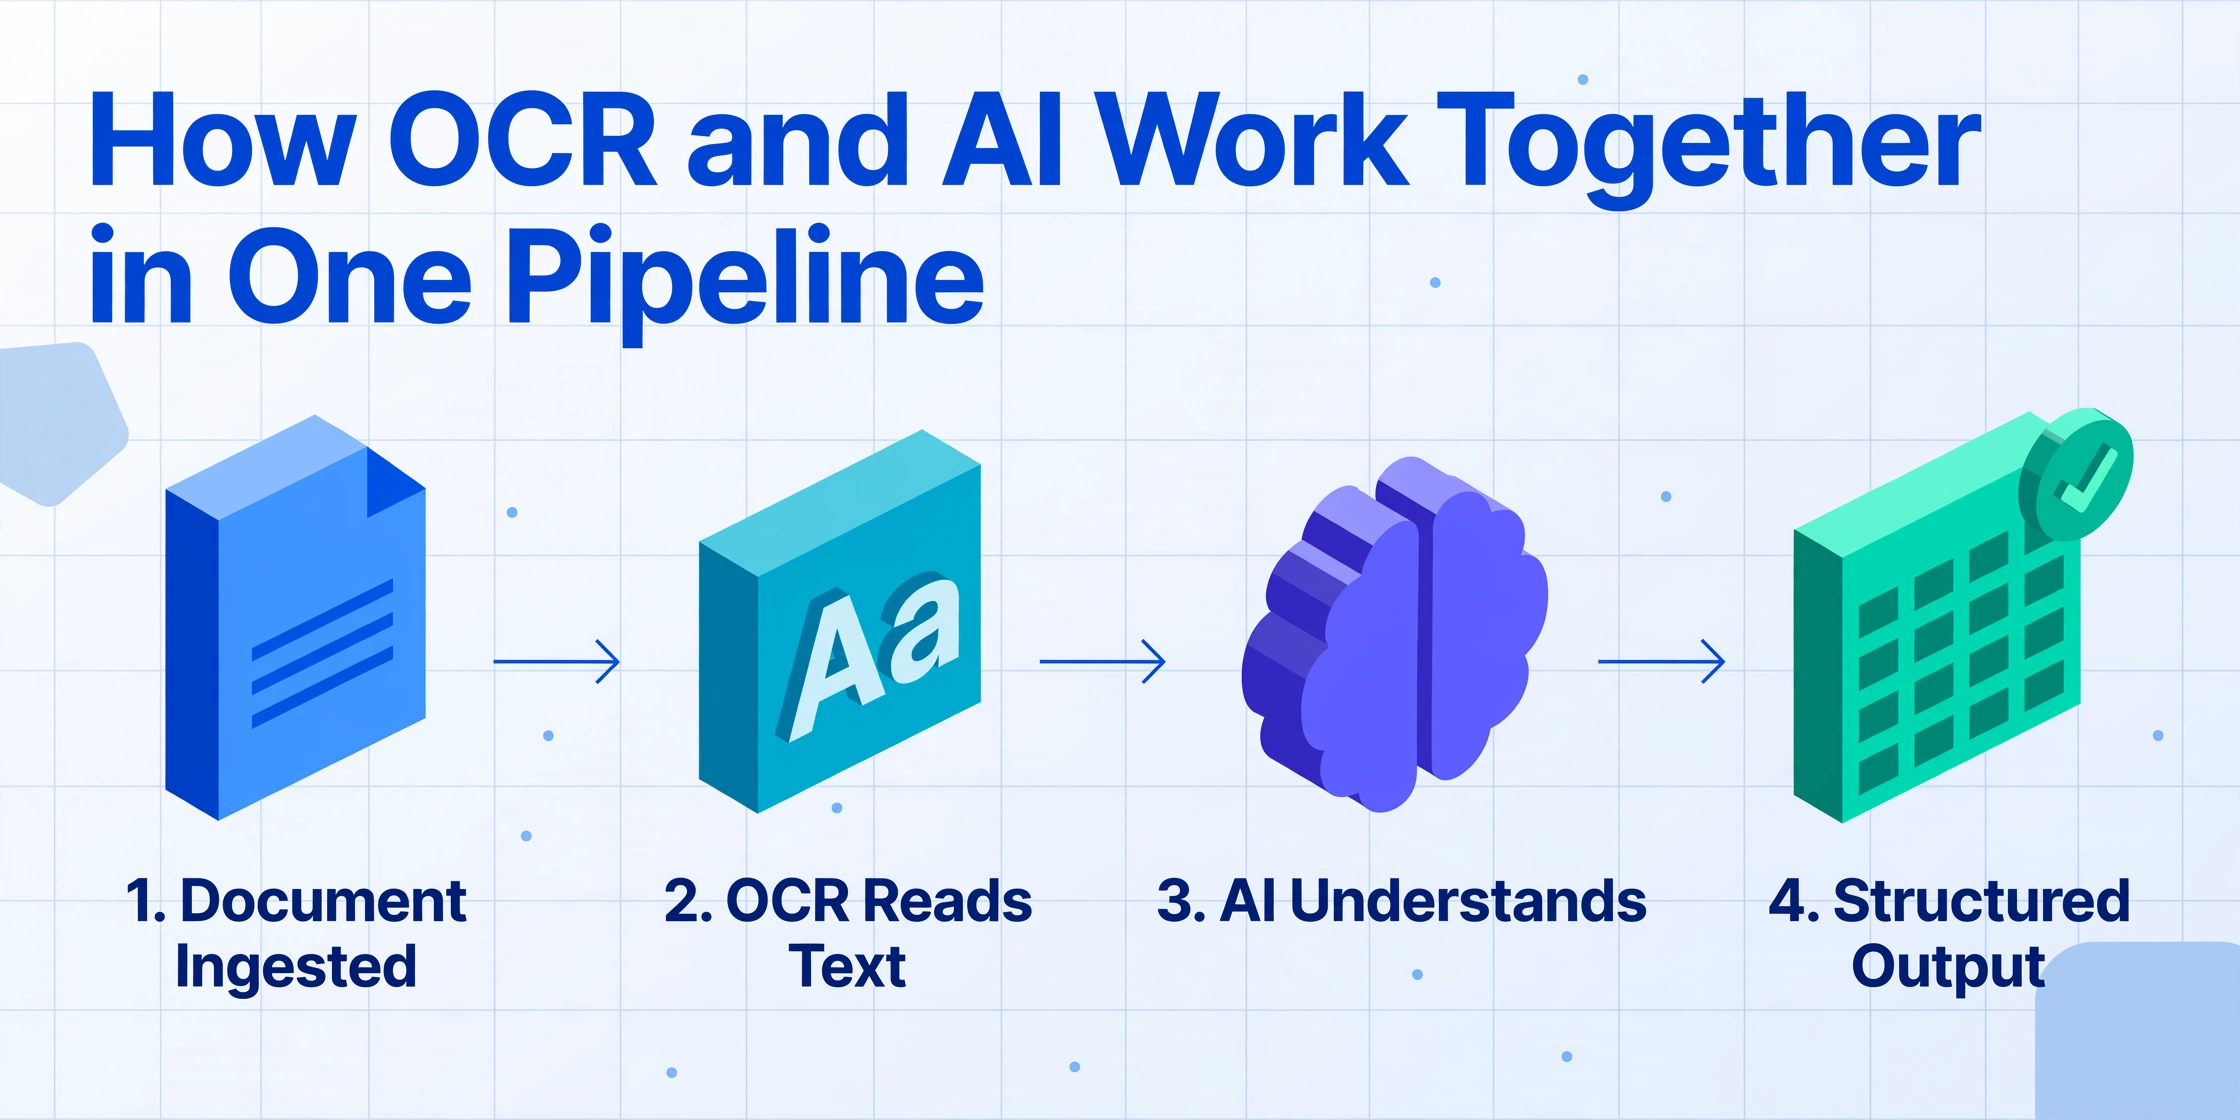
次のように考えてみてください。OCRは基盤であり、視覚的なドキュメントを機械可読なテキストに変換します。AI抽出はその上に重なるレイヤーであり、そのテキスト(または生の視覚データ)を受け取って解釈します。典型的なAIドキュメント処理パイプラインは次のようになります:
PDF、画像、スクリーンショットがシステムに入力されます。
文字が識別され、生テキストとして抽出されます。ここでOCRがその役割を果たします。
AIモデルがドキュメントのレイアウト、文脈、関連性を分析し、各データが何を意味するかを特定します。
解釈されたデータがラベル付きフィールドに整理され、スプレッドシート、データベース、またはAPIにエクスポートされます。
多くの最新システムでは、OCRとAIのレイヤーが緊密に統合されているため、ユーザーがその境界を意識することはありません。しかし概念上、この分離は重要です:OCRが生の材料を提供し、AI抽出がそれに意味を与えます。
これはまた、従来のAI OCR(基本的には文字認識を向上させるために機械学習を組み合わせたOCR)と、ドキュメントの意味を理解する本格的なAIドキュメント抽出との重要な違いでもあります。AI OCRとは何か、従来のOCRとどう違うのかに関する記事では、この違いを詳しく解説しています。
誤解3:「OCRがあれば、AI抽出は不要」
この誤解が根強いのは、OCRが長年にわたり多くの文書タスクで「十分」だったからです。そして、特定のシナリオでは、実際に十分な場合もあります。しかし、文書量が増え、フォーマットが多様化するにつれて、そのようなシナリオは狭まっています。
OCRだけで十分な場合
OCRは、文書が構造的に一貫している場合にうまく機能します。つまり、すべての文書が同じテンプレートに従い、同じレイアウトを使用し、重要な情報が同じ位置にある場合です。例としては、次のようなものがあります。
- 単一の供給元からの標準化された政府フォーム(W-2、1099)のデジタル化
- 印刷された本のページを検索可能なテキストに変換する
- 全部門が同じテンプレートを使用する社内フォームの処理
- スキャン文書から検索可能なPDFアーカイブを作成する場合(目的がデータ抽出ではなく全文検索の場合)
これらの場合、OCRとテンプレート(または手動レビュー)を組み合わせることで、実用的な結果を得られます。文書のばらつきが少ないため、位置ベース抽出が機能します。
AI抽出が必要な場合
以下のいずれかの条件に該当する場合、AI抽出が不可欠になります。
| 条件 | OCRだけでは失敗する理由 | AI抽出が行うこと |
|---|---|---|
| 複数のベンダーまたは供給元 | ベンダーごとに請求書レイアウトが異なるため、テンプレートベースOCRはフォーマット変更のたびに機能しなくなります | 位置に関係なくフィールドの意味を理解し、自動的に適応します |
| 手書きコンテンツ | 従来のOCRは手書きのばらつきに対応するのが困難です | ビジョン言語モデルが視覚的な文脈を使用して手書きを解釈します |
| 混在する文書タイプ | タイプごとに専用のテンプレートが必要で、メンテナンスが直線的に増加します | 単一のAIモデルで、請求書、領収書、発注書、契約書を処理できます |
| すべてのテキストではなく、特定のフィールドが必要 | OCRはすべてを出力するため、必要なデータを探す作業が別途発生します | フィールド(請求書番号、合計金額、支払期日)を定義すると、AIは要求した項目のみを抽出します |
| 品質の低いスキャンや写真 | ぼやけた画像、傾いた角度、低コントラストは精度を低下させます | VLMは画質低下への対応に優れており、文字の形としてだけでなく、視覚的なシーンとして画像を処理します |
| 計算列や推論列のデータが必要 | OCRは計算ができず、印刷された内容を読み取るだけです | AIは明細行の合計を計算したり、経費を分類したり、明示的に書かれていないデータを推論したりできます |
文書ワークフローが最初のシナリオ(単一ソースからの一貫したテンプレート)のみに該当する場合は、OCRで十分かもしれません。しかし、現代の文書処理ニーズのほぼすべてにおいて、AI抽出が実用的な選択肢となります。
転換:位置ベース抽出から意味ベース抽出へ
OCRとAI抽出の混同は、単なる用語の問題ではありません。これは、ドキュメントデータ抽出の仕組みにおけるより深い転換を反映しています——位置ベース抽出から意味ベース抽出への転換です。
何十年もの間、ドキュメントデータ抽出は単純な方式に従っていました:OCRがすべてのテキストを抽出 → テンプレートがフィールドの位置をマッピング → システムが各座標の値を読み取る。これが位置ベースのパラダイムです。すべてのドキュメントがフィールドをまったく同じ場所に配置している限り、機能します。
問題は、実際のドキュメントがそのようには機能しないことです。ベンダーによって請求書のレイアウトは異なります。銀行明細書はさまざまな形式で提供されます。異なる会社からの発注書は情報の配置が異なります。位置ベースのシステムでは、形式が変わるたびに新しいテンプレートやルールの調整が必要になります——そのため、従来のOCRワークフローはドキュメントの多様性が増すにつれて機能しなくなります。
意味ベース抽出——AI抽出が可能にするパラダイム——は、この方式を逆転させます。「ページ上のデータはどこにあるか?」と問う代わりに、「データは何を意味するか?」と問います。AIモデルはドキュメント全体を統一された視覚シーンとして読み取り、テキストブロック間の関係を理解し、各データポイントをその意味役割によって識別します——ページ上の位置に関係なく。
これは漸進的な改善ではありません。問題への異なるアプローチです——適応の負担をユーザー(テンプレート作成)からテクノロジー(ドキュメント理解)へ移すものです。
例えば、ImageToTable.aiは、この意味ベースのパラダイムに完全に基づいて動作します。出力——希望する列名——を定義すると、AIは各フィールドが何を表すかを理解することで、あらゆるドキュメントレイアウト内の対応するデータを特定します。これが製品説明でテンプレート不要およびフォーマット非依存抽出と呼ばれるものです——これらの機能はOCR単独では不可能です。なぜなら、OCRには「仕入先名」や「請求書合計」が何を意味するかという概念がないからです。
新たに登場しつつあるエージェント型OCRの概念は、次の進化を表しています——AIがドキュメントを読み取り理解するだけでなく、ドキュメント構造について推論し、抽出したデータに基づいて行動できるようになるものです。しかし、基盤となる飛躍は「読むこと」から「理解すること」への移行です。
これらのテクノロジーがどのように連携するかについてのより広範な概要については、AIドキュメント抽出ガイドがこのトピッククラスターのハブとして機能します。
よくある質問
AI抽出はOCRを使用しますか?
多くのAI抽出システムは、パイプラインの一部としてOCRを使用しています。通常はテキスト認識レイヤーとしてです。しかし、AIレイヤーは、データポイント間の意味、文脈、関係性を理解することで、OCR単独ではできないはるかに高度な処理を行います。一部の最新のビジョン言語モデルは、文書画像を直接処理することで、従来のOCRを完全に回避しています。
OCRとAI抽出は連携できますか?
はい、多くのシステムで連携しています。OCRは文字認識のステップを担当し、視覚的なテキストを機械可読な形式に変換します。その後、AI抽出がそのテキストを解釈して、特定のフィールドを識別し、データを検証し、出力を構造化します。これらは競合する技術ではなく、補完し合う技術です。
AI抽出はOCRよりも正確ですか?
タスクによります。クリーンで標準化された文書の単純な文字認識では、OCRでも高い精度を達成できます。しかし、特定のデータフィールドの抽出(ページ上の多数の数字の中から請求書の合計額を見つけるなど)では、AI抽出の方がはるかに正確です。位置だけでなく文脈に基づいてどの数字が合計かを理解できるからです。フォーマットが一貫した印刷された表データの場合、最新のAI搭載システムは最大99%の精度を達成できます。
AI抽出に最適な文書の種類は何ですか?
AI抽出は、テキストコンテンツを含むほぼすべての文書タイプで優れた性能を発揮します。請求書、領収書、発注書、銀行明細書、契約書、納品書、タイムシート、保険証書などです。構造化文書(固定レイアウトのフォーム)、半構造化文書(レイアウトが異なる請求書)、さらには非構造化文書(手書きメモ、検査レポート)も処理できます。主な利点は、これらのいずれにもテンプレートが不要なことです。
AI抽出を使用する場合、OCRはまだ必要ですか?
必ずしも必要ではありません。最新のAI抽出ツールの多くは、画像から構造化データまでのパイプライン全体を処理し、OCRを別のステップとして公開していません。AIが文書を直接読み取り、必要なフィールドを出力します。OCRを先に実行してから、その出力をAIツールに渡す必要はありません。AI抽出システムは、読み取りと理解の両方を1回のパスで処理します。
OCRとAI抽出、どちらが高コストですか?
直接的なコスト比較は、使用するツールと処理量によって異なります。ただし、総所有コスト(TCO)の観点では、OCRに隠れたコスト(テンプレートの作成・保守、誤抽出フィールドの手動検証、フォーマット変更時の例外対応)を考慮すると、AI抽出が有利になることが多いです。AI抽出ツールは通常サブスクリプション料金で提供され、テンプレート関連のオーバーヘッドの多くを排除します。多くのツールでは、自社の文書でテストできる無料トライアルやデモアクセスを提供しています。
ご自身のドキュメントで違いを実感してください
OCRとAI抽出の違いを理解する最良の方法は、ご自身のドキュメントで実際に確認することです。以下はライブデモです。請求書、領収書、または任意のドキュメントをアップロードして、AI抽出システムが生成する結果をご覧ください。テンプレート不要、設定不要。アップロードするだけで、AIが識別した構造化フィールドを確認できます。
ファイルは安全に処理され、保存されることはありません。
ドキュメントをアップロードし、「請求書番号」「合計」「仕入先名」「支払期日」などの列名をいくつか入力すると、AIがページ上の位置ではなく意味を理解して各フィールドを特定し抽出する様子をご覧いただけます。これが文字を読むこととドキュメントを理解することの違いです。
これがOCRとAI抽出を分ける点です。OCRは書かれた内容を読み取ります。AI抽出はその意味を理解します。そして、無限のバリエーションで届くドキュメントが存在する世界では、理解することが重要です。