OCR vs. KI-Extraktion:
Den Unterschied zwischen Lesen und Verstehen erkennen
OCR und KI-Extraktion verarbeiten beide Dokumente, beantworten aber grundlegend unterschiedliche Fragen: OCR sagt Ihnen, welche Zeichen auf der Seite erscheinen, während die KI-Extraktion sagt, was diese Zeichen bedeuten. Die Verwechslung der beiden ist verständlich – beide nehmen Dokumentbilder auf und erzeugen eine digitale Ausgabe –, aber sie gleichzusetzen ist, als würde man eine Schreibmaschine mit einem Redakteur verwechseln. Der eine transkribiert. Der andere interpretiert.
Die wichtigsten Erkenntnisse
- Ihr OCR liest jedes Zeichen fehlerfrei – und liefert Ihnen einen einzigen unbeschrifteten Textblock. Ein ERP kann die Rechnungsnummer nicht von der Lieferantenadresse unterscheiden, also öffnet trotzdem jemand jede Datei und sortiert sie von Hand.
- Jedes Mal, wenn ein Lieferant sein Rechnungslayout ändert, erstellen Sie eine neue Vorlage. Die eigentlichen Kosten sind nicht die Vorlage – sondern dass die positionsbasierte Extraktion jedes Dokument als identisch behandelt, und die Welt Ihnen nie identische Dokumente schickt.
- Die KI-Extraktion findet den „Rechnungsbetrag", egal ob er in der oberen rechten Ecke des einen Dokuments oder in der unteren linken Ecke eines anderen steht. Sie fragt nicht wo auf der Seite – sie fragt was die Daten bedeuten, so wie es ein Mensch tun würde.
Was OCR und KI-Extraktion tatsächlich leisten (und was nicht)
Optische Zeichenerkennung (OCR) ist eine Technologie, die Bilder von getipptem, handgeschriebenem oder gedrucktem Text in maschinenlesbaren Text umwandelt. Sie erkennt einzelne Zeichen — Buchstaben, Zahlen, Symbole — indem sie diese mit bekannten Mustern vergleicht oder Mustererkennungsalgorithmen verwendet. Die Ausgabe ist Rohtext: eine Zeichenfolge, die darstellt, was physisch auf der Seite gedruckt wurde.
KI-Dokumentextraktion — manchmal auch intelligente Dokumentenverarbeitung oder KI-gestützte Extraktion genannt — verwendet Vision-Sprach-Modelle, Natural Language Processing und Deep Learning, um den Inhalt eines Dokuments zu verstehen. Sie liest nicht nur Zeichen; sie identifiziert, was diese Zeichen im Kontext bedeuten. Ein KI-Extraktionssystem kann Ihnen sagen, dass eine bestimmte Zahl der Rechnungsbetrag ist, dass ein Datum das Fälligkeitsdatum ist und dass ein Name der Lieferant ist — weil es die semantische Rolle versteht, die jede Information spielt.
Der Kernunterschied: OCR wandelt Bilder in Text um. KI-Extraktion wandelt Bilder in strukturierte, aussagekräftige Daten um. Das eine ist eine Transkriptionstechnologie. Das andere ist eine Verständnistechnologie.
Dieser Unterschied ist wichtig, weil nachgelagerte Systeme — Tabellenkalkulationen, Buchhaltungssoftware, ERPs — keinen Rohtext wollen. Sie wollen saubere Felder mit bekannter Bedeutung: „Rechnungsnummer: INV-2026-0891", „Gesamtbetrag: $1.234,56", „Fälligkeitsdatum: 2026-07-15". OCR kann Ihnen den ersten Teil liefern (die Textzeichen), aber nicht den zweiten Teil (was jeder Textabschnitt bedeutet).
Dasselbe Dokument, zwei verschiedene Antworten
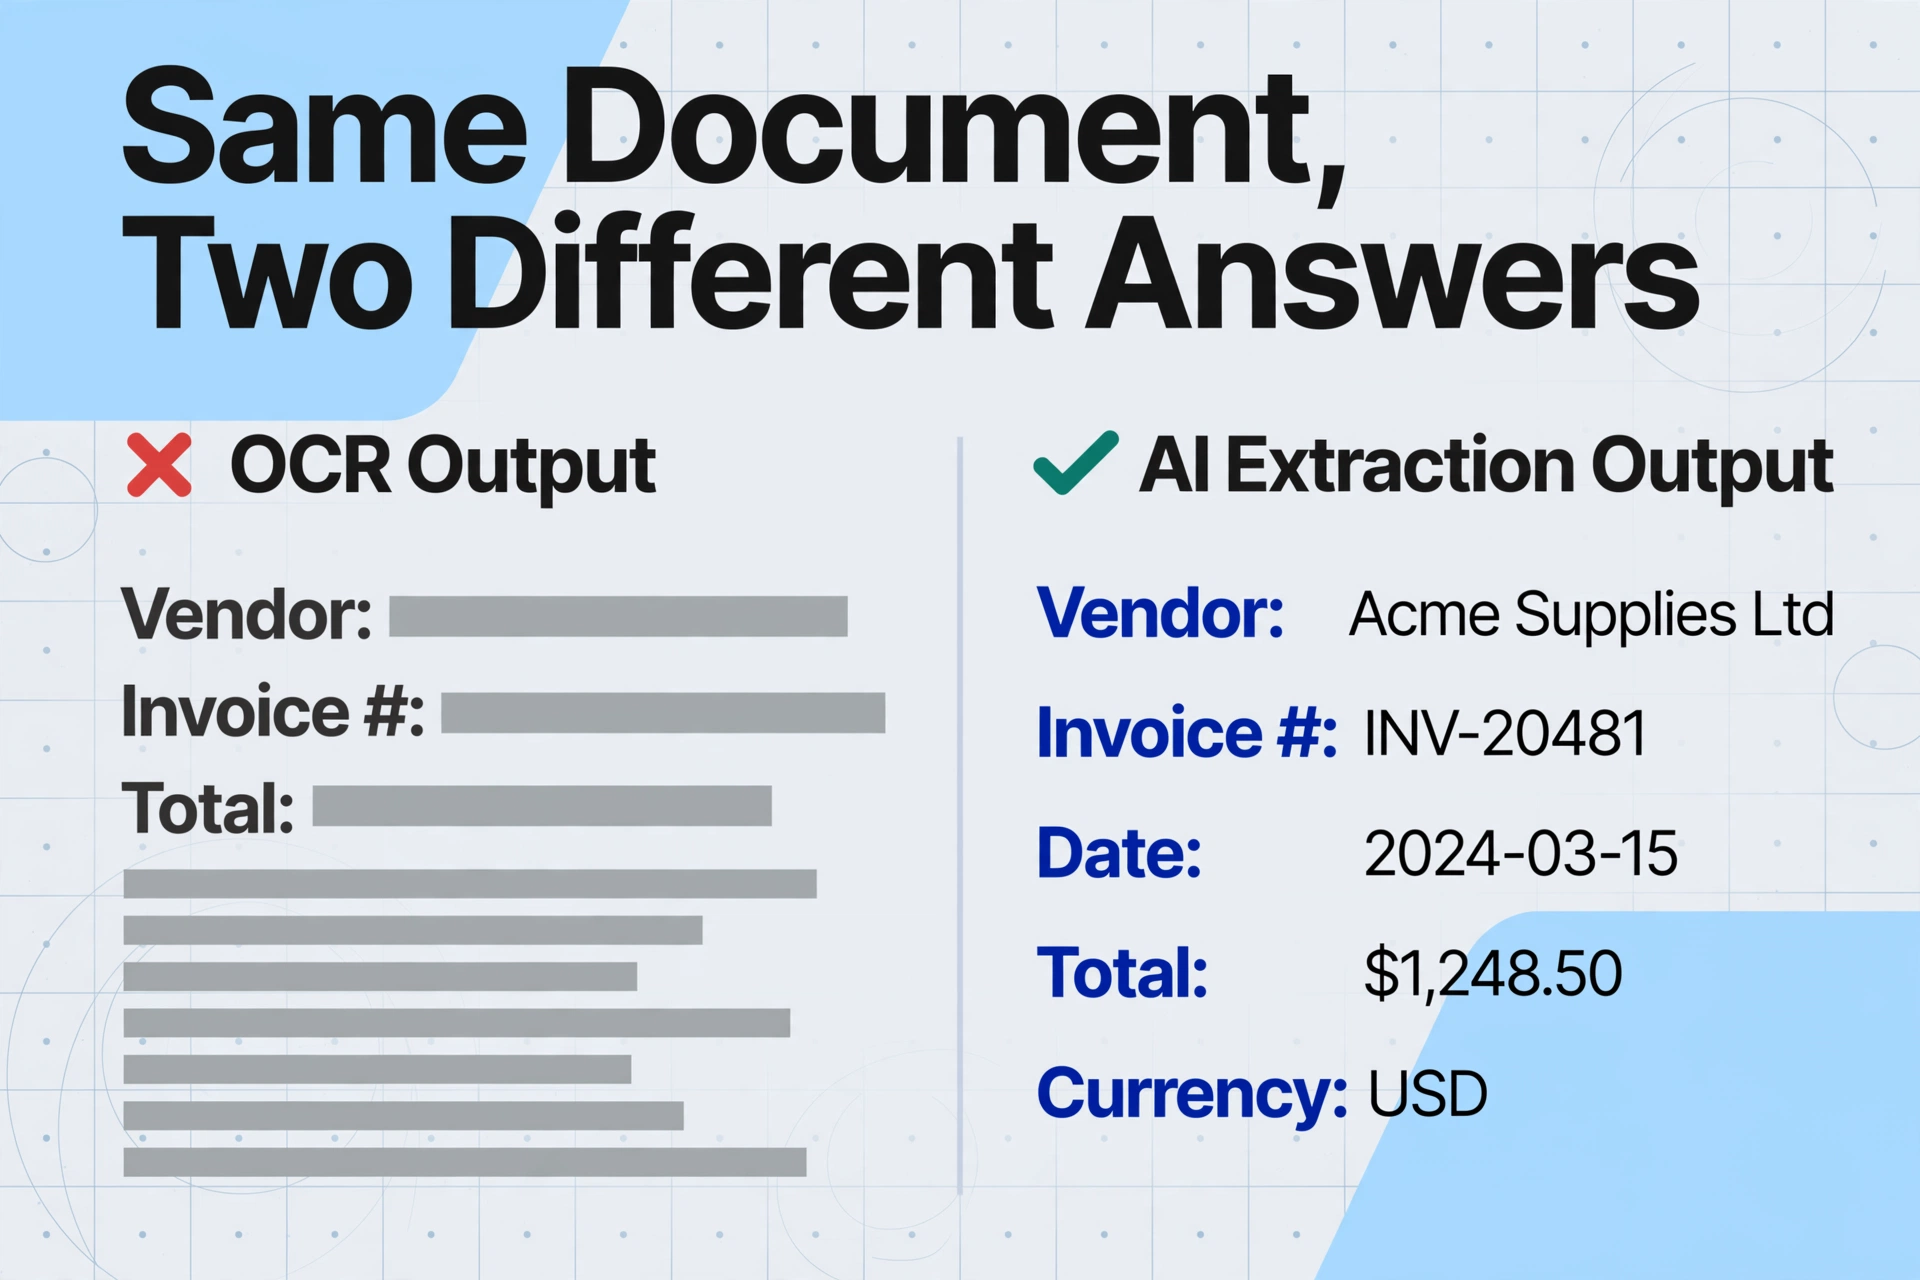
Der effektivste Weg, den Unterschied zu verstehen, ist zu sehen, was jede Technologie tatsächlich ausgibt, wenn sie dasselbe Dokument erhält. Betrachten wir eine Standardrechnung mit folgendem Inhalt:
Beispiel-Rechnungsausschnitt:
Lieferant: Pacific Maritime Supplies
Rechnungsnr.: INV-2026-0891
Datum: 06/15/2026
Fälligkeitsdatum: 2026-07-15
Beschreibung: 40ft-Container – aufgearbeitet
Menge: 2 × Stückpreis: $3.800,00
Zwischensumme: $7.600,00
Steuer (8,25%): $627,00
Rechnungsgesamtbetrag: $8.227,00
OCR-Ausgabe — eine einzelne Zeichenfolge erkannter Zeichen, ohne Bedeutung:
OCR hat jedes Zeichen erfolgreich transkribiert. Aber die Ausgabe ist ein flacher Textblock. Um Bedeutung zu extrahieren – zu wissen, dass „INV-2026-0891" die Rechnungsnummer und „$8.227,00" die Summe ist – braucht es einen Menschen, der es liest, oder eine Vorlage, die dem System anhand der Position sagt, wo sich jedes Feld befindet.
KI-Extraktionsausgabe – strukturierte Daten mit semantischen Bezeichnungen:
| Feld | Wert |
|---|---|
| Lieferantenname | Pacific Maritime Supplies |
| Rechnungsnummer | INV-2026-0891 |
| Rechnungsdatum | 2026-06-15 |
| Fälligkeitsdatum | 2026-07-15 |
| Positionsbeschreibung | 40ft-Container – generalüberholt |
| Menge | 2 |
| Einzelpreis | $3.800,00 |
| Zwischensumme | $7.600,00 |
| Steuer | $627,00 |
| Rechnungssumme | $8.227,00 |
Der Unterschied ist eklatant. KI-Extraktion transkribiert nicht nur den Text – sie versteht, was jeder Wert darstellt und organisiert ihn in beschriftete Felder. Die Rechnungssumme ist nicht nur eine Zeichenfolge ($8.227,00); sie ist die Rechnungssumme – ein semantischer Datenpunkt, den eine Tabellenkalkulation summieren, ein ERP buchen und ein Bericht analysieren kann.
Das ist der entscheidende Unterschied: OCR liefert Text. KI-Extraktion liefert Antworten.
Mythos 1: „OCR und KI-Extraktion sind dieselbe Art von Technologie"
Das ist das häufigste Missverständnis – und es ist nachvollziehbar. Sowohl OCR als auch KI-Extraktion nehmen Dokumentbilder als Eingabe und erzeugen digitale Daten als Ausgabe. Beide werden unter überlappenden Marketingbegriffen wie „Dokumenterfassung", „Datenextraktion" und „intelligentes OCR" verkauft. Aber die zugrunde liegende Technologie ist grundlegend verschieden.
OCR ist eine Mustererkennungstechnologie. Traditionelles OCR funktioniert, indem es Zeichenformen mit einer internen Datenbank bekannter Glyphen vergleicht. Es fragt: „Passt dieses Pixelmuster zum Buchstaben ‚A', zur Zahl ‚8' oder zum Symbol ‚$'?" Es arbeitet auf Zeichenebene – jede Glyphe wird unabhängig erkannt, ohne Verständnis für das Wort oder die Phrase, zu der sie gehört. Modernes OCR wurde durch maschinelles Lernen verbessert, aber seine grundlegende Aufgabe bleibt die Zeichenerkennung.
KI-Extraktion ist eine Technologie zum semantischen Verständnis. Sie verwendet Vision-Sprach-Modelle (VLMs), die das gesamte Dokument als visuelle Szene verarbeiten – nicht nur einzelne Zeichen, sondern das Layout, die räumlichen Beziehungen zwischen Textblöcken, die Formatierungshinweise (fett = Kopfzeile, große Schrift = Titel) und die kontextuelle Bedeutung jedes Datenpunkts. Sie fragt: „Was ist angesichts von allem auf dieser Seite die Rechnungsnummer? Was ist die Summe? Was ist der Lieferantenname?"
Eine hilfreiche Analogie: OCR ist wie eine Person, die jedes Wort in einem Buch laut vorlesen kann, aber nicht sagen kann, worum es in der Geschichte geht. KI-Extraktion ist wie ein Leser, der die Handlung, die Charaktere und die Themen versteht – und sie für Sie zusammenfassen kann.
Der vollständige Leitfaden dazu, was OCR ist erklärt dies ausführlicher, einschließlich der drei Generationen der OCR-Technologie von 1974 bis heute.
Mythos 2: „KI-Extraktion ersetzt OCR – Sie brauchen nur eines"
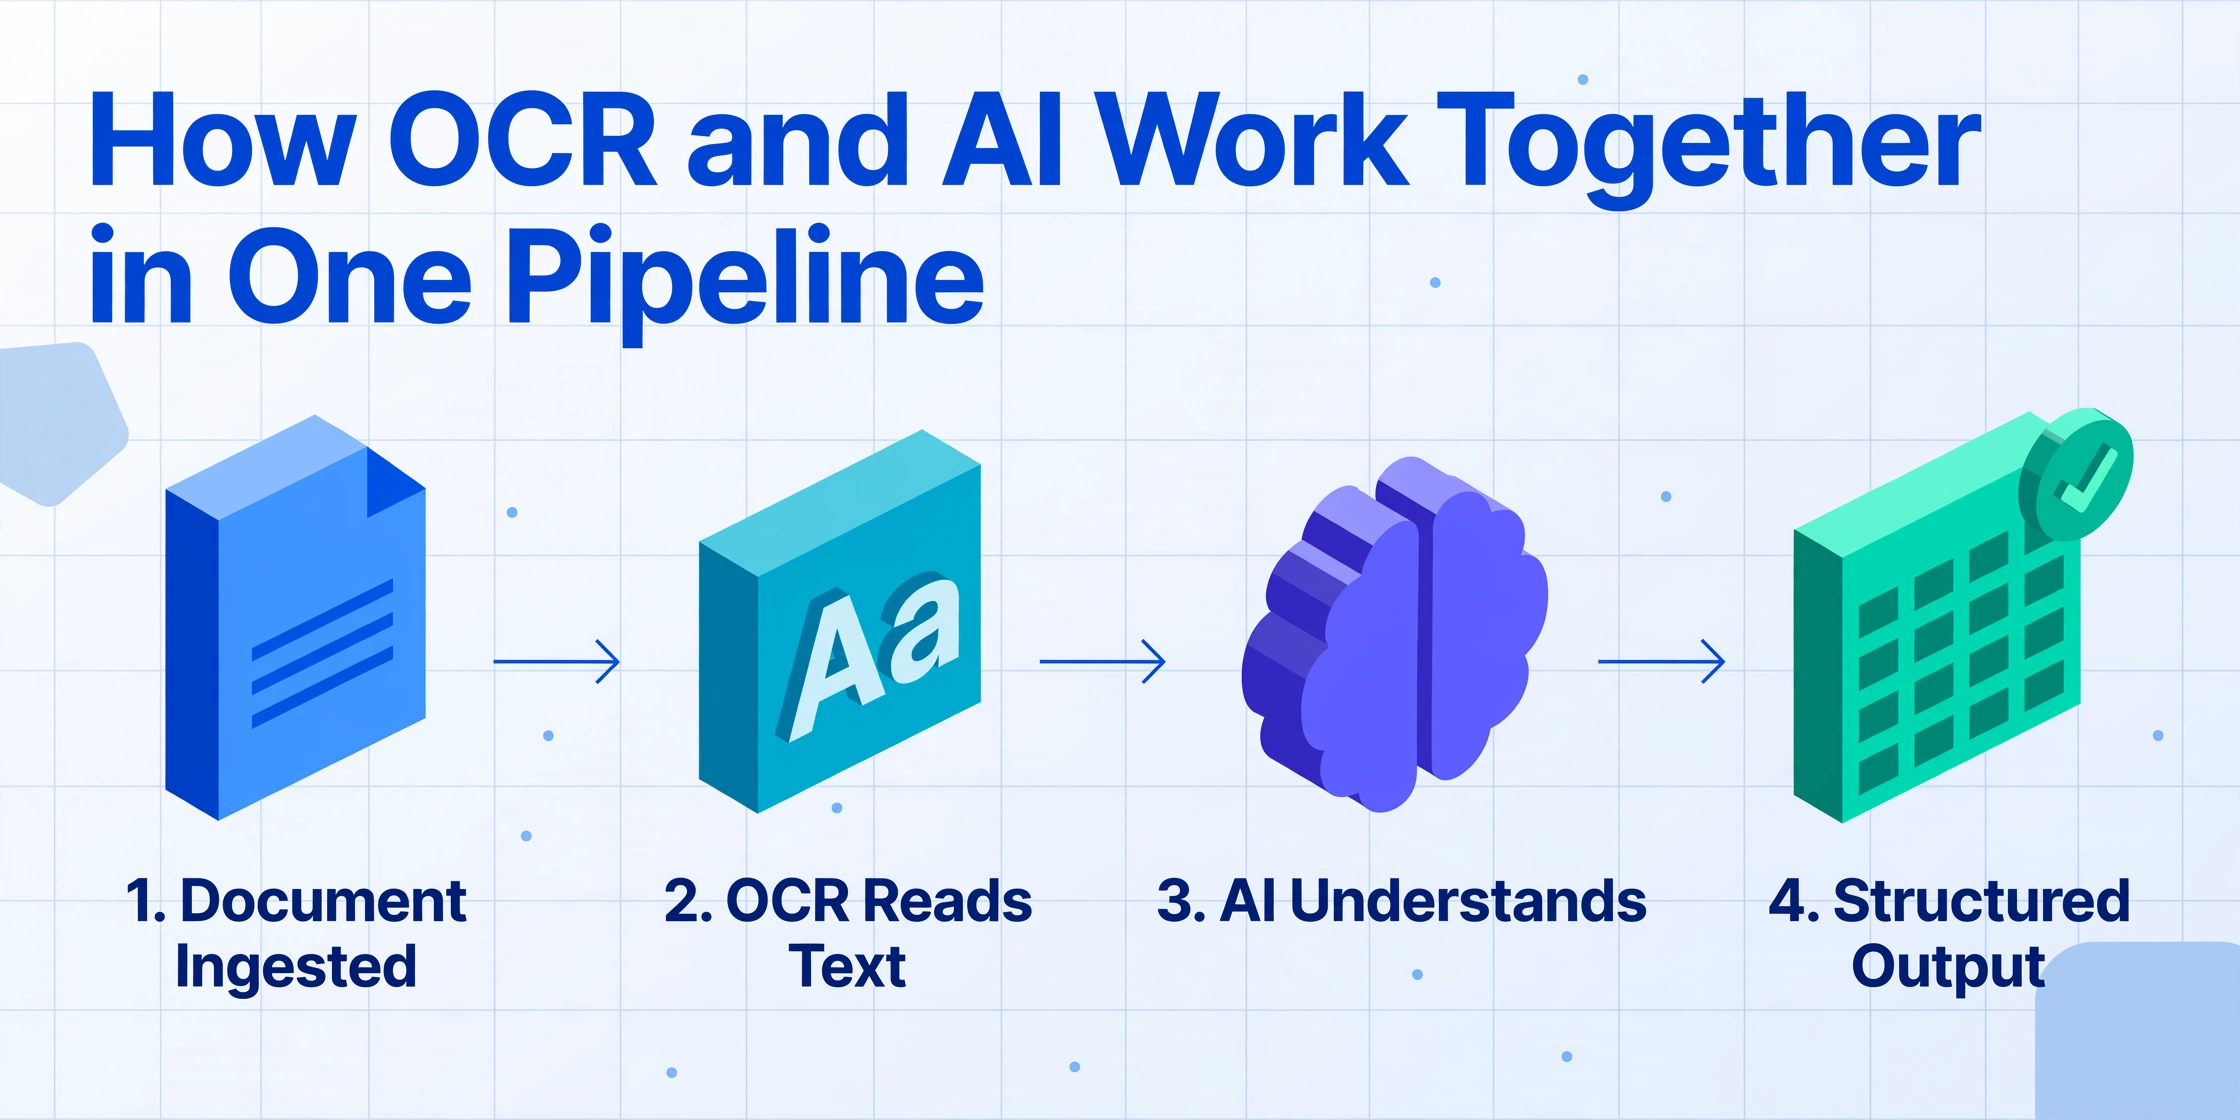
Dieses Missverständnis führt viele Unternehmen zu der Annahme, sie müssten sich zwischen den beiden Technologien entscheiden. In Wirklichkeit arbeiten sie auf verschiedenen Ebenen desselben Stacks, und viele KI-Extraktionspipelines nutzen OCR tatsächlich als ersten Schritt.
Stellen Sie es sich so vor: OCR ist das Fundament – es wandelt das visuelle Dokument in maschinenlesbaren Text um. KI-Extraktion ist die Ebene darüber – sie nimmt diesen Text (oder die rohen visuellen Daten) und interpretiert ihn. Eine typische KI-Dokumentenverarbeitungspipeline sieht so aus:
PDF, Bild oder Screenshot gelangt in das System.
Zeichen werden identifiziert und als Rohtext extrahiert – hier leistet OCR seine Arbeit.
Das KI-Modell analysiert Layout, Kontext und Beziehungen des Dokuments, um zu erkennen, was jedes Datenelement bedeutet.
Die interpretierten Daten werden in beschriftete Felder organisiert und in eine Tabellenkalkulation, Datenbank oder API exportiert.
In vielen modernen Systemen sind die OCR- und KI-Ebenen so eng integriert, dass der Benutzer die Grenze nie sieht. Aber konzeptionell ist die Trennung wichtig: OCR liefert das Rohmaterial. KI-Extraktion verleiht ihm Bedeutung.
Dies ist auch der entscheidende Unterschied zwischen traditionellem KI-OCR – das im Wesentlichen OCR ist, das durch maschinelles Lernen für eine bessere Zeichenerkennung verbessert wurde – und vollständiger KI-Dokumentextraktion, die die Semantik des Dokuments versteht. Der Artikel über was KI-OCR ist und wie es sich von traditionellem OCR unterscheidet untersucht diesen Unterschied im Detail.
Mythos 3: „Wenn Sie OCR haben, brauchen Sie keine KI-Extraktion"
Dieser Mythos hält sich, weil OCR bei vielen Dokumentaufgaben seit Jahren „gut genug" ist. Und in bestimmten Szenarien ist es das tatsächlich. Doch diese Szenarien werden immer seltener, da das Dokumentvolumen wächst und die Formate sich vervielfachen.
Wann OCR allein ausreicht
OCR funktioniert gut, wenn Dokumente strukturell konsistent sind – jedes Dokument folgt derselben Vorlage, verwendet dasselbe Layout und platziert wichtige Informationen an denselben Positionen. Beispiele hierfür sind:
- Digitalisierung standardisierter Regierungsformulare (W-2, 1099) aus einer einzigen Quelle
- Konvertierung gedruckter Buchseiten in durchsuchbaren Text
- Verarbeitung interner Unternehmensformulare, bei denen alle Abteilungen dieselbe Vorlage verwenden
- Erstellung durchsuchbarer PDF-Archive aus gescannten Dokumenten, wenn das Ziel die Volltextsuche und nicht die Datenextraktion ist
In diesen Fällen liefert OCR plus eine Vorlage (oder manuelle Prüfung) brauchbare Ergebnisse. Die Dokumentvarianz ist gering, daher funktioniert die positionsbasierte Extraktion.
Wann Sie KI-Extraktion benötigen
KI-Extraktion wird unverzichtbar, wenn eine der folgenden Bedingungen vorliegt:
| Bedingung | Warum OCR allein versagt | Was KI-Extraktion leistet |
|---|---|---|
| Mehrere Anbieter oder Quellen | Jeder Anbieter verwendet ein anderes Rechnungslayout – vorlagenbasiertes OCR scheitert bei jeder Formatänderung | Versteht die Feldbedeutung unabhängig von der Position – passt sich automatisch an |
| Handschriftlicher Inhalt | Traditionelles OCR hat Probleme mit der Variabilität von Handschrift | Vision-Sprach-Modelle interpretieren Handschrift mithilfe des visuellen Kontexts |
| Gemischte Dokumenttypen | Jeder Typ benötigt eine eigene Vorlage – der Wartungsaufwand skaliert linear | Ein einziges KI-Modell verarbeitet Rechnungen, Belege, Bestellungen und Verträge |
| Bedarf an bestimmten Feldern, nicht am gesamten Text | OCR liefert alles aus – Sie müssen die gewünschten Daten trotzdem noch finden | Sie definieren die Felder (Rechnungsnummer, Gesamtsumme, Fälligkeitsdatum) – die KI extrahiert nur, was Sie angefordert haben |
| Scans oder Fotos von schlechter Qualität | Unscharfe Bilder, schiefe Winkel und geringer Kontrast beeinträchtigen die Genauigkeit | VLMs kommen besser mit Beeinträchtigungen zurecht – sie verarbeiten das Bild als visuelle Szene, nicht nur als Zeichenformen |
| Bedarf an berechneten oder abgeleiteten Daten | OCR kann nicht rechnen – es liest nur, was gedruckt ist | KI kann Positionssummen berechnen, Ausgaben kategorisieren oder Daten ableiten, die nicht explizit geschrieben wurden |
Wenn Ihr Dokumentworkflow nur das erste Szenario umfasst – konsistente Vorlagen aus einer einzigen Quelle – kann OCR für Sie ausreichend sein. Für praktisch jeden anderen modernen Dokumentverarbeitungsbedarf ist KI-Extraktion die praktische Wahl.
Der Wandel: Von positionsbasierter zu semantikbasierter Extraktion
Die Verwechslung zwischen OCR und KI-Extraktion ist nicht nur ein Terminologieproblem. Sie spiegelt einen tieferen Wandel in der Dokumentdatenextraktion wider – einen Wandel von positionsbasierter zu semantikbasierter Extraktion.
Jahrzehntelang folgte die Dokumentdatenextraktion einer einfachen Formel: OCR extrahiert den gesamten Text → eine Vorlage ordnet Feldpositionen zu → das System liest den Wert an jeder Koordinate. Das ist das positionsbasierte Paradigma. Es funktioniert, solange jedes Dokument seine Felder an exakt derselben Stelle platziert.
Das Problem ist, dass reale Dokumente nicht so funktionieren. Anbieter verwenden unterschiedliche Rechnungslayouts. Kontoauszüge gibt es in verschiedenen Formaten. Bestellungen verschiedener Unternehmen ordnen Informationen unterschiedlich an. In einem positionsbasierten System erfordert jede Formatvariation eine neue Vorlage oder eine Regelanpassung – weshalb traditionelle OCR-Workflows scheitern, wenn die Dokumentvielfalt zunimmt.
Semantikbasierte Extraktion – das Paradigma, das KI-Extraktion ermöglicht – dreht die Formel um. Statt zu fragen „Wo befinden sich die Daten auf der Seite?", fragt sie „Was bedeuten die Daten?" Das KI-Modell liest das gesamte Dokument als eine einheitliche visuelle Szene, versteht die Beziehungen zwischen Textblöcken und identifiziert jeden Datenpunkt anhand seiner semantischen Rolle – unabhängig davon, wo er auf der Seite steht.
Das ist keine inkrementelle Verbesserung. Es ist ein anderer Ansatz für das Problem – einer, der die Last der Anpassung vom Nutzer (Erstellen von Vorlagen) auf die Technologie (Verstehen von Dokumenten) verlagert.
ImageToTable.ai beispielsweise arbeitet vollständig nach diesem semantikbasierten Paradigma. Sie definieren die Ausgabe – die Spaltennamen, die Sie wünschen – und die KI lokalisiert die entsprechenden Daten in jedem Dokumentlayout, indem sie versteht, was jedes Feld darstellt. Das ist es, was die Produktbeschreibung als ohne Vorlage und formatunabhängige Extraktion bezeichnet – Fähigkeiten, die mit OCR allein schlicht unmöglich sind, da OCR kein Konzept davon hat, was ein „Lieferantenname" oder eine „Rechnungssumme" bedeutet.
Das aufkommende Konzept des agilen OCR stellt die nächste Evolutionsstufe dar – bei der die KI Dokumente nicht nur liest und versteht, sondern auch über die Dokumentstruktur nachdenken und mit den extrahierten Daten handeln kann. Der grundlegende Sprung ist jedoch der vom Lesen zum Verstehen.
Für einen breiteren Überblick darüber, wie all diese Technologien zusammenpassen, dient der Leitfaden zur KI-Dokumentextraktion als zentrale Anlaufstelle für dieses Themencluster.
Häufig gestellte Fragen
Nutzt die KI-Extraktion OCR?
Viele KI-Extraktionssysteme verwenden OCR als eine Komponente in ihrer Pipeline – typischerweise als Texterkennungsebene. Aber die KI-Ebene geht weit über das hinaus, was OCR allein leisten kann, indem sie die Bedeutung, den Kontext und die Beziehungen zwischen Datenpunkten versteht. Einige moderne Vision-Sprach-Modelle umgehen das traditionelle OCR vollständig, indem sie das Dokumentbild direkt verarbeiten.
Können OCR und KI-Extraktion zusammenarbeiten?
Ja – und in vielen Systemen tun sie das auch. OCR übernimmt den Schritt der Zeichenerkennung und wandelt visuellen Text in ein maschinenlesbares Format um. Die KI-Extraktion interpretiert diesen Text dann, um bestimmte Felder zu identifizieren, Daten zu validieren und die Ausgabe zu strukturieren. Es handelt sich um sich ergänzende Technologien, nicht um Konkurrenten.
Ist die KI-Extraktion genauer als OCR?
Das hängt von der Aufgabe ab. Bei der einfachen Zeichenerkennung auf sauberen, standardisierten Dokumenten kann OCR eine hohe Genauigkeit erzielen. Bei der Extraktion bestimmter Datenfelder – etwa dem Finden der Rechnungssumme unter Dutzenden von Zahlen auf einer Seite – ist die KI-Extraktion jedoch deutlich genauer, da sie anhand des Kontexts versteht, welche Zahl die Summe ist, und nicht nur anhand der Position. Bei gedruckten Tabellendaten mit konsistentem Format erreichen moderne KI-gestützte Systeme eine Genauigkeit von bis zu 99 %.
Mit welchen Dokumenttypen funktioniert die KI-Extraktion am besten?
Die KI-Extraktion funktioniert mit praktisch jedem Dokumenttyp, der Textinhalte enthält: Rechnungen, Belege, Bestellungen, Kontoauszüge, Verträge, Lieferscheine, Stundenzettel, Versicherungszertifikate und mehr. Sie verarbeitet strukturierte Dokumente (Formulare mit festen Layouts), semistrukturierte Dokumente (Rechnungen mit unterschiedlichen Layouts) und sogar unstrukturierte Dokumente (handschriftliche Notizen, Inspektionsberichte). Der entscheidende Vorteil ist, dass für keinen davon Vorlagen erforderlich sind.
Brauche ich OCR trotzdem noch, wenn ich KI-Extraktion verwende?
Nicht unbedingt – viele moderne KI-Extraktionstools übernehmen die gesamte Pipeline vom Bild bis zu strukturierten Daten, ohne OCR als separaten Schritt offenzulegen. Die KI liest das Dokument direkt und gibt die benötigten Felder aus. Sie müssen nicht zuerst OCR ausführen und die Ausgabe dann in ein KI-Tool einspeisen. Das KI-Extraktionssystem übernimmt sowohl das Lesen als auch das Verstehen in einem Durchgang.
Was ist teurer: OCR oder KI-Extraktion?
Der direkte Kostenvergleich hängt vom jeweiligen Tool und Volumen ab. Die Gesamtbetriebskosten sprechen jedoch oft für die KI-Extraktion, wenn man die versteckten Kosten von OCR berücksichtigt: Erstellung und Pflege von Vorlagen, manuelle Validierung falsch extrahierter Felder sowie die Bearbeitung von Ausnahmen bei Formatänderungen. KI-Extraktionstools verwenden in der Regel Abonnementpreise und eliminieren den Großteil des Vorlagenaufwands. Viele bieten kostenlose Testversionen oder Demo-Zugang zum Testen mit Ihren eigenen Dokumenten an.
Sehen Sie den Unterschied an Ihren eigenen Dokumenten
Der beste Weg, die Kluft zwischen OCR und KI-Extraktion zu verstehen, ist, sie an Ihren eigenen Dokumenten zu sehen. Was folgt, ist eine Live-Demo – laden Sie eine beliebige Rechnung, Quittung oder ein Dokument hoch und sehen Sie, was ein KI-Extraktionssystem produziert. Ohne Vorlage. Ohne Konfiguration. Einfach hochladen und die strukturierten Felder sehen, die die KI identifiziert.
Dateien werden sicher verarbeitet und nicht gespeichert.
Laden Sie ein Dokument hoch und geben Sie ein paar Spaltennamen ein – „Rechnungsnummer", „Gesamtbetrag", „Lieferantenname", „Fälligkeitsdatum" – und beobachten Sie, wie die KI jedes Feld lokalisiert und extrahiert, indem sie versteht, was es bedeutet, und nicht, wo es auf der Seite steht. Das ist der Unterschied zwischen dem Lesen von Zeichen und dem Verstehen eines Dokuments.
Das unterscheidet OCR von KI-Extraktion: OCR liest, was geschrieben steht. KI-Extraktion weiß, was es bedeutet. Und in einer Welt, in der Dokumente in endlosen Variationen vorkommen, kommt es auf das Verständnis an.