Extração de dados de imagem com IA
vs. OCR tradicional: qual é a diferença
Você tem uma pilha de notas fiscais, extratos bancários ou formulários digitalizados. Você precisa de campos específicos — valores, datas, nomes — em uma planilha. As ferramentas de OCR existem há décadas; por que isso ainda é difícil? A resposta é que o OCR resolve um problema diferente do que você realmente tem. Aqui está uma visão clara do que o OCR tradicional faz, o que os modelos de visão de IA fazem de diferente e como usar a extração com IA de forma eficaz.
Principais conclusões
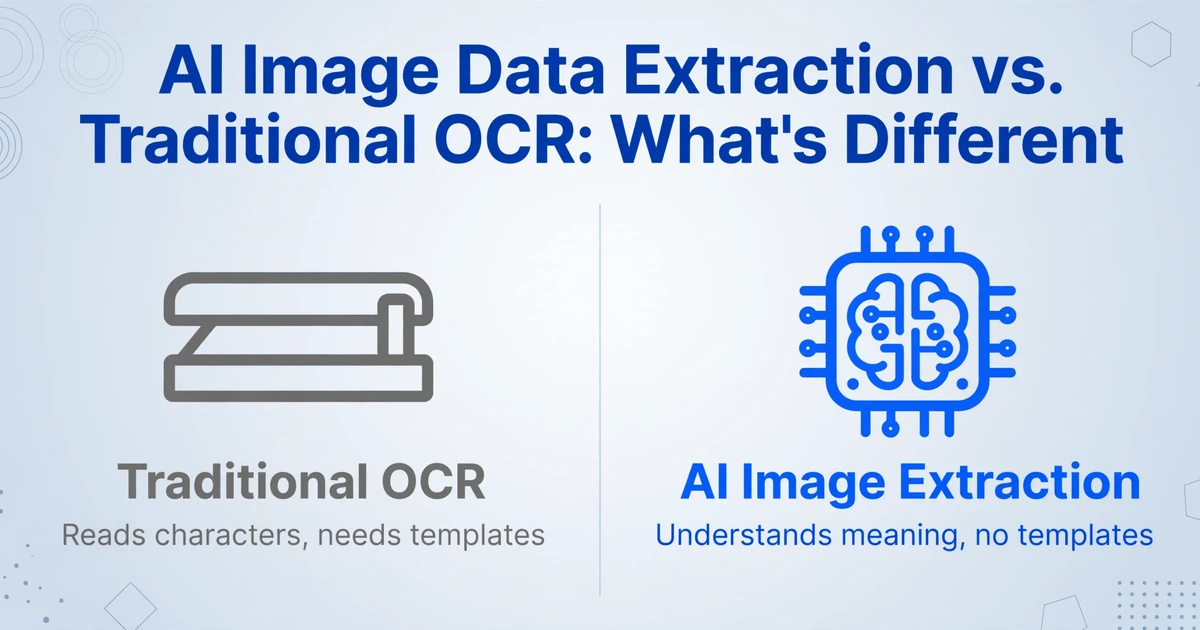
- O OCR tradicional converte imagens em um fluxo de texto, não em campos estruturados — cada layout de fornecedor vira um desafio de análise separado que quebra quando o formato muda.
- A extração com IA lê documentos compreendendo o significado — "Invoice No.", "INV#" e "Bill Reference" todos mapeiam para o mesmo campo sem um modelo ou mapa de coordenadas de pixels.
- O OCR baseado em modelos exige uma nova configuração para cada layout de documento — um fornecedor que redesenha o formato da nota fiscal quebra a extração silenciosamente, sem nenhuma mensagem de erro.
- O ChatGPT extrai um documento por vez de forma confiável, mas não consegue processar em lote, manter esquemas de colunas consistentes entre arquivos nem exportar diretamente para o Excel sem trabalho adicional.
- O OCR continua mais barato para documentos padronizados de alto volume com layouts fixos — a extração com IA é a ferramenta certa quando os formatos variam, aparece escrita manual ou é necessária a compreensão semântica de campos.
A lacuna entre "legível" e "estruturado"
A maioria dos documentos empresariais é legível para humanos, mas não estruturada para máquinas. Uma fatura em PDF é perfeitamente legível — uma pessoa pode olhar para ela e encontrar imediatamente o número da fatura, a data de vencimento e o total. Mas para uma máquina, esses três valores estão flutuando em algum lugar em uma página de texto, distinguidos do texto ao redor apenas pela posição, tamanho da fonte e pelo rótulo próximo que o cérebro humano conecta automaticamente a eles.
Essa é a lacuna que as ferramentas de extração de dados tentam preencher: transformar um documento que um humano pode ler em dados que o software pode usar. "Não estruturado" não significa desorganizado — significa que a informação não está em uma linha de banco de dados ou em um campo de API rotulado. Está em um layout visual que os humanos interpretam sem esforço e que as máquinas sempre acharam difícil.
O desafio cresce rapidamente. Uma fatura, você pode digitar à mão em três minutos. Cinquenta faturas de cinco fornecedores diferentes, cada uma com um layout ligeiramente diferente, leva horas — e introduz erros de transcrição. A necessidade de automação não é sobre um documento; é sobre fazer a mesma extração de forma consistente em muitos.
O que o OCR tradicional realmente oferece
O Reconhecimento Óptico de Caracteres foi projetado para resolver um problema específico e mais restrito: converter uma imagem de texto em caracteres legíveis por máquina. Uma página escaneada de texto entra; uma string de caracteres sai. Para essa tarefa, o OCR moderno é excelente — a precisão em texto impresso e limpo rotineiramente excede 99%.
O problema é o que sai. O OCR lê um documento da esquerda para a direita, de cima para baixo, e fornece um fluxo de texto. Alimente-o com uma fatura de fornecedor e você obtém algo assim:
ACME Supplies Ltd
123 Commerce Street, Chicago IL 60601
INVOICE
Invoice No: INV-2024-0892    Date: March 15, 2024
Bill To: Greenfield Corp     Due: April 14, 2024
Description        Qty    Unit Price    Amount
Office chairs       4       $285.00    $1,140.00
Desk lamps         10        $45.00      $450.00
                                 Total: $1,590.00
O texto está lá — mas você volta ao mesmo problema. Qual linha é o número da nota fiscal? Qual data é a de emissão e qual é a de vencimento? Se você está processando 50 notas fiscais de 20 fornecedores diferentes, cada um coloca o "Nº da Nota" em um lugar diferente, formata a data de um jeito e usa rótulos de coluna diferentes. O layout de cada fornecedor é um desafio de parsing separado.
Sistemas de OCR baseados em modelos resolvem isso com modelos por fornecedor: você define as coordenadas de pixels de cada campo para cada tipo de documento. Isso funciona se o seu conjunto de documentos for fixo e homogêneo. Quebra sempre que um fornecedor muda o layout da nota fiscal ou você adiciona um novo fornecedor.
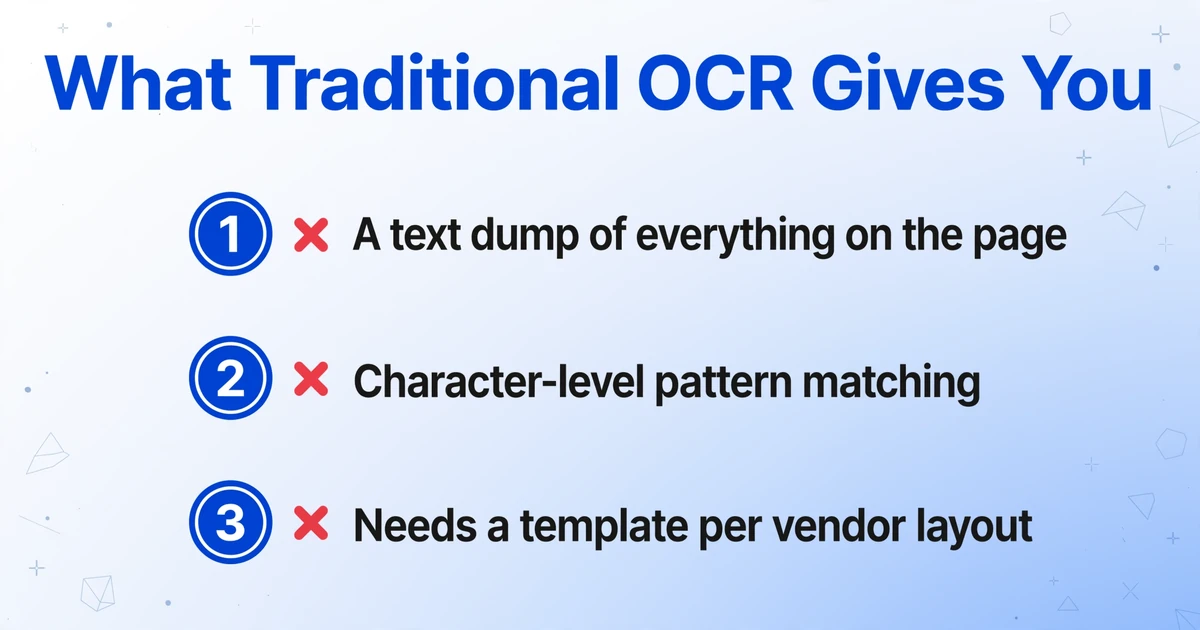
OCR tradicional: o que você obtém
- ✗ Um despejo de texto de tudo na página
- ✗ Apenas correspondência de padrões em nível de caractere
- ✗ Dependente do layout: novo modelo por tipo de documento
- ✗ Ruim com escrita manual, fotos e fontes incomuns
- ✗ Você ainda precisa encontrar e mapear cada campo manualmente
Extração de dados por visão de IA: o que você obtém
- ✓ Apenas os campos que você pediu, já em colunas
- ✓ Compreensão semântica do significado dos campos
- ✓ Independente de formato: um prompt funciona em vários formatos
- ✓ Lida com escrita manual, fotos e formatos mistos
- ✓ Saída pronta para Excel — sem pós-processamento
Como os Modelos de Visão de IA Extraem de Forma Diferente
Os modelos de visão de IA — a categoria que inclui GPT-4o, Claude, Gemini e IA especializada em documentos — abordam o problema da extração de forma diferente. Em vez de fazer correspondência de padrões de caracteres em um fluxo de texto, eles entendem o documento semanticamente: o que o documento é, o que cada seção significa e como diferentes elementos visuais se relacionam entre si.
A consequência prática: quando você pede "Número da Fatura", o modelo encontra independentemente de o documento rotulá-lo como "Invoice No.", "INV#", "Bill Reference" ou "Reference ID". Ele entende que esses são conceitos equivalentes no contexto de uma fatura comercial. Sem modelo, sem mapeamento de coordenadas — apenas extração direcionada a campos.
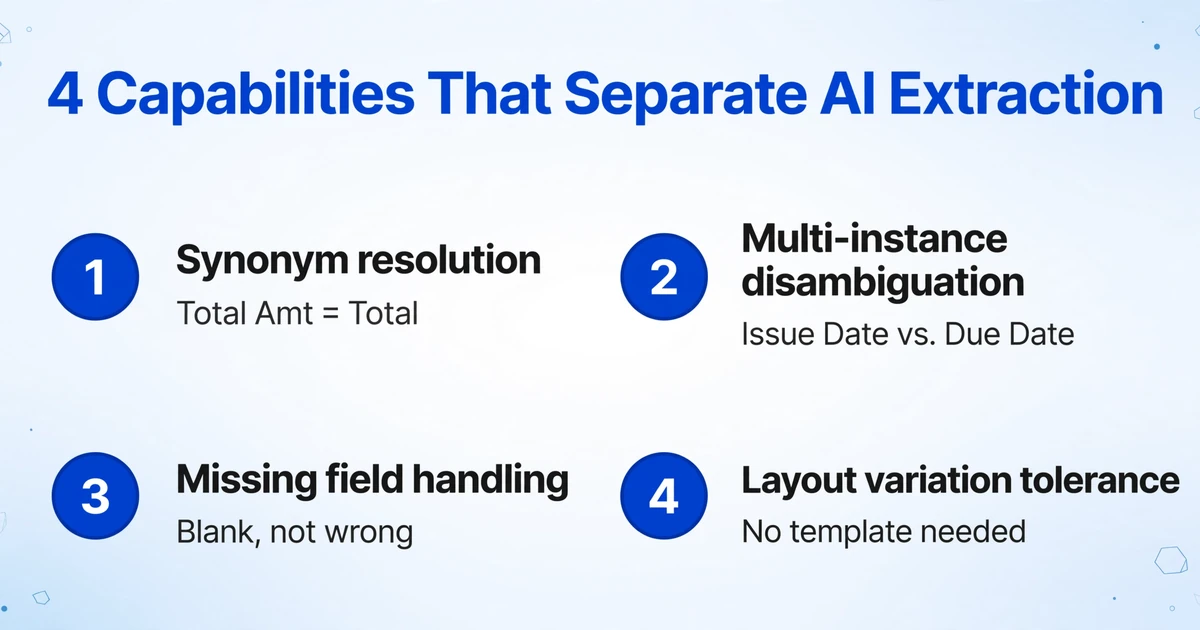
Algumas capacidades específicas que diferenciam a extração com IA do OCR:
- Resolução de sinônimos e abreviações — "Total Amt", "Grand Total", "Amount Due" e "Total" mapeiam para o mesmo campo. O modelo entende o vocabulário de faturas.
- Desambiguação de múltiplas instâncias — quando um documento tem cinco datas diferentes, pedir "Data de Emissão" retorna a data de criação do documento, não a data de entrega ou a data de vencimento. A especificidade do campo no nome da sua coluna orienta a extração.
- Tratamento de campos ausentes — se um campo solicitado não estiver presente em um documento específico, a célula fica em branco em vez de ser preenchida com um valor próximo. Isso é crítico: na conciliação financeira ou em pesquisa, um campo em branco sinaliza corretamente dados ausentes; um valor errado corrompe a análise posterior.
- Tolerância a variações de layout — a mesma extração funciona em extratos bancários do Chase, Wells Fargo e Barclays. A IA lê a estrutura de cada documento de forma independente; ela não depende de posições consistentes dos campos.
- Suporte a manuscritos e fotos — a precisão do texto impresso chega a 99%; texto manuscrito é bem tratado quando legível; fotos de documentos em papel funcionam quando bem iluminadas e tiradas de frente.
Você Pode Simplesmente Usar o ChatGPT para Isso?
Sim, o ChatGPT (GPT-4o) e modelos de IA baseados em chat semelhantes conseguem extrair dados de uma imagem de documento. Você envia um print de uma fatura, pede para ele extrair o número da fatura, a data e o total, e ele faz isso de forma confiável. Para uma extração pontual, isso funciona.
As limitações aparecem quando você faz isso em escala:
- Um documento por vez — interfaces de chat não são feitas para processamento em lote. Enviar 40 faturas uma a uma e extrair dados de cada conversa é lento e gera 40 saídas separadas e desconectadas.
- Sem esquema de colunas consistente — cada resposta do chat é de formato livre. Fazer 40 respostas do chat produzirem 40 linhas com estrutura idêntica na mesma tabela exige trabalho adicional para analisar e mesclar.
- Sem exportação direta — você não consegue exportar uma conversa de chat como um arquivo Excel. Você precisaria copiar a saída para uma planilha manualmente, ou escrever código para chamar a API e lidar com a formatação da resposta por conta própria.
- O contexto não é mantido entre sessões — seu modelo de extração (quais colunas você quer) precisa ser redefinido a cada nova sessão de chat.
Uma ferramenta de extração dedicada, construída sobre a mesma IA subjacente, cuida do fluxo de trabalho em lote, da saída estruturada e da exportação para Excel que a interface de chat não oferece. A capacidade de IA é a mesma; a diferença está na camada de fluxo de trabalho ao redor dela.
Perguntas Frequentes
Qual é a precisão da extração com IA em comparação com a entrada manual?
Para texto impresso por máquina em PDFs e capturas de tela claros, a precisão dos caracteres impressos chega a até 99% — comparável ao OCR tradicional em documentos limpos. A diferença significativa está na precisão da extração direcionada a campos: a IA identifica corretamente qual valor pertence a qual coluna em layouts variados, enquanto o OCR tradicional exige um modelo personalizado para cada layout. Para documentos manuscritos e fotos de papel, a precisão é menor — de moderada a alta, dependendo da legibilidade. Independentemente do método, verificar por amostragem os totais extraídos em relação aos documentos de origem antes de usar os dados é uma boa prática.
O que acontece quando a IA não encontra um campo que eu solicitei?
A célula desse campo fica em branco em vez de ser preenchida com um valor próximo. Isso é intencional: em conciliação financeira, pesquisa e na maioria das análises posteriores, uma célula em branco sinaliza corretamente "este campo não estava presente no documento de origem". Um valor errado — algo adjacente ao campo esperado, preenchido para evitar uma célula vazia — é pior do que um campo em branco. Se você está obtendo valores em branco consistentemente para um campo que sabe que existe no documento, o nome da coluna pode estar ambíguo demais; tente uma descrição mais específica.
Isso funciona em PDFs baseados em imagem (digitalizados), não apenas em PDFs com camada de texto?
Sim. A extração de dados por visão de IA processa todas as entradas como imagens, então não depende de o PDF ter uma camada de texto. Um formulário de papel digitalizado e um PDF gerado digitalmente com texto incorporado são tratados da mesma forma. Na prática, PDFs gerados digitalmente costumam produzir entrada mais limpa e de maior resolução do que fotos de celular, o que pode melhorar a precisão em textos menores.
Onde a extração com IA ainda tem dificuldades em comparação com o OCR tradicional?
O OCR tradicional em documentos padronizados de alto volume com impressão limpa ainda é mais rápido e barato para tarefas de reconhecimento puro de caracteres — se tudo o que você precisa é do texto bruto e você mesmo fará o parsing. A extração com IA adiciona a camada de extração direcionada a campos sobre o OCR, o que a torna mais capaz para layouts variados, mas adiciona custo de processamento por página. Para documentos em que o layout é perfeitamente fixo e nunca muda (um formulário governamental específico, por exemplo), um sistema de OCR baseado em modelos pode ser mais econômico. Para qualquer coisa com variação de layout, formatos mistos ou manuscritos, a extração com IA é a abordagem mais prática.
A extração com IA consegue ler texto manuscrito de forma confiável o suficiente para uso real?
Para a maioria das caligrafias legíveis — incluindo cursiva — a precisão é de moderada a alta. Texto impresso por máquina continua sendo mais confiável. A recomendação prática: use extração com IA para documentos manuscritos quando a alternativa for transcrição manual, mas verifique por amostragem uma proporção maior de linhas antes de usar os dados. Para dados manuscritos de alto risco (formulários médicos, documentos legais), a verificação contra os registros de origem é essencial, independentemente do método de extração.
Experimente com um documento que você tenha — envie um PDF ou imagem, defina os nomes das colunas e veja a saída direcionada a campos.
Começar a Extraer