Extraction de données par vision IA
vs OCR traditionnel : quelles différences ?
Vous avez une pile de factures, de relevés bancaires ou de formulaires scannés. Vous avez besoin de champs spécifiques — montants, dates, noms — dans un tableur. Les outils OCR existent depuis des décennies ; pourquoi est-ce encore difficile ? La réponse est que l'OCR résout un problème différent de celui que vous avez réellement. Voici un regard clair sur ce que fait l'OCR traditionnel, ce que les modèles de vision IA font différemment, et comment utiliser efficacement l'extraction par IA.
Points clés à retenir
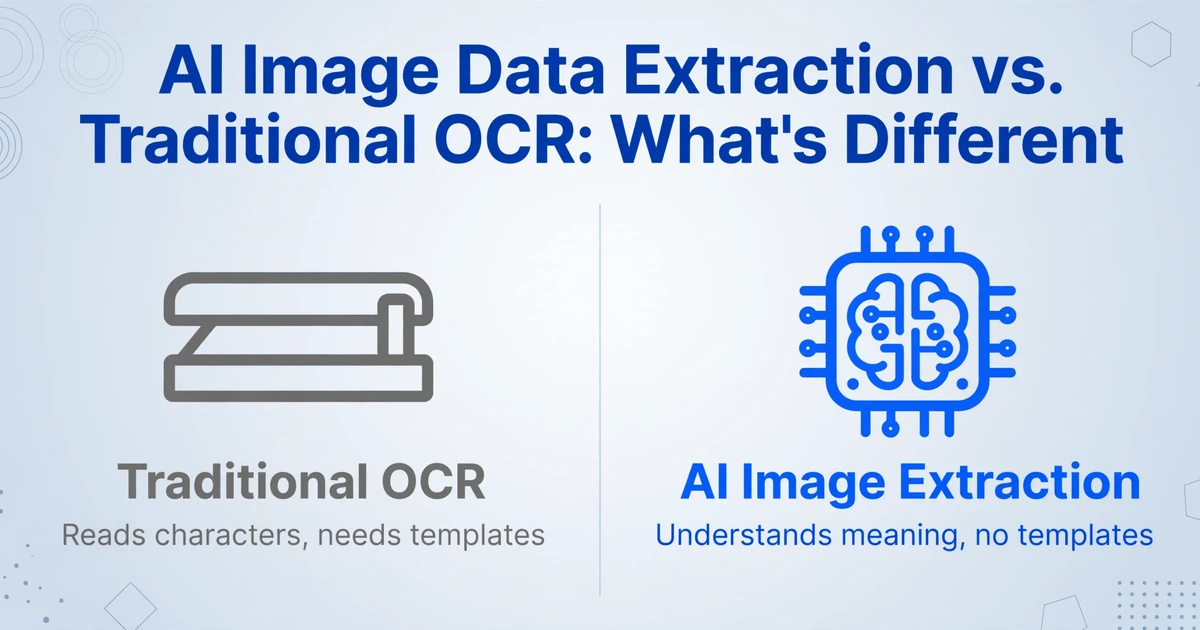
- L'OCR traditionnel convertit les images en un flux de texte, pas en champs structurés — chaque mise en page de fournisseur devient un défi d'analyse séparé qui casse lorsque le format change.
- L'extraction par IA lit les documents en comprenant le sens — « N° de facture », « INV# » et « Référence de facturation » correspondent tous au même champ sans modèle ni carte de coordonnées de pixels.
- L'OCR basé sur des modèles nécessite une nouvelle configuration par mise en page de document — un fournisseur qui redessine son format de facture casse silencieusement l'extraction sans aucun message d'erreur.
- ChatGPT extrait de manière fiable un document à la fois mais ne peut pas traiter par lots, maintenir des schémas de colonnes cohérents entre les fichiers, ni exporter directement vers Excel sans travail supplémentaire.
- L'OCR reste moins cher pour les documents standardisés à volume élevé avec des mises en page fixes — l'extraction par IA est le bon outil lorsque les formats varient, que de l'écriture manuscrite apparaît ou qu'une compréhension sémantique des champs est nécessaire.
L'écart entre « lisible » et « structuré »
La plupart des documents professionnels sont lisibles par l'humain mais non structurés pour la machine. Une facture PDF est parfaitement lisible — une personne peut la regarder et trouver immédiatement le numéro de facture, la date d'échéance et le total. Mais pour une machine, ces trois valeurs flottent quelque part dans une page de texte, distinguées du texte environnant uniquement par leur position, leur taille de police et l'étiquette voisine qu'un cerveau humain associe automatiquement.
C'est cet écart que les outils d'extraction de données tentent de combler : transformer un document qu'un humain peut lire en données qu'un logiciel peut utiliser. « Non structuré » ne signifie pas désorganisé — cela signifie que l'information n'est pas dans une ligne de base de données ou un champ API étiqueté. Elle est dans une mise en page visuelle que les humains interprètent sans effort et que les machines ont toujours trouvée difficile.
Le défi s'amplifie rapidement. Une facture, on peut la saisir à la main en trois minutes. Cinquante factures de cinq fournisseurs différents, chacune avec une mise en page légèrement différente, prend des heures — et introduit des erreurs de transcription. Le besoin d'automatisation ne concerne pas un seul document ; il s'agit de faire la même extraction de manière cohérente sur de nombreux documents.
Ce que l'OCR traditionnel vous donne réellement
La reconnaissance optique de caractères a été conçue pour résoudre un problème spécifique et plus étroit : convertir une image de texte en caractères lisibles par machine. Une page scannée de texte entre ; une chaîne de caractères sort. Pour cette tâche, l'OCR moderne est excellent — la précision sur du texte propre et imprimé dépasse régulièrement 99 %.
Le problème, c'est ce qui sort. L'OCR lit un document de gauche à droite, de haut en bas, et vous donne un flux de texte. Donnez-lui une facture fournisseur et vous obtenez quelque chose comme ceci :
ACME Supplies Ltd
123 Commerce Street, Chicago IL 60601
INVOICE
Invoice No: INV-2024-0892    Date: March 15, 2024
Bill To: Greenfield Corp     Due: April 14, 2024
Description        Qty    Unit Price    Amount
Office chairs       4       $285.00    $1,140.00
Desk lamps         10        $45.00      $450.00
                                 Total: $1,590.00
Le texte est là — mais vous revenez au même problème. Quelle ligne correspond au numéro de facture ? Quelle date est la date d'émission et laquelle est la date d'échéance ? Si vous traitez 50 factures provenant de 20 fournisseurs différents, chacun place « N° de facture » à un endroit différent, formate la date différemment et utilise des libellés de colonnes différents. La mise en page de chaque fournisseur représente un défi d'analyse distinct.
Les systèmes OCR basés sur des modèles résolvent ce problème avec des modèles par fournisseur : vous définissez les coordonnées en pixels de chaque champ pour chaque type de document. Cela fonctionne si votre ensemble de documents est fixe et homogène. Cela échoue dès qu'un fournisseur modifie sa mise en page de facture ou que vous ajoutez un nouveau fournisseur.
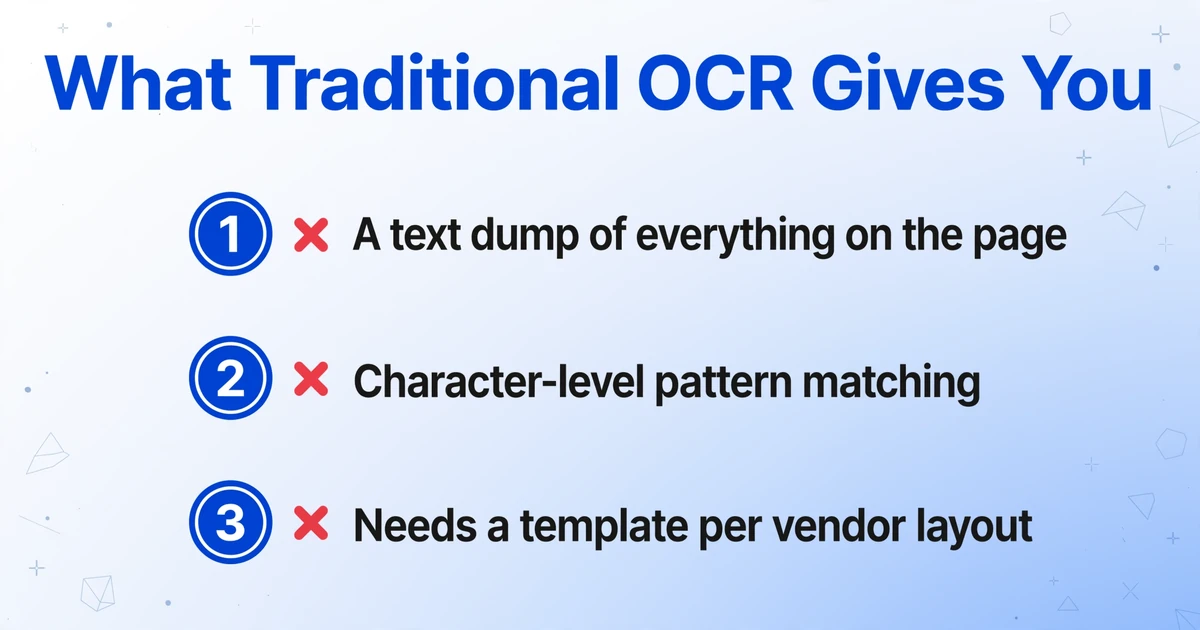
OCR traditionnel : ce que vous obtenez
- ✗ Un extrait texte de tout ce qui se trouve sur la page
- ✗ Correspondance de motifs au niveau des caractères uniquement
- ✗ Dépendant de la mise en page : nouveau modèle par type de document
- ✗ Médiocre sur l'écriture manuscrite, les photos, les polices inhabituelles
- ✗ Vous devez toujours trouver et mapper chaque champ vous-même
Extraction de données par vision IA : ce que vous obtenez
- ✓ Uniquement les champs demandés, déjà en colonnes
- ✓ Compréhension sémantique de la signification des champs
- ✓ Indépendant de la mise en page : une seule invite fonctionne sur tous les formats
- ✓ Gère l'écriture manuscrite, les photos, les formats mixtes
- ✓ Sortie prête pour Excel — aucun post-traitement
Comment les modèles de vision IA extraient différemment
Les modèles de vision IA — la catégorie qui inclut GPT-4o, Claude, Gemini et les IA documentaires spécialisées — abordent le problème de l'extraction différemment. Au lieu de faire correspondre des caractères dans un flux de texte, ils comprennent le document sémantiquement : ce qu'est le document, ce que signifie chaque section et comment les différents éléments visuels sont liés entre eux.
La conséquence pratique : lorsque vous demandez « Numéro de facture », le modèle le trouve, que le document l'étiquette « N° de facture », « INV# », « Référence de facturation » ou « ID de référence ». Il comprend que ce sont des concepts équivalents dans le contexte d'une facture commerciale. Pas de modèle, pas de mappage de coordonnées — juste une extraction ciblée par champ.
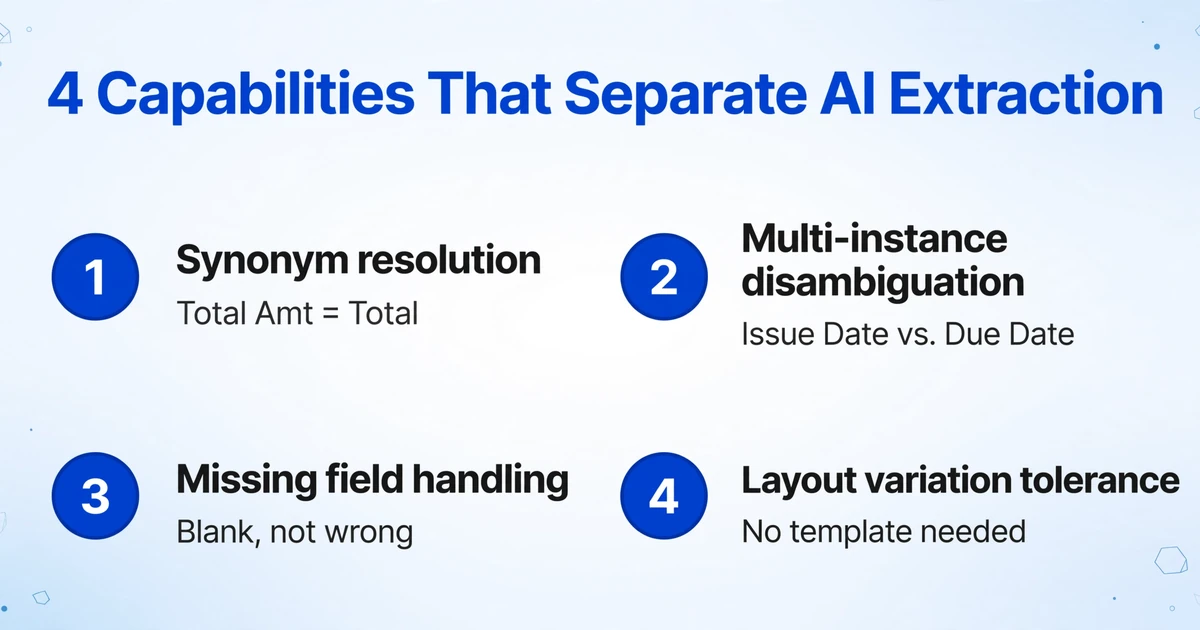
Quelques capacités spécifiques qui distinguent l'extraction par IA de l'OCR :
- Résolution des synonymes et abréviations — « Total Amt », « Grand Total », « Montant dû » et « Total » correspondent tous au même champ. Le modèle comprend le vocabulaire des factures.
- Désambiguïsation multi-instances — lorsqu'un document contient cinq dates différentes, demander « Date d'émission » renvoie la date de création du document, et non la date de livraison ou la date d'échéance. La spécificité du champ dans le nom de votre colonne guide l'extraction.
- Gestion des champs manquants — si un champ demandé n'est pas présent dans un document particulier, la cellule reste vide plutôt que d'être remplie avec une valeur proche. C'est essentiel : en rapprochement financier ou en recherche, une cellule vide signale correctement une donnée manquante ; une valeur erronée corrompt l'analyse en aval.
- Tolérance aux variations de mise en page — la même extraction fonctionne sur les relevés bancaires de Chase, Wells Fargo et Barclays. L'IA lit la structure de chaque document indépendamment ; elle ne dépend pas de la cohérence des positions des champs.
- Prise en charge de l'écriture manuscrite et des photos — la précision du texte imprimé atteint jusqu'à 99 % ; le texte manuscrit est bien traité lorsqu'il est lisible ; les photos de documents papier fonctionnent lorsqu'elles sont bien éclairées et prises de face.
Peut-on simplement utiliser ChatGPT pour cela ?
Oui, ChatGPT (GPT-4o) et les modèles d'IA conversationnelle similaires peuvent extraire des données d'une image de document. Vous téléchargez une capture d'écran de facture, demandez d'en extraire le numéro, la date et le total, et cela fonctionne de manière fiable. Pour une extraction ponctuelle, cela fonctionne.
Les limites apparaissent lorsque vous faites cela à grande échelle :
- Un document à la fois — les interfaces de chat ne sont pas conçues pour le traitement par lots. Télécharger 40 factures une par une et extraire les données de chaque conversation est lent et produit 40 sorties distinctes et non connectées.
- Pas de schéma de colonnes cohérent — chaque réponse de chat est libre. Obtenir 40 réponses de chat qui produisent 40 lignes structurées de manière identique dans le même tableau nécessite un travail supplémentaire pour analyser et fusionner.
- Pas d'export direct — vous ne pouvez pas exporter une conversation de chat sous forme de fichier Excel. Vous devriez copier la sortie dans un tableur manuellement, ou écrire du code pour appeler l'API et gérer le formatage de la réponse vous-même.
- Le contexte ne se transmet pas entre les sessions — votre modèle d'extraction (les colonnes souhaitées) doit être redéfini à chaque nouvelle session de chat.
Un outil d'extraction dédié, construit sur la même IA sous-jacente, gère le flux de traitement par lots, la sortie structurée et l'export Excel que l'interface de chat ne fournit pas. La capacité d'IA est la même ; la différence réside dans la couche de flux de travail qui l'entoure.
Questions fréquemment posées
Quelle est la précision de l'extraction par IA par rapport à la saisie manuelle ?
Pour le texte imprimé sur des PDF clairs et des captures d'écran, la précision des caractères atteint jusqu'à 99 % — comparable à l'OCR traditionnel sur des documents propres. La différence significative réside dans la précision de l'extraction ciblée par champ : l'IA identifie correctement quelle valeur appartient à quelle colonne sur des mises en page variées, là où l'OCR traditionnel exige un modèle personnalisé par mise en page. Pour les documents manuscrits et les photos de papier, la précision est plus faible — modérée à élevée selon la lisibilité. Quelle que soit la méthode, il est recommandé de vérifier par sondage les totaux extraits par rapport aux documents sources avant d'utiliser les données en aval.
Que se passe-t-il lorsque l'IA ne trouve pas un champ demandé ?
La cellule de ce champ reste vide plutôt que d'être remplie avec une valeur voisine. C'est intentionnel : en réconciliation financière, en recherche et dans la plupart des analyses en aval, une cellule vide signale correctement « ce champ n'était pas présent dans le document source ». Une valeur erronée — quelque chose d'adjacent au champ attendu, rempli pour éviter une cellule vide — est pire qu'une cellule vide. Si vous obtenez systématiquement des valeurs vides pour un champ que vous savez présent dans le document, le nom de colonne est peut-être trop ambigu ; essayez une description plus spécifique.
Cela fonctionne-t-il sur les PDF basés sur image (scannés), pas seulement sur les PDF avec couche de texte ?
Oui. L'extraction de données par vision IA traite toutes les entrées comme des images, elle ne dépend donc pas de la présence d'une couche de texte dans le PDF. Un formulaire papier scanné et un PDF généré numériquement avec texte intégré sont traités de la même manière. En pratique, les PDF générés numériquement produisent souvent une entrée plus propre et en plus haute résolution que les photos de téléphone, ce qui peut améliorer la précision sur les petits textes.
Où l'extraction par IA reste-t-elle limitée par rapport à l'OCR traditionnel ?
L'OCR traditionnel sur des documents standardisés à volume élevé avec une impression propre reste plus rapide et moins cher pour les tâches de reconnaissance de caractères pures — si tout ce dont vous avez besoin est le texte brut et que vous l'analyserez vous-même. L'extraction par IA ajoute la couche d'extraction ciblée par champ par-dessus l'OCR, ce qui la rend plus performante pour les mises en page variées mais ajoute un coût de traitement par page. Pour les documents dont la mise en page est parfaitement fixe et ne change jamais (un formulaire gouvernemental spécifique, par exemple), un système d'OCR basé sur des modèles peut être plus rentable. Pour tout ce qui présente des variations de mise en page, des formats mixtes ou de l'écriture manuscrite, l'extraction par IA est l'approche la plus pratique.
L'extraction par IA peut-elle lire l'écriture manuscrite de manière suffisamment fiable pour une utilisation réelle ?
Pour la plupart des écritures manuscrites lisibles — y compris l'écriture cursive — la précision est modérée à élevée. Le texte imprimé reste plus fiable. La recommandation pratique : utilisez l'extraction par IA pour les documents manuscrits lorsque l'alternative est la transcription manuelle, mais vérifiez par sondage une proportion plus élevée de lignes avant d'utiliser les données. Pour les données manuscrites à enjeux élevés (formulaires médicaux, documents juridiques), la vérification par rapport aux enregistrements sources est essentielle quelle que soit la méthode d'extraction.
Essayez avec un document que vous avez — téléversez un PDF ou une image, définissez vos noms de colonnes et observez le résultat de l'extraction ciblée par champ.
Commencer l'extraction