AI画像データ抽出
vs. 従来のOCR:何が違うのか
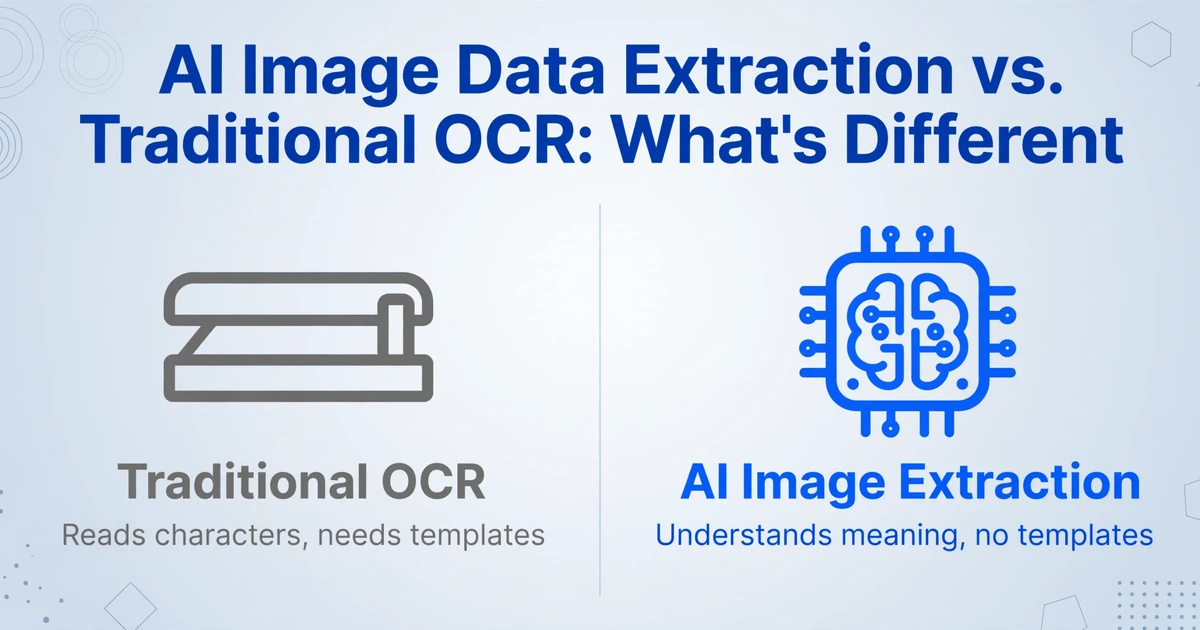
請求書、銀行明細書、スキャンしたフォームの山があるとします。金額、日付、名前など、特定のフィールドをスプレッドシートにまとめる必要があります。OCRツールは何十年も前から存在します。なぜ今でもこれが難しいのでしょうか。答えは、OCRが解決する問題が、実際にあなたが抱えている問題とは異なるからです。ここでは、従来のOCRが何をするのか、AIビジョンモデルがどのように異なるのか、そしてAI抽出を効果的に使う方法について、明確に解説します。
重要なポイント
- 従来のOCRは画像をテキストの流れに変換するだけで、構造化されたフィールドには変換しません。ベンダーごとのレイアウトがそれぞれ別の解析課題となり、フォーマットが変わると機能しなくなります。
- AI抽出は意味を理解してドキュメントを読み取ります。「Invoice No.」「INV#」「Bill Reference」はすべて、テンプレートやピクセル座標マップなしで同じフィールドにマッピングされます。
- テンプレートベースのOCRは、ドキュメントのレイアウトごとに新しい設定が必要です。サプライヤーが請求書フォーマットを変更すると、エラーメッセージも出ずに抽出が静かに失敗します。
- ChatGPTは1つのドキュメントを確実に抽出できますが、バッチ処理、ファイル間での一貫したカラムスキーマの維持、追加作業なしでのExcelへの直接エクスポートはできません。
- OCRは、レイアウトが固定された大量の標準化ドキュメントでは依然として低コストです。AI抽出は、フォーマットが多様な場合、手書き文字が含まれる場合、または意味的なフィールド理解が必要な場合に適したツールです。
「読み取れる」と「構造化されている」のギャップ
ほとんどの業務文書は人間には読めますが、機械には構造化されていません。PDFの請求書は完全に判読可能です。人は見ただけで請求書番号、支払期日、合計金額をすぐに見つけられます。しかし機械にとって、これらの3つの値はテキストのページのどこかに浮かんでいるだけで、周囲のテキストとは位置、フォントサイズ、そして人間の脳が自動的に関連付ける近くのラベルによってのみ区別されます。
これがデータ抽出ツールが橋渡ししようとするギャップです。人間が読める文書を、ソフトウェアが使えるデータに変換することです。「非構造化」とは整理されていないという意味ではなく、情報がデータベースの行やラベル付きのAPIフィールドにないという意味です。情報は、人間が難なく解釈し、機械が常に困難としてきた視覚的なレイアウトの中にあるのです。
この課題は急速に拡大します。請求書1枚なら手入力で3分です。レイアウトがそれぞれ少しずつ異なる5社からの請求書50枚なら、数時間かかり、転記エラーも発生します。自動化の必要性は1枚の文書についてではなく、多数の文書にわたって同じ抽出を一貫して行うことについてです。
従来のOCRが実際に提供するもの
OCR(光学文字認識)は、特定のより狭い問題を解決するために設計されました。テキストの画像を機械可読な文字に変換することです。スキャンしたテキストページが入力され、文字列が出力されます。そのタスクに関して、現代のOCRは優れています。きれいな印刷テキストでの精度は通常99%を超えます。
問題は出力されるものです。OCRは文書を左から右、上から下に読み取り、テキストストリームを返します。仕入先の請求書を入力すると、次のような結果が得られます。
ACME Supplies Ltd
123 Commerce Street, Chicago IL 60601
INVOICE
Invoice No: INV-2024-0892    Date: March 15, 2024
Bill To: Greenfield Corp     Due: April 14, 2024
Description        Qty    Unit Price    Amount
Office chairs       4       $285.00    $1,140.00
Desk lamps         10        $45.00      $450.00
                                 Total: $1,590.00
テキストはそこにあるのに、また同じ問題に直面します。どの行が請求書番号でしょうか?どの日付が発行日で、どの日付が支払期限でしょうか?20社の異なるベンダーから50枚の請求書を処理する場合、各社が「請求書番号」を異なる場所に配置し、日付の形式も異なり、列ラベルも異なります。各ベンダーのレイアウトは、それぞれ別の解析課題となります。
テンプレートベースのOCRシステムは、ベンダーごとのテンプレートでこれを解決します。ドキュメントタイプごとに各フィールドのピクセル座標を定義するのです。これはドキュメントセットが固定され均一な場合に機能します。しかし、ベンダーが請求書レイアウトを変更したり、新しいサプライヤーを追加したりすると、機能しなくなります。
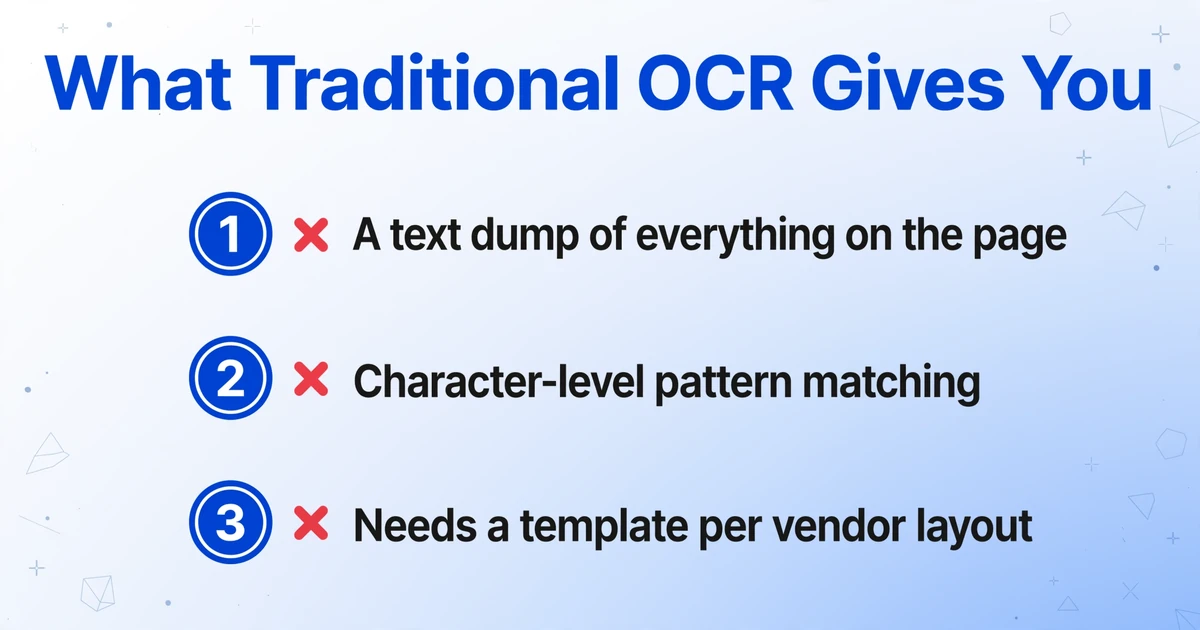
従来のOCR:得られるもの
- ✗ ページ上のすべてのテキストのダンプ
- ✗ 文字レベルのパターンマッチングのみ
- ✗ レイアウト依存:ドキュメントタイプごとに新しいテンプレートが必要
- ✗ 手書き、写真、特殊なフォントに弱い
- ✗ 各フィールドを自分で見つけてマッピングする必要がある
AI画像データ抽出:得られるもの
- ✓ リクエストしたフィールドのみ、すでに列に整理済み
- ✓ フィールドの意味をセマンティックに理解
- ✓ レイアウト非依存:1つのプロンプトで複数の形式に対応
- ✓ 手書き、写真、混合形式に対応
- ✓ Excelにそのまま出力可能 — 後処理不要
AI画像モデルによる抽出方法の違い
AI画像モデル(GPT-4o、Claude、Gemini、専門的なドキュメントAIなどを含むカテゴリ)は、抽出の問題に対して異なるアプローチを取ります。テキストストリーム内の文字をパターンマッチングする代わりに、ドキュメントを意味的に理解します。つまり、ドキュメントが何であるか、各セクションが何を意味するか、異なる視覚要素が互いにどう関連するかを理解します。
実際の結果として、「請求書番号」を要求すると、ドキュメントが「Invoice No.」「INV#」「Bill Reference」「Reference ID」のいずれでラベル付けされていても、モデルはそれを見つけ出します。これらが商業請求書の文脈において同等の概念であると理解しているのです。テンプレートも座標マッピングも不要で、フィールド対象の抽出だけです。
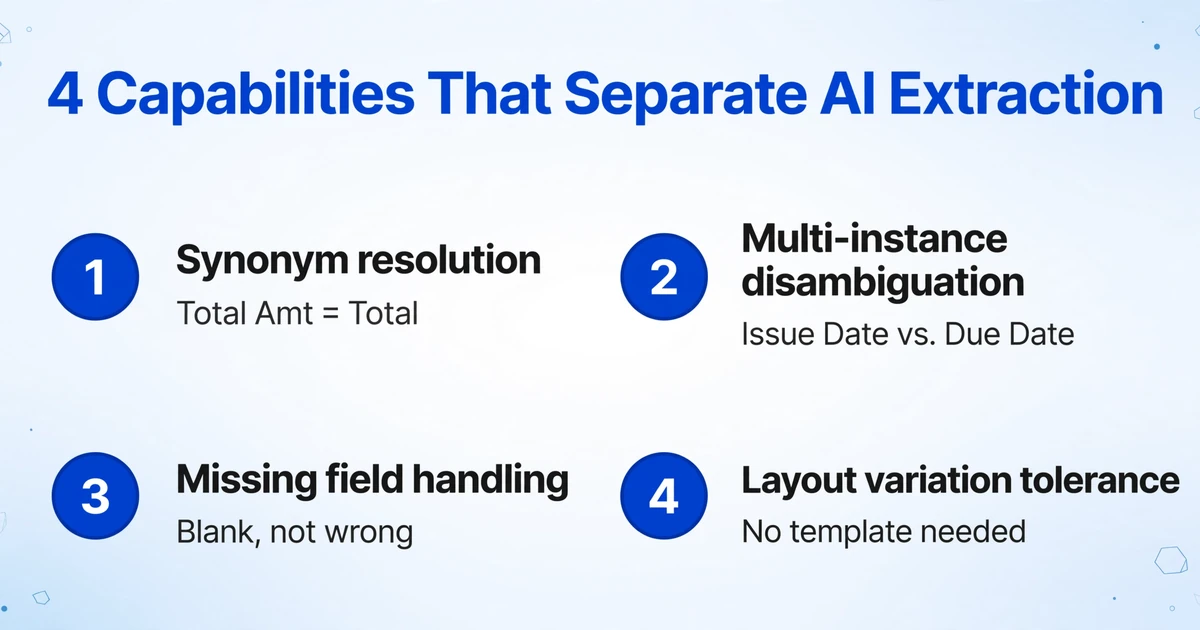
AI抽出をOCRから区別する具体的な機能をいくつか挙げます:
- 同義語・略語の解決 — 「Total Amt」「Grand Total」「Amount Due」「Total」はすべて同じフィールドにマッピングされます。モデルは請求書の語彙を理解しています。
- 複数インスタンスの曖昧性解消 — ドキュメントに5つの異なる日付がある場合、「発行日」を要求すると、納期や支払期日ではなく、ドキュメントの作成日が返されます。列名のフィールド指定が抽出を導きます。
- 欠落フィールドの処理 — 要求したフィールドが特定のドキュメントに存在しない場合、近くの値で埋めるのではなく、セルは空白のままになります。これは重要です。財務照合や調査において、空白はデータ欠落を正しく示し、誤った値は下流の分析を破壊します。
- レイアウト変動への耐性 — 同じ抽出がChase、Wells Fargo、Barclaysの銀行明細書で機能します。AIは各ドキュメントの構造を独立して読み取るため、フィールド位置の一貫性に依存しません。
- 手書き文字・写真への対応 — 印刷テキストの精度は最大99%に達します。手書き文字は読みやすい筆記であれば良好に処理されます。紙のドキュメントの写真は、明るく正面から撮影されていれば機能します。
これにChatGPTをそのまま使えますか?
はい、ChatGPT(GPT-4o)などのチャットベースのAIモデルでも、文書画像からデータを抽出できます。請求書のスクリーンショットをアップロードし、請求書番号、日付、合計金額を抽出するよう依頼すれば、確実に実行してくれます。一度きりの抽出であれば、これで十分機能します。
ただし、これを大規模に行う場合に限界が現れます:
- 一度に1文書のみ — チャットインターフェースはバッチ処理向けに設計されていません。請求書40枚を1枚ずつアップロードして各会話から抽出するのは時間がかかり、40件の独立した出力が生成されます。
- 一貫したカラムスキーマがない — 各チャット応答は自由形式です。40件のチャット応答から同じテーブル内の同一構造の40行を生成するには、解析と統合のための追加作業が必要です。
- 直接エクスポート不可 — チャット会話をExcelファイルとしてエクスポートすることはできません。出力を手動でスプレッドシートにコピーするか、APIを呼び出してレスポンス形式を自分で処理するコードを書く必要があります。
- コンテキストがセッション間で引き継がれない — 抽出テンプレート(必要な列)は、新しいチャットセッションごとに再指定する必要があります。
同じ基盤AI上に構築された専用の抽出ツールは、チャットインターフェースでは提供されないバッチワークフロー、構造化出力、Excelエクスポートを処理します。AIの能力は同じですが、その周囲のワークフロー層が異なります。
よくある質問
AI抽出は手入力と比べてどの程度正確ですか?
鮮明なPDFやスクリーンショット上の機械印字テキストの場合、印字文字の精度は最大99%に達します。これは、クリーンな文書に対する従来のOCRと同等です。大きな違いはフィールド対象の抽出精度です。AIは、さまざまなレイアウトにわたってどの値がどの列に属するかを正しく識別しますが、従来のOCRではレイアウトごとにカスタムテンプレートが必要です。手書き文書や紙の写真の場合、精度は低くなり、読みやすさに応じて中程度から高程度になります。方法に関係なく、抽出した合計値を下流で使用する前に、ソース文書と照合してスポットチェックすることをお勧めします。
AIが要求したフィールドを見つけられない場合はどうなりますか?
そのフィールドのセルは、近くの値で埋められるのではなく、空白のままになります。これは意図的なものです。財務照合、調査、およびほとんどの下流分析では、空白セルは「このフィールドはソース文書に存在しなかった」ことを正しく示します。空白セルを避けるために期待フィールドの隣の値で埋められた誤った値は、空白よりも悪い結果になります。文書に存在することがわかっているフィールドで一貫して空白値が返される場合は、列名が曖昧すぎる可能性があります。より具体的な説明を試してください。
テキストレイヤー付きPDFだけでなく、画像ベース(スキャン)のPDFでも機能しますか?
はい。AI画像データ抽出はすべての入力を画像として処理するため、PDFにテキストレイヤーがあるかどうかに依存しません。スキャンした紙のフォームと、埋め込みテキストを含むデジタル生成PDFは、同じ方法で処理されます。実際には、デジタル生成PDFはスマートフォンの写真よりもクリーンで高解像度の入力になることが多く、小さなテキストの精度を向上させることができます。
従来のOCRと比較して、AI抽出がまだ苦手とする点はどこですか?
高ボリュームで標準化されたクリーンな印字文書に対する従来のOCRは、純粋な文字認識タスクでは今でもより高速で低コストです。生のテキストだけが必要で、自分で解析する場合には適しています。AI抽出はOCRの上にフィールド対象の抽出レイヤーを追加するため、さまざまなレイアウトに対応できますが、ページあたりの処理コストが増加します。レイアウトが完全に固定され、変更されることのない文書(特定の政府フォームなど)の場合、テンプレートベースのOCRシステムの方がコスト効率が高い場合があります。レイアウトのバリエーション、混合フォーマット、または手書きを含むものには、AI抽出の方が実用的なアプローチです。
AI抽出は実際の使用に十分な信頼性で手書き文字を読み取れますか?
ほとんどの読みやすい手書き文字(筆記体を含む)の場合、精度は中程度から高程度です。機械印字テキストは引き続きより信頼性が高くなります。実用的な推奨事項:手書き文書には、手動転写の代替手段としてAI抽出を使用しますが、データを使用する前に、より高い割合の行をスポットチェックしてください。重要度の高い手書きデータ(医療フォーム、法的文書)の場合、抽出方法に関係なく、ソース記録との照合が不可欠です。
お持ちのドキュメントでお試しください — PDFや画像をアップロードし、列名を定義して、フィールド対象の出力をご確認ください。
抽出を開始