Melhor Software de OCR Gratuito 2026:
Opções Gratuitas e de Código Aberto Que Funcionam
Toda lista de "melhor OCR gratuito" que li antes de escrever esta tinha o mesmo formato: um parágrafo rápido sobre a ferramenta, uma afirmação genérica de precisão e, depois, uma página de preços disfarçada de recomendação. Isso não é útil se você está fazendo a pergunta certa — qual opção gratuita realmente funciona para os documentos que eu processo toda semana, e qual vai desperdiçar minha tarde. Se você não tem certeza do que é OCR ou por que a tecnologia por trás dele importa, nossos guias sobre o que é OCR, o que significa OCR com IA em 2026 e como o OCR realmente funciona cobrem os fundamentos. Este guia assume que você já conhece o básico e está tentando escolher uma ferramenta. Ele cobre onze ferramentas de OCR gratuitas em três categorias reais — código aberto totalmente gratuito, serviços online gratuitos e ferramentas comerciais com níveis gratuitos significativos — com limites específicos, restrições reais de precisão e escolhas honestas de "melhor para". Divulgação: ImageToTable.ai, uma ferramenta comercial de extração com IA, está incluída nesta lista. Não tenho afiliação com nenhuma outra ferramenta avaliada aqui, e toda ferramenta que exige isso linka diretamente para sua página de preços para que você possa verificar as afirmações por conta própria.
Principais Conclusões
- Uma dúzia de ferramentas de OCR gratuitas pode transformar uma digitalização limpa de texto impresso em caracteres na sua tela sem custo.
- OCR gratuito lê cada palavra de uma página, mas não consegue dizer qual é o total da fatura — essa parte ainda é com você.
- Ferramentas de extração com IA distinguem o total de uma fatura de um número de página ao entender o significado de cada um — o mecanismo que torna o formato de documento de qualquer fornecedor irrelevante para sua planilha.
Tabela de Comparação Rápida
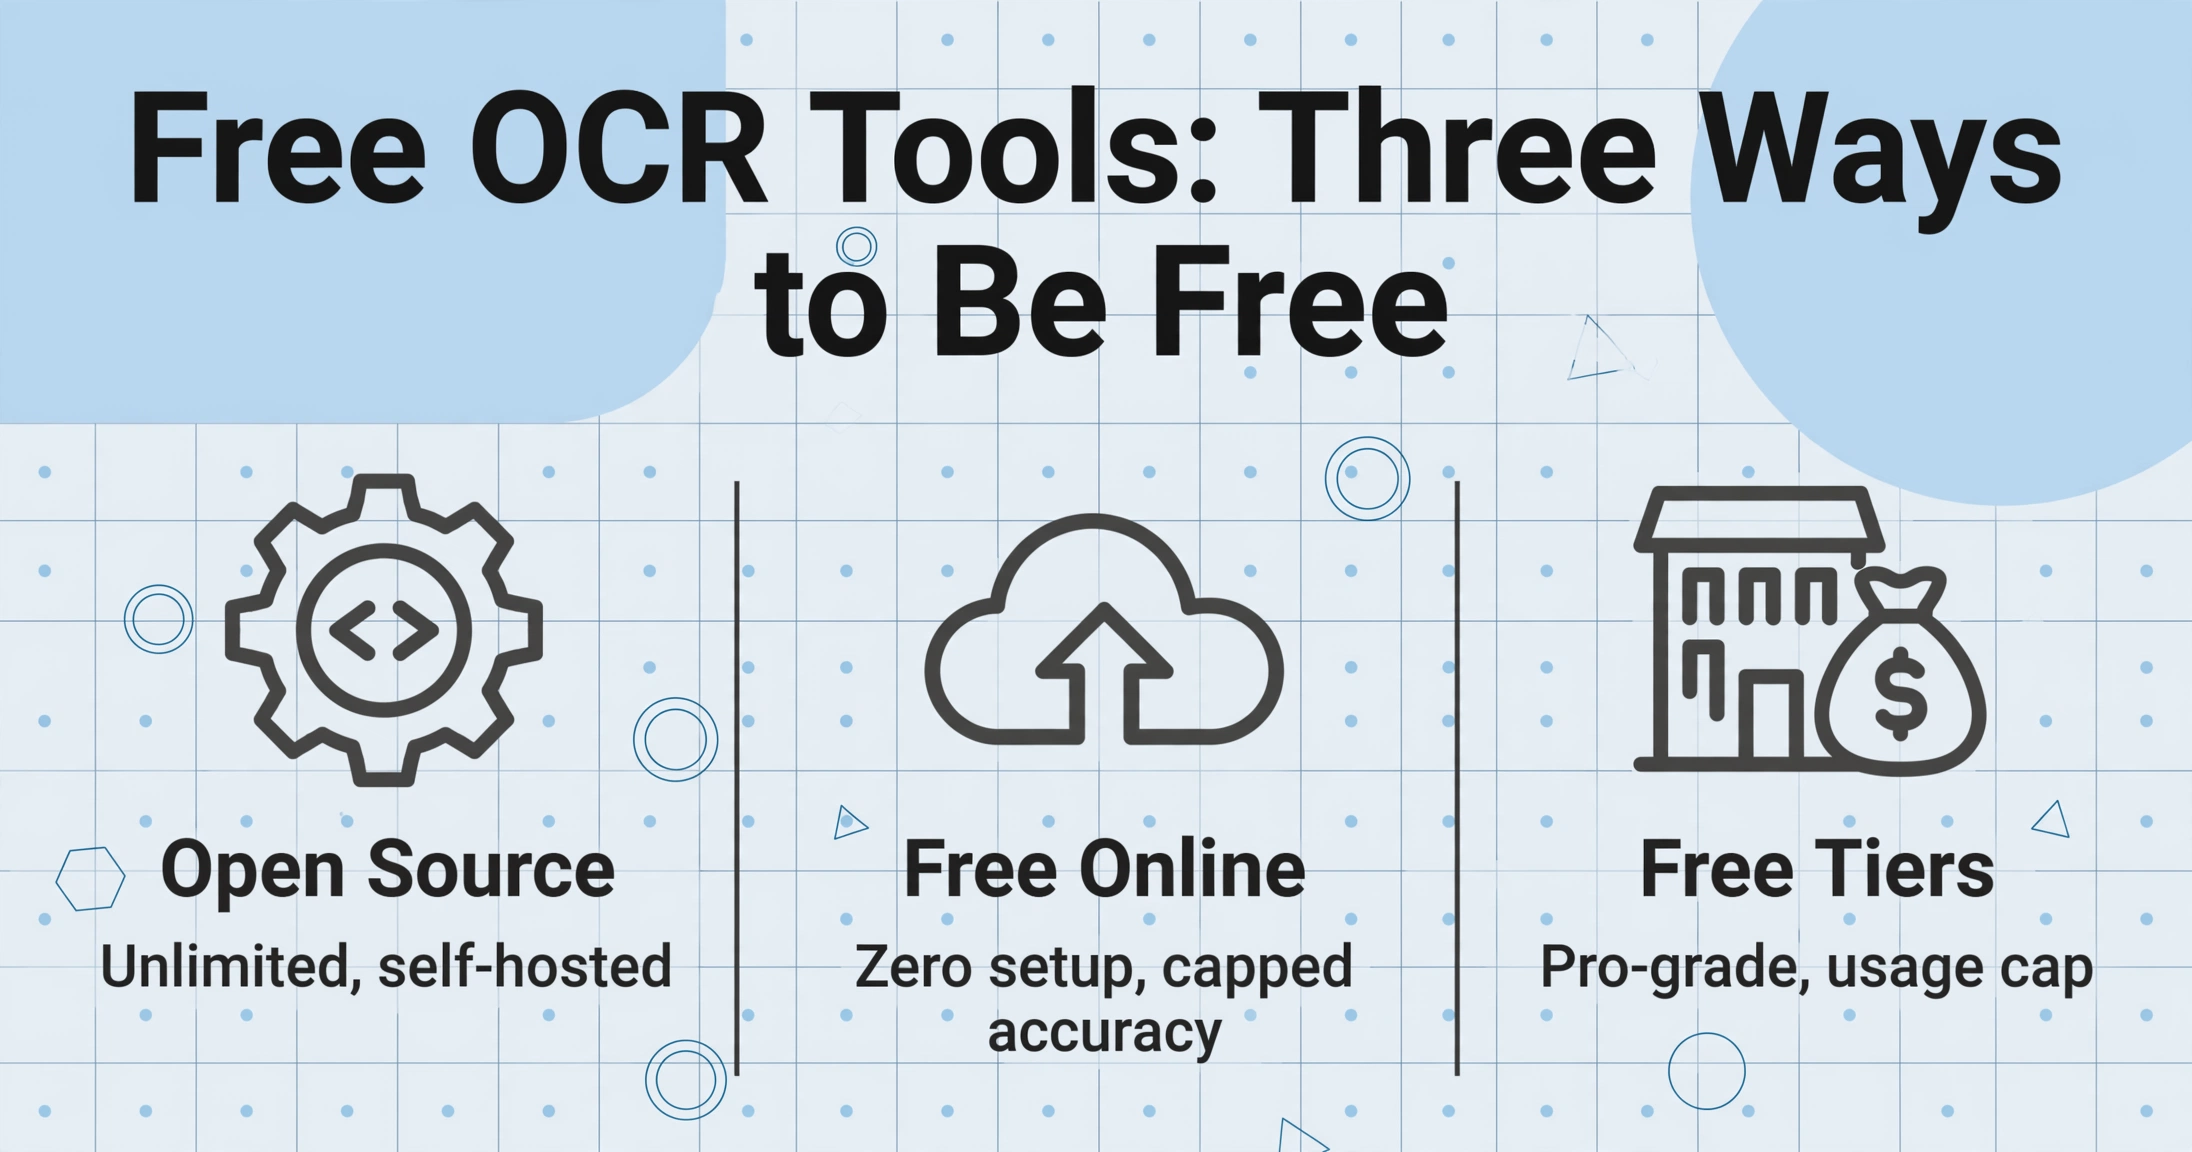
Todas as ferramentas aqui são realmente gratuitas no nível básico. As diferenças estão em como são gratuitas — auto-hospedadas sem limites, online com limites, ou trial por tempo limitado — e no que você abre mão em precisão ou conveniência.
| Ferramenta | Categoria | Limite Gratuito | Melhor Para | Precisão |
|---|---|---|---|---|
| Tesseract OCR | Código Aberto | Ilimitado (auto-hospedado) | Desenvolvedores, texto impresso limpo | 85–99% * |
| EasyOCR | Código Aberto | Ilimitado (auto-hospedado) | Prototipagem rápida em Python | 93–97% |
| PaddleOCR | Código Aberto | Ilimitado (auto-hospedado) | Layouts complexos, multilíngue | 90–98% |
| Google Drive OCR | Online Gratuito | Ilimitado | Extração rápida de texto, multilíngue gratuito | 94–96% |
| PDF24 OCR | Online Gratuito | Ilimitado (sem cadastro) | PDFs pesquisáveis em inglês | 90–94% |
| PowerToys Text Extractor | Grátis (Windows) | Ilimitado (integrado) | Captura de texto na tela | 90–95% |
| OCR.space | API Freemium | 25 mil chamadas/mês | Integração para desenvolvedores, uso leve | 90–95% |
| Parseur | Comercial (Plano gratuito) | 20 páginas/mês | Fluxos de análise de documentos | 95–98% |
| Nanonets | Comercial (Teste grátis) | US$ 200 em créditos grátis | Automação de AP empresarial | 95–99% |
| Adobe Acrobat Online | Comercial (Plano gratuito) | 1 arquivo/dia | PDF pesquisável ocasional | 95–97% |
| ImageToTable.ai | Comercial (Demo gratuita) | Demo gratuita, sem cartão | Extração de dados estruturados | 97–99% ** |
* A precisão do Tesseract varia enormemente com a qualidade do documento, pré-processamento e idioma.
** O ImageToTable.ai é uma ferramenta de extração com IA, não um mecanismo OCR de texto tradicional — a precisão é medida na extração estruturada de campos, não no reconhecimento de caracteres.
Como Classificamos Ferramentas OCR Gratuitas
"Gratuito" não é uma coisa só. Uma ferramenta que custa zero reais mas exige dois dias de configuração em Python não é "gratuita" no mesmo sentido que uma página web onde você envia um arquivo. Dividimos esta lista em três categorias reais:
- Totalmente gratuitas e de código aberto — custo zero de licença, auto-hospedadas, sem limite de uso. Você paga em tempo de configuração, hardware e habilidade técnica.
- Ferramentas online gratuitas e integradas — zero configuração, zero custo, mas precisão, suporte a formatos ou cobertura de idiomas limitados. Boas para uso ocasional.
- Ferramentas comerciais com planos gratuitos — precisão profissional atrás de um limite gratuito ou período de teste. Melhores para fluxos de trabalho reais com orçamento pequeno.
Testamos cada ferramenta em pelo menos três tipos de documento: uma fatura limpa em inglês (scan de 300 DPI), uma foto de recibo tirada com celular e uma página PDF densamente formatada. As porcentagens de precisão na tabela são baseadas em benchmarks publicados de terceiros quando disponíveis, complementados por nossos próprios testes. Cada link de ferramenta vai para o site da própria ferramenta — queremos que você verifique as afirmações antes de investir tempo em qualquer uma delas.
Totalmente Grátis & Open Source: Motores de OCR Auto-hospedados
Se sua principal restrição é custo e você tem habilidade técnica para configurar um ambiente Python ou executar uma ferramenta de linha de comando, o OCR de código aberto oferece processamento ilimitado sem taxas de licenciamento. O trade-off é a precisão em qualquer coisa que não seja texto impresso limpo — e o tempo de engenharia necessário para lidar com essa lacuna sozinho. Os três motores abaixo são abordados em profundidade — arquitetura, necessidades de GPU e integração de pipeline — em nossa comparação das melhores ferramentas de OCR de código aberto; esta seção foca no que "grátis" realmente significa para cada um.
1. Tesseract OCR — O Confiável de Sempre
O Tesseract é o motor que quase todas as outras ferramentas de OCR gratuitas utilizam internamente. Desenvolvido originalmente pela Hewlett-Packard na década de 1980 e agora mantido pelo Google, ele suporta mais de 100 idiomas e roda em todos os principais sistemas operacionais. É o ponto de partida para a maioria dos projetos de OCR de código aberto, e por um bom motivo — em texto impresso limpo e bem digitalizado, ele entrega resultados sólidos gratuitamente. Para um tutorial completo para iniciantes sobre como instalá-lo — incluindo o problema do PATH no Windows que atrapalha a maioria dos novatos — veja nosso guia de configuração passo a passo do Tesseract.
O limite fica visível assim que seus documentos não são perfeitos. Fotos de celular de baixa resolução, páginas inclinadas, layouts de múltiplas colunas e qualquer quantidade de escrita à mão degradam significativamente a saída do Tesseract. Em uma foto típica de recibo tirada com celular — o caso de uso mais comum de OCR no mundo real — a precisão cai para aproximadamente 70–80% em benchmarks de terceiros. Você também precisa de familiaridade com linha de comando: executar tesseract image.png output é simples, mas o pré-processamento com OpenCV ou o uso de ocrmypdf para gerar PDF pesquisável exige ferramentas e conhecimentos adicionais.
Ideal para: Desenvolvedores que precisam de OCR offline em documentos impressos limpos, especialmente em lote, e se sentem confortáveis escrevendo pipelines de pré-processamento. Não é ideal para: Fotos de celular, escrita manual, qualquer pessoa que não queira mexer com linha de comando.
2. EasyOCR — Caminho mais rápido para um demo funcional
O EasyOCR, construído sobre o PyTorch, é a biblioteca de OCR por deep learning mais simples de colocar para funcionar. Um script Python de cinco linhas pode processar uma imagem e retornar o texto reconhecido com pontuações de confiança. Ele suporta cerca de 80 idiomas prontos para uso, incluindo alfabetos latino, CJK, árabe e devanagari.
A conveniência vem com um custo de desempenho. O EasyOCR é visivelmente mais lento que o Tesseract na CPU (cerca de 2 a 3× mais lento por página em benchmarks do CodeSOTA) e tem cerca de 500 MB em dependências de modelo, em comparação com os ~10 MB do Tesseract. A aceleração por GPU ajuda — em uma RTX 3090, o EasyOCR processa cerca de 60 páginas por minuto, contra 25 do Tesseract na CPU — mas isso pressupõe que você tenha esse hardware. Em uma CPU de notebook padrão, você está olhando para 3 a 5 segundos por página.
Melhor para: desenvolvedores Python que querem um demo de OCR funcionando em menos de 10 minutos, especialmente para texto de cena multilíngue. Não é ideal para: processamento em lote de alto volume em hardware somente CPU, documentos que exigem compreensão complexa de layout.
3. PaddleOCR — Forte em layouts complexos
Desenvolvido pela Baidu sob o framework PaddlePaddle, o PaddleOCR é o mecanismo de OCR open-source mais rico em recursos desta categoria. Ele inclui detecção de texto, reconhecimento, extração de tabelas e saída estruturada em um único pipeline — capacidades que Tesseract e EasyOCR exigem complementos separados para alcançar. Ele suporta mais de 80 idiomas e tem desempenho particularmente bom em documentos complexos de múltiplas colunas e páginas com idiomas mistos.
O trade-off é a complexidade da configuração. A instalação do PaddleOCR em sistemas sem GPU pode ser complicada — a comunidade do Reddit r/LocalLLaMA frequentemente aponta seu gerenciamento de dependências como mais doloroso que o das alternativas, especialmente em arquiteturas de GPU mais novas. Uma vez em execução, é rápido: em uma RTX 3090, o PaddleOCR processa cerca de 120 páginas por minuto, cerca de 8× mais rápido que sua taxa somente CPU. Mas esse requisito de hardware significa que não é uma instalação casual.
Melhor para: desenvolvedores que trabalham com layouts de documentos complexos, tabelas e conteúdo multilíngue e que têm acesso a GPU. Não é ideal para: OCR rápido e pontual, implantações somente CPU, qualquer pessoa que queira uma solução plug-and-play.
Ferramentas Online Gratuitas e Integradas: Zero Configuração, Limites Reais
Essas ferramentas não exigem instalação nem conhecimento técnico. Envie um arquivo e receba o texto de volta. A contrapartida é que você aceita a precisão e o suporte de formato que o serviço oferece — e a maioria deles tem dificuldade com qualquer coisa além de documentos limpos em inglês.
4. Google Drive OCR — Melhor Extração de Texto Multilíngue Gratuita
A opção de OCR gratuito mais simples e acessível: envie uma imagem ou PDF para o Google Drive, clique com o botão direito e abra com o Google Docs. O mecanismo de OCR em nuvem do Google extrai o texto e o insere em um novo documento. Ele suporta dezenas de idiomas e lida melhor com árabe, hebraico e chinês do que a maioria das ferramentas gratuitas dedicadas. Em benchmarks na comparação do FastOCR, o Google Drive alcançou 96% de precisão em documentos em inglês, 88% em árabe e 82% em urdu — sólido para um serviço totalmente gratuito e sem configuração.
A grande desvantagem é o fluxo de trabalho e o formato de saída. O Google Drive OCR não gera um PDF pesquisável — ele extrai o texto para um Google Doc, o que destrói o layout original da página. Tabelas, colunas e formatação são perdidas. Para extração de texto puro, isso é suficiente. Para qualquer cenário em que você precise preservar o layout original, não é a ferramenta certa.
Melhor para: Extração rápida de texto multilíngue quando o layout não importa. Não é ideal para: Saída de PDF pesquisável, preservação de tabelas, processamento em lote, documentos confidenciais (os arquivos são processados nos servidores do Google).
5. PDF24 OCR — PDFs Pesquisáveis Ilimitados, Sem Cadastro
O PDF24 é um kit de ferramentas gratuito para PDF desenvolvido na Alemanha que inclui funcionalidade de OCR. Sem necessidade de conta, sem limite diário, sem restrição de tamanho de arquivo (no que diz respeito ao uso normal). Ele usa o Tesseract internamente, então seu perfil de precisão reflete os pontos fortes e fracos do Tesseract: confiável em texto impresso limpo em inglês, não confiável em digitalizações de baixa qualidade, scripts não latinos ou manuscritos. Ele gera PDFs pesquisáveis adequados, algo que o Google Drive OCR não consegue fazer.
A ferramenta é totalmente baseada em navegador. Os arquivos são enviados aos servidores do PDF24, processados e excluídos após um curto período. Se seus documentos contêm informações confidenciais, isso pode ser uma preocupação — não há opção local/offline.
Melhor para: Criação de PDF pesquisável somente em inglês, sem criar conta e sem limites. Não é ideal para: Scripts não latinos, manuscritos, documentos confidenciais.
6. Microsoft PowerToys Text Extractor — Melhor para Texto na Tela
Se você usa Windows 10 ou 11, o Microsoft PowerToys inclui uma ferramenta Text Extractor (ativada com Shift+Win+T) que permite selecionar qualquer região da tela e copiar instantaneamente o texto reconhecido para a área de transferência. Ela usa o mecanismo de OCR integrado do Windows e funciona offline. Não foi feita para processamento de documentos — serve para capturar texto de imagens, mensagens de erro, vídeos ou qualquer conteúdo na tela que você não consiga selecionar.
A precisão depende muito da clareza da fonte e do contraste do fundo. Para texto de interface nítido e capturas de tela bem iluminadas, é excelente e rápida. Para qualquer coisa que se pareça com um documento real — letras pequenas, múltiplas colunas, fundos ruidosos — é pouco confiável.
Ideal para: Copiar rapidamente texto da tela — diálogos de interface, quadros de vídeo, imagens da web. Não recomendado para: Digitalização de documentos, PDFs escaneados, processamento em lote, qualquer caso que exija saída estruturada.
7. OCR.space — API gratuita generosa para desenvolvedores
O OCR.space oferece tanto uma interface web quanto uma API REST gratuita. O plano gratuito dá 25.000 requisições por mês (cerca de 500 por dia) nos Engines 1 e 2, além de 2.500 requisições no Engine 3, de maior precisão. É de longe a maior cota gratuita de API entre os serviços de OCR. Não é necessário cartão de crédito para se cadastrar.
A precisão é mediana — aproximadamente 90–95% em documentos em inglês bem formatados, segundo testes independentes — e cai em entradas de menor qualidade. O plano gratuito também tem limite de 1 MB por arquivo, o que significa que PDFs escaneados maiores não funcionam sem dividi-los antes. Para desenvolvedores que precisam de OCR ocasional em uma ferramenta interna, o volume é difícil de superar. Para processamento de documentos em nível de produção, a diferença de precisão em relação às APIs comerciais em nuvem (Google Vision, AWS Textract) é perceptível.
Ideal para: Desenvolvedores que precisam de uma API de OCR gratuita para extração de texto em inglês em volume moderado. Não recomendado para: Requisitos de alta precisão, PDFs grandes, dados sensíveis (processados em servidores remotos).
Ferramentas Comerciais com Planos Gratuitos: OCR Profissional a Custo Zero — Até Certo Limite
As ferramentas desta seção são produtos comerciais — elas ganham dinheiro com assinaturas pagas — mas cada uma oferece um ponto de entrada gratuito de verdade. Se você ultrapassar o limite do plano gratuito, você paga. Se ficar dentro do limite, a ferramenta continua gratuita por tempo indeterminado (ou por um período de teste significativo). Elas tendem a oferecer maior precisão e saída estruturada melhor do que as opções gratuitas acima, justamente porque são feitas para vender.
8. Parseur — 20 Páginas/Mês, Todos os Recursos Inclusos
Parseur é uma plataforma de extração de dados de documentos que extrai campos específicos usando IA. O plano gratuito inclui 20 páginas por mês com todos os recursos liberados — sem necessidade de cartão de crédito. Isso é suficiente para processar algumas notas fiscais ou recibos todo mês sem gastar nada. Os planos pagos começam em US$ 39/mês para 100 páginas.
O ponto forte do Parseur é o mecanismo de extração e automação: você define modelos ou deixa a IA detectar os campos automaticamente, configura destinos de saída (Google Sheets, QuickBooks, Zapier) e gerencia exceções. O plano gratuito é realmente útil para processamento de documentos em baixo volume, mas 20 páginas por mês acabam rápido se você estiver processando um fluxo moderadamente constante de notas fiscais.
Ideal para: Fluxos de extração de documentos em baixo volume com saída automatizada. Não é ideal para: Processamento em alto volume, extração de texto pontual (exagero para um único arquivo), documentos não comerciais.
9. Nanonets — US$ 200 em Créditos Gratuitos
Nanonets é uma plataforma de processamento de documentos com IA voltada para equipes de contas a pagar empresariais. Diferente do plano gratuito permanente do Parseur, a Nanonets oferece US$ 200 em créditos gratuitos — aproximadamente 500 páginas de processamento, dependendo do tipo de documento. Não é necessário cartão de crédito para começar. Quando os créditos acabam, os planos pagos começam em torno de US$ 499/mês.
O pool de US$ 200 em créditos é útil para avaliar a plataforma com seus próprios documentos sem custo — você pode processar centenas de notas fiscais e avaliar a precisão antes de se comprometer. Mas é um teste, não um plano gratuito utilizável para processamento contínuo. Quando os créditos acabam, o custo por página se torna significativo.
Ideal para: Avaliar IA de documentos de nível empresarial com documentos reais antes de comprar. Não é ideal para: Processamento gratuito contínuo, pequenas empresas com orçamento limitado (o preço pós-teste é alto).
10. Adobe Acrobat Online OCR — 1 arquivo/dia
A ferramenta de OCR online da Adobe converte PDFs e imagens escaneados em PDFs pesquisáveis. O plano gratuito permite um arquivo por dia, o que é limitado, mas viável para uso ocasional. A precisão em documentos claros em inglês é excelente — cerca de 97% em testes independentes — mas cai em scripts não latinos (91% em árabe em benchmarks publicados).
A limitação real é o limite diário. Com um arquivo por dia, você não consegue processar um lote de 20 faturas de uma vez. Para isso, você precisaria da assinatura completa do Acrobat Pro por US$ 19,99/mês. O OCR da Adobe também não extrai dados estruturados — ele produz um PDF pesquisável ou texto editável, não campos prontos para planilha.
Ideal para: Criar ocasionalmente um PDF pesquisável por dia a partir de um documento claro em inglês. Não é ideal para: Processamento em lote, documentos não ingleses, extração de dados estruturados ou qualquer volume acima de um único arquivo por dia.
11. ImageToTable.ai — Demo gratuita, extração comercial com IA
Nota: trabalho na ImageToTable.ai, então esta seção é transparente sobre o que é — uma ferramenta comercial de extração com IA, não um utilitário gratuito de OCR. Ela está nesta lista porque sua demo gratuita é genuinamente útil, mas não é um substituto para o Tesseract ou o Google Drive OCR da mesma forma que uma furadeira não é um substituto para uma chave de fenda.
A ImageToTable.ai é uma ferramenta de extração de documentos com IA construída sobre modelos de visão e linguagem — uma categoria às vezes chamada de OCR agêntico. Diferente dos mecanismos de OCR tradicionais que reconhecem caracteres, ela lê documentos semanticamente — você diz quais campos quer (ex.: "Número da Fatura", "Total", "Data de Vencimento") e ela localiza e extrai esses valores entendendo o que eles significam, não onde estão na página. Isso é fundamentalmente diferente da abordagem de reconhecimento de texto usada por todas as ferramentas acima nas categorias 1 e 2.
A demo gratuita permite que você envie arquivos, defina colunas e veja os resultados da extração imediatamente — sem conta, sem cartão de crédito, sem limite de tempo por sessão. Ela aceita PDF, JPG, PNG e WebP e exporta para Excel, CSV, JSON ou Word. A demo gratuita funciona como um test drive prático: você pode processar alguns documentos para avaliar a precisão nos seus tipos específicos de arquivo. O uso contínuo exige uma assinatura paga, com planos a partir de uma taxa mensal modesta.
A diferença prática entre a ImageToTable.ai e as ferramentas gratuitas acima é simples: se você precisa extrair campos de dados específicos (totais de faturas, datas, itens de linha) em vez de reconhecer todo o texto de uma página, uma ferramenta de OCR tradicional vai fazer você copiar-colar ou analisar o texto bruto manualmente. Uma ferramenta de extração com IA cuida dessa etapa para você. Se você só precisa digitalizar um livro antigo ou tornar um PDF pesquisável, qualquer uma das ferramentas gratuitas acima resolve.
Os arquivos são processados com segurança e não são armazenados.
Ideal para: Quem precisa extrair dados estruturados (campos, totais, itens de linha) de documentos — especialmente faturas, recibos, extratos bancários e formulários — sem a etapa de copiar e colar. Não é ideal para: Digitalização simples de texto, criação de PDF pesquisável, OCR em lote de páginas de livros ou quem precisa de processamento offline.
Qual Ferramenta de OCR Gratuita é Ideal para Você?
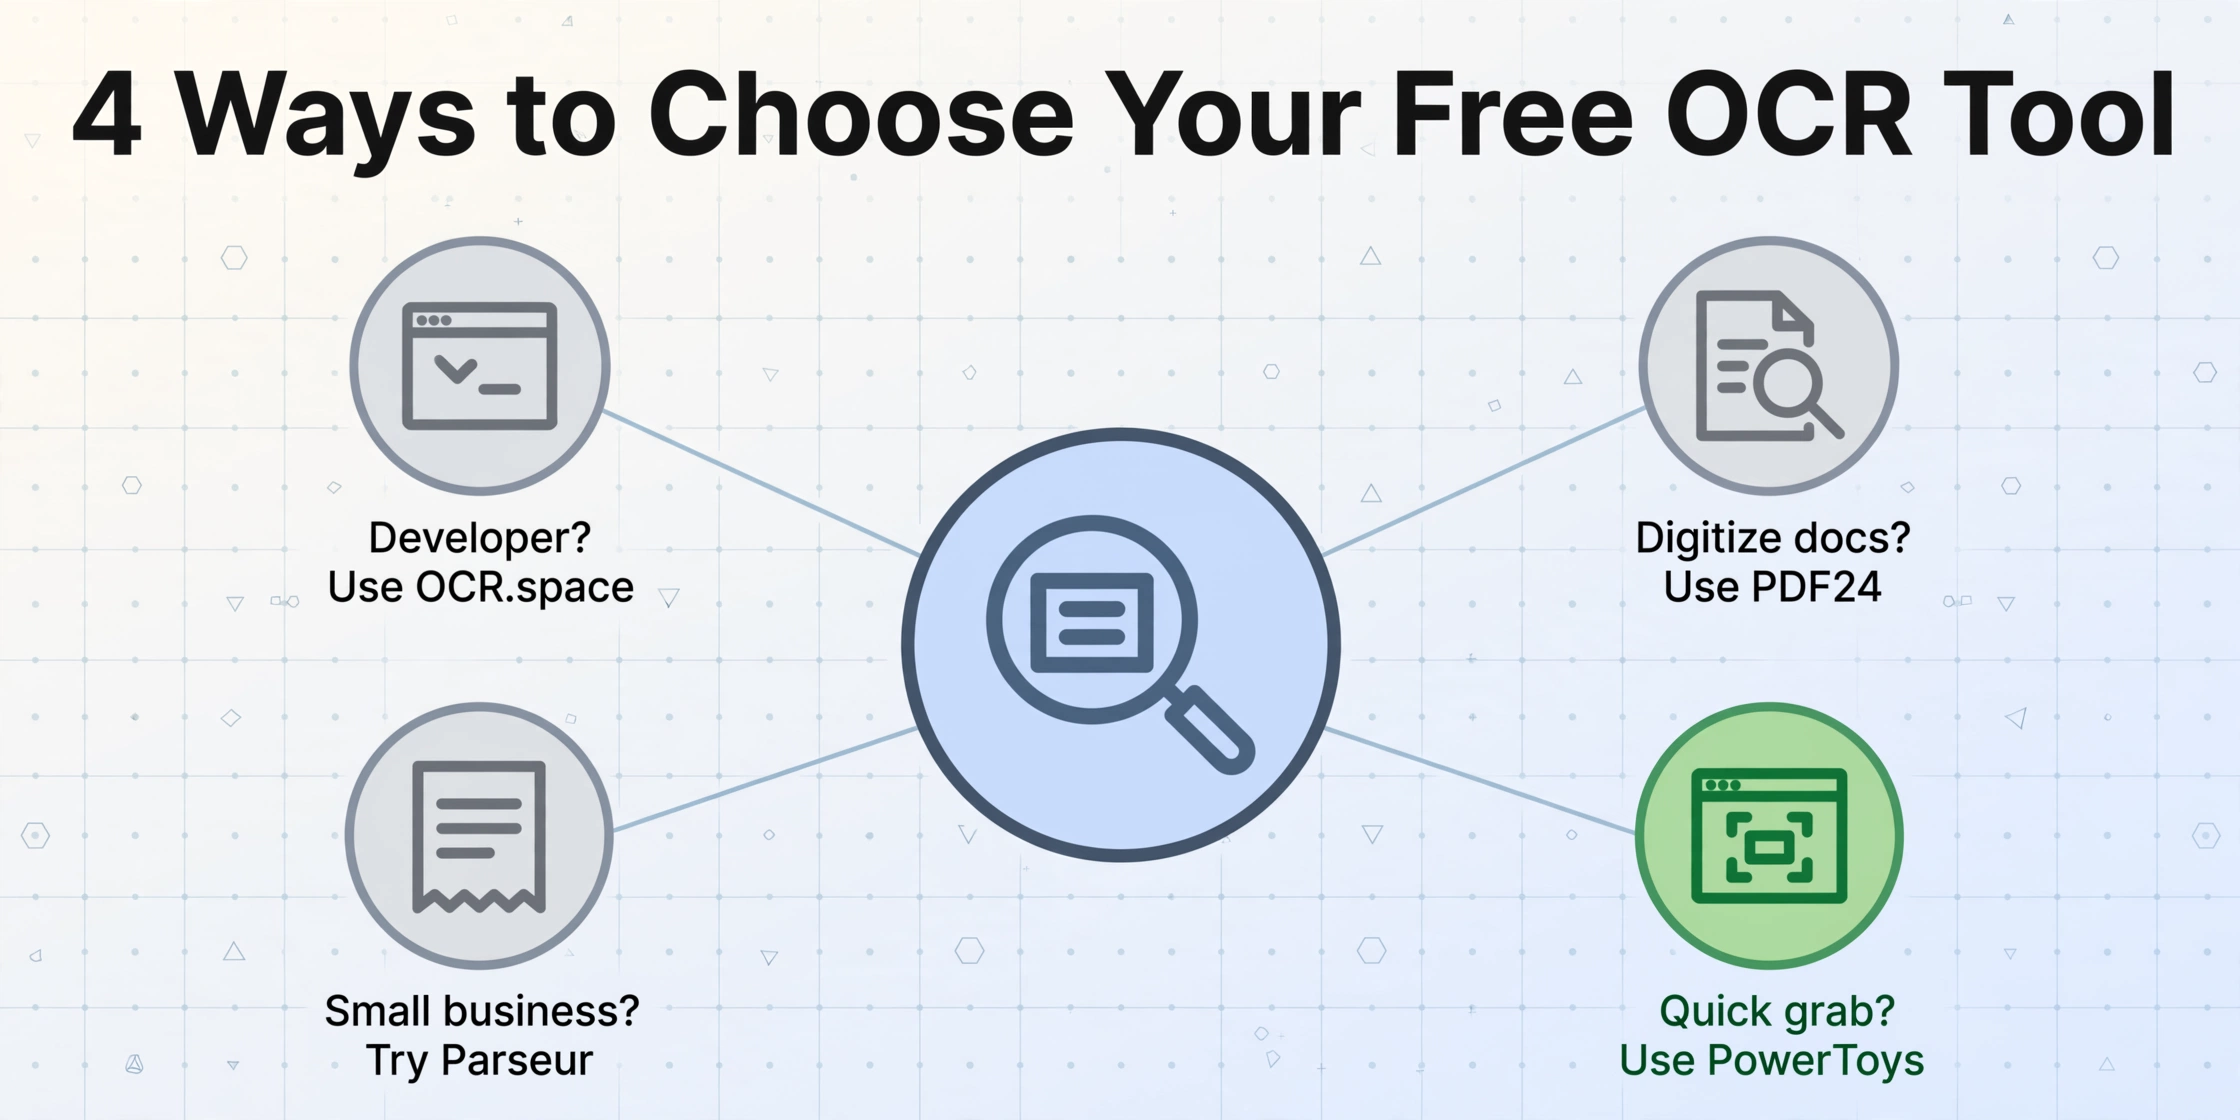
A resposta certa depende totalmente do que você está tentando fazer. Se você ainda está decidindo se o OCR tradicional ou a extração baseada em IA é a abordagem certa, nosso comparativo OCR vs extração por IA detalha a diferença em profundidade. Aqui estão os cenários mais comuns para escolher uma ferramenta gratuita em cada categoria:
Você é um desenvolvedor integrando OCR a um aplicativo
Comece com OCR.space para uma integração rápida de API (25 mil requisições gratuitas/mês). Se você precisar de processamento local/offline, use o Tesseract para reconhecimento de texto leve em CPU ou o PaddleOCR se seus documentos tiverem layouts complexos e você tiver acesso a GPU.
Você precisa digitalizar uma pilha de documentos antigos para pesquisa
Use o PDF24 (gratuito, sem limites, saída em PDF pesquisável). Se os documentos estiverem em vários idiomas, use o Google Drive OCR — qualidade de saída menor, mas suporte a idiomas muito mais amplo.
Você é uma pequena empresa processando de 10 a 30 faturas por mês
O nível gratuito do Parseur cobre 20 páginas/mês. Se suas faturas variam muito em formato, essa é sua melhor aposta de custo zero para extração automatizada de campos. Se você precisar extrair campos para uma planilha agora mesmo, sem configurar um modelo de parsing, experimente a demonstração do ImageToTable.ai.
Você ocasionalmente precisa capturar texto de uma captura de tela ou imagem
No Windows, instale o PowerToys e use Shift+Win+T — é a maneira mais rápida de capturar texto na tela. Em qualquer plataforma, o Google Drive OCR funciona como alternativa.
Um padrão que vale notar: ferramentas online gratuitas são excelentes para reconhecimento de texto (transformar imagens em caracteres). Se o que você realmente precisa é de extração de dados estruturados — encontrar o total da fatura, a data de vencimento ou o nome do fornecedor naquele mar de texto reconhecido — as ferramentas gratuitas transferem o custo do software para o seu tempo de limpeza manual. Essa é a troca que importa.
Se não tiver certeza em qual categoria se encaixa, comece com a ferramenta mais simples (Google Drive OCR ou PDF24 — escolha a que atende seu idioma e necessidades de saída) e veja até onde ela vai. Se perceber que está gastando mais tempo limpando a saída do OCR do que levaria para digitar os dados manualmente, esse é o sinal para explorar os planos gratuitos comerciais. Se seu volume superar esses limites, saberá que a ferramenta vale o investimento.
Perguntas Frequentes
Qual é o melhor software de OCR totalmente gratuito?
Para extração de texto em inglês de documentos limpos, o Google Drive OCR é a melhor opção gratuita: arquivos ilimitados, sem custo de cadastro, 94–96% de precisão em texto impresso e suporte multilíngue surpreendentemente bom. Para saída de PDF pesquisável sem limites, o PDF24 é a melhor escolha gratuita (sem cadastro, sem limite diário). Se você é desenvolvedor e precisa de uma API, o OCR.space oferece 25.000 requisições gratuitas por mês.
Tesseract vs EasyOCR vs PaddleOCR — qual OCR de código aberto devo usar?
Use o Tesseract se precisar de um mecanismo leve, apenas em CPU, para texto impresso limpo — é a dependência mais compacta (~10 MB) e roda mais rápido em CPU. Use o EasyOCR se quiser um demo funcional em Python em cinco minutos e seus documentos forem razoavelmente limpos. Use o PaddleOCR se seus documentos tiverem layouts complexos, tabelas ou idiomas mistos e você tiver uma GPU — ele lida melhor com layouts difíceis que os outros dois, mas exige mais esforço de configuração.
Softwares de OCR gratuitos conseguem converter PDFs escaneados em Word ou Excel editáveis?
Sim, mas com ressalvas. PDF24 e Adobe Acrobat Online (1 arquivo/dia grátis) criam PDFs pesquisáveis e exportam para Word, mas a formatação de tabelas e o layout de colunas geralmente se perdem. O OCR do Google Drive gera arquivos no Google Docs — você perde o layout original completamente. Para saída estruturada em Excel (campos específicos em colunas específicas), nenhuma ferramenta gratuita de OCR de texto lida bem com isso; você precisaria de uma ferramenta de extração de dados como ImageToTable.ai ou Parseur.
Algum software de OCR gratuito reconhece escrita à mão?
Não de forma confiável. O Tesseract tem alguma capacidade para manuscritos se você usar os modelos LSTM e treinar em estilos específicos de caligrafia, mas a precisão padrão para escrita à mão é baixa (cerca de 30–50% em cursiva real). EasyOCR e PaddleOCR vão um pouco melhor em letra de forma, mas ainda ficam muito aquém do que a maioria dos usuários considera "funcional". As ferramentas online gratuitas (Google Drive, PDF24) praticamente não têm reconhecimento de manuscrito. Para escrita à mão, OCR gratuito não é uma solução viável — você precisa de uma ferramenta comercial de extração por IA ou de um serviço dedicado de OCR para manuscritos.
Quais são os custos ocultos dos softwares de OCR gratuitos?
O custo oculto mais comum é o seu tempo de correção. Uma ferramenta de OCR gratuita que produz 90% de precisão em um documento de 200 páginas significa que você terá que corrigir manualmente 20 páginas de erros, o que pode levar horas. O segundo custo oculto é o tempo de configuração para ferramentas de código aberto: colocar o Tesseract ou o PaddleOCR em funcionamento em um pipeline de produção geralmente leva dias de trabalho de engenharia. Para ferramentas online, o custo oculto é a privacidade dos dados — seus documentos são processados em servidores remotos e, embora a maioria dos serviços exclua arquivos automaticamente, os dados em trânsito e durante o processamento não estão sob seu controle.
Quando devo parar de procurar OCR gratuito e pagar por uma ferramenta?
Três sinais: (1) você está gastando mais tempo corrigindo erros de OCR do que digitaria os dados você mesmo; (2) você precisa de dados estruturados (campos específicos em colunas específicas), não apenas texto de uma página; (3) você processa mais de 50–100 documentos por mês de forma consistente. Em qualquer um desses limites, uma ferramenta paga custará menos do que o tempo que você está gastando com a gratuita.
O Veredito sobre OCR Gratuito em 2026
O cenário de OCR gratuito em 2026 é mais amplo do que nunca, mas a mesma verdade de sempre continua valendo: OCR gratuito é excelente em uma coisa específica — transformar uma imagem de texto limpo em caracteres que você pode copiar — e mediano em todo o resto. Se essa única coisa é o que você precisa, você tem opções excelentes. Google Drive OCR, PDF24 e OCR.space cobrem o espectro do casual ao desenvolvedor iniciante com custo zero de verdade. Tesseract, EasyOCR e PaddleOCR dão aos desenvolvedores processamento ilimitado se eles investirem o tempo de configuração.
Se o que você realmente precisa é de dados — não texto, mas valores específicos em colunas específicas — o OCR de texto gratuito vai transformar seu tempo em um custo que parece maior do que qualquer assinatura de software. Os níveis gratuitos comerciais (20 páginas/mês do Parseur, o teste de US$ 200 da Nanonets, a demonstração gratuita do ImageToTable.ai) existem exatamente porque essa lacuna é real, e vale a pena testá-los com seus documentos reais antes de decidir se o gratuito é suficiente.
A ferramenta certa não é a que tem o maior número de precisão — é a que faz seus documentos entregarem a informação que você precisa, a um custo total (incluindo seu tempo) que caiba no valor dessa informação. Comece com a opção mais simples, meça o tempo de limpeza e deixe esse número dizer se o gratuito é suficiente.